
Docling hay bị xếp lẫn với các web scraper, nhưng thực ra nó không phải vậy. Đây là bộ công cụ chuyển đổi tài liệu do IBM Research phát triển — nay là một dự án của LF AI & Data Foundation — chuyên nhận các tệp bạn đã có sẵn (PDF, DOCX, PPTX, XLSX, HTML, ảnh) rồi chuyển chúng sang Markdown hoặc JSON. Ngay trên tagline của họ cũng nói rất rõ: “Chuẩn bị tài liệu của bạn cho gen AI.”
Vì vậy, đây là bài đánh giá thực chiến về một công cụ chuyển đổi, không phải một trình crawl. Mọi kết quả bên dưới đều được đo trên một máy chỉ có CPU (macOS arm64, Python 3.14.2, Docling 2.111.0), chấm điểm bằng script, và lỗi nào cũng được ghi nhận đúng là lỗi. Kho mã này rất lớn và gần như ngày nào cũng thay đổi — 63.069 sao, 4.449 fork, và tôi còn pull metadata đúng ngay trong ngày có bản cập nhật — nên hãy xem mọi con số ở đây như một lát cắt tại thời điểm kiểm tra, chứ không phải chân lý cố định.
Docling Thực Ra Là Gì, Và Không Phải Là Gì
Đơn vị trung tâm của Docling là DoclingDocument: nó phân tích một tệp thành cấu trúc này, rồi xuất ra Markdown, HTML, DocTags hoặc JSON mà không mất dữ liệu. Mã nguồn được cấp phép MIT (từng model có thể có giấy phép riêng), dự án khởi nguồn từ IBM Research Zurich, và tại thời điểm viết bài, bản phát hành mới nhất là v2.112.0, được công bố hai ngày trước khi tôi chạy thử.
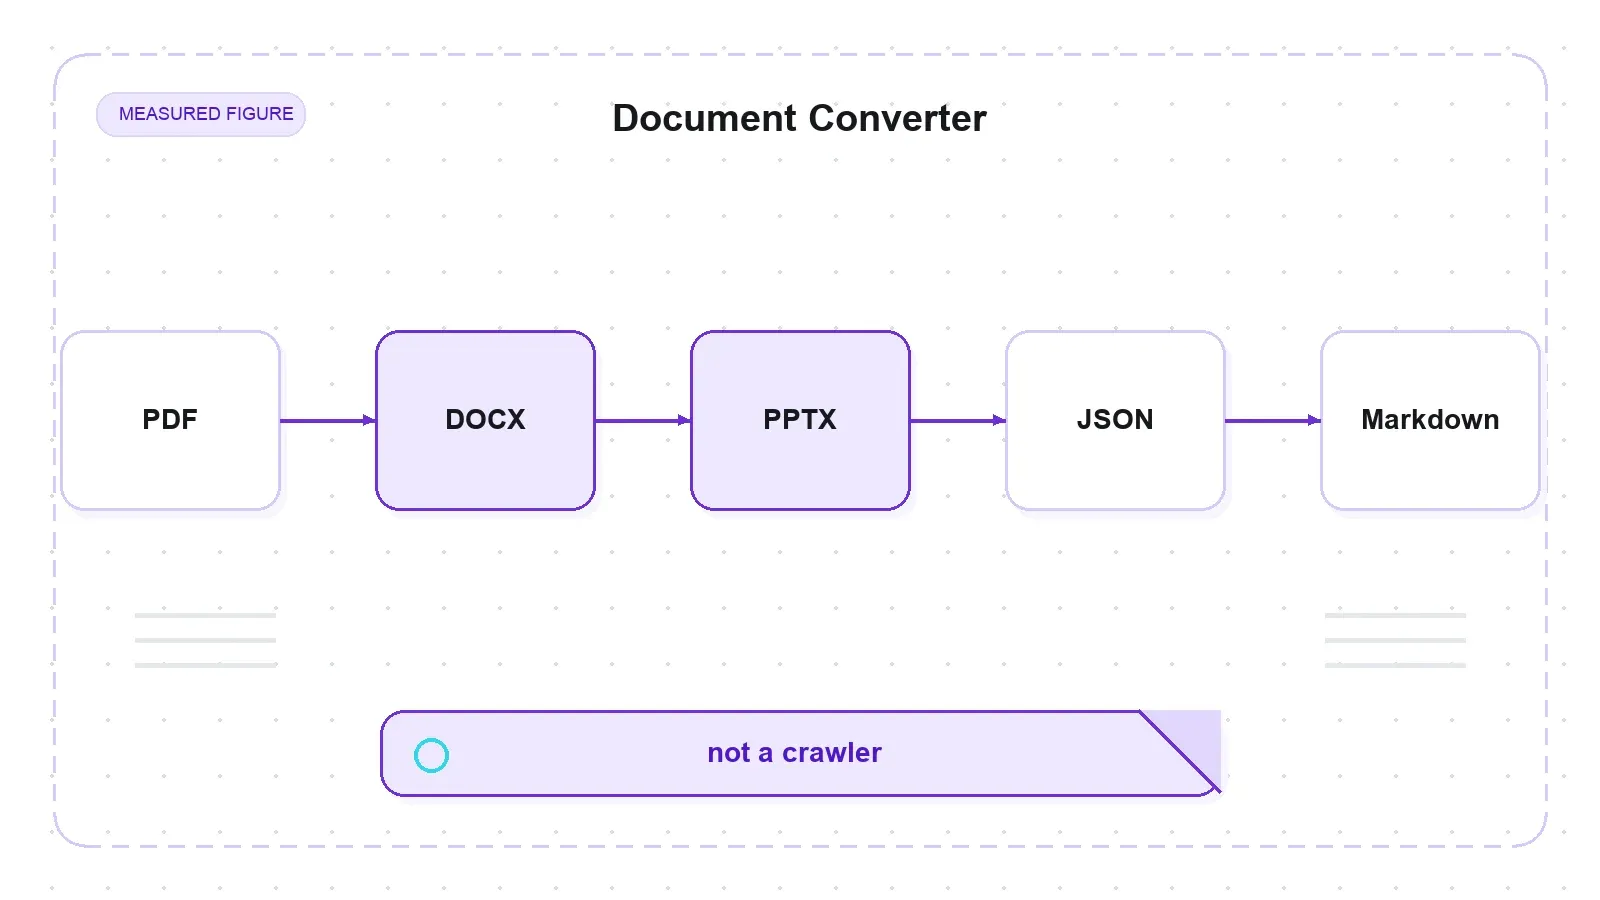
Khả năng nổi bật nhất của nó là xử lý PDF và ảnh. Và đường xử lý này không hề kiểu đọc chuỗi đơn giản — nó là một “stack” gồm các model machine learning: model bố cục RT-DETR, model cấu trúc bảng TableFormer, một vision-language model tùy chọn, và RapidOCR cho tài liệu scan. Những model này được dùng để khôi phục bố cục trang, thứ tự đọc và cấu trúc bảng. Đó mới là phần đáng để review, và cũng là phần mà một bài test chỉ có HTML sẽ không bao giờ nhìn thấy.
Có một điểm khác biệt rất quan trọng để bạn khỏi mất một tuần loay hoay. Docling không đi lấy bất cứ thứ gì. Nó không render JavaScript, không vượt tường anti-bot, và cũng không crawl website. Bạn đưa file vào; nó làm phần hiểu nội dung. Việc crawl là nhiệm vụ của công cụ khác, và chuyện này sẽ rất quan trọng về sau khi nhiều người hỏi liệu Docling có thay thế Firecrawl không (không — chúng bổ trợ cho nhau, tôi sẽ giải thích ngay sau đó).
Lần Chạy Đầu Tiên Mà Không Ai Cảnh Báo Bạn Trước
pip install docling cài đặt khá êm trên Python 3.14.2. Nhưng rồi nhìn vào môi trường ảo, bạn sẽ thấy nó ngốn 1,3 GB. Docling kéo cả bộ ML stack vào dưới dạng phụ thuộc bắt buộc, ngay cả khi thứ bạn chuyển đổi chỉ là một file HTML:
| Phụ thuộc | Dung lượng trên đĩa (MiB, du) |
|---|---|
| torch (2.13.0) | 536 |
| opencv (cv2) | 119 |
| transformers (5.8.1) | 101 |
| scipy | 99 |
| sympy | 76 |
| pandas | 72 |
| rapidocr (+ model đi kèm) | 72.1 |
| docling_parse | 30 |
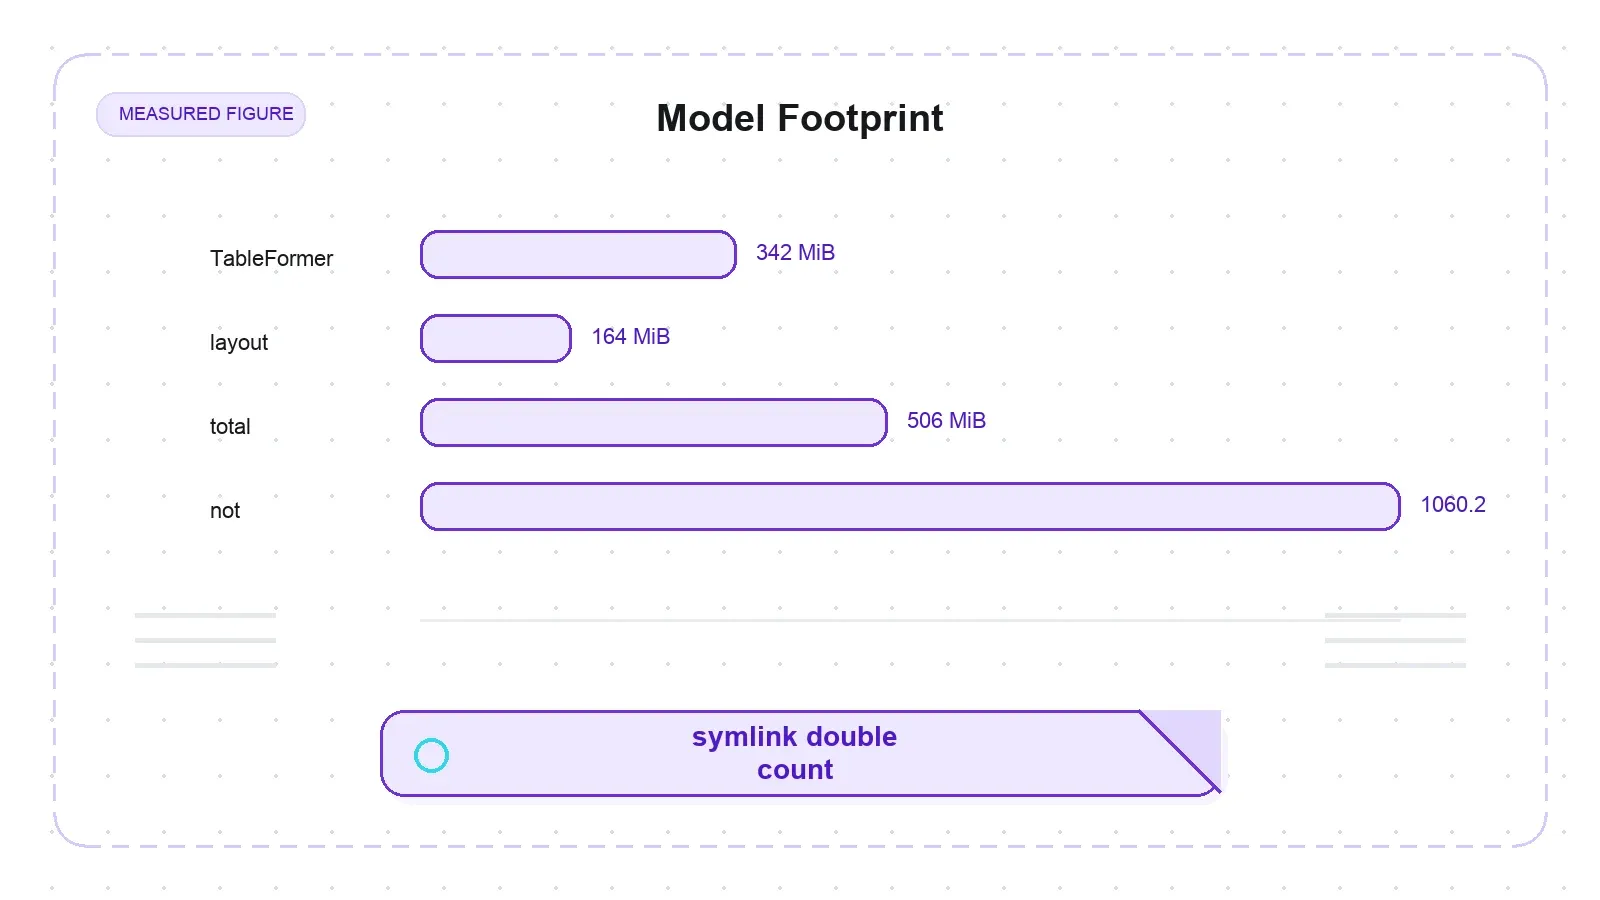
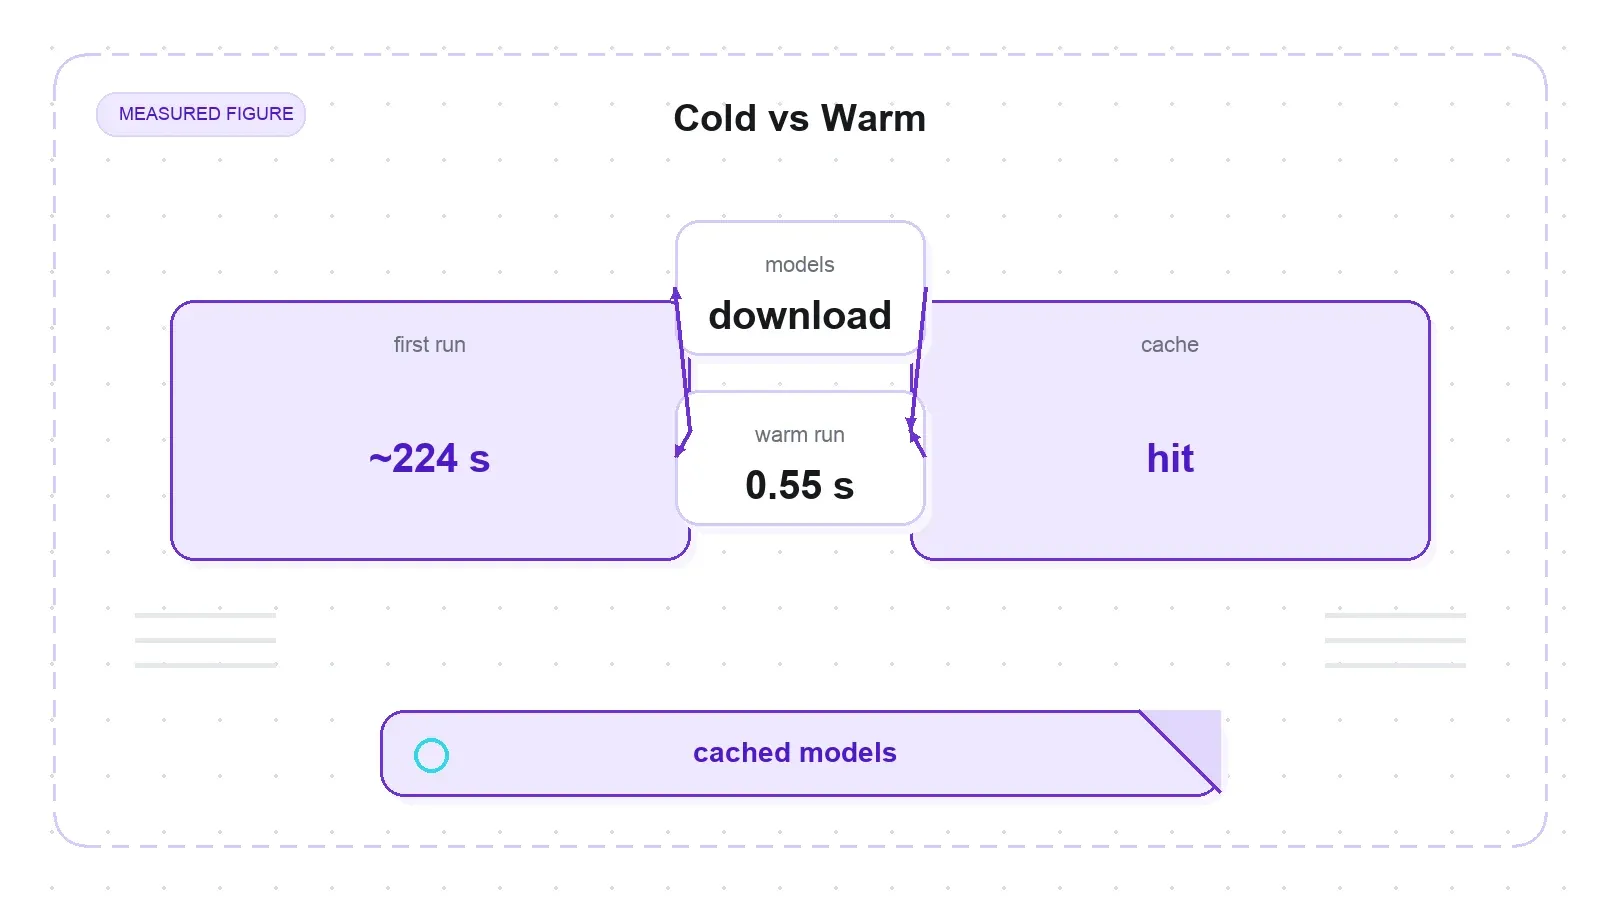
Đó mới chỉ là trước khi bạn chuyển đổi một PDF nào đó. Vấn đề thật sự xuất hiện ở lần chuyển đổi PDF đầu tiên, vì đó là lúc các model được tải xuống. Trên một HuggingFace cache sạch và tách biệt, lần chuyển đổi PDF đầu tiên mất khoảng 224 giây — và gần như toàn bộ thời gian đó là do tải model chứ không phải tính toán. Cặp model layout + TableFormer chiếm khoảng 506 MiB trên đĩa (342 MiB TableFormer + 164 MiB layout, đã xác minh bằng du), còn RapidOCR tải thêm khoảng 40 MB trọng số PP-OCRv4 vào site-packages. Còn lần chuyển đổi thứ hai cho chính file đó? 0,55 giây. Model đã được cache; bạn chỉ phải trả phí một lần.
Có một con số bạn nên bỏ qua: script cold start in ra model_download_mb là 1060.2. Đừng lấy số đó làm footprint thật. Nó đến từ os.walk đi theo cả symlink, trong khi cache của HuggingFace lưu mỗi file model một lần trong blobs/, rồi trỏ ngược ra snapshots/ bằng symlink — nên quá trình walk đã đếm 14 file model hai lần. Con số đúng khi khớp với du và đã loại trùng symlink là khoảng 506 MiB (riêng blobs là 505,4 MiB). Bài học cho bất kỳ ai benchmark Docling: hãy báo riêng dung lượng tải xuống và dung lượng trên đĩa, vì chúng là hai thứ khác nhau.
Có thêm một rắc rối nữa mà ai build container cho Docling cũng sẽ gặp. Trọng số model nằm ở hai nơi khác nhau và theo hai lịch khác nhau. Model layout và TableFormer tôn trọng HF_HOME và chỉ tải khi chuyển đổi PDF lần đầu. Còn model của RapidOCR thì không — nó được lưu vào …/site-packages/rapidocr/models/, hoàn toàn bỏ qua cấu hình cache của bạn. Nếu bạn đang pre-bake image hoặc làm môi trường air-gap, bạn phải xử lý cả hai cache này, và dù có đặt HF_HOME thế nào đi nữa cũng không bắt được phần thứ hai.
Bây giờ nói phần công bằng hơn. Từ các bản phát hành trước đó, dự án đã có docling-slim — một lõi khoảng 50 MB cho phép bạn pip install docling-slim[format-html] để xử lý HTML mà không phải kéo theo torch. Vì vậy, mức 1,3 GB là thật đối với gói mặc định docling, nhưng hiện giờ nó đã có thể tránh được. Tôi vẫn test gói mặc định vì đó là thứ mà pip install docling trả về, nhưng độ “nặng” này không còn là một lỗi chưa được giải quyết — cách mô-đun hóa đã tồn tại và đang được theo dõi ở issue #2393.
Trong lúc cài đặt, tôi cũng gặp một lỗi nhỏ nhưng đáng chú ý: import docling; docling.__version__ sẽ báo AttributeError: module 'docling' has no attribute '__version__'. Module này đơn giản là không export nó. Cách kiểm tra đúng là importlib.metadata.version("docling"), trả về '2.111.0'. Đây chỉ là một khó chịu nhỏ về DX, và đã mở upstream từ tháng 7/2026 dưới issue #3733.
Độ Chính Xác Bảng: Nơi TableFormer Thể Hiện Giá Trị
Bảng là lý do chính khiến nhiều người chọn Docling thay vì chỉ dump PDF sang text, nên tôi tạo ra bảy file PDF có bảng với ground truth đọc máy được và chấm từng ô một. Có hai chỉ số quan trọng, và chúng không giống nhau: cell recall là tỷ lệ giá trị ground truth xuất hiện ở đâu đó trong bảng được phát hiện; in-row rate là tỷ lệ giá trị rơi đúng hàng của nó. Gộp hai thứ này lại sẽ làm công cụ trông đẹp hơn thực tế, nên ở đây tôi ghi cả hai:
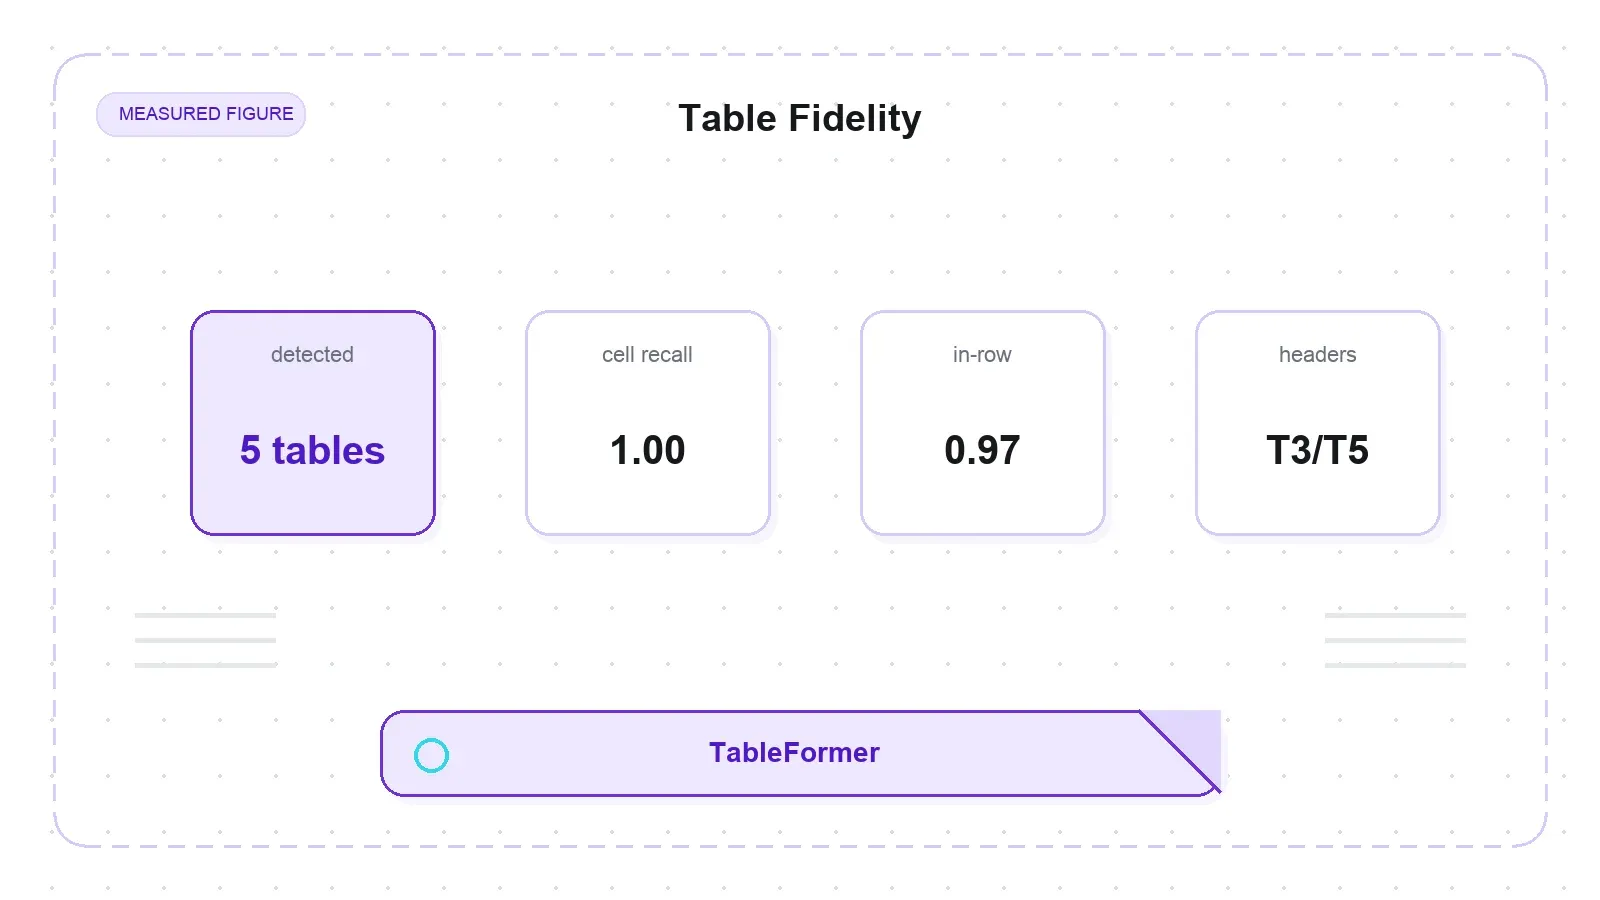
| Bảng (stress test) | Phát hiện được | Cell recall | In-row rate | Ghi chú |
|---|---|---|---|---|
| T1 lưới có viền đơn giản (8 hàng × 5 cột), đứng một mình trên trang | Không | 0.0 | — | bị phân loại thành <!-- image -->, toàn bộ ô bị bỏ |
| T2 không viền (chỉ có một đường ở tiêu đề) | Có | 1.00 | 1.00 | hoàn hảo, đúng lưới |
| T3 tiêu đề colspan 2 tầng có gộp ô | Có | 1.00 | 0.97 | đủ mọi giá trị; một giá trị tiêu đề bị lệch sang hàng khác |
| T4 rowspan nhãn hàng có gộp, đứng một mình trên trang | Không | 0.0 | — | bị phân loại thành <!-- image --> |
| T5 tiêu đề colspan + không viền | Có | 1.00 | 0.97 | đủ mọi giá trị; lệch hàng giống T3 |
| T6 bảng tài chính, có cột trống, canh phải | Có | 1.00 | 1.00 | cột trống được giữ nguyên, không bị dồn lệch |
| T7 lưới rộng 12 cột | Có | 1.00 | 1.00 | không lệch cột trên bảng rộng |
Trong năm bảng mà Docling phát hiện ra, mọi giá trị ground truth đều xuất hiện — cell recall 1.00 trên toàn bộ. Trong số đó, ba bảng còn có toàn bộ giá trị rơi đúng hàng của nó. Ở hai trường hợp tiêu đề nhiều tầng (T3 và T5), một giá trị tiêu đề bị trượt khỏi hàng gốc, làm in-row giảm còn 0,97 — dữ liệu vẫn đủ, nhưng việc gán hàng bị chệch một chút trên tiêu đề xếp lớp.
Các trường hợp cấu trúc khó còn tốt hơn tôi dự đoán. Tiêu đề colspan hai tầng được làm phẳng đúng sang GitHub-flavored Markdown (nhãn “Q1 2026” lặp lại trên hai cột mà nó trải qua, và đó là cách đúng để nén một colspan sang GFM). Lưới không viền chỉ có một đường tiêu đề (T2) đi qua chính xác. Bảng rộng 12 cột (T7) không bị lệch. Và một cột tài chính hoàn toàn trống (T6) vẫn được giữ là ô rỗng thay vì bị bỏ hoặc nén lại. Điều này khớp với điểm TEDS chính thức của TableFormer — 95,4 cho bảng đơn giản, 90,1 cho bảng phức tạp, 93,6 cho toàn bộ bảng — và model card chấm cao hơn Camelot (73,0) lẫn EDD (88,3).
Một lưu ý về ô gộp, vì hiện có một issue nói ngược lại. Issue #3698 báo rằng V1 và V2 xử lý sai hàng và cột gộp. Trên bộ fixture của tôi, colspan đơn giản (T3/T5) và rowspan vẫn được làm phẳng đúng, chỉ có chuyện lệch hàng ở tiêu đề nhiều tầng như đã nêu. Nhưng các case hỏng trong #3698 là những kiểu gộp nhiều hàng/nhiều cột không đều và bảng nhiều trang — tức là phần bệnh lý nặng hơn. Bộ test của tôi thuộc kiểu đơn giản. Vì vậy, phát biểu chính xác phải hẹp hơn: colspan và rowspan đơn giản được phục hồi đúng trong thử nghiệm này (tiêu đề nhiều tầng có thể lệch một hàng); các kiểu gộp phức tạp và không đều vẫn là một vấn đề mở đã được ghi nhận. Không phải “ô gộp hoạt động tốt hết”, cũng không phải “ô gộp đều hỏng”.
Cái Bẫy: Một Bảng Đứng Một Mình Trên Trang Có Thể Biến Mất
Nhìn lại bảng trên — T1 và T4 đã không được phát hiện. Docling xuất ra <!-- image --> và bỏ toàn bộ ô, không báo lỗi. T1 là một lưới rất bình thường, có viền, 8 hàng và 5 cột. Điều đó đủ đáng lo để tôi chưa vội kết luận đây là điểm yếu của parser bảng, mà phải cô lập xem chính xác thứ gì kích hoạt nó, nên tôi làm một bài test A/B bằng script.
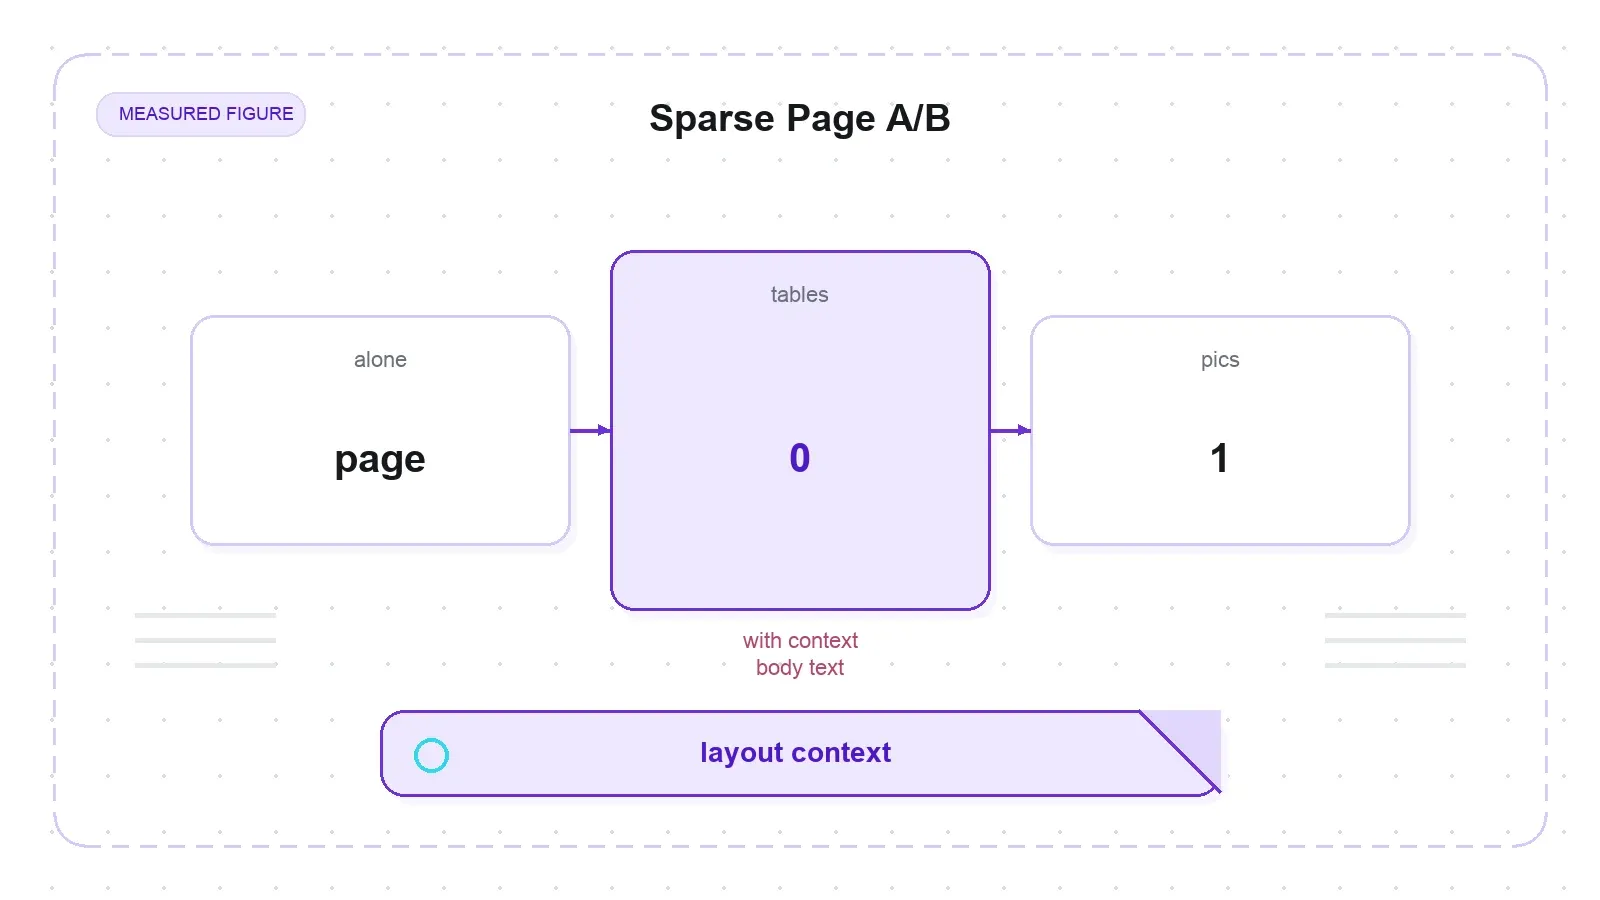
Đầu tiên, tôi loại trừ các nguyên nhân hiển nhiên. Lớp text vẫn còn nguyên — pypdfium2 đọc được 327 ký tự từ T1 và 221 ký tự từ T4, nên đây là PDF số thật sự chứ không phải ảnh scan. Tắt OCR (do_ocr=False) cũng không giúp gì; bảng vẫn rơi mất. Và khi kiểm tra trực tiếp DoclingDocument, len(doc.tables) == 0 trong khi len(doc.pictures) == 1 — nghĩa là model layout đã phân loại cả vùng bảng thành một Picture.
Rồi đến bài test quyết định. Tôi render lại đúng nguyên bảng T1 và T4 đó, nhưng lần này đặt chúng xen giữa vài đoạn văn bản bình thường, rồi convert lại. Kết quả: cả hai đều đi qua hoàn hảo — len(doc.tables) == 1, xuất ra bảng GFM chuẩn, và nhãn rowspan “North” của T4b được lặp đúng qua ba hàng. Cùng một bảng. Chỉ thay đổi duy nhất là nó nằm một mình trên một trang rất trống hay được nhúng vào văn bản.
Vậy caveat thật sự không phải là TableFormer quá mong manh — mà là model bố cục RT-DETR của Docling dùng ngữ cảnh trang, và một bảng nhỏ đứng một mình trên trang gần như trống rất dễ bị đọc thành Picture rồi bị bỏ lặng lẽ. Điều này khá dễ gặp trong thực tế, vì invoice, spec sheet và các bản export bị crop thường đúng là như vậy: mỗi trang một bảng, không có văn bản xung quanh. Cách xử lý thì hơi nhàm nhưng hiệu quả: hãy cung cấp thêm ngữ cảnh cho model bố cục, hoặc kiểm tra hậu xử lý doc.tables sau khi convert và đánh dấu những trang có số lượng bằng 0. Điều này gần với issue #3495 (một bảng bị nhận đồng thời là Table và Picture), nhưng riêng tác nhân “trang quá thưa” — cùng một bảng, bị bỏ khi đứng riêng nhưng convert được khi có ngữ cảnh — thì tôi không tìm thấy tài liệu công khai nào nói trước đó. Đo được, nhưng chưa từng được ghi chép.
OCR Trên File Scan Thật: RapidOCR, Không Phải EasyOCR
PDF scan là nơi rất nhiều trình chuyển đổi âm thầm thất bại, nên tôi đưa cho Docling hai bản scan thật với text layer đo được là 0 ký tự — pypdfium2 báo không thể phục hồi ký tự nào, xác nhận rằng mọi output ở đây là OCR thật sự, không phải text layer ẩn đi kèm.
File một trang ocr_test.pdf trả về sạch sẽ trong 14,3 giây trên CPU: “Docling bundles PDF document conversion to JSON and Markdown in an easy self contained package,” được khôi phục nguyên văn. File bốn trang nemotron_multipage.pdf chạy OCR trên cả bốn trang với tổng thời gian 70,1 giây (17,5 giây/trang), và xuất lại câu test lặp trên từng trang. OCR mặc định tự chạy — không cần cờ, không cần cấu hình.
Chi tiết mà nhiều bài viết nói sai là: engine OCR mặc định là RapidOCR, không phải EasyOCR. Tôi xác nhận điều này bằng cách xem trọng số PP-OCRv4 .pth được tải ở lần chạy đầu tiên. Rất nhiều blog hiện có và cả FAQ cũ của Docling vẫn nói EasyOCR là mặc định; điều đó đã lỗi thời. EasyOCR giờ là một phần bổ sung bạn phải chủ động bật. Còn điều vẫn đúng: OCR là đường xử lý chậm khi chạy ở quy mô lớn, và mọi con số ở đây đều là trần hiệu năng trên CPU — nếu có GPU, thời gian sẽ giảm đáng kể.
PDF Thật, Thứ Tự Đọc Và Thời Gian Mỗi Trang
Các fixture tổng hợp chứng minh hành vi cụ thể; PDF thật chứng minh rằng nó thực sự dùng được. Tôi chạy hai bài báo học thuật born-digital — báo cáo kỹ thuật của Docling dài 9 trang và “Attention Is All You Need” dài 15 trang, cả hai đều hai cột, có bảng và công thức.
Trên paper Attention dài 15 trang, cả năm mốc phần — Abstract, Introduction, Background, Conclusion, References — đều xuất hiện đúng thứ tự trong tài liệu khi Markdown được tuyến tính hóa, bất chấp bố cục hai cột. Mọi tín hiệu nội dung quan trọng đều có mặt (Transformer, encoder, BLEU, multi-head), và các bảng kết quả hai cột nổi tiếng được ghi nhận thành bốn bảng riêng biệt. Đó là khả năng khôi phục thứ tự đọc và gộp cột thực sự, vốn là giá trị cốt lõi cho RAG chunking — bạn không thể chia đoạn tài liệu một cách hợp lý nếu bộ linearizer làm nát trang hai cột thành một mớ nội dung xen kẽ hỗn loạn.
Thời gian xử lý lại cho thấy một bài học hơi ngược trực giác. Thời gian trên mỗi trang không bị quyết định bởi số trang, mà bởi lượng cấu trúc nằm trên từng trang. Báo cáo 9 trang nhưng dày đặc hơn chạy ở 14,95 giây/trang — chậm hơn theo từng trang so với bài 15 trang ở 5,99 giây/trang — vì nó nhồi nhiều bảng và hình hơn trên mỗi trang — 3 bảng trên 9 trang so với 4 bảng trên 15 trang — và mỗi lần như vậy lại kích hoạt thêm nhiều bước suy luận layout và TableFormer. Đây là một biên độ nhỏ, và xét tuyệt đối thì tài liệu dày hơn còn có ít bảng hơn chứ không phải nhiều hơn. Vậy nên “giây trên mỗi trang” trên CPU là hàm của mật độ cấu trúc, không phải độ dài. Đây chỉ là một lần chạy CPU đơn lẻ; nó là mức trần, không phải số production.
Đa Định Dạng Và Lời Hứa Về JSON Không Mất Dữ Liệu
Docling quảng cáo khả năng phân tích thống nhất nhiều định dạng, nên tôi tạo một DOCX, một XLSX và một PPTX với nội dung đã biết cùng các probe ground truth, rồi kiểm tra hai điều: các probe có xuất hiện trong Markdown không, và chúng có còn nguyên sau vòng lặp JSON qua export_to_dict() không.
| Tệp | Thời gian convert (s) | Probe tìm thấy trong MD | Bảng trong MD | Probe còn nguyên trong JSON |
|---|---|---|---|---|
report.docx (tiêu đề + bảng gộp hàng "Total" + bullet) | 0.137 | 7/7 | 1 | Có |
workbook.xlsx (2 sheet, cột trống) | 0.016 | 6/6 | 2 | Có |
deck.pptx (3 slide, bullet + bảng) | 0.038 | 6/6 | 1 | Có |
Tất cả probe nội dung đều xuất hiện trong Markdown, các bảng đều được phục hồi (bao gồm hàng “Total” gộp của DOCX và cả hai sheet của XLSX), và mọi probe cũng còn nguyên sau export_to_dict() sang JSON — đây là bằng chứng quan trọng nhất cho lời khẳng định DoclingDocument không mất dữ liệu, ít nhất trên các input sạch. Những định dạng này đi qua backend gốc của chính format, thay vì qua các model ML, vì vậy chúng chạy trong vài chục mili giây và hoạt động hoàn toàn offline. Phạm vi đánh giá ở đây là thành thật: một file sạch cho mỗi định dạng chứng minh độ rộng hỗ trợ, chứ không phải bài stress test cho các file Office bệnh lý.
HTML: Trung Thực, Nhưng Không Sạch Sẽ
Đây là caveat quyết định Docling có nên vào pipeline RAG của bạn hay không, nên hãy đọc kỹ. Docling chuyển đổi toàn bộ tài liệu HTML. Nó không làm kiểu readability-style để chỉ trích xuất nội dung chính. Tôi đo mức độ “chrome” của site còn sót lại bằng cách đếm các dòng đánh dấu nav, mục lục, cookie và footer trong output của chính Docling.
| Trang | Số dòng MD không rỗng | Số dòng boilerplate | % boilerplate | Bài viết bắt đầu từ dòng |
|---|---|---|---|---|
| Wikipedia "Web scraping" | 255 | 34 | 13.3% | 28 |
| scrapethissite/forms | 63 | 1 | 1.6% | — |
| books.toscrape | 65 | 0 | 0.0% | — |
| quotes.toscrape | 35 | 0 | 0.0% | — |
Trên một trang nhiều “chrome” như Wikipedia, khoảng 13% số dòng Markdown là nav/mục lục/footer boilerplate, và bài viết thật sự chỉ bắt đầu từ dòng 28 — output mở đầu bằng “move to sidebar / Contents / Toggle the table of contents” và kết thúc bằng “CS1 maint… / Search Wikipedia.” Trên các trang nội dung sạch (books, quotes) thì tỷ lệ gần 0%, nên đây là vấn đề của template chrome chứ không phải một thứ phí cố định trên mỗi trang. Docling cho bạn Markdown trung thực của toàn tài liệu, chứ không phải trích xuất nội dung chính đã làm sạch. Upstream đã theo dõi vấn đề “đồ nội thất HTML” này ở issue #1865 (đã đóng) và #1930 (đang mở).
Có hai điểm giúp đánh giá công bằng. Thứ nhất, riêng với HTML thì Docling không chạy bất kỳ model ML nào — nó chỉ dùng BeautifulSoup trong một pipeline đơn giản. Câu chuyện “vision model đọc trang của bạn” chỉ áp dụng cho PDF và ảnh; đưa HTML vào thì toàn bộ phần layout và TableFormer không hề chạy. Thứ hai, đường PDF có cố gắng phân loại header và footer, nên nói “hoàn toàn không dọn boilerplate” sẽ quá tay — chỉ riêng backend HTML mới trả lại phần chrome đó.
So Sánh Với Gì, Và Thunderbit Đứng Ở Đâu
Dùng thử Thunderbit để trích xuất dữ liệu web
Công cụ mốc mà người ta hay đem Docling ra so sánh nhất là Firecrawl, nên dưới đây là bảng định vị. Có một lưu ý trước, vì nó rất quan trọng: đây là so sánh ở mức tài liệu, không phải benchmark trên cùng một máy. Tôi không chạy Firecrawl trên các fixture này. Chỉ cột Docling là kết quả đo trực tiếp; cột Firecrawl lấy từ tài liệu công khai của họ.
| Trục so sánh | Firecrawl (theo tài liệu của họ) | Docling (đo trong bài này) |
|---|---|---|
| Nhiệm vụ cốt lõi | Crawl + scrape web sống → Markdown | Chuyển tài liệu bạn đã có → Markdown/JSON |
| Fetch / render JS / anti-bot | Có (trình duyệt hosted) | Không — bạn tự cung cấp file |
| Trích xuất nội dung chính | Có | Không — trung thực toàn tài liệu (~13% boilerplate trên Wikipedia) |
| Cấu trúc bảng PDF (ML) | hạn chế | Có — TableFormer (TEDS chính thức 93,6; cell recall 1.00, in-row 0.97–1.00 trên fixture đã phát hiện) |
| PDF scan / OCR | hạn chế | Có — RapidOCR mặc định (khôi phục được scan không có text layer) |
| Phạm vi định dạng | trang web | PDF/DOCX/PPTX/XLSX/HTML/EPUB/ảnh |
| Triển khai | API hosted (+ self-host) | thư viện pip local, offline, không cần API key |
| “Trọng lượng” khi cài | API key / client nhẹ | cài mặc định 1,3 GB + ~506 MiB model (hoặc docling-slim) |
| Giấy phép | thương mại / source-available | MIT |
Tóm gọn trong một câu: Firecrawl là công cụ dành cho dữ liệu nằm trên web sống, cần crawl, render JS và dọn nội dung chính. Docling là công cụ dành cho tài liệu bạn đã cầm trong tay — đặc biệt là PDF, bản scan và file Office nhiều bảng — và bạn muốn chuyển đổi offline, giữ nguyên cấu trúc, hiểu bảng và OCR thật sự. Hai công cụ này bổ trợ cho nhau. Một pipeline thực tế sẽ crawl bằng công cụ này và chuyển đổi tài liệu bằng công cụ kia.
Và đây là chỗ tôi nói thẳng về Thunderbit, vì tôi làm ở đây và bạn có quyền nghi ngờ nếu tôi giả vờ không liên quan. Thunderbit và Docling không làm cùng một việc, nên tôi sẽ không cố ép chúng thành tương đương. Với dev, Thunderbit là một AI scraping API cộng thêm MCP server và CLI, và đơn vị làm việc của nó là trang web sống: POST /distill biến một URL thành Markdown sạch, sẵn cho LLM (xử lý phần render JS, anti-bot và CAPTCHA mà Docling không đụng tới), còn POST /extract trả về JSON có cấu trúc khớp schema dựa trên JSON Schema do bạn định nghĩa. Đó là phần fetch-and-clean của một pipeline RAG. Còn Docling là phần tài liệu cục bộ — PDF, bản scan, bảng tính đã nằm sẵn trên ổ đĩa. Nếu corpus của bạn là các trang web, hãy dùng API của Thunderbit, các công cụ MCP (thunderbit_suggest_fields, thunderbit_distill, thunderbit_extract) hoặc CLI (npx @thunderbit/thunderbit-cli). Nếu là PDF và scan, hãy dùng Docling. Nếu là cả hai — và đó mới là đa số pipeline thực tế — hãy ghép chúng lại, vì không công cụ nào đang cố làm vai trò của công cụ kia.
Kết Luận: Tạm Thời, Và Vẫn Còn Việc Phải Làm
Tôi sẽ không đưa bạn một điểm số duy nhất từ 0–100, vì nếu cộng điểm có trọng số ở đây thì nó sẽ trừ điểm cho những việc Docling vốn chưa bao giờ hứa làm (như crawl), rồi giả vờ rằng chúng là thứ có thể so sánh trực tiếp. Nếu nhìn theo từng chiều trên bộ fixture tôi test:
- Cài đặt / lần chạy đầu: nặng — venv 1,3 GB, model ~506 MiB, lần đầu chuyển PDF ~224 giây, lần warm ~0,55 giây — nhưng
docling-slimcho phép bạn tránh gánh nặng này. - Độ chính xác bảng: mạnh khi bảng được nhận diện (cell recall 1.00 trên 5/5, in-row 0.97–1.00), khớp với câu chuyện TEDS chính thức trên các fixture này.
- Độ bền phát hiện bảng: có bẫy trang thưa — bảng đứng một mình có thể bị rơi thành Picture. Hãy kiểm tra lại
doc.tablessau khi convert. - Scan / OCR: hoạt động, RapidOCR mặc định; chậm khi chạy ở quy mô lớn.
- Đa định dạng: ổn, và vòng JSON round-trip vẫn giữ nguyên.
- HTML: trung thực nhưng không sạch — không trích xuất nội dung chính.
- Trải nghiệm dev: API gọn,
DoclingDocumentsạch sẽ, chỉ hơi khó chịu vì thiếu__version__.
Nó phù hợp với ai: các team đang xây RAG hoặc pipeline dữ liệu trên PDF, bản scan và file Office, muốn chuyển đổi offline, giữ cấu trúc, và cần hiểu bảng + OCR thật sự. Nó không phù hợp với ai: người cần crawl web sống hoặc trích xuất HTML nội dung chính sạch sẽ — đó là một bài toán khác.
Và vì đây là review chứ không phải thông cáo báo chí, nên các giới hạn vẫn phải được ghi rõ. Đây là một bộ probe có chủ đích — 7 bảng tổng hợp và 2 PDF thật trên một máy chỉ CPU — chứ không phải benchmark độ chính xác quy mô TEDS. Có nhiều thứ tôi chưa test và bạn cũng nên kiểm tra trước khi đặt cả pipeline lên Docling: đường VLM tùy chọn (GraniteDocling), footprint thực tế của docling-slim, bất kỳ bài chạy GPU nào, các ô gộp phức tạp và không đều cùng bảng nhiều trang, độ trung thực khi chuyển công thức sang LaTeX, và — thứ dễ gây bất ngờ nhất trong production — bộ ba độ bền của tăng bộ nhớ theo batch, scale theo thread/GIL, và vòng đời object qua hàng nghìn lần chuyển đổi. Docling rất mạnh ở đúng những gì nó tuyên bố, được đo chứ không chỉ được tiếp thị, và nó cũng có những cạnh sắc thật sự mà bạn nên vẽ bản đồ trước khi giao một corpus lớn cho nó. Hãy nhớ caveat về trang thưa, dự trù tải xuống ở lần chạy đầu, và tự kiểm tra hành vi ở quy mô lớn.
Dùng thử Thunderbit để trích xuất dữ liệu web Get Started Free
Câu hỏi thường gặp
Docling là web scraper hay crawler à? Không. Docling chuyển đổi những tài liệu bạn đã có sẵn — PDF, DOCX, PPTX, XLSX, HTML, ảnh — sang Markdown hoặc JSON. Nó không fetch URL, không render JavaScript, cũng không xử lý anti-bot. Việc crawl web sống là nhiệm vụ khác, do những công cụ như Firecrawl hoặc API web của Thunderbit đảm nhận; Docling bắt đầu từ chính tệp bạn cung cấp.
Cài Docling nặng bao nhiêu, và lần chạy đầu tải xuống bao nhiêu?
Gói metapackage mặc định docling tạo ra một môi trường ảo khoảng 1,3 GB vì nó kéo cả ML stack đầy đủ vào dưới dạng phụ thuộc bắt buộc (riêng torch đã 536 MiB). Lần chuyển đổi PDF đầu tiên sẽ tải khoảng 506 MiB model layout và TableFormer xuống đĩa, cộng thêm khoảng 40 MB trọng số RapidOCR, và mất chừng 224 giây — gần như toàn bộ là thời gian tải. Lần chuyển đổi thứ hai chỉ khoảng 0,55 giây. Nếu bạn chỉ cần các format nhẹ, docling-slim (lõi ~50 MB) sẽ bỏ qua đường xử lý nặng.
Docling có OCR không, và dùng engine nào? Có. Trên một PDF scan không có text layer, OCR của Docling tự kích hoạt và khôi phục văn bản rất sạch trong bài test của tôi. Engine mặc định là RapidOCR, không phải EasyOCR — đây là nhầm lẫn rất phổ biến trong các bài viết cũ. EasyOCR hiện là phần bổ sung phải chủ động bật. OCR là đường xử lý chậm khi chạy ở quy mô lớn, đặc biệt trên CPU.
Tại sao Docling biến bảng của tôi thành ảnh hoặc bỏ mất nó?
Khả năng cao là do hiệu ứng trang thưa. Model bố cục RT-DETR của Docling dùng ngữ cảnh trang, nên một bảng nhỏ đứng một mình trên trang gần như trống có thể bị phân loại thành Picture rồi bị bỏ mà không báo lỗi. Cùng một bảng đó, nếu có thêm văn bản xung quanh, sẽ convert bình thường. Cách khắc phục là cung cấp thêm ngữ cảnh cho model bố cục, hoặc kiểm tra hậu xử lý doc.tables sau khi convert và đánh dấu bất kỳ trang nào có số lượng bằng 0.
Docling vs Firecrawl — nên dùng cái nào? Hai công việc khác nhau, nên thường không phải chọn một bỏ một. Firecrawl crawl web sống, render JavaScript và trích xuất nội dung chính. Docling chuyển đổi các tài liệu bạn đã có, với cấu trúc bảng PDF và OCR thật sự, hoàn toàn offline. Nếu nguồn của bạn là trang web, hãy dùng một công cụ web (Firecrawl, hoặc API/MCP/CLI của Thunderbit). Nếu là PDF, bản scan hoặc file Office, hãy dùng Docling. Hầu hết pipeline thực tế sẽ dùng cả hai.




