
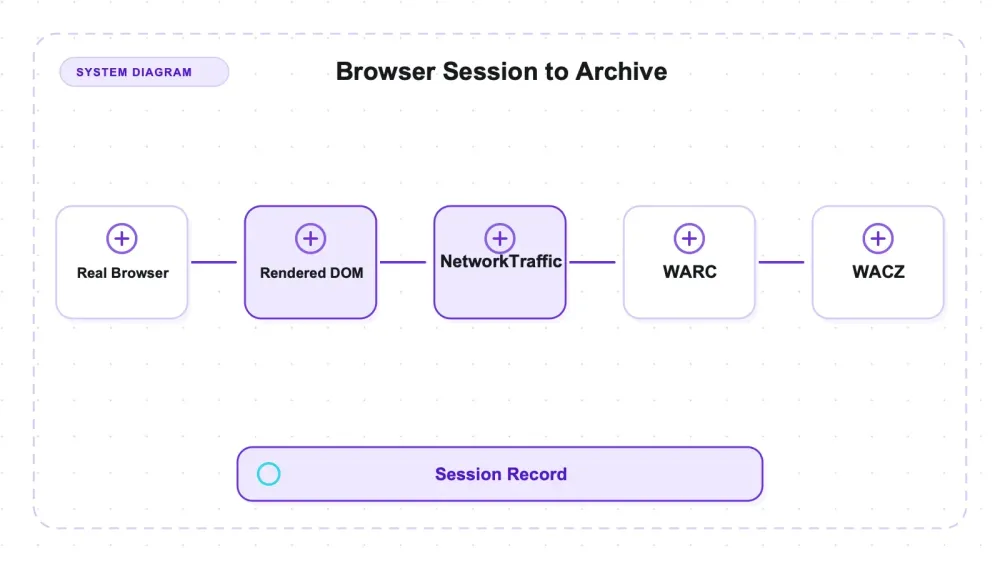
Browsertrix Crawler là công cụ lưu trữ web của Webrecorder: một image Docker duy nhất điều khiển một Chromium thật thông qua Puppeteer, ghi lại mọi thứ trình duyệt đã tải xuống, rồi lưu vào WARC — định dạng lưu trữ web tiêu chuẩn — và tùy chọn đóng gói thành gói WACZ kèm chỉ mục, danh sách trang và log. Mục đích cốt lõi của nó cũng chính là điểm làm nó khác với các công cụ scraping nhìn bề ngoài khá giống nhau. Scraper thì đi lấy dữ liệu rồi bỏ qua trang ngay khi đã có các trường cần thiết; còn archiver thì giữ lại nguyên cả phiên truy cập — byte, header, thứ tự dữ liệu đến — để trang vẫn có thể được mở lại rất lâu sau khi website đã đổi khác hoặc biến mất. Webrecorder đã duy trì lớp hạ tầng web này, gồm cả định dạng và hệ thống phát lại, từ rất lâu trước khi lưu trữ web trở thành một hạng mục sản phẩm, và các thư viện, tòa soạn báo, nhà nghiên cứu đều đang dùng nó.
Tôi đã chạy v1.14.0 trong Docker trên một bộ dữ liệu thử cục bộ gồm bốn lớp endpoint được cố ý tạo khác nhau, và đo ở cả hai phía của quá trình crawl: các bản ghi WARC cho nội dung lưu trữ và bộ đếm hit phía server cho các request thực sự. Điểm khác biệt hữu ích không chỉ đơn giản là tĩnh so với động. Browsertrix bắt được một link được tạo lúc runtime và một fetch() do trang phát ra, nhưng nó không hề request hai URL literal nằm bên trong một hàm JavaScript không bao giờ được gọi.
File app.js được lưu trữ đầy đủ, bao gồm cả hai đường dẫn literal, nhưng không endpoint nào tạo ra bản ghi response, bản ghi request hay hit trên server. Hàm chứa chúng chưa bao giờ chạy. Vì vậy, bài viết này đánh giá Browsertrix như một trình lưu trữ phiên trình duyệt, chứ không phải như một công cụ lập danh sách mọi URL được nhắc đến trong mã nguồn.
Browsertrix Crawler thực chất là gì
Rất nhiều người tìm đến với kỳ vọng đó là một scraper rồi ra về trong thất vọng. Trong pipeline mặc định, không có gì sẽ xuất ra cho bạn một file CSV chứa giá sản phẩm, và mong chờ điều đó cũng giống như mong camera hành trình tự viết báo cáo giao thông. Kết quả đầu ra là bản ghi có thể phát lại của một phiên duyệt web, và mọi quyết định thiết kế phía sau đều xuất phát từ đó.
Tôi đã thử v1.14.0 vào ngày 27/07/2026: webrecorder/browsertrix-crawler:latest với digest sha256:9d6800a8…, và crawl --version xác nhận bản build. Dự án dùng giấy phép AGPL-3.0. Mọi phép đo đều chạy trong Docker thông qua Colima trên macOS arm64, đối chiếu với bộ dữ liệu local được kiểm soát; bộ đếm phía server cung cấp bằng chứng độc lập với log Browsertrix và việc phân tích archive.
AGPL-3.0 xứng đáng được nhắc riêng. Đây là copyleft mạnh kèm điều khoản về sử dụng qua mạng. Nếu Browsertrix Crawler sẽ nằm trong một sản phẩm thương mại thay vì chỉ chạy như một công cụ độc lập, hãy để ai đó đọc kỹ giấy phép trước khi phát hành. Đây là lời cảnh báo, không phải tư vấn pháp lý.
Archive lưu phiên làm việc, không lưu mã nguồn
Bộ dữ liệu thử của tôi phục vụ bốn loại endpoint, được tách riêng có chủ đích vì một archiver sẽ xử lý chúng rất khác nhau:
- Lớp A — thẻ
<a href>thuần trong HTML. Bốn trang cộng một chuỗi độ sâu ba cấp. Bất kỳ crawler nào cũng tìm ra chúng. - Lớp B — URL literal nằm trong một hàm không bao giờ chạy. Hai đường dẫn,
/api/js-endpoint-7và/api/js-endpoint-8, tồn tại dưới dạng chuỗi trongloadData()không được gọi trong fileapp.jsđược liên kết. - Lớp C — link được dựng lên lúc runtime. Một thẻ
<a href>được ghép từ các mảnh trong JavaScript ('endpoint' + (6 * 7)) rồi chèn vào DOM. Đường dẫn liền mạch/runtime-only/endpoint42không xuất hiện trong bất kỳ byte nào được phục vụ. - Lớp D — một
fetch()mà trang thực sự gửi đi. Đường dẫn cũng được ghép theo cách tương tự ('runtime-xhr-' + (33 * 3)), rồi thật sự được request khi tải trang.
Với lớp C và D, các đường dẫn hoàn chỉnh không xuất hiện dưới dạng chuỗi liền mạch trong các file được phục vụ. Các hit phía server và bản ghi response của chúng là bằng chứng rằng việc dựng ở runtime và các luồng request đó đã thực sự diễn ra trong bộ dữ liệu thử này.
Cái gì được ghi lại, và cái gì không
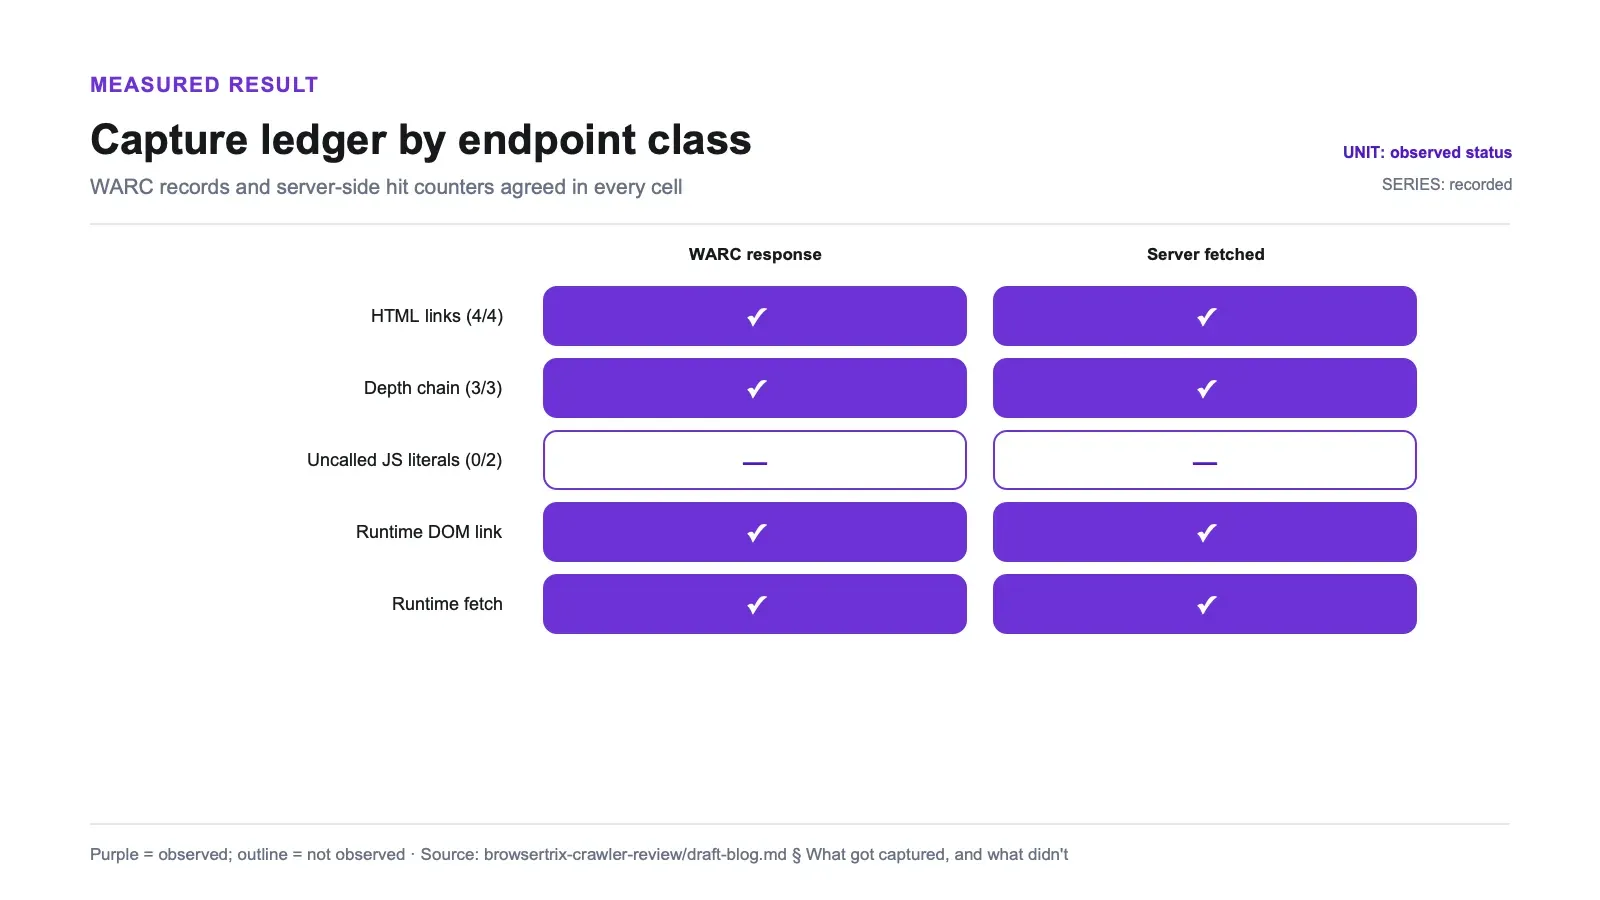
Hai công cụ đo, được đối chiếu với nhau ở mọi ô: bản ghi response WARC (nằm trong archive) và bộ đếm hit phía server của bộ dữ liệu thử gắn với (Host header, path) (những gì thực sự được request). Chúng khớp nhau ở mọi nơi.
| Lớp endpoint | Bản ghi response trong WARC | Thực sự được fetch (phía server) | Kết luận |
|---|---|---|---|
A — HTML <a href> | 4/4 | 4/4 | đã bắt được |
| A — chuỗi độ sâu (3 mức) | 3/3 | 3/3 | đã bắt được |
| B — URL literal trong JS không chạy | 0/2 | 0/2 | không bắt được |
| C — link chèn lúc runtime | có | có | đã bắt được |
D — fetch() lúc runtime | có | có | đã bắt được |
Lớp C là phần phân biệt một trình duyệt thật với một crawl tĩnh. Cơ chế trích xuất link mặc định đọc DOM đã render (a[href]->href, theo tài liệu common options), nên một link chỉ xuất hiện sau khi JavaScript chạy vẫn sẽ được đưa vào hàng đợi, được fetch và được lưu trữ. Lớp D đi vào vì lý do khác — chính trang đã phát ra request, và archiver đang nằm trên đường đi của network để ghi lại mọi thứ đi qua.
Có một ranh giới cần nói rõ với lớp C: link của tôi được chèn đồng bộ ngay khi tải trang. Những link xuất hiện muộn hơn, trong quá trình behaviors của Browsertrix, là một trường hợp khác, và đã có issue mở cho đúng tình huống này — #723, "Links on pages that are discovered during behaviors are not extracted". Tôi không kiểm tra kịch bản đó, nên cũng không khẳng định gì về nó.
File đã được lưu, còn endpoint thì không
Việc xác nhận lớp B bị bỏ sót cần rà từng record trong WARC chứ không thể chỉ nhìn tổng số.
app.js có trong archive — một response record, body JavaScript 222 byte — và cả hai literal của lớp B đều xuất hiện nguyên văn trong đó. Trong khi đó, cả /api/js-endpoint-7 lẫn /api/js-endpoint-8 đều không phải target URI của bất kỳ record nào trong toàn bộ file: không có response record nào, không có request record nào. Mỗi chuỗi literal chỉ xuất hiện đúng một lần trong toàn bộ archive, và cả hai lần đều nằm trong body được lưu của app.js.
Như vậy loại trừ được giải thích quá đơn giản kiểu “app.js chưa từng được fetch”. Archiver đã lưu file có tham chiếu đến các endpoint đó nhưng không bao giờ phát request tới chúng, vì loadData() không được gọi. Các behaviors mặc định của Browsertrix đều đang bật — autoplay, autofetch, autoscroll, siteSpecific — nhưng autofetch cũng không cứu được chúng, điều này hợp lý nếu đọc kỹ autofetch làm gì: nó nhắm vào img srcset, stylesheet và URL trong data-*, chứ không phải các string literal nằm sâu trong thân hàm.
Để so sánh minh họa trên cùng bộ dữ liệu, tôi cũng chạy Katana v1.6.1 với katana -u <seed> -jc -silent -nc -d 4. Tóm tắt discovery thô của nó cho kết quả ngược lại trên hai lớp JavaScript được dựng có chủ đích này:
| Bạn muốn tìm | Browsertrix v1.14.0 | Katana v1.6.1, -jc tiêu chuẩn |
|---|---|---|
| Link trong HTML đã phục vụ | tìm thấy | tìm thấy |
| Link được chèn vào DOM lúc runtime | tìm thấy (trích xuất từ DOM đã render) | bỏ sót nếu không dùng chế độ headless |
fetch() mà trang thực sự gửi | tìm thấy (ghi nhận như traffic) | bỏ sót — không có gì được thực thi |
| URL literal trong JS nhưng không bao giờ chạy | bỏ sót (0/2) | tìm thấy (2/2 trên cùng bộ dữ liệu này) |
| File JS chứa literal đó | được lưu đầy đủ | được phân tích, nhưng không được giữ lại |
Cả hai lệnh đều dùng cùng bộ dữ liệu và tên endpoint. Bảng này không phải bảng xếp hạng chung giữa browser crawler và static crawler; nó cho thấy vì sao việc lập danh sách endpoint và việc giữ lại phiên làm việc cần các bài kiểm tra độ phủ khác nhau.
“Trình duyệt thật nên nó sẽ bắt được mọi thứ JavaScript làm” là câu bạn sẽ thấy lặp lại trong nhiều bài viết. Nhưng như vậy là nói quá. Nó chỉ bắt được traffic đã được thực thi. Mã chỉ nhắc đến một URL mà không hề gọi nó thì sẽ không tạo ra traffic, và không có traffic thì không có bản ghi.
Body để phát lại có ở đó, nhưng có một điều tôi chưa kiểm tra
Với hai endpoint được tạo ở runtime, tôi trích body phản hồi HTTP đã lưu trong WARC ra và xác nhận chúng chứa JSON do server trả về: 206 byte cho target của link được chèn ở runtime, 201 byte cho target của fetch() runtime. Vì vậy, chúng không phải các stub chỉ mục dẫn đến khoảng trống — chính nội dung đã nằm trong archive, tức điều kiện tiên quyết để hệ thống phát lại có thể phục vụ chúng.
Điều tôi chưa làm là dựng pywb hoặc replayweb.page rồi render archive. Có body trong archive và việc phát lại render đúng là hai khẳng định khác nhau, và thử nghiệm này chỉ bao phủ khẳng định đầu tiên. Hành vi replay, kiểm soát tính xác thực, chuỗi bàn giao chứng cứ và khả năng chấp nhận làm bằng chứng đều cần được xác minh riêng.
Một capture sản xuất cần bài kiểm tra chấp nhận rộng hơn
Bộ dữ liệu thử này trả lời gọn một câu hỏi hẹp: một link runtime đồng bộ và một request do trang phát ra có trở thành traffic mạng và record trong archive không? Một job lưu trữ production thường có nhiều cách khác để thất bại dù vẫn tạo ra một WACZ hợp lệ.
Hãy bắt đầu bằng replay. Mở gói trong hệ thống replay mà bộ sưu tập sẽ thực sự dùng và so sánh một tập trang cố định với bản tham chiếu tại thời điểm capture. Kiểm tra text render, hình ảnh, style, điều hướng và mọi tương tác quan trọng đối với hồ sơ lưu trữ. Sau đó mở network panel của trình duyệt replay để tìm subresource bị thiếu. Một response body có thể tồn tại trong WARC nhưng replay vẫn lỗi vì rewrite, index, timing, origin hoặc phụ thuộc không khớp. Bài review này không vượt qua ranh giới đó.
Hành vi động cần bộ dữ liệu thử riêng. Link lớp C ở đây xuất hiện đồng bộ khi trang tải. Ứng dụng thực tế có thể lộ nội dung sau timer, cuộn trang, đóng popup đồng ý, đổi route, custom elements hoặc chuỗi API dài. Hãy đặt một target đã biết phía sau mỗi hành vi bạn phụ thuộc và xác minh cả hit phía server lẫn body đã lưu. Các behaviors mặc định của Browsertrix là input hữu ích cho bài kiểm tra đó, chứ không phải bằng chứng rằng mọi trạng thái trễ đều đã được chạm tới. Issue #723 đặc biệt liên quan nếu link xuất hiện trong behaviors chứ không phải trong lần thực thi trang ban đầu.
Các capture có xác thực sẽ kéo theo câu hỏi về phiên đăng nhập. Hãy xác nhận trạng thái đăng nhập đã đi vào profile trình duyệt, tồn tại qua các lần điều hướng cần thiết, và không bị rò sang các bộ sưu tập cần cô lập. Kiểm tra các luồng refresh token và logout. Nếu archive chứa dữ liệu riêng tư hoặc cá nhân, hãy kiểm tra quyền truy cập và chính sách lưu giữ của các file kết quả như một phần của cùng kế hoạch chấp nhận. Một capture hoàn chỉnh về mặt kỹ thuật vẫn có thể bị xử lý sai sau khi thu thập.
Service worker, streaming media, WebSocket, file tải xuống, iframe cross-origin và signed URL đều nên có một trang đại diện nếu chúng quan trọng với mục tiêu. Bộ dữ liệu thử 11 trang này không nói gì về chúng. Nó cũng không chứng minh crawler sẽ hoạt động thế nào khi một trang còn hoạt động trong nhiều phút, phát request sau cửa sổ chờ thông thường, hoặc cần thao tác người dùng. Đừng biến “real Chromium” thành một tuyên bố bao phủ mọi thứ; hãy xác định rõ các hành vi trình duyệt mà bộ sưu tập cần giữ lại và làm cho từng hành vi đó quan sát được.
Cuối cùng, hãy lưu lại bằng chứng cần thiết để chẩn đoán các lần bỏ sót. Lưu đúng image digest và lệnh đã chạy, log Browsertrix, page list, index, checksum WARC/WACZ, bằng chứng request phía server nếu có, và một manifest ground truth nhỏ. Với các lần capture lặp lại, ghi thời gian, cấu hình và môi trường cùng với artifact. Các bản ghi đó không làm phát sinh giá trị pháp lý, nhưng chúng giúp một tuyên bố kỹ thuật có thể tái hiện và chỉ ra sự khác biệt về sau đến từ target, crawler hay replay stack.
Bộ dữ liệu thân nhỏ này tốn bao nhiêu byte
Bộ dữ liệu này chỉ phục vụ vài trăm byte mỗi trang, nên tỷ lệ overhead của nó không nên áp vào các website nặng tài nguyên. Trong phạm vi hẹp đó, tôi đo cấu phần của archive thay vì chỉ đo kích thước cuối cùng:
| Loại WARC record | Số lượng | Content bytes | Tỷ lệ |
|---|---|---|---|
request | 14 | 6,912 | 40.6% |
response (payload trang thực tế) | 13 | 5,339 | 31.4% |
resource (JSON urn:pageinfo:, mỗi trang một bản) | 11 | 4,527 | 26.6% |
revisit (link chết đã được khử trùng lặp) | 1 | 154 | 0.9% |
warcinfo | 1 | 92 | 0.5% |
| Tổng content của record | 40 | 17,024 | 100% |
Phần đếm theo từng loại và tổng byte có trong công khai capture-summary.json; tỷ lệ dùng tổng content 17,024 byte làm mẫu số.
Trong lần chạy nhỏ này, các request record nặng hơn content response, và tổng byte của request cộng urn:pageinfo: xấp xỉ 2.1× payload response. Điều đó mô tả thành phần record của bộ dữ liệu này, không phải một tỷ lệ WARC chung.
Trên đĩa, qua ba lần chạy tách biệt:
| Chỉ số | nhỏ nhất | trung vị | lớn nhất |
|---|---|---|---|
| Thời gian crawl thực tế (s) | 28.22 | 29.75 | 30.27 |
| WARC.gz bytes | 24,174 | 24,250 | 24,262 |
| WACZ bytes | 53,446 | 53,523 | 53,533 |
| Captured response payload (bytes) | 5,339 | 5,339 | 5,339 |
Lấy trung vị, ta có bốn tỷ lệ như sau:
| Thước đo suy ra (trung vị) | Giá trị |
|---|---|
| WARC nén so với captured response payload | 4.5× |
| WACZ so với captured response payload | 10× |
| WARC mỗi trang | ~2.2 KB |
| WACZ mỗi trang | ~4.9 KB |
Và bên trong chính WACZ:
| Thành phần WACZ | Tỷ lệ trong gói |
|---|---|
| WARC | 45% |
| CDX index | 16% |
| Crawl log | 30% |
Hàng cuối cùng là phần khiến tôi bất ngờ nhất. Gần một phần ba gói archive, trong một lần crawl nhỏ, là bản ghi về chính quá trình crawl chứ không phải về web.
Phép đo khá ổn định: payload response trả về y hệt nhau trong cả ba lần chạy (lần nào cũng 5,339 B), còn WARC.gz và WACZ chỉ dao động dưới 0.4%.
Các tỷ lệ này không áp dụng cho những trang thật có hình ảnh, font và các bundle script lớn. Nhưng điểm cấu trúc thì vẫn đúng: request record và page-info record tạo overhead độc lập với kích thước payload. Hãy đo trên một mẫu đại diện trước khi lên kế hoạch lưu trữ production; đừng lấy tỷ lệ 10× của bộ dữ liệu thử rồi nhân với ước lượng toàn bộ corpus.
Cài đặt, và dung lượng đĩa bạn nên chuẩn bị
Khi Docker hoặc Colima đã cài và chạy, bước thiết lập riêng cho Browsertrix là docker pull webrecorder/browsertrix-crawler:latest, sau đó docker run … crawl --url … --generateWACZ. Image đã chứa sẵn Chromium, nên không cần browser riêng hay môi trường Python riêng.
Sự tiện lợi đó tốn gì, theo các lần chạy đã đo ở đây:
| Bạn cần ngân sách cho | Đo được |
|---|---|
| Tải image | ~1 GB |
| Image giải nén trên đĩa | 3.51 GB |
Cây thư mục crawls/ (WARC, WACZ, dữ liệu profile browser) sau vài lần chạy 11 trang trên bộ dữ liệu chỉ phục vụ vài KB nội dung | ~116 MB |
| Thời gian thực tế, crawl bộ dữ liệu 11 trang | 28–30 s |
Container là nơi phát sinh ma sát, và dòng tải xuống rồi giải nén đó chính là cái giá của việc đóng gói sẵn một browser. Tôi chạy với --shm-size 1g, và vì bộ dữ liệu của tôi nằm trên host còn crawl chạy trong container, tôi cần --add-host=host.docker.internal:host-gateway và fixture phải bind vào 0.0.0.0 thay vì loopback. Nếu bạn crawl internet công khai thì có thể bỏ qua bước mạng đó hoàn toàn, nhưng nếu bạn đang lưu trữ thứ gì đó trên máy mình hoặc trên một host staging nội bộ, hãy dành hẳn một buổi chiều cho nó.
Thư mục đầu ra là phần dễ bị đánh giá thấp nhất. Hãy ngoại suy mức tăng đó sang một crawl thật và lên kế hoạch lưu trữ trước khi bắt đầu, thay vì đợi đến 3 giờ sáng khi ổ đĩa đã đầy.
Có lẽ việc khởi động browser góp phần đáng kể vào một crawl 28–30 giây chỉ với 11 trang, nhưng tôi chưa tách riêng thời gian khởi động khỏi thời gian điều hướng hay đóng gói. Vì vậy, không thể rút ra kết luận nào về thông lượng mỗi trang từ lần chạy này.
Lập kế hoạch lưu trữ mà không lạm dụng tỷ lệ của bộ dữ liệu thử
Cách hữu ích để ước lượng dung lượng cho một bộ sưu tập là làm theo dữ liệu thực tế. Hãy chọn các trang đại diện cho phân bố thật của mục tiêu: lớp ứng dụng mỏng, landing page nhiều hình, tài liệu tải về, bài viết dài, và các trang đã xác thực nếu chúng nằm trong phạm vi. Capture từng lớp với behaviors và thiết lập đóng gói dự kiến. Đo payload response, WARC, WACZ, index, log, phần dư của browser profile và mọi workspace tạm thời còn lại trong lúc chạy. Mức sử dụng đĩa đỉnh còn quan trọng ngang với bundle cuối cùng nếu khâu đóng gói giữ nhiều bản sao trong chốc lát.
Tách riêng thành phần cố định và biến đổi. Container image 3.51 GB là overhead triển khai có thể dùng chung cho nhiều lần capture trên một worker. Request record, page-info record, index và page list tăng theo hoạt động crawl. Body phản hồi phụ thuộc rất mạnh vào target, còn log phụ thuộc vào thời lượng và mức verbosity. Retention và replication sau đó nhân bản bộ sưu tập cuối cùng một cách độc lập với hành vi crawl. Một mô hình năng lực gộp tất cả thành “byte mỗi trang” sẽ rất dễ vỡ.
Compression và deduplication cũng cần nội dung đại diện. Payload response của bộ dữ liệu này giống hệt nhau ở cả ba lần chạy, nhưng điều đó không mô tả các trang có quảng cáo thay đổi, timestamp, phản hồi cá nhân hóa hoặc asset URL thay đổi để tránh cache. Nếu các lần capture lặp lại là một phần của chương trình, hãy đo các lần capture liên tiếp cùng trang và xem revisit record thay vì tự mặc định rằng các trang nhìn như không đổi sẽ dedup tốt. Tương tự, hãy kiểm tra xem log và index có được lưu ở cùng mức replication với preservation payload hay không.
Về mặt vận hành, hãy đặt ngưỡng cảnh báo trước khi bắt đầu collection. Theo dõi dung lượng trống, mức tăng theo từng collection, lỗi đóng gói, và kích thước browser profile hoặc thư mục tạm. Chạy một bài phục hồi từ WACZ đã lưu, không chỉ làm mỗi bước checksum. Các tỷ lệ phía trên hữu ích vì chúng cho thấy những thành phần nào đang tồn tại; mẫu đại diện mới cho bạn biết chúng sẽ lớn đến mức nào đối với site của bạn.
Ghi lại các giả định đó bên cạnh ước lượng dung lượng và xem lại sau pilot crawl.
Kỷ luật về phạm vi, được kiểm tra bằng hai control
Các crawler lưu trữ mà đi lạc phạm vi là rủi ro vận hành có thật — bạn có thể vừa gặp vấn đề pháp lý vừa phải trả hóa đơn lưu trữ cùng lúc. Trang chủ của tôi liên kết đến http://outofscope.test:<port>/page/out, một hostname khác trỏ vào cùng bộ dữ liệu, nên nếu có hit mang Host header đó thì đó chính là bằng chứng của một lần fetch ngoài phạm vi mà không hề chạm tới internet thật.
| Cấu hình | Có fetch host ngoài phạm vi không? | Hit phía server |
|---|---|---|
--scopeType prefix (mặc định) | không | 0 |
--scopeType any | có | 2 |
Hàng thứ hai mới làm cho hàng đầu tiên trở nên có ý nghĩa. Với any, link đã được truy cập hai lần, vậy là nó thực sự reachable — con số 0 ở scope prefix mặc định là kỷ luật phạm vi thật, không phải crawler bỏ sót link. Có một báo cáo mở về các lần truy cập ngoài phạm vi trong cấu hình khác, #788, mà tôi không tái tạo được dưới scope prefix mặc định trên bộ dữ liệu này. Nên biết là nó tồn tại; nhưng tôi không thể nói rằng mình đã thấy nó.
Độ bền bỉ thì tốt theo kiểu rất bình thường. Một route trả HTTP 500 và một link chết đều được request, crawl kết thúc sạch sẽ với WARC và WACZ hợp lệ, còn link chết được lưu dưới dạng record revisit đã khử trùng lặp thay vì làm hỏng mọi thứ.
Ưu và nhược điểm
Ưu điểm
- Bắt được link DOM được chèn lúc runtime và các lệnh
fetch()do trang phát ra — đều được xác nhận cả trong archive lẫn phía server, trên những đường dẫn không hề tồn tại dưới dạng literal ở đâu cả. - HTML tĩnh và duyệt theo chiều sâu đều hoàn chỉnh: 4/4 link, chuỗi độ sâu 3/3, không bỏ sót.
- Khi Docker/Colima đã chạy, chỉ một lệnh
docker runlà tạo ra WARC và WACZ; Chromium đã nằm sẵn trong image. - Scope
prefixmặc định giữ đúng, không có fetch ngoài phạm vi;anymở rộng đúng như tài liệu, nên nút này hoạt động đúng như mô tả. - Đầu ra là một archive theo chuẩn (WARC, đóng gói thành WACZ kèm CDX index và page list) thay vì một blob độc quyền.
- Archive gần như có tính xác định: payload giống hệt nhau qua ba lần chạy, kích thước trên đĩa dao động dưới 0.4%.
- Hành vi lỗi sạch sẽ: route 500 và link hỏng không làm crawl dừng.
Nhược điểm
- URL literal trong JavaScript không được thực thi thì đơn giản là không được phát hiện (0/2), dù file chứa chúng vẫn được lưu. Đúng theo thiết kế, nhưng vẫn là một lỗ hổng coverage thực sự nếu mục tiêu của bạn là khám phá endpoint.
- Dấu chân rất nặng: kéo về khoảng 1 GB, chiếm 3.51 GB trên đĩa, và output directory phình nhanh.
- Overhead theo byte khá lớn trên các trang nhỏ — request cộng pageinfo còn nhiều hơn payload thực, và khoảng 30% của WACZ là crawl log.
- AGPL-3.0 đồng nghĩa với phần việc tuân thủ nghiêm túc nếu muốn nhúng vào sản phẩm thương mại.
- Không phải công cụ dữ liệu có cấu trúc. Không có schema, không có mapping field, không có hàng dữ liệu sạch ở cuối.
- Thông lượng mỗi trang ở mức vừa phải theo thiết kế, vì mọi trang đều đi qua một browser thật.
Ai nên dùng, và ai không nên dùng
Browsertrix phù hợp với các đội mà artifact họ cần là archive của các tài nguyên được browser tải về, chứ không phải các dòng dữ liệu đã trích xuất. Trong bộ dữ liệu thử này, các response body được fetch lúc runtime đều có trong WARC và được đóng gói vào WACZ. Các thư viện, tòa soạn báo và nhà nghiên cứu là những nhóm người dùng hợp lý, nhưng khi triển khai production thì vẫn cần test riêng replay render, xác thực, service worker, luồng đồng ý, hành vi trễ, asset streaming, kiểm soát lưu giữ và mọi yêu cầu xử lý chứng cứ.
Đừng dùng nó nếu thứ bạn thực sự cần là dữ liệu. Nếu mục tiêu là “lấy cho tôi mọi sản phẩm và giá từ 400 trang này thành một bảng tính”, thì một archiver là con đường rất vòng vo — bạn sẽ archive hàng gigabyte rồi vẫn phải viết code trích xuất trên các file WARC. Cũng nên bỏ qua nó nếu bạn đang map bề mặt API của một ứng dụng, vì kết quả lớp B cho thấy rất rõ rằng một static JavaScript parser sẽ tìm ra các endpoint mà Browsertrix không bao giờ chạm tới. Và nếu bạn ngại Docker hoặc đang ở nơi mà image 3.5 GB là vấn đề, đây không phải công cụ sẽ linh hoạt theo bạn.
Ủy quyền và lưu giữ
Kiểm soát phạm vi không phải là ủy quyền. Hãy xác định trước các host được phép, thời hạn lưu giữ và quyền truy cập archive trước khi crawl, nhất là khi các capture bền vững có thể chứa dữ liệu cá nhân. Thử nghiệm prefix/any cho thấy thay đổi cấu hình sẽ đổi phạm vi mạng; nó không xác định phạm vi nào là hợp pháp cho một bộ sưu tập cụ thể.
Bài review liên quan: khía cạnh pháp lý của web scraping và lưu trữ web.
Các lựa chọn thay thế theo loại đầu ra cần có
Hãy chọn theo artifact. Browsertrix nhắm tới bảo tồn trong WARC/WACZ. Một thư viện tự động hóa browser như Playwright cung cấp một page có thể lập trình, nhưng phần đóng gói capture là do bạn tự lo. Các crawler khám phá endpoint sẽ liệt kê URL, còn các công cụ trích xuất sẽ trả về văn bản hoặc bản ghi có cấu trúc. Những nhóm này có thể dùng chung một browser mà vẫn giải quyết những bài toán khác nhau.
Bài review liên quan: đánh giá Heritrix.
Công bố: Thunderbit là sản phẩm của đơn vị xuất bản và không được thử trong bộ dữ liệu Browsertrix này. Nó thuộc nhóm trích xuất được quản lý, tạo ra text trang hoặc dữ liệu có cấu trúc thay vì một archive theo chuẩn. Bài review này chỉ hỗ trợ ranh giới về đầu ra, không phải một tuyên bố so sánh hiệu năng hay năng lực.
Dùng thử Thunderbit để trích xuất dữ liệu web
Kết luận
Hãy dùng Browsertrix Crawler khi đầu ra cần có là một capture WARC/WACZ và một Chromium được container hóa phù hợp với môi trường triển khai. Trên bộ dữ liệu thử này, các record archive và hit phía server khớp nhau với link runtime trong DOM đồng bộ và với request do trang phát ra, scope prefix mặc định chặn host thứ hai, và các route lỗi không ngăn được archive hợp lệ.
Trước khi dùng trong production, hãy xác minh replay, hành vi trễ, session đã xác thực, service worker, cấu trúc lưu trữ trên các trang đại diện và nghĩa vụ giấy phép. Phạm vi đã kiểm tra hẹp hơn thế: các tham chiếu mã không bao giờ được thực thi thì không tạo ra request cũng như không có record archive cho target của chúng, dù script chứa chúng vẫn được giữ lại.
Dùng thử Thunderbit để trích xuất dữ liệu web Get Started Free
Câu hỏi thường gặp
WARC và WACZ khác nhau thế nào trong trường hợp này? WARC chứa request, response và các record liên quan đã được capture. WACZ đóng gói WARC cùng index, page list, metadata và log để phục vụ phân phối và công cụ replay. Bài review này đã xem xét cả hai gói nhưng không render replay.
Nên ước lượng dung lượng thế nào? Hãy đo các trang đại diện và giữ nguyên toàn bộ thành phần của WACZ, gồm cả log và index, trong mẫu. Các tỷ lệ trong bài viết này đến từ những response body rất nhỏ bất thường, nên không phù hợp để nhân với số lượng URL của production.
Nó có đi lạc khỏi site tôi chỉ định không?
Trong thử nghiệm của tôi thì không, ở thiết lập mặc định. Với --scopeType prefix, một link đến hostname khác bị fetch 0 lần; chuyển sang --scopeType any thì nó bị fetch 2 lần, chứng minh rằng link đó reachable và con số 0 ở mặc định là kỷ luật phạm vi thật. Có một báo cáo upstream mở về các lần truy cập ngoài phạm vi trong cấu hình khác mà tôi không tái tạo được dưới mặc định, nên hãy tự kiểm tra scope của bạn thay vì đoán.
Trước khi khẳng định replay fidelity thì phải test gì? Hãy tải WACZ vào hệ thống replay dự kiến và so sánh các trang render, tương tác và subresource bắt buộc với bản live hoặc bản capture tham chiếu. Việc body có trong WARC là cần thiết nhưng tự nó không xác minh replay render đúng.
Browsertrix có biến một trang archive thành các dòng dữ liệu có cấu trúc không? Không. Đầu ra của nó là một gói archive, không phải bảng các trường được chọn lọc. Nếu deliverable là sản phẩm, giá, liên hệ hay một schema khác, bạn vẫn cần một bước trích xuất sau khi capture — hoặc một công cụ khác mà đầu ra chính là dữ liệu có cấu trúc.




