
Lưu lượng truy cập tự động hiện nay đã chiếm 53% toàn bộ web, vượt cả người dùng thật, trong khi các hệ thống chống bot cũng ngày càng siết chặt hơn.
Tôi đã thấy tận mắt chỉ một sai sót nhỏ — như dùng sai user agent — cũng đủ biến dự án dữ liệu của bạn thành một bức tường toàn lỗi 403. Với các team sales, ecommerce và vận hành, bị chặn đồng nghĩa với mất lead, giá cả lỗi thời hoặc thất thu.
Dưới đây là những gì tôi đúc rút về user agent khi scraping — từ các thực hành cốt lõi, lỗi hay gặp, cho đến cách những công cụ như Thunderbit tự động xử lý tất cả chuyện này.

Vì sao chọn user agent tốt nhất cho scraping lại quan trọng
Bắt đầu từ điều cơ bản: user agent là gì? Bạn có thể hiểu nó như “thẻ căn cước” của trình duyệt. Mỗi lần bạn vào một website — dù là người hay bot — trình duyệt đều gửi chuỗi User-Agent trong phần header của request. Nó giống một lời giới thiệu ngắn gọn: “Xin chào, tôi là Chrome trên Windows” hoặc “Tôi là Safari trên iPhone” (ScraperAPI). Đây là ví dụ user agent điển hình của Chrome:
Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36
Website dùng thông tin này vì hai lý do lớn:
- Phục vụ đúng nội dung (ví dụ giao diện mobile hay desktop).
- Nhận diện bot và scraper.
Nếu user agent của bạn là “python-requests/2.28.1” hay “Scrapy/2.9.0”, chẳng khác nào bạn tự đeo bảng “Xin chào, tôi là bot!”. Các website thường có sẵn danh sách chặn những định danh lộ liễu kiểu này, và chúng sẽ đóng cửa với bạn nhanh hơn cả khi bạn kịp nói “403 Forbidden.” Ngược lại, dùng user agent của một trình duyệt phổ biến và mới nhất sẽ giúp bạn hòa vào dòng truy cập bình thường.
Nói ngắn gọn: user agent chính là lớp ngụy trang của bạn. Ngụy trang càng khéo, cơ hội lấy được dữ liệu càng cao.
Vai trò của user agent trong thành công của web scraping
Vì sao việc chọn user agent lại có ảnh hưởng lớn đến vậy? Vì đây là tuyến phòng thủ đầu tiên của hầu hết hệ thống chống bot. Nếu chọn sai, những rủi ro sau rất dễ xảy ra:
- Bị chặn ngay lập tức (lỗi 403/429): Dùng UA mặc định của thư viện scraping, bạn có thể bị chặn trước cả khi nhìn thấy trang chủ (Webmasters StackExchange).
- Dữ liệu rỗng hoặc giả: Một số website sẽ trả về trang trắng hoặc trang “mồi” cho user agent đáng ngờ.
- CAPTCHA hoặc chuyển hướng: UA trông giống bot có thể kích hoạt các câu hỏi “Bạn có phải là con người không?” hoặc vòng lặp đăng nhập vô tận.
- Giới hạn tốc độ và khóa truy cập: Nếu liên tục gửi cùng một UA đến website, bạn có thể bị throttling hoặc khóa IP.
Hãy xem các user agent khác nhau thường dẫn đến kết quả gì:
| Chuỗi User Agent | Kết quả trên hầu hết website (2026) |
|---|---|
python-requests/2.28.1 | Bị chặn ngay, bị gắn cờ là bot |
Scrapy/2.9.0 (+https://scrapy.org) | Bị chặn hoặc bị trả về nội dung giả |
Mozilla/5.0 (Windows NT 10.0; Win64; x64)... | Được xem như người dùng thật, cho phép truy cập |
AhrefsBot/7.0 (+http://ahrefs.com/robot/) | Bị chặn, là crawler đã quá quen thuộc |
| UA trống hoặc vô nghĩa | Đôi khi được phép, nhưng thường đáng ngờ |
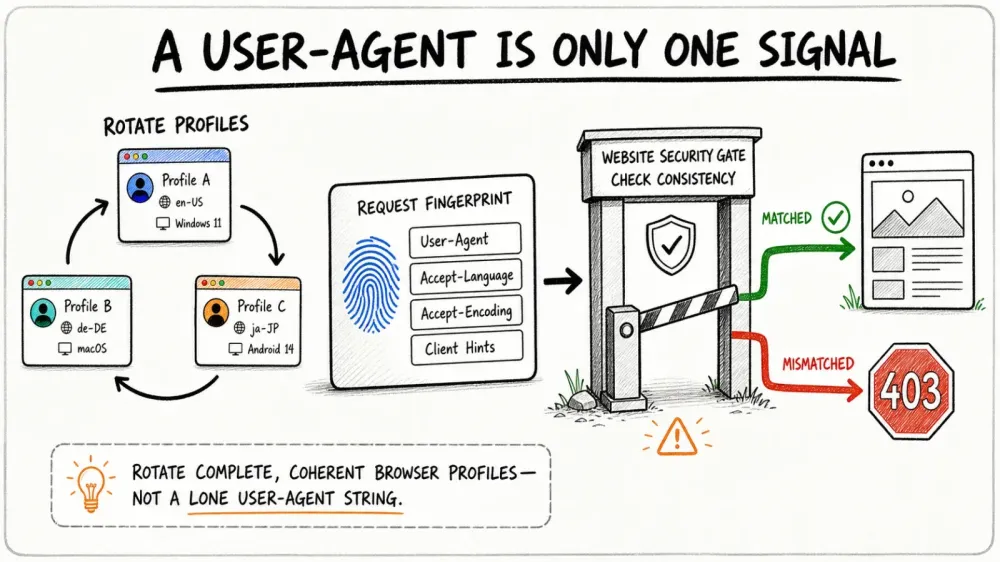
Bài học ở đây là: hãy chọn lớp ngụy trang một cách khôn ngoan. Và đừng quên — các hệ thống chống bot hiện đại không chỉ nhìn vào user agent. Chúng còn kiểm tra xem các header khác của request (như Accept-Language hoặc Referer) có khớp hay không. Nếu bạn tự nhận là Chrome nhưng lại không gửi đúng header, bạn vẫn sẽ bị phát hiện (ScraperAPI).
Dùng AI để scrape dữ liệu từ bất kỳ website nào Web scraper agentic của Thunderbit tự xử lý việc render và cấu trúc trang, nên bạn không cần tự quản lý user agent. Get Started Free
Đây là lúc Thunderbit phát huy tác dụng. Tôi đã nói chuyện với rất nhiều người dùng doanh nghiệp — nhân viên sales, quản lý ecommerce, đại lý bất động sản — họ chỉ muốn dữ liệu, chứ không muốn học cả một khóa về HTTP header. Vì vậy, chúng tôi xây dựng Thunderbit để việc quản lý user agent trở nên vô hình và tự động.
Thunderbit: Đơn giản hóa việc quản lý user agent cho mọi người
Với tính năng scraping một cú nhấp của Thunderbit, bạn không cần phải tự chọn user agent nữa. Bộ máy AI của chúng tôi sẽ lo phần đó, chọn dấu vân tay trình duyệt thực tế và mới nhất cho từng website. Dù bạn dùng Thunderbit Chrome Extension (thực sự dùng UA của Chrome) hay scraping trên cloud (AI của chúng tôi luân phiên qua một nhóm UA trình duyệt hiện hành), bạn luôn hòa vào lưu lượng truy cập bình thường.
Không chỉ dừng ở user agent. Thunderbit còn gửi đầy đủ bộ header nhất quán — Accept-Language, Accept-Encoding, Client Hints, và nhiều thứ khác — để request của bạn nhìn và hoạt động như một trình duyệt thật. Không còn header lệch nhau, không còn cờ đỏ kiểu “bot”.
Điểm hay nhất? Bạn không cần cấu hình gì cả. AI của Thunderbit xử lý toàn bộ chi tiết kỹ thuật ở phía sau, để bạn tập trung vào điều quan trọng: lấy dữ liệu tin cậy, chất lượng cao.
Thử Thunderbit Agentic Web Scraper miễn phí Cài tiện ích Chrome miễn phí và trích xuất dữ liệu có cấu trúc từ bất kỳ trang nào chỉ với một cú nhấp, không cần giả mạo header. Get Started Free
Vì sao xoay vòng user agent động là thực hành tốt bắt buộc
Giả sử bạn đã tìm được user agent hoàn hảo. Vậy cứ dùng nó cho mọi request là xong? Chưa đâu. Trong năm 2026, lặp đi lặp lại cùng một UA là dấu hiệu quá rõ. Người dùng thật có trình duyệt, phiên bản và thiết bị khác nhau. Nếu scraper của bạn gọi website 500 lần liên tiếp bằng cùng một UA, nó giống như một đoàn diễu hành toàn anh em sinh đôi — chẳng ai bị đánh lừa cả.
Đó là lý do xoay vòng user agent động giờ đã thành tiêu chuẩn ngành. Ý tưởng rất đơn giản: luân phiên qua một danh sách UA thực tế, cập nhật cho từng request hoặc từng phiên. Như vậy scraper của bạn sẽ giống một nhóm người dùng đa dạng chứ không phải một script tự động duy nhất (Capsolver).
Cơ chế xoay vòng dựa trên AI của Thunderbit còn đi xa hơn nữa. Với các lần crawl nhiều trang hoặc tác vụ theo lịch, Thunderbit tự động đổi user agent và thậm chí ghép với các proxy IP khác nhau. Nếu website bắt đầu thấy bất thường, Thunderbit sẽ thích ứng theo thời gian thực — đổi UA, chỉnh header hoặc giảm tốc độ request khi cần. Mọi thứ diễn ra ở phía sau, nên quá trình scraping của bạn vẫn kín đáo và dữ liệu vẫn chảy đều.
User agent và request header: Sức mạnh của sự nhất quán
Mẹo chuyên nghiệp: user agent chỉ là một phần trong “dấu vân tay” của request. Hệ thống chống bot hiện đại sẽ kiểm tra UA có khớp với các header khác như Accept-Language, Accept-Encoding và Referer hay không. Nếu bạn nhận mình là Chrome trên Windows nhưng lại gửi Accept-Language tiếng Pháp từ một IP ở New York, đó là dấu hiệu đáng ngờ (ScraperAPI).
Thực hành tốt nhất:
- Luôn gửi đầy đủ bộ header khớp với user agent của bạn.
- Giữ Accept-Language và Accept-Encoding nhất quán với UA và, nếu có thể, với vị trí địa lý của IP.
- Dùng công cụ developer của trình duyệt để xem các request thật và sao chép trọn bộ header cho UA bạn chọn.
Thunderbit lo toàn bộ phần này cho bạn. AI của chúng tôi đảm bảo mọi request đều khớp hoàn hảo — user agent, header, và cả dấu vân tay trình duyệt. Bạn có được hồ sơ request giống người dùng thật mà không cần động tay.
Tránh các sai lầm phổ biến: Những điều KHÔNG nên làm với user agent
Tôi đã thấy nhiều dự án scraping thất bại vì những lý do giống nhau. Dưới đây là các sai lầm lớn nhất cần tránh:
- Dùng UA mặc định của thư viện scraping: Các chuỗi như
python-requests/2.x,Scrapy/2.9.0hoặcJava/1.8là tín hiệu chặn ngay lập tức. - Phiên bản trình duyệt lỗi thời: Tự nhận là Chrome 120 trong năm 2026? Rất đáng nghi — bản đó đã hơn hai năm tuổi. Luôn dùng UA từ kênh ổn định hiện tại (Chrome 147 tại thời điểm viết bài); một danh sách đã cũ 12 tháng cũng đủ lộ là bot.
- Header không khớp: Đừng gửi UA Chrome nhưng lại thiếu hoặc lệch Accept-Language, Accept-Encoding hay Client Hints.
- UA của crawler đã quá quen thuộc: Bất kỳ thứ gì có “bot,” “crawler,” “spider,” hoặc tên công cụ (như AhrefsBot) đều là cờ đỏ.
- UA trống hoặc vô nghĩa: Đôi khi vẫn được chấp nhận, nhưng thường đáng ngờ và không ổn định.
Checklist nhanh cho user agent an toàn:
- Dùng UA trình duyệt thật và mới nhất (Chrome, Firefox, Safari).
- Luân phiên qua một nhóm UA.
- Giữ header nhất quán với UA.
- Cập nhật danh sách UA hằng tháng (trình duyệt thay đổi rất nhanh).
- Tránh mọi thứ toát ra “tự động hóa”.
Thunderbit trong thực tế: Các kịch bản cho sales và vận hành
Hãy nói chuyện thực tế hơn. Đây là cách Thunderbit giúp các đội ngũ thật sự:
| Trường hợp sử dụng | Cách cũ: Scraping thủ công | Với Thunderbit | Kết quả |
|---|---|---|---|
| Tạo lead cho sales | Bị chặn thường xuyên, thiếu dữ liệu | AI chọn UA tốt nhất, luân phiên, mô phỏng duyệt web thật | Nhiều lead hơn, chất lượng cao hơn, ít bounce hơn |
| Theo dõi ecommerce | Script dễ hỏng, bị khóa IP | Scraping cloud với UA động & xoay vòng proxy | Theo dõi giá/tồn kho ổn định |
| Danh sách bất động sản | Chỉnh sửa lắt nhắt, bị chặn | AI thích ứng UA/header, xử lý trang con tự động | Danh sách tài sản đầy đủ, cập nhật liên tục |

Một team sales dùng Thunderbit đã scrape hàng nghìn website để tìm lead và chỉ thấy tỷ lệ email bounce khoảng ~8% — thấp hơn hẳn mức 15–20% của danh sách mua sẵn (Reddit). Đó chính là sức mạnh của scraping kiểu mới, mô phỏng gần giống người dùng thật.
Từng bước: Cách scrape với user agent tốt nhất bằng Thunderbit
Bắt đầu với Thunderbit rất dễ — không cần kỹ năng kỹ thuật:
- Cài Thunderbit Chrome Extension.
- Truy cập website mục tiêu của bạn. Đăng nhập nếu cần — Thunderbit vẫn hoạt động trên các trang đã đăng nhập.
- Nhấn “One Click Extract.” AI của Thunderbit sẽ quét trang và đề xuất các cột tốt nhất để scrape.
- Rà soát và chỉnh sửa trường dữ liệu nếu muốn. Đổi tên, thêm hoặc xóa cột tùy nhu cầu.
- Nhấn “Scrape.” Thunderbit sẽ trích xuất dữ liệu, đồng thời xoay vòng user agent và header ở phía sau.
- Xuất dữ liệu. Gửi thẳng sang Excel, Google Sheets, Airtable, Notion, hoặc tải xuống dưới dạng CSV/JSON.
Bạn không cần tự chọn hay cập nhật user agent — AI của Thunderbit lo hết, tự thích ứng với từng website để tăng tỷ lệ thành công tối đa.
Scrape với xoay vòng user agent do AI hỗ trợ Thunderbit chạy các tác vụ scraping trên hạ tầng riêng, nên chỉ một cú nhấp đã thay thế cho các script xoay vòng user-agent thủ công. Get Started Free
So sánh Thunderbit với cách quản lý user agent truyền thống
Hãy xem Thunderbit vượt trội thế nào so với cách làm thủ công kiểu cũ:
| Tính năng/Nhiệm vụ | Cách scraping thủ công | Cách Thunderbit |
|---|---|---|
| Thiết lập User Agent | Tự nghiên cứu & cấu hình trong code | Tự động, AI chọn theo từng website |
| Cập nhật UA | Làm thủ công, dễ quên | AI tự cập nhật theo xu hướng trình duyệt |
| Xoay vòng UA | Tự viết logic xoay vòng | Tích hợp sẵn, xoay vòng thông minh |
| Nhất quán header | Tự khớp header với UA | AI đảm bảo bộ header đầy đủ và đồng bộ |
| Xử lý chặn/CAPTCHA | Tự thay đổi, bảo trì nặng | AI thích ứng, thử lại và xoay vòng khi cần |
| Kỹ năng kỹ thuật cần có | Cao (lập trình, hiểu HTTP) | Không cần — thiết kế cho người dùng doanh nghiệp |
| Thời gian xử lý sự cố | Nhiều, rất mệt mỏi | Tối thiểu — tập trung vào dữ liệu, không phải phiền toái scraping |
Thunderbit được tạo ra cho bất kỳ ai muốn scraping ổn định, có thể mở rộng — mà không phải gánh thêm áp lực kỹ thuật.
Xem cách Agentic Web Scraping hoạt động AI của Thunderbit đọc trang web như con người và trích xuất dữ liệu chỉ bằng một cú nhấp, giúp bạn không cần tinh chỉnh scraper thủ công. Get Started Free
Kết luận chính: Xây dựng chiến lược user agent bền vững cho tương lai
Đây là những gì tôi học được (đôi khi bằng cách hơi đau) về quản lý user agent trong năm 2026:
- Đừng bao giờ dùng user agent mặc định hoặc lỗi thời. Đây là nguyên nhân số 1 khiến scraper bị chặn.
- Xoay vòng user agent một cách động. Sự đa dạng là lợi thế — đừng để scraper của bạn trông như một đoàn robot diễu hành.
- Giữ header nhất quán và thực tế. User agent chỉ tốt khi “đi cùng đội” phù hợp.
- Luôn cập nhật. Phiên bản trình duyệt thay đổi rất nhanh; danh sách UA của bạn cũng nên như vậy.
- Hãy để AI xử lý phần khó. Những công cụ như Thunderbit đã tích hợp sẵn các thực hành tốt nhất, để bạn tập trung vào kết quả thay vì request.
Nếu bạn đã chán bị chặn, chán sửa script, hoặc chỉ muốn scrape như dân chuyên mà không phải đau đầu, hãy thử Thunderbit. Agentic web scraper của chúng tôi đang được hàng nghìn người dùng trên toàn thế giới tin tưởng và được thiết kế để đưa dữ liệu web đến với mọi người — không cần đau đầu kỹ thuật.
Để xem thêm mẹo, hướng dẫn và phân tích chuyên sâu về web scraping, hãy ghé Thunderbit Blog.
Câu hỏi thường gặp
1. User agent là gì, và vì sao nó quan trọng với web scraping?
User agent là chuỗi được gửi cùng mỗi request web để xác định trình duyệt và hệ điều hành của bạn. Website dùng nó để phục vụ nội dung phù hợp và nhận diện bot. Dùng user agent đúng giúp scraper hòa vào lưu lượng bình thường và tránh bị chặn.
2. Vì sao tôi không nên dùng user agent mặc định từ thư viện scraping?
Các user agent mặc định như python-requests/2.x là dấu hiệu bot đã quá quen thuộc và thường bị chặn ngay. Luôn dùng user agent trình duyệt thực tế, cập nhật mới nhất.
3. Thunderbit xử lý việc xoay vòng user agent như thế nào?
AI của Thunderbit tự động luân phiên qua một nhóm user agent trình duyệt hiện tại, thực tế cho mỗi request hoặc mỗi phiên. Điều này khiến scraping của bạn trông như lưu lượng người dùng thật và đa dạng.
4. Tôi có cần tự thiết lập header như Accept-Language hoặc Referer khi dùng Thunderbit không?
Không cần! AI của Thunderbit đảm bảo toàn bộ header luôn nhất quán và khớp với user agent, nên request của bạn trông và hoạt động như một trình duyệt thật.
5. Nếu website vẫn chặn request của tôi thì sao?
Thunderbit phát hiện chặn hoặc CAPTCHA và thích ứng theo thời gian thực — đổi user agent, điều chỉnh header hoặc thử lại khi cần. Bạn sẽ có dữ liệu ổn định mà không phải tự xử lý thủ công.
Sẵn sàng scrape thông minh hơn chưa? Tải Thunderbit và để AI của chúng tôi lo màn rượt đuổi giữa user agent và website cho bạn. Chúc scraping vui vẻ!
Tìm hiểu thêm
- AI Agents là gì? Cách hoạt động và cách sử dụng
- Manus AI Agent là gì? Cách hoạt động và cách sử dụng
- Hướng dẫn cho người mới: Cách xây dựng AI Agent từng bước
- Hướng dẫn về Vertical AI Agents: Khái niệm & các trường hợp sử dụng thực tế
- Hiểu về thống kê AI Agent: Từ độ chính xác đến khả năng mở rộng
Thử Agentic Web Scraper Get Started Free



