
Internet đang ngập tràn dữ liệu — và nếu bạn làm trong lĩnh vực bán hàng, marketing hay vận hành, bạn thừa hiểu rằng có đúng thông tin vào đúng thời điểm có thể tạo ra khác biệt lớn đến thế nào. Nhưng nói thật: chẳng ai mơ ước dành cả ngày để copy-paste từng dòng từ website vào bảng tính cả. Tôi đã chứng kiến nhiều đội nhóm đốt hàng chục giờ mỗi tháng chỉ để "lấy dữ liệu", để rồi nhận về những danh sách đầy lỗi và đã lỗi thời. Tin vui là gì? Các công cụ screen scraping hiện đại đã thay đổi cuộc chơi, giúp bất kỳ ai — chứ không riêng lập trình viên — có thể thu thập, sắp xếp và hành động dựa trên dữ liệu web chỉ trong vài phút thay vì vài ngày.

Nhu cầu về công cụ screen scraping đang tăng vọt. Thị trường web scraping toàn cầu được định giá khoảng 5 tỷ USD vào năm 2023 và được dự báo sẽ vượt 140 tỷ USD vào năm 2032, tăng trưởng với tốc độ CAGR đáng kinh ngạc là 43%. Vì sao vậy? Vì các doanh nghiệp đang nhận ra rằng tự động hóa không còn là thứ "có thì tốt" — nó là điều bắt buộc để giữ được sức cạnh tranh. Dù bạn đang xây dựng danh sách khách hàng tiềm năng, theo dõi đối thủ hay giám sát các tin đăng bất động sản, công cụ phù hợp có thể giúp bạn tiết kiệm 30–40% thời gian cho các tác vụ dữ liệu và cắt giảm tới 40% chi phí thu thập dữ liệu (scrapingapi.ai).
Hãy cùng khám phá sáu công cụ screen scraping tốt nhất để thu thập dữ liệu hiệu quả trong năm 2025. Tôi sẽ phân tích điểm độc đáo của từng công cụ, ai nên dùng chúng, và cách chọn lựa chọn phù hợp cho đội của bạn — dù bạn là người không rành kỹ thuật hay một lập trình viên dày dạn.
Vì sao công cụ screen scraping lại quan trọng với người dùng doanh nghiệp
Trích xuất dữ liệu từ mọi website bằng AI Get Started Free
Nếu bạn từng phải giữ cho danh sách khách hàng tiềm năng luôn mới hoặc theo dõi giá của đối thủ bằng tay, bạn hiểu rõ nỗi khổ này. Thu thập dữ liệu thủ công vừa chậm, vừa nhàm chán, lại dễ sai sót. Với những người dùng doanh nghiệp không rành kỹ thuật — như nhân viên kinh doanh, marketer, môi giới bất động sản hay chuyên viên phân tích vận hành — công cụ screen scraping chính là phao cứu sinh. Chúng tự động hóa công việc copy-paste lặp đi lặp lại, biến hàng giờ lao động thủ công thành một cú nhấp chuột.
Đây là cách các công cụ screen scraping đang thay đổi quy trình làm việc của doanh nghiệp:
- Tạo khách hàng tiềm năng: Lấy ngay hàng trăm thông tin liên hệ tiềm năng từ các trang danh bạ hoặc mạng xã hội, để đội bán hàng của bạn dành nhiều thời gian bán hàng hơn và ít thời gian sao chép hơn.
- Theo dõi đối thủ: Lên lịch thu thập dữ liệu từ website đối thủ để có bảng giá cập nhật hoặc tự động phát hiện các sản phẩm mới ra mắt. Những nhà bán lẻ như John Lewis đã ghi nhận doanh số tăng 4% chỉ nhờ áp dụng price scraping.
- Thu thập dữ liệu bất động sản: Trích xuất tin đăng bất động sản từ các trang như Zillow chỉ trong vài giây, giúp danh mục và danh sách khách hàng tiềm năng của bạn luôn được cập nhật.
- Tự động hóa quy trình: Xuất dữ liệu đã thu thập trực tiếp sang Excel, Google Sheets, Airtable hay Notion, thậm chí tự động hóa việc điền biểu mẫu hoặc các quy trình phần mềm.
Tóm lại là gì? Công cụ screen scraping trao quyền cho người dùng doanh nghiệp tiếp cận và khai thác dữ liệu web mà không phải chờ đợi bộ phận IT. Điều đó đồng nghĩa với quyết định nhanh hơn, thông tin tươi mới hơn và lợi thế đáng kể trước đối thủ.
Cách chọn công cụ screen scraping phù hợp
Với vô số lựa chọn ngoài kia, việc chọn công cụ screen scraping phù hợp có thể giống như đi chọn mua ô tô — bạn muốn một chiếc nhanh và hào nhoáng, hay một chiếc đáng tin cậy và dễ lái? Đây là danh sách kiểm tra nhanh giúp bạn khớp nhu cầu của mình với đúng công cụ:
- Dễ sử dụng: Bạn muốn một công cụ no-code, chỉ trỏ và nhấp, hay bạn thoải mái với việc viết script?
- Khả năng tùy chỉnh: Bạn có cần xử lý các website phức tạp, trang yêu cầu đăng nhập hay nội dung động (như cuộn vô tận) không?
- Loại dữ liệu được hỗ trợ: Bạn sẽ thu thập văn bản, hình ảnh, PDF hay thứ gì khác?
- Khả năng mở rộng: Bạn chỉ thu thập vài trang, hay cần xử lý hàng nghìn trang mỗi ngày?
- Tùy chọn xuất dữ liệu: Bạn có thể dễ dàng đưa dữ liệu sang Excel, Google Sheets hay CRM của mình không?
- Giá cả: Ngân sách của bạn là bao nhiêu? Bạn tìm một công cụ miễn phí, hay sẵn sàng đầu tư vào giải pháp tự động hóa cấp doanh nghiệp?
- Hỗ trợ & bảo trì: Bạn muốn một dịch vụ được quản lý sẵn, hay chấp nhận tự bảo trì script và tự xử lý sự cố?
Hãy ghi nhớ những tiêu chí này khi chúng ta điểm qua sáu công cụ hàng đầu. Và nhớ rằng: công cụ tốt nhất là công cụ mà đội của bạn thực sự chịu dùng.
1. Thunderbit
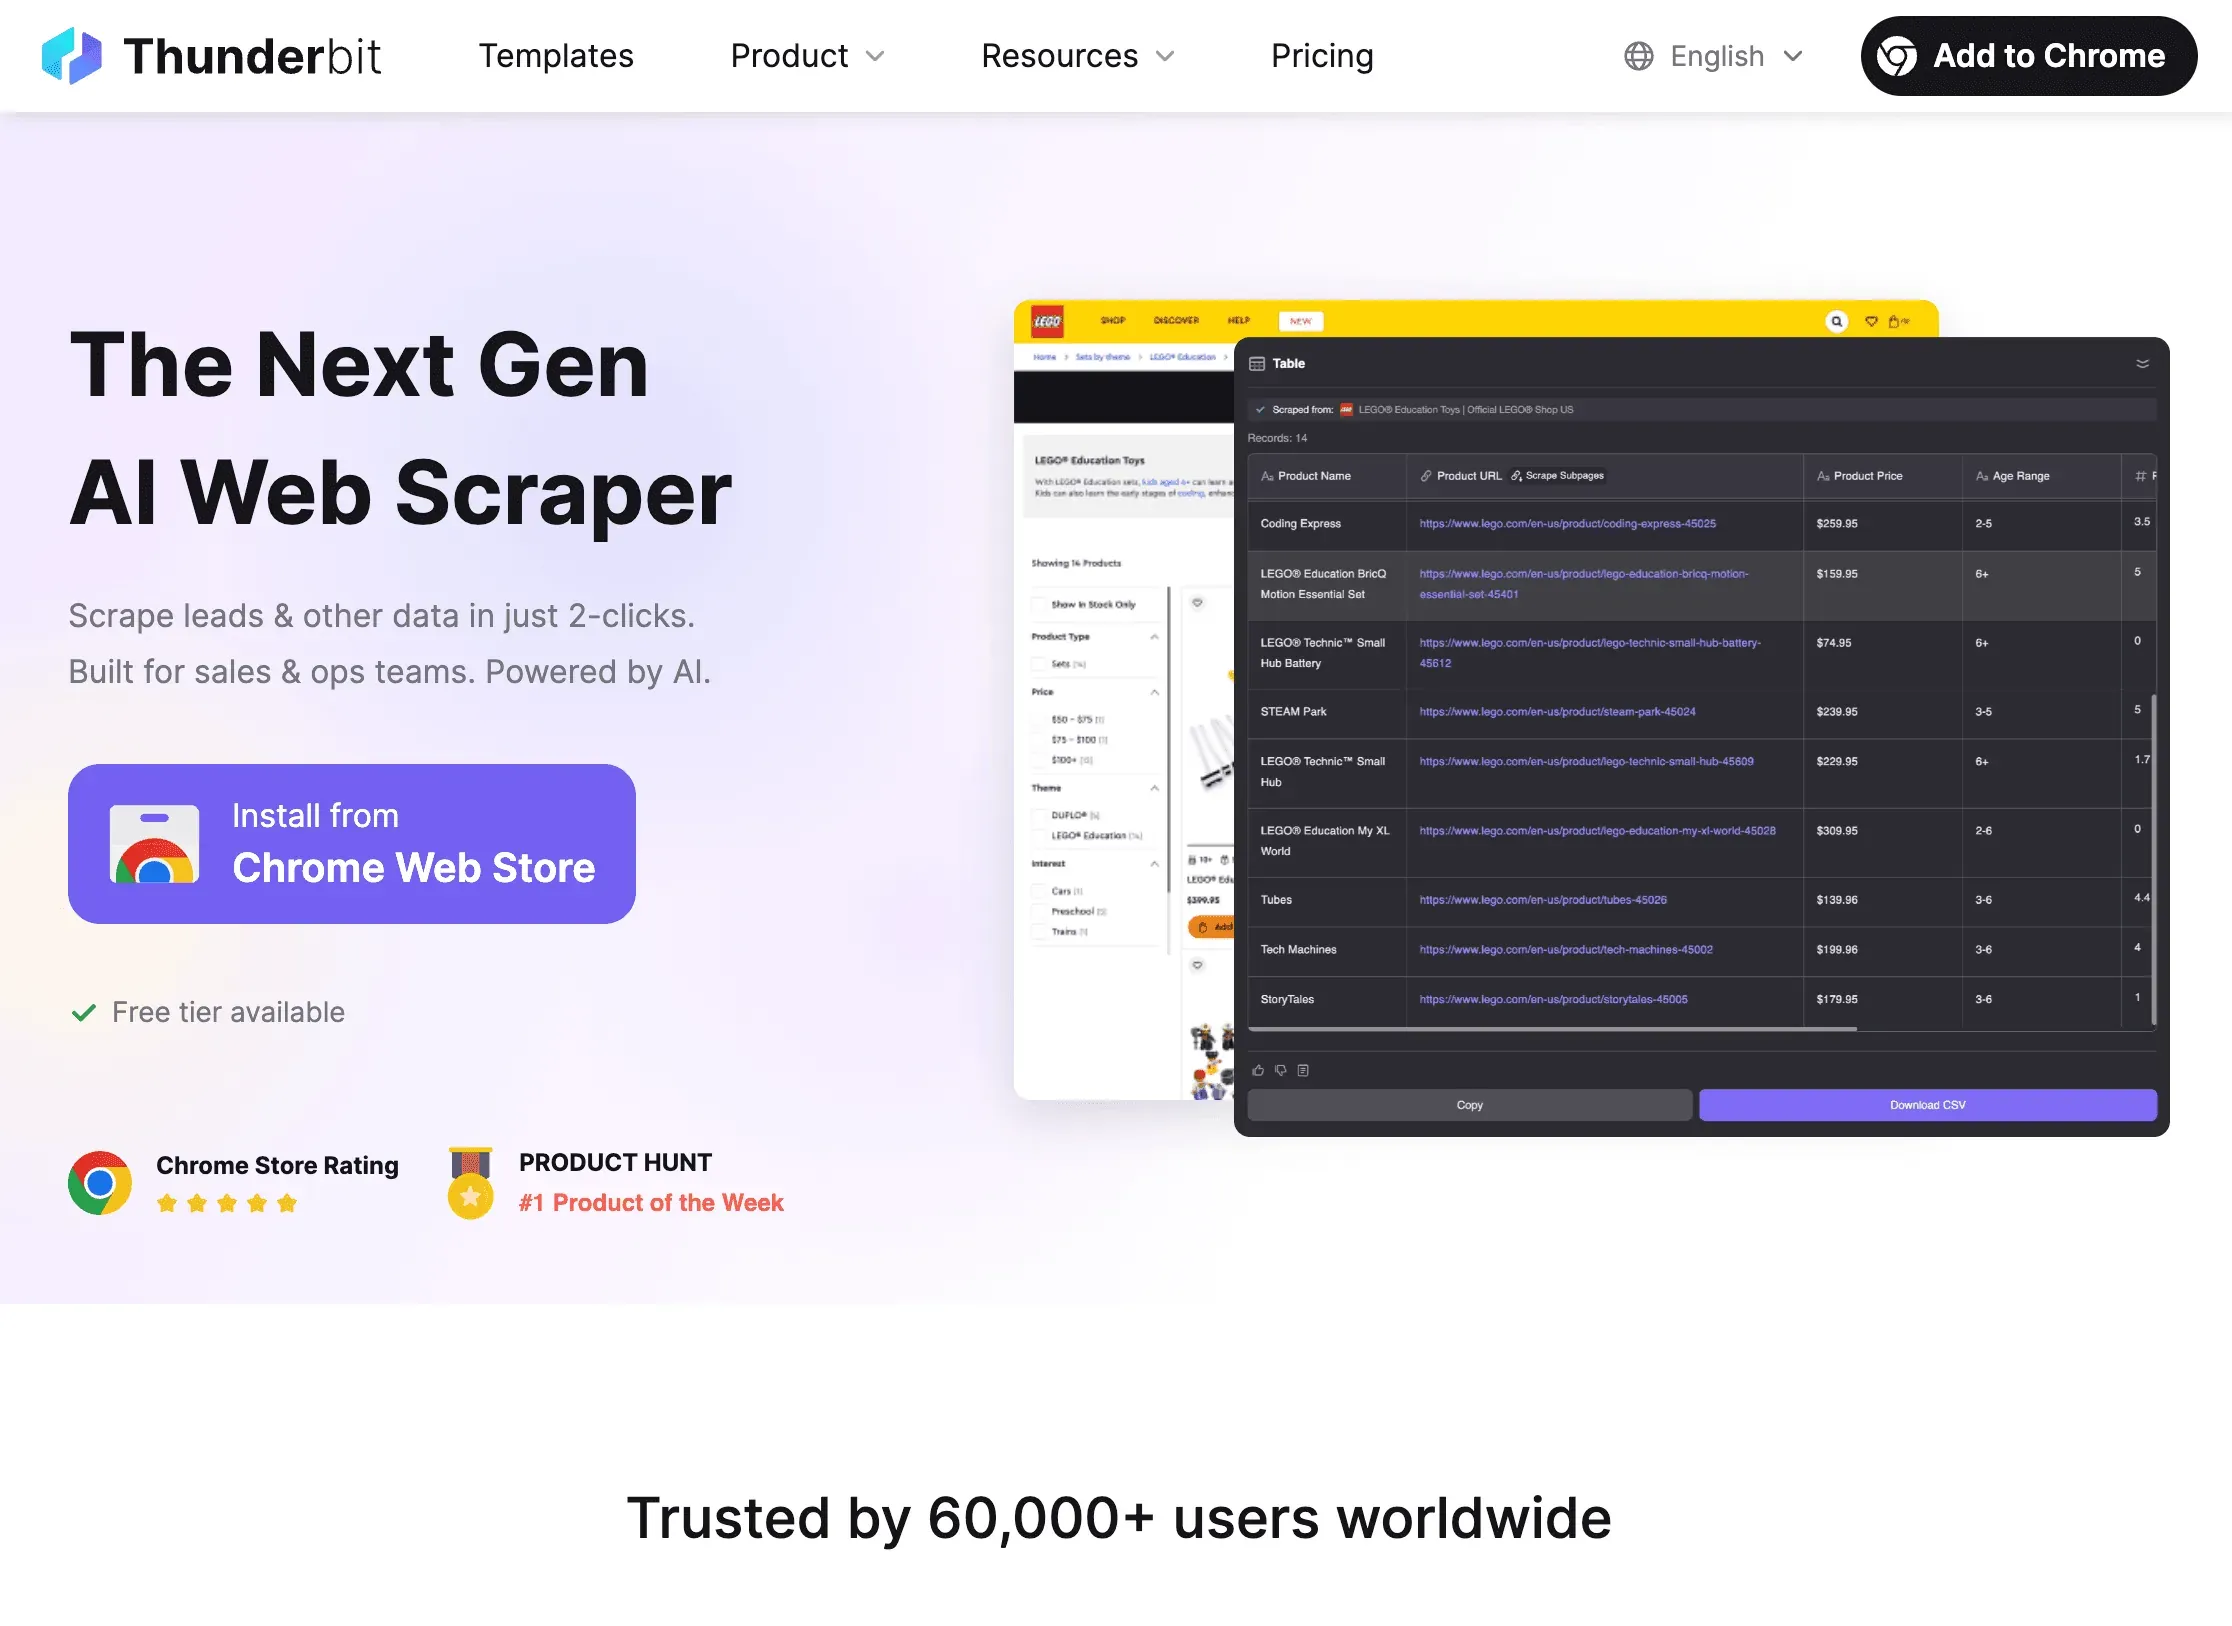
Thunderbit là lựa chọn tôi luôn giới thiệu cho các đội nhóm không rành kỹ thuật muốn thu thập dữ liệu web thật nhanh — không cần code, không cần template, không đau đầu. Với tư cách đồng sáng lập kiêm CEO, có lẽ tôi hơi thiên vị một chút, nhưng tôi xây dựng Thunderbit vì đã quá mệt mỏi khi thấy người dùng doanh nghiệp phải vật lộn với những công cụ cồng kềnh chỉ dành cho lập trình viên.
Điều gì làm Thunderbit khác biệt? Tất cả nằm ở sự đơn giản và sức mạnh:
- Gợi ý trường dữ liệu bằng AI: Chỉ cần nhấp "AI Suggest Fields", AI của Thunderbit sẽ đọc trang web, đề xuất những cột phù hợp nhất (như tên, giá, email), thậm chí thiết lập sẵn kiểu dữ liệu cho bạn.
- Thu thập chỉ với hai cú nhấp: Mở bất kỳ website nào, nhấp "Scrape", và Thunderbit lo phần còn lại — không cần thiết lập, không cần selector, không rắc rối.
- Thu thập trang con & phân trang: Cần lấy chi tiết từ các trang con (như thông tin sản phẩm hay hồ sơ LinkedIn)? Thunderbit có thể truy cập từng trang con và tự động làm giàu bảng dữ liệu của bạn. Công cụ cũng xử lý được phân trang, kể cả cuộn vô tận.
- Template dùng ngay: Với các trang phổ biến như Amazon, Zillow và Instagram, Thunderbit cung cấp template chỉ một cú nhấp — bạn chỉ cần nhập truy vấn rồi xuất dữ liệu.
- Xuất dữ liệu miễn phí: Xuất kết quả sang Excel, Google Sheets, Airtable hoặc Notion — hoàn toàn miễn phí.
- Tính năng nâng cao: Thu thập dữ liệu từ PDF, hình ảnh, thậm chí tự động điền biểu mẫu với AI Autofill (cũng miễn phí). Lên lịch thu thập tự động bằng câu lệnh ngôn ngữ tự nhiên.
- Giá cả: Thunderbit dùng hệ thống credit — thu thập tối đa 6 trang miễn phí (hoặc 10 trang với gói dùng thử tăng cường). Các gói trả phí bắt đầu chỉ từ 15 USD/tháng (hoặc 9 USD/tháng khi thanh toán theo năm) cho 500 dòng dữ liệu, phù hợp với đội nhóm ở mọi quy mô.
Thunderbit được hơn 200.000 người dùng trên toàn thế giới tin dùng, từ các đội bán hàng và marketing cho tới môi giới bất động sản và những người vận hành thương mại điện tử. Phản hồi tôi nghe nhiều nhất là gì? "Tôi không thể tin nổi nó tiết kiệm nhiều thời gian đến vậy — trước đây tôi mất hàng giờ để sao chép lead từ các trang danh bạ, giờ chỉ mất vài phút." Nếu muốn tự mình kiểm chứng, hãy tải tiện ích mở rộng Chrome và dùng thử.
Dùng thử Thunderbit miễn phí – AI Web Scraper
2. Octoparse

Octoparse là một tên tuổi nặng ký trong thế giới scraping no-code, cung cấp giao diện trực quan kéo-thả để xây dựng các quy trình thu thập dữ liệu tùy chỉnh. Nếu bạn là người dùng nâng cao muốn xử lý các website phức tạp — như trang cần đăng nhập, AJAX, cuộn vô tận và điều hướng nhiều bước — Octoparse cho bạn đủ công cụ để làm điều đó mà không cần viết một dòng code nào.
Tính năng chính:
- Trình thiết kế quy trình trực quan: Nhấp qua một trang mẫu, Octoparse sẽ nhận diện các phần tử tương tự và giúp bạn dựng quy trình trích xuất dữ liệu từng bước một.
- Xử lý nội dung động: Hỗ trợ các trang nặng JavaScript, cuộn vô tận và trang được bảo vệ bằng đăng nhập.
- Scraping trên đám mây: Chạy tác vụ trên cloud (nên máy tính của bạn không cần bật liên tục), lên lịch thu thập và xử lý khối lượng dữ liệu lớn 24/7.
- Thư viện template: Truy cập hơn 500 template dựng sẵn cho các trang phổ biến như Amazon, LinkedIn và Twitter.
- Tùy chọn xuất dữ liệu: Tải kết quả dưới dạng CSV, Excel hoặc JSON, hoặc đẩy dữ liệu thẳng vào cơ sở dữ liệu của bạn.
- Giá cả: Có gói miễn phí với tính năng hạn chế; các gói trả phí bắt đầu từ khoảng 69 USD/tháng cho gói Standard, và những gói cao hơn cho phép chạy song song nhiều hơn cùng các tính năng nâng cao.
Octoparse lý tưởng cho chuyên viên phân tích, nhà nghiên cứu và doanh nghiệp nhỏ cần một giải pháp scraping no-code mạnh mẽ ở quy mô trung bình. Công cụ này có đường cong học tập nhất định, đặc biệt với các quy trình nâng cao, nhưng giao diện trực quan và tài liệu hướng dẫn tốt khiến nó dễ tiếp cận với những người am hiểu công nghệ nhưng không muốn viết code.
3. ParseHub

ParseHub là một công cụ scraping trực quan khác, nổi tiếng nhất nhờ khả năng xử lý các website phức tạp, nhiều nội dung động thông qua một ứng dụng desktop. Nếu bạn cần thu thập dữ liệu từ những trang nặng JavaScript hoặc có các phần tử tương tác khó nhằn, cách tiếp cận mô phỏng trình duyệt của ParseHub là một lựa chọn rất hợp.
Điều khiến ParseHub nổi bật:
- Trình scraping trực quan trên desktop: Xây dựng dự án bằng cách nhấp qua trang web ngay trong trình duyệt tích hợp của ứng dụng. ParseHub nhận diện các mẫu lặp lại và cho phép bạn chọn chính xác thứ mình cần.
- Xử lý JavaScript & AJAX: Chờ nội dung tải xong, nhấp nút, điền biểu mẫu và điều hướng các trang tương tác.
- Tích hợp API: Kích hoạt dự án và lấy kết quả theo cách lập trình.
- Lên lịch trên cloud: Đặt lịch chạy tác vụ trên đám mây (ở các gói cao hơn).
- Tùy chọn xuất dữ liệu: Tải dữ liệu dưới dạng CSV, Excel hoặc JSON.
- Giá cả: Gói miễn phí cho phép thu thập tối đa 200 trang mỗi lần chạy; các gói trả phí bắt đầu từ 189 USD/tháng cho gói Standard và 599 USD/tháng cho gói Professional.
ParseHub được ưa chuộng bởi các nhà báo dữ liệu, nhà nghiên cứu và doanh nghiệp nhỏ cần thu thập dữ liệu từ các trang động và thích làm việc trong môi trường desktop. Phần hướng dẫn khởi đầu rất hữu ích cho người mới, nhưng mức giá có thể khá đắt với người dùng nặng.
4. Scrapy

Scrapy là lựa chọn hàng đầu của các lập trình viên và đội kỹ thuật muốn toàn quyền kiểm soát dự án scraping của mình. Đây là một framework mã nguồn mở dựa trên Python cho phép bạn tự xây dựng các web crawler tùy chỉnh — hoàn hảo cho những tác vụ scraping quy mô lớn, phức tạp hoặc cần tùy biến sâu.
Vì sao Scrapy được lập trình viên yêu thích:
- Linh hoạt tối đa: Viết code Python để định nghĩa spider, quy tắc thu thập và pipeline dữ liệu. Scrapy lo phần xử lý đồng thời, thử lại và xuất dữ liệu.
- Hiệu năng: Được thiết kế cho tốc độ và khả năng mở rộng — thu thập hàng nghìn đến hàng triệu trang một cách hiệu quả.
- Khả năng mở rộng chức năng: Tích hợp với proxy, cơ sở dữ liệu, API và middleware tùy chỉnh.
- Mã nguồn mở: Miễn phí sử dụng; chi phí đến từ hạ tầng của chính bạn hoặc dịch vụ cloud hosting (như Scrapy Cloud của Zyte).
- Cộng đồng: Hệ sinh thái khổng lồ, tài liệu trưởng thành và vô số hướng dẫn.
Scrapy không dành cho người yếu tim — đường cong học tập khá dốc, và bạn sẽ phải tự bảo trì code của mình. Nhưng nếu đội của bạn có lập trình viên và cần xây dựng một pipeline dữ liệu mạnh mẽ, có khả năng mở rộng, thì rất khó tìm được đối thủ của Scrapy.
5. Diffbot

Diffbot đi theo một hướng hoàn toàn khác: nó dùng AI và machine learning để tự động phân tích và trích xuất dữ liệu có cấu trúc từ bất kỳ trang web nào. Thay vì phải xây dựng scraper, bạn gửi cho Diffbot một URL (qua API) và nó trả về JSON sạch, có cấu trúc — không cần selector, không cần thiết lập.
Điều khiến Diffbot trở nên độc đáo:
- Trích xuất bằng AI: Các API được huấn luyện sẵn cho bài viết, sản phẩm, thảo luận và nhiều loại nội dung khác. Diffbot "đọc" trang web như một con người và trích xuất các trường quan trọng.
- Crawlbot: Tự động quét toàn bộ website hoặc sitemap.
- Knowledge Graph: Khai thác cơ sở dữ liệu khổng lồ của Diffbot với hơn 1,2 tỷ website, 246 triệu tổ chức và nhiều hơn thế.
- Khả năng mở rộng: Được xây dựng cho việc thu thập dữ liệu ở quy mô doanh nghiệp.
- Giá cả: Có gói miễn phí (10.000 credit/tháng); các gói trả phí bắt đầu từ 299 USD/tháng cho 250.000 credit, cùng những gói cao hơn cho khối lượng lớn hơn.
Diffbot phù hợp nhất với doanh nghiệp lớn, nhà khoa học dữ liệu và bất kỳ ai cần lượng dữ liệu web có cấu trúc khổng lồ mà không phải xây dựng hay bảo trì scraper. Nó không linh hoạt bằng các công cụ dựa trên code, nhưng nếu bạn muốn trích xuất bằng AI ở quy mô lớn mà gần như không phải động tay, Diffbot là vô đối.
6. DataMiner

DataMiner là một tiện ích mở rộng trình duyệt (cho Chrome và Edge) giúp việc trích xuất dữ liệu nhanh, lẻ tẻ trở nên cực kỳ dễ dàng. Nếu bạn là growth hacker, nhà báo hay người dùng doanh nghiệp chỉ muốn lấy một bảng hoặc một danh sách từ trang web vào Excel, DataMiner sẽ là người bạn thân mới của bạn.
Vì sao người dùng yêu thích DataMiner:
- Đơn giản chỉ trỏ và nhấp: Nhấp vào các phần tử trên trang để tạo một "recipe", hoặc dùng một trong hơn 50.000 recipe công khai dành cho hơn 15.000 website.
- Trích xuất một cú nhấp: Áp dụng recipe và xuất dữ liệu ngay sang CSV hoặc Excel.
- Phân trang & thu thập hàng loạt: Xử lý các danh sách nhiều trang, thậm chí cung cấp cả danh sách URL để xử lý theo lô.
- Điền biểu mẫu: Tự động gửi biểu mẫu bằng dữ liệu lấy từ file CSV.
- Gói miễn phí: Thu thập tối đa 500 trang mỗi tháng miễn phí; các gói trả phí bắt đầu từ 19,99 USD/tháng cho 500 trang.
DataMiner rất hợp cho các tác vụ tạm thời, nghiên cứu nhanh và bất kỳ ai thích làm việc trực tiếp trong trình duyệt. Nó không được xây dựng cho những công việc khổng lồ, nhưng với các dự án nhỏ đến vừa thì cực kỳ tiện.
Bảng so sánh nhanh: Các công cụ screen scraping trong một cái nhìn
| Công cụ | Mức độ dễ dùng | Tính năng chính | Phù hợp nhất với | Mô hình giá | Thế mạnh riêng |
|---|---|---|---|---|---|
| Thunderbit | Rất dễ (no-code) | Gợi ý trường bằng AI, trang con/phân trang, template, xuất dữ liệu miễn phí | Người dùng doanh nghiệp không rành kỹ thuật (bán hàng, vận hành, bất động sản) | Miễn phí/Từ 9–15 USD/tháng | Thiết lập dễ nhất, dùng AI, scraping tạm thời cực nhanh |
| Octoparse | Trung bình (no-code) | Quy trình trực quan, chạy trên cloud, trang động, template | Chuyên viên phân tích và nhà nghiên cứu am hiểu công nghệ | Miễn phí/Từ 69 USD/tháng | Trình dựng trực quan, lên lịch trên cloud, logic nâng cao |
| ParseHub | Trung bình (no-code) | Ứng dụng desktop, xử lý JS/AJAX, API, chạy trên cloud | Trang động, người mới có nền tảng kỹ thuật | Miễn phí/Từ 189 USD/tháng | Xử lý được các trang khó, kiểm soát trên desktop |
| Scrapy | Khó (code Python) | Mã nguồn mở, mở rộng tốt, toàn quyền kiểm soát, pipeline | Lập trình viên, đội kỹ thuật | Miễn phí (tự vận hành) | Linh hoạt tối đa, scraping tùy chỉnh quy mô lớn |
| Diffbot | Dễ (với dev) | Trích xuất bằng AI, API, Knowledge Graph, crawlbot | Doanh nghiệp lớn, nhà khoa học dữ liệu | Miễn phí/Từ 299 USD/tháng | AI tự lo hết, dữ liệu toàn web, quy mô khổng lồ |
| DataMiner | Rất dễ (trên trình duyệt) | Tiện ích trình duyệt, hơn 50 nghìn recipe, một cú nhấp, biểu mẫu | Tác vụ tạm thời, nhà báo, growth hacker | Miễn phí/Từ 19,99 USD/tháng | Nhanh nhất trên trình duyệt, thư viện template khổng lồ |
Công cụ screen scraping nào phù hợp với bạn?
Công cụ & phần mềm Web Scraping tốt nhất năm 2025 Get Started Free
- Cần no-code và kết quả tức thì? Hãy chọn Thunderbit hoặc DataMiner. Thunderbit phù hợp nhất cho việc thu thập dữ liệu có cấu trúc, nhiều trang hoặc trang con với sự hỗ trợ của AI; DataMiner hoàn hảo cho những tác vụ nhanh gọn ngay trên trình duyệt.
- Muốn quy trình trực quan và sức mạnh đám mây? Octoparse là người bạn đồng hành của bạn, đặc biệt nếu bạn xử lý các trang phức tạp hoặc cần lên lịch thu thập định kỳ.
- Thu thập từ các trang động, nặng JavaScript? Cách tiếp cận desktop của ParseHub tỏa sáng ở đây, nhất là với người mới có nền tảng kỹ thuật.
- Có lập trình viên và cần toàn quyền kiểm soát? Scrapy là chuẩn mực vàng cho scraping tùy chỉnh ở quy mô lớn.
- Cần dữ liệu do AI xử lý ở quy mô doanh nghiệp? Diffbot mang lại khả năng trích xuất dữ liệu có cấu trúc gần như không cần can thiệp, cùng một knowledge graph khổng lồ.
Lời khuyên của tôi? Hãy bắt đầu bằng bản dùng thử hoặc gói miễn phí — hầu hết những công cụ này đều cho bạn trải nghiệm trước khi quyết định. Hãy đối chiếu mức độ thoải mái về kỹ thuật, khối lượng dữ liệu và nhu cầu quy trình của bạn với công cụ phù hợp, và đừng ngại thử nghiệm.
Kết luận: Mở khóa việc thu thập dữ liệu với đúng công cụ screen scraping
Các công cụ screen scraping đã đi từ chỗ là món đồ chơi ngách của lập trình viên trở thành công cụ tăng năng suất thiết yếu cho doanh nghiệp. Dù bạn là nhân viên kinh doanh đang săn lead, quản lý thương mại điện tử theo dõi giá, hay môi giới bất động sản thu thập tin đăng, công cụ phù hợp có thể biến cả internet thành cơ sở dữ liệu của riêng bạn. Điều mấu chốt là chọn được công cụ khớp với kỹ năng của đội bạn và mục tiêu kinh doanh của bạn — bởi công cụ screen scraping tốt nhất chính là công cụ bạn thực sự sẽ dùng.
Sẵn sàng ngừng copy-paste và bắt đầu thu thập dữ liệu như một chuyên gia chưa? Hãy tải Thunderbit hoặc thử một trong những công cụ khác trong danh sách này. Và nếu bạn muốn thêm mẹo hay, các bài phân tích chuyên sâu và hướng dẫn, hãy ghé thăm Blog Thunderbit.
Dùng thử Thunderbit AI Web Scraper miễn phí Get Started Free
Câu hỏi thường gặp
1. Công cụ screen scraping là gì và nó hoạt động ra sao?
Công cụ screen scraping tự động hóa quá trình trích xuất dữ liệu từ website. Thay vì sao chép thông tin bằng tay, những công cụ này cho phép bạn chọn thứ mình cần và xuất ra định dạng có cấu trúc như Excel hoặc CSV. Một số công cụ dùng AI hoặc quy trình trực quan để việc thiết lập trở nên dễ dàng với người dùng không rành kỹ thuật.
2. Ai nên dùng công cụ screen scraping?
Bất kỳ ai cần thu thập dữ liệu web một cách hiệu quả — đội bán hàng, marketer, môi giới bất động sản, nhà nghiên cứu và chuyên viên phân tích vận hành. Dù bạn đang xây dựng danh sách khách hàng tiềm năng, theo dõi đối thủ hay tổng hợp tin đăng, những công cụ này đều giúp tiết kiệm thời gian và giảm sai sót.
3. Công cụ scraping no-code và công cụ dựa trên code khác nhau thế nào?
Các công cụ no-code (như Thunderbit, Octoparse, ParseHub, DataMiner) cung cấp giao diện chỉ trỏ và nhấp, được thiết kế cho người dùng không rành kỹ thuật. Các công cụ dựa trên code (như Scrapy) đòi hỏi kỹ năng lập trình nhưng mang lại sự linh hoạt và khả năng mở rộng cao hơn cho những dự án phức tạp.
4. Dùng công cụ screen scraping có hợp pháp không?
Screen scraping là hợp pháp đối với dữ liệu công khai, nhưng bạn luôn phải tôn trọng điều khoản dịch vụ của website và luật về quyền riêng tư. Hãy tránh thu thập dữ liệu cá nhân khi chưa có sự đồng ý và đừng gửi quá nhiều yêu cầu khiến website bị quá tải.
5. Làm sao để chọn công cụ screen scraping tốt nhất cho nhu cầu của tôi?
Hãy cân nhắc kỹ năng kỹ thuật của bạn, khối lượng dữ liệu, độ phức tạp của các trang mục tiêu, nhu cầu xuất dữ liệu và ngân sách. Bắt đầu bằng bản dùng thử miễn phí, kiểm nghiệm với trường hợp sử dụng của chính bạn, rồi xem công cụ nào cho cảm giác trực quan nhất và mang lại kết quả bạn mong muốn.
Sẵn sàng khai phá sức mạnh của dữ liệu web chưa? Hãy thử một trong những công cụ này và nhìn năng suất của bạn tăng vọt.



