
Bạn nên dùng ngôn ngữ lập trình nào cho web scraping? Điều này còn tùy vào dự án của bạn — và tôi đã thấy không ít lập trình viên “quay xe” vì chọn sai ngay từ đầu.
Thị trường phần mềm web scraping đã đạt $1,01 tỷ vào năm 2024 và dự kiến sẽ tăng hơn gấp đôi vào năm 2032. Chọn đúng ngôn ngữ có thể giúp bạn ra kết quả nhanh hơn và giảm khối lượng bảo trì. Chọn sai thì chỉ nhận lại scraper hỏng hóc và những cuối tuần bị lãng phí để sửa lỗi.
Tôi đã xây dựng các công cụ tự động hóa trong nhiều năm. Dưới đây là bảy ngôn ngữ tôi từng dùng để scraping — kèm theo ví dụ code, những đánh đổi thực tế, và cả lúc nào bạn nên bỏ qua việc viết code để dùng Thunderbit thay thế.
Cách Chúng Tôi Chọn Ngôn Ngữ Tốt Nhất Cho Web Scraping
Khi nói đến web scraping, không phải ngôn ngữ lập trình nào cũng giống nhau. Tôi đã chứng kiến nhiều dự án bứt phá — và cũng có những dự án “đổ sập” — chỉ vì vài yếu tố then chốt:
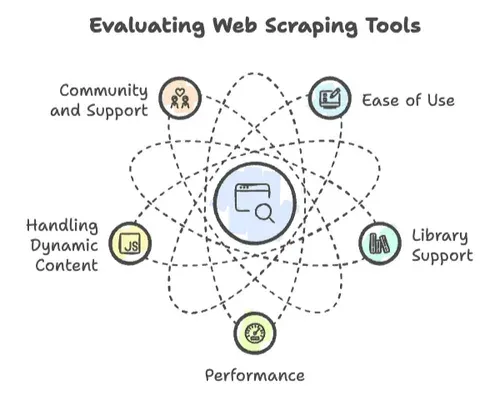
- Dễ sử dụng: Bạn có thể bắt đầu nhanh đến đâu? Cú pháp có thân thiện không, hay bạn phải có bằng tiến sĩ khoa học máy tính mới in nổi “Hello, World”?
- Hỗ trợ thư viện: Có thư viện mạnh cho HTTP request, phân tích HTML và xử lý nội dung động không? Hay bạn phải tự làm lại từ đầu?
- Hiệu năng: Nó có xử lý được việc scraping hàng triệu trang không, hay mới vài trăm trang đã “đuối”?
- Xử lý nội dung động: Website hiện đại rất thích JavaScript. Ngôn ngữ của bạn có theo kịp không?
- Cộng đồng và hỗ trợ: Khi gặp bế tắc (mà kiểu gì cũng sẽ gặp), có cộng đồng nào giúp bạn không?
Dựa trên các tiêu chí đó — và rất nhiều đêm test đến khuya — đây là bảy ngôn ngữ tôi sẽ đề cập:
- Python: Lựa chọn quen thuộc cho cả người mới lẫn dân chuyên.
- JavaScript & Node.js: Vua của nội dung động.
- Ruby: Cú pháp gọn gàng, script nhanh.
- PHP: Đơn giản ở phía server.
- C++: Dành cho khi bạn cần tốc độ thô.
- Java: Sẵn sàng cho doanh nghiệp, dễ mở rộng.
- Go (Golang): Nhanh và xử lý đồng thời tốt.
Và nếu bạn đang nghĩ: “Shuai, tôi không muốn code chút nào cả,” thì cứ ở lại đến cuối để xem Thunderbit.
Python Web Scraping: Sức Mạnh Thân Thiện Với Người Mới
Hãy bắt đầu với lựa chọn được nhiều người yêu thích nhất: Python. Nếu bạn hỏi một phòng đầy người làm dữ liệu rằng “Ngôn ngữ lập trình nào tốt nhất cho web scraping?”, bạn sẽ nghe Python được nhắc lại như một câu thần chú trong concert Taylor Swift.
Vì sao chọn Python?
- Cú pháp thân thiện với người mới: Bạn có thể đọc code Python thành tiếng và nó gần như nghe giống tiếng Anh.
- Hệ sinh thái thư viện cực mạnh: Từ BeautifulSoup để phân tích HTML, Scrapy để crawl quy mô lớn, Requests cho HTTP, đến Selenium cho tự động hóa trình duyệt — Python có đủ cả.
- Cộng đồng khổng lồ: Chỉ riêng web scraping đã có hơn 33.000 câu hỏi trên Stack Overflow.
Ví dụ Python: Lấy tiêu đề trang
import requests
from bs4 import BeautifulSoup

response = requests.get("<https://example.com>")
soup = BeautifulSoup(response.text, 'html.parser')
title = soup.title.string
print(f"Page title: {title}")
Ưu điểm:
- Phát triển và thử nghiệm nhanh.
- Rất nhiều tài liệu hướng dẫn và Q&A.
- Tuyệt vời cho phân tích dữ liệu — scrape bằng Python, phân tích bằng pandas, trực quan hóa bằng matplotlib.
- Thư viện vẫn liên tục tiến hóa: bản phát hành Scrapy 2.14 (tháng 1/2026) đã mang
async/awaitgốc vào toàn bộ framework, nên câu chuyện async giờ không còn chỉ là sân chơi của Selenium/Playwright nữa.
Hạn chế:
- Chậm hơn các ngôn ngữ biên dịch khi làm việc cực lớn.
- Xử lý website siêu động có thể hơi cồng kềnh (dù Selenium và Playwright hỗ trợ khá tốt).
- Không lý tưởng nếu bạn cần scrape hàng triệu trang với tốc độ chớp nhoáng.
Kết luận nhanh:
Nếu bạn mới bắt đầu làm scraping, hoặc chỉ muốn làm cho xong nhanh gọn, Python là lựa chọn tốt nhất cho web scraping — không cần bàn cãi. Vì sao Python thống trị web scraping.
JavaScript & Node.js: Scraping Website Động Một Cách Dễ Dàng
Nếu Python là con dao đa năng kiểu Thụy Sĩ, thì JavaScript (và Node.js) là máy khoan điện — đặc biệt hữu ích khi scraping các website hiện đại, nặng JavaScript.
Vì sao chọn JavaScript/Node.js?
- Sinh ra cho nội dung động: Nó chạy trong trình duyệt, nên có thể thấy đúng những gì người dùng thấy — kể cả trang được xây bằng React, Angular hay Vue.
- Async mặc định: Node.js có thể xử lý hàng trăm request cùng lúc.
- Quen thuộc với dân web: Nếu bạn từng làm website, chắc chắn bạn đã biết ít nhiều JavaScript.
Thư viện quan trọng:
- Playwright: Hỗ trợ nhiều trình duyệt (Chromium, Firefox, WebKit), tự động chờ và proxy theo từng context. Nếu bạn bắt đầu một scraper Node mới trong 2026, đây là lựa chọn mặc định.
- Puppeteer: Điều khiển Chrome headless qua Chrome DevTools Protocol. Vẫn rất ổn cho các job chỉ cần Chrome và muốn phụ thuộc nhẹ hơn.
- Cheerio: Phân tích HTML theo kiểu giống jQuery trong Node khi bạn không cần trình duyệt thật.
Ví dụ Node.js: Lấy tiêu đề trang bằng Puppeteer
const puppeteer = require('puppeteer');

(async () => {
  const browser = await puppeteer.launch();
  const page = await browser.newPage();
  await page.goto('<https://example.com>', { waitUntil: 'networkidle2' });
  const title = await page.title();
  console.log(`Page title: ${title}`);
  await browser.close();
})();
Ưu điểm:
- Xử lý nội dung render bằng JavaScript một cách tự nhiên.
- Rất hợp để scrape infinite scroll, popup và các site có tính tương tác cao.
- Hiệu quả cho scraping đồng thời ở quy mô lớn.
Hạn chế:
- Lập trình async có thể khó với người mới.
- Trình duyệt headless ngốn bộ nhớ nếu chạy quá nhiều instance cùng lúc.
- Ít công cụ phân tích dữ liệu hơn so với Python.
Khi nào JavaScript/Node.js là ngôn ngữ tốt nhất cho web scraping?
Khi website mục tiêu là dynamic, hoặc khi bạn muốn tự động hóa các thao tác trong trình duyệt. Tìm hiểu thêm về Node.js cho scraping nội dung động.
Ruby: Cú Pháp Gọn Gàng Cho Các Script Web Scraping Nhanh
Ruby không chỉ dành cho ứng dụng Rails và những dòng code đẹp như thơ. Nó cũng là một lựa chọn ổn cho web scraping — đặc biệt nếu bạn thích code của mình dễ đọc như một bài haiku.
Vì sao chọn Ruby?
- Cú pháp dễ đọc, biểu đạt tốt: Bạn có thể viết một scraper bằng Ruby gần như dễ đọc như danh sách mua đồ.
- Rất hợp cho prototyping: Viết nhanh, chỉnh sửa nhanh.
- Thư viện chính: Nokogiri để phân tích HTML, Mechanize để tự động điều hướng.
Ví dụ Ruby: Lấy tiêu đề trang
require 'open-uri'
require 'nokogiri'

html = URI.open("<https://example.com>")
doc = Nokogiri::HTML(html)
title = doc.at('title').text
puts "Page title: #{title}"
Ưu điểm:
- Rất dễ đọc và ngắn gọn.
- Tuyệt cho dự án nhỏ, script dùng một lần, hoặc khi bạn đã quen Ruby.
Hạn chế:
- Chậm hơn Python hoặc Node.js khi làm job lớn.
- Ít thư viện scraping hơn và cộng đồng về scraping cũng nhỏ hơn.
- Không lý tưởng cho site nặng JavaScript (dù bạn có thể dùng Watir hoặc Selenium).
Phù hợp nhất:
Nếu bạn là Rubyist hoặc chỉ muốn viết nhanh một script gọn nhẹ, Ruby khá thú vị để dùng. Còn nếu scraping quy mô lớn và site động, bạn nên cân nhắc ngôn ngữ khác.
PHP: Sự Đơn Giản Ở Phía Server Cho Trích Xuất Dữ Liệu Web
PHP có thể nghe như một di sản của thời web sơ khai, nhưng nó vẫn còn rất hữu ích — nhất là khi bạn muốn scrape dữ liệu ngay trên server.
Vì sao chọn PHP?
- Chạy ở khắp nơi: Hầu hết web server đều đã có PHP.
- Dễ tích hợp với ứng dụng web: Vừa scrape vừa hiển thị trên site trong một quy trình.
- Thư viện chính: cURL cho HTTP, Guzzle cho request, Symfony Panther cho tự động hóa trình duyệt headless.
Ví dụ PHP: Lấy tiêu đề trang
<?php
$ch = curl_init("<https://example.com>");
curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);
$html = curl_exec($ch);
curl_close($ch);

$dom = new DOMDocument();
@$dom->loadHTML($html);
$title = $dom->getElementsByTagName("title")->item(0)->nodeValue;
echo "Page title: $title\n";
?>
Ưu điểm:
- Dễ triển khai trên web server.
- Phù hợp khi scraping là một phần của workflow web.
- Nhanh với các tác vụ scraping đơn giản, phía server.
Hạn chế:
- Hỗ trợ thư viện cho scraping nâng cao còn hạn chế.
- Không được thiết kế cho concurrency cao hay scraping quy mô lớn.
- Xử lý site nặng JavaScript khá vất vả (dù Panther có thể hỗ trợ).
Phù hợp nhất:
Nếu stack của bạn đã dùng PHP, hoặc bạn muốn scrape rồi hiển thị dữ liệu ngay trên website, PHP là lựa chọn thực dụng. Tìm hiểu thêm về PHP so với Python khi scraping.
C++: Web Scraping Hiệu Năng Cao Cho Dự Án Quy Mô Lớn
C++ giống như chiếc xe cơ bắp trong thế giới ngôn ngữ lập trình. Nếu bạn cần tốc độ thô và khả năng kiểm soát cao, và không ngại chút công việc thủ công, C++ có thể đưa bạn đi rất xa.
Vì sao chọn C++?
- Cực nhanh: Thường vượt qua hầu hết ngôn ngữ khác trong các tác vụ nặng CPU.
- Kiểm soát chi tiết: Quản lý bộ nhớ, luồng và tinh chỉnh hiệu năng.
- Thư viện chính: libcurl cho HTTP, htmlcxx để phân tích HTML.
Ví dụ C++: Lấy tiêu đề trang
#include <curl/curl.h>
#include <iostream>
#include <string>

size_t WriteCallback(void* contents, size_t size, size_t nmemb, void* userp) {
    std::string* html = static_cast<std::string*>(userp);
    size_t totalSize = size * nmemb;
    html->append(static_cast<char*>(contents), totalSize);
    return totalSize;
}

int main() {
    CURL* curl = curl_easy_init();
    std::string html;
    if(curl) {
        curl_easy_setopt(curl, CURLOPT_URL, "<https://example.com>");
        curl_easy_setopt(curl, CURLOPT_WRITEFUNCTION, WriteCallback);
        curl_easy_setopt(curl, CURLOPT_WRITEDATA, &html);
        CURLcode res = curl_easy_perform(curl);
        curl_easy_cleanup(curl);
    }

    std::size_t startPos = html.find("<title>");
    std::size_t endPos = html.find("</title>");
    if(startPos != std::string::npos && endPos != std::string::npos) {
        startPos += 7;
        std::string title = html.substr(startPos, endPos - startPos);
        std::cout << "Page title: " << title << std::endl;
    } else {
        std::cout << "Title tag not found" << std::endl;
    }
    return 0;
}
Ưu điểm:
- Tốc độ gần như không đối thủ cho các job scraping cực lớn.
- Rất phù hợp để tích hợp scraping vào hệ thống hiệu năng cao.
Hạn chế:
- Đường cong học tập rất dốc (nhớ mang cà phê).
- Phải tự quản lý bộ nhớ.
- Ít thư viện cấp cao; không lý tưởng cho nội dung động.
Phù hợp nhất:
Khi bạn cần scrape hàng triệu trang, hoặc hiệu năng là thứ không thể thỏa hiệp. Nếu không, bạn có thể dành nhiều thời gian debug hơn là scraping.
Java: Giải Pháp Web Scraping Sẵn Sàng Cho Doanh Nghiệp
Java là “con ngựa thồ” của thế giới doanh nghiệp. Nếu bạn đang xây thứ gì đó phải chạy bền bỉ, xử lý lượng dữ liệu lớn và sống sót qua cả ngày tận thế, Java là người bạn đáng tin.
Vì sao chọn Java?
- Mạnh mẽ và dễ mở rộng: Rất hợp cho các dự án scraping lớn, chạy dài hạn.
- Kiểu dữ liệu chặt chẽ và xử lý lỗi tốt: Ít bất ngờ hơn khi chạy production.
- Thư viện chính: Jsoup để phân tích HTML, Selenium WebDriver để tự động hóa trình duyệt, Apache HttpClient cho HTTP.
Ví dụ Java: Lấy tiêu đề trang
import org.jsoup.Jsoup;
import org.jsoup.nodes.Document;

public class ScrapeTitle {
    public static void main(String[] args) throws Exception {
        Document doc = Jsoup.connect("<https://example.com>").get();
        String title = doc.title();
        System.out.println("Page title: " + title);
    }
}
Ưu điểm:
- Hiệu năng cao và hỗ trợ concurrency tốt.
- Rất phù hợp với codebase lớn, cần bảo trì lâu dài.
- Hỗ trợ tốt cho nội dung động (thông qua Selenium hoặc HtmlUnit).
Hạn chế:
- Cú pháp dài dòng; cần nhiều thiết lập hơn các ngôn ngữ scripting.
- Quá mức cần thiết cho script nhỏ, chỉ chạy một lần.
Phù hợp nhất:
Scraping cấp doanh nghiệp, hoặc khi bạn cần độ tin cậy và khả năng mở rộng cực cao.
Go (Golang): Web Scraping Nhanh Và Xử Lý Đồng Thời Tốt
Go là tân binh nổi bật, nhưng đã tạo được nhiều tiếng vang — đặc biệt trong scraping tốc độ cao và xử lý đồng thời.
Vì sao chọn Go?
- Tốc độ của ngôn ngữ biên dịch: Gần nhanh như C++.
- Concurrency tích hợp sẵn: Goroutine giúp chạy scraping song song rất nhẹ nhàng.
- Thư viện chính: Colly cho scraping, Goquery để phân tích HTML.
Ví dụ Go: Lấy tiêu đề trang
package main

import (
    "fmt"
    "github.com/gocolly/colly"
)

func main() {
    c := colly.NewCollector()
    c.OnHTML("title", func(e *colly.HTMLElement) {
        fmt.Println("Page title:", e.Text)
    })
    err := c.Visit("<https://example.com>")
    if err != nil {
        fmt.Println("Error:", err)
    }
}
Ưu điểm:
- Cực nhanh và hiệu quả cho scraping quy mô lớn.
- Dễ triển khai (chỉ một file nhị phân).
- Rất phù hợp cho crawl đồng thời.
Hạn chế:
- Cộng đồng nhỏ hơn Python hoặc Node.js.
- Ít thư viện scraping cấp cao hơn.
- Xử lý site nặng JavaScript cần thiết lập thêm (Chromedp hoặc Selenium).
Phù hợp nhất:
Khi bạn cần scrape ở quy mô lớn, hoặc Python không còn đủ nhanh. So sánh hiệu năng Go vs Python cho scraping.
So Sánh Các Ngôn Ngữ Lập Trình Tốt Nhất Cho Web Scraping
Hãy ghép mọi thứ lại với nhau. Dưới đây là bảng so sánh giúp bạn chọn ngôn ngữ phù hợp nhất cho web scraping trong năm 2026:
| Ngôn ngữ/Công cụ | Dễ sử dụng | Hiệu năng | Hỗ trợ thư viện | Xử lý nội dung động | Trường hợp phù hợp nhất |
|---|---|---|---|---|---|
| Python | Rất cao | Trung bình | Xuất sắc | Tốt (Selenium/Playwright) | Tổng quát, người mới, phân tích dữ liệu |
| JavaScript/Node.js | Trung bình | Cao | Mạnh | Xuất sắc (gốc) | Website động, scraping async, dân web dev |
| Ruby | Cao | Trung bình | Khá ổn | Hạn chế (Watir) | Script nhanh, tạo mẫu |
| PHP | Trung bình | Trung bình | Tạm được | Hạn chế (Panther) | Phía server, tích hợp ứng dụng web |
| C++ | Thấp | Rất cao | Hạn chế | Rất hạn chế | Ưu tiên hiệu năng, quy mô cực lớn |
| Java | Trung bình | Cao | Tốt | Tốt (Selenium/HtmlUnit) | Doanh nghiệp, dịch vụ chạy dài hạn |
| Go (Golang) | Trung bình | Rất cao | Đang phát triển | Trung bình (Chromedp) | Scraping tốc độ cao, xử lý đồng thời |
Khi Nào Nên Bỏ Qua Việc Viết Code: Thunderbit Là Giải Pháp Web Scraping Không Cần Code
Thử Thunderbit Agentic Web Scraper Web scraping không cần code, dùng AI, dành cho người dùng doanh nghiệp, marketer và team sales. Get Started Free
Nói thật nhé: đôi khi bạn chỉ muốn lấy dữ liệu — không muốn viết code, debug hay đau đầu vì “sao selector này mãi không chạy”. Đó là lúc Thunderbit phát huy tác dụng.
Là đồng sáng lập Thunderbit, tôi muốn tạo ra một công cụ giúp web scraping dễ như đặt đồ ăn. Đây là những điểm khiến Thunderbit khác biệt:
- Thiết lập một chạm: Chỉ cần bấm “One Click Extract”. Không phải lo request HTTP, proxy hay mánh chống bot.
- Mẫu thông minh: Một scraper template có thể thích ứng với nhiều bố cục trang khác nhau. Không cần viết lại scraper mỗi khi website thay đổi.
- Scraping bằng trình duyệt và trên cloud: Bạn có thể scrape ngay trong trình duyệt (rất hợp với site cần đăng nhập) hoặc trên cloud (cực nhanh cho dữ liệu công khai).
- Xử lý nội dung động: AI của Thunderbit điều khiển trình duyệt thật — nên có thể xử lý infinite scroll, popup, đăng nhập và nhiều thứ khác.
- Xuất dữ liệu ở mọi nơi: Tải xuống Excel, Google Sheets, Airtable, Notion, hoặc chỉ cần copy vào clipboard.
- Không cần bảo trì: Nếu website thay đổi, chỉ cần chạy lại gợi ý AI. Không còn những đêm khuya ngồi gỡ lỗi.
- Lập lịch và tự động hóa: Thiết lập scraper chạy theo lịch — không cần cron job, không phải setup server.
- Extractor chuyên dụng: Cần email, số điện thoại hay hình ảnh? Thunderbit cũng có extractor một chạm cho những thứ đó.
Và điều tuyệt nhất là gì? Bạn không cần biết một dòng code nào cả. Thunderbit được xây cho người dùng doanh nghiệp, marketer, team sales, chuyên viên bất động sản — bất kỳ ai cần dữ liệu nhanh.
Muốn xem Thunderbit hoạt động thế nào? Tải Chrome Extension hoặc xem kênh YouTube của chúng tôi để xem demo.
Thử Thunderbit Agentic Web Scraper miễn phí Bỏ qua hoàn toàn cuộc tranh luận về ngôn ngữ: agentic web scraper của Thunderbit đọc bất kỳ trang nào và trích xuất dữ liệu chỉ với một cú nhấp, không cần code. Get Started Free
Kết Luận: Chọn Ngôn Ngữ Tốt Nhất Cho Web Scraping Trong Năm 2026
Xem Agentic Web Scraping khác gì so với code AI của Thunderbit đọc trang và tự chọn các trường dữ liệu, làm chỉ với một cú nhấp những gì một script scraping phải mất hàng giờ để viết. Get Started Free
Web scraping trong năm 2026 dễ tiếp cận hơn — và mạnh mẽ hơn — bao giờ hết. Đây là những gì tôi rút ra sau nhiều năm lăn lộn với tự động hóa:
- Python vẫn là ngôn ngữ tốt nhất cho web scraping nếu bạn muốn bắt đầu nhanh và có vô số tài nguyên hỗ trợ.
- JavaScript/Node.js là lựa chọn khó bị vượt qua khi scraping website động, nhiều JavaScript.
- Ruby và PHP rất hợp cho script ngắn và tích hợp web, nhất là khi bạn đã dùng sẵn chúng.
- C++ và Go là bạn đồng hành khi bạn cần tốc độ và khả năng mở rộng.
- Java là lựa chọn quen thuộc cho các dự án doanh nghiệp, dài hạn.
- Và nếu bạn muốn bỏ qua code hoàn toàn? Thunderbit chính là vũ khí bí mật của bạn.
Trước khi bắt tay vào làm, hãy tự hỏi:
- Dự án của tôi lớn đến đâu?
- Tôi có cần xử lý nội dung động không?
- Mức độ thoải mái của tôi với kỹ thuật là bao nhiêu?
- Tôi muốn tự xây, hay chỉ cần lấy dữ liệu?
Hãy thử một đoạn code ở trên, hoặc dùng thử Thunderbit cho dự án tiếp theo của bạn. Và nếu muốn đi sâu hơn, hãy xem Thunderbit Blog để đọc thêm hướng dẫn, mẹo và những câu chuyện scraping thực tế.
Chúc bạn scraping vui vẻ — và mong dữ liệu của bạn luôn sạch sẽ, có cấu trúc, và chỉ cách một cú nhấp chuột.
P.S. Nếu một ngày nào đó bạn thấy mình bị kẹt trong “hố thỏ” web scraping lúc 2 giờ sáng, hãy nhớ: luôn có Thunderbit. Hoặc cà phê. Hoặc cả hai.
Thử Thunderbit Agentic Web Scraper ngay Get Started Free
Câu hỏi thường gặp
1. Ngôn ngữ lập trình nào tốt nhất cho web scraping trong năm 2026?
Python vẫn là lựa chọn hàng đầu nhờ cú pháp dễ đọc, thư viện mạnh (như BeautifulSoup, Scrapy và Selenium), cùng cộng đồng rất lớn. Nó lý tưởng cho cả người mới lẫn người dùng chuyên nghiệp, đặc biệt khi kết hợp scraping với phân tích dữ liệu.
2. Ngôn ngữ nào tốt nhất để scrape website nặng JavaScript?
JavaScript (Node.js) là lựa chọn hàng đầu cho các site động. Những công cụ như Puppeteer và Playwright cho bạn quyền kiểm soát trình duyệt đầy đủ, giúp tương tác với nội dung được tải qua React, Vue hoặc Angular.
3. Có lựa chọn không cần code cho web scraping không?
Có — Thunderbit là một agentic web scraper không cần code, xử lý mọi thứ từ nội dung động đến lập lịch. Chỉ cần bấm “One Click Extract” là bắt đầu scrape. Đây là lựa chọn rất phù hợp cho team sales, marketing hoặc operations cần dữ liệu có cấu trúc thật nhanh.
4. Tôi có còn cần chọn ngôn ngữ nếu một AI coding agent có thể viết scraper cho tôi không?
Một câu hỏi rất hợp lý trong năm 2026. Các công cụ như Claude Code, Cursor và OpenAI Codex có thể tạo ra Scrapy spider, Playwright script hoặc Go + Colly crawler chỉ từ một prompt ngắn vài câu — nên “rào cản chọn ngôn ngữ đầu tiên” thực sự đã thấp hơn hai năm trước rất nhiều. Nhưng agent vẫn sẽ xuất code bằng một ngôn ngữ nào đó, và bạn (hoặc người tiếp quản dự án) cuối cùng vẫn phải đọc, debug và triển khai nó. Vì vậy, lựa chọn ngôn ngữ vẫn quan trọng; chỉ là giờ nó ảnh hưởng nhiều hơn đến khả năng bảo trì hơn là 30 dòng code đầu tiên. Nếu bạn không muốn động vào code chút nào, đó là lúc Thunderbit phát huy tác dụng — nó bỏ qua luôn câu hỏi về ngôn ngữ.
Tìm hiểu thêm:




