
Link hỏng. Trang mồ côi. Một trang “test” từ năm 2019 mà không hiểu sao Google vẫn index được. Nếu bạn quản lý website, chắc hẳn bạn quá hiểu cái cảnh này.
Một trình crawl tốt sẽ quét ra hết những vấn đề đó — đồng thời phác lại toàn bộ cấu trúc site để bạn biết chính xác cần sửa gì. Nhưng nhiều người lại hay nhầm giữa “web crawler” và “web scraper”. Hai khái niệm này hoàn toàn không giống nhau.
Tôi đã test 10 công cụ crawl miễn phí trên các website thực tế. Có công cụ rất mạnh cho audit SEO. Có công cụ lại hợp hơn cho việc trích xuất dữ liệu. Dưới đây là những gì hiệu quả — và những gì không.
Website Crawler Là Gì? Hiểu Đúng Từ Những Khái Niệm Cơ Bản
Trước hết, cần làm rõ một điều: website crawler không phải là web scraper. Tôi biết, hai thuật ngữ này thường bị dùng lẫn lộn như bột làm pizza, nhưng bản chất của chúng khác nhau hoàn toàn. Hãy hình dung crawler như người vẽ bản đồ cho website của bạn — nó đi khắp từng ngóc ngách, lần theo mọi liên kết và dựng lên sơ đồ của toàn bộ trang. Nhiệm vụ của nó là khám phá: tìm URL, vẽ cấu trúc site và lập chỉ mục nội dung. Đây chính là cách các công cụ tìm kiếm như Google dùng bot của họ, và cũng là cách các công cụ SEO kiểm tra tình trạng website (Thunderbit Blog: What Is a Web Crawler?).
Ngược lại, web scraper là người “đào” dữ liệu. Nó không quan tâm đến cả tấm bản đồ — nó chỉ muốn lấy phần “vàng”: giá sản phẩm, tên công ty, đánh giá, email, và nhiều thứ khác. Scraper sẽ trích xuất những trường dữ liệu cụ thể từ các trang mà crawler tìm ra (Thunderbit Blog: How to Web Crawl a Site?).
Ví dụ dễ hiểu:
- Crawler: Người đi qua từng lối trong siêu thị, ghi lại toàn bộ mặt hàng có trên kệ.
- Scraper: Người đi thẳng đến quầy cà phê và chép giá của từng loại cà phê hữu cơ.
Vì sao điều này quan trọng? Vì nếu bạn chỉ muốn tìm tất cả các trang trên website của mình (để audit SEO chẳng hạn), bạn cần crawler. Nếu bạn muốn lấy toàn bộ giá sản phẩm từ website đối thủ, bạn cần scraper — hoặc tốt nhất là một công cụ làm được cả hai.
Vì Sao Nên Dùng Web Crawler Online? Lợi Ích Kinh Doanh Quan Trọng
Vậy tại sao phải dùng web crawler? Đơn giản là vì web ngày càng phình to chứ không hề nhỏ lại. Thực tế, hơn 54% thương hiệu doanh nghiệp dùng nền tảng crawl chuyên dụng để tối ưu website, và một số công cụ SEO còn crawl tới 7 tỷ trang mỗi ngày.
Crawler có thể giúp bạn:
- Audit SEO: Tìm link hỏng, tiêu đề bị thiếu, nội dung trùng lặp, trang mồ côi, v.v. (SEO.ai).
- Kiểm tra link & QA: Phát hiện lỗi 404 và vòng lặp chuyển hướng trước khi người dùng gặp phải (Screaming Frog).
- Tạo sitemap: Tự động tạo XML sitemap cho công cụ tìm kiếm và cho việc lập kế hoạch (PowerMapper).
- Kiểm kê nội dung: Lập danh sách toàn bộ trang, thứ bậc cấu trúc và metadata.
- Tuân thủ & khả năng truy cập: Kiểm tra từng trang theo tiêu chuẩn WCAG, SEO và pháp lý (SiteOne Crawler).
- Hiệu năng & bảo mật: Gắn cờ các trang chậm, ảnh quá nặng hoặc vấn đề bảo mật (SiteOne Crawler).
- Dữ liệu cho AI & phân tích: Đưa dữ liệu crawl được vào các công cụ phân tích hoặc AI (Thunderbit Blog: Crawl4AI Review).
Dưới đây là bảng nhanh ghép các trường hợp sử dụng với vai trò trong doanh nghiệp:
| Trường hợp sử dụng | Phù hợp nhất với | Lợi ích / Kết quả |
|---|---|---|
| Audit SEO & Website | Marketing, SEO, chủ doanh nghiệp nhỏ | Phát hiện vấn đề kỹ thuật, tối ưu cấu trúc, cải thiện thứ hạng |
| Kiểm kê nội dung & QA | Quản lý nội dung, webmaster | Audit hoặc di chuyển nội dung, bắt link/ảnh hỏng |
| Tạo lead (Scraping) | Sales, phát triển kinh doanh | Tự động tìm khách tiềm năng, đổ dữ liệu mới vào CRM |
| Tình báo cạnh tranh | Thương mại điện tử, quản lý sản phẩm | Theo dõi giá đối thủ, sản phẩm mới, thay đổi tồn kho |
| Sao chép sitemap & cấu trúc | Lập trình viên, DevOps, tư vấn | Nhân bản cấu trúc site cho redesign hoặc backup |
| Tổng hợp nội dung | Nhà nghiên cứu, truyền thông, phân tích | Gom dữ liệu từ nhiều site để phân tích hoặc theo dõi xu hướng |
| Nghiên cứu thị trường | Nhà phân tích, đội huấn luyện AI | Thu thập bộ dữ liệu lớn cho phân tích hoặc train mô hình AI |
(Thunderbit Blog: How to Web Crawl a Site?)
Cách Chúng Tôi Chọn Ra Những Công Cụ Crawl Website Miễn Phí Tốt Nhất
Tôi đã trải qua không ít đêm muộn (và uống nhiều cà phê hơn mức cần thiết) để đào sâu vào các công cụ crawl, đọc tài liệu và chạy thử nghiệm. Đây là những tiêu chí tôi dùng:
- Năng lực kỹ thuật: Có xử lý được website hiện đại không (JavaScript, đăng nhập, nội dung động)?
- Tính dễ dùng: Có thân thiện với người không rành kỹ thuật không, hay phải biết dùng dòng lệnh?
- Giới hạn bản miễn phí: Có thực sự miễn phí hay chỉ là bản dùng thử để “dụ” người dùng?
- Khả năng truy cập online: Đây là công cụ cloud, ứng dụng desktop hay thư viện code?
- Tính năng nổi bật: Có điểm gì đặc biệt không — như trích xuất bằng AI, sitemap trực quan hay crawl theo sự kiện?
Tôi test từng công cụ, xem phản hồi người dùng và so sánh tính năng song song. Nếu một công cụ khiến tôi chỉ muốn ném laptop ra cửa sổ, nó sẽ không có mặt trong danh sách.
Bảng So Sánh Nhanh: 10 Website Crawler Miễn Phí Tốt Nhất
| Công cụ & loại | Tính năng cốt lõi | Trường hợp phù hợp nhất | Yêu cầu kỹ thuật | Chi tiết gói miễn phí |
|---|---|---|---|---|
| Bright Data (Cloud/API) | Crawl cấp doanh nghiệp, proxy, render JS, giải CAPTCHA | Thu thập dữ liệu quy mô lớn | Cần một số kiến thức kỹ thuật | Gói miễn phí: 5.000 bản ghi/tháng trên Web Scraper API, không cần thẻ tín dụng |
| Crawlbase (Cloud/API) | Crawl qua API, chống bot, proxy, render JS | Developer cần hạ tầng crawl phía backend | Tích hợp API | Miễn phí: tối đa 20.000 request để bắt đầu, không cần thẻ tín dụng; sau đó trả theo request |
| ScraperAPI (Cloud/API) | Xoay proxy, render JS, crawl bất đồng bộ, endpoint dựng sẵn | Developer, theo dõi giá, dữ liệu SEO | Thiết lập tối thiểu | Miễn phí: 5.000 API call trong 7 ngày, sau đó 1.000/tháng |
| Diffbot Crawlbot (Cloud) | Crawl + trích xuất bằng AI, knowledge graph, render JS | Dữ liệu có cấu trúc ở quy mô lớn, AI/ML | Tích hợp API | Miễn phí: 10.000 credit/tháng cho các API trích xuất; Crawl cần gói Plus |
| Screaming Frog (Desktop) | Audit SEO, phân tích link/meta, sitemap, trích xuất tùy chỉnh | Audit SEO, quản lý website | Ứng dụng desktop, giao diện GUI | Miễn phí: 500 URL mỗi lượt crawl, chỉ có tính năng cơ bản |
| SiteOne Crawler (Desktop) | SEO, hiệu năng, khả năng truy cập, bảo mật, xuất offline, Markdown | Developer, QA, migration, tài liệu hóa | Desktop/CLI, GUI | Miễn phí & mã nguồn mở, báo cáo GUI 1.000 URL (có thể cấu hình) |
| Crawljax (Java, OpenSrc) | Crawl theo sự kiện cho site nặng JS, xuất tĩnh | Developer, QA cho ứng dụng web động | Java, CLI/cấu hình | Miễn phí & mã nguồn mở, không giới hạn |
| Apache Nutch (Java, OpenSrc) | Phân tán, theo plugin, tích hợp Hadoop, search tùy chỉnh | Công cụ tìm kiếm riêng, crawl quy mô lớn | Java, dòng lệnh | Miễn phí & mã nguồn mở, chỉ tốn hạ tầng |
| YaCy (Java, OpenSrc) | Crawl & search peer-to-peer, riêng tư, index web/intranet | Tìm kiếm riêng, phi tập trung | Java, giao diện trình duyệt | Miễn phí & mã nguồn mở, không giới hạn |
| PowerMapper (Desktop/SaaS) | Sitemap trực quan, accessibility, QA, tương thích trình duyệt | Agency, QA, mapping trực quan | GUI, dễ dùng | Dùng thử miễn phí: 30 ngày, 100 trang (desktop) hoặc 10 trang (online) mỗi lượt quét |
Trước khi bạn đọc tiếp, có một điểm cần lưu ý: “miễn phí” trong cột cuối cùng ở trên có nhiều ý nghĩa rất khác nhau. SiteOne, Crawljax, Nutch và YaCy là mã nguồn mở — miễn phí, không có giới hạn ngoài phần cứng của bạn. Screaming Frog miễn phí vĩnh viễn, nhưng giới hạn 500 URL mỗi lần crawl. Bright Data, ScraperAPI và Diffbot có các gói free tier thực sự dùng được nhưng khá nhỏ; riêng với Diffbot, phần crawler lại không nằm trong gói miễn phí. Crawlbase cho bạn một lượng request miễn phí ban đầu rồi tính phí theo request. PowerMapper là công cụ chỉ có trial thuần túy trong danh sách này — hết 30 ngày là phải trả tiền.
Bright Data: Website Crawler Đám Mây Cấp Doanh Nghiệp
Bright Data là “cỗ máy hạng nặng” trong thế giới crawl web. Đây là một nền tảng cloud với mạng proxy khổng lồ, khả năng render JavaScript, giải CAPTCHA và một IDE để tùy chỉnh crawl. Nếu bạn đang làm thu thập dữ liệu quy mô lớn — ví dụ theo dõi hàng trăm website thương mại điện tử để cập nhật giá — thì hạ tầng của Bright Data rất khó bị vượt qua (aimultiple.com).
Điểm mạnh:
- Xử lý tốt các website có cơ chế chống bot
- Mở rộng tốt cho nhu cầu doanh nghiệp
- Có template dựng sẵn cho các website phổ biến
Hạn chế:
- Bản miễn phí có thật nhưng khá nhỏ: 5.000 bản ghi mỗi tháng trên Web Scraper API
- Có thể quá “nặng đô” với các audit đơn giản
- Người không chuyên kỹ thuật sẽ cần làm quen một chút
Nếu bạn cần crawl web ở quy mô lớn, Bright Data giống như thuê một chiếc xe Formula 1. Gói miễn phí 5.000 bản ghi/tháng chỉ đủ để chạy vài vòng quanh khu phố; vượt quá sẽ bị tính phí theo mức sử dụng (Bright Data Pricing).
Crawlbase: Web Crawler Dựa Trên API Cho Developer
Crawlbase (trước đây là ProxyCrawl) tập trung vào crawl theo kiểu lập trình. Bạn gửi URL qua API của họ, rồi hệ thống trả về HTML — đồng thời tự lo proxy, geotargeting và CAPTCHA ở phía sau (Capterra).
Điểm mạnh:
- Tỷ lệ thành công rất cao (99%+)
- Xử lý tốt website nhiều JavaScript
- Phù hợp để tích hợp vào app hoặc workflow riêng
Hạn chế:
- Cần tích hợp API hoặc SDK ở mức nhất định
- Gói miễn phí: tối đa 20.000 request để bắt đầu (không cần thẻ tín dụng), sau đó tính phí theo request
Nếu bạn là developer muốn crawl (và có thể scrape) ở quy mô lớn mà không phải tự quản lý proxy, Crawlbase là một lựa chọn rất ổn (Crawlbase Pricing).
ScraperAPI: Đơn Giản Hóa Việc Crawl Website Động
ScraperAPI là kiểu API “cứ để tôi lo phần fetch cho bạn”. Bạn đưa cho nó một URL, nó sẽ xử lý proxy, headless browser và các biện pháp chống bot, rồi trả lại HTML (hoặc dữ liệu có cấu trúc với một số website). Công cụ này đặc biệt hiệu quả với các trang động, dù phần “miễn phí” khá khiêm tốn: 5.000 credit API trong 7 ngày đầu, không cần thẻ, sau đó là 1.000 credit/tháng trên gói free đang duy trì (ScraperAPI Pricing).
Điểm mạnh:
- Rất dễ cho developer (chỉ cần gọi API)
- Xử lý được CAPTCHA, chặn IP, JavaScript
- Miễn phí: 5.000 API call trong 7 ngày, sau đó 1.000/tháng
Hạn chế:
- Không có báo cáo crawl trực quan
- Nếu muốn lần theo link, bạn sẽ cần tự viết logic crawl
Nếu bạn muốn tích hợp web crawling vào codebase trong vài phút, ScraperAPI là lựa chọn quá hợp lý.
Diffbot Crawlbot: Khám Phá Cấu Trúc Website Tự Động
Diffbot Crawlbot là lúc mọi thứ trở nên “thông minh” hơn. Nó không chỉ crawl — nó dùng AI để phân loại trang và trích xuất dữ liệu có cấu trúc (bài viết, sản phẩm, sự kiện, v.v.) sang JSON. Cứ như thể bạn có một thực tập sinh robot thật sự hiểu mình đang đọc gì (Diffbot Free Plan).
Điểm mạnh:
- Trích xuất bằng AI, không chỉ crawl đơn thuần
- Xử lý JavaScript và nội dung động tốt
- Miễn phí: 10.000 credit/tháng, không cần thẻ tín dụng, bao gồm Extract, Natural Language, Knowledge Graph và Search
Hạn chế:
- Thiên về developer (cần tích hợp API)
- Không phải công cụ SEO trực quan — hợp hơn cho dự án dữ liệu
- Phần Crawlbot — tức phần đi spider toàn bộ site — nằm ở gói Plus trở lên; credit miễn phí chỉ áp dụng cho các API trích xuất (Diffbot Pricing)
Nếu bạn cần dữ liệu có cấu trúc ở quy mô lớn, đặc biệt cho AI hoặc phân tích, Diffbot là một “cỗ máy” thực thụ.
Screaming Frog: Crawler SEO Desktop Miễn Phí
Screaming Frog là công cụ crawl desktop kinh điển dành cho audit SEO. Bản miễn phí crawl tối đa 500 URL mỗi lần quét và cung cấp gần như đầy đủ: link hỏng, meta tag, nội dung trùng lặp, sitemap và nhiều hơn nữa (Screaming Frog User Guide).
Điểm mạnh:
- Nhanh, chi tiết và được giới SEO tin dùng
- Không cần code — chỉ cần nhập URL và chạy
- Miễn phí cho tối đa 500 URL mỗi lượt crawl
Hạn chế:
- Chỉ có bản desktop (không có cloud)
- Tính năng nâng cao (render JS, lên lịch) cần license trả phí
Nếu bạn làm SEO nghiêm túc, Screaming Frog gần như là món phải có — chỉ là đừng kỳ vọng nó crawl miễn phí cả website 10.000 trang của bạn.
SiteOne Crawler: Xuất Site Tĩnh và Tài Liệu Hóa
SiteOne Crawler giống như con dao đa năng Thụy Sĩ dành cho audit kỹ thuật. Đây là dự án mã nguồn mở, đa nền tảng, có thể crawl, audit, và thậm chí xuất website sang Markdown để làm tài liệu hoặc dùng offline (SiteOne Crawler).
Điểm mạnh:
- Bao phủ SEO, hiệu năng, khả năng truy cập và bảo mật
- Xuất site để lưu trữ hoặc di chuyển hệ thống
- Miễn phí & mã nguồn mở, không giới hạn sử dụng
Hạn chế:
- Kỹ thuật hơn so với một số công cụ GUI khác
- Báo cáo audit trong GUI giới hạn mặc định 1.000 URL (có thể cấu hình)
Nếu bạn là developer, QA hoặc consultant cần insight sâu (và thích mã nguồn mở), SiteOne là một “viên ngọc ẩn”.
Crawljax: Web Crawler Java Mã Nguồn Mở Cho Trang Động
Crawljax là một công cụ chuyên biệt: nó được thiết kế để crawl các ứng dụng web hiện đại, nặng JavaScript, bằng cách mô phỏng hành vi người dùng (click, điền form, v.v.). Nó hoạt động theo hướng sự kiện và thậm chí có thể xuất ra phiên bản tĩnh của một site động (Wikipedia: Crawljax).
Điểm mạnh:
- Rất mạnh với SPA và các site nhiều AJAX
- Mã nguồn mở, dễ mở rộng
- Không giới hạn sử dụng
Hạn chế:
- Cần Java và một chút lập trình/cấu hình
- Không phù hợp với người không rành kỹ thuật
Nếu bạn cần crawl một ứng dụng React hoặc Angular như một người dùng thật, Crawljax là người bạn đáng tin.
Apache Nutch: Website Crawler Phân Tán Có Khả Năng Mở Rộng Cao
Apache Nutch là “lão làng” trong thế giới crawler mã nguồn mở. Nó được thiết kế cho các cuộc crawl khổng lồ, phân tán — như xây dựng công cụ tìm kiếm riêng hoặc index hàng triệu trang (Martechvibe).
Điểm mạnh:
- Mở rộng tới hàng tỷ trang khi kết hợp với Hadoop
- Cấu hình linh hoạt và khả năng mở rộng cao
- Miễn phí & mã nguồn mở
Hạn chế:
- Đường cong học tập khá dốc (Java, dòng lệnh, cấu hình)
- Không phù hợp cho site nhỏ hoặc người dùng phổ thông
Nếu bạn muốn crawl web ở quy mô lớn và không ngại làm việc với dòng lệnh, Nutch là công cụ dành cho bạn.
YaCy: Web Crawler Và Công Cụ Tìm Kiếm P2P
YaCy là một crawler và search engine phi tập trung rất độc đáo. Mỗi instance sẽ crawl và index website, rồi bạn có thể tham gia vào mạng peer-to-peer để chia sẻ index với người khác (TechRadar: YaCy).
Điểm mạnh:
- Ưu tiên quyền riêng tư, không cần server trung tâm
- Rất phù hợp để tạo công cụ tìm kiếm nội bộ hoặc riêng tư
- Miễn phí & mã nguồn mở
Hạn chế:
- Kết quả phụ thuộc vào phạm vi phủ của mạng
- Cần thiết lập ban đầu (Java, giao diện trình duyệt)
Nếu bạn hứng thú với phi tập trung hoặc muốn tự xây search engine, YaCy là một lựa chọn rất thú vị.
PowerMapper: Công Cụ Tạo Sitemap Trực Quan Cho UX Và QA
PowerMapper tập trung vào việc trực quan hóa cấu trúc website. Công cụ này crawl site của bạn rồi tạo sitemap tương tác, đồng thời kiểm tra khả năng truy cập, tương thích trình duyệt và những yếu tố SEO cơ bản (Slickplan Review).
Điểm mạnh:
- Sitemap trực quan rất hữu ích cho agency và designer
- Kiểm tra accessibility và tuân thủ
- Giao diện GUI dễ dùng, không cần nhiều kiến thức kỹ thuật
Hạn chế:
- Chỉ có bản dùng thử miễn phí (30 ngày, 100 trang cho desktop / 10 trang online mỗi lần quét)
- Bản đầy đủ là trả phí
Nếu bạn cần trình bày sitemap cho khách hàng hoặc kiểm tra tuân thủ, PowerMapper là công cụ rất tiện.
Chọn Web Crawler Miễn Phí Phù Hợp Với Nhu Cầu Của Bạn
Có quá nhiều lựa chọn thì chọn sao đây? Đây là gợi ý nhanh của tôi:
- Cho audit SEO: Screaming Frog (site nhỏ), PowerMapper (trực quan), SiteOne (audit sâu)
- Cho ứng dụng web động: Crawljax
- Cho search tùy chỉnh hoặc quy mô lớn: Apache Nutch, YaCy
- Cho developer cần API: Crawlbase, ScraperAPI, Diffbot
- Cho tài liệu hóa hoặc lưu trữ: SiteOne Crawler
- Cho nhu cầu cấp doanh nghiệp với free tier nhỏ nhưng có thật: Bright Data, Diffbot
Các yếu tố quan trọng cần cân nhắc:
- Khả năng mở rộng: Website hoặc job crawl của bạn lớn đến đâu?
- Tính dễ dùng: Bạn quen code hay muốn thao tác bằng click chuột?
- Xuất dữ liệu: Bạn cần CSV, JSON hay tích hợp với công cụ khác?
- Hỗ trợ: Có cộng đồng hoặc tài liệu hướng dẫn nếu bạn gặp vấn đề không?
Khi Web Crawling Gặp Web Scraping: Vì Sao Thunderbit Là Lựa Chọn Thông Minh Hơn
Trích xuất dữ liệu từ bất kỳ website nào bằng AI Thunderbit's agentic web scraper đọc bất kỳ website nào bạn cần crawl và trích xuất dữ liệu có cấu trúc chỉ với một cú nhấp — miễn phí 6 trang mỗi tháng. Get Started Free
Thực tế là: đa số người dùng không crawl website chỉ để vẽ cho đẹp. Mục tiêu thật sự thường là lấy dữ liệu có cấu trúc — dù đó là danh sách sản phẩm, thông tin liên hệ hay kiểm kê nội dung. Đó là lúc Thunderbit phát huy tác dụng.
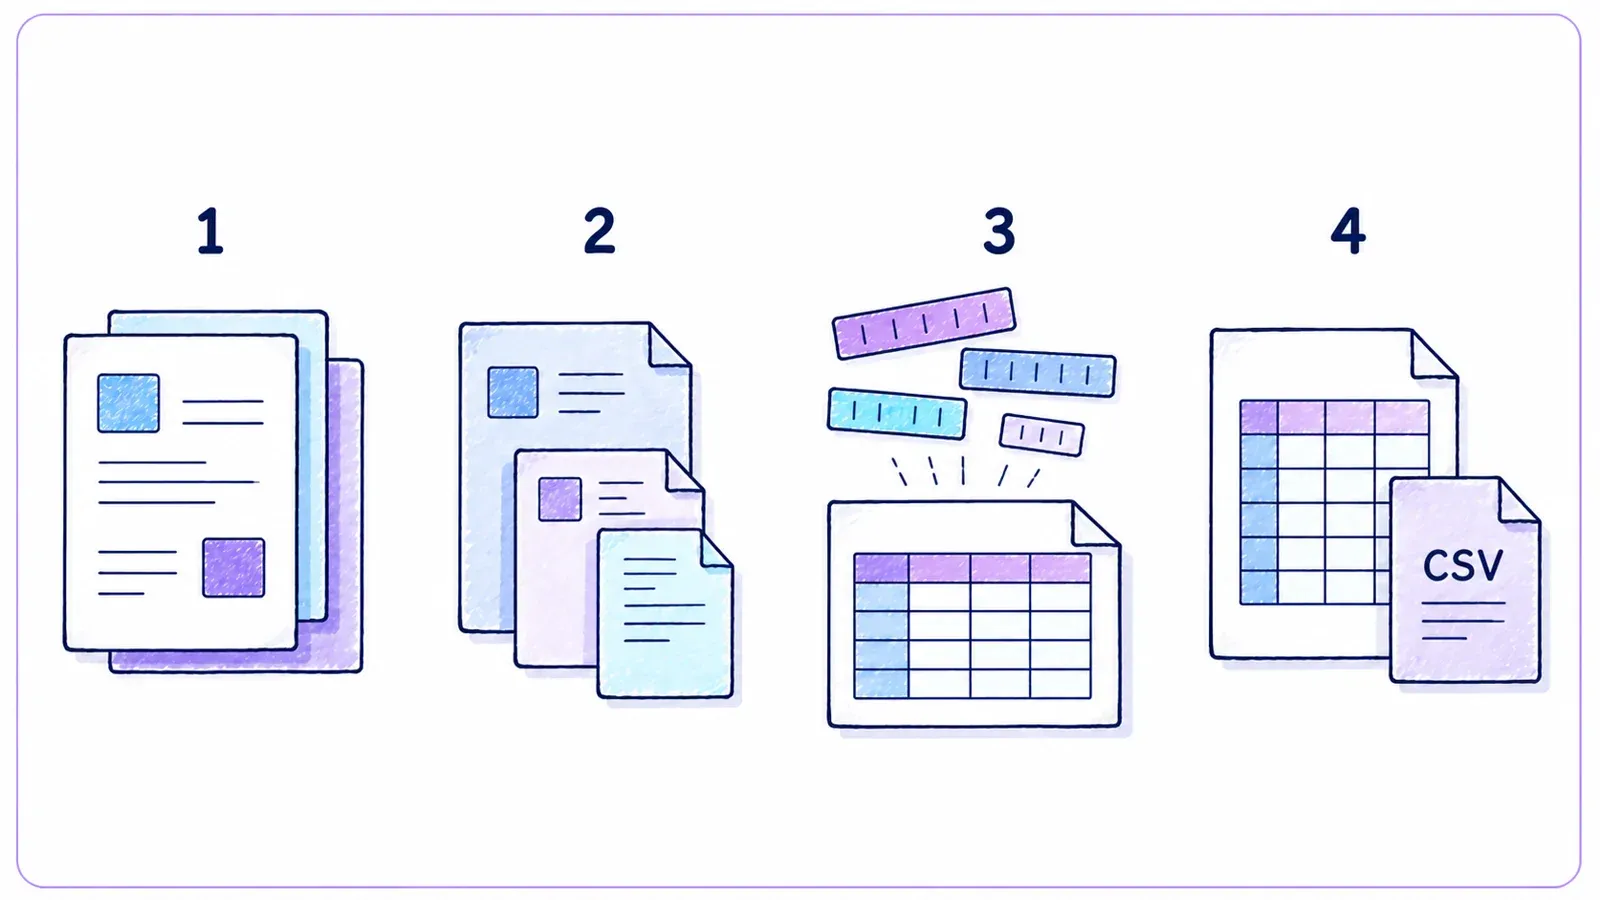
Thunderbit không chỉ là crawler hay scraper — mà là một tiện ích Chrome ứng dụng AI, kết hợp cả hai. Cách hoạt động:
- AI Crawler: Thunderbit khám phá website giống như một crawler.
- Waterfall Crawling: Nếu engine của Thunderbit không lấy được trang (ví dụ gặp lớp chặn anti-bot khó xử lý), nó sẽ tự động chuyển sang các dịch vụ crawl bên thứ ba — không cần bạn thiết lập thủ công.
- AI Data Structuring: Khi đã có HTML, AI của Thunderbit sẽ gợi ý đúng cột dữ liệu và trích xuất dữ liệu có cấu trúc (tên, giá, email, v.v.) mà không cần bạn viết selector nào.
- Subpage Scraping: Bạn cần lấy chi tiết từ từng trang sản phẩm? Thunderbit có thể tự động truy cập từng trang con và làm giàu bảng dữ liệu của bạn.
- Làm sạch & xuất dữ liệu: Công cụ có thể tóm tắt, phân loại, dịch và xuất dữ liệu sang Excel, Google Sheets, Airtable hoặc Notion chỉ với một cú nhấp.
- No-code dễ dùng: Chỉ cần biết dùng trình duyệt là bạn đã dùng được Thunderbit. Không cần code, không cần proxy, không đau đầu.
Khi nào nên dùng Thunderbit thay vì crawler truyền thống?
- Khi mục tiêu cuối cùng của bạn là một bảng dữ liệu sạch, dễ dùng — chứ không chỉ là danh sách URL.
- Khi bạn muốn tự động hóa toàn bộ quy trình (crawl, trích xuất, làm sạch, xuất dữ liệu) ở cùng một nơi.
- Khi bạn coi trọng thời gian và sự tỉnh táo của mình.
Bạn có thể tải tiện ích Chrome của Thunderbit tại đây và tự mình xem vì sao ngày càng nhiều người dùng doanh nghiệp chuyển sang dùng nó.
Dùng thử Thunderbit miễn phí – Agentic Web Scraper Cài tiện ích Chrome miễn phí và bắt đầu crawl bất kỳ website nào chỉ với một cú nhấp, không cần code. Get Started Free
Kết Luận: Tận Dụng Tối Đa Website Crawler Miễn Phí
Xem cách AI Web Scraping hoạt động AI của Thunderbit đọc trang giống như một con người và tự quyết định cần trích xuất gì, thay thế việc cấu hình crawler thủ công. Get Started Free
Website crawler đã tiến rất xa. Dù bạn là marketer, developer, hay chỉ đơn giản là người muốn website của mình luôn khỏe mạnh, vẫn luôn có một công cụ miễn phí — hoặc ít nhất là cho dùng thử miễn phí — dành cho bạn. Từ các nền tảng cấp doanh nghiệp như Bright Data và Diffbot, đến những dự án mã nguồn mở như SiteOne và Crawljax, đến các công cụ tạo sitemap trực quan như PowerMapper, lựa chọn ngày nay đa dạng hơn bao giờ hết.
Nhưng nếu bạn đang tìm một cách thông minh và liền mạch hơn để đi từ “tôi cần dữ liệu này” đến “đây là file spreadsheet của tôi”, hãy thử Thunderbit. Công cụ này được xây dựng cho người dùng doanh nghiệp muốn có kết quả thực tế, không chỉ là báo cáo.
Sẵn sàng bắt đầu crawl chưa? Hãy tải một công cụ, chạy thử một lượt quét và xem bạn đang bỏ lỡ điều gì. Và nếu bạn muốn đi từ crawling đến dữ liệu hành động chỉ trong một cú nhấp, hãy xem Thunderbit.
Để đọc thêm các bài phân tích chuyên sâu và hướng dẫn thực chiến, hãy ghé Thunderbit Blog.
Trích xuất dữ liệu website bằng AI chỉ với một cú nhấp Thiết lập Thunderbit để tự động theo dõi các trang con và chạy theo lịch, ताकि dữ liệu crawl luôn mới mà không cần chạy lại thủ công. Get Started Free
Dùng thử Agentic Web Scraper Get Started Free
FAQ
Sự khác nhau giữa website crawler và web scraper là gì?
Crawler sẽ khám phá và vẽ bản đồ tất cả các trang trên site (tưởng tượng như xây mục lục). Scraper sẽ trích xuất những trường dữ liệu cụ thể (như giá, email hoặc đánh giá) từ các trang đó. Crawler dùng để tìm, scraper dùng để lấy (Thunderbit Blog: What Is a Web Crawler?).
Website crawler miễn phí nào tốt nhất cho người không rành kỹ thuật?
Với site nhỏ và audit SEO, Screaming Frog khá thân thiện. Nếu muốn map trực quan, PowerMapper rất ổn trong thời gian dùng thử. Thunderbit là lựa chọn dễ nhất nếu mục tiêu của bạn là dữ liệu có cấu trúc và bạn muốn trải nghiệm no-code trên trình duyệt.
Có website nào chặn web crawler không?
Có — một số website dùng robots.txt hoặc các biện pháp chống bot như CAPTCHA hay chặn IP để ngăn crawler. Các công cụ như ScraperAPI, Crawlbase và Thunderbit (với waterfall crawling) thường có thể vượt qua những rào cản này, nhưng bạn luôn phải crawl có trách nhiệm và tôn trọng quy định của website (Bright Data Pricing).
Công cụ crawl website miễn phí có giới hạn trang hoặc tính năng không?
Phần lớn là có. Ví dụ, bản miễn phí của Screaming Frog giới hạn 500 URL mỗi lượt crawl; trial của PowerMapper là 100 trang. Các công cụ dựa trên API thường có giới hạn credit theo tháng. Các công cụ mã nguồn mở như SiteOne hoặc Crawljax thường không có giới hạn cứng, nhưng sẽ phụ thuộc vào phần cứng của bạn.
Dùng web crawler có hợp pháp và đảm bảo quyền riêng tư không?
Nhìn chung, crawl các trang web công khai là hợp pháp, nhưng bạn luôn nên kiểm tra điều khoản sử dụng và robots.txt của website. Đừng crawl dữ liệu riêng tư hoặc có mật khẩu nếu chưa được phép, và hãy lưu ý các quy định về quyền riêng tư nếu bạn đang trích xuất dữ liệu cá nhân (Crawlbase Guide).



