
Quý trước, đội vận hành của chúng tôi đã mất 40 giờ mỗi tuần để copy-paste dữ liệu đối thủ vào bảng tính. Quý này, công việc đó chỉ còn 20 phút.
Khác biệt nằm ở đâu? Ở các công cụ web scraping tự động. Chúng đã chuyển từ món đồ dành riêng cho developer thành thứ mà bất kỳ nhân viên sales hay marketer nào cũng có thể thiết lập trong giờ nghỉ trưa.
Tôi đã xây dựng các công cụ SaaS và tự động hóa trong nhiều năm (và đúng vậy, tôi là đồng sáng lập Thunderbit). Làn sóng công cụ năm 2026 là mạnh nhất từ trước đến nay — native AI, tự phục hồi khi website đổi giao diện, và thực sự hữu ích cho người không rành kỹ thuật.
Dưới đây là 10 công cụ tôi đã trực tiếp đánh giá, so sánh theo từng nhu cầu và trình độ sử dụng.
Vì sao công cụ web scraping tự động quan trọng với người dùng doanh nghiệp
Nói thẳng nhé: thời phải thủ công copy-paste dữ liệu từ website đã qua rồi (trừ khi bạn thích đau cổ tay và cảm giác tuyệt vọng hiện sinh). Công cụ web scraping tự động giờ đã trở thành một phần không thể thiếu với doanh nghiệp ở mọi quy mô. Thực tế, hơn 97% tổ chức hiện đang đầu tư vào các sáng kiến dữ liệu lớn và AI, và web scraping là một mảnh ghép quan trọng trong chiến lược đó.
Đây là lý do những công cụ này cực kỳ giá trị:
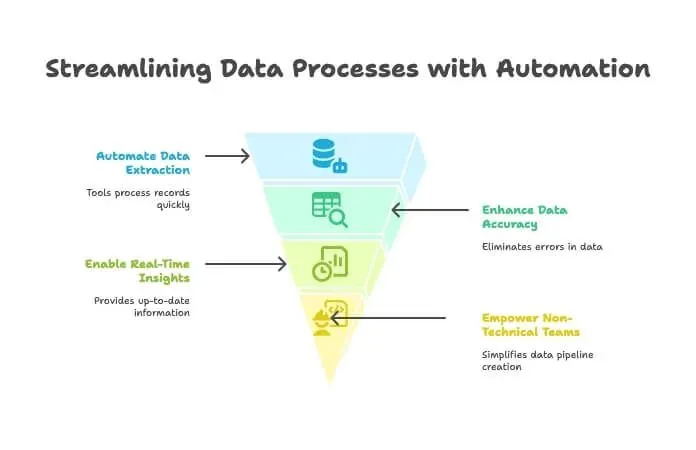
- Tiết kiệm thời gian và giảm việc thủ công: Các công cụ scrape tự động có thể xử lý hàng nghìn bản ghi chỉ trong vài phút, giúp đội ngũ tập trung vào những việc tạo ra giá trị cao hơn. Một người dùng cho biết họ đã tiết kiệm “hàng trăm giờ” nhờ tự động hóa việc thu thập dữ liệu (browsercat.com).
- Tăng độ chính xác dữ liệu: Không còn lỗi gõ nhầm hay bỏ sót thông tin. Trích xuất tự động giúp dữ liệu sạch hơn và đáng tin cậy hơn.
- Hỗ trợ ra quyết định nhanh hơn: Với nguồn dữ liệu cập nhật theo thời gian thực, bạn có thể theo dõi đối thủ, kiểm tra giá, hoặc xây dựng danh sách khách hàng tiềm năng mà không phải chờ báo cáo tháng từ thực tập sinh.
- Trao quyền cho đội ngũ không kỹ thuật: Nhờ các công cụ no-code và AI, ngay cả những người nghĩ “XPath” là một tư thế yoga cũng có thể xây dựng pipeline dữ liệu web (cpomagazine.com).
Không có gì lạ khi 100% chuyên gia dữ liệu được khảo sát sử dụng dữ liệu web công khai trong quy trình làm việc của họ, và gần 80% nói rằng tổ chức của họ sẽ khó vận hành hiệu quả nếu thiếu nó. Năm 2026, nếu bạn chưa tự động hóa việc thu thập dữ liệu, rất có thể bạn đang bỏ lỡ cả tiền bạc lẫn insight.
Chúng tôi chọn các công cụ web scraping tự động tốt nhất như thế nào
Khi thị trường phần mềm web scraping được dự báo sẽ tăng hơn gấp đôi vào năm 2032, việc chọn đúng công cụ giống như mua giày trong một cửa hàng có 10.000 lựa chọn. Đây là cách tôi thu hẹp danh sách:
- Dễ sử dụng: Người không phải developer có thể bắt đầu nhanh không? Có đường cong học tập dốc không?
- Khả năng AI: Công cụ có dùng AI để tự nhận diện trường dữ liệu, xử lý website động, hoặc cho phép mô tả nhu cầu bằng tiếng Anh tự nhiên không?
- Xuất dữ liệu & tích hợp: Có thể đưa dữ liệu vào Excel, Google Sheets, Airtable, Notion hoặc CRM của bạn dễ đến mức nào?
- Giá cả: Có dùng thử miễn phí không? Các gói trả phí có phù hợp với cá nhân và nhóm nhỏ không, hay chỉ dành cho enterprise?
- Khả năng mở rộng: Công cụ có xử lý được cả tác vụ nhỏ lẻ lẫn trích xuất quy mô lớn, theo lịch không?
- Đối tượng mục tiêu: Sản phẩm dành cho người dùng doanh nghiệp, developer hay cả hai?
- Điểm mạnh riêng: Điều gì làm công cụ này nổi bật giữa đám đông?
Tôi đã đưa vào danh sách các công cụ cho mọi cấp độ — từ “tôi chỉ cần một file bảng tính” đến “tôi muốn crawl cả Internet”. Cùng đi vào danh sách.
1. Thunderbit: Công cụ Web Scraper chạy bằng AI dành cho mọi người
Trích xuất dữ liệu từ bất kỳ website nào bằng AI Get Started Free
Để tôi bắt đầu với công cụ mà tôi hiểu rõ nhất — vì đội của tôi và tôi đã xây dựng nó để giải quyết đúng những nỗi đau mà người dùng doanh nghiệp gặp phải suốt nhiều năm. Thunderbit không phải kiểu scraper “kéo-thả” hay “tự viết selector” thông thường. Nó là một trợ lý dữ liệu dùng AI, cho phép bạn mô tả thứ mình muốn, rồi phần còn lại cứ để nó xử lý — không cần code, không cần loay hoay với XPath, không cần đau đầu.
Vì sao Thunderbit đứng đầu danh sách
Thunderbit là thứ gần nhất tôi từng thấy với ý tưởng “biến bất kỳ website nào thành một cơ sở dữ liệu”. Cách nó hoạt động như sau:
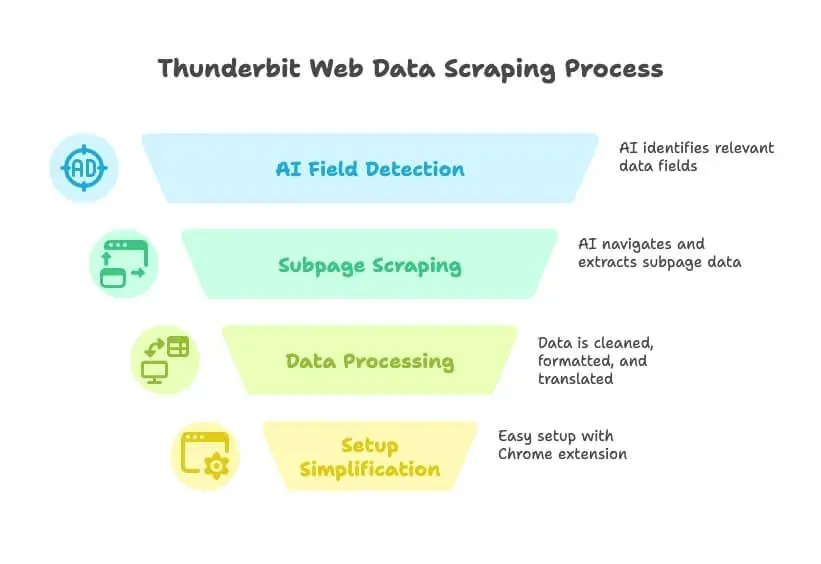
- Điều khiển bằng ngôn ngữ tự nhiên: Chỉ cần nói cho Thunderbit biết bạn cần dữ liệu gì (“Tôi muốn tất cả tên công ty, email và số điện thoại từ danh bạ này”), AI sẽ tự nhận diện các trường liên quan.
- AI gợi ý trường dữ liệu: Chỉ với một cú nhấp, Thunderbit đọc trang và đề xuất những cột nên trích xuất — không còn đoán mò hay thử đi thử lại.
- Scrape trang con & nhiều cấp: Cần lấy chi tiết từ trang con của từng mục? Thunderbit có thể tự bấm qua, lấy thêm thông tin và nối vào bảng của bạn.
- Làm sạch, dịch và phân loại dữ liệu: Thunderbit không chỉ lấy dữ liệu thô — nó còn có thể làm sạch, định dạng, dịch, thậm chí phân loại trường dữ liệu trong lúc scrape.
- Không đau đầu khi thiết lập: Cài tiện ích Chrome, bấm “AI Suggest Fields”, và bạn có thể scrape chỉ trong chưa đầy một phút.
- Dùng thử miễn phí & chi phí thấp: Gói miễn phí khá rộng rãi (có thể scrape tối đa 6 trang miễn phí), gói trả phí chỉ từ $9/tháng. Rẻ hơn cả số tiền tôi tiêu cho cà phê trong một tuần.
Thunderbit được xây dựng cho các đội sales, marketing và vận hành cần dữ liệu nhanh. Không cần code, không cần plugin, không cần đào tạo. Nó giống như có một thực tập sinh dữ liệu biết lắng nghe và không bao giờ phàn nàn.
Những điểm nổi bật của Thunderbit
- Scraping bằng AI: AI hiểu cấu trúc trang, thích nghi khi giao diện thay đổi, và còn tự xử lý phân trang lẫn trang con (cpomagazine.com).
- Xuất dữ liệu ngay lập tức: Gửi kết quả trực tiếp sang Excel, Google Sheets, Airtable, Notion hoặc tải xuống dạng CSV/JSON.
- Chạy trên cloud hoặc cục bộ: Chạy trên cloud để nhanh và mở rộng tốt, hoặc chạy ngay trên trình duyệt nếu bạn cần dùng đăng nhập/session của mình.
- Scraping theo lịch: Thiết lập tác vụ lặp lại để dữ liệu luôn mới — rất hợp cho theo dõi giá hoặc cập nhật lead định kỳ.
- Không cần bảo trì: AI của Thunderbit tự thích nghi khi website thay đổi, nên bạn tốn ít thời gian hơn để sửa scraper bị hỏng (cpomagazine.com).
Phù hợp với ai? Bất kỳ ai muốn đi từ “tôi cần dữ liệu này” đến “đây là file bảng tính của bạn” chỉ trong vài phút — đặc biệt là người dùng không kỹ thuật. Với hơn 200.000 người dùng và đánh giá 4,2★, Thunderbit đang nhanh chóng trở thành lựa chọn quen thuộc của các team kinh doanh muốn có kết quả, không phải rắc rối.
Muốn xem thực tế? Hãy xem kênh YouTube của Thunderbit hoặc đọc thêm các hướng dẫn trên blog Thunderbit.
Dùng thử Thunderbit AI Web Scraper miễn phí
2. Clay: Kết hợp làm giàu dữ liệu tự động với web scraping
Clay giống như con dao đa năng Thụy Sĩ dành cho team tăng trưởng. Nó không chỉ là một web scraper — mà là một bảng tính tự động kết nối với hơn 150–200 nguồn dữ liệu trực tiếp (như Apollo, LinkedIn, Crunchbase) và dùng AI tích hợp để làm giàu lead, viết email tiếp cận và chấm điểm khách hàng tiềm năng.
- Tự động hóa workflow: Mỗi hàng là một lead, mỗi cột có thể lấy dữ liệu hoặc kích hoạt một hành động. Muốn scrape danh sách công ty, làm giàu bằng profile LinkedIn rồi gửi email cá nhân hóa? Clay xử lý được.
- Tích hợp AI: Dùng GPT-4 để viết câu mở đầu, tóm tắt bio, và nhiều hơn nữa.
- Tích hợp hệ sinh thái: Kết nối tự nhiên với HubSpot, Salesforce, Gmail, Slack và nhiều ứng dụng khác.
- Giá: Gói Launch bắt đầu khoảng $167/tháng (hoặc khoảng $60/tháng nếu thanh toán năm), có dùng thử miễn phí cho nhu cầu nhẹ.
Phù hợp nhất cho: Sales outbound, growth hacker và marketer muốn xây dựng pipeline lead tùy chỉnh — kết hợp scraping, làm giàu dữ liệu và outreach trong cùng một nơi. Công cụ này rất mạnh, nhưng nếu bạn mới với automation thì vẫn có độ khó nhất định (lindy.ai).
3. Bardeen: Công cụ web scraper chạy trên trình duyệt để tự động hóa workflow
Bardeen giống như có một robot trong trình duyệt có thể scrape dữ liệu và tự động hóa các tác vụ web lặp đi lặp lại — tất cả chỉ từ một tiện ích Chrome.
- Tự động hóa no-code: Hơn 500 “Playbook” cho việc scrape, điền form, chuyển dữ liệu giữa các ứng dụng, v.v.
- AI Command Builder: Mô tả tác vụ bằng ngôn ngữ tự nhiên, Bardeen sẽ xây workflow.
- Tích hợp: Hoạt động với Notion, Trello, Slack, Salesforce và hơn 100 ứng dụng khác.
- Giá: Gói Basic bắt đầu từ $10/tháng (100 credit/tháng), gói Premium $50/tháng (hoặc $480/năm) cho đội nhóm.
Phù hợp nhất cho: Power user và các team go-to-market muốn tự động hóa scraping lẫn các hành động follow-up trên nhiều ứng dụng. Công cụ này rất linh hoạt, nhưng người mới có thể thấy đường cong học tập hơi dốc (so sánh trên blog Thunderbit).
4. Bright Data: Công cụ web scraping tự động cấp enterprise
Bright Data (trước đây là Luminati) là “máy móc hạng nặng” của web scraping — nghĩ đến mạng proxy toàn cầu, API nâng cao, và khả năng crawl hàng nghìn trang mỗi ngày.
- Quy mô enterprise: Hơn 400 triệu IP, Web Scraper API, Web Unlocker để vượt qua các cơ chế chống bot.
- Tùy biến cao: Xây các quy trình trích xuất phức tạp, quy mô lớn với độ tin cậy cao.
- Giá: Từ $499/tháng cho Web Scraper API, cũng có gói miễn phí và trả theo mức sử dụng.
Phù hợp nhất cho: Doanh nghiệp lớn, đơn vị tổng hợp dữ liệu và người dùng nâng cao cần giải pháp mạnh, ổn định, có thể mở rộng. Nếu bạn crawl hàng nghìn trang mỗi ngày và cần tránh bị chặn IP, Bright Data sinh ra cho bạn (blog.apify.com).
5. Octoparse: Công cụ web scraper trực quan cho người dùng trình độ trung cấp
Octoparse là một công cụ no-code phổ biến với giao diện trực quan kiểu point-and-click — rất hợp cho người muốn sức mạnh mà không cần lập trình.
- Giao diện kéo-thả: Bấm vào phần tử để định nghĩa dữ liệu cần lấy, xử lý đăng nhập, phân trang, và nhiều thứ khác.
- Template: Hơn 500 mẫu dựng sẵn cho các website phổ biến (Amazon, Twitter, v.v.).
- Scraping trên cloud: Chạy tác vụ trên máy chủ của Octoparse, lên lịch trích xuất và dùng xoay vòng IP.
- Giá: Có gói miễn phí giới hạn; gói trả phí bắt đầu từ $69/tháng.
Phù hợp nhất cho: Người không biết lập trình và chuyên viên phân tích dữ liệu muốn có một scraper đủ mạnh mà không phải viết code. Rất tốt cho theo dõi giá, danh sách sản phẩm và các dự án nghiên cứu (thunderbit.com).
6. Import.io: Nền tảng thu thập dữ liệu dành cho doanh nghiệp
Import.io là một trong những “cây đại thụ” của web scraping, nay đã phát triển thành nền tảng trích xuất dữ liệu quy mô lớn.
- Trích xuất bằng point-and-click: Xử lý đăng nhập, menu thả xuống và các phần tử tương tác.
- Dựa trên cloud: Xử lý hàng nghìn URL đồng thời, lên lịch trích xuất và truy cập API.
- Tập trung vào enterprise: Dùng cho theo dõi giá, nghiên cứu thị trường và xây dựng bộ dữ liệu cho machine learning.
- Giá: Gói Standard $199/tháng, Professional $399/tháng, Advanced $699/tháng (theo năm); Enterprise báo giá riêng.
Phù hợp nhất cho: Các doanh nghiệp vừa đến lớn và đội dữ liệu cần giải pháp đáng tin cậy, được duy trì tốt cho các dự án lớn. Có thể hơi quá mức cho các dự án cá nhân, nhưng là cỗ máy thực thụ cho nhu cầu cấp business (import.io).
7. Parsehub: Công cụ web scraper linh hoạt với trình chỉnh sửa trực quan
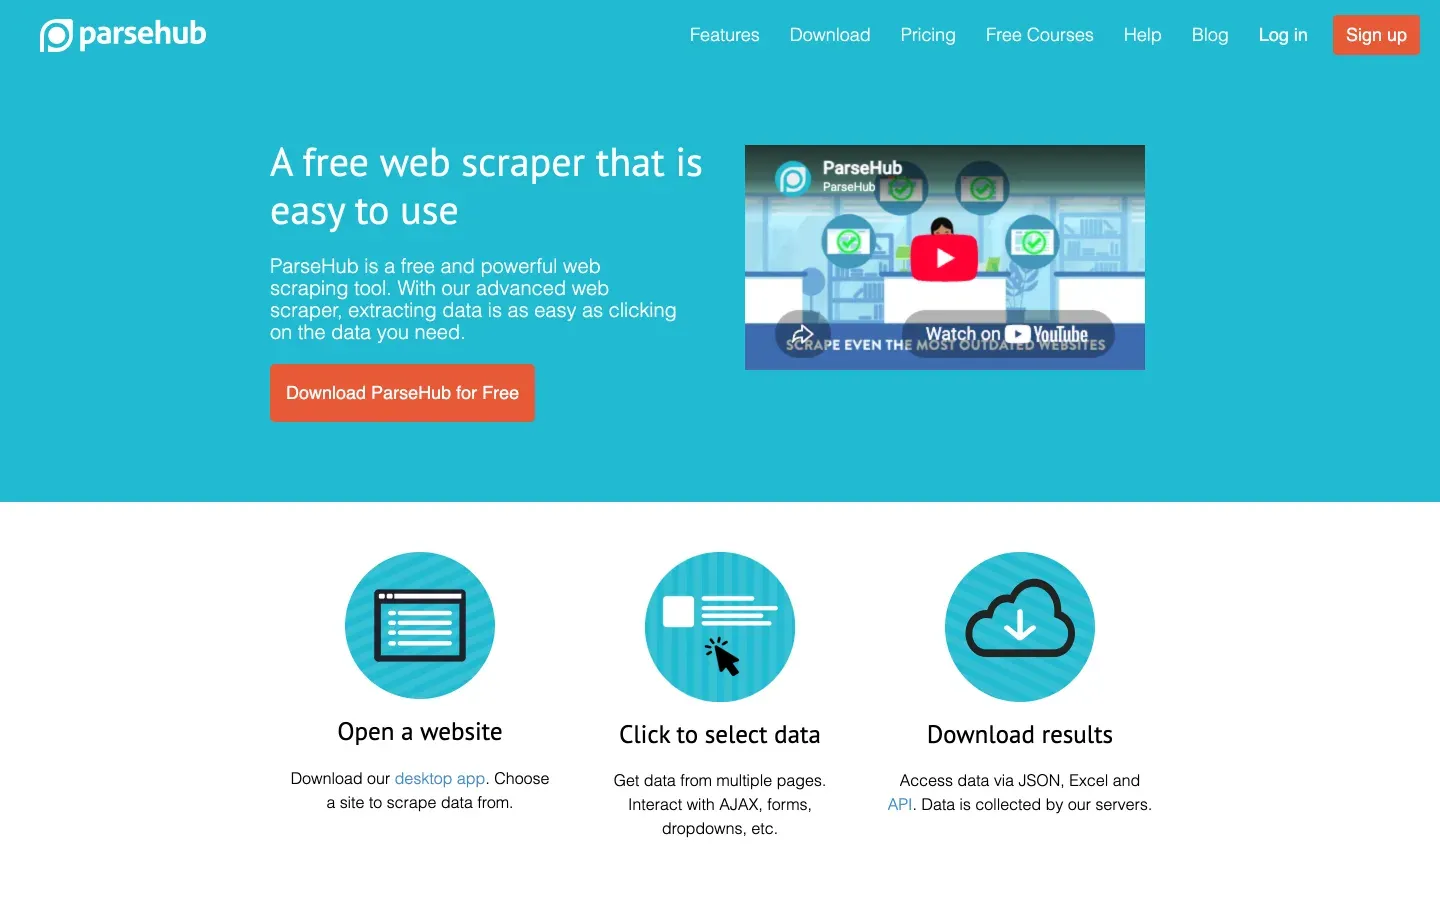
Parsehub là một ứng dụng desktop (Windows, Mac, Linux) cho phép bạn xây scraper bằng cách bấm qua giao diện website.
- Quy trình trực quan: Chọn phần tử, thiết lập quy tắc trích xuất, xử lý đăng nhập, dropdown và infinite scroll.
- Tính năng cloud: Chạy scrape trên cloud, lập lịch tác vụ và dùng API.
- Giá: Có gói miễn phí cho tác vụ nhỏ; gói trả phí từ $149/tháng.
Phù hợp nhất cho: Nhà nghiên cứu, doanh nghiệp nhỏ hoặc cá nhân muốn có nhiều quyền kiểm soát hơn tiện ích trình duyệt, nhưng chưa muốn tự code scraper riêng (scrapingbee.com).
8. Common Crawl: Dữ liệu web mở cho AI và nghiên cứu
Common Crawl không phải là một công cụ theo nghĩa truyền thống — mà là một bộ dữ liệu web crawl khổng lồ, được cập nhật hàng tháng.
- Quy mô: Khoảng 400 TB dữ liệu web, bao phủ hàng tỷ trang.
- Miễn phí và mở: Không cần tự chạy crawler.
- Cần kỹ năng kỹ thuật: Bạn sẽ cần công cụ big data và một chút năng lực kỹ thuật để lọc và phân tích dữ liệu.
Phù hợp nhất cho: Nhà khoa học dữ liệu và kỹ sư xây dựng mô hình AI hoặc làm nghiên cứu quy mô lớn. Nếu bạn cần text web tổng quát hoặc kho lưu trữ dài hạn, đây là một mỏ vàng (scrapingbee.com).
9. Crawly: Công cụ web scraping nhẹ cho startup
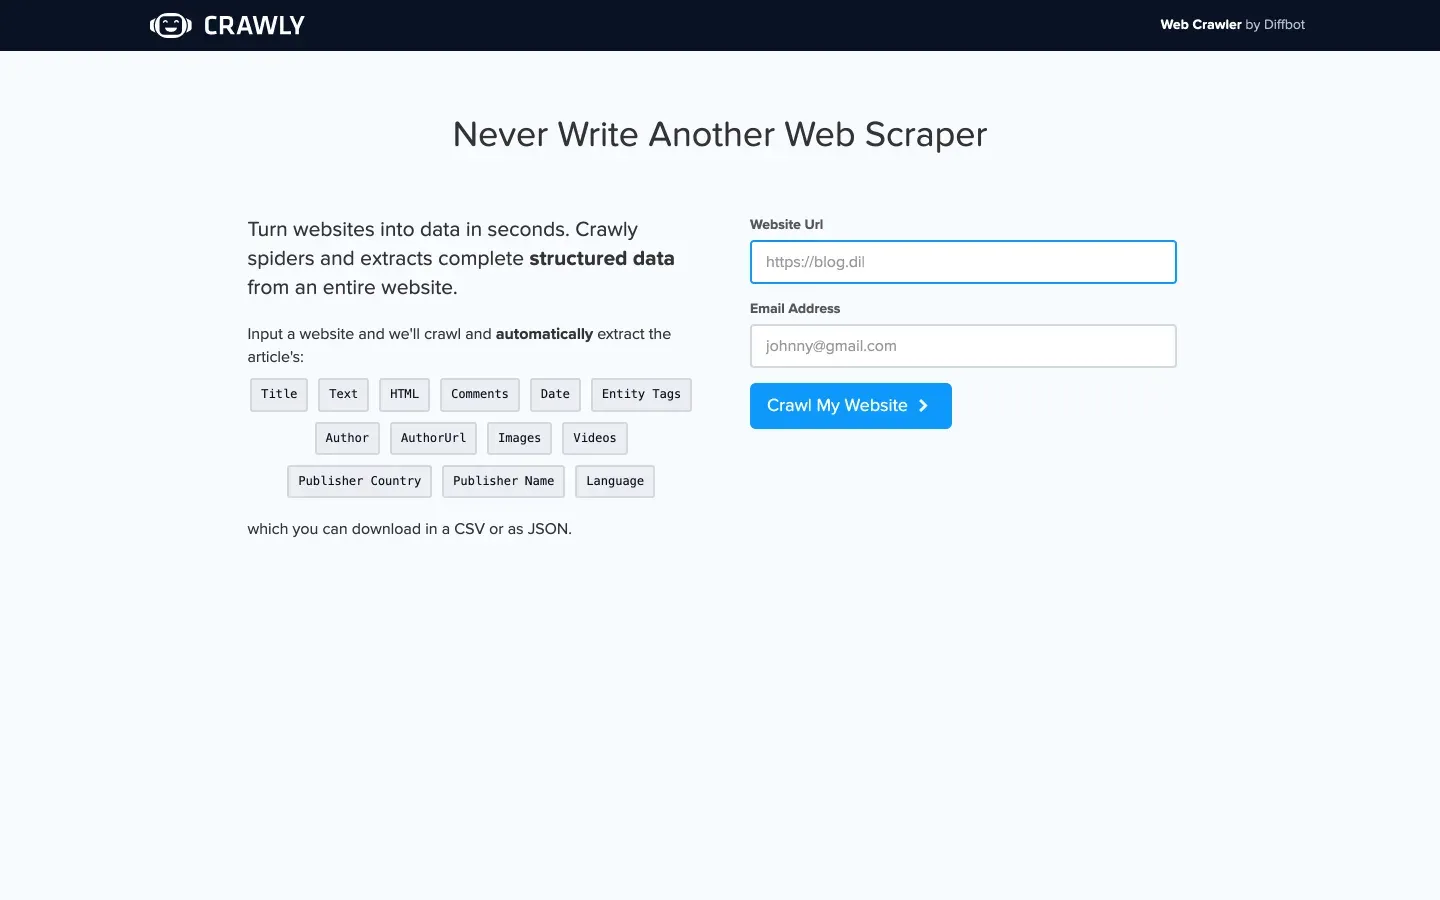
Crawly (thuộc Diffbot) là một crawler chạy trên cloud, dùng AI để thu thập dữ liệu từ hàng triệu website và trả về kết quả có cấu trúc — không cần viết quy tắc parse.
- Trích xuất bằng AI: Dùng machine vision và NLP để nhận diện và lấy nội dung.
- Truy cập API: Truy vấn dữ liệu đã thu thập và tích hợp với hệ thống phân tích hoặc cơ sở dữ liệu.
- Giá: Có gói miễn phí (10.000 credit/tháng qua Diffbot); gói trả phí từ $299/tháng.
Phù hợp nhất cho: Startup và các team có chút kỹ năng kỹ thuật cần trích xuất dữ liệu web thông minh, quy mô lớn mà không muốn tự xây scraper từ đầu (aitoptools.com).
10. Apify: Công cụ web scraper thân thiện với developer kèm marketplace
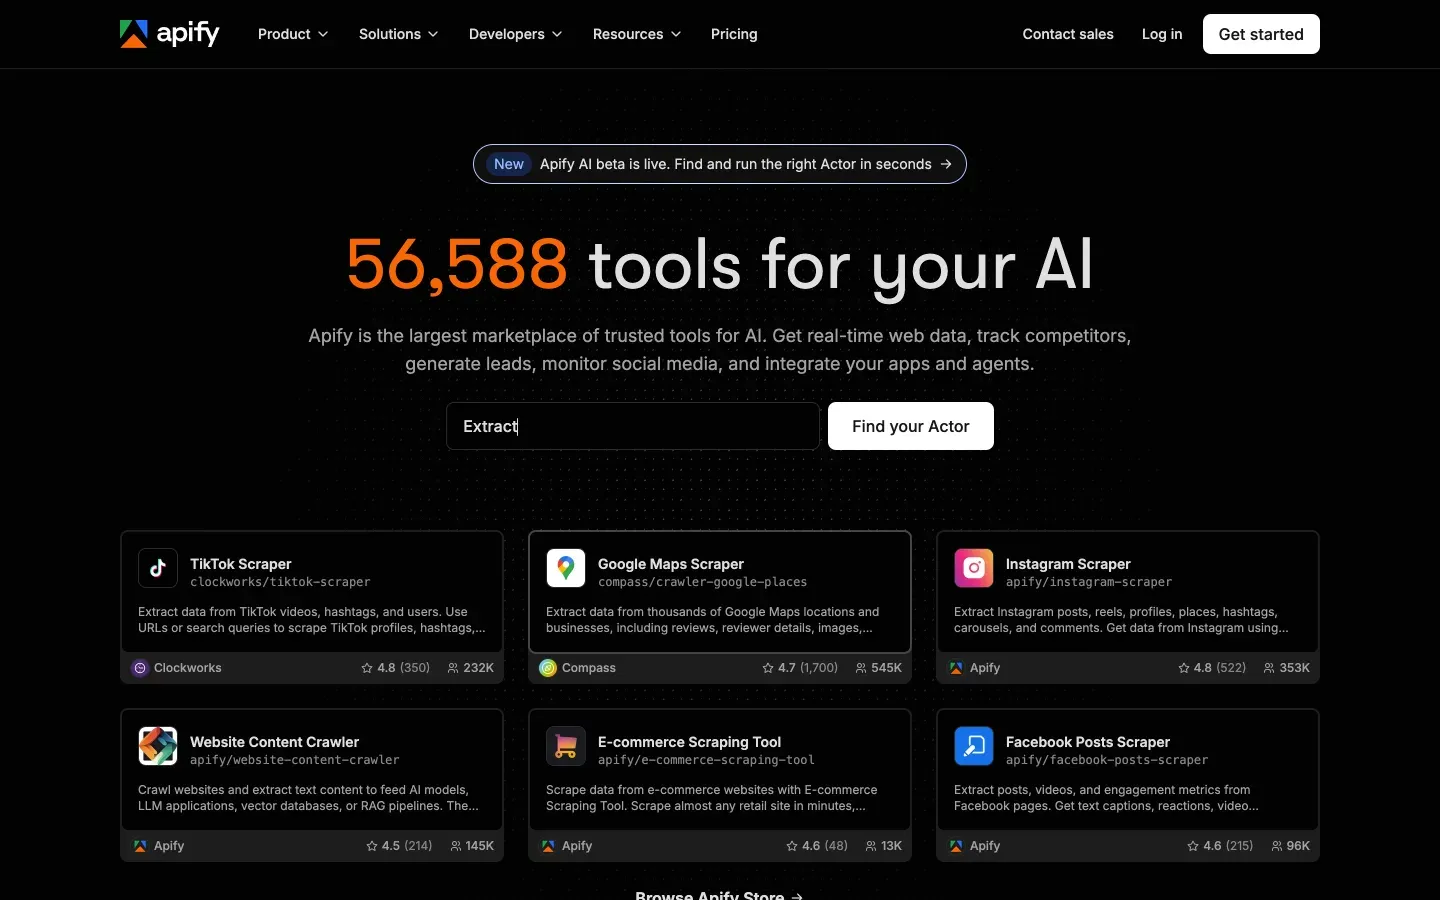
Apify là một nền tảng cloud nơi bạn có thể tự xây scraper của mình (“Actors”) hoặc dùng thư viện scraper dựng sẵn từ cộng đồng.
- Linh hoạt cho developer: Hỗ trợ scraping bằng JavaScript/Python, headless Chrome, quản lý proxy và lập lịch.
- Marketplace: Thư viện lớn các scraper dựng sẵn cho website phổ biến.
- Giá: Có gói miễn phí kèm $5 credit/tháng; gói trả phí từ $29/tháng.
Phù hợp nhất cho: Developer và nhà phân tích am hiểu kỹ thuật muốn kiểm soát hoàn toàn và khả năng mở rộng tốt. Ngay cả người không biết code cũng có thể dùng các Actor dựng sẵn cho những tác vụ phổ biến (blog.apify.com).
Bảng so sánh các công cụ web scraping tự động
| Công cụ | Dễ sử dụng | Tính năng AI | Giá khởi điểm | Đối tượng mục tiêu | Điểm mạnh riêng |
|---|---|---|---|---|---|
| Thunderbit | ★★★★★ | Ngôn ngữ tự nhiên, AI Suggest Fields, scrape trang con | $9/tháng | Người dùng doanh nghiệp không kỹ thuật | Thiết lập 2 cú nhấp, không cần code, xuất dữ liệu tức thì, dùng thử miễn phí |
| Clay | ★★★★☆ | AI làm giàu dữ liệu, GPT-4 | $167/tháng | Growth/sales ops | Bảng tính tự động, enrichment, outreach |
| Bardeen | ★★★★☆ | AI command builder | $10/tháng | Power user, team GTM | Browser RPA, hơn 500 playbook, tích hợp sâu |
| Bright Data | ★★☆☆☆ | Xoay vòng proxy, AI chống bot | $499/tháng | Enterprise, dev | Quy mô lớn, độ tin cậy cao, proxy toàn cầu |
| Octoparse | ★★★★☆ | Nhận diện AI trực quan | $69/tháng | Analyst, người không code | Kéo-thả, template, scraping trên cloud |
| Import.io | ★★★☆☆ | Trích xuất tương tác | $199/tháng | Enterprise, đội dữ liệu | Chạy đồng thời, lập lịch, API, hỗ trợ |
| Parsehub | ★★★★☆ | Workflow trực quan | $149/tháng | Nhà nghiên cứu, SMB | Ứng dụng desktop, xử lý site động |
| Common Crawl | ★☆☆☆☆ | Không áp dụng (chỉ là dataset) | Miễn phí | Nhà khoa học dữ liệu, kỹ sư | Bộ dữ liệu mở khổng lồ, lưu trữ quy mô web |
| Crawly | ★★☆☆☆ | Trích xuất bằng AI | Miễn phí / từ $299/tháng | Startup, team kỹ thuật | Dùng AI, không cần quy tắc parse, có API |
| Apify | ★★★★☆ | Marketplace Actor | $29/tháng | Developer, analyst kỹ thuật | Xây dựng/marketplace, tự động hóa cloud, linh hoạt |
Cách chọn công cụ web scraper phù hợp với nhu cầu của bạn
Data Scraping là gì và cách thực hiện Get Started Free
Chọn công cụ web scraping tự động tốt nhất phụ thuộc vào quy mô đội ngũ, kỹ năng kỹ thuật và mục tiêu kinh doanh của bạn. Đây là hướng dẫn nhanh của tôi:
- Dành cho người không kỹ thuật (Sales, Marketing, Ops): Hãy chọn Thunderbit. Công cụ này được tạo ra cho bạn — không cần code, không cần thiết lập, chỉ cần kết quả. Rất hợp cho tạo lead, theo dõi giá và các dự án dữ liệu nhanh.
- Dành cho đội ngũ mê tự động hóa: Clay và Bardeen sẽ rất mạnh nếu bạn muốn kết hợp scraping với enrichment, outreach hoặc tự động hóa workflow.
- Dành cho enterprise & developer: Bright Data, Import.io và Apify là những lựa chọn hàng đầu cho các dự án lớn, tùy biến sâu.
- Dành cho nhà nghiên cứu & analyst: Octoparse và Parsehub có giao diện trực quan cùng nhiều tính năng mạnh mà không cần code.
- Dành cho dự án AI & khoa học dữ liệu: Common Crawl và Crawly cung cấp bộ dữ liệu khổng lồ và khả năng trích xuất bằng AI cho những ai muốn xây dựng hoặc huấn luyện mô hình.
Hãy tự hỏi: Bạn muốn bắt đầu trong vài phút, hay cần xây một giải pháp tùy chỉnh cấp enterprise? Nếu chưa chắc, hãy bắt đầu bằng bản dùng thử miễn phí — hầu hết công cụ đều có.
Bắt đầu scrape với Thunderbit ngay
Giá trị khác biệt của Thunderbit: Trợ lý AI cho dữ liệu doanh nghiệp
Trong số tất cả các công cụ này, Thunderbit nổi bật là công cụ duy nhất thực sự hoạt động như một “trợ lý AI” cho web scraping và chuyển đổi dữ liệu. Không chỉ là lấy dữ liệu — mà là biến các website lộn xộn thành insight sạch, có cấu trúc, mà không gặp rào cản kỹ thuật nào.
- Giao diện ngôn ngữ tự nhiên: Mô tả nhu cầu bằng tiếng Anh đời thường, Thunderbit lo phần còn lại.
- Tự động hóa toàn bộ workflow: Từ trích xuất đến làm sạch, dịch và xuất dữ liệu — Thunderbit bao phủ trọn quy trình.
- Hoàn hảo cho thử nghiệm nhanh: Cần kiểm chứng thị trường mới, xây danh sách lead hay theo dõi đối thủ? Thunderbit là điểm khởi đầu nhanh nhất và tiết kiệm nhất.
Nó giống như có một nhà phân tích dữ liệu ngay trong trình duyệt của bạn — người không bao giờ đòi tăng lương hay nghỉ phép.
Kết luận: Bắt đầu thông minh hơn với đúng công cụ web scraping tự động
Bức tranh scraping năm 2026 đã khác hoàn toàn so với hai năm trước. Các scraper AI tự phục hồi, pipeline native cho LLM, và những công cụ no-code thực sự dễ dùng đã thay đổi cuộc chơi. Dù bạn là founder solo, một team sales linh hoạt, hay nhà khoa học dữ liệu trong enterprise, danh sách này đều có công cụ phù hợp. Điều quan trọng là ghép đúng workflow và kỹ năng của bạn với đúng nền tảng — để bạn không còn vật lộn với code mà bắt đầu khai thác insight.
Nếu bạn đã sẵn sàng bỏ cách copy-paste thủ công và làm việc thông minh hơn, hãy tải Thunderbit miễn phí và xem web scraping có thể dễ đến mức nào. Hoặc, hãy khám phá các lựa chọn khác ở trên dựa trên mục tiêu của bạn. Dù theo cách nào, tương lai của doanh nghiệp dựa trên dữ liệu thuộc về những ai biết tự động hóa.
Muốn tìm hiểu thêm? Xem blog của Thunderbit để đọc các bài phân tích chuyên sâu, hướng dẫn và mẹo tận dụng tối đa dữ liệu web. Chúc bạn scrape vui vẻ — và nhớ rằng, mong dữ liệu của bạn luôn sạch và scraper của bạn không bao giờ hỏng (nhưng nếu có, cứ để AI xử lý).
Dùng thử Thunderbit AI Web Scraper miễn phí Get Started Free
Câu hỏi thường gặp
1. Vì sao công cụ web scraping tự động lại quan trọng với người dùng doanh nghiệp năm 2026?
Công cụ web scraping tự động giúp tinh gọn việc thu thập dữ liệu, tiết kiệm thời gian và giảm công việc thủ công. Chúng tăng độ chính xác dữ liệu, hỗ trợ ra quyết định theo thời gian thực, và giúp các team không kỹ thuật trích xuất, sử dụng dữ liệu web mà không cần viết code. Đây giờ là công cụ quan trọng cho sales, marketing và vận hành.
2. Thunderbit khác gì so với các công cụ web scraping khác?
Thunderbit dùng AI để cho phép người dùng mô tả dữ liệu họ muốn bằng tiếng Anh tự nhiên. Công cụ tự nhận diện trường dữ liệu, xử lý trang con và phân trang, đồng thời xuất kết quả ngay lập tức sang các nền tảng như Excel và Airtable. Nó được thiết kế cho người không kỹ thuật và có các tính năng mạnh như làm sạch dữ liệu và scraping theo lịch với mức giá dễ tiếp cận.
3. Công cụ nào tốt nhất cho các dự án enterprise quy mô lớn?
Bright Data và Import.io là lựa chọn lý tưởng cho enterprise. Chúng cung cấp các tính năng như xoay vòng proxy, chống bot, chạy đồng thời quy mô lớn và truy cập API, phù hợp với tổ chức cần xử lý hàng nghìn trang web một cách ổn định và ở quy mô lớn.
4. Có công cụ nào vừa scraping vừa tự động hóa và outreach không?
Có. Các công cụ như Clay và Bardeen không chỉ scrape dữ liệu web mà còn tích hợp nó vào workflow. Clay làm giàu lead và tự động hóa outreach, còn Bardeen cho phép người dùng tự động hóa các tác vụ trên trình duyệt và workflow bằng các playbook do AI điều khiển.
5. Lựa chọn nào tốt nhất cho người không có nền tảng kỹ thuật?
Thunderbit nổi bật nhất với người không kỹ thuật nhờ giao diện ngôn ngữ tự nhiên, thiết lập bằng AI và độ dễ sử dụng cao. Nó không cần code hay cấu hình phức tạp, rất phù hợp với người dùng doanh nghiệp cần dữ liệu nhanh, đáng tin cậy mà không muốn rối với kỹ thuật.




