
Yönetici Özeti
Önceki rapor, bir politika sorusu soruyordu: Dünyanın en çok ziyaret edilen sitelerinden kaçı, AI tarayıcılarına ne yapıp ne yapamayacaklarını söylüyor?
Bu devam çalışması ise bunun arkasındaki operasyonel soruyu soruyor: robots.txt, bu politikayı taşımakla görevli altyapı için hâlâ ne kadar güvenilir?
Cevap pek iç açıcı değil. robots.txt hâlâ işe yarıyor; çünkü herkese açık, ucuz, makine tarafından okunabilir ve tarayıcılar tarafından zaten anlaşılıyor. Ama aynı zamanda tasarlandığından çok daha fazlasını taşıması bekleniyor. 2026’da aynı düz metin dosyasında SEO tarama kontrolleri, sitemap dizinleri, eski arama motoru uzantıları, AI eğitiminden çıkış seçenekleri, Cloudflare’ın enjekte ettiği politika sözlüğü, telif hakkı saklama beyanları ve gelecekte doğabilecek anlaşmazlıklara dönük hukuki dil bir arada bulunabiliyor.
Bu, yapılandırma borcu.
Bu raporun arkasındaki veri seti, ilk AI tarayıcı çalışmasında kullanılan aynı Tranco Top 10.000 taramasıdır. 10.000 alan adının 6.638’i okunabilir bir robots.txt döndürdü; ayrıca 610 tanesi 404 döndürdü ve protokole göre bu durum zımni izin sayılır. Böylece bot erişim kararları için 7.248 analiz edilebilir site ve yapılandırma karmaşıklığı analizi için 6.638 somut dosya elde edildi.
Altı bulgu öne çıkıyor:
-
robots.txtdosyalarının çoğu küçük, ama kuyruk kısmı aşırı karmaşık. Ortanca dosya yalnızca 834 bayt ve 31 satır. Buna karşılık 1.005 dosya en az 5 KB, 273 dosya en az 20 KB ve 28 dosya en az 100 KB. Örneklemdeki en büyük dosya 248 KB. -
Önde gelen sitelerin yüzlercesi, politika notundan çok üretim yapılandırmasına benzeyen dosyalar çalıştırıyor. Ortanca dosyada 9
Disallowyönergesi var. Ama 707 sitede en az 100Disallowkuralı, 13 sitede en az 1.000 kural, 240 sitede en az 50 kullanıcı aracısı adı ve 110 sitede en az 100 kullanıcı aracısı adı var. -
Protokol kayması teorik değil. Okunabilir 6.638 dosya içinde 685’inde
Crawl-delay, 303’ündeHost, 200’ündeClean-param, 9’undaRequest-rate, 5’indeVisit-timeve 271’inde Cloudflare tarzıContent-Signaldili var. Bunların hepsi aynı temiz standardın parçası değil; bunlar üst üste binmiş tarayıcı folkloru. -
Googlebot özel bir vatandaş gibi muamele görüyor. Analiz edilebilir 562 alan adı en az bir geleneksel arama tarayıcısını engelliyor. Bu vakaların 404’ünde Googlebot’a izin verilirken en az bir başka arama tarayıcısı engelleniyor. AI tarayıcı ayrımcılığı nötr bir ekosistemde ortaya çıkmadı;
robots.txtzaten arama motorları arasında bir hiyerarşi kodlamıştı. -
AI politikaları bu borcu daha görünür hâle getiriyor. 1.377 okunabilir dosya AI politikası dili içeriyor; 719 dosya telif hakkı, kullanım şartları, lisanslama veya izin dili içeriyor; 501 dosya ise her ikisini birden içeriyor. Dosya hem makine arayüzüne hem de hukuki bir nesneye dönüştü. Bu yararlı, ama kırılgan.
-
En riskli dosyalar her zaman AI karşıtı olanlar değil. E-ticaret, seyahat, sosyal, finans, akademi ve haber kategorileri; tarama bütçesi kontrolü, eski yollar, kullanıcı tarafından üretilen içerik, hak saklama ve bota özel istisnalar gibi farklı nedenlerle karmaşık dosyalar üretiyor. AI kuralları, zaten karmaşık olan bir temelin üzerine ekleniyor.
Ana sonuç şu: robots.txt, açık web’deki en önemli tarayıcı politikası yüzeyi olmaya devam ediyor; ancak ekosistem tarayıcı kimliğini, AI kullanım sözlüğünü ve politika denetlenebilirliğini standardize etmedikçe yüksek riskli AI yönetişimi için zayıf bir temel.
Yöntem
Bu rapor, Tranco Top 10.000 alan adları üzerindeki AI tarayıcı politikalarına ilişkin orijinal Thunderbit analizindeki veri setini yeniden kullanıyor.
Kullanılan kaynaklar şunlardı:
tranco_top10k.csv— orijinal Tranco Top 10K alan adı listesi.out/fetch_meta.csv— çekim durumu, bayt sayısı, şema, yönlendirme sonucu ve hata meta verisi.out/sites.csv— alan adı, sıra, kategori, dil verobots.txtdurumu.out/site_meta.csv— site başına bir analiz satırı; şablon sınıfı, AI engelleme bayrakları, dosya boyutu ve bot politikası özet alanları dahil.out/bot_status.csv— alan adı ve tarayıcı başına bir satır; o botun engellenip engellenmediği ve belirli bir kuralın var olup olmadığı dahil.raw_robots/— 200 durum kodu döndüren 6.638 site için önbelleğe alınmışrobots.txtiçerikleri.
Bu devam çalışmasında, okunabilir her robots.txt dosyası şu açılardan tarandı:
- dosya boyutu ve satır sayısı;
- etkin yorum dışı satırlar;
User-agent,Disallow,AllowveSitemapyönerge sayıları;Crawl-delay,Host,Clean-param,Request-rateveVisit-timegibi eski veya çekirdek dışı yönergeler;Content-Signal,llms.txt, AI, LLM, machine learning, TDM ve2019/790dahil AI çağı sözlüğü;- copyright, terms of service, licensing, permission ve rights-reservation dili gibi hukuki söz varlığı;
- Googlebot, Bingbot, DuckDuckBot, Slurp, Baiduspider ve YandexBot için arama tarayıcısı davranışı.
Rapor ayrıca önceliklendirme için basit bir yapılandırma borcu puanı tanımlar. Bu puan; dosya boyutunu, kullanıcı aracısı sayısını, Disallow sayısını, Allow sayısını, standart dışı yönerge sayısını ve AI politikası ile hukuki dil karışımını birleştirir. Bu puan, doğruluğun evrensel bir ölçüsü olarak tasarlanmadı. Amacı, bakımının, incelemesinin veya yorumlanmasının zor olması muhtemel dosyaları belirlemektir.
Türetilmiş tüm tablolar ve grafikler teslim klasörüne dahildir.
Bulgu 1: Ortanca Dosya Basit; Kuyruk Öyle Değil
Üst web’deki tipik robots.txt dosyası hâlâ küçük.
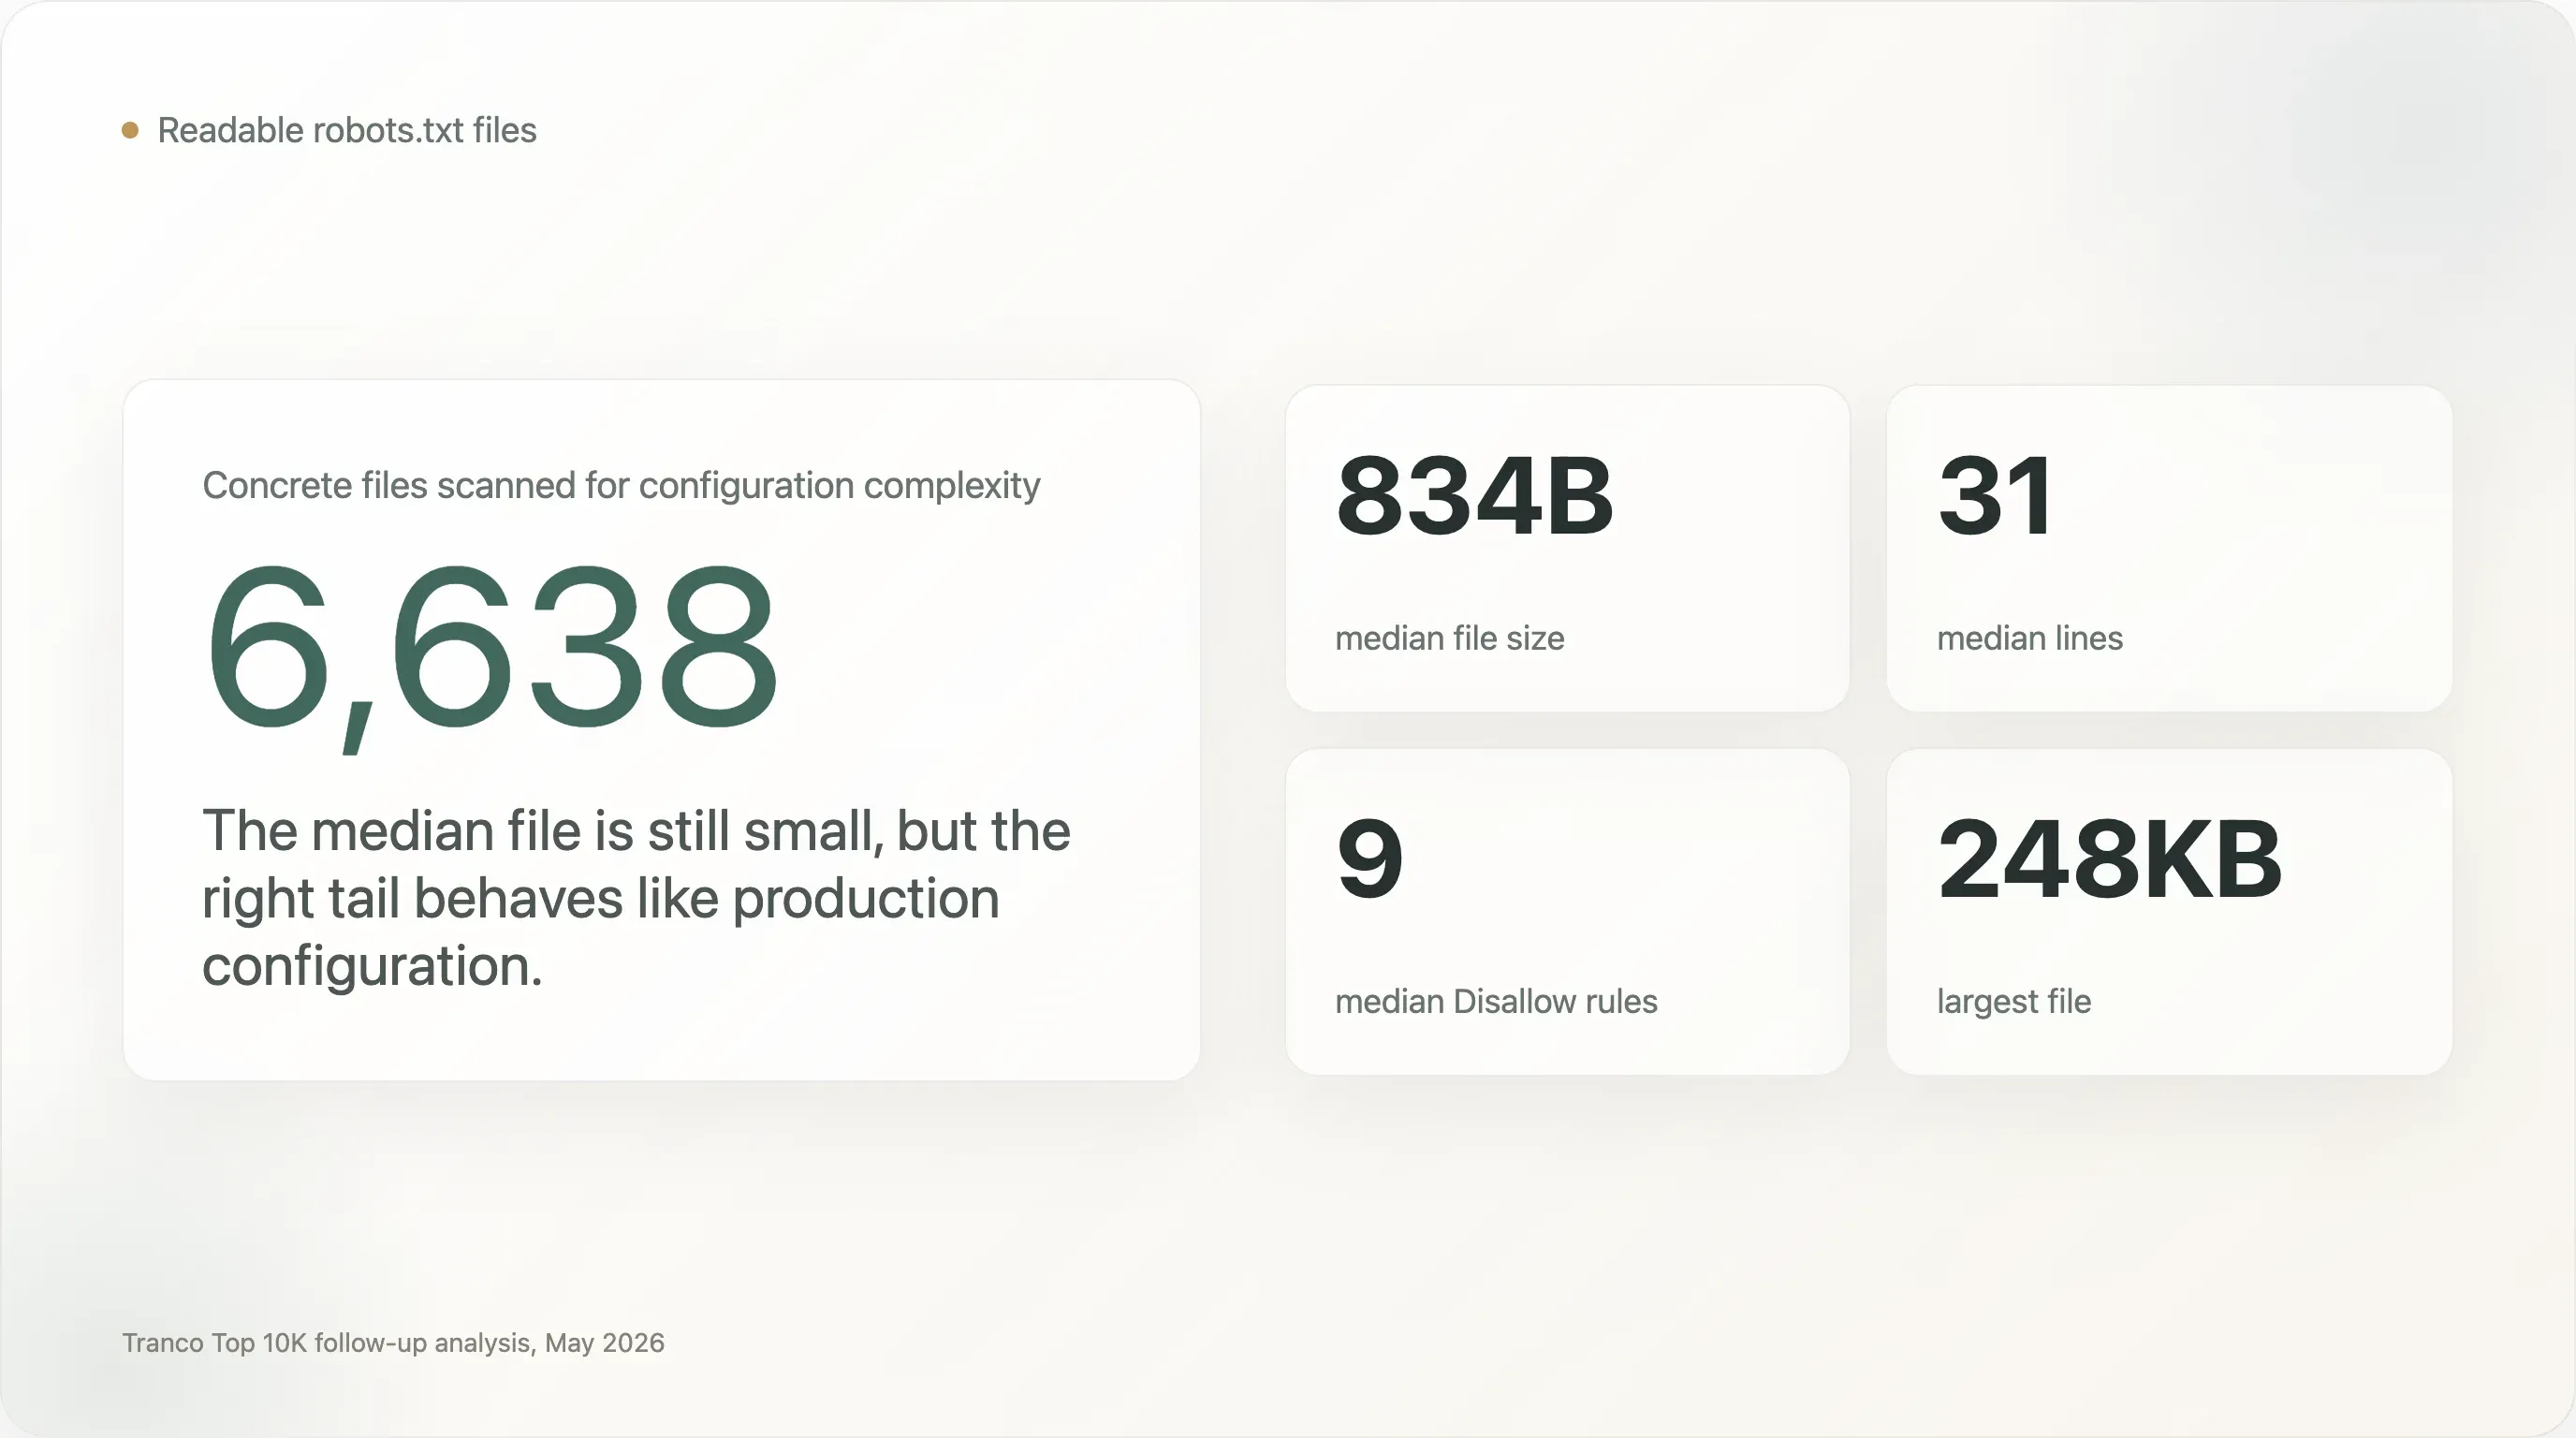
Okunabilir 6.638 dosya boyunca:
| Metrik | Ortanca | P90 | P95 | P99 | Maks |
|---|---|---|---|---|---|
| Dosya boyutu | 834 bayt | 6,7 KB | 15,8 KB | 76,0 KB | 248,3 KB |
| Satırlar | 31 | 238 | 332 | 1.008 | 4.998 |
| Etkin satırlar | 23 | 198 | 282 | 837 | 4.998 |
User-agent yönergeleri | 1 | 21 | 39 | 137 | 823 |
Disallow yönergeleri | 9 | 103 | 176 | 422 | 4.997 |
Allow yönergeleri | 1 | 17 | 33 | 69 | 890 |
Bu dağılım önemli; çünkü robots.txt çoğu zaman sanki küçük bir beyanmış gibi konuşuluyor:
User-agent: *
Disallow: /private/
Bu zihinsel model, yoğun trafikli web’in kayda değer bir azınlığı için doğru değil.
Bu veri setinde:
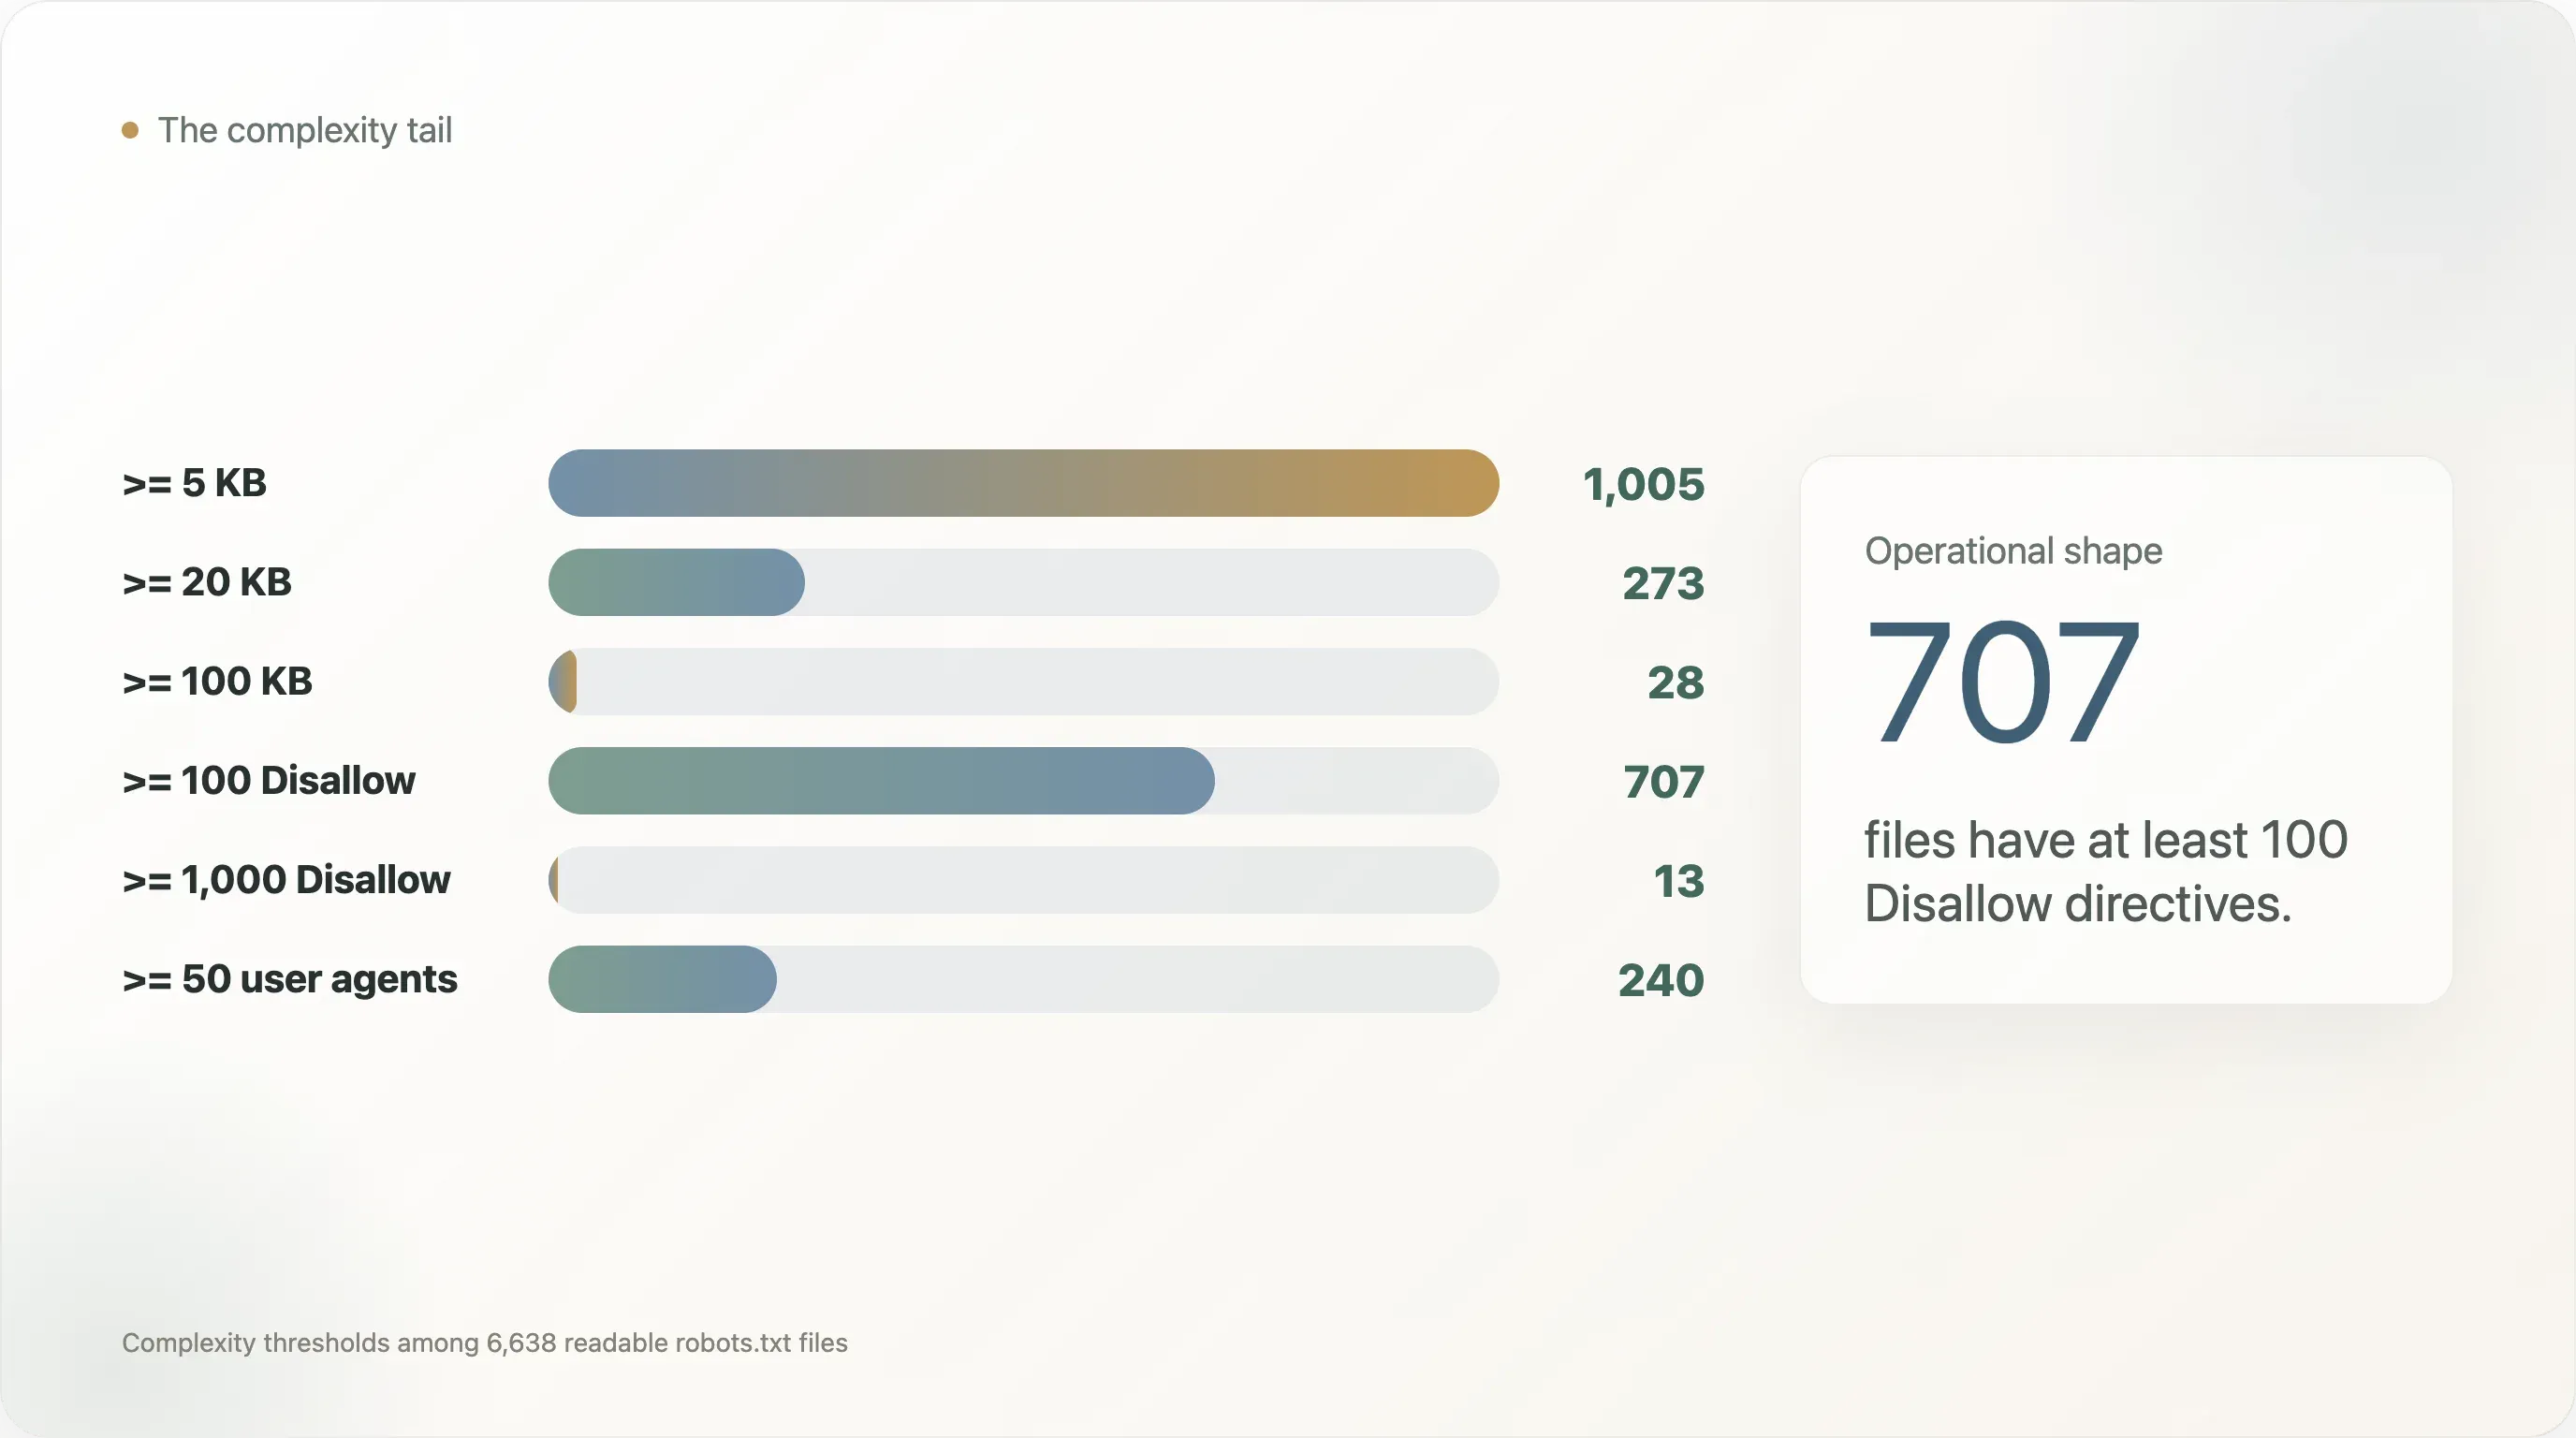
| Karmaşıklık eşiği | Siteler |
|---|---|
5 KB veya daha büyük robots.txt | 1.005 |
| 20 KB veya daha büyük | 273 |
| 100 KB veya daha büyük | 28 |
En az 50 User-agent yönergesi | 240 |
En az 100 User-agent yönergesi | 110 |
En az 100 Disallow yönergesi | 707 |
En az 1.000 Disallow yönergesi | 13 |
En az 100 Allow yönergesi | 40 |
En büyük ve en karmaşık dosyalar akademik merak nesneleri değil. Bunlar gerçek, yüksek trafikli mülklere ait:
| Alan adı | Sıra | Kategori | Bayt | User-agent | Disallow | Allow |
|---|---|---|---|---|---|---|
linkedin.com | 17 | sosyal | 114.341 | 76 | 4.184 | 281 |
runescape.com | 5.226 | bilinmiyor | 113.393 | 1 | 4.997 | 0 |
academia.edu | 832 | akademi | 57.384 | 63 | 2.044 | 227 |
etsy.com | 286 | e-ticaret | 51.320 | 3 | 1.621 | 120 |
thepaper.cn | 9.395 | haber | 56.867 | 1 | 1.496 | 0 |
opentable.com | 4.137 | bilinmiyor | 70.494 | 32 | 1.683 | 176 |
alfabank.ru | 2.625 | finans | 73.158 | 2 | 1.566 | 133 |
Bu dosyalar, politika sloganlarından çok üretim yönlendirme tablolarına benziyor. Ürün lansmanlarının yıllarını, eski yolları, engellenen parametre kalıplarını, tarayıcı istisnalarını, SEO deneylerini, CDN kararlarını ve şimdi de AI tarayıcı kurallarını kodluyorlar.
Kuyruk kısmı yalnızca bir AI hikâyesi değil. 20 KB ve üzerindeki 273 dosyanın 131’i AI politikası dili içeriyor, 142’si içermiyor. En az 100 Disallow yönergesi olan 707 dosyanın yalnızca 207’si AI politikası dili içeriyor. Başka bir deyişle, AI büyük dosya sorununu yaratmadı. Yıllardır süren sıradan web operasyonları dosyayı yol kuralları, sitemap referansları ve tarayıcı istisnalarıyla doldurduktan sonra sahneye çıktı.
Bu önemlidir; çünkü sürdürülebilirlik yalnızca niyete değil, yapıya da bağlıdır. Doğrudan bir AI blokajı içeren küçük bir dosya denetlenmesi kolay olabilir. 70 KB’lık bir e-ticaret veya seyahat dosyası, AI hakkında hiçbir şey söylemese bile denetlenmesi zor olabilir. Risk, her büyük dosyanın yanlış olması değildir. Risk, fiili politikanın bundan sorumlu kişilerin doğrulaması için fazla karmaşık hâle gelmesidir.
Operasyonel risk basittir: robots.txt büyüdükçe, bir yayıncının, platform mühendisinin, avukatın veya SEO liderinin şu temel soruya yanıt vermesi zorlaşır: Bu dosya gerçekte neye izin veriyor?
Bu soru artık önemsiz değil. RFC tarzı ayrıştırma altında bir tarayıcı, User-agent: * yerine daha özel bir kullanıcı aracısı grubuyla eşleşebilir; daha uzun yol eşleşmeleri daha kısa olanları geçersiz kılabilir; Allow ve Disallow yönergeleri öncelik sırasına göre etkileşir; ve genel tümünü reddet kuralları, dosya yazıldığında var olmayan yeni tarayıcıları yanlışlıkla kapsayabilir.
30 satırlık bir dosyada insan bunu mantıksal olarak çözebilir. Onlarca adlandırılmış bot içeren 4.000 satırlık bir dosyada ise çözmemeli.
Bulgu 2: robots.txt Tarama Kurallarından Daha Fazlasını Taşıyor
AI tarayıcı tartışması robots.txt’yi politik olarak görünür kıldı, ama altındaki dosya çoktan ilgisiz sorumluluklar biriktirmişti.
Modern bir üst site robots.txt dosyası şunları içerebilir:
- tarayıcı yol kontrolleri;
- sitemap keşfi;
- arama motoruna özgü uzantılar;
- tarama hızı ipuçları;
- ana makine kanonikleştirme ipuçları;
- URL parametresi temizleme ipuçları;
- CDN tarafından enjekte edilen politika sözlüğü;
- telif hakkı saklama metni;
- AI eğitiminden çıkış beyanları;
- insan tarafından okunabilir hukuki yorumlar.
Veri seti bu katmanlaşmayı açıkça gösteriyor.
| Sinyal | Dosyalar | Okunabilir dosya oranı |
|---|---|---|
Crawl-delay | 685 | 10,3% |
Host | 303 | 4,6% |
Clean-param | 200 | 3,0% |
Content-Signal | 271 | 4,1% |
Request-rate | 9 | 0,1% |
Visit-time | 5 | 0,1% |
llms.txt geçidi | 83 | 1,3% |
| Copyright, şartlar, lisanslama veya izin dili | 719 | 10,8% |
| AI politikası dili | 1.377 | 20,7% |
Bu yönergelerin bir kısmı belirli tarayıcılar tarafından yaygın olarak tanınır. Bazıları eski geleneklerdir. Bazıları satıcıya özeldir. Bazıları ise aslında tarayıcı yönergesi değil, yorumların içine gömülmüş hukuki ya da ürün dilidir.
Protokol kayması tam olarak budur.
Crawl-delay iyi bir örnek. Pek çok site operatörü için tanıdık bir terimdir, ancak büyük tarayıcılar arasında desteği tutarlı değildir. Host ve Clean-param tarihsel olarak Yandex davranışıyla ilişkilendirilmiştir. Content-Signal, Cloudflare’ın AI çağı politika sözlüğünün bir parçasıdır. llms.txt, önerilen bir komşu keşif biçimidir; evrensel olarak benimsenmiş bir standart değildir. Yine de bunların hepsi aynı tür dosyada, çoğu zaman klasik User-agent ve Disallow kurallarının yanında görünür.
Sayılar aynı zamanda eski ve yeni geleneklerin artık yan yana yaşadığını da gösteriyor. Crawl-delay, 271 Content-Signal dosyasından daha fazla olmak üzere 685 dosyada yer alıyor. Host, 303 dosyada; Clean-param ise çoğunlukla arama dönemi geleneklerini yansıtan 200 dosyada görülüyor. AI-arama çevrelerinde yoğun tartışılmasına rağmen llms.txt, yalnızca 83 okunabilir dosyada geçiyor. Canlı web tek bir sözlükte birleşmiyor; sözlükleri üst üste yığıyor.
Sorun herhangi bir tek uzantının yanlış olması değil. Sorun, dosyanın birden fazla örtüşen yönetişim sistemine yönelik sürüm numarası olmayan bir kapsayıcıya dönüşmüş olması.
Bu da üç tür borç yaratıyor:
- Anlamsal borç. Farklı tarayıcılar aynı dosyayı farklı yorumlayabilir.
- Sahiplik borcu. SEO, hukuk, altyapı, güvenlik ve ürün ekiplerinin dosyayı değiştirmek için gerekçeleri olabilir; ama tüm politikayı sahiplenen tek bir ekip olmayabilir.
- Denetim borcu. Bir site, niyetli görünen bir politika yayımlayabilir; ancak fiili davranışı ancak bir ayrıştırıcı belirleyebilir.
AI bunu daha önemli hâle getiriyor; çünkü bahisler değişti. Eski bir tarama hızı ipucu yok sayıldığında sonuç ekstra trafik olabilir. Belirsiz bir AI eğitiminden çıkış beyanı olduğunda sonuç, telif hakkı veya lisanslama anlaşmazlığında kanıt hâline gelebilir.
Bulgu 3: Dosya Hem Makine Arayüzü Hem de Hukuki Bir Nesneye Dönüştü
Orijinal AI tarayıcı raporu, analiz edilebilir sitelerin %17,0’sinin açık AI’ya özgü kurallar yazdığını göstermişti. Bu devam çalışması, bu politikaların eklediği metinsel yükü inceliyor.
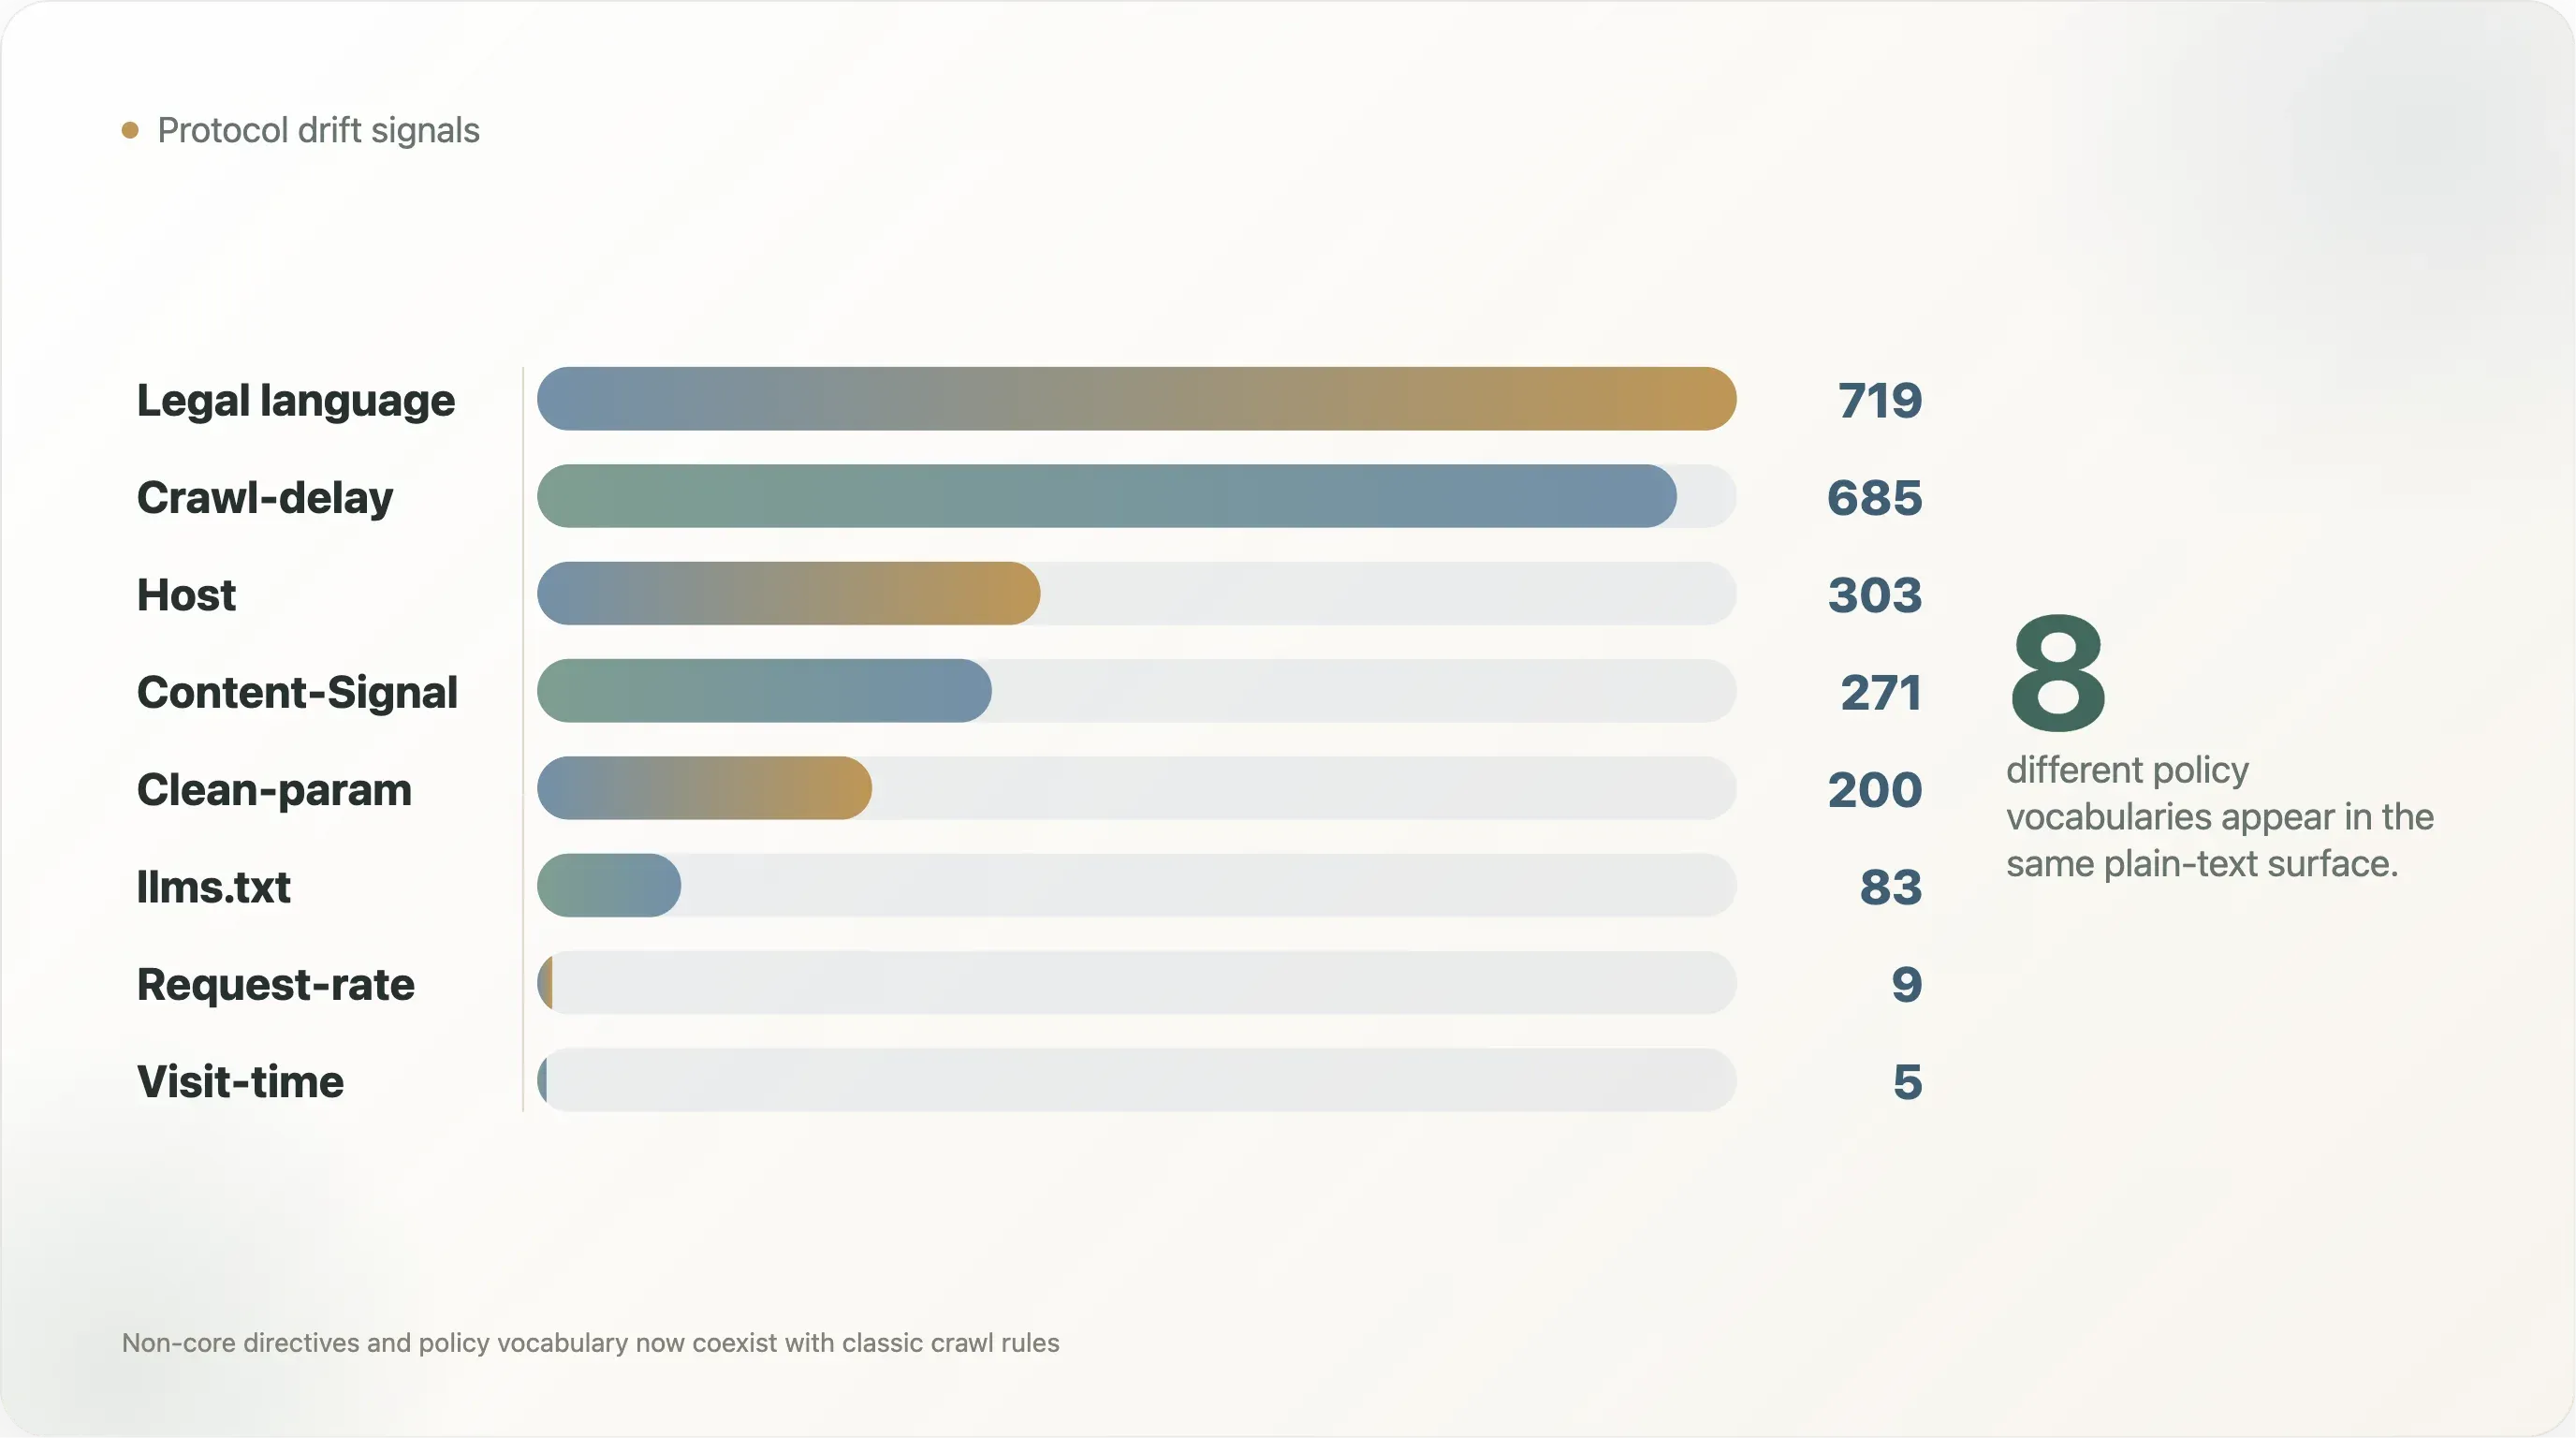
Okunabilir 6.638 robots.txt dosyası arasında:
- 1.377 dosya AI politikası dili içeriyor;
- 719 dosya copyright, şartlar, lisans, hak veya izin dili içeriyor;
- 271 dosya
Content-Signaliçeriyor; - 83 dosya
llms.txtgeçidi içeriyor.
Hikâyeyi ilginç kılan şey, bu örtüşmedir:
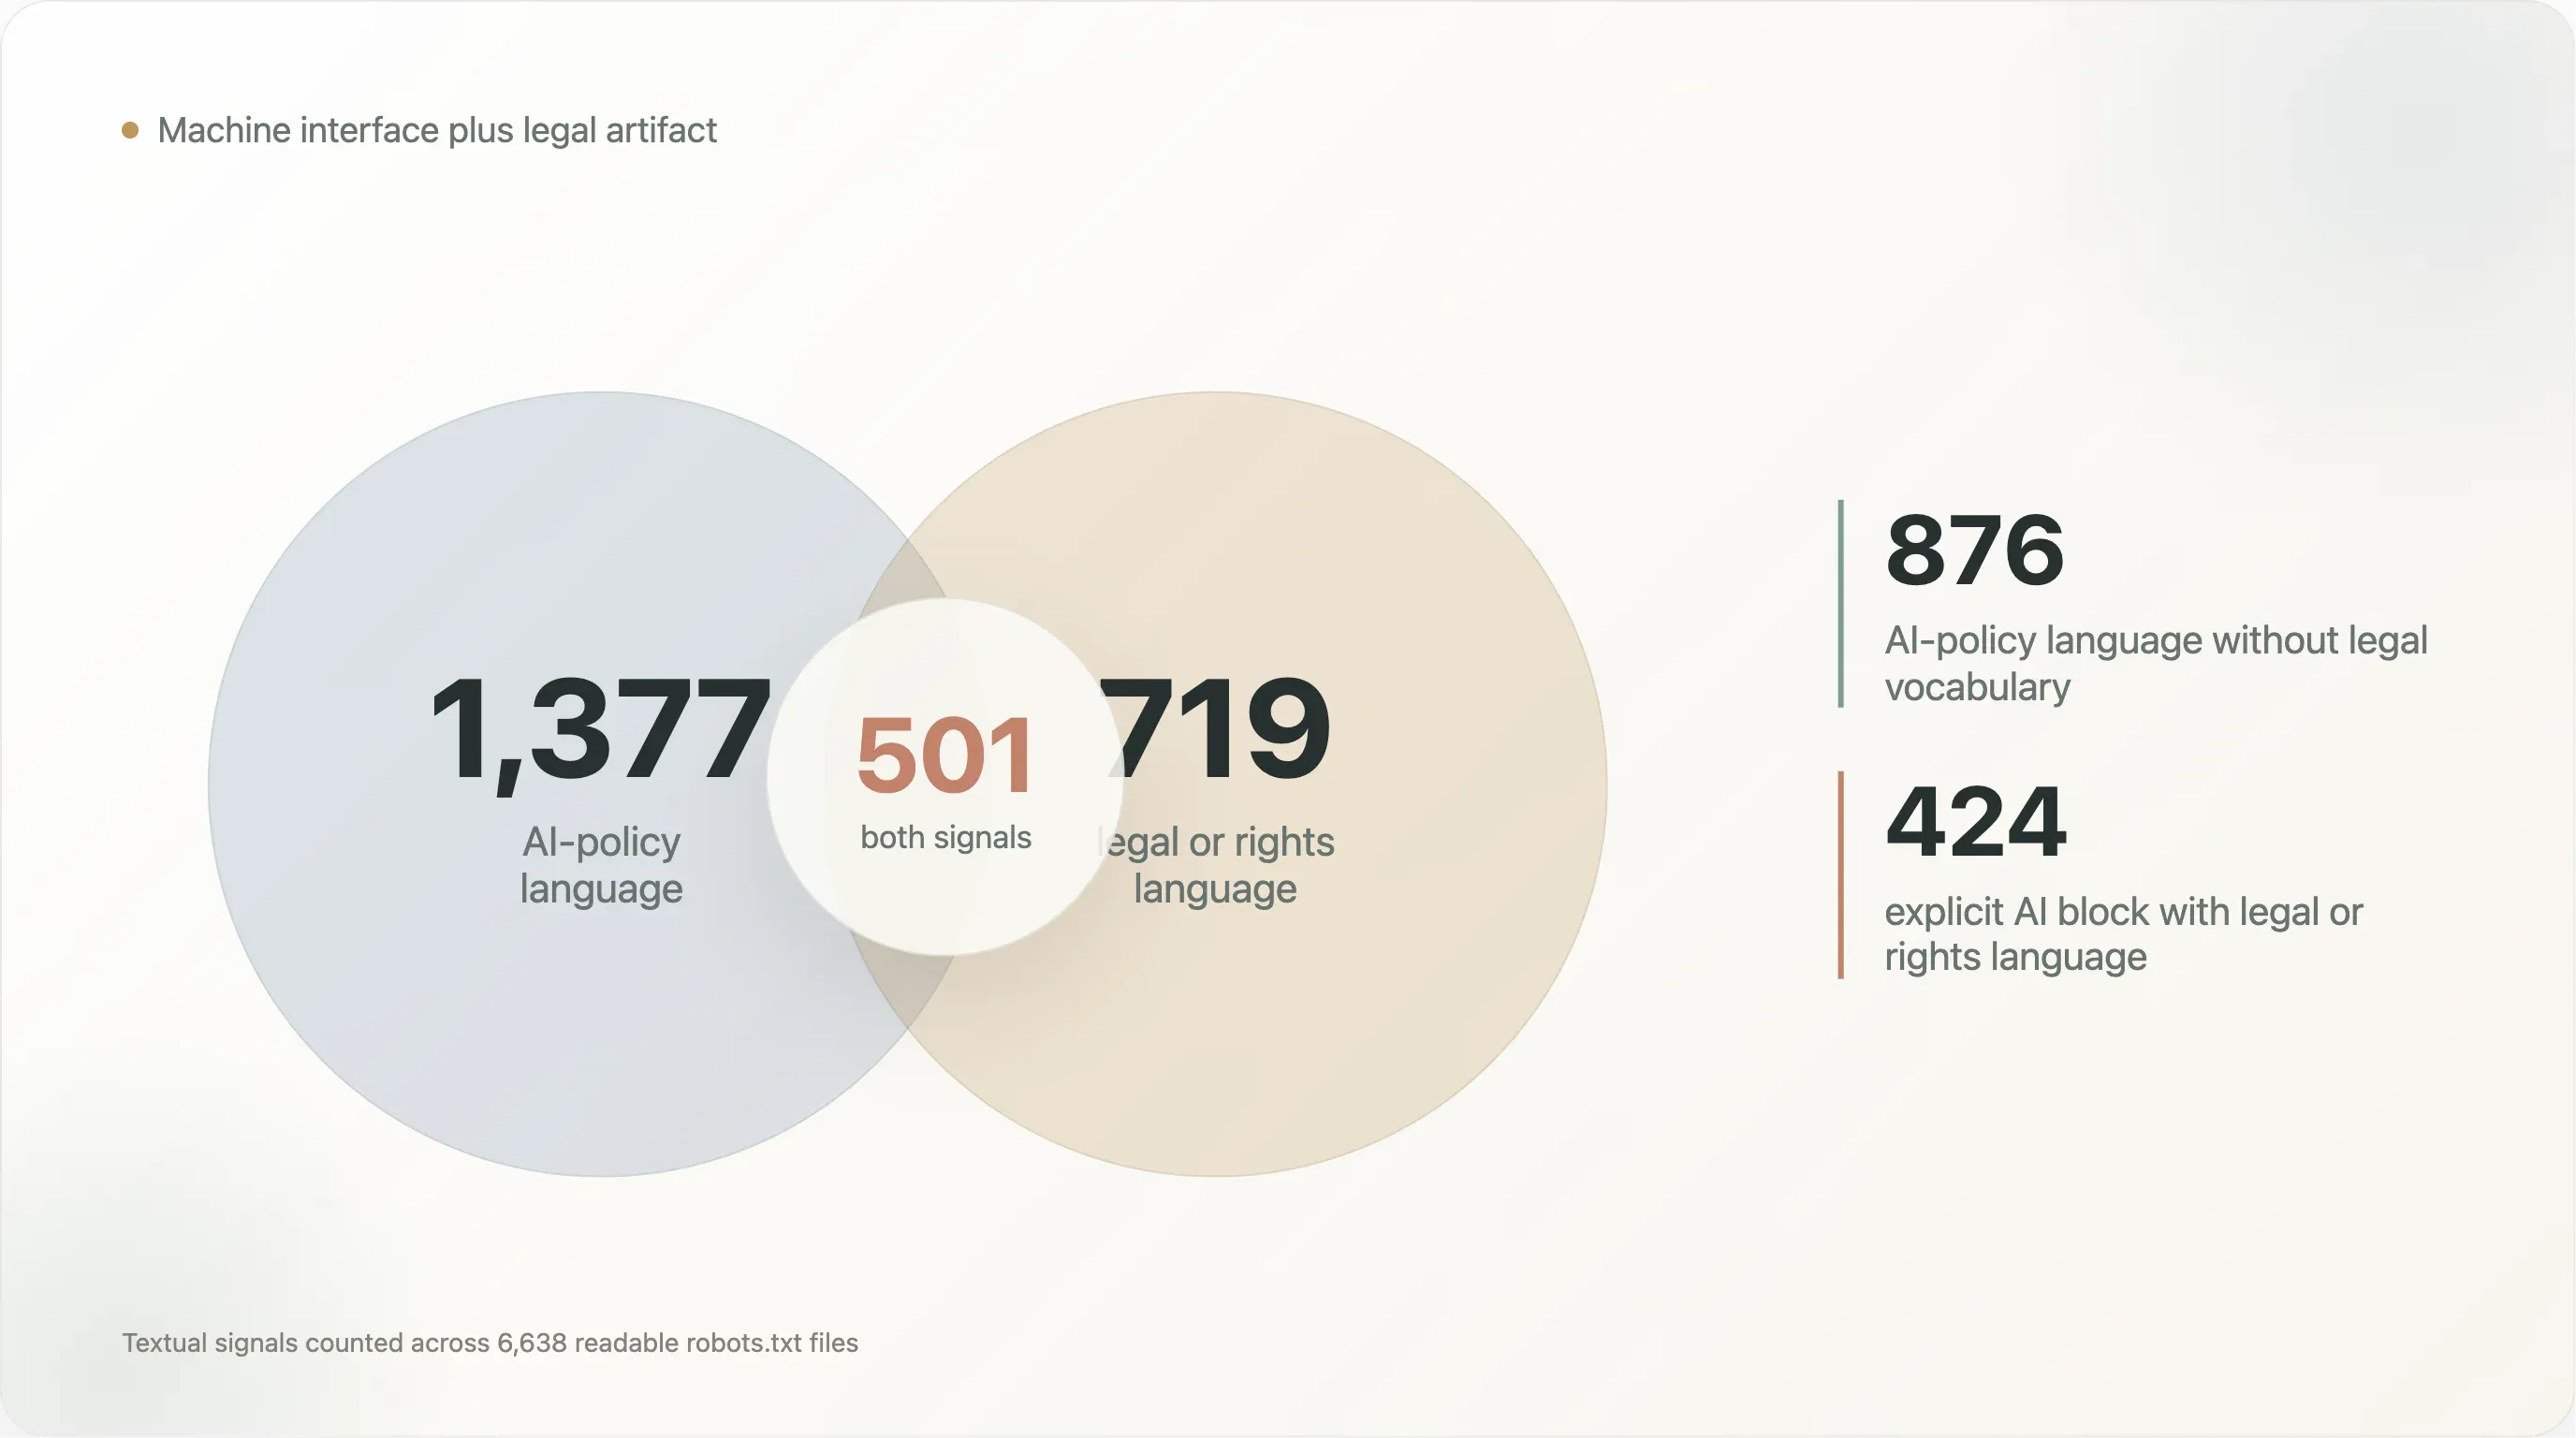
| Metinsel kalıp | Dosyalar |
|---|---|
| AI politikası dili ve hukuki/hak dili | 501 |
| Hukuki/hak dili olmadan AI politikası dili | 876 |
| AI politikası dili olmadan hukuki/hak dili | 218 |
Hukuki/hak dili ile birlikte Content-Signal | 242 |
| Açık AI engeli ile birlikte hukuki/hak dili | 424 |
Bu, yeni bir dosya türü.
Geleneksel bir robots.txt dosyası tarayıcılara hitap eder. Hukuki önsözlü bir robots.txt dosyası ise aynı anda en az dört kitleye hitap eder:
- makine tarafından okunabilir yönergelere ihtiyaç duyan tarayıcı operatörleri;
- politika sinyallerine ihtiyaç duyan arama ve AI satıcıları;
- hak saklama konusunda açık beyan isteyen avukatlar;
- yorumu niyet kanıtı olarak okuyabilecek gelecekteki denetçiler, mahkemeler veya gazeteciler.
Bu çok kitleli tasarım, bazı dosyaların artık politika belgesi gibi okunmasını açıklıyor. Ama aynı zamanda, bir tarayıcının ayrıştırabildiği şey ile bir insan avukatın beyan etmek istediği şey arasındaki temiz ayrımı da zayıflatıyor.
AI politikası dili içerip hukuki söz varlığı içermeyen 876 dosya çoğunlukla makine politikası dosyalarıdır: bot adları, Disallow blokları ve şablon dili. Hem AI hem hukuki dil içeren 501 dosya ise farklıdır. Bunlar aynı anda hem tarayıcı talimatı hem hak saklama beyanı olmaya çalışıyor. AI söz varlığı içermeyen 218 hukuki metin dosyası ise bu kalıbın LLM’lerle başlamadığını gösteriyor; robots.txt, şartları, izin sınırlarını ve hak iddialarını belirtmek için zaten kullanılıyordu.
Örneğin bir yorumda makine öğreniminin yasak olduğu söylenirken, gerçek yönerge bloğu yalnızca bilinen kullanıcı aracılarının bir alt kümesini engelliyor olabilir. Bir site hakları küresel olarak ileri sürerken yalnızca birkaç tarayıcıyı adlandırabilir. Bir CDN şablonu, operatörünün hukuki dili el ile yazmadığı bir dosyaya AI ile ilgili söz varlığı enjekte edebilir. Bir site, gelecekteki tarayıcıları istemeden kapsayan geniş bir User-agent: * kuralı yazabilir.
Yönetişim açısından robots.txt, tam da herkese açık ve makine tarafından okunabilir olduğu için çekicidir. Ancak ne kadar çok politika taşıyorsa, sınırlamaları da o kadar önemli olur:
- Belirli bir politikanın hak sahibi tarafından incelendiğini kanıtlayan bir kimlik doğrulama katmanı yok.
- Yerleşik bir sürüm geçmişi yok.
- Eğitim, retrieval, arama dizinleme, özetleme, önbelleğe alma veya model değerlendirmesi gibi amaçlar için yapısal bir alan yok.
- AI tarayıcı kimlikleri için evrensel bir kayıt yok.
- Uygulama mekanizması yok.
Bu, dosyayı işe yaramaz yapmaz. Onu kırılgan yapar.
Daha doğru yorum şu: robots.txt, bir bildirim katmanına dönüşüyor; tercih ve niyetin herkese açık, denetlenebilir bir beyanı. Tek başına tam bir hak yönetimi sistemi değil.
Bulgu 4: AI Gelmeden Önce de Arama Eşit Değildi
Orijinal rapordaki en güçlü bulgulardan biri, birçok yayıncının AI eğitim tarayıcıları ile arama tarayıcıları arasında ayrım yapmasıydı. CCBot, GPTBot veya Google-Extended engellenirken Google arama görünürlüğü korunuyordu.
Bu devam çalışması farklı bir nokta ekliyor: geleneksel arama tarayıcıları da eşit muamele görmüyor.
Altı arama tarayıcısını kontrol ettik:
- Googlebot;
- Bingbot;
- DuckDuckBot;
- Slurp;
- Baiduspider;
- YandexBot.
Analiz edilebilir 7.248 site boyunca:
| Arama tarayıcısı muamelesi | Siteler |
|---|---|
| En az bir arama tarayıcısını engelliyor | 562 |
| Googlebot’a izin verip en az bir başka arama tarayıcısını engelliyor | 404 |
| Kontrol edilen altı arama tarayıcısının hepsini engelliyor | 152 |
Engellenen bot sayıları eşit dağılmıyor:
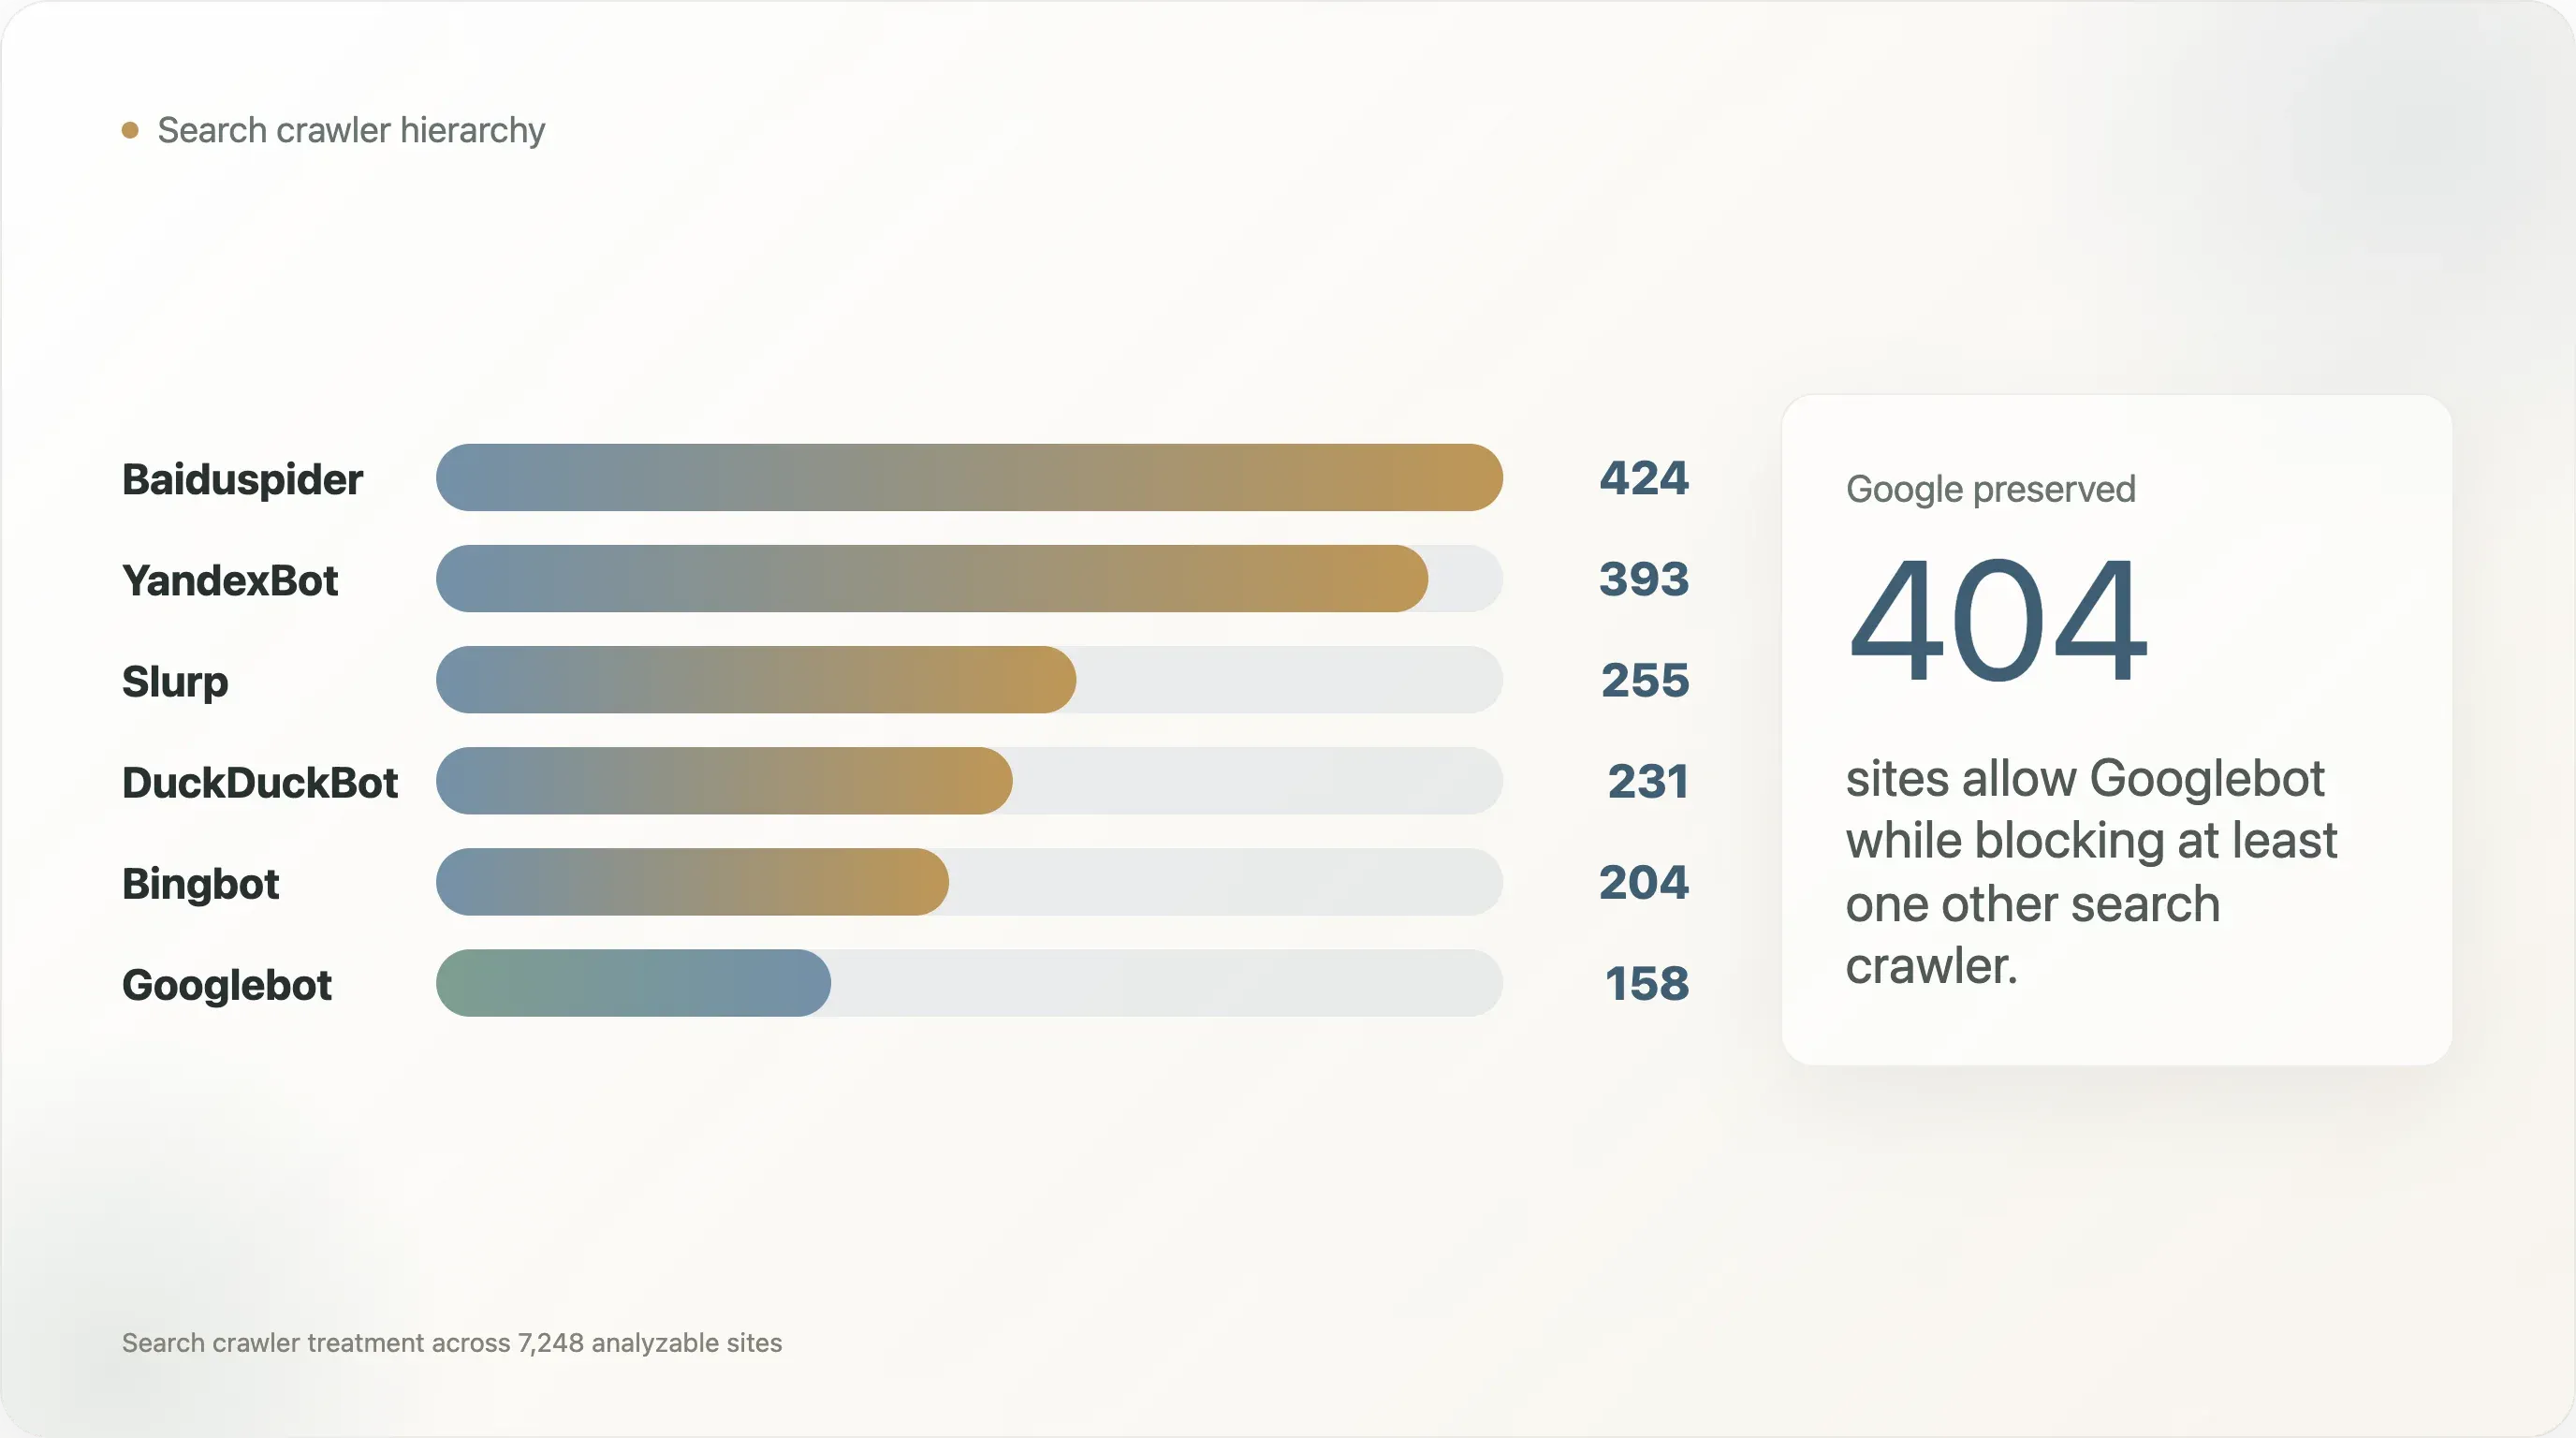
| Arama tarayıcısı | Engelleyen site sayısı |
|---|---|
| Baiduspider | 424 |
| YandexBot | 393 |
| Slurp | 255 |
| DuckDuckBot | 231 |
| Bingbot | 204 |
| Googlebot | 158 |
Googlebot bu sette en az engellenen tarayıcı. Baiduspider ve YandexBot çok daha sık engelleniyor ve bu vakaların çoğunda Googlebot yine de açık bırakılıyor. Googlebot’a izin verip başka bir arama tarayıcısını engelleyen 404 sitenin 269’u Baiduspider’ı, 240’ı YandexBot’u engelliyor.
Örnekler yüksek profilli:
| Alan adı | Googlebot açıkken engellenen arama tarayıcıları |
|---|---|
facebook.com | Baiduspider, YandexBot |
apple.com | Baiduspider |
twitter.com | DuckDuckBot, Slurp, Baiduspider, YandexBot |
netflix.com | DuckDuckBot, Slurp |
x.com | DuckDuckBot, Slurp, Baiduspider, YandexBot |
tiktok.com | Baiduspider |
baidu.com | Bingbot, DuckDuckBot, Slurp, YandexBot |
washingtonpost.com | YandexBot |
wsj.com | YandexBot |
bilibili.com | DuckDuckBot, Slurp, YandexBot |
temu.com | Slurp |
t-mobile.com | Baiduspider, YandexBot |
Bu, AI tartışması için önemli; çünkü robots.txt’nin LLM tarayıcıları gelmeden önce bile tarafsız, evrensel bir erişim protokolü olmadığını gösteriyor. Açık web’in zaten bir hiyerarşisi vardı:
- Googlebot çoğu zaman korunur; çünkü Google arama trafiğini riske atmak fazla değerlidir.
- Bölgesel veya rakip tarayıcılar daha kolay engellenir.
- Bazı siteler arama tarayıcısı erişimini pazar bazında veya satıcı bazında bir karar olarak ele alır.
AI tarayıcıları, farklılaştırılmış erişimin zaten normal olduğu bir ekosisteme girdi.
Bu da politika geçişini anlamayı kolaylaştırıyor. “Google-Extended’i engelle, Googlebot’a izin ver” yazan bir yayıncı yeni bir ayrımcılık biçimi icat etmiyor. Eski bir kalıbı yeni bir tarayıcı sınıfına uyguluyor: dağıtımı koru, çıkarımı kısıtla.
Açık soru ise bu eski kalıbın ölçeklenip ölçeklenemeyeceği. Aramada ekonomik açıdan önemli tarayıcı sayısı bir avuç kadardı. AI’da ise tarayıcı kimliği model satıcıları, retrieval bot’ları, veri komisyoncuları, akademik tarayıcılar, sentetik tarayıcı ajanları ve altyapı düzeyi çekiciler arasında parçalanmış durumda. Ekosistem daha küçük bir amaç temelli sinyal seti etrafında birleşmedikçe adlandırılmış kullanıcı aracılarının sayısı artmaya devam edecek.
Yapılandırma borcu böyle birikir.
Bulgu 5: Karmaşıklık Sektöre Göre Değişiyor, Ama AI Engelleme Oranlarının Değiştiği Gibi Değil
Orijinal rapor, AI engellemede büyük bir sektör farkı göstermişti: haber yüksek oranlarda engelliyor; telekom, devlet ve SaaS düşük oranlarda engelliyor.
Yapılandırma karmaşıklığı ise web’i başka bir şekilde kesiyor.
Karşılaştırma için yeterli sayıda okunabilir robots.txt dosyasına sahip seçili kategoriler arasında:
| Kategori | n | Ortanca bayt | P90 bayt | Ortanca Disallow | P90 Disallow | Ortanca User-agent | P90 User-agent |
|---|---|---|---|---|---|---|---|
| e-ticaret | 215 | 1.738 | 10.388 | 37 | 164 | 3 | 49 |
| seyahat | 63 | 2.074 | 27.368 | 41 | 779 | 5 | 34 |
| haber | 647 | 1.534 | 7.039 | 19 | 114 | 6 | 68 |
| finans | 121 | 1.002 | 8.337 | 17 | 132 | 2 | 23 |
| akademi | 253 | 839 | 3.959 | 14 | 75 | 1 | 11 |
| devlet | 151 | 1.227 | 3.263 | 13 | 46 | 1 | 4 |
| SaaS | 368 | 485 | 12.606 | 4 | 56 | 1 | 10 |
| geliştirici araçları | 119 | 273 | 9.255 | 3 | 58 | 1 | 10 |
Kategoriye göre P90 Disallow grafik alanı burada<<<<<<<<<<<<<<<<<<<<<<<<<
Haber, açık AI kuralları ve hukuki metin yazdığı için politik olarak karmaşık. Ancak e-ticaret ve seyahat, büyük katalogları, fasetli gezinmeyi, arama sonuç sayfalarını, filtreleri, kullanıcı hesabı yollarını ve parametreli URL’leri yönetmek zorunda oldukları için operasyonel olarak karmaşık.
Bu ayrım önemli.
Seyahat bunun en net örneği. Bu kategori diliminde yalnızca 63 okunabilir dosya var, ama P90 robots.txt boyutu 27,4 KB ve P90 Disallow sayısı 779; bu, haberin çok üzerinde. Bu, seyahat sitelerinin daha gelişmiş bir AI politikasına sahip olduğu anlamına gelmiyor. Tarayıcı operatörlerinin bütçesini yanlışlıkla harcayabileceği daha fazla yüzeyleri olduğu anlamına geliyor: tarih aramaları, uygunluk sayfaları, yorum sayfalandırması, rezervasyon akışları, filtre kombinasyonları ve yerelleştirilmiş envanter yolları.
SaaS ise bunun tersindeki sürpriz türü. Ortanca dosyası yalnızca 485 bayt, ama P90 dosya 12,6 KB’ye sıçrıyor. Çoğu SaaS sitesi açık ve hafif; daha küçük bir grup ise uzun yol kontrol dosyaları taşıyor. Bunun nedeni genellikle dokümantasyon, giriş yüzeyleri, uygulama yolları ve pazarlama sayfalarının aynı alan adı altında yaşaması.
Haber, operasyonel olarak ortalarda ama politik olarak en üstlerde yer alıyor. P90 User-agent sayısı 68; bu, tablodaki e-ticaret, seyahat, finans, akademi, devlet, SaaS ve geliştirici araçlarının hepsinden yüksek. Bu, yalnızca yol hijyeninin değil, bota özel politikanın da işareti.
Bir yayıncının robots.txt dosyası hak politikası nedeniyle karmaşık olabilir. Bir pazar yerinin dosyası tarama bütçesi yönetimi nedeniyle karmaşık olabilir. Bir üniversitenin dosyası, tek bir alan adı altında birikmiş binlerce eski yol nedeniyle karmaşık olabilir. Bir sosyal platformun dosyası, dev ölçekte bazı yüzeyleri açıp bazılarını bastırmak zorunda olduğu için karmaşık olabilir.
AI politikası bunların hepsinin üzerine gelir. Dosyanın karmaşık olmasının mevcut nedenlerinin yerini almaz.
Bu da AI çağı robots.txt yönetişiminin neden evrensel bir blok listesiyle çözülemeyeceğini açıklar. Alttaki dosyaların işleri farklıdır:
- e-ticaret siteleri yinelenen yolları ve envanter yüzeylerini yönetir;
- seyahat siteleri listelemeleri, takvimleri, yorumları ve dinamik arama sayfalarını yönetir;
- haber siteleri telif hakkını, arşivleri ve lisans duruşunu yönetir;
- SaaS ve geliştirici araçları siteleri çoğu zaman AI görünürlüğü ister;
- devlet kurumları genellikle kamu erişimine ihtiyaç duyar, ama yine de dışlanması gereken hassas sistemler olabilir;
- sosyal platformlar kullanıcı tarafından üretilen içerikleri, profil yüzeylerini ve kötüye kullanım karşıtı endişeleri yönetir.
Aynı AI tarayıcı kuralı, her ortamda farklı bir anlama gelir.
Bulgu 6: Yapılandırma Borcu Endeksi Ahlaki Başarısızlığı Değil, İnceleme Riskini Belirler
Bu analiz, incelenmesi zor olması muhtemel robots.txt dosyalarını belirlemek için basit bir yapılandırma borcu puanı oluşturdu.
Puan şu unsurları ağırlıklandırır:
- dosya boyutu;
User-agentyönergesi sayısı;Disallowyönergesi sayısı;Allowyönergesi sayısı;- çekirdek dışı yönerge sayısı;
- AI politikası dili varlığı;
- açık AI engelleme ile hukuki veya telif hakkı dili karışımı.
Bu bir doğruluk puanı değildir. Yüksek karmaşıklıktaki bir dosya tamamen niyetli olabilir. Düşük karmaşıklıktaki bir dosya yine de yanlış olabilir. Amaç önceliklendirmedir: bir dosya büyükse, politika yüklüyse, bota özgüyse ve istisnalarla doluysa, daha güçlü bir inceleme disiplinini hak eder.
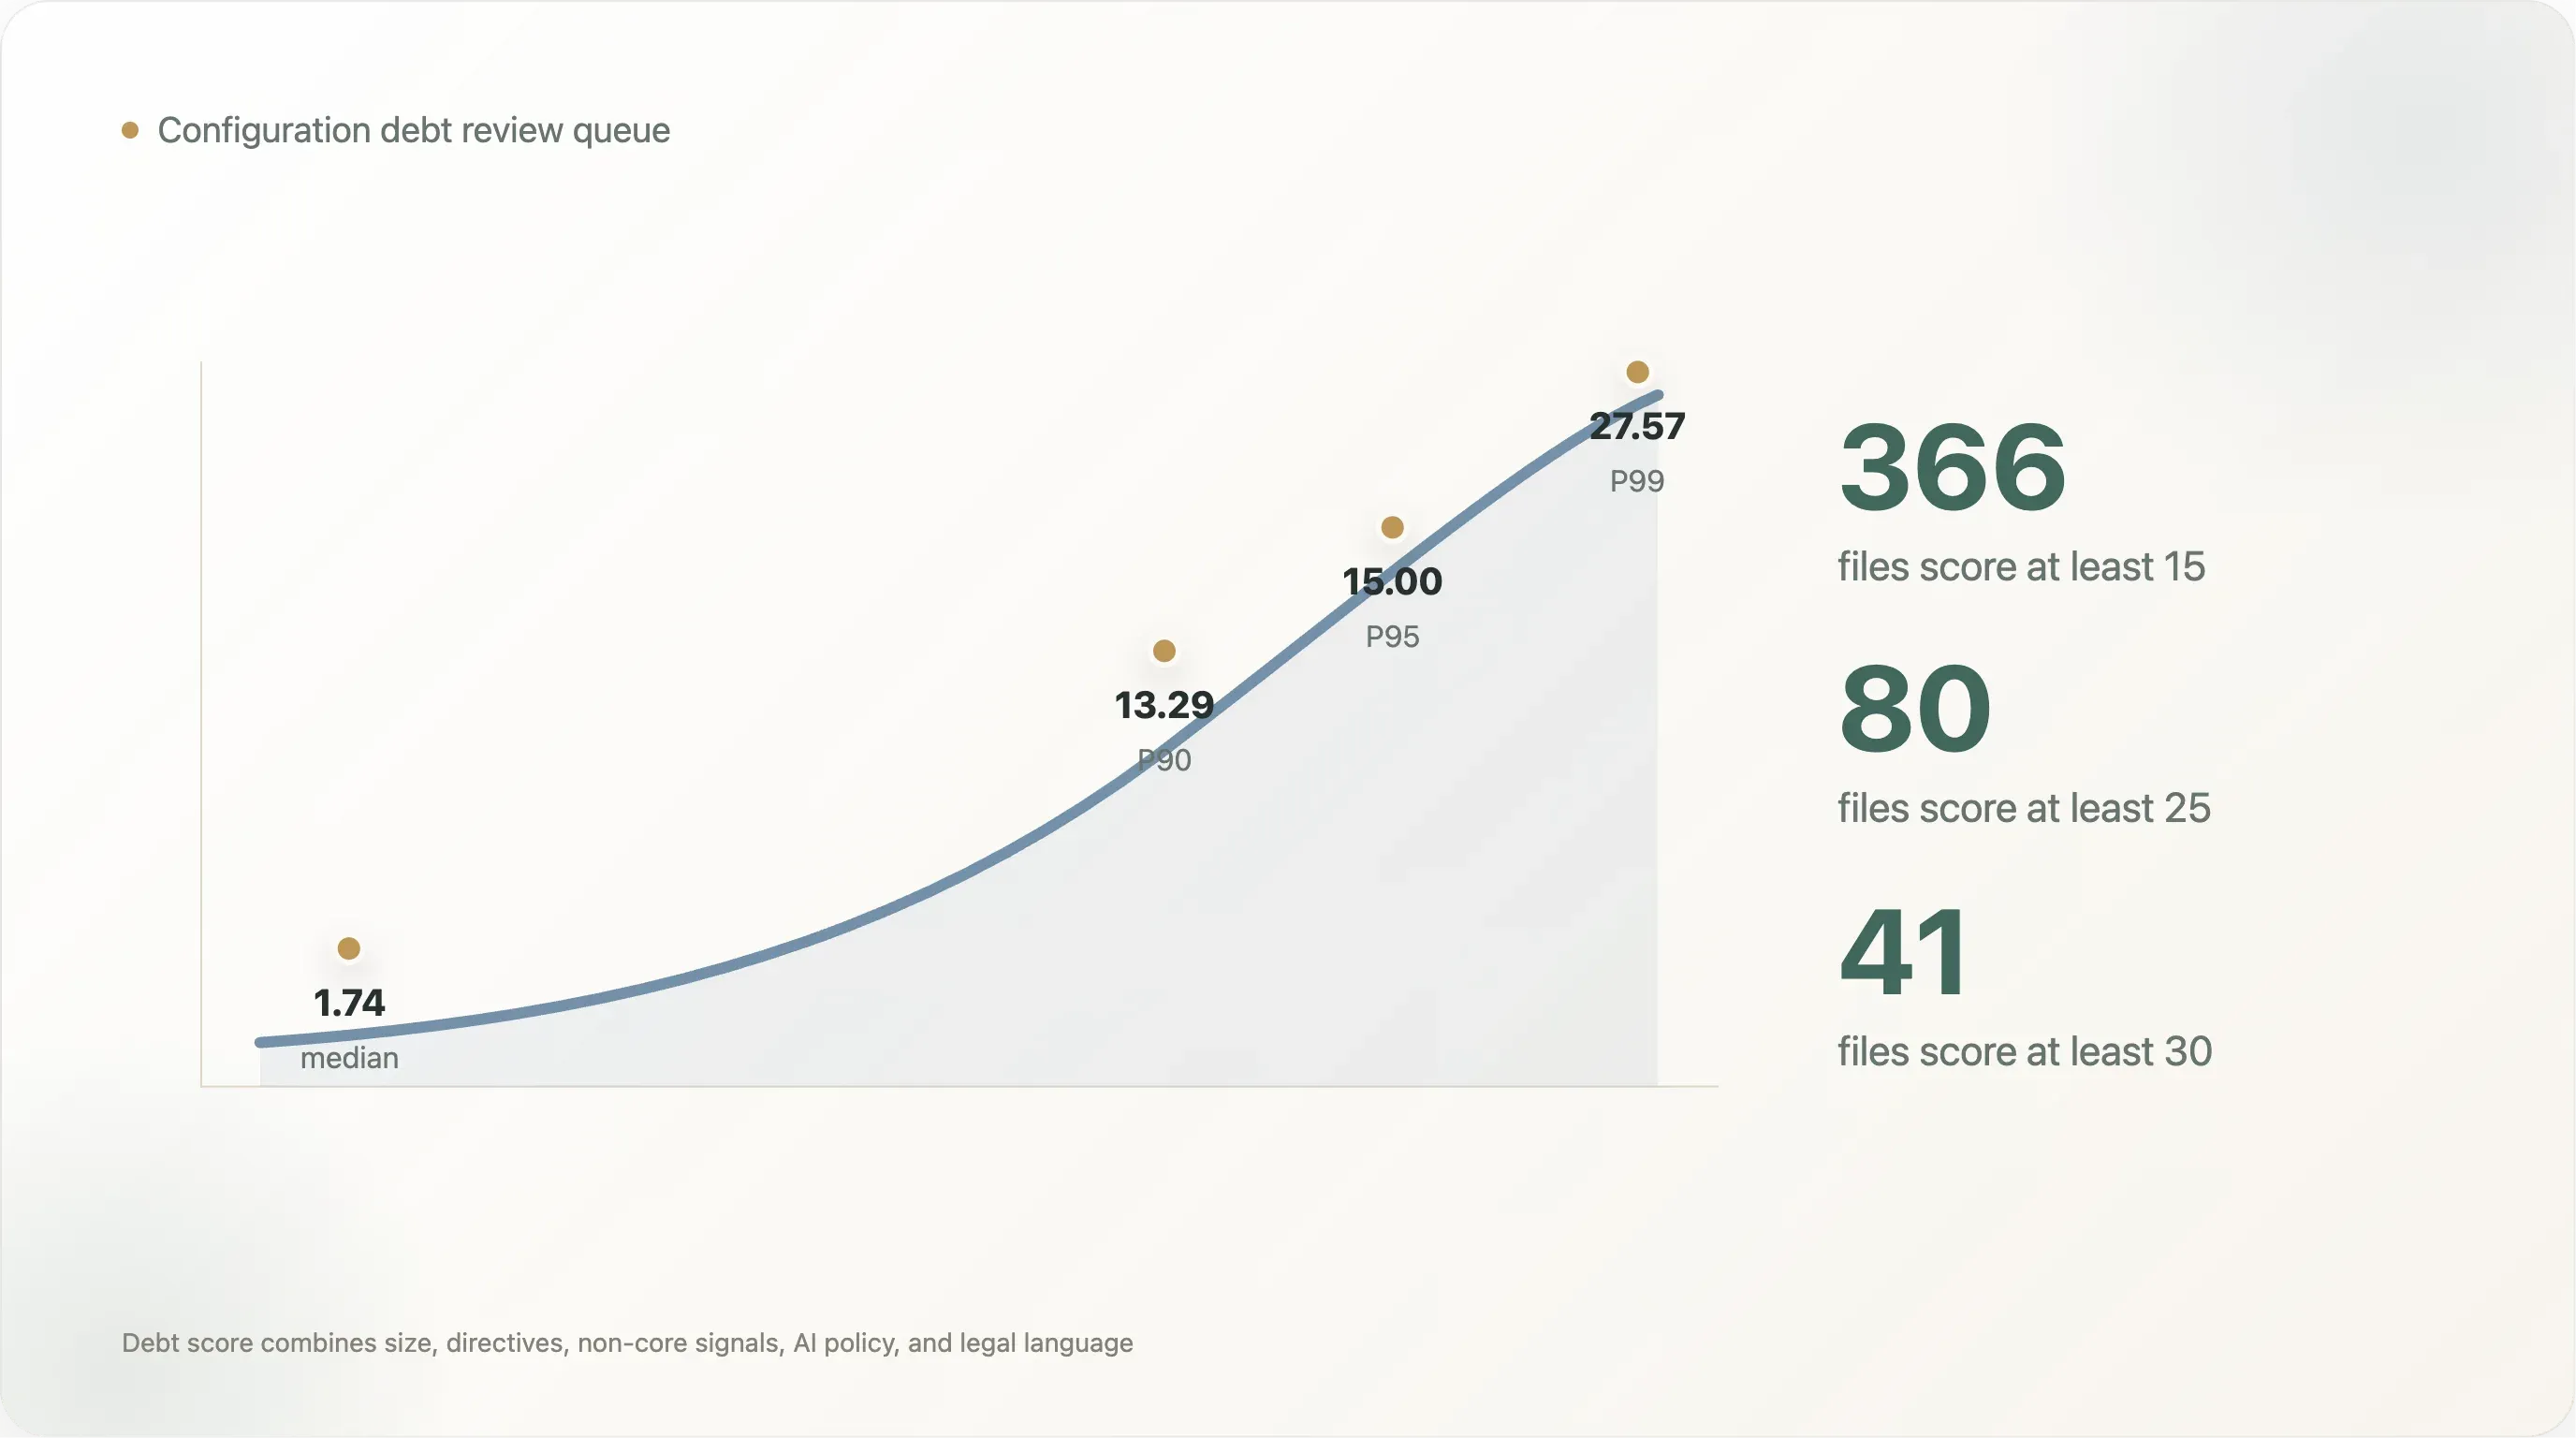
Puan dağılımı diktir. Okunabilir dosyaların ortanca puanı 1,74. P90 puanı 13,29, P95 15,00 ve P99 27,57. Sadece 366 dosyanın puanı en az 15, 80 dosyanın en az 25 ve 41 dosyanın en az 30. Bu, pratik inceleme kuyruğu: her sitenin bir yönetişim projesine ihtiyacı yok, ama üst kuyrukta olanların var.
Kategori görünümü de neden tek bir “AI engelleyici” etiketinin fazla düz olduğunu gösteriyor:
| Kategori | Ortanca puan | P90 puan |
|---|---|---|
| seyahat | 4,92 | 28,94 |
| arama | 2,97 | 24,23 |
| sosyal | 2,25 | 15,00 |
| haber | 4,91 | 14,92 |
| finans | 1,67 | 12,61 |
| SaaS | 0,98 | 11,85 |
| e-ticaret | 3,88 | 10,87 |
| devlet | 1,57 | 6,38 |
Seyahat ve arama en yüksek P90 puanlarına sahip; çünkü dosyaların küçük bir kısmı çok büyük ve kural yüklü hâle geliyor. Haber, kategori genelinde politika dili ve bota özel muamele daha yaygın olduğu için en yüksek ortanca puanlardan birine sahip. E-ticaret yüksek bir ortanca Disallow sayısına sahip, ancak P90 borç puanı seyahatten daha düşük; çünkü karmaşıklık, karışık politika/hukuk sinyallerinden çok yol kurallarında yoğunlaşıyor.
Bu veri setindeki en yüksek puanlı dosyalar arasında şunlar var:
| Alan adı | Neden yüksek puan alıyor |
|---|---|
linkedin.com | Çok büyük dosya, binlerce yol kuralı, çok sayıda adlandırılmış kullanıcı aracısı, açık AI politikası dili |
lnkd.in | LinkedIn kısa bağlantı altyapısıyla aynı politika yüzeyi |
fragrantica.com | Yüzlerce adlandırılmış kullanıcı aracısı bloğu artı AI politikası dili |
sovcombank.ru | Yüzlerce kullanıcı aracısı bloğu ve hukuki/politika dili |
academia.edu | Büyük allow/disallow matrisi ve açık AI engelleme politikası |
opentable.com | Büyük yol kuralı seti, çok sayıda sitemap yönergesi, AI ile ilgili politika yüzeyi |
etsy.com | 1.600’den fazla Disallow kuralı içeren büyük e-ticaret yol kontrol dosyası |
runescape.com | Tek bir user-agent grubu altında neredeyse 5.000 Disallow yönergesi |
Bu dosyalar karmaşık oldukları için küçümsenmemeli. Karmaşıklık çoğu zaman gerçek iş ihtiyaçlarını yansıtır. Ama aynı zamanda robots.txt politikasının diğer üretim yapılandırmalarıyla aynı mühendislik disiplinini hak ettiğini gösterir:
- sahiplik açık olmalı;
- değişiklikler gözden geçirilmeli;
- üretilen bölümler etiketlenmeli;
- hukuki yorumlar mümkün olduğunca makine yönergelerinden ayrılmalı;
- kritik tarayıcılar için beklenen bot erişimini doğrulayan test vakaları olmalı;
- sürüm geçmişi korunmalı;
- eski bot adları emekliye ayrılmalı veya belgelenmeli;
- AI eğitimi, AI retrieval, arama dizinleme ve arşivleme ayrı amaçlar olarak ele alınmalı.
Son madde en önemlisidir. Mevcut dilbilgisi kullanıcı aracısı önceliklidir: site operatörlerinden botları adlandırmasını ister. AI çağının ihtiyacı ise amaç önceliklidir: site operatörlerinden hangi kullanımların izinli olduğunu söylemesini ister.
Bunlar aynı şey değil.
Uzun blok listelerinin iyi yaşlanmamasının nedeni bu uyumsuzluktur. Bir yayıncı bugün GPTBot, ClaudeBot, CCBot, Google-Extended, Bytespider, Applebot-Extended ve PerplexityBot ekleyebilir; ama yarın yeni bir tarayıcı adı, retrieval ajanı veya veri komisyoncusu ortaya çıkabilir. Amaç temelli bir politika, robots.txt’yi botlardan oluşan bir adres defterine çevirmeden “arama dizinleme evet, AI eğitimi hayır, kullanıcı tetiklemeli retrieval belki” deme imkânı verir.
AI Yönetişimi İçin Bu Ne Anlama Geliyor?
Kamusal tartışma çoğu zaman robots.txt’yi ya anlamlı ya da artık geçersiz olarak çerçeveliyor. Veri daha pratik bir cevap öneriyor:
robots.txt anlamlıdır, ama aşırı yüklenmiştir.
Anlamlıdır; çünkü büyük siteler bunu kullanır, tarayıcılar ayrıştırabilir ve politika seçimleri araştırmacılar, gazeteciler, satıcılar ve mahkemeler için görünürdür. Orijinal rapor, analiz edilebilir üst sitelerin %17,0’sinin kasıtlı AI’ya özgü kurallara sahip olduğunu buldu. Bu, sembolik gürültü değil.
Aşırı yüklenmiştir; çünkü dosya artık bot erişiminden fazlasını ifade etmek zorunda:
- “Bu içeriği eğitim için kullanma.”
- “Bu içeriği arama dizinleme için kullanabilirsin.”
- “Bu içeriği canlı retrieval için kullanabilirsin.”
- “Önbelleğe alınmış veri kümeleri oluşturamazsın.”
- “Bu hukuki saklama beyanı AB metin ve veri madenciliği hukuku kapsamında geçerlidir.”
- “Bu CDN tarafından yönetilen site
Content-Signal: ai-train=nogönderiyor.” - “Bu site Googlebot’u istiyor ama YandexBot’u istemiyor.”
- “Bu sitenin taranmaması gereken 1.000 eski URL yolu var.”
Bu kadar çok iş için tasarlanmış bir dilbilgisi yoktu.
Borcu azaltacak üç değişiklik var:
-
Tarayıcı kimliği için bir kayıt sistemi gerekiyor. Site operatörleri, sürekli büyüyen bir
GPTBot,ClaudeBot,anthropic-ai,CCBot,Google-Extended,Applebot-Extended,Bytespider,OAI-SearchBot,ChatGPT-Userve daha nicelerinin listesini yönetmek zorunda kalmamalı. Bir kayıt sistemi olmadan politika, tarayıcı davranışının hep gerisinde kalır. -
AI kullanımı için yapısal söz varlığı gerekiyor. Eğitim, retrieval, indeksleme, özetleme, veri seti yeniden satışı, model değerlendirmesi ve kullanıcı tetiklemeli gezinme farklı kullanımlardır. Bunları satıcıya özgü kullanıcı aracısı adları üzerinden ifade etmek kırılgandır.
-
Politikanın denetlenebilir olması gerekiyor. Web, hak saklama beyanlarının mı el ile yazılmış, mı CDN varsayılanlarından miras kalmış, mı CMS şablonları tarafından üretilmiş, mı eski kuralların kalıntısı, mı kazara tümünü kapsayan bloklar olduğunu ayırt edebilmenin bir yoluna ihtiyaç duyuyor. Bu ayrım güven ve dava süreçleri açısından önemlidir.
Bunların hiçbiri robots.txt’yi bir gecede değiştirmek anlamına gelmiyor. Daha iyi yol katmanlı bir yaklaşım: robots.txt’yi keşif ve uyumluluk yüzeyi olarak koru, ancak AI’ya özgü kullanımlar için yanında makine tarafından okunabilir politika standardize et.
llms.txt bu girişimlerden biri, ama bu veri setinde benimsenme hâlâ çok düşük: yalnızca 83 okunabilir dosya bundan söz ediyor. Content-Signal daha görünür; çünkü Cloudflare bunu altyapı üzerinden dağıtabiliyor ve bu taramadaki 271 Content-Signal dosyasının tamamı AI politikası diliyle de eşleşti. Yine de dağıtım, uzlaşıyla aynı şey değil. Kalıcı bir çözüm muhtemelen standardizasyonun sıkıcı ama gerekli mekanizmasına ihtiyaç duyacak: net alanlar, net semantik, tarayıcı taahhütleri ve kamuya açık test paketleri.
Sonuç
AI tarayıcı savaşı, robots.txt’yi bir yönetişim nesnesine dönüştürdü. Bu hem yararlı hem riskli.
Yararlı; çünkü dosya herkese açık. Araştırmacılar onu denetleyebilir. Yayıncılar değiştirebilir. Tarayıcılar ona uyabilir. Mahkemeler okuyabilir. Altyapı sağlayıcıları onu ölçekli biçimde dağıtabilir.
Riskli; çünkü dosya artık çok fazla yük taşıyor.
Tranco Top 10K içindeki ortanca robots.txt dosyası hâlâ anlaşılabilecek kadar küçük. Ama yüksek trafikli web’in uzun kuyruğu; büyük, eski, katmanlı, satıcıya özgü ve hukuki olarak yüklü dosyalarla dolu. Yüzlerce site artık robots.txt yapılandırmasını basit tarayıcı ipuçlarından çok üretim politika sistemleri olarak yönetiyor.
Merkezi ders, robots.txt’nin başarısız olduğu değil. Web’in onu yeniden düzenlemeden terfi ettirmiş olması.
Eğer AI erişim politikası makine tarafından okunabilir kamu beyanlarına dayanacaksa, bir sonraki adım daha uzun bir blok listesi değil. Daha iyi politika altyapısıdır: amaç temelli izinler, sabit tarayıcı kimliği, gözden geçirilebilir şablonlar ve denetim izleri.
O zamana kadar, açık web’in AI yönetişim katmanı, bu kadar yük taşımak için hiç tasarlanmamış bir metin dosyasına dayanmayı sürdürecek.
Yeniden Üretilebilirlik Notları
Teslim klasörü şunları içerir:
source_data/analysis.json— orijinal toplulaştırılmış metrikler.source_data/site_meta.csv— orijinal site başı analiz tablosu.source_data/bot_status.csv— orijinal alan adı-bot politika tablosu.source_data/fetch_meta.csv— orijinal çekim meta verisi.source_data/sites.csv— orijinal alan adı/kategori/durum tablosu.derived_data/robots_complexity_by_site.csv— bu rapor için üretilen site başı karmaşıklık metrikleri.derived_data/search_bot_treatment.csv— arama tarayıcısı muamele matrisi.derived_data/category_complexity_summary.csv— kategori düzeyi karmaşıklık özeti.derived_data/top_config_debt_sites.csv— yukarıda açıklanan öncelik puanına göre en üstteki siteler.derived_data/summary_metrics.json— bu raporda alıntılanan tüm başlıca metrikler.
Tüm komut dosyalarını ve veri kümelerini indir
Yöntem düzeltmeleri, veri kümesi sorunları ve takip analizleri için support@thunderbit.com adresine yazabilirsiniz. Bu rapor, Thunderbit’in elindeki herhangi bir ticari konumdan bağımsız olarak yayımlanmıştır; biz AI destekli bir web kazıyıcı geliştiriyoruz ve robots.txt’nin açık web’de anlamlı, makine tarafından okunabilir bir sözleşme olarak kalmasında yapısal bir çıkarımız var. Bu rapordaki veriler kendi başına değerlidir. — Thunderbit araştırma ekibi, Mayıs 2026.
AI Web Kazıma için Thunderbit’i deneyin Get Started Free



