
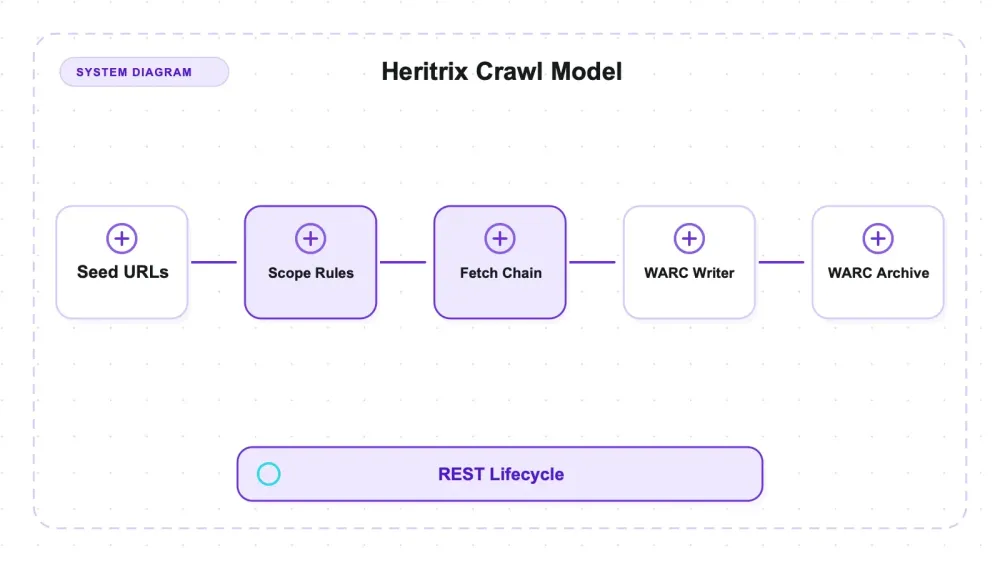
Heritrix, Internet Archive’in açık kaynaklı arşiv tarayıcısıdır — Wayback Machine’in arkasındaki yazılım soyunun bir parçasıdır ve yirmi yıldır üretimde kullanılıyor. Görevi, bir sitenin sunduğu içeriği eksiksiz biçimde WARC dosyalarına kaydetmek ve yıllar sonra yeniden oynatılabilecek bir arşiv oluşturmaktır. Kaputun altında, her taramanın XML ile tanımlanan bir Spring bean grafiği olduğu bir Java motoru çalışır; tüm iş akışı da bir REST API üzerinden yönetilir. Bu bir scraper değildir: seçici sözdizimi yoktur, alan eşleme yoktur, sonunda tablo satırları da yoktur.
3.16.0 sürümünü kontrollü bir yerel test ortamında denedim ve gerçekten ne yazdığını kayıt kayıt inceledim. Ortaya çıkan şeyin en dikkat çekici yanı eksiksizlikti: yirmi alınan URI, altmış bir WARC kaydı üretti; her yanıtta payload digest ve capture IP bilgisi vardı, her istek de ait olduğu yanıta WARC-Concurrent-To ile bağlanmıştı. Bunların hiçbiri için ayarlarla uğraşmak gerekmedi. İşletme tarafında ise tablo tersine dönüyor: 41 MB’lık dağıtım paketi, 114 jar dosyası (lib/ içinde 142 dosya var; kalan 28’i paketlenmiş LICENSE ve NOTICE metinleri), ilk istekten önce yaklaşık 750 satırlık job konfigürasyonu — buna karşın burada yapılan her tarama curl ile headless biçimde çalıştı, hiçbir web arayüzü tıklaması yapılmadı.
Depolama sonucunda, ilk bakışta fark edilmeyen bir varsayılan da ortaya çıktı. Test ortamındaki iki URL byte-byte aynı içeriği döndürüyordu; stock profil ikisini de tam olarak çekip arşivledi: iki response kaydı ve sıfır revisit kaydı, üstelik iki yanıta da aynı payload digest atanmış olmasına rağmen. Content-digest deduplication, geçmiş işleyicileri eklendikten sonra çalışıyor; stock profilde açık değil ve bant genişliğinden çok depolama alanı tasarrufu sağlıyor.
Heritrix aslında nedir?
Arşivleme, scraping değildir; bu kategoriler karıştığında ortaya çıkan kafa karışıklığını netleştirmek gerekiyor. Heritrix size satır vermez. Sonunda bir CSV üretmez. Çıktısı, koruma amacıyla tasarlanmış bir format içinde saklanan HTTP konuşmasının kendisidir — başlıklar, gövdeler ve capture metadatası — ve bu işin referans uygulamalarından biridir. Ondan bir ürün fiyat listesi istemek, mahkeme stenografından özet beklemeye benzer.
27 Temmuz 2026 itibarıyla güncel sayılar şöyle: repo 3.285 yıldız ve 36 açık issue seviyesinde; 3.16.0 ise 2026-07-03 tarihinde yayımlanan en son sürüm. Benim test ettiğim tam olarak bu derlemeydi; dolayısıyla burada anlatılanlar eski sürüm şikâyeti değil. Lisans tarafında küçük bir ayrıntı var: LICENSE dosyası düz Apache-2.0, ancak GitHub’ın kendi algılayıcısı bazı paketlenmiş üçüncü taraf dosyalar farklı koşullar taşıdığı için "Other" olarak işaretliyor. Heritrix ticari bir ürünün içine girecekse, bu durum yan rozetine bir bakış atmaktan ziyade, birinin hukuk ekibine ayıracağı beş dakikalık bir konu.
Genel çerçeveyi belirleyen bir yapısal gerçek var: Heritrix bir tarayıcı çalıştırmaz. HTTP üzerinden veri çeker ve dönen baytlardan linkleri ayıklar. Modern arşivlemedeki kardeşi Browsertrix Crawler ise tam tersini yapar — gerçek Chromium kullanır ve tarayıcının gerçekten ne yaptığını kaydeder. İkisi de WARC yazar; ancak bu inceleme yalnızca Heritrix’in tarayıcı olmayan yolunu ölçtü, ölçek ya da throughput karşılaştırması yapmadı.
Zincirler, bean’ler ve SURT: bir tarama gerçekte nasıl kurulur?
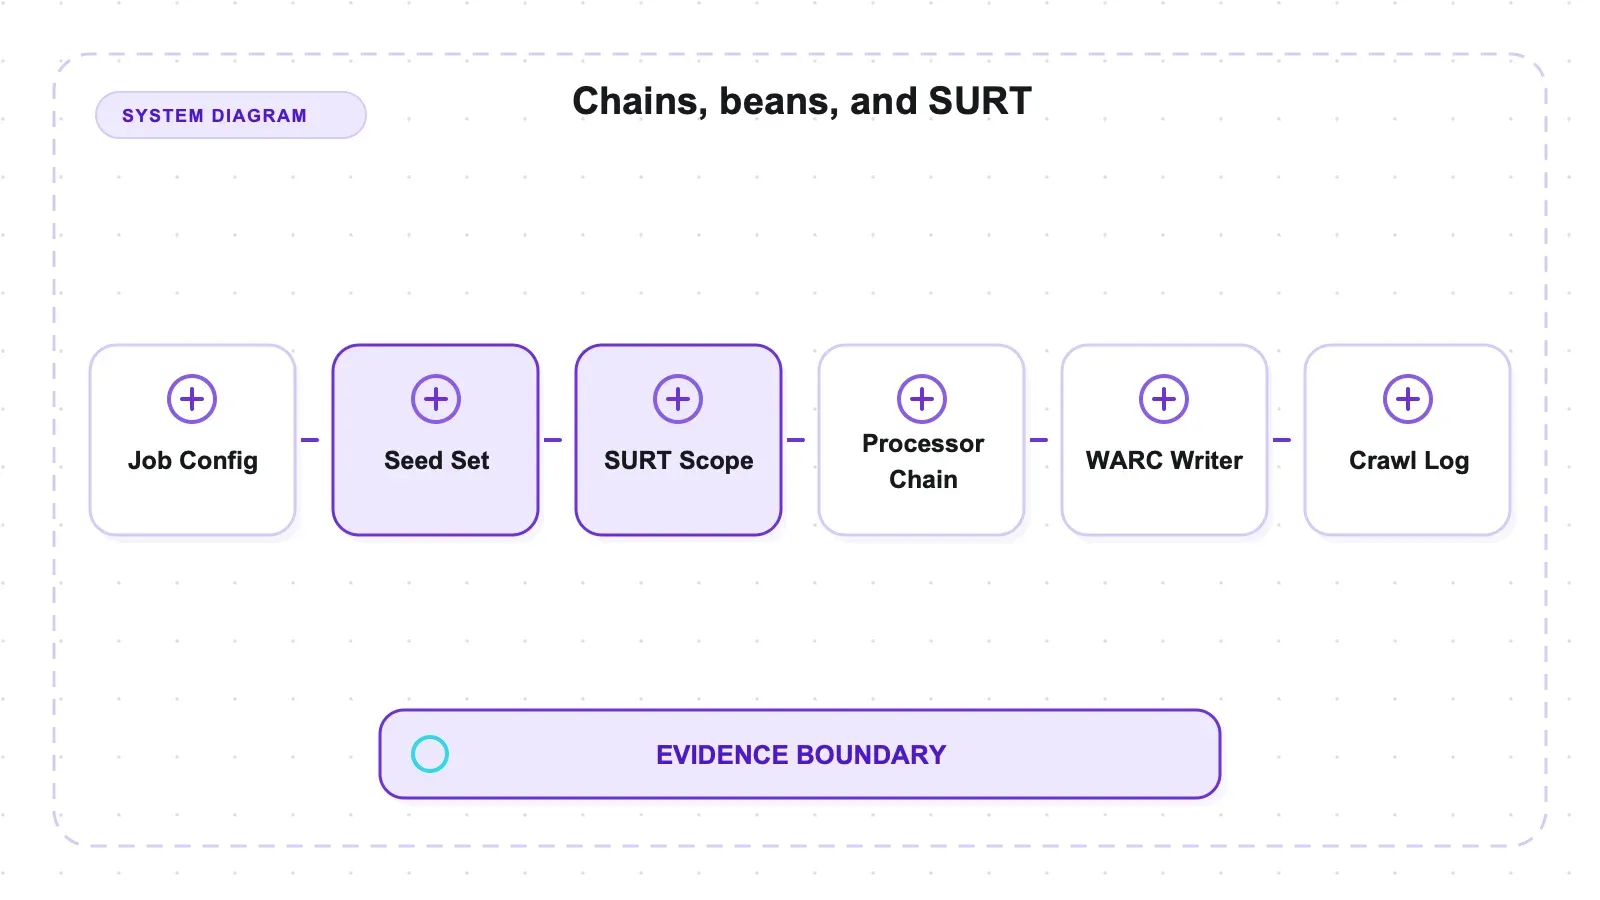
Kaputun altında Heritrix job’ı bir Spring application context’tir. "Spring ile yapılandırılmış" olmakla kalmaz — kendisi XML ile yazılmış bir Spring bean grafiğidir ve taramanın her parçası değiştirilebilir bir bean olarak gelir.
Frontier, URI kuyruğunu host bazında bölümlere ayırarak tutar. Politeness mantığının nasıl çalıştığını belirleyen şey de bu bölümlenmedir; birazdan önemi daha da artacak.
Processor zincirleri işi üç aşamada yürütür: candidate chain (keşfedilen URI planlanmalı mı?), fetch chain (DNS, robots, HTTP fetch, link çıkarımı) ve disposition chain (WARC’a yaz, durumu güncelle). Heritrix’e yeni bir yetenek eklemek genelde doğru zincirin doğru noktasına bir processor bean yerleştirmek anlamına gelir; dedup’u açmam da tam olarak bu şekilde oldu.
Scope, SURT üzerinde çalışan DecideRules yığınından oluşur — Sort-friendly URI Reordering Transform; örneğin http://www.example.com/a adresini http://(com,example,www,)/a biçimine çevirir, böylece hostname önekleri hiyerarşik şekilde sıralanır. Varsayılan scope, seed’lerinizin SURT öneklerinden üretilir. Kurallar sırayla kabul eder veya reddeder; son eşleşen kazanır.
WARC yazıcı, disposition zincirinde yer alır; politeness ise frontier içinde üç sayıyla tanımlanır: delayFactor, minDelayMs, maxDelayMs. Robots uyumu ise fetcher üzerindeki bir politika dizesidir.
Ve tüm bunlar bir REST API üzerinden yönetilebilir; beklediğimden çok daha önemli olan da bu oldu.
Kurulum, tüm deneyimin en ağır kısmı
İlk istekten önce kurduğunuz yapı:
| Kurulum boyutu | Heritrix 3.16.0 |
|---|---|
| Dağıtım tarball boyutu | yaklaşık 41 MB |
Açıldıktan sonra lib/ içindeki dosya sayısı | toplam 142: 114 .jar dosyası ve 28 LICENSE/NOTICE metni |
| Başlatınca ne açılır | self-signed sertifika arkasında https://localhost:8443 üzerinde çalışan bir Java motoru ve gömülü Jetty web arayüzü |
| REST’e hazır hale gelme süresi, benim makinemde | yaklaşık on saniye |
Stock job konfigürasyonu (crawler-beans.cxml) | yaklaşık 750 satırlık Spring bean XML |
Bu job konfigürasyonunun büyük kısmına hiç dokunmazsınız. Ama atlayamazsınız da; tarayıcı herhangi bir şeyi çekmeden önce iki alan zorunludur: seed’iniz ve metadata.operatorContactUrl. Stock değer bir yer tutucudur ve tarama yapan kişiyi tanımlayan gerçek bir URL ile değiştirilmeden çalışmaz.
Bu gereklilik, bir hesap verebilirlik noktası oluşturuyor: operatör, tarayıcı çalışmadan önce bir iletişim URL’si sağlamak zorunda. Bu, kimliğin doğru olduğunu, taramanın yetkili olduğunu ya da ilgili kurallara uyduğunu kanıtlamaz; fakat iletişim bilgisini isteğe bağlı bir gelenek olmaktan çıkarıp işin parçası haline getirir.
Kurulumda beni gerçekten şaşırtan iki şey oldu.
Belgelendirmedeki minimumdan daha yeni bir JDK üzerinde çalıştı. Getting Started dokümanları Java 17 veya daha yenisini istiyor. Heritrix 3.16.0, OpenJDK 26.0.1 üzerinde sorunsuzca açıldı, REST API’sini sundu ve bu testteki her taramayı tamamladı; --add-opens, --enable-preview ya da Security Manager geçici çözümlerine gerek kalmadı. Bu, macOS arm64 üzerinde alınmış tek bir sonuç; bir uyumluluk matrisi değil, ama test edilen bu derlemenin bu makinede JDK 17 ile sınırlı olmadığını gösteriyor.
Web arayüzüne hiç dokunmak zorunda değilsiniz. Tüm iş yaşam döngüsü REST üzerinden yönetiliyor; ben de her şeyi curl ile otomatikleştirdim: job oluştur, beans dosyasını PUT ile yükle, build et, başlat, duraklatmayı kaldır, controller durumu FINISHED olana kadar polling yap, sonlandır, temizle. "Heritrix bir pipeline içinde işletilebilir mi?" sorusunun gerçek cevabı bu: evet, tamamen headless, hiçbir tarayıcı tıklaması olmadan. Çoğu anlatım Jetty arayüzünün ekran görüntüsünü koyup onu ana arayüz gibi gösterir. Oysa o bir kolaylık, zorunluluk değil.
Makineye özgü bir dağıtım notu: Bu Mac, Surge üzerinden sistem genelinde bir HTTP proxy kullanıyor. Heritrix’in Java istemcisi bu proxy’yi devraldı ve 127.0.0.1 test trafiğini bile onun üzerinden gönderdi; bunun sonucu olarak işletim sistemi istisna listesine ve NO_PROXY ayarına rağmen 503 yanıtları oluştu. JVM’i -Djava.net.useSystemProxies=false ile başlatmak, çalışmayı 2×503’ten 18×200’e çevirdi. Bu, Heritrix’te bir kusur değil, çevresel bir etkileşimdi; söz konusu bayrak yalnızca sistem proxy ayarlarını devralmak istenmediğinde önemlidir.
Arşive gerçekte ne giriyor?
Stock varsayılan profili, kontrollü bir test ortamına karşı çalıştırdım — HTML sayfaları, üç seviyeli bir derinlik zinciri, robots.txt ve sitemap ile bilinçli olarak oluşturulmuş 404 ve 500 yollarını içeren, uç noktaları önceden belli bir yerel sunucu — ve ardından çıkan WARC’ı özet satırına güvenmek yerine kayıt kayıt analiz ettim.
Yirmi alınan URI, altmış bir kayıt üretti:
| WARC kayıt türü | Sayı | İçeriği |
|---|---|---|
warcinfo | 1 | tarama düzeyi köken bilgisi, dosya başına bir kez yazılır |
response | 20 | tam HTTP yanıtı, başlıklar ve gövde |
request | 20 | Heritrix’in gönderdiği tam istek |
metadata | 20 | Heritrix’in kendi capture notları |
URI başına temiz bir 1:1:1 response/request/metadata oranı; üstelik benim tarafımda hiçbir ek ayar yapmadan. Kayıt bazındaki eksiksizlik de incelemede yerini korudu:
| Kayıt bazlı kontrol | Sayı | Neden önemli |
|---|---|---|
Yanıtlar üzerinde sha1: önekli payload digest | 20/20 | — |
Yanıtlar üzerinde WARC-IP-Address | 20/20 | içeriğin gerçekten hangi IP’den geldiğini gösterir; yıllar sonra bir domain el değiştirdiğinde hayat kurtaracak türden bir bilgi |
İstek kayıtlarının WARC-Concurrent-To ile yanıtlarına bağlanması | 20/20 | "çoğu bağlı" değil. Hepsi bağlı. |
HTTP durum kodu da olduğu gibi korundu; kötü olanlar dahil: 200 OK, 404 Not Found ve 500 Internal Server Error kayıtlı yanıtların içinde gerçek durum satırları olarak duruyor, hata diye atılmıyor.
Bu son nokta, arşivleme ile scraping arasındaki farkı her şeyden daha net biçimde gösteriyor. Bir scraper için 500, yeniden denenmesi ya da atlanması gereken bir hatadır. Bir arşivci için ise sunucunun o anda söylediği şeydir; korunmaya değer bir gerçektir. Heritrix Output wiki sayfası bu kayıt yapısını anlatıyor; ancak benim başka hiçbir yerde görmediğim şey, ölçülmüş çoğulluk ve bilinen bir uç nokta setinde 20/20 bağlantı oranıydı. Bu yapı gerçekten var.
Dedup sonucu, iki yönden de ölçüldü
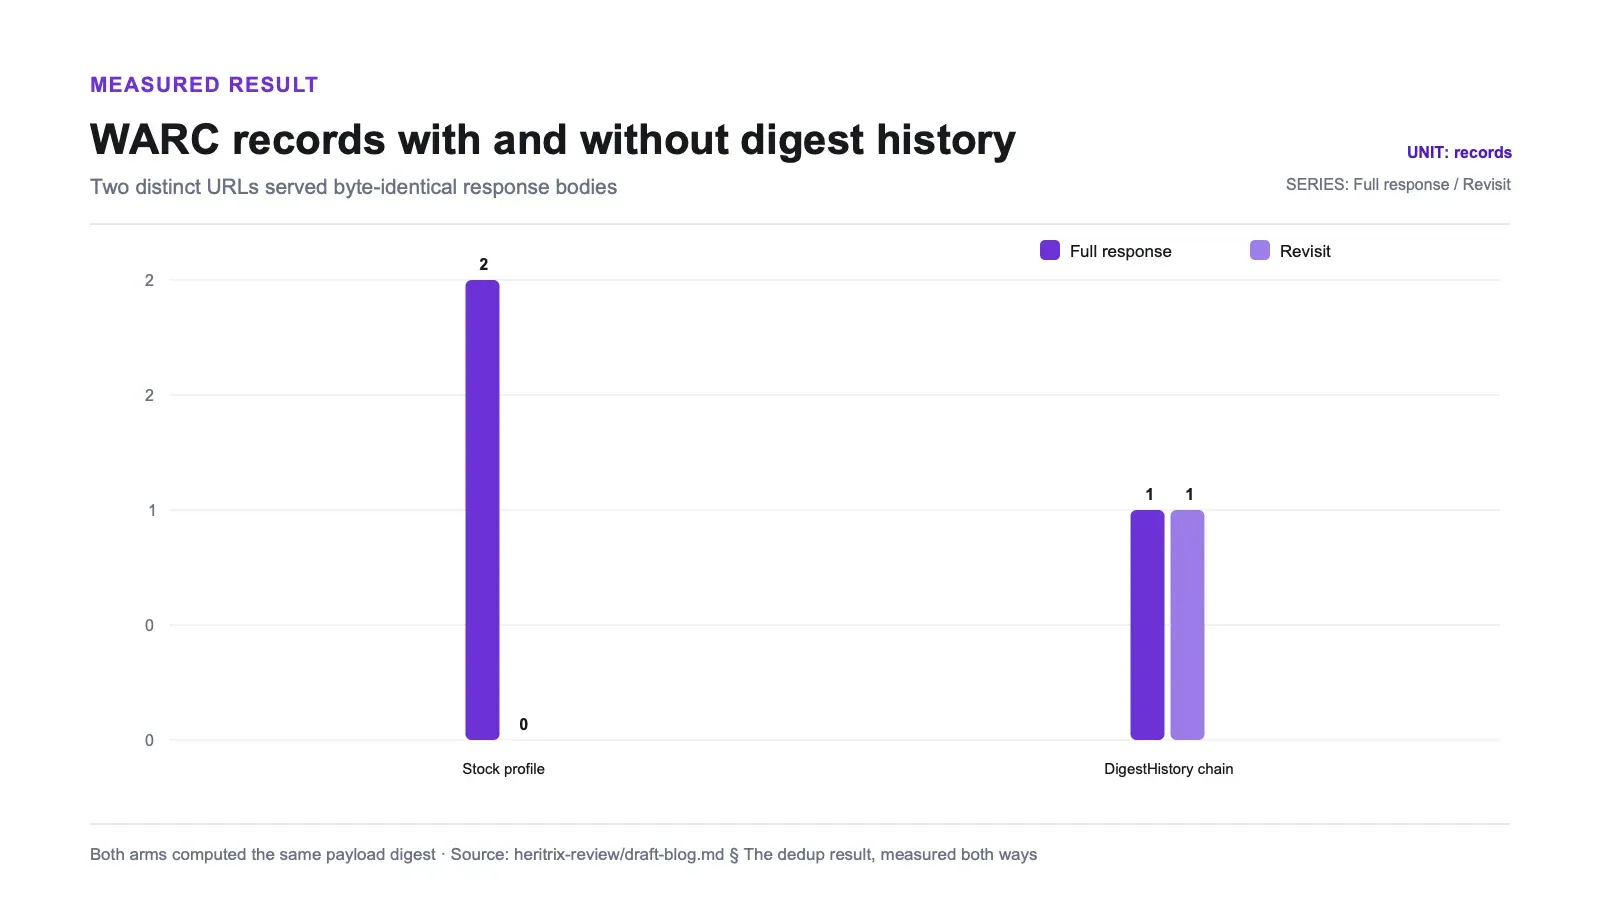
Test ortamım /dup/one ve /dup/two yollarında byte-identical gövdeler sundu. Farklı URL’ler, aynı içerik — content-digest dedup’un tam olarak birleştirmek için var olduğu durum. Bunu iki kez çalıştırdım: bir kez stock profille, bir kez de digest-history zincirini (BdbContentDigestHistory, ayrıca fetch zincirinde bir ContentDigestHistoryLoader ve WARC yazıcısından sonra bir ContentDigestHistoryStorer) ekledikten sonra.
| Stock varsayılan profil | ContentDigestHistory zinciri ile | |
|---|---|---|
Yazılan tam response kaydı | 2 | 1 |
Yazılan revisit kaydı | 0 | 1 |
| Paylaşılan payload digest | evet (ikisi de) | evet |
| Revisit profili | — | identical-payload-digest |
Varsayılan durumda iki yanıta da aynı digest verildi, ancak geçmiş işleyicileri bunu işleme sokmadı ve iki payload da tam olarak yazıldı. Zinciri ekleyince, ikinci capture WARC içinde aynı payload digest’i işaret eden bir revisit kaydına dönüştü; WARC 1.1 spesifikasyonunun revisit için tanımladığı davranış tam olarak buydu.
Bunun hiçbir yanı gizemli değil. Duplication Reduction Processors wiki sayfası skipIdenticalDigests değerinin varsayılan olarak false olduğunu ve URL’den bağımsız dedup için bu loader ve storer bean’lerinin gerektiğini açıkça söylüyor. Burada açığa çıkarılan gizli bir davranış yok; neredeyse ölçtüğüm her şeyde olduğu gibi, bu da birinci elden rakam eklenmiş belgelenmiş Heritrix davranışı. Asıl boşluk belge ile insanların inandıkları şey arasında; benim tecrübemde bu inanç çoğu zaman "Heritrix dedup yapar" şeklinde, ayar notu olmadan söyleniyor.
İki önemli çıkarım var:
Dedup yazma anında çalışır, bant genişliğinde değil. Bunu ayrı bir sayaçla ölçmedim, ama mekanik olarak doğrudan buradan çıkar: bir digest’i ancak baytlar geldikten sonra karşılaştırabilirsiniz; dolayısıyla ikinci URL her durumda kaynağından çekilir. Zinciri açmak depoladığınızı azaltır, aktardığınızı ya da hedef sunucunun sunmak zorunda kaldığını değil. Dedup’u politeness veya bant genişliği kazancı olarak bütçelemek, hesabı ters kurmaktır.
“Zaten dedup yapar” varsayımıyla yapılan depolama planlaması ciddi biçimde yanlış olabilir. Eğer yoğun şablon tekrarına sahip bir siteyi arşivliyorsanız — aynalanmış PDF’ler, standart giriş sayfaları, aynı makalelerin yazdırma görünümü varyantları — ve disk boyutunu aynı gövdelerin birleşeceğini varsayarak hesaplıyorsanız, stock profil beklediğinizden çok daha fazla depolama tüketebilir. İki URL’lik test, varsayılan davranışı ortaya koyar; milyon URI ölçeğindeki etkisini değil. O etki, tekrar oranına, payload boyutuna ve yeniden tarama tasarımına bağlıdır.
Scope ve robots vaat ettiklerini tam yaptı
Bir tarayıcının neyi çekmediğine dair kendi açıklaması çok az şey ifade eder; bu yüzden ikisi de sunucu tarafı hit sayacıyla ölçüldü — hedef sunucunun, Heritrix’in logladığı her şeyden bağımsız olarak isteği kendisinin saymasıyla.
| Kontrol | Koşul | Hedefte sunucu tarafı hit | Tarama kaydında görünen |
|---|---|---|---|
| Scope | Varsayılan scope; ikinci bir host’a link veren ve ayrı SURT otoritesine sahip bir sayfayı seed ettim | 0 | scope dışı host hiç görünmedi — yani keşif aşamasında reddedildi, kuyruğa alınıp başarısız olmadı |
| Robots | Varsayılan obey policy; ana sayfa, fixture robots.txt’nin izin vermediği \/robots-denied\/secret yoluna link veriyordu | 0 | engellenmiş olarak kaydedildi (robots.txt’nin kendisi çekildi) |
| Robots | Kontrol: robotsPolicyName ignore olarak değiştirildi, tekrar çalıştırıldı | 1 | — |
Scope. Bu sırada in-scope host normal şekilde tarandı; yani crawl bozuk değildi, scope gerçekten disiplin uyguluyordu. Küçük bir not: burada yalnızca varsayılan-scope kolunu çalıştırdım; genişletilmiş scope için pozitif kontrol yapmadım. Dolayısıyla bunu iki taraflı bir kanıttan ziyade, belgelenmiş tasarımın teyidi olarak okumak gerekir.
Robots. Link her zaman erişilebilirdi; onu bastıran yalnızca robots politikasıydı. Uyum gerçek, kaçış kapısı da gerçek — bu doğru düzen. Çünkü bazı arşivleme yükümlülükleri robots’u meşru biçimde aşar ve bunun için config dosyasına bilerek ignore yazmak gerekir.
Politeness: yirmi yerel sayfayı taramak için 57,7 saniye
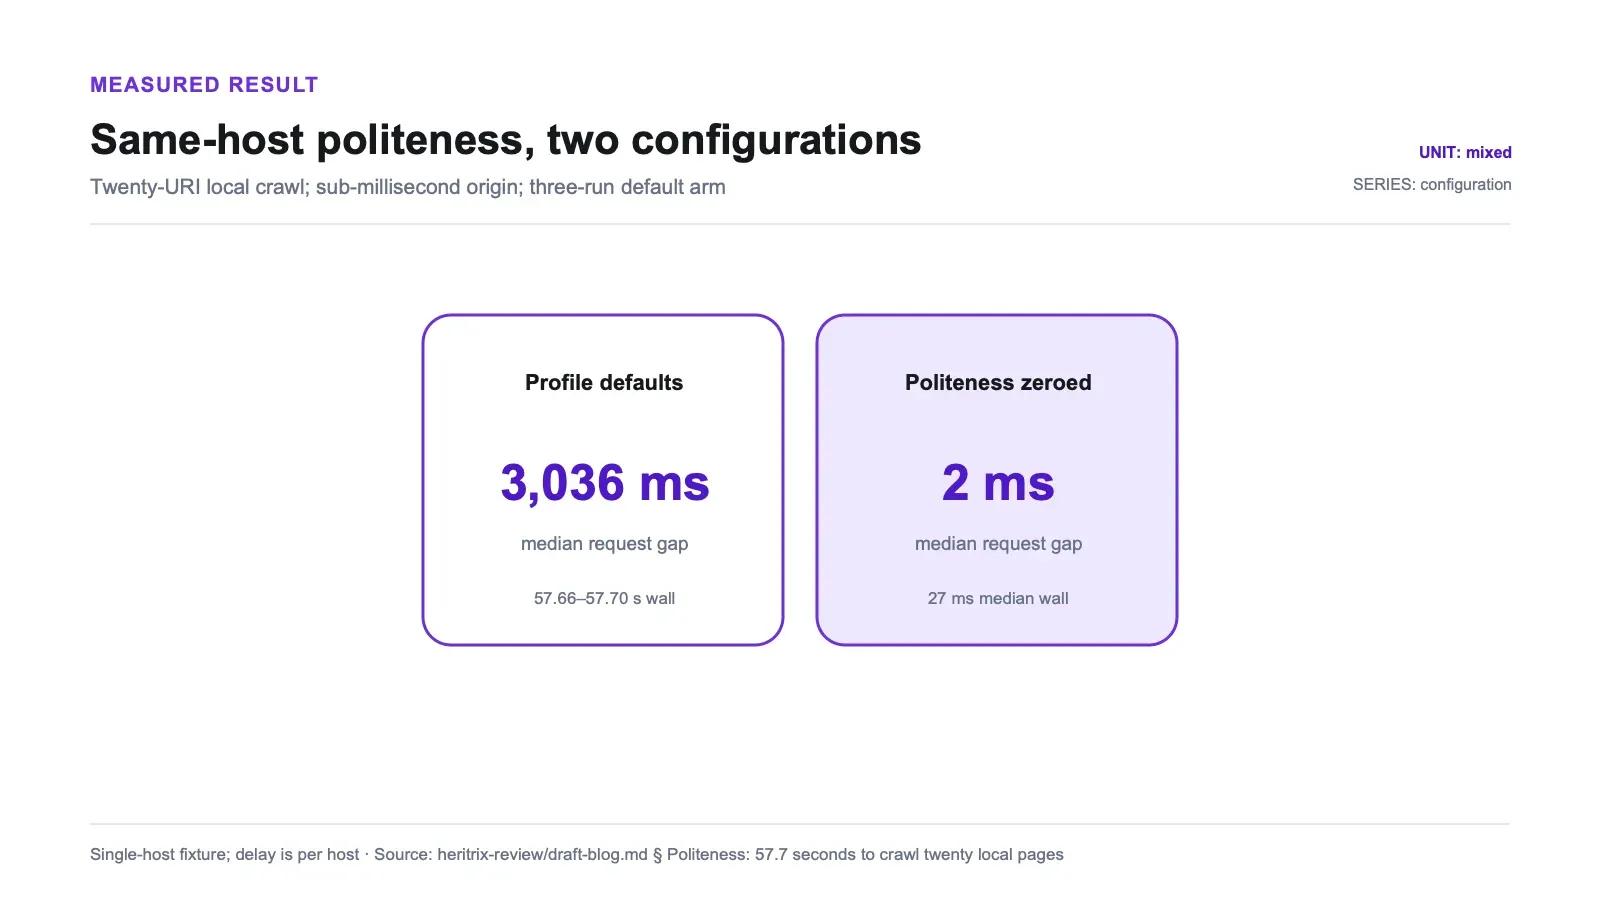
Heritrix’in projenize uyup uymayacağını belirleyen tek bir sayı var.
Aynı test ortamı, aynı üç denemelik işlem, tek bir yerel host ve milisaniyenin altında gecikme:
| Politeness ayarı | Aynı hostta istekler arası medyan boşluk | 20 URI’lik tam taramanın süre değeri |
|---|---|---|
Profil varsayılanları (delayFactor 5.0, minDelayMs 3000, maxDelayMs 30000) | 3.036 ms (min 3.021, max 9.107, 48 ölçülmüş boşluk boyunca) | 57.66 s / 57.66 s / 57.70 s (üç çalışma) |
| Politeness sıfırlandı | 2 ms | 27 ms (medyan) |
Gerçekleşen gecikme tam olarak minDelayMs tabanına oturuyor: milisaniyenin altındaki bir origin’de delayFactor × fetch-time ihmal edilebilir düzeyde kalıyor, minimum ise tasarım gereği baskın oluyor. İki satır arasındaki oran pek anlamlı değil; çünkü sıfır-politeness paydasında süreler sadece onlarca milisaniye ve çalışma bazında oynama var. Kararlı sonuç mutlak tabandır: bu test ortamında varsayılan Heritrix aynı host’a istekler arasında yaklaşık üç saniye bekledi ve yirmi sayfalık taramayı yaklaşık bir dakikalık gerçek süreye çevirdi.
Bunu somutlaştırmanın bir yolu: Diyelim bir üniversite kütüphanesi, devre dışı bırakılmadan önce tek host üzerinde duran 50.000 sayfalık bir devlet sitesini arşivlemek zorunda. Host başına 3 saniyelik tabanda, bu 150.000 saniyelik zorunlu bekleme demek — yaklaşık 42 saat, yani fetch süresini saymadan bir gün ile neredeyse iki gün arası. Bu, ölçtüğüm 3.036 ms tabanına göre yapılan aritmetik: 50.000 × 3.036 s = 151.800 s = 42.2 saat; konfigüre edilmiş 3.000 ms minimumda bile 41.7 saat eder ve bu da 42’ye yuvarlanır, 41’e değil. Ölçülmüş bir crawl değil, ama proje planınızın ihtiyacı olan matematik bu.
Adil olmak gerekirse, Heritrix’in politeness yaklaşımı host bazlıdır, çünkü frontier kuyruklamayı host bazında yapar. Binlerce domain üzerinde geniş bir crawl bu kuyruklar arasında paralelleşir ve bu tavanı global olarak devralmaz. Benim test ortamım tek host’tu; yani bu sayının en kötü durumu. Arşivlemek istediğiniz hedef tek büyük siteyse, o en kötü durum sizin durumunuzdur.
Üstelik bu bir özellik. Gecikme, arşiv tarayıcısını site sahibinin tolere ettiği, bloklamadığı bir araç haline getirir. Bunu düşürmek, bir başkasının sunucusu hakkında karar vermek demektir; araç da bu kararı agresif varsayılanlara bırakmak yerine açıkça görünür kılar.
Test etmediğim şeyler
Bu ölçümler, kontrollü bir test ortamındaki tarama disiplinini kapsıyor; daha fazlasını değil. Sınırın dışında kalanlar:
- Crawl’ler arası dedup ve yeniden tarama. Yalnızca tek crawl içindeki content-digest dedup’u ölçtüm. Ayrı crawl’ler arasında URI geçmiş veritabanını korumak (
FetchHistoryProcessor+PersistLog) farklı bir mekanizmadır ve onu çalıştırmadım. - Ölçek ve uzun vadeli kararlılık. Milyon URI’lik frontier yok, checkpoint-and-restore yok, çok günlük çalışma yok. Benim testim dayanıklılığı değil, disiplini ölçüyor.
- JavaScript ile render edilen içerik. Heritrix’in varsayılan yakalaması tarayıcı olmayan yoldur ve benim ölçtüğüm şey de buydu. İsteğe bağlı tarayıcı tabanlı davranışlar burada test edilmedi.
- Yüksek gecikmeli origin üzerinde politeness. Yerel gecikme milisaniyenin altında olduğu için
minDelayMstasarım gereği baskın oldu.delayFactor’ın yavaş gerçek sunuculara karşı nasıl ölçeklendiği verimde izole değil. - Sitemap geri kazanımı. robots.txt istendi ve sitemap yönergesi takip edildi, ama her
<loc>girdisinin eksiksiz geri kazanımını ayrıca doğrulamadım.
İlk üretim job’ından önce netleştirmeniz gerekenler
Stock profil uzun olabilir, ama bir arşivin anlamını değiştiren kararlar oldukça kompakt. Scope ile başlayın. Seed’ler varsayılan SURT öneklerini üretir; DecideRules bunları sırayla genişletebilir ya da daraltabilir. Final kural sırasını hem kapsam içi hem kapsam dışı örnek URL’lerle gözden geçirin, sonra bunu sunucu tarafı trafikle veya başka bağımsız bir istek günlüğüyle doğrulayın. Yalnızca crawl raporuna bakarak dışlanan bir host’un hiç temas edilmediğini kanıtlayamazsınız.
Sonra robots politikası ve operatör kimliğinin koleksiyon için ne anlama geldiğine karar verin. Test edilen varsayılan, fixture’daki disallow kuralına uydu; robotsPolicyName değerini ignore yapmak ise engellenmiş yolun çekilmesine yol açtı. Bu geçiş teknik olarak basit, kurumsal olarak ise önemlidir. Bunu neden ve kim onayladı, çalışan bir operatorContactUrl ile birlikte kaydedin; zorunlu URL site sahibine operatöre geri dönüş yolu verir, ancak yetkilendirme gerekçesini sağlamaz.
Depolama planlaması da ayrıca ve açık biçimde yapılmalı. Eğer aynı gövdeler revisit kayıtlarına dönüşsün istiyorsanız, arşivi boyutlandırmadan önce content-digest history işleyicilerini ekleyip gözden geçirin. Test edilen zincir, çekimden sonraki temsili etkiledi; dolayısıyla origin trafiği her iki URL için de bütçelendirilmelidir. Crawl’ler arası dedup ayrı bir mekanizmadır ve bu iki URL’lik, tek crawl sonucundan çıkarılmamalıdır. Bilinen tekrar gövdeleriyle küçük bir doğrulama crawl’ı, kurulu bean grafiğinin beklenen kayıt türlerini üretip üretmediğini anlamanın ucuz bir yoludur.
Son olarak, politeness’ı son anda çevrilecek bir ayar düğmesi değil, planlama girdisi olarak düşünün. Tek host’lu yerel testte minDelayMs, toplam süreyi belirledi. Gerçek bir proje, konfigüre edilen host başı tabanı hedef host sayısı ve koleksiyon teslim tarihiyle birlikte hesaplamalı, ardından bunu temsilî gecikme koşullarında test etmelidir. Geniş crawl’ler ile tek site crawl’leri, host-bazlı frontier’i farklı şekilde zorlar; bu inceleme yalnızca ikincisini ölçtü. REST yaşam döngüsünü de runbook’ta tutun: build, launch, unpause, poll, terminate ve teardown otomasyonda ayrı ayrı izlenmeye değer durumlar.
Artılar ve eksiler
Artılar
- Arşiv bütünlüğü varsayılan olarak çok iyi: 20/20 response, payload digest, capture IP ve tam request↔response bağlantısı, hiçbir yapılandırma gerektirmeden.
- Hatalı yanıtları da gerçek veri olarak saklıyor — 200, 404 ve 500 durum satırlarının hepsi olduğu gibi korunuyor.
- Scope disiplini sunucu tarafı sayaçla doğrulandı: kapsam dışı fetch yok, kapsam içi host normal şekilde tarandı.
- Robots uyumu gerçekten fetch’i durduruyor; zorunlu arşivleme için kasıtlı bir
ignorekaçış yolu da var. - REST üzerinden tamamen headless çalışıyor — oluştur, build et, başlat, polling yap, temizle; hepsi
curlile, UI tıklaması yok. - OpenJDK 26.0.1 üzerinde JVM bayrağı olmadan temiz çalışıyor; bu, yirmi yıllık çoğu kod tabanının başarabildiğinden daha iyi bir modern Java hijyeni.
- Zorunlu operatör iletişim URL’si, tarayıcının anonim çalışmasını engelliyor.
- Taramanın her parçası değiştirilebilir bir bean olduğu için, dedup’u açmak fork yerine üç bean eklemekle çözüldü.
Eksiler
- Content-digest dedup varsayılan olarak kapalı ve aynı payload’ları tam olarak yazıyor — gerçek bir depolama planlama tuzağı.
- Dağıtım ağır: 41 MB paket, 114 jar, Java motoru + Jetty ve yaklaşık 750 satırlık Spring job konfigürasyonu.
- Varsayılan politeness, host başına yaklaşık 3 saniyelik taban uygular; 20 URI’lik tek host crawl 57.7 saniye sürdü.
- Varsayılan yolda JavaScript render yok; bu yüzden yalnızca istemci tarafında oluşan içerik yakalanmaz.
- Konfigürasyon yüzeyi uzmanlığı ödüllendirir, gündelik kullanımı cezalandırır; ilk crawl’a beş dakikada ulaşılmıyor.
- Çıktıda yapısal veri yok. WARC içinden alan çıkarmak ayrı bir proje.
Kimler kullanmalı, kimler uzak durmalı?
Heritrix, çıktısı arşivin kendisi olan kurumlar ve ekipler içindir. Kütüphaneler, ulusal arşivler, hukuki ve uyumluluk amaçlı koruma, web’i birincil kaynak olarak yakalayan araştırma grupları, beş yıl sonra bir URL’nin belirli bir günde ne sunduğunu kanıtlaması gereken herkes. Eğer kelime dağarcığınızda zaten "WARC", "replay" ve "provenance" varsa, bu araç ekosisteminizin geri kalanının etrafında kurulduğu araçtır; ağırlığı da bu uyumluluğun bedelidir.
Host-bazlı frontier’i ve web arşivlemedeki uzun geçmişi, onu birçok domain üzerinde geniş crawl’ler için makul bir aday haline getiriyor. Bu mimari ve proje geçmişine dair bir değerlendirmedir; bu test ortamından çıkan bir ölçek sonucu değildir. Uzun dönem throughput, checkpoint kurtarma ve milyon-URI davranışı burada hâlâ test edilmedi.
Veri istiyorsanız, arşiv değilse, uzak durun. Amacınız ürün, ilan ya da iletişim kayıtlarından oluşan bir tabloysa, Heritrix sayfaları kusursuz biçimde yakalar; sonrasında bu sayfaları ayrıştırmak için ayrı bir pipeline yazmanız gerekir — üstelik bunun bedelini bir Java motoru, bir Spring konfigürasyonu ve 3 saniyelik bir politeness tabanı ile ödemiş olursunuz. Hedefleriniz istemci tarafında render edilen tek sayfalı uygulamalarsa da uzak durun; çünkü tarayıcı olmayan bir fetcher yalnızca kabuğu, içeriği değil, kabuğu yakalar. O durumda doğru araç tarayıcı tabanlı bir arşivcidir. Ve bugün ilk sonucu almak istiyorsanız da uzak durun; çünkü kurulum eğrisi gerçek.
Alternatifler ve yönetilen API’nin yeri
Arşivleme dünyasında doğrudan modern karşılık Browsertrix Crawler’dır — Chromium’u çalıştıran ve tarayıcının yaptığını kaydeden tarayıcı tabanlı bir arşivci. Heritrix’in varsayılan HTTP yanıtlarında bulunmayan JavaScript üretimli içeriği yakalayabilir; bunun karşılığında tarayıcı dağıtımı ve çalışma zamanı yükü getirir. Bu inceleme bire bir benchmark yapmadı; dolayısıyla karar, önce capture gereksinimlerinden başlar: tarayıcıda oluşan durumlar bir browser arşivcisine işaret eder; klasik HTTP kaynakları ise Heritrix’in doğal alanıdır.
İlgili inceleme: Browsertrix Crawler incelemesi.
Bambaşka bir problem türü için — arşiv istemiyorsunuz, sayfalardan yapılandırılmış veri istiyorsunuz — Heritrix’i, çıktıya bakarak extraction sistemleriyle karşılaştırın; onları eşdeğer crawler’lar gibi görmeyin. Heritrix ücretsiz ve self-hosted’dır: JVM’i siz çalıştırırsınız, beans dosyasının sahibi sizsiniz, diskleri siz boyutlandırırsınız, politeness’ı siz ayarlarsınız. Koruma teslim edilecek işse bu model uygundur.
Açıklama: Thunderbit yayıncının ürünüdür ve bu Heritrix testinde denenmemiştir. Yönetilen extraction kategorisine girer: çıktısı, koruma kalitesinde WARC dosyaları değil, sayfa içeriği veya yapılandırılmış kayıtlardır. Replay edilebilir capture ve provenance gerekiyorsa bir arşivci seçin; teslim edilecek şey satırlar ya da belge metniyse ve yönetilen operasyon uygunsa extraction hizmetini değerlendirin.
Arşivleme, scraping’den farklı bir izin sorunu taşır. Heritrix varsayılan olarak robots.txt’ye uyar ve bayt çekmeden önce kendinizi tanımlamanızı ister; bu iyi bir başlangıçtır — ama robots’a uyumlu bir crawl otomatik olarak yetkili bir crawl değildir. Telif, kullanım şartları, kişisel veriler ve kurumunuzun kendi görevi bunun üstünde yer alır; ignore politikası da bunu kolaylaştırmak için değil, bunu kullanma konusunda yasal zemini olan kuruluşlar içindir. Bir arşiv programı kuruyorsanız, diskler dolmadan önce yetki kapsamını netleştirin; eğer bu sizin için yeni bir alan ise web scraping ve arşivlemenin hukuki yönleri hakkında da bilgi edinin.
Web Veri Çıkarmak için Thunderbit’i Deneyin
Nihai karar
Heritrix kullanmalı mısınız? Evet — eğer çıktınız bir arşivse ve Spring bean’lerini öğrenmeye istekli biri varsa.
Test ortamı net bir karar veriyor: stock profil response, request ve capture metadatasını tutarlı biçimde korudu; scope ve robots kontrolleri, yapılandırıldığı gibi sunucu tarafı istekleri etkiledi; tüm job yaşam döngüsü REST üzerinden çalıştı. Bunlar, burada test edilen küçük tek-host sınırı içinde arşiv pipeline’ı için değerli özelliklerdir.
Operasyonel maliyetler de aynı derecede açık: Java dağıtımı ve büyük bir Spring konfigürasyonu, bu yerel crawl’da baskın hale gelen host başı gecikme ve ek history işleyicileri gerektiren content-digest dedup. WARC bütünlüğüne ihtiyaç duyan ekipler bu maliyetleri kabul edebilir; çıkarılmış alanlara ihtiyaç duyan ekipler ise başka bir kategoriden başlamalıdır.
Üretim crawl’ından önce dedup zincirini, politeness ayarlarını, scope’u, robots politikasını, operatör kimliğini ve depolama varsayımlarını gerçek job konfigürasyonu ile doğrulayın. Stock profil bir başlangıç noktasıdır; bu operasyonel kararların örtük bir beyanı değildir.
Web Veri Çıkarmak için Thunderbit’i Deneyin Get Started Free
SSS
operatorContactUrl bir crawl’u yetkili hale getirir mi?
Hayır. Job’a bir iletişim URL’si eklenmesini zorunlu kılar; bu da site operatörlerine bir hesap verebilirlik yolu sunar, ancak izin, kimlik doğruluğu, telif durumu veya düzenleyici uyumluluk sağlamaz. Bunlar tarayıcının dışındaki dağıtım kararlarıdır.
Content-digest deduplication origin’e yapılan istekleri azaltır mı? Burada test edilen yapılandırmada hayır. İki URL de payload digest’leri karşılaştırılmadan önce çekildi. History zinciri, ikinci payload’ın WARC depolamasında nasıl temsil edildiğini değiştirdi; ikinci URL’yi ağ isteği olarak atlamadı.
Heritrix web arayüzü olmadan çalışabilir mi?
Evet. Test edilen yaşam döngüsü — oluştur, konfigürasyonu yükle, build et, başlat, duraklatmayı kaldır, polling yap, sonlandır ve temizle — curl ile REST API üzerinden çalıştı. Gömülü Jetty arayüzü gerekli değildi.
Stock Heritrix profili aynı payload’ları dedup eder mi? Bu testte yapılandırıldığı haliyle hayır. Stock profil iki aynı response’u da tam response kaydı olarak sakladı. Content-digest history zincirini eklemek ikinci yakalamayı bir revisit kaydına dönüştürdü; yani dedup, otomatik varsayılan değil, yapılandırıp doğrulamanız gereken bir pipeline tercihidir.
Bir politeness gecikmesini nasıl seçmeliyim? Buradaki yerel zamanlamaları üretim önerisi değil, mekanizma kontrolü olarak düşünün. Gecikmeyi hedef sitenin kuralları, operatör anlaşması, sunucu kapasitesi, crawl amacı ve kendi retry/concurrency politikanız doğrultusunda belirleyin; ardından gerçek aynı-host istek aralıklarını loglarda doğrulayın.




