
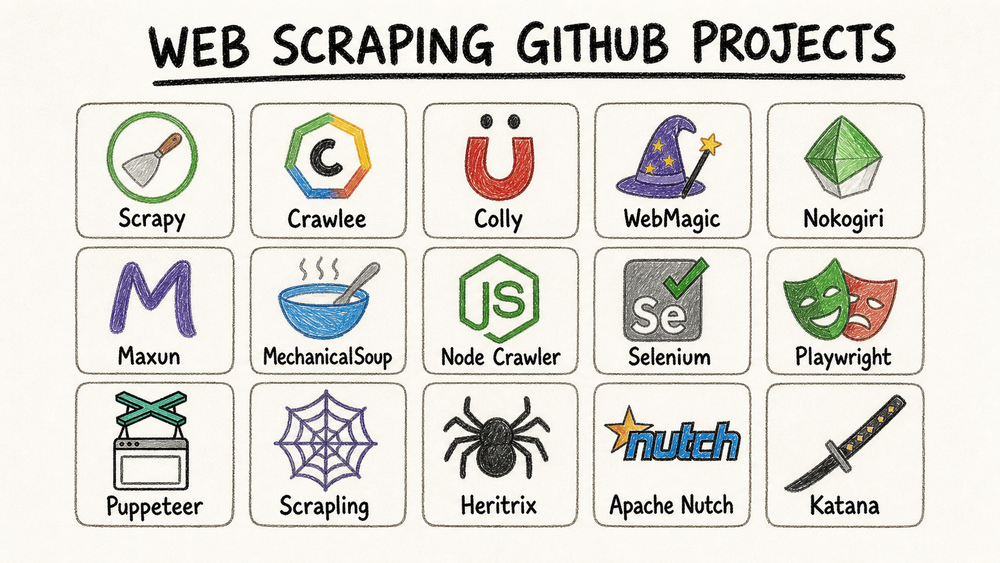
2026'da web hâlâ değerli verilerle dolu; ancak çoğu ekip için mesele soyut anlamda “bir scraper” bulmak değil. Asıl ihtiyaç, şu üç sorudan birine pratik bir yanıt almaktır: Hangi açık kaynak proje hâlâ üzerine geliştirme yapmaya değer? Hangi yığın, modern ve JavaScript ağırlıklı siteleri yönetebilir? Ve teknik olmayan biri GitHub’ı tamamen atlayıp bunun yerine kod yazmadan çalışan bir iş akışı mı kullanmalı?
Bu güncelleme tam da bu karar yoluna göre hazırlandı. 6 Ağustos 2026'da herkese açık GitHub depo sayfalarını, yıldız sayılarını ve commit akışı etkinliğini yeniden kontrol ettim; ardından aşağıdaki projeleri kurulum zorluğu, JavaScript desteği, bakım sinyali, dışa aktarma kolaylığı ve hedef kitle uyumu açısından karşılaştırdım.
Kısa Cevap
- Yapılandırılmış ve büyük ölçekli scraping için en olgun Python crawler çatısını istiyorsanız Scrapy'yi seçin.
- Ekibiniz JavaScript veya TypeScript kullanıyorsa ve hem HTTP hem de tarayıcı tabanlı scraping için tek bir yığın istiyorsanız Crawlee'yi seçin.
- Site JavaScript açısından yoğunsa ve gerçek tarayıcı otomasyonu asıl gereksinimse Playwright veya Puppeteer'ı seçin.
- Sıfırdan scraping kodu yazmak yerine açık kaynaklı, görsel, kendi sunucunuzda barındırılabilir bir kodsuz katman istiyorsanız Maxun'u seçin.
- Arşiv taraması, dağıtık tarama veya güvenlik keşfi gibi özel bir işiniz yoksa Heritrix, Apache Nutch ya da Katana'yı ancak bu durumlarda seçin.
- GitHub üzerinde bir şey kurmak istemiyor, sadece veriyi hızlıca Sheets, Airtable, Notion, CSV veya JSON'a almak istiyorsanız Thunderbit'i seçin.
Kod yığınından önce kodsuz bir scraper deneyin
Hızlı Karşılaştırma
Aşağıdaki GitHub yıldızları ve son commit sinyalleri 6 Ağustos 2026'da herkese açık depo sayfaları ve commit akışları üzerinden kontrol edilmiştir.
| Proje | Dil / Model | Kurulum | JS Desteği | En Uygun Senaryo | GitHub Yıldızları | Son Commit Sinyali |
|---|---|---|---|---|---|---|
| Scrapy | Python framework | Orta | Yerel JS desteği yok | Büyük ölçekli spider'lar, e-ticaret, haber siteleri | 63.7k | 6 Ağustos 2026 |
| Crawlee | Node.js / TypeScript framework | Orta | Evet | Statik + dinamik scraping için tek yığın | 25.2k | 6 Ağustos 2026 |
| Maxun | Açık kaynak kodsuz platform | Dağıtımı orta, kullanıcı için kolay | Evet | Açık kaynak kontrolünden vazgeçmek istemeyen iş kullanıcıları | 17.1k | 5 Ağustos 2026 |
| MechanicalSoup | Python kütüphanesi | Kolay | Hayır | Formlar, oturumlar ve basit statik siteler | 4.9k | 4 Ağustos 2026 |
| Node Crawler | Node.js crawler | Orta | Hayır | Hızlı statik tarama ve feed birleştirme | 6.8k | 18 Haziran 2026 |
| Heritrix | Java arşiv crawler'ı | İleri seviye | Hayır | Web arşivleme ve alan adı ölçeğinde toplama | 3.3k | 5 Ağustos 2026 |
| Apache Nutch | Java dağıtık crawler | İleri seviye | Hayır | Arama motoru tarzı ve büyük veri odaklı tarama | 3.3k | 5 Ağustos 2026 |
| Selenium | Çok dilli tarayıcı otomasyonu | Orta | Evet | Etkileşimi yoğun akışlar ve tarayıcı sadakati | 34.3k | 6 Ağustos 2026 |
| Playwright | Çok dilli tarayıcı otomasyonu | Orta | Evet | Modern dinamik siteler ve sağlam script yazımı | 94.1k | 6 Ağustos 2026 |
| Puppeteer | Node.js tarayıcı otomasyonu | Orta | Evet | Chrome odaklı otomasyon ve scraping | 95.4k | 6 Ağustos 2026 |
| Scrapling | Python gizlilik odaklı scraping araç seti | Orta | Evet | Anti-bot hassasiyetine sahip tarayıcı scraping | 72.8k | 30 Temmuz 2026 |
| Katana | Go crawler / CLI | Orta | İsteğe bağlı headless | Güvenlik taraması ve URL keşfi | 17.3k | 5 Ağustos 2026 |
| Colly | Go framework | Orta | Hayır | Yüksek performanslı statik scraping | 25.4k | 18 Haziran 2026 |
| WebMagic | Java framework | Orta | Yerel JS desteği yok | Genel Java scraping akışları | 11.7k | 20 Aralık 2025 |
| Nokogiri | Ruby ayrıştırıcı | Kolay | Hayır | Ruby uygulamaları ve özel ayrıştırma iş akışları | 6.3k | 3 Ağustos 2026 |
| Thunderbit | AI destekli kodsuz Chrome eklentisi | Tak çalıştır | Evet | Veriyi hızlıca isteyen teknik olmayan ekipler | N/A | Yönetilen ürün, sürekli güncelleniyor |
GitHub Projesi Seçmeden Önce Şunu Sorun: Gerçekten Kod Tabanlı Bir Akışa mı İhtiyacınız Var?
Thunderbit bir GitHub projesi değil; tam da bu yüzden bu karar rehberinde yer alıyor. “En iyi web scraping GitHub projeleri” diye arayan insanların büyük bir kısmı aslında bir crawler yığınını bakıma almak istemiyor. Onlar bugün çalışan bir web sitesinden yapılandırılmış veri almak istiyor.
Thunderbit, kod odaklı scraping araştırmasından işin gerçekten kullanılabilir çıktısına geçiş için en temiz çıkış kapısıdır:
- En uygun kullanım: satış prospekti oluşturma, e-ticaret takibi, emlak verisi toplama, işe alım araştırmaları ve tarayıcı odaklı operasyon işleri.
- Neden öne çıkıyor: AI ile alan önerme, alt sayfa zenginleştirme, dinamik sayfa desteği ve scraping mantığı yazmadan Sheets, Airtable, Notion, CSV ve JSON'a aktarma.
- Dikkat edilmesi gereken nokta: işiniz özel altyapı gerektiren, uzun ömürlü bir iç tarama platformuysa açık kaynak bir framework size daha fazla kontrol sağlar.
GitHub içinde yaşamaya karar vermeden önce kodsuz yolu görmek istiyorsanız, bu güncel Thunderbit anlatımı en hızlı gerçeklik kontrolüdür:
Thunderbit AI Web Scraper'ı ücretsiz deneyin
Bu GitHub Scraping Projelerini Nasıl Değerlendirdim?
Her GitHub scraping projesi birbiriyle kıyaslanabilir değildir. Bazıları tam bir framework'tür. Bazıları tarayıcı otomasyon kütüphanesidir. Bazıları ayrıştırıcıdır. Bazıları da arşivler ya da güvenlik ekipleri için yapılmış niş crawler'lardır.
Listeyi gerçekten faydalı kılmak için, hâlâ şu dört pratik filtreden geçen projelere öncelik verdim:
- Arkasında hâlâ gerçek pazar karşılığı var.
Sadece yüksek yıldız sayısı yeterli değil; düşük benimsenme ve eski bakım durumu genellikle kötü işarettir. - Hâlâ görünür proje hareketi var.
Bu güncellemede eski derleme sayılarına güvenmek yerine 6 Ağustos 2026'da herkese açık commit akışı etkinliğini yeniden kontrol ettim. - Gerçek bir scraping işini çözüyorlar.
Şık ama belirsiz, iş veya araştırma akışlarına iyi oturmayan depoları dışarıda bıraktım. - Kısa listeye girecek kadar birbirinden farklılar.
Amaç 50 depo yığmak değil. Framework'ler, tarayıcı yığınları, kodsuz açık kaynak araçlar ve uzman crawler'lar arasında karar vermenize yardımcı olmak.
Karşılaştırma boyutları, pratikte başarı ya da başarısızlığı en sık belirleyen unsurlarla aynı:
- Kurulum karmaşıklığı: yeni bir kullanıcının çalışan bir scrape'e ne kadar hızlı ulaşabildiği.
- JavaScript desteği: projenin modern, istemci tarafında render edilen siteleri yönetip yönetemediği.
- Proje sağlığı: deponun hâlâ güven verecek kadar canlı görünüp görünmediği.
- Veri işleme: projenin yapılandırılmış çıktı üretip üretmediği veya işi size ne kadar bıraktığı.
- Hedef kitle uyumu: projenin gerçekten yeni başlayanlara, veri mühendislerine, güvenlik ekiplerine ya da teknik olmayan operatörlere uygun olup olmadığı.
Kurulum Karmaşıklığı: Ne Kadar Hızlı Başlayabilirsiniz?
Bu kurulum sınıflandırması hâlâ geçerli; ancak 2026'da daha yararlı çerçeve daha sade:
- Tak çalıştır: İş kullanıcıları için Thunderbit; hafif kod tabanlı script'ler için MechanicalSoup veya Nokogiri.
- Orta: Scrapy, Crawlee, Maxun, Selenium, Playwright, Puppeteer, Colly, Katana, Scrapling, WebMagic ve Node Crawler biraz kod, CLI ya da dağıtım emeği ister.
- İleri seviye: Heritrix ve Apache Nutch yalnızca gerçekten Java tabanlı arşivleme veya dağıtık tarama gerekiyorsa anlamlıdır.
Maxun burada özel olarak anılmayı hak ediyor; çünkü iki dünya arasında bir yerde duruyor. Platformun kendisinin dağıtılması gerekiyor, ancak son kullanıcı akışı doğrudan Scrapy veya Playwright ile çalışmaktan çok daha hafif.
Dinamik İçerik Desteği: Modern Web'i Hangi Projeler Yönetebilir?
Modern siteler React, Vue, sonsuz kaydırma, arka planda çalışan API çağrıları ve giriş gerektiren akışlarla dolu. Bu çizgi, “HTML'yi aldım” ile “gerçekten ihtiyacım olan veriyi aldım” arasındaki farkı belirler.
Bu listedeki projeler üç gruba ayrılıyor:
- Tam tarayıcı otomasyonu: Selenium, Playwright ve Puppeteer JavaScript'i eksiksiz çalıştırır ve etkileşimi yoğun siteler için hâlâ en güvenilir seçeneklerdir.
- Hibrit veya sarmalayıcı destek: Crawlee hafif HTTP tarama ile tarayıcı destekli scraping arasında geçiş yapabilir. Scrapling daha zorlu hedefler etrafında gizlilik odaklı araçlar ekler. Maxun ise görsel arayüz arkasında tarayıcı destekli bir yaklaşım kullanır.
- Varsayılan olarak yalnızca statik HTML: Scrapy, MechanicalSoup, Node Crawler, Colly, WebMagic, Nokogiri, Heritrix ve Apache Nutch modern render sorunlarını tek başına yerel olarak çözmez.
En büyük tereddütünüz “Bu yığın, her tarayıcı adımını tek tek yazmadan JavaScript ağırlıklı sayfaları yönetebilir mi?” sorusuysa, bu güncel Playwright scraping anlatımı en iyi orta karar gerçeklik kontrolüdür:
Proje Sağlığı: 2026'da Hangi Depolar Hâlâ Güvenilir Görünüyor?
Bu yazının 2025 versiyonu yıldız sayılarına ve birkaç eski güncelleme notuna dayanıyordu. Artık bu yeterli değil. 6 Ağustos 2026'da hem güncel yıldız sayılarını hem de son commit sinyallerini kontrol ettim.
Sağlıklı tablo şöyle görünüyor:
- Şu anda belirgin biçimde aktif: Scrapy, Crawlee, Maxun, MechanicalSoup, Heritrix, Apache Nutch, Selenium, Playwright, Puppeteer, Scrapling, Katana ve Nokogiri bu kontrolün öncesindeki iki hafta içinde herkese açık commit gönderdi.
- Canlı ama daha yavaş ilerliyor: Colly ve Node Crawler son commit'i 18 Haziran 2026'da attı. Hâlâ kullanılabilir görünüyorlar, ancak Playwright veya Crawlee kadar haftalık tempoda güncellenmiyorlar.
- Daha temkinli yaklaşmak gerekiyor: Bu listedeki gerçek boşluk WebMagic. Kontrol ettiğim en son herkese açık commit sinyali 20 Aralık 2025 tarihliydi; bu nedenle onu aktif olarak evrilen bir proje değil, daha çok kararlı bir proje olarak değerlendirmek gerekir.
Bu önemlidir, çünkü bakım biçimi kısa listenizi etkilemelidir:
- Yeni bir mühendislik inşası için güvenli varsayılan arıyorsanız, daha görünür biçimde aktif depoları tercih edin.
- Araç basitse ve kullanım alanınız darsa, daha yavaş ilerleyen projeler de kabul edilebilir.
- Proje uzmanlaşmışsa, önce uyuma bakın; haftalık sürüm çıkıp çıkmadığına değil.
2026'da En İyi 15 Web Scraping GitHub Projesi
Büyük Ölçekli veya Genel Amaçlı Scraping İçin Framework'ler
1. Scrapy
Scrapy, iş hızlı bir script'ten daha büyük olduğunda Python tarafında hâlâ ilk akla gelen çözümdür. Spider'lar, pipeline'lar, middleware, hız sınırlama, yeniden deneme mekanizmaları ve olgun bir ekosistem istiyorsanız, bu listedeki en güvenli açık kaynak framework tercihlerinden biri olmaya devam ediyor.
- Kurulum: Orta
- En uygun kullanım: e-ticaret katalogları, dizin tarama, haber toplama ve uzun ömürlü iç scraping sistemleri
- JS desteği: Yerel render yok; gerektiğinde Playwright veya Selenium ile eşleştirin
- Neden seçilmeli: olgun mimari, güçlü dokümantasyon ve açık kaynak scraping dünyasında en iyi güç/topluluk oranlarından biri
- Dikkat: bir crawler framework'ü içinde hiç çalışmadıysanız öğrenme eğrisi gerçektir
Scrapy yolunun size uyup uymadığını karar vermeden önce görmek isterseniz, bu güncel başlangıç anlatımı hâlâ faydalıdır:
2. Crawlee
Crawlee, hafif tarama ile tarayıcı destekli scraping'i tek projede birleştirmek istediğinizde JavaScript veya TypeScript için en çekici framework seçeneği hâline geldi. HTTP öncelikli akışlar ile Playwright veya Puppeteer destekli akışlar arasında geçiş yapabilmesi gerçek avantajıdır.
- Kurulum: Orta
- En uygun kullanım: JS ve TS ekipleri, hibrit statik ve dinamik hedefler, otomasyon ağırlıklı iç araçlar
- JS desteği: Evet
- Neden seçilmeli: esnek çalışma modeli, engel aşma yardımcıları ve eski crawler-only yığınlara göre daha iyi tarayıcı ergonomisi
- Dikkat: en çok Node.js'e zaten hâkim olan ekiplerde mantıklıdır
3. Colly
Colly, varsayılan olarak tarayıcı render'ına ihtiyaç duymayan Go ekipleri için hâlâ en temiz ve yüksek performanslı seçeneklerden biridir. Hızlıdır, şıktır ve darboğazın arayüz karmaşıklığı değil hacim olduğu durumlarda pratiktir.
- Kurulum: Orta
- En uygun kullanım: Hızlı statik crawler'lar yazan Go geliştiricileri
- JS desteği: Yerel render yok
- Neden seçilmeli: eşzamanlılık, oran sınırlama ve yüksek hacimli işler için kullanışlı bir API
- Dikkat: gerçek gereksinim tarayıcı otomasyonuysa doğru seçim değildir
4. WebMagic
WebMagic, Scrapy modelini seven ama JVM ekosisteminde kalmak isteyen ekipler için Java tarafındaki karşılık olmaya devam ediyor. Python veya Node tabanlı seçenekler kadar gündemde olmasa da Java ekipleri için hâlâ anlamlıdır.
- Kurulum: Orta
- En uygun kullanım: Java tabanlı scraping akışları
- JS desteği: Yerel render yok
- Neden seçilmeli: zamanlayıcılar, pipeline'lar ve anlaşılır bir framework yapısı
- Dikkat: ekosistem Python ve Node alternatiflerine kıyasla daha sessiz; ayrıca bulduğum en son herkese açık commit sinyali 20 Aralık 2025 tarihliydi, bu yüzden onu aktif olarak evrilen bir proje değil, daha çok kararlı bir proje olarak değerlendirin
5. Nokogiri
Nokogiri bir crawler framework'ü değildir. Ruby geliştiricilerinin özel bir script ya da uygulama akışı içinde temiz HTML veya XML işlemesi gerektiğinde başvurduğu ayrıştırıcıdır.
- Kurulum: Kolay
- En uygun kullanım: Ayrıştırmaya ihtiyaç duyan Ruby ve Rails uygulamaları; tam bir crawler framework'ü değil
- JS desteği: Hayır
- Neden seçilmeli: hızlı, kararlı ve varsayılan olarak güvenli ayrıştırma
- Dikkat: HTTP, oturum veya tarayıcı katmanını kendiniz sağlamanız gerekir
Hafif Statik ve Başlangıç Dostu Projeler
6. Maxun
Maxun, kodsuz scraping fikrini seven ama yine de kendi sunucusunda barındırma ve GitHub düzeyinde kontrol isteyenler için açık kaynak cevaptır. Saf bir framework'e kıyasla teknik olmayan kişiler için çok daha erişilebilir; ancak kapalı bir SaaS değil, gerçek bir açık kaynak projedir.
- Kurulum: Dağıtım açısından orta, kurulumdan sonra son kullanıcı için kolay
- En uygun kullanım: görsel arayüzle birlikte açık kaynak kontrolü isteyen ekipler
- JS desteği: Evet
- Neden seçilmeli: tıkla-seç çıkarım, çok adımlı akışlar ve sıfırdan kod yazmaya göre daha erişilebilir olması
- Dikkat: dağıtım adımı, tam yönetilen bir tarayıcı eklentisine göre yine de daha ağırdır
7. MechanicalSoup
MechanicalSoup bu listede yer almayı hak ediyor çünkü her scrape'in headless tarayıcıya ihtiyacı yoktur. Gerçek sorun oturum yönetimi, form gönderimi ya da giriş arkasında kalan statik bir akışta ilerlemekse, hâlâ küçük ve anlaşılır kalır.
- Kurulum: Kolay
- En uygun kullanım: Basit formlar, giriş korumalı statik sayfalar ve hızlı Python otomasyon script'leri
- JS desteği: Hayır
- Neden seçilmeli: düşük sürtünme, okunabilir kod ve Python kullanıcıları için yumuşak başlangıç
- Dikkat: JavaScript ağırlıklı sitelerde faydası hızla azalır
8. Node Crawler
Node Crawler, hedefiniz statik HTML ise ve özellikle eşzamanlılık, kuyruklama ve Cheerio tarzı ayrıştırma ile ilgileniyorsanız hâlâ yerini koruyor. Yeni ve tarayıcı ağırlıklı bir proje için bunu seçmezdim; ancak feed tarzı ve statik site toplama için hâlâ iyi bir eşleşme olabilir.
- Kurulum: Orta
- En uygun kullanım: Yüksek hızlı statik tarama ve toplama
- JS desteği: Hayır
- Neden seçilmeli: eşzamanlılık kontrolleri ve jQuery benzeri tanıdık ayrıştırma akışı
- Dikkat: bulduğum en son herkese açık commit sinyali 18 Haziran 2026 tarihliydi ve güncellemeler arasındaki aralıklar uzun; bu yüzden yeni ve uzun ömürlü bir dinamik site yığınına burada başlamazdım
Dinamik Site ve Tarayıcı Otomasyonu Projeleri
9. Selenium
Selenium, Playwright'tan daha eski olabilir; ancak tam tarayıcı davranışı ve etkileşim sadakati şıklıktan daha önemli olduğunda hâlâ önemlidir. Özellikle scraping, QA, regresyon otomasyonu veya çok literal tarayıcı davranışı isteyen sitelerle kesiştiğinde değerini korur.
- Kurulum: Orta
- En uygun kullanım: Etkileşimi yoğun akışlar, eski tarayıcı otomasyonu ve Selenium'u test için zaten kullanan ekipler
- JS desteği: Evet
- Neden seçilmeli: geniş tarayıcı kapsamı, dev ekosistem ve uzun süredir devam eden olgunluk
- Dikkat: yeni nesil otomasyon yığınları, sıfırdan başlayan scraping işleri için çoğu zaman daha temiz ve daha hızlı hissettirir
10. Playwright
Playwright, dinamik sayfa scraping'i gereken geliştirme ekipleri için benim varsayılan modern önerimdir. Çoklu tarayıcı desteği, güçlü bekleme davranışı ve temiz API'lerin birleşimi, onu burada geniş kullanım için önermeyi en kolay tarayıcı otomasyon projesi hâline getiriyor.
- Kurulum: Orta
- En uygun kullanım: Modern web uygulamaları, giriş gerektiren akışlar ve JavaScript ağırlıklı hedefler
- JS desteği: Evet
- Neden seçilmeli: tarayıcılar arası kontrol, sağlam otomasyon ilkelleri ve aktif bakım
- Dikkat: seçicilerden, tarayıcı altyapısından, yeniden denemelerden ve çıktı kalitesinden yine siz sorumlusunuz
11. Puppeteer
Puppeteer hâlâ Chrome odaklı klasik tercihtir. Ekibiniz zaten Node.js kullanıyorsa ve çoğunlukla Chromium uyumlu akışları hedefliyorsa, pratik ve iyi anlaşılmış bir seçenek olmaya devam eder.
- Kurulum: Orta
- En uygun kullanım: Chrome odaklı otomasyon, ekran görüntüleri, PDF'ler ve dinamik içerik çıkarımı
- JS desteği: Evet
- Neden seçilmeli: zengin tarayıcı kontrolü ve çok sayıda topluluk örneği
- Dikkat: daha geniş tarayıcı kapsamı veya daha modern bir tarayıcılar arası hikâye istiyorsanız Playwright daha güçlü varsayılan hâline geldi
12. Scrapling
Scrapling, bu gruptaki en uzmanlaşmış modern adaydır. Bu araç, tarayıcı render'ının tek sorun olmadığını zaten bilen kişiler içindir. Aynı zamanda gizlilik, proxy farkındalığı ve daha güçlü anti-bot yaklaşımı da gerekir.
- Kurulum: Orta
- En uygun kullanım: Gizli scraping, anti-bot hassas hedefler ve Python odaklı dinamik site işleri
- JS desteği: Evet
- Neden seçilmeli: aktif geliştirme ve daha basit framework'lerin göz ardı ettiği scraping sürtünmesine daha keskin odak
- Dikkat: düz statik siteler için gereğinden fazla, MechanicalSoup veya Scrapy'ye göre yeni başlayan dostu değil
Araştırma, Güvenlik ve Altyapı İşleri İçin Uzman Crawler'lar
13. Heritrix
Heritrix ürün karşılaştırma scraping'i için değildir. Tam site koruması ve standartlara uygun toplama ile ilgilenen kurumlar için tasarlanmış bir arşiv crawler'ıdır.
- Kurulum: İleri seviye
- En uygun kullanım: arşivler, kütüphaneler ve büyük ölçekli koruma akışları
- JS desteği: Hayır
- Neden seçilmeli: Internet Archive kökeni ve WARC odaklı arşiv iş akışları
- Dikkat: hedefli liste veya fiyat scraping'i için yanlış araçtır
14. Apache Nutch
Apache Nutch, tek seferlik iş scraping'inden çok dağıtık tarama, indeksleme veya arama motoru tarzı veri toplama düşünen ekipler için hâlâ anlamlıdır.
- Kurulum: İleri seviye
- En uygun kullanım: dağıtık tarama, araştırma veri setleri ve arama motoru tarzı toplama
- JS desteği: Hayır
- Neden seçilmeli: eklenti modeli ve Apache tarzı kurumsal aşinalık
- Dikkat: spreadsheet odaklı veya tarayıcı odaklı işlerin çoğu için fazlasıyla ağırdır
15. Katana
Katana'nın burada yer almasının nedeni, güvenlik taramasının başlı başına ayrı bir kullanım senaryosu olmasıdır. İş keşif, uç nokta bulma veya bir hedefin yapısını hızlıca ortaya çıkarma ise, Katana genel amaçlı bir scraping framework'ünden çok daha iyi bir eşleşmedir.
- Kurulum: Orta
- En uygun kullanım: güvenlik keşfi, bağlantı keşfi ve URL envanteri oluşturma
- JS desteği: İsteğe bağlı headless mod
- Neden seçilmeli: hız, eşzamanlılık ve güvenlik odaklı tarama modeli
- Dikkat: parlak bir iş verisi çıkarım yığını olarak tasarlanmamıştır
Ekip Türüne Göre Kısa Listem
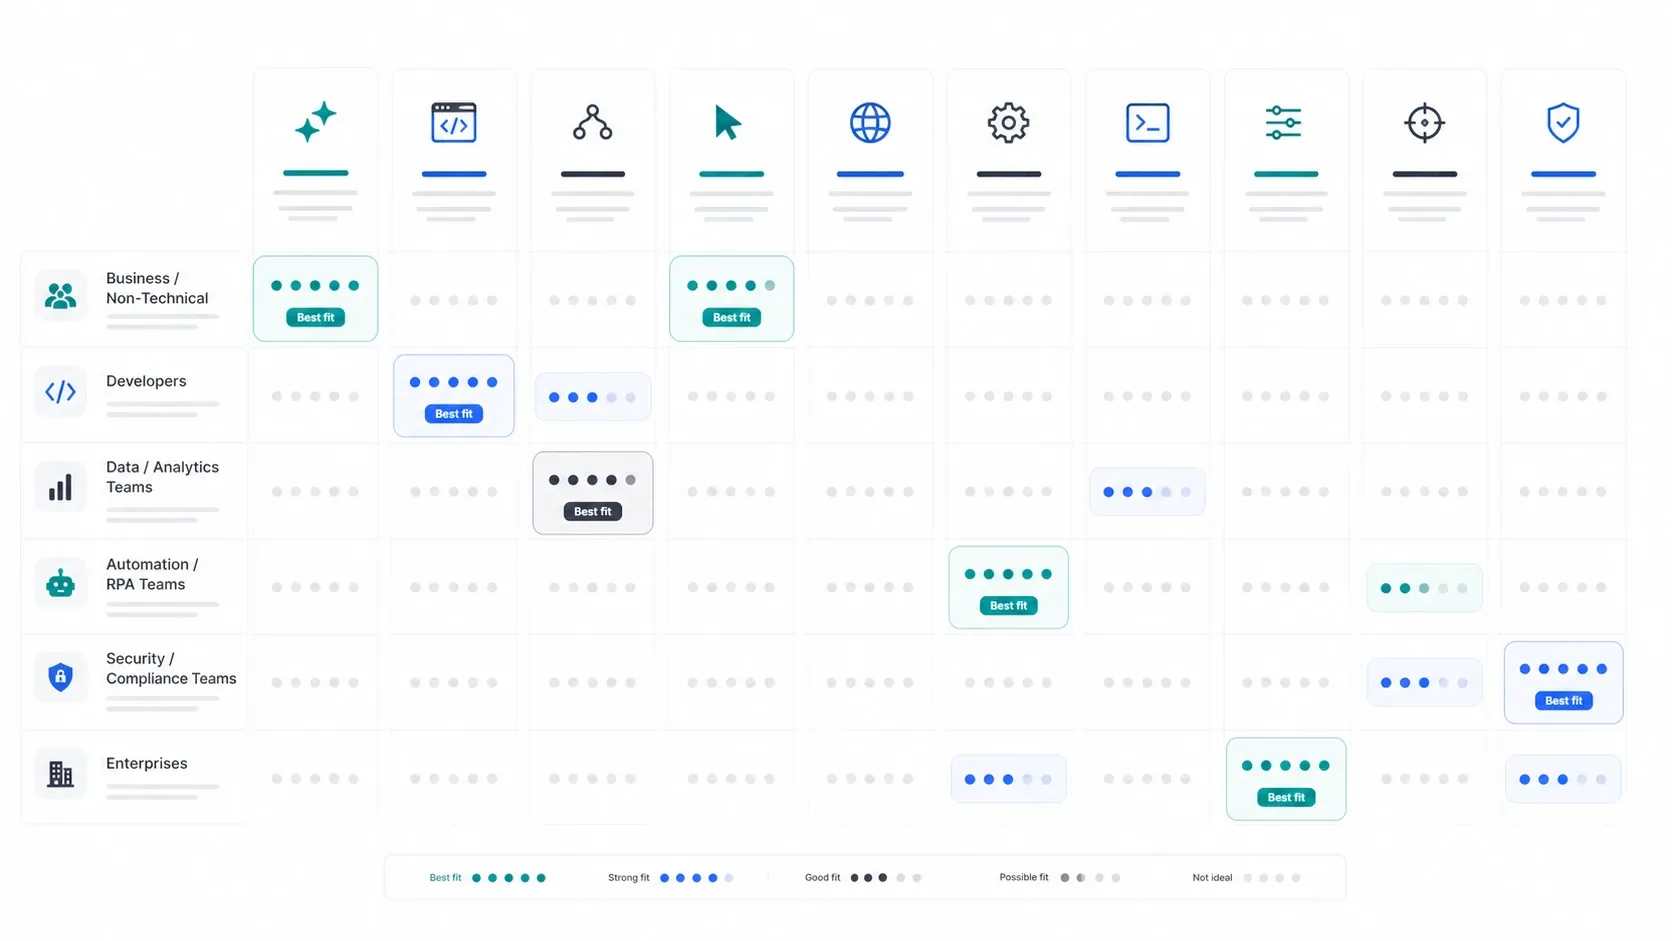
- Python geliştiricileri: framework için Scrapy, daha küçük statik akışlar için MechanicalSoup, gizlilik veya anti-bot sürtünmesi problemin bir parçasıysa Scrapling.
- JavaScript veya TypeScript ekipleri: framework için Crawlee, tarayıcı otomasyonu için Playwright, Chrome-first akışlar yeterliyse Puppeteer.
- Go ekipleri: scraping için Colly, keşif ağırlıklı güvenlik taraması için Katana.
- Java ekipleri: genel tarama için WebMagic, arşiv toplama için Heritrix, dağıtık arama tarzı tarama için Apache Nutch.
- Teknik olmayan operatörler: Açık kaynak ve kendi sunucunda barındırma istiyorsanız Maxun; yönetilen ve kodsuz bir iş akışıyla kullanılabilir çıktıya daha hızlı ulaşmak istiyorsanız Thunderbit.
Çoğu Kişi Gerçekte Hangisiyle Başlamalı?
Pragmatik cevap şu:
- Bir scraper kurmak ve sahip olmak istiyorsanız, Scrapy veya Crawlee ile başlayın.
- Gerçek bir tarayıcıyı kontrol etmeniz gerekiyorsa, Playwright ile başlayın.
- Görsel bir açık kaynak katman istiyorsanız, Maxun ile başlayın.
- Özel arşiv ya da güvenlik taraması gerekiyorsa, yalnızca kullanım senaryonuz bunu açıkça gerektiriyorsa Heritrix, Nutch veya Katana'yı seçin.
- Kodu atlayıp veriyi hemen almak istiyorsanız, kendinizi önce GitHub'a zorlamayın. Thunderbit'i kullanın.
Son Değerlendirme
2026'da en iyi web scraping GitHub projesi, ham yıldız sayısından çok hangi yükü üstlenmeye razı olduğunuza bağlıdır. Scrapy hâlâ en güvenli Python framework varsayılanıdır. Crawlee, modern JavaScript framework seçimi olarak en iyisidir. Playwright, en güçlü tarayıcı otomasyonu varsayılanıdır. Maxun, açık kaynak dünyasında en ilginç kodsuz yoldur. Heritrix, Apache Nutch ve Katana ise yalnızca iş gerçekten uzmanlaşmışsa mükemmel olan niş araçlardır.
Önemli olan, “en güçlü” ile “en iyi uyum”u karıştırmamaktır. Ekibinizin tek ihtiyacı bir elektronik tabloda temiz veri ise, GitHub hiç uygun başlangıç noktası olmayabilir.
Bakım yükünü bir kenara bırakın ve scraping'e daha hızlı başlayın Get Started Free



