
Yellow Pages เป็นแหล่งข้อมูลที่น่าแปลกใจตรงที่เหมือนจะไม่มีวันล้าสมัยเลย หลายสิบปีหลังจากสมุดโทรศัพท์เล่มสุดท้ายถูกวางไว้หน้าบ้านพ่อแม่ของฉัน เวอร์ชันดิจิทัลก็ยังเป็นเหมืองทองของทีมขายและการตลาดอยู่เสมอ แต่ประเด็นสำคัญคือ แม้ข้อมูลจะครบถ้วนและมีมากขึ้น การเก็บมาใช้จริงกลับซับซ้อนกว่าเดิมมาก ฉันเห็นมาหลายทีมเสียเวลาหลายชั่วโมงไปกับการคัดลอกข้อมูลธุรกิจทีละรายการ สุดท้ายได้แค่สเปรดชีตที่รกกับโอกาสทางธุรกิจที่หลุดมือไป นั่นแหละคือเหตุผลที่ฉันเชื่อมั่นในการใช้เครื่องมืออัจฉริยะอย่าง Thunderbit เพื่อเปลี่ยนข้อมูลจาก Yellow Pages ให้กลายเป็นความได้เปรียบในการแข่งขันแบบจริงจัง
ลองใช้ Thunderbit Yellow Pages Scraper แพ็กเกจฟรีรองรับ 6 หน้า/เดือน ไม่ต้องใช้บัตรเครดิต — เพียงพอสำหรับทดสอบการดึงข้อมูลจาก Yellow Pages ก่อนจะขยายการใช้งาน Get Started Free
ในคู่มือนี้ ฉันจะพาคุณดูว่าทำไมการดึงข้อมูลจาก Yellow Pages ถึงยังสำคัญกับการหาลีดในยุคนี้ วิธีตั้งเป้าหมายข้อมูลให้ชัดเจน รวมถึงแนวปฏิบัติที่ดีที่สุด พร้อมทริกเล็ก ๆ จากประสบการณ์จริง เพื่อให้ได้ข้อมูลที่สะอาดและเอาไปใช้ต่อได้มากที่สุด ไม่ว่าคุณจะเป็นมืออาชีพด้านการขายที่มีประสบการณ์ หรือแค่เบื่อการกรอกข้อมูลเอง ลองมาดูกันว่าคุณจะทำงานให้ไวขึ้นและได้ผลลัพธ์ดีขึ้นด้วย Yellow Pages Scraper ได้อย่างไร
Yellow Pages คืออะไร? ปลดล็อกคุณค่าของข้อมูลเพื่อการขายและการตลาด
Yellow Pages ไม่ได้เป็นแค่ของเก่าจากยุคอนาล็อกเท่านั้น แต่ยังเป็นหนึ่งในไดเรกทอรีธุรกิจที่ใหญ่และครอบคลุมที่สุดในโลก และตอนนี้ก็ย้ายมาอยู่ในรูปแบบดิจิทัลเต็มตัว ทำให้ยิ่งเกี่ยวข้องกับการทำงานมากขึ้นกว่าเดิม แพลตฟอร์ม Yellow Pages แบบดิจิทัลอย่าง YP.com, Yell และ PagesJaunes รวมกันมีรายชื่อ ธุรกิจนับล้านทั่วโลก ครอบคลุมแทบทุกอุตสาหกรรมที่คุณนึกถึง
แล้วอะไรทำให้ Yellow Pages มีคุณค่าขนาดนั้น? คำตอบคือความลึกและความกว้างของข้อมูล: ชื่อธุรกิจ เบอร์โทร อีเมล ที่ตั้งจริง เว็บไซต์ หมวดหมู่ธุรกิจ เวลาทำการ ไปจนถึงรีวิวจากลูกค้า สำหรับทีมขายและการตลาด สิ่งเหล่านี้คือขุมทรัพย์สำหรับ:
- การหาลีด: ค้นหาธุรกิจที่ยืนยันแล้วและยังเปิดดำเนินการอยู่ในตลาดเป้าหมายของคุณ
- การวิจัยตลาด: วิเคราะห์คู่แข่ง มองหาตลาดที่อิ่มตัว หรือหาเซ็กเมนต์ที่ยังถูกมองข้าม
- การเจาะพื้นที่เฉพาะ: ระบุธุรกิจตามเมือง รัฐ หรือรหัสไปรษณีย์สำหรับแคมเปญที่เน้นพื้นที่เฉพาะ
- การเข้าถึงลูกค้า B2B: สร้างรายชื่อแบบเจาะจงสำหรับโทรขาย ส่งอีเมลการตลาด หรือไปรษณีย์ตรง
และต่างจากลิสต์ที่ดึงมาจากหลายแหล่งแบบกระจัดกระจาย ข้อมูลจาก Yellow Pages มักอัปเดตมากกว่า และโฟกัสไปที่ธุรกิจที่ยังดำเนินการอยู่จริงและพร้อมตอบรับการติดต่อ (BrowserAct) ซึ่งหมายถึงงานสูญเปล่าน้อยลง และโอกาสได้คำตอบกลับมากขึ้น
ทำความชัดเจนกับความต้องการข้อมูลก่อนใช้ Yellow Pages Scraper
ก่อนคุณจะเปิด Yellow Pages Scraper ตัวโปรดของคุณ ลองหยุดคิดสักนิดเพื่อกำหนดให้ชัดว่าจริง ๆ แล้วคุณต้องการข้อมูลอะไร เชื่อฉันเถอะ ขั้นตอนนี้จะช่วยไม่ให้คุณจมอยู่กับข้อมูลที่ไม่เกี่ยวข้องในภายหลัง
กำหนดเกณฑ์เป้าหมายให้ชัด
ลองถามตัวเองว่า:
- คุณกำลังโฟกัสอุตสาหกรรมหรือหมวดหมู่ธุรกิจใด? (เช่น ร้านอาหาร ทันตแพทย์ อู่ซ่อมรถ)
- พื้นที่ทางภูมิศาสตร์ไหนสำคัญ? (เมือง รัฐ รหัสไปรษณีย์ หรือแม้แต่ประเทศ)
- ขนาดธุรกิจแบบไหนที่เกี่ยวข้อง? (บางไดเรกทอรีมีข้อมูลจำนวนพนักงานหรือปีที่ก่อตั้ง)
- มีคีย์เวิร์ดหรือความเชี่ยวชาญเฉพาะที่คุณสนใจไหม? (เช่น “vegan bakery”, “solar installer”)
เมื่อคุณจำกัดขอบเขตให้แคบลง คุณจะหลีกเลี่ยงปัญหาแบบเดิม ๆ อย่างการเก็บรายชื่อเป็นพันแต่ไม่เคยเอาไปใช้จริง ทั้งหมดนี้คือเรื่องของคุณภาพมากกว่าปริมาณ
ฟิลด์ข้อมูลที่มักต้องดึงออกมา
ทีมขายและการตลาดส่วนใหญ่มักต้องการ:
- ชื่อธุรกิจ
- เบอร์โทรศัพท์
- อีเมล (ถ้ามี)
- ที่อยู่จริง (ถนน เมือง รัฐ รหัสไปรษณีย์)
- URL เว็บไซต์
- หมวดหมู่/ประเภทธุรกิจ
- คำอธิบายหรือความเชี่ยวชาญ
- เวลาทำการ
- คะแนนหรือรีวิว
การกำหนดให้ชัดว่าคุณต้องการฟิลด์ไหนบ้าง จะช่วยให้คุณตั้งค่า scraper ได้แม่นที่สุด (Octoparse)
เลือกตัวกรองที่เหมาะกับ Yellow Pages Scraper ของคุณ
เว็บไซต์ Yellow Pages มักมีตัวเลือกค้นหาและกรองข้อมูลที่ค่อนข้างครบ ใช้ให้คุ้ม เช่น:
- อุตสาหกรรม + สถานที่: “Plumbers” ใน “San Diego, CA”
- คีย์เวิร์ด + หมวดหมู่: “Vegan” ใน “Restaurants”
- ขนาดธุรกิจ: กรองตาม “small business” หรือ “enterprise” (ถ้ามี)
ยิ่งตัวกรองเฉพาะเจาะจงมากเท่าไร ผลลัพธ์ก็ยิ่งตรงความต้องการมากขึ้น และคุณก็จะเสียเวลาทำความสะอาดข้อมูลน้อยลงในภายหลัง (Apify)
ดึงข้อมูล Yellow Pages ด้วย AI แยกข้อมูลลีดธุรกิจจาก Yellow Pages ได้ในคลิกเดียวด้วย agentic web scraper ของ Thunderbit Get Started Free
เมื่อใช้ตัวกรองเหล่านี้ คุณจะมั่นใจได้ว่าข้อมูลที่ได้ทั้งตรงเป้าและจัดการง่าย เป็นจุดเริ่มต้นที่ดีสำหรับการดึงข้อมูลอย่างมีประสิทธิภาพและต่อยอดไปเป็นอินไซต์ที่ใช้ได้จริง
รับมือหน้า Yellow Pages ที่ซับซ้อน: ดึงข้อมูลอย่างไรให้มีประสิทธิภาพ
ตรงนี้แหละที่เริ่มยากขึ้น เว็บไซต์ Yellow Pages ถูกออกแบบมาสำหรับผู้ใช้งานทั่วไป ไม่ได้สร้างมาเพื่อดึงข้อมูลจำนวนมากโดยตรง คุณจะเจอกับ:
- รายการหลายหน้า: ผลลัพธ์นับร้อยที่กระจายอยู่หลายสิบหน้า
- คอนเทนต์แบบไดนามิก: รายการที่โหลดเพิ่มเมื่อเลื่อนหน้า หรือกด “next”
- รายละเอียดซ้อนชั้น: ข้อมูลสำคัญอย่างอีเมลหรือคำอธิบายที่ซ่อนอยู่ในหน้ารายละเอียดของแต่ละธุรกิจ
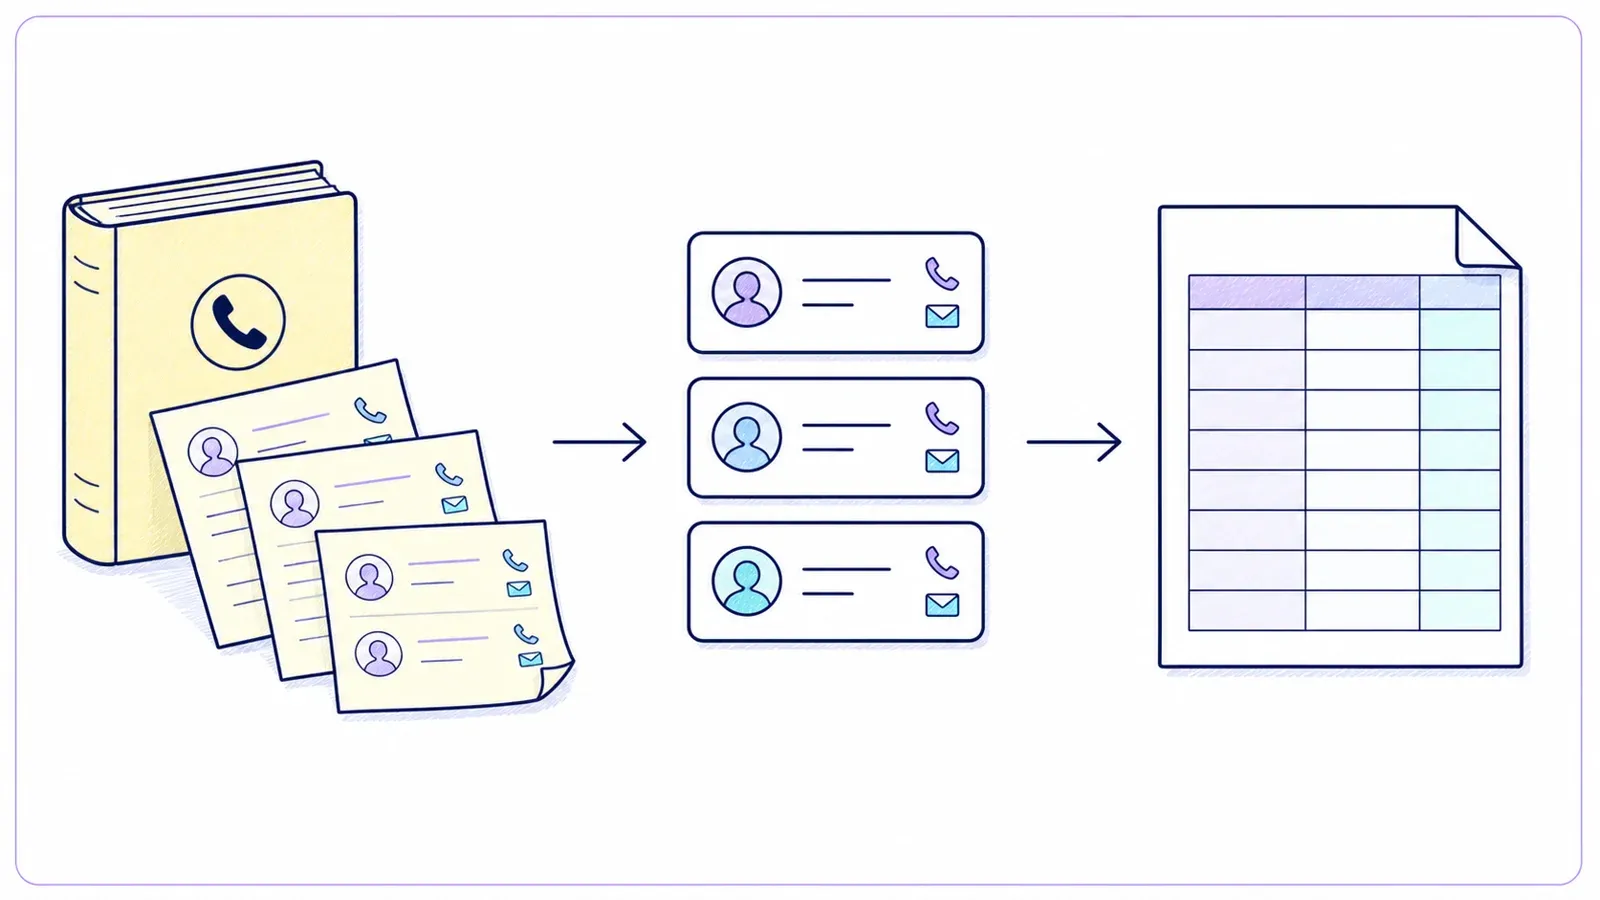 จะมานั่งดึงมือเอง? ลืมไปได้เลย เพราะการเก็บข้อมูลแค่ 100 รายชื่อด้วยมืออาจใช้เวลา 3–5 ชั่วโมง — และสำหรับทีมขายทั่วไป ทุกชั่วโมงที่เสียไปอาจเท่ากับต้นทุนโอกาสที่หายไปถึง 2,500 ดอลลาร์
นั่นคือเหตุผลที่ฉันชอบเครื่องมือยุคใหม่ที่ขับเคลื่อนด้วย AI อย่าง Thunderbit ซึ่งออกแบบมาเพื่อรับมือกับความท้าทายพวกนี้โดยตรง
ใช้ “One Click Extract” เพื่อดึงข้อมูลอย่างชาญฉลาด
ด้วย Thunderbit คุณไม่จำเป็นต้องเป็นนักวิทยาศาสตร์ข้อมูลก็ได้ผลลัพธ์ดี ๆ แค่เปิด Chrome extension ไปที่หน้าผลการค้นหาใน Yellow Pages แล้วกด “One Click Extract” AI ของ Thunderbit จะสแกนหน้าเว็บและระบุคอลัมน์ที่เกี่ยวข้องให้อัตโนมัติ เช่น “Business Name,” “Phone,” “Address,” “Website” และอื่น ๆ (Thunderbit Yellow Pages Scraper)
ข้อดีของฟีเจอร์นี้:
- ไม่ต้องเขียนโค้ดหรือเสียเวลาตั้งค่าเองให้ยุ่งยาก
- AI ปรับตามการเปลี่ยนแปลงของหน้าเว็บได้ (ไม่ต้องเจอเทมเพลตพังทุกครั้งที่เว็บไซต์อัปเดต)
- คนที่ไม่ใช่สายเทคนิคก็เริ่มได้ในไม่กี่นาที
คุณยังสามารถปรับฟิลด์ที่ระบบแนะนำ เพิ่มคอลัมน์เอง หรือใช้ AI prompt เพื่อดึงและติดป้ายกำกับข้อมูลให้ตรงกับที่ต้องการได้อีกด้วย
ใช้ “Subpage Scraping” เพื่อเก็บรายละเอียดเชิงลึกของธุรกิจ
หลายรายการใน Yellow Pages จะแสดงแค่ข้อมูลพื้นฐาน แต่ข้อมูลสำคัญจริง ๆ เช่น อีเมล ประวัติธุรกิจแบบละเอียด หรือความเชี่ยวชาญ มักอยู่ในหน้ารายละเอียดของแต่ละธุรกิจ ฟีเจอร์ “Subpage Scraping” ของ Thunderbit ช่วยให้คุณเข้าไปดึงข้อมูลจากทุกหน้ารายละเอียดอัตโนมัติ แล้วเติมข้อมูลลงในตารางหลักของคุณอย่างครบถ้วน (Thunderbit Yellow Pages Scraper)
ตัวอย่างเช่น หลังจากดึงรายชื่อร้านอาหารแล้ว คุณสามารถใช้ subpage scraping เพื่อเก็บ:
- ชื่อเจ้าของหรือผู้จัดการ
- อีเมลโดยตรง
- ลิงก์โซเชียลมีเดีย
- ไฮไลต์เมนูหรือความเชี่ยวชาญพิเศษ
สิ่งนี้ช่วยยกระดับการทำลีดลิสต์ให้แน่นขึ้นและใช้งานได้จริงมากขึ้น โดยไม่ต้องคลิกไล่ทีละหน้าเป็นชั่วโมง
ขั้นตอนสำคัญในการประมวลผลข้อมูล: ทำความสะอาด จัดรูปแบบ และเชื่อมต่อระบบ
การดึงข้อมูลเป็นแค่ก้าวแรกเท่านั้น ถ้าคุณอยากใช้งานข้อมูลได้จริง และไม่พลาดแบบน่าอาย คุณต้องทำความสะอาด จัดรูปแบบ และจัดระเบียบก่อนนำเข้า CRM หรือเครื่องมือ outreach
ทำความสะอาดและลบข้อมูลซ้ำ
- ลบรายการซ้ำ: แม้แต่ scraper ที่ดีมากก็อาจดึงธุรกิจเดิมซ้ำ หากธุรกิจนั้นอยู่หลายหมวดหมู่
- กรองรายการที่ข้อมูลไม่ครบ: ตัดแถวที่ขาดข้อมูลสำคัญ เช่น เบอร์โทรหรืออีเมล หากคุณไม่ได้ตั้งใจจะเติมภายหลัง
- ตรวจสอบอีเมลและเบอร์โทร: ใช้เครื่องมือในตัวหรือ validator ภายนอกเพื่อตรวจจับการพิมพ์ผิดและปัญหารูปแบบข้อมูล (Perfect Data Entry)
ทำให้การจัดรูปแบบและติดแท็กข้อมูลเป็นอัตโนมัติด้วย Thunderbit
AI ของ Thunderbit สามารถช่วย:
- ทำให้รูปแบบเบอร์โทรเป็นมาตรฐาน (เช่น รูปแบบ E.164 เพื่อให้ใช้กับ CRM ได้ง่าย)
- แยกและจัดรูปแบบที่อยู่ เป็นฟิลด์ย่อย เช่น ถนน เมือง รัฐ รหัสไปรษณีย์
- ติดแท็กและจัดหมวดหมู่ลีด ตามคีย์เวิร์ด สถานที่ หรือประเภทธุรกิจ
- แปลหรือสรุปคำอธิบาย เพื่อให้แบ่งกลุ่มข้อมูลได้ง่ายขึ้น
ทั้งหมดนี้ช่วยให้คุณแบ่งเซ็กเมนต์รายชื่อ มอบลีดให้เซลส์ที่เหมาะสม หรือกระตุ้นเวิร์กโฟลว์อัตโนมัติได้ง่ายขึ้นมาก
เปลี่ยน Yellow Pages ให้เป็นลีดลิสต์ คลิกเดียวดึงชื่อธุรกิจ เบอร์โทร ที่อยู่ และหมวดหมู่ลงตารางที่สะอาดเรียบร้อย — Email และ Phone Extractor ฟรี และไม่ใช้เครดิต Get Started Free
เตรียมข้อมูลสำหรับนำเข้า CRM
- แมปฟิลด์ให้ถูกต้อง: ตรวจสอบว่าคอลัมน์ที่ดึงมาสอดคล้องกับฟิลด์ที่ CRM ของคุณต้องการ เช่น “Business Name” → “Account Name”
- ส่งออกในรูปแบบที่เหมาะสม: Thunderbit ให้คุณส่งออกได้ตรงไปยัง Google Sheets, Airtable, Notion, CSV หรือ Excel
- ทดลองด้วยชุดเล็กก่อน: นำเข้าข้อมูลตัวอย่างก่อน เพื่อดูว่ามีปัญหาเรื่องการแมปหรือรูปแบบข้อมูลหรือไม่ ก่อนจะอัปโหลดทั้งหมด
5 เทคนิคที่พิสูจน์แล้วว่าช่วยเพิ่มประสิทธิภาพการดึงข้อมูลจาก Yellow Pages
ถ้าอยากดึงข้อมูลแบบฉลาดขึ้น ไม่เหนื่อยขึ้น นี่คือ 5 เทคนิคที่ฉันแนะนำที่สุด:
| เคล็ดลับ | รายละเอียด |
|---|---|
| 1. ตั้งเวลาการดึงข้อมูลช่วงนอกชั่วโมงเร่งด่วน | หลายเว็บไซต์จะจำกัดความเร็วหรือบล็อก scraper ในช่วงเวลาทำการ Thunderbit ให้คุณตั้งงานให้รันตอนกลางคืนหรือวันหยุด เพื่อให้ได้ผลลัพธ์ที่ลื่นไหลและเร็วขึ้น |
| 2. ใช้การหมุน IP หรือโหมดไม่ระบุตัวตน | ลดโอกาสถูกบล็อกด้วยการสลับ IP หรือเปิดเบราว์เซอร์ในโหมดส่วนตัว หากเป็นงานปริมาณมาก อาจพิจารณาใช้ VPN หรือ proxy (ScrapingBee) |
| 3. จำกัดอัตราการส่งคำขอ | ตั้งค่า scraper ให้ทำงานใกล้เคียงพฤติกรรมการใช้งานของคนจริง ๆ เพราะการส่งคำขอถี่เกินไปอาจกระตุ้นระบบป้องกันบอท |
| 4. อัปเดตเทมเพลตการดึงข้อมูลอย่างสม่ำเสมอ | แม้จะใช้ AI ก็ควรตรวจสอบการตั้งค่าหลังเว็บไซต์เปลี่ยนแปลงครั้งใหญ่ Thunderbit ปรับตัวอัตโนมัติได้ก็จริง แต่การเช็กสั้น ๆ ก็ไม่เสียหาย |
| 5. ตรวจสอบและยืนยันความถูกต้องของข้อมูลที่ดึงมา | สุ่มตรวจผลลัพธ์เป็นระยะ โดยเฉพาะหลังการรันงานยาว ๆ หรือชุดข้อมูลใหญ่ ใช้ฟีเจอร์ preview และ validation ของ Thunderbit เพื่อตรวจจับปัญหาแต่เนิ่น ๆ (Perfect Data Entry) |
ตั้งเวลาและทำงานอัตโนมัติให้ Yellow Pages Scraper ของคุณ
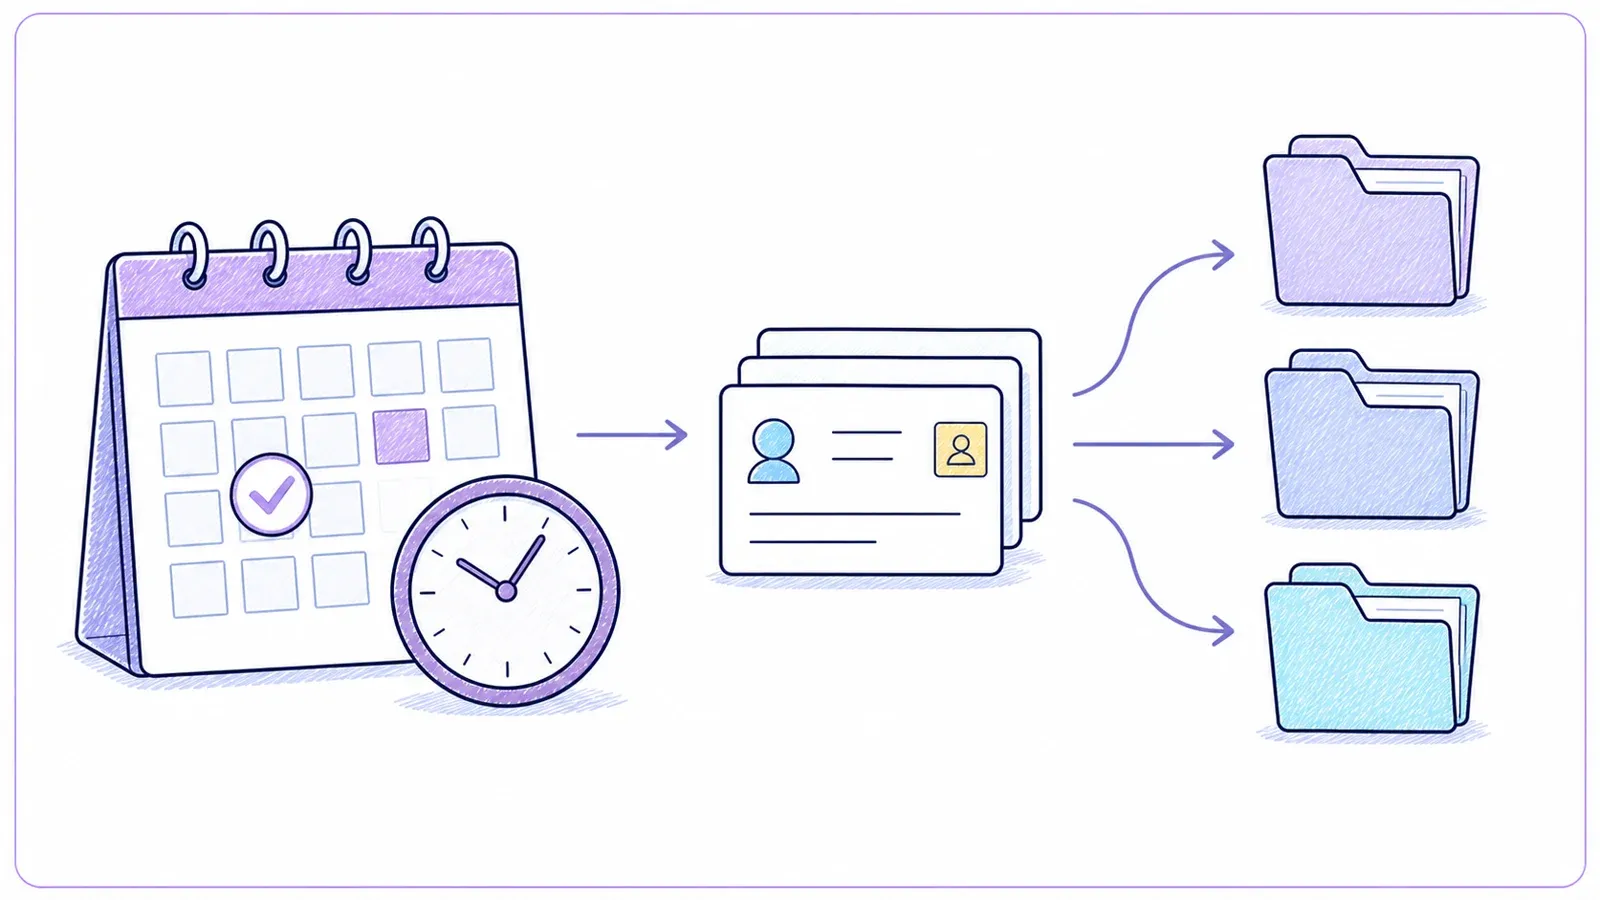 ฟีเจอร์ตั้งเวลาใน Thunderbit เป็นตัวช่วยสำคัญสำหรับทีมที่ต้องการลีดใหม่เป็นประจำ แค่ตั้งช่วงเวลาที่ต้องการ เช่น รายวัน รายสัปดาห์ หรือรายเดือน Thunderbit ก็จะดึงและอัปเดตข้อมูลให้อัตโนมัติ โดยที่คุณไม่ต้องลงแรงเอง เหมาะมากสำหรับ:
- ทีมขาย: มีรายชื่อติดต่ออัปเดตล่าสุดพร้อมใช้งานเสมอ
- ทีมอีคอมเมิร์ซ: ติดตามการเปิดร้านใหม่หรือรายชื่อคู่แข่ง
- เอเจนซี่: ดูแลลีดลิสต์ของลูกค้าให้สดใหม่อยู่เสมอโดยแทบไม่ต้องจับต้องอะไร
นำผลลัพธ์จาก Yellow Pages Scraper ไปใส่ในเวิร์กโฟลว์การขาย
เมื่อข้อมูลสะอาดและจัดรูปแบบเรียบร้อยแล้ว ก็ถึงเวลานำไปใช้งาน Thunderbit รองรับการส่งออกตรงไปยังเครื่องมือหลักที่ทีมขายและการตลาดใช้งานกันอยู่:
- Google Sheets: สำหรับการทำงานร่วมกันและวิเคราะห์อย่างรวดเร็ว
- Airtable: สำหรับเวิร์กโฟลว์แบบฐานข้อมูลที่ซับซ้อนขึ้น
- Notion: สำหรับการบริหารโปรเจกต์และ CRM แบบรวมศูนย์
- CSV/Excel: สำหรับนำเข้าจำนวนมากไปยัง Salesforce, HubSpot, Zoho หรือ CRM ที่คุณเลือกใช้
เคล็ดลับมือโปร: ตรวจสอบการแมปฟิลด์ทุกครั้งและทดสอบการนำเข้าด้วยข้อมูลจำนวนน้อยก่อนเสมอ เพื่อหลีกเลี่ยงการเขียนทับหรือแท็กข้อมูลผิด
ดูว่า Agentic Web Scraping ทำงานอย่างไร AI ของ Thunderbit อ่านหน้ารายชื่อธุรกิจเหมือนคนจริง และดึงลีดได้ในคลิกเดียว ไม่ต้องใช้ CSS selector Get Started Free
เมื่อคุณเชื่อมข้อมูลจาก Yellow Pages เข้ากับเวิร์กโฟลว์โดยตรง คุณจะเร่งการเข้าถึงลูกค้า ปรับการเจาะกลุ่มเป้าหมายให้แม่นขึ้น และสร้างผลลัพธ์ที่ดีกว่าให้ทีมได้
ข้อผิดพลาดที่พบบ่อยเมื่อใช้ Yellow Pages Scraper และควรหลีกเลี่ยง
แม้แต่เครื่องมือที่ดีที่สุดก็ไม่สามารถช่วยคุณจากข้อผิดพลาดคลาสสิกบางอย่างได้ นี่คือสิ่งที่ควรระวัง:
- ดึงข้อมูลที่ไม่เกี่ยวข้อง: หากไม่ตั้งตัวกรองให้ชัด รายชื่อจะบวมและไม่ตรงประเด็น
- ไม่ลบข้อมูลซ้ำ: รายชื่อซ้ำทำให้เสียเวลาและสร้างความรำคาญให้ผู้ที่ถูกติดต่อ
- มองข้ามเรื่องข้อกฎหมาย: ควรตรวจสอบเงื่อนไขการใช้งานของ Yellow Pages และกฎหมายคุ้มครองข้อมูลส่วนบุคคลในพื้นที่ของคุณก่อนเสมอ (Apify)
- ส่งคำขอหนักเกินไป: หากยิงคำขอถี่และเร็วเกินไป คุณอาจถูกบล็อกได้ ควรคุมจังหวะให้ดี
- ข้ามขั้นตอนตรวจสอบข้อมูล: อย่าคิดว่าข้อมูลที่ดึงมาแม่นยำ 100% ต้องตรวจสอบและทำความสะอาดก่อนนำเข้าเสมอ
ฟีเจอร์ใน Thunderbit อย่าง One Click Extract, การลบข้อมูลซ้ำ และการตรวจสอบการส่งออก ช่วยให้คุณเลี่ยงปัญหาเหล่านี้ได้เกือบทั้งหมดตั้งแต่เริ่มใช้งาน
สรุป: ข้อคิดสำคัญเพื่อเพิ่มประสิทธิภาพ Yellow Pages Scraper ให้สูงสุด
การดึงข้อมูลจาก Yellow Pages ยังคงเป็นหนึ่งในวิธีที่มีประสิทธิภาพที่สุดในการสร้างลีดลิสต์คุณภาพสูงและตรงเป้าสำหรับทีมขายและการตลาด แต่ถ้าคุณอยากเพิ่มประสิทธิภาพให้ถึงที่สุด และหลีกเลี่ยงข้อผิดพลาดเดิม ๆ คุณควร:
- กำหนดเป้าหมายข้อมูลและตัวกรองให้ชัดก่อนเริ่ม
- ใช้ฟีเจอร์ขั้นสูงอย่าง One Click Extract และ subpage scraping
- ทำความสะอาด จัดรูปแบบ และติดแท็กข้อมูลเพื่อให้เชื่อมกับ CRM ได้ง่าย
- ทำงานอัตโนมัติและตั้งเวลาการดึงข้อมูลเพื่อให้ข้อมูลสดใหม่เสมอ
- ตรวจสอบ ยืนยันความถูกต้อง และปฏิบัติตามข้อกำหนดในทุกขั้นตอน
ด้วย Thunderbit’s Yellow Pages Scraper คุณสามารถเปลี่ยนจากงานคีย์ข้อมูลหลายชั่วโมงให้กลายเป็นลีดลิสต์ที่สะอาดและพร้อมใช้งานได้ในคลิกเดียว นี่คือเครื่องมือที่ฉันอยากมีตั้งแต่หลายปีก่อน และตอนนี้มันกำลังช่วยให้ทีมงานนับพันทั่วโลกทำงานอย่างฉลาดขึ้น ไม่ใช่ทำงานหนักขึ้น
ดาวน์โหลด Thunderbit Chrome Extension ติดตั้งส่วนขยาย Chrome ฟรี แล้วเริ่มดึงรายการ Yellow Pages ได้ในคลิกเดียว Get Started Free
พร้อมลองด้วยตัวเองหรือยัง? ดาวน์โหลด Thunderbit Chrome Extension แล้วเริ่มสร้างลีดลิสต์ชุดต่อไปที่มีโอกาสปิดการขายสูงได้เลยวันนี้ และถ้าคุณอยากเจาะลึกแนวปฏิบัติที่ดีที่สุดในการดึงข้อมูลจากเว็บ ลองดู Thunderbit Blog เพื่ออ่านคู่มือและเคล็ดลับเพิ่มเติม
เริ่มดึงข้อมูล Yellow Pages ด้วย AI Get Started Free
คำถามที่พบบ่อย
1. การดึงข้อมูลจาก Yellow Pages ถูกกฎหมายหรือไม่?
โดยทั่วไปการดึงข้อมูลจากไดเรกทอรีธุรกิจสาธารณะสามารถทำได้สำหรับการใช้งานเชิงธุรกิจ แต่ควรตรวจสอบเงื่อนไขการใช้งานของเว็บไซต์นั้น ๆ และปฏิบัติตามกฎหมายคุ้มครองข้อมูลส่วนบุคคลในพื้นที่ของคุณเสมอ หลีกเลี่ยงการดึงข้อมูลส่วนตัวหรือใช้ข้อมูลที่ได้ไปส่งสแปม
2. วิธีที่ดีที่สุดเพื่อไม่ให้ถูกบล็อกระหว่างดึงข้อมูลจาก Yellow Pages คืออะไร?
ตั้งเวลาการดึงข้อมูลช่วงนอกชั่วโมงเร่งด่วน ใช้โหมดไม่ระบุตัวตนหรือการหมุน IP และจำกัดอัตราการส่งคำขอให้ใกล้เคียงพฤติกรรมผู้ใช้จริง ฟีเจอร์ตั้งเวลาและตัวเลือกการดึงผ่านเบราว์เซอร์ของ Thunderbit ช่วยลดความเสี่ยงในการถูกบล็อกได้มาก
3. ควรดึงฟิลด์ใดจาก Yellow Pages สำหรับลีดฝ่ายขาย?
ให้โฟกัสที่ชื่อธุรกิจ เบอร์โทร อีเมล ที่อยู่ เว็บไซต์ หมวดหมู่ธุรกิจ และข้อมูลเฉพาะทางที่เกี่ยวข้องกับแคมเปญของคุณ ใช้ฟีเจอร์ “One Click Extract” ของ Thunderbit เพื่อให้ระบบตรวจจับคอลัมน์ที่มีประโยชน์ที่สุดให้อัตโนมัติ
4. จะนำเข้าข้อมูล Yellow Pages ที่ดึงมาเข้า CRM ได้อย่างไร?
ส่งออกข้อมูลจาก Thunderbit เป็น CSV, Excel, Google Sheets, Airtable หรือ Notion แล้วแมปฟิลด์ให้ตรงกับความต้องการของ CRM ของคุณ และควรทดสอบด้วยข้อมูลชุดเล็กก่อนนำเข้าทั้งหมดเสมอ
5. จะทำให้ลีดลิสต์จาก Yellow Pages อัปเดตอยู่เสมอได้อย่างไร?
ใช้ฟีเจอร์ตั้งเวลาของ Thunderbit เพื่อดึงข้อมูลซ้ำแบบอัตโนมัติ วิธีนี้ช่วยให้รายชื่อของคุณสดใหม่และเกี่ยวข้องอยู่เสมอ เหมาะมากสำหรับงาน outreach ต่อเนื่องและการติดตามตลาด
ขอให้ดึงข้อมูลอย่างสนุก และขอให้ลีดลิสต์ของคุณสะอาด ทันสมัย และเต็มไปด้วยโอกาสเสมอ



