
เว็บเต็มไปด้วยข้อมูลมหาศาล—มากจนในปี 2025 เรากำลังพูดถึงการสร้างข้อมูลสูงถึง 463 เอ็กซะไบต์ต่อวัน แบบน่าทึ่ง ถ้าคุณทำงานสายขาย อีคอมเมิร์ซ ปฏิบัติการ หรือวิจัย คุณก็คงรู้ดีว่าการพยายามเปลี่ยนความวุ่นวายตรงนี้ให้กลายเป็นข้อมูลที่เอาไปใช้ได้จริงมันเหนื่อยแค่ไหน จะนั่งคัดลอกวางทีละบรรทัดน่ะเหรอ? ลืมไปได้เลย ทั้งช้า เสี่ยงพลาด และน่าเบื่อพอ ๆ กับนั่งดูสีแห้ง นี่จึงเป็นเหตุผลที่ทีมงานจำนวนมากขึ้น—78% ขององค์กรเลยทีเดียว—หันมาใช้ AI เพื่ออัตโนมัติการดึงข้อมูลจากเว็บ ทำให้งานที่เคยใช้เวลาหลายสัปดาห์เหลือแค่ไม่กี่นาที
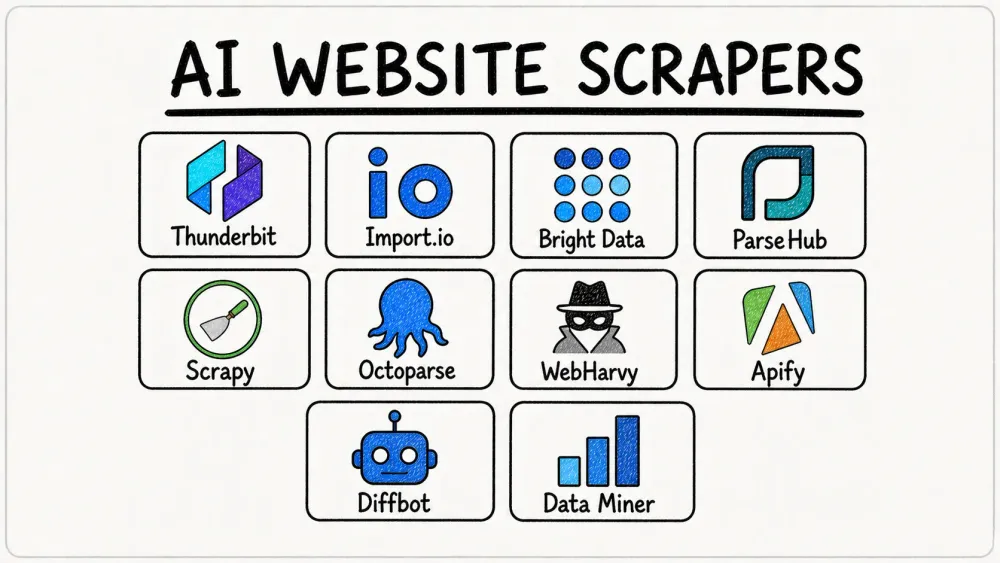
ผมใช้เวลาหลายปีอยู่ในโลก SaaS และระบบอัตโนมัติ และได้เห็นมากับตาว่าเครื่องมือดึงข้อมูลเว็บที่ขับเคลื่อนด้วย AI ที่ดีสามารถช่วยเพิ่มประสิทธิภาพได้แบบก้าวกระโดด แต่พอมีตัวเลือกเยอะขนาดนี้ จะเลือกตัวไหนดีให้เหมาะกับงานของคุณ? มาดู 10 เครื่องมือที่ใช้ AI ในการดึงข้อมูลเว็บไซต์ได้อย่างมีประสิทธิภาพกัน ตั้งแต่ส่วนขยาย Chrome แบบคลิกแล้วใช้ ไปจนถึงแพลตฟอร์มคลาวด์ระดับองค์กร
ทำไมต้องใช้ AI เพื่อดึงข้อมูลจากเว็บไซต์? เปิดประตูสู่ความเป็นไปได้ใหม่ ๆ
ดึงข้อมูลจากเว็บไซต์ใดก็ได้ด้วย AI AI web scraper แบบเอเจนต์ของ Thunderbit อ่านหน้าเว็บได้เองและดึงข้อมูลในคลิกเดียว โดยไม่ต้องตั้งค่าให้ยุ่งยาก Get Started Free
เครื่องมือดึงข้อมูลเว็บแบบดั้งเดิมก็เหมือน GPS รุ่นเก่า—แค่เส้นทางเปลี่ยนนิดเดียวก็พาเราหลงทันที มันพึ่งพากฎตายตัวและตัวเลือกบนหน้าเว็บ ซึ่งพังเอาง่าย ๆ เมื่อเว็บไซต์ปรับหน้าตา แต่ตัวดึงข้อมูลที่ใช้ AI จะต่างออกไป เพราะใช้แมชชีนเลิร์นนิงและการประมวลผลภาษาธรรมชาติเพื่อจับแพตเทิร์น ปรับตัวตามการเปลี่ยนแปลง และยังเข้าใจได้จากคำอธิบายภาษาอังกฤษล้วน ๆ ว่าคุณต้องการอะไร (Bright Data)
สิ่งที่ AI ช่วยได้มีดังนี้:
- ความเร็ว: ตัวดึงข้อมูลแบบ AI เปลี่ยนงานวิจัยที่ต้องทำมือเป็นสัปดาห์ ให้เหลือแค่ไม่กี่นาที (KanhaSoft)
- ความแม่นยำ: ใช้คอมพิวเตอร์วิทัศน์และ NLP แยกได้ว่าอะไรคือชื่อสินค้า อะไรคือรายละเอียด ช่วยให้ข้อมูลสะอาดและเชื่อถือได้มากขึ้น
- ความยืดหยุ่น: เมื่อเว็บไซต์เปลี่ยน AI ก็ปรับตามได้ ไม่ต้องคอยซ่อมสคริปต์ตลอดเวลา
- ใช้งานง่ายขึ้น: คนไม่ถนัดเทคนิคก็ยังดึงข้อมูลได้ เพียงอธิบายสิ่งที่ต้องการ เปิดโอกาสให้ทุกคนทำ lead generation ติดตามราคา และวิจัยตลาดได้
- ประหยัดต้นทุน: หลายทีมรายงานว่าใช้เวลาในการดึงข้อมูลเร็วขึ้น 30–40% และลดงานที่ต้องทำด้วยมือได้มาก
สรุปสั้น ๆ คือ การใช้ AI ดึงข้อมูลเว็บไซต์ช่วยให้คุณได้ข้อมูลที่เร็วกว่า แม่นยำกว่า และเชื่อถือได้กว่า—โดยไม่ต้องเป็นผู้เชี่ยวชาญ regex หรือมีนักพัฒนาอยู่กดเรียกให้ตลอดเวลา
เราคัดเลือกเครื่องมือที่ใช้ AI ในการดึงข้อมูลเว็บไซต์อย่างไร
ด้วยเครื่องมือมากมายในตลาด ผมเลยใช้เกณฑ์สำคัญหลายข้อเพื่อคัด 10 ตัวที่ดีที่สุด:
- ใช้งานง่าย: คนไม่เขียนโค้ดสามารถเริ่มใช้ได้เร็วแค่ไหน? มีหน้าตาแบบภาพหรือรองรับภาษาธรรมชาติไหม?
- ความสามารถของ AI: เครื่องมือนั้นใช้ AI ในการตรวจจับฟิลด์ ปรับตามการเปลี่ยนเลย์เอาต์ หรือเข้าใจคำสั่งภาษาธรรมชาติหรือไม่?
- ฟีเจอร์ครบไหม: รองรับ pagination, scheduling, การจัดการ proxy, แก้ CAPTCHA และรูปแบบการส่งออกข้อมูลหรือไม่?
- ขยายการใช้งานได้แค่ไหน: รับได้ตั้งแต่ไม่กี่หน้าไปจนถึงหลักล้านหน้าไหม? มีตัวเลือกคลาวด์หรือเปล่า?
- ราคาและการเข้าถึง: มีแพ็กเกจฟรีไหม? คุ้มค่าสำหรับรายบุคคล ทีม SMB และองค์กรหรือไม่?
- การซัพพอร์ตและชุมชน: มีเอกสารดีไหม ทีมซัพพอร์ตตอบไวไหม และมีฐานผู้ใช้ที่ active หรือไม่?
- ชื่อเสียง: รีวิวจริงจากผู้ใช้ คำรับรอง และความน่าเชื่อถือในระยะยาวเป็นอย่างไร?
ผมเลือกผสมทั้งส่วนขยายเบราว์เซอร์ แอปเดสก์ท็อป แพลตฟอร์มคลาวด์ และเฟรมเวิร์กสำหรับนักพัฒนา—ดังนั้นไม่ว่าคุณจะเป็นผู้ก่อตั้งเดี่ยว นักวิเคราะห์ข้อมูล หรือทีมระดับองค์กร คุณน่าจะเจอตัวที่เหมาะกับงาน
1. Thunderbit
 Thunderbit คือเครื่องมือที่ผมแนะนำเป็นอันดับแรกสำหรับผู้ใช้งานสายธุรกิจที่อยากใช้ AI ดึงข้อมูลจากเว็บไซต์ให้เร็วที่สุด ในฐานะ Chrome extension, Thunderbit ทำงานเหมือนผู้ช่วย AI ที่อ่านหน้าเว็บได้ทุกแบบ—even PDFs หรือรูปภาพ—แล้วแปลงเป็นข้อมูลโครงสร้างได้ในคลิกเดียว
อะไรที่ทำให้ Thunderbit โดดเด่น?
- อินเทอร์เฟซภาษาธรรมชาติ: แค่บอกสิ่งที่อยากได้ เช่น “ดึงชื่อสินค้า ราคา และรูปภาพทั้งหมดจากหน้านี้” แล้ว AI ของ Thunderbit จะจัดการที่เหลือ
- ดึงข้อมูลในคลิกเดียว: กดปุ่มเดียว AI จะสแกนหน้าเว็บและแนะนำคอลัมน์ที่ควรดึงออกมา คุณจะปรับแก้หรือยอมรับตามที่แนะนำก็ได้ แล้วกด “Scrape”
- ดึงข้อมูลจากหน้าย่อยและหลายหน้า: Thunderbit สามารถตามลิงก์ไปยังหน้าย่อยอัตโนมัติ เช่น หน้ารายละเอียดสินค้า และจัดการ pagination ได้ แม้แต่หน้า infinite scroll
- ส่งออกข้อมูลได้ทันที: ส่งออกไป Excel, Google Sheets, Airtable หรือ Notion ได้ตรง ๆ โดยไม่เสียค่าใช้จ่ายเพิ่ม
- ตัวดึงอีเมล/โทรศัพท์/รูปภาพฟรี: ดึงข้อมูลเหล่านี้ได้ด้วยคลิกเดียว ฟรีทั้งหมด
- ดึงข้อมูลแบบตั้งเวลา: ตั้งงานให้ทำซ้ำได้ด้วยภาษาธรรมชาติ เช่น “ทุกวันจันทร์ 9 โมงเช้า” แล้วปล่อยให้ AI จัดการต่อ
Thunderbit เด่นมากเวลาเจอหน้าเว็บที่รก ซับซ้อน หรือไม่เป็นมาตรฐาน—เช่นไดเรกทอรีเฉพาะทาง รายการอสังหาริมทรัพย์ หรือหน้าสินค้าอีคอมเมิร์ซที่ทำให้ตัวดึงข้อมูลอื่น ๆ ปวดหัว ผู้ใช้มักชื่นชมความเรียบง่ายและพลังของมันอย่างต่อเนื่อง โดยมีคะแนน 4.6★ บน Chrome Web Store
ราคา: ฟรีสำหรับดึงได้ 6–10 หน้า แผนแบบชำระเงินเริ่มราว $15/เดือน สำหรับ 500 เครดิต (หน้า) และมีแพ็กเกจระดับสูงขึ้นสำหรับความต้องการที่มากกว่า การส่งออกข้อมูลฟรีเสมอ
เหมาะสำหรับ: งานขาย การตลาด อีคอมเมิร์ซ และใครก็ตามที่อยากดึงข้อมูลโดยไม่ต้องเขียนโค้ดหรือปวดหัว
ลองใช้ Thunderbit Agentic Web Scraper ฟรี แพ็กเกจฟรีครอบคลุม 6 หน้า/เดือน ไม่ต้องใช้บัตรเครดิต — เหมาะสำหรับทดสอบการดึงข้อมูลด้วย AI อย่างรวดเร็ว Get Started Free
2. import.io
 import.io คือแพลตฟอร์มดึงข้อมูลระดับองค์กรที่แบรนด์ใหญ่ ๆ อย่าง Unilever และ Volvo ไว้วางใจ สิ่งที่ควรรู้ก่อนประเมินคือ ปัจจุบันผลิตภัณฑ์นี้เน้น real-time pricing intelligence สำหรับค้าปลีกและอีคอมเมิร์ซเป็นหลัก ส่วนการดึงข้อมูลทั่วไปจะอยู่เคียงข้างกันมากกว่าจะเป็นจุดขายหลัก ถ้ากรณีใช้งานของคุณคือการติดตามราคาแข่ง จุดนี้ถือว่าได้เปรียบ แต่ถ้าคุณต้องการเว็บสแครปเปอร์ทั่วไป ก็ควรชั่งน้ำหนักเทียบกับเครื่องมือที่สร้างมาเพื่อสิ่งนั้นโดยตรง
ทำไมต้องเลือก import.io?
- AI “Self-Healing” Pipelines: ถ้าเว็บไซต์เปลี่ยนไป AI ของ import.io สามารถปรับตัวให้เองอัตโนมัติ—ไม่ต้องเจอ scraper พังอีก
- Prompt-Based Extraction: ตั้งค่าการดึงข้อมูลด้วยคำสั่งระดับสูง แล้วให้ AI จัดการรายละเอียด
- การปฏิบัติตามข้อกำหนดแบบอัตโนมัติ: มีตัวกรองในตัวสำหรับกฎหมายความเป็นส่วนตัว (GDPR, CCPA) และสามารถปิดบังข้อมูลส่วนบุคคล (PII) ได้ตามต้องการ
- Cloud แบบบริหารจัดการครบ: จัดการ proxy rotation, scheduling และโครงสร้างพื้นฐานให้คุณ
- เชื่อมต่อ API ได้: เปลี่ยนเว็บไซต์ใดก็ได้ให้กลายเป็น API แบบสด ๆ สำหรับระบบวิเคราะห์หรือระบบธุรกิจ
ราคา: เริ่มราว ~$299/เดือน และมีแผนองค์กรแบบกำหนดเอง มีทดลองใช้ฟรี
เหมาะสำหรับ: องค์กรและทีมข้อมูลที่ต้องการ pipeline ข้อมูลเว็บขนาดใหญ่ เชื่อถือได้ และสอดคล้องตามข้อกำหนด
3. Bright Data
 Bright Data เน้นเรื่องสเกลเป็นหลัก ถ้าคุณต้องดึงข้อมูลจากหลายล้านหน้า ติดตามราคาทั่วโลก หรือป้อนข้อมูลเข้าสู่โมเดล AI นี่คือเครื่องมือของคุณ
ฟีเจอร์สำคัญ:
- เครือข่าย Proxy กว่า 100M+: มีทั้ง residential, mobile และ datacenter IP เพื่อกันการบล็อกได้อย่างยอดเยี่ยม
- AI-Powered Unblocker: แก้ CAPTCHA, สลับ headers และปรับตามมาตรการ anti-bot แบบเรียลไทม์
- Scraper สำเร็จรูป: API สำหรับเว็บไซต์ยอดนิยมกว่า 120 แห่ง (Amazon, LinkedIn, Google ฯลฯ)
- Dataset Marketplace: ซื้อหรือเข้าถึงชุดข้อมูลขนาดใหญ่ที่ดึงไว้ล่วงหน้าแล้ว
- LLM-Ready Data Streams: ส่งข้อมูลเว็บแบบเรียลไทม์เข้าสู่ระบบ AI ได้โดยตรง
ราคา: คิดตามการใช้งาน ซึ่งอาจมีค่าใช้จ่ายสูงเมื่อใช้ในปริมาณมาก มีทดลองใช้ฟรีและชุดข้อมูลฟรีบางส่วน
เหมาะสำหรับ: องค์กรขนาดใหญ่ โปรเจกต์ AI และใครก็ตามที่ต้องการข้อมูลเว็บจำนวนมากที่เชื่อถือได้และสอดคล้องตามข้อกำหนด
4. ParseHub
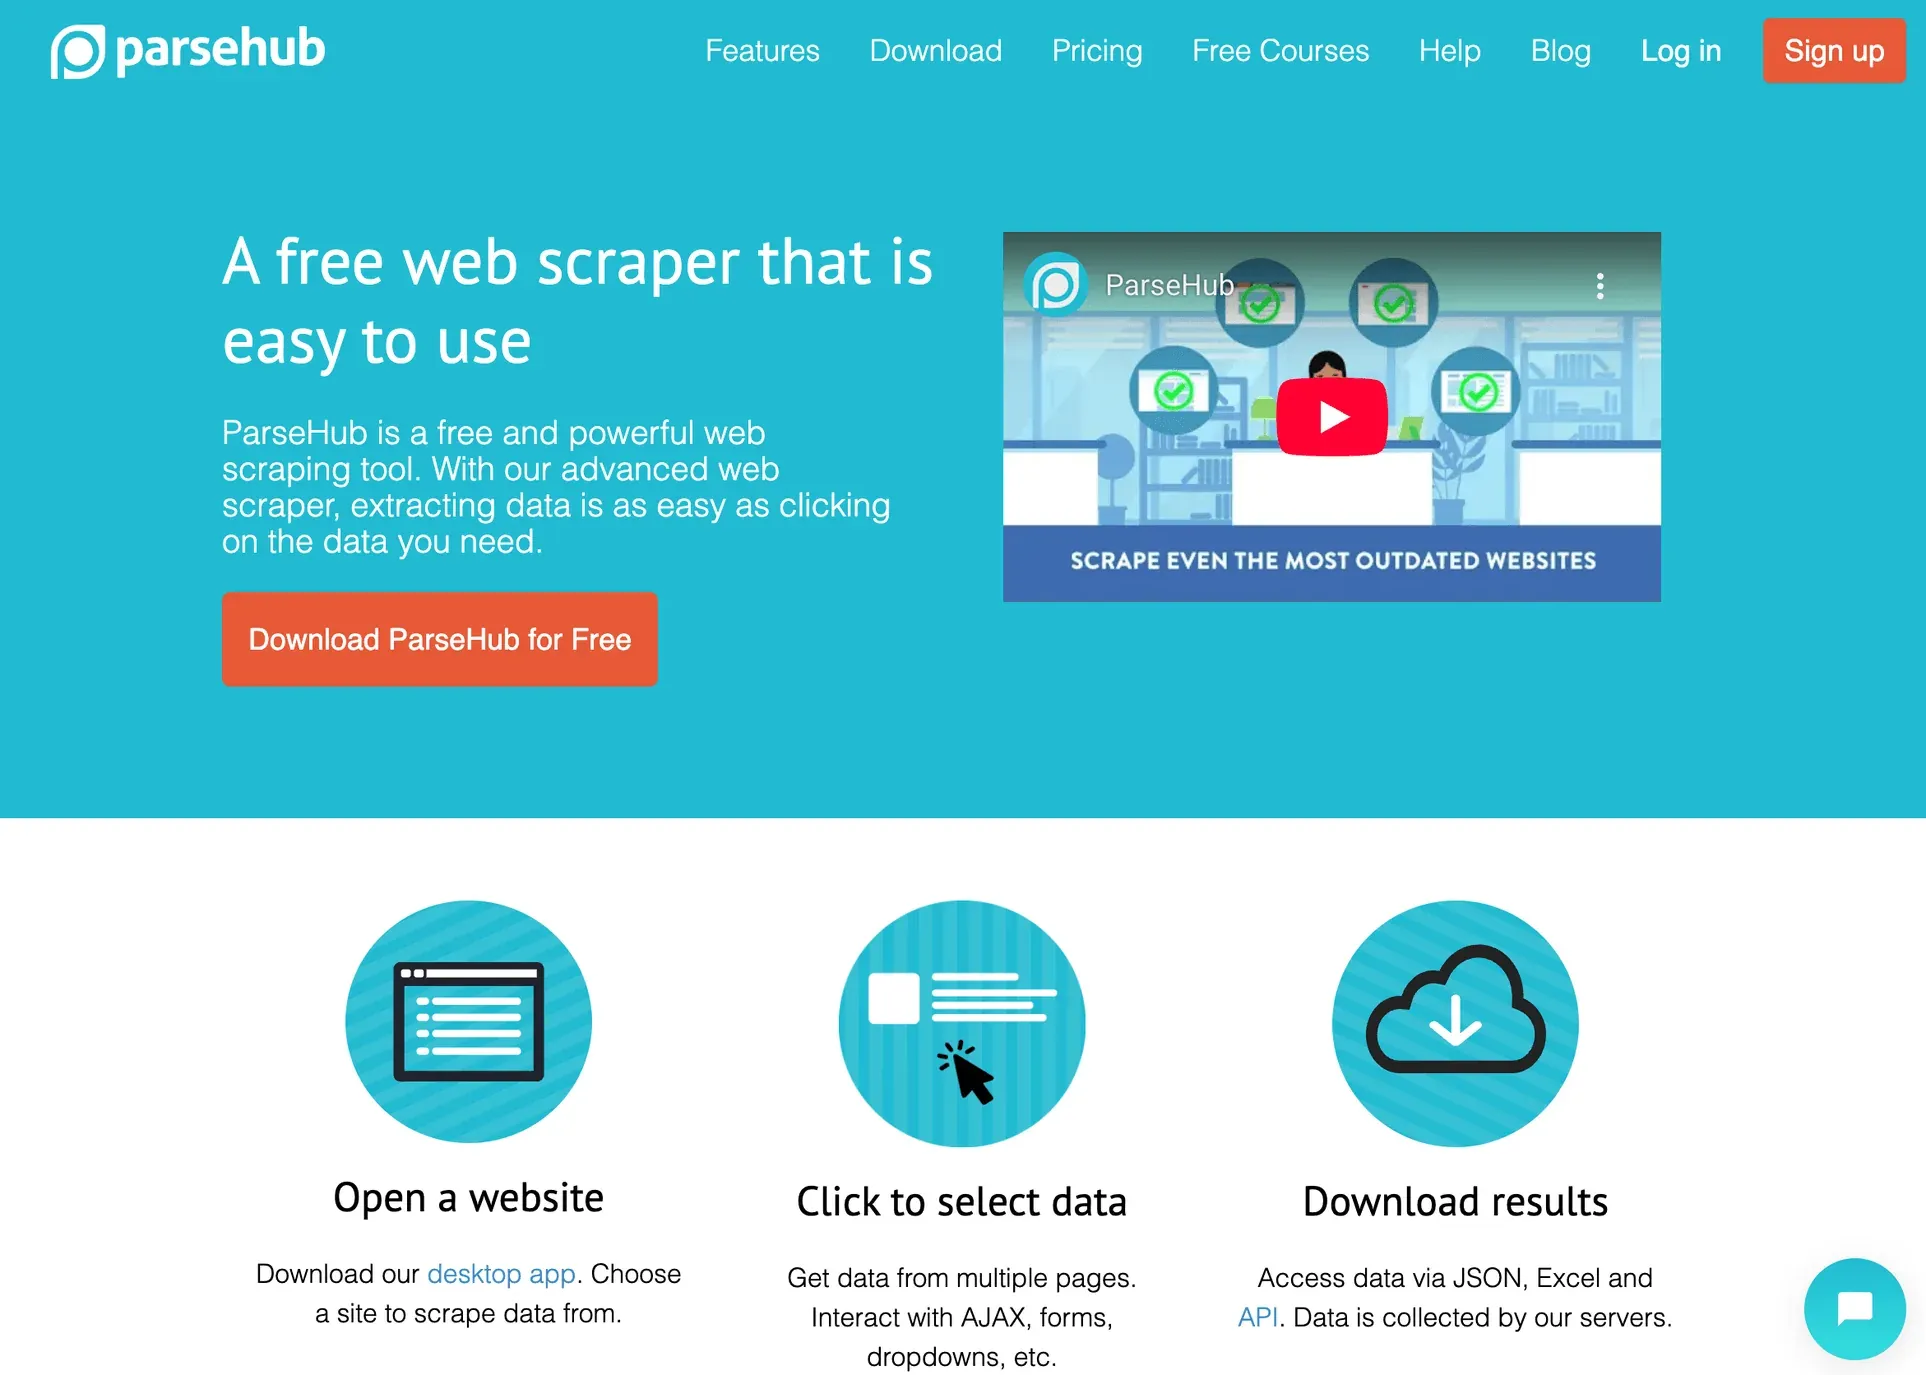 ParseHub คือแอปเดสก์ท็อป (Windows, Mac, Linux) ที่ทำให้การดึงข้อมูลเว็บแบบภาพใช้งานง่าย—even กับเว็บที่ไดนามิกและใช้ JavaScript หนัก ๆ
ทำไมต้อง ParseHub?
- Machine Learning Pattern Detection: คลิกที่ข้อมูลหนึ่งรายการ แล้ว ParseHub จะหาสิ่งที่คล้ายกันทั้งหมดให้อัตโนมัติ
- รองรับคอนเทนต์ไดนามิก: ใช้งานกับ AJAX, infinite scroll และองค์ประกอบแบบโต้ตอบได้
- ตัวสร้างเวิร์กโฟลว์แบบภาพ: สร้าง flow การดึงข้อมูลหลายขั้นตอนได้โดยไม่ต้องเขียนโค้ด
- Cloud Scheduling: รันงานบนคลาวด์และตั้งเวลางานซ้ำได้
- ส่งออกข้อมูลได้ยืดหยุ่น: CSV, Excel, JSON หรือ API
ราคา: ฟรีได้สูงสุด 5 โปรเจกต์ (200 หน้า/รัน); แผนชำระเงินเริ่มที่ $189/เดือน
เหมาะสำหรับ: นักวิเคราะห์ นักวิจัย และธุรกิจขนาดเล็กที่ต้องการตัวดึงข้อมูลแบบคลิกแล้วใช้ที่ทรงพลังสำหรับเว็บซับซ้อน
5. Scrapy
 Scrapy คือชุดเครื่องมือของนักพัฒนาสำหรับการดึงข้อมูลเว็บ เป็น Python framework แบบโอเพ่นซอร์ส และปรับแต่งต่อได้สูง
อะไรที่ทำให้ Scrapy พิเศษ?
- ยืดหยุ่นสูงสุด: เขียน spider เองเพื่อดึงอะไรก็ได้ ทุกขนาดงาน
- เชื่อม AI ได้: ใช้ส่วนขยายอย่าง Scrapy-LLM เพื่อแยกข้อมูลด้วย large language models (LLMs) หรือเชื่อม NLP เพื่อให้การดึงข้อมูลฉลาดขึ้น
- การ crawl แบบ asynchronous: เร็วมากและมีประสิทธิภาพสำหรับงานใหญ่
- ระบบนิเวศเปิด: มีปลั๊กอินมากมายสำหรับ proxy, browser automation และอีกเพียบ
ราคา: ฟรีและโอเพ่นซอร์ส คุณจ่ายเฉพาะโครงสร้างพื้นฐานของคุณเอง
เหมาะสำหรับ: นักพัฒนาและทีมเทคนิคที่ต้องการควบคุมเต็มรูปแบบ และอยากผสาน AI เข้าไปใน workflow การดึงข้อมูลแบบกำหนดเอง
6. Octoparse
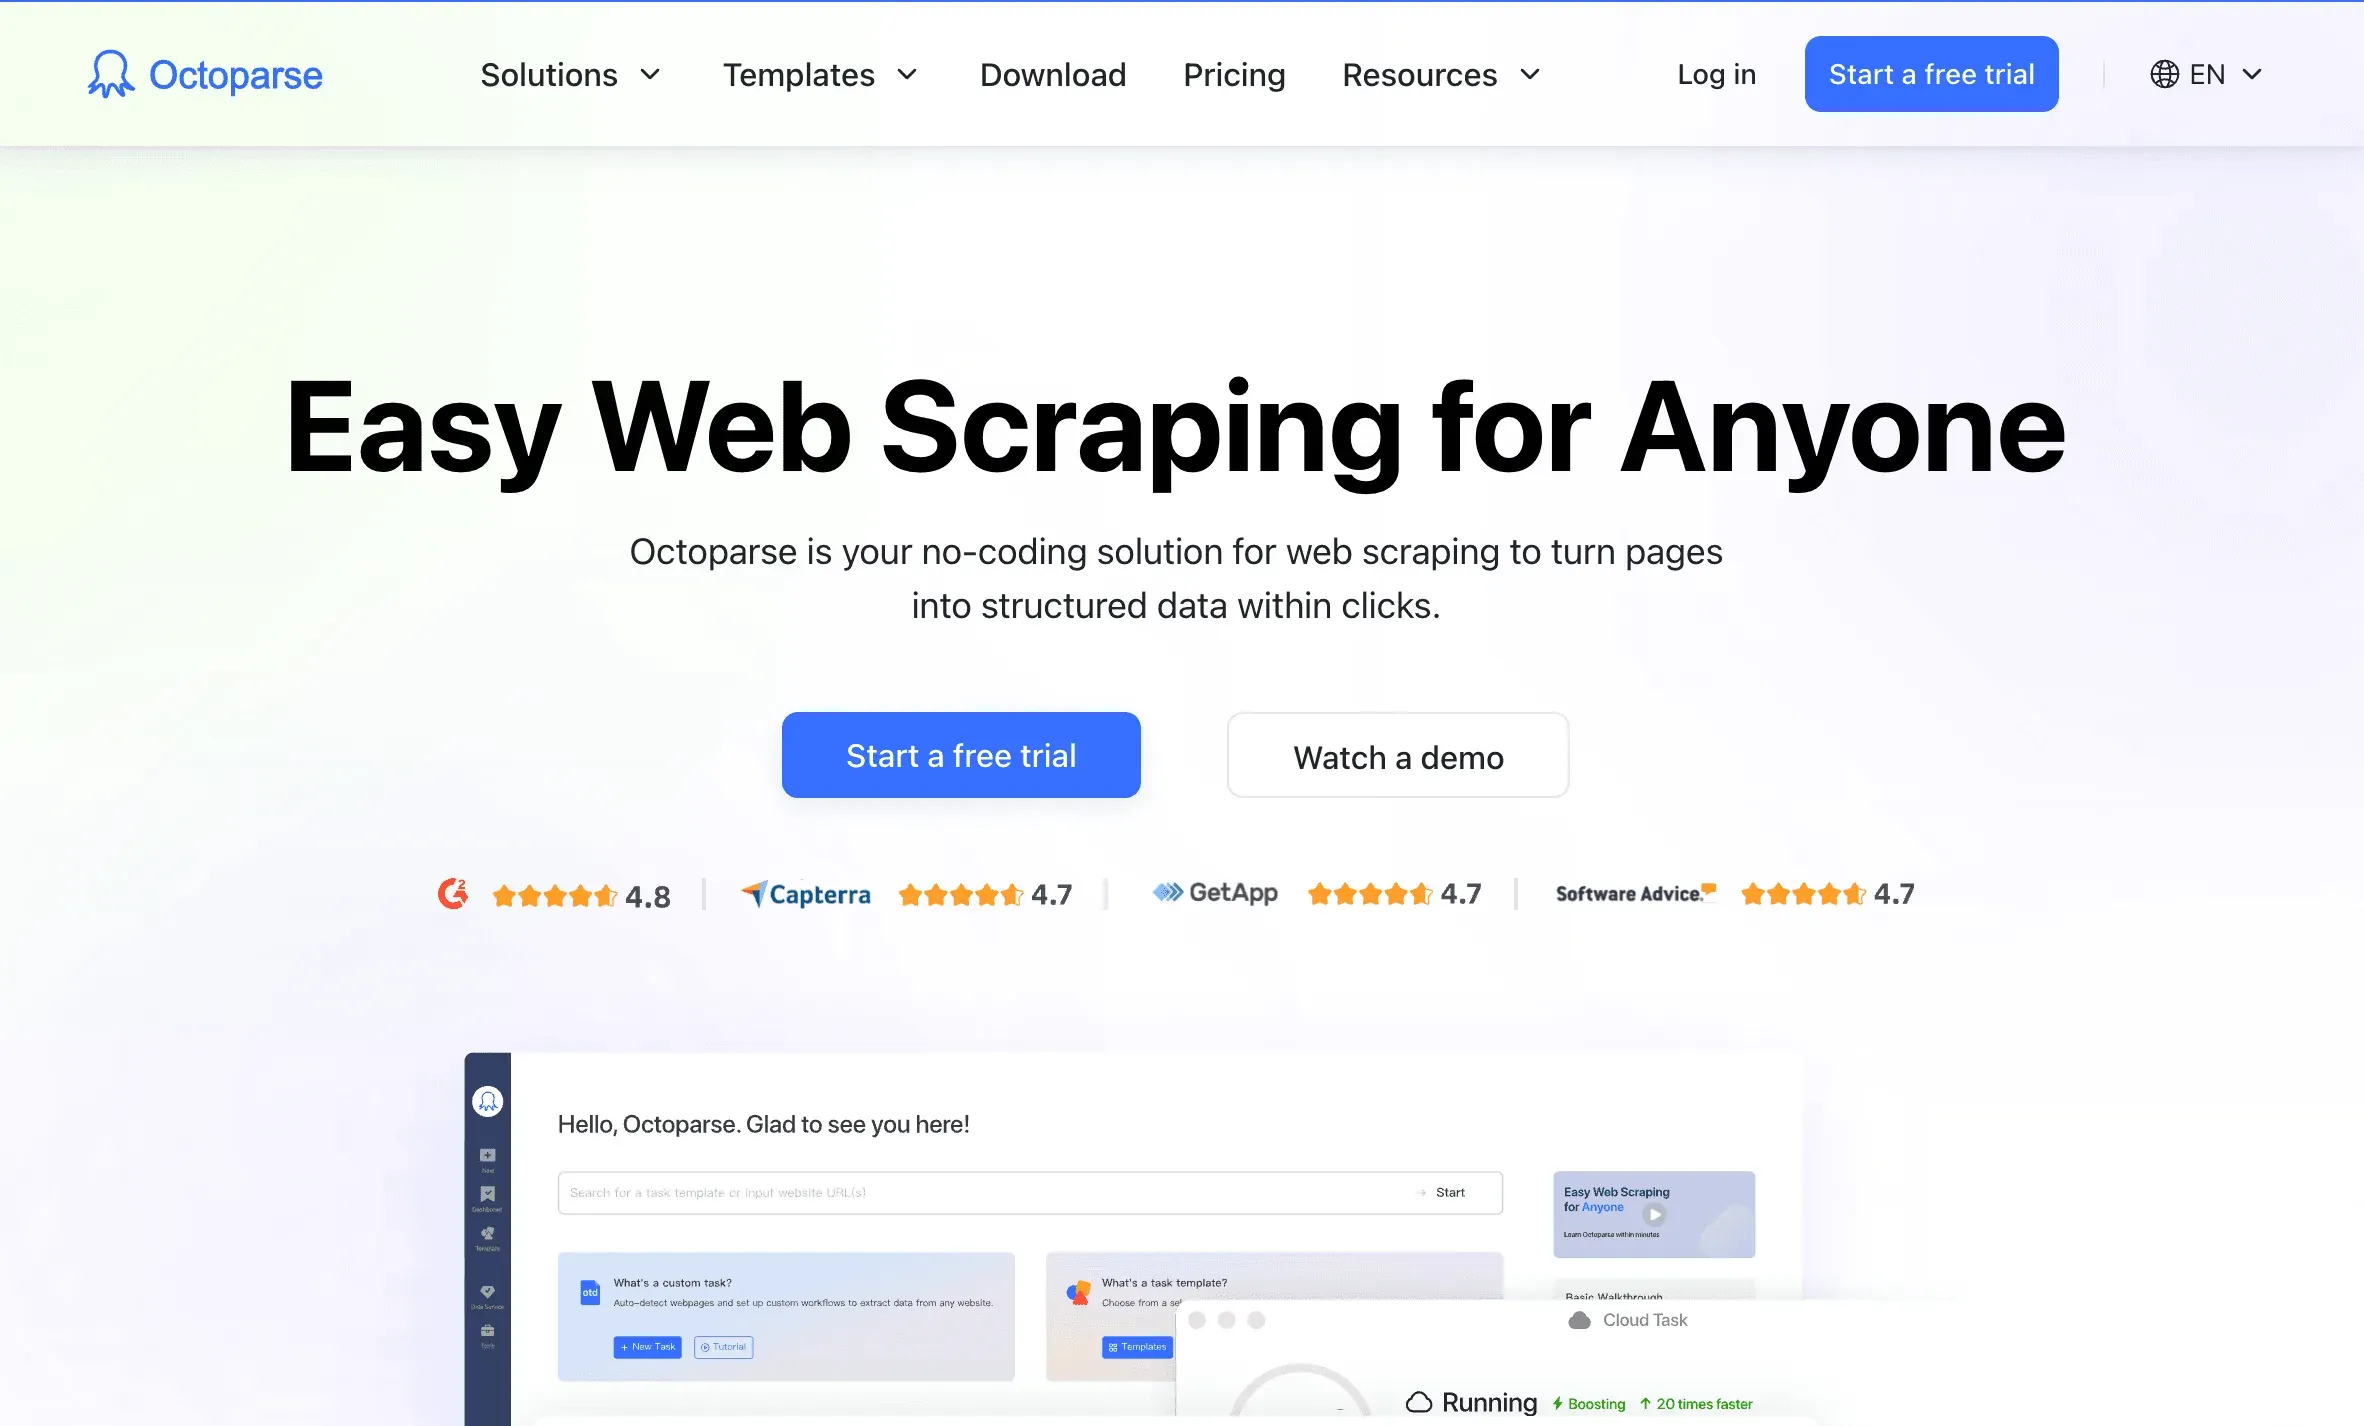 Octoparse คือ web scraper แบบ no-code บนคลาวด์ ออกแบบมาสำหรับผู้ใช้สายธุรกิจและทีมงาน
จุดเด่น:
- AI Auto-Detect: AI สแกนหน้าเว็บและแนะนำว่าควรดึงข้อมูลอะไร—ไม่ต้องตั้งค่าเอง
- Drag-and-Drop Workflow: สร้าง scraper แบบภาพ รองรับ login, pagination และคอนเทนต์ไดนามิก
- เทมเพลตสำเร็จรูป: มีเทมเพลตพร้อมใช้หลายร้อยแบบสำหรับเว็บไซต์ยอดนิยม
- Cloud Scheduling: รันและตั้งเวลาการดึงข้อมูลบนคลาวด์ได้ และส่งออกไป Sheets, Excel หรือผ่าน API
- AI Regex Helper: ให้ AI ช่วยสร้าง regex pattern
ราคา: มีแพ็กเกจฟรี (10 tasks); แผนชำระเงินเริ่มราว ~$75/เดือน
เหมาะสำหรับ: คนไม่เขียนโค้ด ทีมการตลาด และธุรกิจ SMB ที่ต้องการโซลูชันดึงข้อมูลที่ใช้งานง่ายแบบ no-code
7. WebHarvy
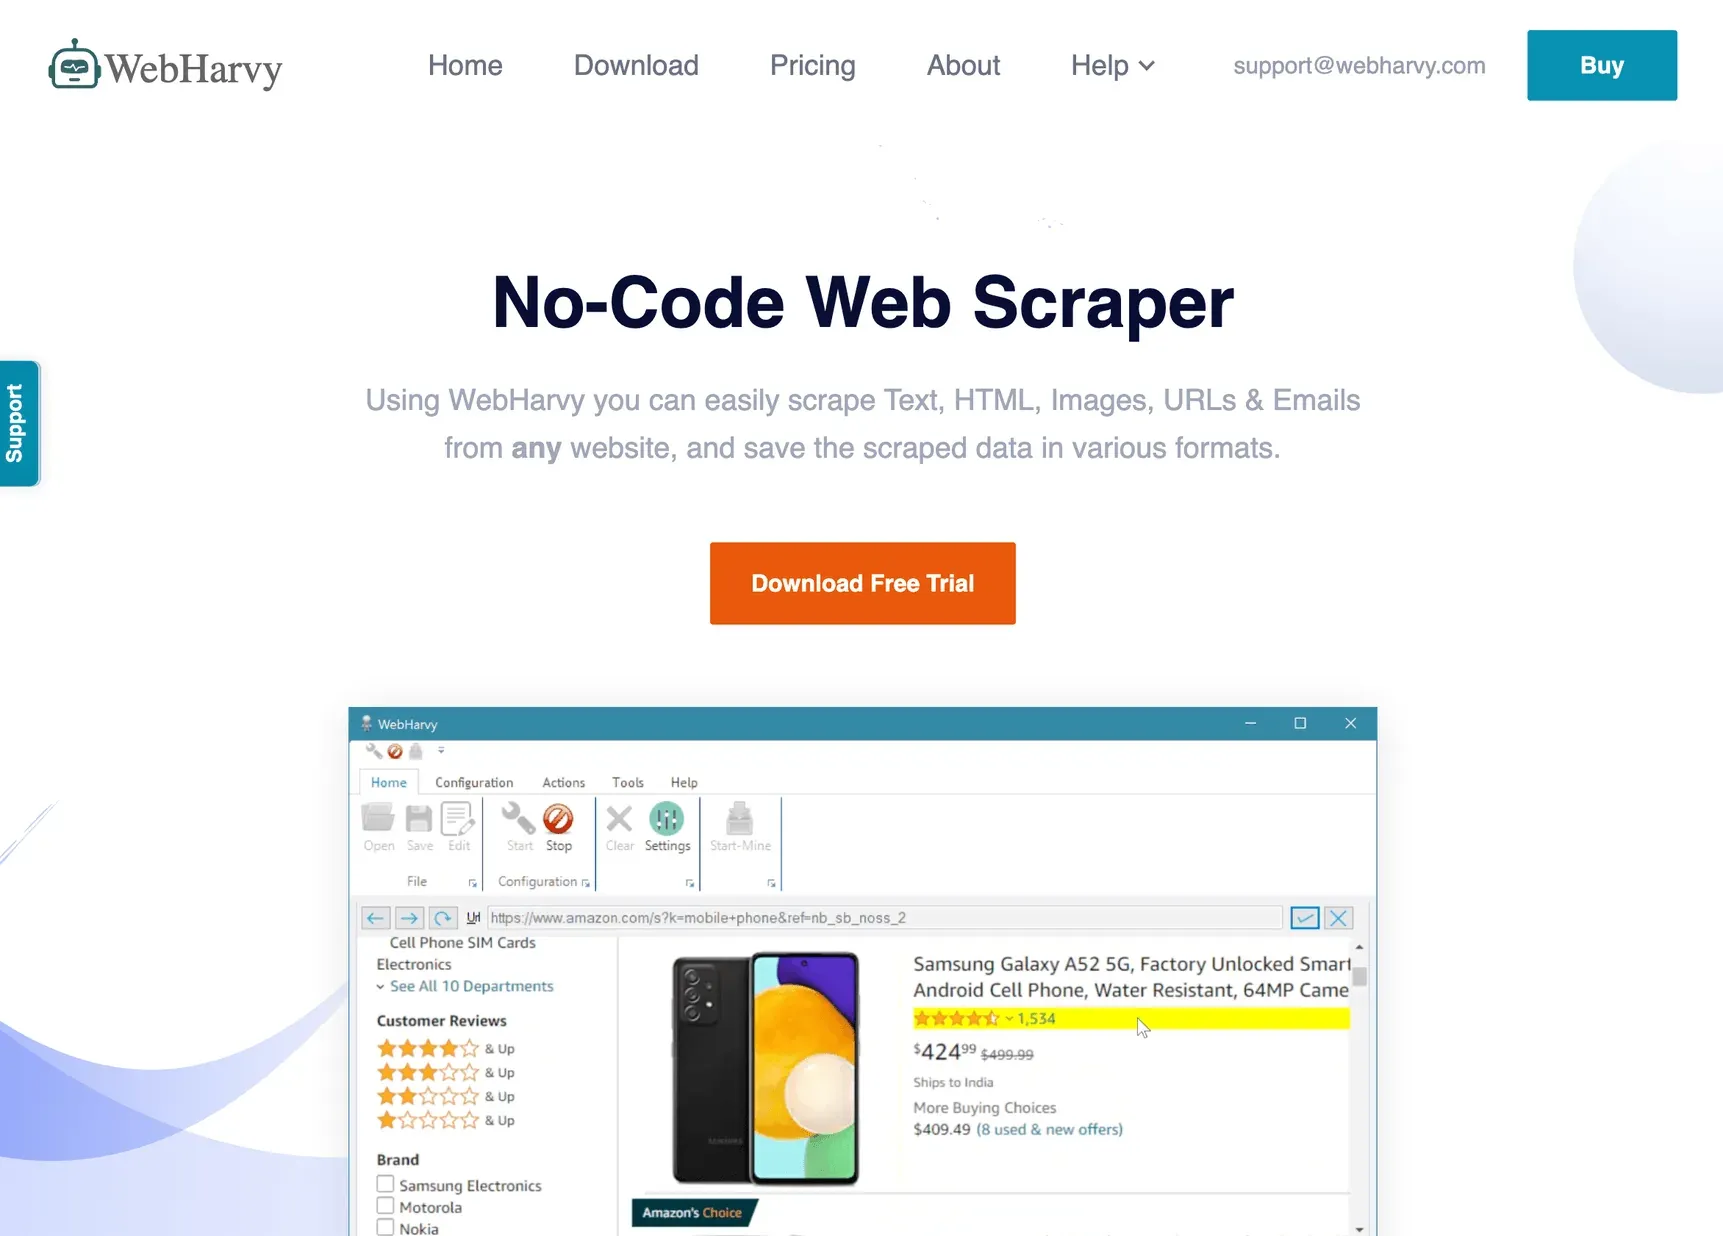 WebHarvy คือแอปเดสก์ท็อปบน Windows ที่ขึ้นชื่อเรื่องการตรวจจับแพตเทิร์นอัจฉริยะและรูปแบบไลเซนส์แบบซื้อครั้งเดียว
ทำไมต้องเลือก WebHarvy?
- ตรวจจับแพตเทิร์นอัตโนมัติ: คลิกข้อมูลหนึ่งรายการ แล้ว WebHarvy จะหาข้อมูลที่คล้ายกันทั้งหมดบนหน้าเว็บให้
- Visual Scraping: มีเบราว์เซอร์ในตัวให้เลือกข้อมูลด้วยการคลิก ไม่ต้องเขียนโค้ด
- ดึงรูปภาพและอีเมลได้: ดาวน์โหลดรูปภาพหรือแยกอีเมลได้อย่างง่ายดาย
- ซื้อครั้งเดียวจบ: ไลเซนส์ใช้งานตลอดชีพ (เริ่มที่ $129) และมีอัปเดตแบบมีค่าใช้จ่ายเพิ่มเติมถ้าต้องการ
ราคา: เริ่มที่ $129 จ่ายครั้งเดียวสำหรับผู้ใช้คนเดียว
เหมาะสำหรับ: ธุรกิจขนาดเล็ก นักวิจัย หรือใครก็ตามที่ใช้ Windows และอยากได้เครื่องมือดึงข้อมูลแบบออฟไลน์ที่คุ้มค่า
8. Apify
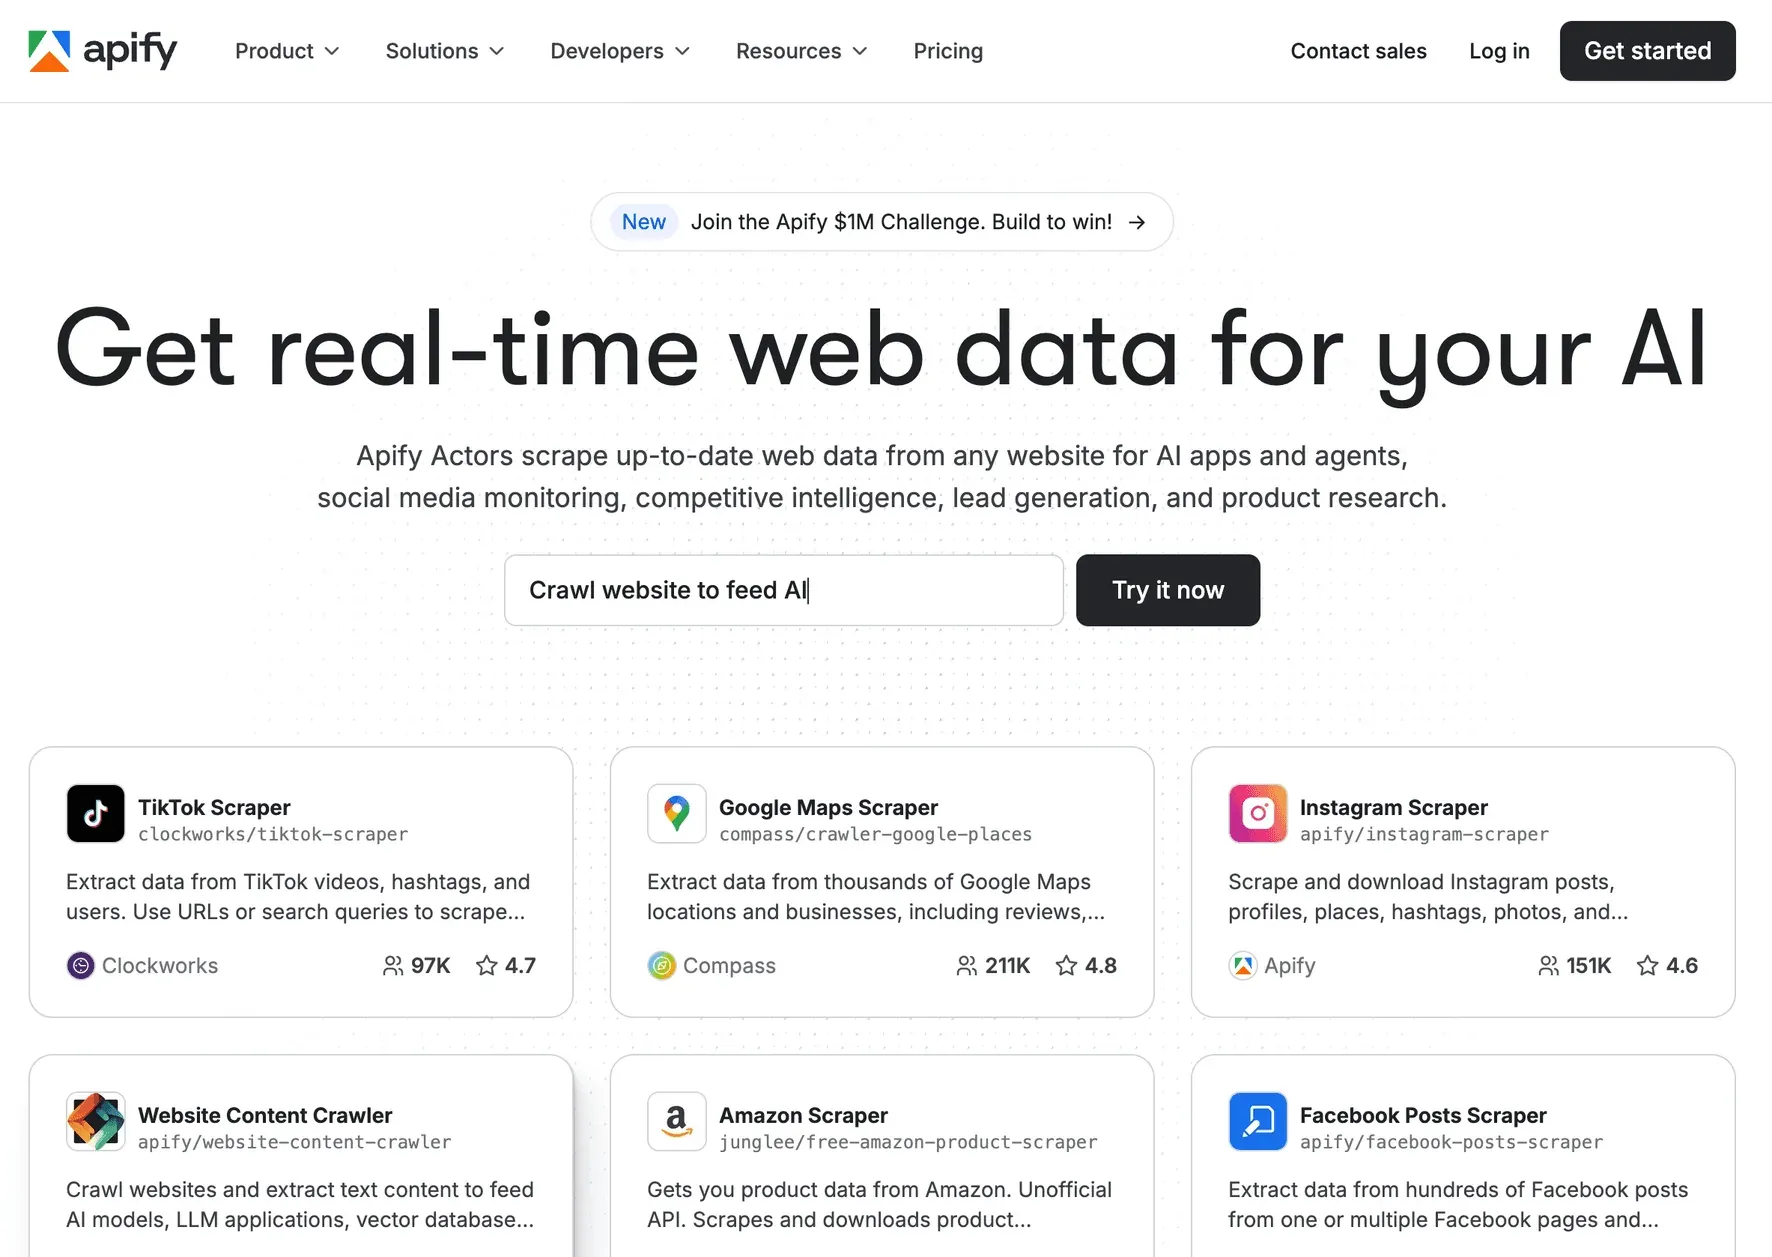 Apify คือแพลตฟอร์มอัตโนมัติบนคลาวด์สำหรับการดึงข้อมูลเว็บและการเชื่อม workflow ซึ่งใช้งานได้ทั้งนักพัฒนาและคนไม่เขียนโค้ด
ฟีเจอร์สำคัญ:
- Actors Marketplace: มีบอทสำเร็จรูปกว่า 200 ตัวสำหรับงานดึงข้อมูลทั่วไป
- Custom Actors: เขียนบอทของคุณเองด้วย JavaScript/Python หรือใช้เครื่องมือแบบภาพ
- AI Integrations: ส่งข้อมูลที่ดึงได้เข้า LLM หรือให้ AI agents เป็นตัวเรียก scraper
- Cloud Scheduling & Storage: รันงานในสเกลใหญ่ เก็บผลลัพธ์ และเชื่อมต่อกับ API หรือเครื่องมือ workflow
- รองรับ Proxy และ Headless Browser: จัดการเว็บไดนามิกและมาตรการ anti-bot ได้ดี
ราคา: แพ็กเกจฟรี (เครดิต $5 ต่อเดือน); แผนชำระเงินเริ่มที่ $49/เดือน
เหมาะสำหรับ: นักพัฒนา สตาร์ทอัป และทีมที่ต้องการการดึงข้อมูลแบบอัตโนมัติที่ขยายสเกลได้และเชื่อมต่อ workflow ได้
9. Diffbot
 Diffbot คือเจ้าแห่งการดึงข้อมูลเว็บด้วย AI และ knowledge graph
อะไรที่ทำให้ Diffbot แตกต่าง?
- ดึงข้อมูลด้วย AI แบบเต็มรูปแบบ: ส่ง URL ใดก็ได้เข้า API ของ Diffbot แล้วรับ JSON ที่มีโครงสร้างออกมาเลย—ไม่ต้องตั้งค่า
- Knowledge Graph: เข้าถึงกราฟขนาดมหึมาที่อัปเดตตลอดเวลามากกว่า 10B entities (บริษัท คน สินค้า บทความ)
- Computer Vision + NLP: ดึงข้อมูลจากข้อความ รูปภาพ และยังอนุมานความสัมพันธ์ได้
- Fact-Grounded LLM: ถามคำถามแล้วได้คำตอบพร้อมอ้างอิงจากเว็บ
ราคา: ทดลองสำหรับนักพัฒนาได้ฟรี (10,000 calls/เดือน); แผน Startup $299/เดือน สำหรับ 250k credits
เหมาะสำหรับ: องค์กร บริษัท AI และนักวิจัยที่ต้องการข้อมูลแบบมีโครงสร้างจากทุกหน้าแบบทันที—หรือฐานความรู้จากเว็บที่พร้อมให้ query ได้เลย
10. Data Miner
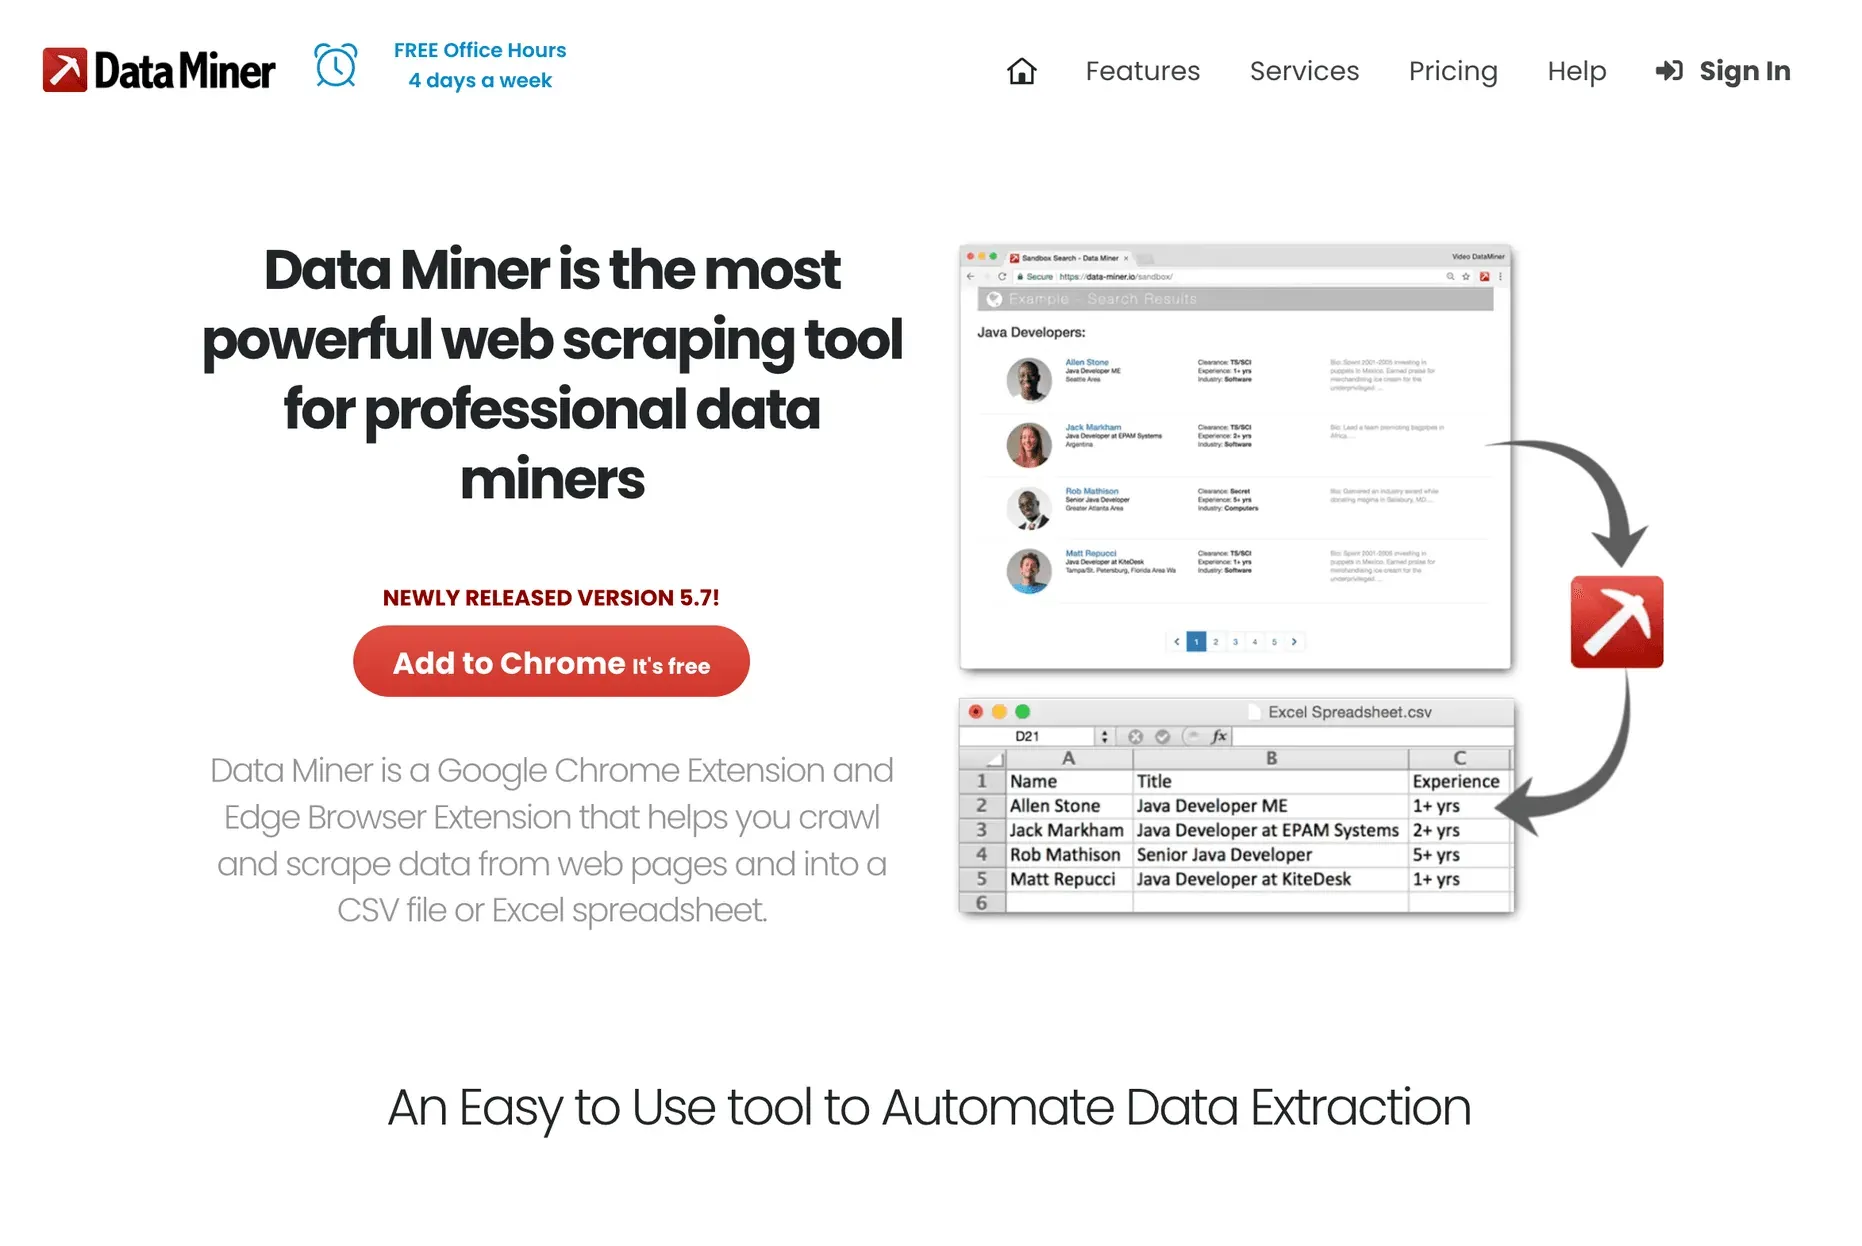 Data Miner คือส่วนขยาย Chrome/Edge ที่ทำให้การดึงข้อมูลแบบรวดเร็วด้วยเทมเพลตเข้าถึงได้สำหรับทุกคน
ทำไมต้อง Data Miner?
- มี Public Recipes กว่า 50,000 แบบ: ดึงข้อมูลได้ในคลิกเดียวจากกว่า 15,000 เว็บไซต์ (LinkedIn, Yellow Pages, Amazon ฯลฯ)
- ปรับแต่งแบบ Point-and-Click: สร้าง scraping recipe ของคุณเองได้แบบภาพ
- Pagination และ Automation: ดึงข้อมูลหลายหน้าหรือจากรายการ URL หลายรายการในเบราว์เซอร์ได้
- ส่งออกตรง: ดาวน์โหลดเป็น CSV/Excel หรืออัปโหลดไป Google Sheets
ราคา: ฟรีได้สูงสุด 500 หน้า/เดือน; แผนชำระเงินเริ่มราว ~$19/เดือน
เหมาะสำหรับ: ผู้ใช้ที่ไม่ถนัดเทคนิคและต้องการดึงข้อมูลผ่านเบราว์เซอร์แบบรวดเร็วสำหรับงานขนาดเล็กถึงกลาง
เปรียบเทียบเครื่องมือยอดนิยมที่ใช้ AI ในการดึงข้อมูลเว็บไซต์
นี่คือภาพรวมเปรียบเทียบเครื่องมือทั้ง 10 ตัวแบบสั้น ๆ:
| เครื่องมือ | เหมาะสำหรับ | ฟีเจอร์ AI | ใช้งานง่าย | ขยายสเกลได้ | ราคา | ซัพพอร์ต/ชุมชน |
|---|---|---|---|---|---|---|
| Thunderbit | คนไม่เขียนโค้ด, ผู้ใช้สายธุรกิจ | ตรวจจับฟิลด์ด้วย LLM, UI ภาษาธรรมชาติ | ง่ายมาก | ปานกลาง (คลาวด์) | ฟรี, เริ่ม $15/เดือน | อีเมลตอบไว, ทีม dev active |
| import.io | องค์กร, ทีมข้อมูล | self-healing, prompt AI | ปานกลาง | สูงมาก | เริ่ม $299/เดือน | ซัพพอร์ตองค์กรโดยเฉพาะ |
| Bright Data | องค์กรขนาดใหญ่, โปรเจกต์ AI | Unblocker, proxy กว่า 100M+ | ปานกลาง | สูงมากเป็นพิเศษ | คิดตามการใช้งาน | องค์กร, เอกสารครบ |
| ParseHub | นักวิเคราะห์, SMB, เว็บไดนามิก | ตรวจจับแพตเทิร์นด้วย ML | ง่าย/ปานกลาง | ปานกลาง-สูง | ฟรี, เริ่ม $189/เดือน | เอกสาร, ฟอรัม |
| Scrapy | นักพัฒนา, workflow แบบกำหนดเอง | ปลั๊กอิน LLM/NLP | ยาก (ต้องเขียนโค้ด) | สูงมาก | ฟรี (OSS) | ชุมชน, เอกสาร |
| Octoparse | SMB, คนไม่เขียนโค้ด, ทีมงาน | AI auto-detect, เทมเพลต | ง่ายมาก | สูง (คลาวด์) | ฟรี, เริ่ม $75/เดือน | แชทสด, วิดีโอสอน |
| WebHarvy | ผู้ใช้ Windows, SMB, นักวิจัย | ตรวจจับแพตเทิร์น | ง่ายมาก | ปานกลาง | จ่ายครั้งเดียว $129 | อีเมล, รีวิว |
| Apify | นักพัฒนา, สตาร์ทอัป, งานอัตโนมัติ | AI integrations, actors | ปานกลาง | สูงมาก | ฟรี, เริ่ม $49/เดือน | เอกสาร, Slack, ซัพพอร์ต |
| Diffbot | AI/data science, องค์กร | AI extraction เต็มรูปแบบ, KG | ง่าย (API) | สูงมากเป็นพิเศษ | ฟรี, เริ่ม $299/เดือน | ซัพพอร์ตเฉพาะ, สายวิชาการ |
| Data Miner | คนไม่ถนัดเทคนิค, งานเบราว์เซอร์เร็ว ๆ | recipes กว่า 50k, pattern AI | ง่ายมาก | ต่ำ-ปานกลาง | ฟรี, เริ่ม $19/เดือน | office hours, recipes |
วิธีเลือกเครื่องมือ AI Web Scraping ที่เหมาะกับคุณ
นี่คือสูตรลัดของผมสำหรับการเลือกเครื่องมือที่ใช่:
- คนไม่เขียนโค้ด, งานเร็ว ๆ: Thunderbit, Octoparse, Data Miner หรือ WebHarvy
- งานขนาดใหญ่ระดับองค์กร: import.io, Bright Data, Diffbot
- เวิร์กโฟลว์เฉพาะสำหรับนักพัฒนา: Scrapy, Apify
- เว็บที่ไดนามิกหรือซับซ้อน: ParseHub, Octoparse, Apify (ร่วมกับ browser automation)
- ต้องการข้อมูลแบบมีโครงสร้างทันทีจากทุกหน้า: Diffbot
- อยากซื้อครั้งเดียว ไม่อยากจ่ายรายเดือน: WebHarvy
ทิปสำคัญ: บางครั้งการใช้หลายเครื่องมือร่วมกันให้ผลดีที่สุด เช่น ใช้ Thunderbit เพื่อจัดโครงสร้างข้อมูลที่ยุ่ง ๆ ให้เรียบร้อยก่อน แล้วค่อยนำไปประมวลผลต่อด้วยการตรวจจับแพตเทิร์นของ WebHarvy เพื่อให้ workflow ลื่นไหล
ปัจจัยหลักในการตัดสินใจ:
- งบประมาณ: แพ็กเกจฟรีเหมาะสำหรับทดลอง ส่วนเครื่องมือระดับองค์กรจะแพงกว่าแต่แลกมากับสเกลและซัพพอร์ต
- ทักษะเทคนิค: เครื่องมือ no-code เหมาะกับผู้ใช้สายธุรกิจ ส่วน framework เหมาะกับนักพัฒนา
- ปริมาณข้อมูล: เครื่องมือบนเบราว์เซอร์เหมาะกับงานเล็ก แพลตฟอร์มคลาวด์เหมาะกับงานใหญ่
- ความต้องการด้านซัพพอร์ต: เครื่องมือองค์กรมี SLA ส่วนที่เหลือมักพึ่งพาชุมชนหรืออีเมล
สรุป: อนาคตของการใช้ AI ในการดึงข้อมูลเว็บไซต์
ดูว่า Thunderbit เปรียบเทียบอย่างไร ดูว่า AI web scraper แบบเอเจนต์ของ Thunderbit เทียบกับแนวทางอื่น ๆ ที่กล่าวถึงในคู่มือนี้อย่างไร Get Started Free
AI กำลังเปลี่ยนการดึงข้อมูลเว็บจากงานเฉพาะทางของนักพัฒนา ให้กลายเป็นความสามารถหลักของธุรกิจ ไม่ว่าคุณจะสร้างรายชื่อ lead ติดตามราคา หรือป้อนข้อมูลเข้าโมเดล AI ตอนนี้ก็มีเครื่องมือที่ตอบโจทย์ทั้งความต้องการและทักษะของคุณแล้ว เครื่องมือทั้งสิบที่กล่าวมาข้างต้นแสดงให้เห็นว่า ecosystem นี้หลากหลายและทรงพลังแค่ไหน
เมื่อ AI พัฒนาต่อไป คาดได้เลยว่าการดึงข้อมูลเว็บจะฉลาดขึ้นอีก: อินเทอร์เฟซภาษาธรรมชาติที่มากขึ้น การปรับตัวต่อการเปลี่ยนแปลงของเว็บไซต์ได้ดีขึ้น และการเชื่อมกับ workflow ธุรกิจที่ลึกขึ้น คำแนะนำของผมคือ ลองใช้หลาย ๆ เครื่องมือ ดูว่าแบบไหนเข้ากับ workflow ของคุณ และอย่ากลัวที่จะผสมผสานเครื่องมือเพื่อให้ได้ผลลัพธ์ที่ดีที่สุด
ถ้าอยากเห็นว่าการดึงข้อมูลแบบ AI สมัยใหม่หน้าตาเป็นอย่างไร ลองใช้ Thunderbit ดู หรือเข้าไปอ่านคู่มืออื่น ๆ บน Thunderbit Blog อนาคตของข้อมูลเว็บมาถึงแล้ว—และสนุกกว่า (พร้อมทั้งมีประสิทธิภาพกว่า) การนั่งคัดลอกวางเป็นชั่วโมง ๆ มาก
ดูว่า Agentic Web Scraping ทำงานอย่างไร AI ของ Thunderbit อ่านหน้าเว็บเหมือนคนจริงและเลือกฟิลด์เอง คลิกเดียวแทนการตั้งค่า scraper ด้วยมือ Get Started Free
คำถามที่พบบ่อย
1. ทำไมควรใช้ AI เพื่อดึงข้อมูลจากเว็บไซต์แทนเครื่องมือแบบเดิม?
ตัวดึงข้อมูลที่ใช้ AI ปรับตัวกับเลย์เอาต์ที่เปลี่ยนไปได้ รู้จักแพตเทิร์นอัตโนมัติ และให้คนไม่ถนัดเทคนิคดึงข้อมูลได้เพียงบอกสิ่งที่ต้องการ ทำให้การดึงข้อมูลเร็วขึ้น เชื่อถือได้มากขึ้น และต้องดูแลน้อยลง
2. เครื่องมือ AI web scraping ตัวไหนเหมาะกับคนไม่เขียนโค้ดที่สุด?
Thunderbit, Octoparse, Data Miner และ WebHarvy ต่างก็เหมาะมากสำหรับผู้ใช้ที่ไม่ถนัดเทคนิค เพราะมีหน้าตาแบบภาพ รองรับภาษาธรรมชาติ และไม่ต้องมีทักษะเขียนโค้ด
3. เครื่องมือที่ดีที่สุดสำหรับการดึงข้อมูลเว็บขนาดใหญ่หรือระดับองค์กรคืออะไร?
import.io, Bright Data และ Diffbot ถูกสร้างมาเพื่อสเกล ความเสถียร และการปฏิบัติตามข้อกำหนด พวกมันรองรับหลายล้านหน้า มี API ที่แข็งแรง และซัพพอร์ตลูกค้าองค์กรโดยเฉพาะ
4. ฉันสามารถใช้หลายเครื่องมือร่วมกันเพื่อเพิ่มประสิทธิภาพ workflow การดึงข้อมูลเว็บได้ไหม?
ได้แน่นอน! หลายทีมใช้หลายเครื่องมือร่วมกัน เช่น ใช้ Thunderbit เพื่อจัดโครงสร้างข้อมูลอย่างรวดเร็ว แล้วค่อยใช้ WebHarvy ตรวจจับแพตเทิร์น หรือใช้ Apify สำหรับทำ workflow อัตโนมัติ การผสมเครื่องมือช่วยให้ใช้จุดแข็งของแต่ละตัวได้เต็มที่
5. มีวิธีลองใช้เครื่องมือ AI web scraping เหล่านี้แบบฟรีไหม?
มี! เครื่องมือส่วนใหญ่มีแพ็กเกจฟรีหรือทดลองใช้ฟรี Thunderbit, Octoparse, Data Miner และ Apify ต่างก็มีแผนฟรีให้ทดลองก่อนตัดสินใจจ่าย
พร้อมยกระดับการทำงานกับข้อมูลเว็บของคุณหรือยัง? ลองใช้เครื่องมือเหล่านี้ดู แล้วคุณจะประหยัดได้ทั้งเวลาและพลังงานใจไปได้มาก และถ้าอยากได้เคล็ดลับเพิ่มเติมเกี่ยวกับ web scraping ระบบอัตโนมัติ และ AI ลองเข้าไปที่ Thunderbit Blog หรือสมัครรับชม ช่อง YouTube ของเรา ขอให้สนุกกับการดึงข้อมูล!
ลองใช้ Thunderbit Agentic Web Scraper Get Started Free
อ่านเพิ่มเติม




