
การดึงข้อมูลจาก Facebook ยังน่าจับตาอยู่มากในปี 2026 แต่จะคุ้มจริงก็ต่อเมื่อคุณเลือกวิธีเก็บข้อมูลให้เหมาะสม Pew Research Center รายงานเมื่อวันที่ 20 พฤศจิกายน 2025 ว่า 71% ของผู้ใหญ่ในสหรัฐฯ ใช้ Facebook และ Meta ระบุเมื่อวันที่ 29 เมษายน 2026 ว่า ตระกูลแอปของบริษัทมีผู้ใช้งานรายวันถึง 3.56 พันล้านคน ในเดือนมีนาคม 2026 ขนาดฐานผู้ใช้ระดับนี้ทำให้ Facebook ยังมีประโยชน์มากสำหรับการตามดู Marketplace, การวิจัยเพจสาธารณะ, การหาลูกค้าเป้าหมาย และการติดตามคู่แข่ง ปัญหาไม่ได้อยู่ที่หา use case ไม่เจอ แต่คือจะดึงข้อมูลออกมาให้สะอาดได้อย่างไร โดยไม่ติดกำแพงล็อกอิน โหลดข้อมูลแบบไดนามิก การบล็อกชั่วคราว หรือระบบสครัปที่พังง่าย
รายการคัดเลือกประจำปีนี้ออกแบบมาเพื่อช่วยให้ตัดสินใจได้ไวขึ้น ผมตรวจสอบหน้าโปรดักต์ เอกสารประกอบ และสัญญาณด้านราคาอีกครั้งในเดือนสิงหาคม 2026 แล้วคัดเหลือเฉพาะเครื่องมือที่ยังเหมาะกับผู้ใช้งานธุรกิจจริง ๆ ถ้าคุณต้องการโครงสร้างระดับ API, Bright Data, Apify และ Nimble by Nimbleway ควรอยู่แถวบนของลิสต์ ถ้างานของคุณต้องมีระบบอัตโนมัติบนคลาวด์ หรือมีขั้นตอนต่อเนื่องหลังเก็บข้อมูล PhantomBuster ก็เป็นตัวเลือกที่ควรพิจารณาจริงจัง
ตัวเลือกด่วนตามลักษณะงาน
- ต้องการเส้นทางอย่างเป็นทางการสำหรับแอสเซ็ตที่คุณดูแลอยู่? เริ่มจากเครื่องมือจัดการและ API ที่ Meta อนุมัติ
- ต้องการ API เฉพาะทางสำหรับข้อมูลสาธารณะ? ลองเทียบ Bright Data หรือ Apify กับเป้าหมายจริงและการใช้งานที่ได้รับอนุญาต
- ต้องการชั้นโครงสร้างพื้นฐานข้อมูลเว็บแบบทั่วไป? ลองประเมิน Nimble หรือ ScrapingBot ผ่านการทดสอบใช้งานจริงแบบจำกัดขอบเขต
- ต้องการเวิร์กโฟลว์แบบเห็นภาพสำหรับแหล่งข้อมูลที่ไม่ใช่ Meta และใช้งานได้ตามสิทธิ์? Octoparse อาจเหมาะกับกระบวนการที่ทีมวิเคราะห์เป็นเจ้าของ
ทำไมการดึงข้อมูลจาก Facebook ยังยากในปี 2026
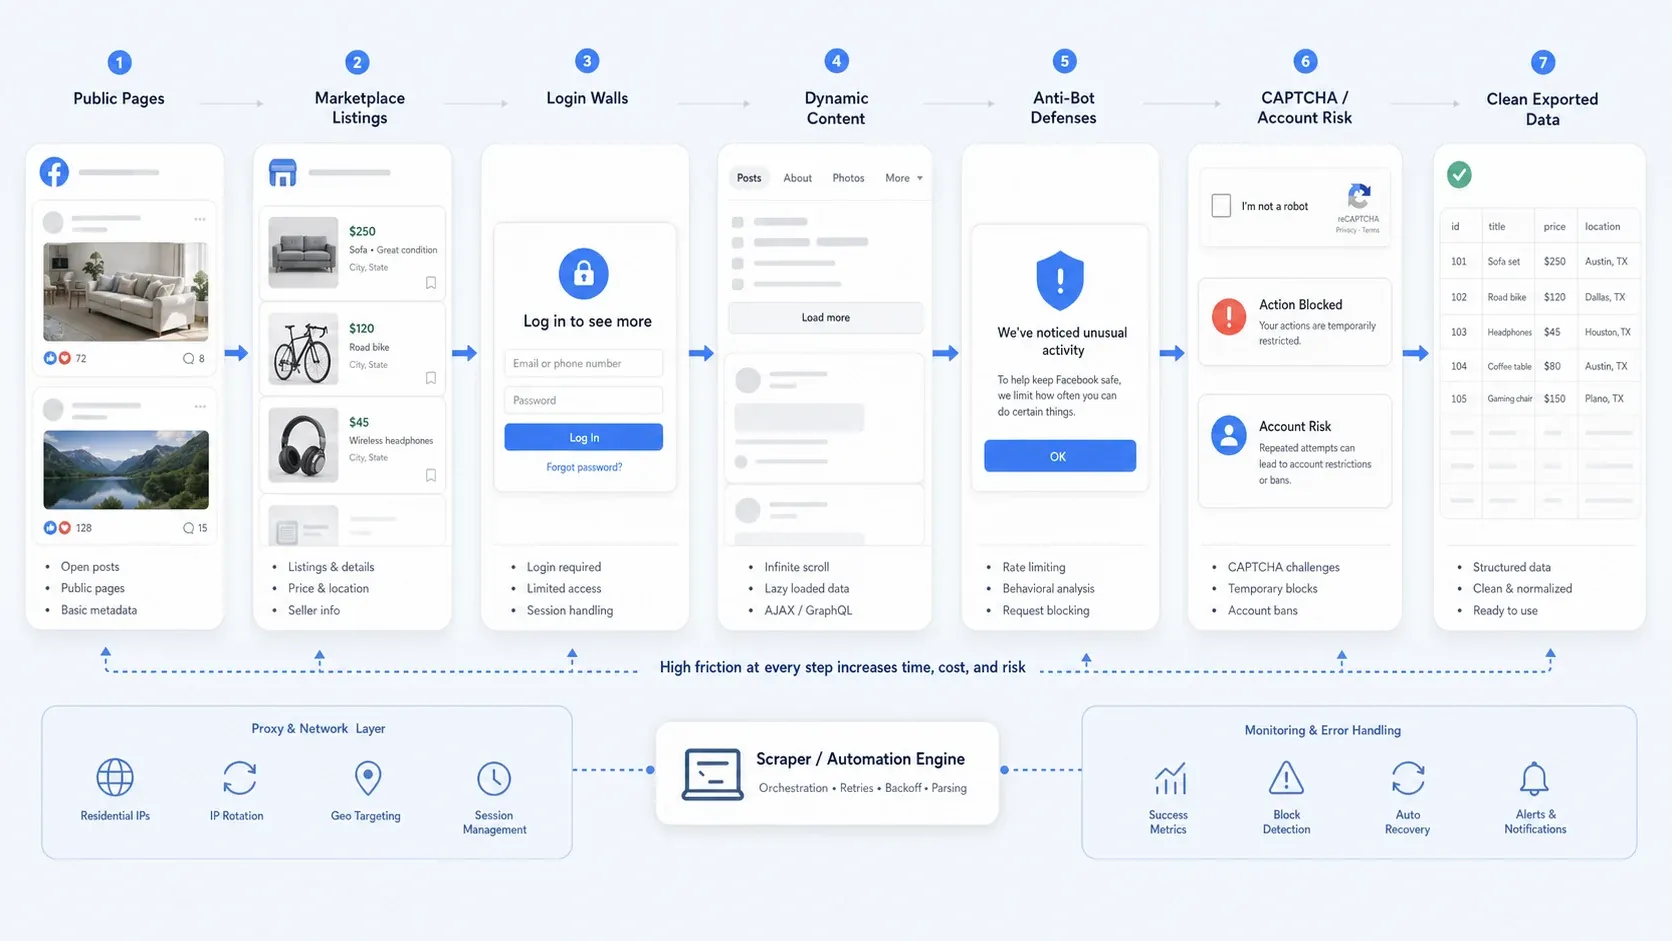
การเก็บข้อมูลจาก Facebook ตอนนี้แทบไม่ได้จบแค่การหา selector อีกต่อไป ในทางปฏิบัติ ทีมส่วนใหญ่จะเจออย่างน้อยหนึ่งปัญหาเหล่านี้:
- การเข้าถึงสาธารณะไม่ครบทุกส่วน: บางเพจยังเปิดให้ดูได้ แต่บางจังหวะจะพาไปหน้าล็อกอินเพื่อดูรายละเอียดเพิ่ม
- เนื้อหาแบบไดนามิก: หน้า Marketplace, เธรดคอมเมนต์ยาว ๆ และเนื้อหาในเพจมักโหลดเพิ่มทีละส่วน
- ระบบป้องกันบอต: การจำกัดอัตราการใช้งาน, การตรวจพฤติกรรม, CAPTCHA และการบล็อกการกระทำชั่วคราว ทำให้อัตโนมัติแบบง่าย ๆ ใช้ไม่ได้
- ความเสี่ยงด้านการปฏิบัติการ: การเก็บข้อมูลที่ต้องล็อกอินมีความเสี่ยงสูงกว่าการสครัปเพจสาธารณะมาก โดยเฉพาะถ้าคุณให้ความสำคัญกับความปลอดภัยของบัญชีและความสามารถในการทำซ้ำ
วิธีที่ผมใช้ประเมินเครื่องมือเหล่านี้
หน้านี้ถูกออกแบบมาเพื่อช่วยคัดลิสต์ ไม่ใช่เพิ่มฟีเจอร์ให้เกินจำเป็น เครื่องมือในบทความนี้ถูกเปรียบเทียบจากเกณฑ์ต่อไปนี้:
- ความเหมาะกับเวิร์กโฟลว์: เครื่องมือนั้นตอบโจทย์งานเก็บข้อมูลจาก Facebook และ Marketplace ที่ทีมจริงใช้งานอยู่หรือไม่
- ใช้งานง่าย: คนที่ไม่ใช่นักพัฒนา หรือทีมขนาดเล็ก สามารถได้ผลลัพธ์ที่ใช้ได้เร็วแค่ไหน
- สเกลและความเสถียร: เครื่องมือยังเหมาะอยู่หรือไม่เมื่อไม่ได้ใช้แค่สครัปครั้งเดียว
- การจัดการ anti-bot และเซสชัน: โครงสร้างพื้นฐานที่เครื่องมือลดภาระให้คุณได้มากน้อยแค่ไหน
- คุณภาพของผลลัพธ์: ส่งข้อมูลเป็น CSV, Sheets หรือระบบปลายทางได้เลยไหม โดยไม่ต้องล้างข้อมูลหนัก
- สัญญาณด้านราคา: ประเมินได้จริงสำหรับทีมทั่วไป หรือบังคับให้ต้องคุยกับฝ่ายขายระดับองค์กร
- ท่าทีด้าน compliance: เครื่องมือนั้นออกแบบมาเพื่อเก็บข้อมูลสาธารณะและใช้งานอย่างรับผิดชอบหรือไม่
คุณต้องการ Facebook Scraper แบบไหน?
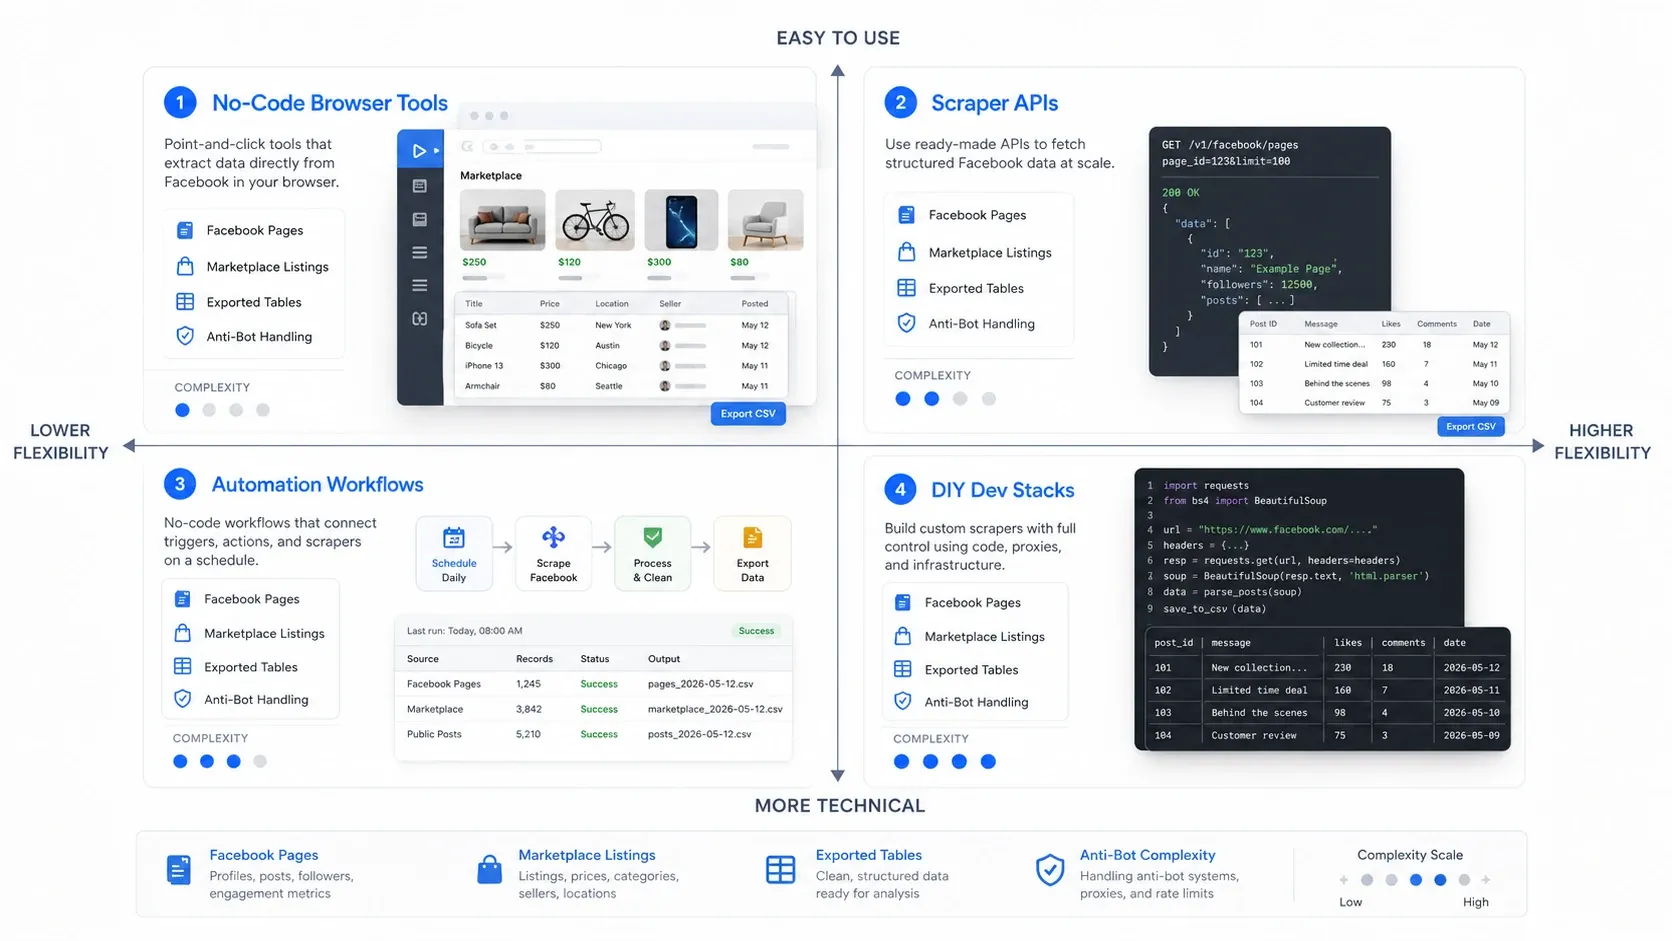
วิธีเลือกที่เร็วที่สุดคือเริ่มจากเลือกประเภทเครื่องมือให้ถูกก่อน โดยทั่วไปเครื่องมือสำหรับ Facebook scraping จะแบ่งได้ 4 โมเดลการทำงาน:
- เครื่องมือแบบไม่ต้องเขียนโค้ดบนเบราว์เซอร์: เหมาะเมื่อคุณต้องการดึงข้อมูลจากหน้าที่เปิดอยู่ตรงหน้าแบบรวดเร็ว
- Scraper API: เหมาะเมื่อคุณต้องการเก็บข้อมูลได้เสถียร ทำซ้ำได้ และในปริมาณสูงขึ้น
- เวิร์กโฟลว์อัตโนมัติ: เหมาะเมื่อการสครัปเป็นเพียงหนึ่งขั้นตอนในกระบวนการ go-to-market ที่ใหญ่กว่า
- สแต็กแบบ DIY สำหรับนักพัฒนา: เหมาะเมื่อทีมต้องการคุมทุกอย่างเอง และพร้อมรับภาระดูแลระบบ
ตารางเปรียบเทียบ
| Tool | Best fit | Operating model |
|---|---|---|
| Bright Data | เวิร์กโฟลว์ API สำหรับข้อมูลสาธารณะที่มีการจัดการ | API เฉพาะทางและเลเยอร์การส่งมอบข้อมูล |
| Apify | งาน Page หรือ Profile ที่ต้องทำซ้ำได้ | Cloud actor และ dataset output |
| Nimble | การประเมินโดยทีมวิศวกรรม | API สำหรับเว็บสาธารณะทั่วไป |
| ScrapingBot | การทดสอบที่ต้องเรนเดอร์หน้าเว็บได้ | API สำหรับสครัปทั่วไป |
| PhantomBuster | เวิร์กโฟลว์ GTM บนบัญชีที่คุณเป็นเจ้าของ | ระบบอัตโนมัติสำหรับ prospecting |
| Octoparse | งานแบบ visual ที่ทีมวิเคราะห์เป็นเจ้าของ | เวิร์กโฟลว์แบบไม่ต้องเขียนโค้ด |
1. Bright Data
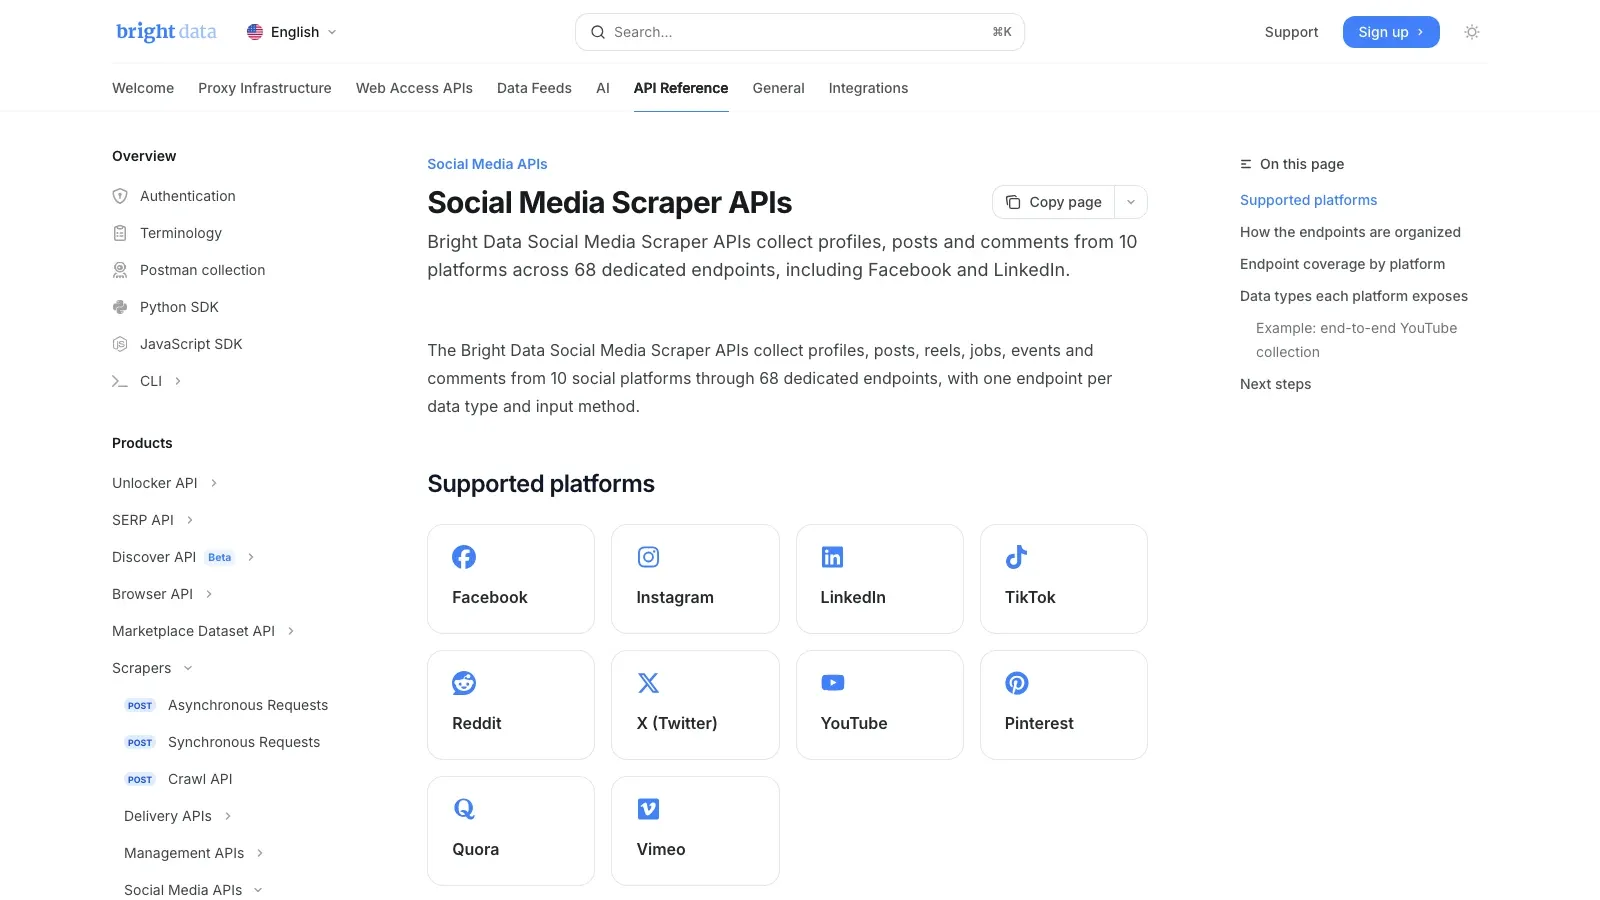
Bright Data เป็นตัวเลือกสายโครงสร้างพื้นฐานเป็นอันดับแรก เอกสารของ Bright Data เองระบุว่า Social Media Scraper APIs ครอบคลุม 10 แพลตฟอร์มและ 68 endpoint เฉพาะทาง รวมถึง Facebook ด้วย ถ้างานของคุณคือการเก็บข้อมูลสาธารณะขนาดใหญ่ ชุด API แบบ managed ลักษณะนี้มักจะสมจริงกว่าการพยายามขยาย browser extension หรือสคริปต์ที่ทำเอง
เหตุผลที่อยู่ในลิสต์:
- มี endpoint สำหรับ social media โดยเฉพาะ
- ช่วยจัดการการปลดบล็อกและการดึงข้อมูลให้
- ส่งออกข้อมูลแบบมีโครงสร้างสำหรับ data pipeline ได้
- เหมาะกับงานมอนิเตอร์และวิเคราะห์ที่ต้องการความเสถียรสูง
เหมาะสำหรับ: นักวิเคราะห์ ทีมข้อมูล โปรเจกต์มอนิเตอร์ขนาดใหญ่ และชุดข้อมูลโซเชียลสาธารณะในระดับสเกล
สัญญาณด้านราคา: ราคาขึ้นอยู่กับสินค้าและปริมาณการใช้งาน ตรวจสอบได้จาก ราคาปัจจุบันของ Bright Data
2. Apify
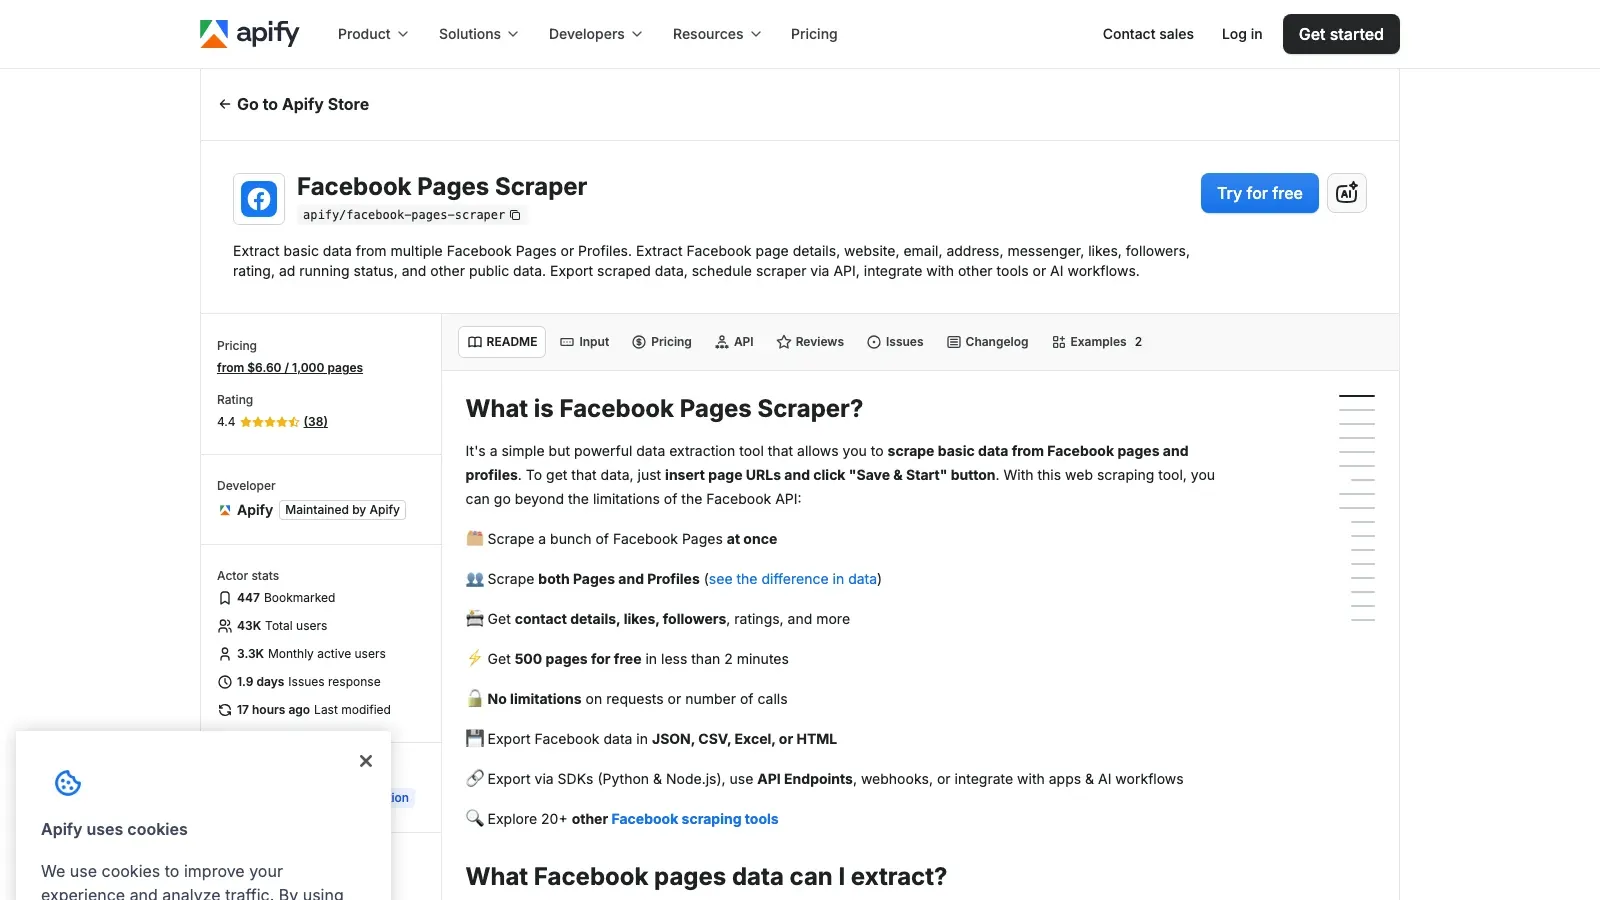
Apify ยังคงน่าสนใจเพราะอยู่ตรงกลางระหว่างเทมเพลตสำเร็จรูปกับการปรับแต่งเต็มรูปแบบ Facebook Pages Scraper actor ของ Apify เป็นจุดเริ่มต้นที่ดี ขณะที่แพลตฟอร์ม Apify โดยรวมยังมี cloud run, การตั้งเวลา, API และพื้นที่ให้ต่อยอดเวิร์กโฟลว์เมื่อความต้องการซับซ้อนขึ้น
เหตุผลที่ติดลิสต์:
- มี Facebook actor สำเร็จรูป
- รันบนคลาวด์และตั้งเวลาทำงานซ้ำได้
- ส่งออกข้อมูลและเข้าถึงผ่าน API ได้ยืดหยุ่น
- ต่อยอดง่ายกว่าเวิร์กโฟลว์แบบ no-code บนเบราว์เซอร์ล้วน ๆ
เหมาะสำหรับ: นักการตลาดสายเทคนิค เอเจนซี ทีม ops และงานเก็บข้อมูลซ้ำ ๆ จากหลายเว็บไซต์
สัญญาณด้านราคา: แผนแพลตฟอร์มมีค่าใช้จ่าย และการใช้งาน actor คิดแยกตามการใช้งาน ตรวจสอบ ราคา Apify
3. Nimble by Nimbleway
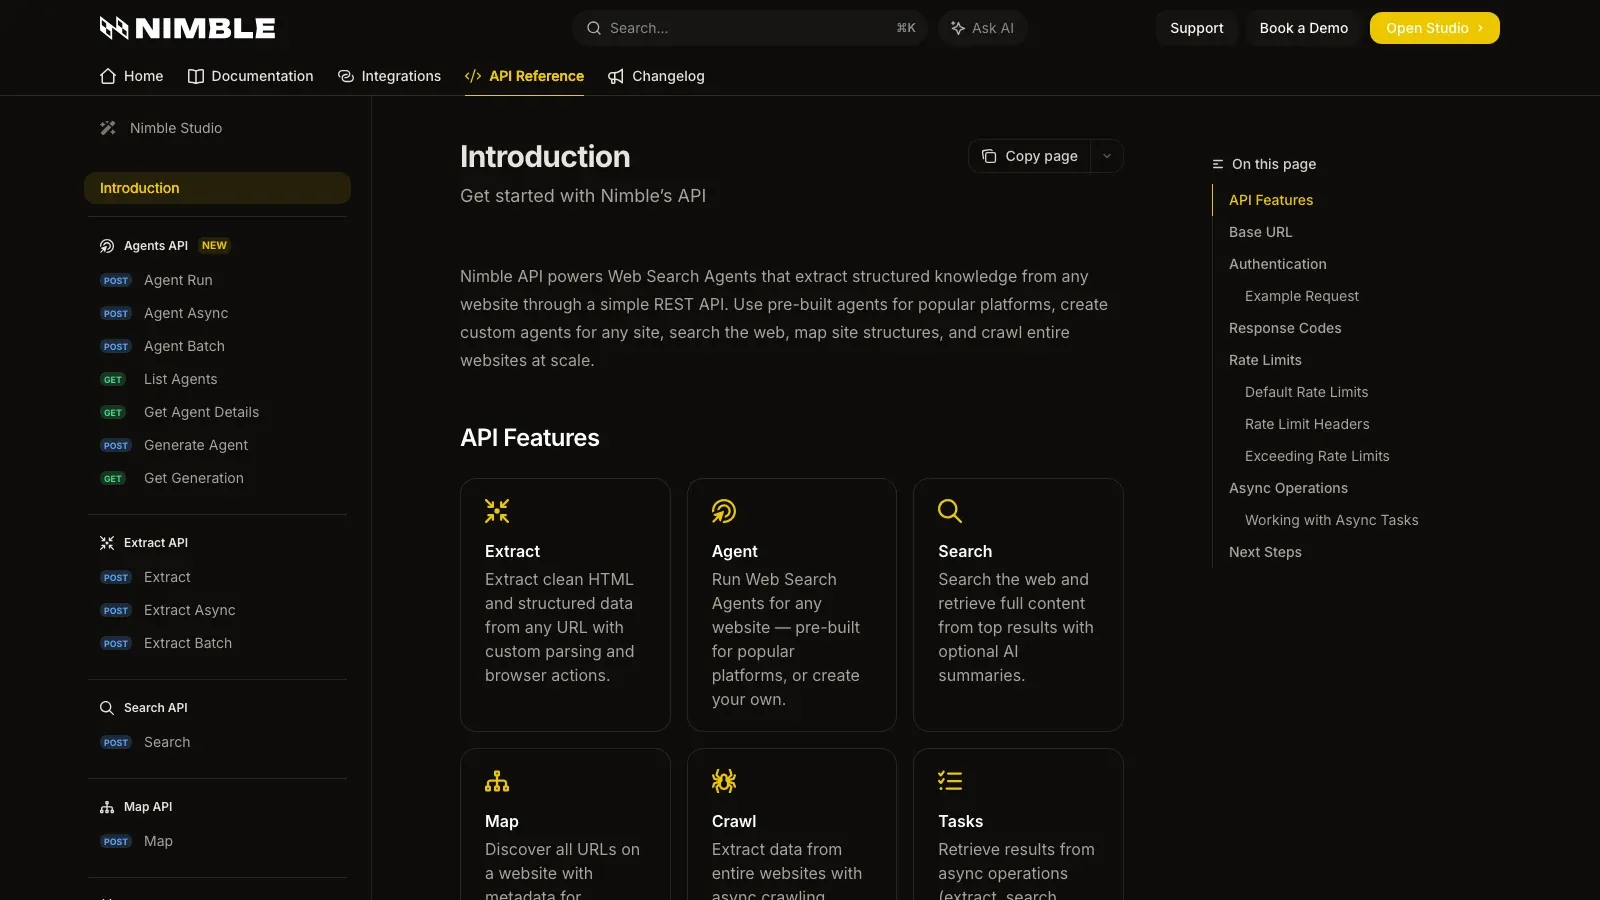
Nimble by Nimbleway เป็นตัวเลือกแบบ API-first สำหรับทีมที่ต้องการส่ง URL เข้าไป แล้วให้แพลตฟอร์มจัดการเรื่องการเข้าถึง การเรนเดอร์ และการส่งผลลัพธ์ให้ Nimble วางตำแหน่ง Web Scraper API ไว้เป็นเครื่องมือเก็บข้อมูลเว็บสาธารณะแบบครบวงจร ซึ่งทำให้เหมาะเมื่อ Facebook scraping เป็นเพียงส่วนหนึ่งของสแต็กข้อมูลที่ใหญ่กว่า
เหตุผลที่ควรประเมิน:
- เวิร์กโฟลว์แบบ URL-first
- ลดภาระการดูแลสคริปต์ของทีมวิศวกรรม
- เหมาะกับการดึงข้อมูลเว็บสาธารณะอย่างทนทาน
- ใช้ได้ดีเมื่อข้อมูลที่ดึงมาไปต่อกับผลิตภัณฑ์ภายในหรือแดชบอร์ด
เหมาะสำหรับ: ทีมที่นำโดยวิศวกร pipeline ข้อมูลของโปรดักต์ และองค์กรที่ต้องการเลเยอร์โครงสร้างพื้นฐานแทนการใช้เครื่องมือเฉพาะจุด
สัญญาณด้านราคา: หน้า API หลักของ Nimble ไม่ได้เน้นราคาที่เปิดให้ลองเองชัดเจน จึงคาดว่าเป็นการขายแบบคุยกับทีมขาย และควรตรวจสอบโดยตรงกับ Nimble by Nimbleway
4. ScrapingBot
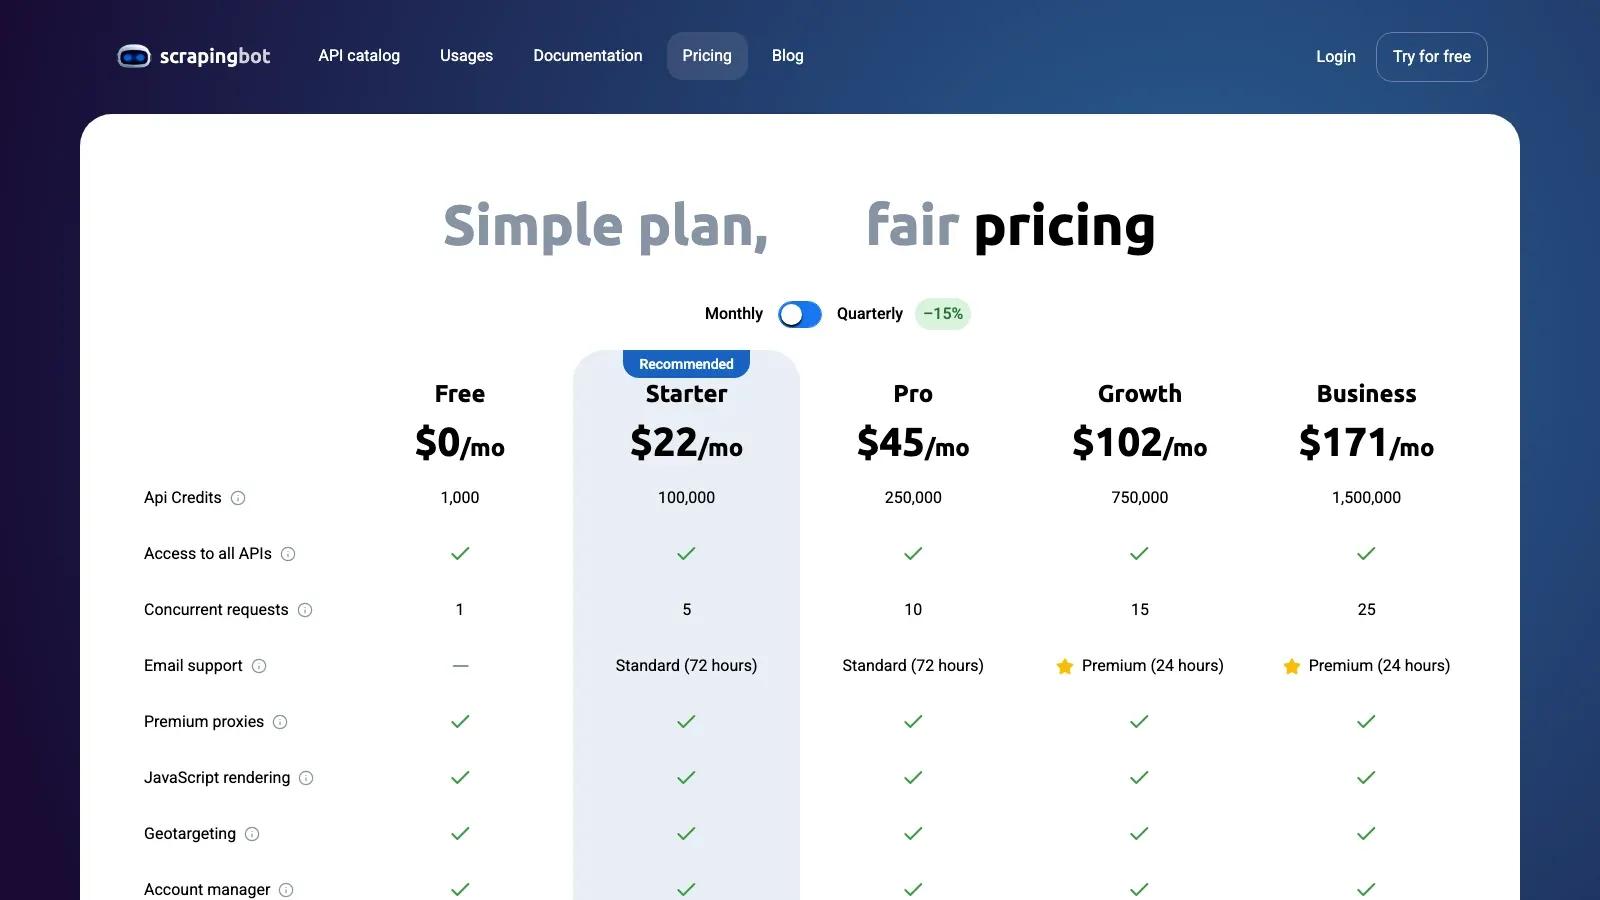
ScrapingBot เป็นตัวเลือก API ที่คุ้มงบที่สุดในลิสต์นี้ แม้จะไม่ใช่แพลตฟอร์มที่เชี่ยวชาญ Facebook มากที่สุด แต่ก็ยังเหมาะสำหรับงานข้อมูลสาธารณะขนาดเล็กที่คุณต้องการ API, รองรับการเรนเดอร์ และมีต้นทุนเริ่มต้นต่ำกว่าระบบสครัประดับองค์กร
เหมาะกับงานแบบนี้:
- สครัปข้อมูลสาธารณะผ่าน API แบบตรงไปตรงมา
- ราคาเริ่มต้นต่ำกว่า
- มีระบบเรนเดอร์และ proxy ในตัว
- เหมาะกับต้นแบบและงานดึงข้อมูลซ้ำแบบเบา ๆ มากกว่าระบบ intelligence ขนาดใหญ่
เหมาะสำหรับ: สตาร์ทอัพ ธุรกิจขนาดเล็ก และนักพัฒนาที่กำลังทดสอบ use case การเก็บข้อมูลจากเพจสาธารณะแบบเบา ๆ
สัญญาณด้านราคา: มีแผนฟรี และหน้าราคาสาธารณะปัจจุบันเริ่มต้นราว $22/เดือน
5. PhantomBuster
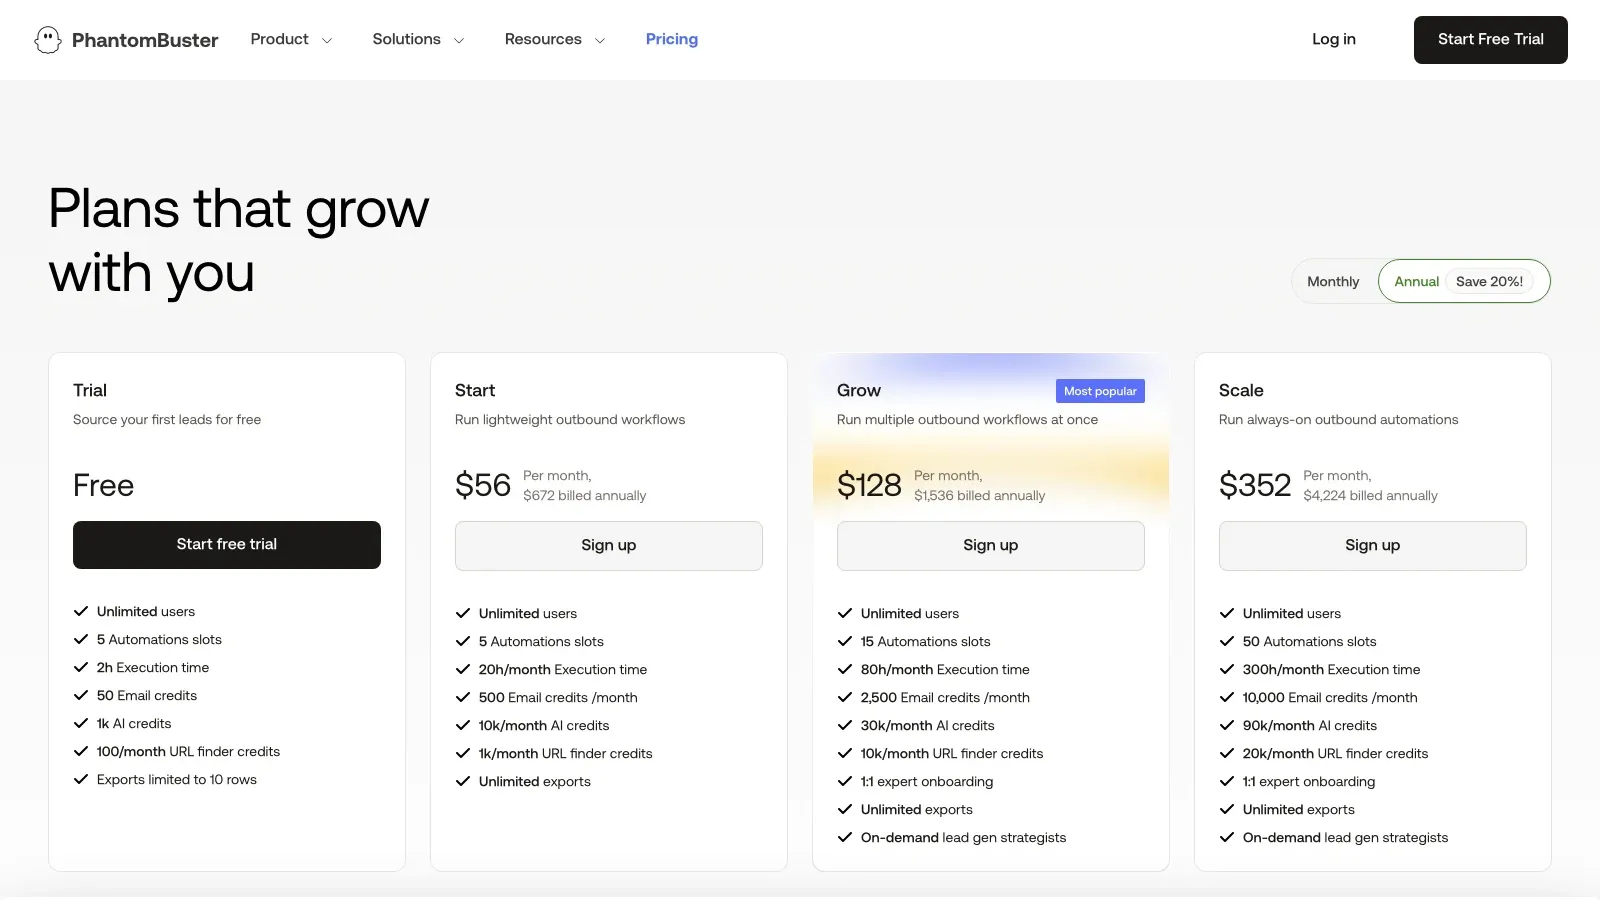
PhantomBuster ไม่ได้เน้นโครงสร้างพื้นฐานสำหรับสครัปดิบ ๆ เท่าไร แต่เน้นสิ่งที่เกิดขึ้นหลังเก็บข้อมูลมากกว่า ถ้า use case ของคุณคือ “เก็บข้อมูลก่อน แล้วค่อยยิง outreach, enrich ข้อมูล หรือทำ action ต่อ” PhantomBuster มักมีประโยชน์กว่า extractor ธรรมดา เพราะออกแบบมาเพื่อ cloud automation และ workflow ที่สั่งการบนเบราว์เซอร์
เหตุผลที่ทีมยังคัดเลือก:
- เวิร์กโฟลว์อัตโนมัติบนคลาวด์
- เหมาะกับ lead generation และงาน GTM
- ตอบโจทย์กว่าเมื่อ scraping เป็นเพียงขั้นตอนหนึ่งในกระบวนการใหญ่
- ใช้งานได้จริงสำหรับคนที่สนใจ action มากกว่าแค่ export ข้อมูล
เหมาะสำหรับ: ทีม GTM ทีม growth ผู้สรรหาบุคลากร และ operator ที่เชื่อมการเก็บข้อมูลไปสู่การทำงานต่อ
สัญญาณด้านราคา: มีทดลองใช้ฟรี และแผนเสียเงินบนหน้าราคาเริ่มต้นราว $56/เดือน
6. Octoparse
Octoparse ยังเป็นหนึ่งในเครื่องมือสครัปแบบ no-code ที่ใช้งานง่ายและมองเห็นกระบวนการได้ดีสำหรับผู้ใช้ที่ต้องการเวิร์กโฟลว์ทำซ้ำได้และรันบนคลาวด์แบบตั้งเวลา เครื่องมือนี้ให้ผู้ใช้ที่ไม่ใช่นักพัฒนาควบคุมตรรกะการดึงข้อมูลได้ชัดเจนขึ้น แต่ก็แลกกับขั้นตอนตั้งค่าที่มากกว่าเวิร์กโฟลว์สั้น ๆ แบบครั้งเดียว
เหตุผลที่ยังสำคัญ:
- ตัวสร้างเวิร์กโฟลว์แบบ point-and-click
- ดึงข้อมูลบนคลาวด์และตั้งเวลาได้
- เหมาะกับงานโครงสร้างชัดเจนที่ต้องทำซ้ำ
- เหมาะกับนักวิเคราะห์ที่ต้องการความทำซ้ำได้โดยไม่ต้องเขียนโค้ด
เหมาะสำหรับ: นักวิเคราะห์ที่ไม่ใช่สายเทคนิค ทีม ops ของ SMB และงานเก็บข้อมูลที่ต้องมีตรรกะเวิร์กโฟลว์ชัดเจน
สัญญาณด้านราคา: หน้าราคาสาธารณะของ Octoparse ระบุแผนเสียเงินเริ่มต้นราว $69/เดือนสำหรับแผน Standard แบบชำระรายปี
ลิสต์สั้นตามประเภททีม
- เวิร์กโฟลว์นำด้วย API: Bright Data หรือ Apify
- การประเมินข้อมูลเว็บสาธารณะโดยทีมวิศวกรรมเป็นเจ้าของ: Nimble หรือ ScrapingBot
- เวิร์กโฟลว์ prospecting ที่ใช้บัญชีของเจ้าของงาน: PhantomBuster
- เวิร์กโฟลว์แบบ visual ที่แก้ไขได้: Octoparse
ก่อนเลือกเครื่องมือใด ๆ ควรทดสอบประเภทหน้าที่ต้องใช้และฟิลด์ข้อมูลที่ทีมของคุณได้รับอนุญาตให้ใช้งาน ความสามารถในการมองเห็นข้อมูลบน Facebook แตกต่างกันไปตาม Pages, Profiles, Marketplace, Groups, ตำแหน่ง และสถานะบัญชี
บทสรุปสุดท้าย
เส้นทางที่เหมาะสมขึ้นอยู่กับข้อมูล โมเดลการเข้าถึง และความรับผิดชอบของทีมในการตรวจสอบความถูกต้อง หากเป็นแอสเซ็ตที่คุณดูแลเอง ให้เริ่มจากเครื่องมือทางการของ Meta และ API ที่ได้รับอนุมัติ สำหรับงานวิจัยที่อยู่นอกขอบเขตนั้น ควรเลือกผู้ให้บริการหรือแหล่งข้อมูลต่อเมื่อยืนยันประเภทหน้า การใช้งานที่อนุญาต ภาระหน้าที่ด้านความเป็นส่วนตัว และพฤติกรรมของโปรดักต์ในปัจจุบันแล้วเท่านั้น
คำถามที่พบบ่อย
ผู้ใช้ที่ไม่ใช่สายเทคนิคควรเริ่มจากเส้นทางไหนก่อน?
ถ้าเป็นแอสเซ็ตที่องค์กรของคุณดูแลอยู่ ให้เริ่มจากเครื่องมือจัดการและวิเคราะห์ของ Meta เอง ถ้าเป็นความต้องการด้านการวิจัยที่กว้างกว่า ให้หาแหล่งข้อมูลที่ได้รับอนุญาตซึ่งคุณประเมิน workflow และสิทธิ์ข้อมูลได้
ตัวเลือกไหนเหมาะที่สุดสำหรับการเชื่อมต่อกับซอฟต์แวร์หรือ data pipeline?
ลองประเมิน API เฉพาะ Facebook อย่าง Bright Data, แพลตฟอร์มแบบ actor อย่าง Apify หรือ API สำหรับเว็บสาธารณะทั่วไป โดยทดสอบแบบจำกัดขอบเขตกับเป้าหมายจริง
เครื่องมือเหล่านี้สามารถเลี่ยงข้อจำกัดการเข้าถึงของ Facebook ได้ไหม?
ไม่ได้ และไม่ควรใช้เครื่องมือเพื่อหลบเลี่ยงการควบคุมของแพลตฟอร์ม หน้าล็อกอิน หรือการป้องกันความเป็นส่วนตัว




