
สแครปรีวิว Amazon ของผมใช้งานได้แบบไม่มีปัญหาอยู่หกสัปดาห์ — แล้วอยู่ดี ๆ เช้าวันหนึ่งมันก็ส่งกลับมาเป็น 200 OK พร้อมหน้า HTML ว่างเปล่า ไม่มี error ไม่มี CAPTCHA มีแต่ HTML เปล่า ๆ ตรงที่เคยเป็นรีวิวหลายร้อยรายการ
ถ้าคุณเคยเจออะไรแบบนี้ คุณไม่ได้เจออยู่คนเดียว ช่วงปลายปี 2025 Amazon เริ่มบังคับให้ต้องล็อกอินก่อนถึงจะดูหน้ารีวิวฉบับเต็มได้ ทำให้สคริปต์ Python จำนวนมากพังพร้อมกันข้ามคืน ช่วงหลายเดือนที่ผ่านมา ผมทำงานกับปัญหานี้จากสองมุมที่ Thunderbit — ทั้งการสร้าง AI scraper ของเราเอง และการดูแล pipeline รีวิวด้วย Python ของตัวเอง — เลยคิดว่าถึงเวลาต้องเขียนคู่มือที่ผมอยากมีตอนสคริปต์ของผมดับไปแล้ว บทความนี้จะพาไปดูวิธีที่ใช้งานได้จริง: การยืนยันตัวตนด้วยคุกกี้, การใช้ selector ที่ทนต่อ CSS obfuscation ของ Amazon, วิธีหลบข้อจำกัด pagination 10 หน้า, การรับมือ anti-bot, และโบนัสส่วนวิเคราะห์ sentiment ที่เปลี่ยนข้อความรีวิวดิบ ๆ ให้กลายเป็นอินไซต์ทางธุรกิจจริง ๆ และถ้าคุณอ่านไปครึ่งทางแล้วคิดว่า "ไม่อยากดูแลโค้ดทั้งหมดนี้แล้ว" ผมจะให้ดูว่า Thunderbit จัดการงานเดียวกันได้ในเวลาราวสองนาทีโดยไม่ต้องเขียน Python เลย
การสแครปรีวิว Amazon คืออะไร และทำไมถึงสำคัญ?
การสแครปรีวิว Amazon คือการดึงข้อมูลรีวิวของลูกค้าแบบอัตโนมัติ เช่น คะแนนดาว เนื้อหารีวิว ชื่อผู้เขียน วันที่ รีวิวที่ระบุว่า verified purchase ฯลฯ จากหน้าสินค้าของ Amazon เนื่องจาก Amazon ลบข้อมูลรีวิวออกจาก Product Advertising API ไปตั้งแต่ปี 2010 และไม่เคยนำกลับมาอีก Web scraping จึงเป็นช่องทางแบบโปรแกรมมิงเพียงทางเดียวที่จะเข้าถึงข้อมูลนี้ได้
ตัวเลขก็ยืนยันเรื่องนี้เช่นกัน 95% ของผู้ซื้ออ่านรีวิวก่อนตัดสินใจซื้อ และ 94% ระบุว่า Amazon เป็นแหล่งรีวิวสินค้าหลักอันดับ 1 การแสดงรีวิวแค่ 5 รายการบนหน้าสินค้าอาจช่วยเพิ่ม conversion ได้ถึง 270% บริษัทที่วิเคราะห์ sentiment ของรีวิวอย่างเป็นระบบมีโอกาส รักษาลูกค้าได้สูงขึ้นถึง 15% นี่ไม่ใช่แค่ข้อมูลเชิงวิชาการ แต่คือ competitive intelligence, สัญญาณพัฒนาสินค้า และภาษาที่ใช้ทำการตลาด ซึ่งทั้งหมดอยู่ในรูปข้อความธรรมดาบนเซิร์ฟเวอร์ของ Amazon
ทำไมต้องสแครปรีวิว Amazon ด้วย Python
Python ยังเป็นภาษาหลักสำหรับงานนี้ เพราะเป็น ภาษาที่นักพัฒนาต้องการมากที่สุดอันดับ 1 ใน Stack Overflow Developer Survey 2024 และ ecosystem อย่าง requests, BeautifulSoup, pandas, Scrapy ก็ทำให้ web scraping เข้าถึงได้ แม้สำหรับคนที่ไม่ได้เป็นนักพัฒนาเต็มเวลา
แต่ละทีมก็นำข้อมูลนี้ไปใช้ต่างกัน:
| ทีม | Use Case | สิ่งที่ดึงออกมา |
|---|---|---|
| Product / R&D | หา complaint ที่เกิดซ้ำและจัดลำดับความสำคัญของการแก้ไข | ข้อความรีวิว 1–2 ดาว, ความถี่ของคีย์เวิร์ด |
| Sales | เฝ้าดู sentiment ของสินค้าคู่แข่ง | คะแนน, แนวโน้มปริมาณรีวิว |
| Marketing | นำภาษาลูกค้าไปใช้เป็น copy โฆษณา | วลีเชิงบวกจากรีวิว, การกล่าวถึงฟีเจอร์ |
| Ecommerce Ops | ติดตาม sentiment ของสินค้าตัวเองตามเวลา | การกระจายของคะแนนดาว, สัดส่วน verified purchase |
| Market Research | เปรียบเทียบผู้นำในหมวดหมู่เดียวกันตามฟีเจอร์ | ชุดข้อมูลรีวิวหลาย ASIN |
แบรนด์เครื่องครัวแบรนด์หนึ่ง วิเคราะห์รีวิวเชิงลบและพบว่า 22% พูดถึง "สารเคลือบไม่ติดลอกออก" จึงปรับสูตรสินค้าใหม่ และกลับมาครองอันดับ #1 Best Seller ได้ภายใน 60 วัน บริษัทอุปกรณ์ฟิตเนสแบรนด์หนึ่ง เจอคำว่า "สายรัดระคายเคือง" จากข้อความรีวิว ตรวจพบปัญหาแพ้ลาเท็กซ์ เปิดตัวรุ่นที่เป็น hypoallergenic และลดอัตราการคืนสินค้าได้ 40% นี่คือ ROI แบบที่ทำให้งานด้านวิศวกรรมคุ้มค่าจริง ๆ
Login Wall: ทำไม Amazon Review Scraper ของคุณถึงหยุดทำงาน
เมื่อวันที่ 14 พฤศจิกายน 2024 Amazon เริ่มบังคับให้ลงชื่อเข้าใช้ก่อนดูหน้ารวมรีวิวสินค้า การเปลี่ยนแปลงนี้ถูกยืนยันทั้งใน ฟอรั่มชุมชน และ บล็อกของผู้ให้บริการ scraping ถ้าคุณเปิด /product-reviews/{ASIN}/ ในโหมดไม่ระบุตัวตน ระบบจะพาคุณไปยังหน้าล็อกอินแทนข้อมูลรีวิว
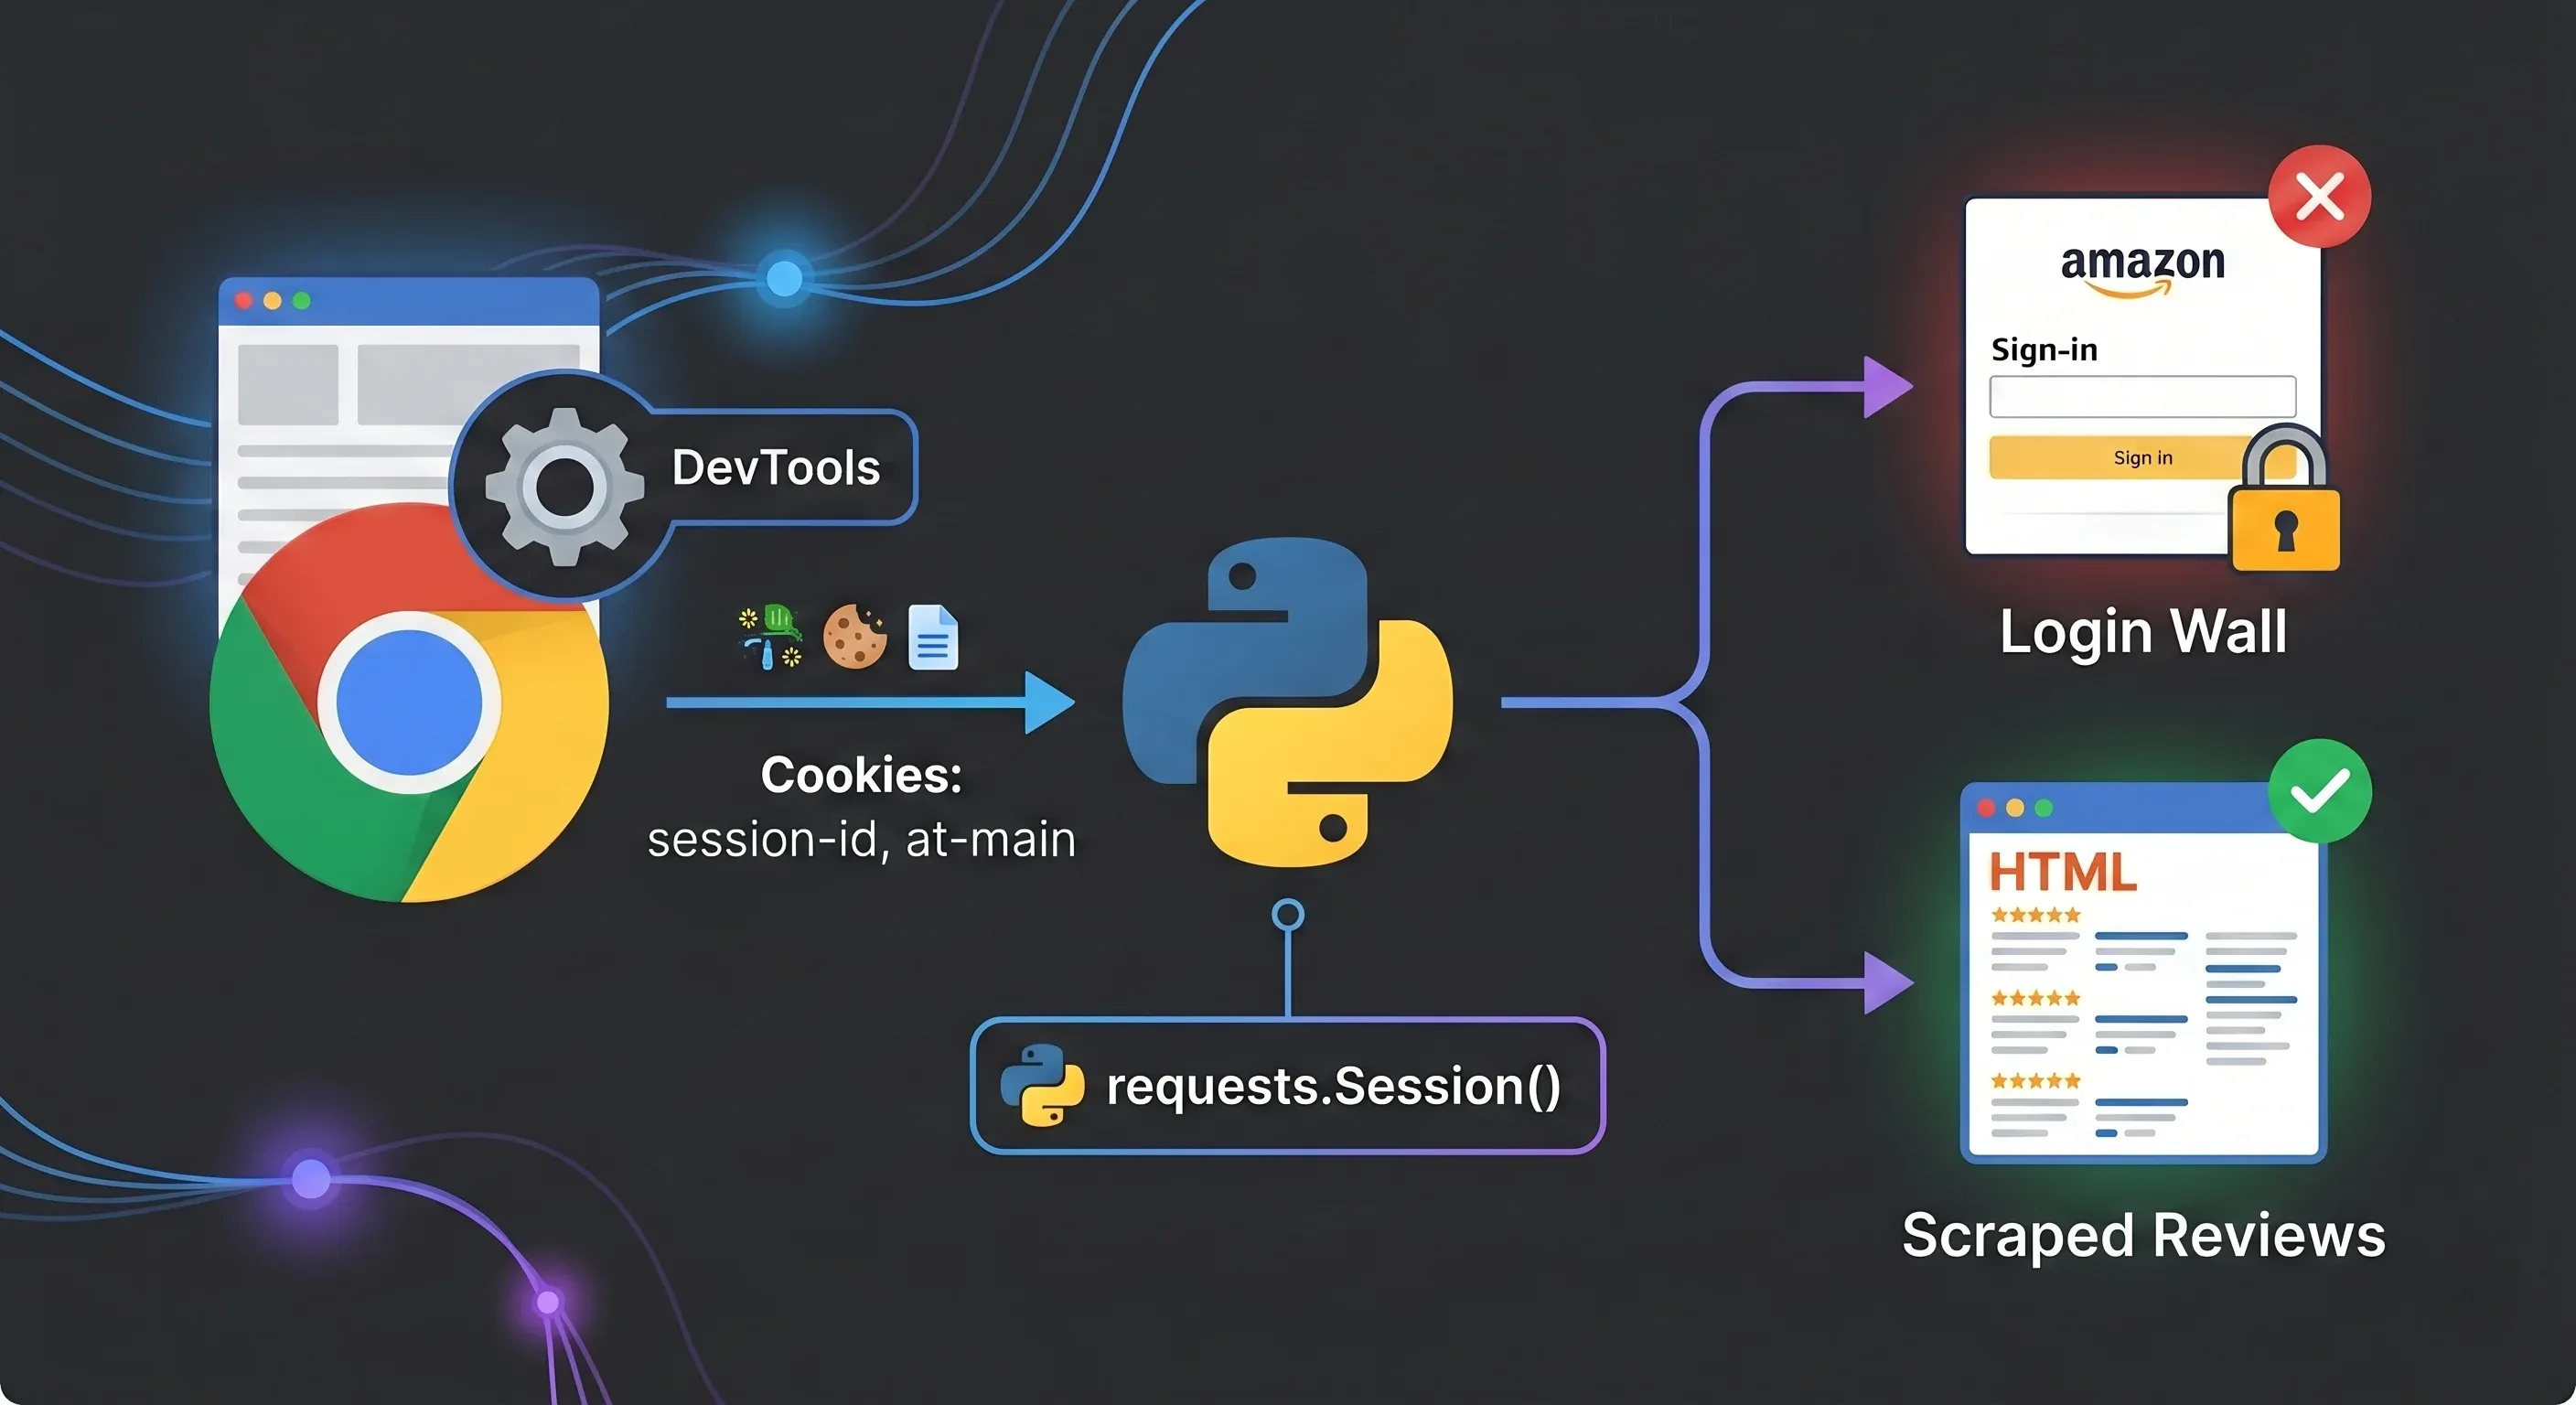
อาการจะค่อนข้างหลอกตา: สคริปต์ของคุณได้ response 200 OK ก็จริง แต่เนื้อหา HTML ข้างในมีฟอร์มล็อกอิน (name="email", id="ap_password") แทนที่จะเป็นรีวิว ไม่มี error code ไม่มี CAPTCHA มีแค่... ไม่มีอะไรที่ใช้ได้เลย
Amazon ทำแบบนี้ด้วยเหตุผลด้าน anti-bot และการปฏิบัติตามข้อกำหนดระดับภูมิภาค การบังคับใช้ไม่สม่ำเสมอ — บางครั้งเปิดหน้าต่างเบราว์เซอร์ใหม่อาจยังเห็นรีวิวได้สักสองสามรายการก่อนที่กำแพงล็อกอินจะเริ่มทำงาน โดยเฉพาะหน้าแรก — แต่ถ้าคุณสแครปในระดับใช้งานจริง ควรตั้งสมมติฐานไว้เลยว่ากำแพงนี้เปิดใช้งานตลอด
โดเมนประเทศของ Amazon แต่ละประเทศ (.de, .co.uk, .co.jp) บังคับใช้ login wall แยกกัน ดังที่ผู้ใช้ในฟอรั่มคนหนึ่งพูดไว้ว่า “ต้องล็อกอินแยกตามประเทศ” ดังนั้นคุกกี้ของ .com ใช้กับ .co.uk ไม่ได้
Featured Reviews vs. Full Reviews: ยังเข้าถึงอะไรได้บ้างโดยไม่ต้องล็อกอิน
หน้าสินค้าของ Amazon (/dp/{ASIN}/) ยังแสดงรีวิวที่ Amazon คัดมาให้ราว 8 รายการ “featured reviews” โดยไม่ต้องยืนยันตัวตน รีวิวพวกนี้เป็นรีวิวที่อัลกอริทึมของ Amazon คัดเลือกมา ซึ่งพอใช้เช็ก sentiment เบื้องต้นได้ แต่จัดเรียง กรอง หรือแบ่งหน้าไม่ได้
หน้ารวมรีวิวแบบเต็ม (/product-reviews/{ASIN}/) — ที่สามารถเรียงตามล่าสุด กรองตามดาว และไล่ดูรีวิวหลายร้อยรายการได้ — ต้องล็อกอิน
ถ้าคุณต้องการแค่รีวิวไม่กี่รายการเพื่อเช็กความรู้สึกคร่าว ๆ ก็สแครปจากหน้าสินค้าได้เลย แต่ถ้าต้องการหลักร้อยหรือหลักพัน คุณจะต้องจัดการ authentication
สิ่งที่ต้องเตรียมก่อนเริ่ม: Python Setup และไลบรารีที่ต้องใช้
ก่อนจะเขียนโค้ด นี่คือสิ่งที่ต้องมี:
- ระดับความยาก: ระดับกลาง (ใช้ Python ได้ และเข้าใจ HTML เบื้องต้น)
- เวลาที่ต้องใช้: ประมาณ 45 นาทีสำหรับ pipeline เต็มรูปแบบ; ประมาณ 10 นาทีสำหรับการสแครปแบบพื้นฐาน
- สิ่งที่ต้องมี: Python 3.8+, เบราว์เซอร์ Chrome, บัญชี Amazon ที่ใช้งานได้
ติดตั้งไลบรารีหลัก:
pip install requests beautifulsoup4 lxml pandas textblob
ตัวเลือกเสริม (สำหรับ sentiment analysis ขั้นสูง):
pip install transformers torch
ASIN คืออะไร? มันคือรหัสสินค้าของ Amazon ยาว 10 ตัวอักษร คุณจะเจอได้ใน URL ของสินค้า เช่นใน amazon.com/dp/B0BCNKKZ91 ค่า ASIN คือ B0BCNKKZ91 นี่คือคีย์ที่จะนำไปใช้ใน URL ของหน้ารีวิว
ขั้นตอนที่ 1: ข้าม Login Wall ด้วยการยืนยันตัวตนผ่านคุกกี้
วิธีที่น่าเชื่อถือที่สุดคือ ล็อกอิน Amazon ในเบราว์เซอร์ แล้วคัดลอก session cookies มาใส่ใน requests.Session() ของ Python วิธีนี้ช่วยหลีกเลี่ยง CAPTCHA และ SMS 2FA ที่มักมีปัญหากับการล็อกอินอัตโนมัติผ่าน Selenium
คุณต้องใช้คุกกี้ 7 ตัวนี้:
| ชื่อคุกกี้ | หน้าที่ |
|---|---|
session-id | ตัวระบุ session ที่เปลี่ยนไปเรื่อย ๆ |
session-id-time | เวลาเริ่ม session |
session-token | token ของ session ที่เปลี่ยนเป็นระยะ |
ubid-main | ตัวระบุพฤติกรรมการท่องเว็บของผู้ใช้ |
at-main | auth token หลัก |
sess-at-main | auth ของ session ปัจจุบัน |
x-main | ตัวระบุที่ผูกกับอีเมลผู้ใช้ |
วิธีดึงคุกกี้จาก Chrome DevTools
- ล็อกอินเข้า amazon.com ใน Chrome
- เปิด DevTools (F12 หรือคลิกขวา → Inspect)
- ไปที่ Application → Storage → Cookies →
https://www.amazon.com - หาชื่อคุกกี้แต่ละตัวในตาราง แล้วคัดลอกค่า
- จัดรูปเป็นสตริงคั่นด้วย semicolon สำหรับใช้ใน Python
ตั้งค่า session แบบนี้:
import requests

session = requests.Session()

# วางค่าคุกกี้ของคุณตรงนี้
cookies = {
    "session-id": "YOUR_SESSION_ID",
    "session-id-time": "YOUR_SESSION_ID_TIME",
    "session-token": "YOUR_SESSION_TOKEN",
    "ubid-main": "YOUR_UBID_MAIN",
    "at-main": "YOUR_AT_MAIN",
    "sess-at-main": "YOUR_SESS_AT_MAIN",
    "x-main": "YOUR_X_MAIN",
}

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/147.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8",
    "Accept-Language": "en-US,en;q=0.5",
}

session.cookies.update(cookies)
session.headers.update(headers)
สำคัญ: ใช้ session ตัวเดิมซ้ำตลอดทุก request วิธีนี้จะทำให้คุกกี้คงที่และดูเหมือน session ของเบราว์เซอร์จริง คุกกี้มักอยู่ได้หลายวันถึงหลายสัปดาห์ภายใต้การสแครป แต่ถ้าคุณเริ่มถูกพาไปหน้าล็อกอินอีกครั้ง ให้รีเฟรชคุกกี้จากเบราว์เซอร์ใหม่
สำหรับ marketplace ที่ไม่ใช่ .com ชื่อคุกกี้จะเปลี่ยนเล็กน้อย — amazon.de ใช้ at-acbde แทน at-main, amazon.co.uk ใช้ at-acbuk และอื่น ๆ แต่ละ marketplace ต้องใช้ session แยกกัน
ขั้นตอนที่ 2: สร้าง request และ parse HTML ของรีวิวด้วย BeautifulSoup
URL ของ Amazon reviews จะมีรูปแบบนี้:
https://www.amazon.com/product-reviews/{ASIN}/ref=cm_cr_arp_d_viewopt_srt?sortBy=recent&pageNumber=1
ฟังก์ชันหลัก:
from bs4 import BeautifulSoup
import time, random

def get_soup(session, url):
    time.sleep(random.uniform(2, 5))  # เว้นช่วงอย่างสุภาพ
    response = session.get(url, timeout=15)

    # ตรวจจับ login wall
    if "ap_email" in response.text or "Amazon Sign-In" in response.text:
        raise Exception("พบ login wall — กรุณารีเฟรชคุกกี้")

    if response.status_code != 200:
        raise Exception(f"HTTP {response.status_code}")

    return BeautifulSoup(response.text, "lxml")
มีทริกเล็ก ๆ ที่ช่วยได้: ก่อนเข้าไปที่หน้ารวมรีวิว ให้เปิดหน้าสินค้าก่อน วิธีนี้ทำให้ session ของคุณมีพฤติกรรมการใช้งานที่ดูเป็นธรรมชาติมากขึ้น
# เปิดหน้าสินค้าก่อน (เลียนแบบการใช้งานจริง)
product_url = f"https://www.amazon.com/dp/{asin}"
session.get(product_url, timeout=15)
time.sleep(random.uniform(1, 3))

# แล้วค่อยเข้ารีวิว
reviews_url = f"https://www.amazon.com/product-reviews/{asin}/ref=cm_cr_arp_d_viewopt_srt?sortBy=recent&pageNumber=1"
soup = get_soup(session, reviews_url)
ขั้นตอนที่ 3: ใช้ selector ที่เสถียรเพื่อดึงข้อมูลรีวิว ไม่ต้องพึ่ง CSS class
นี่คือจุดที่บทความสอนส่วนใหญ่จากปี 2022–2023 มักพัง Amazon ทำให้ชื่อ CSS class สับสนและเปลี่ยนเป็นระยะ ๆ ดังที่นักพัฒนาคนหนึ่งระบายไว้ในฟอรั่มว่า “ไม่มีสักอันที่มีแพตเทิร์นเดียวกันสำหรับชื่อ class ของ span tags”
วิธีแก้คือ: Amazon ใช้แอตทริบิวต์ data-hook บนองค์ประกอบรีวิว ซึ่งเสถียรกว่ามาก เพราะเป็นตัวระบุเชิงความหมายที่โค้ด frontend ของ Amazon เองต้องพึ่งพา จึงไม่ค่อยถูกสุ่มเปลี่ยน
| ฟิลด์รีวิว | Selector ที่เสถียร (data-hook) | Selector ที่เปราะบาง (class) |
|---|---|---|
| ข้อความรีวิว | [data-hook="review-body"] | .review-text-content (เปลี่ยนบ่อย) |
| คะแนนดาว | [data-hook="review-star-rating"] | .a-icon-alt (กำกวม) |
| ชื่อรีวิว | [data-hook="review-title"] | .review-title (บางครั้งใช้ได้) |
| ชื่อผู้เขียน | span.a-profile-name | ค่อนข้างเสถียร |
| วันที่รีวิว | [data-hook="review-date"] | .review-date (ขึ้นกับภูมิภาค) |
| verified purchase | [data-hook="avp-badge"] | span.a-size-mini |
โค้ดดึงข้อมูลด้วย selector แบบ data-hook:
import re

def extract_reviews(soup):
    reviews = []
    review_divs = soup.select('[data-hook="review"]')

    for div in review_divs:
        # คะแนนดาว
        rating_el = div.select_one('[data-hook="review-star-rating"]')
        rating = None
        if rating_el:
            rating_text = rating_el.get_text(strip=True)
            match = re.search(r'(\d\.?\d?)', rating_text)
            if match:
                rating = float(match.group(1))

        # ชื่อเรื่อง
        title_el = div.select_one('[data-hook="review-title"]')
        title = title_el.get_text(strip=True) if title_el else ""

        # เนื้อหารีวิว
        body_el = div.select_one('[data-hook="review-body"]')
        body = body_el.get_text(strip=True) if body_el else ""

        # ผู้เขียน
        author_el = div.select_one('span.a-profile-name')
        author = author_el.get_text(strip=True) if author_el else ""

        # วันที่และประเทศ
        date_el = div.select_one('[data-hook="review-date"]')
        date_text = date_el.get_text(strip=True) if date_el else ""
        # รูปแบบ: "Reviewed in the United States on January 15, 2025"
        country_match = re.search(r'Reviewed in (.+?) on', date_text)
        date_match = re.search(r'on (.+)$', date_text)
        country = country_match.group(1) if country_match else ""
        date = date_match.group(1) if date_match else ""

        # verified purchase
        verified_el = div.select_one('[data-hook="avp-badge"]')
        verified = bool(verified_el)

        reviews.append({
            "author": author,
            "rating": rating,
            "title": title,
            "content": body,
            "date": date,
            "country": country,
            "verified": verified,
        })

    return reviews
ผมทดสอบชุด selector นี้กับหลาย ASIN มาหลายเดือนแล้ว และ data-hook ยังไม่เคยเปลี่ยนแม้แต่ครั้งเดียว ส่วน CSS class กลับเปลี่ยนไปแล้วอย่างน้อยสองรอบในช่วงเวลาเดียวกัน
ขั้นตอนที่ 4: จัดการ pagination และข้อจำกัด 10 หน้า ของ Amazon
Amazon จำกัดค่า pageNumber ไว้ที่ 10 หน้า หน้า 10 รีวิวต่อหน้า แบบเพดานแข็ง ~100 รีวิวต่อการกรองหนึ่งชุด ปุ่ม "Next page" จะหายไปหลังจากหน้า 10
ลูป pagination แบบพื้นฐาน:
all_reviews = []

for page in range(1, 11):
    url = f"https://www.amazon.com/product-reviews/{asin}/ref=cm_cr_arp_d_viewopt_srt?sortBy=recent&pageNumber={page}"
    soup = get_soup(session, url)
    page_reviews = extract_reviews(soup)

    if not page_reviews:
        break  # ไม่มีรีวิวเพิ่มในหน้านี้

    all_reviews.extend(page_reviews)
    print(f"Page {page}: {len(page_reviews)} reviews")
วิธีดึงรีวิว Amazon ให้ได้มากกว่า 10 หน้า
วิธีแก้คือการแบ่งบัคเก็ตด้วย filter แต่ละชุด filterByStar และ sortBy จะได้หน้าต่าง 10 หน้าแยกกัน
ค่าของ star filter: one_star, two_star, three_star, four_star, five_star
ค่าของ sort: recent, helpful (ค่าเริ่มต้น)
เมื่อรวม 5 ตัวกรองดาว × 2 แบบการเรียงลำดับ คุณจะเข้าถึงได้สูงสุด 100 หน้า หรือ 1,000 รีวิวต่อสินค้า — และสำหรับสินค้าที่มีการกระจายคะแนนไม่สม่ำเสมอ คุณมักจะดึงรีวิวได้เกือบครบชุด
star_filters = ["one_star", "two_star", "three_star", "four_star", "five_star"]
sort_orders = ["recent", "helpful"]
all_reviews = []
seen_titles = set()  # dedupe แบบง่าย

for star in star_filters:
    for sort in sort_orders:
        for page in range(1, 11):
            url = (
                f"https://www.amazon.com/product-reviews/{asin}"
                f"?filterByStar={star}&sortBy={sort}&pageNumber={page}"
            )
            soup = get_soup(session, url)
            page_reviews = extract_reviews(soup)

            if not page_reviews:
                break

            for review in page_reviews:
                # deduplicate ด้วยชื่อรีวิว + ชื่อผู้เขียน
                key = (review["title"], review["author"])
                if key not in seen_titles:
                    seen_titles.add(key)
                    all_reviews.append(review)

            print(f"[{star}/{sort}] Page {page}: {len(page_reviews)} reviews")

print(f"Total unique reviews: {len(all_reviews)}")
แต่ละบัคเก็ตจะมีรีวิวซ้ำทับกันอยู่บ้าง ดังนั้นการ dedupe จึงสำคัญมาก ผมใช้คู่ของชื่อรีวิว + ชื่อผู้เขียนเป็นคีย์แบบเร็ว ๆ — ไม่สมบูรณ์แบบ แต่ช่วยจับ duplicates ได้เกือบทั้งหมด
ขั้นตอนที่ 5: หลบการป้องกัน Anti-Bot ด้วยการสลับ, หน่วงเวลา, และ retry
Amazon ใช้ AWS WAF Bot Control และเข้มงวดขึ้นมาก มาตรการแบบชั้นเดียว เช่น แค่หมุน User-Agent หรือแค่ใส่ delay อย่างเดียว ไม่พออีกต่อไป
| เทคนิค | วิธีทำ |
|---|---|
| หมุน User-Agent | สุ่มเลือกจากสตริงเบราว์เซอร์จริงกว่า 10 แบบ |
| Exponential backoff | หน่วง 2s → 4s → 8s เมื่อเจอ 503 |
| จำกัดอัตราการส่ง request | เว้น random.uniform(2, 5) วินาทีระหว่างหน้า |
| สลับ proxy | ใช้ residential proxies แบบวนรอบ |
| Session fingerprint | คุกกี้ + headers ต้องสอดคล้องกันในแต่ละ session |
| TLS impersonation | ใช้ curl_cffi แทน requests ปกติในงาน production |
ตัว wrapper สำหรับ retry แบบพร้อมใช้จริง:
import time, random

USER_AGENTS = [
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/147.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/147.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:149.0) Gecko/20100101 Firefox/149.0",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 15_7_5) AppleWebKit/605.1.15 (KHTML, like Gecko) Version/26.0 Safari/605.1.15",
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/146.0.0.0 Safari/537.36",
]

def scrape_with_retries(session, url, max_retries=3):
    for attempt in range(max_retries):
        try:
            session.headers["User-Agent"] = random.choice(USER_AGENTS)
            time.sleep(random.uniform(2, 5))

            response = session.get(url, timeout=15)

            # ตรวจจับการบล็อก
            if "validateCaptcha" in response.url or "Robot Check" in response.text:
                wait = (2 ** attempt) * 5
                print(f"ตรวจพบ CAPTCHA รอ {wait} วินาที...")
                time.sleep(wait)
                continue

            if response.status_code in (429, 503):
                wait = (2 ** attempt) * 2
                print(f"ถูกจำกัดอัตรา ({response.status_code}) รอ {wait} วินาที...")
                time.sleep(wait)
                continue

            if "ap_email" in response.text:
                raise Exception("เจอ login wall — คุกกี้หมดอายุแล้ว")

            return BeautifulSoup(response.text, "lxml")

        except Exception as e:
            if attempt == max_retries - 1:
                raise
            print(f"ลองครั้งที่ {attempt + 1} ไม่สำเร็จ: {e}")

    return None
หมายเหตุเรื่อง proxy: Amazon บล็อก IP ของดาต้าเซ็นเตอร์ที่รู้จักกันดี (AWS, GCP, Azure, DigitalOcean) ในระดับ network layer ถ้าคุณสแครปมากกว่าสองสามร้อยหน้า residential proxies แทบจะเป็นสิ่งจำเป็น — เตรียมงบไว้ราว $50–200+/เดือน ตามปริมาณงาน สำหรับโปรเจกต์ขนาดเล็ก (ต่ำกว่า 100 requests/วัน) การหน่วงอย่างระมัดระวังจาก IP บ้านมักยังพอใช้ได้
Amazon ยังตรวจสอบ TLS fingerprint ด้วย Python requests แบบมาตรฐานมี JA3 hash ที่ WAF มักบล็อกไว้ล่วงหน้า สำหรับ scraper ระดับ production ควรพิจารณา curl_cffi ซึ่งสามารถปลอมลักษณะ TLS stack ของเบราว์เซอร์จริงได้ แต่สำหรับงานสเกลแบบบทความสอน (ไม่กี่ร้อยหน้า) requests ที่ตั้ง header ดี ๆ ก็มักใช้งานได้
ขั้นตอนที่ 6: Export รีวิว Amazon ที่สแครปได้เป็น CSV หรือ Excel
เมื่อเก็บรีวิวได้แล้ว การแปลงให้อยู่ในรูปที่ใช้งานได้ด้วย pandas ทำได้ตรงไปตรงมา:
import pandas as pd

df = pd.DataFrame(all_reviews)
df.to_csv("amazon_reviews.csv", index=False)
print(f"Exported {len(df)} reviews to amazon_reviews.csv")
ตัวอย่างผลลัพธ์:
| author | rating | title | content | date | country | verified |
|---|---|---|---|---|---|---|
| Sarah M. | 5.0 | ซื้อแล้วคุ้มที่สุดของปีนี้ | แบตอยู่ได้ทั้งวัน หน้าจอสวยมาก... | January 15, 2025 | the United States | True |
| Mike T. | 2.0 | ผิดหวังหลังใช้ไป 2 สัปดาห์ | ช่องชาร์จเริ่มมีปัญหา... | February 3, 2025 | the United States | True |
| Priya K. | 4.0 | คุ้มค่ากับราคา | ตอบโจทย์ทุกอย่างที่ต้องใช้ มีหน่วงเล็กน้อยตอนเปิดแอปหนัก ๆ... | March 10, 2025 | the United States | False |
ถ้าจะ export เป็น Excel: df.to_excel("amazon_reviews.xlsx", index=False) (ต้องติดตั้ง openpyxl)
ถ้าจะส่งเข้า Google Sheets ไลบรารี gspread ใช้ได้ แต่ต้องตั้งค่า Google Cloud มากกว่า 8 ขั้นตอน — สร้างโปรเจกต์, เปิดใช้สอง API, สร้าง service account credentials, แชร์ชีต ถ้าคุณรู้สึกว่านี่คือการตั้งค่าที่มากกว่างานสแครปจริง ๆ คุณคิดไม่ผิด (นี่เป็นหนึ่งในจังหวะที่เครื่องมืออย่าง Thunderbit ซึ่ง export ไป Google Sheets ได้แค่คลิกเดียว เริ่มน่าสนใจมากขึ้น)
โบนัส: เพิ่ม Sentiment Analysis ให้รีวิวที่สแครปมาได้ใน Python แค่ 5 บรรทัด
บทความสอนสแครปส่วนใหญ่หยุดแค่ export เป็น CSV แต่การให้คะแนน sentiment ต่างหากที่เปลี่ยนข้อมูลดิบให้กลายเป็นการตัดสินใจทางธุรกิจ
วิธีเร็วที่สุดคือใช้ TextBlob:
from textblob import TextBlob

df["sentiment"] = df["content"].apply(lambda x: TextBlob(str(x)).sentiment.polarity)
โค้ดนี้จะให้คะแนน polarity ตั้งแต่ -1.0 (ลบมาก) ถึง +1.0 (บวกมาก) สำหรับแต่ละรีวิว ตัวอย่างผลลัพธ์:
| content (ย่อ) | rating | sentiment |
|---|---|---|
| "Battery lasts all day, screen is gorgeous..." | 5.0 | 0.65 |
| "The charging port stopped working after..." | 2.0 | -0.40 |
| "Does everything I need, minor lag on..." | 4.0 | 0.25 |
| "Absolute garbage. Returned immediately." | 1.0 | -0.75 |
| "It's okay. Nothing special but works." | 3.0 | 0.10 |
แถวที่น่าสนใจจริง ๆ คือแถวที่ไม่สอดคล้องกัน — เช่นรีวิว 3 ดาวที่มีข้อความเชิงบวก หรือรีวิว 5 ดาวที่ใช้ภาษาลบ ความต่างเหล่านี้มักเผยให้เห็นความคิดเห็นของลูกค้าในรายละเอียดที่คะแนนดาวอย่างเดียวจับไม่ได้
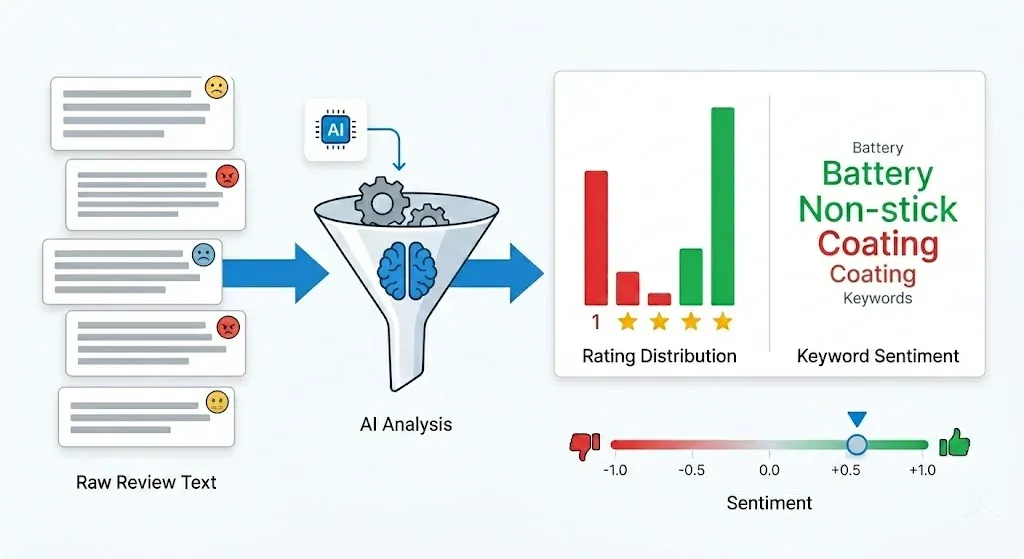
ถ้าต้องการความแม่นยำระดับ production ขอแนะนำ Hugging Face Transformers VADER ถูกฝึกมาจากทวีต ไม่ใช่รีวิวสินค้า และ โมเดล transformer ทำความแม่นยำได้มากกว่า 98% ในงาน review classification เมื่อเทียบกับเครื่องมือแบบ lexicon โมเดล nlptown/bert-base-multilingual-uncased-sentiment ยังทำนายคะแนน 1–5 ดาวได้โดยตรง:
from transformers import pipeline

clf = pipeline("sentiment-analysis",
               model="nlptown/bert-base-multilingual-uncased-sentiment")
df["predicted_stars"] = df["content"].apply(
    lambda x: int(clf(str(x)[:512])[0]["label"][0])
)
รีวิว Amazon มักมีการกระจายตัวแบบ J-shaped distribution — พุ่งสูงที่ 5 ดาว, มีอีกยอดที่ 1 ดาว, และแอ่งตรงกลาง ดังนั้นค่าเฉลี่ยของคะแนนดาวมักไม่ใช่ตัวแทนคุณภาพสินค้าที่ดีนัก ลองแยกกลุ่ม 1 ดาวแล้วขุดหาธีมที่เกิดซ้ำ — ตรงนั้นมักซ่อนข้อบกพร่องที่แก้ได้ไว้
ความจริงเรื่องการแลกเปลี่ยน: Python ทำเอง vs. Paid Scraping API vs. Thunderbit
ผมดูแล Python scraper สำหรับ Amazon มาหลายตัว และพูดตรง ๆ คือมันพังบ่อย selectors เปลี่ยน คุกกี้หมดอายุ Amazon ปล่อยชั้นตรวจจับบอทใหม่ แล้ววันเสาร์เช้าของคุณก็กลายเป็นการ debug scraper แทนที่จะวิเคราะห์ข้อมูล ผู้ใช้ในฟอรั่มก็บ่นแบบเดียวกัน — สคริปต์ DIY ที่ “เดือนที่แล้วยังใช้ได้” ตอนนี้ต้องแพตช์ตลอดเวลา
นี่คือการเปรียบเทียบแนวทางหลัก 3 แบบ:
| เกณฑ์ | DIY Python (BS4/Selenium) | Paid Scraping API | Thunderbit (No-Code) |
|---|---|---|---|
| เวลาเริ่มต้น | 1–3 ชั่วโมง | 30 นาที (API key) | 2 นาที |
| ค่าใช้จ่าย | ฟรี (+ ค่าพร็อกซี) | $50–200+/เดือน | มีแผนใช้ฟรี |
| การจัดการ login wall | ต้องจัดการคุกกี้เอง | ส่วนใหญ่จัดการให้ | จัดการอัตโนมัติ |
| งานดูแลรักษา | สูง (selectors พังบ่อย) | ต่ำ (ผู้ให้บริการดูแล) | แทบไม่มี (AI ปรับตัว) |
| Pagination | ต้องเขียนเอง | มีมาให้ | มีมาให้ |
| รองรับหลายประเทศ | ต้องแยก session ตามโดเมน | มักรองรับ | ใช้งานผ่านเบราว์เซอร์ = ตาม locale ของคุณ |
| Sentiment analysis | ต้องเขียนโค้ดเอง | บางเจ้ามี | export ไป Sheets แล้ววิเคราะห์ต่อได้ |
| เหมาะกับ | การเรียนรู้, ต้องการควบคุมทุกอย่าง | production pipeline ที่เน้นเสถียรภาพ | ดึงข้อมูลเร็ว ๆ, ทีมที่ไม่ใช่นักพัฒนา |
Python ให้การควบคุมเต็มที่ และเป็นวิธีที่ดีที่สุดถ้าคุณอยากเข้าใจว่า web scraping ทำงานอย่างไรภายใน Paid API อย่าง ScrapingBee, Oxylabs, Bright Data เหมาะกับ production pipeline ที่ uptime สำคัญกว่าราคา และสำหรับทีมที่ต้องการข้อมูลรีวิวโดยไม่อยากแบกภาระด้าน dev — เช่นทีม ecommerce ที่ติดตามสินค้าคู่แข่งรายสัปดาห์ หรือทีมการตลาดที่ดึงภาษาลูกค้าไปทำโฆษณา — ก็มีอีกทางเลือก
วิธีสแครปรีวิว Amazon ด้วย Thunderbit (ไม่ต้องเขียนโค้ด, ไม่ต้องดูแล)
เราออกแบบ Thunderbit มาเพื่อจัดการสถานการณ์ที่การดูแล Python scraper เองมันเกินความจำเป็น วิธีใช้งานเป็นแบบนี้:
- ติดตั้ง Thunderbit Chrome Extension
- เปิดหน้ารวมรีวิวสินค้าของ Amazon ในเบราว์เซอร์ของคุณ (คุณล็อกอินอยู่แล้ว ดังนั้น login wall ไม่ใช่ปัญหา)
- คลิก "AI Suggest Fields" — Thunderbit จะอ่านหน้าแล้วแนะนำคอลัมน์ เช่น Author, Rating, Title, Review Text, Date, Verified Purchase
- คลิก "Scrape" — ข้อมูลจะถูกดึงออกมาทันที พร้อม pagination ในตัว
- Export ไปยัง Excel, Google Sheets, Airtable หรือ Notion
ข้อดีหลักคือ AI ของ Thunderbit จะอ่านโครงสร้างหน้าเว็บใหม่ทุกครั้ง ไม่มี CSS selector ให้ต้องดูแล ไม่มีคุกกี้ให้จัดการ ไม่มีโค้ด anti-bot เมื่อ Amazon เปลี่ยน HTML AI ก็ปรับตามได้ สำหรับคนที่อยากเข้าถึงข้อมูลแบบโปรแกรมมิงโดยไม่ต้องทำเองทั้งหมด Thunderbit ยังมี Extract API สำหรับดึงข้อมูลแบบมีโครงสร้างผ่าน API พร้อม AI ช่วยตรวจจับฟิลด์ โดยไม่ต้องดูแล selector
ถ้าอยากเจาะลึกข้อมูล Amazon เพิ่มเติม ดูคู่มือของเราเรื่อง วิธีสแครปสินค้าและรีวิว Amazon และ การดึงและวิเคราะห์ข้อมูลยอดขาย Amazon
เคล็ดลับการสแครปรีวิว Amazon ในสเกลใหญ่ด้วย Python
ถ้าคุณสแครปรีวิวจากหลาย ASIN พร้อมกัน แนวปฏิบัติไม่กี่อย่างนี้จะช่วยลดปวดหัวได้มาก:
- แบ่งชุด ASIN เป็นรอบ ๆ และเว้นช่วงระหว่างสินค้า ไม่ใช่แค่ระหว่างหน้า ผมใช้การพัก 10–15 วินาทีระหว่าง ASIN
- Deduplicate อย่างจริงจัง เมื่อรวมหลายชุดของ star filter และ sort order คุณจะเจอรีวิวซ้ำ ใช้ set ของ tuple
(title, author, date)เป็นคีย์ dedupe - บันทึก failure ไว้ ติดตามว่า ASIN + page + filter ชุดไหนล้มเหลว เพื่อจะลองใหม่ได้โดยไม่ต้องสแครปทั้งหมดซ้ำ
- เก็บลงฐานข้อมูลสำหรับโปรเจกต์ใหญ่ SQLite ง่ายและสเกลได้ดีกว่า CSV ที่โตขึ้นเรื่อย ๆ:
import sqlite3

conn = sqlite3.connect("reviews.db")
df.to_sql("reviews", conn, if_exists="append", index=False)
- ตั้งเวลาสแครปซ้ำอัตโนมัติ สำหรับการมอนิเตอร์ต่อเนื่อง ให้ตั้ง cron job หรือใช้ฟีเจอร์ Scheduled Scraper ของ Thunderbit — แค่บอก URL และตารางเวลา ที่เหลือระบบจัดการให้โดยไม่ต้องมีเซิร์ฟเวอร์
ถ้าอยากดูแนวทางเพิ่มเติม โพสต์ของเราที่ เครื่องมือ web scraping แบบอัตโนมัติที่ดีที่สุด และ การสแครปข้อมูลจากเว็บไซต์ลง Excel มีทางเลือกอื่น ๆ เพิ่มเติม
ข้อควรทราบเรื่องกฎหมายและจริยธรรม
ข้อกำหนดการใช้งานของ Amazon Conditions of Use ระบุชัดว่าห้ามใช้ "robot, spider, scraper หรือวิธีอัตโนมัติอื่น ๆ เพื่อเข้าถึง Amazon Services" อย่างไรก็ตาม คดีในสหรัฐฯ ช่วงหลังมีแนวโน้มเป็นบวกต่อการสแครปข้อมูลสาธารณะ ในคดี Meta Platforms v. Bright Data (มกราคม 2024) ศาลรัฐบาลกลางตัดสินว่าการสแครปข้อมูลที่เข้าถึงได้สาธารณะไม่ได้ละเมิดข้อกำหนดการใช้งานหาก scraper ไม่ใช่ "user" ที่ล็อกอินอยู่
ประเด็นที่ต้องแยกให้ออกคือ: การสแครปหลังล็อกอิน (ซึ่งเป็นสิ่งที่บทความนี้พูดถึง) ทำให้คุณเข้าสู่ขอบเขตของสัญญา เพราะคุณยอมรับ ToS ของ Amazon ตอนสร้างบัญชีแล้ว การสแครปรีวิวที่มองเห็นได้สาธารณะมีความเสี่ยงทางกฎหมายน้อยกว่าการสแครปหลัง login wall
แนวทางปฏิบัติ: อย่านำข้อมูลที่สแครปไปเผยแพร่ต่อเชิงพาณิชย์ อย่าสแครปข้อมูลส่วนบุคคลของผู้ใช้เกินกว่าที่แสดงสาธารณะ เคารพ robots.txt และปรึกษาทนายสำหรับการใช้งานเชิงพาณิชย์หรือในสเกลใหญ่ นี่ไม่ใช่คำแนะนำทางกฎหมาย สำหรับภาพรวมด้านกฎหมายเพิ่มเติม ดูบทความ ผลกระทบทางกฎหมายของ web scraping
สรุป: จะสแครปรีวิว Amazon ด้วย Python หรือข้ามการเขียนโค้ดไปเลยก็ได้
สรุปสิ่งที่คู่มือนี้พาไปดู:
- Login wall มีอยู่จริง แต่แก้ได้ด้วยการยืนยันตัวตนผ่านคุกกี้ — คัดลอกคุกกี้ 7 ตัวจากเบราว์เซอร์ แล้วใส่ใน
requests.Session() - ใช้ selector แบบ
data-hookแทน CSS class เพื่อให้การดึงข้อมูลไม่พังทุกไม่กี่สัปดาห์ - ผสม star filter และ sort order เพื่อเอาชนะข้อจำกัด 10 หน้า และเข้าถึงรีวิวได้มากกว่า 500 รายการต่อสินค้า
- เพิ่ม sentiment analysis ด้วย TextBlob เพื่อ baseline แบบเร็ว หรือ Hugging Face Transformers เพื่อความแม่นยำระดับ production
- ดูแลการป้องกัน anti-bot: throttling, หมุน User-Agent, exponential backoff และ residential proxies เมื่อต้องสเกล
Python ให้การควบคุมเต็มที่ และเป็นวิธีที่ดีที่สุดในการเข้าใจว่าระบบทำงานอย่างไรภายใน แต่ถ้า use case ของคุณคือ "ต้องมีข้อมูลรีวิวคู่แข่งลงสเปรดชีตภายในวันศุกร์" มากกว่า "อยากสร้าง data pipeline ระดับ production" ภาระการดูแล scraper เองอาจไม่คุ้ม
Thunderbit จัดการ authentication, selector, pagination และ export ได้ในไม่กี่คลิก — ลองใช้ free tier แล้วดูว่าเข้ากับ workflow ของคุณไหม เมื่อ Amazon เข้มงวดกับมาตรการ anti-bot มากขึ้น เครื่องมือที่ขับเคลื่อนด้วย AI และปรับตัวได้แบบเรียลไทม์จะไม่ได้เป็นแค่ของดีที่มีไว้ใช้ แต่จะกลายเป็นสิ่งจำเป็น
คุณยังสามารถเข้าไปดู Thunderbit YouTube Channel เพื่อดูวิดีโอสาธิต workflow การสแครปได้ด้วย
คำถามที่พบบ่อย
1. สามารถสแครปรีวิว Amazon ได้โดยไม่ต้องล็อกอินไหม?
ได้ แต่จะได้แค่รีวิวที่ Amazon แสดงบนหน้าสินค้าประมาณ 8 รายการเท่านั้น (/dp/{ASIN}/) ส่วนหน้ารวมรีวิวฉบับเต็มที่มีการเรียงลำดับ กรอง และแบ่งหน้า ต้องยืนยันตัวตนตั้งแต่ปลายปี 2024 เป็นต้นมา สำหรับ use case ทางธุรกิจส่วนใหญ่ คุณจะต้องจัดการ login wall อยู่ดี
2. การสแครปรีวิว Amazon ถูกกฎหมายไหม?
Amazon Terms of Service ห้ามการสแครปอัตโนมัติ อย่างไรก็ตาม คดีในสหรัฐฯ ช่วงหลัง (Meta v. Bright Data, 2024; hiQ v. LinkedIn) สนับสนุนการสแครปข้อมูลที่เข้าถึงได้สาธารณะ การสแครปหลังล็อกอินมีความเสี่ยงทางกฎหมายสูงกว่า เพราะคุณยอมรับ ToS ของ Amazon แล้ว ควรปรึกษาทนายหากใช้เชิงพาณิชย์
3. หนึ่งสินค้าสามารถสแครปรีวิว Amazon ได้กี่รายการ?
Amazon จำกัดรีวิวไว้ที่ 10 หน้า ต่อการเรียงลำดับและตัวกรองดาวหนึ่งชุด เมื่อใช้ 5 ตัวกรองดาว × 2 การเรียงลำดับ คุณจะเข้าถึงได้สูงสุด 100 หน้า หรือประมาณ 1,000 รีวิวต่อสินค้า หากใช้ keyword filter เพดานตามทฤษฎีจะสูงกว่านี้มาก แต่ก็มีรีวิวซ้ำจำนวนไม่น้อย
4. ไลบรารี Python ที่ดีที่สุดสำหรับการสแครปรีวิว Amazon คืออะไร?
requests + BeautifulSoup สำหรับ parsing HTML แบบสแตติก เป็นชุดที่พบได้บ่อยและเชื่อถือได้มากที่สุด Selenium มีประโยชน์เมื่อจำเป็นต้องเรนเดอร์ JavaScript ถ้าอยากได้ทางเลือกแบบไม่ต้องเขียนโค้ดที่จัดการ login wall และ pagination ให้อัตโนมัติ ลอง Thunderbit
5. จะหลีกเลี่ยงการถูกบล็อกตอนสแครป Amazon ได้อย่างไร?
หมุนสตริง User-Agent จากชุดเบราว์เซอร์จริงมากกว่า 10 แบบ ใส่ delay สุ่ม 2–5 วินาทีระหว่าง request ใช้ exponential backoff เมื่อเจอข้อผิดพลาด 503/429 ใช้ residential proxies เมื่อต้องสเกล (เพราะ IP จากดาต้าเซ็นเตอร์มักถูกบล็อกไว้แล้ว) และใช้คุกกี้ session ชุดเดิมให้สอดคล้องกันทุก request ถ้าอยากได้แนวทางที่ไม่ต้องดูแลเอง Thunderbit จะจัดการ anti-bot defenses ให้ผ่าน session ของเบราว์เซอร์คุณโดยอัตโนมัติ
อ่านเพิ่มเติม



