
เว็บเต็มไปด้วยข้อมูลที่มีค่ามหาศาล ไม่ว่าจะเป็นราคาสินค้า รายชื่อติดต่อทางธุรกิจ ความเคลื่อนไหวของคู่แข่ง หรือเทรนด์ตลาด แต่พูดกันตรง ๆ คงไม่มีใครอยากใช้เวลาทั้งวันคัดลอกและวางข้อมูลจากหน้าเว็บเป็นร้อย ๆ หน้า นั่นคือเหตุผลที่การดึงข้อมูลจากเว็บเข้ามามีบทบาท และทำให้ Python data scraper กลายเป็นเครื่องมือยอดนิยมสำหรับธุรกิจที่ต้องการเปลี่ยนความยุ่งเหยิงบนอินเทอร์เน็ตให้เป็นข้อมูลสะอาด พร้อมนำไปใช้ตัดสินใจได้จริง
จากประสบการณ์หลายปีในสาย SaaS และ automation ผมเห็นความต้องการใช้ข้อมูลจากเว็บเพิ่มขึ้นอย่างรวดเร็วมาก ปัจจุบัน 96% ของธุรกิจบอกว่าการตัดสินใจด้วยข้อมูลเป็นเรื่องสำคัญอย่างยิ่ง และตลาดซอฟต์แวร์ web scraping ทั่วโลกก็ยังมีแนวโน้มเติบโตต่อเนื่องไปอีกหลายปี (ScrapingDog) แต่จริง ๆ แล้ว Python data scraper คืออะไร ทำงานอย่างไร และเหมาะกับธุรกิจของคุณที่สุดหรือไม่ หรือมีทางเลือกที่ฉลาดกว่าและขับเคลื่อนด้วย AI อย่าง Thunderbit ที่ทำให้ทุกอย่างง่ายขึ้น? มาดูทีละส่วนกัน
ทำความรู้จัก Python Data Scraper: มันคืออะไร?
โดยแก่นแล้ว Python data scraper คือสคริปต์หรือโปรแกรมที่เขียนด้วย Python เพื่อทำให้กระบวนการเก็บข้อมูลจากเว็บไซต์เป็นอัตโนมัติ ลองคิดว่ามันเป็นหุ่นยนต์ดิจิทัลที่เข้าไปเปิดหน้าเว็บ อ่านเนื้อหา แล้วหยิบเฉพาะข้อมูลที่คุณต้องการออกมา ไม่ว่าจะเป็นราคาสินค้า หัวข้อข่าว อีเมล หรือรูปภาพ แทนที่จะต้องนั่งคัดลอกและวางเองเป็นชั่วโมง scraper จะรับงานหนักแทนคุณ แล้วเปลี่ยนหน้าเว็บที่กระจัดกระจายให้เป็นตารางเรียบร้อยสำหรับนำไปวิเคราะห์หรือส่งต่อเข้าระบบธุรกิจ (BuiltIn)
Python scraper จัดการได้ทั้ง ข้อมูลแบบมีโครงสร้าง เช่น ตารางหรือรายการ และ ข้อมูลแบบไม่มีโครงสร้าง เช่น ข้อความรีวิว หรือรูปภาพ ถ้าคุณมองเห็นสิ่งนั้นบนหน้าเว็บ ไม่ว่าจะเป็นข้อความ ตัวเลข วันที่ URL อีเมล เบอร์โทรศัพท์ หรือรูปภาพ Python scraper ก็มักจะดึงออกมาได้ (Scrape.do)
สรุปสั้น ๆ: Python data scraper คือผู้ช่วยที่ไม่รู้จักเหนื่อย ขับเคลื่อนด้วยโค้ด และช่วยเปลี่ยนเว็บอันยุ่งเหยิงให้กลายเป็นข้อมูลธุรกิจที่มีโครงสร้างและนำไปใช้ได้จริง
ทำไมธุรกิจถึงใช้ Python Data Scraper?
Python data scraper แก้ปัญหาพื้นฐานข้อหนึ่งของธุรกิจ: การเก็บข้อมูลด้วยมือขยายสเกลไม่ได้ นี่คือวิธีที่มันช่วยทีมขาย ecommerce และ operations:
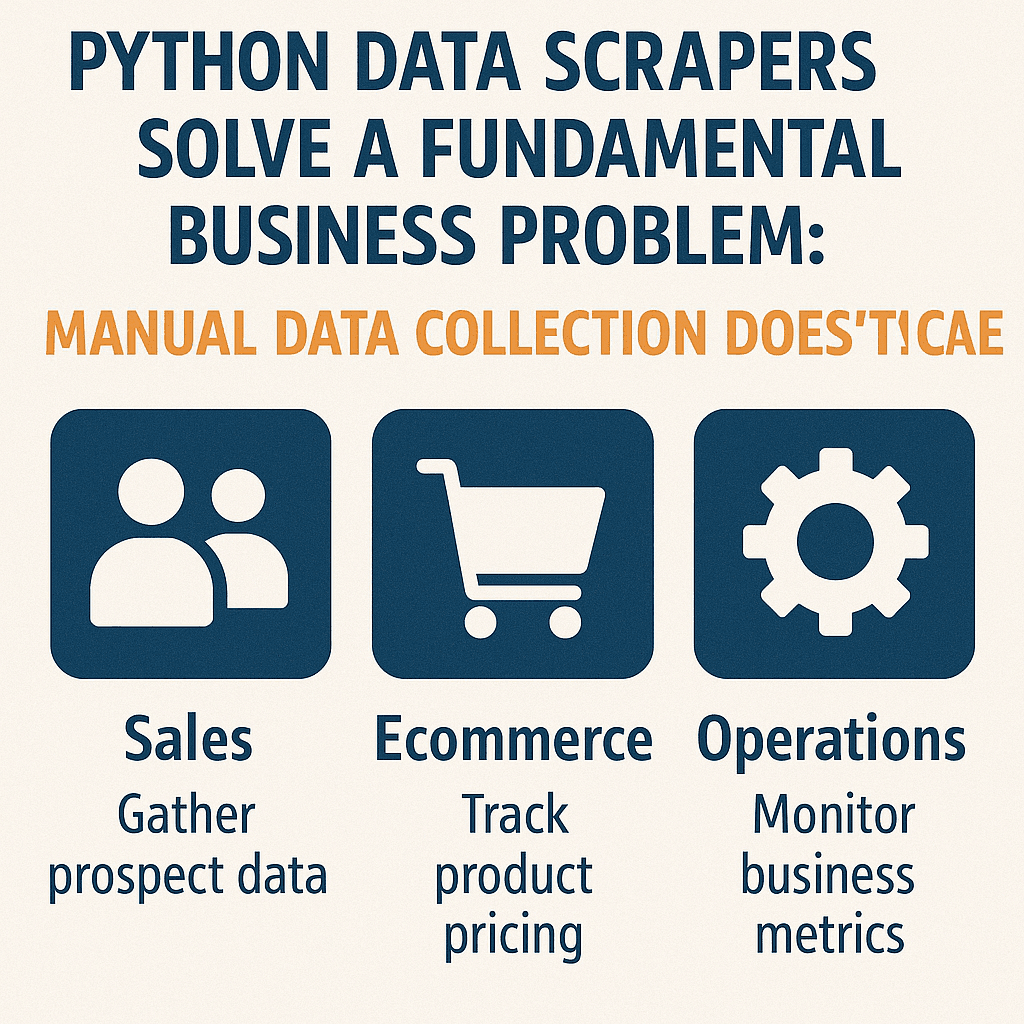
- Lead Generation: ทีมขายใช้ Python scraper เพื่อดึงข้อมูลติดต่อ เช่น ชื่อ อีเมล เบอร์โทรศัพท์ จากไดเรกทอรีและฟอรัมอุตสาหกรรม งานที่คนคนหนึ่งอาจต้องใช้เวลาหลายวันในการคัดลอกและวาง สามารถจบได้ภายในงานรันข้ามคืนครั้งเดียว แม้ว่า anti-bot defenses บนไดเรกทอรีขนาดใหญ่ รวมถึงเงื่อนไขการใช้งานแพลตฟอร์ม เช่น LinkedIn จะทำให้ขอบเขตการใช้งานจริงแคบกว่าภาพที่มักเห็นในคำโฆษณา (BuiltIn)
- Competitor Monitoring: ธุรกิจ ecommerce และค้าปลีก scrape เว็บไซต์คู่แข่งเพื่อดูราคา คำอธิบายสินค้า และสถานะสต็อก John Lewis ร้านค้าปลีกในสหราชอาณาจักร เพิ่มยอดขายได้ 4% เพียงใช้ข้อมูลราคาที่ scrape มาเพื่อปรับราคาของตนเอง
- Market Research: นักวิเคราะห์ scrape เว็บไซต์ข่าว รีวิว หรือ job board เพื่อดูเทรนด์ วัด sentiment หรือติดตามการจ้างงาน ASOS ทำยอดขายต่างประเทศเพิ่มขึ้นเป็นสองเท่าด้วยการ scrape ข้อมูลเว็บไซต์แต่ละภูมิภาคเพื่อนำมาปรับข้อเสนอให้เหมาะกับตลาดนั้น ๆ (Browsercat)
- Operational Automation: ทีม operations ทำงานป้อนข้อมูลซ้ำ ๆ ให้เป็นอัตโนมัติ เช่น scrape สต็อกของ vendor หรือสถานะการจัดส่ง ช่วยประหยัดเวลาหลายร้อยชั่วโมงที่เดิมต้องหมดไปกับการคัดลอกข้อมูลด้วยมือ
นี่คือตารางสรุป use case จริงและผลกระทบทางธุรกิจ:
| Use Case | Python Scraping ช่วยอย่างไร | ผลลัพธ์ทางธุรกิจ |
|---|---|---|
| Competitor Price Monitoring | เก็บราคาจริงแบบ real-time | John Lewis ยอดขายเพิ่มขึ้น 4% (Browsercat) |
| Market Expansion Research | รวมข้อมูลสินค้าตามแต่ละท้องถิ่น | ASOS เพิ่มยอดขายต่างประเทศเป็นสองเท่า (Browsercat) |
| Lead Generation Automation | ดึงข้อมูลติดต่อจากไดเรกทอรี | scrape ได้ 12,000 leads ในหนึ่งสัปดาห์ ประหยัดเวลาหลายร้อยชั่วโมง (Browsercat) |
ใจความสำคัญคือ Python data scraper ช่วยเพิ่มรายได้ ลดต้นทุน และสร้างความได้เปรียบในการแข่งขัน ด้วยการปลดล็อกข้อมูลจากเว็บที่เดิมเข้าถึงได้ยากหรือแทบเป็นไปไม่ได้ (Browsercat)
Python Data Scraper ทำงานอย่างไร? ภาพรวมทีละขั้นตอน
มาดู workflow ทั่วไปของ Python data scraper กัน ถ้าคุณเคยนึกภาพการจ้างเด็กฝึกงานที่เปิดหน้าเว็บได้เร็วมากแล้วจดข้อมูลสำคัญลงมา คุณก็เข้าใจไปครึ่งหนึ่งแล้ว
- ระบุเป้าหมาย: ตัดสินใจว่าจะ scrape เว็บไซต์หรือหน้าใด และต้องการข้อมูลอะไร เช่น “ชื่อสินค้าและราคาทั้งหมดจาก 5 หน้าแรกของผลค้นหา Amazon สำหรับ ‘laptop’”
- ส่ง HTTP Request: scraper ใช้ไลบรารี
requestsของ Python เพื่อดึง HTML ดิบของหน้าเว็บ คล้ายกับที่เบราว์เซอร์ทำเมื่อคุณเข้าเว็บไซต์ - Parse HTML: ด้วยไลบรารีอย่าง Beautiful Soup scraper จะ “อ่าน” HTML แล้วค้นหาข้อมูลที่ต้องการจาก tag, class หรือ ID เฉพาะ เช่น element ทั้งหมดที่เป็น
<span class="price"> - Extract และจัดโครงสร้างข้อมูล: สคริปต์ดึงข้อมูลเป้าหมายออกมา แล้วเก็บไว้ในรูปแบบมีโครงสร้าง เช่น list ของ dictionary หรือตารางใน memory
- จัดการหลายหน้า (Crawling): ถ้าข้อมูลกระจายอยู่หลายหน้า scraper จะวนผ่าน pagination หรือตามลิงก์ไปยัง subpage แล้วทำขั้นตอนเดิมซ้ำ
- Post-Process ข้อมูล: ทำความสะอาด จัดรูปแบบ หรือแปลงข้อมูลเพิ่มเติมถ้าจำเป็น เช่น แปลง “Oct 5, 2025” เป็น “2025-10-05”
- Export ผลลัพธ์: สุดท้าย บันทึกข้อมูลเป็น CSV, Excel file, JSON หรือแม้แต่ database เพื่อพร้อมสำหรับการวิเคราะห์หรือเชื่อมต่อระบบ
เปรียบให้เห็นภาพ: scraper ก็เหมือนเด็กฝึกงานความเร็วสูงที่เปิดแต่ละหน้าเว็บ หาข้อมูลที่คุณต้องการ จดลง spreadsheet แล้วไปต่อหน้าถัดไป โดยไม่ต้องพักดื่มกาแฟเลย
ไลบรารีและ Framework ยอดนิยมสำหรับ Python Data Scraper
เหตุผลที่ Python ได้รับความนิยมในงาน web scraping มาจาก ecosystem ของไลบรารีที่แข็งแรงมาก นี่คือเครื่องมือที่ใช้กันแพร่หลาย พร้อมจุดแข็งและสถานการณ์ที่เหมาะกับแต่ละตัว:
| Library/Framework | การใช้งานหลัก | จุดแข็ง | ข้อจำกัด |
|---|---|---|---|
| Requests | ดึงหน้าเว็บ (HTTP requests) | เรียบง่าย เร็วสำหรับเนื้อหา static | จัดการ JavaScript หรือหน้า dynamic ไม่ได้ |
| Beautiful Soup | Parse HTML/XML | ใช้ง่าย เหมาะกับ HTML ที่ไม่เป็นระเบียบ | ช้ากว่าสำหรับโปรเจกต์ใหญ่ ไม่มี HTTP requests ในตัว |
| Scrapy | Crawling ขนาดใหญ่และประสิทธิภาพสูง | เร็ว รองรับ concurrency แข็งแรงสำหรับงานใหญ่ | learning curve สูง เกินจำเป็นสำหรับงานเล็ก |
| Selenium | Browser automation สำหรับเว็บ dynamic | จัดการ JavaScript, login และ user actions ได้ | ช้า ใช้ resource สูง ไม่เหมาะกับสเกลใหญ่มาก |
| Playwright | Browser automation สมัยใหม่ | เร็ว รองรับหลายเบราว์เซอร์ จัดการเว็บซับซ้อนได้ | ต้องเขียนโค้ด และใหม่กว่า Selenium |
| lxml | HTML parsing ที่เร็วมาก | เร็วมาก เหมาะกับ dataset ขนาดใหญ่ | ไม่เป็นมิตรกับมือใหม่เท่าไร และใช้ parse เท่านั้น |
- Requests เหมาะสำหรับการดึง HTML ดิบ
- Beautiful Soup เด่นเมื่อคุณต้อง parse และดึงข้อมูลจากหน้า static
- Scrapy เป็นตัวหนักสำหรับ crawling หลายพันหน้าอย่างมีประสิทธิภาพ
- Selenium และ Playwright เข้ามาช่วยเมื่อคุณต้องโต้ตอบกับเว็บที่ใช้ JavaScript หนัก ๆ หรือมีระบบ login
ในทางปฏิบัติ Python scraper ส่วนใหญ่มักผสมเครื่องมือเหล่านี้เข้าด้วยกัน เช่น Requests + Beautiful Soup สำหรับงานง่าย Scrapy สำหรับ crawl ขนาดใหญ่ และ Selenium/Playwright สำหรับเว็บ dynamic ที่จัดการยาก (ZenRows)
Python Data Scraper vs. Web Scraper บนเบราว์เซอร์ (Thunderbit): แบบไหนเหมาะกับคุณ?
Data Scraping คืออะไร และทำอย่างไร Get Started Free
ทีนี้มาถึงส่วนที่น่าสนใจ แม้ Python scraper จะยืดหยุ่นได้สูงสุด แต่ก็ไม่ได้เหมาะกับทุกสถานการณ์ โดยเฉพาะกับผู้ใช้ฝั่งธุรกิจที่ต้องการข้อมูลเร็ว และไม่อยากเจอความยุ่งยากทางเทคนิค นี่คือจุดที่เครื่องมือบนเบราว์เซอร์ซึ่งขับเคลื่อนด้วย AI อย่าง Thunderbit เข้ามา
ลองเปรียบเทียบสองแนวทางนี้แบบข้างต่อข้าง:
| ประเด็น | Python Data Scraper (เขียนโค้ด) | Thunderbit (AI No-Code Scraper) |
|---|---|---|
| Setup & Ease | ต้องมี programming, ความรู้ HTML และ custom code สำหรับแต่ละโปรเจกต์ | ไม่ต้องเขียนโค้ด ติดตั้ง Chrome extension ใช้ AI แนะนำ field แล้ว scrape ได้ในไม่กี่คลิก |
| Technical Skill | ต้องมี developer หรือความชำนาญด้าน scripting | สร้างมาสำหรับผู้ใช้ที่ไม่ใช่สายเทคนิค ใช้ natural language และ interface แบบ point-and-click |
| Customization | ไม่จำกัด เขียน logic หรือ processing แบบไหนก็ได้ | ยืดหยุ่นสำหรับ pattern ทั่วไป AI จัดการความต้องการส่วนใหญ่ได้ แต่ไม่ใช่สำหรับโค้ดเฉพาะทางมาก ๆ |
| Dynamic Content | ต้องใช้ Selenium/Playwright สำหรับ JavaScript หรือ login | รองรับในตัว ใช้กับ session ที่ login แล้วและหน้า dynamic ได้ทันที |
| Maintenance | สูง สคริปต์พังเมื่อเว็บไซต์เปลี่ยน ต้องแก้ไขต่อเนื่อง | ต่ำ AI ปรับตัวกับ layout ที่เปลี่ยนได้ และ Thunderbit ดูแล platform updates ให้ |
| Scalability | scale ได้ แต่ต้องจัดการ infrastructure, concurrency, proxies เอง | มี cloud scraping, parallel processing และ scheduling ในตัว ไม่ต้องดูแล infrastructure |
| Speed to Results | ช้า การเขียนโค้ด debug และ test อาจใช้เวลาหลายชั่วโมงหรือหลายวัน | ได้ผลทันที ตั้งค่าและรัน scrape ได้ในไม่กี่นาที พร้อม template สำหรับเว็บไซต์ยอดนิยม |
| Data Export | ต้องเขียน custom code เพื่อเชื่อม CSV/Excel/Sheets | export คลิกเดียวไปยัง Excel, Google Sheets, Airtable, Notion หรือ JSON |
| Cost | ไลบรารีฟรี แต่เวลาของ developer และ maintenance สะสมเป็นต้นทุนสูง | คิดแบบ subscription/credit-based แต่ช่วยลดแรงงานและ opportunity cost ได้มาก |
พูดแบบเข้าใจง่าย:
- Python scraper เหมาะมากถ้าคุณมี developer อยู่ใกล้ ๆ ต้องการ customization ลึก และไม่ติดเรื่อง maintenance ระยะยาว
- Thunderbit เหมาะกับผู้ใช้ธุรกิจที่ต้องการข้อมูลตอนนี้ ไม่ต้องเขียนโค้ด มี AI ช่วยแนะนำ field รองรับ subpage และ pagination พร้อม export ข้อมูลฟรีทันที
ลองใช้ Thunderbit AI Web Scraper ฟรี
ข้อจำกัดของ Python Data Scraper สำหรับผู้ใช้ธุรกิจ
พูดกันตรง ๆ: Python scraper ทรงพลัง แต่ไม่ได้เหมาะกับทุกคน นี่คือเหตุผลที่ผู้ใช้ธุรกิจจำนวนมากมักติดกำแพง:
- ต้องมีทักษะเขียนโค้ด: คนในทีม sales, marketing หรือ ops ส่วนใหญ่ไม่ได้เชี่ยวชาญ Python การต้องเรียนเขียนโค้ดเพื่อ scrape ข้อมูลบางอย่างจึงเป็นด่านที่สูงมาก
- ตั้งค่าใช้เวลานาน: แม้แต่คนเขียนโค้ดเอง การสร้างและ debug scraper ก็ใช้เวลา กว่าสคริปต์จะพร้อม ข้อมูลอาจล้าสมัยไปแล้ว
- เปราะบาง: เว็บไซต์เปลี่ยนตลอด class CSS ใหม่หรือ layout ที่ปรับเล็กน้อยอาจทำให้สคริปต์พังข้ามคืน แล้วคุณต้องรีบหาทางแก้
- ขยายสเกลยาก: อยาก scrape หลายร้อยหน้าทุกวันหรือไม่? ตอนนี้คุณต้องจัดการ loop, proxy, scheduling และ server management ซึ่งไม่ใช่เรื่องสนุกสำหรับคนที่ไม่ใช่สายเทคนิค
- ปัญหา environment: การติดตั้ง Python, libraries และ dependencies อาจเป็นเรื่องปวดหัวมากสำหรับผู้ใช้ที่ไม่ใช่สายเทคนิค
- ขาดความยืดหยุ่นแบบ real-time: ต้องเปลี่ยนข้อมูลที่ดึงหรือไม่? ถ้าใช้โค้ด ทุกการเปลี่ยนแปลงหมายถึงต้องแก้และรันสคริปต์ใหม่
- เสี่ยงเกิด error: ถ้าโค้ดไม่สมบูรณ์ ก็มีโอกาสดึงข้อมูลผิดหรือพลาดบางหน้าได้ง่าย
- ข้อกังวลด้าน compliance: ถ้าจัดการมารยาทในการ scraping ไม่ดี เช่น ไม่สนใจ
robots.txtก็อาจทำให้ IP ถูกแบนหรือเจอปัญหาที่หนักกว่า
ผลสำรวจชี้ว่า ต้นทุนแฝงที่ใหญ่ที่สุดของ web scraping แบบดั้งเดิมคือ maintenance เพราะ developer ต้องใช้เวลาหลายชั่วโมงแก้สคริปต์ที่พังทุกครั้งเมื่อเว็บไซต์อัปเดต (Skyvern) สำหรับคนที่ไม่เขียนโค้ด เรื่องนี้มักจัดการแทบไม่ไหว
ทำไมหลายธุรกิจจึงเปลี่ยนมาใช้ Thunderbit และ AI Web Scraper
วิธี Scrape เว็บไซต์ใดก็ได้ด้วย AI Get Started Free
เมื่อเห็น pain point ทั้งหมดนี้ จึงไม่น่าแปลกใจที่ธุรกิจตั้งแต่ startup ไปจนถึง enterprise หันมาใช้เครื่องมือ no-code ที่ขับเคลื่อนด้วย AI อย่าง Thunderbit มากขึ้น เหตุผลคือ:
- ประหยัดเวลาอย่างมาก: งานที่เคยต้องใช้เวลาหลายวันในการเขียนโค้ด ตอนนี้กลายเป็นกระบวนการ 2 คลิก ต้องการราคาคู่แข่งทุกเช้าหรือไม่? ตั้ง scheduled scrape ใน Thunderbit แล้วให้ข้อมูลส่งไปยัง Google Sheet ได้เลย โดยไม่ต้องให้คนคอยทำ
- ทำให้ทีมที่ไม่ใช่สายเทคนิคลงมือเองได้: ทีม sales, marketing และ ops สามารถดึงข้อมูลที่ต้องการได้ด้วยตัวเอง ลดภาระ IT และช่วยให้ตัดสินใจเร็วขึ้น
- ความฉลาดของ AI: แค่บอกสิ่งที่ต้องการ เช่น “product name, price, rating” แล้ว AI ของ Thunderbit จะหาวิธีดึงข้อมูลให้เอง รวมถึงจัดการ subpage และ pagination อัตโนมัติ
- ลด error: AI อ่าน context ของหน้าเว็บ จึงมักยืดหยุ่นกว่า selector ที่เขียนด้วยมือเมื่อเว็บไซต์เปลี่ยน layout ส่วน template สำเร็จรูปสำหรับเว็บไซต์ยอดนิยมก็ถูกดูแลจากส่วนกลาง ช่วยกันปัญหาพังที่พบบ่อยโดยไม่ต้องให้ผู้ใช้แต่ละคนไปแก้สคริปต์เอง
- มี best practices ในตัว: สำหรับเว็บไซต์ที่ต้อง login โหมด browser ของ Thunderbit จะทำงานใน Chrome session ที่คุณ authenticate แล้ว ทำให้ cookies และ session state ถูกใช้งานต่อได้ ส่วนงานขนาดใหญ่ โหมด cloud จะ rotate IP และควบคุมจังหวะ request ให้อยู่ในมารยาททั่วไปของ scraping แม้ว่า เช่นเดียวกับ scraper ทุกตัว เว็บไซต์ที่มี anti-bot defenses เข้มงวด เช่น Cloudflare หรือ hCaptcha ในสเกลใหญ่ ก็ยังอาจป้องกันได้
- Total Cost of Ownership ต่ำกว่า: เมื่อรวมเวลาของ developer, maintenance และ productivity ที่เสียไปแล้ว pricing แบบ subscription หรือ credit-based ของ Thunderbit มักถูกกว่า Python script ที่ดูเหมือน “ฟรี”
สถานการณ์จริง:
ทีมขายเคยต้องรอ IT หลายสัปดาห์เพื่อสร้าง custom scraper ตอนนี้ sales ops manager ใช้ Thunderbit scrape leads จากไดเรกทอรีได้เอง แล้ว export เข้า CRM โดยตรงภายในบ่ายเดียว ผลลัพธ์คือ outreach เร็วขึ้น และทีมทำงานสบายขึ้น
จะเลือก Data Scraper อย่างไร: Python หรือ Thunderbit?
แล้วเครื่องมือไหนเหมาะกับคุณ? ลองใช้กรอบตัดสินใจสั้น ๆ นี้:
- คุณมีความเชี่ยวชาญด้านโค้ดและมีเวลาหรือไม่?
- มี: Python scraper อาจเพียงพอ
- ไม่มี: Thunderbit คือเพื่อนที่ใช่
- งานนี้เร่งด่วนหรือทำซ้ำบ่อยหรือไม่?
- ต้องใช้ตอนนี้หรือใช้บ่อย: Thunderbit เร็วกว่า
- ครั้งเดียวและ custom มาก: Python อาจเหมาะ ถ้าคุณมีทักษะ
- ข้อมูลที่ต้องการเป็นแบบมาตรฐานหรือไม่ เช่น tables, lists, listings?
- ใช่: Thunderbit จัดการได้ง่าย
- ไม่ใช่ และ custom มาก: ใช้ Python หรือแนวทาง hybrid
- คุณต้องการ maintenance ต่ำหรือไม่?
- ใช่: Thunderbit
- ไม่: Python แต่ต้องพร้อมซ่อม
- สเกลของคุณเป็นอย่างไร?
- ปานกลาง: cloud mode ของ Thunderbit เหมาะมาก
- ใหญ่มาก: คุณอาจต้องใช้ custom solution
- งบประมาณเทียบกับต้นทุนภายใน:
- คำนวณต้นทุนจริง: developer 10 ชั่วโมง เทียบกับ subscription ของ Thunderbit หลายครั้ง Thunderbit ชนะ
Checklist:
- ไม่มีทักษะเขียนโค้ด? Thunderbit
- ต้องการข้อมูลเร็ว? Thunderbit
- อยากเลี่ยง maintenance? Thunderbit
- ต้องการ customization ลึกและมี developer? Python
ลองใช้ Thunderbit เพื่อ Web Scraping ที่ง่ายขึ้น
Key Takeaways: ทำให้ Data Scraping ใช้ได้จริงกับธุรกิจของคุณ
มาสรุปกัน:
- Python data scraper ทรงพลัง ยืดหยุ่น และเหมาะกับ developer ที่ต้องการ custom solution แต่ต้องเขียนโค้ด ดูแลต่อเนื่อง และอาจใช้เวลานานกว่าจะตั้งค่าเสร็จ
- Thunderbit และ scraper บนเบราว์เซอร์ที่ขับเคลื่อนด้วย AI ทำให้ทุกคนเข้าถึงข้อมูลจากเว็บได้ ไม่ต้องเขียนโค้ด ตั้งค่าได้ทันที และมี best practices ในตัว เหมาะกับทีม sales, marketing และ ops ที่ต้องการผลลัพธ์ตอนนี้
- เครื่องมือที่เหมาะขึ้นอยู่กับความต้องการของคุณ: ถ้าคุณให้ค่ากับความเร็ว ความง่าย และ maintenance ต่ำ Thunderbit เป็นตัวเลือกที่ชัดเจน แต่ถ้าต้องการ customization ลึกและมี resource ด้านเทคนิค Python ก็ยังมีที่ทางของมัน
- ลองก่อนตัดสินใจ: Thunderbit มี free tier ลองใช้ดู แล้วดูว่าคุณไปจาก “ฉันต้องการข้อมูลนี้” เป็น “นี่คือ spreadsheet ของฉัน” ได้เร็วแค่ไหน
ในโลกที่ขับเคลื่อนด้วยข้อมูลทุกวันนี้ ความสามารถในการเปลี่ยนความวุ่นวายบนเว็บให้เป็น insight ทางธุรกิจคือพลังพิเศษ ไม่ว่าคุณจะเขียนสคริปต์เองหรือให้ AI จัดการ เป้าหมายก็เหมือนกัน: ได้ข้อมูลที่ต้องการ ในเวลาที่ต้องใช้ ด้วยแรงเสียดทานให้น้อยที่สุด
อยากเห็นไหมว่า web scraping ทำได้ง่ายแค่ไหน? ดาวน์โหลด Thunderbit Chrome Extension แล้วเริ่ม scrape ให้ฉลาดขึ้น ไม่ใช่เหนื่อยขึ้น และถ้าอยากอ่านเทคนิคเพิ่มเติมเกี่ยวกับข้อมูลบนเว็บ ดูได้ที่ Thunderbit Blog
FAQs
1. Python data scraper คืออะไร?
Python data scraper คือสคริปต์หรือโปรแกรมที่เขียนด้วย Python เพื่อเก็บข้อมูลจากเว็บไซต์แบบอัตโนมัติ มันดึงหน้าเว็บ parse เนื้อหา แล้วดึงข้อมูลเฉพาะ เช่น ราคา อีเมล หรือรูปภาพ ออกมาเป็นรูปแบบมีโครงสร้างสำหรับวิเคราะห์
2. ประโยชน์หลักของการใช้ Python data scraper คืออะไร?
Python scraper ช่วยทำงานเก็บข้อมูลที่น่าเบื่อให้เป็นอัตโนมัติ รองรับการดึงข้อมูลจากเว็บในสเกลใหญ่ และปรับแต่งได้สำหรับความต้องการทางธุรกิจที่ซับซ้อนหรือเฉพาะทาง มักใช้กับ lead generation, competitor monitoring และ market research
3. Python data scraper มีข้อจำกัดอะไรสำหรับผู้ใช้ธุรกิจ?
มันต้องใช้ทักษะเขียนโค้ด ใช้เวลาตั้งค่านาน และมักพังเมื่อเว็บไซต์เปลี่ยน Maintenance และ scaling อาจเป็นเรื่องท้าทายสำหรับผู้ใช้ที่ไม่ใช่สายเทคนิค จึงไม่เหมาะกับทีมที่ไม่มี developer คอยช่วย
4. Thunderbit เทียบกับ Python data scraper อย่างไร?
Thunderbit คือ AI-powered no-code web scraper ที่ช่วยให้ทุกคนดึงข้อมูลจากเว็บไซต์ได้ในไม่กี่คลิก รองรับ dynamic content, subpages และ scheduling อัตโนมัติ พร้อม export ทันทีไปยัง Excel, Google Sheets และอื่น ๆ โดยไม่ต้องเขียนโค้ดหรือดูแล maintenance
5. ควรเลือก Python data scraper หรือ Thunderbit อย่างไร?
ถ้าคุณมีทักษะเทคนิคและต้องการ customization ลึก Python scraper อาจเหมาะกว่า แต่ถ้าต้องการความเร็ว ความง่าย และ maintenance ต่ำ โดยเฉพาะ use case ธุรกิจมาตรฐาน Thunderbit เป็นตัวเลือกที่ดีกว่า ลองใช้ free tier ของ Thunderbit เพื่อดูว่าคุณได้ผลลัพธ์เร็วแค่ไหน
ลองใช้ Thunderbit AI Web Scraper ฟรี Get Started Free




