
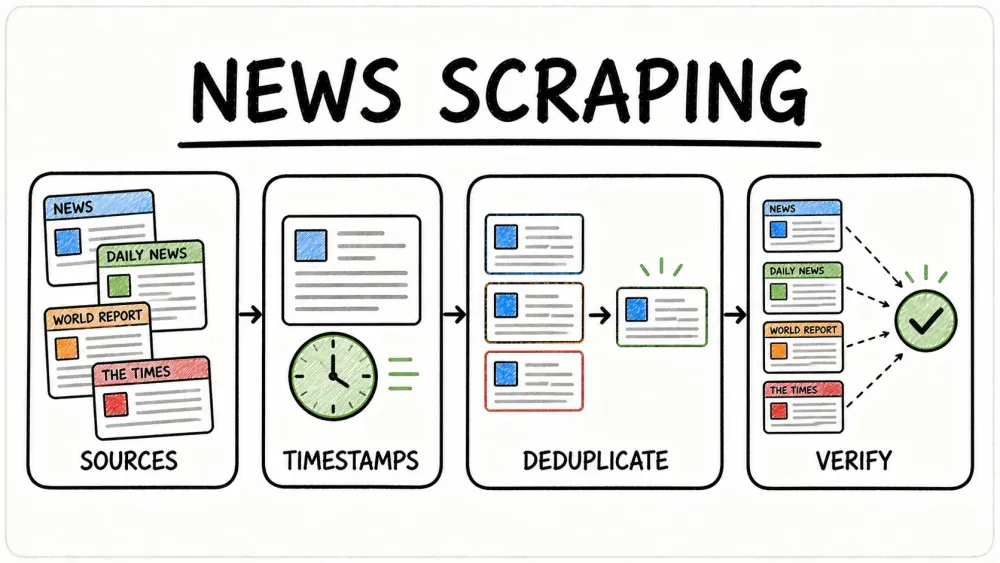
จังหวะของข่าวสารดิจิทัลในปัจจุบันเร็วเสียจนแทบตามไม่ทัน ทุก ๆ นาทีมีพาดหัวข่าวนับพันถูกเผยแพร่ อัปเดต หรือแอบแก้ไขอยู่เงียบ ๆ — ทั้งจากสำนักข่าวกระแสหลัก บล็อกเฉพาะทาง ไปจนถึงโซเชียลฟีด
ถ้าจะให้เห็นภาพ LexisNexis Newsdesk รับข่าวสารเข้าไปมากกว่า 4 ล้านบทความต่อวัน ขณะที่ GDELT Project ติดตามข่าวใน กว่า 100 ภาษา และอัปเดตฟีดทั่วโลกทุก ๆ 15 นาที
สำหรับคนทำงานด้านสื่อ งานวิจัย หรือ business intelligence การพยายามตามข่าวให้ทันด้วยมือเปล่าก็เหมือนพยายามตักน้ำจากเรือที่กำลังจมด้วยแก้วกาแฟใบเดียว
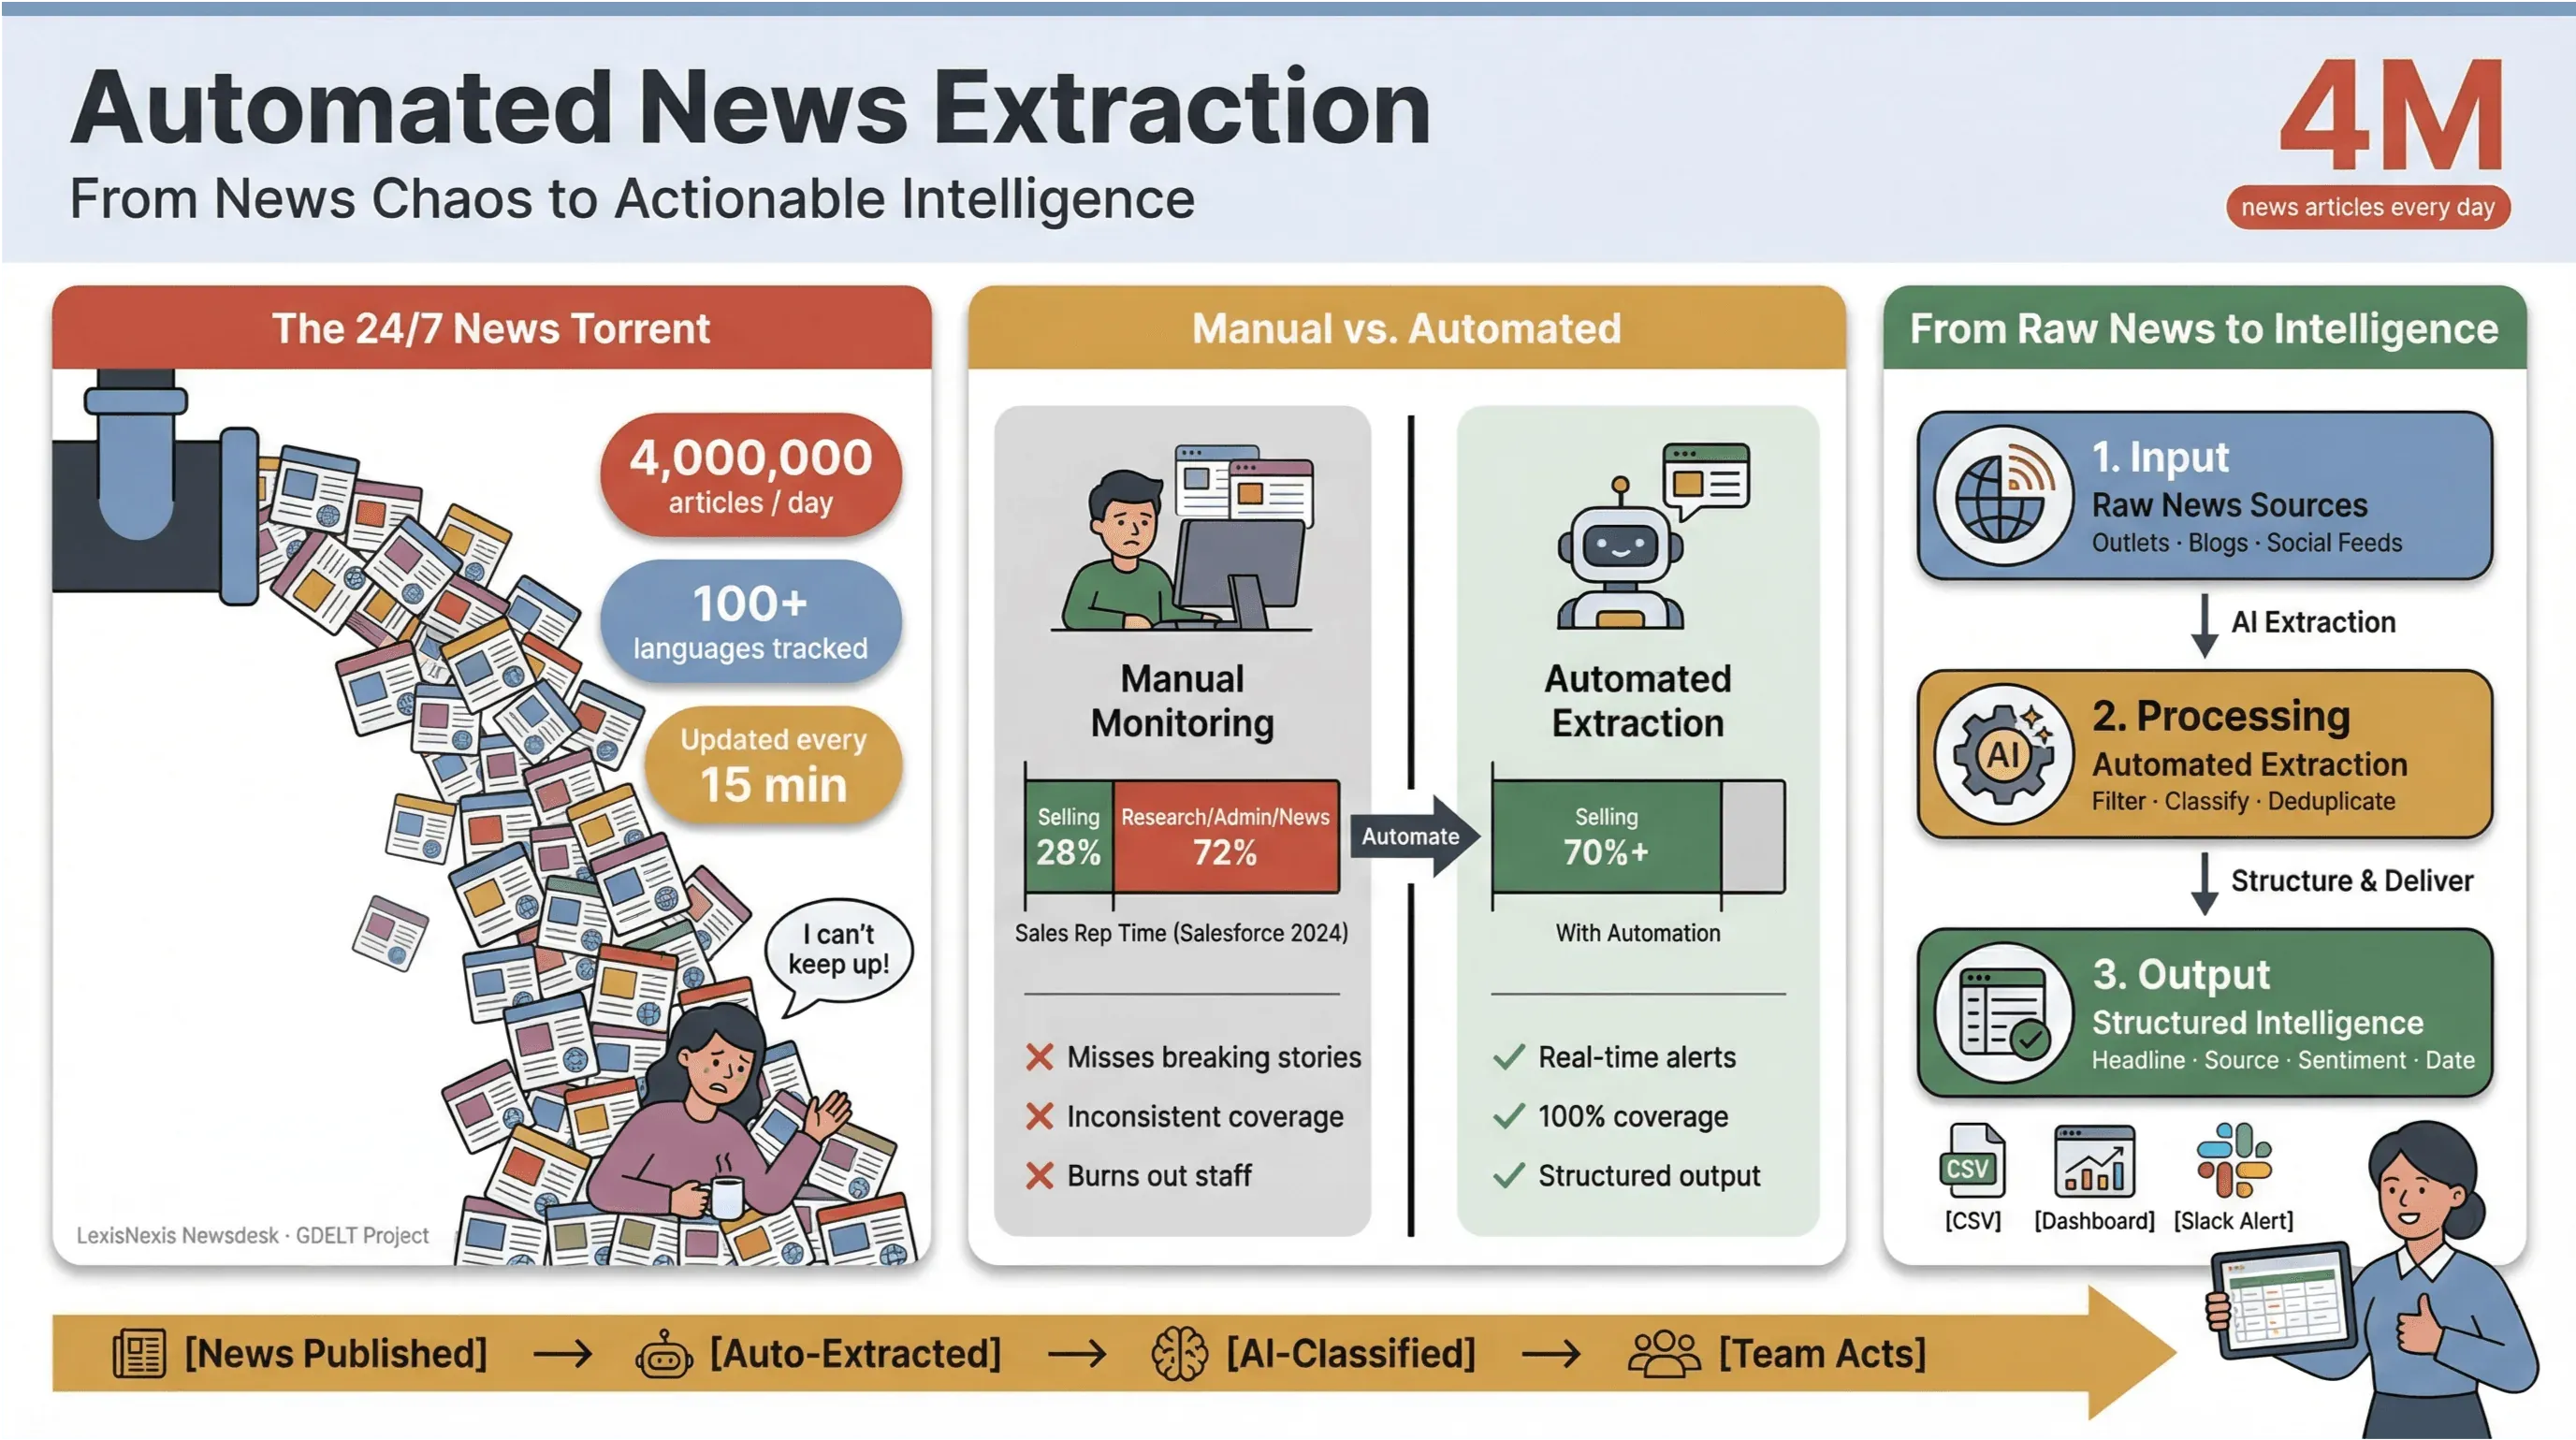
จากประสบการณ์ตรง ฉันเห็นชัดว่าการเฝ้าติดตามข่าวแบบ manual กินทั้งเวลาและทรัพยากร ทีมขายใช้เวลาน้อยกว่าหนึ่งในสามของสัปดาห์ไปกับการขายจริง ๆ — เพียง 28% ตามข้อมูลของ Salesforce — ที่เหลือหมดไปกับการค้นคว้า งานเอกสาร และแน่นอน การสลับแท็บข่าวแบบไม่มีที่สิ้นสุด
นั่นคือเหตุผลที่การดึงข่าวแบบอัตโนมัติกลายเป็นอาวุธลับของทีมยุคใหม่ เพราะมันคือวิธีเดียวที่จะเปลี่ยนความโกลาหลของข่าว 24/7 ให้กลายเป็นข้อมูลเชิงลึกที่มีโครงสร้างและพร้อมใช้งาน โดยไม่ต้องเผาแรงคนหรือพลาดเรื่องสำคัญ
มาดูกันว่า automated news extraction คืออะไร ทำไมจึงสำคัญสำหรับคนที่ต้องพึ่งพาข่าวแบบเรียลไทม์ และจะสร้างเวิร์กโฟลว์ที่แข็งแรงและสอดคล้องกับข้อกำหนดได้อย่างไรด้วยเครื่องมือที่ดีที่สุด รวมถึงวิธีที่ Thunderbit ทำให้ทุกอย่างง่ายอย่างน่าตกใจ — แม้แต่กับคนที่ไม่ถนัดเทคอย่างแม่ของฉัน
ลองใช้ Thunderbit สำหรับการดึงข่าวแบบอัตโนมัติ ดึงหัวข้อข่าว เวลา ผู้เขียน และสรุปจากหน้าข่าวใดก็ได้ — คลิกครั้งเดียวแล้วตั้งเวลาให้ทำซ้ำได้ Get Started Free
การดึงข่าวแบบอัตโนมัติ: ทำไมจึงจำเป็นต่อห้องข่าวยุคใหม่
Automated news extraction คือการใช้ซอฟต์แวร์ เก็บรวบรวมเนื้อหาข่าวโดยอัตโนมัติ แล้วแปลงให้เป็นข้อมูลที่มีโครงสร้าง ค้นหาได้ง่าย — นึกถึงแถวและคอลัมน์ แทนที่จะเป็นหน้าเว็บรก ๆ หรือไฟล์ PDF ในทางปฏิบัติ หมายความว่าคุณสามารถติดตามแหล่งข่าวนับร้อยหรือนับพัน ดึงฟิลด์สำคัญอย่างหัวข้อข่าว เวลา ผู้เขียน และเนื้อหาบทความ แล้วส่งข้อมูลนั้นไปยังแดชบอร์ด ระบบแจ้งเตือน หรือระบบวิเคราะห์ต่อเนื่องได้ โดยไม่ต้องกด Ctrl+C/Ctrl+V เลยแม้แต่ครั้งเดียว
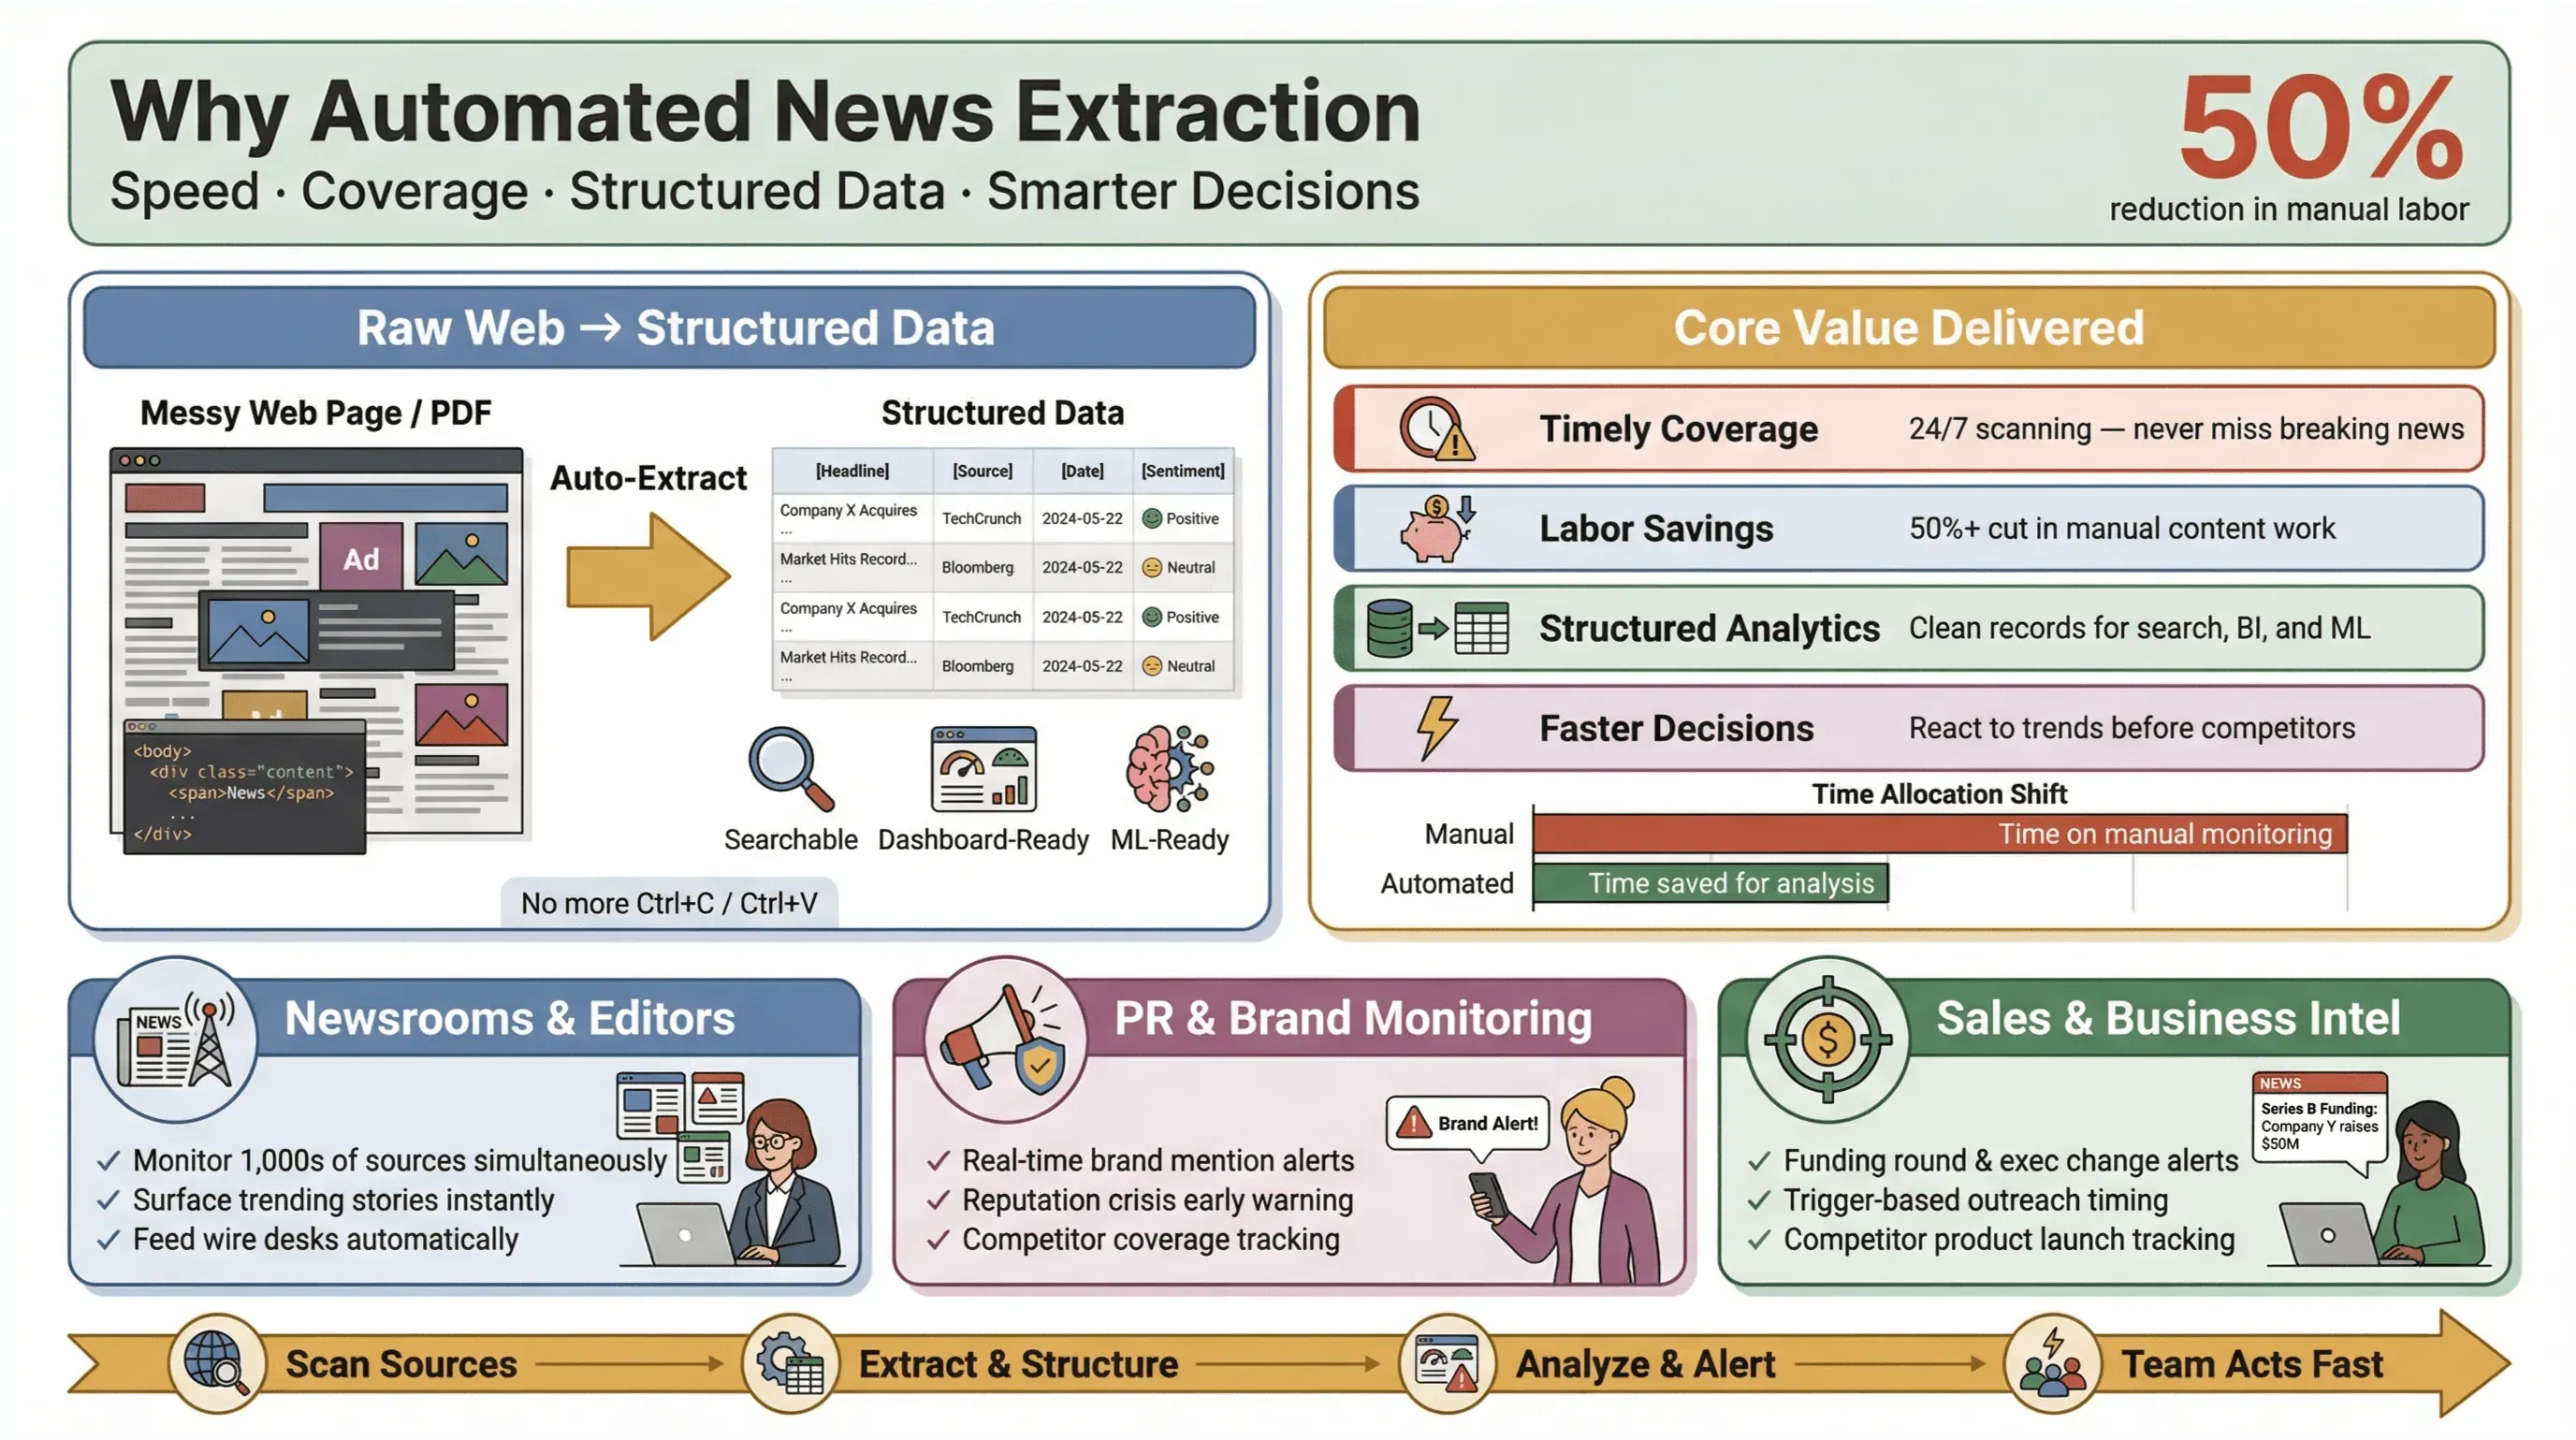 ทำไมเรื่องนี้ถึงสำคัญ? เพราะในโลกข่าวทุกวันนี้ ความเร็วคือทุกอย่าง ไม่ว่าคุณจะเป็นบรรณาธิการในห้องข่าว ผู้จัดการ PR ที่ต้องจับตาแบรนด์เมนชัน หรือ analyst ฝั่งธุรกิจที่ติดตามความเคลื่อนไหวของคู่แข่ง การรู้ก่อนย่อมหมายถึงความได้เปรียบระหว่างการคว้าโอกาสกับการไล่ตามคนอื่น เครื่องมือดึงข้อมูลอัตโนมัติช่วยให้ทีมเล็ก ๆ ทำงานได้เกินตัว — เก็บข่าวเรียลไทม์จากทั่วเว็บ ลดงาน manual และดึงเรื่องสำคัญขึ้นมาให้เห็นเด่นชัด
และผลลัพธ์ก็จับต้องได้: งานวิจัยหลายชิ้นชี้ว่า automation ช่วยลดแรงงาน manual สำหรับการอัปเดตคอนเทนต์ได้ อย่างน้อย 50% ทำให้มีเวลาไปโฟกัสกับการวิเคราะห์และการตัดสินใจจริง ๆ
คุณค่าหลักของการดึงข่าวอัตโนมัติในอุตสาหกรรมข่าว
มาดูแบบใช้งานจริงกันว่า automated news extraction ช่วยอะไรทีมข่าวและทีมธุรกิจได้บ้าง
- ครอบคลุมทันเวลาและครบถ้วน: ไม่พลาดข่าวด่วนเพราะมีคนลืมเช็กฟีด เครื่องมืออัตโนมัติสแกนแหล่งข่าวตลอด 24/7
- ประหยัดแรงและต้นทุน: ทีมขนาดเล็กถึงกลางสามารถติดตามแหล่งข่าวได้มากพอ ๆ กับองค์กรใหญ่ โดยไม่ต้องจ้างคนเพิ่มจำนวนมาก
- ข้อมูลมีโครงสร้างสำหรับการวิเคราะห์: แทนที่จะต้องคัดแยกบทความที่ไม่มีโครงสร้าง คุณจะได้เรคคอร์ดที่สะอาด พร้อมใช้กับการค้นหา แดชบอร์ด และ machine learning
- ตัดสินใจได้เร็วและฉลาดขึ้น: ข่าวแบบเรียลไทม์ช่วยให้คุณตอบสนองต่อความเปลี่ยนแปลงของตลาด วิกฤต PR หรือเทรนด์ที่กำลังก่อตัว ก่อนคู่แข่ง
ลองดูฝั่ง PR และการสื่อสาร: แพลตฟอร์มอย่าง Cision และ Meltwater วางตำแหน่งการเฝ้าระวังสื่อแบบเรียลไทม์ว่าเป็นสิ่งจำเป็นต่อการปกป้องชื่อเสียงและรับมือกับคอนเทนต์เชิงลบได้อย่างรวดเร็ว ส่วนในงานขาย ข่าวเรียลไทม์จะกลายเป็น “context cards” สำหรับ prospecting เช่น รอบระดมทุน การเปลี่ยนตัวผู้บริหาร หรือการเปิดตัวสินค้า ซึ่งช่วยให้เข้าหาลูกค้าได้ถูกจังหวะ
วิธีเลือกเครื่องมือดึงข่าวให้เหมาะกับแต่ละสถานการณ์
เครื่องมือดึงข่าวไม่ได้เหมือนกันทั้งหมด การเลือกที่เหมาะขึ้นอยู่กับเป้าหมาย ความถนัดด้านเทคนิค และประเภทข่าวที่คุณสนใจ นี่คือกรอบคิดเพื่อช่วยตัดสินใจ
- ประเมินความง่ายในการใช้งานและการเข้าถึง
- พิจารณาความปลอดภัยและความเป็นส่วนตัวของข้อมูล
- เลือกเครื่องมือให้ตรงกับประเภทข่าวและความต้องการของอุตสาหกรรม
ประเมินความง่ายในการใช้งานและการเข้าถึง
สำหรับผู้ใช้ธุรกิจและนักข่าวส่วนใหญ่ ความง่ายในการใช้งานเป็นเรื่องต่อรองไม่ได้ คุณต้องการเครื่องมือที่ใช้งานได้ทันที ไม่ต้องเขียนโค้ดหรือเซ็ตอัปซับซ้อน แพลตฟอร์มแบบ no-code และ low-code อย่าง Thunderbit, Octoparse และ ParseHub ช่วยให้คุณสร้าง scraper ได้แบบเห็นภาพ แค่ชี้ คลิก แล้วดึงข้อมูล
โดยเฉพาะ Thunderbit โดดเด่นด้วย เวิร์กโฟลว์คลิกเดียว: กด One Click Extract แล้ว AI จะอ่านหน้าเว็บ วิเคราะห์ฟิลด์ที่ควรดึง และดึงข้อมูลออกมาให้ แม้แต่ผู้ใช้ที่ไม่ใช่สายเทคนิคก็สามารถตั้ง pipeline ข่าวได้ในไม่กี่นาที ไม่ใช่เป็นชั่วโมง
พิจารณาความปลอดภัยและความเป็นส่วนตัวของข้อมูล
เมื่อได้ข้อมูลมาก ก็ต้องรับผิดชอบมากเช่นกัน เครื่องมือดึงข่าวมักเข้าถึงคอนเทนต์ที่ละเอียดอ่อน ดังนั้น ความปลอดภัยและ compliance ต้องมาก่อนเสมอ สิ่งที่ควรมองหา ได้แก่
- การเข้ารหัสข้อมูล ทั้งระหว่างส่งและเมื่อจัดเก็บ
- นโยบายความเป็นส่วนตัวที่ชัดเจน (เช่น Thunderbit ระบุว่าไม่ขายข้อมูลผู้ใช้ และเข้าถึงเฉพาะคอนเทนต์ที่คุณเลือกให้ดึงเท่านั้น)
- สิทธิ์การเข้าถึงแบบละเอียด โดยเฉพาะส่วนขยายเบราว์เซอร์ — ตรวจสอบเสมอว่าเครื่องมือเข้าถึงข้อมูลอะไรได้บ้าง
- สอดคล้องกับกฎหมายท้องถิ่น (GDPR, CCPA และสำหรับผู้ใช้ในสหภาพยุโรปคือ DSM Copyright Directive)
เพื่อความอุ่นใจเพิ่มเติม ควรเลือกผู้ให้บริการที่น่าเชื่อถือ ตรวจสอบ permission ของส่วนขยาย และจำกัดสิทธิ์เข้าถึงเท่าที่จำเป็นเท่านั้น
เลือกเครื่องมือให้ตรงกับประเภทข่าวและความต้องการของอุตสาหกรรม
เครื่องมือบางตัวเหมาะกับข่าวบางประเภทมากเป็นพิเศษ:
- การเงิน: APIs อย่าง News API และ AYLIEN มีฟีเจอร์ clustering, sentiment และการตรวจจับ event สำหรับข่าวการเงิน
- เทคโนโลยีและสตาร์ทอัป: การดึงข้อมูลแบบกำหนดเองด้วย Thunderbit หรือ Octoparse เหมาะกับบล็อกเฉพาะทาง ข่าวประชาสัมพันธ์ หรือรายการอีเวนต์
- การเมืองและนโยบาย: ฐานข้อมูลแบบมีลิขสิทธิ์ เช่น Factiva และ LexisNexis ให้การเข้าถึงแหล่งข่าวพรีเมียมและคลังข่าวย้อนหลัง
ถ้าคุณต้องติดตามทั้งแหล่งข่าวกระแสหลัก เฉพาะทาง และต่างประเทศ รวมถึงแหล่งที่ไม่มี API เครื่องมือ AI ที่ยืดหยุ่นอย่าง Thunderbit คือคำตอบที่คุ้มค่าที่สุด
ข้อได้เปรียบเฉพาะตัวของ Thunderbit สำหรับการดึงข่าวแบบเรียลไทม์
ดึงข้อมูลข่าวแบบเรียลไทม์ด้วย Thunderbit AI อ่านหน้าเว็บและวิเคราะห์ฟิลด์ให้อัตโนมัติ — ไม่ต้องคอยปรับ selector ทุกครั้งที่สำนักข่าวปรับหน้าเว็บ Get Started Free
ทีนี้มาดูกันว่าอะไรทำให้ Thunderbit เป็นตัวเลือกที่โดดเด่นสำหรับ automated news extraction โดยเฉพาะถ้าคุณต้องการ ข่าวแบบเรียลไทม์ โดยไม่ต้องปวดหัวกับเรื่องเทคนิค
Thunderbit คือ Chrome Extension สำหรับ AI web scraper ที่ออกแบบมาสำหรับผู้ใช้ธุรกิจ นักข่าว และ analyst ที่ต้องการคอนเทนต์ข่าวที่เป็นโครงสร้างและอัปเดตล่าสุดจากทุกเว็บไซต์ นี่คือเหตุผลที่ฉันใช้มันเป็นตัวหลัก:
- One Click Extract: Thunderbit อ่านหน้าข่าวและหาคอลัมน์ที่เหมาะสมที่สุดให้เอง เช่น หัวข้อข่าว เวลา ผู้เขียน สรุป และอื่น ๆ ไม่ต้องเสียเวลาจัดการ selector หรือ template
- Subpage Scraping: ถ้าต้องการบทความฉบับเต็ม ไม่ใช่แค่พาดหัว Thunderbit สามารถเข้าไปในลิงก์ข่าวแต่ละชิ้น ดึงเนื้อหาบทความ เอนทิตี และแท็ก แล้วรวมทุกอย่างเป็นตารางที่มีโครงสร้างเดียวกัน
- Bulk Export & Instant Updates: ส่งออกข้อมูลข่าวไปยัง Excel, Google Sheets, Airtable หรือ Notion ได้ด้วยคลิกเดียว ไม่ต้องเสียเวลาคัดลอกวางหรือจัดการ CSV แบบวุ่นวาย
- Scheduled Scraping: ตั้งงานให้รันซ้ำรายชั่วโมง รายวัน หรือกำหนดช่วงเวลาเอง เพื่อให้ pipeline ข่าวของคุณสดใหม่อยู่เสมอ เหมาะกับข่าวด่วน การเฝ้าติดตามตลาด หรือการวิจัยต่อเนื่อง
- Adaptability: AI ของ Thunderbit ปรับตัวกับการเปลี่ยนแปลงของเลย์เอาต์และเว็บไซต์ข่าวเฉพาะกลุ่มได้ดี ทำให้คุณเสียเวลาซ่อม scraper น้อยลง และมีเวลาไปวิเคราะห์ข้อมูลมากขึ้น
ด้วยผู้ใช้งานกว่า 100,000+ คน บน Chrome Web Store มันถูกใช้งานโดยทีม PR นักวิจัยฝ่ายขาย และ analyst ที่ต้องการข้อมูลข่าวโดยไม่ต้องคอยดูแล scraper ตลอดเวลา
การตรวจจับฟิลด์ด้วย AI และการดึงข้อมูลจากซับเพจ
หนึ่งในฟีเจอร์เด่นของ Thunderbit คือ การตรวจจับฟิลด์ด้วย AI แค่กด “One Click Extract” เครื่องมือจะสแกนหน้าข่าวและระบุฟิลด์สำคัญ เช่น ชื่อเรื่อง วันที่ ผู้เขียน และสรุป คุณสามารถปรับแต่งหรือเพิ่มฟิลด์เองได้ เช่น “แท็กบทความนี้ว่า earnings ถ้าพูดถึงผลประกอบการรายไตรมาส” จากนั้น AI ของ Thunderbit จะจัดการที่เหลือให้
การดึงข้อมูลจากซับเพจถือเป็นเกมเชนเจอร์สำหรับข่าว: ดึงรายการพาดหัวจากหน้าโฮมเพจหรือหมวดข่าวก่อน แล้วให้ Thunderbit เข้าไปยัง URL ของแต่ละบทความเพื่อดึงเนื้อหาเต็ม เอนทิตี และแม้แต่รูปภาพออกมา สิ่งนี้ทำให้คุณได้ เรคคอร์ดข่าวที่ครบถ้วนและมีคุณค่าเพิ่ม พร้อมใช้กับการค้นหา แดชบอร์ด หรือการวิเคราะห์ด้วย AI ต่อเนื่อง
การส่งออกแบบจำนวนมากและการอัปเดตแบบทันที
Thunderbit ทำให้การส่งออกข้อมูลข่าวเป็นเรื่องง่ายอย่างมาก แค่คลิกครั้งเดียว คุณสามารถส่งฟีดข่าวที่มีโครงสร้างไปยัง Google Sheets, Airtable, Notion หรือดาวน์โหลดเป็น CSV/Excel ได้ สำหรับทีมที่ทำงานอยู่ในสเปรดชีตหรือ BI tools นี่ช่วยประหยัดเวลาได้มหาศาล
และเพราะ Thunderbit รองรับ scheduled scraping คุณจึงตั้งให้รันทุกชั่วโมง ทุกวัน หรือกำหนดเองได้ เพื่อให้ข้อมูลข่าวของคุณอัปเดตอยู่ตลอดเวลา ไม่ต้องรอ Google Alerts จนข่าวตกกระแสไปแล้วหลายวัน
วิธีรับมือกับความท้าทายเชิงปฏิบัติในการดึงข่าวแบบเรียลไทม์
แม้จะมีเครื่องมือดีแค่ไหน การดึงข่าวแบบเรียลไทม์ก็ยังมีความท้าทายเฉพาะตัว นี่คือวิธีรับมือกับปัญหาที่พบบ่อยที่สุด
จัดการความหน่วงและความสดใหม่ของข้อมูล
- ตั้งรอบดึงข้อมูลให้สอดคล้องกับความเร็วของข่าว: สำหรับข่าวด่วน ให้รัน scraper ทุก 15–30 นาที (ใกล้เคียงกับรอบอัปเดตของ GDELT Project) ส่วนข่าวที่เคลื่อนไหวช้ากว่าอาจใช้รายวันหรือรายชั่วโมงก็พอ
- ตรวจสอบช่องว่างระหว่างเวลาที่เผยแพร่กับเวลาที่ดึงมา: ติดตามความต่างระหว่างเวลาที่บทความถูกเผยแพร่กับเวลาที่ระบบของคุณดึงข้อมูล หากช่องว่างมากขึ้น ให้ตรวจสอบว่ามีการบล็อกหรือระบบช้าลงหรือไม่
- ดึงซ้ำเพื่อจับ “การแก้ไขแบบเงียบ ๆ”: บทความข่าวมักถูกอัปเดตหลังเผยแพร่แล้ว ให้ตั้งดึงซ้ำอีกครั้งหลัง 24 ชั่วโมงเพื่อจับการแก้ไขหรือการเปลี่ยนแปลงที่ไม่ประกาศ (GDELT ออกแบบมาให้ทำเช่นนี้)
รับมือกับขีดจำกัดของ API และความหลากหลายของแหล่งข้อมูล
- เคารพโควตาของ API: ถ้าคุณใช้ news APIs ให้ระวัง rate limit กระจายคำขอออกไปตามเวลา และแคชผลลัพธ์เมื่อเป็นไปได้ (เอกสาร News API)
- กำจัดข้อมูลซ้ำและทำ canonicalization: ข่าวเดียวกันมักปรากฏหลาย URL หรือถูกอัปเดต ให้เก็บ canonical URL และใช้ hash เช่น ชื่อเรื่อง + วันที่ เพื่อหลีกเลี่ยงข้อมูลซ้ำ (คู่มือ canonicalization ของ Google)
- จัดการคอนเทนต์แบบไดนามิก: สำหรับเว็บไซต์ที่มี infinite scroll หรือ lazy loading ให้ใช้เครื่องมือที่รองรับการ render แบบ dynamic และเฝ้าดูการเปลี่ยนแปลงของเลย์เอาต์ (คู่มือของ Octoparse)
การวิเคราะห์ข้อมูลข่าวอย่างชาญฉลาด: บทบาทของ AI และ Machine Learning
การดึงข่าวเป็นเพียงก้าวแรกเท่านั้น คุณค่าจริงเกิดขึ้นเมื่อคุณ วิเคราะห์และนำข้อมูลนั้นไปใช้ — และตรงนี้เองที่ AI และ machine learning จะโดดเด่น
- Entity extraction: ใช้ NLP เพื่อดึงชื่อบุคคล องค์กร และสถานที่ที่ถูกกล่าวถึงในแต่ละบทความ (คู่มือของ Google Cloud)
- Topic classification: ติดแท็กบทความโดยอัตโนมัติตามหัวข้อ อารมณ์ หรือความเร่งด่วน เพื่อสร้างแดชบอร์ดและการแจ้งเตือนที่ฉลาดขึ้น (เอกสาร taxonomy ของ AYLIEN)
- Event clustering: รวมข่าวซ้ำหรือข่าวที่เกี่ยวข้องจากหลายสำนักเข้าด้วยกัน เพื่อให้เห็นภาพใหญ่ ไม่ใช่แค่พาดหัวที่เหมือนกันเต็มไปหมด
- Personalization และ targeting: ใช้ข้อมูลข่าวแบบเรียลไทม์เพื่อแบ่งกลุ่มผู้ชม ปรับปรุงการยิงโฆษณา หรือแนะนำคอนเทนต์ ซึ่งช่วยเพิ่ม engagement และ ROI
ตัวอย่างเช่น ทีม PR ใช้ news analytics แบบเรียลไทม์เพื่อจับสัญญาณวิกฤตที่กำลังก่อตัวก่อนที่มันจะกลายเป็นไวรัล ส่วนทีมขายใช้ข่าวมาป้อนข้อมูลเชิงลึกให้รายชื่อ prospect ด้วย “trigger events” อย่างการระดมทุนหรือการจ้างผู้บริหารใหม่
เช็กลิสต์แนวปฏิบัติที่ดีที่สุดสำหรับการดึงข่าวแบบอัตโนมัติ
นี่คือเช็กลิสต์สั้น ๆ สำหรับช่วยให้ pipeline การดึงข่าวของคุณทำงานได้ลื่นไหล
| แนวปฏิบัติที่ดีที่สุด | เหตุผลที่สำคัญ | วิธีนำไปใช้ |
|---|---|---|
| ตั้งรอบดึงข้อมูลถี่ ๆ | ลดความล่าช้าของข้อมูลและจับข่าวด่วนให้ทัน | กำหนดความถี่ให้เหมาะกับความเร็วของข่าว เช่น ทุก 15 นาทีสำหรับข่าวเร็ว |
| ใช้การดึงข้อมูลด้วย AI | ปรับตัวต่อการเปลี่ยนเลย์เอาต์และลดเวลาเซ็ตอัป | ใช้เครื่องมืออย่าง Thunderbit, Diffbot, Zyte API |
| กำจัดข้อมูลซ้ำและทำ canonicalization | ลด alert ซ้ำและทำให้ข้อมูลสะอาด | เก็บ canonical URL และใช้ hash สำหรับ dedupe |
| ตรวจสอบคุณภาพการดึงข้อมูล | จับฟิลด์ที่หายไป ความคลาดเคลื่อน หรือความล้มเหลว | ติดตามเปอร์เซ็นต์เรคคอร์ดที่ครบถ้วน ความหน่วง และอัตรา error |
| เคารพข้อกำหนดทางกฎหมายและ compliance | ลดความเสี่ยงทางกฎหมายและรักษาความน่าเชื่อถือ | ใช้ API/feed ทางการเมื่อมี ตรวจสอบเงื่อนไข และลดข้อมูลส่วนบุคคล |
| ส่งออกเป็นรูปแบบที่มีโครงสร้าง | พร้อมใช้ต่อในระบบวิเคราะห์ | CSV, Excel, Sheets, Notion, Airtable |
| ตั้งดึงซ้ำสำหรับบทความที่มีการแก้ไข | จับการเปลี่ยนแปลงหลังเผยแพร่ | กลับไปดึงซ้ำหลัง 24 ชม./1 สัปดาห์ (ตามโมเดลของ GDELT) |
| ปกป้อง pipeline ของคุณ | ปกป้องข้อมูลอ่อนไหว | เข้ารหัส ควบคุมสิทธิ์ และใช้เครื่องมือที่น่าเชื่อถือ |
สร้างเวิร์กโฟลว์การดึงข่าวอัตโนมัติที่แข็งแรง
พร้อมจะสร้าง “กล่องดำ” สำหรับข้อมูลข่าวของตัวเองหรือยัง? นี่คือเวิร์กโฟลว์แบบทีละขั้นตอน
- ระบุแหล่งข้อมูลของคุณ: ทำรายการเว็บไซต์ข่าว บล็อก หรือ APIs ที่ต้องการติดตาม
- ตั้งค่าการดึงข้อมูล: ใช้ Thunderbit หรือเครื่องมือที่ถนัดเพื่อกำหนดฟิลด์ (One Click Extract ช่วยให้ขั้นตอนนี้ง่ายมาก)
- ตั้งเวลาการดึง: กำหนดความถี่ตามความเร็วของข่าว — รายชั่วโมงสำหรับข่าวด่วน หรือรายวันสำหรับข่าวที่เคลื่อนไหวช้า
- เพิ่มข้อมูลจากซับเพจ: สำหรับทุกหัวข้อข่าว ให้ดึงบทความฉบับเต็มเพื่อเอาเนื้อหา เอนทิตี และแท็ก
- กำจัดข้อมูลซ้ำและทำให้เป็นมาตรฐาน: เก็บ canonical URL ทำ hash ของเรคคอร์ด และทำให้ฟิลด์ต่าง ๆ อยู่ในรูปแบบเดียวกัน
- ส่งออกและเชื่อมต่อระบบ: ส่งข้อมูลที่มีโครงสร้างไปยัง Excel, Google Sheets, Airtable หรือ Notion เพื่อการวิเคราะห์
- ติดตามและปรับ: ตรวจคุณภาพการดึงข้อมูล เฝ้าดูการเปลี่ยนเลย์เอาต์ และปรับตามความจำเป็น
- รักษา compliance: ตรวจสอบเงื่อนไขการใช้งาน เคารพ robots.txt และเก็บข้อมูลส่วนบุคคลให้น้อยที่สุด
ถ้าจะมองเป็นภาพรวมเวิร์กโฟลว์:
แหล่งข้อมูล → การดึงข้อมูล (ฟิลด์ AI) → การเพิ่มข้อมูลจากซับเพจ → การกำจัดข้อมูลซ้ำ → ส่งออก → การวิเคราะห์/แจ้งเตือน → การเฝ้าระวัง
สรุปและประเด็นสำคัญ
เปลี่ยนทุกหน้าข่าวให้เป็นตารางได้ เริ่มใช้ได้ฟรี ไม่ต้องใช้บัตรเครดิต รวม Email, Phone Number และ Image Extractor ไว้ในทุกแพ็กเกจ Get Started Free
การดึงข่าวแบบอัตโนมัติไม่ได้เป็นแค่ของเสริมอีกต่อไป — แต่มันคือสิ่งจำเป็นสำหรับทุกคนที่ต้องการก้าวนำในโลกที่ข่าวเปลี่ยนแปลงทุกนาที ด้วยแนวปฏิบัติที่เหมาะสมและเครื่องมือที่ใช่ คุณสามารถเปลี่ยนท่อข่าวสารดิจิทัลที่ไหลเชี่ยวให้กลายเป็นกระแสข้อมูลเชิงลึกที่มีโครงสร้างและนำไปใช้ได้จริง
ประเด็นสำคัญ:
- ปริมาณและความเร็วของข่าวออนไลน์ทำให้ automation เป็นสิ่งจำเป็น — การเฝ้าดูด้วยมือไม่สามารถตามทันได้
- เครื่องมือดึงข่าวอัตโนมัติช่วยประหยัดเวลา ลดต้นทุน และทำให้ทีมเล็กแข่งขันกับองค์กรใหญ่ได้
- การเลือกเครื่องมือที่เหมาะสมต้องบาลานซ์ระหว่างความง่ายในการใช้ ความปลอดภัย และความยืดหยุ่น — Thunderbit โดดเด่นด้วยความเรียบง่ายที่ขับเคลื่อนด้วย AI และตัวเลือกส่งออกแบบเรียลไทม์
- สร้างเวิร์กโฟลว์โดยยึดความสดใหม่ของข้อมูล การกำจัดข้อมูลซ้ำ compliance และการตรวจสอบคุณภาพ เพื่อให้ได้ข้อมูลข่าวที่เชื่อถือได้และใช้งานได้จริง
- AI และ machine learning ช่วยปลดล็อกคุณค่าที่มากขึ้นอีกขั้น — ทั้งการกำหนดเป้าหมายที่แม่นยำขึ้น การทำ personalization และการตัดสินใจที่ดีขึ้น
ถ้าตอนนี้คุณยังคัดลอกพาดหัวข่าวด้วยมือ หรือรอให้ Google Alerts ส่งเรื่องราวมาช้าไปหนึ่งวัน การลองใช้เวิร์กโฟลว์อัตโนมัติก็น่าคุ้มค่า ติดตั้ง Chrome Extension ฟรี แล้วลองชี้ไปที่แหล่งข่าว 3–4 แห่งที่คุณเปิดเช็กทุกเช้า จากนั้นดูว่า export แบบมีโครงสร้างช่วยประหยัดเวลาได้จริงอย่างที่คิดหรือไม่ สำหรับเคล็ดลับ เวิร์กโฟลว์ และบทความเจาะลึกเพิ่มเติม ดูได้ที่ Thunderbit Blog
ดึงข่าวจากทุกเว็บไซต์ด้วย Thunderbit ตั้งเวลาให้ระบบเฝ้าดูแหล่งข่าวที่คุณสนใจได้เลย และส่งออกตรงไปยัง Sheets, Excel, Airtable หรือ Notion Get Started Free
คำถามที่พบบ่อย
1. automated news extraction คืออะไร และทำงานอย่างไร?
Automated news extraction คือกระบวนการใช้ซอฟต์แวร์เก็บบทความข่าวแล้วแปลงเป็นข้อมูลที่มีโครงสร้าง เช่น ตารางหรือ JSON เพื่อใช้ในการวิเคราะห์ ค้นหา หรือแจ้งเตือน เครื่องมืออย่าง Thunderbit ใช้ AI เพื่อระบุฟิลด์สำคัญ เช่น หัวข้อข่าว เวลา ผู้เขียน และเนื้อหาบทความ แล้วดึงออกมาจากหน้าเว็บหรือ APIs โดยอัตโนมัติ
2. ทำไมข้อมูลข่าวแบบเรียลไทม์จึงสำคัญต่อธุรกิจ?
ข้อมูลข่าวแบบเรียลไทม์ช่วยให้ธุรกิจตอบสนองต่อเหตุการณ์ในตลาด วิกฤต PR หรือความเคลื่อนไหวของคู่แข่งได้อย่างรวดเร็ว ไม่ว่าคุณจะทำงานด้าน sales, PR หรือ research การมีข่าวล่าสุดจะช่วยให้ตัดสินใจได้ฉลาดและเร็วกว่า
3. Thunderbit ทำให้การดึงข่าวง่ายขึ้นสำหรับผู้ใช้ที่ไม่ถนัดเทคนิคได้อย่างไร?
Thunderbit มีเวิร์กโฟลว์แบบคลิกเดียว: กด One Click Extract แล้ว AI จะหาว่าควรดึงอะไรให้เอง ด้วยฟีเจอร์อย่าง subpage scraping และการส่งออกไป Excel หรือ Google Sheets ทันที แม้แต่ผู้ใช้ที่ไม่ใช่สายเทคนิคก็สามารถสร้าง pipeline ข่าวที่แข็งแรงได้ในไม่กี่นาที
4. ข้อควรพิจารณาด้านกฎหมายและ compliance ของการดึงข่าวมีอะไรบ้าง?
ควรตรวจสอบเงื่อนไขการใช้งานของเว็บไซต์เป้าหมายเสมอ เลือกใช้ API หรือ feed ทางการเมื่อมี และเคารพ robots.txt หลีกเลี่ยงการดึงข้อมูลจากหน้าที่ต้องล็อกอินหรือมี paywall หากไม่ได้รับอนุญาต และเก็บข้อมูลส่วนบุคคลให้น้อยที่สุดเพื่อให้สอดคล้องกับกฎหมายความเป็นส่วนตัว
5. จะทำอย่างไรให้เวิร์กโฟลว์การดึงข่าวเชื่อถือได้ในระยะยาว?
ตั้งรอบดึงข้อมูลอย่างสม่ำเสมอ ตรวจสอบคุณภาพการดึง และใช้เครื่องมือที่ปรับตัวต่อการเปลี่ยนเลย์เอาต์ได้ เช่น การดึงด้วย AI ของ Thunderbit กำจัดข้อมูลซ้ำ ติดตามความหน่วงระหว่างเวลาที่เผยแพร่กับเวลาที่ดึง และตั้ง alert สำหรับความล้มเหลวหรือฟิลด์ที่หายไป เพื่อให้ pipeline ของคุณแข็งแรงและอัปเดตอยู่เสมอ
ลองใช้ Thunderbit AI Web Scraper Get Started Free
เรียนรู้เพิ่มเติม
- 10 เครื่องมือ Automated Web Scraping ที่ช่วยประหยัดเวลาทีมของฉันได้หลายชั่วโมง (2026)
- 5 อันดับซอฟต์แวร์ Web Data Scraping ที่ดีที่สุดในปี 2026
- 15 เครื่องมือ Data Extraction ที่ดีที่สุดในปี 2026: รายชื่อที่คัดมาแล้วสำหรับทุกทีม
- Article Scraper ที่ดีที่สุดในปี 2026: เปรียบเทียบแบบลงมือใช้จริง
- วิธีเชี่ยวชาญการดึงข้อมูลอัตโนมัติด้วย Thunderbit




