
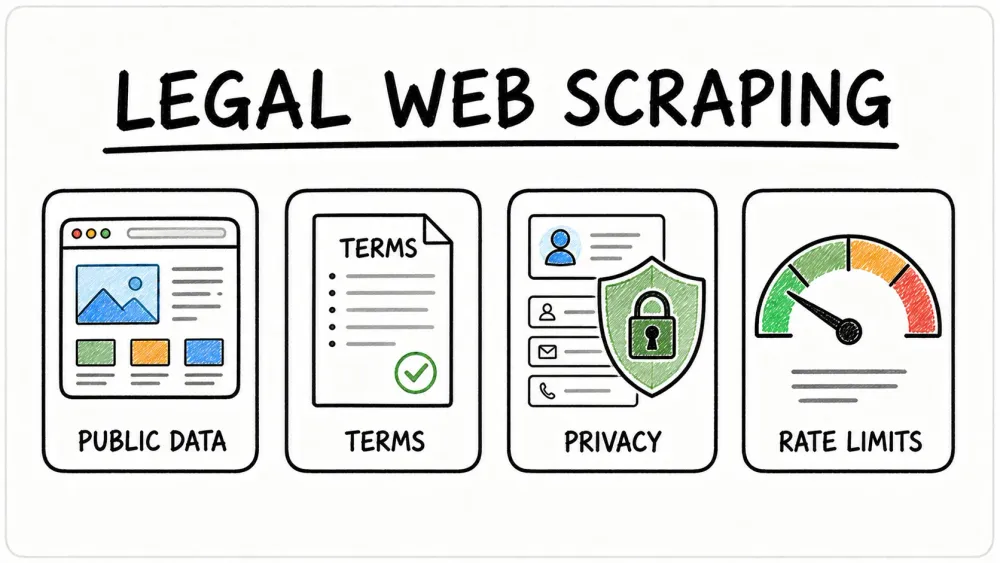
“การดึงข้อมูลจากเว็บไซต์ทำได้อย่างถูกกฎหมายไหม?”—นี่คือคำถามมูลค่าหลายล้านที่ผมได้ยินจากทีมขาย ทีมปฏิบัติการ และทีมการตลาดแทบทุกสัปดาห์ พอการทำเว็บสครัปปิงถูกนำมาใช้ตั้งแต่งานหาลูกค้าเป้าหมายไปจนถึงงานวิเคราะห์คู่แข่ง ก็ไม่น่าแปลกที่ทุกคนอยากได้คำตอบชัด ๆ แต่ความจริงคืออะไร? ภาพรวมทางกฎหมายยังคลุมเครือพอ ๆ กับกาแฟค้างคืนในแก้วใบเดิม แค่ดูพาดหัวข่าวก็เห็นแล้ว—ศาลบางแห่งบอกว่าการดึงข้อมูลสาธารณะทำได้ ในขณะที่อีกแห่งเตือนเรื่อง “การเก็บเกี่ยวข้อมูลที่ผิดกฎหมาย” จึงไม่น่าแปลกที่หลายทีมจะกังวลว่าจะก้าวข้ามเส้นเมื่อไหร่
ประเด็นคือ ตอนนี้กว่า 2 ใน 3 ขององค์กรใช้เว็บสครัปปิงเพื่อขับเคลื่อนงานวิเคราะห์และโปรเจกต์ AI และยังมีถึง 78% ของบริษัทอีคอมเมิร์ซ ที่พึ่งพามันเพื่อทำข่าวกรองด้านราคา แต่เมื่อมีคดีใหญ่ ๆ อย่าง LinkedIn vs. hiQ Labs ออกมาให้เห็นต่อหน้าสาธารณะ ความเสี่ยงก็ยิ่งสูงขึ้น แล้วเราจะใช้ประโยชน์จากข้อมูลบนเว็บได้อย่างไร โดยไม่ทำให้ตัวเองตกอยู่ในปัญหาทางกฎหมาย? มาทำความเข้าใจกรอบกฎหมาย เช็กลิสต์ด้านคอมพลายแอนซ์ และแนวทางที่ดีที่สุดที่ผู้ใช้ธุรกิจทุกคนควรรู้ และใช่ ผมจะพาไปดูด้วยว่า Thunderbit ทำให้การสครัปปิงแบบคำนึงถึงกฎหมายทำได้ง่ายขึ้นแค่ไหน
ทำความเข้าใจภาพรวมทางกฎหมาย: การดึงข้อมูลจากเว็บไซต์ทำได้อย่างถูกกฎหมายไหม?
ลองใช้ Web Scraper ของ Thunderbit ที่คำนึงถึงคอมพลายแอนซ์ Thunderbit's agentic web scraper reads public pages itself and extracts data in one click, built with compliance-conscious teams in mind. Get Started Free
พูดตรง ๆ เลยว่า ความถูกกฎหมายของเว็บสครัปปิงขึ้นอยู่กับว่าคุณดึงอะไร ดึงอย่างไร และอยู่ในประเทศไหน มันไม่มี “กฎหมายเดียว” ที่บอกว่าเว็บสครัปปิงถูกกฎหมายหรือผิดกฎหมายแบบครอบจักรวาล แต่เป็นชุดกฎหลายชั้นที่ปะปนกันอยู่—ทั้งกฎหมายต่อต้านการแฮ็ก กฎหมายคุ้มครองข้อมูลส่วนบุคคล ลิขสิทธิ์ และแม้แต่เงื่อนไขการใช้งานของเว็บไซต์ (Thunderbit Blog).
ปัจจัยสำคัญที่ใช้ตัดสินว่าโปรเจกต์สครัปปิงของคุณอยู่ฝั่งถูกกฎหมายหรือไม่นั้นมีดังนี้:
- ข้อมูลสาธารณะ vs. ข้อมูลส่วนตัว: การดึงข้อมูลที่เปิดให้ทุกคนเข้าถึงได้ (ไม่ต้องล็อกอิน ไม่ติดเพย์วอลล์) มักปลอดภัยกว่า แต่ถ้าพยายามเข้าถึงเนื้อหาหลังล็อกอิน โอกาสสูงที่จะเข้าเขตผิดกฎหมาย
- ประเภทของข้อมูล: ข้อมูลส่วนบุคคล (เช่น ชื่อ อีเมล โปรไฟล์โซเชียล) และเนื้อหาที่มีลิขสิทธิ์ (บทความ รูปภาพ) มีความเสี่ยงสูงกว่าการดึงข้อมูลเชิงข้อเท็จจริง เช่น ราคา สเปกสินค้า หรือรายชื่อธุรกิจ
- วัตถุประสงค์ในการใช้: การนำข้อมูลที่ดึงมาใช้ภายในองค์กรเพื่อวิเคราะห์หรือทำวิจัยมีความเสี่ยงน้อยกว่าการนำไปเผยแพร่หรือขายต่อ
- การปฏิบัติตามกฎของเว็บไซต์: หากฝ่าฝืนเงื่อนไขการใช้งานของเว็บหรือไม่สนใจไฟล์ robots.txt ก็อาจมีปัญหาได้ แม้ข้อมูลนั้นจะเป็นข้อมูลสาธารณะก็ตาม
- วิธีการทางเทคนิค: การสครัปปิงด้วยความเร็วใกล้เคียงมนุษย์ และไม่หลบเลี่ยงมาตรการป้องกัน เช่น CAPTCHA หรือการบล็อก IP จะช่วยให้คุณอยู่ในฝั่งที่ปลอดภัยกว่า
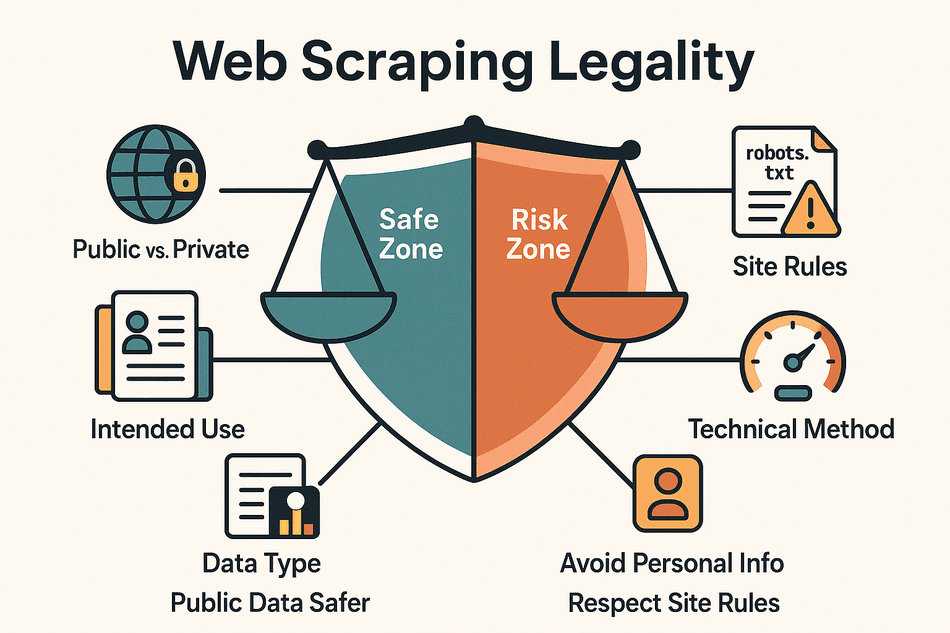
 สรุปสั้น ๆ คือ การดึงข้อมูลสาธารณะที่ไม่ใช่ข้อมูลส่วนบุคคลเพื่อใช้ภายในองค์กรเป็นสิ่งที่หลายภูมิภาคยอมรับในวงกว้าง แต่ก็ยังมีข้อควรระวังสำคัญ โดยเฉพาะเรื่องความเป็นส่วนตัว ลิขสิทธิ์ และความเข้มข้นของการสครัปปิง (Thunderbit Blog).
กรอบกฎหมายของการดึงข้อมูล: ภาพรวมกฎระเบียบสำคัญทั่วโลก
 มาดูภาพรวมแบบรวบรัดของกรอบกฎหมายหลัก ๆ ที่เกี่ยวข้องกับเว็บสครัปปิงในแต่ละภูมิภาคกัน
สหรัฐอเมริกา: CFAA, ลิขสิทธิ์ และสัญญา
- Computer Fraud and Abuse Act (CFAA): กฎหมายต่อต้านการแฮ็กนี้ห้ามการเข้าถึงระบบคอมพิวเตอร์ “โดยไม่ได้รับอนุญาต” แต่ศาลได้อธิบายเพิ่มเติมแล้วว่าการสครัปปิงเว็บไซต์สาธารณะไม่ได้ละเมิด CFAA เพราะกรณีนี้ไม่ได้มี “การอนุญาต” ที่ต้องขออยู่แล้ว (California Lawyers Association).
- คดีสำคัญ: ในคดี hiQ Labs v. LinkedIn ศาลอุทธรณ์เขตที่ 9 ตัดสินว่าการสครัปปิงโปรไฟล์ LinkedIn ที่เป็นสาธารณะไม่ถือเป็นการละเมิด CFAA อย่างไรก็ตาม LinkedIn ยังสามารถฟ้องในประเด็นผิดสัญญา (ละเมิดเงื่อนไขการใช้งาน) หรือการละเมิดลิขสิทธิ์ได้
- ความเสี่ยงอื่น ๆ: หากคุณสครัปปิงอย่างหนักมาก (เหมือนบอตในคดี eBay v. Bidder’s Edge ที่ส่งคำขอ 100,000 ครั้งต่อวัน) คุณอาจเข้าข่าย “trespass to chattels” หรือการรบกวนทรัพย์สิน/ระบบของผู้อื่น (Wikipedia).
สหภาพยุโรป: GDPR และสิทธิในฐานข้อมูล
- GDPR: กฎคุ้มครองข้อมูลส่วนบุคคลของสหภาพยุโรปบังคับใช้แม้กับข้อมูลส่วนบุคคลที่เปิดเผยต่อสาธารณะ หากคุณดึงข้อมูลที่สามารถระบุตัวบุคคลได้ คุณต้องมีฐานทางกฎหมาย เช่น ความยินยอม หรือประโยชน์โดยชอบด้วยกฎหมาย และต้องปฏิบัติตามข้อกำหนดด้านความเป็นส่วนตัวอย่างเคร่งครัด
- Database Directive: สหภาพยุโรปยังคุ้มครองฐานข้อมูลในภาพรวมด้วย การสครัปปิง “ส่วนสำคัญ” ของฐานข้อมูลที่มีโครงสร้าง เช่น รายการอสังหาริมทรัพย์ทั้งหมดจากเว็บไซต์หนึ่ง อาจละเมิดสิทธิในฐานข้อมูลได้ แม้ข้อเท็จจริงรายชิ้นจะไม่ได้มีลิขสิทธิ์ก็ตาม (Thunderbit Blog).
สหราชอาณาจักร: UK GDPR และ Data Protection Act
- UK GDPR: หลัง Brexit กฎของสหราชอาณาจักรมีโครงสร้างคล้ายกับสหภาพยุโรป การสครัปปิงข้อมูลสาธารณะที่ไม่ใช่ข้อมูลส่วนบุคคลโดยทั่วไปถือว่าโอเค แต่การดึงข้อมูลส่วนบุคคลจะถูกควบคุมอย่างเข้มงวด
- Computer Misuse Act: คล้ายกับ CFAA กฎหมายนี้อาจทำให้การเข้าถึงโดยไม่ได้รับอนุญาตกลายเป็นความผิดทางอาญาได้
จีน: PIPL และกฎหมายความมั่นคงของข้อมูล
- Personal Information Protection Law (PIPL): กำหนดให้ต้องขอความยินยอมก่อนเก็บข้อมูลส่วนบุคคล หากคุณสครัปปิงเว็บไซต์จีนเพื่อเก็บข้อมูลส่วนบุคคลโดยไม่ได้รับอนุญาต นั่นถือว่าเป็นเรื่องที่ไม่ควรทำอย่างยิ่ง
- Data Security Law: ถูกใช้เพื่อจัดการกับการสครัปปิงที่สร้างความเสียหายต่อเจ้าของข้อมูลหรือก่อให้เกิดการแข่งขันที่ไม่เป็นธรรม
ภูมิภาคอื่น ๆ
- แคนาดา ออสเตรเลีย และ APAC: ส่วนใหญ่มีทั้งกฎหมายต่อต้านการแฮ็กและกฎคุ้มครองความเป็นส่วนตัวที่คล้ายกับ EU/UK ควรตรวจสอบกฎหมายท้องถิ่นทุกครั้งก่อนสครัปปิง
ข้อสรุปสำคัญ: ทางเลือกที่ปลอดภัยที่สุดคือการสครัปปิงข้อมูลสาธารณะที่ไม่ใช่ข้อมูลส่วนบุคคลเพื่อใช้ภายในองค์กร และต้องเช็กกฎในภูมิภาคของคุณเสมอ (Thunderbit Blog).
เช็กลิสต์คอมพลายแอนซ์: จะทำให้การดึงข้อมูลถูกกฎหมายได้อย่างไร?
ก่อนเริ่มสครัปปิง ให้ไล่ตรวจตามเช็กลิสต์นี้ก่อน:
- อ่านเงื่อนไขการใช้งานของเว็บไซต์: ถ้า ToS ระบุว่า “ห้ามสครัปปิง” ให้พิจารณาหยุด หรือขออนุญาตก่อน (Thunderbit Blog).
- ยึดเฉพาะข้อมูลสาธารณะ: อย่าดึงข้อมูลที่อยู่หลังล็อกอินหรือเพย์วอลล์ หากไม่ได้รับอนุญาตอย่างชัดเจน
- ตรวจ robots.txt: ไปที่
site.com/robots.txtเพื่อดูว่าบ็อตถูกห้ามเข้าถึงส่วนใดบ้าง แม้ไม่ใช่ข้อผูกมัดทางกฎหมายโดยตรง แต่ก็ควรเคารพเป็นมารยาท - หลีกเลี่ยงข้อมูลส่วนบุคคล: อย่าดึงชื่อ อีเมล หรือข้อมูลระบุตัวตนอื่น ๆ เว้นแต่คุณมีฐานทางกฎหมายและแผนคุ้มครองข้อมูลที่ชัดเจน
- อย่าคัดลอกเนื้อหาเชิงสร้างสรรค์: ให้เน้นเฉพาะข้อเท็จจริงและจุดข้อมูล การเผยแพร่บทความ รูปภาพ หรือเนื้อหาจำนวนมากซ้ำ ๆ อาจนำไปสู่ข้อกล่าวหาเรื่องลิขสิทธิ์
- ใช้ API ทางการเมื่อมีให้ใช้: หากเว็บไซต์มี API ให้ใช้ จะปลอดภัยกว่าและมักเสถียรกว่า
- สครัปปิงอย่างสุภาพ: อย่าใช้งานจนกระทบเซิร์ฟเวอร์ ควรใช้ความเร็วใกล้เคียงมนุษย์และไม่หลบเลี่ยงการป้องกันทางเทคนิค
- บันทึกกระบวนการของคุณ: เก็บหลักฐานว่าเก็บอะไร เมื่อไหร่ และเพื่ออะไร จะช่วยได้มากหากมีข้อสงสัยในภายหลัง
- พร้อมหยุดทันทีเมื่อถูกขอ: ถ้าได้รับจดหมายให้หยุดและยุติการกระทำ ให้หยุดสครัปปิงทันทีและประเมินใหม่
แนวปฏิบัติการสครัปปิงแบบคำนึงถึงกฎหมายของ Thunderbit: ทำให้การดึงข้อมูลปลอดภัยและเชื่อถือได้มากขึ้น
ตอนที่เราสร้าง Thunderbit เรื่องคอมพลายแอนซ์ถูกวางไว้ตั้งแต่ต้น นี่คือวิธีที่ Thunderbit ช่วยให้คุณอยู่ในกรอบกฎหมาย:
- สครัปปิงผ่านเบราว์เซอร์: Thunderbit จะดึงเฉพาะสิ่งที่คุณมองเห็นในเบราว์เซอร์เท่านั้น ไม่มีการเรียก API ที่ซ่อนอยู่ และไม่มีการแฮ็กฝ่าด่านล็อกอิน ถ้ามองไม่เห็น Thunderbit ก็จะดึงไม่ได้ (Thunderbit Blog).
- มีคำเตือนในตัว: ถ้าคุณพยายามสครัปปิงเว็บไซต์ที่มีกฎต่อต้านสครัปปิงเข้มงวด Thunderbit จะแสดงคำเตือนขึ้นมา เหมือนมีผู้เชี่ยวชาญด้านคอมพลายแอนซ์คอยดูอยู่ข้าง ๆ
- ดึงข้อมูลได้ในคลิกเดียว: AI ของ Thunderbit จะสแกนหน้าเว็บและแนะนำเฉพาะฟิลด์ที่เกี่ยวข้อง ช่วยลดโอกาสในการดึงข้อมูลอ่อนไหวหรือข้อมูลที่ไม่จำเป็นโดยไม่ได้ตั้งใจ (Thunderbit Blog).
- ความเร็วแบบมนุษย์: ไม่ว่าจะสครัปปิงแบบโลคัลหรือบนคลาวด์ Thunderbit จะคำนวณจังหวะให้เหมาะสม เพื่อไม่ให้เซิร์ฟเวอร์ทำงานหนักเกินไป
- ไม่เก็บข้อมูลบนเซิร์ฟเวอร์ของเรา: ข้อมูลที่คุณดึงมาจะส่งถึงคุณโดยตรง Thunderbit ไม่เก็บสำเนาไว้ ซึ่งดีมากในแง่ความเป็นส่วนตัว
- ส่งออกข้อมูลได้อย่างเป็นมิตรต่อคอมพลายแอนซ์: ส่งออกไปยัง Google Sheets, Excel, Airtable หรือ Notion ได้โดยตรง เหมาะมากสำหรับการใช้ภายในองค์กร
- รองรับการไล่หน้ากับหน้าย่อย: Thunderbit เลื่อนผ่านเว็บไซต์เหมือนผู้ใช้จริง คลิกไปตามหน้าต่าง ๆ โดยไม่ใช้วิธีโจมตี endpoint แบบตรงไปตรงมา
- ตั้งเวลาสครัปปิงอย่างมีขอบเขต: ตั้งรอบการสครัปปิงแบบมีความรับผิดชอบ ไม่ไปรบกวนเว็บไซต์ทุกนาที
- รองรับหลายภาษา: UI ของ Thunderbit มีให้ใช้ถึง 55 ภาษาบน Chrome Web Store ทำให้คำเตือนด้านคอมพลายแอนซ์และคำแนะนำฟิลด์อ่านเข้าใจง่ายสำหรับทีมที่ไม่ใช้ภาษาอังกฤษ (Chrome Web Store listing).
พูดสั้น ๆ คือ Thunderbit “ฝังคอมพลายแอนซ์ไว้ในตัวผลิตภัณฑ์” เพื่อให้คุณสครัปปิงอย่างรับผิดชอบได้ แม้คุณจะไม่ใช่ผู้เชี่ยวชาญด้านกฎหมายก็ตาม (Thunderbit Blog).
ลองใช้ Thunderbit สำหรับการสครัปปิงที่คำนึงถึงคอมพลายแอนซ์ ติดตั้งส่วนขยาย Chrome ฟรีของ Thunderbit แล้วดึงข้อมูลจากหน้าเว็บสาธารณะได้ในคลิกเดียว Get Started Free
การใช้ข้อมูลที่ดึงมา vs. การนำข้อมูลไปใช้ซ้ำ: เส้นแบ่งทางกฎหมายอยู่ตรงไหน?
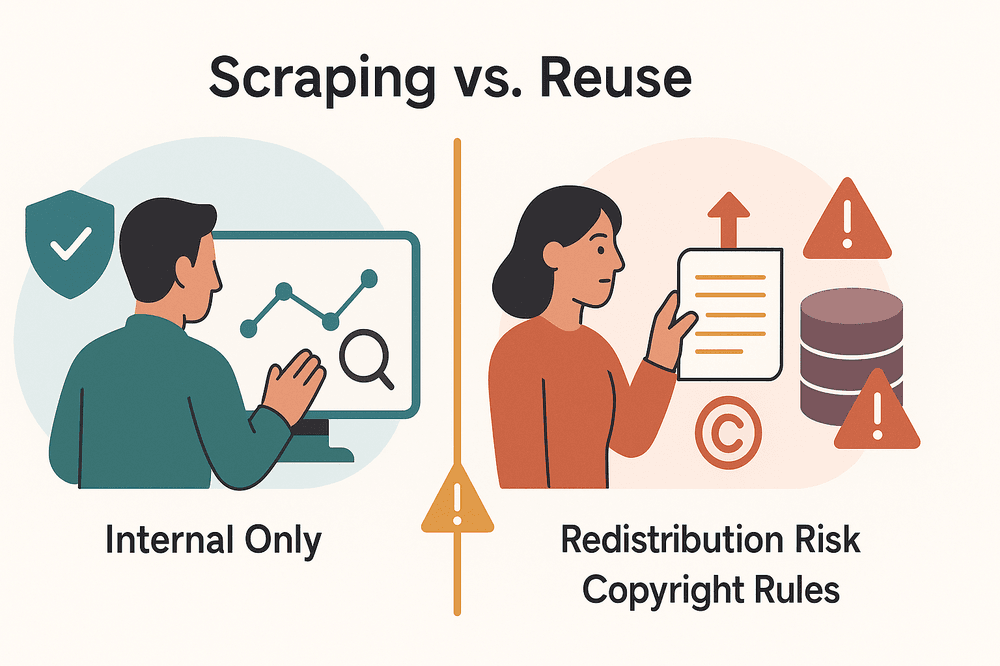 การดึงข้อมูลมาใช้ภายในองค์กรอย่างเดียวกับการนำข้อมูลนั้นไปเผยแพร่ ขายต่อ หรือใช้ซ้ำในรูปแบบอื่นนั้นคนละเรื่องกัน และตรงนี้เองที่เส้นทางกฎหมายเริ่มชัดเจนขึ้น:
- การใช้ภายใน: การดึงข้อมูลสาธารณะมาใช้วิเคราะห์ภายใน เช่น หา lead หรือเฝ้าดูราคา โดยทั่วไปถือว่าปลอดภัยกว่า ตราบใดที่ไม่ใช่ข้อมูลส่วนบุคคลและไม่ขัดกับกฎหมายความเป็นส่วนตัว
- การเผยแพร่ต่อหรือขายต่อ: การนำข้อมูลที่ดึงมาไปเผยแพร่บนเว็บไซต์ ใส่ในผลิตภัณฑ์ หรือขายต่อ อาจนำไปสู่ข้อกล่าวหาเรื่องลิขสิทธิ์ สิทธิในฐานข้อมูล หรือผิดสัญญา
- ลิขสิทธิ์และสิทธิในฐานข้อมูล: ในสหรัฐฯ ข้อเท็จจริงไม่อาจมีลิขสิทธิ์ได้ แต่การคัดเลือกหรือการจัดวางข้อมูลอาจมีได้ ส่วนใน EU/UK หากสครัปปิง “ส่วนสำคัญ” ของฐานข้อมูลก็อาจละเมิดสิทธิในฐานข้อมูลแบบ sui generis ได้
- Fair Use: กฎหมายสหรัฐฯ อนุญาต “fair use” ในบางกรณี เช่น การวิจารณ์หรือวิเคราะห์ แต่การคัดลอกและวางเนื้อหาจำนวนมากแทบไม่เคยถือเป็น fair use
- การอ้างอิงแหล่งที่มา: หากนำข้อมูลที่ดึงมาใช้ต่อสาธารณะ ควรอ้างอิงแหล่งที่มาเสมอ—แต่ต้องจำไว้ว่า การอ้างแหล่งที่มาไม่ได้ทำให้ถูกกฎหมายโดยอัตโนมัติ หากคุณละเมิดสิทธิอื่นอยู่
- อย่าขายข้อมูลดิบ: การขายชุดข้อมูลที่ดึงมาแบบไม่แปลงสภาพมีความเสี่ยงสูงมาก ควรใช้ข้อมูลนั้นเพื่อสร้างอินไซต์ ไม่ใช่ขายเป็นผลิตภัณฑ์ตรง ๆ
คำแนะนำพิเศษ: ใช้ข้อมูลที่ดึงมาเพื่อข่าวกรองภายในและการตัดสินใจทางธุรกิจ หากจำเป็นต้องแชร์ภายนอก ให้ทำการสรุปหรือแปลงข้อมูลก่อน และตรวจสอบเสมอว่าต้องขออนุญาตหรือไม่ (Thunderbit Blog).
กรณีศึกษาจากอุตสาหกรรม: จะลดความเสี่ยงทางกฎหมายได้อย่างไร
มาดูตัวอย่างจากโลกจริงกันบ้าง เพราะไม่มีอะไรสอนเรื่องคอมพลายแอนซ์ได้ดีเท่ากับการเห็นว่าคนอื่นพลาดอะไรไปบ้าง:
LinkedIn vs. hiQ Labs
- เกิดอะไรขึ้น: hiQ Labs สครัปปิงโปรไฟล์ LinkedIn ที่เป็นสาธารณะเพื่อนำไปสร้างการวิเคราะห์การลาออกของพนักงาน LinkedIn พยายามบล็อก แต่ศาลตัดสินว่าการดึงข้อมูลสาธารณะไม่ถือเป็นการละเมิด CFAA
- บทเรียน: การสครัปปิงข้อมูลสาธารณะสามารถตั้งหลักทางกฎหมายได้ในสหรัฐฯ แต่คุณยังต้องระวังเงื่อนไขการใช้งานและข้อเรียกร้องด้านความเป็นส่วนตัวอยู่ดี (California Lawyers Association).
eBay vs. Bidder’s Edge
- เกิดอะไรขึ้น: Bidder’s Edge สครัปปิงรายการประมูลของ eBay อย่างหนัก (100,000 คำขอต่อวัน) จนละเมิดเงื่อนไขการใช้งานและ robots.txt ศาลจึงออกคำสั่งห้ามในข้อหา “trespass to chattels”
- บทเรียน: แม้เป็นข้อมูลสาธารณะก็ยังผิดกฎหมายได้ หากสครัปปิงหนักเกินไปหรือฝ่าฝืนกฎของเว็บโดยตรง (Wikipedia).
Facebook (Meta) vs. Power Ventures
- เกิดอะไรขึ้น: Power Ventures สครัปปิงข้อมูล Facebook โดยอ้างว่ามีความยินยอมจากผู้ใช้ แต่หลังจาก Facebook ถอนสิทธิ์การเข้าถึงและบล็อก IP แล้ว Power Ventures ยังสครัปปิงต่อ ศาลจึงวินิจฉัยว่าเป็น “การเข้าถึงโดยไม่ได้รับอนุญาต”
- บทเรียน: ถ้าเจ้าของเว็บสั่งให้หยุดสครัปปิง คุณต้องหยุด ไม่เช่นนั้นอาจเสี่ยงละเมิดกฎหมายต่อต้านการแฮ็ก
ตัวอย่างความสำเร็จด้านคอมพลายแอนซ์
เว็บไซต์เปรียบเทียบราคาหลายแห่งใน EU ดำเนินงานได้อย่างถูกกฎหมายด้วยการดึงเฉพาะข้อมูลเชิงข้อเท็จจริง เคารพการ opt-out และไม่สครัปปิงฐานข้อมูลทั้งก้อน การที่บริษัทเหล่านี้ไม่ค่อยถูกฟ้องร้องคือสัญญาณว่า การยึดข้อมูลสาธารณะที่ไม่ใช่ข้อมูลส่วนบุคคลและปฏิบัติตามกฎของเว็บใช้ได้ผลจริง
Thunderbit ช่วยอย่างไร
คำเตือนในตัวของ Thunderbit การจำกัดอัตราการดึงข้อมูล และแนวทางแบบผ่านเบราว์เซอร์ จะช่วยลดความผิดพลาดทางกฎหมายหลายอย่างได้—โดยแจ้งเตือนผู้ใช้เมื่อเจอเว็บไซต์เสี่ยง และบังคับให้สครัปปิงอย่างสุภาพเป็นค่าเริ่มต้น
เช็กลิสต์สำหรับตรวจสอบตัวเองก่อนสครัปปิงข้อมูลในงานธุรกิจ
นี่คือเช็กลิสต์สำหรับประเมินโปรเจกต์สครัปปิงครั้งต่อไปของคุณ:
- ข้อมูลเป็นสาธารณะหรือไม่? (ไม่ต้องล็อกอิน)
- เงื่อนไขการใช้งานของเว็บระบุว่าอะไร? (มีข้อห้ามสครัปปิงหรือไม่?)
- ตรวจ robots.txt แล้วหรือยัง? (ส่วนที่ต้องการดึงถูกห้ามไว้หรือไม่?)
- กำลังดึงข้อมูลส่วนบุคคลอยู่หรือเปล่า? (ถ้าใช่ มีแผนคุ้มครองข้อมูลไหม?)
- กำลังดึงข้อมูลจำนวนมากของทั้งเว็บไซต์หรือไม่? (หลีกเลี่ยงการดึงทั้งฐานข้อมูล)
- จุดประสงค์คืออะไร? (ใช้ภายใน = ปลอดภัยกว่า; ใช้ซ้ำต่อสาธารณะ = เสี่ยงกว่า)
- สครัปปิงอย่างสุภาพหรือไม่? (ความเร็วใกล้เคียงมนุษย์ ไม่หลบเลี่ยงทางเทคนิค)
- มี API ให้ใช้หรือไม่? (ถ้ามี ควรใช้)
- พร้อมหยุดทันทีเมื่อถูกขอหรือไม่? (มีแผนรับมือจดหมายให้หยุดและยุติหรือไม่?)
- จะจัดเก็บและปกป้องข้อมูลอย่างไร? (จำกัดการเข้าถึง และคุ้มครองความเป็นส่วนตัว)
- บันทึกกระบวนการไว้หรือไม่? (เก็บหลักฐานเพื่อคอมพลายแอนซ์)
ถ้าคำตอบของข้อใดข้อหนึ่งคือ “ไม่” หรือคุณยังไม่แน่ใจ ให้หยุดก่อนแล้วค่อยหาความชัดเจนก่อนเดินหน้าต่อ (Thunderbit Blog).
ตัวอย่างเวิร์กโฟลว์สำหรับการดึงข้อมูลแบบคอมพลายแอนซ์ด้วย Thunderbit
 มาดูเวิร์กโฟลว์ทั่วไปที่เป็นมิตรต่อคอมพลายแอนซ์ของ Thunderbit กัน:
- ตรวจสอบก่อนสครัปปิง: เปิด robots.txt และอ่านเงื่อนไขการใช้งานของเว็บไซต์ ถ้าไม่มีถ้อยคำต่อต้านการสครัปปิงก็ถือว่าไฟเขียว
- เปิด Thunderbit: เข้าไปยังหน้าที่ต้องการแล้วเปิดใช้งาน Thunderbit Chrome Extension
- ดึงข้อมูลในคลิกเดียว: ให้ AI ของ Thunderbit แนะนำฟิลด์ที่เกี่ยวข้องและไม่อ่อนไหว ตรวจซ้ำว่าไม่มีข้อมูลส่วนบุคคล ถ้าไม่มีฐานทางกฎหมายรองรับ
- ปรับแต่งฟิลด์: ปรับคอลัมน์และชนิดข้อมูลตามต้องการ—เก็บเฉพาะสิ่งที่จำเป็นจริง ๆ
- เริ่มสครัปปิง: คลิก “Scrape” Thunderbit จะดึงข้อมูลด้วยจังหวะที่เหมาะสมและเคารพโครงสร้างของเว็บ
- สครัปปิงหน้าย่อย: หากต้องการ ใช้ฟีเจอร์ subpage เพื่อเพิ่มความครบถ้วนของข้อมูล—แต่ยังคงใช้กับข้อมูลสาธารณะเท่านั้น
- ส่งออก: ส่งข้อมูลไปยัง Google Sheets, Excel, Airtable หรือ Notion เพื่อวิเคราะห์ภายใน
- ตั้งเวลา (ถ้าจำเป็น): ตั้งการดึงข้อมูลเป็นรอบ ๆ อย่างเหมาะสม อย่าให้ถี่เกินไป
- บันทึกไว้: เก็บบันทึกว่าเก็บอะไร เมื่อไหร่ และเพื่ออะไร
อินเทอร์เฟซของ Thunderbit จะมีการแจ้งเตือนคุณในแต่ละขั้นตอนหากมีประเด็นด้านคอมพลายแอนซ์ เพื่อให้คุณไม่ต้องทำแบบเดา ๆ
ดูฟีเจอร์คอมพลายแอนซ์ของ Thunderbit เพิ่มเติม แผนฟรีครอบคลุม 6 หน้า/เดือน ไม่ต้องใช้บัตรเครดิต — เป็นวิธีความเสี่ยงต่ำในการทดสอบการดึงข้อมูลบนหน้าเว็บสาธารณะ Get Started Free
สรุปและคำแนะนำสำคัญ: ปลดล็อกคุณค่าของข้อมูลอย่างปลอดภัยและเป็นไปตามกฎหมาย
เว็บสครัปปิงเป็นเครื่องมือทรงพลังสำหรับการเติบโตทางธุรกิจ—แต่ไม่ใช่การทำอะไรก็ได้ตามใจ ภาพรวมทางกฎหมายอาจซับซ้อน แต่หลักการสำคัญนั้นชัดเจน:
- พยายามดึงเฉพาะข้อมูลสาธารณะที่ไม่ใช่ข้อมูลส่วนบุคคลเพื่อใช้ภายในองค์กร
- ตรวจสอบเงื่อนไขของเว็บ robots.txt และกฎหมายที่เกี่ยวข้องก่อนเริ่มเสมอ
- หลีกเลี่ยงการดึงข้อมูลส่วนบุคคลหรือเนื้อหาเชิงสร้างสรรค์ เว้นแต่คุณมีฐานทางกฎหมายและแผนคุ้มครองข้อมูลรองรับ
- ใช้เครื่องมือที่คำนึงถึงคอมพลายแอนซ์ เช่น Thunderbit เพื่อช่วยกำกับเวิร์กโฟลว์และลดความเสี่ยง
- บันทึกกระบวนการของคุณ และพร้อมหยุดทันทีเมื่อถูกขอ
เมื่อคุณทำให้เรื่องคอมพลายแอนซ์กลายเป็นนิสัย ก็จะสามารถใช้ประโยชน์จากข้อมูลบนเว็บได้เต็มที่ โดยไม่ต้องปวดหัวกับปัญหาทางกฎหมาย และถ้าอยากเห็นว่าการสครัปปิงแบบถูกกฎหมายทำได้ง่ายแค่ไหน ลอง Thunderbit ได้เลย ทีมกฎหมายของคุณ—and ตัวคุณในอนาคต—จะขอบคุณมาก
หากอยากอ่านเชิงลึกเพิ่มเติมเกี่ยวกับเว็บสครัปปิง คอมพลายแอนซ์ และระบบอัตโนมัติ ลองดู Thunderbit Blog
ลองใช้ Agentic Web Scraper สำหรับการดึงข้อมูลที่คำนึงถึงคอมพลายแอนซ์ Get Started Free
คำถามที่พบบ่อย
1. การดึงข้อมูลจากทุกเว็บไซต์ทำได้อย่างถูกกฎหมายหรือไม่?
ไม่เสมอไป การดึงข้อมูลสาธารณะที่ไม่ใช่ข้อมูลส่วนบุคคลเพื่อใช้ภายในองค์กรโดยทั่วไปถือว่าถูกกฎหมายในหลายภูมิภาค แต่การดึงข้อมูลส่วนบุคคล เนื้อหาที่มีลิขสิทธิ์ หรือข้อมูลหลังล็อกอินอาจมีความเสี่ยงสูงหรือผิดกฎหมายได้โดยตรง ควรตรวจสอบเงื่อนไขของเว็บไซต์และกฎหมายท้องถิ่นก่อนสครัปปิงเสมอ (Thunderbit Blog).
2. การสครัปปิงกับการนำข้อมูลไปใช้ซ้ำต่างกันอย่างไร?
การสครัปปิงคือการเก็บรวบรวมข้อมูล ส่วนการนำไปใช้ซ้ำคือการเผยแพร่ ขาย หรือแจกจ่ายข้อมูลนั้นต่อ การใช้ภายในองค์กรปลอดภัยกว่ามาก แต่ถ้าจะเผยแพร่หรือขายข้อมูลที่ดึงมา อาจเข้าข่ายละเมิดลิขสิทธิ์ สิทธิในฐานข้อมูล หรือผิดสัญญา (Thunderbit Blog).
3. Thunderbit ช่วยให้คอมพลายแอนซ์ดีขึ้นได้อย่างไร?
Thunderbit ดึงเฉพาะข้อมูลที่มองเห็นได้ในเบราว์เซอร์ แจ้งเตือนเมื่อเจอเว็บไซต์เสี่ยง แนะนำฟิลด์ที่เกี่ยวข้องและไม่อ่อนไหว และควบคุมอัตราคำขอเพื่อไม่ให้เซิร์ฟเวอร์ทำงานหนักเกินไป นอกจากนี้ยังไม่เก็บข้อมูลของคุณไว้ และตัวเลือกการส่งออกถูกออกแบบมาเพื่อการใช้งานภายใน (Thunderbit Blog).
4. ถ้าได้รับจดหมายให้หยุดและยุติการกระทำควรทำอย่างไร?
ให้หยุดสครัปปิงทันทีและทบทวนโปรเจกต์ของคุณต่อ หากยังทำต่อหลังจากมีคำขอให้หยุดโดยตรง อาจทำให้พื้นที่สีเทาทางกฎหมายกลายเป็นการละเมิดกฎหมายต่อต้านการแฮ็กหรือเงื่อนไขสัญญาอย่างชัดเจน (Thunderbit Blog).
5. ถ้าข้อมูลเป็นสาธารณะแล้ว ฉันจะดึงข้อมูลส่วนบุคคลได้ไหม?
ไม่ได้หากไม่มีฐานทางกฎหมาย กฎหมายคุ้มครองความเป็นส่วนตัวอย่าง GDPR และ CCPA บังคับใช้กับข้อมูลส่วนบุคคลที่เปิดเผยต่อสาธารณะด้วย คุณต้องมีความยินยอมหรือประโยชน์โดยชอบด้วยกฎหมายที่หนักแน่น และต้องจัดการข้อมูลอย่างรับผิดชอบ (Thunderbit Blog).
คู่มือนี้มีวัตถุประสงค์เพื่อให้ข้อมูลเท่านั้น และไม่ถือเป็นคำแนะนำทางกฎหมาย สำหรับโปรเจกต์ที่ซับซ้อนหรือมีความเสี่ยงสูง ควรปรึกษาทนายที่มีความเชี่ยวชาญด้านกฎหมายข้อมูลและความเป็นส่วนตัวในเขตอำนาจศาลของคุณ
อ่านเพิ่มเติม




