
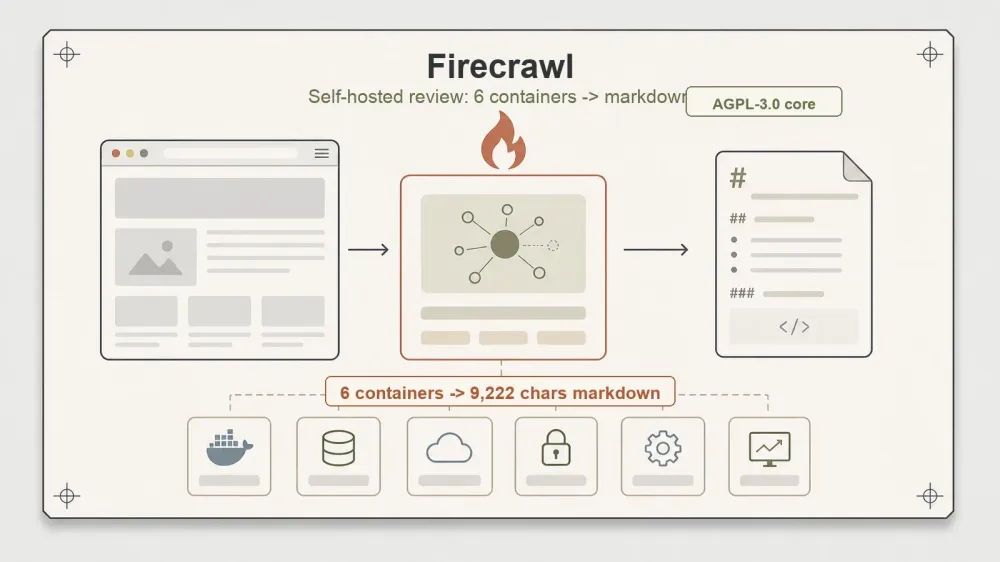
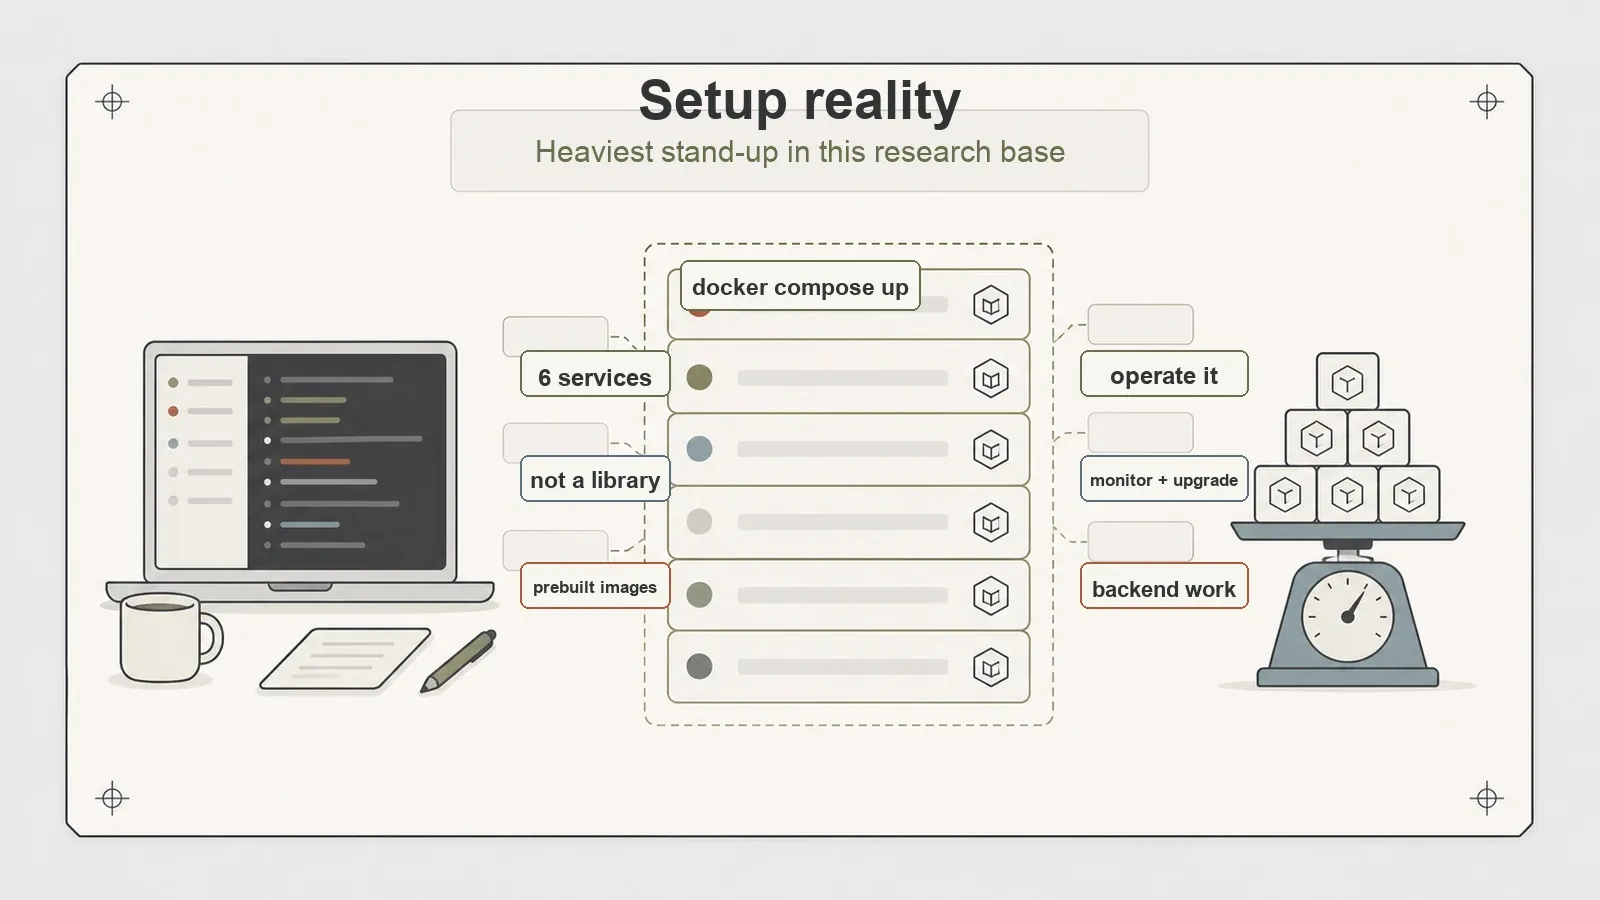
คนส่วนใหญ่เข้าใจว่า Firecrawl เป็นแค่ไลบรารีสำหรับ Web Scraper ที่ติดตั้งผ่าน pip install แล้วก็เขียนสคริปต์นิดหน่อยก็เสร็จ แต่จริงๆ แล้วความคิดนี้มันผิดถนัดเลยนะ และความแตกต่างนี้สำคัญมากก่อนที่คุณจะเริ่มพิมพ์คำสั่งอะไรลงไป Firecrawl แบบโฮสต์เองเนี่ย มันไม่ใช่ไลบรารีที่คุณจะ import เข้ามาใช้ได้ง่ายๆ แต่มันเป็น "บริการ" ที่คุณต้องรันเอง และการติดตั้งใช้งานมันหมายถึงการรัน Docker container ถึงหกตัวที่ต้องสื่อสารกัน
ผมลองรันสแต็กแบบโฮสต์เองบน Mac (arm64, Docker ผ่าน colima) โดยที่ไม่มีคีย์คลาวด์เลยนะ แล้วก็ชี้ปลายทาง /v1/scrape ไปที่เว็บไซต์สาธิตที่เหมาะกับการสแครปสองสามแห่ง แล้วก็ดูผลลัพธ์ที่ได้ สรุปสั้นๆ เลยคือ: สิ่งที่เขาเคลมไว้เป็นจริงนะ — หน้าเว็บถูกป้อนเข้าไป แล้วก็ได้ Markdown ที่สะอาดพร้อมใช้งานสำหรับ LLM ออกมา — แต่การตั้งค่านี้มันหนักหนาสาหัสที่สุดในบรรดาเครื่องมือทั้งหมดที่ผมได้ลองทดสอบมาในงานวิจัยนี้เลยนะ นี่เป็นการตรวจสอบเบื้องต้นเท่านั้น ไม่ใช่การให้คะแนนขั้นสุดท้าย และผมจะบอกให้ชัดเจนเลยว่าผมได้ทดสอบอะไรไปบ้างและไม่ได้ทดสอบอะไร
Firecrawl เป็นบริการ ไม่ใช่ไลบรารี
นี่คือแนวคิดที่คุณต้องทำความเข้าใจก่อนเลยนะ เครื่องมือ Web Scraper ส่วนใหญ่ที่นักพัฒนาใช้กันเนี่ย มันเป็นไลบรารี: คุณแค่เพิ่ม dependency เรียกใช้ฟังก์ชัน แล้วก็ได้ HTML หรือข้อมูลที่แยกวิเคราะห์กลับมาในกระบวนการของคุณเอง แต่ Firecrawl แบบโฮสต์เองมันแตกต่างออกไป มันคือแพลตฟอร์มที่ทำงานอยู่ตลอดเวลาพร้อม API ของตัวเอง และคุณต้องสื่อสารกับมันผ่าน HTTP
ตำแหน่งอย่างเป็นทางการของมันคือ "API สำหรับการค้นหา สแครป และโต้ตอบกับเว็บในวงกว้าง" และรูปแบบผลิตภัณฑ์ก็เป็นแบบนั้นเลย — ป้อนหน้าเว็บเข้าไป ได้ Markdown ที่สะอาดหรือข้อมูลที่มีโครงสร้าง ออกมา เมื่อคุณโฮสต์เอง คุณไม่ได้แค่เชื่อมโยงกับ Firecrawl นะ คุณกำลังรันสแต็ก docker compose และเรียกใช้ปลายทาง เหมือนกับการเรียกใช้ microservice ภายในองค์กรนั่นแหละ
สแต็กที่ผมรันประกอบด้วยบริการหกตัว:
- api — ส่วนติดต่อ HTTP ที่คุณเรียกใช้จริงๆ
- playwright-service — เบราว์เซอร์แบบ headless สำหรับการเรนเดอร์ JavaScript
- redis — คิวและแคช
- rabbitmq — โบรกเกอร์ข้อความ
- nuq-postgres — Postgres เวอร์ชันสำหรับสถานะงาน
- foundationdb — ที่เก็บข้อมูลคีย์-ค่าแบบกระจาย
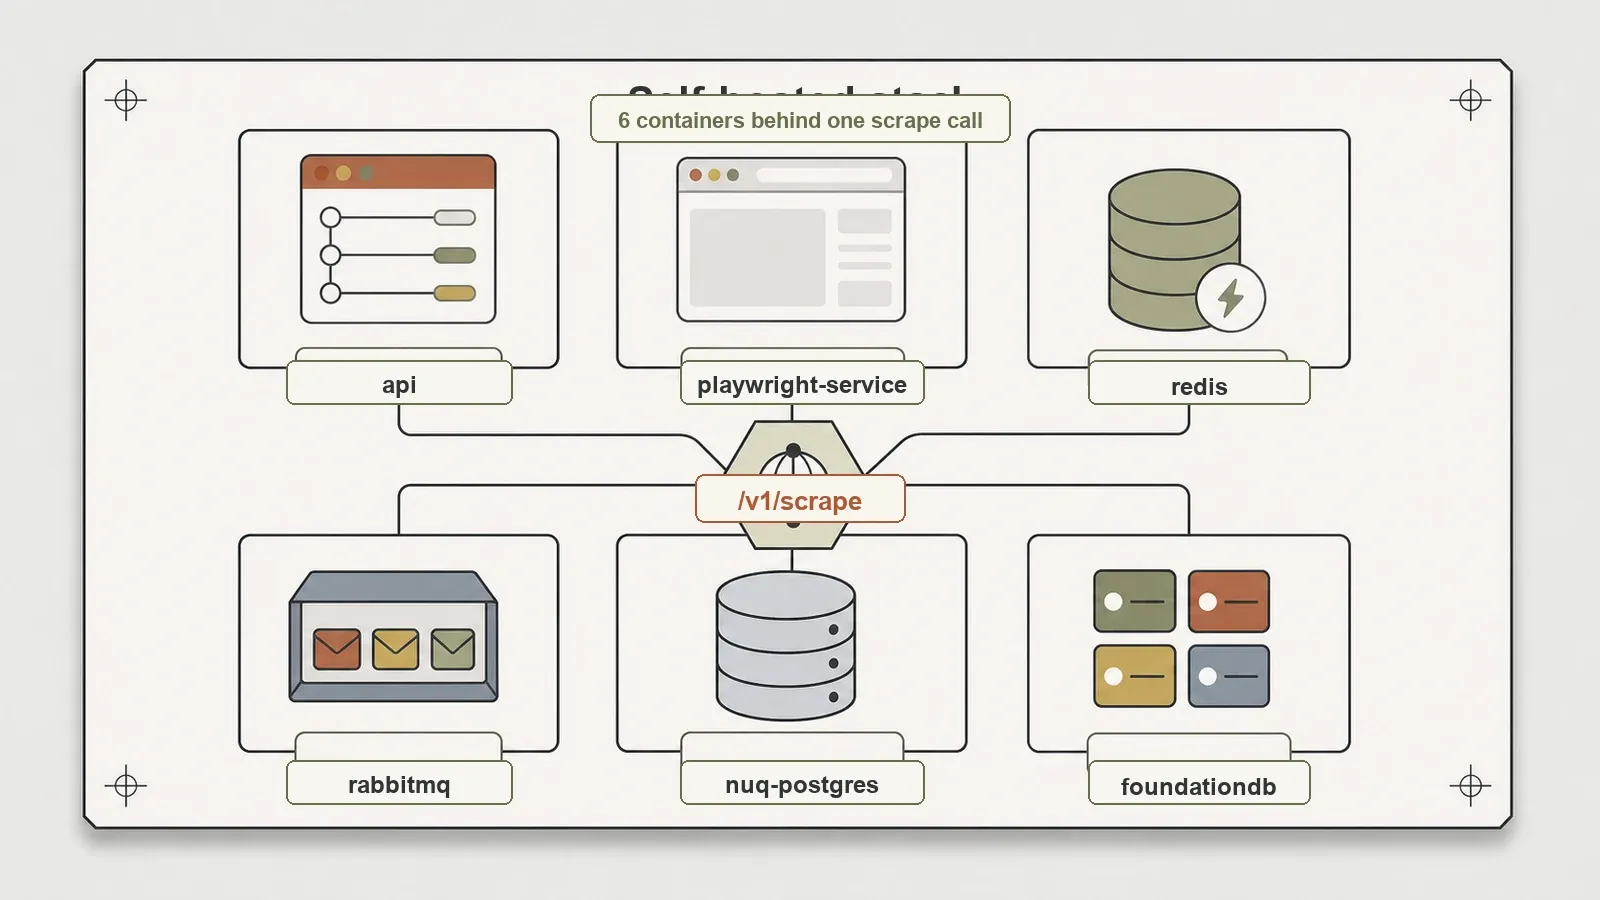
นี่คือแบ็กเอนด์จริงๆ นะ ไม่ใช่แค่สคริปต์ช่วยงาน Redis, RabbitMQ, Postgres และ FoundationDB ล้วนเป็นโครงสร้างพื้นฐานระดับอุตสาหกรรมในตัวมันเอง ข้อดีคือ Firecrawl จัดการส่วนที่ยุ่งยากของการสแครป — การจัดคิว การเรนเดอร์ การลองใหม่ — ด้วยการเรียก API เพียงครั้งเดียว แต่ข้อเสียคือตอนนี้คุณต้องดูแลคอนเทนเนอร์ทั้งหกตัวนั้น โปรดจำข้อแลกเปลี่ยนนี้ไว้ให้ดีนะ; มันคือแก่นของรีวิวทั้งหมดนี้เลย
สำหรับการอ้างอิง ผมได้ทดสอบกับ SDK firecrawl-py 4.32.0 และ firecrawl-js 4.30.0 โดยดึงอิมเมจ ghcr.io/firecrawl/firecrawl:latest ที่สร้างไว้ล่วงหน้าอย่างเป็นทางการเมื่อวันที่ 2026-07-09 ณ วันที่นั้น repo มีดาวประมาณ 148k (ถือเป็นข้อมูลเมตา ไม่ใช่คะแนนคุณภาพ) ภายใต้ ใบอนุญาต AGPL-3.0 — รายละเอียดที่ผมจะกลับมาพูดถึงอีกครั้ง เพราะมันเปลี่ยนการคำนวณสำหรับการใช้งานเชิงพาณิชย์
การทดสอบหลัก: หน้าเว็บกลายเป็น Markdown ที่สะอาด
เหตุผลทั้งหมดที่ Firecrawl มีอยู่ก็คือการเปลี่ยนหน้าเว็บให้เป็น Markdown ที่ LLM สามารถอ่านได้จริงๆ นั่นคือสิ่งแรกที่ผมตรวจสอบเลย
ผมชี้ /v1/scrape ไปที่ books.toscrape.com ซึ่งเป็นแคตตาล็อกแบบคงที่ที่สร้างขึ้นมาเพื่อการฝึกสแครปโดยเฉพาะ ผลลัพธ์: 9,222 ตัวอักษร ของ Markdown ที่สะอาดพร้อมใช้งานสำหรับ LLM โดยมีชื่อหน้า All products | Books to Scrape ถูกแยกวิเคราะห์อย่างถูกต้อง ไม่ใช่ HTML ดิบที่ถูกทิ้งลงในสตริง — แต่เป็น Markdown ที่มีโครงสร้าง พร้อมหัวข้อ ลิงก์ และการอ้างอิงรูปภาพที่สมบูรณ์แบบ ผลลัพธ์ที่คุณสามารถนำไปใช้ใน retrieval pipeline หรือป้อนให้กับโมเดลได้โดยไม่ต้องทำความสะอาดอีกครั้ง
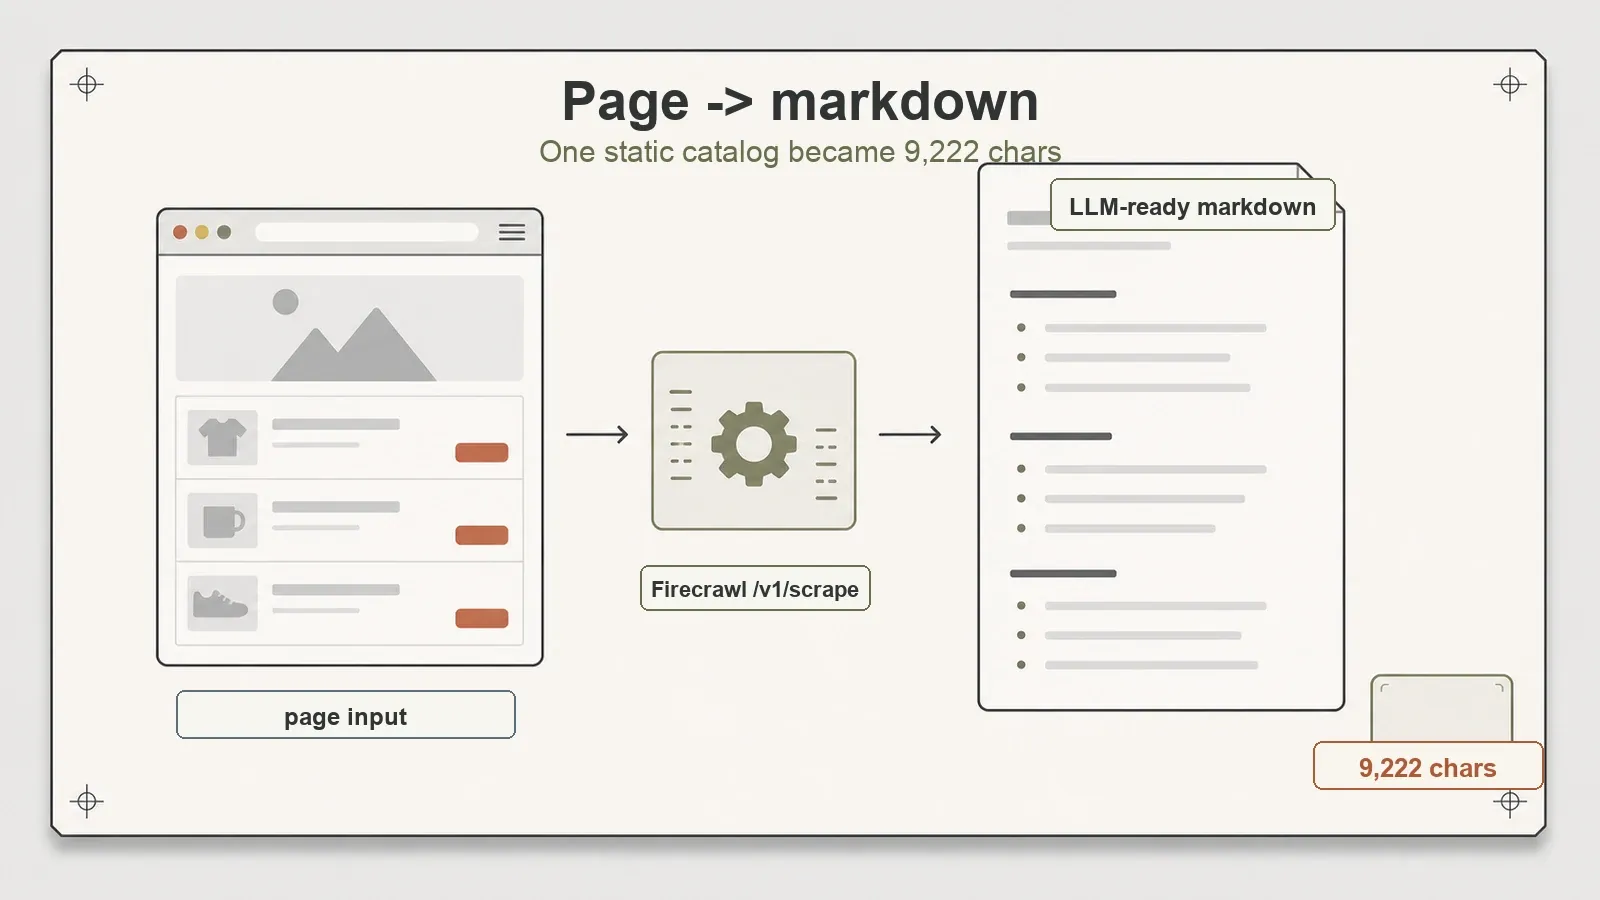
นี่คือจุดแข็งหลักของ Firecrawl และการโฮสต์เองก็ทำได้โดยไม่มีปัญหาเลยนะ หากงานของคุณคือ "ให้เนื้อหาที่อ่านได้ของหน้านี้เป็น Markdown" หน้าเว็บแบบคงที่ก็ให้ผลลัพธ์ตามที่โฆษณาไว้ทุกประการ นั่นเป็นฟังก์ชันพื้นฐานที่มีประโยชน์อย่างแท้จริง และเป็นเหตุผลที่เครื่องมือนี้ได้รับความนิยมอย่างมาก
ควรระบุขอบเขตให้ชัดเจน: ผมได้ทดสอบเส้นทาง /v1/scrape แบบหน้าเดียว ผมไม่ได้ทดสอบ /v1/crawl ซึ่งเป็น crawler แบบหลายหน้าที่สำรวจทั้งเว็บไซต์ นั่นเป็นความสามารถที่แยกต่างหากซึ่งมีโหมดความล้มเหลวของตัวเอง และผมจะไม่ยืนยันว่ามันทำงานได้ดีเมื่อผมไม่ได้รันมัน
หน้า JavaScript: เบราว์เซอร์ที่มาพร้อมเครื่องพิสูจน์คุณค่าของคอนเทนเนอร์
หน้าเว็บแบบคงที่เป็นกรณีที่ง่าย คำถามที่ยากกว่าสำหรับ Web Scraper ใดๆ ก็คือจะเกิดอะไรขึ้นเมื่อเนื้อหาปรากฏขึ้นหลังจาก JavaScript ทำงานเท่านั้น — ซึ่งในเว็บสมัยใหม่ ส่วนใหญ่ก็เป็นแบบนั้นแหละ
นี่คือจุดที่คอนเทนเนอร์ playwright-service หยุดเป็นภาระและเริ่มเป็นจุดสำคัญ ผมชี้ Web Scraper ไปที่ quotes.toscrape.com/js/ ซึ่งเป็นเว็บไซต์สาธิตเวอร์ชันที่เรนเดอร์คำคมฝั่งไคลเอ็นต์ หาก Firecrawl ดึง HTML ดิบมาเท่านั้น คำคมเหล่านั้นก็จะไม่ปรากฏ — มันจะไม่มีอยู่จนกว่าเบราว์เซอร์จะรันสคริปต์ของหน้าเว็บ
การสแครปกลับมาพร้อมกับ Markdown 1,574 ตัวอักษร และคำคมของ Einstein ก็อยู่ในนั้น คำคมนั้นเป็นเนื้อหาหลัง JavaScript: การมีอยู่ของมันเป็นหลักฐานว่า playwright-service ได้เรนเดอร์หน้าเว็บในเอนจินเบราว์เซอร์จริงก่อนที่จะดึงข้อความออกมา แทนที่จะดึงเชลล์ที่ว่างเปล่าก่อนการเรนเดอร์
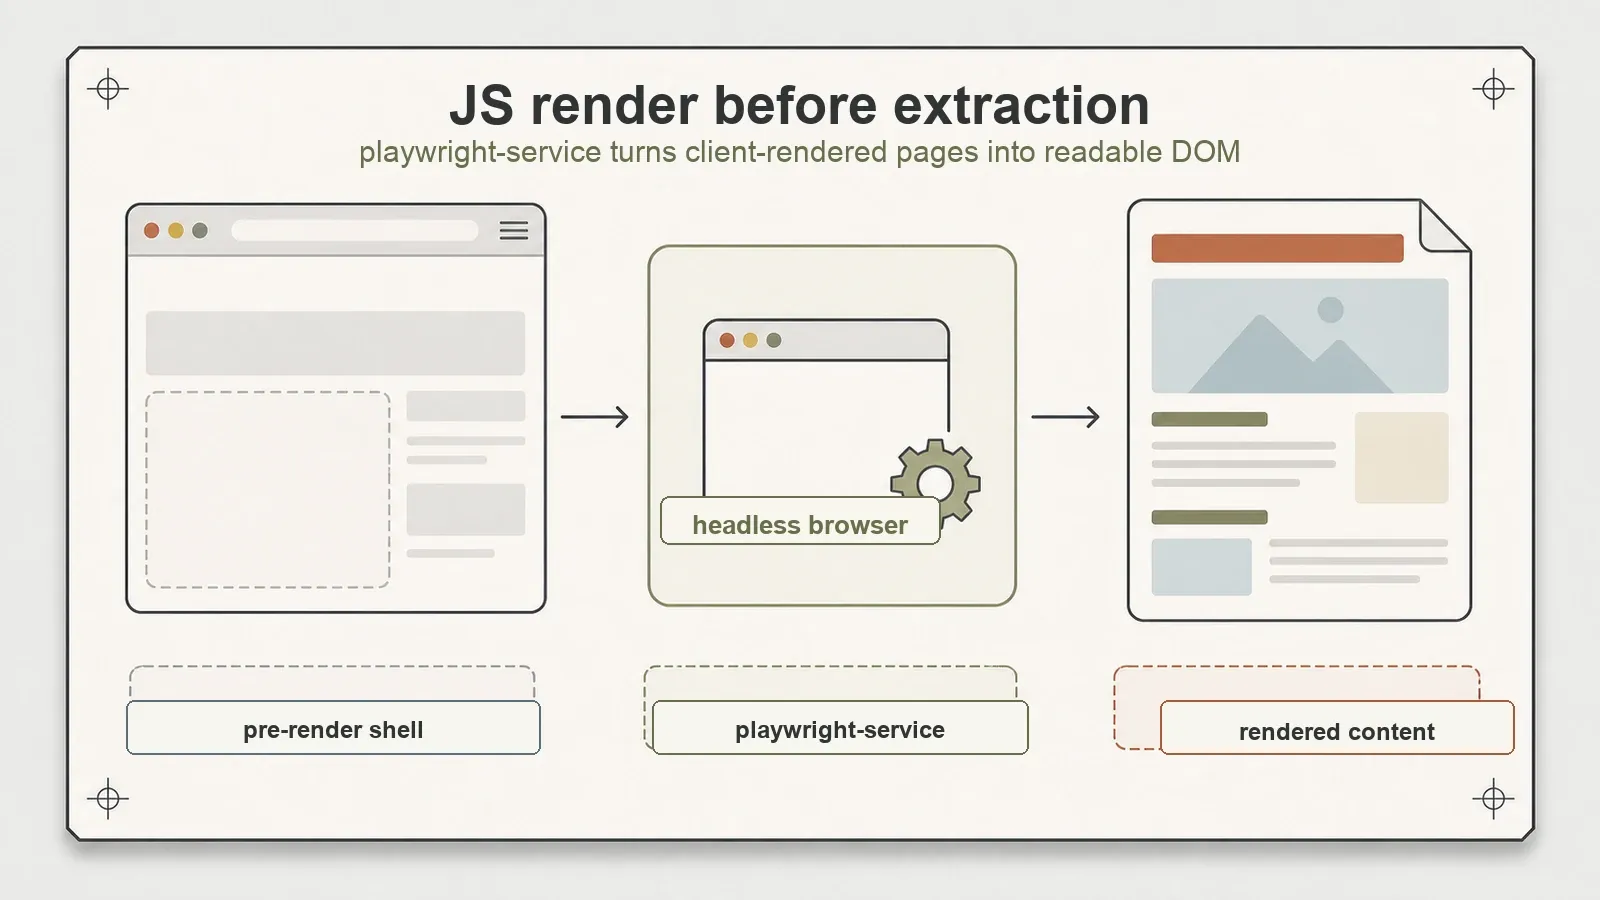
ดังนั้นหนึ่งในหกคอนเทนเนอร์คือเบราว์เซอร์แบบ headless และมันทำงานตามที่คุณต้องการ นั่นคือเหตุผลที่ชัดเจนสำหรับสถาปัตยกรรมที่หนักกว่า: คุณไม่ได้จ่ายแค่ค่าคอนเทนเนอร์ แต่คุณกำลังจ่ายเพื่อความสามารถในการเรนเดอร์หน้าเว็บที่มี JavaScript มากมายโดยไม่ต้องตั้งค่าระบบอัตโนมัติของเบราว์เซอร์ของคุณเอง สำหรับเป้าหมายในโลกแห่งความเป็นจริงจำนวนมาก นั่นคือความแตกต่างระหว่างผลลัพธ์ที่ใช้งานได้กับ div ที่ว่างเปล่า
เมื่อเป้าหมายไม่ดี: ข้อผิดพลาดที่มีโครงสร้าง ไม่มีการขัดข้อง
Web Scraper ใช้เวลาส่วนใหญ่ไปกับการชี้ไปยังสิ่งที่ไม่ทำงาน — โฮสต์ที่ตายแล้ว, URL ที่พิมพ์ผิด, เซิร์ฟเวอร์ที่ค้าง การที่เครื่องมือล้มเหลวบอกอะไรได้มากพอๆ กับการที่มันประสบความสำเร็จ
ผมป้อนโฮสต์ที่ไม่ถูกต้องให้กับ API โดยเจตนา มันส่งคืน HTTP 500 ที่มีโครงสร้างและยังคงทำงานต่อไป — ไม่มี stack trace ที่ถูกส่งไปยังไคลเอ็นต์, ไม่มีคอนเทนเนอร์ล้มเหลว, ไม่มีกระบวนการค้าง ข้อผิดพลาดกลับมาเป็นคำตอบที่สะอาดซึ่งผู้เรียกสามารถแยกสาขาได้
นั่นคือพฤติกรรมที่น่าเบื่อแต่ถูกต้องที่คุณต้องการจากสิ่งที่คุณจะใส่ใน pipeline Web Scraper ที่ตื่นตระหนกเมื่อเจอเป้าหมายที่ไม่ดีคือ Web Scraper ที่คุณไม่สามารถทำให้เป็นอัตโนมัติได้ เครื่องมือนี้ส่งคืนข้อผิดพลาดที่คุณสามารถจับและดำเนินการต่อไปได้ ผมทดสอบกรณีข้อผิดพลาดเพียงกรณีเดียว ดังนั้นโปรดอ่านว่า "จัดการความล้มเหลวที่ผมโยนให้มันได้อย่างถูกต้อง" ไม่ใช่การตรวจสอบความยืดหยุ่นอย่างละเอียด — แต่ข้อมูลจุดเดียวนี้เป็นผลลัพธ์ที่ถูกต้อง
ความเป็นจริงของการตั้งค่า: การยกที่หนักที่สุดในฐาน
ตอนนี้เป็นส่วนที่ไม่มีใครถ่ายภาพหน้าจอสำหรับทวีตเปิดตัว Firecrawl แบบโฮสต์เองนั้น โดยไม่มีการกล่าวเกินจริง เป็นการตั้งค่าที่ซับซ้อนที่สุดในบรรดาเครื่องมือทั้งหมดในงานวิจัยนี้ — และผมได้ตั้งค่ามามากมายแล้ว
หกคอนเทนเนอร์คือค่าใช้จ่ายพื้นฐาน แต่ผมก็เจออุปสรรคสองอย่างระหว่างทาง และผมต้องการระบุให้ชัดเจนว่าใครเป็นคนผิด — ซึ่งไม่ใช่ Firecrawl อย่างที่ปรากฏ
อุปสรรคแรก: การสร้างจากซอร์สโค้ด การสร้างอิมเมจจากซอร์สโค้ดล้มเหลวภายใน colima VM ของผมเนื่องจากข้อผิดพลาดของ containerd snapshotter นั่นคือการโต้ตอบที่ไม่เสถียรระหว่างการสร้างและเลเยอร์จัดเก็บข้อมูลของ colima — เป็นปัญหาโครงสร้างพื้นฐานในสภาพแวดล้อมของผม ไม่ใช่ข้อบกพร่องใน Firecrawl ไฟล์ compose ระบุทางเลือกอื่น: ใช้อิมเมจ ghcr.io/firecrawl/* ที่สร้างไว้ล่วงหน้าอย่างเป็นทางการแทนการสร้างในเครื่อง ผมเปลี่ยนไปใช้อิมเมจเหล่านั้น และสแต็กทั้งหมดก็ทำงานได้อย่างราบรื่น หากคุณใช้ Docker daemon มาตรฐานแทน colima คุณอาจไม่เคยเห็นสิ่งนี้เลย; ผมระบุว่าเป็นข้อควรระวังด้านสภาพแวดล้อม และการตรวจสอบการสร้างของผู้ร่วมให้ข้อมูลบน daemon ที่สะอาดอยู่ในรายการช่องว่างของผม
อุปสรรคที่สอง: ตัวป้องกัน SSRF การสแครปครั้งแรกของผมถูกบล็อกโดย IP ส่วนตัวของ Firecrawl / การป้องกัน SSRF ทำไม? การเชื่อมต่อเครือข่ายของ colima แมปชื่อโฮสต์สาธารณะไปยังที่อยู่ 198.18.x.x ซึ่งอยู่ในช่วงที่สงวนไว้ซึ่ง Firecrawl ถือว่าเป็นส่วนตัวอย่างถูกต้อง — ดังนั้นเลเยอร์ความปลอดภัยของมันจึงทำงานและปฏิเสธที่จะดึงสิ่งที่ดูเหมือนเป็นเป้าหมายภายใน เพื่อหลีกเลี่ยงปัญหานี้ สำหรับการทดสอบในเครื่องเท่านั้น ผมตั้งค่า ALLOW_LOCAL_WEBHOOKS=true
แฟล็กนั้นถูกคัดลอกและวางลงในการผลิตและทำให้เกิดเหตุการณ์ ดังนั้นโปรดระบุให้ชัดเจนว่ามันคืออะไร: ตัวป้องกัน SSRF เป็นคุณสมบัติ ไม่ใช่อุปสรรค มันคือสิ่งที่หยุดบริการสแครปจากการถูกหลอกให้เข้าถึงเครือข่ายภายในของคุณ ผมปิดใช้งานมันเพราะความแปลกประหลาดของ DNS ของ colima ทำให้เป้าหมายสาธารณะที่ถูกต้องของผม ดูเหมือน เป็นส่วนตัวภายใน VM อย่าปิดการป้องกัน SSRF ในการใช้งานจริง หากคุณจดบันทึกการปฏิบัติงานเพียงข้อเดียวจากรีวิวนี้ โปรดจดข้อนั้นไว้
อุปสรรคทั้งสองอย่าง พูดง่ายๆ คือเป็นผลมาจากการรัน Docker ผ่าน colima บนแล็ปท็อป — ไม่ใช่ข้อบกพร่องในซอฟต์แวร์ ในทางกลับกัน น้ำหนักของการตั้งค่าเองนั้นเป็นเรื่องจริงและเป็นของ Firecrawl โดยการออกแบบ นี่ไม่ใช่เครื่องมือที่คุณใช้เมื่อคุณต้องการสคริปต์ในเครื่องอย่างรวดเร็ว; มันเป็นเครื่องมือที่คุณตั้งค่าเมื่อคุณต้องการบริการสแครปที่สามารถเรนเดอร์ได้และคุณยินดีที่จะรันโครงสร้างพื้นฐานสำหรับมัน
สิ่งที่ผมไม่ได้ทดสอบ และสิ่งที่มันไม่ได้ทำ
นี่คือสิ่งที่ผมไม่ได้ครอบคลุม และสิ่งที่เครื่องมือนี้ไม่ได้ให้คุณ
แบบโฮสต์เองไม่มี Fire-engine ผลิตภัณฑ์คลาวด์ของ Firecrawl มี Fire-engine ซึ่งเป็นเลเยอร์ป้องกันการบล็อกที่เป็นกรรมสิทธิ์ของตนเองสำหรับการหลีกเลี่ยงการป้องกันบอท ตามเอกสาร SELF_HOST.md ของโปรเจกต์เอง อินสแตนซ์แบบโฮสต์เองไม่ได้รับมัน ดังนั้นหากคุณกำลังจินตนาการว่า Firecrawl แบบโฮสต์เองสามารถทะลุระบบป้องกันบอทที่รุนแรงได้ทันที โปรดปรับภาพใหม่ — ความสามารถนั้นอยู่ในระดับคลาวด์ และมันไม่ได้เป็นส่วนหนึ่งของสิ่งที่ผมรัน
API คลาวด์ไม่ได้ถูกทดสอบที่นี่ ผมไม่มีคีย์คลาวด์ ดังนั้นทุกอย่างข้างต้นเป็นเพียงสแต็กแบบโฮสต์เองเท่านั้น บริการคลาวด์ที่มีการจัดการ — พร้อม Fire-engine, การปรับขนาดที่โฮสต์ และคุณสมบัติ AI — เป็นผลิตภัณฑ์ที่แตกต่างกัน และผมจะไม่ระบุลักษณะประสิทธิภาพของมันจากภายนอก โปรดถือว่าการอ้างสิทธิ์ใดๆ เกี่ยวกับคลาวด์อยู่นอกขอบเขตของรีวิวนี้
คุณสมบัติ AI ต้องการคีย์ รูปแบบเอาต์พุตที่มีโครงสร้าง json และปลายทาง /extract อาศัย LLM ซึ่งหมายถึงการนำคีย์ OpenAI หรือการเชื่อมต่อ Ollama มาใช้ นั่นทำให้การเลือกโมเดลเป็นส่วนหนึ่งของรายการวัสดุ: ก่อนที่จะตัดสินใจตั้งค่า โปรดเปรียบเทียบ ราคา API ปัจจุบัน ของผู้ให้บริการที่คุณสามารถนำมาใช้ได้ ผมไม่ได้ทดสอบเส้นทางเหล่านั้น ดังนั้น /extract และเอาต์พุต json ที่มีโครงสร้างจึงอยู่ในคอลัมน์ที่ไม่ได้ทดสอบด้วย
พร็อกซีเป็นข้อควรระวัง ไม่ใช่หัวข้อข่าว Firecrawl รองรับการกำหนดค่าพร็อกซี แต่ผมระบุว่าเป็นเชิงอรรถโดยเจตนา — มันเป็นปุ่มที่คุณ สามารถ หมุนได้ ไม่ใช่เหตุผลในการเลือกเครื่องมือ และแบบโฮสต์เองยังคงขาดเลเยอร์ป้องกันการบล็อกของคลาวด์อยู่ดี
AGPL-3.0 เป็นการตัดสินใจด้านการปฏิบัติตามข้อกำหนดที่แท้จริง ข้อนี้สมควรได้รับความสนใจเป็นพิเศษ
ใบอนุญาต: อ่าน AGPL-3.0 ก่อนที่คุณจะเผยแพร่
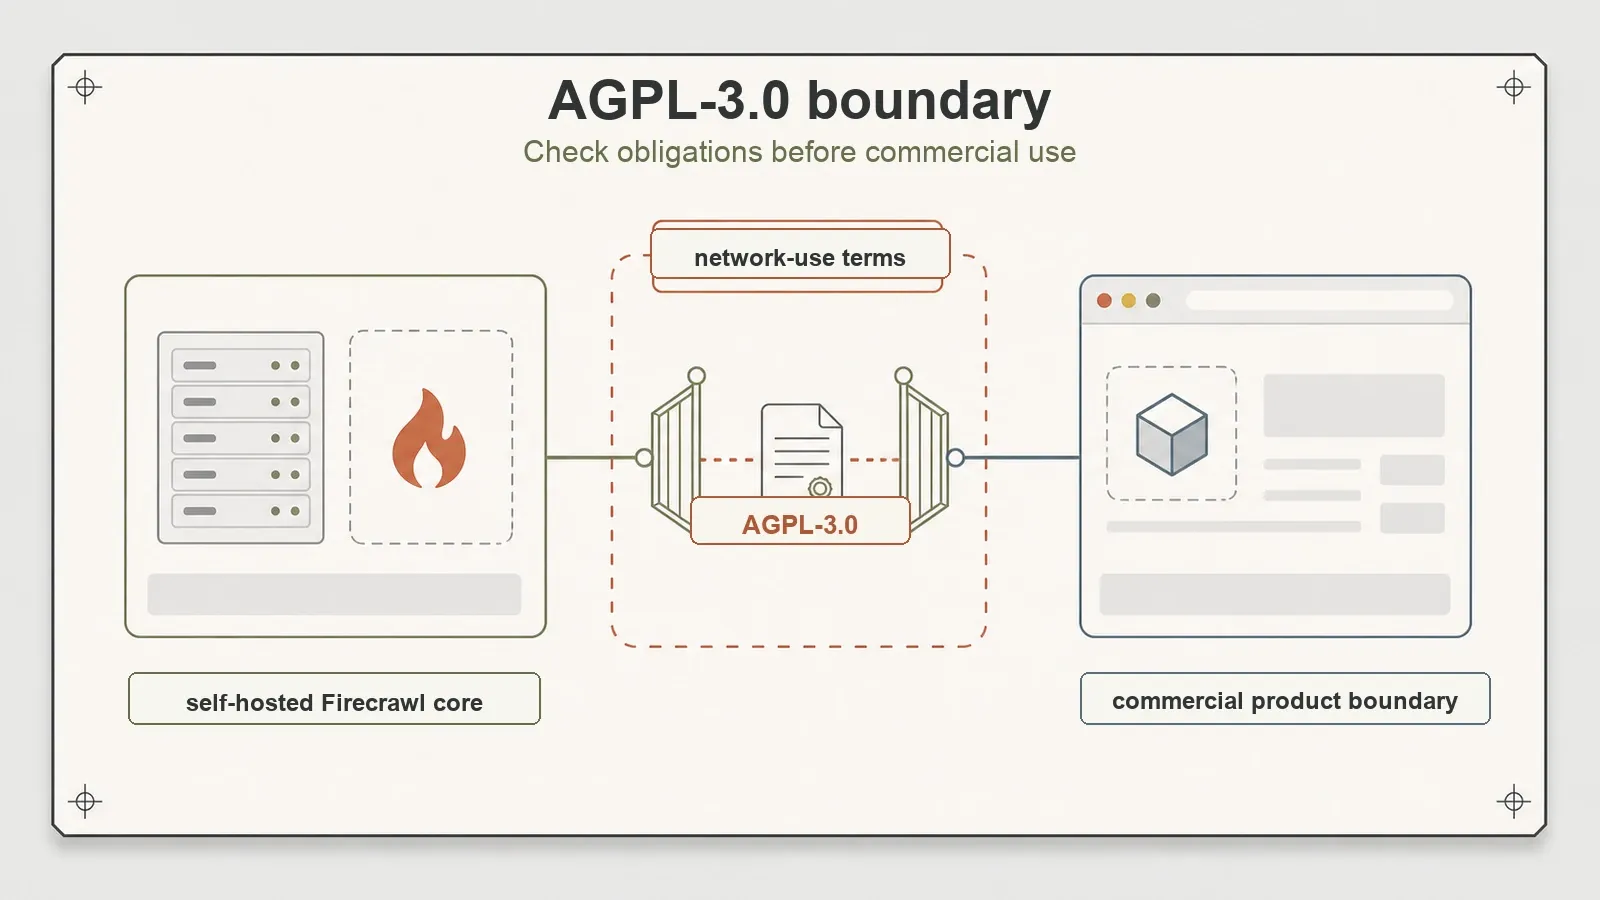
Firecrawl ได้รับอนุญาตภายใต้ AGPL-3.0 นั่นไม่ใช่ข้อความที่ถูกทิ้งท้ายใน README — มันคือ copyleft ที่เข้มแข็งพร้อมข้อกำหนดการใช้งานเครือข่าย และมันสามารถส่งผลโดยตรงต่อว่าคุณสามารถสร้างผลิตภัณฑ์เชิงพาณิชย์บนอินสแตนซ์ที่โฮสต์เองได้หรือไม่
สรุปสั้นๆ: ข้อผูกพัน GPL มาตรฐานจะเกิดขึ้นเมื่อมีการแจกจ่าย AGPL ไปไกลกว่านั้น — ข้อกำหนดการใช้งานเครือข่ายหมายถึงการนำเสนอการทำงานของซอฟต์แวร์ให้กับผู้ใช้ผ่านเครือข่ายสามารถนับเป็นการใช้งานประเภทที่มาพร้อมกับข้อผูกพันในการเปิดเผยซอร์สโค้ด หากคุณกำลังฝัง Firecrawl ที่โฮสต์เองไว้ในบริการที่ลูกค้าของคุณเข้าถึงผ่านอินเทอร์เน็ต ข้อกำหนดนั้นอยู่ในขอบเขตโดยตรง และ "เราไม่เคยเผยแพร่ไบนารี" ไม่ใช่ทางออกที่ผู้คนคิดว่าเป็นเช่นนั้น
ผมไม่ใช่ทนายความของคุณ และการตีความใบอนุญาตขึ้นอยู่กับวิธีการใช้งานของคุณอย่างแม่นยำ แต่สำหรับการแนะนำเชิงพาณิชย์ใดๆ AGPL-3.0 เป็นข้อพิจารณาอันดับแรก ไม่ใช่ข้อความเล็กๆ โปรดปรึกษาผู้ที่รับผิดชอบด้านใบอนุญาตในบริษัทของคุณก่อนที่คุณจะสร้างบนมัน การระบุสิ่งนี้ไม่ใช่การตำหนิ Firecrawl — มีเครื่องมือที่ยอดเยี่ยมมากมายที่เป็น AGPL — มันเป็นเพียงข้อเท็จจริงที่คุณต้องทราบตั้งแต่เนิ่นๆ
Thunderbit's Developer Stack เข้ากันได้อย่างไร
ลองใช้ Thunderbit สำหรับการดึงข้อมูลเว็บ
หากเป้าหมายที่แท้จริงของคุณคือ "หน้าเว็บ → Markdown พร้อมใช้งานสำหรับ LLM" หรือ "หน้าเว็บ → ข้อมูลที่มีโครงสร้าง" และค่าใช้จ่ายในการดำเนินการหกคอนเทนเนอร์รวมถึงคำถามเกี่ยวกับ AGPL ไม่ใช่สิ่งที่คุณต้องการรับผิดชอบ นั่นคือช่องว่างที่ Thunderbit's developer stack ถูกสร้างขึ้นมาเพื่อเติมเต็ม ด้วยเอนจิน AI เดียวกันที่อยู่เบื้องหลังผู้ใช้ส่วนขยายกว่า 100,000 รายของเรา ซึ่งเปิดเผยสามวิธีสำหรับการทำงานทางเทคนิค — โดยมีโครงสร้างพื้นฐานอยู่ฝั่งของเรา
- Open API (REST)
POST /distillเปลี่ยนหน้าเว็บให้เป็น Markdown ที่สะอาดพร้อมใช้งานสำหรับ LLM;POST /extractส่งคืนข้อมูลที่มีโครงสร้างตาม JSON Schema ที่คุณกำหนด การเรนเดอร์ JS, การจัดการป้องกันบอท และเนื้อหาแบบไดนามิกจะถูกจัดการฝั่งเซิร์ฟเวอร์ — คุณไม่ต้องรันคอนเทนเนอร์เบราว์เซอร์ แฟล็กrenderMode(none/basic/full) ควบคุมความยากในการเรนเดอร์ และปลายทางแบบแบตช์รองรับ URL ได้สูงสุด 100 รายการสำหรับการกลั่นกรอง - เซิร์ฟเวอร์ MCP เซิร์ฟเวอร์ Model Context Protocol อย่างเป็นทางการ เพื่อให้เอเจนต์ AI ภายใน Claude หรือ Cursor สามารถสแครปข้อมูลระหว่างงาน:
thunderbit_suggest_fieldsเพื่อวางแผนการดึงข้อมูล (ฟรี),thunderbit_distillสำหรับ Markdown,thunderbit_extractสำหรับข้อมูลที่มีโครงสร้าง เอเจนต์ตัดสินใจ เมื่อใด ที่จะดึงข้อมูลโดยไม่ต้องออกจากสภาพแวดล้อมของมัน - CLI
npx -y @thunderbit/thunderbit-cliรันการสแครปจากเทอร์มินัล, สคริปต์, CI หรือ cron — ไม่มีเบราว์เซอร์, ไม่มีสแต็กให้ดูแล ส่งตรงไปยังเครื่องมืออื่นๆ:thunderbit distill "$URL" -f markdown | claude -p "summarise"
ความแตกต่างกับ Firecrawl แบบโฮสต์เองนั้นชัดเจน Firecrawl แบบโฮสต์เองให้คุณควบคุมได้อย่างเต็มที่และรับผิดชอบการดำเนินการอย่างเต็มที่: หกคอนเทนเนอร์, น้ำหนักของการตั้งค่า, ข้อกำหนด AGPL และไม่มี Fire-engine สำหรับการป้องกันการบล็อก Thunderbit's API/MCP/CLI แลกเปลี่ยนการควบคุมนั้นกับเอนจินที่โฮสต์ซึ่งส่งคืน JSON ที่มีโครงสร้างตรงตาม Schema — ไม่ใช่แค่ Markdown ดิบ — โดยมีคอนเทนเนอร์, เลเยอร์ป้องกันบอท และข้อผูกพัน copyleft ถูกยกออกจากจานของคุณ เครื่องมือที่แตกต่างกันสำหรับความต้องการโครงสร้างพื้นฐานที่แตกต่างกัน
นี่คือข้อแลกเปลี่ยนในมุมมองเดียว:
| ข้อพิจารณา | Firecrawl แบบโฮสต์เอง | Thunderbit dev stack (API · MCP · CLI) |
|---|---|---|
| รูปแบบการใช้งาน | บริการที่คุณดำเนินการ (6 คอนเทนเนอร์) | API ที่โฮสต์ที่คุณเรียกใช้ |
| การเริ่มต้นใช้งาน | docker compose เรียกใช้สแต็ก 6 บริการ | คีย์ API แล้วจึงส่งคำขอ |
| การเรนเดอร์ JS | playwright-service ที่มาพร้อมเครื่อง (คุณรันเอง) | ฝั่งเซิร์ฟเวอร์, แฟล็ก renderMode |
| เอาต์พุตที่มีโครงสร้าง | ต้องการคีย์ LLM (/extract, json) | POST /extract พร้อม JSON Schema |
| เลเยอร์ป้องกันบอท | ไม่มีแบบโฮสต์เอง (Fire-engine มีเฉพาะในคลาวด์) | จัดการฝั่งเซิร์ฟเวอร์ |
| ใบอนุญาต | AGPL-3.0 (copyleft การใช้งานเครือข่าย) | API เชิงพาณิชย์, ไม่มี copyleft บนโค้ดของคุณ |
| เหมาะที่สุดเมื่อ | คุณต้องการการควบคุมเต็มที่และจะรันโครงสร้างพื้นฐาน | คุณต้องการ Markdown/ข้อมูลที่มีโครงสร้างโดยไม่ต้องดำเนินการ |
ไม่มีสิ่งใดที่ "ดีกว่า" โดยรวม หากการรันแพลตฟอร์ม คือ จุดสำคัญสำหรับคุณ — การควบคุมข้อมูลอย่างเต็มที่, ไม่มี dependency ภายนอก และ AGPL เหมาะสมกับสถานการณ์ของคุณ — Firecrawl แบบโฮสต์เองเป็นตัวเลือกที่มีความสามารถและได้รับการดูแลอย่างต่อเนื่อง หากคุณต้องการเรียกใช้ API และหลีกเลี่ยงชีวิตหกคอนเทนเนอร์ นั่นคือข้อเสนอสำหรับสแต็ก Thunderbit
ใครควรโฮสต์ Firecrawl ด้วยตัวเองจริงๆ
ตัดเรื่องความตื่นเต้นออกไป ภาพก็ชัดเจนพอที่จะจัดเรียงตามความต้องการได้
โฮสต์ Firecrawl ด้วยตัวเองหาก คุณต้องการควบคุมโครงสร้างพื้นฐานการสแครปของคุณอย่างเต็มที่ คุณคุ้นเคยกับการดำเนินการ Redis / RabbitMQ / Postgres / FoundationDB ในการผลิต ความต้องการในการเรนเดอร์ของคุณสมเหตุสมผลกับคอนเทนเนอร์ playwright-service และ AGPL-3.0 เหมาะสมกับวิธีการใช้งานของคุณ ความสามารถหลักเป็นจริง: ผมได้ Markdown ที่สะอาด มีโครงสร้าง พร้อมใช้งานสำหรับ LLM จากทั้งหน้าเว็บแบบคงที่และหน้าเว็บที่เรนเดอร์ด้วย JS และสแต็กทั้งหมดทำงานบนอิมเมจที่สร้างไว้ล่วงหน้า
มองหาทางเลือกอื่นหาก คุณต้องการสคริปต์ในเครื่องอย่างรวดเร็ว (นี่คือการตั้งค่าที่หนักที่สุดในฐานนี้, จบ), คุณต้องการการป้องกันการบล็อกระดับคลาวด์โดยไม่ต้องดำเนินการเอง (แบบโฮสต์เองไม่มี Fire-engine) หรือข้อกำหนดการใช้งานเครือข่าย AGPL ขัดแย้งกับแผนการเชิงพาณิชย์ของคุณ สำหรับกรณีที่ "ฉันแค่ต้องการ Markdown หรือข้อมูลที่มีโครงสร้างจาก URL โดยไม่ต้องดำเนินการ" API ที่โฮสต์เช่น /distill และ /extract ของ Thunderbit ครอบคลุมพื้นที่เดียวกันโดยไม่มีคอนเทนเนอร์
การอ่านเบื้องต้นของผม: แกนหลักแข็งแกร่ง, ความมุ่งมั่นในการดำเนินการสูง และใบอนุญาตที่คุณต้องเคลียร์ก่อนที่จะสร้างเชิงพาณิชย์ มันสมควรได้รับตำแหน่งสำหรับทีมที่ต้องการเป็นเจ้าของ pipeline ทั้งหมด — และมันเรียกร้องมากจากคนอื่นๆ ผมจะกลับมาตรวจสอบอีกครั้งเมื่อผมได้รัน /v1/crawl, ทดสอบ /extract ด้วยคีย์ LLM และตรวจสอบการสร้างจากซอร์สโค้ดบน daemon ที่ไม่ใช่ colima; นั่นคือคำถามที่เปิดอยู่ระหว่างนี้กับการตัดสินขั้นสุดท้าย
ลองใช้ Thunderbit สำหรับการดึงข้อมูลเว็บ Get Started Free
คำถามที่พบบ่อย
Firecrawl แบบโฮสต์เองเหมือนกับเวอร์ชันคลาวด์หรือไม่?
ไม่เหมือน แบบโฮสต์เองให้เอนจินหลักในการสแครปเป็น Markdown และการเรนเดอร์ JavaScript ผ่าน playwright-service ที่มาพร้อมเครื่อง แต่ไม่รวม Fire-engine ซึ่งเป็นเลเยอร์ป้องกันการบล็อกที่เป็นกรรมสิทธิ์ของผลิตภัณฑ์คลาวด์ คุณสมบัติ AI เช่น ปลายทาง /extract และเอาต์พุต json ยังต้องใช้คีย์ LLM ของคุณเอง (OpenAI หรือ Ollama) ในรีวิวนี้ผมทดสอบเฉพาะสแต็กแบบโฮสต์เองเท่านั้น API คลาวด์อยู่นอกขอบเขต
Firecrawl แบบโฮสต์เองต้องการคอนเทนเนอร์กี่ตัว? หกตัว: api, playwright-service, redis, rabbitmq, nuq-postgres และ foundationdb มันเป็นสแต็กบริการที่สมบูรณ์ ไม่ใช่ไบนารีเดียว — ซึ่งเป็นเหตุผลว่าทำไมมันจึงเป็นการตั้งค่าที่หนักที่สุดในงานวิจัยนี้ วางแผนสำหรับค่าใช้จ่ายในการดำเนินการของโครงสร้างพื้นฐานของ message-broker, แคช และฐานข้อมูล ไม่ใช่แค่สคริปต์
Firecrawl สามารถจัดการหน้าเว็บที่มี JavaScript มากมายเมื่อโฮสต์เองได้หรือไม่? ได้ จากการทดสอบของผม playwright-service ที่มาพร้อมเครื่องจะเรนเดอร์หน้าเว็บในเอนจินเบราว์เซอร์จริงก่อนการดึงข้อมูล ผมยืนยันสิ่งนี้บน quotes.toscrape.com/js/ ซึ่งคำคมของ Einstein — เนื้อหาที่มีอยู่หลังจาก JavaScript ทำงานเท่านั้น — ปรากฏใน Markdown ที่ส่งคืน ความสามารถในการเรนเดอร์นั้นคือเหตุผลที่หนึ่งในหกคอนเทนเนอร์คือเบราว์เซอร์แบบ headless
ใบอนุญาต AGPL-3.0 มีผลต่อการใช้งานเชิงพาณิชย์หรือไม่? อาจมีผล และคุณควรพิจารณาว่าเป็นคำถามอันดับแรก AGPL-3.0 เป็น copyleft ที่เข้มแข็งพร้อมข้อกำหนดการใช้งานเครือข่าย ซึ่งหมายถึงการนำเสนอการทำงานของซอฟต์แวร์ให้กับผู้ใช้ผ่านเครือข่ายสามารถมาพร้อมกับข้อผูกพันในการเปิดเผยซอร์สโค้ด — แม้ว่าคุณจะไม่เคยแจกจ่ายไบนารีก็ตาม หากคุณวางแผนที่จะสร้างผลิตภัณฑ์เชิงพาณิชย์บนอินสแตนซ์ที่โฮสต์เอง โปรดปรึกษาผู้ที่รับผิดชอบด้านใบอนุญาตในบริษัทของคุณก่อนที่คุณจะตัดสินใจ รีวิวนี้ระบุใบอนุญาต; ไม่ใช่คำแนะนำทางกฎหมาย
ความแตกต่างระหว่าง Firecrawl และเครื่องมือสำหรับนักพัฒนาของ Thunderbit คืออะไร?
Firecrawl แบบโฮสต์เองเป็นบริการที่คุณดำเนินการ — หกคอนเทนเนอร์ที่คุณรันเอง พร้อมข้อกำหนด AGPL-3.0 และไม่มีเลเยอร์ป้องกันการบล็อกในตัว สแต็กสำหรับนักพัฒนาของ Thunderbit (Open API, เซิร์ฟเวอร์ MCP, CLI) เป็นเอนจินที่โฮสต์ที่คุณเรียกใช้: POST /distill สำหรับ Markdown, POST /extract สำหรับข้อมูลที่มีโครงสร้างตาม JSON-Schema โดยมีการเรนเดอร์ JS และการจัดการป้องกันบอทฝั่งเซิร์ฟเวอร์ และไม่มีข้อผูกพัน copyleft บนโค้ดของคุณเอง Firecrawl เหมาะสำหรับทีมที่ต้องการควบคุมโครงสร้างพื้นฐานอย่างเต็มที่; Thunderbit เหมาะสำหรับผู้ที่ต้องการผลลัพธ์โดยไม่มีภาระในการดำเนินการ




