
ปัจจุบันทราฟฟิกอัตโนมัติคิดเป็น 53% ของทั้งเว็บ มากกว่าผู้ใช้จริงเสียอีก และระบบป้องกันบอทก็เข้มงวดขึ้นกว่าที่เคย
ผมเคยเห็นกับตาว่าแค่พลาดนิดเดียว — อย่างเช่นใช้ user agent ผิดตัว — ก็ทำให้โปรเจกต์ดึงข้อมูลของคุณชนกำแพง error 403 ได้เลย สำหรับทีมขาย อีคอมเมิร์ซ และทีมปฏิบัติการ การถูกบล็อกหมายถึงลีดที่หายไป ราคาที่ไม่อัปเดต หรือรายได้ที่สูญเสียไปจริง ๆ
นี่คือสิ่งที่ผมได้เรียนรู้เกี่ยวกับ user agent สำหรับการสแครป — แนวปฏิบัติสำคัญ ข้อผิดพลาดที่พบบ่อย และวิธีที่เครื่องมืออย่าง Thunderbit เข้ามาจัดการเรื่องทั้งหมดนี้ให้อัตโนมัติ

ทำไมการเลือก User Agent ที่ดีที่สุดสำหรับการสแครปจึงสำคัญ
เริ่มจากพื้นฐานก่อน: user agent คืออะไร? ให้นึกว่าเป็น “บัตรประจำตัว” ของเบราว์เซอร์ ทุกครั้งที่คุณเข้าเว็บไซต์ — ไม่ว่าจะเป็นคนหรือบอท — เบราว์เซอร์จะส่งสตริง User-Agent ไปพร้อมกับ request headers มันเป็นข้อความแนะนำตัวสั้น ๆ เช่น “สวัสดี ฉันคือ Chrome บน Windows” หรือ “ฉันคือ Safari บน iPhone” (ScraperAPI) ตัวอย่าง user agent ของ Chrome ทั่วไปจะหน้าตาแบบนี้:
Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36
เว็บไซต์ใช้ข้อมูลนี้ด้วยเหตุผลหลัก 2 ข้อ:
- เพื่อแสดงเนื้อหาให้เหมาะสม เช่น หน้าจอมือถือกับเดสก์ท็อป
- เพื่อจับบอทและสแครปเปอร์
ถ้า user agent ของคุณบอกว่าเป็น “python-requests/2.28.1” หรือ “Scrapy/2.9.0” ก็แทบไม่ต่างจากติดป้าย “สวัสดี ฉันคือบอท!” ไว้หน้าตัวเอง เว็บไซต์จำนวนมากมีรายการบล็อกชื่อเหล่านี้ชัดเจน และจะปิดประตูใส่คุณทันที ก่อนที่คุณจะพูดคำว่า “403 Forbidden” เสียอีก แต่ถ้าคุณใช้ user agent ของเบราว์เซอร์ยอดนิยมที่อัปเดตล่าสุด โอกาสจะกลมกลืนไปกับทราฟฟิกปกติก็จะสูงขึ้นมาก
พูดสั้น ๆ คือ: user agent คือสิ่งที่ใช้พรางตัว ยิ่งพรางได้แนบเนียนเท่าไร โอกาสได้ข้อมูลที่ต้องการก็ยิ่งมากขึ้นเท่านั้น
บทบาทของ User Agent ต่อความสำเร็จในการ Web Scraping
ทำไมการเลือก user agent ถึงมีผลมากขนาดนั้น? เพราะมันคือแนวป้องกันด่านแรกของระบบ anti-bot ส่วนใหญ่ นี่คือสิ่งที่อาจเกิดขึ้นถ้าเลือกผิด:
- โดนบล็อกทันที (403/429): ถ้าใช้ UA จากไลบรารีสแครปทั่วไป คุณอาจโดนบล็อกตั้งแต่ยังไม่เห็นหน้าโฮมเพจ (Webmasters StackExchange)
- ข้อมูลว่างหรือข้อมูลปลอม: บางเว็บไซต์จะส่งหน้าว่างหรือหน้า “dummy” ให้กับ user agent ที่ดูน่าสงสัย
- CAPTCHA หรือการรีไดเรกต์: UA ที่ดูเหมือนบอทอาจทำให้เจอคำถาม “คุณเป็นมนุษย์หรือไม่?” หรือวนไปหน้าเข้าสู่ระบบไม่รู้จบ
- ถูกจำกัดความถี่และแบน: ถ้าเรียกเว็บเดิมด้วย UA เดิมซ้ำ ๆ คุณอาจถูกจำกัดการใช้งานหรือโดนแบน IP
มาดูกันว่า user agent แบบต่าง ๆ ให้ผลอย่างไร:
| User Agent String | ผลลัพธ์บนเว็บไซต์ส่วนใหญ่ (2026) |
|---|---|
python-requests/2.28.1 | ถูกบล็อกทันที ถูกระบุว่าเป็นบอท |
Scrapy/2.9.0 (+https://scrapy.org) | ถูกบล็อกหรือถูกส่งเนื้อหาปลอม |
Mozilla/5.0 (Windows NT 10.0; Win64; x64)... | ถูกมองว่าเป็นผู้ใช้จริง เข้าถึงได้ |
AhrefsBot/7.0 (+http://ahrefs.com/robot/) | ถูกบล็อก เป็น crawler ที่รู้จักกันดี |
| UA ว่างเปล่าหรือเป็นข้อความมั่ว ๆ | บางครั้งผ่านได้ แต่ส่วนใหญ่ดูน่าสงสัย |
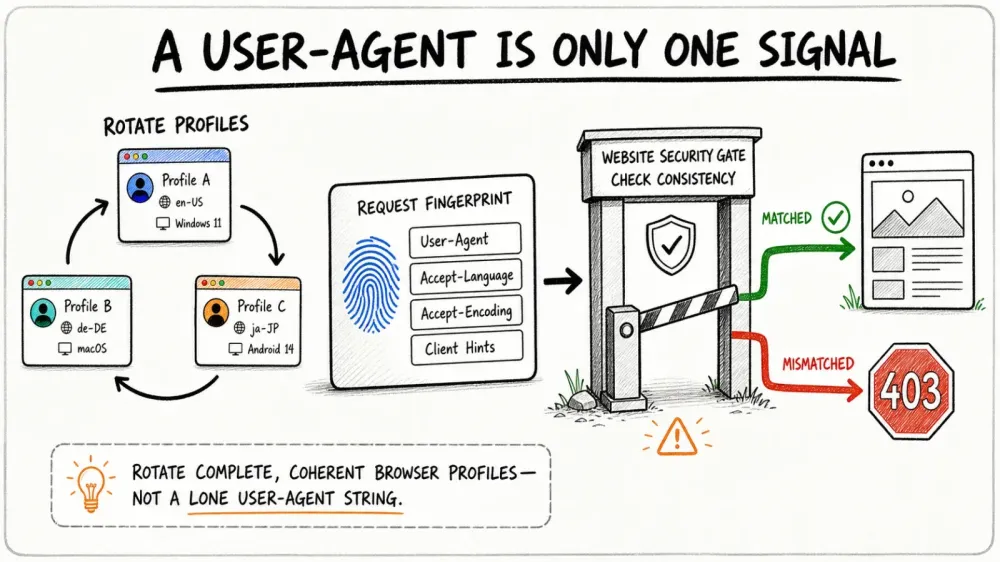
บทเรียนคือ: เลือกพรางตัวให้ฉลาด และอย่าลืมว่า anti-bot สมัยใหม่ไม่ได้ดูแค่ user agent อย่างเดียว พวกมันยังเช็กด้วยว่า headers อื่น ๆ ของคุณ เช่น Accept-Language หรือ Referer สอดคล้องกันไหม ถ้าคุณอ้างว่าเป็น Chrome แต่ส่ง headers ไม่ตรงกัน คุณก็ยังโดนจับได้อยู่ดี (ScraperAPI)
ดึงข้อมูลจากทุกเว็บไซต์ด้วย AI agentic web scraper ของ Thunderbit จัดการการเรนเดอร์และโครงสร้างหน้าเว็บให้เอง คุณจึงไม่ต้องมานั่งจัดการ user agent ด้วยมือ Get Started Free
ตรงนี้แหละที่ Thunderbit เข้ามาช่วย ผมได้คุยกับผู้ใช้งานธุรกิจจำนวนมาก — ทั้งฝ่ายขาย ผู้จัดการอีคอมเมิร์ซ และเอเจนต์อสังหาฯ — พวกเขาแค่อยากได้ข้อมูล ไม่ได้อยากเรียนรู้เรื่อง HTTP headers แบบลึก ๆ นั่นคือเหตุผลที่เราออกแบบ Thunderbit ให้การจัดการ user agent เป็นเรื่องอัตโนมัติและมองไม่เห็นเบื้องหลัง
Thunderbit: ทำให้การจัดการ User Agent ง่ายสำหรับทุกคน
ด้วย one-click scraping ของ Thunderbit คุณไม่ต้องเลือก user agent เองเลย ระบบ AI จะเลือก signature ของเบราว์เซอร์ที่สมจริงและอัปเดตที่สุดให้ในแต่ละเว็บ ไม่ว่าคุณจะใช้ Thunderbit Chrome Extension (ซึ่งใช้ UA จริงของ Chrome โดยตรง) หรือการสแครปบนคลาวด์ (ที่ AI จะสลับใช้กลุ่ม UA ของเบราว์เซอร์เวอร์ชันปัจจุบัน) คุณก็จะกลมกลืนไปกับทราฟฟิกปกติได้ตลอด
และไม่ได้มีแค่ user agent เท่านั้น Thunderbit ยังส่งชุด headers แบบครบถ้วนและสอดคล้องกัน เช่น Accept-Language, Accept-Encoding, Client Hints และอื่น ๆ เพื่อให้ request ของคุณดูและทำงานเหมือนเบราว์เซอร์จริง ไม่มี headers ที่ไม่เข้ากัน ไม่มีธงเตือนว่าเป็นบอท
ข้อดีที่สุดคือ คุณไม่ต้องตั้งค่าอะไรเลย AI ของ Thunderbit จัดการรายละเอียดเชิงเทคนิคทั้งหมดให้หลังบ้าน คุณจึงโฟกัสกับสิ่งสำคัญได้เต็มที่: การได้ข้อมูลที่เชื่อถือได้และมีคุณภาพสูง
ลอง Thunderbit Agentic Web Scraper ฟรี ติดตั้ง Chrome extension ฟรี แล้วดึงข้อมูลแบบมีโครงสร้างจากทุกหน้าได้ในคลิกเดียว โดยไม่ต้องปลอม header เอง Get Started Free
ทำไมการหมุนเวียน User Agent แบบไดนามิกจึงเป็น Best Practice ที่ขาดไม่ได้
สมมติว่าคุณเจอ user agent ที่เหมาะที่สุดแล้ว คุณควรใช้มันกับทุก request เลยไหม? ยังไม่ควร ในปี 2026 การใช้ UA เดิมซ้ำ ๆ เป็นการบอกใบ้ที่ชัดมาก ผู้ใช้จริงมีเบราว์เซอร์ เวอร์ชัน และอุปกรณ์หลากหลาย ถ้า scraper ของคุณยิงเว็บ 500 ครั้งติดด้วย UA เดิม มันก็เหมือนส่งฝาแฝดหน้าตาเหมือนกันมาเป็นขบวน — ไม่มีใครหลงแน่นอน
นั่นจึงเป็นเหตุผลที่ การหมุนเวียน user agent แบบไดนามิก กลายเป็นมาตรฐานของวงการ แนวคิดง่ายมาก: สลับใช้ user agent ที่สมจริงและอัปเดตล่าสุดจากลิสต์ในแต่ละ request หรือแต่ละ session วิธีนี้ทำให้ scraper ของคุณดูเหมือนผู้เข้าชมจริงที่หลากหลาย ไม่ใช่สคริปต์อัตโนมัติตัวเดียว (Capsolver)
การหมุนเวียนด้วย AI ของ Thunderbit ยกระดับไปอีกขั้น สำหรับการ crawl หลายหน้า หรือ job แบบตั้งเวลา Thunderbit จะสลับ user agent ให้อัตโนมัติ และยังจับคู่กับ proxy IP ที่แตกต่างกันด้วย ถ้าเว็บเริ่มระแวง Thunderbit จะปรับตัวแบบเรียลไทม์ — เปลี่ยน UA ปรับ headers หรือชะลอ request ตามความเหมาะสม ทั้งหมดนี้เกิดขึ้นหลังบ้าน ทำให้การสแครปของคุณไม่ถูกตรวจจับ และข้อมูลยังไหลต่อเนื่อง
User Agent กับ Request Headers: พลังของความสอดคล้อง
เคล็ดลับระดับโปร: user agent เป็นเพียงส่วนหนึ่งของ “ลายนิ้วมือ” ของ request เท่านั้น ระบบ anti-bot สมัยใหม่จะเช็กว่า UA ของคุณสอดคล้องกับ headers อื่น ๆ อย่าง Accept-Language, Accept-Encoding และ Referer หรือไม่ ถ้าคุณอ้างว่าเป็น Chrome บน Windows แต่ส่ง Accept-Language แบบฝรั่งเศสจาก IP ที่อยู่ในนิวยอร์ก นั่นคือธงแดงชัด ๆ (ScraperAPI)
แนวปฏิบัติที่ดี:
- ส่ง headers ให้ครบและให้ตรงกับ user agent เสมอ
- ทำให้ Accept-Language และ Accept-Encoding สอดคล้องกับ UA และตำแหน่ง IP ของคุณ ถ้าเป็นไปได้
- ใช้เครื่องมือ developer tools ของเบราว์เซอร์เพื่อดู request จริง แล้วคัดลอกชุด headers ทั้งหมดของ UA ที่คุณเลือก
Thunderbit จัดการทั้งหมดนี้ให้คุณ AI ของเราจะทำให้ทุก request ตรงกันอย่างสมบูรณ์ — ทั้ง user agent, headers และแม้แต่ browser fingerprinting คุณจะได้ request profile ที่เหมือนมนุษย์โดยแทบไม่ต้องทำอะไรเลย
หลีกเลี่ยงข้อผิดพลาดที่พบบ่อย: อะไรที่ไม่ควรทำกับ User Agent
ผมเห็นโปรเจกต์สแครปจำนวนมากล้มเหลวด้วยเหตุผลเดิม ๆ ต่อไปนี้คือความผิดพลาดใหญ่ที่ควรเลี่ยง:
- ใช้ UA ดีฟอลต์จากไลบรารีสแครป: สตริงอย่าง
python-requests/2.x,Scrapy/2.9.0หรือJava/1.8มักเป็นตัวกระตุ้นให้โดนบล็อกทันที - ใช้เวอร์ชันเบราว์เซอร์ที่เก่า: ถ้าในปี 2026 คุณยังอ้างว่าเป็น Chrome 120 อยู่ น่าสงสัยแน่นอน — รุ่นนั้นเก่ามากแล้ว ควรใช้ UA จาก stable channel ปัจจุบันเสมอ (ขณะเขียนบทความนี้คือ Chrome 147) ลิสต์ที่ล้าสมัยไป 12 เดือนก็ถือว่าเป็นสัญญาณของบอทแล้ว
- headers ไม่ตรงกัน: อย่าส่ง Chrome UA แต่ขาดหรือส่ง Accept-Language, Accept-Encoding หรือ Client Hints ที่ไม่สอดคล้องกัน
- UA ของ crawler ที่เป็นที่รู้จัก: อะไรก็ตามที่มีคำว่า “bot,” “crawler,” “spider,” หรือชื่อเครื่องมืออย่าง AhrefsBot ถือเป็นธงแดง
- UA ว่างหรือมั่ว ๆ: บางครั้งอาจผ่านได้ แต่ส่วนใหญ่ดูน่าสงสัยและไม่เสถียร
เช็กลิสต์สั้น ๆ สำหรับ user agent ที่ปลอดภัย:
- ใช้ UA ของเบราว์เซอร์จริงที่อัปเดตล่าสุด (Chrome, Firefox, Safari)
- หมุนเวียนผ่าน pool ของ UA
- ให้ headers สอดคล้องกับ UA
- อัปเดตรายการ UA ทุกเดือน เพราะเบราว์เซอร์เปลี่ยนเร็ว
- หลีกเลี่ยงทุกอย่างที่ดูเหมือน “automation” ชัดเจน
Thunderbit ในการใช้งานจริง: สถานการณ์สำหรับฝ่ายขายและฝ่ายปฏิบัติการ
มาดูแบบใช้งานจริงกันว่า การจัดการ user agent ของ Thunderbit ช่วยทีมต่าง ๆ ได้อย่างไร:
| กรณีใช้งาน | วิธีเดิม: สแครปด้วยมือ | เมื่อใช้ Thunderbit | ผลลัพธ์ |
|---|---|---|---|
| หา Sales Lead | โดนบล็อกบ่อย ข้อมูลขาดหาย | AI เลือก UA ที่ดีที่สุด หมุนเวียนอัตโนมัติ เลียนแบบการท่องเว็บจริง | ได้ลีดมากขึ้น คุณภาพดีขึ้น bounce น้อยลง |
| ติดตามอีคอมเมิร์ซ | สคริปต์พัง โดนแบน IP | สแครปบนคลาวด์พร้อม UA ไดนามิกและการหมุน proxy | ติดตามราคา/สต็อกได้เสถียร |
| รายการอสังหาฯ | ต้องปรับจุกจิก โดนบล็อก | AI ปรับ UA/headers ให้เหมาะ และจัดการหน้าย่อยอัตโนมัติ | ได้รายการทรัพย์สินครบถ้วนและอัปเดตล่าสุด |

ทีมขายทีมหนึ่งใช้ Thunderbit สแครปเว็บไซต์เพื่อหา lead หลายพันเว็บ และพบว่าอัตราอีเมลเด้งกลับอยู่เพียง ประมาณ 8% เท่านั้น — เทียบกับ 15–20% จากรายชื่อที่ซื้อมา (Reddit) นี่คือพลังของการสแครปที่สดใหม่และดูเหมือนคนจริง
แบบทีละขั้น: วิธีสแครปด้วย User Agent ที่ดีที่สุดโดยใช้ Thunderbit
เริ่มกับ Thunderbit ได้ง่ายมาก — ไม่ต้องมีทักษะเทคนิคก็ทำได้:
- ติดตั้ง Thunderbit Chrome Extension
- ไปยังเว็บไซต์เป้าหมายของคุณ หากต้องล็อกอินก็เข้าได้ — Thunderbit รองรับหน้าที่ต้องล็อกอินด้วย
- คลิก “One Click Extract” AI ของ Thunderbit จะสแกนหน้าและแนะนำคอลัมน์ที่เหมาะสำหรับการสแครป
- ตรวจสอบและปรับฟิลด์ตามต้องการ เปลี่ยนชื่อ เพิ่ม หรือลบคอลัมน์ได้ตามความเหมาะสม
- คลิก “Scrape” Thunderbit จะดึงข้อมูลให้ พร้อมสลับ user agent และ headers อยู่เบื้องหลัง
- ส่งออกข้อมูลของคุณ ส่งตรงไปยัง Excel, Google Sheets, Airtable, Notion หรือดาวน์โหลดเป็น CSV/JSON
ไม่ต้องคอยเลือกหรืออัปเดต user agent เอง — AI ของ Thunderbit จัดการทั้งหมด และปรับตามแต่ละเว็บไซต์เพื่อให้สำเร็จสูงสุด
สแครปด้วยการหมุนเวียน User Agent ที่ขับเคลื่อนด้วย AI Thunderbit รันงานสแครปผ่านโครงสร้างพื้นฐานของตัวเอง ดังนั้นคลิกเดียวก็แทนสคริปต์หมุน user-agent ด้วยมือได้เลย Get Started Free
เปรียบเทียบ Thunderbit กับการจัดการ User Agent แบบดั้งเดิม
มาดูกันว่า Thunderbit เทียบกับวิธี manual แบบเก่าเป็นอย่างไร:
| ฟีเจอร์/งาน | วิธีสแครปแบบ manual | แนวทางของ Thunderbit |
|---|---|---|
| การตั้งค่า User Agent | ค้นหาและกำหนดในโค้ด | อัตโนมัติ เลือกด้วย AI ตามแต่ละเว็บ |
| การอัปเดต UA | ต้องทำเอง ลืมได้ง่าย | AI อัปเดตตามเทรนด์เบราว์เซอร์อย่างต่อเนื่อง |
| การหมุนเวียน UA | ต้องเขียน logic เอง | มีในตัว หมุนเวียนอย่างชาญฉลาด |
| ความสอดคล้องของ Headers | ต้องจับคู่ headers กับ UA ด้วยมือ | AI ทำให้ครบและสอดคล้องทั้งหมด |
| การรับมือบล็อก/CAPTCHA | ต้องสลับเอง ดูแลเยอะ | AI ปรับตัว ลองใหม่ และหมุนเวียนให้อัตโนมัติ |
| ทักษะเทคนิคที่ต้องใช้ | สูง (ต้องเขียนโค้ดและรู้ HTTP) | ไม่ต้อง — ออกแบบมาสำหรับผู้ใช้ธุรกิจ |
| เวลาที่เสียไปกับการแก้ปัญหา | บ่อยและน่าหงุดหงิด | น้อยมาก — โฟกัสที่ข้อมูล ไม่ใช่ปวดหัวกับการสแครป |
Thunderbit ถูกสร้างมาสำหรับทุกคนที่ต้องการการสแครปที่เชื่อถือได้และสเกลได้ โดยไม่ต้องแบกภาระทางเทคนิค
ดูว่า Agentic Web Scraping ทำงานอย่างไร AI ของ Thunderbit อ่านหน้าเว็บเหมือนคนจริงและดึงข้อมูลได้ในคลิกเดียว โดยไม่ต้องปรับสแครปเปอร์ด้วยมือ Get Started Free
ประเด็นสำคัญ: สร้างกลยุทธ์ User Agent ที่พร้อมรับอนาคต
นี่คือสิ่งที่ผมเรียนรู้มาเกี่ยวกับการจัดการ user agent ในปี 2026 — บางเรื่องก็เรียนรู้แบบเจ็บตัว:
- อย่าใช้ user agent ดีฟอลต์หรือที่ล้าสมัยเด็ดขาด นี่คือสาเหตุอันดับ 1 ที่ทำให้สแครปเปอร์โดนบล็อก
- หมุนเวียน user agent แบบไดนามิก ความหลากหลายคือเพื่อนของคุณ อย่าปล่อยให้ scraper ดูเหมือนขบวนหุ่นยนต์
- ทำให้ headers สอดคล้องและสมจริง user agent จะดีแค่ไหนก็ขึ้นอยู่กับเพื่อนร่วมทีมของมันด้วย
- อัปเดตให้ทันสมัยเสมอ เวอร์ชันเบราว์เซอร์เปลี่ยนเร็ว รายการ UA ของคุณก็ควรเปลี่ยนตาม
- ให้ AI จัดการเรื่องยาก เครื่องมืออย่าง Thunderbit ฝัง best practices มาให้เลย คุณจึงโฟกัสที่ผลลัพธ์ ไม่ใช่ request
ถ้าคุณเบื่อกับการโดนบล็อก แก้สคริปต์ไม่จบ หรือแค่อยากสแครปแบบมืออาชีพโดยไม่ต้องวุ่นวาย ลองใช้ Thunderbit ดูได้เลย agentic web scraper ของเราได้รับความไว้วางใจจากผู้ใช้หลายพันคนทั่วโลก และถูกออกแบบมาเพื่อทำให้ข้อมูลบนเว็บเข้าถึงได้สำหรับทุกคน — โดยไม่ต้องปวดหัวทางเทคนิค
สำหรับเคล็ดลับ บทแนะนำ และการเจาะลึกเรื่อง web scraping เพิ่มเติม ลองดู Thunderbit Blog
คำถามที่พบบ่อย
1. User agent คืออะไร และทำไมถึงสำคัญกับ web scraping?
user agent คือสตริงที่ส่งไปพร้อมกับทุก web request เพื่อระบุเบราว์เซอร์และระบบปฏิบัติการของคุณ เว็บไซต์ใช้มันเพื่อแสดงเนื้อหาให้เหมาะสมและจับบอท การใช้ user agent ที่ถูกต้องช่วยให้ scraper กลมกลืนและหลีกเลี่ยงการถูกบล็อกได้
2. ทำไมไม่ควรใช้ user agent ดีฟอลต์จากไลบรารีสแครปของฉัน?
user agent ดีฟอลต์อย่าง python-requests/2.x เป็นสัญญาณบอทที่รู้จักกันดี และมักโดนบล็อกทันที ควรใช้ user agent ของเบราว์เซอร์ที่สมจริงและอัปเดตล่าสุดเสมอ
3. Thunderbit จัดการการหมุนเวียน user agent อย่างไร?
AI ของ Thunderbit จะหมุนเวียนผ่านกลุ่ม user agent ของเบราว์เซอร์ปัจจุบันที่สมจริงให้อัตโนมัติในแต่ละ request หรือ session ทำให้การสแครปดูเหมือนทราฟฟิกจากผู้ใช้จริงที่หลากหลาย
4. ฉันต้องตั้งค่า headers อย่าง Accept-Language หรือ Referer เองกับ Thunderbit ไหม?
ไม่ต้องเลย! AI ของ Thunderbit ทำให้ headers ทั้งหมดสอดคล้องและตรงกับ user agent จึงทำให้ request ของคุณดูและทำงานเหมือนเบราว์เซอร์จริง
5. ถ้าเว็บเริ่มบล็อก request ของฉันอยู่ดีล่ะ?
Thunderbit ตรวจจับการบล็อกหรือ CAPTCHA และปรับตัวแบบเรียลไทม์ — เปลี่ยน user agent ปรับ headers หรือ retry ตามความจำเป็น คุณจะได้ข้อมูลที่เชื่อถือได้โดยไม่ต้องไล่แก้ปัญหาเอง
พร้อมสแครปให้ฉลาดขึ้นแล้วหรือยัง? ดาวน์โหลด Thunderbit แล้วปล่อยให้ AI ของเรารับมือเกมไล่จับ user agent แทนคุณ ขอให้สแครปสนุก!
เรียนรู้เพิ่มเติม
- AI Agents คืออะไร? ทำงานอย่างไร และใช้งานอย่างไร
- Manus AI Agent คืออะไร? ทำงานอย่างไร และใช้งานอย่างไร
- คู่มือสำหรับมือใหม่: วิธีสร้าง AI Agent แบบทีละขั้นตอน
- คู่มือ Vertical AI Agents: แนวคิดและกรณีใช้งานจริง
- ทำความเข้าใจสถิติ AI Agent: ตั้งแต่ความแม่นยำไปจนถึงการสเกล
ลองใช้ Agentic Web Scraper Get Started Free



