
เว็บเต็มไปด้วยข้อมูลมหาศาล—and ถ้าคุณทำงานด้านขาย การตลาด หรือปฏิบัติการ คุณย่อมรู้ดีว่า “ข้อมูลที่ใช่” ใน “เวลาที่ใช่” สามารถสร้างความแตกต่างได้อย่างมาก แต่พูดตรง ๆ นะ: ไม่มีใครอยากเสียทั้งวันไปกับการก็อปปี้วางข้อมูลจากเว็บลงสเปรดชีตหรอก ผมเคยเห็นทีมงานเสียเวลาหลายสิบชั่วโมงต่อเดือนเพื่อแค่ “ดึงข้อมูล” สุดท้ายก็ได้รายชื่อที่ล้าสมัยและเต็มไปด้วยความคลาดเคลื่อน ข่าวดีก็คือ เครื่องมือ screen scraping ยุคใหม่ได้เปลี่ยนเกมนี้ไปแล้ว ทำให้ไม่ใช่แค่นักพัฒนาเท่านั้นที่สามารถเก็บ จัดระเบียบ และนำข้อมูลบนเว็บไปใช้ต่อได้ แต่คนทั่วไปก็ทำได้ภายในไม่กี่นาที ไม่ใช่หลายวัน

ความต้องการเครื่องมือ screen scraping กำลังพุ่งขึ้นแบบก้าวกระโดด ตลาด web scraping ทั่วโลกมีมูลค่าราว 5 พันล้านดอลลาร์ในปี 2023 และคาดว่าจะทะลุ 1.4 แสนล้านดอลลาร์ภายในปี 2032 ด้วยอัตราเติบโตเฉลี่ยต่อปีที่น่าทึ่งถึง 43% ทำไมถึงเป็นแบบนั้น? เพราะธุรกิจเริ่มเห็นชัดแล้วว่า automation ไม่ได้เป็นแค่ของเสริมอีกต่อไป แต่เป็นสิ่งจำเป็นในการแข่งขัน ไม่ว่าคุณจะกำลังสร้างรายชื่อลีด ติดตามคู่แข่ง หรือเฝ้าดูประกาศอสังหาริมทรัพย์ เครื่องมือที่เหมาะสมช่วยประหยัดเวลาในงานข้อมูลได้ 30–40% และลดต้นทุนการได้มาซึ่งข้อมูลลงได้สูงสุด 40% (scrapingapi.ai)
มาดูกันว่า 6 เครื่องมือ screen scraping ที่ดีที่สุดสำหรับการเก็บข้อมูลอย่างมีประสิทธิภาพในปี 2025 มีอะไรบ้าง ผมจะช่วยแยกให้ชัดว่าแต่ละตัวเด่นตรงไหน เหมาะกับใคร และควรเลือกแบบไหนให้เข้ากับทีมของคุณ ไม่ว่าคุณจะเป็นผู้ใช้ที่ไม่ถนัดเทคนิคหรือเป็นนักพัฒนาที่มีประสบการณ์ก็ตาม
ทำไมเครื่องมือ Screen Scraping ถึงสำคัญสำหรับผู้ใช้ในธุรกิจ
ดึงข้อมูลจากเว็บไซต์ใดก็ได้ด้วย AI Get Started Free
ถ้าคุณเคยพยายามอัปเดตรายชื่อลีดขาย หรือเฝ้าดูราคาคู่แข่งด้วยตัวเอง คุณคงรู้ดีว่ามันเหนื่อยแค่ไหน การเก็บข้อมูลด้วยมือช้า น่าเบื่อ และผิดพลาดได้ง่าย สำหรับผู้ใช้ธุรกิจที่ไม่ใช่สายเทคนิค—ไม่ว่าจะเป็นเซลส์ นักการตลาด เอเจนต์อสังหาฯ หรือนักวิเคราะห์งานปฏิบัติการ—เครื่องมือ screen scraping คือผู้ช่วยตัวจริง มันทำงานซ้ำ ๆ แบบคัดลอกวางให้เป็นอัตโนมัติ เปลี่ยนงานที่เคยกินเวลาหลายชั่วโมงให้กลายเป็นงานคลิกครั้งเดียว
นี่คือวิธีที่เครื่องมือ screen scraping กำลังเปลี่ยนวิธีทำงานของธุรกิจ:
- สร้างลีด: ดึงข้อมูลผู้มีโอกาสเป็นลูกค้าหลายร้อยรายจากไดเรกทอรีหรือโซเชียลมีเดียได้ในทันที ทีมขายจึงมีเวลาไปขายมากขึ้น แทนที่จะเสียเวลาก็อปปี้ข้อมูล
- ติดตามคู่แข่ง: ตั้งเวลาสั่งดึงข้อมูลจากเว็บไซต์คู่แข่ง เพื่อให้ได้รายการราคาที่อัปเดตล่าสุด หรือจับสัญญาณเปิดตัวสินค้าใหม่ได้อัตโนมัติ ร้านค้าปลีกอย่าง John Lewis เคยเห็นยอดขายเพิ่มขึ้น 4% เพียงแค่ใช้ price scraping
- เก็บข้อมูลอสังหาริมทรัพย์: ดึงประกาศขาย/เช่าจากเว็บไซต์อย่าง Zillow ได้ภายในไม่กี่วินาที ทำให้สต็อกและโอกาสทางธุรกิจของคุณทันสมัยอยู่เสมอ
- ทำงานอัตโนมัติ: ส่งออกข้อมูลที่ดึงมาไปยัง Excel, Google Sheets, Airtable หรือ Notion ได้โดยตรง และยังสามารถทำให้การกรอกฟอร์มหรือเวิร์กโฟลว์ซอฟต์แวร์เป็นอัตโนมัติได้อีกด้วย
สรุปสั้น ๆ คือ เครื่องมือ screen scraping ช่วยให้ผู้ใช้ธุรกิจเข้าถึงข้อมูลบนเว็บและนำไปใช้ต่อได้โดยไม่ต้องรอฝ่าย IT นั่นหมายถึงการตัดสินใจได้เร็วขึ้น อินไซต์สดใหม่กว่าเดิม และได้เปรียบคู่แข่งอย่างชัดเจน
วิธีเลือกเครื่องมือ Screen Scraping ที่เหมาะกับคุณ
มีตัวเลือกมากมายจนการเลือกเครื่องมือ screen scraping ที่ใช่ อาจให้ความรู้สึกเหมือนเลือกซื้อรถคันใหม่—คุณอยากได้แบบแรง ๆ โดดเด่น หรือแบบที่ขับง่ายและไว้ใจได้? นี่คือเช็กลิสต์สั้น ๆ ที่จะช่วยจับคู่ความต้องการของคุณกับเครื่องมือที่เหมาะสม:
- ใช้งานง่ายแค่ไหน: คุณอยากได้เครื่องมือแบบ no-code ที่คลิก ๆ ก็ใช้ได้เลย หรือคุณโอเคกับการเขียนสคริปต์?
- ความยืดหยุ่นในการปรับแต่ง: ต้องรับมือกับเว็บที่ซับซ้อน การล็อกอิน หรือคอนเทนต์ที่เปลี่ยนตามการใช้งาน เช่น infinite scroll หรือไม่?
- ประเภทข้อมูลที่รองรับ: คุณจะดึงข้อความ รูปภาพ PDF หรืออย่างอื่น?
- ความสามารถในการสเกล: คุณดึงข้อมูลแค่ไม่กี่หน้า หรือจำเป็นต้องประมวลผลวันละหลายพันหน้า?
- ตัวเลือกการส่งออกข้อมูล: ส่งข้อมูลไป Excel, Google Sheets หรือ CRM ได้ง่ายไหม?
- ราคา: งบประมาณของคุณเท่าไร? ต้องการเครื่องมือฟรี หรือพร้อมลงทุนกับ automation ระดับองค์กร?
- การซัพพอร์ตและการดูแล: คุณอยากได้บริการที่มีคนดูแลให้ หรือรับได้กับการต้องดูแลสคริปต์และแก้ปัญหาเอง?
เก็บเกณฑ์เหล่านี้ไว้ในใจระหว่างที่เราดู 6 เครื่องมือเด่นด้านล่าง และจำไว้ว่า เครื่องมือที่ดีที่สุดคือเครื่องมือที่ทีมของคุณ “จะใช้จริง” นั่นเอง
1. Thunderbit
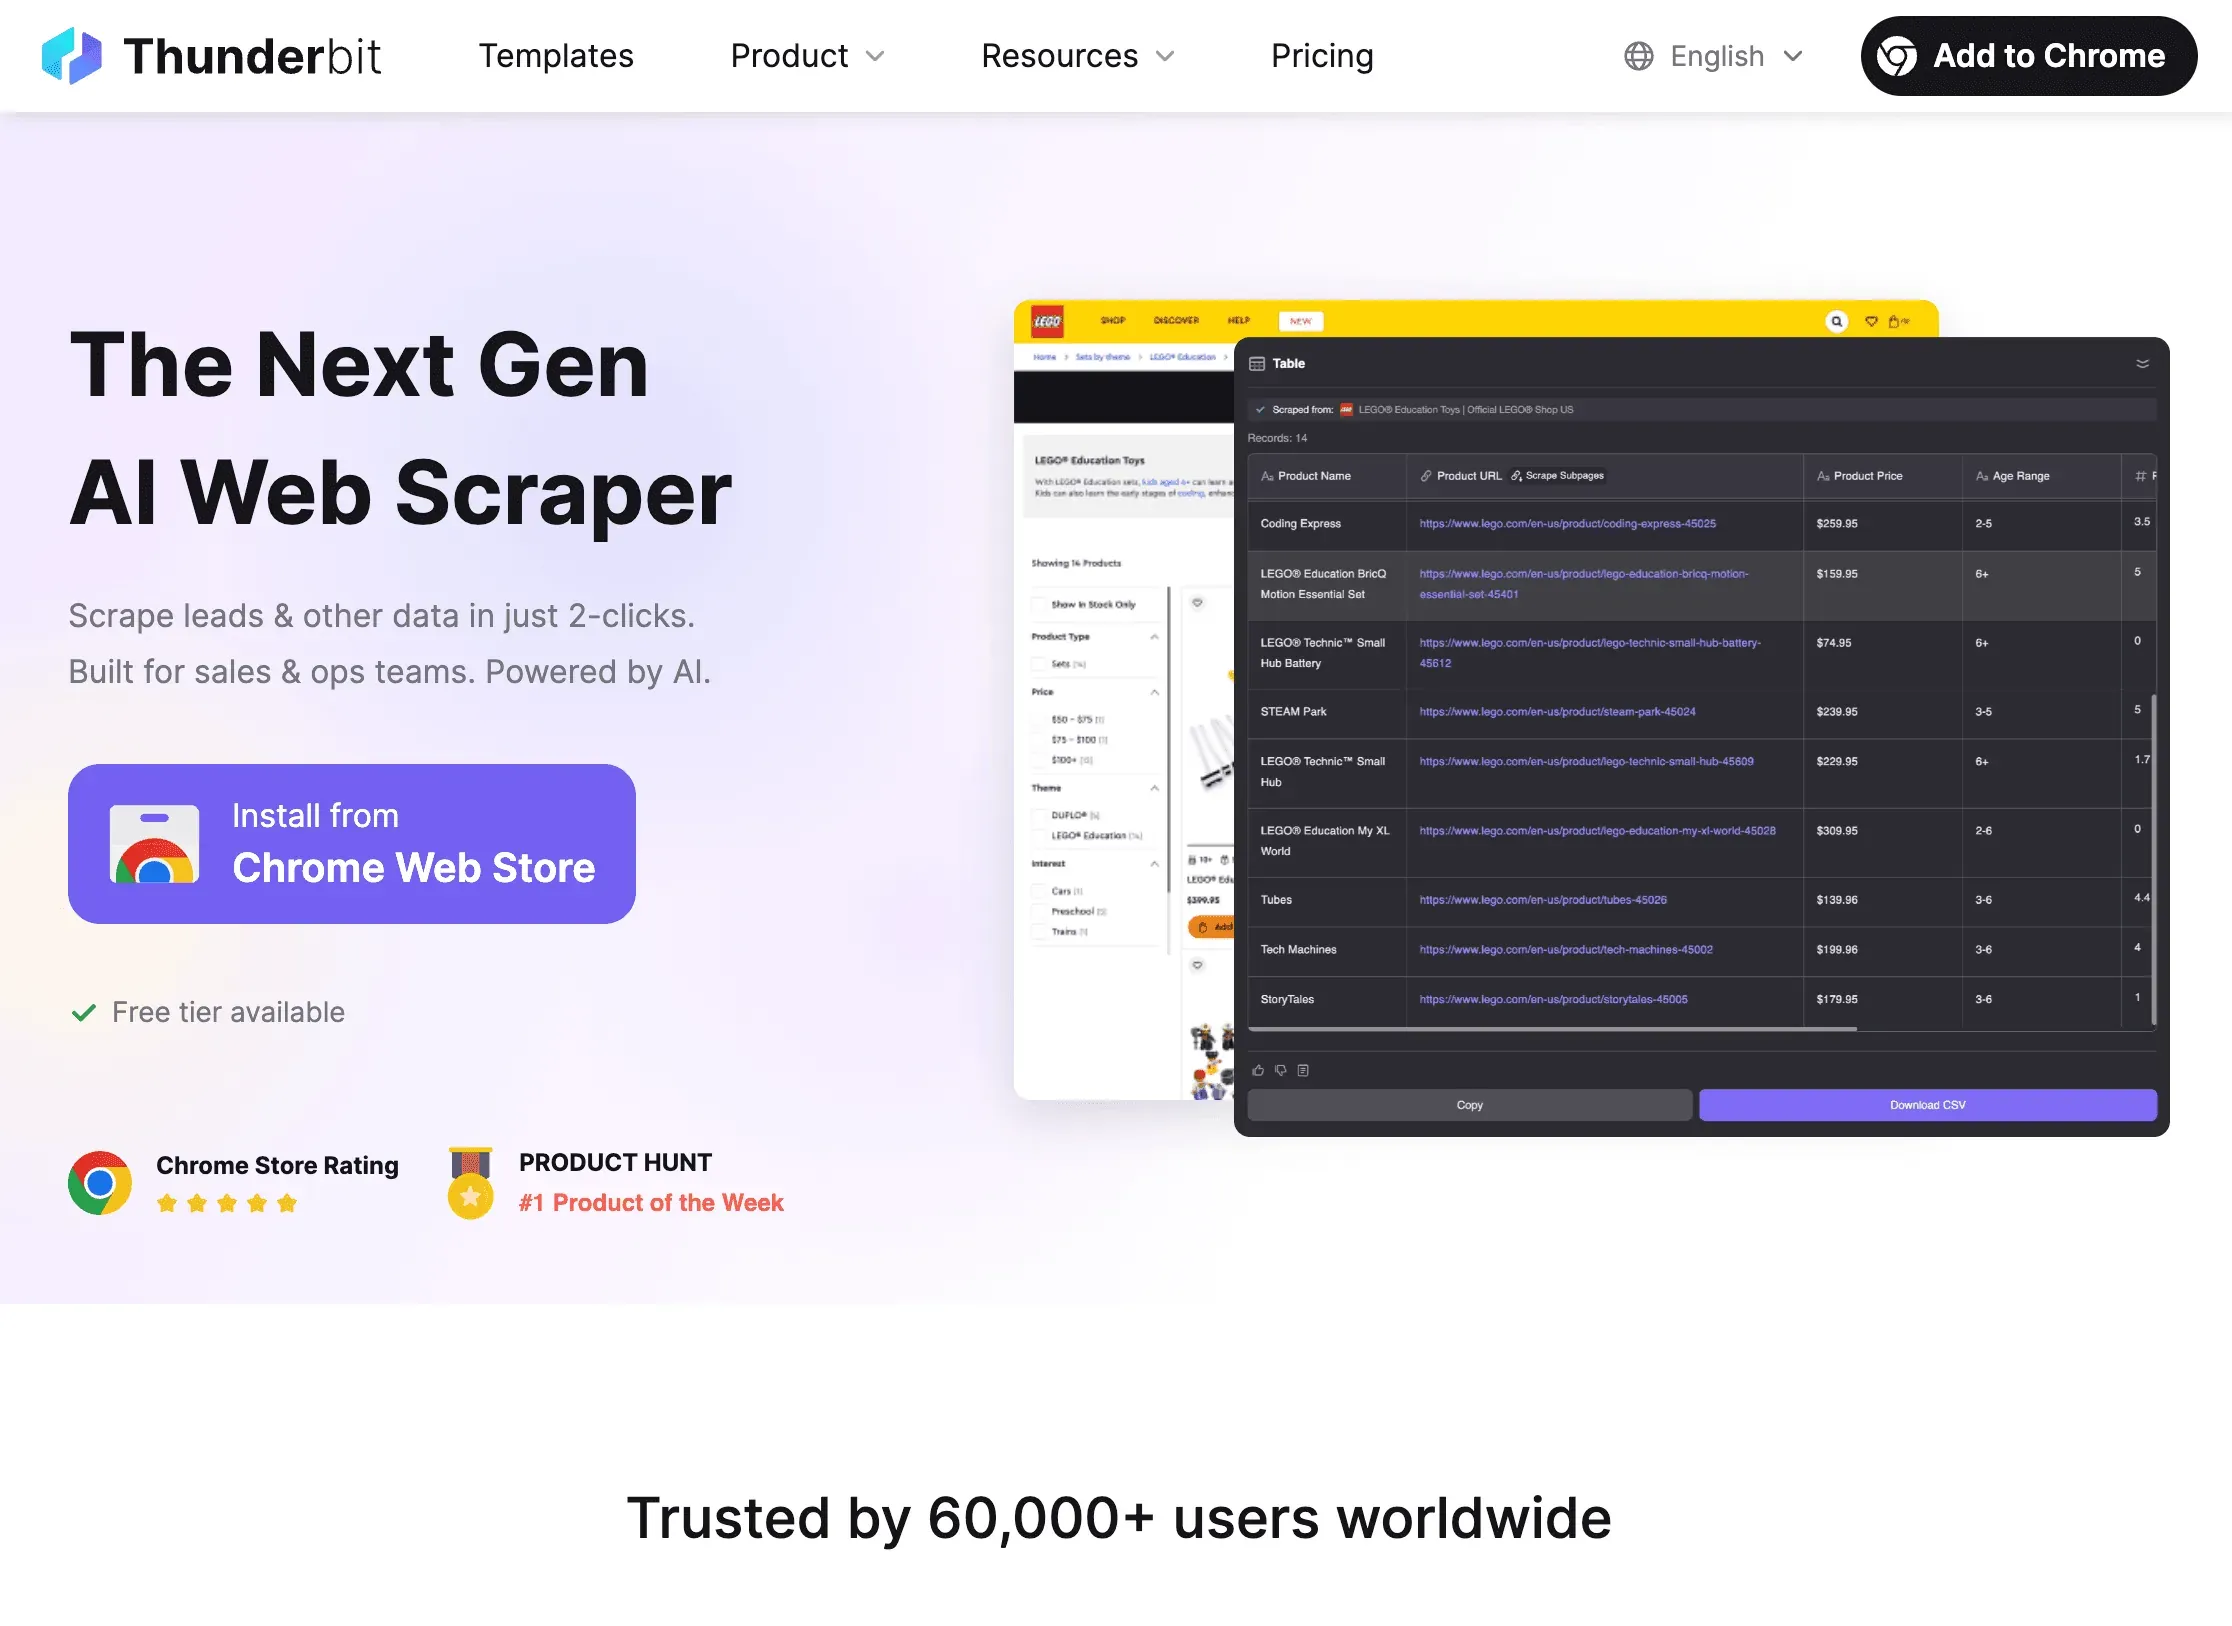
Thunderbit คือคำแนะนำอันดับแรกของผมสำหรับทีมที่ไม่ถนัดเทคนิคแต่ต้องการเก็บข้อมูลบนเว็บให้เร็ว—โดยไม่ต้องเขียนโค้ด ไม่ต้องใช้เทมเพลต และไม่ต้องปวดหัว ในฐานะผู้ร่วมก่อตั้งและ CEO ผมอาจจะมีอคตินิดหน่อย แต่เหตุผลที่ผมสร้าง Thunderbit ขึ้นมาก็เพราะไม่อยากเห็นผู้ใช้ธุรกิจต้องทรมานกับเครื่องมือที่ซับซ้อนและออกแบบมาสำหรับนักพัฒนา
แล้วอะไรที่ทำให้ Thunderbit แตกต่าง? คำตอบคือความเรียบง่ายที่มาพร้อมพลัง:
- AI แนะนำฟิลด์อัตโนมัติ: แค่คลิก “AI Suggest Fields” แล้ว AI ของ Thunderbit จะอ่านหน้าเว็บ แนะนำคอลัมน์ที่เหมาะสมที่สุด เช่น ชื่อ ราคา อีเมล และยังตั้งค่า Data Type ให้คุณด้วย
- ดึงข้อมูลใน 2 คลิก: เข้าไปยังเว็บไซต์ที่ต้องการ คลิก “Scrape” แล้วให้ Thunderbit จัดการที่เหลือ—ไม่ต้องตั้งค่า ไม่ต้องเลือก selector ไม่ต้องยุ่งยาก
- ดึงข้อมูลจากหน้าเชื่อมและแบ่งหน้าได้: ถ้าต้องการรายละเอียดจากหน้ารอง เช่น ข้อมูลสินค้า หรือโปรไฟล์ LinkedIn Thunderbit สามารถไล่เก็บข้อมูลทีละหน้าและเติมข้อมูลลงตารางให้อัตโนมัติได้ รวมถึงรองรับ pagination และ infinite scroll
- เทมเพลตสำเร็จรูปทันที: สำหรับเว็บไซต์ยอดนิยมอย่าง Amazon, Zillow และ Instagram Thunderbit มีเทมเพลตแบบคลิกครั้งเดียวให้ใช้งาน เพียงพิมพ์คำค้นแล้วส่งออกข้อมูลได้เลย
- ส่งออกข้อมูลฟรี: ส่งผลลัพธ์ไปยัง Excel, Google Sheets, Airtable หรือ Notion ได้ฟรีทั้งหมด
- ฟีเจอร์ขั้นสูง: ดึงข้อมูลจาก PDF, รูปภาพ และยังทำให้การกรอกฟอร์มเป็นอัตโนมัติด้วย AI Autofill ได้อีกด้วย โดยไม่เสียค่าใช้จ่าย นอกจากนี้ยังตั้งเวลารัน scraping อัตโนมัติด้วยคำสั่งภาษาธรรมชาติได้
- ราคา: Thunderbit ใช้ระบบเครดิต—ดึงข้อมูลได้ฟรีสูงสุด 6 หน้า (หรือ 10 หน้าหากใช้ trial boost) แพ็กเกจแบบชำระเงินเริ่มต้นที่เพียง $15/เดือน (หรือ $9/เดือนเมื่อจ่ายรายปี) สำหรับ 500 แถว เหมาะกับทีมทุกขนาด
Thunderbit ได้รับความไว้วางใจจากผู้ใช้กว่า 200,000 คนทั่วโลก ตั้งแต่ทีมขายและการตลาด ไปจนถึงเอเจนต์อสังหาฯ และผู้ประกอบการอีคอมเมิร์ซ คำชมที่ผมได้ยินบ่อยที่สุดคือ “ไม่อยากเชื่อเลยว่ามันประหยัดเวลาได้ขนาดนี้ เมื่อก่อนต้องเสียเวลาหลายชั่วโมงคัดลอกลีดจากไดเรกทอรี ตอนนี้เสร็จในไม่กี่นาที” ถ้าอยากลองด้วยตัวเอง ดาวน์โหลดส่วนขยาย Chrome แล้วลองใช้งานดู
ลองใช้ Thunderbit ฟรี – AI Web Scraper
2. Octoparse

Octoparse เป็นหนึ่งในตัวท็อปของโลก no-code scraping ที่มาพร้อมอินเทอร์เฟซแบบภาพและลากวางสำหรับสร้างเวิร์กโฟลว์การดึงข้อมูลแบบกำหนดเอง หากคุณเป็นผู้ใช้ระดับโปรที่ต้องรับมือกับเว็บซับซ้อน—เช่นมีการล็อกอิน, AJAX, infinite scroll และการนำทางหลายขั้นตอน—Octoparse มีเครื่องมือให้ครบ โดยไม่ต้องเขียนโค้ดแม้แต่บรรทัดเดียว
ฟีเจอร์เด่น:
- ตัวสร้างเวิร์กโฟลว์แบบภาพ: คลิกผ่านหน้าเว็บตัวอย่าง แล้ว Octoparse จะตรวจจับองค์ประกอบที่คล้ายกัน ช่วยให้คุณสร้างกระบวนการดึงข้อมูลได้ทีละขั้น
- รองรับคอนเทนต์แบบไดนามิก: ใช้งานกับเว็บที่หนัก JavaScript, infinite scroll และหน้าที่ต้องล็อกอินได้
- Cloud Scraping: รันงานบนคลาวด์ได้โดยไม่ต้องเปิดคอมไว้ตลอด ตั้งเวลารัน และประมวลผลข้อมูลปริมาณมากได้ 24/7
- คลังเทมเพลต: มีเทมเพลตสำเร็จรูปมากกว่า 500 แบบสำหรับเว็บไซต์ยอดนิยมอย่าง Amazon, LinkedIn และ Twitter
- ตัวเลือกการส่งออก: ดาวน์โหลดผลลัพธ์เป็น CSV, Excel หรือ JSON หรือส่งต่อข้อมูลไปยังฐานข้อมูลได้โดยตรง
- ราคา: มีแผนฟรีที่ความสามารถจำกัด; แพ็กเกจเสียเงินเริ่มต้นราว $69/เดือนสำหรับ Standard plan และมีระดับที่สูงกว่าสำหรับ concurrency และฟีเจอร์ขั้นสูง
Octoparse เหมาะกับนักวิเคราะห์ นักวิจัย และธุรกิจขนาดเล็กที่ต้องการเครื่องมือ no-code ที่แข็งแรงสำหรับงานระดับกลาง อาจต้องใช้เวลาศึกษาเล็กน้อย โดยเฉพาะถ้าต้องทำเวิร์กโฟลว์ขั้นสูง แต่หน้าตาแบบภาพและเอกสารที่ชัดเจนทำให้ผู้ใช้ที่พอมีพื้นฐานเทคนิคใช้งานได้ไม่ยาก
3. ParseHub

ParseHub เป็นอีกหนึ่งเครื่องมือ scraping แบบภาพ โดยโดดเด่นเรื่องการรับมือกับเว็บไซต์ซับซ้อนและเปลี่ยนแปลงตลอดเวลา ผ่านแอปเดสก์ท็อป หากคุณต้องดึงข้อมูลจากเว็บที่ใช้ JavaScript หนัก ๆ หรือมีองค์ประกอบอินเทอร์แอ็กทีฟที่ซับซ้อน ParseHub ใช้วิธีจำลองการใช้งานเบราว์เซอร์ ซึ่งตอบโจทย์มาก
จุดเด่นของ ParseHub:
- เครื่องมือ visual scraper บนเดสก์ท็อป: สร้างโปรเจกต์โดยคลิกผ่านเว็บไซต์ในเบราว์เซอร์ที่ฝังมากับแอป ParseHub จะตรวจจับแพตเทิร์นและให้คุณเลือกสิ่งที่ต้องการได้อย่างแม่นยำ
- รองรับ JavaScript & AJAX: รอให้คอนเทนต์โหลด คลิกปุ่ม กรอกฟอร์ม และนำทางบนเว็บแบบโต้ตอบได้
- เชื่อมต่อ API ได้: เรียกใช้งานโปรเจกต์และดึงผลลัพธ์แบบโปรแกรมได้
- ตั้งเวลารันบนคลาวด์: สามารถสั่งรันงานบนคลาวด์ได้ (ในแพ็กเกจระดับสูง)
- ตัวเลือกการส่งออก: ดาวน์โหลดข้อมูลเป็น CSV, Excel หรือ JSON
- ราคา: แผนฟรีให้ดึงได้สูงสุด 200 หน้า/รัน; แพ็กเกจเสียเงินเริ่มต้นที่ $189/เดือนสำหรับ Standard และ $599/เดือนสำหรับ Professional
ParseHub เป็นที่ชื่นชอบของนักข่าวสายข้อมูล นักวิจัย และธุรกิจขนาดเล็กที่ต้องดึงข้อมูลจากเว็บไดนามิก และชอบทำงานในสภาพแวดล้อมแบบเดสก์ท็อป การเริ่มต้นใช้งานที่มีไกด์ช่วยมือใหม่ได้ดี แต่ราคาค่อนข้างสูงสำหรับผู้ใช้หนัก
4. Scrapy

Scrapy คือเครื่องมือที่นักพัฒนาและทีมเทคนิคเลือกใช้เมื่ออยากควบคุมโปรเจกต์ scraping ได้ทั้งหมด มันเป็นเฟรมเวิร์กแบบโอเพนซอร์สบน Python ที่ให้คุณสร้าง web crawler แบบกำหนดเองได้ เหมาะอย่างยิ่งกับงานขนาดใหญ่ ซับซ้อน หรือมีเงื่อนไขเฉพาะสูง
ทำไมนักพัฒนาถึงชอบ Scrapy:
- ยืดหยุ่นที่สุด: เขียนโค้ด Python เพื่อกำหนด spider, กฎการ crawl และ data pipeline ได้เอง Scrapy จัดการ concurrency, retry และการส่งออกข้อมูลให้
- ประสิทธิภาพสูง: ออกแบบมาเพื่อความเร็วและการสเกล—ดึงข้อมูลได้ตั้งแต่หลักพันไปจนถึงหลักล้านหน้าอย่างมีประสิทธิภาพ
- ขยายต่อได้ง่าย: เชื่อมกับ proxy, ฐานข้อมูล, API และ middleware แบบกำหนดเองได้
- โอเพนซอร์ส: ใช้ได้ฟรี ค่าใช้จ่ายจะไปอยู่ที่โครงสร้างพื้นฐานของคุณเองหรือโฮสติ้งบนคลาวด์ เช่น Scrapy Cloud ของ Zyte
- ชุมชนใหญ่: มี ecosystem ขนาดใหญ่ เอกสารครบ และบทเรียนมากมาย
Scrapy ไม่ใช่ของที่ใครก็เริ่มใช้ได้ง่าย ๆ—มีเส้นโค้งการเรียนรู้ที่ชัน และคุณต้องดูแลโค้ดเอง แต่ถ้าคุณมีนักพัฒนาในทีมและต้องการสร้าง data pipeline ที่แข็งแรงและสเกลได้ Scrapy คือหนึ่งในตัวเลือกที่ยากจะเอาชนะ
5. Diffbot

Diffbot ใช้วิธีที่ต่างออกไปอย่างสิ้นเชิง: มันใช้ AI และ machine learning เพื่อวิเคราะห์และดึงข้อมูลแบบมีโครงสร้างจากทุกเว็บเพจโดยอัตโนมัติ แทนที่จะสร้าง scraper เอง คุณแค่ส่ง URL ให้ Diffbot ผ่าน API แล้วระบบจะคืนค่าเป็น JSON ที่สะอาดและเป็นระเบียบ โดยไม่ต้องตั้งค่า selector หรือเตรียมงานอะไรทั้งนั้น
อะไรที่ทำให้ Diffbot ไม่เหมือนใคร:
- ดึงข้อมูลด้วย AI: มี API ที่ผ่านการฝึกมาแล้วสำหรับบทความ สินค้า กระทู้สนทนา และอีกมากมาย Diffbot จะ “อ่าน” หน้าเว็บเหมือนมนุษย์แล้วดึงฟิลด์สำคัญออกมา
- Crawlbot: ใช้ crawl เว็บไซต์ทั้งเว็บหรือ sitemap ได้อัตโนมัติ
- Knowledge Graph: เข้าถึงฐานข้อมูลขนาดมหึมาของ Diffbot ที่มีเว็บไซต์มากกว่า 1.2 พันล้านแห่ง องค์กร 246 ล้านแห่ง และอีกมาก
- รองรับการสเกล: ออกแบบมาสำหรับงานเก็บข้อมูลระดับองค์กร
- ราคา: มีแผนฟรี (10,000 เครดิต/เดือน); แพ็กเกจเสียเงินเริ่มต้นที่ $299/เดือนสำหรับ 250,000 เครดิต และมีระดับที่สูงกว่าสำหรับปริมาณมากขึ้น
Diffbot เหมาะที่สุดสำหรับองค์กร นักวิทยาศาสตร์ข้อมูล และใครก็ตามที่ต้องการข้อมูลเว็บแบบมีโครงสร้างจำนวนมหาศาล โดยไม่อยากสร้างหรือดูแล scraper เอง แม้อาจปรับแต่งได้น้อยกว่าเครื่องมือที่เขียนโค้ดเองได้ แต่ถ้าต้องการการดึงข้อมูลแบบ AI ที่แทบไม่ต้องลงมือทำ และทำได้ในสเกลใหญ่ Diffbot ถือว่าโดดเด่นมาก
6. DataMiner

DataMiner เป็นส่วนขยายเบราว์เซอร์สำหรับ Chrome และ Edge ที่ทำให้การดึงข้อมูลแบบเฉพาะกิจเป็นเรื่องง่ายสุด ๆ ถ้าคุณเป็น growth hacker นักข่าว หรือผู้ใช้ธุรกิจที่แค่อยากดึงตารางหรือรายการจากหน้าเว็บลง Excel แบบเร็ว ๆ DataMiner จะกลายเป็นเพื่อนซี้ของคุณ
ทำไมผู้ใช้ถึงชอบ DataMiner:
- ใช้งานง่ายแบบคลิก ๆ: คลิกองค์ประกอบบนหน้าเว็บเพื่อสร้าง “recipe” หรือจะใช้หนึ่งในสูตรสำเร็จสาธารณะกว่า 50,000 แบบสำหรับเว็บไซต์มากกว่า 15,000 แห่งก็ได้
- ดึงข้อมูลได้ในคลิกเดียว: ใช้ recipe แล้วส่งออกข้อมูลเป็น CSV หรือ Excel ได้ทันที
- รองรับ pagination และการดึงแบบจำนวนมาก: จัดการรายการหลายหน้าได้ และยังสามารถใส่รายการ URL เพื่อประมวลผลเป็นชุดได้
- กรอกฟอร์มอัตโนมัติ: ใช้ข้อมูลจาก CSV เพื่อส่งฟอร์มแบบอัตโนมัติ
- แผนฟรี: ดึงได้ฟรีสูงสุด 500 หน้า/เดือน; แพ็กเกจเสียเงินเริ่มต้นที่ $19.99/เดือนสำหรับ 500 หน้า
DataMiner เหมาะกับงานเฉพาะกิจ งานวิจัยด่วน และคนที่ชอบทำงานโดยตรงในเบราว์เซอร์ แม้จะไม่ถูกสร้างมาเพื่อโปรเจกต์ขนาดใหญ่ แต่สำหรับงานขนาดเล็กถึงกลาง มันสะดวกมากจริง ๆ
ตารางเปรียบเทียบแบบเร็ว: เครื่องมือ Screen Scraping ในภาพรวม
| เครื่องมือ | ใช้งานง่ายแค่ไหน | ฟีเจอร์เด่น | เหมาะกับใคร | รูปแบบราคา | จุดแข็งเฉพาะตัว |
|---|---|---|---|---|---|
| Thunderbit | ง่ายมาก (no-code) | AI แนะนำฟิลด์, subpage/pagination, เทมเพลต, ส่งออกฟรี | ผู้ใช้ธุรกิจที่ไม่ถนัดเทคนิค (ขาย, ops, อสังหาฯ) | ฟรี/เริ่มต้น $9–$15/เดือน | ตั้งค่าง่ายที่สุด, ขับเคลื่อนด้วย AI, ดึงข้อมูลเฉพาะกิจได้เร็ว |
| Octoparse | ปานกลาง (no-code) | เวิร์กโฟลว์แบบภาพ, รันบนคลาวด์, เว็บไดนามิก, เทมเพลต | นักวิเคราะห์และนักวิจัยที่คุ้นเทคโนโลยี | ฟรี/เริ่มต้น $69/เดือน | ตัวสร้างแบบภาพ, ตั้งเวลาบนคลาวด์, ตรรกะขั้นสูง |
| ParseHub | ปานกลาง (no-code) | แอปเดสก์ท็อป, รองรับ JS/AJAX, API, รันบนคลาวด์ | เว็บไดนามิก, มือใหม่สายเทคนิค | ฟรี/เริ่มต้น $189/เดือน | จัดการเว็บยาก ๆ ได้, ควบคุมผ่านเดสก์ท็อป |
| Scrapy | ยาก (โค้ด Python) | โอเพนซอร์ส, สเกลได้, ควบคุมได้เต็มที่, pipelines | นักพัฒนา, ทีมวิศวกรรม | ฟรี (โฮสต์เอง) | ยืดหยุ่นสูงสุด, scraping แบบกำหนดเองในสเกลใหญ่ |
| Diffbot | ง่าย (สำหรับ devs) | ดึงข้อมูลด้วย AI, API, Knowledge Graph, crawlbot | องค์กร, นักวิทยาศาสตร์ข้อมูล | ฟรี/เริ่มต้น $299/เดือน | AI แบบไม่ต้องดูแล, ข้อมูลทั่วเว็บ, สเกลมหาศาล |
| DataMiner | ง่ายมาก (เบราว์เซอร์) | ส่วนขยายเบราว์เซอร์, 50k+ recipes, คลิกเดียว, ฟอร์ม | งานเฉพาะกิจ, นักข่าว, growth hacker | ฟรี/เริ่มต้น $19.99/เดือน | เร็วที่สุดในฝั่งเบราว์เซอร์, คลังเทมเพลตมหาศาล |
เครื่องมือ Screen Scraping แบบไหนเหมาะกับคุณ?
เครื่องมือและซอฟต์แวร์ Web Scraping ที่ดีที่สุดในปี 2025 Get Started Free
- ต้องการแบบ no-code และได้ผลลัพธ์ทันที? เลือก Thunderbit หรือ DataMiner Thunderbit เหมาะที่สุดสำหรับการดึงข้อมูลแบบมีโครงสร้าง หลายหน้า หรือจากหน้าเชื่อม พร้อมความช่วยเหลือจาก AI ส่วน DataMiner เหมาะกับงานเร็ว ๆ ผ่านเบราว์เซอร์
- อยากได้เวิร์กโฟลว์แบบภาพและพลังของคลาวด์? Octoparse คือเพื่อนที่ใช่ โดยเฉพาะถ้าคุณรับมือกับเว็บซับซ้อนหรือจำเป็นต้องตั้งเวลารันซ้ำเป็นประจำ
- ต้องดึงข้อมูลจากเว็บไดนามิกที่ใช้ JavaScript หนัก ๆ? ParseHub โดดเด่นในจุดนี้ โดยเฉพาะสำหรับมือใหม่ที่พอมีพื้นฐานเทคนิค
- มีนักพัฒนาในทีมและต้องการการควบคุมเต็มรูปแบบ? Scrapy คือมาตรฐานทองคำสำหรับงาน scraping แบบกำหนดเองและขนาดใหญ่
- ต้องการข้อมูลระดับองค์กรที่ขับเคลื่อนด้วย AI? Diffbot ส่งมอบการดึงข้อมูลแบบมีโครงสร้างโดยแทบไม่ต้องลงมือทำ พร้อม knowledge graph ขนาดมหึมา
คำแนะนำของผม? เริ่มจากทดลองใช้ฟรีหรือใช้แพ็กเกจฟรีก่อน—เครื่องมือส่วนใหญ่ให้ลองใช้งานก่อนตัดสินใจ เลือกจากความถนัดทางเทคนิค ปริมาณข้อมูล และความต้องการในเวิร์กโฟลว์ของคุณ แล้วอย่ากลัวที่จะทดลอง
บทสรุป: ปลดล็อกการเก็บข้อมูลด้วยเครื่องมือ Screen Scraping ที่เหมาะสม
เครื่องมือ screen scraping ได้พัฒนาจากของเล่นสำหรับนักพัฒนาเฉพาะกลุ่ม กลายมาเป็นตัวเร่งประสิทธิภาพการทำงานที่จำเป็นของธุรกิจ ไม่ว่าคุณจะเป็นเซลส์ที่กำลังหาลีด ผู้จัดการอีคอมเมิร์ซที่ติดตามราคา หรือเอเจนต์อสังหาฯ ที่รวบรวมประกาศขาย เครื่องมือที่เหมาะสมสามารถเปลี่ยนเว็บให้กลายเป็นฐานข้อมูลส่วนตัวของคุณได้ หัวใจสำคัญคือเลือกเครื่องมือที่เข้ากับทักษะของทีมและเป้าหมายทางธุรกิจของคุณ—เพราะเครื่องมือ screen scraping ที่ดีที่สุด คือเครื่องมือที่คุณจะใช้งานจริง
พร้อมจะเลิกคัดลอกวาง แล้วเริ่มเก็บข้อมูลแบบมืออาชีพหรือยัง? ดาวน์โหลด Thunderbit หรือเลือกลองเครื่องมืออื่นในลิสต์นี้ดู และถ้าคุณอยากได้เคล็ดลับเชิงลึก บทวิเคราะห์ และบทสอนเพิ่มเติม ลองเข้าไปดู Thunderbit Blog
ลองใช้ Thunderbit AI Web Scraper ฟรี Get Started Free
คำถามที่พบบ่อย
1. เครื่องมือ screen scraping คืออะไร และทำงานอย่างไร?
เครื่องมือ screen scraping คือซอฟต์แวร์ที่ช่วยทำให้การดึงข้อมูลจากเว็บไซต์เป็นอัตโนมัติ แทนที่จะต้องคัดลอกข้อมูลเอง คุณสามารถเลือกข้อมูลที่ต้องการแล้วส่งออกในรูปแบบที่มีโครงสร้าง เช่น Excel หรือ CSV เครื่องมือบางตัวใช้ AI หรือเวิร์กโฟลว์แบบภาพเพื่อให้ผู้ใช้ที่ไม่ถนัดเทคนิคตั้งค่าได้ง่าย
2. ใครควรใช้เครื่องมือ screen scraping?
ใครก็ตามที่ต้องเก็บข้อมูลบนเว็บอย่างมีประสิทธิภาพ—ทีมขาย นักการตลาด เอเจนต์อสังหาฯ นักวิจัย และนักวิเคราะห์งานปฏิบัติการ ไม่ว่าคุณจะสร้างรายชื่อลีด ติดตามคู่แข่ง หรือรวบรวมรายการประกาศ เครื่องมือเหล่านี้ช่วยประหยัดเวลาและลดความผิดพลาด
3. เครื่องมือ scraping แบบ no-code กับแบบเขียนโค้ดต่างกันอย่างไร?
เครื่องมือ no-code อย่าง Thunderbit, Octoparse, ParseHub และ DataMiner มีอินเทอร์เฟซแบบคลิกใช้งานและออกแบบมาสำหรับผู้ใช้ที่ไม่ถนัดเทคนิค ส่วนเครื่องมือแบบเขียนโค้ดอย่าง Scrapy ต้องใช้ทักษะการเขียนโปรแกรม แต่ให้ความยืดหยุ่นและการสเกลที่สูงกว่าสำหรับโปรเจกต์ซับซ้อน
4. เครื่องมือ screen scraping ใช้ถูกกฎหมายไหม?
การ screen scraping ข้อมูลที่เปิดเผยต่อสาธารณะทำได้ตามกฎหมาย แต่คุณควรเคารพข้อกำหนดการใช้งานของเว็บไซต์และกฎหมายความเป็นส่วนตัวเสมอ หลีกเลี่ยงการดึงข้อมูลส่วนบุคคลโดยไม่ได้รับความยินยอม และอย่าส่งคำขอถี่จนทำให้เว็บไซต์รับภาระเกินไป
5. ฉันจะเลือกเครื่องมือ screen scraping ที่ดีที่สุดสำหรับความต้องการของฉันได้อย่างไร?
พิจารณาทักษะทางเทคนิคของคุณ ปริมาณข้อมูล ความซับซ้อนของเว็บไซต์เป้าหมาย ความต้องการด้านการส่งออกข้อมูล และงบประมาณ เริ่มจากทดลองใช้ฟรี ทดลองกับเคสใช้งานจริง แล้วดูว่าเครื่องมือไหนใช้งานได้เป็นธรรมชาติที่สุดและให้ผลลัพธ์ที่ตรงใจ
พร้อมจะปลดล็อกพลังของข้อมูลบนเว็บแล้วหรือยัง? ลองใช้เครื่องมือสักตัว แล้วดูประสิทธิภาพการทำงานของคุณพุ่งสูงขึ้นได้เลย



