
เว็บสมัยนี้โตเร็วยิ่งกว่าผมติดกาแฟอีกครับคุณ! ซึ่งบอกเลยว่ามันไม่ธรรมดาจริงๆ ในปี 2026 การดึงข้อมูลจากเว็บไม่ได้เป็นแค่ทักษะเฉพาะทางของนักวิเคราะห์ข้อมูลอีกต่อไปแล้ว แต่มันกลายเป็นหัวใจสำคัญของระบบธุรกิจอัจฉริยะ การฝึกอบรม AI และระบบอัตโนมัติไปแล้ว ไม่ว่าคุณจะตามเทรนด์ตลาด ป้อนข้อมูลให้ LLM ตัวใหม่ๆ หรือแค่เช็คราคาคู่แข่ง ความต้องการข้อมูลเว็บที่จัดระเบียบดีและอัปเดตตลอดเวลามันพุ่งสูงขึ้นอย่างไม่เคยมีมาก่อน แล้วอะไรคือหัวใจสำคัญของการขุดทองข้อมูลนี้ล่ะ? ก็ Python ไงครับ! ด้วยระบบนิเวศที่กว้างขวางและไวยากรณ์ที่เข้าใจง่าย Python ยังคงเป็นภาษาหลักสำหรับการทำ Web Scraping ขับเคลื่อนทุกอย่างตั้งแต่สคริปต์เล็กๆ ไปจนถึงโปรแกรมรวบรวมข้อมูลขนาดใหญ่ระดับอุตสาหกรรมเลยทีเดียว
แต่ประเด็นสำคัญคือ: การเลือก แพ็กเกจ Python Web Scraping ที่เหมาะสมนี่แหละครับที่จะชี้ชะตาโปรเจกต์ของคุณได้เลย ผมเคยเห็นทีมเสียเวลาเป็นวันๆ กับการต่อสู้กับระบบป้องกันบอทด้วยเครื่องมือที่ไม่ถูก หรือเสียเวลาเป็นชั่วโมงกับการแยกวิเคราะห์ HTML ที่ยุ่งเหยิง ทั้งที่ไลบรารีที่ฉลาดกว่าสามารถทำได้ในไม่กี่นาที ดังนั้น ในฐานะคนที่คลุกคลีอยู่ในวงการ SaaS, ระบบอัตโนมัติ และ AI มาหลายปี (และสร้าง Thunderbit ขึ้นมาเพื่อให้การทำ Scraping ง่ายขึ้นสำหรับทุกคน) ผมได้รวบรวม 12 แพ็กเกจ Python Web Scraping ที่ดีที่สุดสำหรับปี 2026 มาให้แล้วครับ แต่ละแพ็กเกจก็มีจุดแข็ง จุดอ่อน และกรณีการใช้งานที่เหมาะสมของตัวเอง มาดูกันว่าแพ็กเกจไหนจะเหมาะกับการผจญภัยด้านข้อมูลครั้งต่อไปของคุณบ้าง
ทำไมแพ็กเกจ Python Web Scraping ที่เหมาะสมถึงสำคัญนัก
ดึงข้อมูลจากเว็บไซต์ใดก็ได้ด้วย AI Get Started Free
พูดกันตรงๆ เลยนะครับ: โปรเจกต์ Web Scraping ไม่ได้ถูกสร้างมาเท่าเทียมกันเสมอไป บางครั้งคุณอาจจะแค่ต้องการดึงราคาผลิตภัณฑ์ไม่กี่รายการจากหน้าเว็บแบบคงที่ แต่บางครั้งคุณก็ต้องเจอกับเว็บไซต์ที่ใช้ JavaScript เยอะๆ ซึ่งดื้อยิ่งกว่าแมวตอนอาบน้ำเสียอีก แพ็กเกจที่เหมาะสมสามารถช่วยคุณประหยัดเวลาได้เป็นชั่วโมง (หรือเป็นวัน) ลดข้อผิดพลาด และช่วยให้คุณหลีกเลี่ยงปัญหาทั่วไป เช่น การโดนบล็อกบอท หรือ HTML ที่เสียหายได้
ความนิยมของ Python ในการทำ Web Scraping ไม่ใช่แค่กระแสชั่วคราว ไลบรารีอย่าง requests และ urllib3 มียอดดาวน์โหลดมากกว่า 1 พันล้านครั้งต่อเดือน และเครื่องมือ Scraping หลักๆ เกือบทั้งหมดก็เน้น Python เป็นอันดับแรก แต่พลังที่ยิ่งใหญ่มาพร้อมกับความรับผิดชอบที่ยิ่งใหญ่: เลือกเครื่องมือผิด คุณอาจจะพบว่าตัวเองติดอยู่กับโปรเจกต์ที่ช้ากว่าอินเทอร์เน็ตแบบ Dial-up แต่ถ้าเลือกอย่างชาญฉลาด คุณจะได้ข้อมูลที่สะอาดและมีโครงสร้างก่อนที่กาแฟของคุณจะเย็นเสียอีก
เราเลือกแพ็กเกจ Python Web Scraping ที่ดีที่สุดได้อย่างไร
ผมไม่ได้แค่สุ่มเลือกจากแผนภูมิ PyPI นะครับ นี่คือวิธีที่ผมประเมินแต่ละแพ็กเกจ:
- ประสิทธิภาพและการทำงานพร้อมกัน: สามารถดึงข้อมูลได้หลายร้อย (หรือหลายพัน) หน้าได้อย่างรวดเร็วไหม?
- ความง่ายในการใช้งาน: เป็นมิตรกับผู้เริ่มต้น หรือต้องมีความรู้ระดับปริญญาเอกด้านวิทยาการคอมพิวเตอร์?
- พลังในการแยกวิเคราะห์ HTML: จัดการกับมาร์กอัปที่เสียหาย รองรับตัวเลือก XPath/CSS และทำให้การดึงข้อมูลเป็นเรื่องง่ายไหม?
- การรองรับเนื้อหาแบบไดนามิก: สามารถจัดการกับเว็บไซต์ที่ใช้ JavaScript เยอะๆ ได้ไหม หรือใช้ได้เฉพาะหน้าเว็บแบบคงที่?
- ชุมชนและเอกสารประกอบ: มีฐานผู้ใช้ที่แข็งแกร่งและเอกสารประกอบที่ดี หรือคุณจะต้องติดอยู่ในนรกของ Stack Overflow?
- กรณีการใช้งานที่ดีที่สุด: เหมาะสำหรับสคริปต์ด่วน โปรแกรมรวบรวมข้อมูลขนาดใหญ่ หรืออะไรที่อยู่ตรงกลาง?
ผมยังพิจารณาความคิดเห็นจากนักพัฒนาในโลกแห่งความเป็นจริง เกณฑ์มาตรฐานล่าสุด และประสบการณ์ (บางครั้งก็เจ็บปวด) ของผมเองในสาขานี้ ตอนนี้ มาพบกับผู้เข้าแข่งขันกันเลยครับ
1. Thunderbit
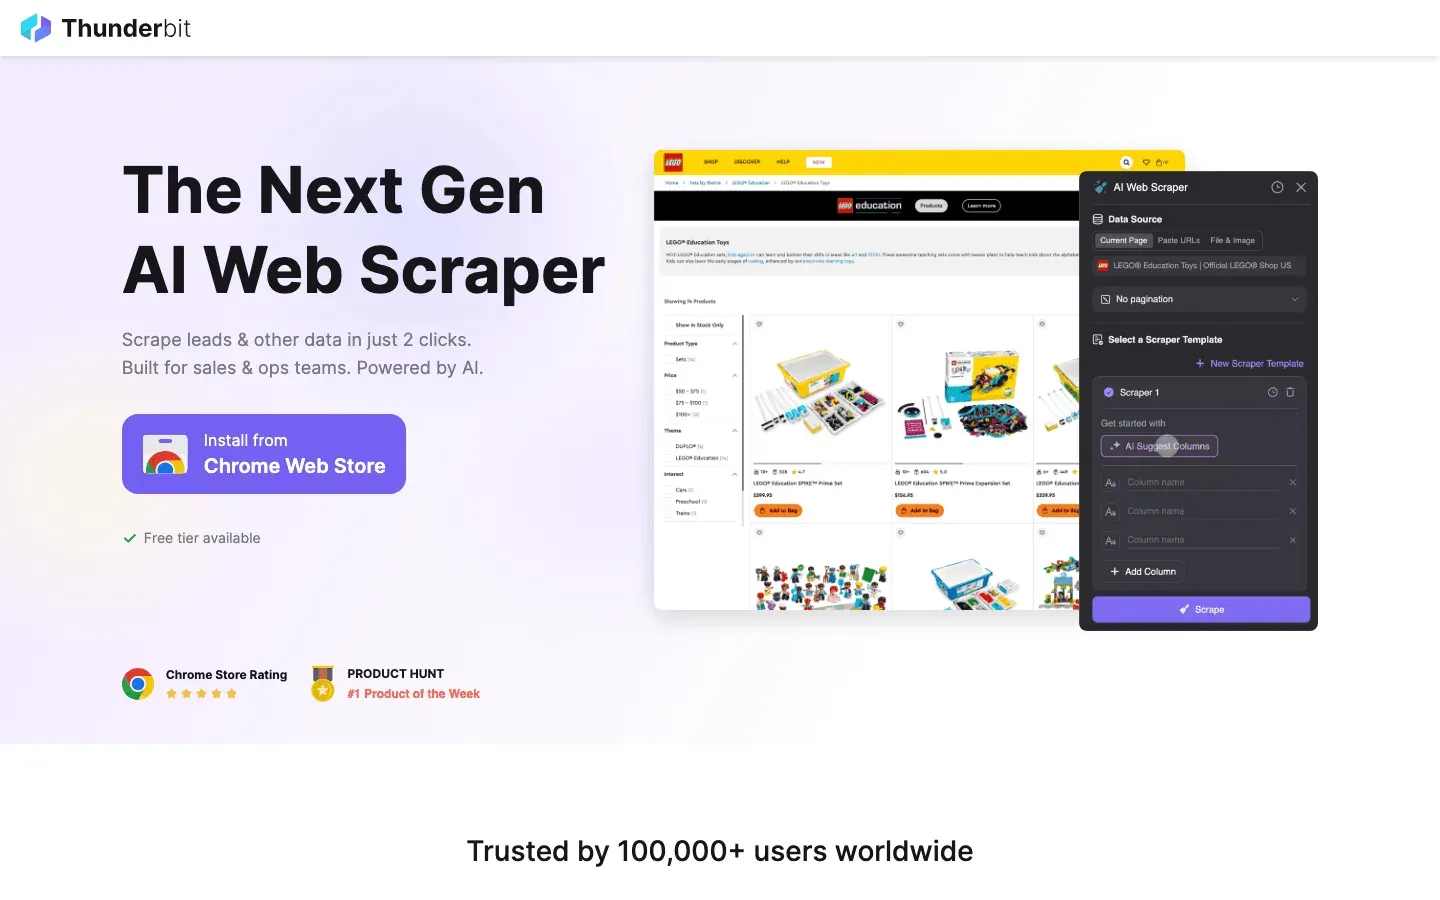 Thunderbit ไม่ใช่ไลบรารี Python ทั่วไปนะครับ แต่มันเป็นส่วนขยาย Chrome ที่ขับเคลื่อนด้วย AI ซึ่งกำลังเปลี่ยนเกมสำหรับการทำ Web Scraping โดยเฉพาะสำหรับนักพัฒนา Python ที่ต้องการความเร็ว ความแม่นยำ และความมหัศจรรย์ของ AI อะไรที่ทำให้ Thunderbit โดดเด่นน่ะเหรอ? มันช่วยให้คุณใช้ คำสั่งภาษาธรรมชาติ เพื่อบอก AI ว่าคุณต้องการข้อมูลอะไร จากนั้นมันจะจัดการทุกอย่าง: การแนะนำฟิลด์ การนำทางไปยังหน้าย่อย การแบ่งหน้า และแม้กระทั่งการส่งออกไปยัง Excel, Google Sheets, Notion หรือ Airtable
Thunderbit เป็นผู้ช่วยชีวิตสำหรับการ Scraping ข้อมูลที่ซับซ้อนและไม่มีโครงสร้าง เช่น ไดเรกทอรีที่ยุ่งเหยิง รายการผลิตภัณฑ์ หรือเว็บไซต์ที่ HTML เป็น “ศิลปะนามธรรม” มากกว่า “เอกสารที่มีโครงสร้าง” คุณสมบัติ AI Suggest Fields จะอ่านหน้าเว็บและเสนอคอลัมน์ที่ดีที่สุด ในขณะที่ Subpage Scraping ช่วยให้คุณเพิ่มข้อมูลในชุดข้อมูลของคุณโดยการเยี่ยมชมหน้ารายละเอียดที่เชื่อมโยงโดยอัตโนมัติ และหากคุณเบื่อกับปัญหาการป้องกันบอท ตัวเลือกการ Scraping บนเบราว์เซอร์และบนคลาวด์ของ Thunderbit ก็พร้อมให้บริการคุณ
นักพัฒนา Python ชื่นชอบ Thunderbit สำหรับการสร้างต้นแบบอย่างรวดเร็ว การสร้างลูกค้าเป้าหมาย และการวิจัยตลาด คุณสามารถใช้ผลลัพธ์โดยตรงใน Python data pipeline ของคุณ หรือแม้กระทั่งทำให้เวิร์กโฟลว์การ Scraping เป็นไปโดยอัตโนมัติด้วย API ของมัน มันไม่ใช่ไลบรารีโค้ดแบบดั้งเดิม แต่กำลังกลายเป็นที่ชื่นชอบอย่างรวดเร็วสำหรับทุกคนที่ต้องการใช้เวลากับการเขียนโค้ดน้อยลงและใช้เวลากับการวิเคราะห์ข้อมูลมากขึ้น
คุณสมบัติหลัก:
- การแนะนำฟิลด์และการดึงข้อมูลที่ขับเคลื่อนด้วย AI
- จัดการหน้าย่อย การแบ่งหน้า และแม้กระทั่ง PDF/รูปภาพ
- ส่งออกไปยัง CSV, Excel, Google Sheets, Notion, Airtable
- ไม่ต้องเขียนโค้ด เหมาะสำหรับทั้งผู้ใช้ที่ไม่ใช่ด้านเทคนิคและผู้เชี่ยวชาญ Python ที่ต้องการทำงานอย่างรวดเร็ว
- มีแผนฟรี; แผนแบบชำระเงินจะปรับขนาดตามความต้องการของคุณ
เหมาะสำหรับ: การสร้างลูกค้าเป้าหมาย การวิจัยตลาด การสร้างต้นแบบอย่างรวดเร็ว และการ Scraping ข้อมูลเว็บที่ซับซ้อนหรือยุ่งเหยิง
ลองใช้ Thunderbit AI Web Scraper ฟรี
2. Beautiful Soup
 Beautiful Soup คือ OG ของการแยกวิเคราะห์ HTML ใน Python ครับ หากคุณเพิ่งเริ่มต้น หรือต้องการดึงข้อมูลจากหน้าเว็บแบบคงที่ นี่คือเพื่อนที่ดีที่สุดของคุณ Beautiful Soup เก่งในการนำทางและแยกวิเคราะห์ HTML ที่มีโครงสร้างไม่ดี (“tag soup”) ทำให้เป็นผู้ช่วยชีวิตสำหรับการ Scraping เว็บไซต์ที่ไม่เป็นไปตามกฎ
API ใช้งานง่ายสำหรับผู้เริ่มต้น – ลองนึกถึง .find(), .select() และ .text – และทำงานร่วมกับ requests ได้อย่างสมบูรณ์แบบสำหรับการดึงหน้าเว็บ ภายใต้การทำงาน คุณสามารถเลือกตัวแยกวิเคราะห์ที่แตกต่างกันได้ (เช่น lxml เพื่อความเร็ว หรือ html5lib เพื่อความเข้ากันได้สูงสุด) เอกสารประกอบยอดเยี่ยม และชุมชนก็ใหญ่มาก
คุณสมบัติหลัก:
- API ที่ใช้งานง่ายแบบ Pythonic สำหรับการนำทาง HTML/XML
- จัดการมาร์กอัปที่เสียหายหรือไม่สอดคล้องกันได้อย่างราบรื่น
- ทำงานร่วมกับตัวแยกวิเคราะห์หลายตัวเพื่อความเร็วหรือความเข้ากันได้
- ชุมชนขนาดใหญ่และบทเรียนมากมาย
เหมาะสำหรับ: สคริปต์ด่วน การ Scraping หน้าเว็บแบบคงที่ และผู้เริ่มต้นที่ต้องการเรียนรู้ได้อย่างง่ายดาย
เรียนรู้เพิ่มเติมเกี่ยวกับ Beautiful Soup
3. Scrapy
 Scrapy คือแชมป์เปี้ยนสำหรับ Web Crawling ขนาดใหญ่และอัตโนมัติครับ หากคุณต้องการ Scraping หลายร้อยหรือหลายพันหน้า จัดการ Pipeline หรือกำหนดเวลาการทำงานซ้ำๆ Scrapy คือเฟรมเวิร์กที่ทีมส่วนใหญ่เลือกใช้ มันยังคงทำงานบน Twisted reactor ภายใต้การทำงาน แต่ตั้งแต่เวอร์ชัน 2.14 เป็นต้นมา ส่วนใหญ่ของ async internals ได้ถูกเขียนใหม่เป็น
asyncio coroutines และตอนนี้มี AsyncCrawlerProcess / AsyncCrawlerRunner entry points ที่ทำงานร่วมกับระบบนิเวศ async ของ Python สมัยใหม่ได้อย่างดีเยี่ยม มันรวดเร็ว รองรับการ Crawling พร้อมกัน Item Pipeline สำหรับการทำความสะอาดข้อมูล และส่งออกไปยัง JSON, CSV หรือฐานข้อมูล
Scrapy สามารถขยายได้ด้วยปลั๊กอินสำหรับพร็อกซี การแคช และแม้กระทั่งการเรนเดอร์ JavaScript แบบจำกัด (ผ่าน Splash หรือ Selenium integration) การเรียนรู้จะยากกว่า Beautiful Soup แต่ถ้าคุณจริงจังกับข้อมูลเว็บในระดับใหญ่ Scrapy คือสิ่งที่คุณจะเติบโตไปพร้อมกับมัน
คุณสมบัติหลัก:
- การ Crawling แบบ Asynchronous ผ่าน Twisted reactor + native
asynciocoroutines (Scrapy 2.14+, Python 3.10+) - Pipeline ในตัวสำหรับการทำความสะอาดและจัดเก็บข้อมูล
- ส่งออกไปยังหลายรูปแบบ (JSON, CSV, DB)
- ชุมชนขนาดใหญ่และใช้งานอยู่ และระบบนิเวศปลั๊กอิน
เหมาะสำหรับ: โปรเจกต์ Scraping ขนาดใหญ่และทำซ้ำ Pipeline ข้อมูล และทุกคนที่ต้องการความเร็วและความน่าเชื่อถือ
4. Selenium
 Selenium เป็นเครื่องมือหลักสำหรับการ Scraping เว็บไซต์ที่ใช้ JavaScript เยอะๆ หรือเว็บไซต์แบบโต้ตอบครับ มันจะทำงานอัตโนมัติบนเบราว์เซอร์จริง (Chrome, Firefox ฯลฯ) ทำให้คุณสามารถจำลองการกระทำของผู้ใช้ เช่น การคลิก การเลื่อน และการส่งฟอร์ม หากข้อมูลที่คุณต้องการปรากฏขึ้นหลังจาก JavaScript ทำงานเท่านั้น Selenium ก็สามารถดึงข้อมูลนั้นได้ ไม่ว่าเว็บไซต์จะดื้อแค่ไหนก็ตาม
ข้อเสียคือ Selenium ช้าและใช้ทรัพยากรมาก คุณกำลังรันเบราว์เซอร์เต็มรูปแบบสำหรับการ Scraping แต่ละครั้ง ดังนั้นอย่าคาดหวังว่าจะประมวลผลได้หลายพันหน้าต่อนาที แต่สำหรับสถานการณ์ที่ “ไม่มีเครื่องมืออื่นใดทำได้” Selenium คือผู้ช่วยชีวิต
คุณสมบัติหลัก:
- การทำงานอัตโนมัติของเบราว์เซอร์เต็มรูปแบบ (รองรับ Chrome, Firefox, Edge ฯลฯ)
- จัดการเนื้อหาที่เรนเดอร์ด้วย JavaScript และองค์ประกอบแบบโต้ตอบ
- รองรับโหมด Headless เพื่อการ Scraping ที่เร็วขึ้นโดยไม่มี UI
- ชุมชนขนาดใหญ่และเอกสารประกอบที่ครอบคลุม
เหมาะสำหรับ: การ Scraping เว็บไซต์แบบไดนามิกที่ใช้ JavaScript เยอะๆ การทำงานอัตโนมัติของขั้นตอนการเข้าสู่ระบบ และการจัดการ CAPTCHA หรือการโต้ตอบของผู้ใช้ที่ซับซ้อน
อ่านเพิ่มเติมเกี่ยวกับจุดแข็งและจุดอ่อนของ Selenium
5. PyQuery
 PyQuery นำไวยากรณ์สไตล์ jQuery มาสู่ Python ทำให้การแยกวิเคราะห์ HTML รู้สึกคุ้นเคยสำหรับทุกคนที่เคยทำงานกับ jQuery ใน JavaScript มันห่อหุ้มตัวแยกวิเคราะห์
lxml ที่รวดเร็ว และช่วยให้คุณใช้ตัวเลือก CSS เช่น $('div.classname') เพื่อค้นหาองค์ประกอบต่างๆ
PyQuery เหมาะสำหรับการสร้างต้นแบบอย่างรวดเร็ว และสำหรับนักพัฒนาที่ต้องการโค้ดที่กระชับและอ่านง่าย มันเร็วกว่า Beautiful Soup สำหรับการสอบถามที่ซับซ้อน และรวมเข้ากับเครื่องมือ async หรือ Selenium ได้อย่างง่ายดายสำหรับเวิร์กโฟลว์ที่ซับซ้อนมากขึ้น
คุณสมบัติหลัก:
- ตัวเลือกและไวยากรณ์แบบ jQuery ใน Python
- การแยกวิเคราะห์ที่รวดเร็วด้วยแบ็กเอนด์ lxml
- เหมาะสำหรับนักพัฒนาที่เปลี่ยนจาก JavaScript
- รองรับการเชื่อมโยงและการสอบถามที่กระชับ
เหมาะสำหรับ: การสร้างต้นแบบ แฟนๆ jQuery และทุกคนที่ต้องการเขียนโค้ดน้อยลงสำหรับการแยกวิเคราะห์ HTML
บทเรียนและเปรียบเทียบ PyQuery
6. LXML
 LXML คือปีศาจแห่งความเร็วในการแยกวิเคราะห์ HTML และ XML ใน Python ครับ สร้างขึ้นบนไลบรารี C
libxml2 และ libxslt เป็นที่รู้จักในด้านประสิทธิภาพและการรองรับ XPath และ CSS selectors ที่ทรงพลัง หากคุณกำลังจัดการกับเอกสารขนาดใหญ่หรือต้องการเรียกใช้การสอบถามที่ซับซ้อน lxml คือตัวเลือกที่ดีที่สุดของคุณ
สามารถใช้โดยตรงหรือเป็นแบ็กเอนด์สำหรับ Beautiful Soup หรือ PyQuery API ค่อนข้างซับซ้อนกว่า แต่ความเร็วและความยืดหยุ่นนั้นคุ้มค่าสำหรับงานใหญ่ๆ
คุณสมบัติหลัก:
- การแยกวิเคราะห์ที่เร็วที่สุดใน Python
- รองรับ XPath และ CSS selectors อย่างเต็มรูปแบบ
- จัดการเอกสารขนาดใหญ่และซับซ้อนได้อย่างมีประสิทธิภาพ
- สามารถใช้แบบสแตนด์อโลนหรือเป็นตัวแยกวิเคราะห์สำหรับไลบรารีอื่นๆ
เหมาะสำหรับ: การแยกวิเคราะห์ประสิทธิภาพสูง การ Scraping ขนาดใหญ่ และโปรเจกต์ที่ต้องการการสอบถามขั้นสูง
ทำไม lxml จึงโดดเด่นสำหรับการแยกวิเคราะห์
7. Requests
 Requests เป็นมาตรฐานโดยพฤตินัยสำหรับการสร้างคำขอ HTTP ใน Python ครับ API ที่สะอาดและใช้งานง่ายทำให้การดึงหน้าเว็บเป็นเรื่องง่ายเหมือน
requests.get(url) มันจัดการคุกกี้ เซสชัน และแม้กระทั่งการถอดรหัส JSON ได้ทันที
แม้ว่า Requests จะเป็นแบบ Synchronous (แต่ละคำขอจะรอจนกว่าจะเสร็จสิ้น) แต่ก็เหมาะสำหรับสคริปต์ด่วนและการ Scraping ขนาดเล็ก จับคู่กับ Beautiful Soup หรือ lxml เพื่อเวิร์กโฟลว์การ Scraping แบบคลาสสิก
คุณสมบัติหลัก:
- API ที่เรียบง่ายแบบ Pythonic สำหรับคำขอ HTTP
- จัดการคุกกี้ เซสชัน และการเปลี่ยนเส้นทาง
- รวมเข้ากับไลบรารีการแยกวิเคราะห์ได้อย่างราบรื่น
- ชุมชนและเอกสารประกอบขนาดใหญ่
เหมาะสำหรับ: สคริปต์ง่ายๆ การ Scraping หน้าเว็บแบบคงที่ และผู้เริ่มต้นที่ต้องการเริ่มต้นอย่างรวดเร็ว
ดูว่าทำไม Requests ถึงได้รับความนิยม
8. MechanicalSoup
 MechanicalSoup เป็นไลบรารีน้ำหนักเบาที่ทำให้การโต้ตอบกับเบราว์เซอร์ง่ายๆ เป็นไปโดยอัตโนมัติ เช่น การกรอกแบบฟอร์ม หรือการนำทางขั้นตอนการเข้าสู่ระบบหลายขั้นตอน โดยไม่ต้องเปิดเบราว์เซอร์เต็มรูปแบบ มันห่อหุ้ม
requests และ Beautiful Soup ทำให้เร็วกว่าและเบากว่า Selenium มากสำหรับเว็บไซต์ที่ไม่พึ่งพา JavaScript มากนัก
หากคุณต้องการเข้าสู่ระบบ ส่งแบบฟอร์ม หรือคลิกผ่านไม่กี่หน้า (และเว็บไซต์ไม่ไดนามิกเกินไป) MechanicalSoup เป็นทางเลือกที่ดี
คุณสมบัติหลัก:
- ทำให้การกรอกแบบฟอร์มและการนำทางเป็นไปโดยอัตโนมัติ
- สร้างขึ้นบน Requests และ Beautiful Soup
- น้ำหนักเบาและรวดเร็ว (ไม่มีโอเวอร์เฮดของเบราว์เซอร์)
- ใช้งานง่ายสำหรับการโต้ตอบระดับปานกลาง
เหมาะสำหรับ: เว็บไซต์ที่ต้องการการเข้าสู่ระบบหรือการส่งแบบฟอร์ม งานอัตโนมัติง่ายๆ และทุกคนที่ต้องการหลีกเลี่ยงโอเวอร์เฮดของ Selenium
9. Aiohttp
 Aiohttp คือขุมพลังแบบ async สำหรับคำขอเว็บความเร็วสูงและพร้อมกันครับ หากคุณต้องการ Scraping หลายร้อยหน้าอย่างรวดเร็ว aiohttp ช่วยให้คุณส่งคำขอพร้อมกันได้ ซึ่งช่วยลดเวลาการทำงานทั้งหมดได้อย่างมาก ในการทดสอบหนึ่งครั้ง การ Scraping 50 หน้าใช้เวลาเพียง 3 วินาทีด้วย aiohttp เทียบกับ 16 วินาทีเมื่อใช้คำขอแบบ synchronous (ดูความแตกต่างของประสิทธิภาพ)
Aiohttp ต้องเขียนโค้ด async def และใช้ await แต่ความเร็วที่เพิ่มขึ้นนั้นคุ้มค่าสำหรับงานขนาดใหญ่
คุณสมบัติหลัก:
- เฟรมเวิร์กไคลเอนต์/เซิร์ฟเวอร์ HTTP แบบ Asynchronous
- รองรับเซสชัน คุกกี้ และ HTTP/2
- เพิ่มความเร็วอย่างมากสำหรับคำขอพร้อมกัน
- รวมเข้ากับไลบรารีการแยกวิเคราะห์แบบ async
เหมาะสำหรับ: การ Scraping ความเร็วสูงขนาดใหญ่ การเก็บเกี่ยว API และทุกคนที่คุ้นเคยกับการเขียนโปรแกรมแบบ async
10. Twisted
 Twisted คือเอนจินเครือข่ายที่ขับเคลื่อนด้วยเหตุการณ์ที่ขับเคลื่อน Scrapy ครับ แม้ว่าจะไม่ใช่ไลบรารี Scraping โดยตรง แต่ผู้ใช้ขั้นสูงสามารถใช้ Twisted โดยตรงเพื่อสร้างโปรแกรมรวบรวมข้อมูลที่กำหนดเอง จัดการโปรโตคอลที่ไม่ใช่ HTTP หรือใช้สไปเดอร์ที่มีการทำงานพร้อมกันสูง
Twisted มีประสิทธิภาพแต่มาพร้อมกับเส้นโค้งการเรียนรู้ที่สูงชัน เหมาะที่สุดสำหรับสถานการณ์ที่กำหนดเองสูง หรือเมื่อสร้างเฟรมเวิร์กตั้งแต่เริ่มต้น
คุณสมบัติหลัก:
- เครือข่ายที่ขับเคลื่อนด้วยเหตุการณ์สำหรับ HTTP, WebSockets, SSH และอื่นๆ
- รองรับ SSL, การทำงานพร้อมกัน และโปรโตคอลที่กำหนดเอง
- เป็นรากฐานของเอนจิน async ของ Scrapy
- ยืดหยุ่นสูงสำหรับกรณีการใช้งานขั้นสูง
เหมาะสำหรับ: โปรโตคอลที่กำหนดเอง การสร้างเฟรมเวิร์ก Scraping และผู้ใช้ขั้นสูงที่ต้องการการควบคุมสูงสุด
11. Grab
 Grab เป็นชุดเครื่องมือ Scraping แบบ All-in-one ที่รวมคำขอ HTTP, การแยกวิเคราะห์, ระบบอัตโนมัติ, การหมุนพร็อกซี และการจัดการ CAPTCHA มีลักษณะคล้ายกับ Scrapy แต่มีเป้าหมายเพื่อให้เรียนรู้และใช้งานง่ายขึ้น โดยมีการรองรับพร็อกซี, การแคช และสไปเดอร์แบบ Asynchronous ในตัว
คุณสมบัติเด่นของ Grab คือระบบ Grab:Spider ซึ่งสามารถเรียกใช้คำขอหลายพันรายการพร้อมกันโดยใช้ multicurl หากคุณต้องการโซลูชันแบบ All-in-one ที่มีการตั้งค่าน้อยกว่า Scrapy Grab ก็เป็นตัวเลือกที่น่าสนใจ
คุณสมบัติหลัก:
- รองรับพร็อกซี, การหมุน User-Agent และการแคชในตัว
- ระบบสไปเดอร์แบบ Asynchronous สำหรับการทำงานพร้อมกันสูง
- การแยกวิเคราะห์ XPath และสถาปัตยกรรมแบบโมดูลาร์
- ใช้ในการผลิตสำหรับการ Scraping ขนาดใหญ่
เหมาะสำหรับ: โปรเจกต์ Scraping แบบ All-in-one งานที่ใช้พร็อกซีเยอะ และผู้ใช้ที่ต้องการประสิทธิภาพโดยไม่มีความซับซ้อนของ Scrapy
12. Urllib3
 Urllib3 คือเอนจิน HTTP ระดับต่ำที่ขับเคลื่อนไคลเอนต์ Python จำนวนมาก รวมถึง Requests มันมีการรวมการเชื่อมต่อ ความปลอดภัยของเธรด การลองใหม่ และการควบคุมการเชื่อมต่อ HTTP อย่างละเอียดถี่ถ้วน แม้ว่านักพัฒนาส่วนใหญ่จะใช้มันโดยอ้อม แต่ urllib3 คือตัวเลือกของคุณเมื่อคุณต้องการประสิทธิภาพสูงสุด หรือกำลังสร้างไลบรารีระดับสูงขึ้นไป
มันไม่เป็นมิตรกับผู้เริ่มต้นเท่า Requests แต่มันผ่านการทดสอบมาแล้วและเชื่อถือได้สูง
คุณสมบัติหลัก:
- การรวมการเชื่อมต่อและความปลอดภัยของเธรด
- การควบคุมการเชื่อมต่อ HTTP อย่างละเอียด
- ใช้เป็นรากฐานสำหรับไลบรารีอื่นๆ มากมาย
- ประสิทธิภาพสูงสำหรับการร้องขอซ้ำๆ
เหมาะสำหรับ: ไคลเอนต์ HTTP ที่กำหนดเอง โปรแกรมรวบรวมข้อมูลแบบ Multi-threaded และนักพัฒนาที่สร้างบน Python HTTP stack
ดูบทบาทของ urllib3 ในการ Scraping
ตารางเปรียบเทียบ: แพ็กเกจ Python Web Scraping โดยสรุป
| แพ็กเกจ | ความง่ายในการใช้งาน | ประสิทธิภาพ | เนื้อหาแบบไดนามิก | พลังในการแยกวิเคราะห์ | ชุมชน/เอกสารประกอบ | เหมาะสำหรับ |
|---|---|---|---|---|---|---|
| Thunderbit | ★★★★☆ (GUI/AI) | เร็ว (คลาวด์/ในเครื่อง) | ใช่ (ผ่าน AI) | ฟิลด์อัตโนมัติ, หน้าย่อย | กำลังเติบโต (เทรนด์ AI) | การสร้างลูกค้าเป้าหมาย, การวิจัยตลาด, ผู้ใช้ที่ไม่ต้องเขียนโค้ด |
| Beautiful Soup | ★★★★★ (ง่าย) | ปานกลาง | ไม่ | HTML/XML, ยืดหยุ่น | ใหญ่มาก | หน้าเว็บแบบคงที่, ผู้เริ่มต้น |
| Scrapy | ★★☆☆☆ (ยาก) | ★★★★★ (สูงมาก) | ปลั๊กอินเท่านั้น | CSS/XPath, Pipeline | ใหญ่, ใช้งานอยู่ | การ Scraping ขนาดใหญ่และทำซ้ำ |
| Selenium | ★★☆☆☆ (ปานกลาง) | ★☆☆☆☆ (ช้า) | ใช่ (เต็มรูปแบบ) | DOM เต็มรูปแบบ, JS | มีประสบการณ์ | เว็บไซต์ที่ใช้ JS เยอะ, เว็บไซต์แบบโต้ตอบ |
| PyQuery | ★★★★☆ (jQuery) | เร็ว (lxml) | ไม่* | ตัวเลือก jQuery | ปานกลาง | การสร้างต้นแบบ, นักพัฒนา jQuery |
| LXML | ★★★☆☆ (ขั้นสูง) | ★★★★★ (เร็วที่สุด) | ไม่ | XPath/CSS, XML | ปานกลาง | เอกสารขนาดใหญ่, การสอบถามขั้นสูง |
| Requests | ★★★★★ (ง่ายมาก) | ★★☆☆☆ (ซิงค์) | ไม่ | HTTP, JSON | ใหญ่มาก | สคริปต์ง่ายๆ, หน้าเว็บแบบคงที่ |
| MechanicalSoup | ★★★★☆ (ง่าย) | ★★☆☆☆ (ซิงค์) | ไม่ | ฟอร์ม, การนำทาง | เล็ก | ขั้นตอนการเข้าสู่ระบบ, การทำงานอัตโนมัติของฟอร์ม |
| Aiohttp | ★★☆☆☆ (async) | ★★★★★ (พร้อมกัน) | ไม่ | Async HTTP | ใหญ่ (async) | การ Scraping ความเร็วสูงและพร้อมกัน |
| Twisted | ★☆☆☆☆ (ซับซ้อน) | ★★★★★ (กำหนดเอง) | ไม่ | เครือข่าย, โปรโตคอล | เฉพาะกลุ่ม | เฟรมเวิร์กที่กำหนดเอง, ผู้ใช้ขั้นสูง |
| Grab | ★★★☆☆ (โมดูลาร์) | ★★★★☆ (async) | ไม่ | พร็อกซี, XPath | เล็ก | All-in-one, งานที่ใช้พร็อกซี/CAPTCHA เยอะ |
| Urllib3 | ★★★★☆ (ระดับต่ำ) | ★★★★☆ (รวมกลุ่ม) | ไม่ | HTTP, การรวมกลุ่ม | ใหญ่มาก | ไคลเอนต์ที่กำหนดเอง, โปรแกรมรวบรวมข้อมูลแบบ Multi-threaded |
*PyQuery สามารถใช้ร่วมกับ Selenium สำหรับเว็บไซต์แบบไดนามิกได้
วิธีเลือกแพ็กเกจ Python Web Scraping ที่เหมาะสมกับความต้องการของคุณ
การดึงข้อมูลคืออะไรและทำอย่างไรในปี 2026 Get Started Free
แล้วคุณควรเลือกแพ็กเกจไหนดีล่ะ? นี่คือคู่มือฉบับย่อของผมครับ:
- หน้าเว็บแบบคงที่ งานเล็กๆ หรือคุณเพิ่งเริ่มต้นการ Scraping: เริ่มต้นด้วย Requests + Beautiful Soup
- การ Scraping ขนาดใหญ่ ทำซ้ำ หรือระดับ Production: Scrapy หรือ Grab (สำหรับความต้องการแบบ All-in-one)
- เว็บไซต์ที่ใช้ JavaScript เยอะ หรือเว็บไซต์แบบโต้ตอบ: Selenium (หรือ Thunderbit หากคุณต้องการการ Scraping ที่ขับเคลื่อนด้วย AI และไม่ต้องเขียนโค้ด)
- การ Scraping ความเร็วสูงและพร้อมกัน: Aiohttp (หากคุณคุ้นเคยกับ async)
- การทำงานอัตโนมัติของฟอร์ม หรือขั้นตอนการเข้าสู่ระบบ: MechanicalSoup (สำหรับเว็บไซต์ง่ายๆ), Selenium (สำหรับ JS ที่ซับซ้อน)
- การแยกวิเคราะห์ขั้นสูง หรือเอกสารขนาดใหญ่: LXML หรือ PyQuery
- งานเครือข่ายหรือโปรโตคอลที่กำหนดเอง: Twisted
- การสร้างต้นแบบอย่างรวดเร็ว การสร้างลูกค้าเป้าหมาย หรือข้อมูลที่ยุ่งเหยิง/ไม่มีโครงสร้าง: Thunderbit
และอย่ากลัวที่จะผสมผสานกันนะครับ – เวิร์กโฟลว์จำนวนมากรวมเครื่องมือเหล่านี้เข้าด้วยกันเพื่อประสิทธิภาพสูงสุด ตัวอย่างเช่น คุณอาจใช้ Selenium เพื่อเรนเดอร์หน้าเว็บ จากนั้นส่ง HTML ไปยัง Beautiful Soup หรือ PyQuery เพื่อแยกวิเคราะห์
สรุป: เพิ่มประสิทธิภาพการทำ Web Scraping ของคุณด้วยเครื่องมือ Python ที่เหมาะสม
การทำ Web Scraping ในปี 2026 มีประสิทธิภาพมากขึ้น – และจำเป็นมากขึ้น – กว่าที่เคยเป็นมา ด้วยแพ็กเกจ Python Web Scraping ที่เหมาะสม คุณสามารถเปลี่ยนความวุ่นวายของเว็บให้เป็นข้อมูลที่สะอาดและนำไปใช้ได้จริงสำหรับธุรกิจ การวิจัย หรือแนวคิดใหม่ๆ ของคุณ ไม่ว่าคุณจะเป็นนักพัฒนาที่มีประสบการณ์ หรือเพิ่งเริ่มต้นเข้าสู่โลกของข้อมูล ก็มีเครื่องมือในรายการนี้ที่เหมาะกับความต้องการของคุณ
หากคุณต้องการดูว่าการ Scraping ที่ขับเคลื่อนด้วย AI และไม่ต้องเขียนโค้ดเป็นอย่างไร ลองใช้ Thunderbit ฟรี และหากคุณต้องการเคล็ดลับ ข้อมูลเชิงลึก และบทเรียนเพิ่มเติม โปรดดูที่ บล็อก Thunderbit สำหรับข้อมูลล่าสุดเกี่ยวกับการทำ Web Scraping ระบบอัตโนมัติ และเวิร์กโฟลว์ที่ขับเคลื่อนด้วยข้อมูล
ลองใช้ Thunderbit AI Web Scraper
ขอให้มีความสุขกับการ Scraping – และขอให้ตัวเลือกของคุณตรงกันเสมอ พร็อกซีของคุณไม่เคยล้มเหลว และข้อมูลของคุณสะอาดเหมือนโค้ดของคุณ
คำถามที่พบบ่อย
1. แพ็กเกจ Python Web Scraping ที่ดีที่สุดสำหรับผู้เริ่มต้นคืออะไร? สำหรับผู้เริ่มต้นส่วนใหญ่ การรวมกันของ Requests และ Beautiful Soup เป็นวิธีที่ง่ายที่สุดในการเริ่มต้น ทั้งสองมี API ที่ใช้งานง่าย บทเรียนมากมาย และจัดการงาน Scraping หน้าเว็บแบบคงที่ส่วนใหญ่ได้
2. ฉันจะ Scraping เว็บไซต์ที่ใช้ JavaScript เยอะๆ ด้วย Python ได้อย่างไร? ใช้ Selenium เพื่อทำให้เบราว์เซอร์จริงทำงานอัตโนมัติ หรือลองใช้ Thunderbit สำหรับการ Scraping ที่ขับเคลื่อนด้วย AI และไม่ต้องเขียนโค้ด ซึ่งสามารถจัดการเนื้อหาแบบไดนามิกได้ สำหรับความต้องการขนาดใหญ่ Scrapy สามารถใช้ร่วมกับ Splash หรือ Selenium ได้
3. แพ็กเกจใดดีที่สุดสำหรับการ Scraping ขนาดใหญ่และรวดเร็ว? Scrapy ถูกสร้างมาสำหรับการ Crawling แบบ Asynchronous ขนาดใหญ่ หากคุณต้องการความเร็วที่มากขึ้นและคุ้นเคยกับโค้ด async aiohttp เป็นตัวเลือกอันดับต้นๆ สำหรับคำขอพร้อมกัน
4. ฉันสามารถรวมแพ็กเกจเหล่านี้ในเวิร์กโฟลว์ของฉันได้หรือไม่? แน่นอนครับ! นักพัฒนาหลายคนใช้ Requests หรือ Selenium เพื่อดึงหน้าเว็บ จากนั้นแยกวิเคราะห์ด้วย Beautiful Soup, lxml หรือ PyQuery ผลลัพธ์ของ Thunderbit สามารถป้อนเข้าสู่สคริปต์ Python เพื่อการวิเคราะห์เพิ่มเติมได้
5. Thunderbit เป็นไลบรารี Python หรือเครื่องมือแบบสแตนด์อโลน? Thunderbit เป็นส่วนขยาย Chrome ที่ขับเคลื่อนด้วย AI และแพลตฟอร์ม ไม่ใช่ไลบรารี Python แบบดั้งเดิม อย่างไรก็ตาม ผลลัพธ์ของมัน (CSV, Excel, Sheets, Notion, Airtable) สามารถรวมเข้ากับ Python data pipelines ได้อย่างราบรื่น ทำให้เป็นคู่หูที่ทรงพลังสำหรับนักพัฒนา Python
6. AI coding agents จะมาแทนที่ไลบรารี Python Scraping ในปี 2026 หรือไม่? ยังไม่ถึงขั้นนั้นครับ แต่ก็ควรทำความรู้จักไว้ เครื่องมืออย่าง Claude Code และ OpenAI Codex สามารถสร้างสคริปต์ Requests + Beautiful Soup หรือ Scrapy ที่ใช้งานได้จากคำสั่งภาษาอังกฤษธรรมดาในไม่กี่วินาที ซึ่งมีประโยชน์อย่างแท้จริงสำหรับงานเฉพาะกิจและการสร้างต้นแบบ สำหรับขั้นตอนการทำงานของเบราว์เซอร์ด้วยภาษาธรรมชาติ (การเข้าสู่ระบบ, JS แบบไดนามิก, การนำทางหลายขั้นตอน) Browser Use เป็นตัวเลือกโอเพนซอร์สที่ผู้คนนิยมใช้ และ Firecrawl เป็นที่นิยมเมื่อเป้าหมายคือการป้อน Markdown ที่สะอาดให้กับ LLM ไม่มีสิ่งใดที่ขจัดส่วนที่ยากออกไปได้ — การป้องกันบอท, อัตราการจำกัด และ TOS ยังคงมีผลบังคับใช้ — และสำหรับโปรแกรมรวบรวมข้อมูลระดับ Production ในขนาดใหญ่ Scrapy + aiohttp ยังคงชนะในด้านต้นทุนและการควบคุม ถือว่า AI agents เป็นวิธีที่เร็วกว่าในการ เขียน โปรแกรม Scraping ไม่ใช่การแทนที่ไลบรารีในรายการนี้โดยตรง
ต้องการก้าวล้ำหน้าในโลกของการทำ Web Scraping หรือไม่? สมัครสมาชิก ช่อง YouTube ของ Thunderbit และติดตาม บล็อก Thunderbit สำหรับคู่มือ การเปรียบเทียบ และเคล็ดลับระบบอัตโนมัติเพิ่มเติม
ลองใช้ Thunderbit AI Web Scraper ฟรี Get Started Free
เรียนรู้เพิ่มเติม




