
ถ้าคุณเคยจ้องมองหน้าเว็บ สเปรดชีต หรือไฟล์ PDF กองโต แล้วคิดในใจว่า “ต้องมีวิธีเอาข้อมูลออกมาที่ดีกว่านี้แน่” คุณไม่ได้คิดอยู่คนเดียว ผมใช้เวลาหลายปีในการสร้างเครื่องมืออัตโนมัติ และคุยกับทีมธุรกิจที่เบื่อสุด ๆ กับงานคัดลอกวางที่ไม่มีวันจบ ความจริงคือ ในปี 2026 ปริมาณข้อมูลไม่มีโครงสร้างในโลกมันมหาศาลมาก—80–90% ของข้อมูลองค์กรใหม่เป็นข้อมูลไม่มีโครงสร้าง และมีเพียงไม่กี่บริษัทเท่านั้นที่เอามาใช้ได้อย่างคุ้มค่าจริง (Docsumo) การเก็บข้อมูลด้วยมือไม่ได้แค่น่าเบื่อ—แต่มันเปลืองเวลา เสี่ยงผิดพลาด และลากประสิทธิภาพการทำงานให้ตกลงไปมาก
ดึงข้อมูลจากทุกเว็บไซต์ด้วย AI Get Started Free
นี่แหละคือจุดที่เครื่องมือดึงข้อมูลเข้ามาช่วย ไม่ว่าคุณจะอยู่ในทีมขาย ทีมปฏิบัติการ อีคอมเมิร์ซ หรือฝ่ายวิจัย เครื่องมือที่เหมาะสมช่วยประหยัดเวลาได้เป็นชั่วโมงหรือเป็นวัน เพิ่มความแม่นยำ และปล่อยให้ทีมไปโฟกัสกับงานที่สำคัญจริง ๆ แต่พอมีตัวเลือกเยอะขนาดนี้—ตั้งแต่ส่วนขยาย Chrome ที่ใช้ AI แพลตฟอร์มแบบไม่ต้องเขียนโค้ด ไปจนถึงเฟรมเวิร์กสำหรับนักพัฒนา—แล้วจะเลือกตัวที่เหมาะกับงานของคุณยังไง? ผมคัดมาแล้ว 10 เครื่องมือดึงข้อมูลที่น่าสนใจที่สุดสำหรับปี 2026 พร้อมสรุปจุดแข็ง จุดอ่อน และสถานการณ์ที่เหมาะที่สุด มาดูกันเลย
ทำไมธุรกิจต้องมีเครื่องมือดึงข้อมูลเพื่อเพิ่มประสิทธิภาพสูงสุด
พูดตรง ๆ เลย: 94% ของธุรกิจต้องติดอยู่กับงานซ้ำ ๆ ที่กินเวลา อย่างการกรอกข้อมูลด้วยมือ (ServiceNow) และต้นทุนไม่ได้มีแค่เวลาที่หายไป—การดึงข้อมูลด้วยมืออาจมีค่าใช้จ่ายสูงถึง $1,500 ต่อพนักงานต่อเดือน (ResolvePay) เครื่องมือดึงข้อมูลช่วยเปลี่ยนงานหนักที่ซ้ำซากให้กลายเป็นอัตโนมัติ ทำให้คุณ:
- ประหยัดเวลาได้สูงสุด 77% ที่เคยเสียไปกับการเก็บข้อมูล (ServiceNow)
- เพิ่มประสิทธิภาพการทำงานได้ 40% (PerfectDataEntry)
- ลดเวลาประมวลผลลง 50% หรือมากกว่า (Docsumo)
- ทำความแม่นยำได้สูงถึง 99.9% ในการดึงข้อมูลจากเอกสาร (Docsumo)
แล้วผลลัพธ์คืออะไร? ตัดสินใจได้เร็วขึ้น ข้อมูลมีคุณภาพขึ้น และทีมทำงานได้สบายขึ้น ไม่ว่าคุณจะใช้มันเพื่อดึงลีด ติดตามราคาคู่แข่ง หรือส่งข้อมูลเข้าเครื่องมือ BI เครื่องมือดึงข้อมูลที่ดีเปรียบเหมือนผู้ช่วยดิจิทัลที่ไม่เคยเหนื่อยและไม่เคยขอขึ้นเงินเดือน
วิธีเลือกเครื่องมือดึงข้อมูลที่ดีที่สุด: เกณฑ์สำคัญที่ควรดู
เครื่องมือดึงข้อมูลไม่ได้เหมือนกันหมด นี่คือสิ่งที่ผมใช้เป็นหลักเวลาแนะนำเครื่องมือ:
- ใช้งานง่าย: คนที่ไม่ใช่สายเทคนิคเริ่มได้เร็วแค่ไหน? มี AI หรือการตั้งค่าแบบคลิกเลือกไหม?
- ปรับแต่งได้และยืดหยุ่น: รับมือเว็บซับซ้อน หน้า login หรือคอนเทนต์ที่เปลี่ยนตลอดเวลาได้ไหม? มีสคริปต์สำหรับงานขั้นสูงหรือเปล่า?
- รองรับประเภทข้อมูลอะไรบ้าง: ดึงข้อความ ตัวเลข รูปภาพ อีเมล เบอร์โทร PDF ฯลฯ ได้ไหม?
- รองรับงานขนาดใหญ่และประสิทธิภาพ: รับมือเป็นพันหน้าได้ไหม? มีการทำงานบนคลาวด์หรือหลายเธรดหรือไม่?
- เชื่อมต่อและทำงานอัตโนมัติ: ส่งออกตรงไปยัง Excel, Google Sheets, Airtable, Notion หรือเชื่อมผ่าน API ได้ไหม?
- ราคาและความคุ้มค่า: มีแผนใช้ฟรีไหม? แผนเสียเงินเหมาะกับงบและรูปแบบการใช้งานหรือเปล่า?
- ซัพพอร์ตและคอมมูนิตี้: มีเอกสาร คู่มือ และทีมช่วยเหลือตอบไวแค่ไหน?
แต่ละทีมให้น้ำหนักกับเรื่องพวกนี้ไม่เท่ากัน เช่น ทีมขายอาจเน้นความง่ายและการส่งออกข้อมูลเร็ว ๆ ในขณะที่นักพัฒนาจะมองหาการปรับแต่งลึกและการเข้าถึง API
เครื่องมือดึงข้อมูลสำหรับอีคอมเมิร์ซและการวิจัยตลาด
ทีมอีคอมเมิร์ซและทีมวิจัยตลาดพึ่งพาข้อมูลที่อัปเดตตลอดเวลา—ไม่ว่าจะเป็นการติดตามราคา วิเคราะห์รีวิวสินค้า หรือเฝ้าดูคู่แข่ง สำหรับงานแบบนี้ คุณควรมองหาเครื่องมือที่รองรับการดึงข้อมูลขนาดใหญ่ มีมาตรการต้านบอท และตั้งเวลาอัตโนมัติได้
- Octoparse: เด่นด้วยอินเทอร์เฟซแบบไม่ต้องเขียนโค้ดที่ใช้งานได้แข็งแรง และมีเทมเพลตสำเร็จรูปหลายร้อยแบบสำหรับ Amazon, eBay และเว็บไซต์อื่น ๆ เหมาะมากกับการติดตามราคาและดึงรีวิว
- Import.io: เน้นเอาข้อมูลจากเว็บไปเชื่อมกับเครื่องมือ BI พร้อมฟีเจอร์ตั้งเวลาและตรวจจับการเปลี่ยนแปลง เหมาะกับบริษัทวิจัยตลาดที่ต้องการฟีดข้อมูลต่อเนื่อง
- Dexi.io: ระดับองค์กร มาพร้อมเวิร์กโฟลว์อัตโนมัติและการแปลงข้อมูล ใช้โดยร้านค้าปลีกรายใหญ่เพื่อทำ competitive intelligence และติดตามราคา
เครื่องมือกลุ่มนี้ถูกออกแบบมาให้รองรับงานสเกลใหญ่ และรับมือกับระบบป้องกันการดึงข้อมูลที่มักเจอในเว็บไซต์อีคอมเมิร์ซรายใหญ่
เครื่องมือดึงข้อมูลสำหรับทีมเทคนิคและเวิร์กโฟลว์แบบกำหนดเอง
ถ้าทีมของคุณมีนักพัฒนาอยู่ด้วย (หรือคุณเขียนโค้ดได้บ้าง) คุณจะอยากได้เครื่องมือที่ยืดหยุ่นที่สุด:
- Scrapy: มาตรฐานทองคำของการสแครปด้วย Python แบบโอเพนซอร์ส ปรับแต่งได้สูง และเหมาะกับโปรเจกต์ขนาดใหญ่ เหมาะสำหรับสร้าง crawler แบบเฉพาะทางหรือฝังการดึงข้อมูลเข้าไปในแอปของคุณ
- ParseHub: ตัวสร้างเวิร์กโฟลว์แบบภาพที่รับมือเว็บที่ใช้ JavaScript หนัก ๆ ได้ดี รองรับ logic แบบมีเงื่อนไข, custom JS และการเข้าถึง API
- Apify: แพลตฟอร์มคลาวด์สำหรับรันสคริปต์ดึงข้อมูล (“Actors”) ด้วย JavaScript หรือ Python เหมาะกับการต่อเวิร์กโฟลว์ ทำ automation ด้วย headless browser และขยายสเกลบนคลาวด์
นี่คือเครื่องมือที่ผมแนะนำเวลาคุณต้องสแครปเว็บที่ยุ่งยาก ทำงานหลายขั้นตอนอัตโนมัติ หรือสร้างสิ่งที่เครื่องมือแบบคลิกแล้วจบธรรมดา ๆ ทำไม่ได้
เครื่องมือดึงข้อมูลสำหรับการเชื่อมต่อข้อมูลและเวิร์กโฟลว์อัตโนมัติ
บางทีมต้องการมากกว่าข้อมูลดิบ—พวกเขาอยากทำให้ทั้งสายพานทำงานอัตโนมัติ ตั้งแต่การดึงข้อมูลไปจนถึงการวิเคราะห์:
- Import.io: อย่างที่บอกไปแล้ว จุดเด่นคือการเชื่อมข้อมูลเว็บเข้ากับแดชบอร์ด analytics และ BI พร้อมการตั้งเวลาและส่งข้อมูลผ่าน API
- Dexi.io: สร้างมาเพื่อ automation แบบ end-to-end รวมถึงการทำความสะอาดข้อมูล การแปลงข้อมูล และการเชื่อมกับ CRM, ฐานข้อมูล และระบบอื่น ๆ
ถ้าเวิร์กโฟลว์ของคุณมีหลายขั้นตอน หรือคุณอยากให้ข้อมูลไหลเข้าระบบเดิมได้โดยตรง เครื่องมือเหล่านี้คุ้มค่ามากที่จะพิจารณา
ตารางเปรียบเทียบ: 10 เครื่องมือดึงข้อมูลยอดนิยมแบบสรุปเร็ว
นี่คือตารางเปรียบเทียบแบบย่อ เพื่อช่วยให้คุณคัดตัวเลือกได้เร็วขึ้น:
| ชื่อเครื่องมือ | ใช้งานง่าย | เหมาะที่สุดสำหรับ | ราคา | การปรับแต่ง | ประเภทข้อมูลที่รองรับ |
|---|---|---|---|---|---|
| Thunderbit | ⭐ ง่ายมาก | ทุกอุตสาหกรรม, ผู้ใช้ที่ไม่ใช่สายเทคนิค | ฟรี & แบบเสียเงิน | AI Prompt แบบ low-code | ข้อความ, ตัวเลข, วันที่, URL, อีเมล, เบอร์โทร, รูปภาพ, PDF |
| Octoparse | 🙂 ปานกลาง | อีคอมเมิร์ซ, วิจัยตลาด | ฟรี & แบบเสียเงิน | สูง (ภาพ, regex) | ข้อความ, ตัวเลข, URL, รูปภาพ |
| ParseHub | 🙂 ปานกลาง | เว็บไซต์ไดนามิก, ผู้ใช้สายเทคนิค | แบบเสียเงิน | สูง (JS, logic) | ข้อความ, ตัวเลข, URL, รูปภาพ |
| Import.io | 😀 ง่าย | เชื่อมข้อมูล, BI | แบบเสียเงิน (องค์กร) | ปานกลาง | ข้อความ, ตาราง, รายการ |
| Scrapy | 😐 ยาก | งาน dev แบบกำหนดเอง, ขนาดใหญ่ | ฟรี (โอเพนซอร์ส) | สูงมาก (โค้ด) | ได้ทุกแบบ (กำหนดเองโดยนักพัฒนา) |
| Apify | 😐 ยาก | อัตโนมัติเวิร์กโฟลว์, นักพัฒนา | ฟรี & แบบเสียเงิน | สูงมาก (โค้ด) | เนื้อหาเว็บทุกประเภท |
| Dexi.io | 🙂 ปานกลาง | องค์กร, เวิร์กโฟลว์ | แบบเสียเงิน (องค์กร) | สูง (ภาพ, สคริปต์) | ข้อความ, รูปภาพ, ไฟล์ |
| WebHarvy | 😀 ง่าย | ธุรกิจขนาดเล็ก, เว็บไซต์แบบคงที่ | ไลเซนส์จ่ายครั้งเดียว | ต่ำ-ปานกลาง | ข้อความ, ตัวเลข, URL, รูปภาพ |
| Data Miner | 😀 ง่าย | ดึงข้อมูลลงชีตแบบรวดเร็ว, งานขาย | ฟรี & แบบเสียเงิน | ปานกลาง (recipes) | ข้อความ, ตาราง, รายการ |
| Helium Scraper | 🙂 ปานกลาง | logic เฉพาะทาง, ข้อมูลเชิงสัมพันธ์ | ไลเซนส์จ่ายครั้งเดียว | สูง (JS, SQL) | ข้อความ, URL, รูปภาพ, ไฟล์ |
มีสองชื่อที่คุณอาจกำลังมองหา แต่ไม่ได้อยู่ในตารางนี้ คือ Visual Web Ripper ซึ่งหายไปแล้ว—Sequentum ปิดเซิร์ฟเวอร์ไลเซนส์ในปี 2022—และ Content Grabber ที่ถูกผนวกเข้า Sequentum Enterprise ตั้งแต่ปี 2020 และเวอร์ชันเดิมก็ไม่ได้วางขายหรือซัพพอร์ตอีกต่อไป
คำอธิบายสัญลักษณ์: 😀 ง่าย (เหมาะกับคนไม่ใช่สายเทคนิค), 🙂 ปานกลาง (ต้องเรียนรู้นิดหน่อย), 😐 ยาก (ต้องเขียนโค้ด)
1. Thunderbit
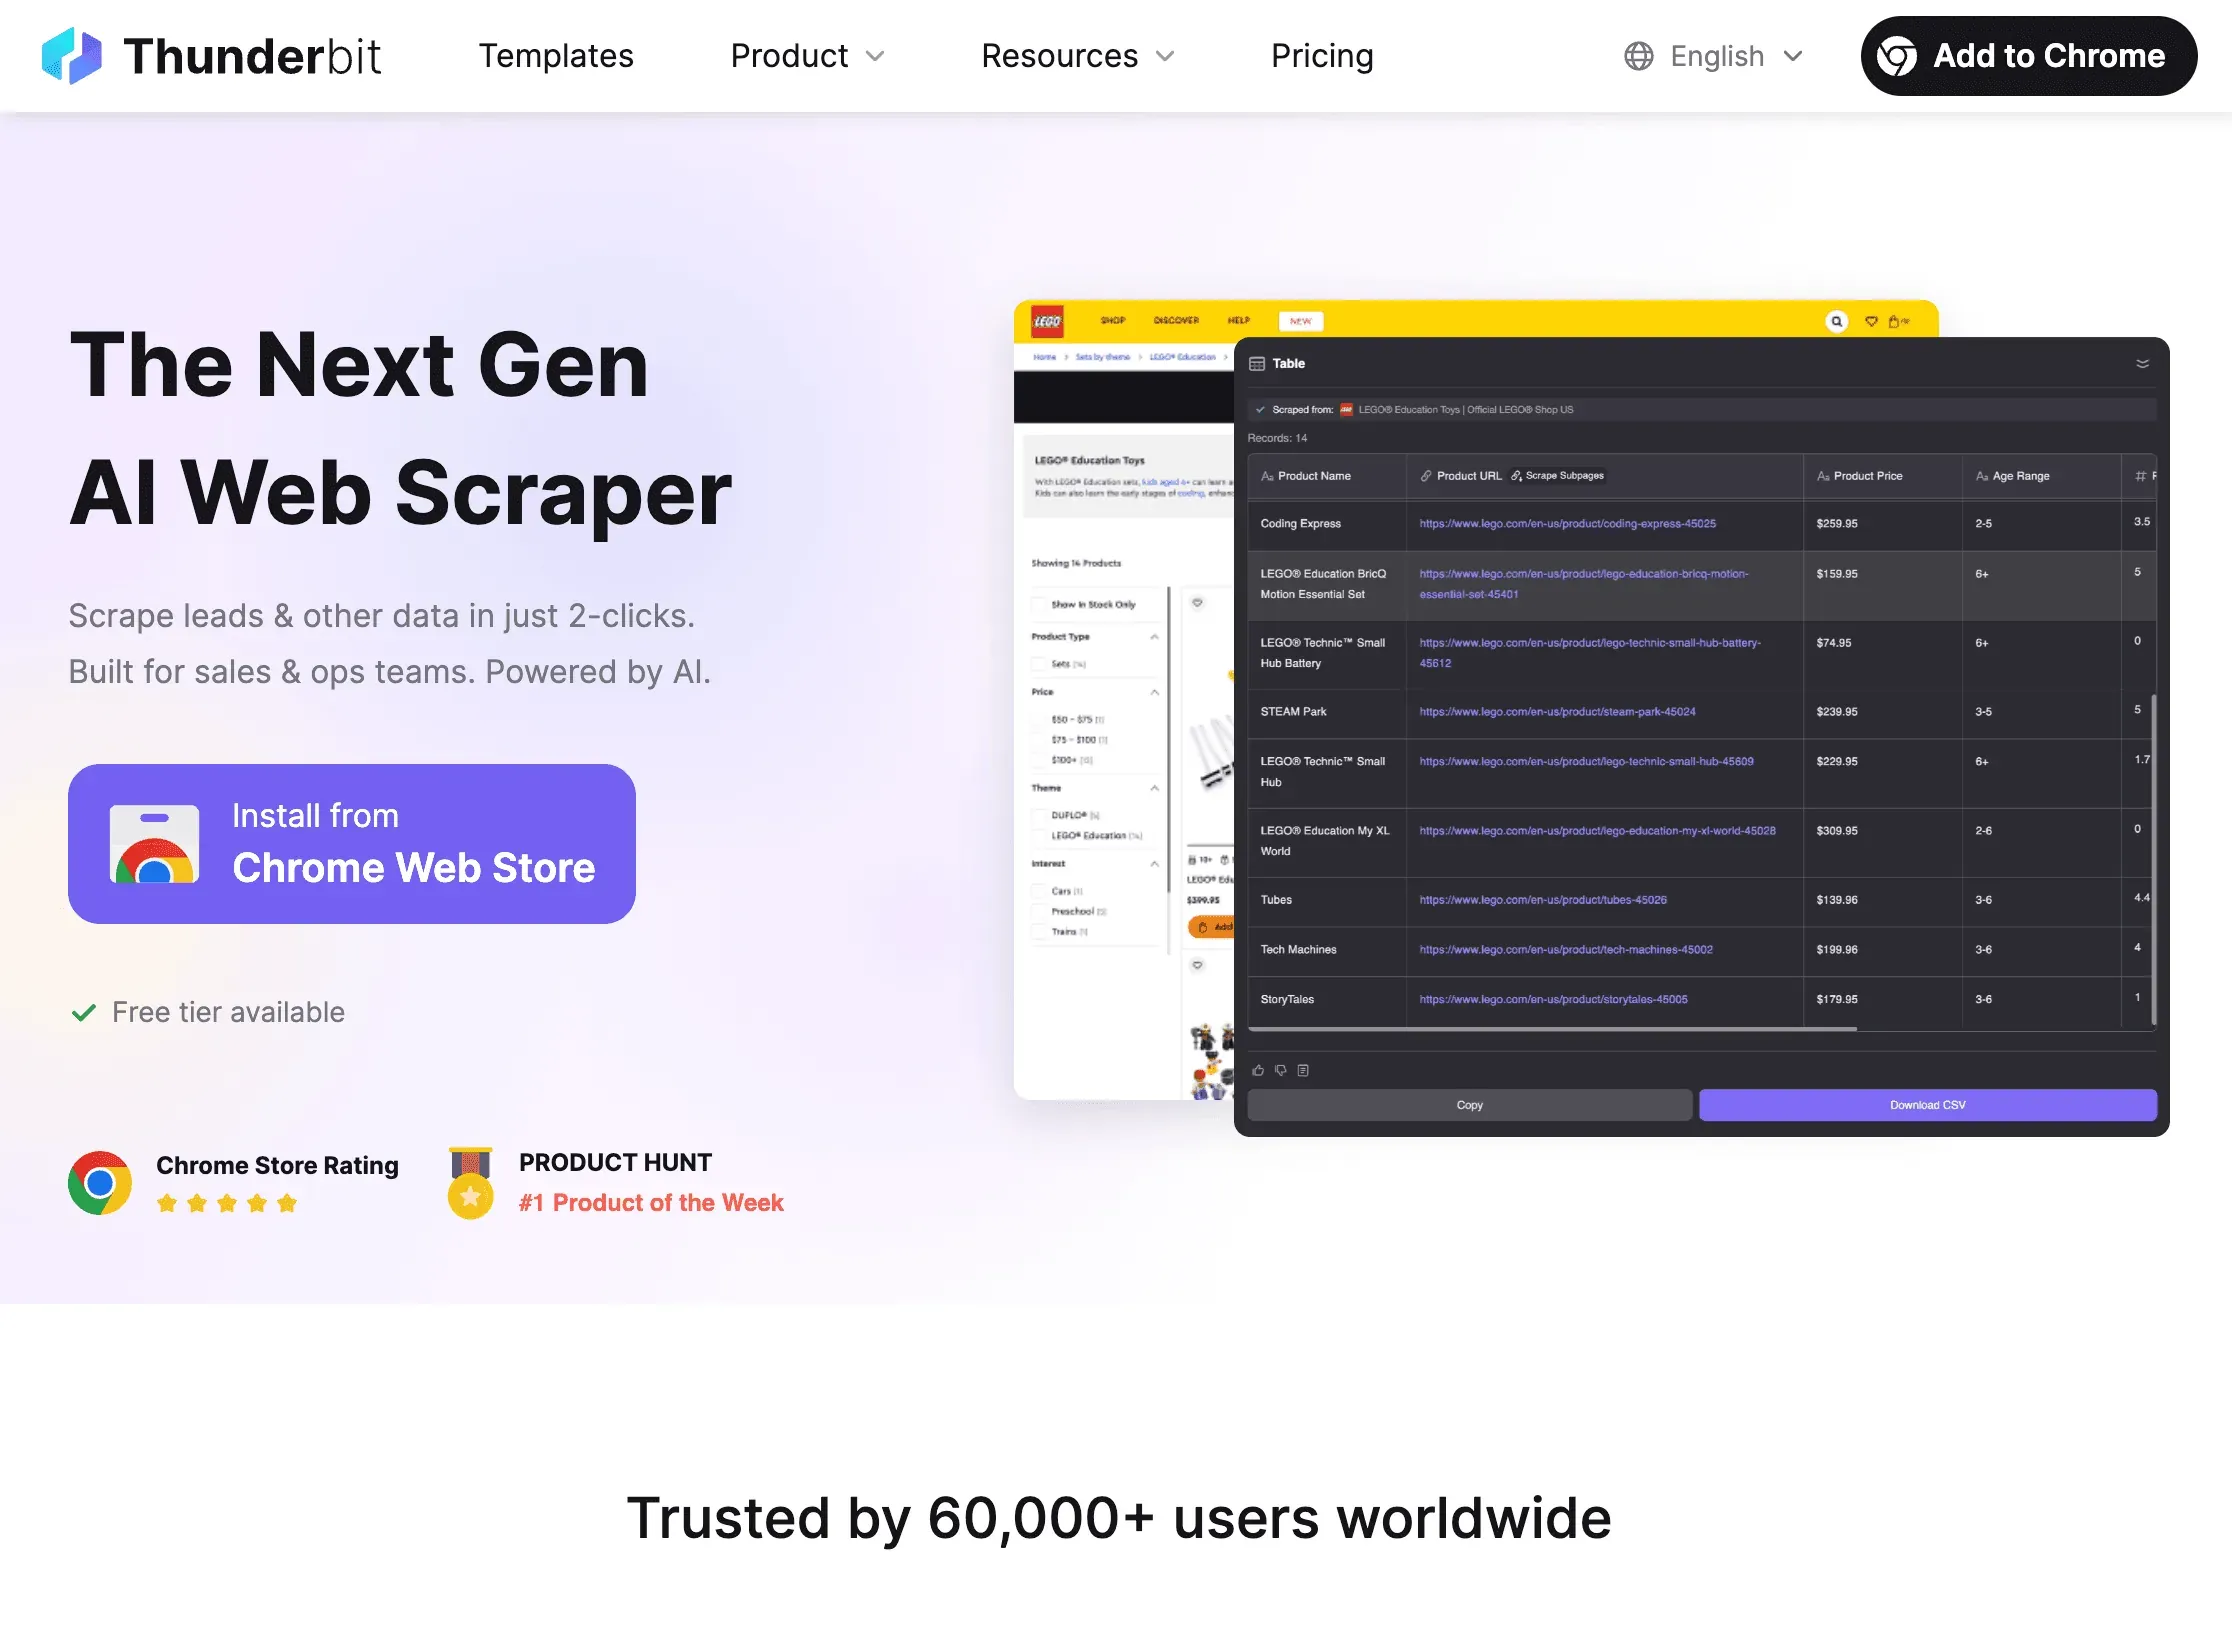 Thunderbit คือคำตอบอันดับหนึ่งของผมสำหรับผู้ใช้ที่ไม่ใช่สายเทคนิค แต่ต้องการประสิทธิภาพสูงสุดแบบไม่ต้องปวดหัว ในฐานะ ส่วนขยาย Chrome ที่ขับเคลื่อนด้วย AI มันถูกสร้างมาสำหรับผู้ใช้สายธุรกิจ—ฝ่ายขาย ปฏิบัติการ อสังหาริมทรัพย์ อีคอมเมิร์ซ—ที่ต้องการข้อมูล ไม่ใช่ความวุ่นวาย
ฟีเจอร์เด่น:
- AI Suggest Columns: คลิกครั้งเดียว AI ของ Thunderbit จะอ่านหน้าเว็บแล้วเสนอฟิลด์ที่ควรดึงออกมาให้อัตโนมัติ—ไม่ต้องตั้งค่าด้วยตัวเอง
- ดึงข้อมูลใน 2 คลิก: แค่ยืนยันฟิลด์ กด “Scrape” แล้วจบ แม้แต่คุณแม่ผมก็ใช้ได้ (ทั้งที่ยังโทรหาผมทุกครั้งเวลา Wi‑Fi มีปัญหา)
- Subpage Scraping: ถ้าต้องการรายละเอียดเพิ่ม Thunderbit สามารถเข้าไปยังแต่ละหน้าย่อยโดยอัตโนมัติ เช่นหน้าสินค้าหรือหน้าโปรไฟล์ แล้วเติมข้อมูลลงตารางให้ครบ
- ส่งออกข้อมูลฟรี: ส่งผลลัพธ์ตรงไปยัง Excel, Google Sheets, Airtable หรือ Notion ได้เลย ไม่คิดเพิ่ม
- ดึงอีเมล เบอร์โทร และรูปภาพได้ในคลิกเดียว: เหมาะมากสำหรับการหา lead หรือดึงข้อมูลติดต่อจากเว็บไซต์ใดก็ได้
- ดึงข้อมูลได้ทั้งบนคลาวด์หรือในเบราว์เซอร์: เลือกใช้โหมดคลาวด์ที่เร็วสำหรับเว็บสาธารณะ หรือโหมดเบราว์เซอร์สำหรับหน้าที่ต้องล็อกอิน
- รองรับ 34 ภาษา: ทีมงานระดับโลกน่าจะถูกใจมาก
ข้อดี: ใช้งานง่ายสุด ๆ ไม่ต้องเขียนโค้ด รองรับข้อมูลไม่มีโครงสร้าง และปรับตามการเปลี่ยนแปลงของเว็บไซต์ได้อัตโนมัติ มีแพ็กเกจใช้ฟรีสำหรับงานเล็ก และแพ็กเกจเสียเงินที่ราคาจับต้องได้สำหรับงานใหญ่
ข้อเสีย: ปรับแต่งเชิงลึกได้ไม่เท่าเครื่องมือสาย dev สำหรับเว็บที่ซับซ้อนมาก และมีการคิดราคาแบบเครดิตสำหรับผู้ใช้ที่ใช้งานหนัก
เหมาะกับ: ทีมขาย ทีมอีคอมเมิร์ซ เอเจนต์อสังหาฯ และทุกคนที่อยากเปลี่ยนจาก “ฉันต้องการข้อมูลนี้” ไปเป็น “นี่คือสเปรดชีตของฉัน” ภายในไม่ถึงห้านาที ลองใช้ Thunderbit ฟรี
2. Octoparse
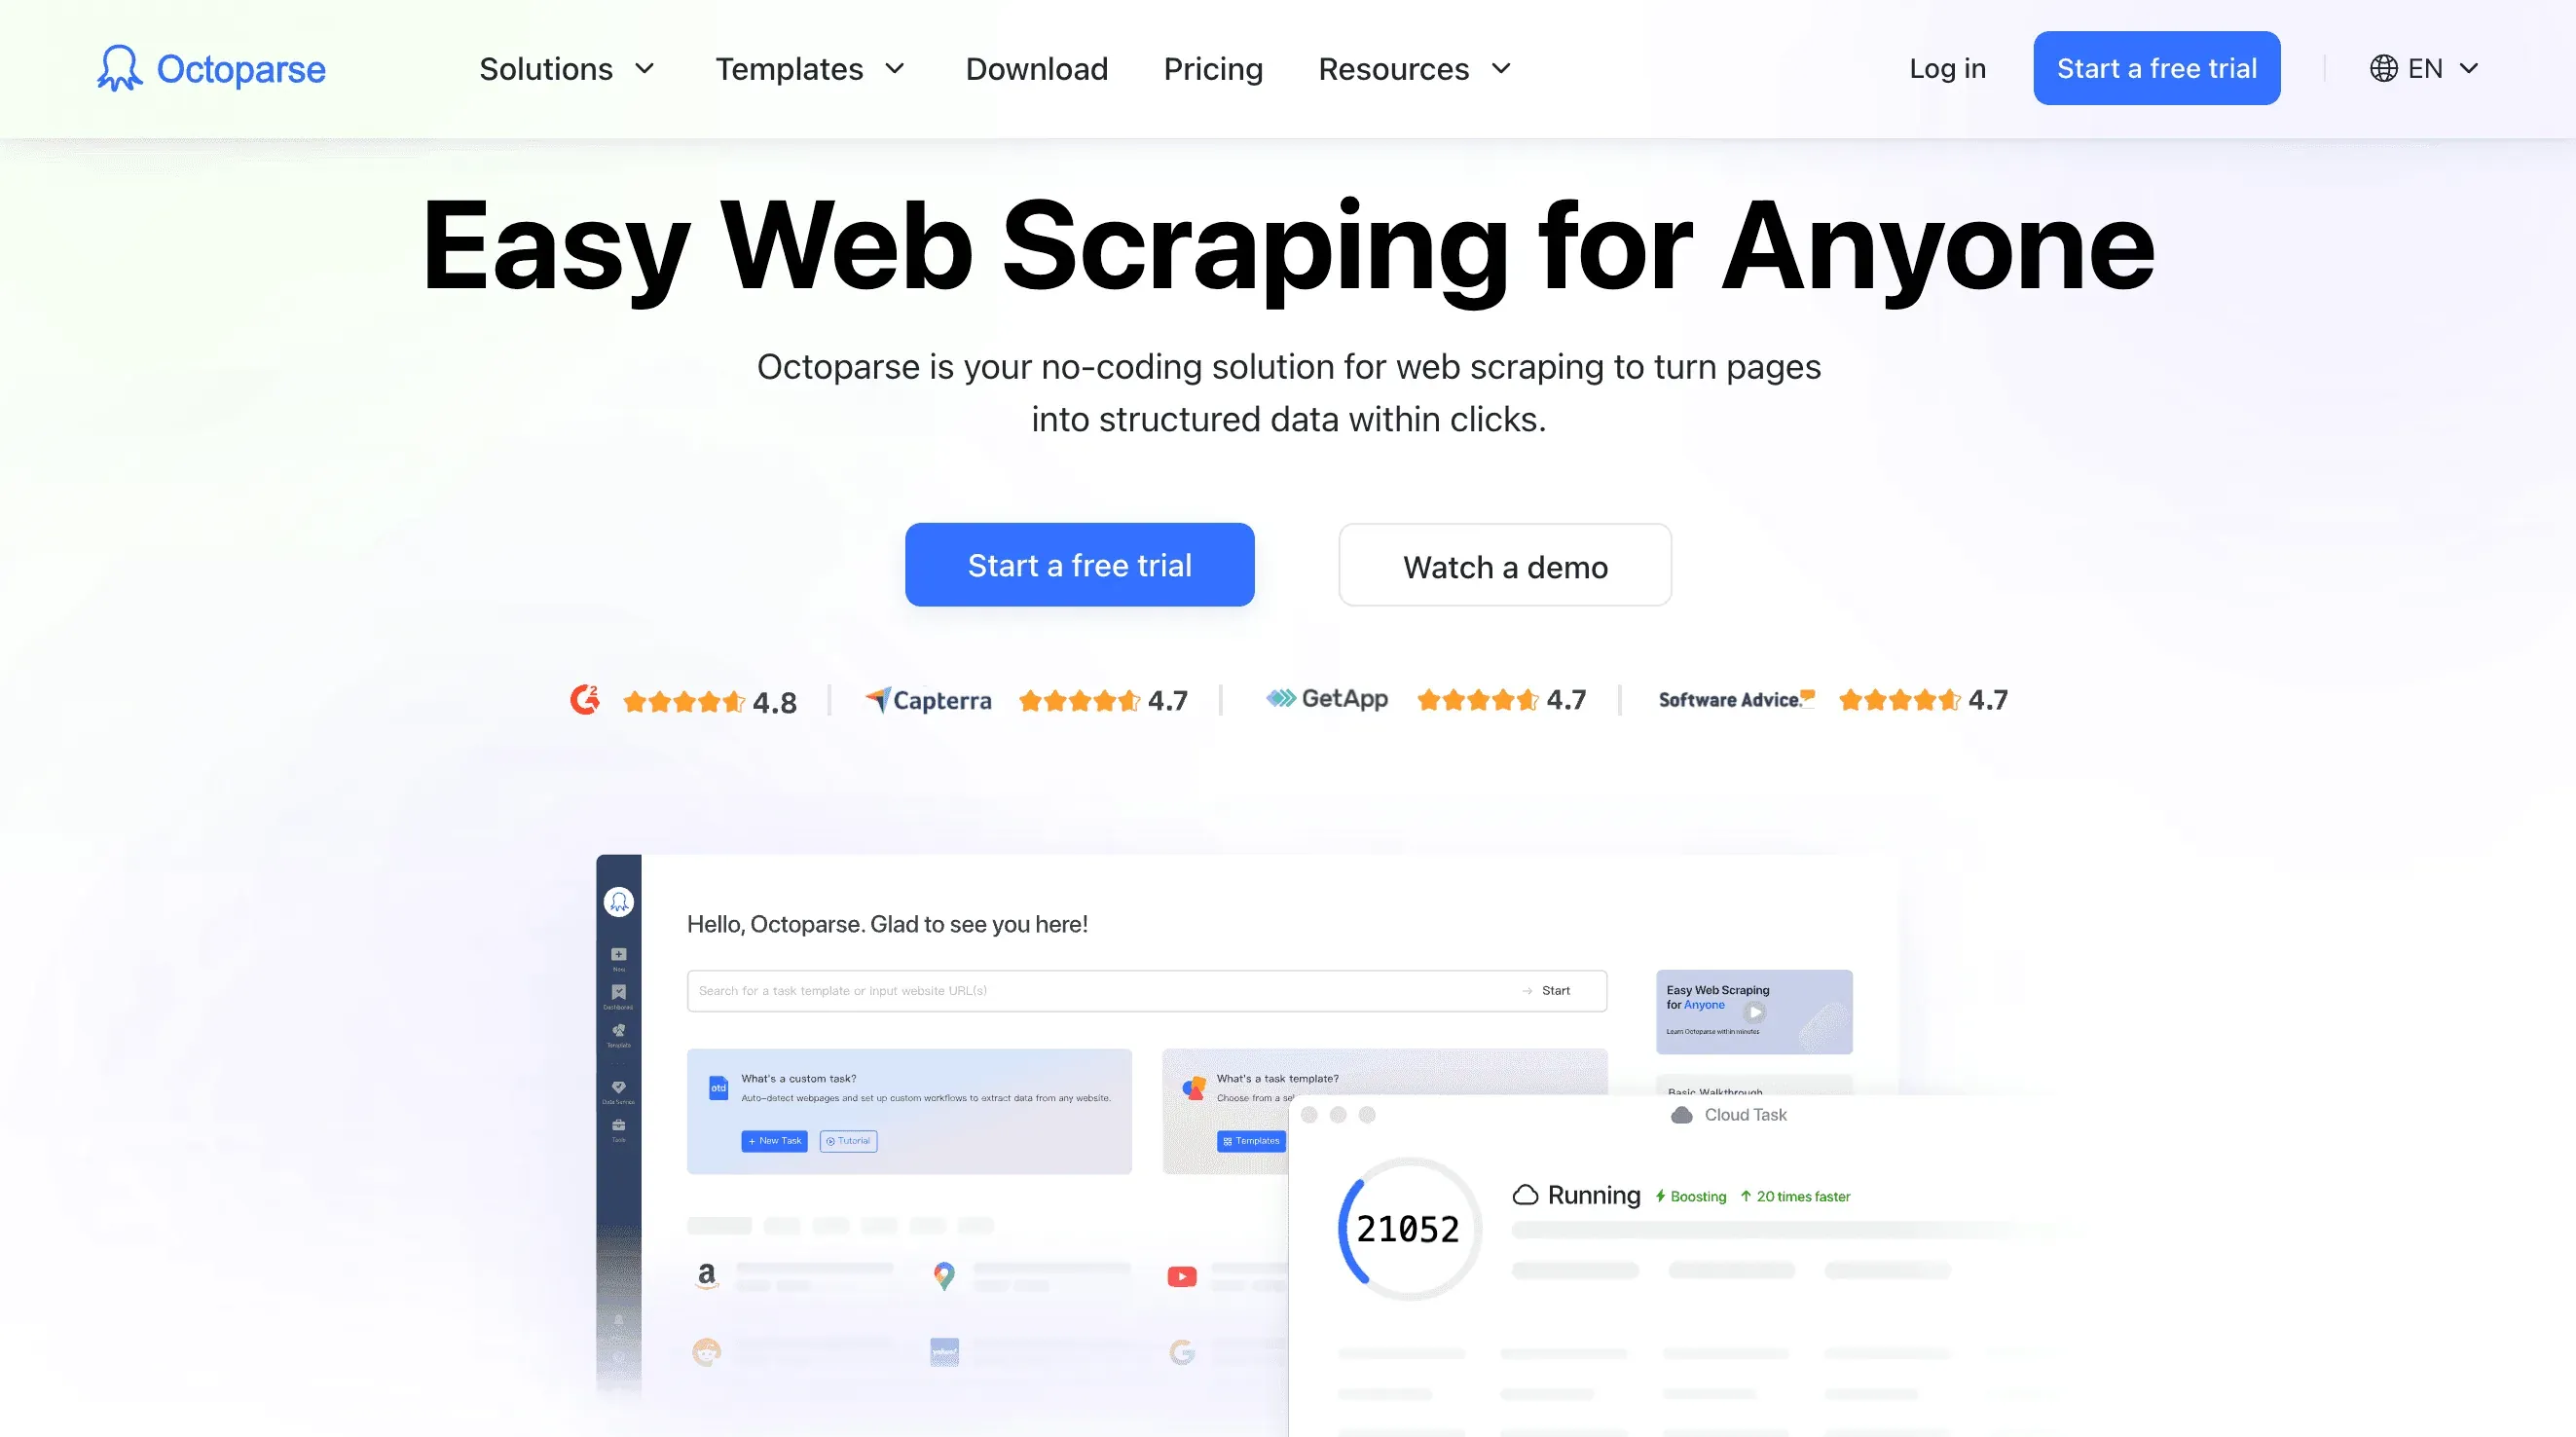 Octoparse เป็นเครื่องมือทรงพลังสำหรับทีมอีคอมเมิร์ซและการวิจัยตลาด เป็นแอปเดสก์ท็อปแบบไม่ต้องเขียนโค้ด (Windows) ที่มีตัวสร้างเวิร์กโฟลว์แบบภาพ และเทมเพลตสำเร็จรูปจำนวนมากสำหรับเว็บไซต์อย่าง Amazon, eBay และ Zillow
ฟีเจอร์เด่น:
- อินเทอร์เฟซแบบคลิกเลือก: สร้างงานดึงข้อมูลโดยคลิกองค์ประกอบบนหน้าเว็บ
- ดึงข้อมูลบนคลาวด์และตั้งเวลา: แผนแบบเสียเงินช่วยให้รันงานบนคลาวด์และตั้งเวลารับข้อมูลเป็นรอบ ๆ ได้
- IP Rotation & Anti-Bot: รับมือเว็บที่พยายามบล็อกสแครปเปอร์ พร้อมระบบพร็อกซีและ captcha ในตัว
- คลังเทมเพลต: มีเทมเพลตพร้อมใช้กว่า 500 แบบสำหรับเว็บยอดนิยม
- ดึงข้อมูลแบบหลายชั้นและหลายหน้า: รับมือการนำทางที่ซับซ้อนและการดึงข้อมูลจากหน้ารายละเอียดได้ดี
ข้อดี: เหมาะมากสำหรับการติดตามราคาในสเกลใหญ่ วิเคราะห์รีวิว และเฝ้าดูอีคอมเมิร์ซ ไม่ต้องเขียนโค้ดสำหรับงานส่วนใหญ่
ข้อเสีย: ใช้ได้เฉพาะเดสก์ท็อป อาจค่อนข้างแพงสำหรับผู้ใช้หนัก ๆ และงานขั้นสูงมีเส้นโค้งการเรียนรู้พอสมควร
เหมาะกับ: นักวิเคราะห์อีคอมเมิร์ซ นักวิจัยตลาด และใครก็ตามที่ต้องติดตามสินค้าหรือคู่แข่งจำนวนมาก
3. ParseHub
 ParseHub เป็นเครื่องมือดึงข้อมูลแบบภาพที่ยืดหยุ่น และทำงานได้ดีมากกับเว็บไซต์ไดนามิกที่ใช้ JavaScript หนัก ๆ เป็นแอปเดสก์ท็อป (Windows, Mac, Linux) ที่มีตัวสร้างเวิร์กโฟลว์ซึ่งรองรับ logic แบบมีเงื่อนไข, custom JS และการเข้าถึง API
ฟีเจอร์เด่น:
- รับมือคอนเทนต์ไดนามิก: ใช้งานได้กับ single-page app, AJAX และเว็บอินเทอร์แอคทีฟ
- เวิร์กโฟลว์และการเขียนสคริปต์: สร้างฟลว์หลายขั้นตอน แทรก custom JS และใช้ regex เพื่อปรับแต่งละเอียด
- รันได้ทั้งบนคลาวด์และเครื่องตัวเอง: รันงานบนเครื่องหรือบนคลาวด์ (แบบเสียเงิน)
- API Access: เชื่อมการดึงข้อมูลเข้ากับแอปของคุณ หรือทำอัตโนมัติผ่าน webhook ได้
ข้อดี: ปรับแต่งได้สูงสำหรับผู้ใช้ที่มีพื้นฐานเทคนิค รับมือเว็บยาก ๆ ได้ และรองรับ logic ที่ซับซ้อน
ข้อเสีย: ช้าสำหรับงานใหญ่ เส้นโค้งการเรียนรู้ปานกลาง และการรันบนคลาวด์มีค่าใช้จ่ายเพิ่ม
เหมาะกับ: นักวิเคราะห์สายเทคนิค นักพัฒนา หรือใครก็ตามที่ต้องดึงข้อมูลจากเว็บที่มีความอินเทอร์แอคทีฟสูง
4. Import.io
 Import.io โฟกัสไปที่การเชื่อมข้อมูลเว็บเข้ากับเวิร์กโฟลว์ด้าน business intelligence ของคุณ เป็นแพลตฟอร์มบนเว็บที่ใช้งานแบบคลิกเลือก พร้อมความสามารถด้านการตั้งเวลาและ API ที่แข็งแรง
ฟีเจอร์เด่น:
- ตรวจจับตารางอัตโนมัติ: วาง URL แล้ว Import.io จะพยายามดึงข้อมูลที่เป็นโครงสร้างให้อัตโนมัติ
- ตั้งเวลาและตรวจจับการเปลี่ยนแปลง: ตั้งงานให้รันตามเวลา และรับแจ้งเตือนเมื่อข้อมูลเปลี่ยน
- การเชื่อมต่อผ่าน API: ดึงข้อมูลด้วยโปรแกรมหรือส่งต่อเข้าเครื่องมือ BI ของคุณ
- แปลงข้อมูล: ทำความสะอาดและจัดรูปแบบข้อมูลภายในแพลตฟอร์มได้
ข้อดี: ใช้งานง่าย เหมาะกับนักวิเคราะห์ธุรกิจ และเชื่อมต่อกับเครื่องมือ analytics ได้ดี
ข้อเสีย: ราคาสำหรับองค์กร อาจจำกัดกับเว็บที่โต้ตอบสูงมาก และให้การควบคุมสำหรับผู้ใช้ขั้นสูงน้อยกว่า
เหมาะกับ: ทีมวิจัยตลาด นักวิเคราะห์ธุรกิจ และทีมปฏิบัติการที่ต้องการฟีดข้อมูลต่อเนื่อง
5. Scrapy
 Scrapy คือเฟรมเวิร์ก Python แบบโอเพนซอร์สที่นักพัฒนาหลายคนชื่นชอบ ถ้าคุณต้องการการควบคุมเต็มรูปแบบ ขยายสเกลได้ และสร้าง crawler แบบกำหนดเอง Scrapy คือเพื่อนแท้ของคุณ
ฟีเจอร์เด่น:
- การ crawl แบบอะซิงโครนัส: เร็ว มีประสิทธิภาพ และสร้างมาสำหรับโปรเจกต์ขนาดใหญ่
- ควบคุมด้วยโค้ดเต็มรูปแบบ: เขียน spider ด้วย Python ปรับแต่งทุกขั้นตอน และเชื่อมกับระบบใดก็ได้
- Middleware & Plugins: หมุนพร็อกซี จัดการการล็อกอิน และต่อยอดด้วยปลั๊กอินจากคอมมูนิตี้
- ผลลัพธ์แบบมีโครงสร้าง: ส่งออกเป็น JSON, CSV, ฐานข้อมูล หรือฟอร์แมตเฉพาะทาง
ข้อดี: ฟรี ยืดหยุ่นสูง และมีคอมมูนิตี้ใหญ่คอยซัพพอร์ต
ข้อเสีย: ต้องมีทักษะ Python ไม่มี GUI และคุณต้องดูแลเรื่องการบำรุงรักษาเอง
เหมาะกับ: นักพัฒนา วิศวกรข้อมูล และใครก็ตามที่ต้องการฝังการดึงข้อมูลเข้าไปในแอปหรือ data pipeline ของตัวเอง
6. Apify
 Apify เป็นแพลตฟอร์มคลาวด์สำหรับรันและแชร์สคริปต์ดึงข้อมูล (“Actors”) ด้วย JavaScript หรือ Python ถูกสร้างมาเพื่อ automation การต่อเวิร์กโฟลว์ และการขยายสเกลบนคลาวด์
ฟีเจอร์เด่น:
- Actors & SDK: เขียนสคริปต์เอง หรือใช้ actors สำเร็จรูปจาก Apify Store
- Headless Browser Automation: ดึงข้อมูลจากเว็บไดนามิก จัดการล็อกอิน และทำงานเว็บอัตโนมัติ
- Workflow Chaining: สั่งให้ actor หนึ่งเรียกอีกตัวต่อ ๆ กัน ทำให้หลายขั้นตอนเป็นอัตโนมัติ
- API & Integrations: เชื่อมกับ Zapier, Make, Google Drive, AWS และอื่น ๆ
ข้อดี: ทรงพลังสำหรับนักพัฒนา ขยายสเกลได้ดี และเหมาะกับการทำเวิร์กโฟลว์ซับซ้อนให้เป็นอัตโนมัติ
ข้อเสีย: งานที่ต้องปรับแต่งเองต้องเขียนโค้ด การคิดราคาตามการใช้งานอาจบานปลาย และต้องใช้เวลาทำความเข้าใจพอสมควร
เหมาะกับ: สตาร์ตอัป ทีม dev และใครก็ตามที่ต้องการการดึงข้อมูลบนคลาวด์แบบอัตโนมัติในสเกลใหญ่
7. Dexi.io
 Dexi.io (เดิมชื่อ CloudScrape) เป็นแพลตฟอร์มระดับองค์กรสำหรับการทำให้การเก็บและเชื่อมข้อมูลเป็นอัตโนมัติ โดยเน้นการสร้างเวิร์กโฟลว์แบบ end-to-end ตั้งแต่การดึงข้อมูลไปจนถึงการแปลงและส่งมอบข้อมูล
ฟีเจอร์เด่น:
- Visual Robot Designer: สร้างเวิร์กโฟลว์หลายขั้นตอนด้วย logic แบบคลิกเลือก
- รันบนคลาวด์และตั้งเวลา: รัน robots บนคลาวด์ ตั้งงานเป็นรอบ และรองรับปริมาณงานมหาศาล
- ประมวลผลและเชื่อมต่อข้อมูล: ทำความสะอาด แปลง และส่งออกข้อมูลไปยัง CRM, ฐานข้อมูล หรือ API
- ฟีเจอร์ระดับองค์กร: การจัดการผู้ใช้ การปฏิบัติตามข้อกำหนด และตัวเลือก on-premise
ข้อดี: ขยายสเกลได้ แข็งแรงสำหรับเวิร์กโฟลว์ซับซ้อน และเชื่อมต่อกับระบบอื่นได้ดี
ข้อเสีย: ราคาสำหรับองค์กร ไม่เหมาะกับมือใหม่ และต้องมีการฝึกอบรมสำหรับการใช้งานขั้นสูง
เหมาะกับ: องค์กรขนาดใหญ่ ทีม retail intelligence และใครก็ตามที่ต้องการทำ data pipeline หลายขั้นตอนให้เป็นอัตโนมัติ
8. WebHarvy
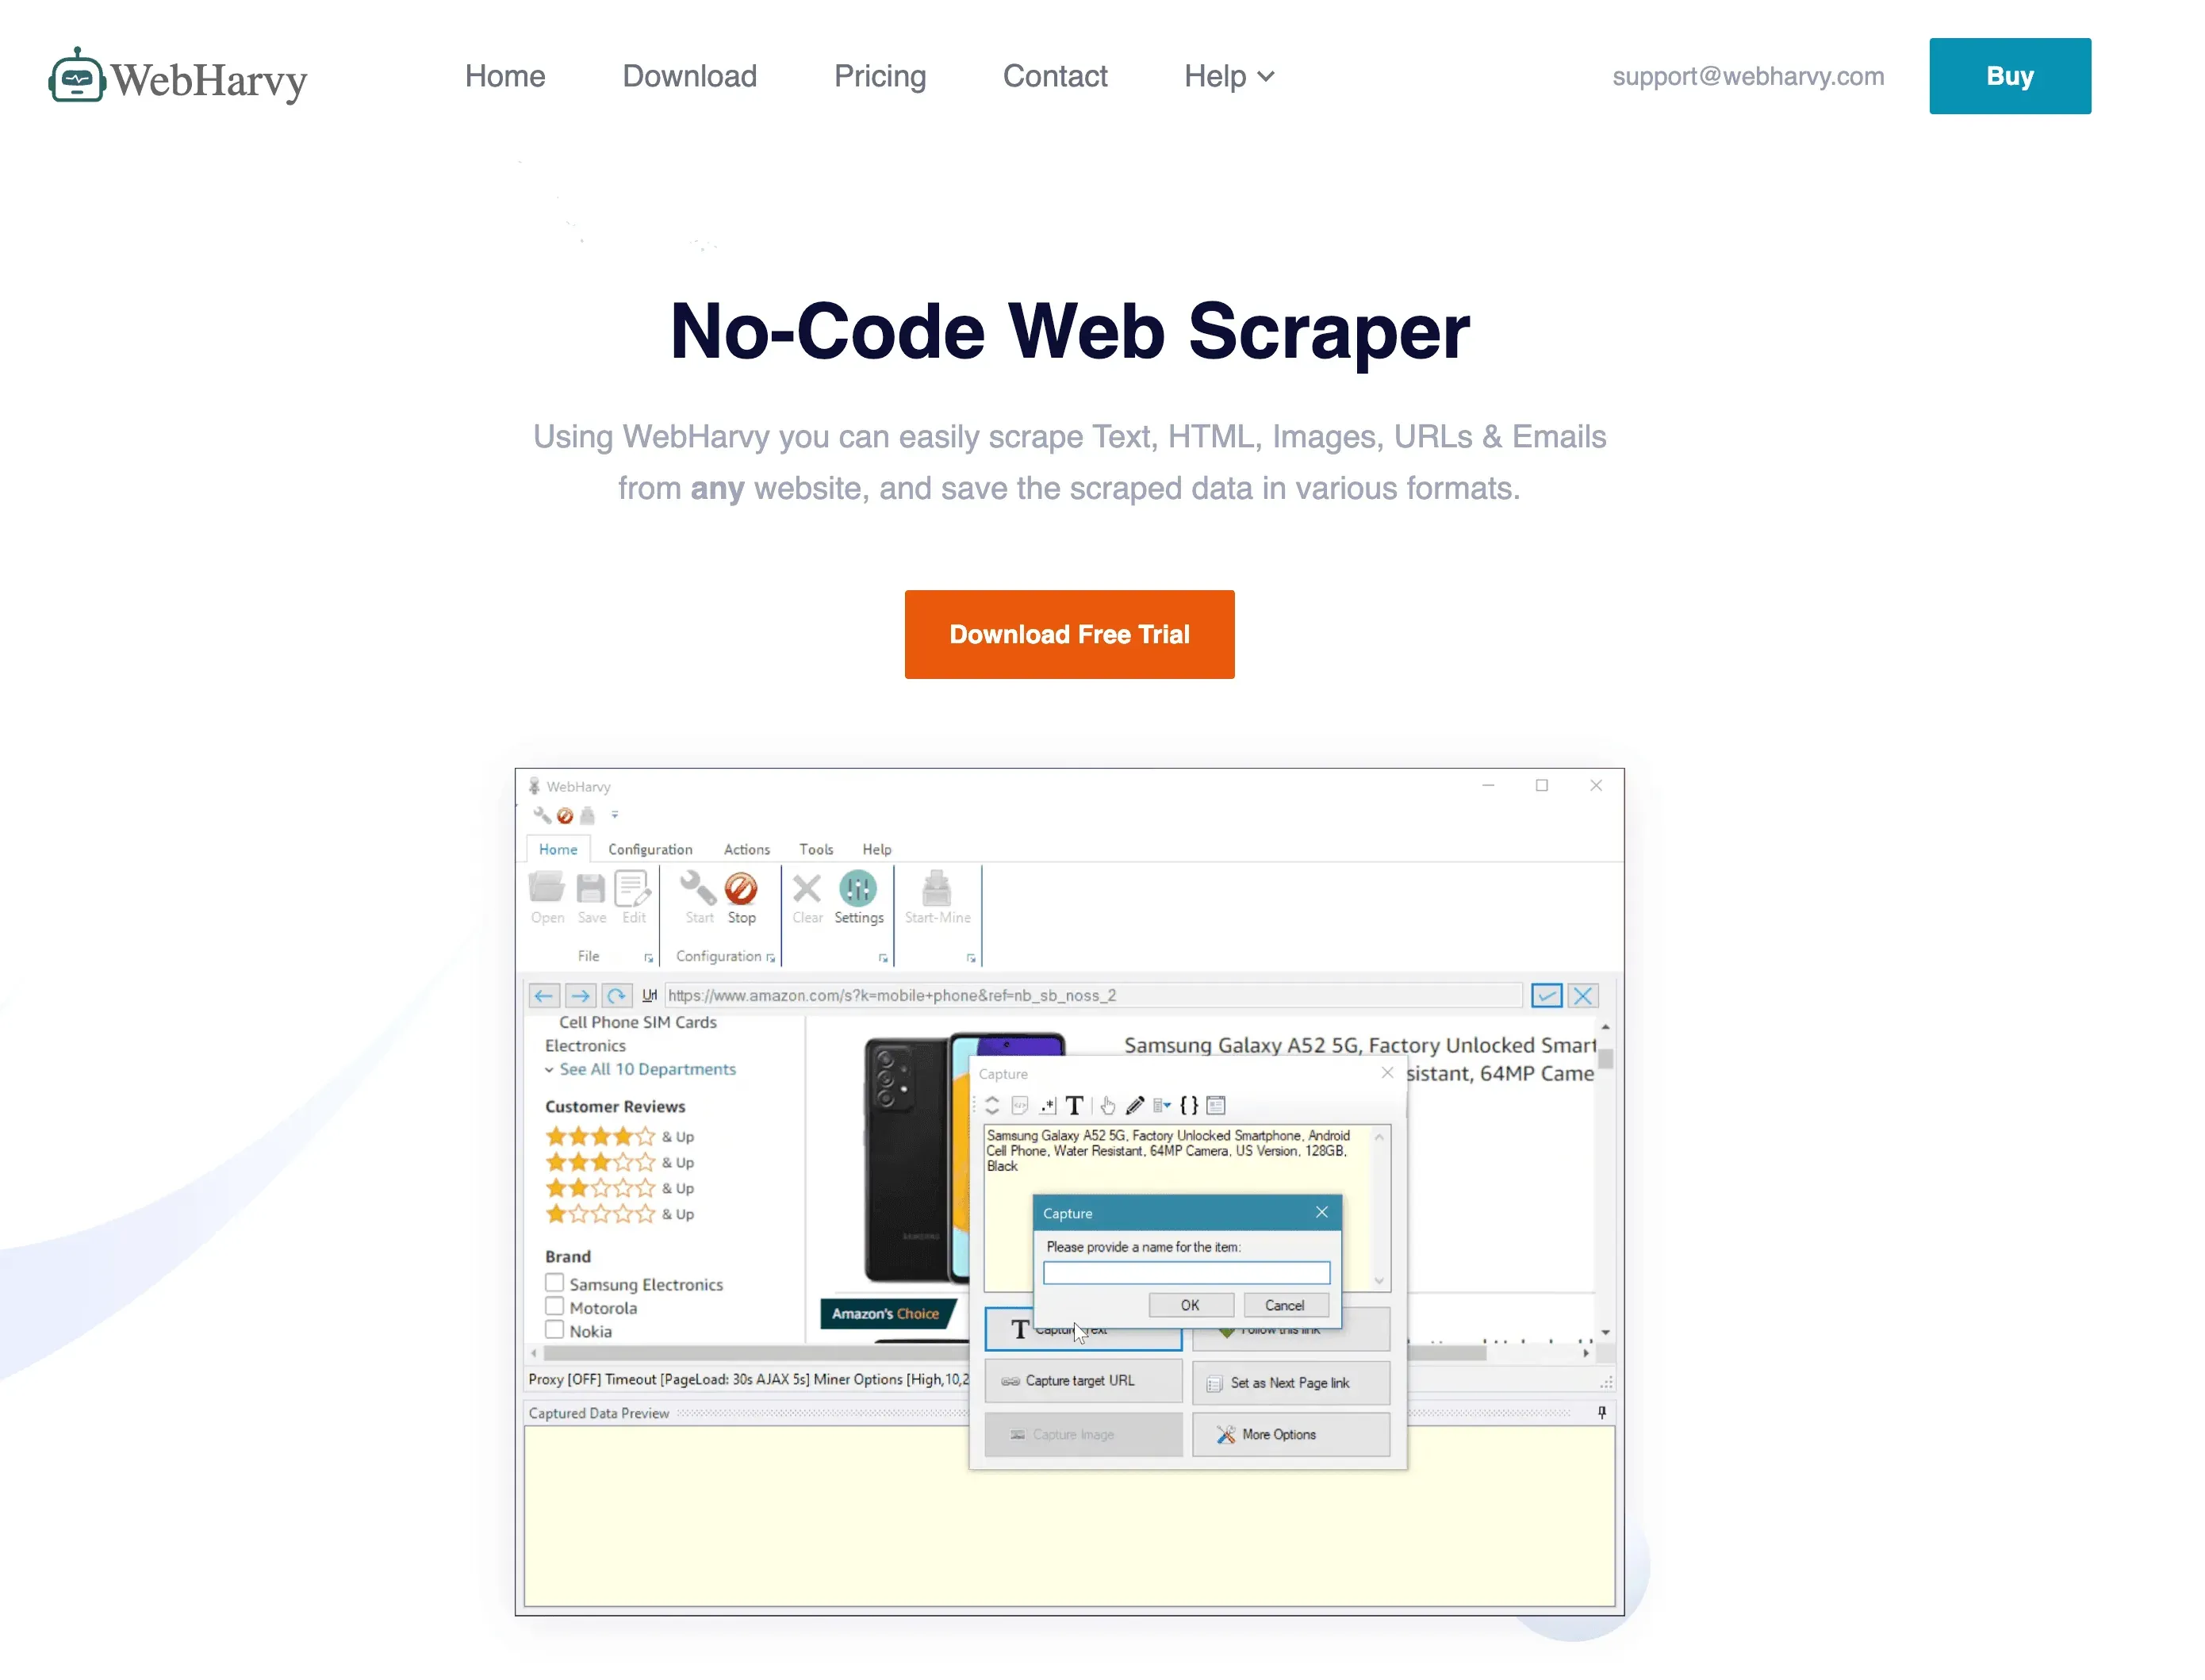 WebHarvy เป็นเครื่องมือดึงข้อมูลบน Windows ที่ขึ้นชื่อเรื่องความง่ายแบบคลิกแล้วจบ และรูปแบบไลเซนส์จ่ายครั้งเดียว
ฟีเจอร์เด่น:
- การเลือกแบบภาพ: คลิกองค์ประกอบในเบราว์เซอร์ในตัวเพื่อกำหนดฟิลด์
- ตรวจจับแพตเทิร์นอัตโนมัติ: หา list และตารางได้เอง
- ดาวน์โหลดรูปภาพและไฟล์: ดึงได้ทั้งรูป เอกสาร และข้อความ
- ตั้งเวลา: ทำงานอัตโนมัติผ่าน Windows Task Scheduler
ข้อดี: ราคาคุ้มแบบจ่ายครั้งเดียว ใช้งานง่ายกับเว็บไซต์ที่ไม่ซับซ้อน และทำงานแบบออฟไลน์ได้
ข้อเสีย: มีปัญหากับ JavaScript หนัก ๆ หรือเว็บที่กันบอท ใช้ได้เฉพาะ Windows และการปรับแต่งขั้นสูงมีจำกัด
เหมาะกับ: ธุรกิจขนาดเล็ก นักวิจัย และใครก็ตามที่ต้องการเครื่องมือดึงข้อมูลราคาประหยัดสำหรับเว็บแบบคงที่
9. Data Miner
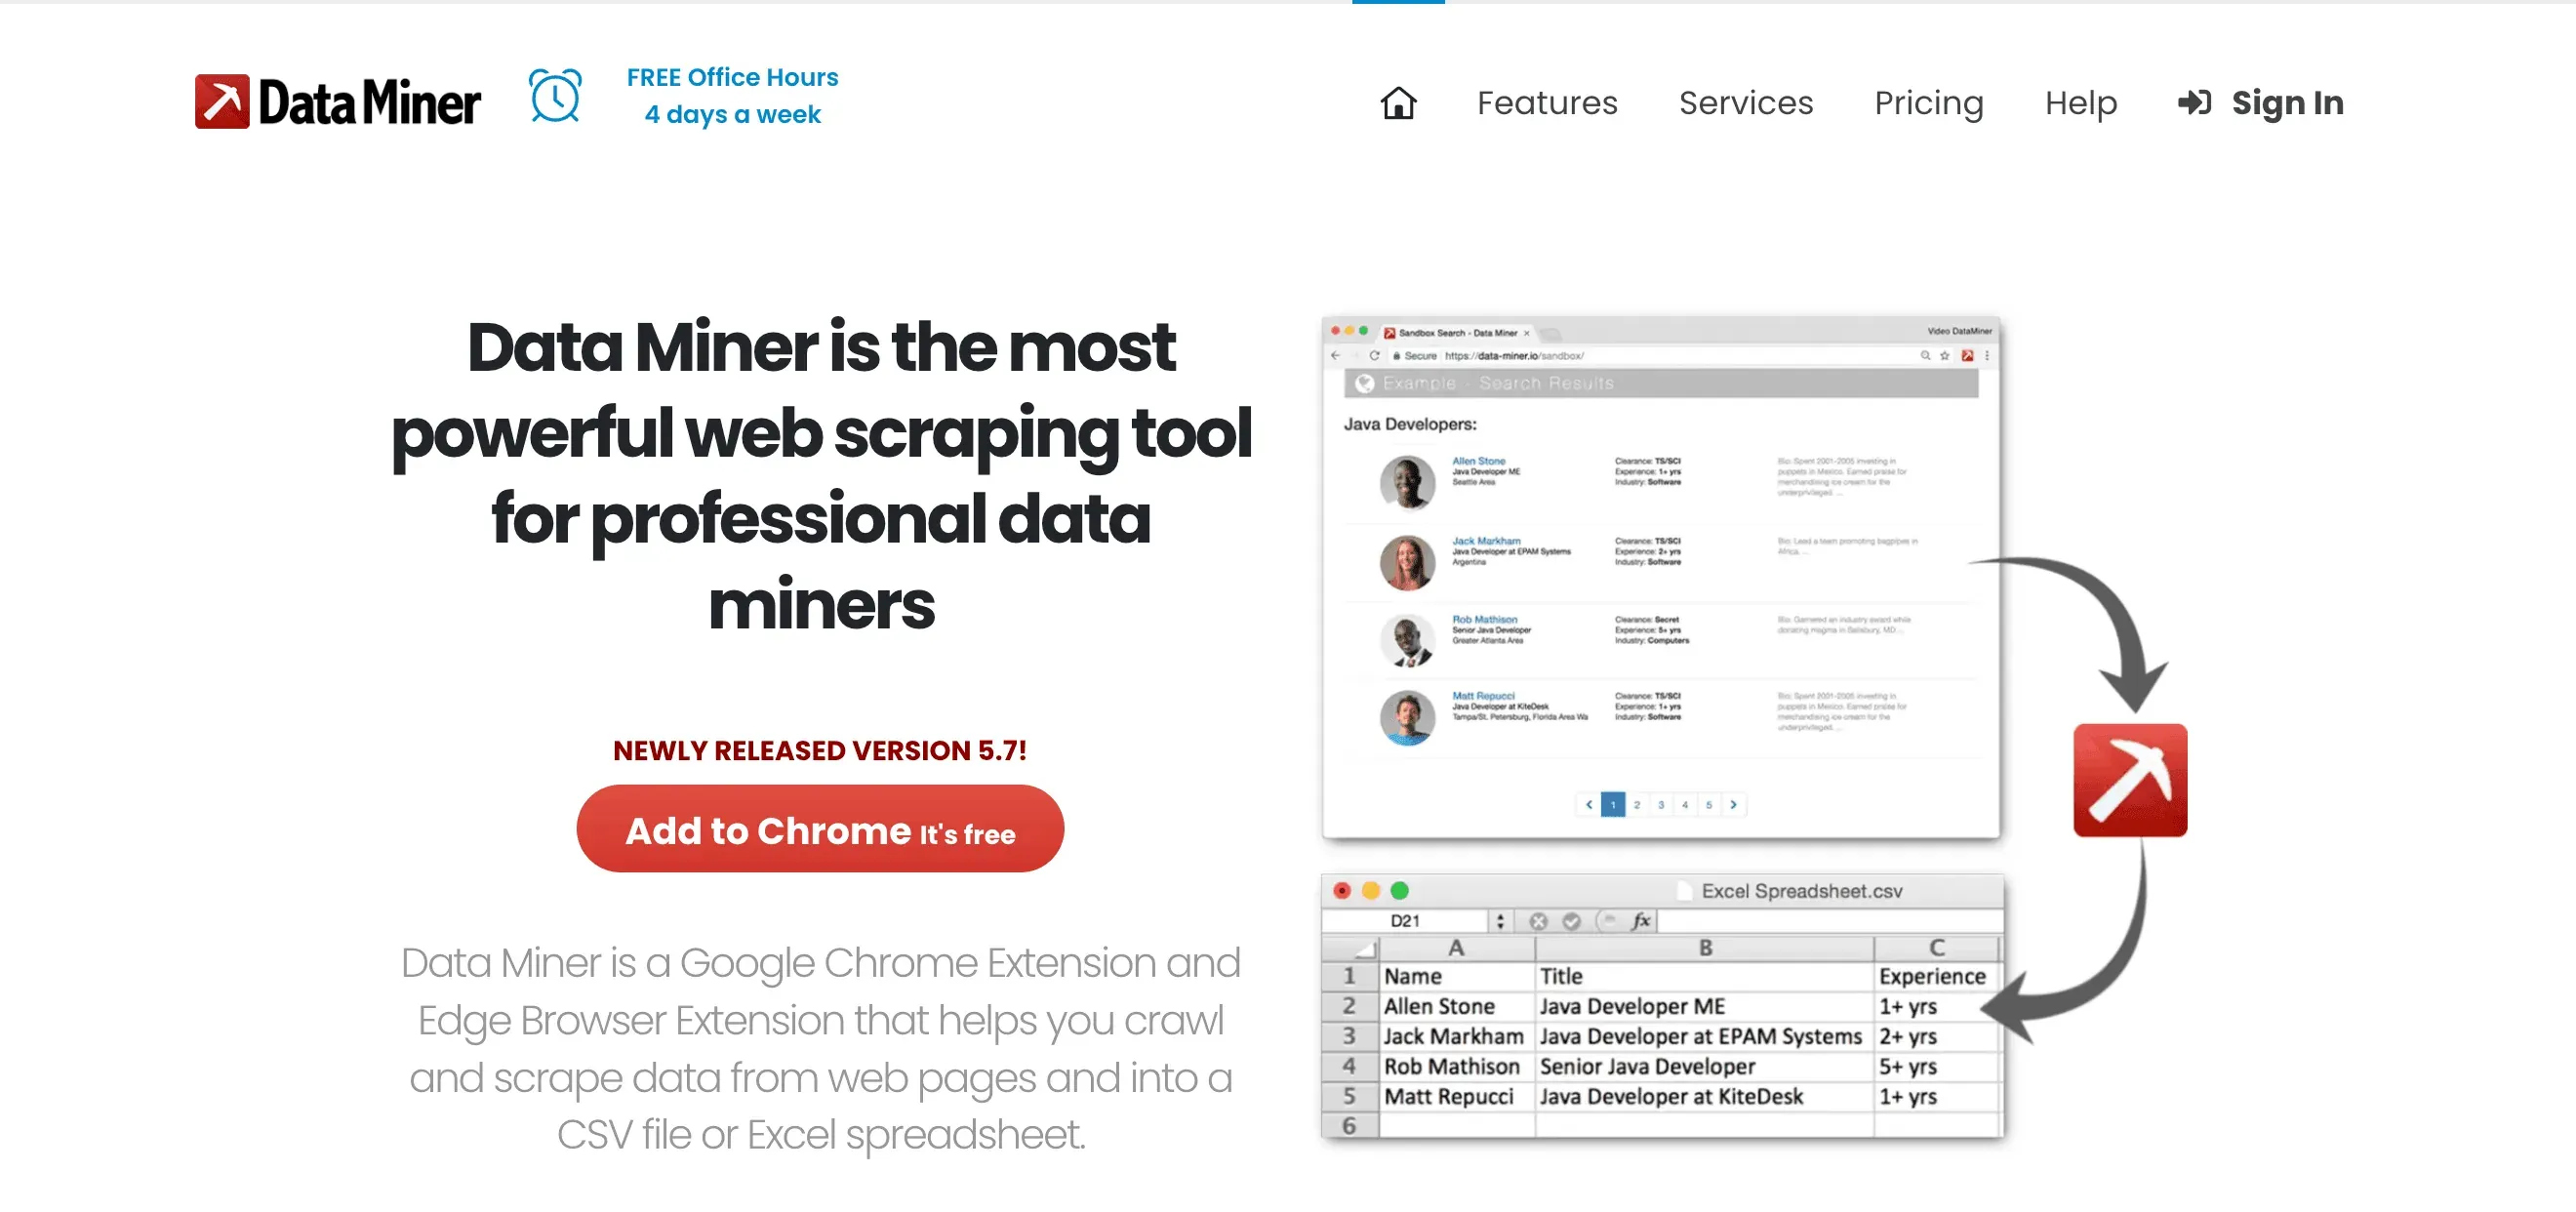 Data Miner เป็นส่วนขยาย Chrome/Edge ที่เหมาะมากสำหรับการดึงข้อมูลจากเว็บแบบรวดเร็วด้วยเทมเพลต โดยเฉพาะสำหรับทีมขายและทีมปฏิบัติการ
ฟีเจอร์เด่น:
- สูตรสำเร็จสาธารณะกว่า 50,000 แบบ: ดึงข้อมูลเว็บยอดนิยมได้ในคลิกเดียว
- ตัวสร้างสูตรแบบคลิกเลือก: สร้างกฎการดึงข้อมูลของคุณเอง
- ดึงตารางทันที: เอาตาราง HTML หรือรายการออกมาได้ในไม่กี่วินาที
- ส่งออกตรง: ส่งข้อมูลไปยัง Google Sheets, Excel หรือ CSV
ข้อดี: เร็ว ใช้งานผ่านเบราว์เซอร์ ไม่ต้องเขียนโค้ด และเหมาะมากกับเว็บที่ต้องล็อกอิน
ข้อเสีย: ถูกจำกัดด้วยความเร็วของเบราว์เซอร์ มีข้อจำกัดจำนวนหน้าตามแผนฟรี/เสียเงิน และไม่เหมาะกับงานขนาดใหญ่มาก
เหมาะกับ: งานหาลีด การค้นคว้าแบบรวดเร็ว และใครก็ตามที่อยากได้ปุ่ม “Export to Excel” สำหรับเว็บ
10. Helium Scraper
 Helium Scraper เป็นแอป Windows ที่ผสมความง่ายแบบลากแล้ววางเข้ากับการปรับแต่งเชิงลึก
ฟีเจอร์เด่น:
- โมเดล Kinds และ Actions: กำหนดแพตเทิร์นของข้อมูลแบบภาพ แล้วตั้งค่าการกระทำสำหรับการดึงข้อมูล
- ข้อมูลหลายระดับและเชิงสัมพันธ์: ส่งออกความสัมพันธ์แบบ parent-child และรัน SQL กับข้อมูลที่สแครปมาได้
- การเขียนสคริปต์แบบกำหนดเอง: แทรก JavaScript หรือ SQL สำหรับ logic ขั้นสูง
- Multi-threading: ดึงข้อมูลหลายหน้าแบบขนานเพื่อความเร็ว
ข้อดี: ยืดหยุ่น รองรับโครงสร้างข้อมูลซับซ้อน และราคาจ่ายครั้งเดียวค่อนข้างคุ้ม
ข้อเสีย: แนวคิด “Kinds” ต้องใช้เวลาเรียนรู้ ใช้ได้เฉพาะ Windows และการซัพพอร์ตยังไม่แพร่หลายเท่าเครื่องมือกระแสหลัก
เหมาะกับ: นักวิเคราะห์และคนสายเทคที่อยากได้พลังมากกว่าเครื่องมือคลิกเลือกพื้นฐาน แต่ยังไม่พร้อมเขียนโค้ดจากศูนย์
เครื่องมือดึงข้อมูลตัวไหนเหมาะกับคุณ? ใช้กรณีไหนถึงจะคุ้ม
- สร้างลีดสำหรับงานขาย: Thunderbit (ขับเคลื่อนด้วย AI ส่งออกง่าย), Data Miner (ผ่านเบราว์เซอร์ สูตรสำเร็จรวดเร็ว)
- ติดตามอีคอมเมิร์ซ: Octoparse (เทมเพลตและตั้งเวลา), Dexi.io (ระดับองค์กร เชื่อมระบบได้ดี)
- ปรับแต่งเชิงเทคนิค: Scrapy (Python, โอเพนซอร์ส), Apify (คลาวด์, อัตโนมัติเวิร์กโฟลว์), ParseHub (แบบภาพ, เว็บไดนามิก)
- เชื่อมข้อมูลและทำงานอัตโนมัติ: Import.io (เวิร์กโฟลว์ BI)
- งานเล็ก ๆ ที่ต้องการความเร็ว: WebHarvy (คลิกแล้วจบ จ่ายครั้งเดียว), Helium Scraper (ลากแล้ววาง, logic เฉพาะทาง)
ทิปสำคัญ: เครื่องมือส่วนใหญ่มีทดลองใช้ฟรีหรือแผนใช้ฟรี—ลองกับโจทย์ข้อมูลจริงของคุณสัก 2-3 ตัวก่อนตัดสินใจ
Data Scraping คืออะไร และทำอย่างไรในปี 2025 Get Started Free
สรุป: ปลดล็อกประสิทธิภาพสูงสุดด้วยเครื่องมือดึงข้อมูลที่ใช่
ยุคของการจัดการข้อมูลด้วยมือกำลังจะหมดไป ด้วยเครื่องมือดึงข้อมูลที่เหมาะสม คุณสามารถทำให้งานหนักที่ซ้ำซากหลายชั่วโมงกลายเป็นอัตโนมัติ เพิ่มความแม่นยำ และตัดสินใจได้ดีขึ้น—ไม่ว่าคุณจะเป็นผู้ก่อตั้งเดี่ยว ทีมขาย หรือผู้จัดการปฏิบัติการในบริษัทระดับ Fortune 500 สิ่งสำคัญคือเลือกเครื่องมือให้ตรงกับเคสการใช้งาน ระดับความถนัดด้านเทคนิค และงบประมาณ
ถ้าคุณกำลังมองหาทางลัดจาก “ฉันต้องการข้อมูลนี้” ไปเป็น “มันอยู่ในสเปรดชีตแล้ว” Thunderbit คือจุดเริ่มต้นที่ยอดเยี่ยม แต่ไม่ว่าความต้องการของคุณจะเป็นแบบไหน ก็มีเครื่องมือในลิสต์นี้ที่ช่วยให้คุณทำงานอย่างชาญฉลาดขึ้น ไม่ใช่หนักขึ้น
พร้อมยกระดับเกมข้อมูลของคุณแล้วหรือยัง? ลองใช้เครื่องมือเหล่านี้สักสองสามตัว แล้วคุณจะเห็นว่าคุณประหยัดเวลาได้มากแค่ไหน—และสบายใจขึ้นแค่ไหนด้วย
ติดตั้ง Thunderbit Chrome Extension
คำถามที่พบบ่อย
1. เครื่องมือดึงข้อมูลคืออะไร และทำไมฉันถึงควรใช้?
เครื่องมือดึงข้อมูลคือเครื่องมือที่ช่วยเก็บข้อมูลแบบมีโครงสร้างจากเว็บไซต์ เอกสาร หรือฐานข้อมูลโดยอัตโนมัติ มันช่วยประหยัดเวลา ลดข้อผิดพลาด และทำให้คุณไปโฟกัสกับการวิเคราะห์แทนการคัดลอกวางด้วยมือ
2. เครื่องมือดึงข้อมูลตัวไหนเหมาะกับผู้ใช้ที่ไม่ใช่สายเทคนิคที่สุด?
Thunderbit เด่นด้วยการตั้งค่า 2 คลิกที่ขับเคลื่อนด้วย AI และพรอมต์ภาษาธรรมชาติ ออกแบบมาสำหรับผู้ใช้สายธุรกิจที่อยากได้ผลลัพธ์โดยไม่ต้องเขียนโค้ดหรือเสียเวลาตั้งค่าซับซ้อน
3. เครื่องมือดึงข้อมูลรับมือเว็บไซต์ไดนามิกหรือเว็บที่ใช้ JavaScript หนัก ๆ ได้ไหม?
ได้—เครื่องมืออย่าง ParseHub, Apify, และ Scrapy (เมื่อใช้ร่วมกับ headless browser) ทำงานได้ดีมากกับคอนเทนต์ไดนามิกและเว็บอินเทอร์แอคทีฟ
4. จะเลือกใช้เครื่องมือดึงข้อมูลแบบฟรีหรือแบบเสียเงินอย่างไร?
เครื่องมือฟรีเหมาะกับงานเล็ก ๆ เป็นครั้งคราว แต่ถ้าเป็นงานต่อเนื่อง งานขนาดใหญ่ หรือภารกิจสำคัญต่อธุรกิจ แผนเสียเงินมักให้ฟีเจอร์มากกว่า จำกัดน้อยกว่า และซัพพอร์ตดีกว่า ควรเริ่มจากทดลองใช้ฟรีเพื่อเช็กความเหมาะสมก่อน
5. การใช้เครื่องมือดึงข้อมูลถูกกฎหมายหรือไม่?
โดยทั่วไป การดึงข้อมูลที่เปิดเผยต่อสาธารณะทำได้ตามกฎหมาย แต่ควรตรวจสอบเงื่อนไขการใช้งานของเว็บไซต์และเคารพกฎหมายความเป็นส่วนตัวเสมอ สำหรับข้อมูลอ่อนไหวหรือข้อมูลส่วนบุคคล ต้องมั่นใจว่าปฏิบัติตามข้อกำหนดอย่าง GDPR
อยากได้เคล็ดลับเพิ่มเติมเกี่ยวกับเว็บสแครปปิง ระบบอัตโนมัติ และการทำงานให้มีประสิทธิภาพมากขึ้นไหม? แวะดู Thunderbit Blog สำหรับบทความเชิงลึก คู่มือสอนใช้ และอัปเดตล่าสุดด้านการดึงข้อมูลด้วย AI
อ่านเพิ่มเติม
- How to Scrape Data from PDF using AI
- How to Extract Data from a Website: A Beginner-Friendly Guide
- How to Extract Data from a Web Page Using Thunderbit
- Top 12 Free Data Scraper Tools in 2025
ลองใช้ AI Web Scraper Get Started Free




