
ตอนนี้เว็บไม่ได้เป็นแค่สนามเด็กเล่นบนโลกดิจิทัลอีกต่อไป—แต่มันคือคลังข้อมูลขนาดใหญ่ที่สุดของโลก และทุกคนตั้งแต่ทีมขายไปจนถึงนักวิเคราะห์ตลาดต่างก็เร่งพยายามดึงประโยชน์จากข้อมูลเหล่านี้ แต่เอาเข้าจริง การเก็บข้อมูลจากเว็บด้วยมือก็ไม่ต่างจากการประกอบเฟอร์นิเจอร์ IKEA แบบไม่มีคู่มือ แถมยังมีน็อตเหลือเยอะกว่าเดิมอีกด้วย เมื่อธุรกิจต้องพึ่งพาข้อมูลเชิงลึกแบบเรียลไทม์ ราคาคู่แข่ง และการหาลูกค้าใหม่มากขึ้น ความต้องการเครื่องมือดึงข้อมูลจากเว็บที่ทั้งมีประสิทธิภาพและเชื่อถือได้ก็ยิ่งสูงขึ้นอย่างไม่เคยเป็นมาก่อน ที่จริงแล้ว เกือบ 85% ขององค์กรในปัจจุบันพึ่งพาการดึงข้อมูลจากเว็บ เพื่อใช้ประกอบการตัดสินใจ และตลาด web scraping ทั่วโลกกำลังมุ่งหน้าไปสู่การ เติบโตเป็นสองเท่าภายในปี 2030
ดึงข้อมูลจากทุกเว็บไซต์ด้วย AI Get Started Free
ถ้าคุณเบื่อการก็อปปี้วางทีละบรรทัด พลาดโอกาสจากลีดใหม่ ๆ หรือแค่อยากเห็นว่าออโตเมชันจะช่วยลดงานหนักได้แค่ไหน คุณมาถูกที่แล้ว ผมใช้เวลาหลายปีในการสร้างและทดสอบเครื่องมือดึงข้อมูลจากเว็บ (และใช่ ผมยังเป็นผู้นำทีมที่ Thunderbit ด้วย) จึงรู้ดีว่าการเลือกเครื่องมือที่ใช่สามารถเปลี่ยนงานหนักหลายชั่วโมงให้กลายเป็นเรื่องง่ายในคลิกเดียวได้อย่างไร ไม่ว่าคุณจะเป็นคนไม่เขียนโค้ดที่อยากได้ผลลัพธ์ทันที หรือเป็นนักพัฒนาที่ต้องการควบคุมทุกอย่างได้เอง รายชื่อ 10 เครื่องมือดึงข้อมูลจากเว็บที่ดีที่สุดนี้จะช่วยให้คุณหาเครื่องมือที่เหมาะกับคุณได้แน่นอน
ทำไมการเลือกเครื่องมือดึงข้อมูลจากเว็บที่ใช่จึงสำคัญ
มาพูดกันแบบตรงไปตรงมา: ความต่างระหว่างเครื่องมือดึงข้อมูลจากเว็บที่ดี กับเครื่องมือที่พอใช้ได้ ไม่ได้มีแค่เรื่องความสะดวกสบายเท่านั้น แต่มันส่งผลต่อการเติบโตของธุรกิจโดยตรง เมื่อคุณทำเว็บสแครปปิ้งแบบอัตโนมัติ คุณไม่ได้แค่ประหยัดเวลาเท่านั้น (แม้จะมีผู้ใช้ G2 รายหนึ่งบอกว่าเขา ประหยัดได้ “น่าจะสัปดาห์ละ 10 ชั่วโมง”) แต่ยังช่วยลดข้อผิดพลาด เปิดโอกาสทางธุรกิจใหม่ ๆ และทำให้ทีมของคุณทำงานกับข้อมูลที่สดใหม่และแม่นยำที่สุดเสมอ การค้นหาข้อมูลด้วยมือทั้งช้า มีโอกาสพลาดสูง และมักจะล้าสมัยก่อนงานจะเสร็จ แต่ถ้าใช้เครื่องมือที่ใช่ คุณสามารถติดตามคู่แข่ง เช็กราคา หรือสร้างรายชื่อลีดได้ภายในไม่กี่นาที ไม่ใช่หลายวัน
ตัวอย่างที่เห็นชัด: ผู้ค้าปลีกด้านความงามรายหนึ่งใช้เว็บสแครปปิ้งเพื่อติดตามสต็อกและราคาของคู่แข่ง จน เพิ่มความแม่นยำของการคาดการณ์เป็น 85% และทำรายได้เพิ่มขึ้นสองเท่าในสี่เดือน นี่คือผลลัพธ์แบบที่ทำเองด้วยสเปรดชีตและแรงคนอย่างเดียวแทบเป็นไปไม่ได้
เราใช้เกณฑ์อะไรในการประเมินเครื่องมือดึงข้อมูลจากเว็บที่ดีที่สุด
ด้วยตัวเลือกที่มีอยู่มากมาย การเลือกเครื่องมือดึงข้อมูลจากเว็บที่เหมาะกับคุณอาจให้ความรู้สึกเหมือนเดทสปีดเดทในงานสายเทคโนโลยี นี่คือเกณฑ์ที่ผมใช้คัดเลือกตัวที่ดีที่สุดออกจากตัวเลือกอื่น ๆ:
- ใช้งานง่ายแค่ไหน: เริ่มใช้ได้เลยโดยไม่ต้องจบปริญญาเอก Python ไหม มีอินเทอร์เฟซแบบภาพหรือ AI ช่วยสำหรับคนไม่เขียนโค้ดหรือเปล่า?
- ความสามารถด้านอัตโนมัติ: รองรับ pagination, subpage, เนื้อหาแบบไดนามิก และการตั้งเวลาหรือไม่? รันบนคลาวด์สำหรับงานใหญ่ได้ไหม?
- ราคาและการขยายตัว: มีแพ็กเกจฟรีหรือแพ็กเกจเริ่มต้นที่เข้าถึงได้ไหม? ต้นทุนจะเพิ่มขึ้นอย่างไรเมื่อความต้องการข้อมูลโตขึ้น?
- ฟีเจอร์และการเชื่อมต่อ: ส่งออกไป Excel, Google Sheets หรือผ่าน API ได้ไหม? มีเทมเพลต การตั้งเวลา หรือฟีเจอร์ทำความสะอาดข้อมูลในตัวหรือเปล่า?
- เหมาะกับใคร: เครื่องมือนี้ออกแบบมาสำหรับผู้ใช้ธุรกิจ นักพัฒนา หรือทีมองค์กรกันแน่?
ท้ายบทความผมมีตารางเปรียบเทียบสรุปให้ดูด้วย เพื่อให้คุณเห็นภาพว่าแต่ละเครื่องมือเด่นต่างกันอย่างไร
เอาล่ะ มาดู 10 เครื่องมือดึงข้อมูลจากเว็บที่ดีที่สุดสำหรับการเก็บข้อมูลจากเว็บอย่างมีประสิทธิภาพในปี 2026 กันเลย
1. Thunderbit
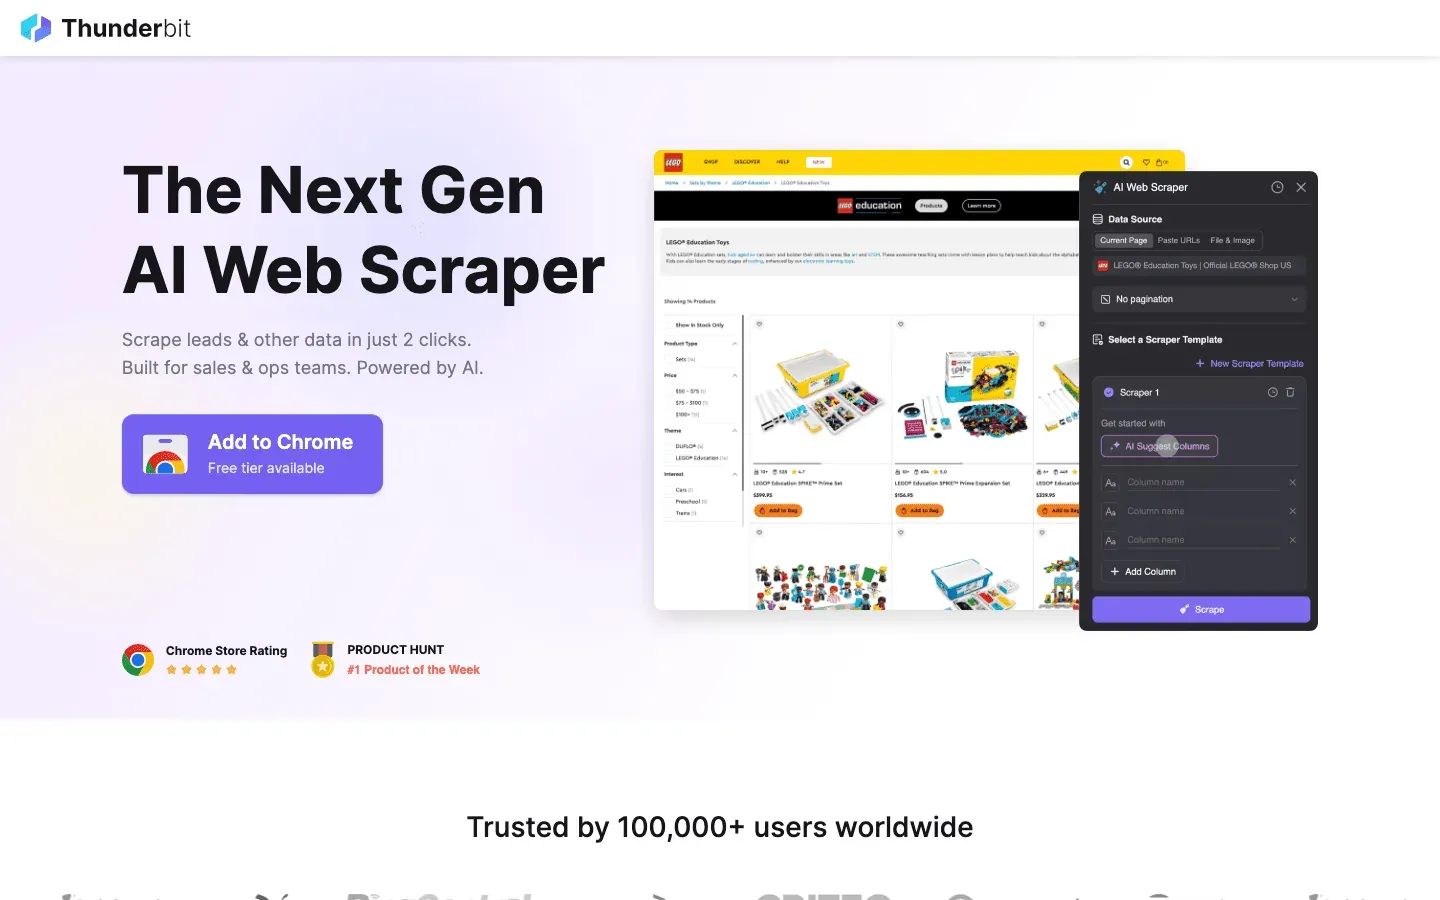 Thunderbit คือเครื่องมือที่ผมแนะนำเป็นอันดับแรกสำหรับใครก็ตามที่อยากให้การดึงข้อมูลจากเว็บง่ายพอ ๆ กับการสั่งอาหารเดลิเวอรี Thunderbit เป็นส่วนขยาย Chrome ที่ขับเคลื่อนด้วย AI และเน้นการ สแครปในคลิกเดียว: กดครั้งเดียวแล้ว AI จะจัดการให้เอง มันรู้ว่าข้อมูลส่วนไหนของหน้าเว็บควรไปอยู่ในตาราง และส่วนไหนเป็นแค่ของตกแต่งหน้าเว็บ จากนั้นก็เติมข้อมูลลงตารางให้คุณขณะคุณไปทำอย่างอื่นที่มีประโยชน์กว่าเดิม ถ้าคุณอยากกำหนดรูปแบบเองก็ทำได้ แค่บอกชนิดข้อมูลที่ต้องการ แล้วมันจะทำตามเวอร์ชันของคุณ ไม่มีโค้ด ไม่ต้องจิ้ม selector ให้ยุ่งยาก ได้ผลลัพธ์ทันที
อะไรที่ทำให้ Thunderbit กลายเป็นขวัญใจของทีมขาย การตลาด และอีคอมเมิร์ซ? เพราะมันถูกออกแบบมาให้เข้ากับงานธุรกิจจริง ๆ:
- คอลัมน์อัตโนมัติ: ระบบสร้างรายการคอลัมน์ให้คุณเองโดยไม่ต้องขอ เช่น ชื่อ ราคา อีเมล หรืออะไรก็ตามที่ต้องการ และถ้าคุณอยากกำหนดเองก็แค่บอก
- สแครปซับเพจ: ถ้าต้องการรายละเอียดเพิ่ม Thunderbit สามารถเปิดแต่ละซับเพจโดยอัตโนมัติ เช่น หน้ารายละเอียดสินค้า หรือโปรไฟล์ LinkedIn แล้วนำข้อมูลมาเติมในตารางให้ครบ
- ส่งออกได้ทันที: ส่งข้อมูลไปยัง Excel, Google Sheets, Airtable หรือ Notion ได้โดยตรง และการส่งออกทั้งหมดฟรี
- เทมเพลตคลิกเดียว: สำหรับเว็บไซต์ยอดนิยมอย่าง Amazon, Zillow หรือ Instagram ใช้เทมเพลตสำเร็จรูปเพื่อให้ได้ผลลัพธ์เร็วขึ้น
- ส่งออกข้อมูลฟรี: ไม่มีการล็อกข้อมูลออกจากระบบ
- สแครปแบบตั้งเวลาได้: ตั้งงานที่ทำซ้ำเป็นประจำด้วยภาษาคนธรรมดา เช่น “ทุกวันจันทร์เวลา 9 โมงเช้า” เหมาะมากสำหรับการติดตามราคา หรืออัปเดตลีดรายสัปดาห์
Thunderbit ใช้ระบบเครดิต (1 เครดิต = 1 แถว, 2 เครดิตเมื่อแถวนั้นมาจากซับเพจ) และมี แพ็กเกจฟรี สำหรับสูงสุด 6 หน้า (หรือ 10 หน้าหากได้บูสต์จากช่วงทดลองใช้งาน) แพ็กเกจแบบชำระเงินเริ่มต้นที่ $15/เดือนสำหรับ 500 เครดิต ทำให้เหมาะกับทีมทุกขนาด
ถ้าอยากดูว่า Thunderbit ทำงานจริงเป็นอย่างไร ลองเข้าไปดู ช่อง YouTube หรือ บล็อก ของเราได้เลย นี่คือเครื่องมือที่ผมอยากมีตั้งแต่ตอนที่ต้องจมอยู่กับงานคีย์ข้อมูลด้วยมือ
ลองใช้ Thunderbit ฟรี – AI Web Scraper คลิกเดียว
2. Octoparse
 Octoparse เป็นตัวเลือกสายหนักในโลกของการดึงข้อมูลจากเว็บ โดยเฉพาะสำหรับผู้ใช้ระดับองค์กรที่ต้องการพลังแบบจริงจัง มันมีอินเทอร์เฟซแบบภาพบนเดสก์ท็อป (Windows และ Mac) ให้คุณคลิกเลือกและสร้างเวิร์กโฟลว์การดึงข้อมูลได้โดยไม่ต้องเขียนโค้ด แต่ก็อย่าถูกหน้าตาที่ใช้ง่ายหลอกล่ะ เพราะข้างใน Octoparse จัดการเรื่องล็อกอิน การเลื่อนหน้าแบบไม่มีที่สิ้นสุด proxy แบบสลับ IP และแม้แต่การแก้ CAPTCHA ได้ด้วย
- เทมเพลตสำเร็จรูปมากกว่า 500 แบบ: เริ่มต้นได้เร็วกับเทมเพลตสำหรับ Amazon, Twitter, LinkedIn และอีกมากมาย
- สแครปบนคลาวด์: รันงานบนเซิร์ฟเวอร์ของ Octoparse ตั้งเวลางาน และขยายการใช้งานสำหรับโปรเจกต์ใหญ่ ๆ
- เข้าถึงผ่าน API: เชื่อมข้อมูลที่สแครปได้เข้ากับแอปหรือฐานข้อมูลของธุรกิจคุณโดยตรง
- อัตโนมัติขั้นสูง: รองรับเนื้อหาแบบไดนามิก pagination และเวิร์กโฟลว์หลายขั้นตอน
แพ็กเกจฟรีครอบคลุม 10 งาน พร้อมโควตาส่งออก 50,000 แถวต่อเดือน ซึ่งถือว่าใช้งานจริงได้ ไม่ใช่แค่ให้ลองเล่น ราคาของแพ็กเกจแบบชำระเงินเริ่มต้นที่ $69/เดือนสำหรับ Standard (เมื่อจ่ายรายปี; ประมาณ $82/เดือนถ้าจ่ายรายเดือน) และ $249/เดือนสำหรับ Professional เส้นโค้งการเรียนรู้จะชันกว่า Thunderbit อยู่พอสมควร แต่ถ้าคุณต้องสแครปหลายพันหน้าอย่างเสถียรและต้องการรันบนคลาวด์ Octoparse ก็ยังเป็นหนึ่งในตัวเลือกที่อยู่มานานและน่าพิจารณาอย่างจริงจัง ตรวจสอบราคาแล้วจาก octoparse.com/pricing เมื่อ 2026-05-13.
3. Scrapy
 Scrapy คือมาตรฐานทองคำสำหรับนักพัฒนาที่ต้องการควบคุมโปรเจกต์ดึงข้อมูลจากเว็บแบบเต็มรูปแบบ มันเป็นเฟรมเวิร์ก Python แบบโอเพนซอร์สที่ให้คุณเขียน spider แบบกำหนดเองสำหรับทุกเว็บไซต์ ถ้าคุณนึกออก คุณก็สร้างได้ด้วย Scrapy
- ตั้งโปรแกรมได้เต็มที่: เขียนโค้ด Python เพื่อกำหนดวิธีการ crawl และแยกข้อมูลของแต่ละเว็บไซต์ได้อย่างละเอียด
- ทำงานแบบอะซิงโครนัสและเร็วมาก: รองรับการประมวลผลหลายพันหน้าแบบขนาน เหมาะกับงานขนาดใหญ่
- ขยายต่อได้ง่าย: เพิ่ม middleware สำหรับ proxy เบราว์เซอร์แบบ headless หรือเงื่อนไขเฉพาะทางได้
- ชุมชนแข็งแรง: มีบทเรียน ปลั๊กอิน และการช่วยเหลือมากมายสำหรับงานสแครปที่ซับซ้อน
Scrapy ฟรีและเป็นโอเพนซอร์ส แต่ต้องมีทักษะการเขียนโปรแกรม ถ้าคุณมีทีมเทคนิคหรืออยากสร้าง pipeline แบบกำหนดเอง Scrapy ถือว่าแข็งมาก ส่วนคนไม่เขียนโค้ด อาจรู้สึกว่าทางชันพอสมควร
4. ParseHub
 ParseHub เป็นเครื่องมือเว็บสแครปปิ้งแบบเห็นภาพและไม่ต้องเขียนโค้ด เหมาะมากสำหรับคนไม่เขียนโค้ดที่ต้องเจอกับเว็บไซต์ซับซ้อน อินเทอร์เฟซแบบคลิกเลือกช่วยให้คุณเลือกองค์ประกอบ กำหนดการทำงาน และสร้างเวิร์กโฟลว์การดึงข้อมูลได้ แม้กับเว็บไซต์ที่มีเนื้อหาไดนามิกหรือการนำทางที่ซับซ้อน
- ตัวสร้างเวิร์กโฟลว์แบบภาพ: คลิกเลือกข้อมูล ตั้งค่า pagination และจัดการป๊อปอัปหรือดรอปดาวน์ได้
- รองรับเนื้อหาไดนามิก: ใช้งานได้กับเว็บที่ใช้ JavaScript หนัก ๆ และหน้าที่มีการโต้ตอบสูง
- รันบนคลาวด์และตั้งเวลาได้: รันงานสแครปบนคลาวด์และตั้งให้อัปเดตซ้ำเป็นรอบ ๆ
- ส่งออกเป็น CSV, Excel หรือผ่าน API: เชื่อมต่อกับเครื่องมือที่คุณใช้อยู่ได้ง่าย
ParseHub มีแพ็กเกจฟรี (5 โปรเจกต์) ส่วนแพ็กเกจแบบชำระเงินเริ่มต้นที่ ประมาณ $189/เดือน ราคาค่อนข้างสูงกว่าเครื่องมือบางตัว แต่แนวทางแบบภาพช่วยให้ใช้งานได้ง่ายสำหรับนักวิเคราะห์ นักการตลาด และนักวิจัยที่ต้องการมากกว่าแค่ส่วนขยาย Chrome ธรรมดา
5. Apify
 Apify เป็นทั้งแพลตฟอร์มและมาร์เก็ตเพลสสำหรับการดึงข้อมูลจากเว็บ มีไลบรารี “Actors” สำเร็จรูปจำนวนมากสำหรับเว็บไซต์ยอดนิยม และยังสามารถสร้างและรัน crawler แบบกำหนดเองบนคลาวด์ได้อีกด้วย
- Actors พร้อมใช้มากกว่า 5,000 ตัว: ดึงข้อมูลจาก Google Maps, Amazon, Twitter และอีกมากมายได้ทันที
- เขียนสคริปต์เองได้: นักพัฒนาสามารถใช้ JavaScript หรือ Python สร้าง crawler ขั้นสูงได้
- ขยายการทำงานบนคลาวด์: รันงานแบบขนาน ตั้งเวลางาน และจัดการข้อมูลบนคลาวด์ได้
- รองรับ API และการเชื่อมต่อ: ส่งผลลัพธ์ไปยังแอป เวิร์กโฟลว์ หรือ data pipeline ของคุณได้เลย
Apify ให้เครดิตแพลตฟอร์มฟรี $5 เพื่อเริ่มต้น จากนั้นแพ็กเกจจะเป็น Starter ที่ $29/เดือน, Scale ที่ $199/เดือน และ Business ที่ $999/เดือน — แต่ละระดับเป็นแบบ “เครดิตแพลตฟอร์ม + จ่ายตามการใช้งานหน่วยคำนวณ” ดังนั้นยอดใช้งานจริงจะเป็นตัวกำหนดบิล มีเส้นโค้งการเรียนรู้อยู่บ้าง แต่ถ้าคุณอยากได้ทั้ง actor แบบพร้อมใช้และความสามารถในการเขียน crawler เองด้วย JS หรือ Python Apify คือหนึ่งในตัวเลือกที่แข็งแรงที่สุดในลิสต์นี้ ตรวจสอบราคาแล้วจาก apify.com/pricing เมื่อ 2026-05-13.
6. Data Miner
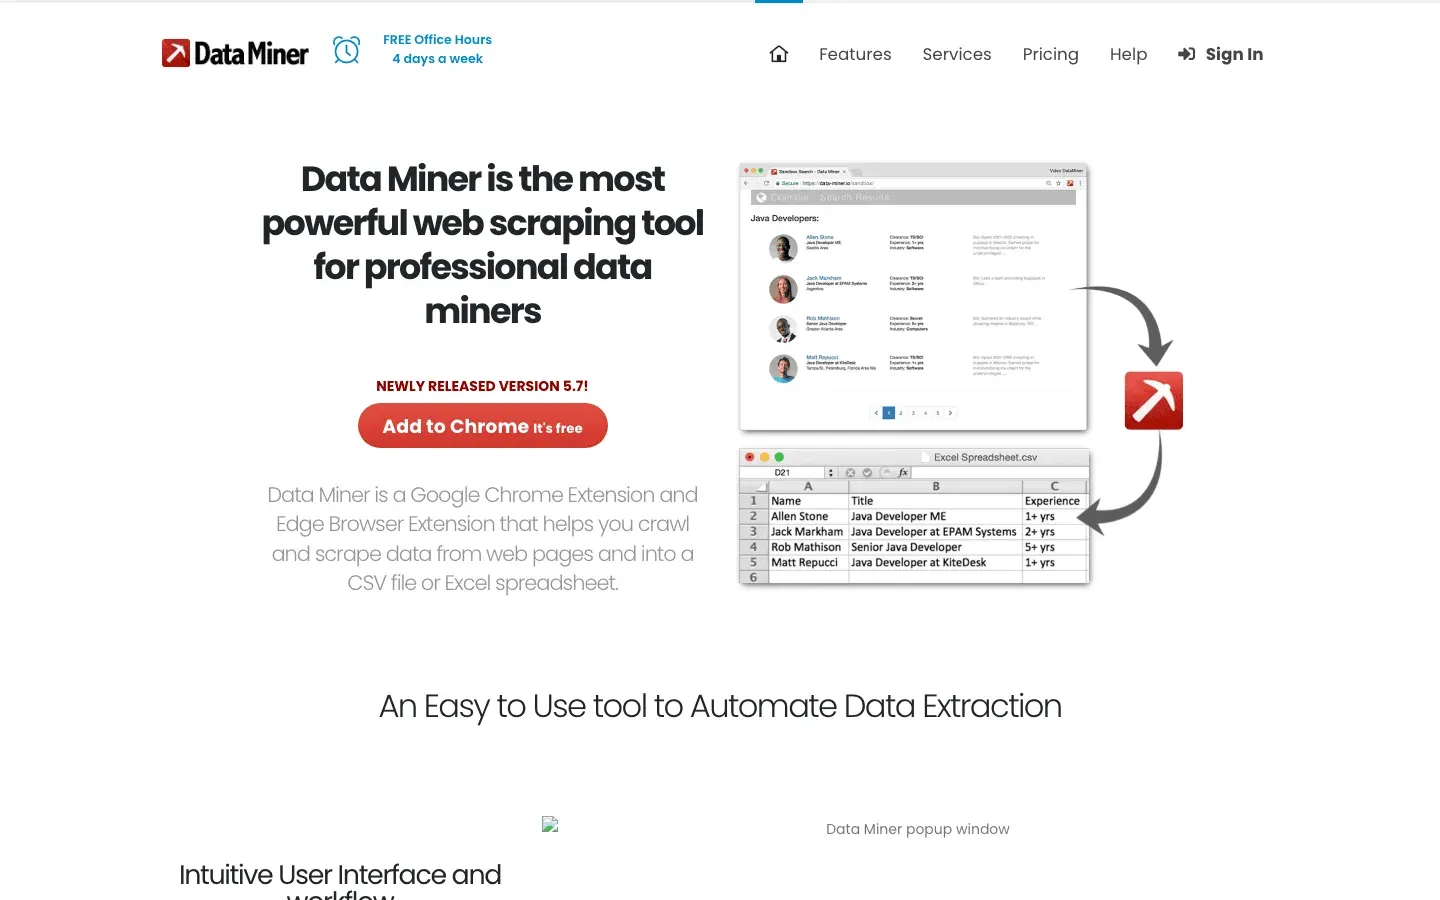 Data Miner เป็นส่วนขยาย Chrome ที่สร้างมาเพื่อการดึงข้อมูลแบบเร็วและใช้เทมเพลตเป็นหลัก เหมาะมากสำหรับผู้ใช้ธุรกิจที่อยากดึงข้อมูลจากตารางหรือลิสต์โดยไม่ต้องตั้งค่าอะไรเยอะ
- คลังเทมเพลตขนาดใหญ่: มีสูตรสำเร็จมากกว่าพันแบบสำหรับเว็บไซต์ยอดนิยม (เช่น LinkedIn, Yelp เป็นต้น)
- ดึงข้อมูลแบบคลิกเลือก: เลือกเทมเพลต ดูตัวอย่างข้อมูล แล้วส่งออกได้ทันที
- ทำงานในเบราว์เซอร์: ใช้กับเซสชันที่คุณเปิดอยู่ได้ เหมาะกับการสแครปข้อมูลหลังล็อกอิน
- ส่งออกเป็น CSV หรือ Excel: ย้ายข้อมูลลงสเปรดชีตได้ในไม่กี่วินาที
แพ็กเกจฟรี ครอบคลุม 500 หน้า/เดือน และแพ็กเกจแบบชำระเงินเริ่มที่ $20/เดือน เหมาะที่สุดกับงานเล็ก ๆ งานครั้งเดียว หรือเวลาที่คุณต้องการข้อมูลเดี๋ยวนั้น แต่ถ้าเป็นงานปริมาณมหาศาลหรืออัตโนมัติที่ซับซ้อน อาจไม่ใช่ตัวเลือกที่ตอบโจทย์ที่สุด
7. Import.io
 Import.io เป็นแพลตฟอร์มระดับองค์กรสำหรับบริษัทที่ต้องการเชื่อมต่อข้อมูลเว็บอย่างต่อเนื่องและเชื่อถือได้ มันไม่ได้เป็นแค่ crawler ธรรมดา แต่เป็นบริการแบบ managed service ที่ส่งข้อมูลที่สะอาดและมีโครงสร้างไปยังระบบธุรกิจของคุณโดยตรง
- ดึงข้อมูลแบบไม่ต้องเขียนโค้ด: ตั้งค่าด้วยภาพเพื่อกำหนดว่าต้องการดึงข้อมูลอะไร
- ส่งข้อมูลแบบเรียลไทม์: สตรีมข้อมูลเข้า dashboard เครื่องมือวิเคราะห์ หรือฐานข้อมูลได้
- ความน่าเชื่อถือและการปฏิบัติตามข้อกำหนด: รองรับการสลับ IP มาตรการต้านบอท และเรื่องการปฏิบัติตามกฎหมาย
- บริการแบบมีทีมดูแล: ทีมของ Import.io สามารถช่วยตั้งค่าและดูแลสคริปต์สแครปของคุณได้
ราคาเป็นแบบ กำหนดเองและคิดตามปริมาณการใช้งาน พร้อมทดลองใช้ฟรี 14 วันสำหรับแพลตฟอร์ม SaaS ถ้าธุรกิจของคุณต้องพึ่งพาข้อมูลเว็บที่อัปเดตตลอดเวลา (เช่น ค้าปลีก การเงิน หรือวิจัยตลาด) Import.io ก็น่าสนใจมาก
8. WebHarvy
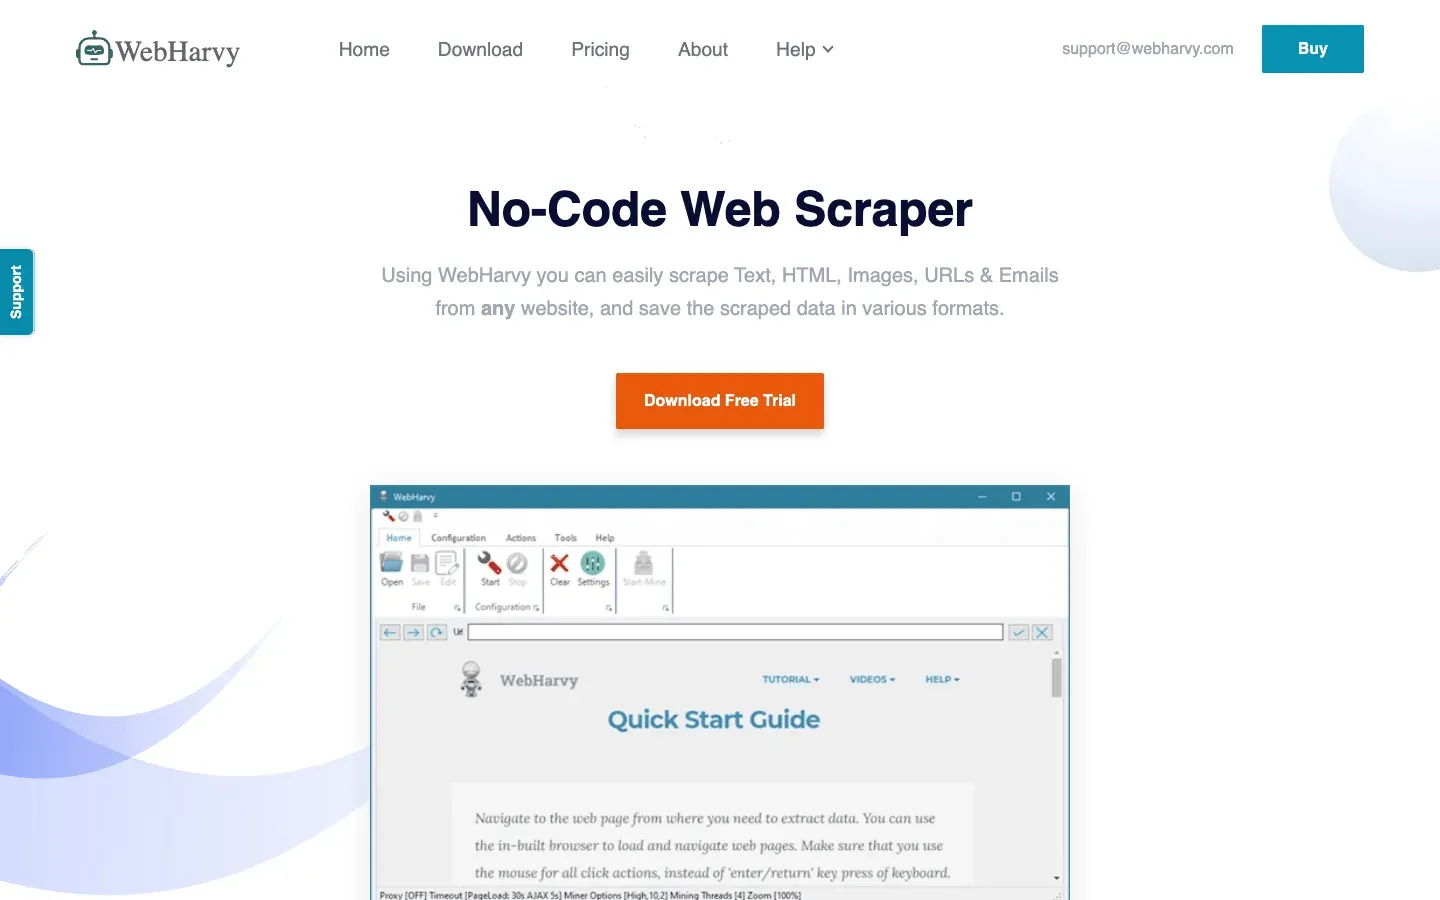 WebHarvy เป็นโปรแกรมสแครปแบบเดสก์ท็อปสำหรับผู้ใช้ Windows ที่อยากได้โซลูชันแบบคลิกเลือกโดยไม่ต้องสมัครรายเดือน เครื่องมือนี้ได้รับความนิยมเป็นพิเศษในกลุ่มธุรกิจขนาดเล็กและผู้ใช้รายบุคคลที่ชอบซื้อครั้งเดียวจบ
- ตรวจจับรูปแบบอัตโนมัติแบบภาพ: คลิกเลือกองค์ประกอบข้อมูล แล้ว WebHarvy จะตรวจจับรูปแบบที่ซ้ำกันให้เอง
- รองรับข้อความ รูปภาพ และอื่น ๆ: ดึงได้ทั้งอีเมลและ URL รวมถึงชนิดข้อมูลทั่วไปอื่น ๆ
- pagination และการตั้งเวลา: ไปยังหลายหน้าได้ และตั้งให้สแครปตามเวลาได้
- ส่งออกเป็น Excel, CSV, XML, JSON หรือ SQL: รองรับรูปแบบผลลัพธ์ที่ยืดหยุ่นสำหรับทุกเวิร์กโฟลว์
ไลเซนส์ผู้ใช้เดี่ยวราคา ประมาณ $99 แบบจ่ายครั้งเดียวตลอดชีพ ทำให้เป็นตัวเลือกที่คุ้มสำหรับการใช้งานบ่อย ๆ เพียงแต่ต้องทราบว่าใช้งานได้เฉพาะ Windows เท่านั้น
9. Mozenda
 Mozenda เป็นแพลตฟอร์มดึงข้อมูลจากเว็บบนคลาวด์ที่สร้างมาสำหรับงานปฏิบัติการของธุรกิจและความต้องการข้อมูลต่อเนื่อง มันผสานเครื่องมือออกแบบบนเดสก์ท็อป (Windows) เข้ากับการทำงานบนคลาวด์และระบบอัตโนมัติที่ทรงพลัง
- ตัวสร้าง Agent แบบภาพ: ออกแบบขั้นตอนการดึงข้อมูลด้วยอินเทอร์เฟซแบบคลิกเลือก
- สเกลบนคลาวด์: รันหลาย agent พร้อมกัน ตั้งเวลางาน และจัดการข้อมูลแบบรวมศูนย์
- คอนโซลจัดการข้อมูล: รวม กรอง และทำความสะอาดชุดข้อมูลหลังการดึงข้อมูล
- ซัพพอร์ตระดับองค์กร: มีผู้ดูแลบัญชีเฉพาะและบริการแบบ managed service สำหรับทีมขนาดใหญ่
แพ็กเกจ Pilot แบบ self-serve ของ Mozenda ราคา $500/เดือน (5,000 processing credits, 10 agents, storage 10GB) ส่วน Enterprise ต้องขอใบเสนอราคา และยังมีแพ็กเกจ Trial 14 วันพร้อม 500 credits สำหรับลองใช้ก่อนตัดสินใจ Mozenda เหมาะที่สุดกับบริษัทที่ต้องการนำข้อมูลเว็บที่เชื่อถือได้และทำซ้ำได้มาใช้ในงานประจำวัน—ราคาไม่น้อย และแพลตฟอร์มนี้ก็ตั้งใจให้คุณใช้งานแบบจริงจัง ตรวจสอบราคาแล้วจาก mozenda.com/pricing เมื่อ 2026-05-13.
10. BeautifulSoup
 BeautifulSoup คือไลบรารี Python สุดคลาสสิกสำหรับการแยก HTML และ XML มันไม่ใช่ crawler แบบครบวงจร แต่เป็นที่รักของนักพัฒนาสำหรับโปรเจกต์สแครปแบบกำหนดเองขนาดเล็ก
- แยก HTML ได้ง่าย: ดึงข้อมูลจากหน้าเว็บแบบ static ได้อย่างสะดวก
- ใช้ร่วมกับ Python Requests ได้: ผสานกับไลบรารีอื่นเพื่อดึงและ crawl ข้อมูลต่อได้
- ยืดหยุ่นและเบาเครื่อง: เหมาะกับสคริปต์สั้น ๆ หรือโปรเจกต์เพื่อการเรียนรู้
- ชุมชนใหญ่: มีบทเรียนและคำตอบจาก Stack Overflow ให้ค้นหาเยอะมาก
BeautifulSoup ฟรีและเป็นโอเพนซอร์ส แต่คุณต้องเขียนโค้ดและจัดการ logic ของการ crawl เอง เหมาะที่สุดสำหรับนักพัฒนาหรือผู้เรียนที่อยากเข้าใจกลไกเบื้องหลังของ web scraping อย่างแท้จริง
ตารางเปรียบเทียบ: เครื่องมือดึงข้อมูลจากเว็บแบบเห็นภาพรวม
| เครื่องมือ | ใช้งานง่ายแค่ไหน | ระดับอัตโนมัติ | ราคา | ตัวเลือกการส่งออก | เหมาะกับใคร |
|---|---|---|---|---|---|
| Thunderbit | ง่ายมาก, ไม่ต้องเขียนโค้ด | สูง (AI, subpages) | ทดลองใช้ฟรี, เริ่มต้น $15/เดือน | Excel, Sheets, Airtable, Notion, CSV | ทีมขาย, การตลาด, อีคอมเมิร์ซ, คนไม่เขียนโค้ด |
| Octoparse | ปานกลาง, UI แบบภาพ | สูงมาก, บนคลาวด์ | ฟรี, $69–$249/เดือน | CSV, Excel, JSON, API | องค์กร, ทีมข้อมูล, เว็บไซต์ไดนามิก |
| Scrapy | ต่ำ (ต้องใช้ Python) | สูง (ปรับแต่งได้) | ฟรี, โอเพนซอร์ส | ได้ทุกแบบ (ผ่านโค้ด) | นักพัฒนา, โปรเจกต์กำหนดเองขนาดใหญ่ |
| ParseHub | สูง, แบบภาพ | สูง (เว็บซับซ้อน) | ฟรี, เริ่มต้น $189/เดือน | CSV, Excel, JSON, API | คนไม่เขียนโค้ด, โครงสร้างเว็บซับซ้อน |
| Apify | ปานกลาง, ยืดหยุ่น | สูงมาก, บนคลาวด์ | ฟรี, $29–$999/เดือน | CSV, JSON, API, cloud storage | นักพัฒนา, ธุรกิจ, actor สำเร็จรูปหรือแบบกำหนดเอง |
| Data Miner | ง่ายมาก, ผ่านเบราว์เซอร์ | ต่ำ (กึ่งแมนนวล) | ฟรี, $20–$99/เดือน | CSV, Excel | งานดึงข้อมูลเร็ว ๆ ครั้งเดียว, ชุดข้อมูลเล็ก |
| Import.io | ปานกลาง, มีบริการดูแล | สูงมาก, ระดับองค์กร | กำหนดเอง, คิดตามปริมาณ | CSV, JSON, API, เชื่อมต่อโดยตรง | องค์กร, เชื่อมข้อมูลแบบต่อเนื่อง |
| WebHarvy | สูง, เดสก์ท็อป | ปานกลาง (ตั้งเวลาได้) | $99 จ่ายครั้งเดียว | Excel, CSV, XML, JSON, SQL | ธุรกิจขนาดเล็กถึงกลาง, ผู้ใช้ Windows, สแครปเป็นประจำ |
| Mozenda | ปานกลาง, แบบภาพ | สูงมาก, บนคลาวด์ | $500/เดือน Pilot | CSV, Excel, JSON, cloud, DB | งานประจำ, การปฏิบัติงานขนาดใหญ่ต่อเนื่อง |
| BeautifulSoup | ต่ำ (ต้องใช้ Python) | ต่ำ (เขียนโค้ดเอง) | ฟรี, โอเพนซอร์ส | ได้ทุกแบบ (ผ่านโค้ด) | นักพัฒนา, ผู้เรียน, สคริปต์กำหนดเองขนาดเล็ก |
วิธีเลือกเครื่องมือดึงข้อมูลจากเว็บที่เหมาะกับทีมของคุณ
Data Scraping คืออะไร และทำอย่างไรในปี 2026 Get Started Free
การเลือกเครื่องมือดึงข้อมูลจากเว็บที่ดีที่สุดไม่ใช่การหาเครื่องมือที่ “ทรงพลังที่สุด” เสมอไป แต่คือการหาเครื่องมือที่เหมาะกับทักษะ ความต้องการ และงบประมาณของทีมคุณมากที่สุด คำแนะนำสั้น ๆ ของผมคือ:
- คนไม่เขียนโค้ดหรือผู้ใช้ธุรกิจ: เริ่มจาก Thunderbit, ParseHub หรือ Data Miner เพื่อให้ได้ผลลัพธ์เร็วและตั้งค่าง่าย
- องค์กรหรือความต้องการระดับใหญ่: ดูที่ Octoparse, Mozenda หรือ Import.io สำหรับอัตโนมัติ การตั้งเวลา และการสนับสนุน
- นักพัฒนาหรือโปรเจกต์เฉพาะทาง: Scrapy, Apify หรือ BeautifulSoup ให้การควบคุมและความยืดหยุ่นสูงสุด
- งบจำกัดหรืองานครั้งเดียว: WebHarvy (Windows) หรือ Data Miner (บนเบราว์เซอร์) เป็นตัวเลือกที่คุ้มและใช้งานง่าย
อย่าลืมทดลองใช้ตัวเลือกที่ติดอันดับต้น ๆ กับเว็บไซต์เป้าหมายจริงของคุณผ่านทดลองใช้ฟรี เพราะสิ่งที่ใช้ได้กับเว็บหนึ่ง อาจใช้ไม่ได้กับอีกเว็บหนึ่ง และอย่าลืมเรื่องการเชื่อมต่อด้วย: ถ้าคุณต้องการส่งข้อมูลไป Sheets, Notion หรือฐานข้อมูล ตรวจสอบให้แน่ใจว่าเครื่องมือนั้นรองรับตั้งแต่ต้นทาง
สรุป: ปลดล็อกมูลค่าทางธุรกิจด้วยเครื่องมือดึงข้อมูลจากเว็บที่ดีที่สุด
ข้อมูลจากเว็บคือทรัพยากรใหม่ แต่จะมีค่าได้จริงก็ต่อเมื่อคุณมีเครื่องมือที่เหมาะสมในการสกัดและกลั่นมันออกมา ด้วยเครื่องมือดึงข้อมูลจากเว็บยุคใหม่ คุณสามารถเปลี่ยนงานค้นคว้าด้วยมือหลายชั่วโมงให้กลายเป็นอินไซต์อัตโนมัติในไม่กี่นาที—ช่วยให้การขายฉลาดขึ้น การตลาดคมขึ้น และการทำงานคล่องตัวขึ้น ไม่ว่าคุณจะกำลังสร้างรายชื่อลีด ติดตามคู่แข่ง หรือแค่เบื่อการก็อปปี้วาง เครื่องมือในลิสต์นี้มีตัวที่ช่วยให้ชีวิตคุณง่ายขึ้นได้แน่นอน
ดังนั้น ลองดูความต้องการของทีมคุณ ทดลองใช้เครื่องมือเหล่านี้สักสองสามตัว แล้วคุณจะเห็นว่าออโตเมชันช่วยยกระดับงานได้มากแค่ไหน และถ้าอยากเห็นการสแครปแบบขับเคลื่อนด้วย AI ที่คลิกเดียวจบ ลองใช้ฟรี Thunderbit ได้เลย ขอให้การดึงข้อมูลราบรื่น และขอให้ข้อมูลของคุณสดใหม่ มีโครงสร้าง และพร้อมใช้งานเสมอ
ลองใช้ Thunderbit AI Web Scraper ฟรี
คำถามที่พบบ่อย
1. เครื่องมือดึงข้อมูลจากเว็บคืออะไร และทำไมฉันถึงควรใช้?
เครื่องมือดึงข้อมูลจากเว็บช่วยทำงานเก็บข้อมูลจากเว็บไซต์แบบอัตโนมัติ ประหยัดเวลา ลดข้อผิดพลาด และช่วยให้ทีมรวบรวมข้อมูลล่าสุดสำหรับงานขาย การตลาด วิจัย และปฏิบัติการได้มีประสิทธิภาพกว่าการก็อปปี้วางด้วยมือมาก
2. เครื่องมือดึงข้อมูลจากเว็บตัวไหนเหมาะกับผู้ใช้ที่ไม่ถนัดเทคนิคที่สุด?
Thunderbit, ParseHub และ Data Miner เป็นตัวเลือกยอดนิยมสำหรับคนไม่เขียนโค้ด Thunderbit เด่นเรื่องเวิร์กโฟลว์ AI แบบคลิกเดียว ส่วน ParseHub เหมาะกับเว็บไซต์ที่ซับซ้อนกว่าเพราะมีแนวทางแบบภาพ
3. รูปแบบการคิดราคาของเครื่องมือดึงข้อมูลจากเว็บต่างกันอย่างไร?
ราคามีความหลากหลายมาก: บางเครื่องมือ เช่น Thunderbit และ Data Miner มีแพ็กเกจฟรีและแผนรายเดือนที่เข้าถึงได้ ในขณะที่แพลตฟอร์มระดับองค์กร เช่น Import.io และ Mozenda มักคิดราคาแบบกำหนดเองหรือคิดตามปริมาณการใช้งาน ควรตรวจสอบเสมอว่าราคาเหมาะกับปริมาณข้อมูลของคุณหรือไม่
4. ใช้เครื่องมือเหล่านี้สำหรับการดึงข้อมูลเป็นประจำตามเวลาได้ไหม?
ได้แน่นอน—เครื่องมืออย่าง Thunderbit, Octoparse, Apify, Mozenda และ Import.io รองรับการสแครปแบบตั้งเวลาหรือทำซ้ำเป็นรอบ ๆ จึงเหมาะมากสำหรับการติดตามราคา การหาลูกค้าใหม่ หรือวิจัยตลาดอย่างต่อเนื่อง
5. ควรพิจารณาอะไรบ้างก่อนเลือกเครื่องมือดึงข้อมูลจากเว็บ?
พิจารณาทักษะด้านเทคนิคของทีม ความซับซ้อนของเว็บไซต์ที่ต้องสแครป ปริมาณข้อมูล ความต้องการด้านการเชื่อมต่อ และงบประมาณ ทดลองใช้เครื่องมือสองสามตัวกับงานจริงก่อนตัดสินใจซื้อแพ็กเกจ
ถ้าอยากอ่านเชิงลึกและคู่มือใช้งานจริงเพิ่มเติม ลองเข้าไปดู Thunderbit Blog
ลองใช้ AI Web Scraper Get Started Free
อ่านเพิ่มเติม




