
ในปี 2015 การทำเว็บสแครปปิ้งยังแปลว่าต้องไปขอให้ดีเวลอปเปอร์เขียนสคริปต์ Python ให้ ไม่งั้นก็ต้องยอมเสียสุดสัปดาห์ไปกับการเรียน XPath เอง แต่พอถึงปี 2026 แค่พิมพ์ว่า “ดึงชื่อสินค้าและราคาให้หมด” แล้วปล่อยให้ AI จัดการต่อแทบทุกอย่างได้เลย
การเปลี่ยนแปลงนี้เกิดขึ้นเร็วมาก จากผลสำรวจของ Censuswide ที่เก็บข้อมูลจากผู้เชี่ยวชาญด้านเว็บสแครปปิ้ง 506 คนในสหรัฐฯ และสหราชอาณาจักร 74% บอกว่าธุรกิจของพวกเขาเจอความต้องการข้อมูลเว็บเพิ่มขึ้นในช่วง 12 เดือนที่ผ่านมา
อะไรคือแรงผลักหลัก? ก็พวก AI web crawler นี่แหละ พวกมันปรับตัวกับการเปลี่ยนแปลงของหน้าเว็บได้ เข้าใจคอนเทนต์บนหน้า ไม่ได้มองแค่แท็ก HTML และที่สำคัญคือใช้งานได้ แม้คุณจะไม่เคยเขียนโค้ดเลยสักบรรทัด
ผมใช้เวลาหลายเดือนทดสอบทั้งหมด 15 ตัว และนี่คือสิ่งที่ผมเจอ — รวมถึงเหตุผลที่ Thunderbit (ใช่แล้ว บริษัทที่ผมร่วมก่อตั้ง) ได้อันดับหนึ่ง
ทำไม AI ถึงกำลังเปลี่ยนเกมการดึงข้อมูลจากหน้าเว็บ: ยุคใหม่ของเครื่องมือ Web Scraper
ดึงข้อมูลจากทุกเว็บไซต์ได้ด้วย AI Get Started Free
พูดกันตรง ๆ เลยนะ: เว็บสแครปปิ้งแบบเดิมไม่เคยถูกสร้างมาเพื่อผู้ใช้ธุรกิจทั่วไป มันเต็มไปด้วยโค้ด ตัวเลือก selector และการลุ้นไม่ให้สคริปต์พังตอนเว็บไซต์เปลี่ยนหน้า หรือจัดเลย์เอาต์ใหม่ แต่ AI และ LLM ทำให้เกมนี้พลิกไปหมด
สิ่งที่เปลี่ยนไปมีดังนี้:
- สั่งด้วยภาษาคน: แทนที่จะต้องนั่งเขียนโค้ด คุณแค่บอก AI ว่าต้องการอะไร เครื่องมืออย่าง Thunderbit ใช้ AI ตรวจจับฟิลด์ที่ควรดึงและจัดโครงสร้างข้อมูลให้เรียบร้อย
- เรียนรู้และปรับตัวได้: AI scraper สามารถ ปรับเข้ากับการเปลี่ยนแปลงของหน้าเว็บ ได้ ช่วยลดภาระการต้องคอยแก้สคริปต์ลงไปเยอะ
- รับมือคอนเทนต์แบบไดนามิก: เว็บไซต์ยุคใหม่มักใช้ JavaScript และ infinite scroll กันบ่อย เครื่องมือที่ใช้ AI จะโต้ตอบกับองค์ประกอบพวกนี้และเก็บข้อมูลได้ครบกว่าสแครปเปอร์รุ่นเก่าที่มักพลาด
- ส่งออกข้อมูลเป็นโครงสร้างด้วย AI parsing: เครื่องมือที่อิง LLM จะ เข้าใจคอนเทนต์บนหน้าเว็บ และแปลงให้ออกมาเป็นข้อมูลที่สะอาดและเป็นระเบียบ
- โครงสร้างพื้นฐานสำหรับเว็บไซต์ที่ซับซ้อน: บางแพลตฟอร์มรวม AI extraction เข้ากับ browser rendering, proxy และการจัดการ CAPTCHA ด้วย ฟีเจอร์ด้านโครงสร้างพื้นฐานพวกนี้แหละ ไม่ใช่แค่ AI อย่างเดียว ที่ช่วยรับมือกับเว็บยากหรือเว็บที่กันการเข้าถึง
- เชื่อมต่อเวิร์กโฟลว์ข้อมูลได้เลย: เครื่องมือที่ดีไม่ได้แค่ดึงข้อมูลออกมา แต่ยังส่งต่อไปยังที่ที่คุณใช้จริงได้ทันที เช่น Google Sheets, Airtable, Notion และอื่น ๆ (source)
ผลลัพธ์คืออะไร? เว็บสแครปปิ้งกลายเป็นประสบการณ์แบบกดแล้วใช้ได้เลย หรือคุยกับมันเหมือนแชตก็ยังได้ ทำให้ทีมขาย ทีมการตลาด และทีมปฏิบัติการ ใช้ข้อมูลจากเว็บได้โดยตรง ไม่ใช่แค่นักพัฒนาอีกต่อไป
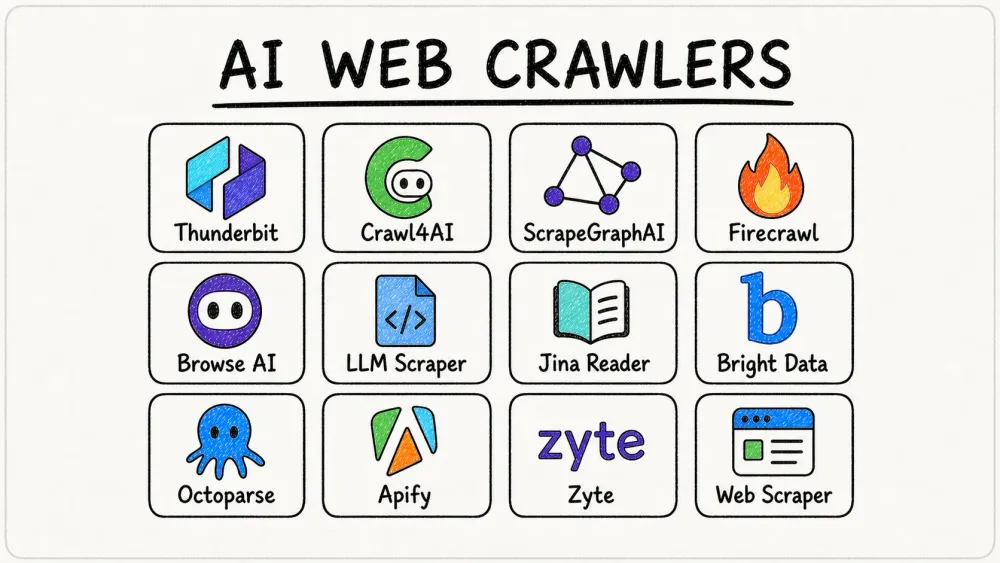
15 AI Web Crawler ที่ควรจับตาในปี 2026
มาดูกันทีละตัวกับ 15 อันดับ AI web crawler เริ่มจาก Thunderbit ผมจะเล่าจุดเด่น ฟีเจอร์หลัก กลุ่มผู้ใช้ เป้าหมายราคา และสิ่งที่ทำให้แต่ละตัวโดดเด่น พร้อมบอกตรง ๆ ด้วยว่าอะไรคือจุดแข็ง และอะไรที่อาจยังไม่ใช่ทางของมัน
1. Thunderbit: AI Web Scraper สำหรับทุกคน
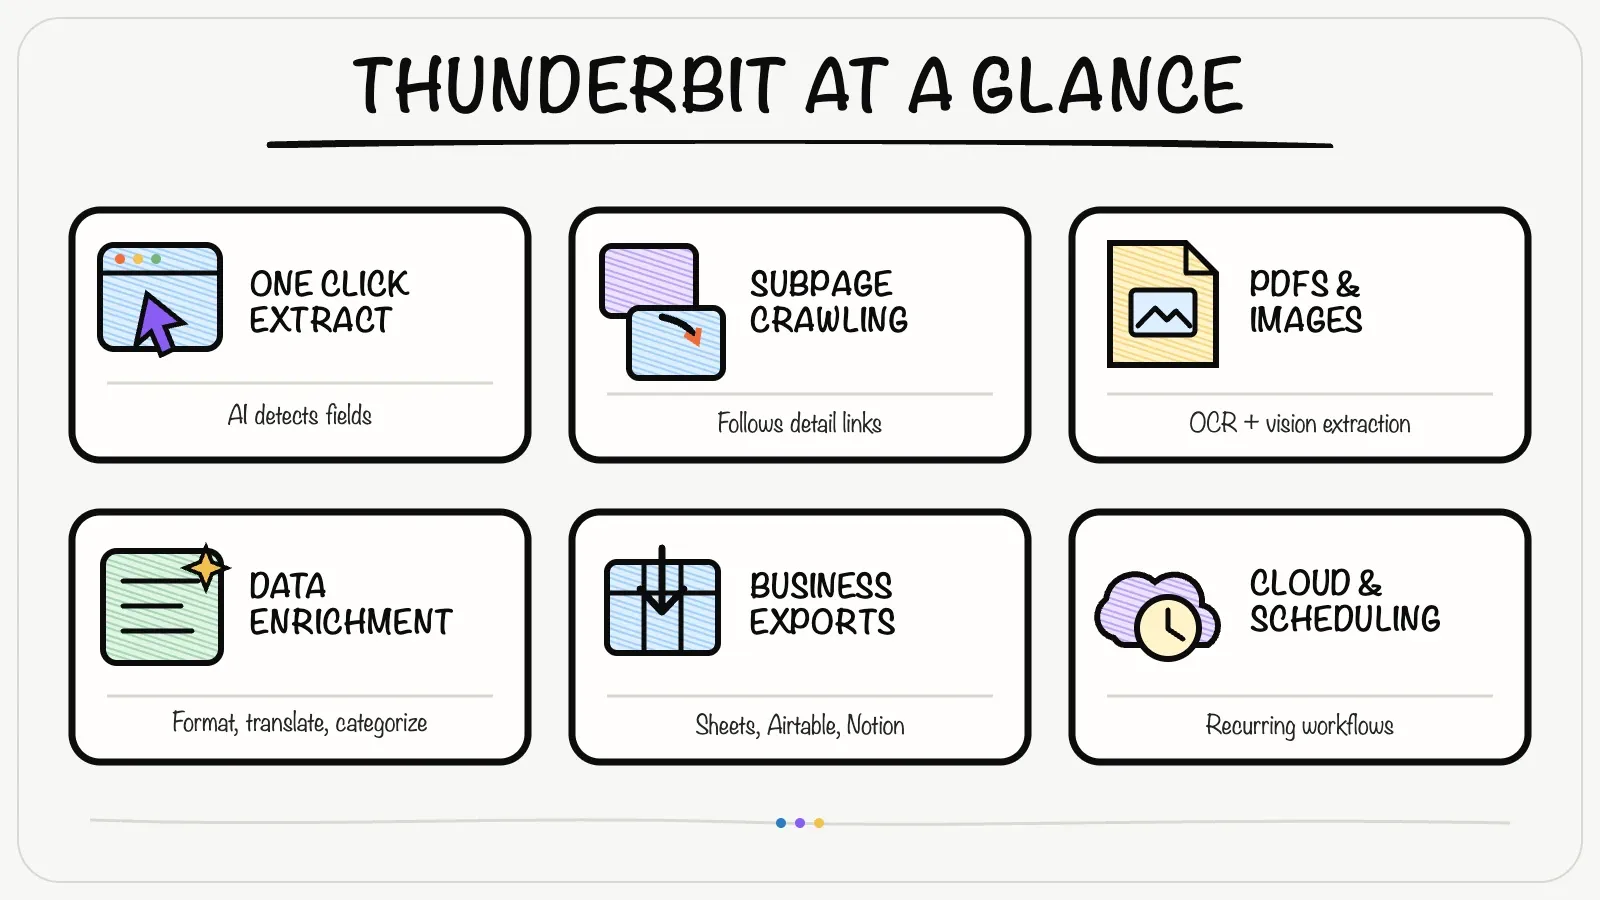
แน่นอนว่าผมมีอคติอยู่บ้าง แต่ Thunderbit คือ agentic web scraper ที่ผมอยากมีตั้งนานแล้ว เปิดหน้าเว็บแล้วกด One Click Extract ตัวเอเจนต์จะตรวจจับโครงสร้างหน้า ระบุฟิลด์ที่มีประโยชน์ และเตรียมการดึงข้อมูลให้ คุณกด Run Now ได้เลย หรือจะปล่อยให้เริ่มงานอัตโนมัติก็ได้ นี่คือเหตุผลที่มันได้อันดับ 1 ในลิสต์นี้:

- ดึงข้อมูลด้วยภาษาธรรมชาติ: Thunderbit ผสานคำสั่งฟิลด์แบบภาษาคนเข้ากับ One Click Extract ซึ่งวิเคราะห์หน้าเว็บและระบุฟิลด์ที่ควรดึงให้อัตโนมัติ โดยไม่ต้องเขียนโค้ดหรือใช้ selector (source)
- Crawl ได้ทั้งหน้าและหลายระดับ: Thunderbit ตามลิงก์และดึงข้อมูลจากหน้าย่อยได้ เช่น ดึงรายการสินค้า แล้วเข้าไปเก็บรายละเอียดในหน้าสินค้าแต่ละหน้าในเวิร์กโฟลว์เดียวกัน (source)
- ได้ผลลัพธ์ที่เป็นโครงสร้างทันที: AI แนะนำฟิลด์ ปรับรูปแบบข้อมูลให้เป็นมาตรฐาน และยังสรุป จัดหมวดหมู่ แปลภาษา หรือเติมคุณค่าเพิ่มเติมให้ข้อมูลที่ดึงมาได้ด้วย (source)
- รองรับแหล่งข้อมูลหลากหลาย: Thunderbit ดึงข้อมูลจากเว็บไซต์ PDF และรูปภาพได้ โดยใช้ OCR และ vision AI (source)
- เชื่อมต่อกับเครื่องมือธุรกิจได้: ส่งออกไป Google Sheets, Airtable, Notion หรือ Excel ได้ และตั้งเวลารัน cloud scrape ซ้ำได้สำหรับงานที่ต้องทำต่อเนื่อง (source)
- มีเทมเพลตสำเร็จรูป: Thunderbit มีเทมเพลตสำหรับเว็บยอดนิยม ช่วยให้เริ่มงานดึงข้อมูลทั่วไปได้เร็วขึ้น
- ใช้งานง่ายและเข้าถึงได้: หน้าตาแบบกดแล้วใช้ได้เลย มีผู้ช่วยที่เข้าใจง่าย ผู้ใช้จำนวนมากบอกว่าพร้อมใช้งานได้ภายในไม่กี่นาที
Thunderbit มีผู้ใช้งาน มากกว่า 200,000 คนทั่วโลก ทีมขายใช้สร้างรายชื่อ lead นายหน้าใช้รวบรวมประกาศอสังหาฯ และนักการตลาดใช้ติดตามคู่แข่ง — ทั้งหมดนี้โดยไม่ต้องเขียนโค้ดแม้แต่บรรทัดเดียว
ราคา: แพ็กเกจฟรี ใช้ได้ 6 หน้า/เดือน แพ็กเกจเสียเงินเริ่มต้นที่ $15.99/เดือน
Thunderbit คือสิ่งที่ใกล้เคียงกับการ “แปลงเว็บให้เป็นฐานข้อมูล” มากที่สุดเท่าที่ผมเคยเห็น — และสร้างมาเพื่อทุกคน ไม่ใช่แค่วิศวกร
ลองใช้ Thunderbit Chrome Extension
2. Crawl4AI
เหมาะสำหรับ: นักพัฒนาและทีมเทคนิคที่สร้าง pipeline เอง
Crawl4AI เป็นเฟรมเวิร์กโอเพนซอร์สบน Python ที่เน้นความเร็วและการ crawl ขนาดใหญ่ พร้อมออกแบบมาโดยคิดถึง การเชื่อมกับ LLM เป็นหลัก มันเร็วมาก รองรับ headless browser สำหรับคอนเทนต์แบบไดนามิก และจัดโครงสร้างข้อมูลที่สแครปได้เพื่อป้อนเข้าเวิร์กโฟลว์ AI ได้ง่าย
- เหมาะที่สุดสำหรับ: นักพัฒนาที่ต้องการ engine สำหรับ crawl ที่ทรงพลังและปรับแต่งได้
- ราคา: ฟรีและโอเพนซอร์สภายใต้ Apache 2.0 แบบต้องระบุที่มา คุณต้องโฮสต์และรันเอง
3. ScrapeGraphAI
เหมาะสำหรับ: นักพัฒนาและนักวิเคราะห์ที่สร้าง AI agent หรือ data pipeline ที่ซับซ้อน
ScrapeGraphAI เป็นไลบรารี Python แบบโอเพนซอร์สที่ขับเคลื่อนด้วย prompt และแปลงเว็บไซต์เป็นกราฟข้อมูลที่มีโครงสร้างโดยใช้ LLM คุณสามารถเขียน prompt เช่น “ดึงชื่อสินค้า ราคา และเรตติ้งทั้งหมดจาก 5 หน้าแรก” แล้วมันจะสร้าง workflow สำหรับสแครปให้คุณ (source)
- เหมาะที่สุดสำหรับ: ผู้ใช้สายเทคนิคที่ต้องการการสแครปที่ยืดหยุ่นและสั่งด้วย prompt ได้
- ราคา: ฟรีสำหรับไลบรารีโอเพนซอร์ส; cloud API เริ่มต้นที่ $20/เดือน
4. Firecrawl
เหมาะสำหรับ: นักพัฒนาที่สร้าง AI agent หรือ data pipeline ขนาดใหญ่
Firecrawl เป็นแพลตฟอร์มและ API สำหรับ crawling ที่เน้น AI และเปลี่ยนทั้งเว็บไซต์ให้เป็นข้อมูลแบบ “LLM-ready” (source) มันส่งออกเป็น Markdown หรือ JSON รองรับคอนเทนต์แบบไดนามิก และเชื่อมกับเฟรมเวิร์กอย่าง LangChain และ LlamaIndex ได้
- เหมาะที่สุดสำหรับ: นักพัฒนาที่ต้องป้อนข้อมูลเว็บสดเข้าโมเดล AI
- ราคา: โค้ดหลักแบบโอเพนซอร์สใช้ฟรี แผน Hobby บน cloud ราคา $19 แบบจ่ายรายเดือน หรือ $16/เดือนเมื่อชำระรายปี และมีแพ็กเกจฟรีแบบจำกัดให้ใช้งาน
5. Browse AI
เหมาะสำหรับ: ผู้ใช้ธุรกิจ growth hacker และนักวิเคราะห์
Browse AI เป็นแพลตฟอร์ม no-code ที่มี อินเทอร์เฟซแบบกดแล้วเลือก คุณ “ฝึก” หุ่นยนต์โดยคลิกข้อมูลที่ต้องการ แล้ว AI จะเรียนรู้รูปแบบนั้นเพื่อนำไปใช้กับการสแครปครั้งต่อไป รองรับการล็อกอิน infinite scroll และใช้เฝ้าดูเว็บไซต์เมื่อมีการเปลี่ยนแปลงได้
- เหมาะที่สุดสำหรับ: ผู้ใช้ที่ไม่ถนัดเทคนิค แต่อยากทำงานเก็บและเฝ้าดูข้อมูลแบบอัตโนมัติ
- ราคา: มีแผนฟรี (50 credits/เดือน) แผน Personal เริ่มที่ $19/เดือนเมื่อจ่ายรายปี และราคาแบบจ่ายรายเดือนคือ $48/เดือน
6. LLM Scraper
เหมาะสำหรับ: นักพัฒนาที่อยากให้ AI ช่วยตีความข้อมูล
LLM Scraper เป็นไลบรารี JavaScript/TypeScript แบบโอเพนซอร์ส ที่ให้คุณ กำหนด schema ของข้อมูล แล้วให้ LLM ดึงข้อมูลนั้นจากหน้าเว็บใดก็ได้ มันสร้างบน Playwright รองรับผู้ให้บริการ LLM หลายราย และยังสร้างโค้ดที่นำกลับมาใช้ซ้ำได้ด้วย
- เหมาะที่สุดสำหรับ: นักพัฒนาที่อยากให้ LLM ช่วยแปลงหน้าเว็บเป็นข้อมูลแบบมีโครงสร้าง
- ราคา: ฟรี (MIT license)
7. Reader (Jina Reader)
เหมาะสำหรับ: นักพัฒนาที่สร้างแอป LLM, แชตบอท หรือเครื่องมือสรุปข้อมูล
Jina Reader ซึ่งปัจจุบันเป็นส่วนหนึ่งของ Elastic คือ API ที่ดึง ข้อความสะอาดและข้อมูลแบบมีโครงสร้างจากหน้าเว็บ (รวมถึง PDF/รูปภาพ) แล้วส่งกลับมาเป็น Markdown หรือ JSON ที่พร้อมใช้กับ LLM นอกจากนี้ยังสร้างคำบรรยายภาพได้ด้วย
- เหมาะที่สุดสำหรับ: การดึงคอนเทนต์ที่อ่านง่ายและสะอาดให้ LLM หรือระบบถาม-ตอบ
- ราคา: API ใช้ได้ฟรี (ไม่ต้องใช้ key สำหรับการใช้งานพื้นฐาน)
8. Bright Data
เหมาะสำหรับ: องค์กรขนาดใหญ่และผู้ใช้มืออาชีพที่ต้องการสเกล ความสอดคล้อง และความเสถียร
Bright Data เป็นผู้เล่นรายใหญ่ในอุตสาหกรรม web data มีเครือข่าย proxy ขนาดมหาศาลและ เครื่องมือสแครปปิ้งที่ขับเคลื่อนด้วย AI ให้บริการสแครปเปอร์สำเร็จรูป Web Scraper API แบบทั่วไป และฟีดข้อมูลที่พร้อมใช้กับ LLM
- เหมาะที่สุดสำหรับ: องค์กรที่ต้องการข้อมูลเว็บที่เชื่อถือได้ในระดับใหญ่
- ราคา: คิดตามการใช้งานแบบพรีเมียม มีทดลองใช้ฟรี
9. Octoparse
เหมาะสำหรับ: ผู้ใช้ที่ไม่ถนัดเทคนิคไปจนถึงกึ่งเทคนิค
Octoparse เป็นเครื่องมือ no-code ที่อยู่มานาน มี ตัวออกแบบเวิร์กโฟลว์แบบภาพ และระบบ auto-detect ที่ขับเคลื่อนด้วย AI รองรับการล็อกอิน infinite scroll และส่งออกข้อมูลได้หลายรูปแบบ

- เหมาะที่สุดสำหรับ: นักวิเคราะห์ เจ้าของธุรกิจขนาดเล็ก หรือผู้ทำวิจัย
- ราคา: มีแผนฟรี แผน Standard ราคา $83 แบบจ่ายรายเดือน หรือ $69/เดือนเมื่อจ่ายรายปี
10. Apify
เหมาะสำหรับ: นักพัฒนาและทีมเทคนิคที่ต้องการสแครป/อัตโนมัติแบบกำหนดเอง
Apify คือแพลตฟอร์มบนคลาวด์สำหรับรันสคริปต์สแครปปิ้ง (เรียกว่า “actors”) และมี store ที่รวม actors สำเร็จรูปไว้มากมาย มันรองรับการขยายระบบ เชื่อมกับ AI และจัดการ proxy ได้

- เหมาะที่สุดสำหรับ: นักพัฒนาที่อยากรันสคริปต์เฉพาะทางบนคลาวด์
- ราคา: แผนฟรีรวมการใช้งาน $5 ต่อเดือน แผน Starter เริ่มที่ $29/เดือน
11. Zyte (Scrapy Cloud)
เหมาะสำหรับ: นักพัฒนาและบริษัทที่ต้องการการสแครประดับองค์กร
Zyte คือบริษัทที่อยู่เบื้องหลัง Scrapy และมีแพลตฟอร์มบนคลาวด์พร้อม การดึงข้อมูลอัตโนมัติด้วย AI รองรับการตั้งเวลา การใช้ proxy และโปรเจกต์ขนาดใหญ่
- เหมาะที่สุดสำหรับ: ทีมพัฒนาที่รันโปรเจกต์สแครประยะยาว
- ราคา: มีเครดิตทดลอง $5 จากนั้น Zyte API จะคิดตามการใช้งานแบบ pay-as-you-go โดยพิจารณาจากประเภทคำขอและผลลัพธ์ที่สำเร็จ
12. Webscraper.io
เหมาะสำหรับ: มือใหม่ นักข่าว และนักวิจัย
Webscraper.io เป็น Chrome extension ยอดนิยม สำหรับการดึงข้อมูลแบบกดแล้วเลือก ใช้งานง่าย ฟรีสำหรับการใช้งานบนเครื่อง และยังมีบริการ cloud สำหรับงานใหญ่ขึ้น
- เหมาะที่สุดสำหรับ: งานสแครปแบบเร็ว ๆ หรือทำครั้งเดียว
- ราคา: ส่วนขยายใช้ฟรี; แผน cloud เริ่มที่ประมาณ $50/เดือน
13. ParseHub
เหมาะสำหรับ: ผู้ใช้ที่ไม่ถนัดเทคนิค แต่ต้องการพลังมากกว่าเครื่องมือพื้นฐาน
ParseHub เป็นแอปเดสก์ท็อปที่มีเวิร์กโฟลว์แบบภาพสำหรับสแครปคอนเทนต์ไดนามิก รวมถึงแผนที่และฟอร์มต่าง ๆ มันรันงานบนคลาวด์ได้และมี API ให้ใช้งาน
- เหมาะที่สุดสำหรับ: นักการตลาดดิจิทัล นักวิเคราะห์ และนักข่าว
- ราคา: มีแผนฟรี (200 pages/run); แผนเสียเงินเริ่มที่ $189/เดือน
14. Diffbot
เหมาะสำหรับ: องค์กรและบริษัท AI ที่ต้องการข้อมูลเว็บแบบมีโครงสร้างในระดับใหญ่
Diffbot ใช้ computer vision และ NLP เพื่อ ดึงข้อมูลจากหน้าเว็บใดก็ได้โดยอัตโนมัติ พร้อม API สำหรับบทความ สินค้า และ knowledge graph ขนาดใหญ่
- เหมาะที่สุดสำหรับ: market intelligence, การเงิน และข้อมูลสำหรับฝึก AI
- ราคา: มีแผนฟรี 10,000 credits/เดือน; แผนเสียเงินเริ่มที่ $299/เดือน
15. DataMiner
เหมาะสำหรับ: ผู้ใช้ที่ไม่ถนัดเทคนิค โดยเฉพาะสายขาย การตลาด และงานข่าว
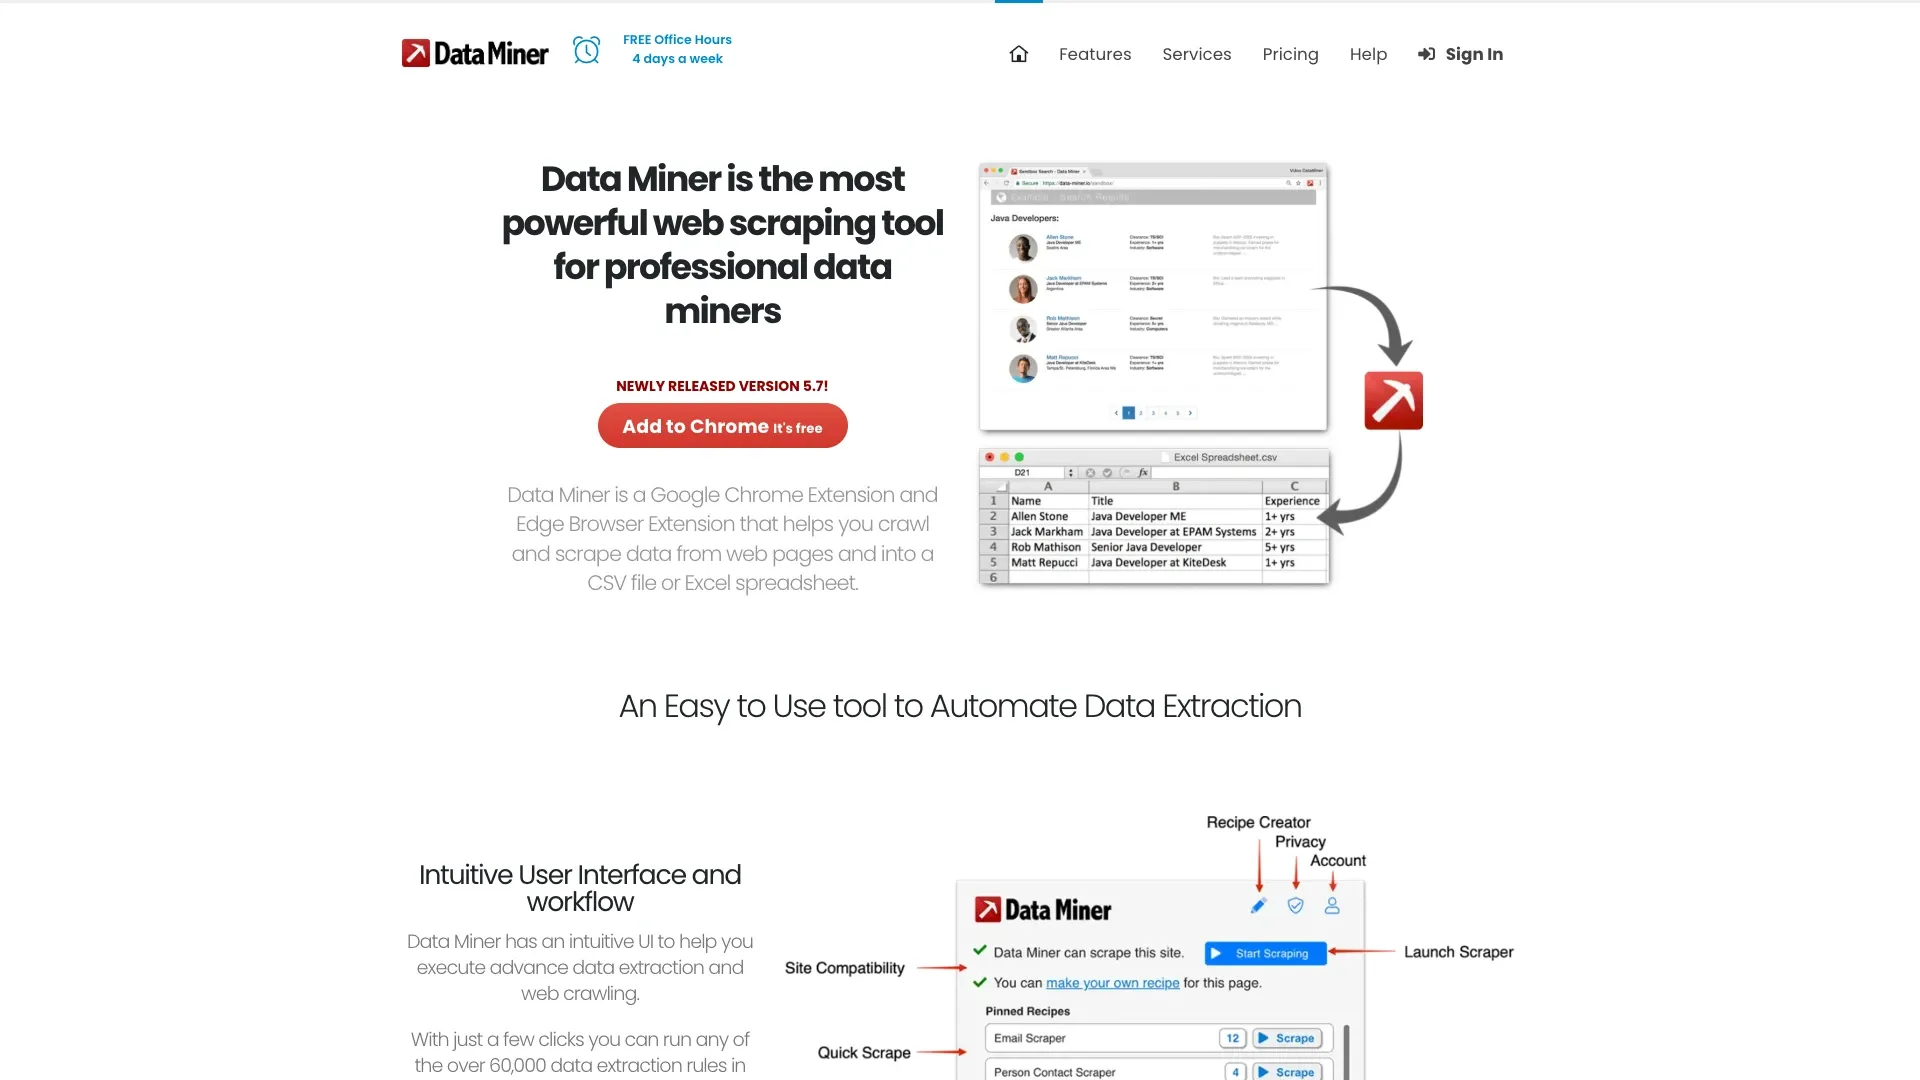
DataMiner เป็น Chrome extension สำหรับการดึงข้อมูลจากเว็บแบบเร็ว ๆ ด้วยการกดเลือก มีคลัง “recipes” สำเร็จรูปจำนวนมาก และส่งออกไป Google Sheets ได้โดยตรง
- เหมาะที่สุดสำหรับ: งานด่วน เช่น ส่งออกตารางหรือรายชื่อไปยังสเปรดชีต
- ราคา: มีแผนฟรี (500 pages/เดือน); แผน Solo เริ่มที่ $19.99/เดือน
เปรียบเทียบเครื่องมือ AI Web Scraper ชั้นนำ: ตัวไหนเหมาะกับคุณ?
นี่คือภาพรวมแบบสั้น ๆ เพื่อช่วยคุณเลือกเครื่องมือที่ใช่:
| เครื่องมือ | การใช้ AI/LLM | ความง่ายในการใช้งาน | ผลลัพธ์/การเชื่อมต่อ | เหมาะสำหรับ | ราคา |
|---|---|---|---|---|---|
| Thunderbit | Agentic One Click Extract ตรวจจับฟิลด์และจัดโครงสร้างข้อมูล | ง่ายที่สุด (ส่วนขยายแบบ no-code) | ส่งออกไป Sheets, Airtable, Notion | ทีมที่ไม่ถนัดเทคนิค | ฟรี 6 หน้า/เดือน; เสียเงินเริ่ม $15.99/เดือน |
| Crawl4AI | รองรับการ crawl ที่พร้อมใช้กับ AI; เชื่อม LLM ได้ | ยาก (เขียน Python) | ไลบรารี/CLI; เชื่อมผ่านโค้ด | นักพัฒนาที่ต้องการ data pipeline เร็ว ๆ | ฟรี |
| ScrapeGraphAI | pipeline สั่งงานด้วย prompt สำหรับสแครป | ปานกลาง (ต้องเขียนโค้ดหรือใช้ API บ้าง) | API/SDK; JSON output | นักพัฒนา/นักวิเคราะห์ที่สร้าง AI agent | ฟรีแบบ OSS; API $20+/เดือน |
| Firecrawl | Crawl ให้เป็น Markdown/JSON ที่พร้อมใช้กับ LLM | ปานกลาง (ใช้ผ่าน API/SDK) | SDK (Py, Node ฯลฯ); เชื่อม LangChain ได้ | นักพัฒนาที่ป้อนข้อมูลเว็บสดเข้า AI | ฟรี; แผน Hobby $19/เดือน หรือ $16/เดือนเมื่อจ่ายรายปี |
| Browse AI | AI ช่วยคลิกและสั่งงาน | ง่าย (no-code) | เชื่อมกับแอปผ่าน Zapier | ผู้ใช้ทั่วไปที่ต้องการเฝ้าระวังเว็บอัตโนมัติ | ฟรี 50 credits; $19/เดือนรายปี หรือ $48/เดือน |
| LLM Scraper | ใช้ LLM แปลงหน้าเว็บตาม schema | ยาก (เขียน TS/JS) | ไลบรารีโค้ด; JSON output | นักพัฒนาที่อยากให้ AI ช่วย parsing | ฟรี (ใช้ LLM API ของตัวเอง) |
| Reader (Jina) | AI ดึงข้อความ/JSON | ง่าย (เรียก API แบบง่าย) | REST API ส่งกลับ Markdown/JSON | นักพัฒนาที่เสริม web search/content ให้ LLM | ฟรี API |
| Bright Data | API สแครปที่เสริม AI; เครือข่าย proxy ขนาดใหญ่ | ยาก (API, ต้องมีพื้นฐานเทคนิค) | API/SDK; data stream หรือ datasets | องค์กรที่ต้องการสเกล | คิดตามการใช้งาน |
| Octoparse | AI auto-detect รายการ | ปานกลาง (แอป no-code) | CSV/Excel, API สำหรับผลลัพธ์ | ผู้ใช้กึ่งเทคนิค | ฟรี; Standard $83/เดือน หรือ $69/เดือนรายปี |
| Apify | มีฟีเจอร์ AI บางส่วน (Actors, คู่มือ AI) | ยาก (เขียนสคริปต์) | API ครอบคลุม; เชื่อม LangChain ได้ | นักพัฒนาที่ต้องการสแครปบนคลาวด์แบบกำหนดเอง | ฟรี $5 usage; Starter $29/เดือน |
| Zyte (Scrapy) | auto extraction แบบ ML; ใช้เฟรมเวิร์ก Scrapy | ยาก (เขียน Python) | API, UI ของ Scrapy Cloud; JSON/CSV | ทีม dev, โปรเจกต์ระยะยาว | เครดิตทดลอง $5; คิดตามการใช้งาน |
| Webscraper.io | ไม่มี AI (เทมเพลตแบบ manual) | ง่าย (ส่วนขยายเบราว์เซอร์) | ดาวน์โหลด CSV, Cloud API | มือใหม่ งานสแครปเร็ว ๆ | ส่วนขยายฟรี; cloud ประมาณ $50/เดือน |
| ParseHub | ไม่มี LLM โดยตรง; ตัวสร้างเวิร์กโฟลว์แบบภาพ | ปานกลาง (แอป no-code) | JSON/CSV; API สำหรับงาน cloud | คนไม่เขียนโค้ดที่สแครปเว็บซับซ้อน | ฟรี 200 pages; เสียเงิน $189+/เดือน |
| Diffbot | AI vision/NLP สำหรับทุกหน้า; knowledge graph | ง่าย (เรียก API) | API (Article/Prod/...) + Query knowledge graph | องค์กร ข้อมูลเว็บแบบมีโครงสร้าง | ฟรี 10K credits; เสียเงินเริ่ม $299/เดือน |
| DataMiner | ไม่มี LLM; recipes จากคอมมูนิตี้ | ง่ายที่สุด (UI บนเบราว์เซอร์) | ส่งออก Excel/CSV; Google Sheets | ผู้ใช้ทั่วไปที่สแครปลงสเปรดชีต | ฟรี 500 หน้า/เดือน; Solo $19.99/เดือน |
หมวดหมู่ของเครื่องมือ: ตั้งแต่วิศวกรตัวจริงไปจนถึงเว็บสแครปเปอร์ที่เหมาะกับธุรกิจ
เพื่อให้เข้าใจลิสต์นี้ง่ายขึ้น มาจัดกลุ่มเครื่องมือออกเป็นหมวดหมู่กันก่อน:
1. ตัวแรงสายพัฒนาและโอเพนซอร์ส
- ตัวอย่าง: Crawl4AI, LLM Scraper, Apify, Zyte/Scrapy, Firecrawl
- จุดแข็ง: ยืดหยุ่นสูง ขยายระบบได้ และปรับแต่งได้ละเอียด เหมาะสำหรับสร้าง pipeline เฉพาะทางหรือเชื่อมกับโมเดล AI
- ข้อแลกเปลี่ยน: ต้องมีทักษะเขียนโค้ดและตั้งค่ามากกว่า
- กรณีใช้งาน: สร้าง data pipeline เอง สแครปเว็บที่ซับซ้อน หรือเชื่อมต่อกับระบบภายใน
2. เอเจนต์สแครปที่ผสาน AI
- ตัวอย่าง: Thunderbit, ScrapeGraphAI, Firecrawl, Reader (Jina), LLM Scraper
- จุดแข็ง: ลดช่องว่างระหว่างการดึงข้อมูลกับการเข้าใจข้อมูล อินเทอร์เฟซภาษาธรรมชาติทำให้เข้าถึงได้ง่าย
- ข้อแลกเปลี่ยน: บางตัวยังอยู่ในช่วงพัฒนา อาจยังไม่มีการควบคุมแบบละเอียดทุกจุด
- กรณีใช้งาน: ดึงข้อมูลหรือ dataset แบบเร็ว ๆ สร้าง autonomous agent หรือป้อนข้อมูลสดให้ LLM
3. เครื่องมือ no-code/low-code สำหรับธุรกิจ
- ตัวอย่าง: Thunderbit, Browse AI, Octoparse, ParseHub, Webscraper.io, DataMiner
- จุดแข็ง: ใช้งานง่าย แทบไม่ต้องเขียนโค้ด เหมาะกับงานธุรกิจที่ทำซ้ำบ่อย
- ข้อแลกเปลี่ยน: อาจรับมือเว็บที่ซับซ้อนมากหรือสเกลขนาดใหญ่มากได้ไม่ดีนัก
- กรณีใช้งาน: หาลูกค้าเป้าหมาย ติดตามคู่แข่ง งานวิจัย และดึงข้อมูลครั้งคราว
4. แพลตฟอร์มและบริการข้อมูลระดับองค์กร
- ตัวอย่าง: Bright Data, Diffbot, Zyte
- จุดแข็ง: โซลูชันครบชุด มีบริการจัดการให้ มีความสอดคล้องตามข้อกำหนด และเชื่อถือได้เมื่อใช้งานระดับใหญ่
- ข้อแลกเปลี่ยน: ราคาสูงกว่า และต้องใช้เวลา onboarding มากขึ้น
- กรณีใช้งาน: data pipeline ขนาดใหญ่ที่รันตลอดเวลา market intelligence และข้อมูลสำหรับฝึก AI
วิธีเลือก AI Web Crawler ให้เหมาะกับงานดึงข้อมูลจากหน้าเว็บของคุณ
Data Scraping คืออะไร และทำอย่างไร Get Started Free
การเลือกเครื่องมือที่ใช่บางทีก็ทำเอาปวดหัวได้เหมือนกัน งั้นมาดูแนวทางทีละขั้นตอนของผม:
- กำหนดเป้าหมายและความต้องการข้อมูลให้ชัด: คุณต้องการเว็บไหน ข้อมูลอะไร เก็บบ่อยแค่ไหน ปริมาณเท่าไร และจะเอาไปใช้ทำอะไร
- ประเมินทักษะทางเทคนิคของคุณ: ไม่เขียนโค้ดเลย? ลอง Thunderbit, Browse AI หรือ Octoparse ถ้าพอเขียนสคริปต์ได้บ้างให้ดู LLM Scraper หรือ DataMiner ถ้าเป็นสาย dev เต็มตัว Crawl4AI, Apify หรือ Zyte จะเหมาะกว่า
- พิจารณาความถี่และสเกล: งานครั้งเดียวใช้เครื่องมือฟรีได้ ถ้าต้องรันซ้ำให้มองหาฟีเจอร์ตั้งเวลา ถ้าเป็นงานขนาดใหญ่ให้ดูเครื่องมือระดับองค์กรหรือโอเพนซอร์สที่สเกลได้
- งบประมาณและโมเดลราคา: แผนฟรีดีสำหรับทดลองใช้งาน ส่วนแบบสมัครสมาชิกหรือคิดตามการใช้งานก็เหมาะต่างกันไปตามลักษณะงาน
- ทดลองและทำ proof of concept: ลองเครื่องมือสัก 2–3 ตัวกับข้อมูลจริงของคุณ ส่วนใหญ่มีแพ็กเกจฟรีให้ลอง
- การดูแลและซัพพอร์ต: ถ้าเว็บไซต์เปลี่ยนแล้วใครจะเป็นคนแก้? เครื่องมือ no-code ที่มี AI อาจแก้การเปลี่ยนเล็ก ๆ ได้เอง แต่โอเพนซอร์สจะขึ้นกับคุณหรือชุมชนผู้ใช้
- จับคู่เครื่องมือกับสถานการณ์ใช้งาน: ทีมขายดึง lead? Thunderbit หรือ Browse AI นักวิจัยเก็บทวีต? DataMiner หรือ Webscraper.io โมเดล AI ต้องการบทความข่าว? Jina Reader หรือ Zyte สร้างเว็บไซต์เปรียบเทียบ? Apify หรือ Zyte
- เตรียมแผนสำรองไว้เสมอ: บางครั้งเครื่องมือหนึ่งอาจใช้ไม่ได้กับบางเว็บ ควรมีตัวสำรองไว้
เครื่องมือที่ “ใช่” คือเครื่องมือที่พาคุณไปถึงข้อมูลที่ต้องการด้วยความติดขัดน้อยที่สุด และอยู่ในงบที่รับได้ บางครั้งอาจต้องใช้หลายเครื่องมือร่วมกัน
Thunderbit เทียบกับเครื่องมือ Web Scraper แบบเดิม: อะไรที่ทำให้มันโดดเด่น?
มาดูให้ชัดว่า Thunderbit แตกต่างอย่างไร:
- ตั้งค่าแบบ Agentic One-Click: คลิก One Click Extract แล้ว Thunderbit จะตรวจจับคอลัมน์ที่มีประโยชน์ให้ เลือก Run Now หรือปล่อยให้เริ่มงานอัตโนมัติได้เลย (source)
- ตั้งค่าน้อย: Thunderbit ตรวจจับโครงสร้างหน้าที่พบบ่อย pagination และลิงก์ไปหน้าย่อยได้ ช่วยลดขั้นตอนตั้งค่ามือ (source)
- ทำความสะอาดและเพิ่มมูลค่าข้อมูลด้วย AI: สรุป จัดหมวดหมู่ แปล และเติมข้อมูลให้ระหว่างการสแครปได้ (source)
- ปวดหัวเรื่องบำรุงรักษาน้อยลง: AI ของ Thunderbit ทนต่อการเปลี่ยนแปลงเล็ก ๆ ของเว็บได้ดี ทำให้สคริปต์พังน้อยลง
- เชื่อมต่อกับเครื่องมือธุรกิจได้โดยตรง: ส่งออกไป Google Sheets, Airtable, Notion ได้เลย ไม่ต้องมานั่งจัดการ CSV ให้ยุ่งยาก (source)
- ไปถึงผลลัพธ์ได้เร็ว: จากไอเดียถึงข้อมูล ใช้เวลาเป็นนาที ไม่ใช่เป็นวัน
- เรียนรู้ง่าย: ถ้าคุณเปิดเว็บเป็น และบอกได้ว่าต้องการอะไร Thunderbit ก็ใช้งานได้
- ยืดหยุ่น: ดึงข้อมูลจากเว็บไซต์ PDF รูปภาพ และอื่น ๆ ได้ด้วยเครื่องมือเดียว
Thunderbit ไม่ใช่แค่สแครปเปอร์ แต่มันเป็นผู้ช่วยด้านข้อมูลที่เข้ากับเวิร์กโฟลว์ของคุณ ไม่ว่าคุณจะอยู่ในสายขาย การตลาด อีคอมเมิร์ซ หรืออสังหาฯ
ลองใช้ Thunderbit AI Web Scraper
แนวปฏิบัติที่ดีที่สุดสำหรับการดึงข้อมูลจากหน้าเว็บด้วย AI Web Scraper
ถ้าอยากใช้ AI web scraper ให้คุ้มที่สุด นี่คือคำแนะนำหลักของผม:
- กำหนดความต้องการข้อมูลให้ชัดเจน: รู้ว่าต้องการฟิลด์อะไร กี่หน้า และอยากได้ข้อมูลในรูปแบบไหน
- ใช้คำแนะนำจาก AI ให้เต็มที่: ใช้การตรวจจับฟิลด์และคำแนะนำของเครื่องมือ เพื่อไม่พลาดข้อมูลสำคัญ (source)
- เริ่มจากเล็ก ๆ แล้วตรวจสอบผลลัพธ์: ทดสอบกับตัวอย่างขนาดเล็ก เช็กผล แล้วค่อยปรับ
- รองรับคอนเทนต์แบบไดนามิก: ตรวจให้แน่ใจว่าเครื่องมือรองรับคอนเทนต์และการโต้ตอบแบบไดนามิก เช่น pagination, infinite scroll
- เคารพนโยบายเว็บไซต์: ตรวจ robots.txt หลีกเลี่ยงการสแครปข้อมูลอ่อนไหว และเคารพ rate limit
- เชื่อมเข้าระบบเพื่อทำงานอัตโนมัติ: ใช้ฟีเจอร์ export และ webhook เพื่อส่งข้อมูลที่สแครปได้เข้าเวิร์กโฟลว์ของคุณโดยตรง
- รักษาคุณภาพข้อมูล: ตรวจความสมเหตุสมผลของข้อมูล ใช้ post-processing และติดตามข้อผิดพลาด
- เขียน prompt ให้กระชับ: ถ้าใช้เครื่องมือที่ขับเคลื่อนด้วย AI คำสั่งที่ชัดและเจาะจงจะได้ผลดีกว่า
- เรียนรู้จากคอมมูนิตี้: เข้าร่วมฟอรั่มและชุมชนเพื่อเก็บทิปส์และแนวทางแก้ปัญหา
- อัปเดตสม่ำเสมอ: เครื่องมือ AI เปลี่ยนไว คอยติดตามฟีเจอร์ใหม่ ๆ และการปรับปรุงอยู่เสมอ
อนาคตของ Web Scraping: AI, LLM และการเติบโตของเอเจนต์สแครปแบบใช้ภาษาธรรมชาติ
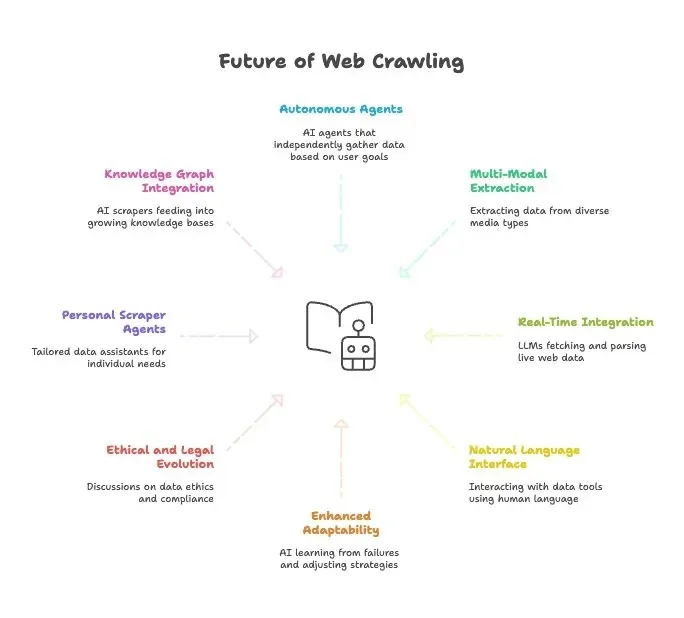
เมื่อมองไปข้างหน้า การผสานระหว่าง AI กับ web scraping จะยิ่งเร่งตัวขึ้น:
- เอเจนต์สแครปที่ทำงานได้เองเต็มรูปแบบ: อีกไม่นาน คุณจะบอกเป้าหมายปลายทางกับ AI agent แล้วมันจะหาวิธีเอาข้อมูลมาให้เอง
- ดึงข้อมูลได้หลายรูปแบบ: สแครปเปอร์จะดึงข้อมูลจากข้อความ รูปภาพ PDF และแม้แต่วิดีโอได้
- เชื่อมต่อแบบเรียลไทม์กับโมเดล AI: LLM จะมีโมดูลในตัวสำหรับเรียกและตีความข้อมูลเว็บสด
- ทุกอย่างใช้ภาษาคน: เราจะคุยกับเครื่องมือข้อมูลเหมือนคุยกับคน ทำให้การเก็บและแปลงข้อมูลเข้าถึงได้กับทุกคน
- ปรับตัวเก่งขึ้น: AI scraper จะเรียนรู้จากความล้มเหลวและปรับกลยุทธ์เองโดยอัตโนมัติ
- ประเด็นด้านจริยธรรมและกฎหมายจะชัดขึ้น: คาดว่าจะมีการคุยเรื่องจริยธรรมข้อมูล การปฏิบัติตามข้อกำหนด และการใช้งานอย่างเป็นธรรมมากขึ้น
- ผู้ช่วยสแครปส่วนตัว: ลองนึกภาพผู้ช่วยข้อมูลส่วนตัวที่คอยรวบรวมข่าว งานรับสมัคร และข้อมูลอื่น ๆ ตามความต้องการของคุณ
- เชื่อมกับ knowledge graph: AI scraper จะส่งข้อมูลเข้า knowledge base ที่เติบโตต่อเนื่อง ทำให้ AI ฉลาดขึ้นเรื่อย ๆ
สรุปสั้น ๆ คือ อนาคตของ web scraping ผูกพันอยู่กับอนาคตของ AI อย่างแยกไม่ออก เครื่องมือเหล่านี้ฉลาดขึ้น อัตโนมัติมากขึ้น และเข้าถึงง่ายขึ้นทุกวัน
บทสรุป: สร้างมูลค่าทางธุรกิจด้วย AI Web Crawler ที่ใช่
เว็บสแครปปิ้งจากที่เคยเป็นทักษะเฉพาะทาง กลายมาเป็นความสามารถหลักของธุรกิจได้แล้ว เพราะ AI เครื่องมือทั้ง 15 ตัวที่ผมพูดถึงในบทความนี้สะท้อนสิ่งที่ดีที่สุดของปี 2026 ตั้งแต่ตัวแรงสาย dev ไปจนถึงผู้ช่วยที่ใช้ง่ายสำหรับธุรกิจ
ความลับที่แท้จริงคืออะไร? การเลือกเครื่องมือที่เหมาะสามารถเพิ่มมูลค่าที่คุณได้จากข้อมูลเว็บอย่างมหาศาล สำหรับทีมที่ไม่ถนัดเทคนิค Thunderbit คือวิธีที่ง่ายที่สุดในการเปลี่ยนเว็บให้เป็นฐานข้อมูลที่มีโครงสร้างและพร้อมวิเคราะห์ — ไม่ต้องเขียนโค้ด ไม่ต้องวุ่นวาย แค่ได้ผลลัพธ์
ดังนั้น ไม่ว่าคุณจะกำลังรวบรวม lead ติดตามคู่แข่ง หรือป้อนข้อมูลให้โมเดล AI รุ่นใหม่ ลองใช้เวลาประเมินความต้องการ ทดลองเครื่องมือหลายตัว และดูว่าอะไรเหมาะกับคุณที่สุด และถ้าอยากสัมผัสอนาคตของเว็บสแครปปิ้งตั้งแต่วันนี้ ลองใช้ Thunderbit ได้เลย อินไซต์ที่คุณต้องการอยู่แค่ปลายนิ้วพิมพ์คำสั่งเท่านั้น
อยากอ่านเพิ่มเติมไหม? ดู Thunderbit Blog สำหรับบทความเชิงลึก คู่มือสอนใช้งาน และอัปเดตล่าสุดเกี่ยวกับการดึงข้อมูลด้วย AI
อ่านเพิ่มเติม:
- Data Scraping คืออะไร และทำอย่างไรในปี 2026
- วิธีดึงข้อมูลเว็บไซต์ลง Excel ด้วย AI
- เครื่องมือและซอฟต์แวร์ Web Scraping ที่ดีที่สุดในปี 2026
ลองใช้ AI Web Scraper Get Started Free
คำถามที่พบบ่อย
1. AI web crawler คืออะไร และต่างจากเว็บสแครปเปอร์แบบเดิมอย่างไร?
AI web crawler ใช้ natural language processing และ machine learning เพื่อเข้าใจ ดึง และจัดโครงสร้างข้อมูลจากเว็บ ต่างจากสแครปเปอร์แบบเดิมที่ต้องเขียนโค้ดเองและใช้ XPath selectors เครื่องมือ AI รับมือคอนเทนต์แบบไดนามิก ปรับตัวกับการเปลี่ยนเลย์เอาต์ได้ และตีความคำสั่งของผู้ใช้เป็นภาษาอังกฤษธรรมดาได้
2. ใครควรใช้เครื่องมือ AI web scraping อย่าง Thunderbit?
Thunderbit ออกแบบมาสำหรับทั้งผู้ใช้ที่ไม่ถนัดเทคนิคและผู้ใช้สายเทคนิค เหมาะกับงานขาย การตลาด ปฏิบัติการ วิจัย และอีคอมเมิร์ซ ที่ต้องการดึงข้อมูลแบบมีโครงสร้างจากเว็บไซต์ PDF หรือรูปภาพ โดยไม่ต้องเขียนโค้ดเลย
3. ฟีเจอร์อะไรที่ทำให้ Thunderbit เด่นกว่า AI web crawler ตัวอื่น?
Thunderbit มีอินเทอร์เฟซภาษาธรรมชาติ การ crawl หลายระดับ การจัดโครงสร้างข้อมูลอัตโนมัติ รองรับ OCR และส่งออกไปยังแพลตฟอร์มอย่าง Google Sheets และ Airtable ได้ลื่นไหล นอกจากนี้ยังมี AI ช่วยแนะนำฟิลด์และเทมเพลตสำเร็จรูปสำหรับเว็บยอดนิยม
4. ในปี 2026 มีตัวเลือกฟรีสำหรับ AI web scraping ไหม?
มี Thunderbit, Browse AI, DataMiner และ Diffbot มีแผนฟรีที่จำกัดการใช้งาน สำหรับนักพัฒนา ตัวเลือกโอเพนซอร์สอย่าง Crawl4AI และ ScrapeGraphAI ให้ฟังก์ชันหลักโดยไม่เสียค่าซอฟต์แวร์ แต่ต้องตั้งค่าทางเทคนิคเอง และอาจมีค่าโฮสต์หรือค่าโมเดลเพิ่มเติม
5. จะเลือก AI web crawler ที่เหมาะกับความต้องการของฉันได้อย่างไร?
เริ่มจากกำหนดเป้าหมายข้อมูล ทักษะทางเทคนิค งบประมาณ และสเกลที่ต้องการ หากอยากได้โซลูชันแบบ no-code ใช้งานง่าย Thunderbit หรือ Browse AI เป็นตัวเลือกที่ดี ถ้าต้องการงานระดับใหญ่หรือแบบกำหนดเอง Apify หรือ Bright Data จะเหมาะกว่า




