
สรุปผู้บริหาร
เราดึงไฟล์ robots.txt ของทุกโดเมนในรายการ Tranco อันดับท็อป 10,000 ของเว็บไซต์ที่มีทราฟฟิกสูงที่สุดในโลก จากนั้นจึงแยกวิเคราะห์แต่ละไฟล์ด้วยพาร์เซอร์ที่สอดคล้องกับ RFC 9309 จัดหมวดหมู่ไฟล์ตามนโยบายบอท AI ที่เว็บไซต์นั้นใช้ (ถ้ามี) และนับว่าเว็บไซต์ที่มีผู้เข้าชมมากที่สุดในโลกมีสัดส่วนเท่าไรที่พยายามบล็อก ChatGPT, Claude, Perplexity, Gemini, Common Crawl, Bytespider, Apple Intelligence และตัวรวบรวมข้อมูลอื่น ๆ ที่ใช้ฝึกและให้บริการโมเดลภาษาขนาดใหญ่ในปี 2026
ตัวเลขสำคัญจากตัวอย่าง 7,248 เว็บไซต์ที่เราสามารถอ่าน robots.txt ได้อย่างชัดเจน:
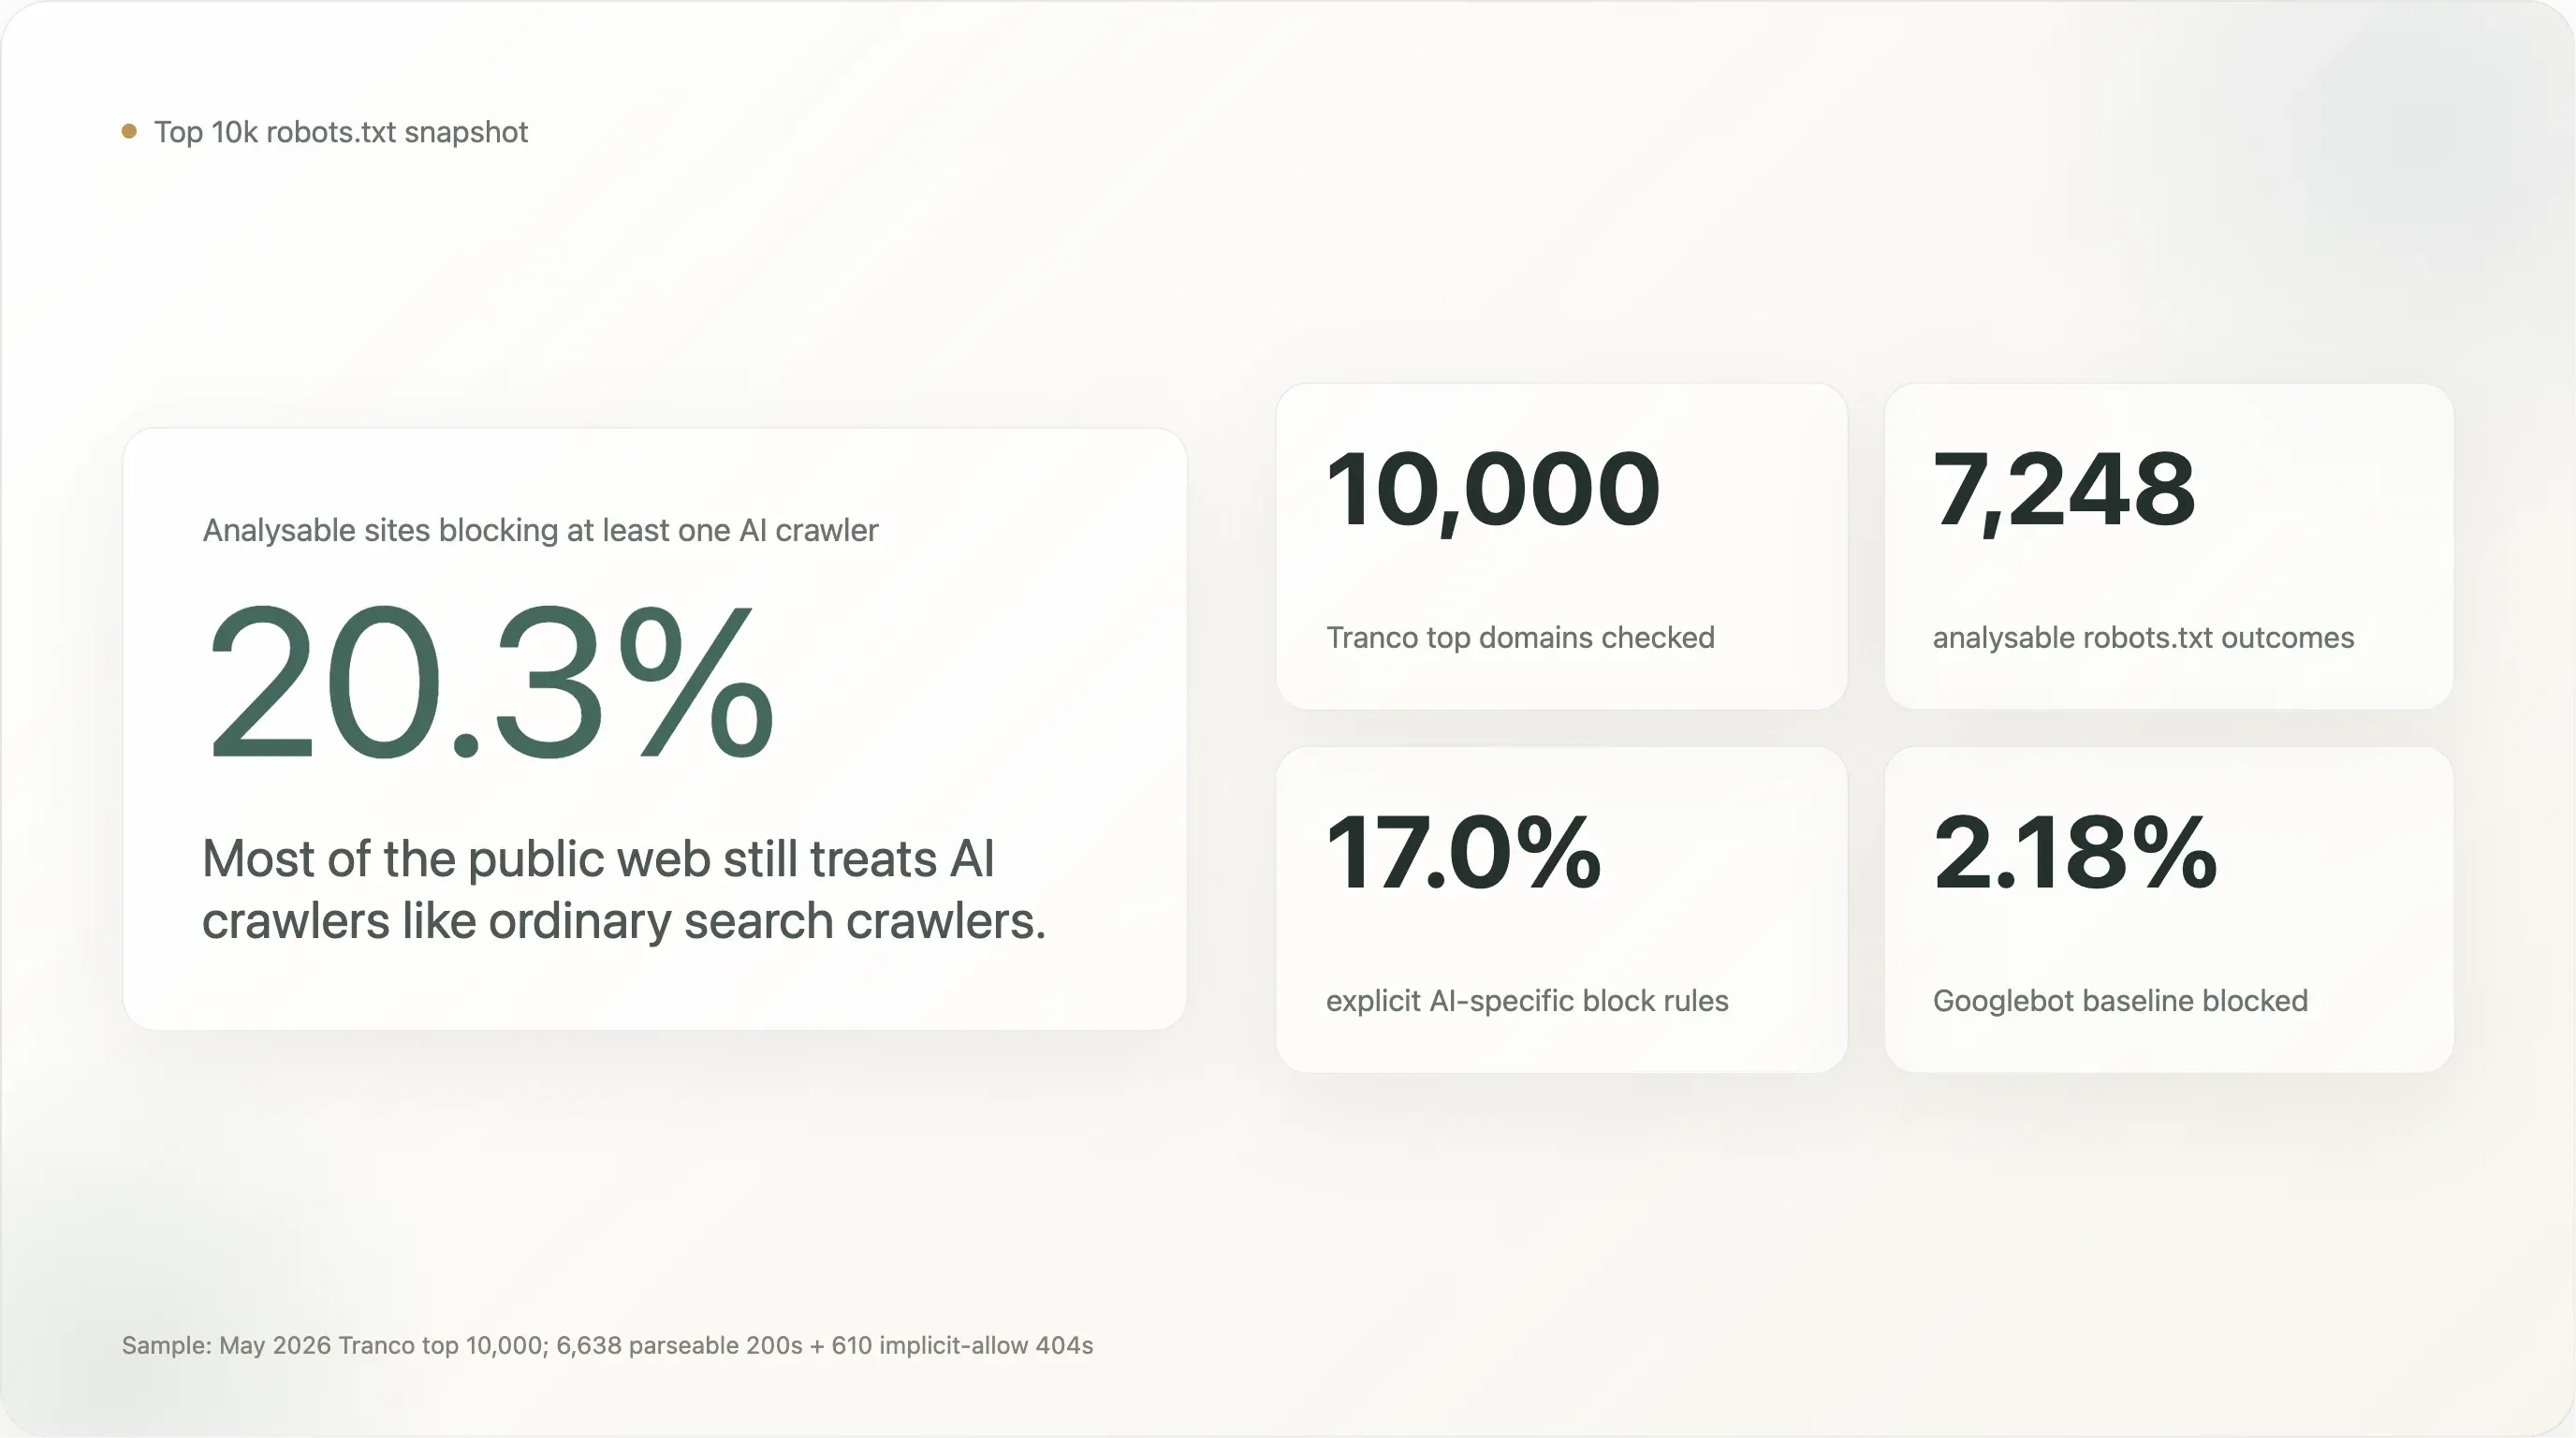
20.3% ของเว็บไซต์ท็อป 10,000 ของโลกบล็อก AI crawler อย่างน้อยหนึ่งตัว 17.0% มีการเขียนกฎเฉพาะสำหรับ AI โดยตั้งใจ ส่วนอีก 80% ปล่อยให้ AI crawler เป็นที่ต้อนรับพอ ๆ กับ Googlebot
6 ข้อค้นพบที่เปลี่ยนภาพรวมของเรื่องนี้:
- องค์กรข่าวบล็อกสูงถึง 47% — สูงที่สุดในทุกอุตสาหกรรม ข่าวเยอรมนีสูงสุดที่ 88% ข่าวฝรั่งเศส 80% และข่าวรัสเซีย 0% กรอบกฎหมาย ไม่ใช่เทคโนโลยีหรือเศรษฐศาสตร์อุตสาหกรรม คือปัจจัยหลัก
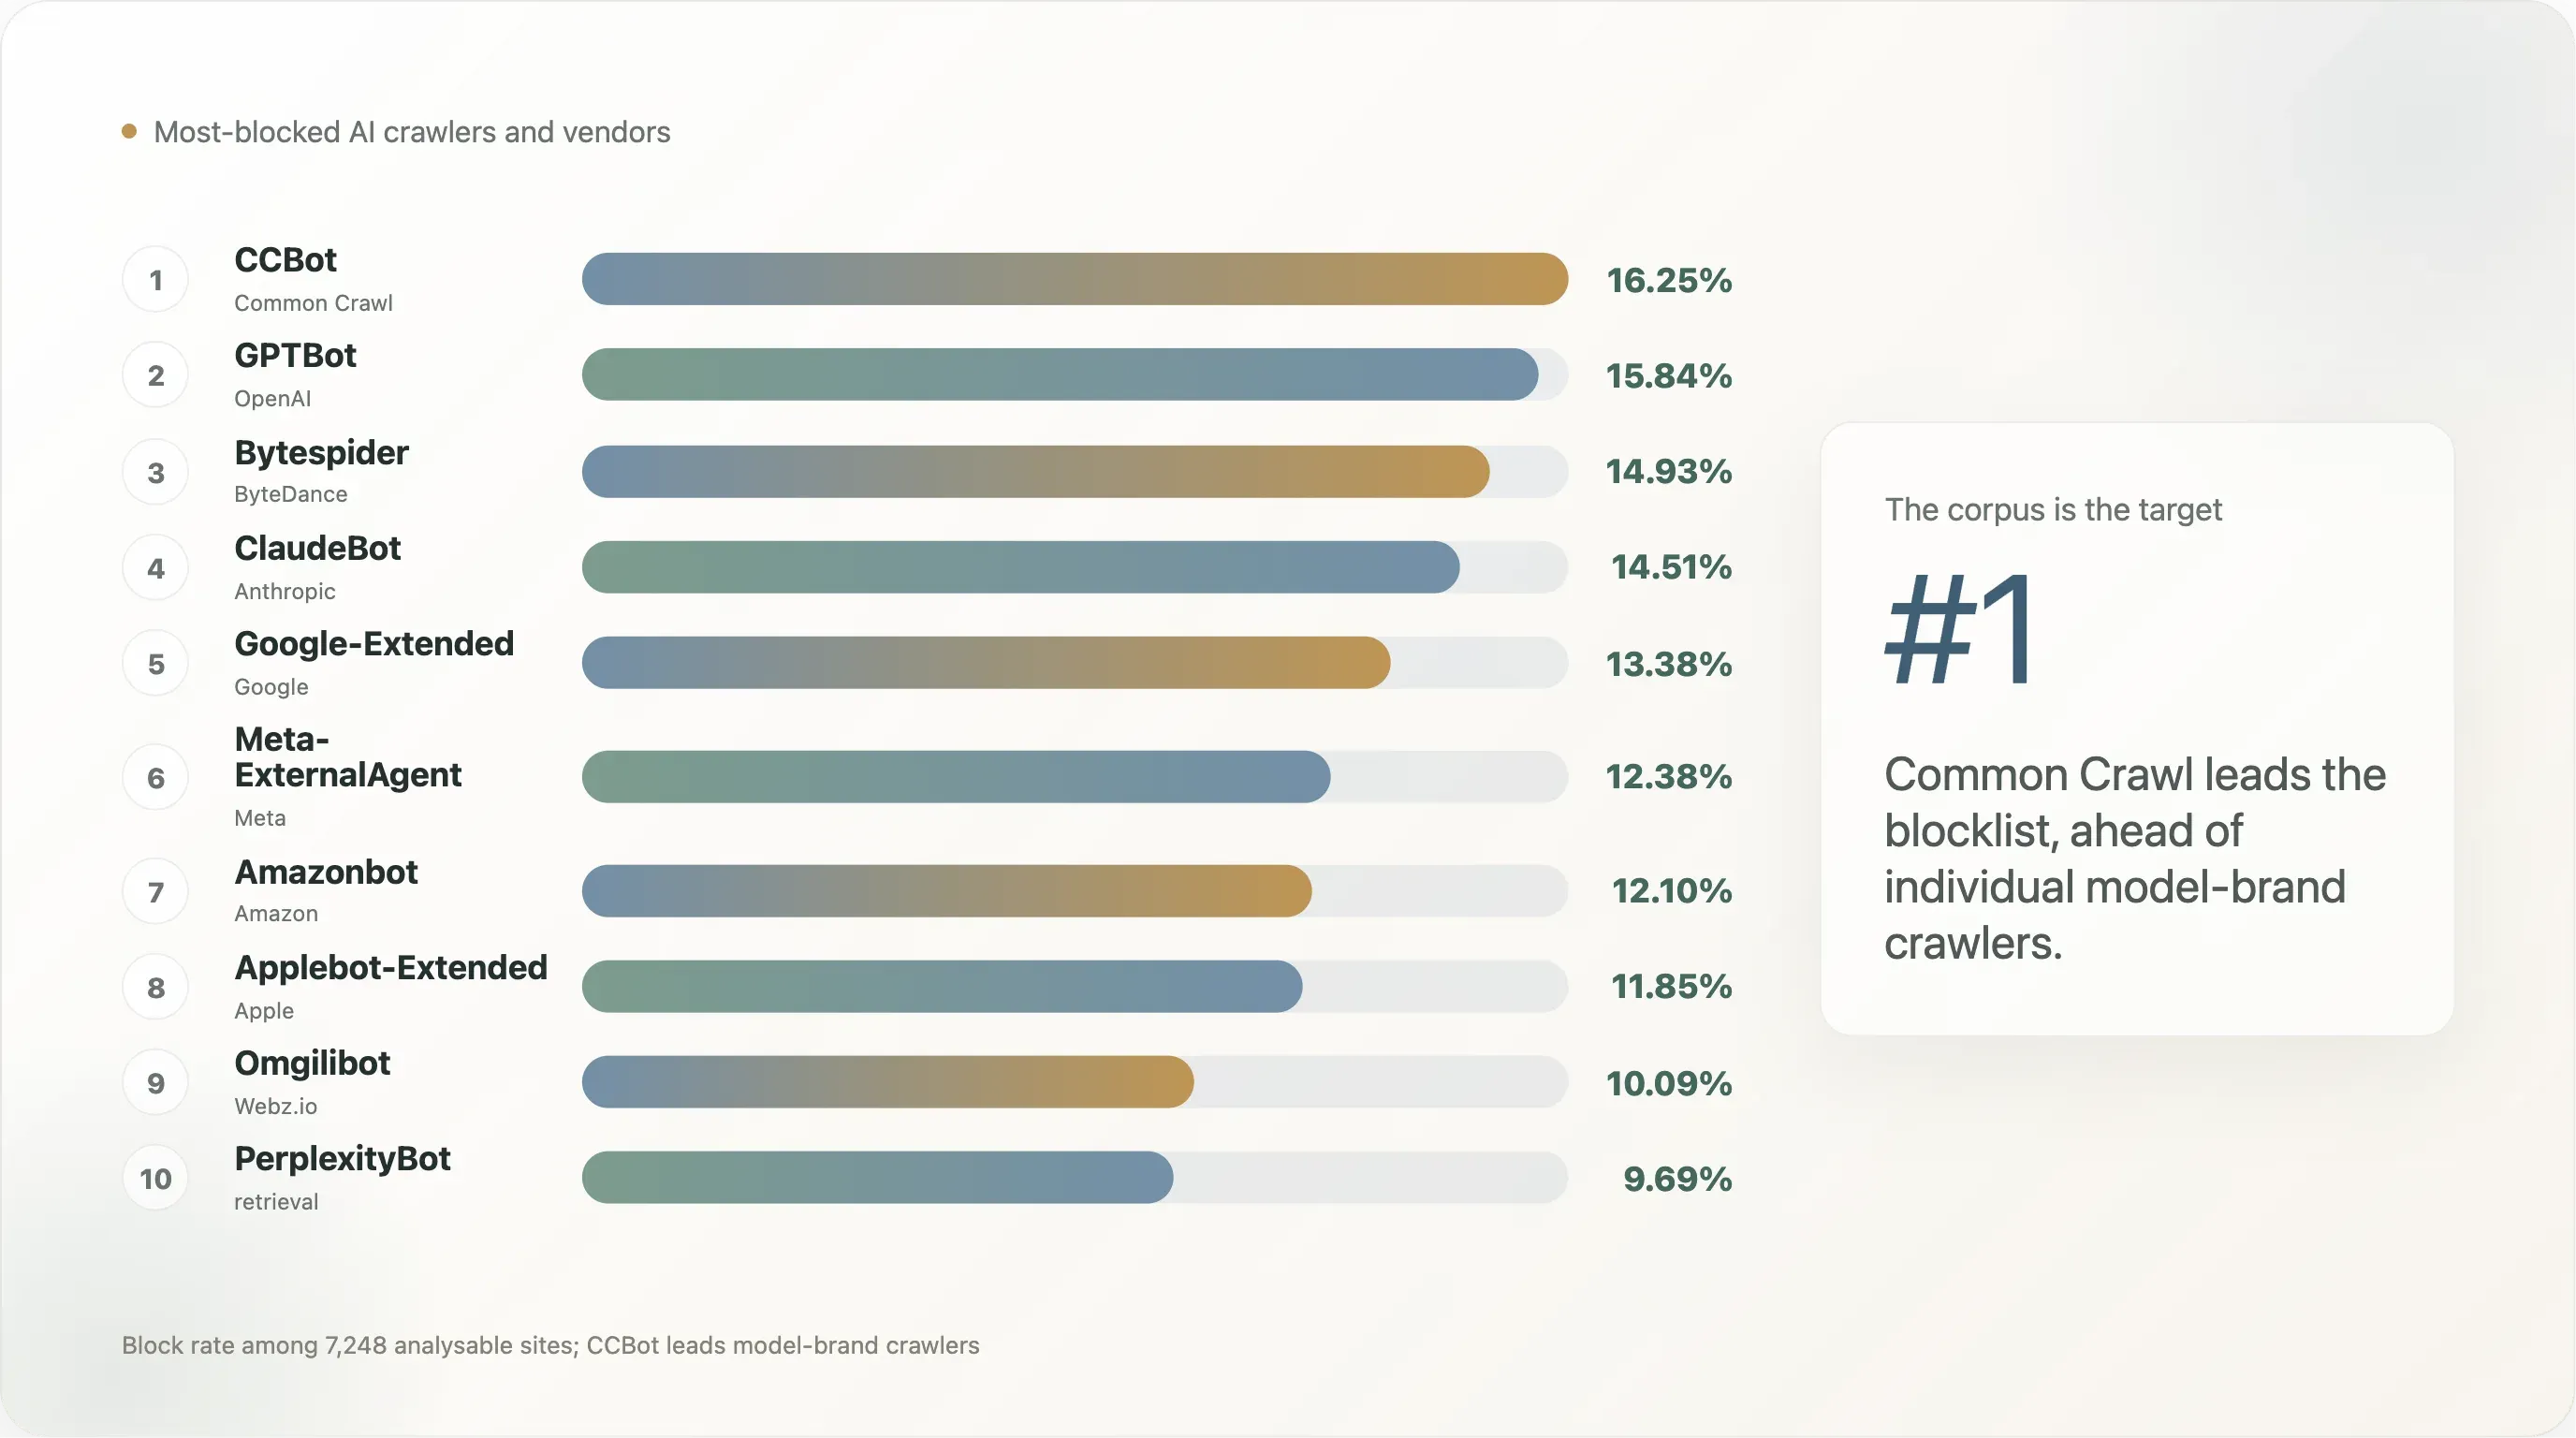
CCBot(Common Crawl) คือบอทที่ถูกบล็อกมากที่สุดที่ 16.3% — นำหน้าGPTBot(15.8%) และBytespider(14.9%) สำนักพิมพ์มุ่งเป้าไปที่ คอร์ปัสสำหรับการฝึก ไม่ใช่ชื่อแบรนด์ของโมเดล กฎแบบเลือกบล็อกที่ถูกใช้มากที่สุดคือ "บล็อกCCBotแต่อนุญาตGooglebot" (14.1% ของเว็บไซต์)- ฝรั่งเศสนำทุกประเทศด้วยการบล็อก AI 50.6% บนเว็บไซต์
.fr; กลุ่มประเทศ EU สูงกว่าค่าเฉลี่ยโลก 16 จุด ไฟล์robots.txt275 ไฟล์อ้างถึง EU Directive 2019/790 อย่างชัดเจน มาตรา 4 คือกรอบกฎหมายเดียวที่เห็นได้ชัดว่าทำให้ตัวเลขขยับ - 17.8% เขียนกฎ AI เอง; 4.5% ใช้เทมเพลตที่ Cloudflare จัดให้; 75.7% ไม่พูดอะไรเลย เว็บไซต์ขนาดใหญ่เขียนเอง ส่วนหางยาวใช้สวิตช์เทมเพลต The Atlantic และ
cloudflare.comเองก็อยู่ในรายการ Cloudflare Managed - 108 เว็บไซต์ประกาศ อนุญาต
GPTBotอย่างชัดเจน — WordPress.org, Kaspersky, Norton, Avast, Sophos, The Verge, The Atlantic, NBA.com, The Sun, Branch.io กลุ่มความปลอดภัยและเครื่องมือสำหรับนักพัฒนามีสัดส่วนสูงเป็นพิเศษ - นโยบาย AI ไม่ได้เข้มขึ้นตามตำแหน่งของเว็บไซต์ในกราฟความนิยม ท็อป 100, อันดับ 101–1000, 1001–5000, 5001–10000 ล้วนอยู่ระหว่าง 19% ถึง 23% อัตราที่เห็นจึงสะท้อนสภาพของเว็บสาธารณะในปี 2026 ไม่ใช่สัญญาณว่าเว็บไซต์ใดเว็บไซต์หนึ่งจะใหญ่แค่ไหน
เรื่องนี้ไม่ใช่คำถามว่าเว็บกำลัง "ตอบโต้กลับ" หรือไม่อีกต่อไป แต่คืออุตสาหกรรมไหน ประเทศไหน กรอบกฎหมายไหน และผู้ให้บริการ AI รายไหนเป็นเป้าหมายของนโยบายเชิงรุก — และรายไหนไม่ใช่
I. ภูมิหลัง: robots.txt กลายเป็นวัตถุเชิงนโยบายสำหรับ AI ได้อย่างไร
มี 3 แรงที่เปลี่ยนความหมายของ robots.txt ตั้งแต่ OpenAI เปิดตัว GPTBot ในเดือนสิงหาคม 2023
ผู้ให้บริการ AI เพิ่มขึ้นอย่างรวดเร็ว Google-Extended ของ Google, ClaudeBot ของ Anthropic, Bytespider ของ ByteDance, Applebot-Extended ของ Apple, Amazonbot ของ Amazon, Meta-ExternalAgent ของ Meta ต่างก็ตามมา CCBot ที่มีอยู่เดิมของ Common Crawl กลายเป็นเป้าหมายบล็อกที่มีอิทธิพลสูงสุดเพราะคลังเก็บข้อมูลของมันป้อนโมเดลโอเพนเวตส่วนใหญ่ บอทที่ไม่ใช่ของค่ายโมเดลก็โผล่ขึ้นมาเช่นกัน: AI2Bot, cohere-ai, PerplexityBot, YouBot, DuckAssistBot, Diffbot, Omgili รายการบล็อกครอบคลุมในปี 2026 มีชื่อราว 25 ตัว
มาตรา 4 ของ EU Copyright Directive 2019/790 สร้างข้อยกเว้นสำหรับ text-and-data mining ที่ใช้ไม่ได้หากเจ้าของสิทธิ์ได้ "สงวนสิทธิ์ไว้อย่างชัดแจ้ง" ในรูปแบบที่ "เครื่องอ่านได้" ตลอดปี 2024–2025 สำนักพิมพ์ใน EU และที่ปรึกษากฎหมายของพวกเขาตกลงกันว่า robots.txt คือวิธีมาตรฐานในการแสดงการสงวนสิทธิ์ดังกล่าว ชุดข้อมูลของเราแสดงว่า 275 เว็บไซต์อ้างถึง Directive 2019/790 โดยตรง และอีก 87 เว็บไซต์กล่าวถึง "TDM" — กระจุกตัวอยู่ในเว็บไซต์ข่าวยุโรปที่มักใส่ไว้เป็นคำนำทางกฎหมาย 4–8 บรรทัด
Cloudflare ทำให้สวิตช์นี้กลายเป็นสินค้าพร้อมใช้ ในปี 2024–2025 Cloudflare ปล่อยแดชบอร์ด "AI Audit" สวิตช์ "Block AI Bots" และเทมเพลต robots.txt แบบ Managed พร้อมคำศัพท์ Content-Signal: search=yes,ai-train=no และข้อความมาตรฐานอ้างอิง EU 2019/790 ภายในเดือนพฤษภาคม 2026 เทมเพลตนี้ถูกใช้งานบน 4.5% ของท็อป 10k ที่อ่านได้ Cloudflare ยังพูดถึงแผนทำให้สวิตช์นี้เปิดโดยค่าเริ่มต้นสำหรับบัญชีใหม่ ซึ่งจะดันอัตราการบล็อกทั่วโลกขึ้น 5–8 จุดโดยที่สำนักพิมพ์แต่ละรายไม่ต้องตัดสินใจเอง
ในปี 2026 robots.txt ไม่ใช่ไฟล์คอนฟิกน่าเบื่อแบบที่เคยเป็นในปี 2022 อีกต่อไป มันคือกลไกสงวนสิทธิ์ด้านลิขสิทธิ์ที่มีฐานรองรับในสนธิสัญญาของ EU เป็นวัตถุเชิงนโยบายที่ถูกผลิตโดยผู้ให้บริการในหางยาว และเป็นแนวหน้าในการต่อรองระหว่างคนที่ดูแลเว็บไซต์กับคนที่ฝึกโมเดล
II. วิธีการศึกษา
เราพยายามทำให้เรื่องนี้น่าเบื่อและทำซ้ำได้มากที่สุดเท่าที่เป็นไปได้ กระบวนการทั้งหมด (สคริปต์ Python, CSV ที่แยกวิเคราะห์แล้ว, คลัง robots.txt ดิบ, กราฟ) เผยแพร่พร้อมรายงานนี้
ตัวอย่างข้อมูล
เราเริ่มจาก Tranco list ณ เดือนพฤษภาคม 2026 ดาวน์โหลดเป็น top-1m.csv.zip แล้วตัด 10,000 แถวแรก Tranco รวมอันดับจากต้นทาง 4 แหล่ง (Cisco Umbrella, Majestic, Farsight และ Cloudflare Radar) กรองความเสถียรในช่วง 30 วัน และตัดสัญญาณรบกวนจาก crawler/CDN ที่เห็นชัด รายการที่มันสร้างขึ้นใกล้เคียงกับ "ท็อป 10k ของทราฟฟิกเว็บโลก" ที่เป็นมาตรฐานที่สุดในโลกเปิด และเป็นตัวอย่างมาตรฐานสำหรับงานวิจัยเว็บเชิงวิชาการ (ใช้ในบทความ peer-reviewed กว่า 600 ชิ้นนับตั้งแต่เปิดตัวโดย KU Leuven ในปี 2018)
รายการนี้ประกอบด้วยทั้ง (ก) เว็บไซต์หลักที่คนเข้าใช้งาน (ข) โดเมนโครงสร้างพื้นฐาน / API / DNS / CDN ที่ไม่ให้บริการอะไรที่ / และ (ค) โดเมนที่แพลตฟอร์มใหญ่ใช้ภายใน (เช่น gvt1.com, apple-dns.net, googleusercontent.com) แทนที่จะกรองทิ้งตั้งแต่แรก เราเก็บทั้งหมดไว้และติดป้ายหมวด infrastructure ในชั้นวิเคราะห์ มันจะหลุดออกไปเองเมื่อเราจำกัดเฉพาะ "เว็บไซต์ที่ตอบกลับ robots.txt ที่อ่านได้"
การดึงข้อมูล
สำหรับทั้ง 10,000 โดเมน เราส่ง GET /robots.txt แบบอะซิงโครนัสผ่าน HTTPS โดยมี fallback ไป HTTP ตามมา เปิดการ redirect ได้สูงสุด 4 hop ตั้ง timeout รวม 12 วินาที จำกัด body 500 KB และใช้ User-Agent แบบเบราว์เซอร์จริงพร้อม Accept-Language: en-US ตั้ง concurrency ไว้ที่ 80 คำขอพร้อมกัน งานนี้รันจาก IP ที่อยู่อาศัยจริงหนึ่งตัวในซานฟรานซิสโก
ผลการดึงข้อมูล:
| สถานะ | จำนวน | ความหมาย |
|---|---|---|
200 OK | 6,638 | ได้เนื้อหา robots.txt และอ่านได้ |
404 Not Found | 610 | ไม่มี robots.txt ตามนิยาม RFC 9309 ถือว่าอนุญาตโดยปริยาย "allow everything" |
403 Forbidden | 563 | ต้นทางปฏิเสธคำขอ robots.txt อย่างแข็งขัน ตัดออกจากการวิเคราะห์ |
429 Too Many Requests | 7 | แทบไม่มีการจำกัดความถี่ในระดับ CDN ที่ช่วงอันดับนี้ |
fetch_failed (TLS / DNS / TCP error) | 2,065 | ส่วนใหญ่เป็นโดเมน apex ของ CDN (akamai.net, cloudfront.net, fastly.net, gtld-servers.net, apple-dns.net) ที่ไม่ได้รันเว็บเซิร์ฟเวอร์บน / ไม่ใช่ "ถูกบล็อก" — แค่ไม่มี robots.txt ให้บริการ |
| อื่น ๆ 4xx/5xx | 117 | ปนกันทั้งข้อผิดพลาดเซิร์ฟเวอร์ geofencing และการตอบกลับที่รูปแบบผิด |
นั่นทำให้เรามี 7,248 เว็บไซต์ในตัวอย่างที่วิเคราะห์ได้ (6,638 200 + 610 404) ส่วน 2,065 ที่ fetch_failed เป็นโดเมนจริง แต่เป็นจุด apex ของ CDN/DNS ไม่ใช่เว็บไซต์ที่คนเข้าใช้งาน และการตีความว่ามันมี "นโยบาย AI" จึงไม่สมเหตุสมผล เราจัดไว้เป็นสถิติการเข้าถึงแยกต่างหาก
การแยกวิเคราะห์
เนื้อหา 200 ทุกชิ้นถูกพาร์สด้วย protego ซึ่งเป็นการใช้งาน RFC 9309 ด้วย Python และถูกใช้งานจริงใน Scrapy สำหรับแต่ละคู่ (เว็บไซต์, บอท) เราคำนวณ 3 อย่าง:
can_fetch_root— บอทนั้นสามารถดึง/ได้หรือไม่ โดยอิง semantics ของ group-of-records, ลำดับความสำคัญของกฎที่ตรงยาวที่สุด และการที่User-agent: *ถูกแทนที่ด้วยบล็อกของบอทเฉพาะเมื่อมีทั้งสองอย่างhas_specific_rule— ในไฟล์มีบรรทัดUser-agent:ที่ระบุชื่อบอทนี้ตรงตัวหรือไม่ (ไม่สนตัวพิมพ์เล็กใหญ่)disallow_count— มีกี่คำสั่งDisallow:ในบล็อกที่ตรงกัน ใช้แยกแยะการแบนทั้งเว็บไซต์ออกจากข้อจำกัดระดับพาธ
การผสมกันของตัวแปรเหล่านี้สำคัญ เพราะอัตรา "บล็อก AI" บนหัวตารางเดียวอาจซ่อนปรากฏการณ์ที่ต่างกันสองแบบ: แบรนด์ที่ ตั้งใจ เขียน User-agent: GPTBot \n Disallow: / เพราะต้องการตอบโต้ และแบรนด์ที่มีกฎทั่วไป User-agent: * \n Disallow: / (ตั้งไว้เพื่อ staging หรือ maintenance เมื่อหลายปีก่อน) ซึ่งบังเอิญบล็อก AI bot ทุกตัวที่ไม่เคยมีอยู่ตอนเขียนกฎนั้น ตลอดรายงานนี้ ตัวเลข "บล็อก AI ใดก็ได้" รวมทั้งสองแบบ ส่วน "บล็อก AI แบบชัดเจน" คือกลุ่มที่ตั้งใจจริง
บอทที่อยู่ในขอบเขต
เราติดตามบอท 25 ตัว แบ่งเป็น 3 กลุ่ม:
- crawler สำหรับฝึก AI (16):
GPTBot,ClaudeBot,anthropic-ai,CCBot,Google-Extended,Meta-ExternalAgent,Bytespider,Applebot-Extended,Diffbot,Amazonbot,ImagesiftBot,FacebookBot,cohere-ai,AI2Bot,Omgili,Omgilibot - บอทสำหรับ inference / ดึงข้อมูลสดของ AI (7):
PerplexityBot,Perplexity-User,ChatGPT-User,OAI-SearchBot,ClaudeBot(ซึ่งใช้ได้ทั้ง training และ inference),YouBot,DuckAssistBot - ค่าอ้างอิงด้าน search (6):
Googlebot,Bingbot,DuckDuckBot,Slurp(Yahoo),Baiduspider,YandexBot
บอทบางตัวอยู่กึ่งกลางระหว่าง training และ inference ClaudeBot เป็นตัวที่เด่นที่สุด — Anthropic เลิกใช้ UA เก่า anthropic-ai ในปี 2024 และใช้ ClaudeBot สำหรับทั้ง training และการดึงข้อมูลสด ดังนั้นกฎ Disallow: ClaudeBot จึงไม่สามารถแปลได้ชัด ๆ ว่า "บล็อกการฝึกแต่ยังให้มองเห็นได้" เราคงการจัดหมวดตามเดิมและอธิบายผลกระทบไว้ภายหลัง
การจัดหมวดอุตสาหกรรม
เราแบ่งโดเมนแต่ละตัวเป็น 1 ใน 16 กลุ่มอุตสาหกรรม (news, social, streaming, ecommerce, search, finance, infrastructure, saas, academia, dev, gov, adult, gambling, travel, telecom, unknown) ด้วยแนวทางหลายชั้น:
- พจนานุกรมโดเมนที่รู้จักอยู่แล้ว — แมปโดเมนทราฟฟิกสูงราว 500 รายการกับอุตสาหกรรมที่จัดทำด้วยมือ
- รูปแบบ TLD / suffix —
.gov→gov,.eduและ.ac.*→academia, suffix ของ CDN ที่รู้จัก →infrastructure - คีย์เวิร์ดในชื่อโดเมน — news, post, shop, bank, porn, casino เป็นต้น เป็นสัญญาณสำรอง
- การสแกนหน้าโฮมเพจ — สำหรับเว็บไซต์ที่ 3 ชั้นแรกจัดหมวดไม่ได้และกลับมาเป็น
robots.txt200เราดึง HTML หน้าแรก, แยก<title>,<meta name="description">,<meta property="og:type">และให้คะแนนคีย์เวิร์ดเทียบกับสัญญาณหมวดหมู่แบบภาษาของโมเดล
ผลลัพธ์คือมี 3,407 เว็บไซต์ (34%) ที่ได้แท็กอุตสาหกรรมอย่างมั่นใจ และอีก 6,593 เว็บไซต์ถูกทิ้งไว้ใน unknown หมวด unknown กระจุกตัวอยู่ที่พอร์ทัลภูมิภาคที่ไม่ใช่ภาษาอังกฤษ เว็บไซต์แบรนด์ .com ของบริษัทที่ไม่เข้ากลุ่มใดกลุ่มเดียว และสำนักข่าวท้องถิ่นในภาษาขนาดเล็กที่เราไม่มีรายการในพจนานุกรม เมื่อรายงานนี้อ้างเปอร์เซ็นต์รายอุตสาหกรรม ตัวหารจะเป็นตัวอย่างที่ถูกจัดหมวดของอุตสาหกรรมนั้น ไม่ใช่ทั้ง 10,000
III. ข้อค้นพบ
ข้อค้นพบ 1 — เว็บไซต์ที่มีทราฟฟิกสูงหนึ่งในห้าบล็อก AI bot อย่างน้อยหนึ่งตัว
จาก 7,248 เว็บไซต์ที่วิเคราะห์ได้ 1,472 เว็บไซต์ (20.31%) บล็อก AI bot อย่างน้อยหนึ่งตัว 1,230 เว็บไซต์ (16.97%) มีกฎ AI เฉพาะโดยตั้งใจ ค่า baseline ของ Googlebot อยู่ที่ 2.18% (158 เว็บไซต์ — ส่วนใหญ่เป็นเว็บไซต์ที่ตั้งค่าให้บล็อกทั้งหมดไว้เป็น default ช่วง maintenance หรือใน 3 กรณีเป็น search engine ที่บล็อกคู่แข่ง)
ตัวเลข 20% บนหัวข้อข่าวคือ สูงกว่า baseline ของ Googlebot 9 เท่า นั่นเป็นสัญญาณจริง — เว็บไซต์ทราฟฟิกสูงมีแนวโน้มบล็อก AI crawler มากกว่า search crawler ถึงระดับหนึ่ง — แต่ก็ยังน้อยกว่านัยที่สื่อหลายแห่งเล่ากันมาว่า "AI blocking กำลังจะถูกใช้อย่างแพร่หลายทั่วไป" ตั้งแต่ปี 2024 แม้บนเว็บไซต์ 10,000 อันดับแรกที่มีผู้เข้าชมมากที่สุดของเว็บ ส่วนใหญ่ 5 ใน 6 ก็ยังเงียบเรื่อง AI อยู่ดี
ช่องว่างระหว่าง "บล็อก AI ใดก็ได้" (20.3%) กับ "บล็อก AI แบบชัดเจน" (17.0%) มีขนาดไม่มากในเชิงตัวเลข แต่สำคัญในเชิงแนวคิด ช่องว่าง 3.3 จุดนี้คือสัดส่วนของเว็บไซต์ที่บล็อก AI bot ก็เพราะกฎเดิม User-agent: * \n Disallow: / ของพวกเขาดักทุกอย่างที่ผ่านเข้ามา รวมถึง bot ที่ยังไม่มีตอนเขียนกฎนั้น ตัวเลข 17.0% แบบตั้งใจจึงอ่านได้ชัดกว่าในแง่ "เว็บไซต์ที่ใหญ่ที่สุดของโลกกี่แห่งตัดสินใจเรื่อง AI โดยเฉพาะ"
เมื่อเทียบกับงานศึกษาก่อนหน้า:
| แหล่งข้อมูล | วันที่ | ตัวอย่าง | อัตราการบล็อก |
|---|---|---|---|
| Originality.ai | มี.ค. 2025 | 1,000 ข่าวยอดนิยมที่สุด (ภาษาอังกฤษ) | 35.7% บล็อก GPTBot |
| Palewire | ส.ค. 2024 | องค์กรข่าว 1,500 แห่ง | 36.0% บล็อก AI crawler ใดก็ได้ |
| Reuters Institute | ฤดูใบไม้ผลิ 2025 | แบรนด์ข่าวชั้นนำ 50 แห่งใน 10 ประเทศ | 78% บล็อก AI crawler ใดก็ได้ |
| WIRED / NYT | ปลายปี 2023 | ข่าวสหรัฐฯ ท็อป 50 | 26% บล็อก GPTBot |
| รายงานนี้ (Thunderbit) | พ.ค. 2026 | Tranco ท็อป 10,000 (ทุกภาคส่วน) | 20.3% / 17.0% แบบ explicit |
ตัวเลข explicit 17.0% ของเราต่ำกว่าทุกงานที่เน้นข่าวเพราะสองในสามของตัวอย่างเราไม่ใช่ข่าว ถ้าจำกัดเฉพาะ 650 เว็บไซต์ข่าว เราจะได้ 47% — อยู่ในช่วงเดียวกับงานก่อนหน้าหากคำนึงถึงองค์ประกอบของตัวอย่าง ภาพเชิงโครงสร้างสอดคล้องกัน: กลุ่มข่าวบล็อก AI ในอัตรา 3–4 เท่าของเว็บส่วนอื่น
ข้อค้นพบ 2 — เจาะลึกตามอุตสาหกรรม: ช่วงห่าง 12 เท่าระหว่างข่าวกับโทรคมนาคม
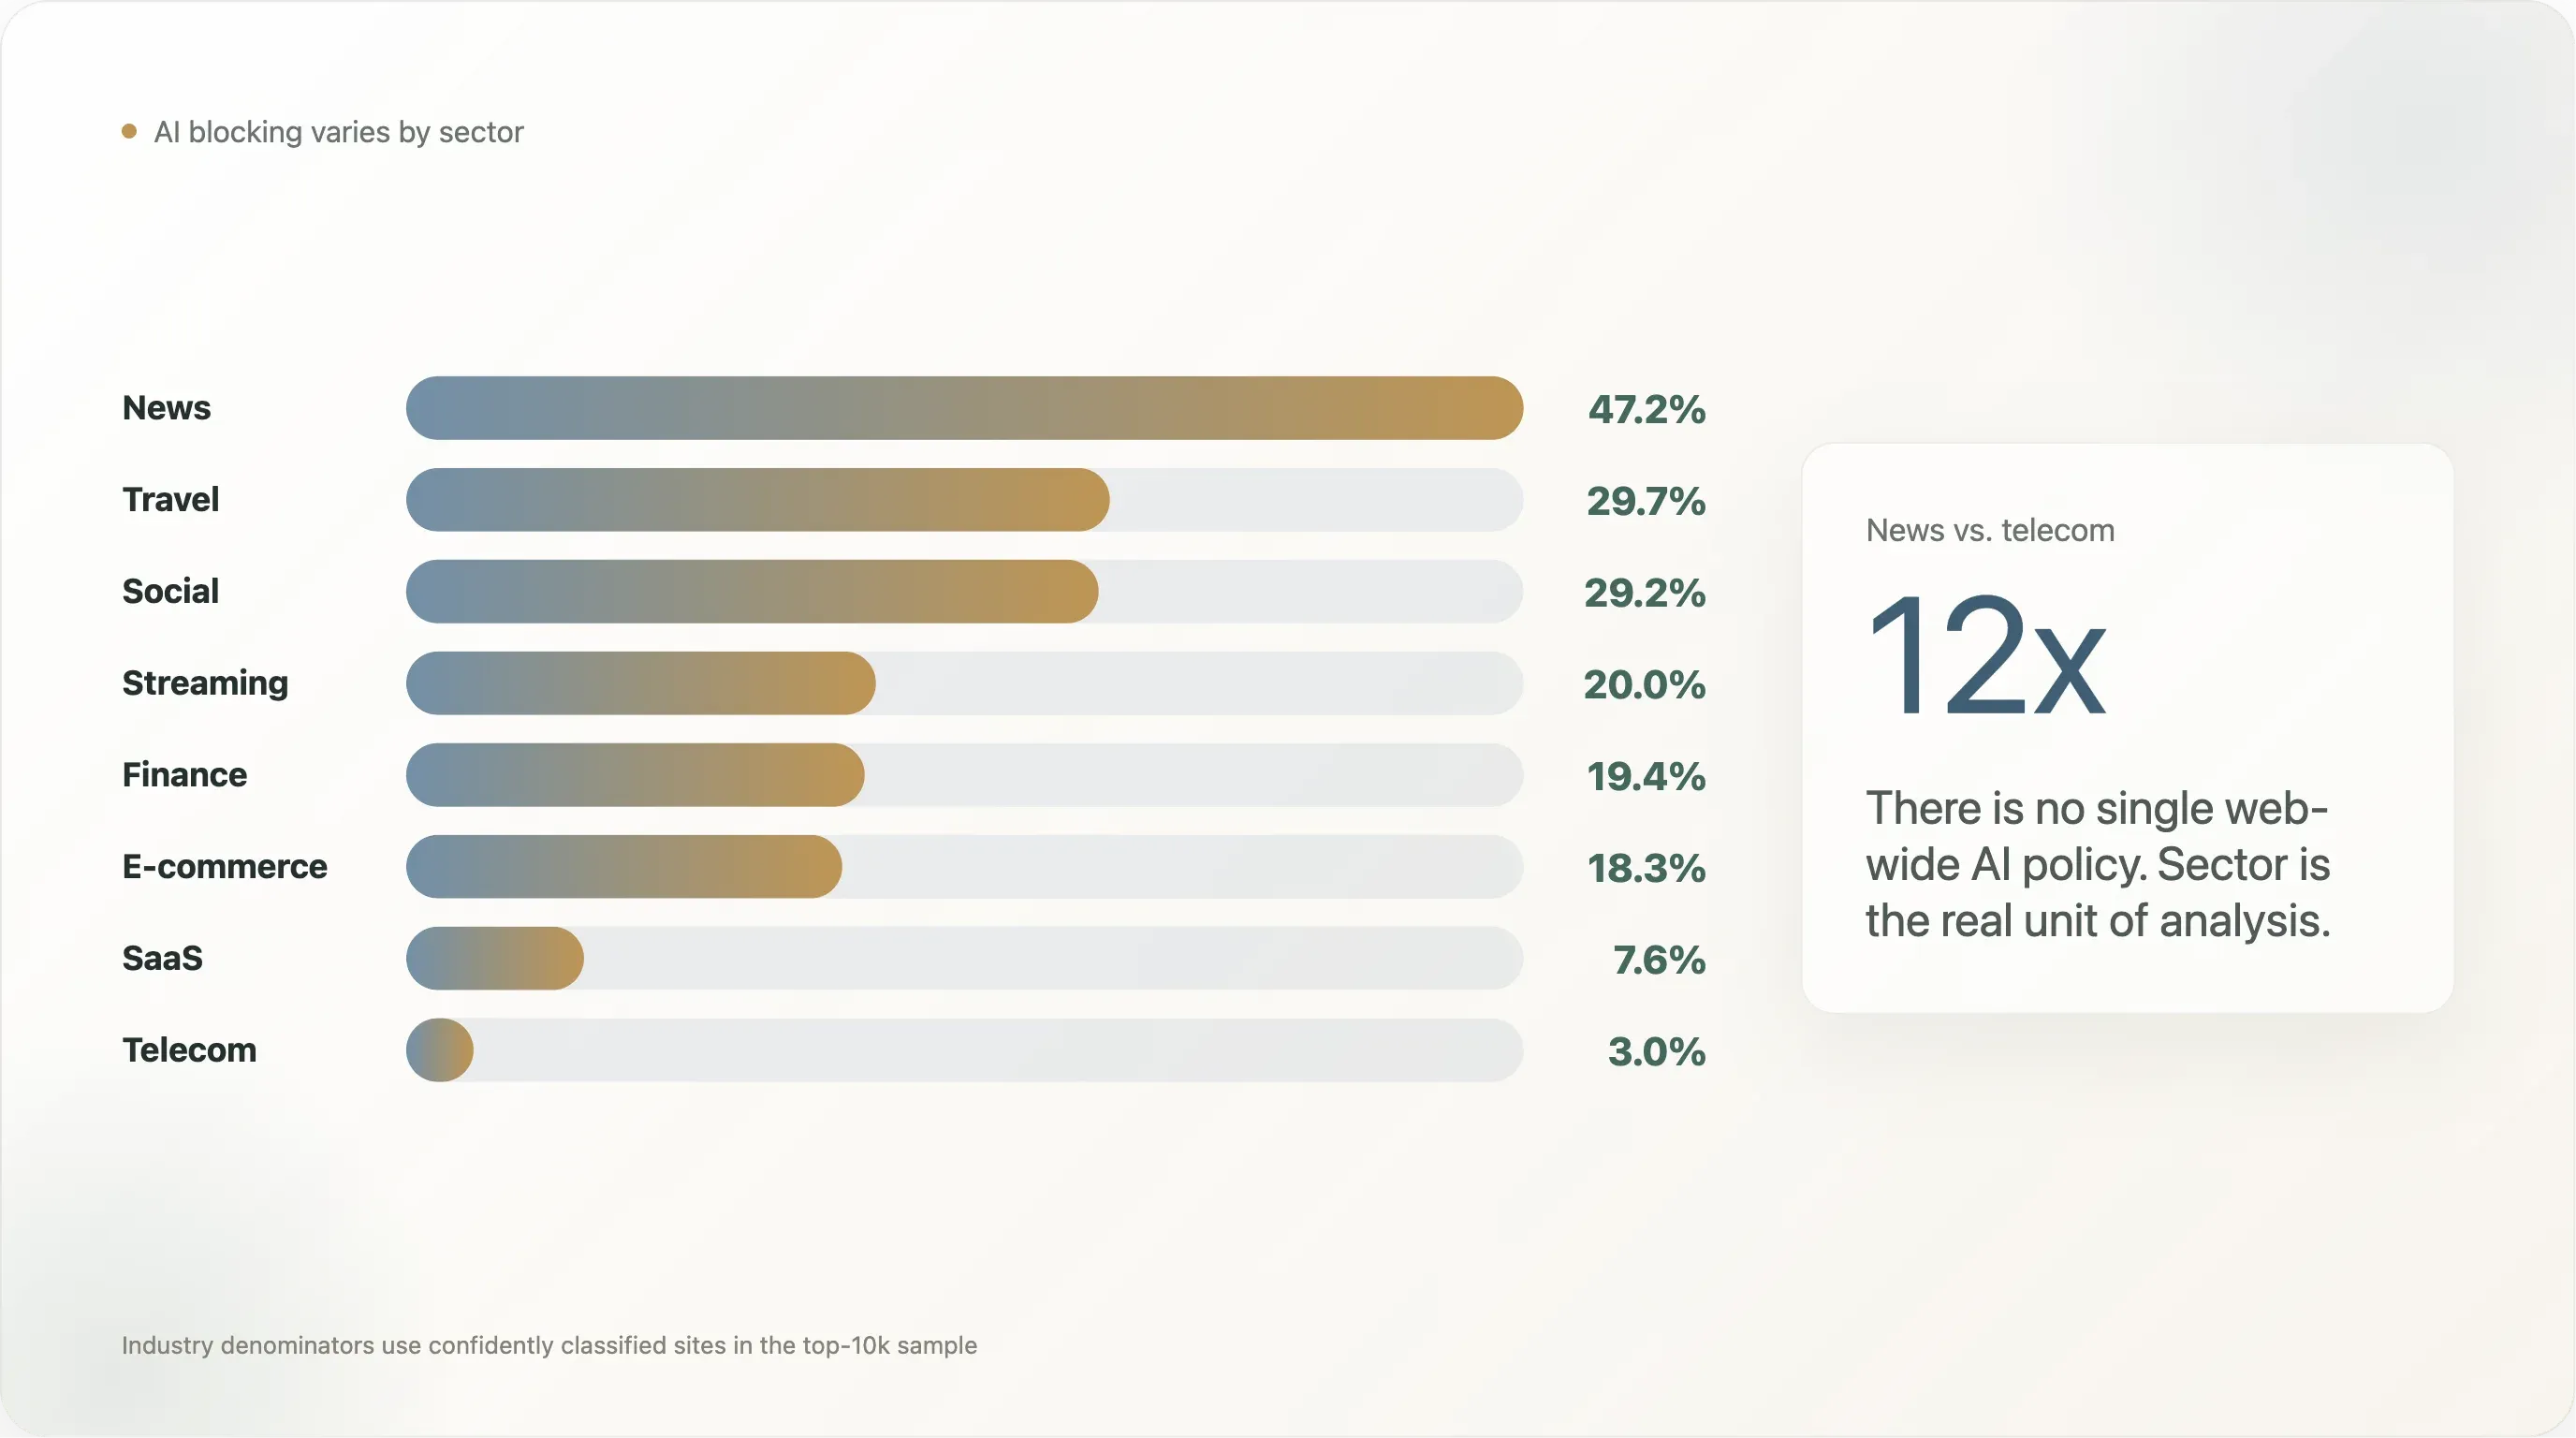
ข้อค้นพบที่ถูกอ้างมากที่สุดในรอบสองปีของการรายงานเรื่อง "AI scraping" คือ 80% ของสำนักข่าวบล็อก GPTBot จาก Originality.ai และ Palewire การแบ่งของเราทำให้ได้ตัวเลขที่เล็กลงแต่ยังชัดเจน: 47.2% ของเว็บไซต์ข่าวในท็อป 10,000 บล็อก AI bot อย่างน้อยหนึ่งตัว และ 45.2% เขียนกฎ AI แบบ explicit
แต่ "ข่าว vs ทุกอย่างที่เหลือ" ยังหยาบเกินไป การแยกทั้งหมด (เฉพาะอุตสาหกรรมที่มี n ≥ 10 ในตัวอย่าง) เล่าเรื่องที่ละเอียดกว่ามาก:
| อุตสาหกรรม | n | บล็อก AI ใดก็ได้ | Explicit | บล็อก Googlebot | กฎเขียนเอง | Cloudflare Managed | เงียบ |
|---|---|---|---|---|---|---|---|
| ข่าว | 650 | 47.2% | 45.2% | 1.5% | 46.9% | 1.5% | 48.5% |
| ท่องเที่ยว | 64 | 29.7% | 29.7% | 0.0% | 35.9% | 3.1% | 54.7% |
| โซเชียล | 65 | 29.2% | 23.1% | 4.6% | 23.1% | 6.2% | 66.2% |
| สตรีมมิง | 440 | 20.0% | 17.7% | 0.7% | 16.8% | 3.6% | 75.5% |
| การเงิน | 129 | 19.4% | 12.4% | 0.8% | 14.7% | 2.3% | 75.2% |
| อีคอมเมิร์ซ | 224 | 18.3% | 17.4% | 0.4% | 24.1% | 1.3% | 66.1% |
| ผู้ใหญ่ | 254 | 17.3% | 14.6% | 0.4% | 10.2% | 7.9% | 79.5% |
| Search | 12 | 16.7% | 0.0% | 0.0% | 0.0% | 0.0% | 100.0% |
| Academia | 268 | 14.6% | 13.8% | 0.4% | 13.4% | 3.4% | 77.2% |
| การพนัน | 100 | 14.0% | 13.0% | 0.0% | 18.0% | 4.0% | 77.0% |
| เครื่องมือสำหรับนักพัฒนา | 129 | 10.1% | 7.8% | 0.0% | 8.5% | 5.4% | 77.5% |
| SaaS | 369 | 7.6% | 6.2% | 0.3% | 9.5% | 0.8% | 87.5% |
| ภาครัฐ | 172 | 5.2% | 3.5% | 0.0% | 4.1% | 0.6% | 83.1% |
| โครงสร้างพื้นฐาน | 47 | 4.3% | 0.0% | 0.0% | 4.3% | 2.1% | 72.3% |
| โทรคมนาคม | 33 | 3.0% | 3.0% | 0.0% | 12.1% | 0.0% | 78.8% |
ช่องว่าง 12 เท่าระหว่างข่าวกับโทรคมนาคมนี่เองที่ทำให้คำว่า "นโยบาย AI ของเว็บ" เป็นหน่วยวิเคราะห์ที่ผิด ไม่มีตัวเลขเดียว มีแต่ตัวเลขรายภาคส่วนที่เบนกันเป็นระดับสิบเท่า เราจะไล่ดูข้อค้นพบที่เด่นที่สุด 4 ข้อด้านล่าง
ข่าว: บล็อก 47% และเขียนเอง 47% ข่าวคือกลุ่มที่เขียนพิมพ์เขียวของเรื่องนี้ Cloudflare Managed มีอยู่แค่ 1.5% ในกลุ่มข่าว — สำนักพิมพ์เหล่านี้ไม่ outsource กฎ เนื้อหามีความอุดมสมบูรณ์ของภาษาอย่างผิดปกติ: NYT เปิดด้วยคำนำทางกฎหมาย 14 บรรทัดอ้าง "Art. 4 of the EU Directive"; BBC เปิดด้วย "Please use our site like a human, not a robot... TL;DR: Browse, read, watch, enjoy — like a human."; The Sun เปิดด้วย "The Sun does not permit the unlicensed use of our content for large language models." นี่คือ robots.txt ในฐานะถ้อยแถลงเชิงนโยบาย ไม่ใช่ไฟล์คอนฟิก
ท่องเที่ยวที่ 30% — ตัวเซอร์ไพรส์ Booking, Expedia, TripAdvisor, Kayak และสายการบินรายใหญ่บล็อกในอัตราสองในสามของข่าว รูปแบบการเลือกบล็อกสอดคล้องกัน: บล็อก training UA 5–7 ตัว แต่ปล่อย inference UA (PerplexityBot, ChatGPT-User, OAI-SearchBot) ไว้ ข้อมูลราคาและรีวิวที่ถูกรวมศูนย์คือกำแพงป้องกัน ส่วนการอ้างอิงกลับมายังเว็บไซต์คือผลลัพธ์ด้านบวก นี่คือรูปแบบ "บล็อกการฝึก แต่เปิดให้ inference" ที่ชัดที่สุดในอุตสาหกรรมเดียว
ผู้ใหญ่ 17% — ก็เป็นตัวเซอร์ไพรส์เช่นกัน ตัวอย่างขนาดเล็กก่อนหน้านี้เคยเห็น 0% ข้อมูลทั้งชุดแสดงว่าเว็บไซต์หมวดผู้ใหญ่ 1 ใน 6 บล็อก AI bot อย่างน้อยหนึ่งตัว โดยมี อัตรา Cloudflare Managed สูงที่สุดในทุกภาคส่วน (7.9%) มากกว่าครึ่งของการบล็อก AI ในเว็บผู้ใหญ่มาจากสวิตช์ Cloudflare ไม่ใช่การตัดสินใจของสำนักพิมพ์ ความเสี่ยงที่ซ่อนอยู่คือการฝึกโมเดลสร้างภาพ — โมเดลระดับ StableDiffusion เรียนรู้สไตล์ภาพได้เร็วกว่าที่โมเดลข้อความจะเรียนรู้สไตล์การเขียน
SaaS ที่ 7.6% เป็นตัวเลขที่ขัดกับสัญชาตญาณ ผู้ขายซอฟต์แวร์เป็นกลุ่มที่พูดเรื่องนโยบาย AI ดังที่สุด แต่ robots.txt ของพวกเขาเปิดกว้างมาก การอ่านที่ถูกต้องคือ: ทีมการตลาดของ SaaS เข้าใจแล้วว่า AI search เป็นช่องทางกระจายสินค้า ผู้ที่คิดจริง ๆ กลับเลือกเปิดรับ ไม่ได้ปิด — รายการ explicit-Allow-GPTBot (ข้อค้นพบ 12) ถูกครองโดย SaaS ด้านความปลอดภัยและเครื่องมือ dev
ภาครัฐ 5.2%, โทรคมนาคม 3.0%, โครงสร้างพื้นฐาน 4.3%, dev 10.1% ข้อกำหนดด้านเอกสารสาธารณะทำให้ Disallow: / ใน .gov เสี่ยงทางกฎหมาย ผู้ทำการตลาดในโทรคมนาคมต้องการให้ค้นเจอ โดเมน apex ของ CDN ไม่มีอะไรต้องปกป้อง ส่วนเครื่องมือ dev เลือกเปิดรับอย่างชัดเจน (เพราะเนื้อหาของมันมีค่ามากขึ้นเมื่อ LLM อ้างอิงได้)
ข้อสรุป: ไม่มีตัวเลขเดียวที่ตอบได้ว่า "เว็บบล็อก AI หรือไม่" โดยไม่ทำให้ข้อมูลเสียความหมายมากกว่าที่สื่อออกไป การรายงานระดับภาคส่วนเท่านั้นที่ซื่อสัตย์กับข้อมูล
ข้อค้นพบ 3 — เมื่อมองรายผู้ให้บริการ AI ใครถูกบล็อกมากที่สุด?
การแบ่งข้อมูลอีกแบบที่เป็นธรรมชาติคือแยกตามบริษัท AI แทนที่จะแยกตามบอท ผู้ให้บริการหลายรายมีหลายบอท (OpenAI มี 3: GPTBot, ChatGPT-User, OAI-SearchBot; Anthropic มี 2: ClaudeBot, anthropic-ai; Meta มี 2: Meta-ExternalAgent, FacebookBot) การรวมระดับผู้ให้บริการจึงใกล้ที่สุดกับคำถามว่า "เว็บสาธารณะคิดอย่างไรกับบริษัท AI แต่ละราย"
| ผู้ให้บริการ AI | บอทที่รวมแล้ว | เว็บไซต์ที่บล็อกอย่างน้อย 1 บอท | % ของตัวอย่างที่วิเคราะห์ได้ |
|---|---|---|---|
| Common Crawl | CCBot | 1,178 | 16.25% |
| OpenAI | GPTBot, ChatGPT-User, OAI-SearchBot | 1,172 | 16.17% |
| Anthropic | ClaudeBot, anthropic-ai | 1,111 | 15.33% |
| ByteDance | Bytespider | 1,082 | 14.93% |
| Meta | Meta-ExternalAgent, FacebookBot | 989 | 13.65% |
Google-Extended | 970 | 13.38% | |
| Amazon | Amazonbot | 877 | 12.10% |
| Apple | Applebot-Extended | 859 | 11.85% |
| Webz.io (Omgili) | Omgili, Omgilibot | 731 | 10.09% |
| Cohere | cohere-ai | 717 | 9.89% |
| Perplexity | PerplexityBot, Perplexity-User | 715 | 9.86% |
| Diffbot | Diffbot | 684 | 9.44% |
| You.com | YouBot | 563 | 7.77% |
| AI2 (Allen AI) | AI2Bot | 487 | 6.72% |
| DuckDuckGo | DuckAssistBot | 482 | 6.65% |
Common Crawl คือเป้าหมายที่ถูกจู่โจมมากที่สุดเพียงรายเดียว ทั้งที่มันเป็นเว็บอาร์ไคฟ์แบบไม่แสวงกำไร ไม่ใช่ผู้ให้บริการ LLM เหตุผลคืออำนาจคานงัด: CCBot ป้อนข้อมูลให้เกือบทุกโมเดลโอเพนเวตและส่วนสำคัญของโมเดลปิด การบล็อก CCBot ก่อนคือกฎที่คุ้มค่าที่สุดที่สำนักพิมพ์หนึ่งจะเขียนได้
OpenAI, Anthropic, ByteDance กระจุกตัวที่ 14–16% การที่ OpenAI นำหน้าเกิดบางส่วนจากผลของการนับ (OpenAI มีบอท 3 ตัวเมื่อเทียบกับ ByteDance ที่มี 1 ตัว) พฤติกรรมของ Bytespider ที่ 14.9% คือผลจากการที่มันถูกบันทึกว่ามักเพิกเฉยต่อ robots.txt ตั้งแต่ปี 2024 และสำนักพิมพ์บล็อกมันในฐานะสัญญาณสาธารณะ ไม่ใช่เพราะกังวล TikTok
Meta, Google, Amazon, Apple ที่ 12–14% อยู่ในชั้นที่สอง — เขียนแบบป้องกันตัวมากกว่าจะเป็นถ้อยแถลงทางจุดยืน ผู้ให้บริการรายเล็ก (Webz.io, Cohere, Perplexity, Diffbot, You.com, AI2, DuckDuckGo) ที่ 6–10% ส่วนใหญ่ถูกดึงขึ้นด้วย floor แบบเหมา ๆ 3.8% ส่วนกฎเฉพาะของพวกเขาอยู่ในช่วง 1–4%
xAI (Grok), Mistral และแล็บโมเดลจากยุโรป/จีนส่วนใหญ่ไม่มีในตาราง — พวกเขายังไม่ได้เผย UA สำหรับ crawler ฝึกข้อมูลที่เป็นเอกสารชัดเจน ระบบนิเวศ robots.txt ปัจจุบันจึงเป็นบทสนทนาระหว่างผู้ให้บริการสหรัฐ/จีนที่ปล่อย UA กับสำนักพิมพ์สหรัฐ/EU ที่เขียนกฎ ผู้ที่ไม่ปล่อย UA จึงหายไปจากโต๊ะเจรจา
ข้อค้นพบ 4 — CCBot คือเป้าหมายสายฟ้าฟาดตัวใหม่ ไม่ใช่ GPTBot
การเรียงลำดับบอทในท็อป 10k มีหน้าตาประมาณนี้:
| อันดับ | บอท | อัตราบล็อก | อัตรากฎ explicit |
|---|---|---|---|
| 1 | CCBot (Common Crawl) | 16.25% | 12.90% |
| 2 | GPTBot (OpenAI) | 15.84% | 12.72% |
| 3 | Bytespider (ByteDance) | 14.93% | 11.35% |
| 4 | ClaudeBot (Anthropic) | 14.51% | 11.13% |
| 5 | Google-Extended | 13.38% | 10.18% |
| 6 | Meta-ExternalAgent | 12.38% | 8.95% |
| 7 | Amazonbot | 12.10% | 8.66% |
| 8 | Applebot-Extended | 11.85% | 8.72% |
| 9 | Omgilibot | 10.09% | 5.31% |
| 10 | anthropic-ai (deprecated) | 9.99% | 6.55% |
| 11 | cohere-ai | 9.89% | 6.42% |
| 12 | PerplexityBot | 9.69% | 6.40% |
| 13 | Diffbot | 9.44% | 5.95% |
| 14 | ChatGPT-User (inference) | 8.90% | 5.73% |
| 15 | YouBot (inference) | 7.77% | 4.29% |
| 16 | OAI-SearchBot (inference) | 6.83% | 3.66% |
| baseline | Googlebot | 2.18% | — |
| baseline | Bingbot | 2.27% | — |
เรื่องที่ตารางนี้บอกคือ บอทที่เว็บสาธารณะบล็อกก่อน ไม่ใช่แบรนด์ของโมเดล — แต่เป็นคอร์ปัส คลัง 250 พันล้านหน้าเพจของ Common Crawl คืออินพุตการฝึกที่ใหญ่ที่สุดเพียงแหล่งเดียวของ GPT-3, GPT-4, Llama 1 / 2 / 3, Falcon, Mistral, BLOOM และโมเดลโอเพนเวตส่วนใหญ่ที่ปล่อยตั้งแต่ปี 2020 เว็บไซต์ที่อยาก opt out จาก "การไปอยู่ใน frontier model ตัวต่อไป" จะได้ผลดีที่สุดถ้าบล็อก CCBot ก่อน — ถ้าคุณไม่ได้อยู่ใน Common Crawl คุณก็แทบจะถูกตัดออกจากสายการฝึกโอเพนซอร์สแบบไม่เสียค่าใช้จ่าย GPTBot และ ClaudeBot จึงมาเป็นอันดับ 2 และ 3 เพราะเป็นส่วนหน้าที่มองเห็นได้ของผลิตภัณฑ์เชิงพาณิชย์สองค่าย; UA ระดับคอร์ปัสต่างหากคือเป้าหมายเชิงโครงสร้าง
บอท AI ที่อยู่ลำดับล่างในตารางก็ให้ข้อมูลเชิงลึกเช่นกัน Omgilibot ที่ 10% สูงผิดปกติสำหรับบอทที่ผู้อ่านจำนวนมากไม่เคยได้ยิน — มันรันโดย Webz.io ตัวกลางข้อมูลคอนเทนต์ที่ขายเว็บอาร์ไคฟ์ให้ผู้ให้บริการ LLM และสำนักข่าวจำนวนมากเริ่มระบุชื่อมันในไฟล์อย่างชัดเจน AI2Bot ที่ 6.7% (และกฎ Ai2Bot-Dolma ที่พบในไซต์ Squarespace) บอกว่าชุมชน LLM เชิงวิชาการก็เริ่มถูกตีธง จากสำนักพิมพ์ที่ไม่ได้แยก "crawler งานวิจัยไม่แสวงกำไร" ออกจาก "crawler เชิงพาณิชย์" เสมอไป
กลุ่ม inference — ChatGPT-User, OAI-SearchBot, YouBot, Perplexity-User — อยู่ต่ำกว่ากลุ่ม training 4–8 จุด ช่องว่างนี้ตอบคำถามนโยบายที่ถกกันมานาน: ใช่ เว็บไซต์ทราฟฟิกสูงแยกแยะระหว่างบอทที่เก็บข้อมูลเพื่อฝึกโมเดลในอนาคตกับบอทที่ดึงข้อมูลสดเพื่อตอบคำถามของผู้ใช้ตอนนี้ พวกเขาไม่ได้แยกเสมอไป (กฎเหมา ๆ ก็ไม่แยก) แต่สัดส่วนที่มีนัยสำคัญเขียนกฎที่มุ่งไปที่ฝั่ง training โดยเฉพาะ
ข้อค้นพบ 5 — 14% บล็อก CCBot แต่ยังต้อนรับ Googlebot — รูปแบบ "บล็อกคอร์ปัส แต่เก็บ search"
กฎแบบเลือกที่ถูกใช้มากที่สุดในท็อป 10k:
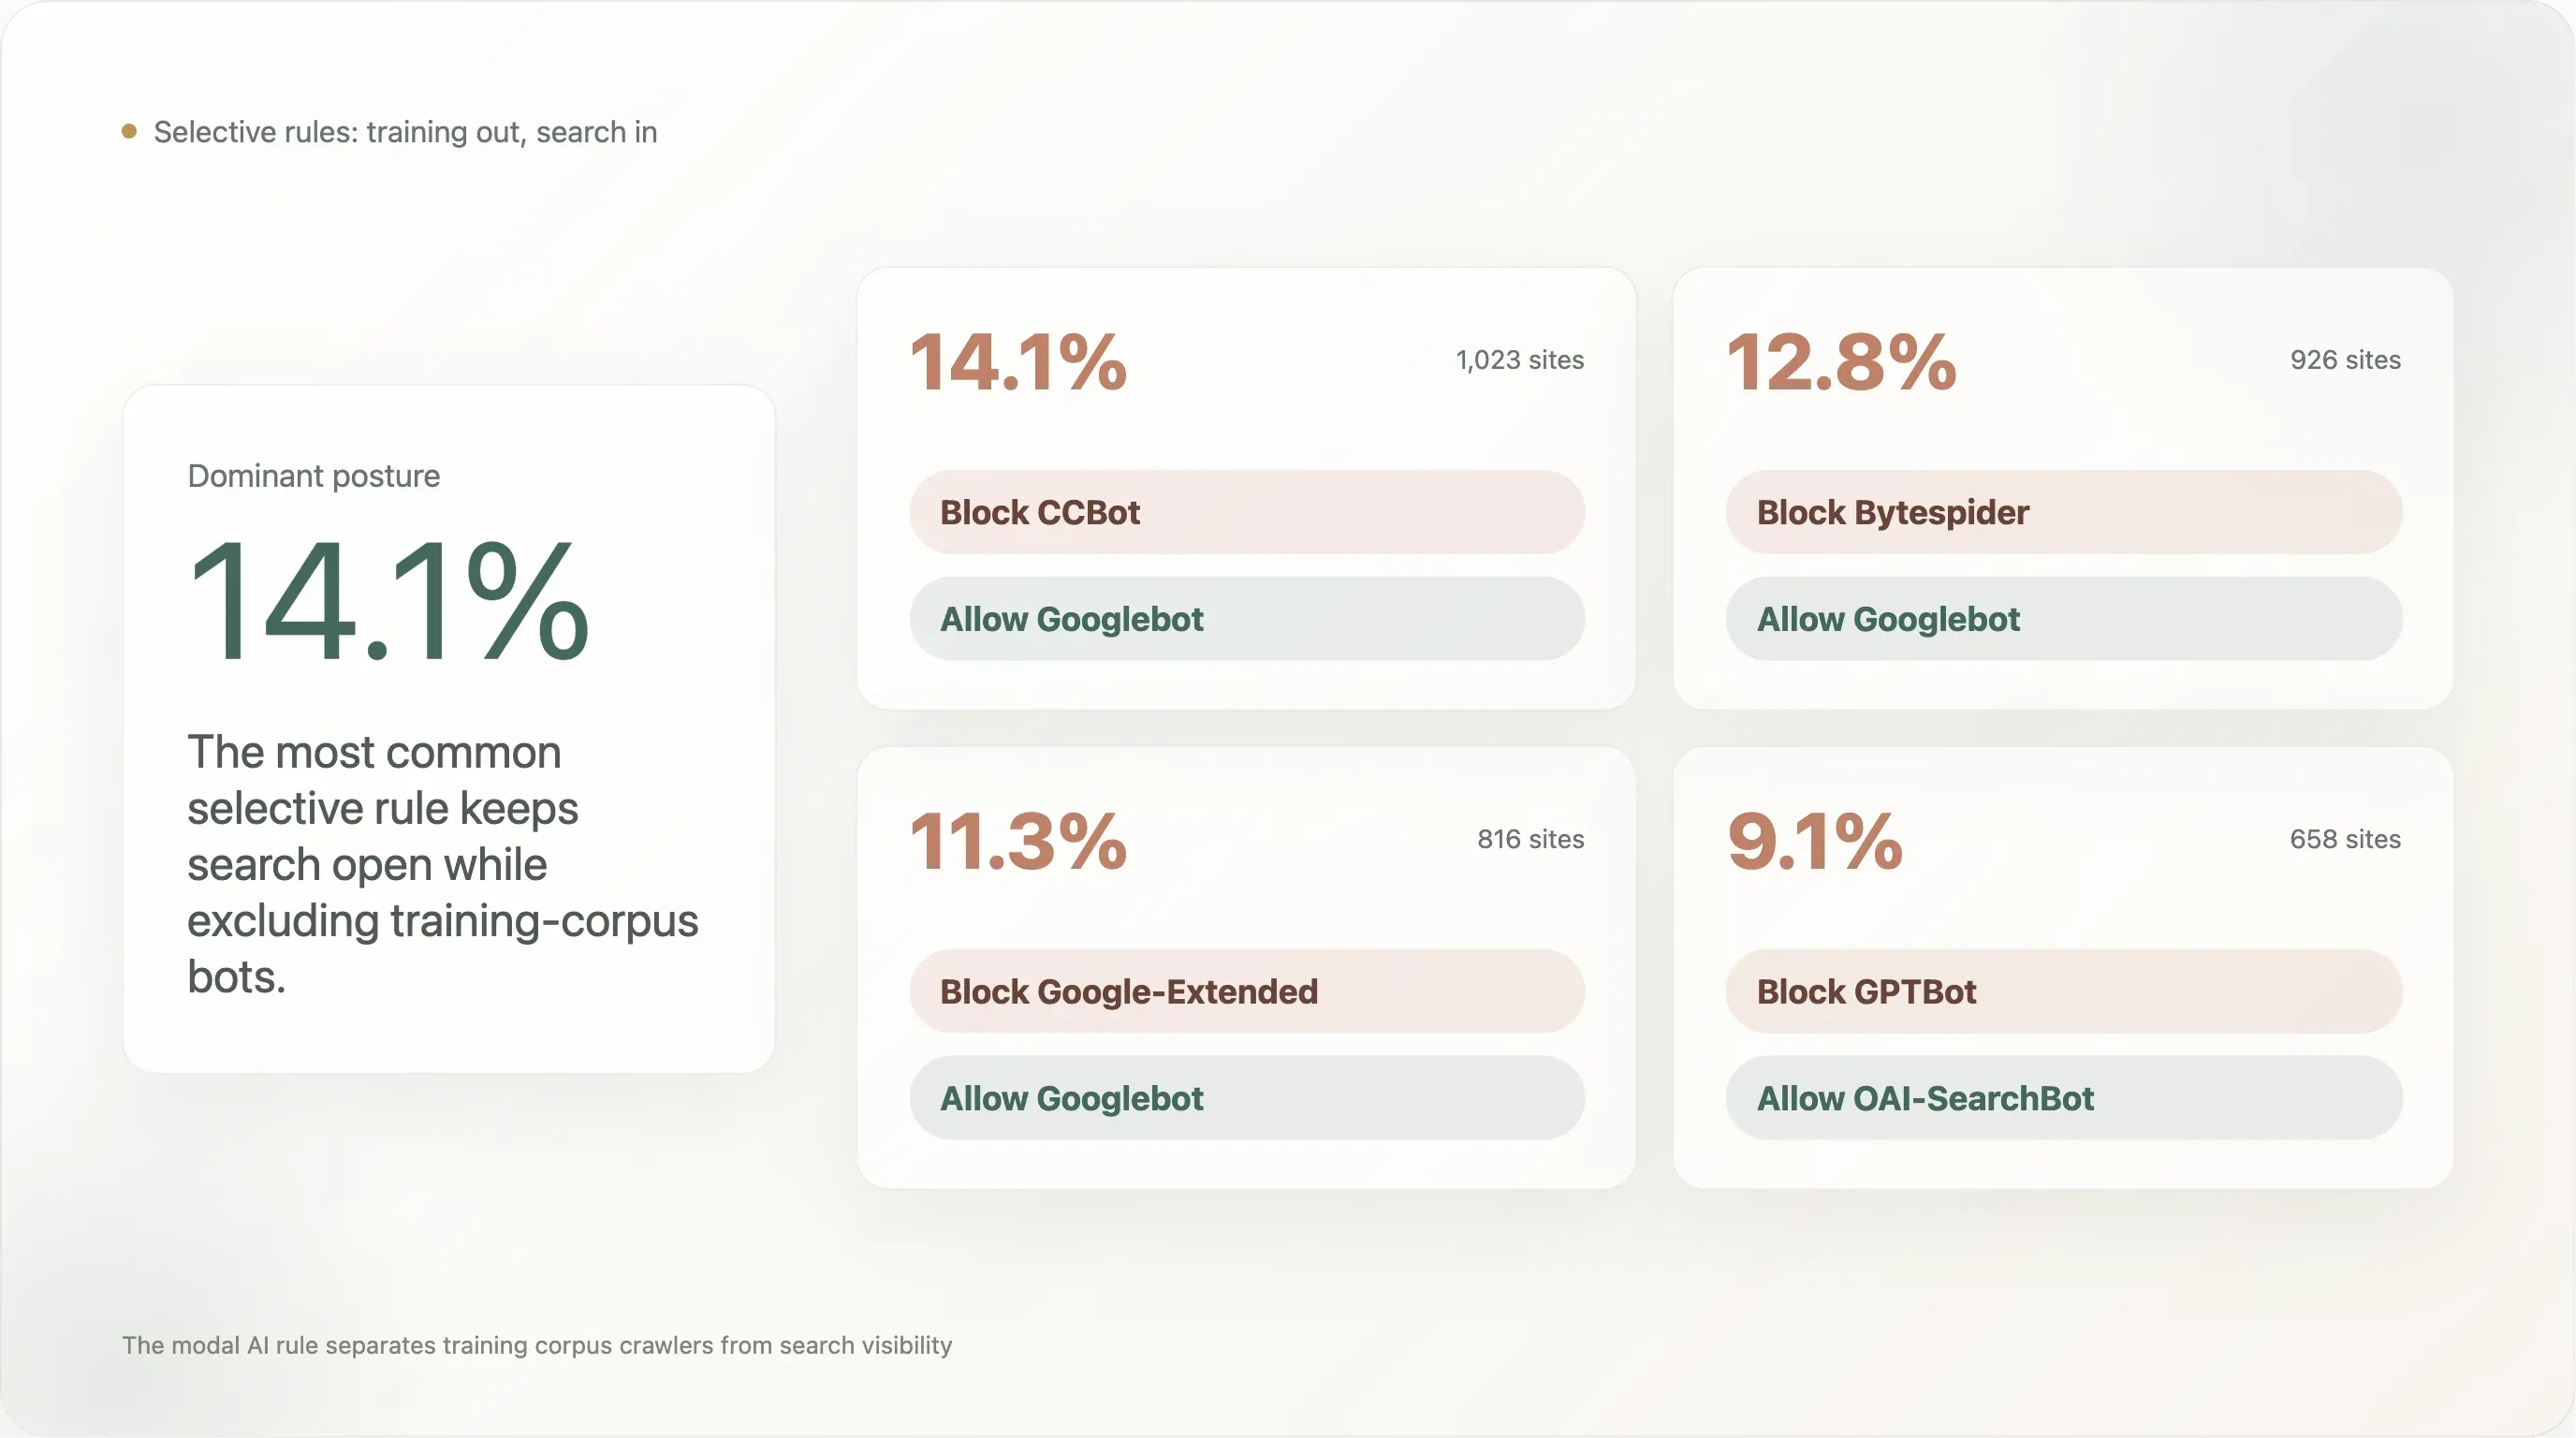
| รูปแบบกฎ | เว็บไซต์ | % ของตัวอย่างที่วิเคราะห์ได้ |
|---|---|---|
บล็อก CCBot, อนุญาต Googlebot | 1,023 | 14.11% |
บล็อก Bytespider, อนุญาต Googlebot | 926 | 12.78% |
บล็อก Google-Extended, อนุญาต Googlebot | 816 | 11.26% |
บล็อก GPTBot, อนุญาต OAI-SearchBot | 658 | 9.08% |
บล็อก GPTBot, อนุญาต ChatGPT-User | 525 | 7.24% |
บล็อก CCBot, อนุญาต PerplexityBot | 519 | 7.16% |
บล็อก anthropic-ai, อนุญาต ClaudeBot | 59 | 0.81% |
รูปแบบที่ถูกใช้มากที่สุด (14.1%) คือ "บล็อก Common Crawl แต่คงการมองเห็นบน Google search" อันดับรองลงมา (12.8%) คือ "บล็อก Bytespider แต่คงการมองเห็นบน Google search" — กล่าวคือบล็อก crawler ของ ByteDance ที่มีชื่อเสียงเรื่องละเลยกฎ ขณะยังเปิด baseline search ที่ถูกต้อง อันดับสาม (11.3%) คือ "บล็อก UA ฝึก AI ของ Google เองแต่ยังคง UA search ของ Google" ซึ่งตรงกับสิ่งที่ Google ออกแบบ Google-Extended มาเพื่อทำ: ให้ผู้เผยแพร่ opt out จากการฝึก Bard / Gemini โดยไม่เสียอันดับค้นหา
สามตัวเลขนี้รวมกันอธิบายจุดยืนเชิงนโยบายที่ครองเว็บท็อป 10k: ปฏิเสธบอทของคอร์ปัสฝึกข้อมูล แต่ปล่อยบอท search และ inference ไว้ รูปแบบส่วนน้อย "ปฏิเสธ training แต่อนุญาต UA สำหรับ live retrieval ของ LLM ตัวนี้โดยเฉพาะ" — GPTBot ✗ / ChatGPT-User ✓ ที่ 7.2% — มีอยู่ แต่ยังน้อยกว่าการตัดสินใจระดับคอร์ปัส
แถว anthropic-ai / ClaudeBot ที่ 0.81% สะท้อนการเลิกใช้ UA ของ Anthropic ในปี 2024: ClaudeBot ตอนนี้ใช้ได้ทั้ง training และ inference ทำให้การแสดงเจตนาแบบ "บล็อก training แต่อนุญาตการอ้างอิง" สำหรับ Claude ที่ UA เก่า anthropic-ai เคยอนุญาตนั้นหายไป นี่คือหนึ่งในการตัดสินใจด้านการออกแบบ UA ที่ถูกพูดถึงน้อยที่สุดในปี 2024–2025 — มันลบกลุ่มการแสดงนโยบายทั้งกลุ่มออกจาก robots.txt
ข้อค้นพบ 6 — เจาะรายละเอียดข่าว: แยกตามประเทศและภาษา
เมื่อเราแยกหมวดข่าวตาม ccTLD ของประเทศ — โดยจำไว้ว่านี่หมายถึง .de สำหรับข่าวเยอรมัน .fr สำหรับข่าวฝรั่งเศส ฯลฯ ไม่ใช่ภาษาที่ให้บริการ — ความแปรปรวนภายในกลุ่มข่าวยิ่งใหญ่กว่าความแปรปรวนระหว่างข่าวกับส่วนอื่นของเว็บ:
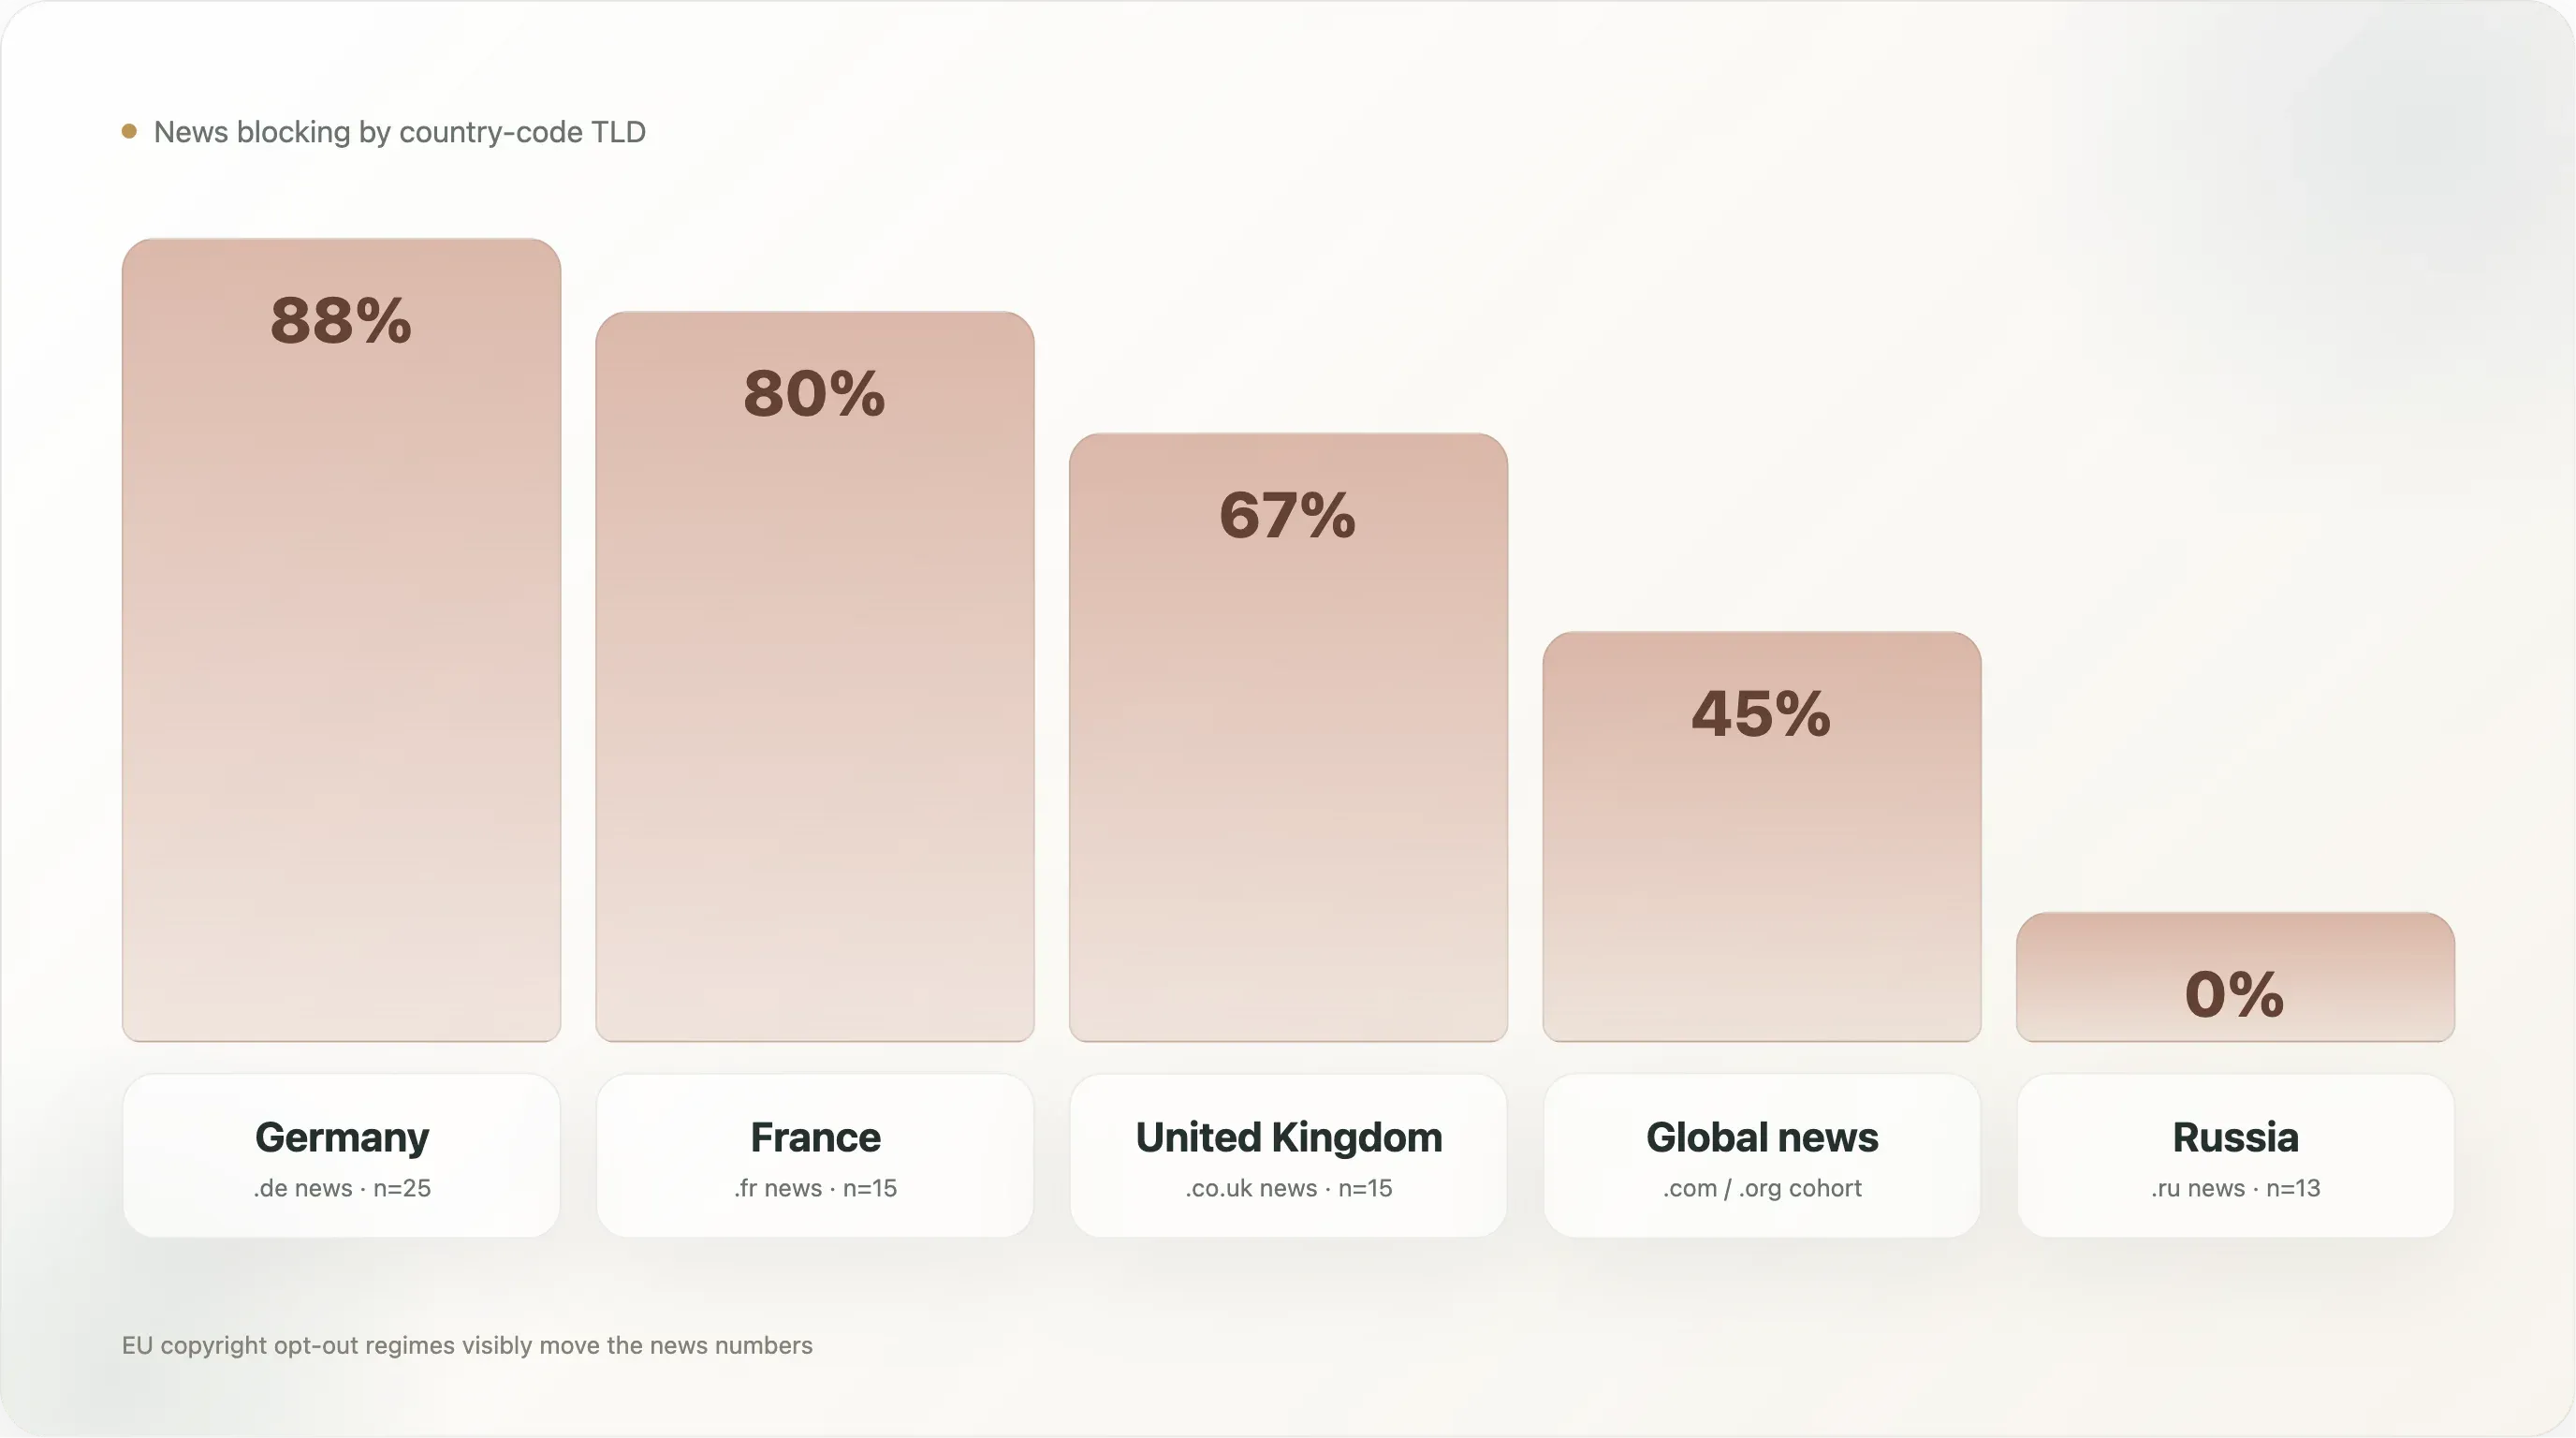
| ประเทศ (เฉพาะข่าว) | n | บล็อก AI ใดก็ได้ | Explicit |
|---|---|---|---|
🇩🇪 เยอรมนี (.de) | 25 | 88.0% | 88.0% |
🇫🇷 ฝรั่งเศส (.fr) | 15 | 80.0% | 80.0% |
🇬🇧 สหราชอาณาจักร (.co.uk) | 15 | 66.7% | 53.3% |
🇪🇸 สเปน (.es) | 5 | 60.0% | 60.0% |
🇮🇹 อิตาลี (.it) | 13 | 53.8% | 53.8% |
ข่าวระดับโลก (.com/.org/อื่น ๆ) | 500 | 45.0% | 42.8% |
🇵🇱 โปแลนด์ (.pl) | 7 | 42.9% | 42.9% |
🇯🇵 ญี่ปุ่น (.jp) | 12 | 25.0% | 25.0% |
🇷🇺 รัสเซีย (.ru) | 13 | 0.0% | 0.0% |
🇬🇷 กรีซ (.gr) | 6 | 0.0% | 0.0% |
ข่าวเยอรมันคือกลุ่มย่อยที่บล็อกสูงที่สุดในชุดข้อมูลทั้งหมดที่ 88% และทั้งหมดเป็น explicit 88% — แทบไม่มีเว็บไซต์ข่าวเยอรมันในท็อป 10k ที่ปล่อยให้ AI training crawler เข้าถึงคลังของตน กลุ่มนี้นำโดย Spiegel, Bild, Welt, Zeit, FAZ, Süddeutsche, Heise, Golem, Stern, Focus — คือสถานประกอบการสื่อกระแสหลักของเยอรมนีทั้งหมด บวกกับสำนักข่าวเทคโนโลยีที่เขียนกฎของตนเอง การรองรับทางการเมืองเบื้องหลังค่อนข้างหนาแน่น: VG Media องค์กรสิทธิรวมของสำนักพิมพ์เยอรมัน เป็นกลุ่มโจทก์ที่แข็งที่สุดกลุ่มหนึ่งในคดีลิขสิทธิ์ AI ของ EU และมาตรา 4 ของ EU Directive ถูกนำไปใช้ในกฎหมายเยอรมันเป็น §44b UrhG พร้อมถ้อยคำ opt-out ที่อ่านได้ด้วยเครื่องอย่างชัดเจน เมื่อผู้ให้บริการ AI เข้ามา สำนักพิมพ์เยอรมันจึงพร้อมกว่าทุกกลุ่มที่จะเปลี่ยนท่าทีทางกฎหมายนี้ให้กลายเป็นกฎ robots.txt
ข่าวฝรั่งเศสที่ 80% ตามมาติด ๆ สภาพกฎหมายของฝรั่งเศสคล้ายกัน (Directive 2019/790 ถูกนำไปใช้ในกฎหมายฝรั่งเศส) และพฤติกรรมของกลุ่มก็คล้ายกัน — lemonde.fr, lefigaro.fr, liberation.fr, lequipe.fr, 20minutes.fr, ouest-france.fr ต่างบล็อก ขณะที่ไฟล์ของ Le Monde ยังอ้าง droit du producteur de base de données ของฝรั่งเศส (มาตรา L 342-1 ของ Code de la propriété intellectuelle) เป็นฐานกฎหมายภายในประเทศคู่ขนาน ฝรั่งเศสยังมีรายละเอียดเพิ่มอีกชั้นจากคำพิพากษาปี 2024 ของศาลพาณิชย์ปารีสที่ระบุว่าการ opt-out ผ่าน robots.txt เพียงพอสำหรับแจ้งตามมาตรา 4 ซึ่งให้ฐานทางคดีโดยตรงที่ยังไม่มีเขตอำนาจอื่นเทียบได้
สหราชอาณาจักรที่ 67% ต่ำกว่า และเหตุผลคือสำนักข่าวใหญ่หลายแห่ง (thesun.co.uk, dailymail.co.uk, mirror.co.uk) ใช้บล็อกแบบ deny-all ผ่าน User-agent: * แทนที่จะใช้กฎเฉพาะ AI ทำให้ตัวเลข explicit ลดลงเหลือ 53% ผลรวมเชิงปฏิบัติไม่ต่างกัน — เว็บไซต์เหล่านี้ไม่อนุญาตให้ AI crawl — แต่ถ้อยคำของนโยบายถูกแสดงเป็น "ไม่มีบอทใดเลยยกเว้นรายชื่อ search engine ที่อนุญาต" มากกว่าจะเป็นการปฏิเสธบอท AI ที่มีชื่อระบุ ฐานกฎหมายก็อ่อนกว่า: หลัง Brexit สหราชอาณาจักรรับแนวคิด Article 4 มา แต่แนวคดีในประเทศที่สอดรับยังบางกว่า
ข่าวรัสเซีย 0% คือแถวที่น่าประหลาดที่สุด สิบสามเว็บไซต์ข่าวโดเมนรัสเซียในตัวอย่าง (dzen.ru, rbc.ru, ria.ru, kommersant.ru, tass.ru, lenta.ru, gazeta.ru, interfax.ru, kp.ru, tass.com, ฯลฯ) ไม่มีเว็บใดบล็อก AI crawler เลย คำอธิบายที่เป็นไปได้: การฝึก LLM ภาษารัสเซียถูกครอบงำโดยโมเดลสไตล์ GPT ของ Yandex เอง (ซึ่งใช้ crawler ภายในของ Yandex ไม่ใช่ Common Crawl) สภาพแวดล้อมลิขสิทธิ์ของรัสเซียยังไม่มี Article 4 ฉบับเทียบเท่า และสำนักพิมพ์ใหญ่ในรัสเซียมองว่า LLM ตะวันตกไม่ใช่ปัญหา (มาตรการควบคุมการส่งออกของสหรัฐฯ จำกัดบริการ OpenAI/Anthropic ในรัสเซียอยู่แล้ว) ส่วน Yandex เป็นผู้มีส่วนได้ส่วนเสียในประเทศมากกว่าจะเป็นคู่แข่ง ท่าทีเชิงนโยบายจึงต่างออกไปอย่างชัดเจน
ข่าวญี่ปุ่น 25% เป็นอีกแบบหนึ่ง ญี่ปุ่นมีข้อยกเว้น text-and-data mining ที่ชัดในกฎหมายลิขสิทธิ์ภายในประเทศ (มาตรา 30-4 ของ Copyright Act ญี่ปุ่น แก้ไขปี 2018) ซึ่ง เปิดกว้างกว่า Article 4 ของ EU Directive — อนุญาต TDM เพื่อวัตถุประสงค์แบบ "non-enjoyment" รวมถึงการฝึก AI โดยไม่ต้องขอความยินยอมจากเจ้าของสิทธิ์ สำนักพิมพ์ญี่ปุ่นจึงมีแรงทางกฎหมายน้อยกว่าสำหรับการ opt-out และอัตรา robots.txt ที่เกี่ยวข้องจึงต่ำกว่า 25% ที่บล็อกมักเป็นสำนักพิมพ์ใหญ่ระดับสากล (asahi.com, nikkei.com) ที่วางตัวเป็นสื่อระหว่างประเทศมากกว่าตลาดในประเทศ
ข้อมูลข่าวข้ามประเทศเป็นหลักฐานที่ชัดที่สุดในรายงานนี้ว่า กรอบกฎหมาย ไม่ใช่เทคโนโลยีหรือเศรษฐศาสตร์อุตสาหกรรม คือแรงขับหลักของการบล็อก AI กลุ่มข่าวใน EU กระจุกระหว่าง 54% ถึง 88%; กลุ่มข่าวนอก EU (รัสเซีย ญี่ปุ่น กลุ่ม .com ทั่วโลก) อยู่ระหว่าง 0% ถึง 45% จุดสูงสุด 88% อยู่ในประเทศที่มีการ implement Article 4 เข้มที่สุด; จุดต่ำสุด 0% อยู่ในประเทศที่แทบไม่มีมาตรการนโยบาย AI เลย
ข้อค้นพบ 7 — EU เทียบกับที่เหลือ: ช่องว่าง 16 จุด
เมื่อยกเลนส์ระดับประเทศขึ้นอีกขั้น การแบ่ง EU เทียบกับที่เหลือเด่นชัดมาก:
| ภูมิภาค | n | บล็อก AI ใดก็ได้ | Explicit |
|---|---|---|---|
EU ccTLDs (.fr, .de, .es, .it, .nl, .pl, .se, .dk, .fi, .be, .at, .cz, .hu, .ro, .gr, .pt, .ie, .sk, .bg) | 617 | 35.2% | 33.9% |
ccTLD ของประเทศนอก EU (.uk, .jp, .kr, .cn, .ru, .br, .in, .au, .mx, .ca, .tr, .ar, .cl, .co, .pe) | 897 | 17.2% | 13.6% |
ทั่วโลก (.com, .net, .org, ฯลฯ) | 5,734 | 19.2% | 15.7% |
เว็บไซต์ ccTLD ของ EU บล็อก AI ในอัตราสูงกว่ากลุ่มประเทศนอก EU ถึงสองเท่า และสูงเกือบสองเท่าของ baseline .com ทั่วโลก ความต่างนี้สม่ำเสมอในทุกประเทศสมาชิก EU (ไม่มีประเทศเดียวที่เป็นตัวดันค่าเฉลี่ย) และสม่ำเสมอในทุกอุตสาหกรรม (.de ข่าวที่ 88%, .de SaaS ที่ประมาณ 12%, .de อีคอมเมิร์ซที่ประมาณ 25% — สูงกว่าคู่เทียบทั่วโลกทั้งหมด)
เราพบไฟล์ robots.txt 275 ไฟล์ในท็อป 10k ที่ อ้างถึง Directive 2019/790 โดยตรงในคอมเมนต์ — ประมาณ 3.8% ของตัวอย่างที่อ่านได้ กลุ่มนี้ถูกครองโดยสำนักพิมพ์ EU แต่ก็เลยไปนอก EU ด้วย: สำนักข่าวสหรัฐบางราย (โดยเฉพาะ NYT ที่อ้าง "Art. 4 of the EU Directive" โดยตรง) เว็บไซต์ UK บางราย และเว็บไซต์อีคอมเมิร์ซยุโรปรายใหญ่บางราย ต่างก็ใช้ถ้อยคำทางกฎหมายนี้ซ้ำ 87 ไฟล์กล่าวถึง "TDM" หรือ "text and data mining" โดยชื่อ 460 ไฟล์มีถ้อยคำสงวนลิขสิทธิ์ในรูปแบบใดรูปแบบหนึ่ง ("expressly opts out," "all rights reserved," "no commercial use," "no machine learning") แม้จะไม่ได้อ้างกฎหมายเฉพาะ
ข้อสังเกตเพิ่มเติมจากมุมนี้:
ผลของ EU ไม่ได้จำกัดแค่ข่าว เมื่อเราคงหมวดข่าวไว้ เว็บไซต์ EU ที่ไม่ใช่ข่าวยังบล็อก AI ในอัตราสูงกว่าเว็บไซต์ที่ไม่ใช่ข่าวในนอก EU (ประมาณ 28% เทียบกับ 14%) เว็บไซต์ SaaS อีคอมเมิร์ซ และ academia บางส่วนใน EU ซึมซับกรอบ Article 4 มาใช้กับภาคส่วนของตนเองแล้ว
ภาษาแบบ EU กำลังกลายเป็นเทมเพลตโดยพฤตินัยแม้นอก EU เทมเพลต robots.txt แบบ Cloudflare Managed — ที่ถูกใช้งานทั่วโลก — อ้าง "ARTICLE 4 OF THE EUROPEAN UNION DIRECTIVE 2019/790" ไว้อย่างชัดเจนในข้อความมาตรฐาน เว็บไซต์สหรัฐที่เปิดสวิตช์ "Block AI Bots" ของ Cloudflare จึงเท่ากับกำลังอ้างสิทธิ์ตามกฎหมาย EU โดยที่อาจไม่รู้ตัว นี่เป็นหนึ่งในหลักฐานการไหลของนโยบายที่น่าสนใจที่สุดที่เราพบ: แนวคิดทางกฎหมายของยุโรปกำลังถูกทำให้เป็นสากลผ่าน UI ของผู้ให้บริการโครงสร้างพื้นฐานในสหรัฐฯ
ข้อค้นพบ 8 — เทมเพลตและต้นกำเนิดของเทมเพลต
การแยกแหล่งที่มาของเทมเพลตสำหรับ 6,638 เว็บไซต์ที่ตอบ robots.txt แบบอ่านได้:
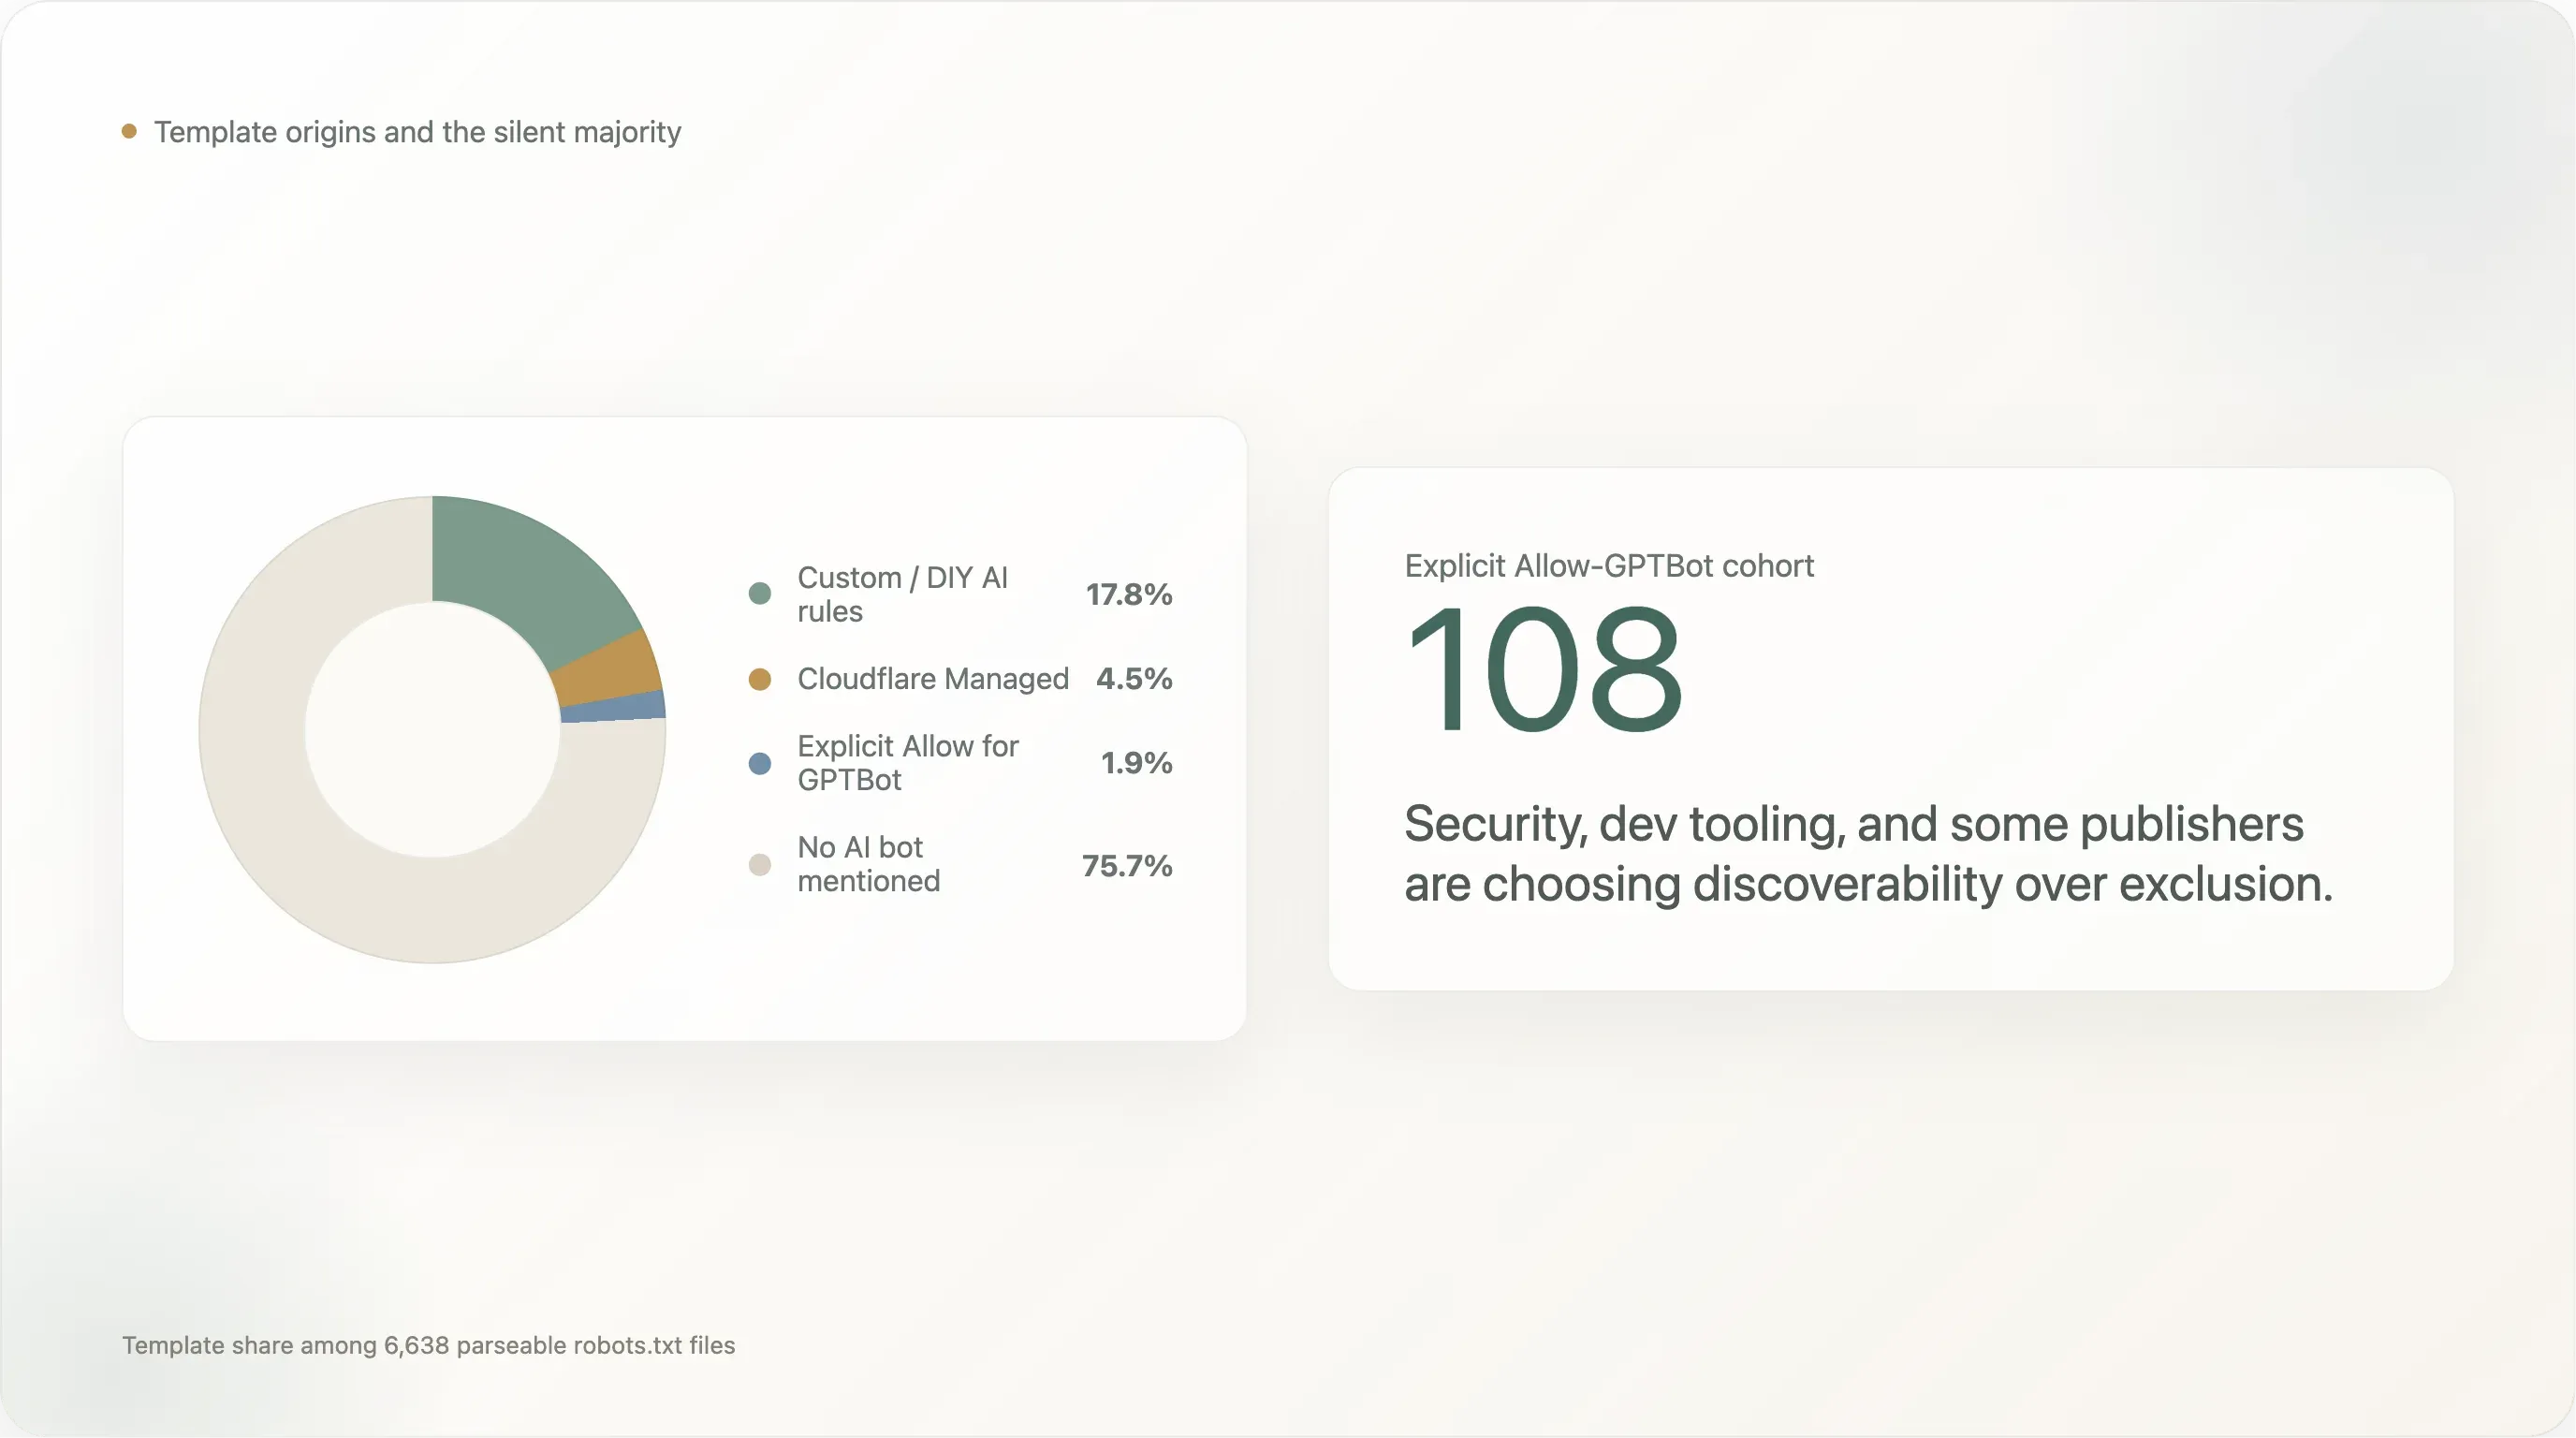
| เทมเพลต | เว็บไซต์ | สัดส่วน |
|---|---|---|
| ไม่กล่าวถึง AI bot เลย (ค่าเริ่มต้นแบบ Shopify, Yoast, หรือเขียนเองโดยไม่คำนึงถึง AI) | 5,024 | 75.7% |
| กฎ AI แบบ Custom / DIY | 1,183 | 17.8% |
Cloudflare Managed (Content-Signal: search=yes,ai-train=no) | 302 | 4.5% |
Explicit Allow: / สำหรับ GPTBot | 124 | 1.9% |
| ค่าเริ่มต้นของ Squarespace (28 AI UA ในบล็อกที่จำกัดเฉพาะพาธ) | 5 | 0.1% |
กฎแบบเขียนเองครองสัดส่วนที่ 17.8% กลุ่มผู้บล็อกที่เขียนเองถูกนำโดยทุกแพลตฟอร์มโซเชียลมีเดีย (facebook.com, twitter.com, linkedin.com, whatsapp.com, tiktok.com, snapchat.com, pinterest.com, x.com, chatgpt.com เอง), เว็บไซต์อีคอมเมิร์ซรายใหญ่ (amazon.com, amazonvideo.com), แบรนด์ข่าวชั้นนำ (nytimes.com, cnn.com, bbc.com, theguardian.com, forbes.com, reuters.com, bbc.co.uk, t-online.de, weather.com), สตรีมมิง/สื่อสำคัญ (netflix.com, vimeo.com, soundcloud.com, imdb.com), และเว็บไซต์บริการมืออาชีพอีกยาวเหยียด (canva.com, medium.com)
Cloudflare Managed อยู่ที่ 4.5% — สูงกว่าสัดส่วนของเทมเพลตเดียวกันในช่วงหัวกราฟมาก และต่ำกว่าสัดส่วนในหางยาวนอกขอบเขตของรายงานนี้ เทมเพลตนี้ถูกใช้มากที่สุดในช่วงอันดับ 1001–10000 (4–5%) และแทบไม่มีในหัวกราฟจริง ๆ (Top 100: ใช้ 1 เว็บไซต์; Top 101–1000: 5 เว็บไซต์) เว็บไซต์ระดับโลกขนาดใหญ่เขียนกฎเอง; หางยาวใช้สวิตช์ของผู้ให้บริการ
มีเว็บไซต์ Cloudflare Managed บางแห่งที่น่าสังเกต cloudflare.com เองก็ใช้เทมเพลตนี้ ซึ่งสอดคล้องกัน (Cloudflare กินอาหารสุนัขของตัวเองบนโดเมนของตัวเอง) theatlantic.com ใช้เทมเพลตนี้ — เป็นแบรนด์ข่าวสหรัฐรายใหญ่เพียงรายเดียวที่เราพบว่าไม่ได้เขียนกฎเอง spankbang.com ใช้เทมเพลตนี้ — เว็บไซต์ผู้ใหญ่ที่มีอันดับสูงสุดที่ใช้บล็อก AI จาก Cloudflare linktr.ee ใช้เทมเพลตนี้ ซึ่งบล็อก AI training ครอบคลุมทั้ง creator economy ที่โฮสต์บน Linktree ด้วยการตัดสินใจจากผู้ให้บริการเพียงรายเดียว launchpad.net, nexusmods.com, vinted.fr, cookielaw.org, rustdesk.com และสื่อขนาดเล็กอีกยาวเหยียดเติมเต็มกลุ่ม Cloudflare Managed ที่มองเห็นได้
รูปแบบการใช้งาน Cloudflare คือหลักฐานที่ชัดเจนที่สุดที่เราเห็นว่าคำว่า "นโยบาย AI ของเว็บ" จำนวนมากกำลังถูกตัดสินโดยผู้ให้บริการโครงสร้างพื้นฐาน สัดส่วนสัมบูรณ์อาจเล็ก (4.5%) แต่สำคัญเชิงโครงสร้าง: เทมเพลตนี้คือค่า default ที่ Cloudflare ส่งออก และแนวโน้มที่จะเปิดใช้งานโดยค่าเริ่มต้นใน 12 เดือนถัดไปก็เพิ่มขึ้น ถ้า Cloudflare เปลี่ยนให้สวิตช์เปิดโดยค่าเริ่มต้นสำหรับบัญชีใหม่ อัตราบล็อกทั่วโลกจะขยับขึ้นจริงโดยที่ไม่มีสำนักพิมพ์รายใดต้องตัดสินใจ
ค่าเริ่มต้นของ Squarespace (5 เว็บไซต์ในท็อป 10k แต่มีจำนวนมากกว่านั้นนอกตัวอย่างเรา) เป็นอีกแบบหนึ่ง: Squarespace ส่ง robots.txt ที่ระบุ AI bot 28 ตัวในบล็อกเดียว แต่บอทเหล่านั้นรับผลของข้อจำกัดพาธจาก User-agent: * แทนที่จะถูกแบนทั้งเว็บไซต์ AI crawler ยังดึง /, หน้าโฮมเพจ, หน้าผลิตภัณฑ์, บล็อกได้ เพียงแต่ดึง /config หรือ /account ไม่ได้ เราเคยชี้ว่าประเด็นนี้เป็นสาเหตุของการอ่าน "AI block" แบบผิดบวกในสแกนของบุคคลที่สามบนเว็บไซต์ Squarespace มาก่อน ข้อควรระวังเดียวกันนี้ใช้กับที่นี่เช่นกัน
ข้อค้นพบ 9 — นโยบาย AI สม่ำเสมอทั่วทั้งการกระจายอันดับ
สัญชาตญาณทั่วไปสำหรับการศึกษาประเภทนี้คือเว็บไซต์ที่มีผู้เข้าชมมากที่สุดน่าจะมีนโยบาย AI ที่เข้มที่สุด — พวกเขามีสิ่งให้เสียจากการแทนที่ด้วยการฝึกมากที่สุด มีศักยภาพด้านกฎหมายมากที่สุด และถูกจับตามองสาธารณะมากที่สุด แต่ข้อมูลไม่สนับสนุนสัญชาตญาณนั้น
| ช่วงอันดับ | n | บล็อก AI ใดก็ได้ | Explicit | Cloudflare Managed |
|---|---|---|---|---|
| ท็อป 100 | 67 | 22.4% | 17.9% | 1 เว็บไซต์ |
| ท็อป 101–1,000 | 598 | 22.9% | 19.2% | 5 เว็บไซต์ |
| ท็อป 1,001–5,000 | 2,810 | 19.0% | 15.3% | 99 เว็บไซต์ |
| ท็อป 5,001–10,000 | 3,773 | 20.8% | 17.8% | 197 เว็บไซต์ |
ทั้ง 4 ช่วงอยู่ระหว่าง 19% ถึง 23% ท็อป 100 ไม่ได้เข้มไปกว่าหางยาว 5001–10000 เลย อัตราหัวข้อข่าวจึงดูเหมือนคุณสมบัติของเว็บสาธารณะในปี 2026 มากกว่าจะเป็นสัญญาณว่าเว็บไซต์ใดเว็บไซต์หนึ่งใหญ่หรือโดดเด่นแค่ไหน
มีสองปัจจัยที่ช่วยอธิบาย หนึ่ง หัวกราฟถูกครอบงำด้วยโดเมนโครงสร้างพื้นฐาน / SaaS / search / portal (Microsoft, Apple, Google ฯลฯ) ซึ่งมีอัตราบล็อก AI ต่ำอยู่แล้ว สอง หางยาวมีสัดส่วนสูงของสำนักข่าวภูมิภาคและเว็บไซต์ในเขตอำนาจ EU ซึ่ง — ดังที่ข้อค้นพบ 6 และ 7 แสดง — บล็อก AI มากกว่าค่าเฉลี่ยโลก ผลทั้งสองเกือบหักล้างกัน และผลลัพธ์สุทธิคือหัวเรื่องที่สม่ำเสมอ
คอลัมน์ Cloudflare Managed มีการขยับตามกราฟมากกว่าค่าอื่น ท็อป 1000 มีเว็บไซต์ Cloudflare-managed 6 แห่ง (1.0%); ท็อป 1001–10000 มี 296 แห่ง (5.7%) เว็บไซต์ขนาดใหญ่เขียนเอง; หางยาวใช้สวิตช์ของผู้ขาย นี่คือสัญญาณเดียวที่มีความหมายตามอันดับในชุดข้อมูล และชี้ว่า เมื่อไล่ลงจากหัวเว็บไปหาหางยาว สัดส่วนของนโยบาย AI ที่ผู้ให้บริการตั้งให้แทนสำนักพิมพ์จะเพิ่มขึ้นเรื่อย ๆ เราคาดว่ากราดิเอนต์นี้จะต่อเนื่องเลยท็อป 10k ไปถึงท็อป 100k และมากกว่านั้น
ข้อค้นพบ 10 — 5 รูปร่างของไฟล์: robots.txt จะหน้าตาอย่างไรเมื่อมันเป็นนโยบายจริง ๆ
ตัวเลขบอกภาพรวมของชุดข้อมูล แต่ลักษณะที่แท้จริงของ "นโยบาย AI บนเว็บสาธารณะ" จะเห็นดีที่สุดเมื่ออ่านไฟล์จริง นี่คือ 5 ตัวอย่างที่ควรหยุดดู
รูปร่างที่ 1 — The New York Times (nytimes.com)
14 บรรทัดแรกของ nytimes.com/robots.txt:
# เนื้อหาของ New York Times เปิดให้คุณใช้เพื่อการส่วนตัวและไม่เชิงพาณิชย์
# ภายใต้เงื่อนไขการให้บริการของเราที่นี่:
# https://help.nytimes.com/hc/en-us/articles/115014893428-Terms-of-Service.
# การใช้เครื่องมือ อุปกรณ์ หรือกระบวนการใด ๆ ที่ออกแบบมาเพื่อขุดข้อมูลหรือสแครปเนื้อหา
# ด้วยวิธีอัตโนมัติเป็นสิ่งต้องห้าม เว้นแต่จะได้รับอนุญาตเป็นลายลักษณ์อักษรล่วงหน้าจาก
# The New York Times Company การใช้งานที่ต้องห้ามรวมถึงแต่ไม่จำกัดเพียง:
# (1) กิจกรรม text and data mining ภายใต้มาตรา 4 ของ EU Directive ว่าด้วยลิขสิทธิ์ใน
# ตลาดดิจิทัลเดียว;
# (2) การพัฒนาซอฟต์แวร์ใด ๆ machine learning, artificial intelligence (AI),
# และ/หรือ large language models (LLMs);
# (3) การสร้างหรือให้ชุดข้อมูลที่เก็บถาวรหรือแคชซึ่งมีเนื้อหาของเราแก่ผู้อื่น; และ/หรือ
# (4) วัตถุประสงค์เชิงพาณิชย์ใด ๆ
# ติดต่อ https://nytlicensing.com/contact/ เพื่อขอความช่วยเหลือ
นี่คือ robots.txt ในฐานะหลักฐานทางกฎหมาย ไฟล์นี้ถูกจัดรูปแบบให้ใช้เป็นหลักฐานได้ในคดี NYT v. OpenAI ที่เป็นคู่ความอยู่ การอ้าง "Art. 4 of the EU Directive" — โดยสำนักพิมพ์สหรัฐ — แสดงให้เห็นข้อสังเกตของข้อค้นพบ 7 ว่าเฟรมกฎหมายของ EU กำลังรั่วไหลเข้าสู่การสนทนาทั่วโลก การห้ามอย่างชัดแจ้งเรื่อง "การสร้างหรือให้ชุดข้อมูลที่เก็บถาวรหรือแคช" มุ่งตรงไปที่ Common Crawl ไฟล์นี้ยาวกว่า 60 บรรทัด มีบล็อก User-agent ที่ระบุชื่อบอทสำหรับ GPTBot, OAI-SearchBot, ChatGPT-User, anthropic-ai, ClaudeBot, CCBot, Google-Extended, Applebot-Extended, Bytespider, Diffbot, Meta-ExternalAgent, Amazonbot, Omgili, Omgilibot และอีกหลายตัว บอทที่ถูกระบุชื่อทุกตัวมี Disallow: / ของตัวเอง
รูปร่างที่ 2 — Der Spiegel (spiegel.de) — การให้สิทธิ์ AI ระดับส่วนย่อย
Der Spiegel คือไฟล์ robots.txt ที่ซับซ้อนเชิงปฏิบัติการที่สุดที่เราพบในชุดข้อมูลทั้งหมด บล็อกที่เกี่ยวข้อง:
# TLP-6507: เปิดการใช้งาน OpenAI search crawler แบบทดลองสำหรับบางส่วนที่เลือกไว้
User-agent: OAI-SearchBot
Allow: /ausland/
Allow: /partnerschaft/
Allow: /gesundheit/
Allow: /familie/
Allow: /reise/
Allow: /psychologie/
Allow: /stil/
Disallow: /

User-agent: ChatGPT-User
Allow: /ausland/
Allow: /partnerschaft/
Allow: /gesundheit/
Allow: /familie/
Allow: /reise/
Allow: /psychologie/
Allow: /stil/
Disallow: /
คอมเมนต์นี้แปลว่า "เปิดใช้งาน OpenAI search crawler แบบทดสอบสำหรับบางหมวดที่เลือก" Spiegel white-list หมวดเนื้อหา 7 หมวด — ข่าวต่างประเทศ ความสัมพันธ์ สุขภาพ ครอบครัว การท่องเที่ยว จิตวิทยา และไลฟ์สไตล์ — ให้กับ UA สำหรับ inference ของ OpenAI ขณะที่ที่เหลือถูกบล็อกทั้งหมด ส่วนข่าวการเมือง ข่าวเยอรมันระดับชาติ และงานสืบสวนถูกยกเว้นอย่างชัดแจ้ง Common Crawl, Bytespider, Cohere, Webzio-Extended และ UA ฝึกข้อมูลอื่น ๆ ถูกสั่ง Disallow: / ทั้งหมดในส่วนถัดลงไปของไฟล์
นี่คือ robots.txt ในฐานะนโยบายเชิงบรรณาธิการระดับส่วนย่อย ทฤษฎีโดยนัยคือ เนื้อหาไลฟ์สไตล์มีความเสี่ยงต่อการถูกแทนที่ในการฝึกต่ำกว่า และให้ประโยชน์จากการถูกอ้างอิงใน inference สูงกว่า ดังนั้น Spiegel จึงอนุญาตให้ AI แสดงผลส่วนเหล่านั้น; เนื้อหาการเมืองและสืบสวนคือกำแพงป้องกัน จึงไม่เปิดให้ AI เราไม่เห็นรูปแบบนี้ที่อื่น มันบ่งชี้ถึงการประสานงานภายในระดับสูงระหว่างกองบรรณาธิการ กฎหมาย และทีมโครงสร้างพื้นฐาน ซึ่ง newsroom ส่วนใหญ่ยังไปไม่ถึง เราคาดว่านโยบายละเอียดระดับส่วนย่อยแบบนี้จะกระจายต่อในปี 2026–2027 — ไฟล์ของ Spiegel คือ leading indicator
รูปร่างที่ 3 — BBC (bbc.com) — รูปแบบถ้อยแถลงเชิงนโยบาย
robots.txt ของ BBC เปิดด้วย:
# version: ec59bd036e5138eb4831a9ed44447b1ff310e235
# BBC's Terms of Use: https://www.bbc.co.uk/terms
# - อธิบายกฎสำหรับการใช้บริการของเรา
# - บอกคุณว่าคุณทำอะไรกับเนื้อหาของเราได้บ้าง
#
# สรุปสั้น ๆ: โปรดใช้เว็บไซต์ของเราแบบมนุษย์ ไม่ใช่หุ่นยนต์
# ซึ่งหมายความว่า:
# - ห้ามสแครป ครอว์ล หรือสกัดเนื้อหาอย่างเป็นระบบ
# - ห้ามใช้เนื้อหา BBC เพื่อฝึกหรือปรับแต่งโมเดล AI รวมถึง LLM
# - ห้ามใช้ retrieval-augmented generation (RAG), การค้นหาด้วย AI, agentic AI หรือ
#   grounding โดยใช้เนื้อหา BBC
# - ห้ามสร้างชุดข้อมูลจากเนื้อหา BBC
# - ห้าม text and data mining (TDM) ภายใต้มาตรา 4 ของ EU Directive ว่าด้วยลิขสิทธิ์
# - ห้ามใช้เนื้อหา BBC เพื่อสร้างสรุปสำหรับการใช้งานของคุณเอง
# - ห้ามใช้เชิงธุรกิจโดยไม่ได้รับอนุญาต
# - BBC สงวนสิทธิ์ทั้งหมดในเนื้อหา และขอสงวนสิทธิ์อย่างชัดแจ้งจากข้อยกเว้นตามกฎหมายใด ๆ
#   ในเขตอำนาจใดก็ตามสำหรับ text and data mining ตามที่กฎหมายอนุญาต
#
# TL;DR: Browse, read, watch, enjoy - like a human.
BBC ใส่เวอร์ชันสตริงไว้ใน robots.txt (# version: ec59bd... คือ git commit hash) ห้ามการใช้งาน AI แบบเฉพาะ 8 ประเภทที่ทีมกฎหมาย BBC กำลังติดตาม และปิดท้ายด้วยสรุปสั้นบรรทัดเดียวในน้ำเสียงที่สะท้อนแบรนด์ BBC วลี "expressly opts out of any statutory exceptions in any jurisdiction" เป็นการสงวนสิทธิ์ระดับโลกโดยตั้งใจ — หมายถึง เราไม่เชื่อว่ากรอบกฎหมายใดกรอบหนึ่งจะให้การคุ้มครองที่เราต้องการ ดังนั้นเราขอ opt-out ทุกที่พร้อมกัน นี่คือไฟล์ robots.txt ที่ถูกร่างหนักที่สุดในชุดข้อมูล อ่านแล้วเหมือนถ้อยแถลงข่าวมากกว่าคอนฟิก
รูปร่างที่ 4 — WordPress.org — การต้อนรับอย่างเปิดเผย
เทียบทั้งหมดนี้กับ wordpress.org:
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: anthropic-ai
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: Applebot-Extended
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Bytespider
Allow: /

User-agent: CCBot
Allow: /

User-agent: Copilot
Allow: /
WordPress.org ประกาศเปิดรับ crawler ฝึก AI 9 ตัวอย่างชัดเจน รวมถึง 3 ตัว (Bytespider, CCBot, anthropic-ai) ที่มักถูกบล็อกมากที่สุดที่อื่น ทฤษฎีโดยนัยคือเอกสาร WordPress และระบบปลั๊กอินของมันคือ ประโยชน์สาธารณะที่ยิ่งมี AI assistant ตอบคำถามได้ดีเท่าไรยิ่งมีค่า ทุกครั้งที่มีคนถาม Claude ว่า "จะตั้งค่า permalinks ใน WordPress ยังไง" และ Claude ถูกฝึกจาก wordpress.org/documentation/ ภารกิจของ WordPress ก็ถูกตอบสนองไปแล้ว ดูเหมือนมูลนิธิจะตัดสินว่า การอยู่ในคอร์ปัสฝึกของทุกโมเดลคือผลเชิงกลยุทธ์ในทางบวก และใช้ไวยากรณ์ของไฟล์นี้บอกอย่างนั้น
รูปร่างที่ 5 — The Verge (theverge.com) — แบบผสมที่มีสปอนเซอร์
อีกหนึ่งแพตเทิร์นที่ควรยกมา The Verge วางกฎ AI เป็น Disallow: / \ Allow: /sp/:
User-agent: GPTBot
Allow: /

User-agent: Applebot
Allow: /

User-agent: Google-Extended
Disallow: /
Allow: /sp/

User-agent: anthropic-ai
Disallow: /
Allow: /sp/

User-agent: Bytespider
Disallow: /
Allow: /sp/

User-agent: CCBot
Disallow: /
Allow: /sp/

User-agent: ChatGPT-User
Disallow: /
Allow: /sp/

User-agent: ClaudeBot
Disallow: /
Allow: /sp/
พาธ /sp/ คือส่วนคอนเทนต์สปอนเซอร์/พาร์ทเนอร์ของ The Verge เนื้อหาบรรณาธิการถูกบล็อกจากการฝึก AI; เนื้อหาสปอนเซอร์ถูกอนุญาต ตรรกะทางเศรษฐกิจชัดเจน: สปอนเซอร์ จ่าย เพื่อให้เนื้อหาของตนถูกค้นพบ รวมถึงผ่าน AI; ส่วนหัวเรือบรรณาธิการคือกำแพงป้องกัน GPTBot เปิดเต็มที่ (น่าจะเพราะความสัมพันธ์ตรงกับ OpenAI) Applebot เปิดเต็มในฐานะ baseline ของ search ส่วนที่เหลือได้แบบผสม นี่คือโครงสร้าง "tiered AI access" แบบเดียวที่เราเจอ
ไฟล์ทั้ง 5 นี้อธิบายขอบเขตปัจจุบันของนโยบาย AI ใน robots.txt ไฟล์ส่วนใหญ่ในท็อป 10k ไม่ได้หน้าตาแบบไหนเลยในนี้ — พวกมันเงียบ หรือไม่ก็ใช้เทมเพลตของผู้ให้บริการ ไฟล์ที่หน้าตาเหมือนหนึ่งในตัวอย่างเหล่านี้มักถูกเขียนโดยคนที่ตัดสินแล้วว่าควรอ่านอย่างละเอียด
ข้อสังเกตเรื่องขนาดไฟล์: body ของ robots.txt ค่ากลางในตัวอย่างเราอยู่ที่ 858 ไบต์ — เล็กเกินไปที่จะบรรจุนโยบาย AI ที่มีความหมาย หางขวาคือที่อยู่ของกฎ: 1,005 เว็บไซต์ (15.3%) มีไฟล์ใหญ่กว่า 5 KB, 273 ไฟล์ใหญ่กว่า 20 KB และค่าสูงสุดคือ 248 KB 460 ไฟล์มีถ้อยคำสงวนลิขสิทธิ์; 275 ไฟล์อ้างถึง EU 2019/790 โดยตรง robots.txt ในปี 2026 กำลังกลายเป็นเอกสารที่มีเวอร์ชันและผ่านการทบทวนโดยทนาย มากกว่าจะเป็นบรรทัดคอนฟิก
ข้อค้นพบ 11 — 108 เว็บไซต์ประกาศ ต้อนรับ GPTBot อย่างชัดเจน
มีกลุ่มเล็กแต่เห็นชัดที่เขียนกฎ User-agent: GPTBot \n Allow: / — ซึ่งเป็นภาพกลับด้านของกฎ "Disallow GPTBot" ที่ถูกพูดถึงมากกว่า จำนวนเต็มในตัวอย่างของเราคือ 108 เว็บไซต์ ที่ระบุ Allow สำหรับ GPTBot ที่พาธราก รายชื่อ 25 อันดับแรกตาม Tranco:
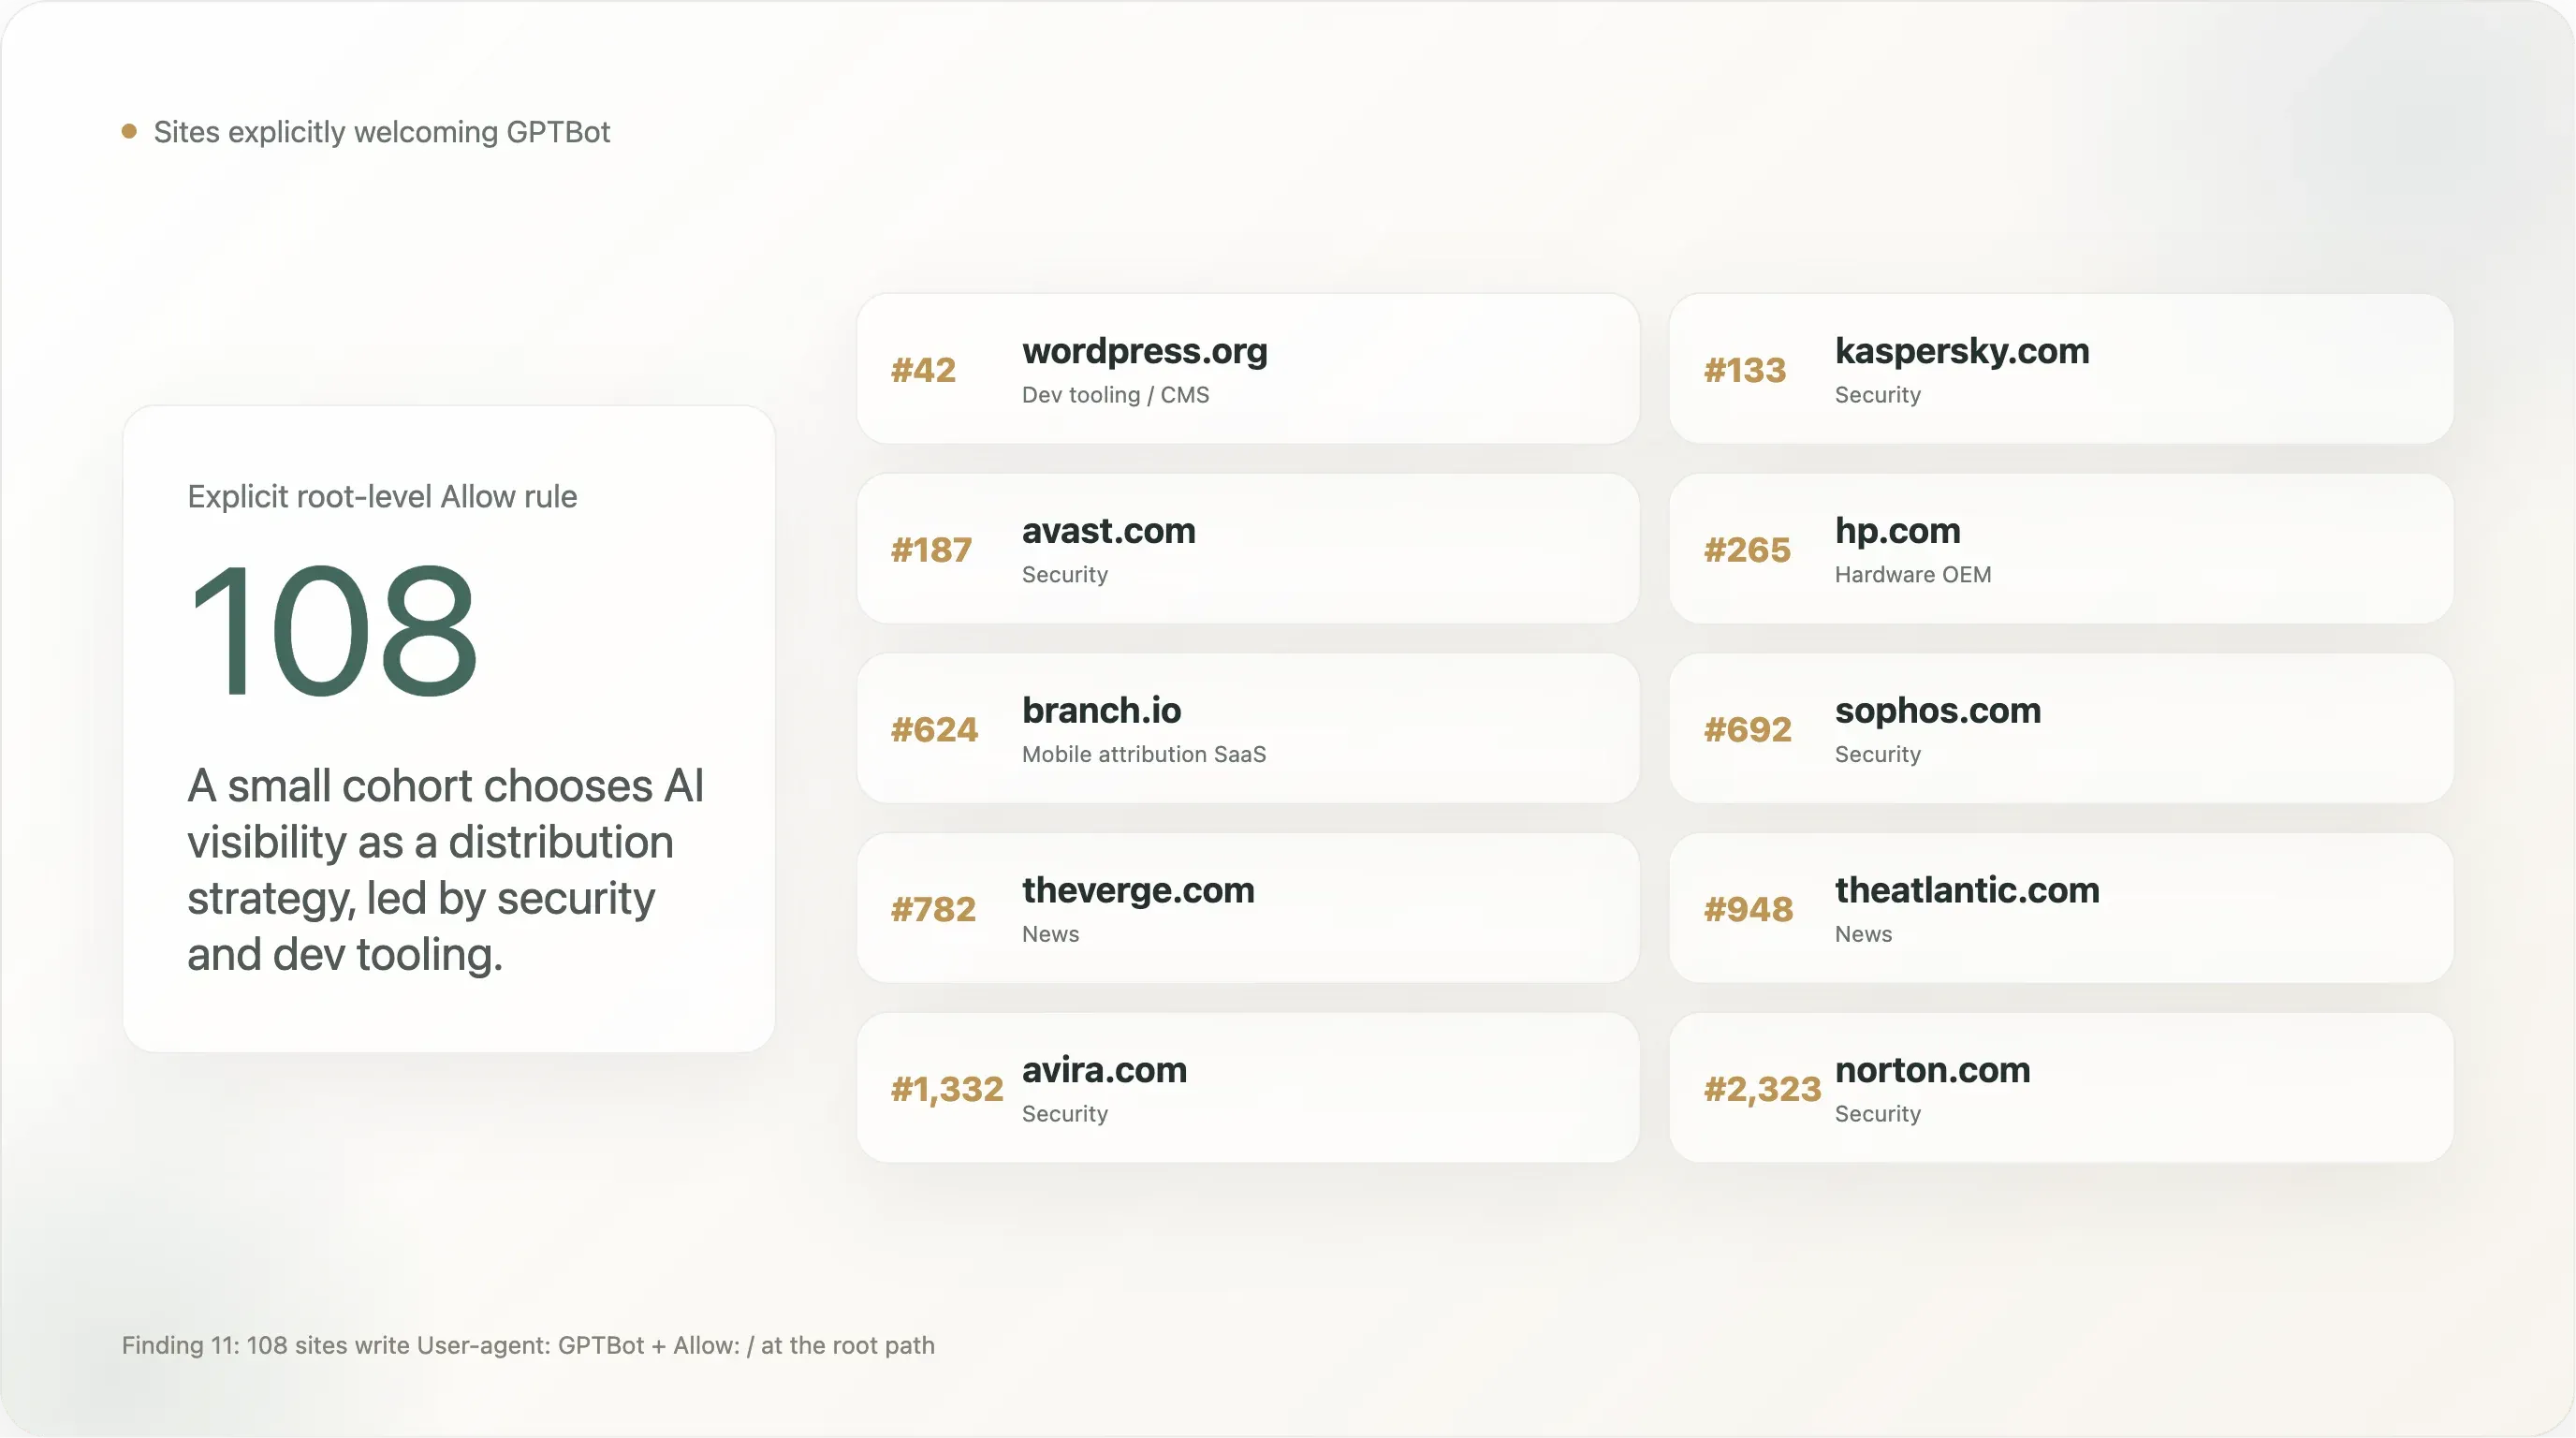
| อันดับ | โดเมน | ภาคส่วน |
|---|---|---|
| 42 | wordpress.org | เครื่องมือ dev / CMS |
| 133 | kaspersky.com | ความปลอดภัย |
| 187 | avast.com | ความปลอดภัย |
| 265 | hp.com | ผู้ผลิตฮาร์ดแวร์ |
| 624 | branch.io | SaaS ด้าน mobile attribution |
| 692 | sophos.com | ความปลอดภัย |
| 782 | theverge.com | ข่าว |
| 905 | rambler.ru | พอร์ทัลรัสเซีย |
| 945 | kleinanzeigen.de | มาร์เก็ตเพลสเยอรมัน |
| 948 | theatlantic.com | ข่าว |
| 1,092 | lge.com | LG Electronics |
| 1,300 | justdial.com | search ท้องถิ่นอินเดีย |
| 1,332 | avira.com | ความปลอดภัย |
| 1,412 | youm7.com | ข่าวอียิปต์ |
| 1,530 | goodreturns.in | การเงินอินเดีย |
| 1,621 | publi24.ro | classified โรมาเนีย |
| 1,807 | geocomply.com | SaaS ด้าน compliance |
| 1,908 | nba.com | กีฬา |
| 1,956 | oneindia.com | ข่าวอินเดีย |
| 1,974 | mindbox.ru | SaaS รัสเซีย |
| 2,009 | thesun.co.uk | ข่าว |
| 2,126 | vox.com | ข่าว |
| 2,140 | mgid.com | native advertising |
| 2,314 | ninjarmm.com | SaaS ด้าน IT management |
| 2,323 | norton.com | ความปลอดภัย |
รูปแบบบางอย่าง:
บริษัทด้านความปลอดภัยมีสัดส่วนสูงอย่างชัดเจน Kaspersky, Avast, Sophos, Avira, Norton, NinjaRMM ต่างอนุญาต GPTBot อย่างชัดเจน นี่คือกลยุทธ์กระจายสินค้าแบบตั้งใจ: เมื่อผู้ใช้ถาม ChatGPT ว่า "แอนติไวรัสตัวไหนดีที่สุดสำหรับเครื่อง Windows ของฉัน" การที่แบรนด์อยู่ในคอร์ปัสฝึกโมเดลส่งผลโดยตรงต่อคำแนะนำ ความปลอดภัยคือหนึ่งในไม่กี่หมวดสินค้า B2C ที่ AI search กำลังแทน SEO ในฐานะช่องทางหาลูกค้าหลัก และแบรนด์เหล่านี้ขยับก่อน เราคาดว่ากลุ่มความปลอดภัยที่เหลือจะตามมาใน 12 เดือนข้างหน้า
แบรนด์ข่าวใหญ่บางรายอยู่ในลิสต์ต้อนรับ ไม่ใช่ลิสต์บล็อก The Verge, The Atlantic, Vox, The Sun, NBA.com นี่ไม่ใช่ความขัดแย้ง — สำนักพิมพ์เหล่านี้ดูเหมือนจะตัดสินว่าการถูกอ้างอิงได้ภายใน ChatGPT search มีค่ามากกว่าการป้องกันไม่ให้ถูกฝึก และพวกเขาเขียนกฎ Allow แบบชัดเจนเพื่อป้องกันการบล็อกเกินจาก CDN หรือ CMS ของตน เปรียบเทียบกับท่าทีของ NYT / Reuters / BBC / Forbes / Guardian ที่เลือก Disallow อย่างชัดแจ้ง ทั้งสองแบบมีเหตุผลรองรับได้ อุตสาหกรรมข่าวไม่ใช่กลุ่มเดียวกันทั้งก้อน
การมีอยู่ของ The Sun น่าสนใจเป็นพิเศษ เพราะเว็บไซต์เดียวกันนี้ใช้บล็อก deny-all ผ่าน User-agent: * ในส่วนอื่นของไฟล์ มุมมองที่ดีที่สุดต่อ policy ของ The Sun คือ "ห้ามฝึก AI แต่อนุญาต AI search และเราได้ whitelist GPTBot เป็นข้อยกเว้นจาก deny-all เพื่อให้ ChatGPT ตอบคำถามโดยอ้างถึง The Sun ได้" นี่คือกฎ Allow-GPTBot ที่มีความซับซ้อนทางกฎหมายที่สุด — เป็นทั้ง opt-out และ opt-in กับผู้ให้บริการรายเดียวในคราวเดียว
การปรากฏของ WordPress.org คือรายการเดี่ยวที่มีผลกระทบมากที่สุด สัดส่วนที่ไม่เล็กของระบบนิเวศ CMS โอเพนซอร์สทั่วโลกเชื่อมต่อกับ WordPress.org เพื่อดูเอกสารหรือโฮสต์ปลั๊กอินจากที่นั่น การอนุญาต GPTBot อย่างชัดแจ้งใน wordpress.org/robots.txt จึงแทบเท่ากับการบอกว่าระบบนิเวศเอกสารของ WordPress เปิดสำหรับการฝึก ซึ่งส่งผลต่อความสามารถของ Claude, Gemini และ ChatGPT ในการตอบคำถามแนว "จะทำอย่างไร..." เกี่ยวกับ WordPress
อีก 83 เว็บไซต์ในรายการ Allow-GPTBot แบบเต็มคือหางยาวของข่าวภูมิภาค ผู้ขายความปลอดภัยรายเล็ก แพลตฟอร์ม classified ในตลาดที่ไม่ใช่ภาษาอังกฤษ และ SaaS แบบ B2B เท่าที่เรามองเห็น ไม่มีการประสานงาน "Allow-GPTBot" ระดับอุตสาหกรรมเกิดขึ้น — กฎนี้กำลังถูกใช้ทีละเว็บไซต์ โดยผู้ดูแลที่มองว่าการอยู่ในคอร์ปัสคือจุดยืนเชิงกลยุทธ์
ข้อค้นพบ 12 — llms.txt แทบยังเป็นแค่ข่าวลือในสเกลนี้
llms.txt ซึ่งเป็นรูปแบบไฟล์ทางเลือกที่เสนอสำหรับการค้นหาเนื้อหาที่เป็นมิตรกับ LLM (ได้รับการผลักดันโดย Mintlify, Anthropic, Vercel และผู้ให้บริการเครื่องมือ dev บางรายตั้งแต่ปลายปี 2024) แทบไม่มีการใช้งานให้เห็นในตัวอย่างของเรา
จาก 6,638 เว็บไซต์ที่ตอบ robots.txt แบบอ่านได้ มีเพียง 83 เว็บไซต์ (1.15%) ที่กล่าวถึง llms.txt — โดยมากมาในรูปบรรทัด Sitemap: https://example.com/llms.txt ซึ่งต่ำกว่าตัวชี้วัดเดียวกันที่วัดบนตัวอย่างอีคอมเมิร์ซที่มีเครื่องมือ dev หนาแน่นถึงสองลำดับชั้น เนื่องจากค่า default ของ Vercel และ Mintlify ทำให้อัตราการใช้งานพองขึ้น
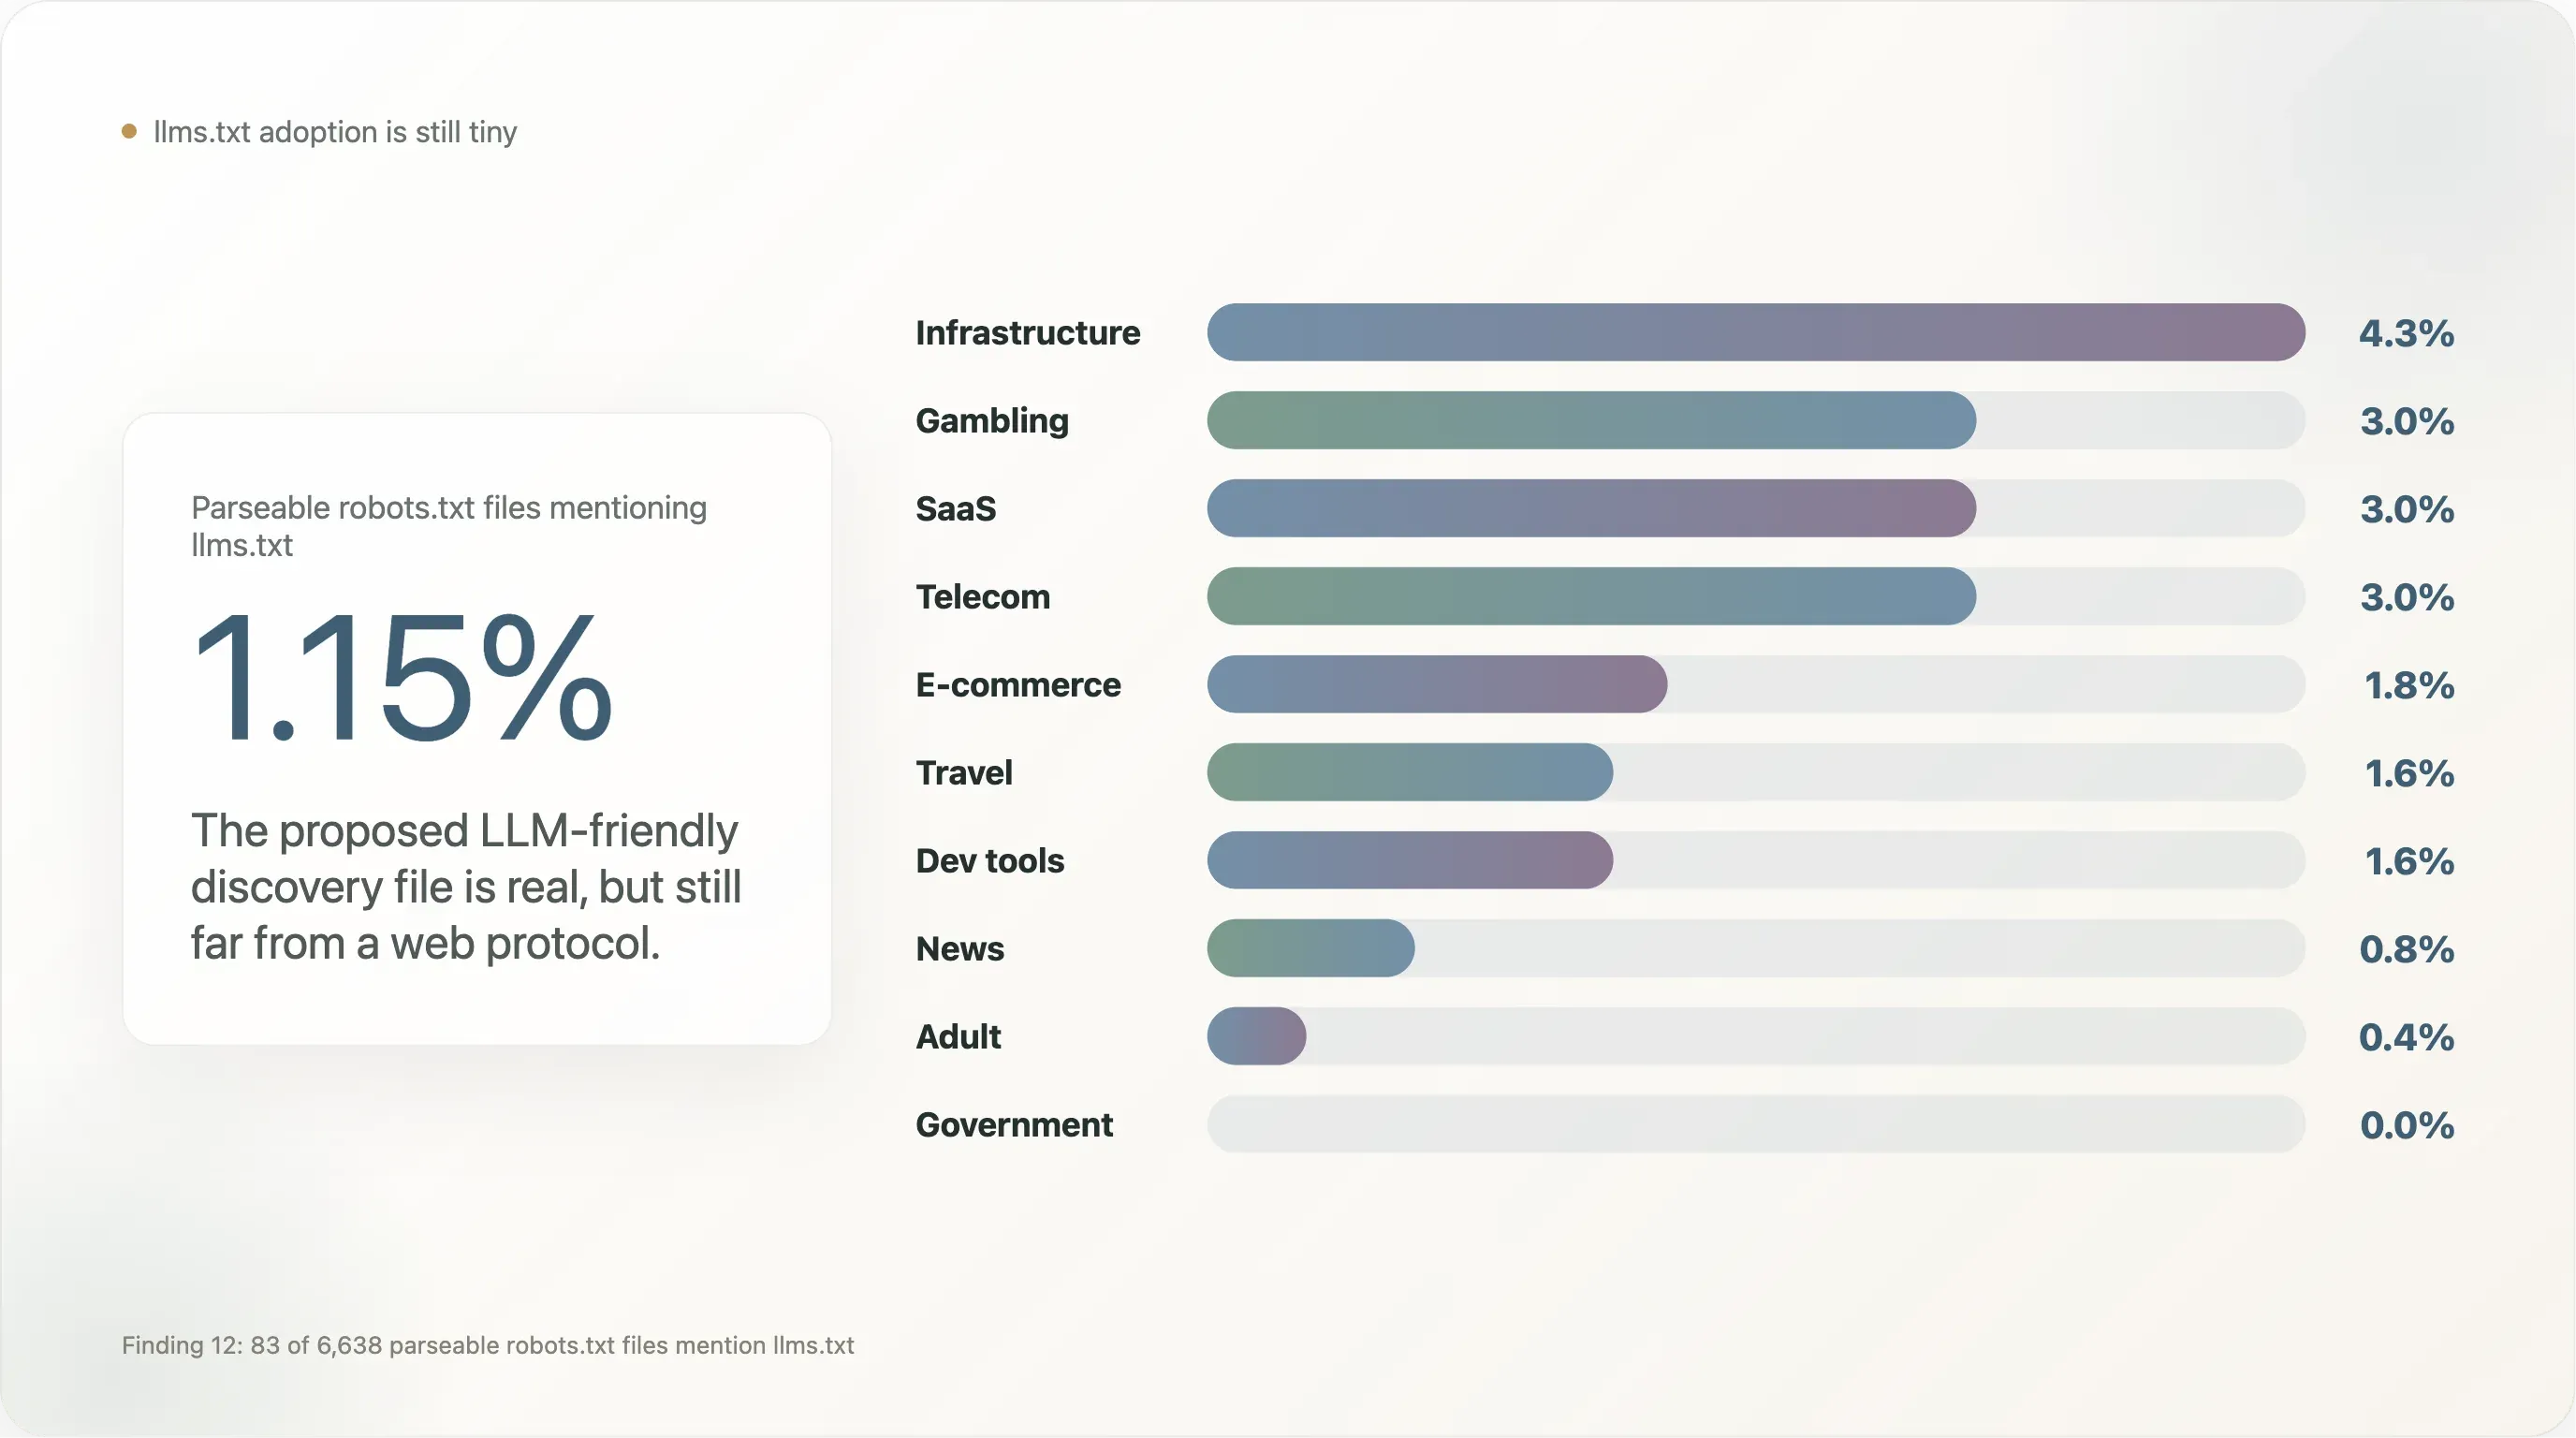
การแยกตามหมวดอุตสาหกรรม:
| อุตสาหกรรม | n | % ที่กล่าวถึง llms.txt |
|---|---|---|
| โครงสร้างพื้นฐาน | 47 | 4.3% |
| การพนัน | 100 | 3.0% |
| SaaS | 369 | 3.0% |
| โทรคมนาคม | 33 | 3.0% |
| อีคอมเมิร์ซ | 224 | 1.8% |
| ท่องเที่ยว | 64 | 1.6% |
| เครื่องมือสำหรับนักพัฒนา | 129 | 1.6% |
| ข่าว | 650 | 0.8% |
| ผู้ใหญ่ | 254 | 0.4% |
| ภาครัฐ | 172 | 0.0% |
| Academia | 268 | 0.0% |
| Search | 12 | 0.0% |
llms.txt กระจุกตัวอยู่ใน SaaS ที่อยู่ใกล้เครื่องมือ dev, การพนัน (ซึ่งรับฟีเจอร์ robots.txt คำศัพท์ใหม่ ๆ ได้เร็วกว่ากลุ่มอุตสาหกรรมที่มีการกำกับดูแลหนักอื่น ๆ เพราะมีทีม compliance คุ้นกับการวาง metadata ซ้อนชั้น), และอีคอมเมิร์ซแบบ B2B มันหายไปอย่างเห็นได้ชัดจากข่าวและภาครัฐ — สองภาคส่วนที่เกี่ยวข้องกับนโยบาย AI มากที่สุดและควรเป็นกลุ่มที่ทำให้มาตรฐานนี้ก้าวจาก "การทดลองของผู้ขาย" ไปเป็น "โปรโตคอลของเว็บ" จนกว่าจะถึงตอนนั้น llms.txt มีอยู่จริงแต่ยังเล็ก และการตรวจซ้ำในปลายปี 2026 จะเป็นการทดสอบซ้ำที่มีประโยชน์
ปัญหาเชิงโครงสร้างของ llms.txt คือมันไม่ได้ผ่านกระบวนการมาตรฐานของ IETF และผู้ให้บริการ AI รายใหญ่ก็ยังไม่ได้ผูกมัดว่าจะเคารพมัน กฎใน robots.txt มีโครงสร้างพื้นฐานสำหรับ crawler รองรับมา 30 ปีแล้ว ส่วน llms.txt ไม่มีเลย จนกว่าผู้ให้บริการรายใหญ่สักราย (OpenAI, Anthropic, Google, Cloudflare) จะประกาศรองรับอย่างเป็นทางการ ไฟล์นี้ก็ยังเป็นเพียงวัตถุเชิงการตลาดของระบบนิเวศ Mintlify / Vercel เราไม่คาดว่าจะเปลี่ยนในปี 2026
ข้อค้นพบ 13 — การเข้าถึง: robots.txt ยังอ่านได้สำหรับสองในสามของเว็บชั้นนำ
ข้อสังเกตข้างเคียงที่ไม่ได้ตั้งใจจะเป็นข้อค้นพบ: 66% ของท็อป 10,000 เว็บไซต์ส่ง robots.txt ที่อ่านได้กลับมายัง IP วิจัยเดียว และมีเพียง 7 จาก 10,000 (0.07%) ที่ตอบ 429 Too Many Requests ข้อดีคือ robots.txt ยังเป็นโปรโตคอลสาธารณะที่เข้าถึงได้
เพื่อเปรียบเทียบเดียวกัน กระบวนการนี้ที่รันบนตัวอย่างอีคอมเมิร์ซระดับกลาง 1,008 โดเมนเมื่อสองเดือนก่อน ได้ 429 จาก 52% ของโดเมนที่ resolve ได้ — Shopify และ CDN ของ Cloudflare throttling คำขอจาก UA ที่ไม่ใช่ search engine ใหญ่ ๆ อย่างแข็งขัน เว็บทราฟฟิกสูงเป็นมิตรกว่ามาก: เว็บไซต์ชั้นนำมักจะมีทั้ง (ก) ชั้น bot-management ที่เข้มไม่มาก หรือ (ข) allowlist ชัดเจนสำหรับ crawler วิจัยที่รู้จัก หรือทั้งสองอย่าง
อัตรา fetch_failed 21% ในท็อป 10k ถูกครอบงำโดยโดเมน apex ของ CDN (akamai.net, cloudfront.net, fastly.net, apple-dns.net, gtld-servers.net) ที่ไม่ได้รันเว็บเซิร์ฟเวอร์บน / พวกมันไม่ได้บล็อกเรา; แค่มันไม่มีอะไรให้บริการ เมื่อยกสิ่งเหล่านี้ออก อัตราล้มเหลวของการพยายามอ่านจริง ๆ อยู่ในระดับเลขตัวเดียวต้น ๆ
นั่นหมายความว่าการทำซ้ำรายงานนี้ในอนาคต — สแน็ปช็อตรายไตรมาส เปรียบเทียบปีต่อปี — สามารถทำได้ถูกและทำซ้ำได้บนเครื่องเดียว หน้าต่างการตรวจสอบยังเปิดอยู่ที่หัวกราฟ ด้านที่ไม่สมมาตรคือหางยาวและกลุ่มอีคอมเมิร์ซ ซึ่งการ throttling ระดับ CDN ได้ทำให้ robots.txt กลายเป็นของกึ่งเอกชนไปแล้ว เราคาดว่าความแตกต่างนี้จะยิ่งกว้างขึ้น: เว็บไซต์ชั้นนำจะยังอ่านได้เพราะ search engine ต้องการความอ่านได้ ส่วนอีคอมเมิร์ซหางยาวจะอ่านยากขึ้นเมื่อชั้น bot-fight ของ Cloudflare ดุดันกว่าเดิม ความสามารถในการตรวจสอบสาธารณะของ robots.txt กำลังแยกเป็นสองทางตามเส้นเดียวกับที่แยกระหว่าง "เว็บที่มองเห็นได้" กับ "เว็บที่ได้รับการป้องกันเชิงปฏิบัติการ"
IV. ทั้งหมดนี้แปลว่าอะไร
4 ข้อกล่าวอ้าง เรียงตามระดับที่ข้อมูลสนับสนุน
1. อินเทอร์เน็ตมีนโยบาย AI รายอุตสาหกรรม ไม่ใช่นโยบาย AI แบบทั่วโลก ช่องว่าง 12 เท่าระหว่างข่าวกับโทรคมนาคมครอบงำทุกตัวเลขรวม การรายงานว่า "X% ของเว็บบล็อก AI" โดยไม่แยกภาคส่วนทำให้ SaaS/ภาครัฐ/dev ถูกประเมินสูงไป และข่าว/ท่องเที่ยว/โซเชียลถูกประเมินต่ำไป การแยกตามภาคส่วนเท่านั้นคือกรอบที่ซื่อสัตย์
2. มาตรา 4 ของ EU Copyright Directive คือกรอบกฎหมายเดียวที่เห็นได้ชัดว่าทำให้ตัวเลขขยับ เว็บไซต์ ccTLD ของ EU บล็อกที่ 35% เทียบกับ baseline โลกที่ 19% คดีในสหรัฐฯ (NYT v. OpenAI, รายงานของ Copyright Office เดือนมกราคม 2025) ได้เปลี่ยนกลุ่มข่าวในสหรัฐฯ แต่ไม่ได้เปลี่ยนเว็บสหรัฐฯ ในภาพรวม กรอบของ EU ยังรั่วไหลไปทั่วโลกผ่านเทมเพลตของ Cloudflare ที่อ้าง Directive 2019/790 ไว้ในข้อความมาตรฐานไม่ว่าสมาชิกจะอยู่เขตอำนาจไหน
3. มีการแสดง "นโยบาย AI" สองแบบที่ทำงานคู่ขนานกันและไม่ลงรอยกัน นโยบายที่เขียนเองอย่างตั้งใจ (17.8%, ส่วนใหญ่เป็นข่าว/โซเชียล/ท่องเที่ยว/อีคอมเมิร์ซ) และนโยบายที่สืบทอดมาจาก Cloudflare Managed (4.5%) ซ้อนทับกันในสาระ แต่ต่างกันในความชอบธรรม ในโลกที่ผู้เล่น AI กำลังหาข้ออ้างทางกฎหมายเพื่อไม่ต้องเคารพ robots.txt ข้อแก้ต่างแบบ "เราเขียนและทบทวนมันเอง" แข็งแรงกว่า "ฉันแค่เปิดสวิตช์" ตามโครงสร้างของการฟ้องร้อง แรงจูงใจคือผลักนโยบายจากหมวดที่สองไปหมวดแรก
4. สิ่งที่สำนักพิมพ์บล็อกคือคอร์ปัส ไม่ใช่โมเดล CCBot ที่ 16.3% — สูงกว่าบอทแบรนด์โมเดลใด ๆ — คือถ้อยแถลงที่ชัดที่สุด การไม่อนุญาต OpenAI ไม่ได้ทำให้สำนักพิมพ์หลุดจากการถูกฝึก; การไม่อนุญาต CCBot ต่างหากที่ทำได้ 14.1% ของเว็บท็อป 10k บล็อก CCBot แต่ยังปล่อย Googlebot รูปแบบ "บล็อก training แต่เก็บ search" คือกฎ AI ที่พบได้มากที่สุดในปี 2026
สำหรับเว็บไซต์ที่กำลังพิจารณาจุดยืนของตัวเอง: จุดยืนค่ากลางคือความเงียบ — 80% ของท็อป 10k ไม่พูดอะไรเกี่ยวกับ AI 17% ที่เขียนกฎจะกระจุกที่ Disallow แต่กลุ่มเล็ก ๆ ที่เพิ่มขึ้น (รายการ explicit-Allow-GPTBot 1.5% นำโดยผู้ขายด้านความปลอดภัย) กำลังเลือกแนวตรงข้ามอย่างเปิดเผย ไม่มีฉันทามติในอุตสาหกรรม และจะไม่เกิดขึ้นใน 12 เดือนข้างหน้า
สำหรับผู้ให้บริการ AI: การยืนกรานว่า robots.txt เป็นโปรโตคอลเก่าที่มี semantics กำกวม เริ่มยากจะรักษา เมื่อ 17% ของเว็บไซต์ที่ใหญ่ที่สุดในโลกเขียนกฎที่ตั้งใจชัดเจนและระบุชื่อบอทเอง และ 3.8% ของไฟล์อ้างถึงมาตราเฉพาะของกฎหมาย EU เป็นตัวเลข ข้อจะเคารพกฎเหล่านั้นหรือไม่เป็นการตัดสินใจทางธุรกิจ; แต่การที่กฎเหล่านั้นมีอยู่จริงตอนนี้เป็นข้อเท็จจริงเชิงประจักษ์แล้ว
V. แนวโน้ม: สิ่งที่เราคาดว่าจะเห็นภายในสิ้นปี 2026
มี 3 แนวโน้มที่เห็นได้ในชุดข้อมูล:
Cloudflare Managed จะมากกว่าสองเท่าจากสัดส่วนเดิม และอาจแตะ 10%+ ของท็อป 10k ที่อ่านได้ โรดแมปของ Cloudflare พูดถึง Block AI Bots แบบเปิดโดยค่าเริ่มต้นสำหรับบัญชีใหม่อย่างเปิดเผย ถ้าสวิตช์นี้ออกมาพร้อมค่า default-on อัตราบล็อกทั่วโลกจะเพิ่มขึ้น 5–8 จุดโดยที่ไม่มีสำนักพิมพ์รายใดต้องตัดสินใจ เราจะรู้ว่าเกิดขึ้นเมื่อสัดส่วน Cloudflare Managed ของช่วงอันดับ 5001–10000 สูงกว่าปัจจุบันที่ 5.7%
นโยบาย AI ระดับส่วนย่อยแบบ Spiegel จะกระจายไปยังสำนักข่าวเรือธงรายใหญ่อีกหลายแห่ง ตรรกะทางเศรษฐกิจ — ปล่อยให้ AI อ้างอิงเนื้อหาความเสี่ยงต่ำ ปกป้องเนื้อหาหลักที่เป็นกำแพง — น่าเชื่อมากพอที่เราคาดว่าสำนักข่าวเรือธงอีกอย่างน้อย 10 แห่งจะปล่อยกฎระดับส่วนย่อยภายในสิ้นปี 2026 จับตาสื่อระดับกลางของเยอรมนีและฝรั่งเศสก่อน กรอบกฎหมายเอื้อให้ทดลองที่นั่น
กลุ่ม explicit-Allow-GPTBot จะโตขึ้น นำโดย B2B SaaS และเครื่องมือ dev เมื่อ AI search กลายเป็นช่องทาง acquisition ที่วัดผลได้สำหรับผู้ขายซอฟต์แวร์ (ซึ่งเป็นอยู่แล้วในกลุ่มความปลอดภัย) CMO ที่มีเหตุผลจะเขียน User-agent: GPTBot \n Allow: / เพื่อกันการบล็อกเกินโดยไม่ตั้งใจ เราคาดว่ารายการ 108 เว็บไซต์จะเพิ่มขึ้นราวสองเท่าภายในสิ้นปี
สิ่งที่เรา ไม่ คาดว่าจะเห็น: การเปลี่ยนแปลงอย่างมีนัยสำคัญของสัดส่วนเสียงเงียบ 80% ของเว็บที่ไม่พูดอะไรเรื่อง AI ได้แก่ภาคส่วน (ภาครัฐ โทรคมนาคม โครงสร้างพื้นฐาน B2B SaaS) ที่ไม่มีเหตุผลทางเศรษฐกิจจะเขียนกฎ และไม่มีแรงกดดันทางกฎหมายพอให้ทำ AI policy ทั่วโลกจะไม่เกิดขึ้น
VI. ข้อจำกัด
- อคติจาก snapshot เดียว การดึงข้อมูลเกิดขึ้นในช่วง 36 ชั่วโมงต้นเดือนพฤษภาคม 2026 ไฟล์เปลี่ยนทุกวันในท็อป 100 ควรคาดว่าตัวเลขหัวข้อข่าวจะขยับ 1–2 จุดเปอร์เซ็นต์ต่อไตรมาส
- ช่องว่างการจัดหมวดอุตสาหกรรม 6,593 จาก 10,000 เว็บไซต์ยังเป็น
unknownหลังตัวจัดหมวด 4 ชั้น ตัวเลขรายอุตสาหกรรมมีความแข็งแรงในกลุ่มที่ n สูง (ข่าว: 650, สตรีมมิง: 440, saas: 369, academia: 268, ผู้ใหญ่: 254, ecommerce: 224, gov: 172, finance: 129, dev: 129) และมีสัญญาณรบกวนมากขึ้นเมื่อ n < 30 การแบ่งข่าวรายประเทศก็มีข้อจำกัดเช่นกัน — DE/FR/UK มี n ≥ 15 ส่วนเกาหลี สวีเดน เช็กอาศัย n 20–25 robots.txtเป็นสิ่งสมัครใจDisallowคือคำขอ ไม่ใช่อุปสรรคBytespider,PerplexityBotและตัวอื่น ๆ ถูกบันทึกว่าเพิกเฉยต่อกฎ เราวัดการประกาศนโยบาย ไม่ใช่การบังคับใช้นโยบาย- การตรวจสอบแบบ IP เดียวในสหรัฐฯ เราอ่านไม่ได้ 21% ของโดเมนที่ resolve ได้ ส่วนใหญ่เป็นโดเมน apex ของ CDN ที่ไม่มีเว็บเซิร์ฟเวอร์; สัดส่วนเล็ก ๆ เป็นเว็บไซต์ที่ CDN ของพวกเขาธงเราก่อนถึง origin สิ่งนี้ทำให้ตัวอย่างมีอคติเล็กน้อยไปทางโครงสร้างพื้นฐานรุ่นเก่าและต่อต้านเว็บไซต์ที่ geofence ตามประเทศต้นทาง
- ความหมายของ Tranco list Tranco กรองความเสถียร มันไม่ใช่อันดับจากพฤติกรรมผู้ใช้จริง ตัวเลขรวมค่อนข้างทนต่อการเลือก list แต่ตำแหน่งอันดับเฉพาะไม่ทน
- ไม่มีข้อมูลทราฟฟิก เราวัดนโยบาย
robots.txtไม่ใช่ throughput ของ AI bot จริง นโยบายกับทราฟฟิกไม่ได้สอดคล้องกันเสมอไป
VII. วิธีทำซ้ำ
ทุกอย่างที่ใช้สร้างรายงานนี้อยู่ในโฟลเดอร์ส่งมอบ
- tranco_top10k.csv — รายการอินพุต
- out/sites.csv — โดเมน × อันดับ × อุตสาหกรรม × ภาษา × สถานะ robots.txt (10,000 แถว)
- out/fetch_meta.csv — ผลการดึงข้อมูลต่อโดเมน (status, scheme, bytes, error)
- out/bot_status.csv — ตารางโดเมน × บอท (250,000 แถว: blocked, has_rule, fetch_status)
- out/site_meta.csv — บันทึกเชิงวิเคราะห์หนึ่งรายการต่อเว็บไซต์ (เทมเพลต, boolean สรุป)
- out/analysis.json — ทุกเมตริกที่อ้างในรายงาน
- 01_fetch_robots.py, 02_classify.py, 03_parse_and_analyze.py — pipeline Python เต็มรูปแบบ
ดาวน์โหลดสคริปต์และชุดข้อมูลทั้งหมด
ยินดีรับข้อแก้ไขด้านวิธีวิทยา ปัญหาชุดข้อมูล และการวิเคราะห์ต่อเนื่องที่ support@thunderbit.com รายงานนี้เผยแพร่อย่างเป็นอิสระจากจุดยืนเชิงพาณิชย์ใด ๆ ของ Thunderbit; เราสร้าง AI-powered web scraper และมีผลประโยชน์เชิงโครงสร้างให้ robots.txt ยังคงเป็นสัญญาที่มีความหมายและอ่านได้โดยเครื่องบนเว็บสาธารณะ ข้อมูลในรายงานนี้ยืนได้ด้วยตัวเอง — ทีมวิจัย Thunderbit, พฤษภาคม 2026
ลองใช้ Thunderbit AI Web Scraper Get Started Free




