
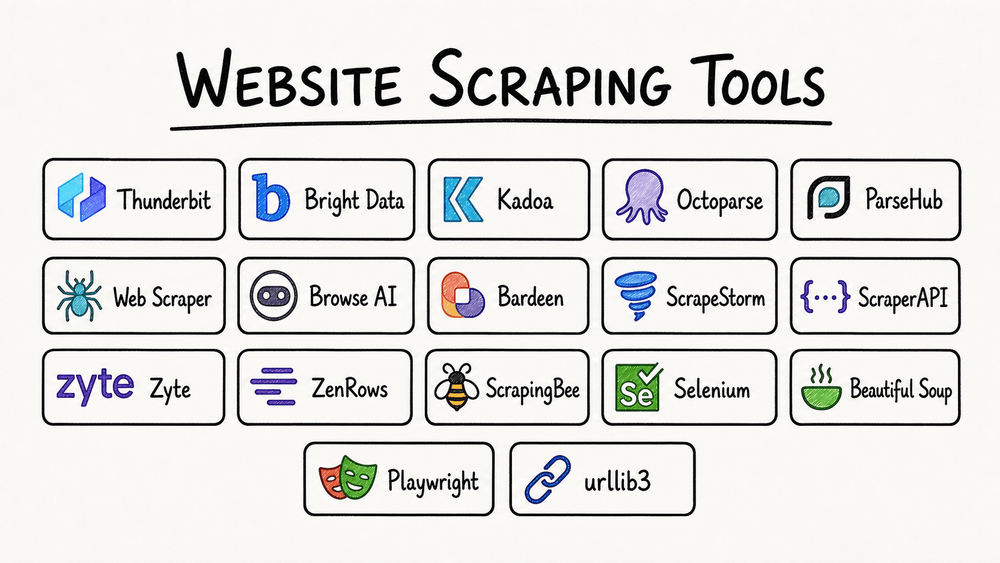
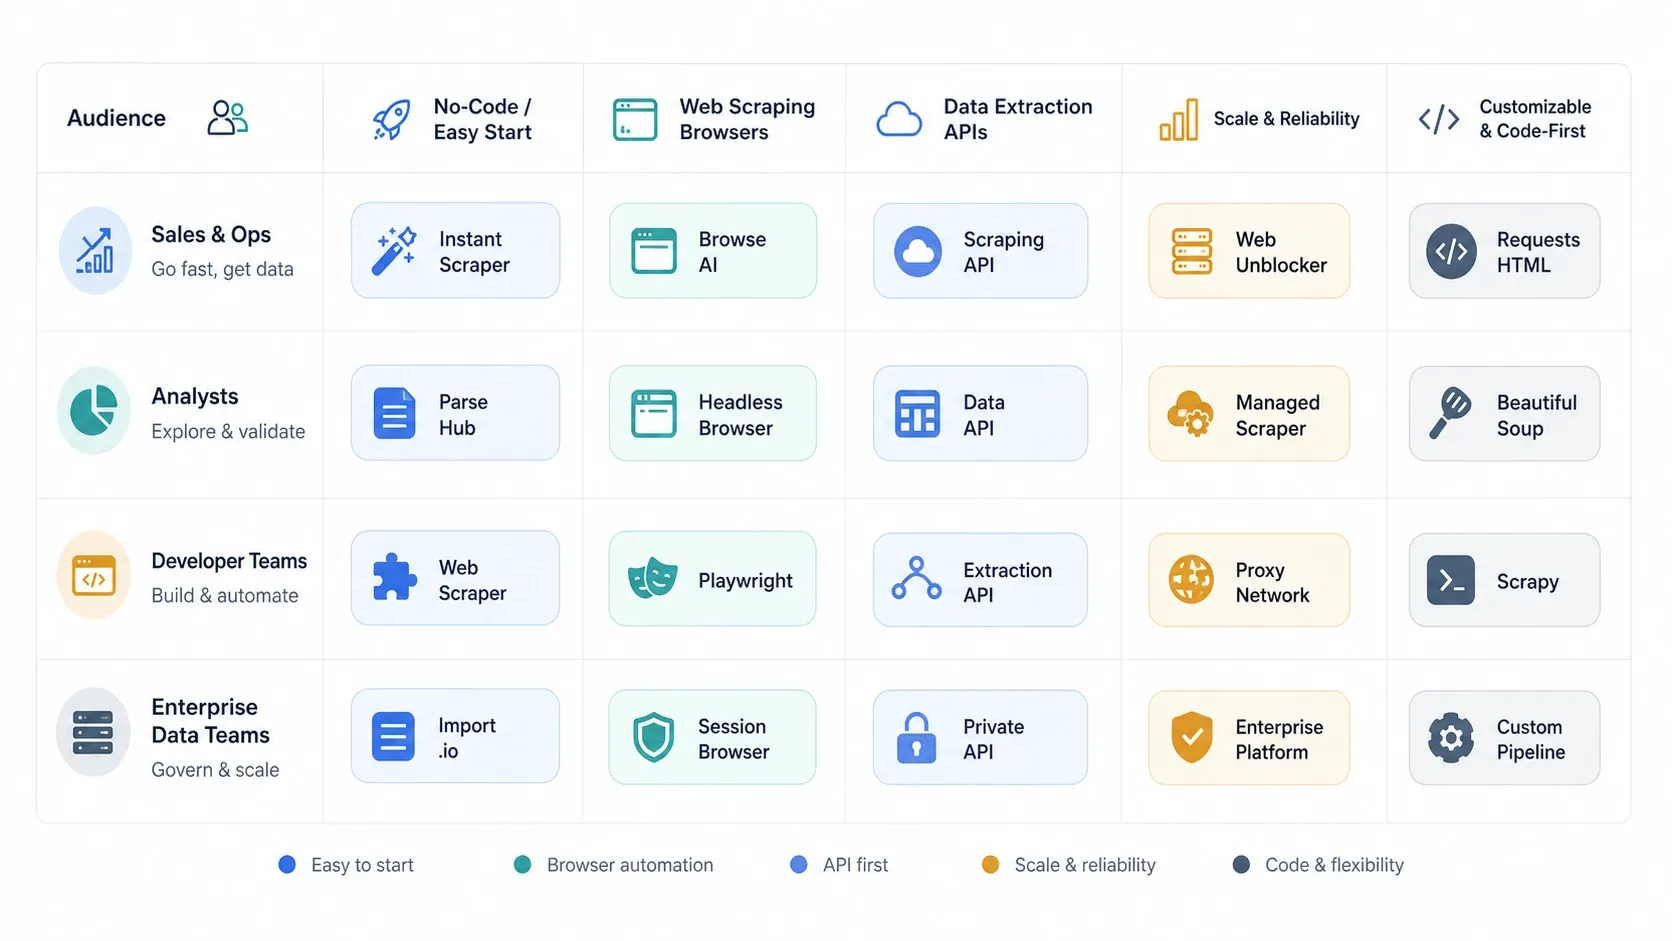
Om du behöver webdata 2026 är den riktigt svåra frågan inte längre “går det här att skrapa?” utan “vilken typ av verktyg ger mig användbar data med minst tidsförlust, underhåll och infrastrukturkostnad?” Därför är den här sidan upplagd efter vad som passar bäst: AI-baserade web scraper-verktyg för snabbhet, no-code-verktyg för återkommande webbläsarjobb, API:er för skalning och anti-bot-hantering, samt Python-bibliotek för team som vill ha full kontroll.
Kort svar
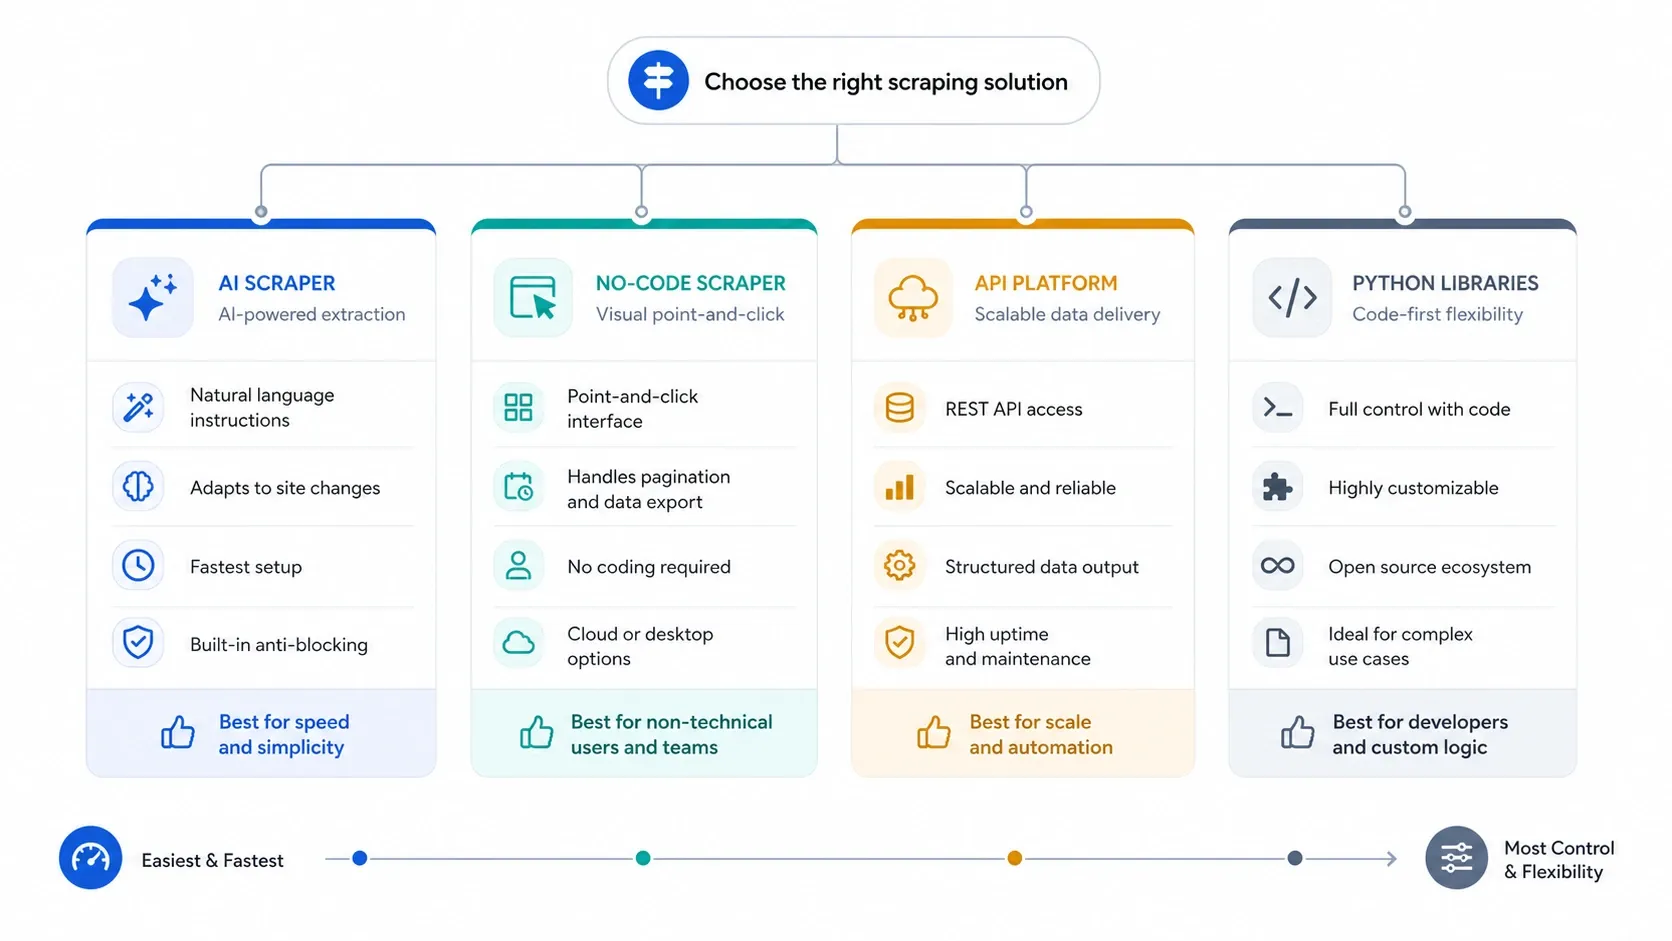
- Välj en AI web scraper om du vill gå snabbast från sida till kalkylblad med minimalt upplägg.
- Välj en no-code scraper om du behöver tydligare paginering, schemaläggning, inloggningshantering eller återkommande kontroll över uppgiften.
- Välj ett scraping-API om rendering, anti-bot-skydd, samtidighet och hög andel lyckade anrop är viktigare än ett enkelt gränssnitt.
- Välj ett Python-bibliotek om ditt team vill äga hela kedjan själv: requests, parsing, webbläsarautomation, retries och deployment.
För de flesta affärsteam är misstaget att gå för djupt i stacken för tidigt. Börja med det enklaste verktyget som faktiskt löser uppgiften pålitligt, och gå sedan från AI till no-code till API:er och kod först när arbetsflödet kräver det.
Snabb jämförelsetabell: Webbskrapningsverktyg i överblick
Prisindikatorerna nedan har kontrollerats mot officiella produktsidor, prissidor eller dokumentation i augusti 2026. När leverantörer använder anpassad prissättning eller användningsbaserad debitering beskriver jag därför prismodellen i stället för att pressa fram ett falskt månadspris som ska jämföras direkt.
| Verktyg | Kategori | Bäst för | Varför det kom med på 2026-listan | Prisindikator (kontrollerad maj 2026) |
|---|---|---|---|---|
| Thunderbit | AI web scraper | Försäljning, drift, e-handel, fastigheter | Snabbaste vägen för icke-tekniska användare från webbsida till strukturerad tabell | Gratis plan, betalda nivåer, företagsprissättning |
| Bright Data Web Scraper | Enterprise-scrapingplattform | Inköpsintensiva och compliance-fokuserade program | Mest heltäckande datainsamlingsstacken i gruppen | Produktbaserad och användningsbaserad prissättning |
| Kadoa | AI-extraktionsplattform | Datateam och större återkommande program | Starkt val för självläkande, agentliknande extraktionsflöden | Gratis utvärdering, användningsbaserade och enterprise-planer |
| Octoparse | No-code scraper | Analytiker och återkommande driftjobb | Moget molnskrapande och visuell uppgiftsbyggare | Gratis plan, Standard från $69/månad, högre nivåer |
| ParseHub | Low-code scraper | Tekniska icke-kodare och forskare | Flexibel navigationslogik för svårare sajter | Gratis plan, betalda planer från $189/månad |
| Web Scraper | Webbläsarbaserad no-code scraper | Nybörjare och lättare återkommande jobb | Enkel sitemap-modell med valbart molnlager | Gratis tillägg, Cloud från $50/månad |
| Browse AI | No-code robot scraper | Övervakning och team som tänker kalkylblad först | Stark för återkommande bevakning och ändringslarm | Gratis plan, betalda planer, hanterad nivå |
| Bardeen | AI webbläsarautomation | GTM- och revops-automation | Bäst när skrapning bara är ett steg i ett större flöde | Gratis plan, Basic från $10/månad, Premium och Enterprise |
| ScrapeStorm | AI-assisterad visuell scraper | Användare som vill ha snabb visuell setup | Bra mellanväg mellan manuella selectors och AI-stöd | Gratis test, betalda planer, enterprise-prissättning |
| ScraperAPI | Scraping-API | Utvecklare som skalar upp anropsvolym | Enkel API-tjänst plus proxy, CAPTCHA och rendering avlastas | 7-dagars test, betalda planer från $49/månad |
| Zyte | API + anti-bot-stack | Utvecklar- och datateam | Stark för webbläsaråtgärder, JS-rendering och IP-rotation | $5 i gratis testkredit, användningsbaserade planer |
| ZenRows | Scraping-API | Startups och utvecklarteam | Ren anti-bot-API med lägre tröskel för att komma igång | Gratis test, Developer från $69/månad |
| ScrapingBee | Scraping-API | Team som skrapar JS-tunga sajter | Användbart när rendering är den största utmaningen | Gratis test, betalda planer från $49/månad |
| Selenium | Webbläsarautomation med öppen källkod | QA-liknande flöden och interaktionsintensiv skrapning | Fortfarande relevant när exakt användarinteraktion är viktig | Gratis och öppen källkod |
| Beautiful Soup | Python-bibliotek för parsing | Lättviktig Python-skrapning | Enklaste parsern i stacken för rörig HTML | Gratis och öppen källkod |
| Playwright | Modern webbläsarautomation | Moderna webbappar och utvecklarteam | Bästa moderna valet för skriptad webbläsarskrapning | Gratis och öppen källkod |
| urllib3 | Python HTTP-bibliotek | Utvecklare som vill styra requests på låg nivå | Bra grund när du vill äga transportbeteendet direkt | Gratis och öppen källkod |
Så väljer du rätt webbskrapningsverktyg
Utgå från fyra filter innan du jämför varumärken:
- Tid till första användbara resultat
Om verktyget inte snabbt kan leverera en riktig tabell, förlorar det redan i de flesta affärscase. - Underhållsbehov
En billig scraper som går sönder varje gång layouten ändras är i praktiken inte billig. - Skalbarhetsgräns
Ett webbläsartillägg kan vara perfekt för 50 sidor i veckan och helt fel för 5 miljoner anrop i månaden. - Passar arbetsflödet
Den bästa scrapen för revops är sällan den bästa för en plattformsingenjör.
Beslutsmodellen är oftast enklare än teamen tror:
- Om du vill skrapa leads, listningar eller produktsidor utan att röra selectors, börja med AI.
- Om du behöver återkommande uppgifter, körningar i molnet och tydligare kontroll, gå till no-code visuella byggare.
- Om anti-bot, JavaScript-rendering och samtidighet är det verkliga problemet, hoppa till API:er.
- Om du vill äga varje lager själv, använd Python-bibliotek och acceptera underhållsbördan.
Bästa AI-baserade web scraper-verktygen för snabba affärsflöden
Det här är den första kategorin jag skulle testa om du vill ha spreadsheet-klara data med så lite konfiguration som möjligt.
1. Thunderbit
Thunderbit är fortfarande den enklaste startpunkten här för icke-kodare. Den stora fördelen är inte bara “AI” i teorin, utan att produkten kortar hela uppläggsloopen. Du öppnar en sida, låter AI föreslå fält, berikar via undersidor vid behov och skickar resultatet direkt till de verktyg teamet redan använder.
- Bäst för: säljprospektering, övervakning av e-handel, fastighetsinsamling och driftteam som arbetar direkt i webbläsaren.
- Varför den sticker ut: snabbaste vägen från rörig sida till strukturerad tabell.
- Att tänka på: om du behöver crawler-lik logik eller mycket specialanpassade utvecklingsflöden kommer du så småningom att behöva gå vidare till API:er eller kod.
- Prisindikator: gratis plan, självbetjänade betalda nivåer och företagsprissättning.
Den här genomgången är fortfarande det snabbaste sättet att avgöra om AI-först-skrapning räcker för ditt arbetsflöde:
Prova Thunderbit AI Web Scraper gratis Skrapa vilken webbplats som helst med 1 klick — inga selectors, ingen setup, export direkt till Sheets eller Excel. Get Started Free
2. Bright Data Web Scraper
Bright Data är det tunga valet när blockeringshantering, proxyinventarie, compliance och hanterade alternativ är viktigare än enkelhet.
- Bäst för: insamling i enterprise-skala och program med höga compliance-krav.
- Varför den sticker ut: bredaste stacken i jämförelsen, från proxies till hanterade insamlingsprodukter.
- Att tänka på: lätt att köpa mer än du behöver om teamets arbetsflöde fortfarande är ganska enkelt.
- Prisindikator: produktbaserad och användningsbaserad prissättning.
3. Kadoa
Kadoa är det mer infrastrukturorienterade AI-alternativet i gruppen. Det passar när du vill ha självläkande extraktion och återkommande jobb i större operativ skala än vad de flesta webbläsartillägg är byggda för.
- Bäst för: datateam, interna intelligence-program och större återkommande extraktionsvolymer.
- Varför den sticker ut: agentliknande orkestrering och en starkare berättelse kring minskat underhåll.
- Att tänka på: tyngre än vad de flesta affärsanvändare behöver för snabba engångsjobb.
- Prisindikator: gratis utvärdering, användningsbaserade och enterprise-planer.
Bästa no-code webbskrapningsverktygen för återkommande jobb
När skrapningen blir återkommande blir visuella arbetsflödesbyggare och körning i molnet viktigare än ren ett-klicks-snabbhet.
4. Octoparse
Octoparse är fortfarande ett av de mest trovärdiga no-code-verktygen när jobbet är större än ett webbläsartillägg men ännu inte ett skräddarsytt utvecklingsprojekt. Styrkan ligger i kombinationen av molnkörningar, mallar och en mogen visuell uppgiftsbyggare.
- Bäst för: analytiker, pristeam och återkommande insamlingsjobb med verklig affärskritik.
- Varför den sticker ut: mer djup än webbläsarplugins, utan att tvinga dig in i kod.
- Att tänka på: du betalar för flexibiliteten med en brantare inlärningskurva än AI-först-verktyg.
- Prisindikator: gratis plan, Standard från $69/månad, högre betalda nivåer.
Om du vill utvärdera en mer traditionell no-code-miljö innan du satsar på AI-först-verktyg är den här officiella översikten från Octoparse fortfarande användbar:
5. ParseHub
ParseHub är fortfarande relevant eftersom många team vill ha mer steg-för-steg-logik än vad en lätt AI-scraper erbjuder. Det är inte den snyggaste produkten i kategorin, men den är fortsatt flexibel.
- Bäst för: forskare, journalister och tekniska icke-kodare som kan leva med mer uppsättning.
- Varför den sticker ut: starkare villkorslogik och navigationskontroll än många nybörjarverktyg.
- Att tänka på: långsammare att lära sig och mindre modern i känslan än nyare alternativ.
- Prisindikator: gratis plan, betalda planer från $189/månad.
6. Web Scraper
Web Scraper är ett av de renare alternativen för dig som vill “lära dig grunderna utan att köpa en plattform”. Om du gillar sitemap-modellen är det fortfarande en rimlig startpunkt.
- Bäst för: nybörjare, hobbyprojekt och mindre webbläsarbaserade jobb.
- Varför den sticker ut: enkel setup och smidig övergång från lokal extension till molnplaner.
- Att tänka på: blir begränsande när du behöver mer adaptiv logik eller starkare anti-blockering.
- Prisindikator: gratis tillägg, Cloud från $50/månad.
7. Browse AI
Browse AI är fortfarande ett starkt val när skrapning och övervakning är lika viktiga. Dess robotmodell är intuitiv för affärsanvändare som tänker i termer av “bevaka den här sidan och säg vad som ändrats”.
- Bäst för: konkurrentbevakning, prisövervakning och team som arbetar kalkylblad först.
- Varför den sticker ut: välpolerad onboarding, återkommande övervakning och automatiseringsvänliga resultat.
- Att tänka på: komplexa jobb med hög volym kan bli dyrare snabbare än API-först-stackar.
- Prisindikator: gratis plan, betalda planer, hanterad nivå.
För team som utvärderar sidövervakning snarare än engångsextraktion är den här korta officiella översikten fortfarande en bra signalcheck:
8. Bardeen
Bardeen handlar mindre om ren skrapningsdjup och mer om vad som händer efter att datan hämtats. Den är som starkast när webbaserad extraktion bara är ett steg i ett större webbläsarautomationsflöde.
- Bäst för: GTM-drift, lead routing, överlämning till CRM och webbläsarnativ automation.
- Varför den sticker ut: stark automation kring själva skrapningsmomentet.
- Att tänka på: inte det bästa valet när extraktionsprecision är det enda som spelar roll.
- Prisindikator: gratis plan, Basic från $10/månad, Premium- och Enterprise-nivåer.
9. ScrapeStorm
ScrapeStorm fyller fortfarande en nyttig mellanposition för användare som vill ha AI-stöd men också förväntar sig en mer traditionell visuell skrapmiljö.
- Bäst för: katalogskrapning, insamling av e-handelssidor och visuellt konfigurerade återkommande jobb.
- Varför den sticker ut: enklare att komma igång med än många äldre visuella verktyg.
- Att tänka på: mindre polerad än kategoriledarna och kan kännas smalare på svårare sajter.
- Prisindikator: gratis test, betalda planer, enterprise-prissättning.
Bästa scraping-API:er när skalning och anti-bot-hantering är viktigt
Det här är kategorin du går in i när begränsningen inte längre är “hur väljer jag datan?” utan “hur håller jag detta stabilt under belastning?”
10. ScraperAPI
ScraperAPI är fortfarande en av de mest tillgängliga API-först-produkterna för utvecklare som vill slippa tänka på proxies och lyckade anrop.
- Bäst för: utvecklare som snabbt behöver gå från prototyp till produktion.
- Varför den sticker ut: enkel API-tjänst plus stöd för proxy, CAPTCHA och rendering.
- Att tänka på: du äger fortfarande parsing, retries och datakvaliteten längre ned i flödet.
- Prisindikator: 7-dagars test, betalda planer från $49/månad.
11. Zyte
Zyte är fortfarande ett seriöst alternativ för utvecklarteam som vill ha webbläsaråtgärder, JS-rendering, roterande IP:er och anti-bot-funktioner samlat i en och samma plattform.
- Bäst för: teknikdrivna skrapningsprogram och återkommande extraktionssystem.
- Varför den sticker ut: stark anti-detekteringsstack och API-först-arbetsflöden.
- Att tänka på: bättre för team med eget utvecklaransvar än för affärsanvändare.
- Prisindikator: $5 i gratis testkredit, användningsbaserade planer.
12. ZenRows
ZenRows är en av de mer lättanvända upplevelserna i API-kategorin om du vill ha anti-bot-hantering utan en tung enterprise-lik inköpsprocess.
- Bäst för: startups, utvecklare och små interna verktygsteam.
- Varför den sticker ut: relativt låg tröskel att börja med plus stark anti-bot-positionering.
- Att tänka på: fortfarande en API-produkt, så du behåller ansvaret för app-logik och testning.
- Prisindikator: gratis test, Developer från $69/månad.
13. ScrapingBee
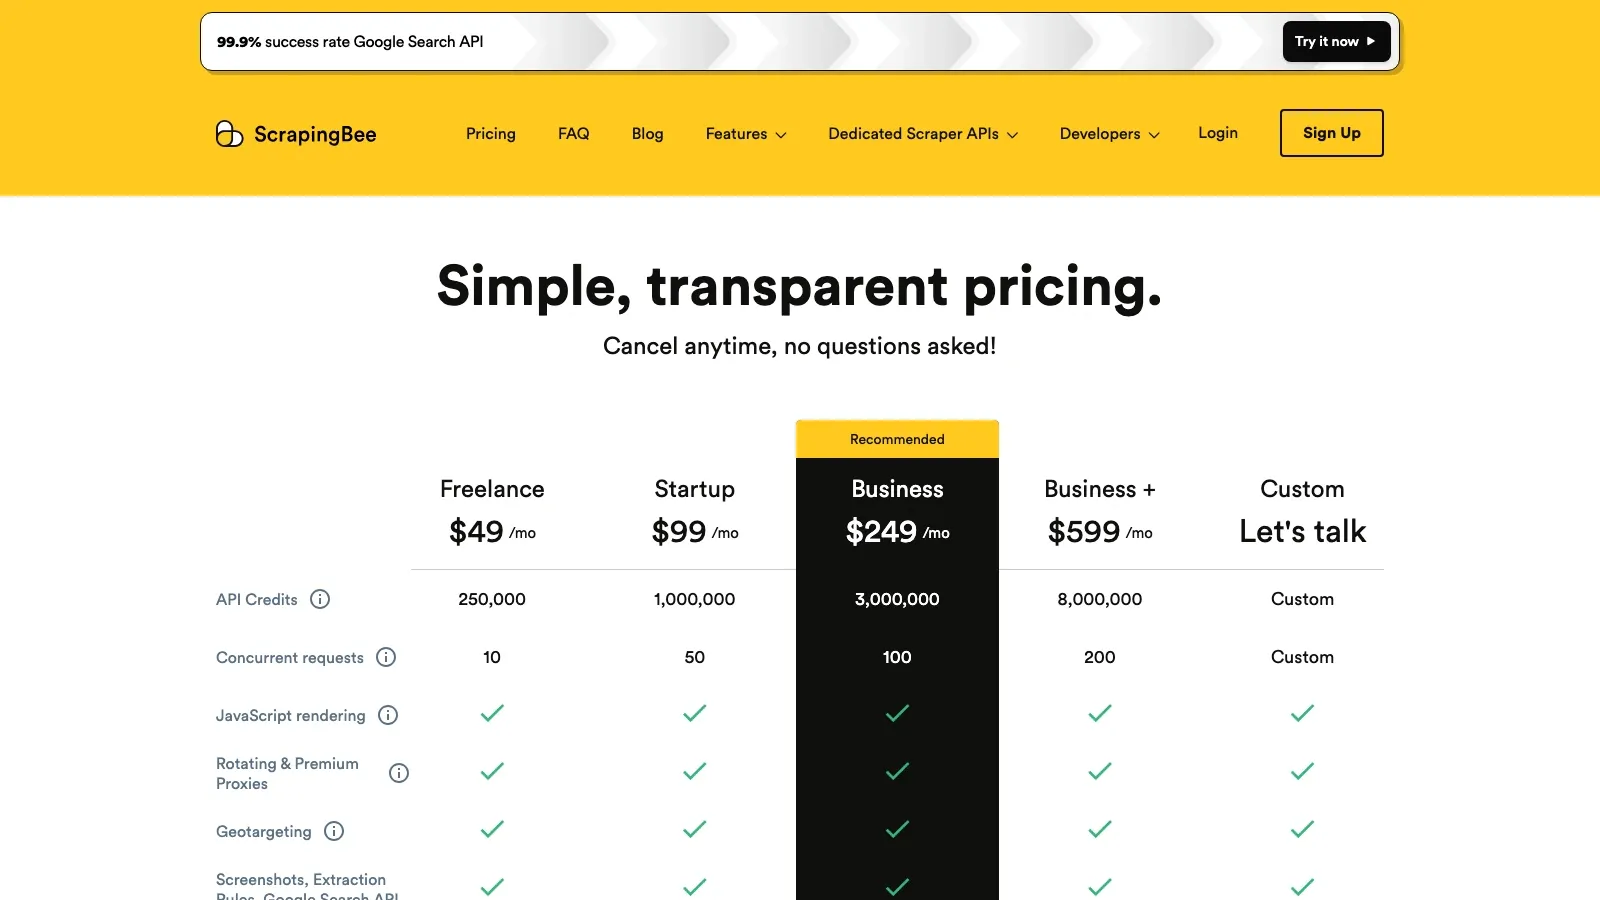
ScrapingBee passar när ditt verkliga behov är en renderad sida och mindre infrastrukturjobb, särskilt för JS-tunga sajter.
- Bäst för: utvecklare som skrapar dynamiska sajter och vill avlasta rendering.
- Varför den sticker ut: enkelt API kring headless browsing och proxies.
- Att tänka på: det minskar infrastrukturarbetet, men tar inte bort behovet av bra skraplogik.
- Prisindikator: gratis test, betalda planer från $49/månad.
Bästa Python-webbskrapningsbibliotek för anpassade stackar
Den här gruppen är fortfarande rätt svar när kontroll väger tyngre än bekvämlighet och teamet är redo att ta ansvar för underhållet.
14. Selenium
Selenium är inte det nyaste webbläsarverktyget, men det är fortfarande relevant där användarinteraktion måste vara exakt och trovärdig snarare än där rå genomströmning är viktigast.
- Bäst för: interaktionsintensiva flöden, överlapp med QA och sajter där webbläsarbeteendet är huvudutmaningen.
- Varför den sticker ut: moget ekosystem och brett webbläsarstöd.
- Att tänka på: tyngre och långsammare än nyare automationstackar för många skrapjobb.
- Prisindikator: gratis och öppen källkod.
15. Beautiful Soup
Beautiful Soup är fortfarande den enklaste parsern i Python-stackens skrapvärld. Det är inte en komplett skrapplattform, men det är fortfarande det smidigaste sättet att göra om stökig HTML till användbar struktur.
- Bäst för: lätta Python-jobb, statiska HTML-sidor och snabba prototyper.
- Varför den sticker ut: låg mental belastning och förlåtande parsing.
- Att tänka på: kombinera med
requests, ett webblager eller en crawler; på egen hand parser den bara. - Prisindikator: gratis och öppen källkod.
16. Playwright
Playwright är mitt standardval för moderna utvecklarteam som behöver robust webbläsarautomation på dagens webben.
- Bäst för: JavaScript-tunga sajter, modern webbläsarautomation och team som redan är bekväma med kod.
- Varför den sticker ut: starkt väntbeteende, stöd för flera webbläsare och rena API:er.
- Att tänka på: du äger fortfarande samtidighet, selectors, webbläsarinfrastruktur och datavalidering.
- Prisindikator: gratis och öppen källkod.
17. urllib3
urllib3 finns med på listan eftersom vissa team vill ha direkt kontroll över transportbeteendet i stället för ett högre abstraktionslager. Det är inte en nybörjarvänlig scraper, men det är ett användbart grundbibliotek när du bygger din egen stack.
- Bäst för: utvecklare som vill ha exakt kontroll över retries, proxies, sessions och HTTP-beteende.
- Varför den sticker ut: lättviktig, pålitlig och brett använd som infrastruktur.
- Att tänka på: du bygger själv större delen av stacken.
- Prisindikator: gratis och öppen källkod.
Gratis webbskrapningsverktyg värda att testa först
Om du vill prova innan du köper är de bästa gratisstartpunkterna i den här listan Thunderbit, Octoparse, ParseHub, Web Scraper, Browse AI, Bardeen, Selenium, Beautiful Soup, Playwright och urllib3. Den kostnadsfria upplevelsen räcker gott för att förstå vilken typ av scraper du faktiskt behöver, vilket oftast är viktigare än att fastna i en perfekt funktionschecklista första dagen.
Min kortlista efter teamtyp
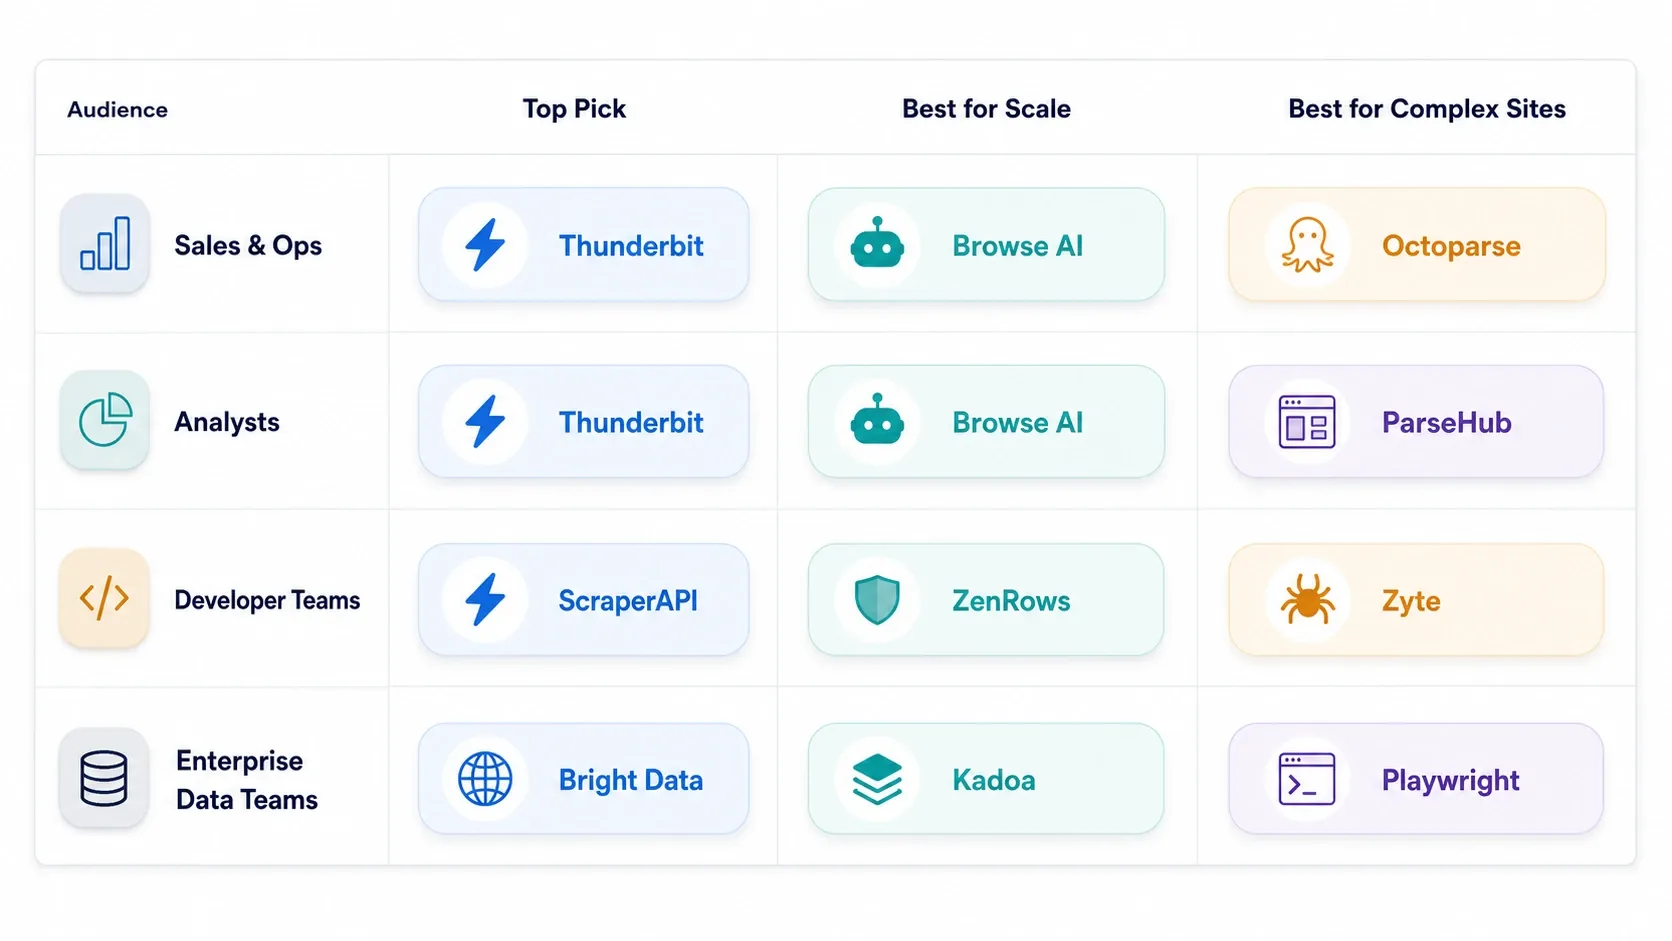
- Försäljning, drift och e-handel: börja med Thunderbit och jämför sedan Browse AI om övervakning är viktigare än berikning via undersidor.
- Analytiker och återkommande manuella operatörer: Octoparse först, och ParseHub om du behöver mer anpassad uppgiftslogik.
- GTM-automationsteam: Bardeen om skrapningen behöver gå direkt in i CRM, Sheets eller webbläsarflöden.
- Utvecklarteam som bygger interna verktyg: ScraperAPI, ZenRows, Zyte eller Playwright beroende på hur mycket av stacken du vill äga.
- Enterprise-dataprogram: Bright Data och Zyte är de mer seriösa infrastruktursamtalen här, med Kadoa som ett AI-drivet alternativ när minskat underhåll är huvudmålet.
När du ska gå djupare i stacken
Använd den här uppgraderingsvägen:
- Håll dig till AI web scrapers tills du stöter på begränsningar i återupprepbarhet eller specialfall.
- Gå över till no-code-byggare när schemaläggning, paginering och körning i molnet är viktigare än enkelheten med ett klick.
- Gå över till API:er när lyckade anrop, rendering och samtidighet blir flaskhalsen.
- Gå över till Python-bibliotek när kostnaden för leverantörsabstraktion blir högre än att äga hela systemet själv.
De flesta team gör detta i fel ordning. De bygger för mycket först och inser först senare att ett lättare verktyg hade kunnat lösa det verkliga arbetsflödet.
Slutlig rekommendation
Det bästa webbskrapningsverktyget 2026 är inte det med längst funktionslista. Det är det som får in korrekt data i nästa steg i arbetsflödet med minst underhåll för ditt team. Därför fortsätter AI-först-verktyg att vinna hos operativa användare, no-code-verktyg är fortfarande värdefulla för återkommande webbläsarjobb, API:er dominerar när skalning och blockering spelar störst roll, och Python-bibliotek äger fortfarande den mest kontrollerade delen av stacken.
Om målet är att få användbar data redan den här veckan, börja enkelt. Om din arbetsbelastning redan säger att hög lyckandegrad, webbläsar-rendering och utvecklarkontroll är de verkliga problemen, gå då djupare i stacken medvetet i stället för av vana.
Börja med den enklaste scrapern som faktiskt klarar jobbet Get Started Free
Vanliga frågor
1. Vilket är det bästa webbskrapningsverktyget för icke-tekniska användare 2026?
För de flesta icke-tekniska team är AI-först-verktyg som Thunderbit och Browse AI fortfarande snabbast eftersom de minskar både uppsättningstid, behovet av selectors och underhållsarbete.
2. Vad ska jag välja för JS-tunga eller anti-bot-skyddade sajter?
Det är vanligtvis där ScraperAPI, Bright Data, Zyte, ZenRows, ScrapingBee, Playwright eller Selenium börjar bli mer rimliga val än webbläsartillägg.
3. Är no-code skrapningsverktyg fortfarande relevanta nu när AI-scrapers är bättre?
Ja. Octoparse, ParseHub, Web Scraper och Browse AI är fortfarande viktiga när du behöver tydligare uppgiftskontroll, återkommande körningar eller felsökning som syns i webbläsaren.
4. Vilka verktyg passar bäst för utvecklarteam?
ScraperAPI, Zyte, ZenRows, ScrapingBee, Playwright, Selenium, Beautiful Soup och urllib3 är de mest naturliga valen när ingenjörsteamet äger arbetsflödet.
Relaterad läsning




