
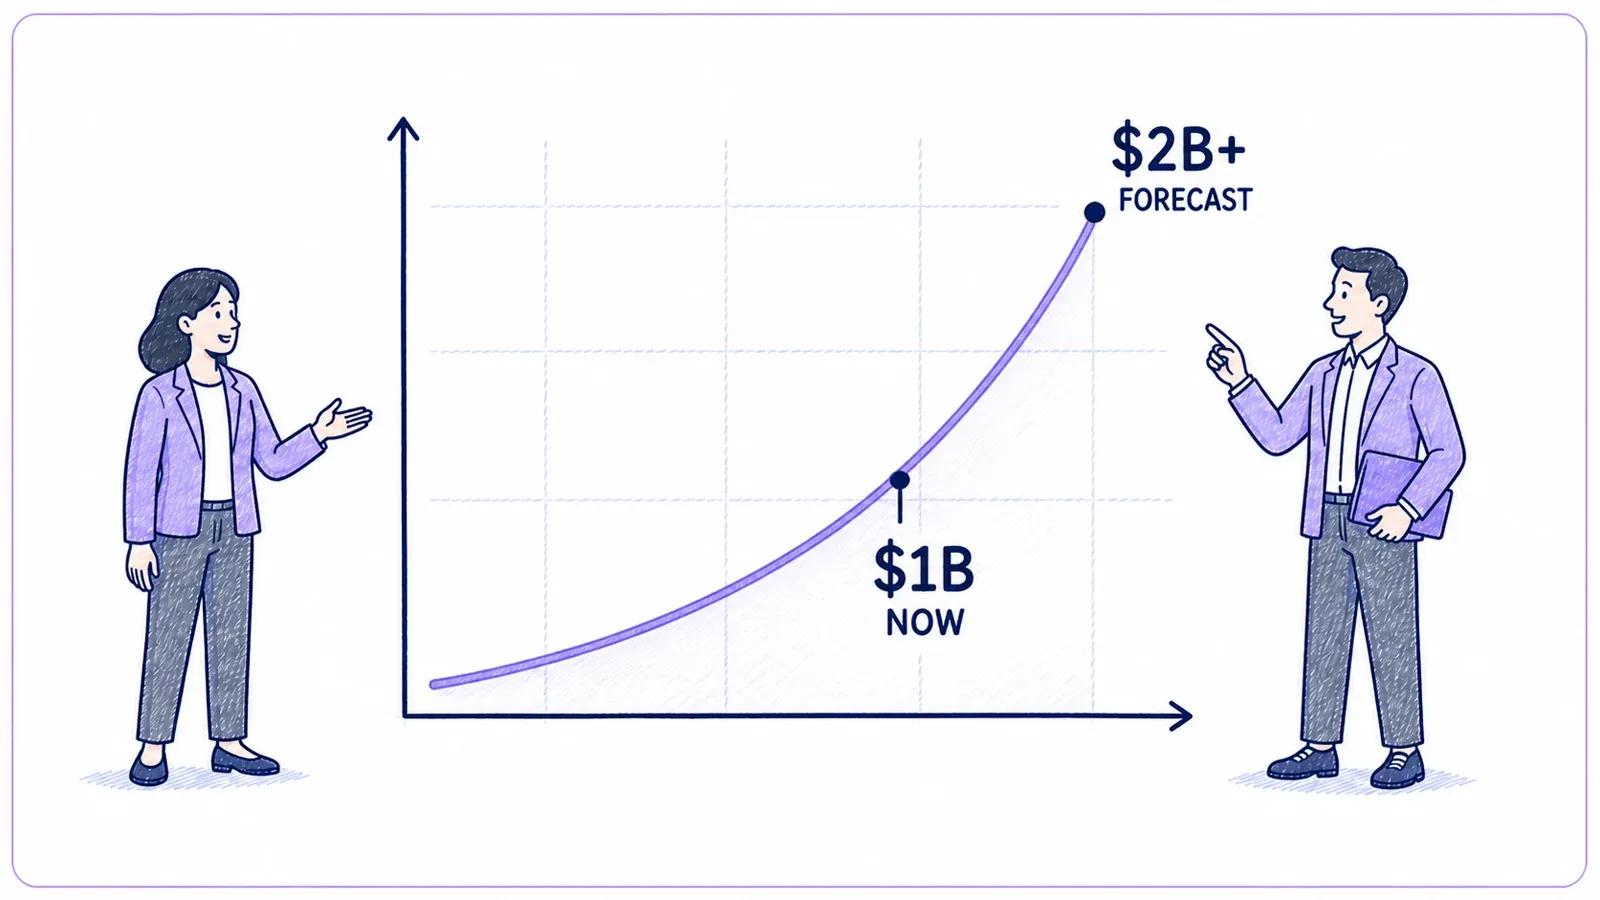
Låt oss vara raka: år 2026 är det som att springa ett maraton i flip-flops om du fortfarande sitter och kopierar och klistrar in data från webbplatser för hand. Marknaden för web scraping-programvara var värd 1,01 miljarder dollar 2024 och väntas växa till 2,49 miljarder dollar 2032, enligt Apifys rapport om web scraping-läget. Mer än hälften av alla amerikanska företag samlar redan in extern webbdata — de håller koll på konkurrenter, följer priser och bygger leadlistor — eftersom de vet att den som har den färskaste datan ofta är den som vinner.
Skrapa webbplatsdata med AI med ett klick Thunderbits agentiska webbskrapare läser själv av datan på vilken webbplats som helst och extraherar den med ett klick – ingen konfigurering krävs. Get Started Free
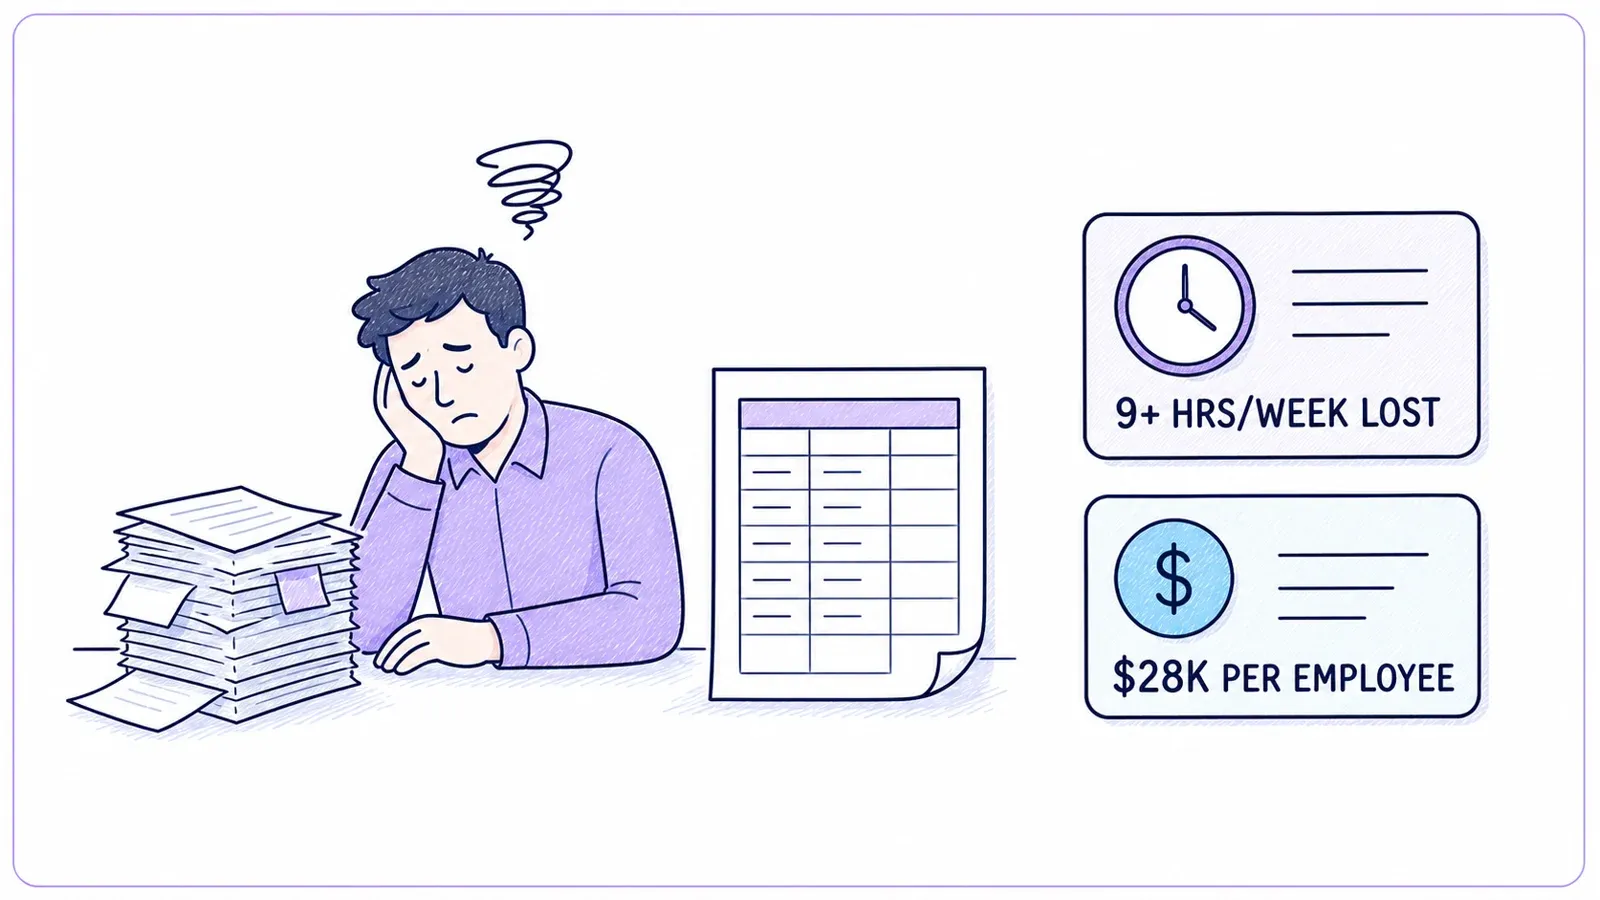
Men här är grejen: de flesta affärsanvändare är inte utvecklare. Jag har sett säljteam, marknadsförare och folk inom operations lägga över 9 timmar i veckan på upprepande datainmatning, vilket enligt en 2025-undersökning från Parseur/QuestionPro bland 500 amerikanska yrkespersoner kostar företag ungefär 28 500 dollar per anställd och år. Och nästan 60 % av arbetstagarna säger att de här uppgifterna leder till utmattning. Den goda nyheten? Att skrapa webbplatsdata effektivt är nu inom räckhåll för alla — även om du aldrig har skrivit en enda rad kod. Här går vi igenom exakt hur du gör, vilka verktyg du ska använda och hur du går från ”jag behöver den här datan” till ett användbart kalkylblad — för välstrukturerade sajter på bara några klick; för rörigare sajter på några klick plus ett par justeringar i prompten.
Vad betyder det att skrapa webbplatsdata?
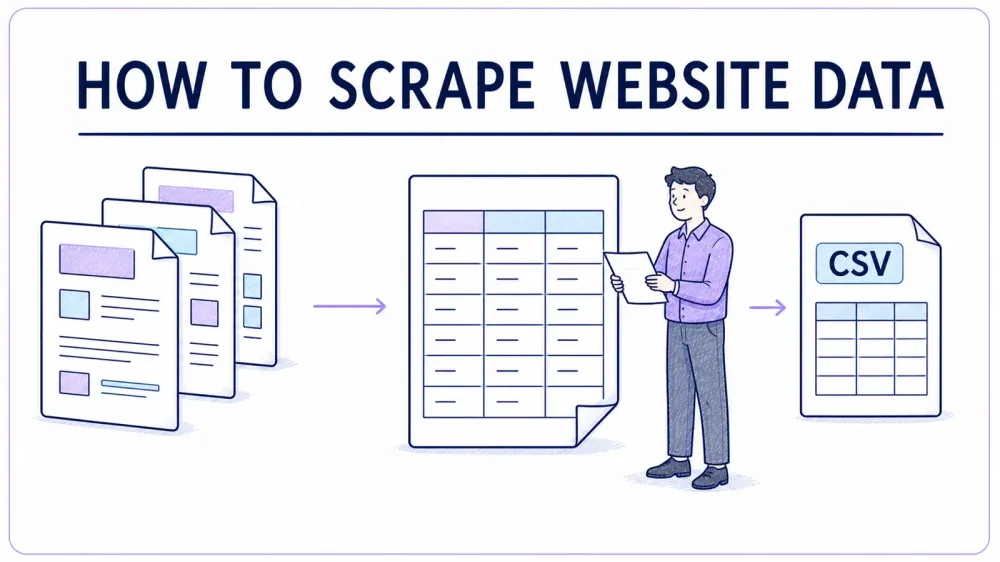
I grunden betyder att skrapa webbplatsdata att använda programvara för att automatiskt hämta information från webbsidor och organisera den i ett strukturerat format — tänk tabeller, kalkylblad eller databaser. Föreställ dig en digital assistent som besöker hundratals webbsidor, plockar ut det du behöver, som namn, priser eller e-postadresser, och lägger allt i Excel medan du tar en kopp kaffe.
Manuell datainsamling — att kopiera och klistra in från webbplatser — funkar när det bara handlar om några få rader. Men när du behöver samla in information från tiotals eller tusentals sidor blir det snabbt ett recept på ömma handleder och en hel del felskrivningar. Automatiska webbskrapningsverktyg gör grovjobbet åt dig, hämtar exakt de fält du vill ha, i stor skala och med betydligt färre misstag (ParseHub).
De grundläggande stegen i web scraping:
- Identifiera vilken data du vill ha (t.ex. produktpriser, kontaktuppgifter, recensioner).
- Extrahera datan med ett verktyg eller skript.
- Exportera resultatet till ett format du kan analysera (CSV, Excel, Google Sheets osv.).
Moderna webbskrapare kan till och med hantera listningar över flera sidor, klicka vidare på ”nästa”-knappar och öppna undersidor — så du får med hela datamängden, inte bara det som syns på en skärm.
Varför webbskrapning är viktig för affärsteam
Låt oss prata om varför den här förmågan är så viktig för sälj-, marknads- och operations-team:
- Leadgenerering: Bygg riktade listor över prospekt genom att skrapa företagsregister, LinkedIn eller deltagarsidor från evenemang. Slipp köpa gamla listor eller lägga timmar på att leta på Google.
- Prisbevakning: Följ konkurrenters priser och lagernivåer på marknadsplatser. Det finns återförsäljare, som John Lewis, som ökade försäljningen med 4 % med hjälp av skrapad prisdata.
- Marknadsanalys: Samla recensioner, betyg och omnämnanden i sociala medier för att se trender och kundsentiment i realtid.
- Operativ effektivitet: Håll produktkataloger, leverantörsinformation eller bostadsannonser uppdaterade — automatiskt.
Här är en snabb tabell som sammanfattar fördelarna:
| Viktig fördel | Vad det innebär | Resultat i praktiken |
|---|---|---|
| Tidsbesparing | Automatisera timmar av manuellt datarbete | +9 timmar/vecka sparade per medarbetare (PRNewswire) |
| Noggrannhet | Färre fel, mer konsekvent data | Upp till 99,5 % noggrannhet (Scrapingdog) |
| Konkurrensfördel | Snabbare och färskare insikter än konkurrenterna | Dynamisk prissättning, bättre målgruppsstyrning |
| Automatiserade flöden | Datat uppdaterar sig självt – inga fler manuella kontroller | Schemalagda dagliga/veckovisa rapporter |
Inte konstigt att 63 % av företagen som använder extern data säger att det förbättrade beslutsfattandet, och mer än hälften såg intäktstillväxt.
Steg för steg: Så skrapar du webbplatsdata utan kod
Den här frågan får jag ofta: ”Hur börjar jag egentligen med dataskrapning om jag inte är teknisk?” Här är en nybörjarvänlig vägledning:
1. Definiera ditt mål och vilka fält du behöver
Bestäm vad du vill ha. Är det en lista över alla restauranger i din stad från Yelp, med namn, adress och telefonnummer? Eller kanske konkurrenters produktpriser från Amazon? Skriv ner vilka fält du behöver.
2. Välj rätt verktyg
Om du inte kodar, hoppa över Python-skript. Välj no-code-verktyg som Thunderbit, som är ett AI-drivet Chrome-tillägg, eller andra visuella skrapverktyg som Octoparse eller ParseHub.
Prova Thunderbits agentiska webbskrapare gratis Gratisplanen täcker 6 sidor per månad, inget kreditkort krävs — ett snabbt sätt att testa extrahering på din målsajt. Get Started Free
3. Sätt upp din miljö
Installera verktyget du valt (för Thunderbit, hämta Chrome-tillägget). Skapa konto, logga in och du är redo att köra.
4. Identifiera datan på webbplatsen
Gå till din målsida. Med Thunderbit klickar du bara på ”One Click Extract” — AI:n skannar sidan, listar ut rätt kolumner (som Namn, Pris, E-post) och extraherar dem.
5. Kör en testskrapning
Börja alltid i liten skala. Skrapa en sida eller ett fåtal poster för att kolla att datan ser rätt ut. Justera kolumner eller promptar vid behov.
6. Skrapa hela datamängden
När du är nöjd kör du hela skrapningen. För större jobb använder du molnläge (mer om det strax). Verktyget hanterar sidnumrering och undersidor om det är konfigurerat.
7. Exportera och använd din data
Exportera till Excel, Google Sheets, Airtable eller Notion. Gör stickprov på några rader för att säkerställa att allt stämmer.
Tips: Undvik vanliga misstag som att glömma sidnumrering, skrapa för mycket på en gång eller ignorera webbplatsens användarvillkor. Börja fokuserat, iterera, och du kommer snabbt att bli en skrapningsproffs.
Att välja rätt verktyg: Thunderbit jämfört med traditionella skraplösningar
Låt oss jämföra alternativen:
| Lösning | Användarvänlighet | Tid att komma igång | Underhåll | Skalbarhet | Kostnad | Passar bäst för |
|---|---|---|---|---|---|---|
| Thunderbit (AI no-code) | Mycket hög | Minuter | Låg | Hög (moln) | Gratisnivå, från $15/mån | Sälj, ops, icke-tekniska användare |
| Traditionella tillägg | Medel | 30+ min | Medel | Begränsad | Gratis/låg | Enkla jobb, tålmodiga användare |
| Egen kod (Python) | Låg | Timmar+ | Hög | Mycket hög | Utvecklartid | Utvecklare, datateam |
| Outsourcing-tjänster | Hög | Dagar | Låg | Hög | $$$ | Stora engångsprojekt |
Thunderbit sticker ut för icke-tekniska användare: ingen kod, One Click Extract och ett arbetsflöde som är lika enkelt som att beställa hämtmat. Traditionella verktyg kräver mer pillande, och egen kod passar bäst för utvecklare.
Extrahera vilken sida som helst med ett enda klick Thunderbits agentiska webbskrapare läser av sidan, förstår dess struktur och ger dig en ren tabell — utan selectors. Get Started Free
Thunderbit i praktiken: skrapa webbplatsdata på bara några klick
Så här skulle jag använda Thunderbit för att skrapa till exempel ett register över fastighetsmäklare:
- Installera Chrome-tillägget och logga in.
- Gå till målsajten (t.ex. ett mäklarregister).
- Klicka på Thunderbit-ikonen för att öppna sidofältet.
- Tryck på ”One Click Extract.” Thunderbits AI skannar sidan och föreslår kolumner som Namn, Byrå, Telefon, E-post.
- Granska och justera fälten — byt namn på kolumner, lägg till en anpassad prompt om du vill kategorisera eller formatera data.
- Klicka på ”Scrape.” Thunderbit extraherar datan till en tabell och hanterar både sidnumrering och oändlig scroll.
- Exportera till Excel, Google Sheets eller Notion — utan extra kostnad och utan dolda avgifter.
Om varje mäklares namn länkar till en profilsida kan du använda undersidesskrapning: Thunderbit besöker varje profil, hämtar extra information, som adress eller antal år i branschen, och lägger till den i tabellen. Slipp öppna flikar en och en.
Webbläsarskrapning vs molnskrapning: vilket läge passar dig?
Thunderbit ger dig två lägen:
- Webbläsarskrapning: Körs i din lokala Chrome-webbläsare. Perfekt för data bakom inloggning eller personliga sidor (som ditt LinkedIn-konto eller interna dashboards). Den använder din session och dina cookies, så om du kan se det kan Thunderbit skrapa det.
- Molnskrapning: Körs på Thunderbits servrar. Väldigt snabbt för offentlig data — skrapar upp till 50 sidor samtidigt, belastar inte din dator och fortsätter även om du stänger locket på datorn. Perfekt för större jobb som att skrapa alla produkter från en e-handelsbutik.
När du ska använda vad:
- Webbläsarläge: Sajter som kräver inloggning, personliga flöden, mindre jobb.
- Molnläge: Storskalig offentlig data, schemalagda skrapningar eller när du vill köra och glömma.
Thunderbit hanterar också sidnumrering och undersidor i båda lägena, så du får kompletta datamängder varje gång.
Dubbla ner på effektiviteten: använd AI för att förfina fält och dataformat
En av mina favoritfunktioner i Thunderbit är ”AI Improve Fields”. Här är varför den är så bra:
- Automatisk formatering: Standardisera telefonnummer, priser eller datum medan du skrapar — inga fler stökiga kalkylblad.
- Kategorisering: Lägg till en kolumn som ”Kategori” och låt AI:n märka varje rad (t.ex. Elektronik, Kläder, Möbler) utifrån beskrivningen.
- Översättning: Skrapa sajter på andra språk och låt Thunderbit översätta fälten till engelska (eller 34+ andra språk).
- Anpassade promptar: Vill du extrahera sentiment från recensioner eller tagga företag efter storlek? Lägg bara till en AI-prompt för fältet.
Det betyder att du får analysklar data direkt från verktyget, utan timmar av manuell städning.
Automatisera ditt arbetsflöde: schemalägg regelbunden skrapning av webbplatsdata
Varför nöja sig med engångsskrapning? Thunderbits Schedule-funktion låter dig sätta upp återkommande skrapningar — dagligen, veckovis eller när du vill.
- Beskriv schemat i vanlig svenska (”varje måndag kl. 9”).
- Välj projekt och exportmål (Excel, Google Sheets, Airtable, Notion).
- Thunderbit kör skrapningen automatiskt och uppdaterar din data — utan manuellt arbete.
Användningsområden:
- Sälj: Dagliga uppdateringar av leadlistor.
- E-handel: Automatiserad prisbevakning.
- Operations: Lager- eller stockvarningar.
- Marknadsanalys: Sammanställning av nyheter eller recensioner.
Med schemalagd skrapning hålls datan färsk, och teamet har alltid den senaste informationen nära till hands.
Jämförelse av populära verktyg för att skrapa webbplatsdata: snabb översikt
Här är en sida-vid-sida-översikt över de vanligaste alternativen:
| Verktygstyp | Användarvänlighet | Tid att komma igång | Skalbarhet | Underhåll | Kostnad | Passar bäst för |
|---|---|---|---|---|---|---|
| Thunderbit (AI no-code) | ⭐⭐⭐⭐⭐ | Minuter | Hög | Låg | Gratis/$15+/mån | Sälj, ops, icke-tekniska användare |
| Traditionella tillägg | ⭐⭐⭐ | 30+ min | Medel | Medel | Gratis/låg | Enkla jobb, tålmodiga användare |
| Egen kod (Python) | ⭐ | Timmar+ | Mycket hög | Hög | Utvecklartid | Utvecklare, datateam |
| Outsourcing-tjänster | ⭐⭐⭐⭐ | Dagar | Hög | Låg | $$$ | Stora engångsprojekt |
För de flesta affärsanvändare är Thunderbit den tydliga vinnaren när det gäller hastighet, enkelhet och kostnad.
Viktiga slutsatser: så skrapar du webbplatsdata effektivt
- Webbskrapning är nu tillgängligt för alla. Ingen kod behövs — välj bara rätt verktyg och följ några enkla steg.
- Definiera mål och fält innan du börjar. Vet vilken data du behöver och var du hittar den.
- Använd AI-drivna verktyg som Thunderbit för snabbast och enklast resultat — särskilt om du inte är teknisk.
- Automatisera repetitiva uppgifter med schemaläggning så att datan uppdaterar sig själv.
- Förfina och formatera datan medan du skrapar med AI-promptar — få analysklar output direkt.
Redo att testa? Ladda ner Thunderbits Chrome-tillägg och börja med din första skrapning gratis. Eller kolla in Thunderbit-bloggen för fler guider och verkliga exempel.
Se hur Thunderbit står sig Se hur Thunderbits AI-drivna extrahering med ett klick jämförs med de andra verktygen i den här guiden. Get Started Free
Vanliga frågor
1. Är web scraping lagligt och säkert för företag?
Ja, så länge du skrapar offentligt tillgänglig data och följer webbplatsens användarvillkor. Undvik att skrapa personliga eller känsliga uppgifter utan tillstånd och kontrollera alltid sajtens policyer.
2. Vilken typ av data kan jag skrapa med Thunderbit?
Du kan extrahera text, siffror, datum, URL:er, e-postadresser, telefonnummer, bilder med mera. Thunderbits AI kan dessutom kategorisera, märka och översätta fält medan du skrapar.
3. Kan jag skrapa data från sajter som kräver inloggning?
Absolut — använd Thunderbits webbläsarläge för att skrapa data från vilken sida du än kan öppna i din webbläsare, även bakom inloggning.
4. Hur hanterar Thunderbit webbplatser med många sidor eller undersidor?
Thunderbit stöder automatisk sidnumrering och skrapning av undersidor. Det kan följa ”nästa”-knappar och besöka länkade detaljsidor, och sedan slå ihop all data i en tabell.
5. Kan jag schemalägga skrapningar så att de körs automatiskt?
Ja! Thunderbits Schedule-funktion låter dig skapa återkommande skrapningar (dagligen, veckovis osv.) och exportera resultaten direkt till Excel, Google Sheets, Airtable eller Notion.
Prova Thunderbits agentiska webbskrapare gratis Get Started Free
Att skrapa webbplatsdata behöver inte vara ett huvudbry. Med rätt verktyg och en tydlig plan kan du förvandla webben till din egen databas — ingen kod, ingen stress, bara resultat. Lycka till med skrapandet!



