
Varannan månad dyker det upp en snabbare HTML-parsare, benchmark-resultaten sprids och någon ropar ut att gamla rävar är föråldrade. Sedan ska du markera varje paragraf som innehåller ett visst ord, eller hämta föräldern till en matchad nod, och då minns du varför lxml fortfarande ligger öppen i en annan flik.
lxml är en 20 år gammal binding till libxml2. Den är inte särskilt glammig. Den är inte ny. Och för en specifik uppgift — allt som kräver riktig XPath — finns det faktiskt inget annat i det etablerade Python-ekosystemet som riktigt konkurrerar. Det här är en praktisk genomgång av vad lxml gör, var den tyst vinner, och de få ställen där standardinställningarna kan bita dig om du inte känner till dem.
lxml i korthet: vad det faktiskt är
lxml är en Python-binding till C-biblioteken libxml2 och libxslt. Det är en parser och serializer, inte en scraper och inte en webbläsare — den omvandlar markup till ett träd du kan fråga och redigera, och gör sedan om trädet till bytes igen. Du får ett ElementTree-kompatibelt API, en komplett XPath 1.0-motor, XSLT 1.0 och schema-validering, underhållet av Stefan Behnel med parollen "the most feature-rich and easy-to-use library for processing XML and HTML in the Python language".
Så här såg läget ut, baserat på en GitHub- och PyPI-snapshot tagen 2026-07-14:
| Fält | Värde |
|---|---|
| Repo | lxml/lxml |
| Stjärnor | 3,043 |
| Forks | 620 |
| Öppna ärenden | 16 |
| Licens | BSD-3-Clause |
| Skapat | 2011-02-11 |
| Senaste push | 2026-07-02 |
| Stabil version på PyPI | 6.1.1 (2026-05-18) |
| Inkluderad motor | libxml2 2.14.6 + libxslt 1.1.43 |
En sak att reda ut direkt, innan någon anklagar mig för hype: det finns inga hemligheter i den här recensionen. lxml är gammal nog att allt här redan finns dokumenterat någonstans i lxml-dokumentationen, en changelog för libxml2 eller en tråd på Launchpad. Jag hittade inget exklusivt, odokumenterat trick, och jag tänker inte hitta på något. Värdet i det som följer är att det är systematiserat, kvantifierat och organiserat kring lxml som ämne — inte att det är nyhetsstoff.
Testupplägget (och varför tidsmätningarna är lånade)
Två kategorier av data ligger bakom den här recensionen, och de kommer från två olika ställen, så jag vill vara tydlig med vad som är vad.
Kapacitetstesterna — XPath-beteende, de två parser-API:erna, namespaces, kodning, nodlivscykel — körde jag färskt på en maskin: macOS arm64, Python 3.14.2, lxml 6.1.1, libxml2 2.14.6. Varje siffra i filerna artifacts/raw/*.json är beräknad av ett skript, inte inskriven för hand. Kapacitetstester är deterministiska booleans och enum-värden, så ett enda körningstillfälle är stabilt — maskinbelastning ändrar inte om //a/@href returnerar en attributsträng.
Tids- och minnessiffrorna är inte från den här omgången. De återanvänds ordagrant från den tidigare selectolax-benchmarkpaketen — samma maskin, samma virtuella miljö, samma lxml- och libxml2-byggnad, benchmarks som gällde 2026-07-13 — och jag körde inte om dem här. Det är medvetet. Att köra tidsbenchmarks samtidigt som en bunt kapacitetsskript riskerar CPU-konkurrens som smutsar ned de återanvända siffrorna, och det skulle också vara dubbelarbete: lxml var redan ett fullt uppmätt kontrollbibliotek i det paketet. Att återanvända samma bench håller allt jämförbart i stället för att introducera en andra, lite annorlunda mätning. Så när du ser en millisekundssiffra nedan, läs den som "samma testuppsättning, giltig per 2026-07-13," inte "jag mätte om detta i dag."
Resultaten har en tillförlitlighetsmarkering: single-observation för de deterministiska kapacitetstesterna, triple-run för de återanvända tidsdistributionerna och hypothesis där jag föreslår en mekanism jag inte isolerade.
XPath: det som selectolax och BeautifulSoup helt enkelt inte har
Det här är huvudpoängen, så vi börjar här.
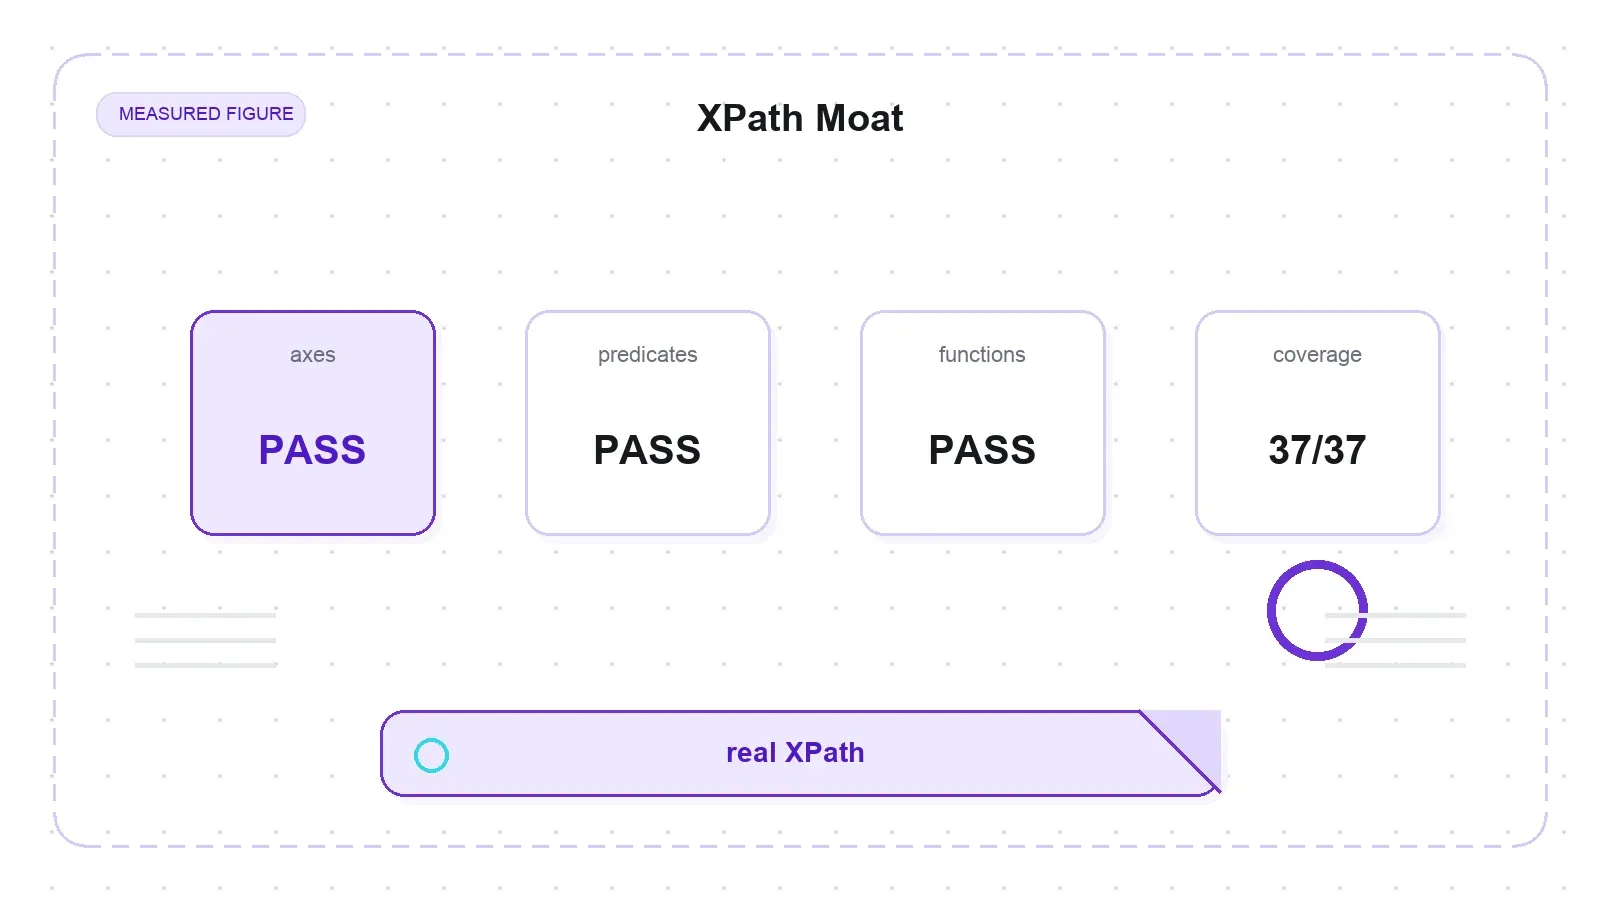
Jag körde lxml:s xpath() genom en förregistrerad matris med 37 punkter — förväntat resultat för varje fall skrevs in i källkoden innan testet kördes, så jag kunde inte råka sätta betyg på en kurva. Tio axes, nio predikatstilar, tio inbyggda funktioner, tre skalära returtyper och fem medvetna fällor med XPath 2.0-syntax som lxml:s 1.0-motor ska avvisa.
| Kategori | Täckning | Resultat |
|---|---|---|
| Axes | child / descendant / parent / ancestor / following-sibling / preceding-sibling / self / attribute / following / preceding | 10/10 godkända |
| Predikat | [1] / last() / position()<n / attributlikhet / attributexistens / and / or / nästlad [.//a] / not() | 9/9 godkända |
| Funktioner | text() / contains() / starts-with() / count() / string-length() / normalize-space() / concat() / substring() / name() / string() | 10/10 godkända |
| Returtyper | boolean / number-skalärer | 3/3 godkända |
| Fällor | matches() / sekvenser / if-then-else / except / syntaxfel | 5/5 avvisade korrekt |
Poängen blev 37/37, och fällkolumnen är den viktiga delen. matches(), sekvenser, if/then/else och except är XPath 2.0-syntax, och libxml2:s 1.0-motor stöder dem inte halvvägs — den kastar XPathEvalError och vägrar i stället för att tyst returnera en felaktig nodmängd. Så detta är full pott efter att ha försökt bryta den, inte en perfekt poäng byggd på enkla frågor. Varje beteende här är exakt vad lxml:s XPath-dokumentation beskriver, vilket är poängen.
Jag erkänner också en sak som testharnessen först gjorde fel, eftersom det är den version av "37/37" du faktiskt kan lita på. Min första förväntade mängd för //div[.//a[@href]] förutsåg två träffar; körningen gav en. Jag antog att lxml hade fel i ungefär trettio sekunder, kollade sedan fixture-filen och såg att det andra elementet var en <footer>, inte en <div> — min förväntan var fel, inte motorn. Jag rättade den förväntade mängden och lämnade misstaget i en kommentar i källkoden. Det är rätt ordning på skulden: misstänk ditt eget test innan du misstänker ett 20 år gammalt C-bibliotek.
XPath vs CSS: det du bokstavligen inte kan uttrycka i CSS
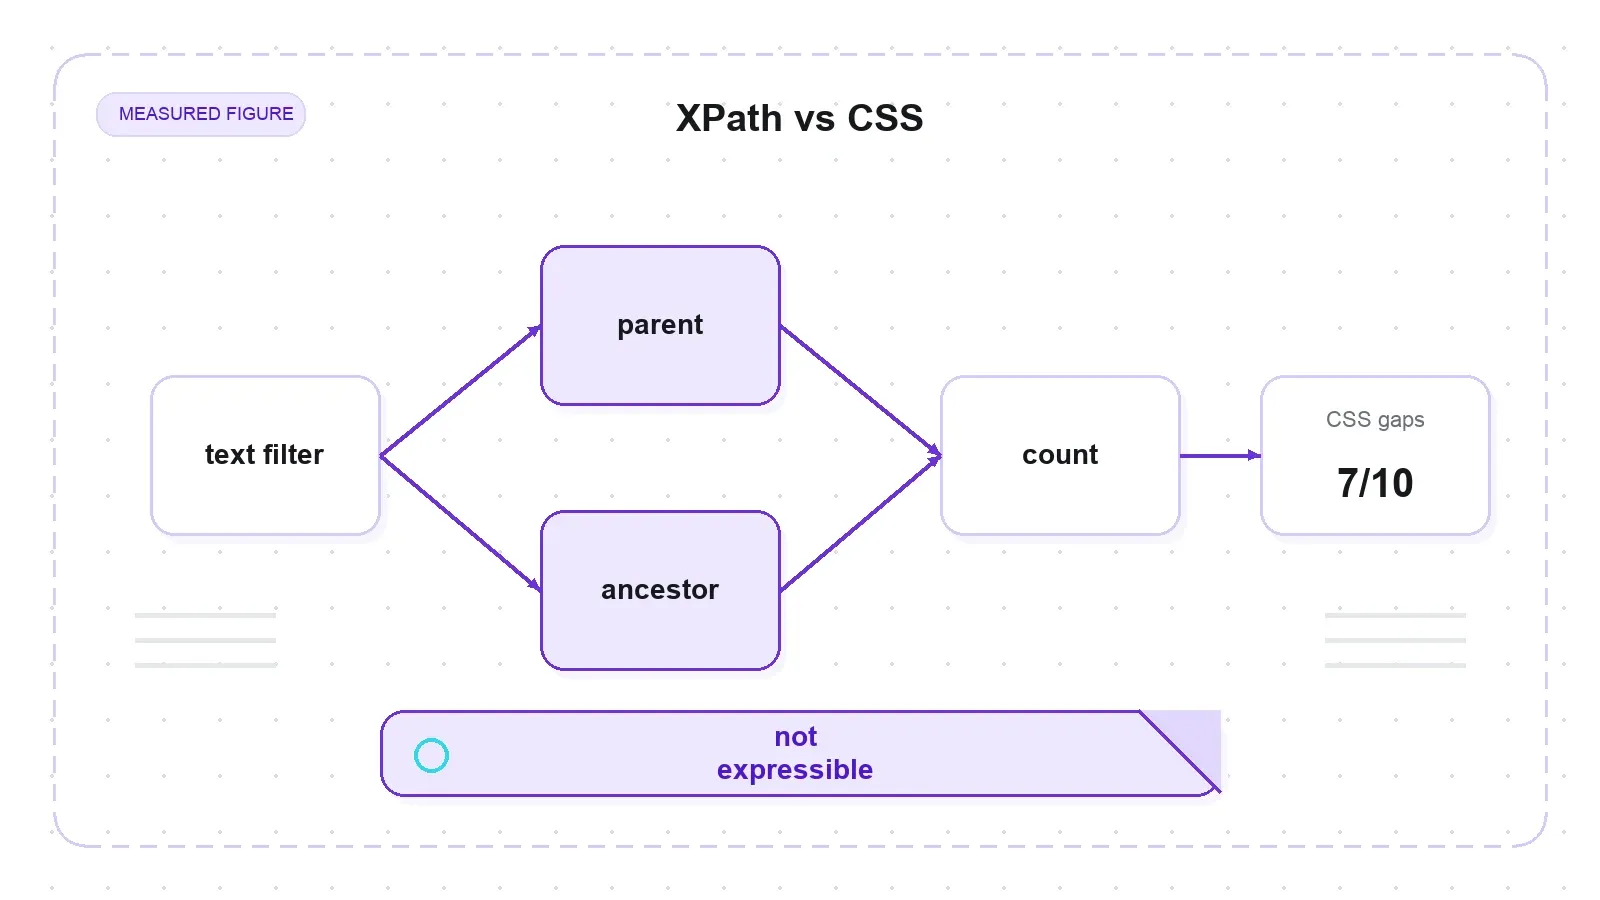
Det abstrakta påståendet att "XPath är kraftfullare" förtjänar en konkret siffra, så jag kvantifierade gapet. lxml ger dig både .xpath() och .cssselect() (den senare översätter CSS till XPath under huven). Jag tog tio urvalsmål och kontrollerade vilka av dem CSS faktiskt kan uttrycka.
| Mål | XPath | CSS (cssselect) |
|---|---|---|
Filtrera på textinnehåll (contains(text(),"bargain")) | Ja | Ingen textpredikatsyntax |
Välj förälder från barn (//b/parent::p) | Ja | Ingen föräldraselektor |
Returnera ett attributvärde (//a/@href) | Ja | Endast element |
Returnera en textnod (//p/text()) | Ja | Inga textnoder |
Ancestor-axis (//td/ancestor::div) | Ja | Ingen uppåtgående navigering |
Filtrera förälder efter antal barn (//ul[count(li)=4]) | Ja | Inget count-predikat |
Filtrera efter textlängd (string-length(text())>5) | Ja | Inget längdpredikat |
nth-child / last-child / angränsande syskon | Ja | Ja (3 grundfall) |
Sju av tio mål har ingen CSS-motsvarighet alls. Filtrering på textinnehåll, uppåtgående navigering till föräldrar och förfäder, att hämta ett attributvärde eller en ren textnod som resultat, samt predikat baserade på antal — CSS kan inte uttrycka något av detta. Endast tre (nth-child, last-child, angränsande syskon) fungerar i båda. Det är det kvantifierade svaret på "vad får jag egentligen ut av att välja lxml." selectolax är endast CSS-baserat och har ingen xpath()-metod alls, så de sju frågetyperna blir där antingen flerstegs-Pythonloopar eller omöjliga. Om din scrapinglogik lutar på någon av dem har du redan ditt beslut.
(Och ja, harnessen fångade mig en andra gång här: jag förutspådde en tom mängd för string-length(text())>5, men två strängar med sex tecken matchade. Fixade förväntan, inte verktyget.)
Tre nivåer av strikthet: etree, recover och lxml.html
XPath är skälet att välja lxml. Trelägeskontrollen för strikthet är skälet att behålla den.
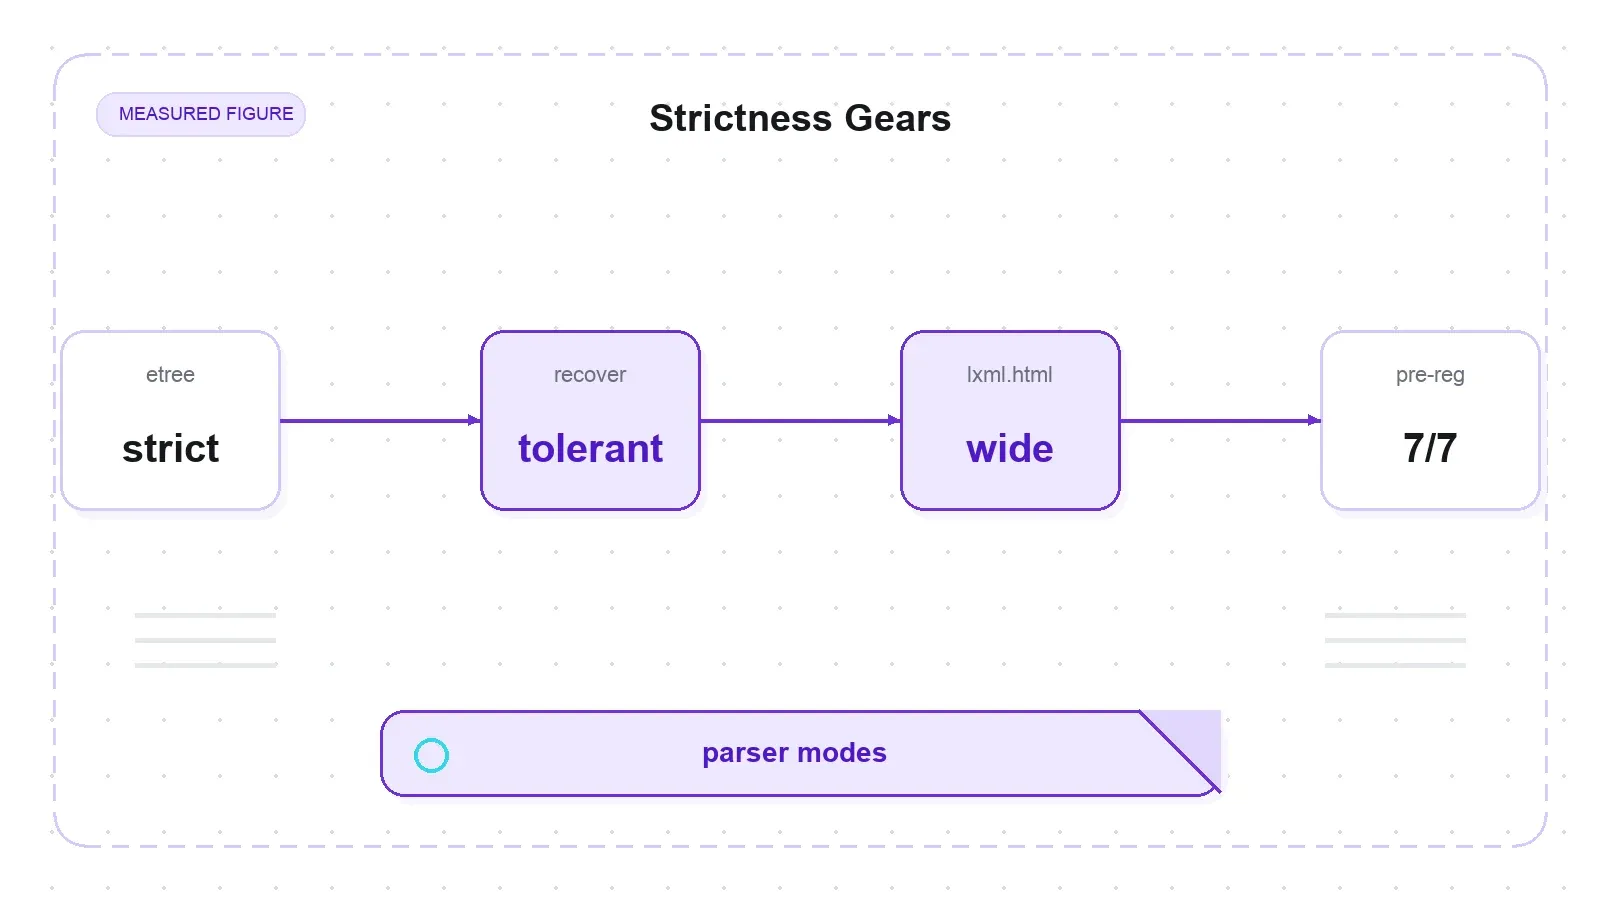
De flesta parsare ger dig ett beteende för trasig indata. lxml ger dig tre, och de är tillräckligt förutsägbara för att jag matade sex klasser av felaktig markup genom var och en och förregistrerade hur varje väg skulle bete sig.
| Felaktig indata | lxml.etree (strikt) | etree + recover=True | lxml.html (tolerant) |
|---|---|---|---|
Oavslutad tagg <root><a>x</root> | kastar fel | återställer | accepterar |
Fel nästlad <b><i></b></i> | kastar fel | återställer | accepterar |
Odefinierad entitet | kastar fel | återställer | accepterar |
Ensamt & (Tom & Jerry) | kastar fel | återställer | accepterar |
Flera rötter <a>1</a><b>2</b> | kastar fel | återställer | accepterar |
| Välformad XML | accepterar | accepterar (0 fel) | accepterar |
Boolean-attribut <input disabled> | kastar fel | återställer | accepterar |
Sju av sju matchade den förregistrerade förväntan. lxml.etree kastar XMLSyntaxError på alla sex felaktiga klasserna. Lägg till recover=True i samma parser och den sväljer felen och bygger upp ett användbart träd — och det underskattade här är att parser.error_log då listar varje fel den svalde. lxml.html accepterar allt utan invändningar.
Klassificeraren som avgör "kastar fel vs återställer vs accepterar" drivs i sig av längden på error_log vid körning, inte hårdkodat, vilket är skälet till att ett välformat dokument med recover=True korrekt etiketteras som "accepterar" (tom logg) i stället för "återställer." Min första version av klassificeraren märkte varje recover=True-resultat som "återställer" och felklassificerade den rena indata; att läsa den faktiska error_log löste det.
Vad detta ger i praktiken: strikt validering när en trasig feed ska falla högt och tydligt, använd lxml.etree. Smutsig verklig HTML som du bara behöver ta dig igenom, använd lxml.html. Och mellanfallet som de flesta verktyg inte klarar — "var tolerant, men säg exakt vad som var trasigt så jag kan logga det" — använd recover=True och läs felloggen. selectolax har den toleranta växeln och inget mer, inget strikt läge och ingen fellogg.
iterparse: streaming-växeln som selectolax inte har alls
Det här är en kapabilitetsrad, inte en hastighetsknapp. selectolax tar bara in en hel sträng — det finns inget inkrementellt gränssnitt. lxml:s iterparse ger element allt eftersom de stängs, och ihop med det klassiska fast_iter-mönstret (anropa elem.clear() och ta bort föregående syskon medan du går) håller den minnet plant oavsett hur stor dokumentet blir.
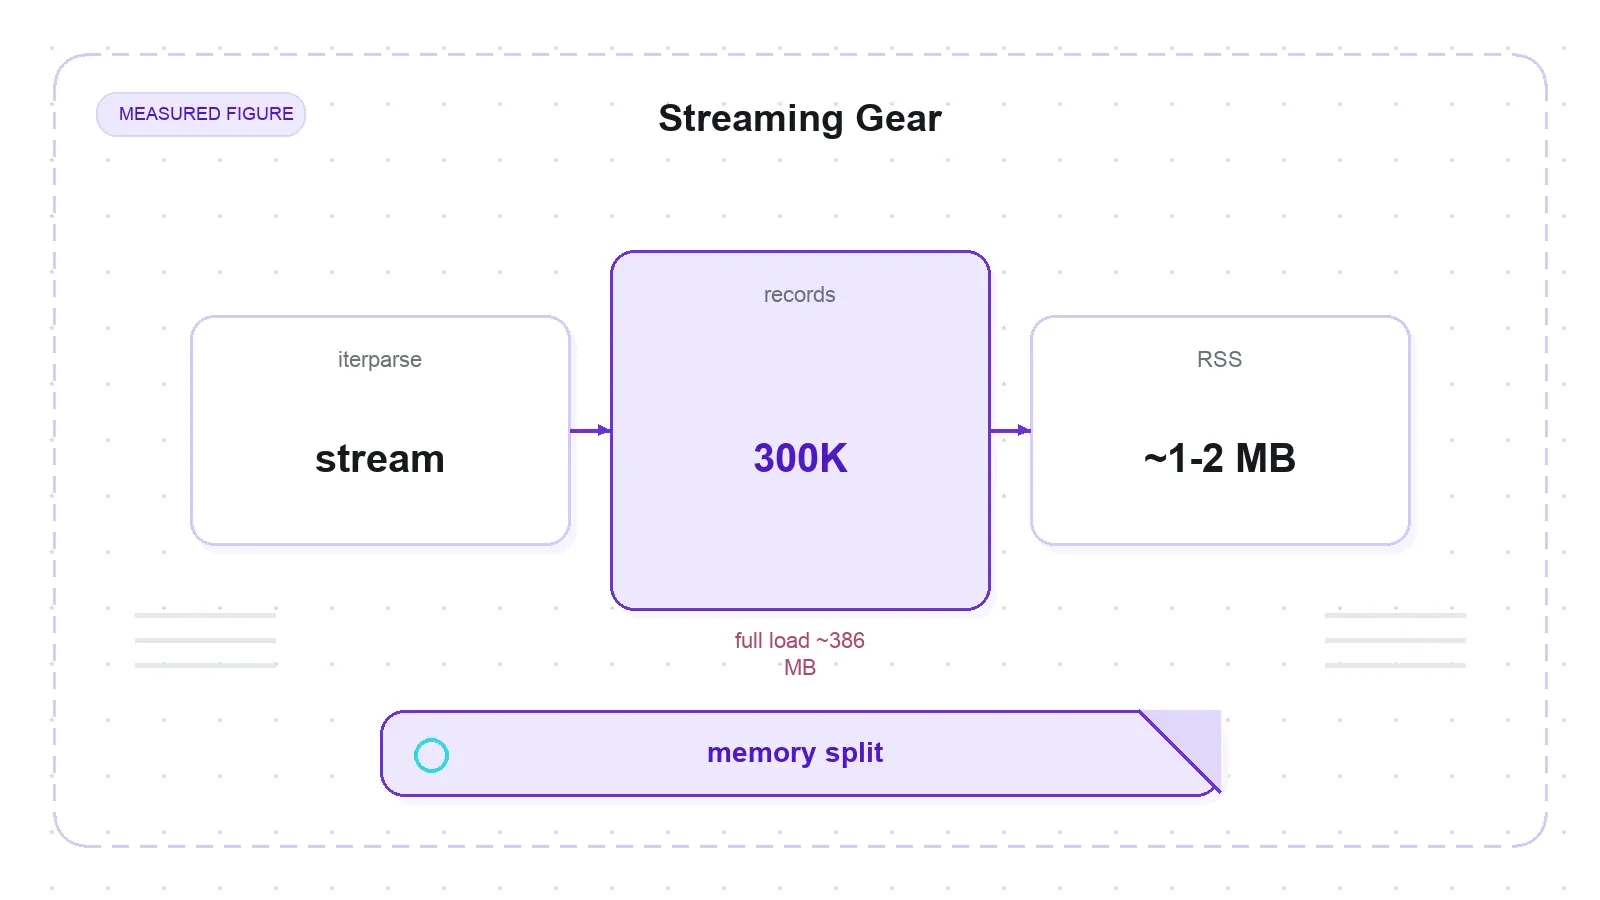
Jag mätte minnesegenskapen direkt — peak RSS via ru_maxrss, varje test i en egen färsk process, på 300 000 <record>-element som tillsammans vägde ungefär 26,7 MB (26,744,801 bytes).
| Läge | Topp-RSS-ökning | Notering |
|---|---|---|
iterparse + clear (fast_iter) | ~1-2 MB | släpper minne löpande; plant oavsett antal |
iterparse utan clear | ~386 MB | behåller referenser; lika tungt som full laddning |
etree.parse (full laddning, referens) | ~386 MB | känt tung; visar att mätaren fångar storleksordningen |
Det begränsade läget håller toppökningen i RSS till ungefär 1-2 MB jämfört med full laddnings ~386 MB — en storleksordningsskillnad på 0,3–0,4% — och den första record-händelsen triggas innan filen ens är färdigläst, så det är verkligen inkrementellt, inte fejkat streaming. Den lärorika raden är mittenraden. Kör samma iterparse-loop men hoppa över clear(), så klättrar minnet tillbaka till ~386 MB, eftersom du håller referenser till allt. Vinsten sitter i clear(), inte i iterparse i sig. Referensläsningen med full laddning betydligt högre än det begränsade läget bekräftar också att RSS-mätaren faktiskt kan se storleksskillnaden i stället för att läsa i blindo. (Det här är ett minnestest jag körde i just det här paketet — en footprint-mätning, skild från de lånade tidssiffrorna.)
Den verkliga versionen av detta: en XML-export på flera gigabyte som inte ryms i RAM har ingen selectolax-väg alls. Det är lxml:s streamingparser eller ett annat språk.
Namespaces: RSS, SVG och fällan med standardnamespace
Tolv namespace-fall, som täcker RSS över tre namespaces, SVG med ett standardnamespace plus xlink, och XML med standardnamespace. Alla tolv klarade sig.
lxml plockar //dc:creator/text() ur ett RSS-flöde som exakt ["Alice", "Bob"], löser //atom:link/@href och //content:encoded över tre separata namespaces i samma dokument, hanterar //s:rect och //s:use/@xlink:href i SVG:s andra namespace, delar Clark-notationens {uri}lokal-namn med QName och kan inspektera via nsmap. Det här är dokumenterat, underhållet beteende, och det är en hel dimension som selectolax inte rör vid, eftersom selectolax är HTML5-baserat och inte hanterar godtyckliga XML-namespaces.
Det finns en dokumenterad fälla som är värd att lägga på minnet. XPath har inget begrepp om ett standardnamespace. Peka //book mot ett dokument som deklarerar xmlns="urn:..." och du får noll träffar — det tomma prefixet är inte definierat för XPath, som lxml-dokumentationen förklarar. Du måste binda ett artificiellt prefix (//c:book med namespaces={"c": "urn:..."}, vilket hittade alla tre) eller falla tillbaka på //*[local-name()='book'] (också tre). Inte en bugg — det är XPath-specifikationen, korrekt implementerad. Den överraskar bara alla en gång.
Verkligt smutsiga sidor: träffsäkerhet på 11 faktiska scrapningar
Syntetiska tester är rena; webben är det inte. Jag återanvände elva verkliga fångade sidor från selectolax-paketets fixture-set (giltigt per 2026-07-10, read-only) och körde lxml.html mot dem med lxml som huvudobjekt.
| Fixture | Storlek | Länkar | libxml2 återställda fel | Strikt XML |
|---|---|---|---|---|
| news_bbc.html | 398 KB | 255 | 4 | ok |
| docs_mdn_array.html | 243 KB | 508 | 0 | kastade fel |
| wiki_scraping.html | 227 KB | 460 | 0 | kastade fel |
| gov_whitehouse.html | 289 KB | 154 | 0 | kastade fel |
| oldstyle_craigslist.html | 561 KB | 351 | 0 | kastade fel |
| forum_reddit.html | 129 KB | 318 | 0 | kastade fel |
| docs_python.html | 80 KB | 341 | 2 | kastade fel |
| ecommerce_books.html | 51 KB | 94 | 0 | kastade fel |
| news_hackernews.html | 35 KB | 229 | 0 | kastade fel |
| ecommerce_webscraper_allinone.html | 16 KB | 35 | 0 | kastade fel |
| spa_quotes_js.html | 6 KB | 5 | 0 | kastade fel |
Alla elva parse:ades med lxml.html, och antal länkar, rubriker och bilder stämde med de återanvända lxml-siffrorna från selectolax-paketet i alla elva fall — korscheck true. Den överensstämmelsen är det som säger mig att återanvändningen verkligen är äpplen mot äpplen och inte två olika mätningar som bär samma etikett.
Sidofyndet: den strikta XML-parsern kastade fel på tio av de elva sidorna. Verkliga webbsidor är överväldigande ofta inte välformad XML, vilket är exakt varför libxml2:s HTML-återställningsläge finns för att svälja dem. Det enda undantaget var BBC News, renderad med Next.js och tillräckligt välformad för att överleva strikt XML-parsning. Allt som kallas "HTML" behöver inte återställningsläget.
En räknedetalj som är lätt att snubbla på. På docs_python.html gav //a[@href] (attributexistens) 343 träffar, medan selectolax-paketets if n.get("href") (sanningsvärde) gav 341. De två extra är tomma href=""-länkar. Det är en skillnad i räknekonvention — attribut finns kontra attributet är icke-tomt — inte en skillnad i lxml-beteende, och siffrorna går ihop när du alignerar predikatet. Bra att känna till när du scrapar: om tomma hrefs räknas eller inte är ditt filterval, inte parsarens.
Djupgränsen som ser ut som en bugg (men inte är det)
Selectolax-paketet hade noterat att lxml tappade det djupaste innehållet i markup med 1 000 och 5 000 nivåers inbäddade <div>-taggar, och beskrev det som att "lxml tyst förlorar det djupaste innehållet." Jag ville förstå mekanismen, så jag körde standardparsern mot huge_tree=True.
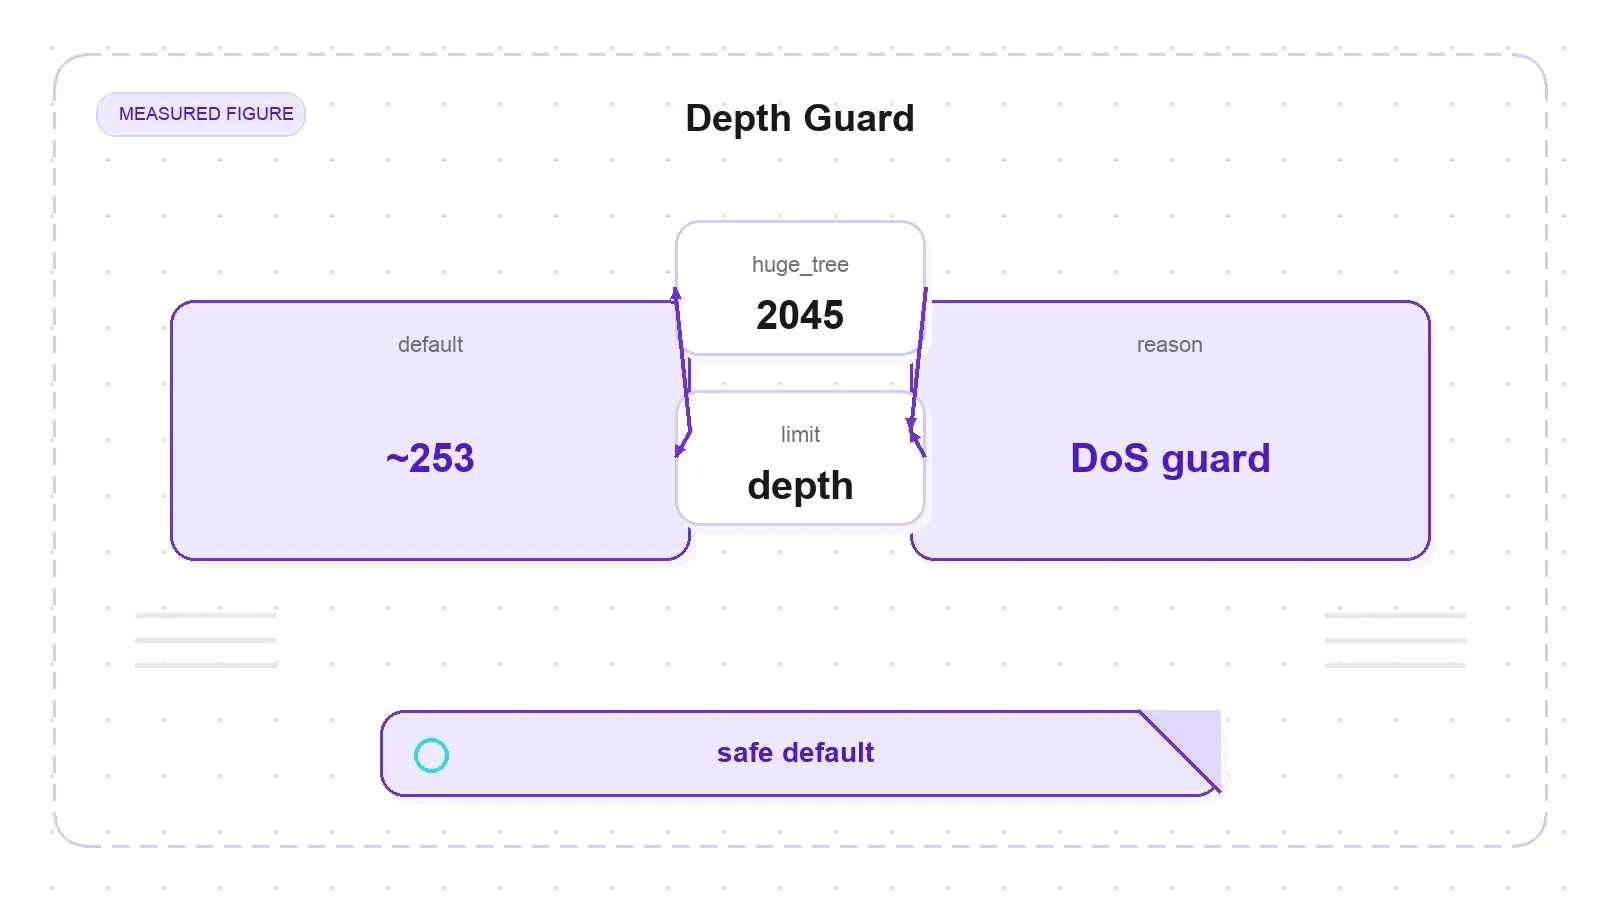
| Begärt djup | Standardparser når | huge_tree=True når |
|---|---|---|
| 300 | 253 (tappar resten) | 299 (återställt) |
| 1000 | 253 (tappar resten) | 999 (återställt) |
| 5000 | 253 (tappar resten) | 2045 (tappar fortfarande) |
Standardparsern trunkerar vid ungefär 253 nivåer och kastar tyst bort allt djupare. Det är inte en bugg — det är libxml2:s DoS-försvar, ett ungefär 256-nivåers nestningstak som hindrar ett fientligt dokument från att slå ut stacken, och det är dokumenterat i lxml-tråden på Launchpad om XML_PARSE_HUGE. Sätt huge_tree=True och djup på 300 och 1 000 kommer tillbaka helt och hållet. Djup 5 000 når däremot bara 2 045 även med huge_tree aktiverat — det finns en andra, hårdare rekursionsgräns i libxml2 ovanför den konfigurerbara, och huge_tree tar inte bort den.
Så åtgärden är konkret: när du parser djup markup från en källa du litar på, använd lxml.html.HTMLParser(huge_tree=True). Det här paketet tillför ovanpå den återanvända observationen mekanismen (en säkerhetsgräns, inte datakorruption), fixen (huge_tree) och faktumet att det finns ett andra tak som fixen inte når.
Läsa/skriva DOM, serialisering, kodning
lxml är ett fullt läs/skriv-träd, inte en skrivskyddad extraktor, och jag verifierade redigeringsytan fall för fall. Alla åtta DOM-operationer klarade sig: SubElement, insert, remove, replace, strip_tags (tar bort taggar men behåller deras text), strip_elements (tar bort taggar och deras text), drop_tree (en lxml.html-exklusiv funktion) och den dubbla text/tail-modellen som ofta förvirrar nybörjare — i <p>head<b>bold</b>tail</p> är p.text "head", b.text "bold" och b.tail "tail".
Serialisering klarade fem av fem: tostring i XML- och HTML-läge (HTML lämnar korrekt tomma element o-self-cloosed), pretty_print, C14N-kanonisering (method="c14n", ännu en lxml-exklusivitet) och en ren round-trip.
Kodning är där lxml tyst skiljer ut sig. Ge den bytes som inte är UTF-8 — "<p>café éè</p>".encode("latin-1") via lxml.html.fromstring — och den återställer café éè intakt, inga U+FFFD-ersättningstecken, inga borttappade bytes. Det reproducerar direkt dess roll som den "rena referensen" i selectolax-paketet, där samma indata korruptades tyst av de andra två motorerna (Lexbor gav ersättningstecken, Modest släppte bytes helt). lxml:s libxml2-baserade teckenuppsättningsdetektion är helt enkelt stabilare här.
Motsidan är striktheten kring hur du deklarerar en kodning. encoding="latin-1" i en XML-deklaration kastar XMLSyntaxError: Unsupported encoding: latin-1, medan den IANA-kanoniska encoding="ISO-8859-1" parse:as fint och returnerar café. libxml2 accepterar bara kanoniska kodningsnamn, inte alias — en detalj som dokumenterats ända sedan Launchpad #613302. Irriterande om du inte vet det, trivialt när du väl gör det.
Slutligen nodlivscykel. Jag körde tre scenarier med gamla handtag i isolerade subprocesser (en hård krasch skulle synas som en icke-noll exit): att hålla en nod efter att dess träd samlats in av garbage collector, läsa ett handtag efter drop_tree() och använda en nod efter remove(). Inga segfaults i något av fallen — lxml håller kvar nodens referens till sitt träd för att förhindra use-after-free. Samma rena protokoll som selectolax fick i det här testet.
Hastighet och minne (lånade, och ärliga om det)
Allt i det här avsnittet är återanvänt från selectolax-paketet, giltigt per 2026-07-13. Det här paketet producerade inga egna tidssiffror, och jag säger hellre det två gånger än att du tror att jag mätte om något.
| Dimension | lxml-värde | Tolkning |
|---|---|---|
| Ren parse p50 (10 MB) | 77.9 ms | cirka 33–34% snabbare än selectolax-Lexbor |
| Full parse + extraktion p50 (1 MB / 10 MB) | 14.18 ms / 172.9 ms | ungefär jämbördigt med Lexbor vid små storlekar |
| 100k-noders CSS-genomströmning | 3,002,646 noder/s | snabbaste nivån bland de tre C-motorerna |
| 10 MB RSS-ökning | 128.9 MB | snålast av sex parsare, cirka 1,7x snålare än BeautifulSoup |
| Kallstart för import | 14.1 ms | cirka 2,3x snabbare än parsel-liknande imports |
Siffrorna för ren parse och genomströmning är starka, och lxml är den mest minnessnåla av de sex parsarna som mättes. Trådningsbilden behöver dock en brasklapp. De återanvända uppgifterna visar en 4-tråds wall-clock-acceleration på bara 1,21x, markerad som osäker — men det gäller vägen med delad standardparser. lxml:s FAQ är tydlig med att GIL släpps under parsing bara när varje tråd använder sin egen parser (eller en kopierad standard); en delad parser serialiserar åtkomst. Jag verifierade API-ytan för att göra det rätt (XMLParser.copy() finns, get/set_default_parser finns, XPathEvaluator har ett internt lås), men jag mätte inte hastighetsvinsten med per-tråd-parser — det skulle vara en ny tidsmätning, och det här paketet producerar inte sådana. Läs alltså "1.21x" som "under den naiva delade vägen", inte som lxml:s tak för trådning.
Och en asterisk på alltihop: det här är siffror från en plattform, macOS arm64. Påståendet att lxml:s rena parse slår Lexbor går emot den vanliga uppfattningen att Lexbor-baserade parsare är snabbast, så det förtjänar verkligen en ny kontroll på Linux x86_64 innan någon betraktar det som avgjort.
Licens: den tråkiga vinsten
lxml distribueras under BSD-3-Clause, och C-biblioteken den bundlar — libxml2 och libxslt — är båda MIT-licensierade. Det är en helt tillåtande kedja utan copyleft någonstans, vilket spelar roll i samma sekund som du redistribuerar den. Som kontrast bundlar selectolax-hjulet LGPL-2.1-Modest och Apache-2.0-Lexbor, så lxml är den renare historien för distribution i en sluten produkt.
Det finns också en praktisk installationsfördel: lxml publicerar förbyggda wheels som statiskt länkar libxml2 och libxslt, så pip install lxml behöver normalt varken systemets libxml2 eller en kompilator på din maskin — en annan upplevelse än att bygga från källkod.
Var lxml passar in — och när ett AI-extraktionslager tar över
Det är dags att vara tydlig med gränsen, för det är lätt att blanda ihop kategorierna. lxml är ett parsningsbibliotek. Det ger dig ett träd och en utmärkt sökmotor, och allt runt det trädet är fortfarande ditt ansvar: hämta sidan, rendera JavaScript, ta dig förbi anti-bot-skydd, skriva och underhålla XPath och strukturera resultatet. Det är ett annat lager än en hostad extraktionstjänst, och de två är inte så mycket rivaler som grannar.
För en utvecklare som helst inte vill äga hela stacken för fetch–render–select–maintain är det i det övre lagret något som Thunderbit passar in — och för den här målgruppen är det API:et, MCP-servern och CLI:n, inte webbläsartillägget. Thunderbit Open API exponerar POST /distill för att göra en sida till ren Markdown och POST /extract för att hämta strukturerad data mot ett JSON Schema, med renderMode-växel och batchjobb för större volymer. Samma motor finns som MCP-server (thunderbit_suggest_fields, thunderbit_distill, thunderbit_extract) för agenter och kodassistenter, och som CLI du kan köra direkt från terminalen via npx @thunderbit/thunderbit-cli. Den hanterar JS-rendering, anti-bot och CAPTCHAs direkt och returnerar schema-matchad JSON — vilket är lagret ovanför parsing, inte en ersättning för det.
Testa Thunderbit för webbdatasutvinning
Poängen är enkel. Välj lxml när du äger pipelinen och vill ha kirurgisk kontroll med XPath över ett träd du förstår. Välj ett AI-extraktions-API när du helst slipper underhålla selektorer och rendering alls. Många riktiga system använder båda — lxml för de strukturerade flöden de själva kontrollerar, en extraktionstjänst för de stökiga långsvanssidor de inte gör det.
Vad den här recensionen inte testade
Det här är en preliminär recension, inte ett slutgiltigt facit, så här är vad den inte täcker.
Alla tids- och minnessiffror är återanvända, från en enda plattform (macOS arm64, Python 3.14) och ärvde det paketets förbehåll — resultatet att "lxml är snabbare vid ren parsing" går emot konsensus och behöver en ny kontroll på Linux x86_64. Hastighetsvinsten per tråd med egen parser är inte testad (det skulle kräva nya tidsmätningar). Jag mätte iterparse-minne på 300k poster men inte på verklig XML i gigabyteklass, inte iterparse på HTML kontra XML och inte ett långkörningstest i flera timmar. lxml:s XSLT 1.0, RelaxNG / XMLSchema / DTD-validering och EXSLT-tillägg är helt otestade här — en stor kapacitetsyta, men utanför kärnan parsing och urval. Jag observerade det andra djupstaket vid 2 045 men fastställde inte libxml2:s exakta rekursionskonstant. Endast stabila 6.1.1 testades, inte 7.0.0-alpha. Windows, byggnad från källkod och den fritrådade 3.14t-byggnaden är också otestade. Och inom själva XPath täckte jag inbyggda funktioner men inte XPath-variabler, egna Python-extensionfunktioner eller återanvändning av förkompilerade etree.XPath-objekt.
Slutsatsen
lxml är inte det snabba nya, och det är just därför det är rekommendationen. Det är en två decennier gammal libxml2-binding med en fullständig XPath 1.0-motor som ingen mainstream-Python-alternativ matchar, tre förutsägbara nivåer av parserstrikthet med en fellogg i mitten, en riktig streamingparser för dokument som inte ryms i minnet, korrekt hantering av flera namespaces och kodningar samt en helt tillåtande licens. De få vassa kanterna — djupgränsen runt 253 nivåer och trådsiffran med delad parser — är dokumenterade, justerbara och nu förklarade.
Om du äger din scraping-pipeline och lutar dig mot XPath är lxml fortfarande parsaren du väljer. Om du helst vill slippa underhålla selektorer och rendering är det där ett AI-extraktionslager som Thunderbit API, MCP och CLI kommer in — en tydlig arbetsfördelning, inte en tävling. Oavsett vilket bör du behandla dessa siffror som preliminära och kontrollmäta på din egen plattform innan du citerar dem i ett design-dokument.
Testa Thunderbit för webbdatasutvinning Get Started Free
Vanliga frågor
Är lxml en web scraper?
Nej. lxml är en parser och serializer — en Python-binding till libxml2/libxslt som gör markup till ett redigerbart och sökbart träd. Den hämtar inte sidor, renderar inte JavaScript och hanterar inte anti-bot-skydd; du tillhandahåller request-lagret (via requests, httpx, en headless browser eller en scraping-tjänst) och ger bytes till lxml.
När ska jag använda lxml i stället för BeautifulSoup eller selectolax? Välj lxml när du behöver XPath. BeautifulSoup kan faktiskt använda lxml som backend-parser men erbjuder ingen inbyggd XPath, och selectolax är CSS-baserat och snabbare i sin smala nisch. Om din urvalslogik behöver filtrering på textinnehåll, navigering till föräldrar eller förfäder, extraktion av attribut/textnoder eller count-predikat, är lxml:s XPath-motor det enda etablerade Python-alternativet som uttrycker det direkt.
Varför tappar lxml tyst djupt nästlad innehåll?
Standardparsern sätter ett tak runt 253 nivåer — libxml2:s DoS-försvar mot fientliga dokument, inte en bugg. Sätt huge_tree=True (till exempel lxml.html.HTMLParser(huge_tree=True)) och den återställer fullt ut djup på 300 och 1 000. Tänk på att det finns ett andra, hårdare rekursionstak runt 2 045 nivåer som huge_tree inte tar bort.
Släpper lxml GIL vid multitrådad parsing? Bara under rätt förutsättningar. lxml:s FAQ säger att GIL släpps under parsing när varje tråd använder sin egen parser eller en kopierad standardparser; en delad parser serialiserar i stället åtkomsten. Den återanvända 4-trådsaccelerationen på 1,21x speglar den naiva vägen med delad parser, inte taket med per-tråd-parser, som inte mättes här.
Underhålls lxml fortfarande 2026? Ja. Stabil version 6.1.1 släpptes 2026-05-18, repot pushades senast 2026-07-02 och en 7.0.0-alpha är under utveckling. Med omkring 3 000 GitHub-stjärnor och ett aktivt underhåll av libxml2 i botten är det fortfarande ett aktuellt och välstödd bibliotek, inte en relik.




