
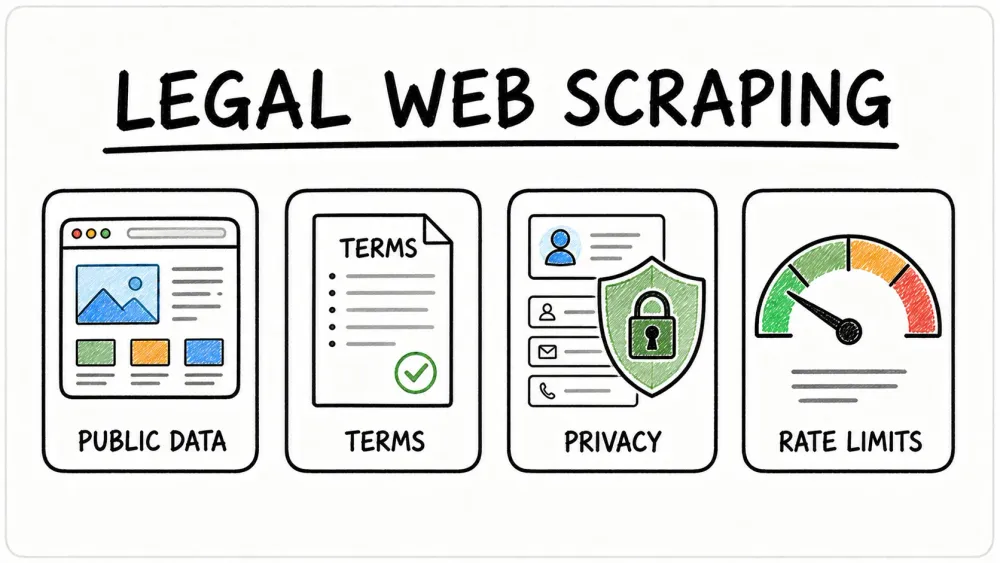
Keywords
är det lagligt att samla in data från webbplatser
Content
”Är det lagligt att samla in data från webbplatser?”—det är den där miljonfrågan jag får från sälj-, operations- och marknadsteam nästan varje vecka. Eftersom web scraping nu driver allt från leadgenerering till konkurrensanalys är det inte konstigt att alla vill ha ett tydligt svar. Men sanningen? Det juridiska läget är ungefär lika klart som en kopp kaffe från gårdagen. Titta bara på rubrikerna: en domstol säger att insamling av offentliga data är okej, medan en annan varnar för ”olaglig datainsamling”. Inte konstigt att så många team känner sig osäkra på var gränsen går.
Så här ser läget ut: mer än två tredjedelar av organisationer använder nu web scraping för att driva analys- och AI-projekt, och hela 78% av e-handelsföretagen lutar sig mot det för prisintelligens. Men med uppmärksammade rättsprocesser som LinkedIn mot hiQ Labs i rubrikerna har insatserna aldrig varit högre. Så hur får du ut värdet av webdata—utan att hamna i juridiskt trubbel? Låt oss reda ut de juridiska ramarna, kontrollpunkterna för efterlevnad och de bästa arbetssätten som alla affärsanvändare behöver känna till. Och ja, jag visar också hur Thunderbit gör regelrätt scraping betydligt enklare.
Förstå det juridiska landskapet: Är det lagligt att samla in data från webbplatser?
Testa Thunderbits regelmedvetna web scraper Thunderbits agentiska web scraper läser offentliga sidor själv och extraherar data med ett klick, byggd med compliance i fokus. Get Started Free
Låt oss ta det direkt: lagligheten kring web scraping beror på vad du samlar in, hur du gör det och var du befinner dig. Det finns ingen enda global lag som säger att ”scraping är lagligt” eller ”scraping är olagligt”. I stället handlar det om en mix av regler—tänk anti-hackinglagar, integritetsregler, upphovsrätt och till och med webbplatsens användarvillkor (Thunderbit Blog).
Här är de viktigaste faktorerna som avgör om ditt scraping-projekt håller sig på rätt sida av lagen:
- Offentliga vs. privata data: Att samla in data som är öppen för alla (ingen inloggning, ingen betalvägg) är i regel säkrare. Om du försöker ta dig in bakom inloggning är du sannolikt ute på hal is.
- Typ av data: Personuppgifter (som namn, e-post eller sociala profiler) och upphovsrättsskyddat innehåll (artiklar, bilder) är betydligt känsligare än faktauppgifter (priser, produktspecifikationer, företagslistningar).
- Avsedd användning: Att använda insamlad data internt (för analys eller research) är mycket mindre riskabelt än att publicera eller sälja den vidare.
- Efterlevnad av webbplatsens regler: Att bryta mot en sajts villkor eller ignorera dess robots.txt-fil kan ställa till problem—även om uppgifterna är offentliga.
- Tekniskt tillvägagångssätt: Att skrapa i mänsklig takt och inte kringgå säkerhetsskydd (som CAPTCHA eller IP-blockeringar) gör att du står stadigare juridiskt.
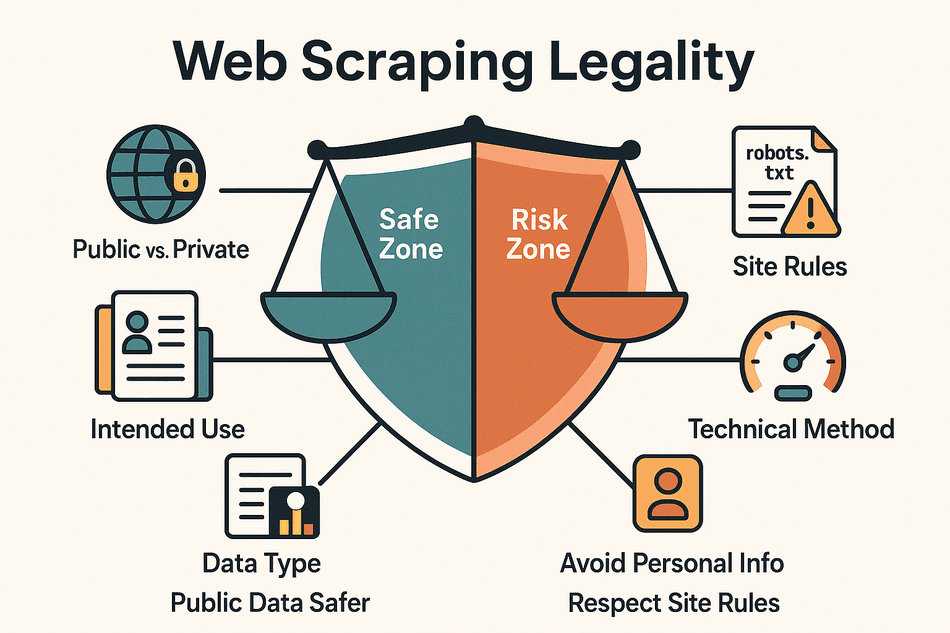
 Kort sagt? Att samla in offentliga, icke-personliga data för internt bruk accepteras brett i många regioner, men det finns viktiga undantag—särskilt när det gäller integritet, upphovsrätt och hur aggressivt du samlar in data (Thunderbit Blog).
Juridiska ramar för datainsamling: En översikt över stora globala regelverk
 Låt oss göra en snabb rundtur bland världens viktigaste juridiska ramverk för web scraping:
USA: CFAA, upphovsrätt och avtal
- Computer Fraud and Abuse Act (CFAA): Den här anti-hackinglagen gör det olagligt att komma åt datasystem ”utan tillstånd”. Men domstolar har klargjort att scraping av offentliga webbplatser inte bryter mot CFAA, eftersom inget särskilt ”tillstånd” krävs (California Lawyers Association).
- Banbrytande fall: I hiQ Labs v. LinkedIn slog Ninth Circuit fast att scraping av offentliga LinkedIn-profiler inte var ett CFAA-brott. Däremot kunde LinkedIn fortfarande stämma för avtalsbrott (brott mot användarvillkoren) eller upphovsrättsintrång.
- Andra risker: Om du skrapar aggressivt (som boten i eBay v. Bidder’s Edge som skickade 100 000 förfrågningar per dag) kan du bli ansvarig för ”trespass to chattels”—i praktiken att du stör någon annans servrar (Wikipedia).
Europeiska unionen: GDPR och databasrättigheter
- GDPR: EU:s dataskyddsförordning gäller även offentliga personuppgifter. Om du samlar in något som kan identifiera en individ behöver du en rättslig grund (till exempel samtycke eller berättigat intresse) och måste följa strikta integritetsregler.
- Databasdirektivet: EU skyddar också databaser som helhet. Att skrapa en ”väsentlig del” av en strukturerad databas (till exempel alla listningar på en bostadssajt) kan bryta mot databasrättigheter—även om de enskilda faktauppgifterna inte är upphovsrättsskyddade (Thunderbit Blog).
Storbritannien: UK GDPR och Data Protection Act
- UK GDPR: Efter Brexit speglar Storbritanniens regler EU:s. Att skrapa offentliga, icke-personliga data är i regel okej, men insamling av personuppgifter är hårt reglerad.
- Computer Misuse Act: Liknar CFAA och kan göra obehörig åtkomst till ett brott.
Kina: PIPL och Data Security Law
- Personal Information Protection Law (PIPL): Kräver samtycke för att samla in personuppgifter. Att skrapa kinesiska webbplatser efter personuppgifter utan tillstånd är ett tydligt nej.
- Data Security Law: Används för att slå ned på scraping som skadar datainnehavare eller skapar osund konkurrens.
Andra regioner
- Kanada, Australien, APAC: De flesta har anti-hackinglagar och integritetsregler som liknar EU:s och Storbritanniens. Kontrollera alltid lokala regler innan du skrapar.
Viktig slutsats: Det säkraste valet är att skrapa offentliga, icke-personliga data för internt bruk och alltid kontrollera reglerna i din region (Thunderbit Blog).
Checklista för efterlevnad: Hur säkerställer du att din datainsamling är laglig?
Innan du börjar skrapa, gå igenom den här checklistan:
- Läs webbplatsens användarvillkor: Om villkoren säger ”ingen scraping”, överväg att avstå eller be om tillstånd först (Thunderbit Blog).
- Håll dig till offentliga data: Skrapa inte innehåll bakom inloggning eller betalvägg om du inte har uttryckligt tillstånd.
- Kontrollera robots.txt: Besök
site.com/robots.txtför att se om botar är förbjudna från vissa delar. Även om det inte är juridiskt bindande är det god sed att respektera det. - Undvik personuppgifter: Samla inte in namn, e-post eller andra personuppgifter om du inte har en rättslig grund och en plan för integritet.
- Kopiera inte kreativt innehåll: Håll dig till fakta och datapunkter. Att publicera artiklar, bilder eller stora delar av innehåll kan leda till upphovsrättsanspråk.
- Använd officiella API:er när de finns: Om sajten erbjuder ett API, använd det—det är säkrare och ofta stabilare.
- Skrapa varsamt: Överbelasta inte servrar. Skrapa i mänsklig takt och undvik att kringgå tekniska skydd.
- Dokumentera processen: Spara information om vad du skrapade, när och varför. Det hjälper om frågor dyker upp senare.
- Var beredd att stoppa: Om du får ett kravbrev, sluta skrapa omedelbart och gör en ny bedömning.
Thunderbits regelmedvetna arbetssätt: Gör datautvinning säkrare och mer tillförlitlig
När vi byggde Thunderbit stod efterlevnad i centrum. Så här hjälper Thunderbit dig att hålla dig på rätt sida av lagen:
- Web scraping i webbläsaren: Thunderbit skrapar bara det du faktiskt kan se i din webbläsare—inga dolda API-anrop, inget hackande runt inloggningar. Om du inte kan se det, kan Thunderbit inte skrapa det (Thunderbit Blog).
- Inbyggda varningar: Om du försöker skrapa en sajt med strikta anti-scraping-regler visar Thunderbit en varning. Det är som att ha en compliance-expert vid din sida.
- Extrahera med ett klick: Thunderbits AI analyserar sidan och föreslår bara relevanta fält—vilket hjälper dig att undvika att oavsiktligt samla in känsliga eller onödiga uppgifter (Thunderbit Blog).
- Mänsklig hastighet: Oavsett om du skrapar lokalt eller i molnet anpassar Thunderbit tempot för att inte belasta servrarna.
- Ingen data lagras på våra servrar: Din insamlade data skickas direkt till dig—Thunderbit sparar ingen kopia, vilket är bra ur integritetsperspektiv.
- Export som passar compliance: Exportera direkt till Google Sheets, Excel, Airtable eller Notion—perfekt för internt bruk.
- Hantering av undersidor och paginering: Thunderbit navigerar på sajter som en riktig användare, klickar sig igenom sidor och undersidor utan att forcera endpoint:er.
- Schemalagd scraping med måtta: Sätt upp schemalagd insamling med rimliga intervall, så att du inte hamrar på en sajt varje minut.
- Stöd för flera språk: Thunderbits gränssnitt finns nu på 55 språk i Chrome Web Store, så compliance-meddelanden och fältförslag förblir lättlästa även för team som inte arbetar på engelska (Chrome Web Store listing).
Kort sagt: Thunderbit bygger in compliance i produkten, så att du leds att skrapa ansvarsfullt—även om du inte är jurist (Thunderbit Blog).
Testa Thunderbit för regelrätt web scraping Installera Thunderbits kostnadsfria Chrome-tillägg och extrahera data från vilken offentlig sida som helst med ett klick. Get Started Free
Datainsamling vs. dataåteranvändning: Var går de juridiska gränserna?
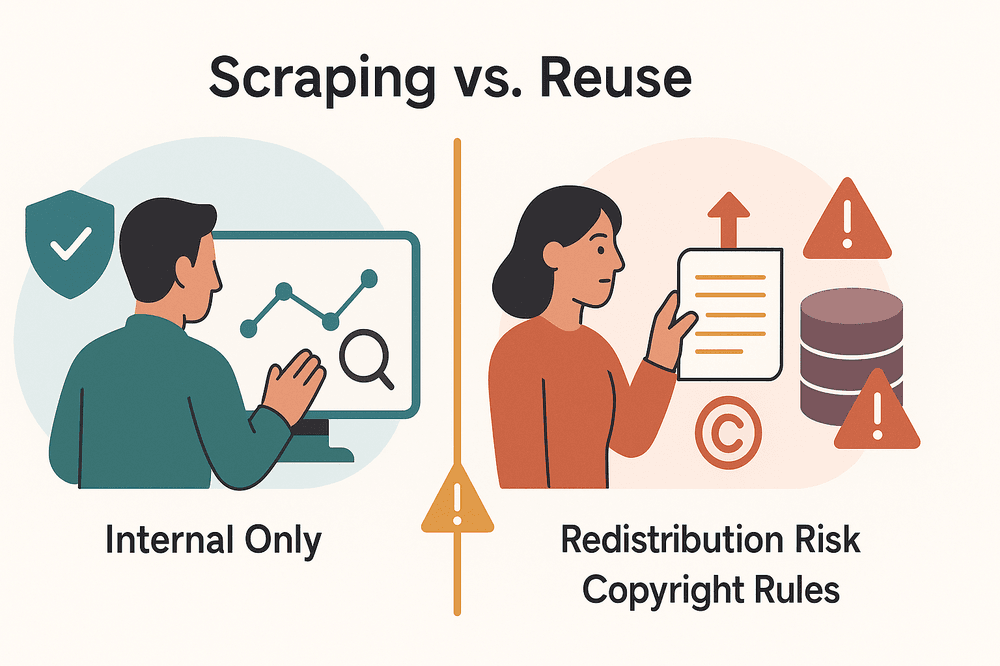 Det är en sak att samla in data för eget internt bruk, och en helt annan att publicera, sälja vidare eller återanvända den på annat sätt. Här blir den juridiska gränsen tydligare:
- Internt bruk: Att samla in offentliga data för intern analys (som säljleads eller prisbevakning) är i regel säkert—förutsatt att du inte samlar in personuppgifter eller bryter mot integritetslagar.
- Vidarepublicering eller försäljning: Att publicera insamlade data igen (på din webbplats, i en produkt eller som försäljning) kan utlösa krav kopplade till upphovsrätt, databasrättigheter eller avtalsbrott.
- Upphovsrätt och databasrättigheter: I USA är fakta inte upphovsrättsskyddade, men urvalet eller strukturen i data kan vara det. I EU/Storbritannien kan scraping av en ”väsentlig del” av en databas bryta mot den särskilda databasrätten.
- Fair use: Amerikansk rätt tillåter i vissa fall ”fair use” (till exempel för kommentarer eller analys), men att bara kopiera och klistra in stora innehållsmängder är nästan aldrig fair use.
- Källhänvisning: Ange alltid dina källor om du använder insamlade data offentligt—men kom ihåg att källangivelse inte gör det lagligt om du bryter mot andra rättigheter.
- Sälj inte rådata: Att sälja oförändrade insamlade dataset är särskilt riskfyllt. Använd insamlad data för att skapa insikter, inte som en produkt i sig.
Proffstips: Använd insamlade data för intern analys och beslutsfattande. Om du behöver dela dem externt, aggregera eller omvandla dem, och kontrollera alltid om du behöver tillstånd (Thunderbit Blog).
Branschcase: Hur du minskar juridiska risker
Låt oss titta på några verkliga fall—för inget lär ut compliance bättre än att se vad andra gjorde fel:
LinkedIn mot hiQ Labs
- Vad hände: hiQ Labs samlade in offentliga LinkedIn-profiler för att bygga analyser kring personalomsättning. LinkedIn försökte stoppa dem, men domstolen slog fast att scraping av offentliga data inte var ett CFAA-brott.
- Lärdom: Att samla in offentliga data är juridiskt försvarbart i USA, men du måste fortfarande hålla koll på användarvillkor och integritetsanspråk (California Lawyers Association).
eBay mot Bidder’s Edge
- Vad hände: Bidder’s Edge skrapade eBays auktionslistor aggressivt (100 000 förfrågningar per dag) och bröt mot eBays villkor och robots.txt. Domstolen utfärdade ett föreläggande för ”trespass to chattels”.
- Lärdom: Även scraping av offentliga data kan vara olagligt om det sker aggressivt eller bryter mot tydliga sajtregler (Wikipedia).
Facebook (Meta) mot Power Ventures
- Vad hände: Power Ventures skrapade Facebook-data med användarnas samtycke, men efter att Facebook drog tillbaka åtkomsten och blockerade deras IP-adresser fortsatte Power Ventures att skrapa. Domstolen slog fast att detta var ”obehörig åtkomst”.
- Lärdom: Om webbplatsägaren säger åt dig att sluta skrapa måste du göra det—annars riskerar du att bryta mot anti-hackinglagar.
Framgångsberättelser inom compliance
Många prisjämförelsesajter i EU verkar lagligt genom att bara skrapa faktabaserade data, respektera opt-out och inte hämta hela databaser. Avsaknaden av rättsprocesser mot dessa företag visar att det fungerar att hålla sig till offentliga, icke-personliga data och följa sajtens regler.
Hur Thunderbit hjälper
Thunderbits inbyggda varningar, hastighetsbegränsningar och webbläsarbaserade arbetssätt skulle ha hjälpt till att förhindra många av dessa juridiska misstag—genom att varna för riskabla sajter och som standard tvinga fram försiktig scraping.
Självchecklista för compliance vid datainsamling i affärssammanhang
Här är en praktisk självrensning inför ditt nästa scraping-projekt:
- Är datan offentlig? (Ingen inloggning krävs)
- Vad säger sajtens villkor? (Finns det anti-scraping-klausuler?)
- Har du kollat robots.txt? (Är din målsektion förbjuden?)
- Samlar du in personuppgifter? (Om ja, har du en integritetsplan?)
- Samlar du in en stor del av sajten? (Undvik att hämta hela databaser)
- Vad är syftet? (Internt bruk = säkrare; offentlig återanvändning = högre risk)
- Skrapar du varsamt? (Mänsklig takt, ingen teknisk kringgång)
- Finns det ett API? (Använd det om det finns)
- Är du redo att sluta om du blir ombedd? (Ha en plan för cease-and-desist)
- Hur ska du lagra och säkra datan? (Begränsa åtkomst, skydda integritet)
- Dokumenterar du processen? (Spara underlag för compliance)
Om du svarar ”nej” eller känner dig osäker på någon punkt, pausa och reda ut det innan du går vidare (Thunderbit Blog).
Exempel på arbetsflöde för regelrätt datainsamling med Thunderbit
 Låt oss gå igenom ett typiskt, compliance-vänligt Thunderbit-flöde:
- Kontroll före scraping: Besök sajtens robots.txt och användarvillkor. Inga anti-scraping-formuleringar? Grönt ljus.
- Öppna Thunderbit: Gå till målsidan och starta Thunderbit Chrome Extension.
- Extrahera med ett klick: Låt Thunderbits AI föreslå relevanta, icke-känsliga fält. Dubbelkolla att inga personuppgifter ingår om du inte har rättslig grund.
- Anpassa fälten: Justera kolumner och datatyper efter behov—samla bara in det du faktiskt behöver.
- Skrapa: Klicka på ”Scrape”. Thunderbit extraherar data i mänsklig takt och följer sajtens struktur.
- Skrapa undersidor: Vid behov kan du använda Thunderbits undersidesfunktion för att berika din data—fortfarande bara för offentliga uppgifter.
- Exportera: Skicka datan direkt till Google Sheets, Excel, Airtable eller Notion för intern analys.
- Schemalägg (valfritt): Sätt upp schemalagda körningar med rimliga intervall—aldrig för tätt.
- Dokumentera: Spara information om vad du skrapade, när och varför.
Thunderbits gränssnitt kommer att uppmana dig i varje steg om det finns compliance-aspekter att tänka på—så du behöver aldrig gissa i blindo.
Läs mer om Thunderbits compliance-funktioner Gratisplanen täcker 6 sidor per månad, inget kreditkort krävs — ett låg-risk sätt att testa extrahering på offentliga sidor. Get Started Free
Slutsats och viktiga rekommendationer: Lås upp datavärde på ett säkert och regelrätt sätt
Web scraping är ett kraftfullt verktyg för tillväxt i affärer—men det är inte vilda västern utan regler. Det juridiska landskapet är komplext, men kärnprinciperna är tydliga:
- Samla i möjligaste mån in offentliga, icke-personliga data för internt bruk.
- Kontrollera alltid sajtens villkor, robots.txt och relevanta lagar innan du börjar.
- Undvik att samla in personuppgifter eller kreativt innehåll om du inte har rättslig grund och en integritetsplan.
- Använd regelvänliga verktyg som Thunderbit för att styra ditt arbetsflöde och minska riskerna.
- Dokumentera processen och var beredd att sluta om du blir ombedd.
Genom att göra compliance till en vana kan du frigöra värdet i webdata—utan juridiskt huvudbry. Och om du vill se hur enkelt regelrätt scraping kan vara, testa Thunderbit. Din juristavdelning (och ditt framtida jag) kommer att tacka dig.
För fler fördjupningar om web scraping, compliance och automatisering, kolla in Thunderbit Blog.
Testa Agentic Web Scraper för regelrätt datautvinning Get Started Free
Vanliga frågor
1. Är det lagligt att samla in data från vilken webbplats som helst?
Inte alltid. Att samla in offentliga, icke-personliga data för internt bruk är i regel lagligt i många regioner, men att skrapa personuppgifter, upphovsrättsskyddat innehåll eller data bakom inloggning kan vara riskabelt eller direkt olagligt. Kontrollera alltid sajtens villkor och lokala lagar innan du skrapar (Thunderbit Blog).
2. Vad är skillnaden mellan att samla in data och att återanvända data?
Att samla in data handlar om att hämta information; återanvändning betyder att publicera, sälja eller på annat sätt distribuera den. Internt bruk är mycket säkrare. Att publicera eller sälja insamlad data kan utlösa krav kopplade till upphovsrätt, databasrättigheter eller avtalsbrott (Thunderbit Blog).
3. Hur hjälper Thunderbit till att säkerställa compliance?
Thunderbit skrapar bara det som är synligt i din webbläsare, varnar för riskabla sajter, föreslår relevanta (icke-känsliga) fält och anpassar hastigheten för att inte överbelasta servrar. Det lagrar inte heller din data, och exportalternativen är byggda för internt bruk (Thunderbit Blog).
4. Vad ska jag göra om jag får ett cease-and-desist-brev?
Sluta skrapa omedelbart och gör en ny bedömning av projektet. Att fortsätta efter en direkt begäran att sluta kan förvandla en juridisk gråzon till ett tydligt brott mot anti-hackinglagar eller avtalsvillkor (Thunderbit Blog).
5. Kan jag samla in personuppgifter om de är offentliga?
Inte utan rättslig grund. Integritetslagar som GDPR och CCPA gäller även offentliga personuppgifter. Du behöver samtycke eller ett starkt berättigat intresse, och du måste hantera uppgifterna ansvarsfullt (Thunderbit Blog).
Denna guide är endast avsedd som information och utgör inte juridisk rådgivning. För komplexa eller högriskprojekt bör du rådfråga en kvalificerad jurist med kunskap om data- och integritetsrätt i din jurisdiktion.
Läs mer




