
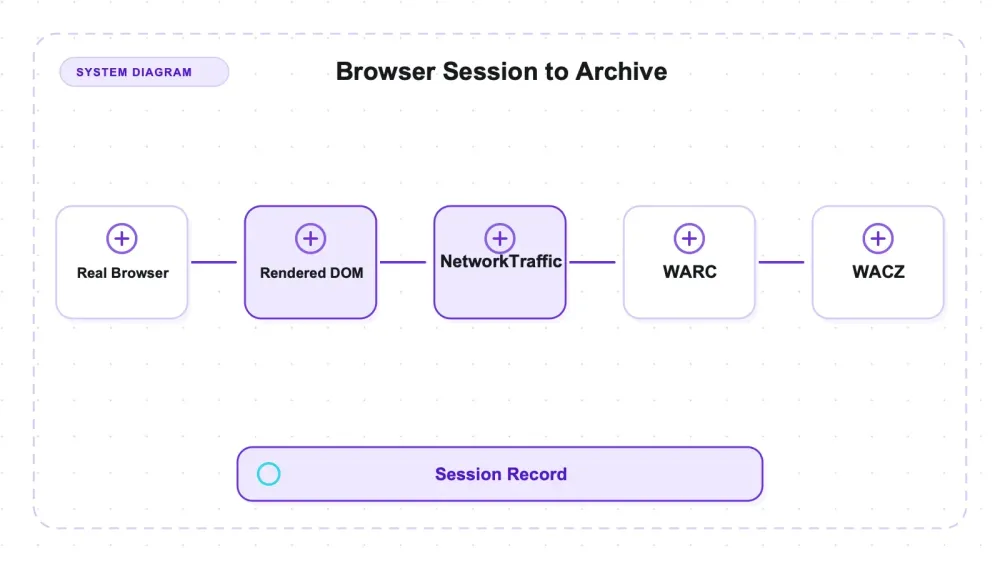
Browsertrix Crawler är Webrecorders arkiveringscrawler: en enda Docker-image som kör en riktig Chromium via Puppeteer, registrerar allt webbläsaren hämtar och skriver det till WARC — standardformatet för webbarkiv — med möjlighet att paketera allt i en WACZ-fil med index, sidlista och loggar. Det är just syftet som skiljer den från de scrapingverktyg den ytligt liknar. En scraper hämtar data och släpper sidan så fort fälten är ute; en arkiverare bevarar själva besöket — byte för byte, rubrikerna, ordningen de kom i — så att sidan kan öppnas igen långt efter att webbplatsen har ändrats eller försvunnit. Webrecorder har förvaltat den delen av webbinfrastrukturen, inklusive format och återspelningsstack, långt innan arkivering ens liknade en produktkategori, och bibliotek, redaktioner och forskare bygger på den.
Jag körde v1.14.0 i Docker mot ett lokalt testunderlag med fyra medvetet olika typer av endpoints, och instrumenterade båda sidor av crawlen: WARC-poster för arkivinnehållet och en serverräknare för faktiska förfrågningar. Den viktiga skillnaden var inte bara statisk kontra dynamisk. Browsertrix fångade en länk som skapades vid körning och en fetch() som sidan själv gjorde, men den begärde inte två URL-litteraler som låg inuti en JavaScript-funktion som aldrig anropades.
Den länkade app.js-filen arkiverades i sin helhet, inklusive båda de litterala sökvägarna, men ingen av endpoints gav någon responsrad, någon förfrågningsrad eller något serveranrop. Funktionen som innehöll dem kördes aldrig. Den här artikeln bedömer därför Browsertrix som en arkiverare av en webbläsarsession, inte som en inventering av varje URL som nämns i källkoden.
Vad Browsertrix Crawler faktiskt är
Många kommer hit och väntar sig en scraper, och går därifrån besvikna. Ingenting i standardflödet ger dig en CSV med produktpriser, och att förvänta sig det är lite som att vänta sig att en dashcam skriver en trafikrapport åt dig. Resultatet är en återspelningsbar logg av en webbläsarsession, och varje designbeslut längre ned i kedjan utgår från det.
Jag testade v1.14.0 den 27 juli 2026: webrecorder/browsertrix-crawler:latest med digest sha256:9d6800a8…, och crawl --version bekräftade bygget. Projektet är AGPL-3.0. Alla mätningar kördes i Docker via Colima på macOS arm64 mot det kontrollerade lokala testunderlaget; serverräknaren gav bevis som var oberoende av Browsertrix-loggar och arkivparsning.
AGPL-3.0 förtjänar en egen kommentar. Stark copyleft med villkor för nätverksanvändning. Om Browsertrix Crawler ska ingå i en kommersiell produkt i stället för att köras som ett fristående verktyg, låt någon läsa licensen ordentligt innan ni släpper den. Det är en markering, inte juridisk rådgivning.
Arkivet bevarar sessionen, inte källkoden
Mitt testunderlag serverade fyra typer av endpoints, medvetet åtskilda eftersom en arkiverare behandlar dem helt olika:
- Klass A — vanlig
<a href>i HTML. Fyra sidor plus en kedja med tre nivåer. Varje crawler i världen hittar dessa. - Klass B — URL-litteraler i en funktion som aldrig körs. Två sökvägar,
/api/js-endpoint-7och/api/js-endpoint-8, som strängar inne i en oanropadloadData()i en länkadapp.js. - Klass C — en länk som byggs vid körning. En
<a href>som sätts ihop av fragment i JavaScript ('endpoint' + (6 * 7)) och läggs till i DOM:en. Den sammanhängande sökvägen/runtime-only/endpoint42finns inte i någon serverad byte. - Klass D — en
fetch()som sidan faktiskt skickar. Sökväg ihopbyggd på samma sätt ('runtime-xhr-' + (33 * 3)), och sedan verkligen efterfrågad vid laddning.
För klass C och D saknades de fullständiga sökvägarna som sammanhängande strängar i de serverade filerna. Deras serveranrop och responsrader är därför bevis för att den här testmiljön verkligen exponerade både körning vid runtime och request-flöden.
Vad som fångades — och vad som inte gjorde det
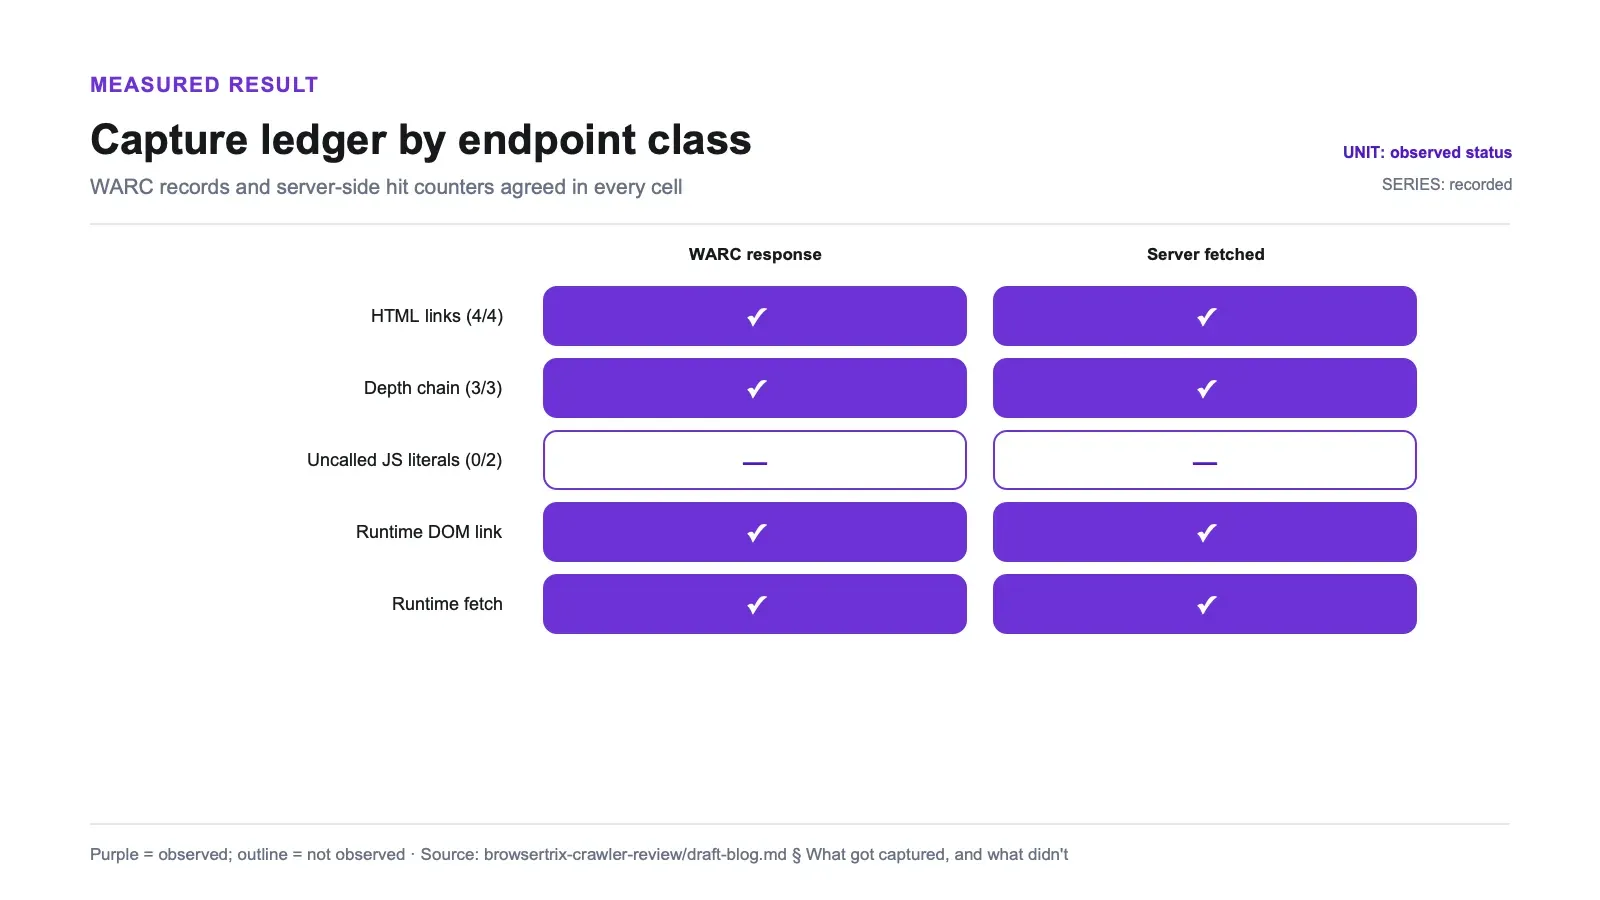
Två instrument, kontrollerade mot varandra i varje ruta: WARC-responsrader (det som finns i arkivet) och testunderlagets serverräknare per (Host header, path) (det som faktiskt begärdes). De stämde överallt.
| Endpoint-klass | Responsrad i WARC | Faktiskt hämtad (server-side) | Bedömning |
|---|---|---|---|
A — HTML <a href> | 4/4 | 4/4 | fångad |
| A — djupkedja (3 nivåer) | 3/3 | 3/3 | fångad |
| B — URL-litteral i oanropad JS | 0/2 | 0/2 | inte fångad |
| C — länk injicerad vid runtime | ja | ja | fångad |
D — runtime-fetch() | ja | ja | fångad |
Klass C är den som skiljer en riktig webbläsare från en statisk crawl. Standardextraktionen av länkar läser den renderade DOM:en (a[href]->href, enligt dokumentationen för vanliga alternativ), så en länk som bara finns efter att JavaScript körts blir ändå köad, hämtad och arkiverad. Klass D fångas av en annan orsak — sidan skickade själv förfrågan, och arkiveraren stod på nätverksvägen och loggade allt som passerade.
En ärlig avgränsning för klass C: min länk injicerades synkront vid sidladdning. Länkar som dyker upp senare, under Browsertrix-behaviors, är en separat fråga, och det finns ett öppet ärende just för det — #723, "Links on pages that are discovered during behaviors are not extracted". Jag testade inte det scenariot, så jag påstår inget om det åt något håll.
Filen arkiverades. Endpoints gjorde det inte.
Att bekräfta missarna i klass B krävde en rad-för-rad-genomgång av WARC-filen, inte bara en sammanfattning.
app.js finns i arkivet — en responsrad, en JavaScript-body på 222 byte — och båda klass-B-litteralerna förekommer ordagrant där. Samtidigt är varken /api/js-endpoint-7 eller /api/js-endpoint-8 mål-URI i en enda rad i hela filen: noll responsrader, noll förfrågningsrader. Varje litteralsträng förekommer exakt en gång i hela arkivet, och båda gångerna inne i den lagrade body:n för app.js.
Det utesluter den enkla förklaringen (att app.js aldrig hämtades). Arkiveraren sparade filen som nämner dessa endpoints men skickade aldrig någon förfrågan för dem, eftersom loadData() aldrig anropades. Browsertrix standardbeteenden var aktiva — autoplay, autofetch, autoscroll, siteSpecific — och autofetch räddade dem inte heller, vilket blir logiskt när man läser vad autofetch gör: den letar upp img-srcset, stylesheets och data-*-URL:er, inte stränglitteraler som ligger gömda i funktionskroppar.
Som en jämförelse i samma testunderlag körde jag också Katana v1.6.1 som katana -u <seed> -jc -silent -nc -d 4. Dess råa discovery summary visar motsatt resultat för de två medvetet konstruerade JavaScript-klasserna:
| Det du vill hitta | Browsertrix v1.14.0 | Katana v1.6.1, standard -jc |
|---|---|---|
| Länkar i serverad HTML | hittade | hittade |
| Länk injicerad i DOM vid runtime | hittade (renderad DOM-extraktion) | missade utan headless-läge |
fetch() som sidan faktiskt gör | hittade (loggad som trafik) | missade — inget körs |
| URL-litteral i JS som aldrig körs | missade (0/2) | hittade (2/2 på samma testunderlag) |
| JS-filen som innehåller litteralen | arkiverad i sin helhet | parsad, men inte bevarad |
Båda kommandona använde samma testunderlag och samma endpointnamn. Tabellen är inte en generell ranking av browser- och statiska crawlers; den visar varför inventering av endpoints och bevarande av sessioner kräver olika täckningstester.
"Riktig webbläsare, alltså fångar den allt JavaScript gör" är en formulering man ofta ser upprepad. Den är överdriven. Den fångar exekverad trafik. Kod som nämner en URL utan att någonsin anropa den skapar ingen trafik, och ingen trafik betyder ingen post.
Replay-body finns där, med en sak jag inte kontrollerade
För de två runtime-skapade endpoints hämtade jag ut de arkiverade HTTP-responsbodys ur WARC och bekräftade att de innehåller den serverade JSON:en: 206 byte för den runtime-injicerade länkens mål, 201 byte för runtime-fetch()-målet. Så det är inte bara indexstubbar som pekar på ingenting — själva innehållet ligger i arkivet, vilket är förutsättningen för att en replay ska kunna leverera det.
Det jag inte gjorde var att starta pywb eller replayweb.page och rendera arkivet. Body i arkivet och korrekt återgiven replay är två olika påståenden, och det här testet täcker bara det första. Replaybeteende, autenticitet, kedja av bevis, och om materialet kan användas som bevis kräver separat verifiering.
En produktionsinsamling behöver ett bredare acceptanstest
Testunderlaget svarar tydligt på en snäv fråga: blev en synkron runtime-länk och en sidinitierad request nätverkstrafik och arkivposter? En produktionsarkivering brukar kunna misslyckas på flera andra sätt och ändå ge en giltig WACZ.
Börja med replay. Öppna paketet i det återspelningssystem som samlingen faktiskt ska använda och jämför ett fast urval sidor med referensen från insamlingstillfället. Kontrollera renderad text, bilder, stilar, navigering och alla interaktioner som spelar roll för arkivet. Granska sedan replay-webbläsarens nätverkspanel efter saknade subresurser. En responsbody kan finnas i WARC samtidigt som replay ändå misslyckas därför att omskrivningar, index, timing, ursprung eller beroenden inte linjerar. Den här recensionen gick inte över den gränsen.
Dynamiskt beteende behöver sin egen uppsättning testfall. Klass-C-länken här dök upp synkront vid sidladdning. Verkliga applikationer kan visa innehåll efter timers, scrollning, samtyckesdialoger, route-byten, custom elements eller långa API-kedjor. Lägg ett känt mål bakom varje beteende du är beroende av och verifiera både serveranropet och den arkiverade bodyn. Browsertrix standardbeteenden är användbara indata för det testet, inte bevis för att varje fördröjt tillstånd nåddes. Ärende #723 är särskilt relevant om länkar visas under behaviors snarare än under den inledande sidexekveringen.
Autentiserade insamlingar lägger till sessionsfrågor. Kontrollera att inloggningsläget hamnar i webbläsarprofilen, överlever de nödvändiga navigeringarna och inte läcker in i samlingar som ska vara isolerade. Testa tokenförnyelse och utloggningsflöden. Om arkivet innehåller privat eller personligt material ska åtkomstkontroller och retention för de resulterande filerna testas som en del av samma acceptansplan. En tekniskt korrekt insamling kan fortfarande hanteras fel efteråt.
Service workers, streaming media, WebSockets, nedladdningar, cross-origin-frames och signerade URL:er förtjänar var sin representativa sida om de är relevanta för målet. Det elva sidor stora testunderlaget säger inget om dem. Det säger inte heller hur crawlen beter sig när en sida förblir aktiv i flera minuter, skickar förfrågningar efter det vanliga lugntidsfönstret eller kräver användargester. Undvik att göra ”riktig Chromium” till ett svepande täckningspåstående; definiera vilka webbläsarbeteenden samlingen måste bevara och gör var och en observerbar.
Sist, behåll det underlag som behövs för att felsöka missar. Spara exakt image-digest och kommando, Browsertrix-loggar, sidlistor, index, kontrollsummor för WARC/WACZ, serverbevis för förfrågningar där det finns, och ett litet manifest med verklighetsfacit. För upprepade körningar, notera tid, konfiguration och miljö tillsammans med artefakten. De uppgifterna skapar inte juridisk bevisbarhet, men de gör ett tekniskt påstående reproducerbart och visar om en senare skillnad kom från målet, crawlen eller replay-stacken.
Vad det här lilla testunderlaget kostade i byte
Det här testunderlaget serverar bara några hundra byte per sida, så dess overheadkvoter bör inte överföras till sajter med många tillgångar. Inom den smala ramen mätte jag arkivets sammansättning, inte bara dess slutstorlek:
| WARC-posttyp | Antal | Innehållsbyte | Andel |
|---|---|---|---|
request | 14 | 6,912 | 40.6% |
response (den faktiska sidnyttolasten) | 13 | 5,339 | 31.4% |
resource (urn:pageinfo:-JSON, en per sida) | 11 | 4,527 | 26.6% |
revisit (deduplicerad död länk) | 1 | 154 | 0.9% |
warcinfo | 1 | 92 | 0.5% |
| Totalt postinnehåll | 40 | 17,024 | 100% |
Antal och byte per typ finns i den publika
capture-summary.json; andelar använder 17 024 byte totalt postinnehåll som nämnare.
I den här lilla körningen vägde request-posterna tyngre än responsinnehållet, och request plus urn:pageinfo:-byte var ungefär 2,1× responsnyttolasten. Det beskriver just det här testunderlagets postmix, inte någon generell WARC-kvot.
På disk, över tre isolerade körningar:
| Metrik | min | median | max |
|---|---|---|---|
| Crawl-tid i väggklocka (s) | 28.22 | 29.75 | 30.27 |
| WARC.gz byte | 24,174 | 24,250 | 24,262 |
| WACZ byte | 53,446 | 53,523 | 53,533 |
| Fångad responsnyttolast (byte) | 5,339 | 5,339 | 5,339 |
Med medianerna blir fyra relationer tydliga:
| Härledd måttstock (medianer) | Värde |
|---|---|
| Komprimerad WARC jämfört med fångad responsnyttolast | 4.5× |
| WACZ jämfört med fångad responsnyttolast | 10× |
| WARC per sida | ~2.2 KB |
| WACZ per sida | ~4.9 KB |
Och inne i själva WACZ-filen:
| WACZ-komponent | Andel av paketet |
|---|---|
| WARC | 45% |
| CDX-index | 16% |
| Crawl-logg | 30% |
Den sista raden var den som överraskade mig. Nästan en tredjedel av arkivpaketet, i en liten crawl, är alltså själva loggen över crawlen snarare än webbinnehållet.
Mätningen var stabil: responsnyttolasten var byte-identisk över alla tre körningar (5 339 B varje gång), medan WARC.gz och WACZ varierade under 0,4 %.
Kvoterna går inte att överföra till riktiga sidor med bilder, typsnitt och stora scriptpaket. Den strukturella poängen består: request- och page-info-poster skapar overhead oberoende av nyttolastens storlek. Mät ett representativt urval innan du planerar produktionslagring; multiplicera inte 10×-kvoten från testunderlaget med en uppskattning av hela korpuset.
Installation och det diskutrymme du bör planera för
När Docker eller Colima väl är installerat och kör, är Browsertrix-delen enkel: docker pull webrecorder/browsertrix-crawler:latest, sedan docker run … crawl --url … --generateWACZ. Image:n innehåller Chromium, så någon separat webbläsare eller Python-miljö behövdes inte.
Vad bekvämligheten kostar, i de körningar som mättes här:
| Vad du budgeterar för | Uppmätt |
|---|---|
| Nedladdad image | ~1 GB |
| Image uppackad på disk | 3.51 GB |
crawls/-trädet (WARC:er, WACZ:er, webbläsarprofildata) efter ett antal 11-sidorskörningar på ett testunderlag som serverar några kilobyte innehåll | ~116 MB |
| Väggklocka, crawl med 11 sidor | 28–30 s |
Containern är där friktionen bor, och linjen för nedladdning och uppackning är vad det kostar att paketera med en webbläsare. Jag körde den med --shm-size 1g, och eftersom mitt testunderlag låg på värden medan crawlen kördes i containern behövde jag --add-host=host.docker.internal:host-gateway samt att testunderlaget band till 0.0.0.0 i stället för loopback. Om du crawlar det publika internet slipper du den nätverksdetaljen helt, men om du arkiverar något på din egen maskin eller på en intern staging-host får du räkna med en eftermiddag för det.
Mappen för utdata är den rad som lättast underskattas. Extrapolera den tillväxten till en riktig crawl och planera lagring innan du börjar, inte efter att disken fyllts klockan tre på natten.
Browserstart bidrar sannolikt märkbart till en crawl på 28–30 sekunder av bara elva sidor, men jag isolerade inte starttid från navigering eller paketeringstid. Ingen slutsats om per-sidgenomströmning följer av den här körningen.
Planera lagring utan att missbruka testunderlagets kvoter
Det användbara sättet att dimensionera en samling är empiriskt. Välj sidor som representerar målets faktiska fördelning: tunna applikationsskal, bildtunga landningssidor, dokumentnedladdningar, långa artiklar och autentiserade vyer om de ingår. Fånga varje klass med de tänkta beteendena och paketeringsinställningarna. Mät responsnyttolast, WARC, WACZ, index, loggar, browserprofilrester och eventuella temporära arbetsytor som finns kvar under en körning. Toppförbrukning på disk är lika viktig som slutpaketet om paketeringen tillfälligt behåller flera kopior.
Separera fasta och variabla komponenter. Container-imagen på 3,51 GB är distributionsöverhead som kan delas av många insamlingar på en worker. Request-poster, page-info-poster, index och sidlistor växer med crawlaktiviteten. Responsbodys beror starkt på målet, medan loggar beror på körlängd och verbosity. Retention och replikering multiplicerar sedan hela samlingen oberoende av crawl-beteendet. En kapacitetsmodell som klumpar ihop allt till “byte per sida” blir skör.
Komprimering och deduplicering behöver också representativt innehåll. Testunderlagets responsnyttolast var byte-identisk över tre körningar, men det beskriver inte sidor med ändrade annonser, tidsstämplar, personliga svar eller cache-bustande asset-URL:er. Om upprepade insamlingar ingår i programmet, mät efterföljande insamlingar av samma sidor och granska revisit-poster i stället för att anta att oförändrade sidor dedupliceras väl. Testa också om loggar och index behålls på samma replikeringsnivå som bevarandepaketet.
Operativt bör varningsgränser sättas innan samlingen startar. Övervaka ledigt utrymme, tillväxt per samling, misslyckad paketering och storleken på webbläsarprofiler eller temporära kataloger. Kör en återställningsövning från den lagrade WACZ-filen, inte bara en kontroll av checksumma. Kvoterna ovan är användbara eftersom de visar vilka komponenter som finns; det representativa urvalet visar hur stora de blir för just din webbplats.
Dokumentera dessa antaganden bredvid kapacitetsuppskattningen och gå igenom dem igen efter pilotcrawlen.
Disciplin för avgränsning, testad med två kontroller
Arkiveringscrawlers som driver iväg är en verklig driftsrisk — du kan få ett juridiskt problem och en lagringsnota samtidigt. Min startsida länkade till http://outofscope.test:<port>/page/out, ett annat värdnamn som pekade på samma testunderlag, så ett anrop med den Host-headern skulle bevisa en hämtning utanför scope utan någon verklig internettrafik.
| Konfiguration | Hämtades host utanför scope? | Server-side-anrop |
|---|---|---|
--scopeType prefix (standard) | nej | 0 |
--scopeType any | ja | 2 |
Den andra raden är det som gör den första meningsfull. Med any nåddes länken två gånger, alltså var den nåbar — nollan under standard-scope med prefix är verklig disciplin, inte en länk som crawlen råkade missa. Det finns en öppen rapport om out-of-scope-besök i andra konfigurationer, #788, som jag inte reproducerade under standard prefix-scope på det här testunderlaget. Bra att känna till att den finns; inte bra att jag påstår att jag såg den.
Robustheten var okomplicerad på det goda sättet. En route som returnerade HTTP 500 och en död länk begärdes båda, crawlen avslutades rent med giltig WARC och WACZ, och den döda länken sparades som en deduplicerad revisit-post i stället för att något gick sönder.
För- och nackdelar
Fördelar
- Fångar runtime-injicerade DOM-länkar och sidinitierade
fetch()-anrop — båda bekräftade både i arkivet och på serversidan, på sökvägar som inte finns som litteraler någonstans. - Statisk HTML och djuptraversering är kompletta: 4/4 länkar, 3/3 i djupkedjan, inga missar.
- När Docker/Colima väl körde gav ett enda
docker runen WARC och WACZ; Chromium följde med i imagen. - Standard-scope med
prefixhöll med noll out-of-scope-anrop;anybreddade som dokumenterat, så reglaget gör vad det säger. - Resultatet är ett standardsbaserat arkiv (WARC, paketerat som WACZ med CDX-index och sidlista) snarare än ett proprietärt blob-format.
- Nästan deterministiska arkiv: nyttolasten identisk byte för byte över tre körningar, och storleken på disk varierade under 0,4 %.
- Ren felhantering: en 500-route och en trasig länk avbröt inte crawlen.
Nackdelar
- URL-litteraler i JavaScript som aldrig exekveras upptäcks helt enkelt inte (0/2), även när filen som innehåller dem arkiveras. Korrekt enligt design, men ändå en verklig täckningslucka om endpointinventering är målet.
- Tung fotavtryck: ~1 GB nedladdning, 3,51 GB på disk och utmatningskataloger som växer snabbt.
- Byteöverheaden är betydande på små sidor — request plus pageinfo-poster översteg faktiskt innehållet, och ungefär 30 % av WACZ var crawl-loggen.
- AGPL-3.0 innebär riktigt licensarbete om den ska bäddas in kommersiellt.
- Inte ett verktyg för strukturerad data. Det finns inget schema, ingen fältmappning, inga snygga rader i slutet.
- Genomströmningen per sida är medvetet måttlig, eftersom varje sida går igenom en riktig webbläsare.
Vem bör köra den — och vem bör låta bli
Browsertrix är till för team vars nödvändiga artefakt är ett arkiv av resurser som hämtats av en webbläsare, inte extraherade rader. I det här testunderlaget fanns runtime-hämtade responsbodys i WARC och de paketerades till WACZ. Bibliotek, redaktioner och forskare är rimliga användare, men produktionsinförande bör separat testa renderad replay, autentisering, service workers, samtyckesflöden, fördröjt beteende, streamingresurser, retentionkontroller och alla krav kring bevishantering.
Skippa det om det du faktiskt behöver är data. Om målet är ”ge mig alla produkter och priser från dessa 400 sidor i ett kalkylblad”, är en arkiverare en märklig väg till det resultatet — du skulle arkivera gigabyte och ändå behöva skriva extraheringskod mot WARC-filer. Skippa det också om du kartlägger ett programs API-yta, eftersom klass-B-resultatet tydligt visar att en statisk JavaScript-parser hittar endpoints som Browsertrix aldrig rör. Och om du ogillar Docker eller jobbar någonstans där en 3,5 GB image är ett problem, är det här inte verktyget som kommer anpassa sig efter dig.
Auktorisation och retention
Scope-kontroller ger inte auktorisation. Definiera tillåtna hosts, retention och arkivåtkomst innan crawlen körs, särskilt när permanenta insamlingar kan innehålla personuppgifter. Testet med prefix/any visar att konfiguration ändrar nätverksräckvidd; det säger inte vilken räckvidd som är laglig för en viss samling.
Relaterad granskning: juridiska aspekter av web scraping och arkivering.
Alternativ utifrån vilket resultat du behöver
Välj efter artefakt. Browsertrix siktar på bevarande i WARC/WACZ. Ett webbläsarautomationsbibliotek som Playwright ger dig en programmerbar sida men lämnar paketeringen av fångsten åt dig. Crawlers för endpointupptäckt inventerar URL:er, medan extraktionsverktyg returnerar text eller strukturerade poster. De här kategorierna kan dela webbläsare och ändå lösa olika uppgifter.
Relaterad granskning: Heritrix-recension.
Upplysning: Thunderbit är utgivarens produkt och testades inte i det här Browsertrix-underlaget. Det hör till kategorin hanterad extraktion och producerar sidtext eller strukturerad data snarare än ett standardsbaserat arkiv. Den här recensionen stödjer bara gränsen för utdata, inte något jämförande påstående om prestanda eller kapacitet.
Prova Thunderbit för webbdataextraktion
Slutsats
Använd Browsertrix Crawler när det du behöver är en WARC/WACZ-insamling och en containeriserad Chromium passar din miljö. I det här testunderlaget stämde arkivposter och serveranrop för synkrona runtime-DOM-länkar och sidinitierade fetches, standard-scope med prefix stängde ute den andra hosten, och felrutter hindrade inte ett giltigt arkiv.
Innan produktionsanvändning bör du validera replay, fördröjt beteende, autentiserade sessioner, service workers, lagringssammansättning på representativa sidor och licenskrav. Den testade gränsen är smalare: kodreferenser som aldrig exekveras gav varken någon förfrågan eller någon arkivpost för sina mål, även om det innehållande skriptet bevarades.
Prova Thunderbit för webbdataextraktion Get Started Free
Vanliga frågor
Vad är skillnaden mellan WARC och WACZ här? WARC innehåller de fångade request-, response- och relaterade posterna. WACZ paketerar WARC tillsammans med index, sidlistor, metadata och loggar för distribution och återspelningsverktyg. Den här recensionen granskade båda paketen men renderade ingen replay.
Hur bör jag uppskatta lagring? Mät representativa sidor och behåll hela WACZ-sammansättningen, inklusive loggar och index, i urvalet. Kvoterna i den här artikeln kommer från ovanligt små responsbodys och ska inte multipliceras med ett produktionsantal URL:er.
Kommer den att vandra iväg från sajten jag pekade den mot?
Inte med standardinställningen, i min testning. Med --scopeType prefix hämtades en länk till ett annat värdnamn noll gånger; när jag bytte till --scopeType any hämtades den två gånger, vilket bevisar att länken var nåbar och att standardens noll var verklig scope-disciplin. Det finns en öppen upstream-rapport om out-of-scope-besök i andra konfigurationer som jag inte reproducerade under standardläget, så kontrollera dina egna scope-inställningar i stället för att anta.
Vad måste jag testa innan jag påstår replay-trohet? Ladda WACZ-filen i det tänkta återspelningssystemet och jämför renderade sidor, interaktioner och nödvändiga subresurser med den levande eller referensinsamlade versionen. Att body finns i WARC är nödvändigt, men det bevisar inte den renderade replayen i sig.
Gör Browsertrix en arkiverad sida till strukturerade rader? Nej. Utdata är ett arkivpaket, inte en tabell med utvalda fält. Om leveransen ska vara produkter, priser, kontakter eller ett annat schema behöver du fortfarande ett extraktionssteg efter insamlingen — eller ett annat verktyg vars primära utdata är strukturerad data.




