
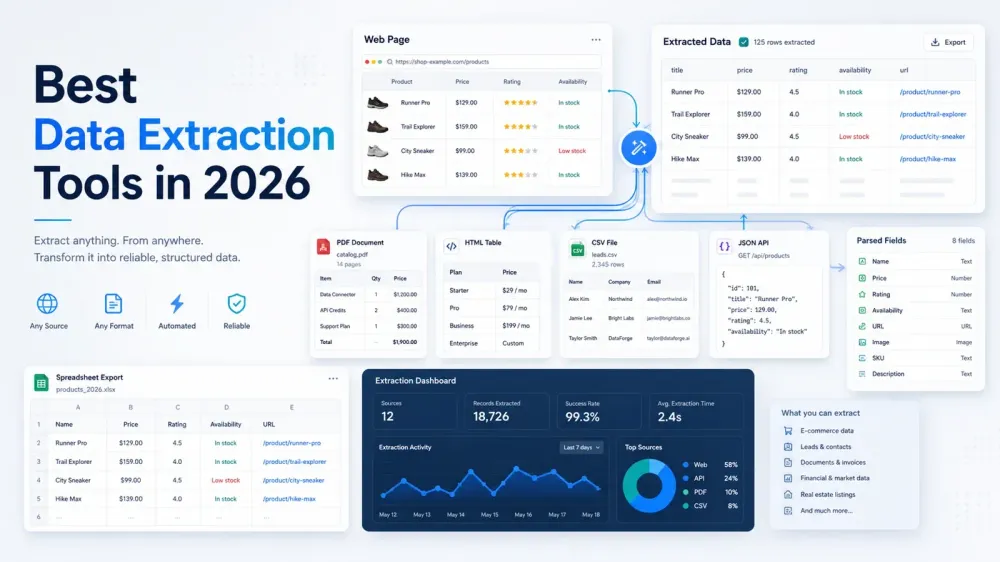
Programvara för dataextraktion 2026 är inte längre bara en enda kategori med en enda typ av köpare. Vissa team behöver ett webbläsarbaserat verktyg som kan förvandla webbplatser till kalkylblad på bara några minuter. Andra behöver crawl-API:er, proxyinfrastruktur eller en styrd pipeline som matar ett datalager. Att slå ihop alla de här behoven i en och samma ranking utan sammanhang är ett säkert sätt för köpare att slösa tid och köpa mer än de faktiskt behöver.
Den här uppdaterade årliga översikten är byggd för att göra en sak riktigt bra: hjälpa dig att snabbt skapa en shortlist. De 15 verktygen nedan täcker fortfarande de flesta verkliga inköpsvägar på marknaden, men de löser väldigt olika problem. Om du behöver snabb extraktion av webbdata med minimal konfiguration ska din shortlist se helt annorlunda ut än för ett team som köper ELT och governance.
Granskningsnotering: Denna årliga översikt granskades den 7 maj 2026. Nästa ansvariga för granskning: Thunderbit redaktionsteam.
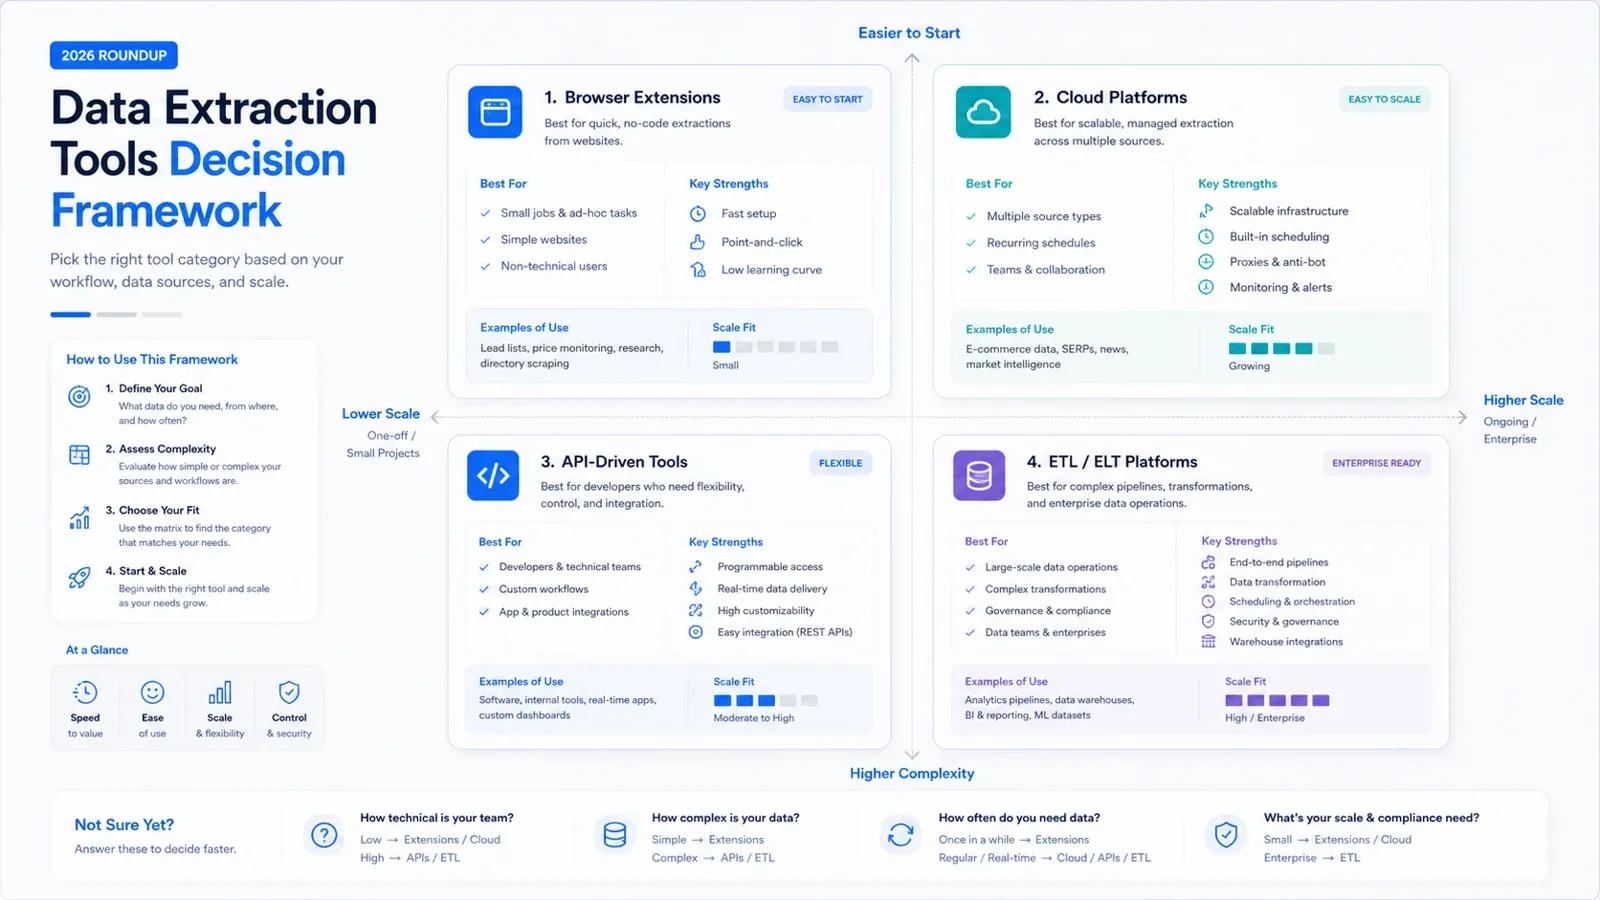
Börja med rätt verktygstyp
Innan du jämför leverantörer, bestäm vilket jobb du faktiskt försöker lösa:
- Behöver du webbdata i ett kalkylblad snabbt, utan att äga scraping-infrastruktur: börja med AI-baserade eller no-code-verktyg i webbläsaren, som Thunderbit, Octoparse, Data Miner eller Browse AI.
- Behöver du renderade sidor, API-leverans eller anti-bot-infrastruktur för produktteam: titta på ScrapingBee, Diffbot, Bright Data eller Captain Data.
- Behöver du samla data från SaaS-appar, API:er och databaser till ett datalager: fokusera på Airbyte, Hevo, Fivetran, Talend, Matillion eller Integrate.io.
Se om Thunderbit passar ditt arbetsflöde
Snabb jämförelsetabell: Bästa verktygen för dataextraktion 2026
| Verktyg | Bäst för | Det som utmärker sig | Prismodell |
|---|---|---|---|
| Thunderbit | Affärsanvändare som snabbt vill ha webbdata | AI-baserade fältförslag, undersidor, paginering, export till kalkylblad | Gratis nivå; betald prenumeration + krediter |
| Diffbot | Team som bygger strukturerade webbdataprodukter | Extraktions-API, Crawlbot, Knowledge Graph | Gratis nivå; betalda API-krediter; företagsanpassat |
| Captain Data | Tillväxt- och operations-team som automatiserar outbound-flöden | No-code flerstegsarbetsflöden över webbplatser och SaaS-verktyg | Användningsbaserad / säljledd |
| ScrapingBee | Utvecklare som skrapar JS-tunga sidor | Headless-rendering, proxyrotation, enkel API-leverans | Gratis provperiod; betalda API-planer |
| Octoparse | Analytiker som vill ha visuell scraping plus molnkörningar | Point-and-click-byggare, mallar, schemalagda molnjobb | Gratis nivå; betalda planer |
| Data Miner | Webbläsaranvändare som extraherar listor och tabeller vid behov | Webbläsarextraktion baserad på recept med snabb export | Gratis nivå; betalda planer |
| Browse AI | Team som bryr sig om övervakning och ändringsaviseringar | Tränade robotar, schemalagd övervakning, leverans till Sheets/Zapier | Gratis nivå; betalda planer |
| Bardeen | Användare som kombinerar scraping med automatisering av webbläsarflöden | AI-playbooks, webbläsarautomatiseringar, appintegrationer | Gratis nivå; betalda planer |
| Bright Data | Datainsamling i företagsklass och stor skala | Proxy-nätverk, unblocker, datasets, scraping-plattform | Användningsbaserad / avtal |
| Airbyte | Ingenjörsteam som bygger warehouse-pipelines | Öppna connectors, självhanterat alternativ, fokus på datalager | Gratis självhanterad; moln- och enterprise-nivåer |
| Talend / Qlik Talend Cloud | Företag som behöver integrationslösningar med stark governance | Integration, datakvalitet, governance, enterprise-kontroller | Offertbaserad prenumeration |
| Matillion | Molnbaserade datateam som arbetar i moderna datalager | Molnbaserad ELT och transformation i datalagret | Förbrukningsbaserad |
| Integrate.io | Medelstora team som vill ha hanterade pipelines | Hanterade integrationer mellan SaaS och databaser | Säljledd prenumeration |
| Hevo Data | Team som vill ha nästan realtidsstyrd synk med minimalt arbete | Hanterade connectors, fokus på realtid, låg konfigurationsinsats | Gratis nivå; betalda planer |
| Fivetran | Team som prioriterar driftsäkerhet framför anpassning | Hanterade connectors, schemahantering, enkel drift | Gratis plan; användningsbaserad MAR-prissättning |
Vad som har förändrats 2026
Tre skiften spelar större roll nu än generiska snackpunkter om ”automation”:
- AI-först extraktion är mainstream. Köpare förväntar sig allt oftare att ett verktyg kan tolka fält, hantera enklare variationer mellan sidor och exportera rena tabeller utan att man behöver sätta upp selektorer.
- Infrastruktur har skilts från arbetsflödesverktyg. Vissa produkter är bäst att köpa som API:er eller proxy-lager, medan andra passar bättre som kompletta arbetsflöden för affärsanvändare.
- Årliga köpare granskar underhållskostnaden hårdare. Ett verktyg som ser billigare ut på pappret kan ändå vara sämre om teamet måste vaka över selektorer, synkar till datalager eller anti-bot-workarounds varje vecka.
Därför håller den här sidan shortlistan uppdelad efter driftsmodell i stället för att låtsas att alla verktyg konkurrerar direkt med varandra.
Bästa AI- och no-code-verktygen för dataextraktion
1. Thunderbit
Thunderbit är fortfarande det starkaste valet för icke-tekniska team som snabbt vill få webbdata i en strukturerad tabell. Dess största styrka är inte bara att det är no-code, utan att produkten är byggd för att minska friktionen i uppstarten. Du öppnar en sida, låter AI föreslå fält, justerar tabellen vid behov och exporterar.
- Bäst för: säljops, e-handel, rekrytering, research och alla som går från webbsida till kalkylblad.
- Det som utmärker sig: AI-baserade fältförslag, skrapning av undersidor, hantering av paginering, export till Sheets / Excel / Airtable / Notion.
- Pris: gratis nivå finns; betalda planer skalar genom abonnemang och kreditanvändning.
Testa Thunderbit AI Web Scraper gratis
2. Octoparse
Octoparse är fortfarande en av de mest etablerade no-code-produkterna för scraping för team som vill ha en tydlig visuell arbetsflödesbyggare. Den kräver mer konfiguration än Thunderbit, men kompromissen är bättre kontroll för användare som vill modellera arbetsflödet.
- Bäst för: analytiker, forskare och operations-team som skrapar återkommande dataset i medelstor skala.
- Det som utmärker sig: visuell task-design, molnschemaläggning, uppgiftsmallar, stöd för inloggning och dynamiska sidor.
- Pris: gratis nivå plus betalda planer för molnkapacitet och teamfunktioner.
3. Data Miner
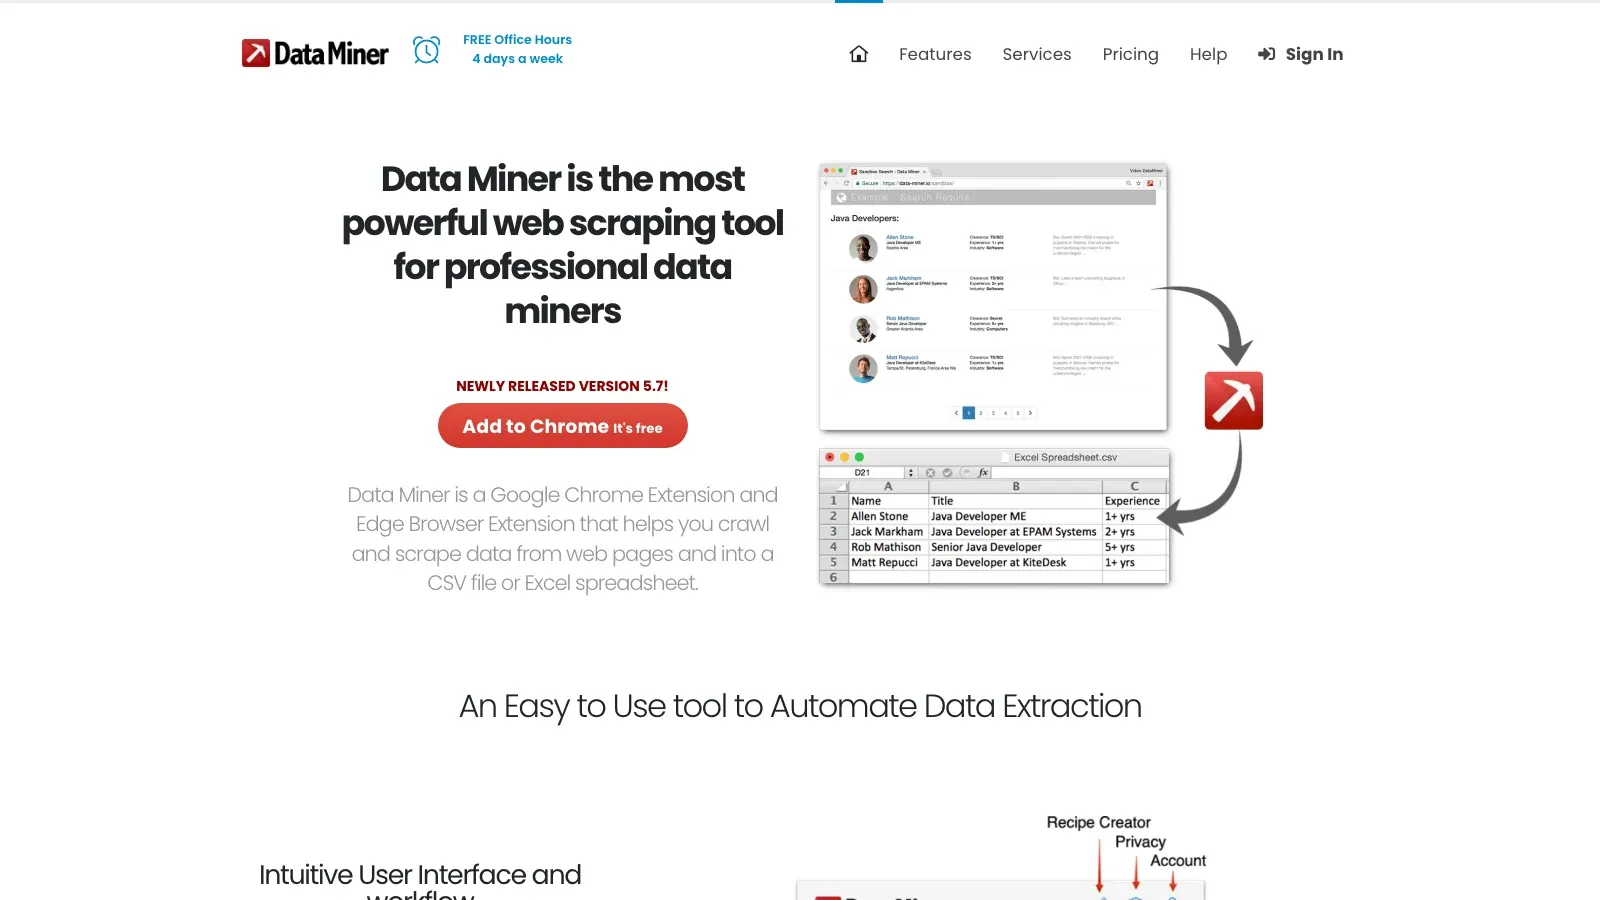
Data Miner är fortfarande användbart för taktisk extraktion direkt i webbläsaren. Det passar särskilt bra när en användare snabbt vill hämta en lista, katalog eller tabell och är bekväm med att använda eller anpassa recept.
- Bäst för: webbläsarnära extraktion av tabeller, kataloger och upprepade sidkomponenter.
- Det som utmärker sig: stort receptbibliotek, snabbt arbetsflöde i webbläsaren, välbekanta exportmönster till CSV / kalkylblad.
- Pris: gratis nivå med betalda uppgraderingar för tyngre användning.
4. Browse AI
Browse AI är som starkast när uppgiften inte bara är extraktion utan övervakning. Om en köpare vill ha en robot som återbesöker en sida, bevakar förändringar och skickar resultaten vidare, är Browse AI fortfarande relevant.
- Bäst för: återkommande övervakning, ändringsaviseringar och enkel schemalagd extraktion.
- Det som utmärker sig: tränade robotar, återkommande körningar, arbetsflöden med aviseringar, leverans till Sheets och automatiseringsverktyg.
- Pris: gratis nivå plus betalda planer baserade på körkapacitet.
5. Bardeen
Bardeen ligger på gränsen mellan extraktion och automatisering av arbetsflöden i webbläsaren. Det är mindre en ren scraper och mer ett produktivitetslager för webbläsaren som kan samla in data och skicka den vidare i resten av ett flöde.
- Bäst för: team som automatiserar återkommande webbläsaruppgifter kring scraping, enrichment och överlämning.
- Det som utmärker sig: AI-playbooks, webbläsarautomatiseringar, djupa appintegrationer.
- Pris: gratis nivå plus betalda planer.
Bästa API-, arbetsflödes- och infrastrukturdrivna extraktionsverktyg
6. Diffbot
Diffbot är fortfarande ett av de tydligaste valen när köparen vill ha extraktion som en API-produkt snarare än ett arbetsflöde i webbläsaren. Det är byggt för strukturerad webbförståelse i stor skala och är fortfarande mer inriktat på utvecklare och datadrivna produkter än no-code-verktygen ovan.
- Bäst för: team som bygger dataprodukter, enrichment-system eller storskaliga strukturerade webbpipelines.
- Det som utmärker sig: extraktions-API:er, Crawlbot, Knowledge Graph, entitetsorienterade dataprodukter.
- Pris: gratis nivå och betalda API-kreditnivåer, med företagsalternativ.
7. Captain Data
Captain Data fortsätter att vara relevant eftersom det behandlar extraktion som ett steg i ett bredare go-to-market-arbetsflöde. Det är mest användbart när den verkliga uppgiften inte är ”skrapa en sida” utan ”hämta leads, berika dem, routa dem och uppdatera systemen nedströms”.
- Bäst för: growth-, outbound- och revenue operations-team.
- Det som utmärker sig: flerstegsarbetsflöden, berikningsåtgärder, överlämning till CRM, automatisering av outbound-processer.
- Pris: användningsbaserad och säljledd.
8. ScrapingBee
ScrapingBee är fortfarande ett praktiskt API-val för utvecklare som vill ha stöd för renderade sidor och infrastrukturabstraktion utan att bygga hela scrapingstacken från grunden.
- Bäst för: produktteam och utvecklare som bygger in scraping i appar eller interna verktyg.
- Det som utmärker sig: JavaScript-rendering, proxyhantering, enkel request-modell, API-format anpassat för utvecklare.
- Pris: betalda API-planer med provåtkomst.
9. Bright Data
Bright Data är fortfarande alternativet i företagsklass när utmaningen inte är ett enskilt arbetsflöde utan datamängd, geografi, unblock-infrastruktur och compliance-tunga driftskrav.
- Bäst för: webbinhämtning i enterprise-skala, proxy-tunga arbetslaster och avancerade insamlingsprogram.
- Det som utmärker sig: proxy-nätverk, unblocker-verktyg, dataprodukter och insamlingsinfrastruktur för stor skala.
- Pris: användningsbaserad och avtalsledd.
Bästa ELT- och datapipelineplattformar med extraktionsfunktioner
10. Airbyte
Airbyte är rätt kandidat på shortlistan när jobbet är bredare än webbextraktion och teamet vill ha connectors, förflyttning till datalager och kontroll över pipelinearkitekturen. Det är inte en ersättare för en web scraper, men det är ett av de bättre alternativen för att centralisera data från SaaS, API:er och databaser.
- Bäst för: ingenjörsdrivna team som vill ha öppna connectors och kontroll med datalager i centrum.
- Det som utmärker sig: öppet ekosystem, självhanterat alternativ, molnerbjudande, flexibel connector-struktur.
- Pris: gratis självhanterad väg plus moln- och enterprise-nivåer.
11. Talend / Qlik Talend Cloud
Talend är fortfarande ett integrationsalternativ för företag som bryr sig mer om styrd dataförflyttning, kvalitet, lineage och kontroll än om snabb och enkel uppstart.
- Bäst för: företag med krav på governance, kvalitet och integration mellan flera system.
- Det som utmärker sig: enterprise-governance, verktyg för datakvalitet, bred integration, hanterad molnrikning under Qlik.
- Pris: offertbaserad prenumeration.
12. Matillion
Matillion passar fortfarande molnbaserade datateam som vill ha ELT tätt kopplat till moderna datalager och transformationsmönster i lagret.
- Bäst för: Snowflake, Databricks, BigQuery och team som arbetar i moderna datalager.
- Det som utmärker sig: molnbaserad ELT, lagercentrerad transformation, teamflöden för analytics engineering.
- Pris: förbrukningsbaserad.
13. Integrate.io
Integrate.io är fortfarande relevant för team som vill ha ett hanterat integrationslager utan att själva bygga och underhålla en bredare, ingenjörstung pipeline-stack.
- Bäst för: medelstora team som föredrar hanterade integrationer mellan SaaS-appar och databaser.
- Det som utmärker sig: hanterad implementation, koppling till affärssystem, lågt friktionsbaserat driftsätt.
- Pris: säljledd prenumeration.
14. Hevo Data
Hevo Data fortsätter att tilltala team som vill ha en lättuppsatt, hanterad pipeline med nästan realtidsbaserad synk och relativt låg driftbörda.
- Bäst för: analysteam som vill flytta data snabbt från operativa system till ett datalager.
- Det som utmärker sig: hanterade connectors, nästan realtids-synk, lätt att komma igång.
- Pris: gratis nivå och betalda planer.
15. Fivetran
Fivetran är fortfarande ett av de säkraste valen på shortlistan när köparen värdesätter driftsäkerhet, underhåll av connectors och enkel drift mer än kostnadseffektivitet eller frihet att anpassa.
- Bäst för: datateam som vill ha en standard för hanterade connectors och är beredda att betala för det.
- Det som utmärker sig: hanterade connectors, schemahantering, hög driftsmognad, lågt underhållsbehov.
- Pris: gratis plan plus användningsbaserad MAR-prissättning.
Så väljer du utan att köpa för mycket
Det snabbaste sättet att välja rätt är att undvika att lösa fel problem.
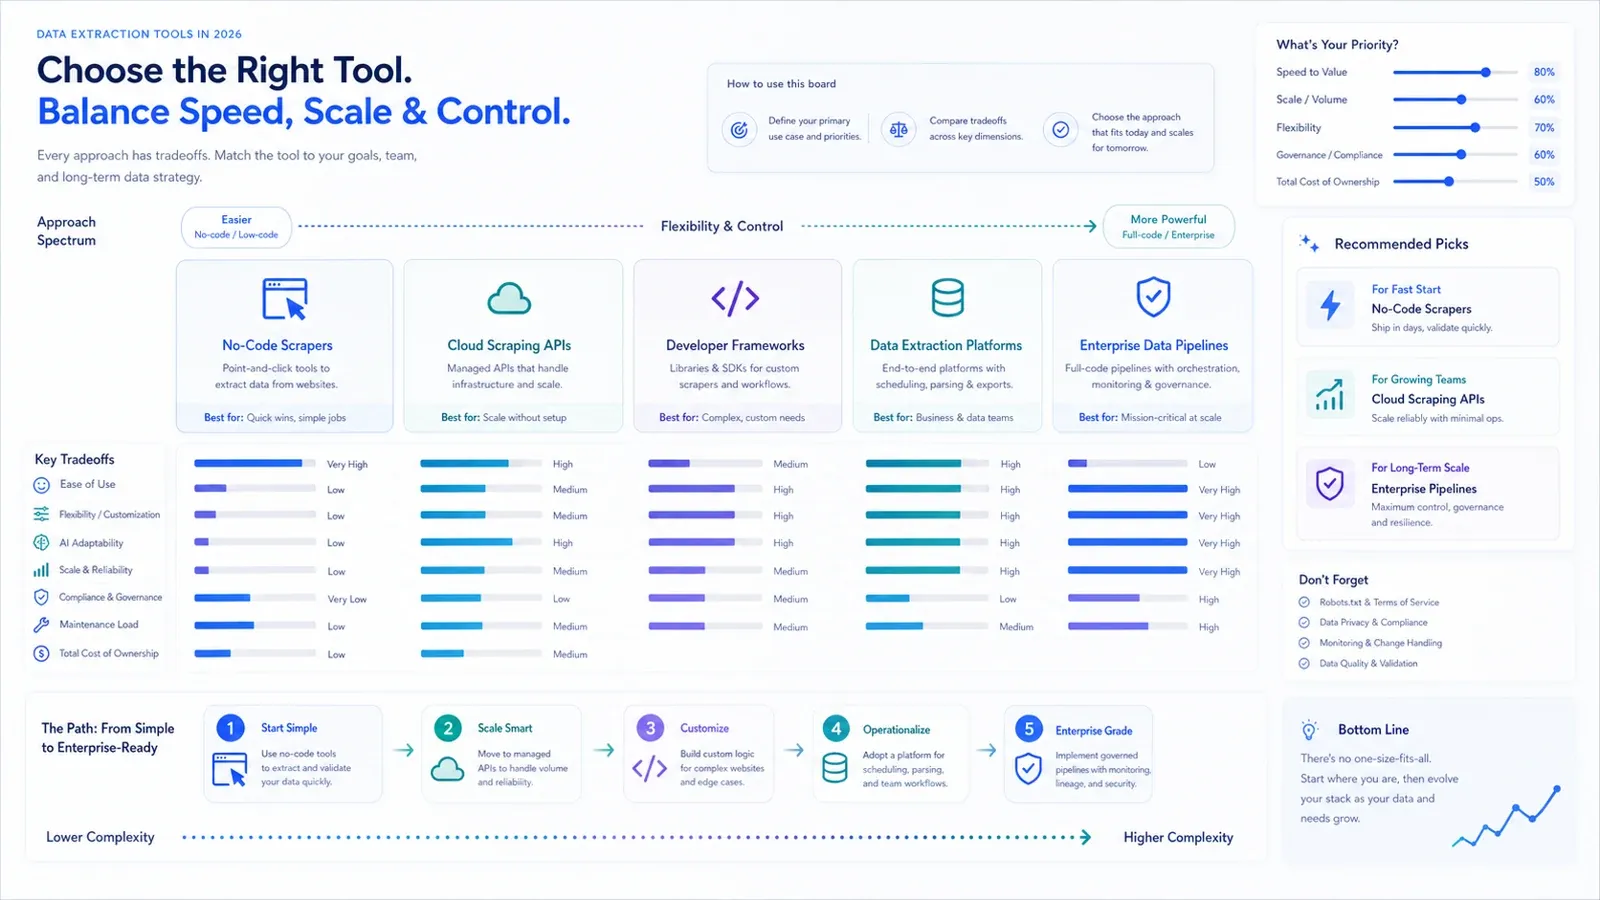
- Om du främst behöver webbdata i ett kalkylblad, börja inte med en ELT-plattform.
- Om du behöver en styrd pipeline till datalagret, tvinga inte en web scraper att bli din dataplattform.
- Om den svåraste delen av arbetsflödet är JavaScript-rendering, blockering eller API-leverans, jämför infrastrukturverktyg först.
- Om den svåraste delen är införande i teamet och snabb konfiguration, jämför AI- och no-code-verktyg först.
En användbar inköpsregel 2026 är denna: välj så låg komplexitet som ditt verkliga arbetsflöde tillåter. Underhållskostnader växer snabbare än besparingar på listpriset.
Slutgiltig shortlist per teamtyp
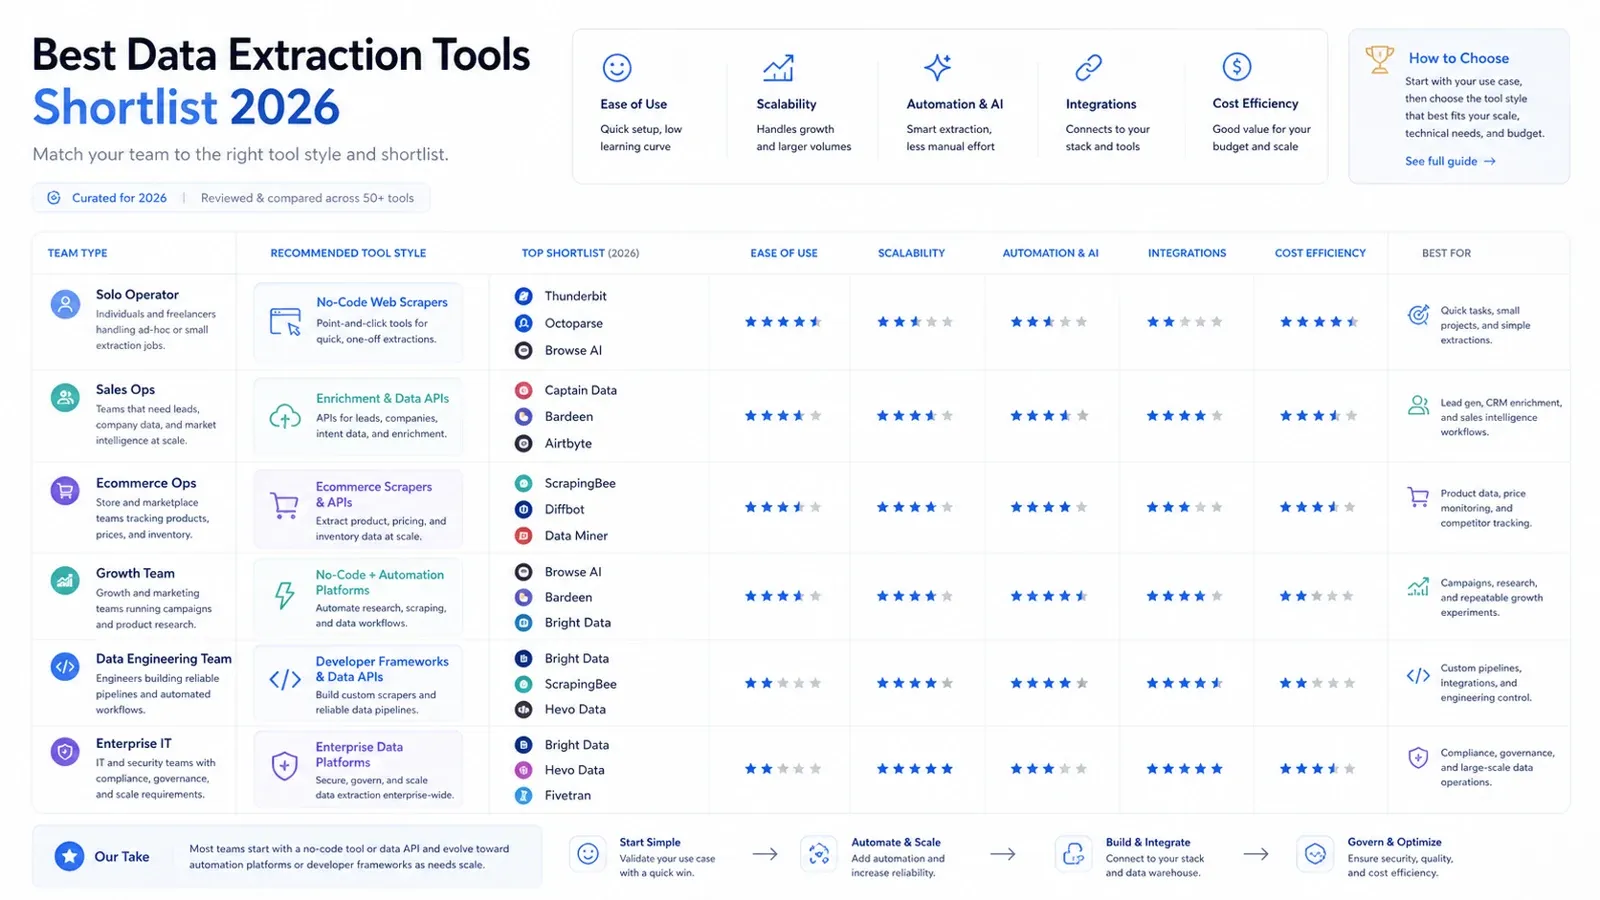
Här är den praktiska shortlist-versionen:
- Ensam operatör eller affärsanvändare: Thunderbit, Data Miner, Browse AI.
- Team för säljops eller growth-flöden: Thunderbit, Captain Data, Bardeen.
- Team för e-handelsoperationer: Thunderbit, Octoparse, Bright Data.
- Datateknikteam: Airbyte, Fivetran, Matillion, Hevo.
- Enterprise IT / köpare med styrd integration: Talend, Fivetran, Integrate.io, Bright Data.
- Utvecklare som bygger dataprodukter: Diffbot, ScrapingBee, Bright Data.
Om jag skulle reducera hela marknaden till den kortaste användbara startlistan för de flesta köpare 2026, skulle den vara:
- Thunderbit för snabb AI-assisterad extraktion av webbdata för icke-tekniska team.
- ScrapingBee för utvecklare som behöver API-infrastruktur för renderade sidor.
- Bright Data för datainsamling i stor skala och unblock-infrastruktur.
- Airbyte för ingenjörsdrivna pipelines till datalager med flexibilitet.
- Fivetran för tillförlitliga hanterade connectors.
Kom igång gratis med Thunderbit Get Started Free
Vanliga frågor
Q1: Är verktyg för dataextraktion och ETL-verktyg samma sak?
Nej. Ett dataextraktionsverktyg kan fokusera på webbplatser, PDF:er eller strukturerad fångst på sidnivå, medan en ETL- eller ELT-plattform fokuserar på att flytta och transformera data mellan system till ett datalager. Vissa köpare behöver båda, men de bör inte bedömas som om de löser exakt samma första problem.
Q2: Vad är det bästa valet för ett icke-tekniskt team 2026?
För snabb webbextraktion med minimal konfiguration är AI- och no-code-verktyg fortfarande bästa utgångspunkt. Thunderbit, Octoparse, Browse AI och Data Miner är de mest relevanta första alternativen beroende på hur mycket kontroll respektive hastighet teamet vill ha.
Q3: Vilka verktyg är bäst för utvecklare eller företagsanvändning?
För utvecklare är ScrapingBee och Diffbot starka utgångspunkter beroende på om du vill ha renderingsinfrastruktur eller API:er för strukturerad webbdata. För insamling i enterprise-skala eller infrastruktur med höga compliance-krav är Bright Data fortfarande ett viktigt alternativ. För styrda interna pipelines passar Airbyte, Fivetran, Talend, Matillion, Hevo och Integrate.io bättre.




