

O PubMed Scraper da Thunderbit ajuda você a transformar páginas do PubMed em conjuntos de dados limpos e estruturados usando IA. Você pode extrair pesquisas médicas em alta, evidências de ensaios clínicos, resumos, autores, afiliações, datas de publicação, PMIDs e links de artigos, e depois exportar para Excel, Google Sheets, Airtable ou Notion. Basta abrir o PubMed no Chrome, deixar a IA sugerir as melhores colunas e fazer a coleta.
🧬 O que é o PubMed Scraper
O PubMed Scraper é um AI Web Scraper criado para PubMed | US National Library of Medicine. Com a Thunderbit (uma extensão de Chrome de web scraper com IA), você pode acessar qualquer página de resultados do PubMed, clicar em AI Suggest Columns e depois em Scrape para extrair dados estruturados sem escrever código.
🔎 O que você pode extrair com o PubMed
O PubMed reúne metadados biomédicos de alto valor, mas nem sempre prontos para análise. O AI Web Scraper da Thunderbit (https://thunderbit.com/) ajuda você a coletar e organizar listas do PubMed e enriquecer os dados com detalhes de nível de artigo por meio de Subpage Scraping (abrindo cada página de artigo e adicionando campos como resumo, afiliações, DOI e muito mais).
Abaixo estão dois fluxos de trabalho comuns que você pode executar em minutos.
📈 Capturar pesquisas médicas em alta no PubMed
Use este fluxo para acompanhar o que está em destaque na página de tendências do PubMed. Ele é útil para se manter atualizado, criar resumos internos, monitorar publicações da concorrência ou alimentar um pipeline de acompanhamento bibliográfico.
Exemplo de página de destino: PubMed Trending
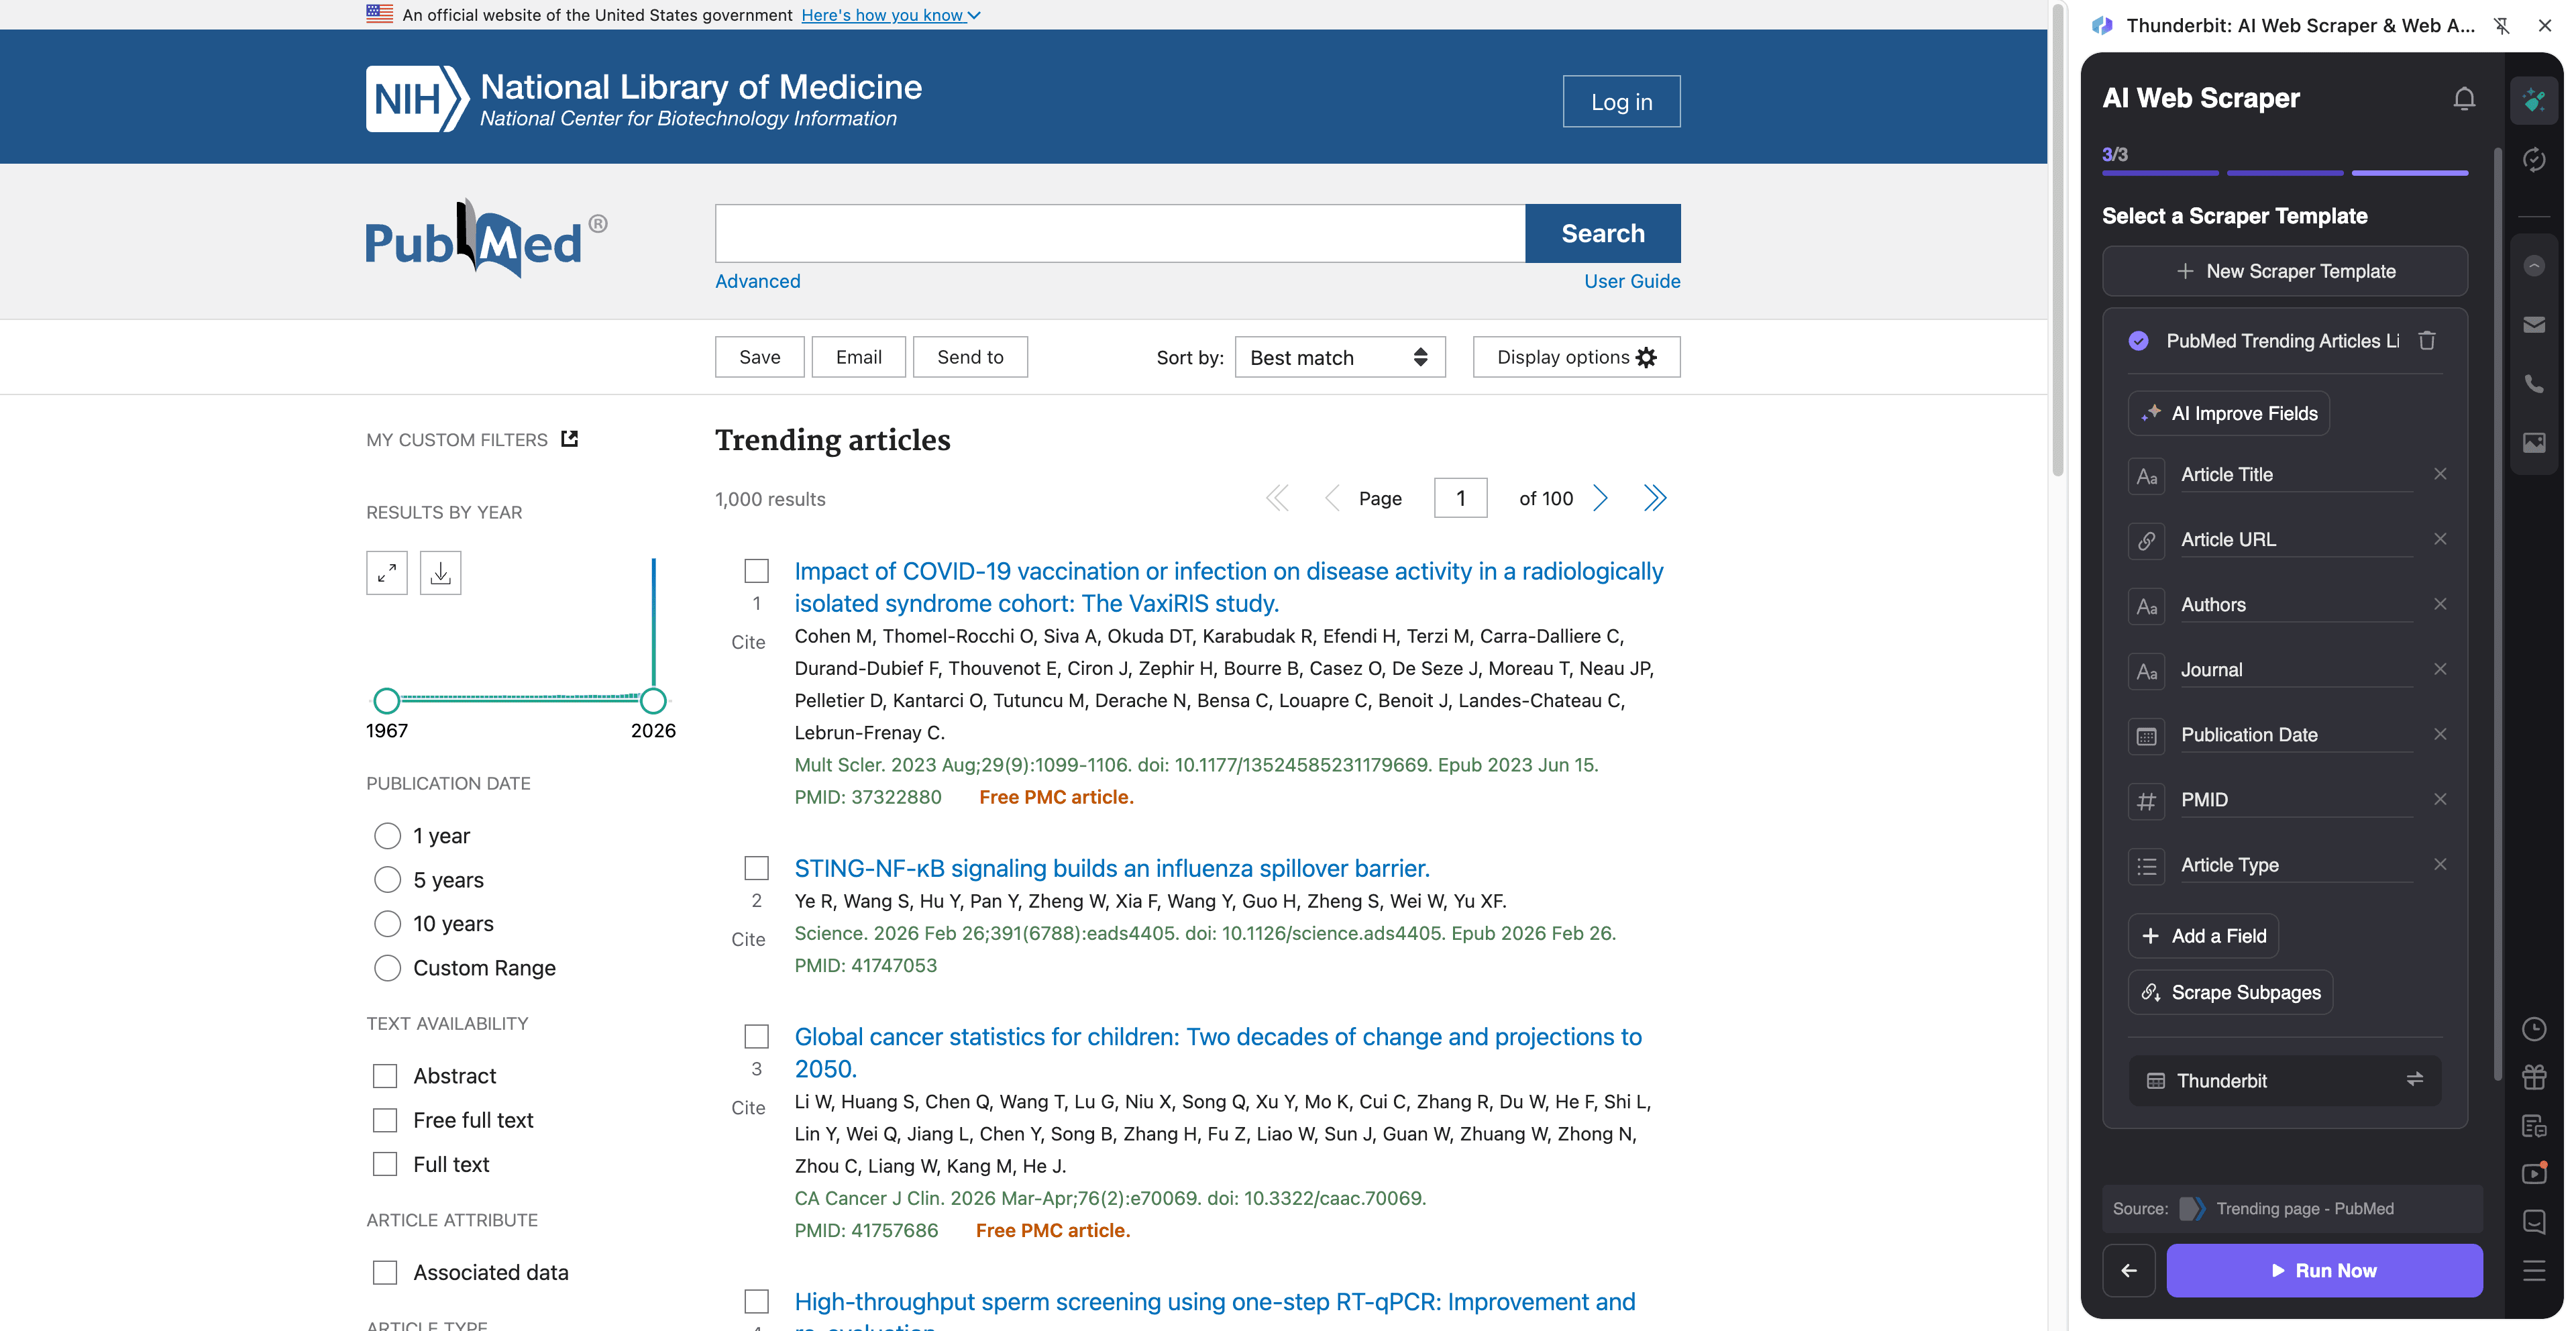
Passos:
- Baixe a Thunderbit Chrome Extension e crie uma conta.
- Acesse a página de destino, por exemplo: PubMed Trending.
- Clique em AI Suggest Columns para que a IA recomende os melhores nomes de colunas e tipos de dados.
- Clique em Scrape para extrair os dados e, depois, exporte para Excel, Google Sheets, Airtable ou Notion.
Nomes das colunas
| Coluna | Descrição |
|---|---|
| 🧾 Título do artigo | Título do artigo em alta no PubMed. |
| 🔗 URL do artigo | Link direto para a página do registro no PubMed. |
| 🆔 PMID | Identificador PubMed do registro (útil como chave estável). |
| 🏛️ Periódico | Nome da revista em que o artigo foi publicado. |
| 📅 Data de publicação | Data de publicação exibida na listagem. |
| ✍️ Autores | String de autores mostrada no card do resultado. |
| 🧪 Tipo de artigo | Tipo de publicação, quando disponível (ex.: Review, Clinical Trial). |
| 🏷️ Palavras-chave / temas | Tags de tema ou palavras-chave visíveis na listagem (se houver). |
| 📝 Trecho / resumo curto | Texto curto exibido na listagem (se houver). |
| 🧷 DOI | DOI, quando disponível (geralmente melhor capturado via subpage scraping). |
| 🧑🔬 Afiliações | Afiliações dos autores (normalmente extraídas via subpage scraping). |
| 📄 Resumo | Texto do abstract (normalmente extraído via subpage scraping). |
🧫 Extrair evidências de ensaios clínicos do PubMed
Use este fluxo para extrair evidências relacionadas a ensaios clínicos dos resultados de busca do PubMed e, em seguida, enriquecer cada linha visitando a página do artigo para capturar resumo, sinais de ensaio e metadados necessários para revisão.
Exemplo de página de destino: Resultados de busca por ensaio clínico
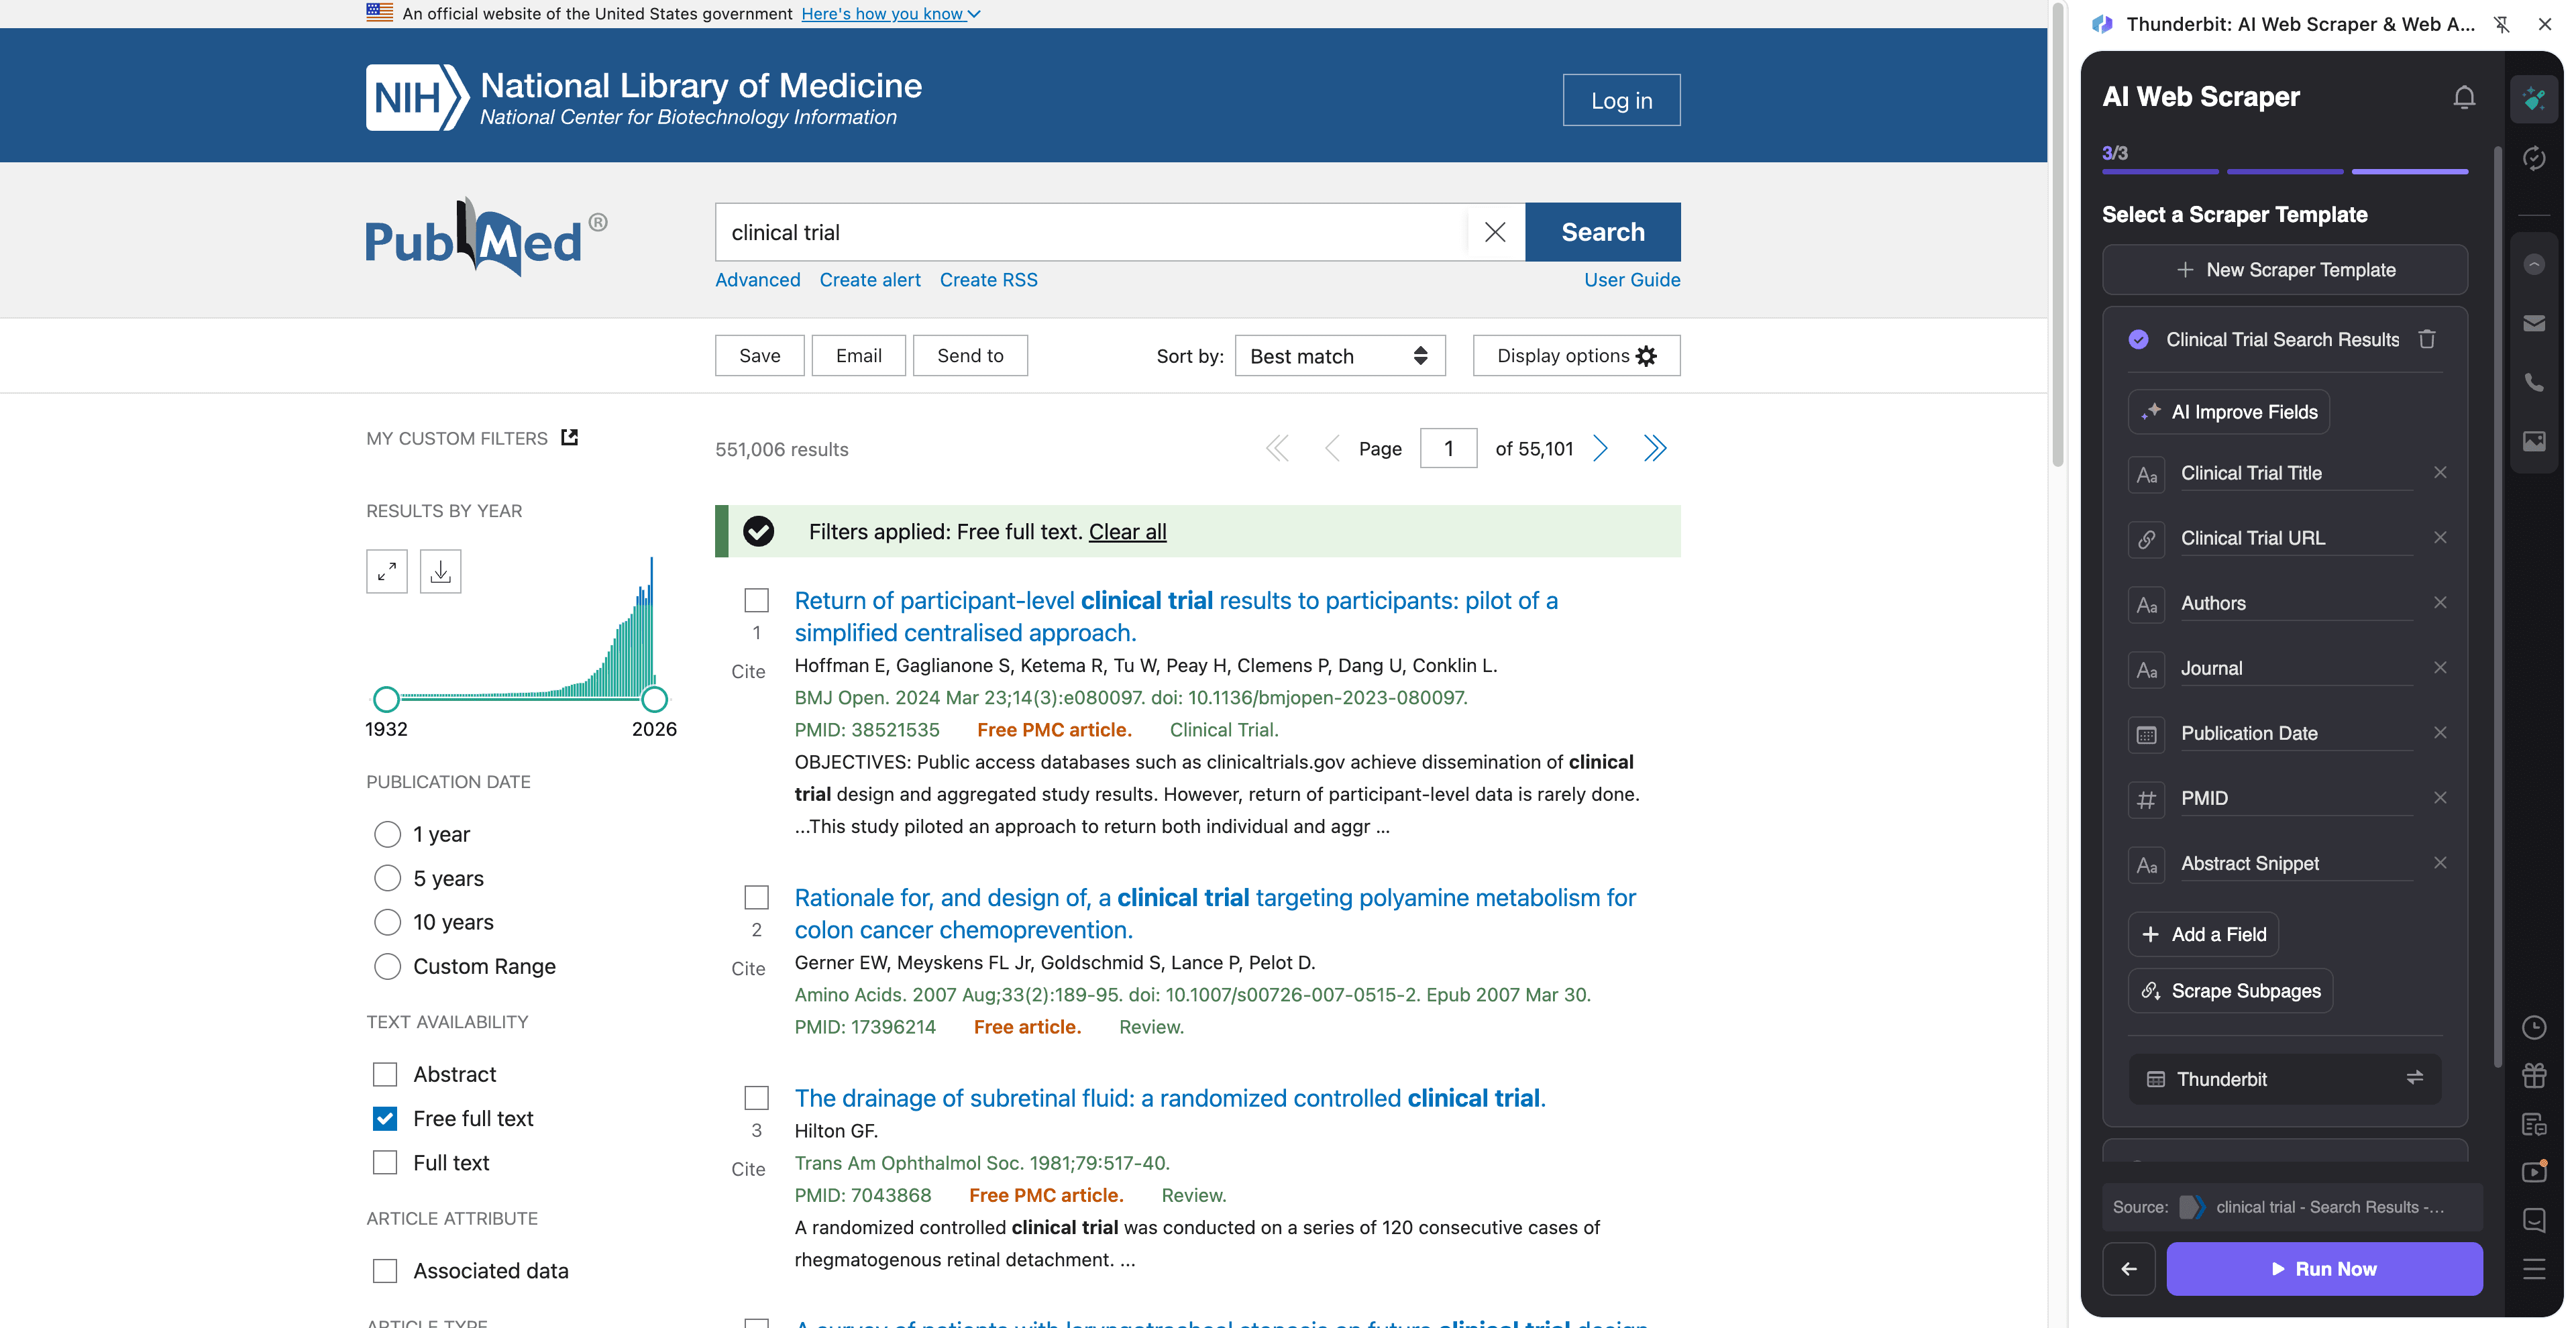
Passos:
- Baixe a Thunderbit Chrome Extension e crie uma conta.
- Acesse a página de destino, por exemplo: Resultados de busca por ensaio clínico.
- Clique em AI Suggest Columns para gerar os campos recomendados (você pode renomear ou adicionar os seus).
- Clique em Scrape para coletar os resultados e, depois, use Scrape Subpages para enriquecer cada linha com resumo, afiliações, DOI e muito mais.
Nomes das colunas
| Coluna | Descrição |
|---|---|
| 🧾 Título | Título do artigo nos resultados de busca. |
| 🔗 URL do PubMed | Link para a página do artigo no PubMed para enriquecimento via subpágina. |
| 🆔 PMID | Identificador PubMed para deduplicação e referência. |
| 🧑⚕️ Autores | Autores listados no trecho do resultado. |
| 🏛️ Periódico | Nome do periódico e informações de citação exibidas nos resultados. |
| 📅 Data | Data de publicação (ou data de ePub) mostrada na listagem. |
| 🧪 Tipo de publicação | Sinais como Clinical Trial, Randomized Controlled Trial, Meta-Analysis (geralmente mais claros na página do artigo). |
| 🧾 Resumo | Texto completo do abstract (melhor via subpage scraping). |
| 🧬 Termos MeSH | Medical Subject Headings, quando disponíveis (muitas vezes na página do artigo). |
| 🧷 DOI | DOI para linkar páginas do editor e gerenciadores de referência. |
| 🏥 Afiliações | Afiliações dos autores para análise institucional (subpage scraping). |
| 🌍 País / instituição | Interpretado a partir das afiliações com Field AI Prompts (opcional). |
| 🔍 Palavras-chave de ensaio clínico | Sinais rotulados por IA como “randomized”, “double-blind”, “placebo” (opcional via Field AI Prompt). |
| 📎 Links para texto completo | Links externos para o editor ou texto completo gratuito, quando disponíveis. |
🎯 Por que usar a ferramenta para PubMed
Extrair dados do PubMed é uma questão de velocidade, consistência e de tornar os dados de pesquisa utilizáveis em todo o seu fluxo de trabalho. Em vez de copiar citações uma a uma, você pode criar um conjunto de dados estruturado para filtrar, marcar e compartilhar.
Motivos comuns para equipes extraírem dados do PubMed:
- Equipes de medical affairs e farma: acompanham novas publicações em uma área terapêutica, monitoram ensaios da concorrência e montam tabelas de evidências para revisões internas.
- Biotech e operações clínicas: coletam publicações relacionadas a estudos, mapeiam instituições e investigadores e mantêm uma bibliografia viva.
- Marketing de saúde e equipes de conteúdo: identificam temas em alta, revistas de alto impacto e palavras-chave emergentes para planejamento editorial.
- Pesquisadores acadêmicos e bibliotecários: montam conjuntos de dados para revisão de literatura, removem duplicidades por PMID e exportam para planilhas para triagem.
- Equipes de dados: criam entradas estruturadas para análises posteriores, dashboards ou bases internas de conhecimento.
A Thunderbit é especialmente útil quando você precisa de mais do que a página de listagem. Com Subpage Scraping, você pode extrair abstracts, afiliações, DOI, termos MeSH e links para texto completo em escala.
🧩 Como usar a extensão do Chrome para PubMed
- Instale a Thunderbit Chrome Extension: baixe na Chrome Web Store e crie sua conta.
- Acesse uma página do PubMed: abra o PubMed, uma página de tendências como Trending ou uma busca como resultados de ensaio clínico.
- Ative o scraper com IA: clique em AI Suggest Columns para gerar campos, ajuste os tipos de dados (texto/data/url) e adicione Field AI Prompts opcionais (para rotulagem, formatação ou extração de sinais de ensaio).
- Extraia e exporte: clique em Scrape. Se precisar de abstracts/afiliações/MeSH, use Scrape Subpages para enriquecer cada linha e depois exporte para Excel, Google Sheets, Airtable ou Notion.
Leituras úteis se você estiver montando um fluxo de trabalho repetível:
- Como extrair qualquer site usando IA
- O que é data scraping e como fazer em 2025
- Como extrair dados de site para o Excel usando IA
- O que é list crawling e como fazer usando IA
💳 Preços para o PubMed
A Thunderbit usa um sistema simples de créditos:
- 1 crédito = 1 linha de saída na sua tabela de resultados (por exemplo, um registro do PubMed).
- A exportação de dados é gratuita: baixe CSV/JSON ou envie para Excel, Google Sheets, Airtable ou Notion.
Você pode começar com:
- Plano gratuito: extraia 6 páginas por mês (limite por páginas no Free).
- Teste gratuito: extraia 10 páginas grátis, ideal para testar páginas de tendências do PubMed e algumas páginas de resultados de ensaios clínicos.
Se você faz extrações com frequência (monitoramento semanal, atualizações de evidências ou consultas grandes), os planos pagos oferecem mais créditos. O plano anual costuma ser mais vantajoso, pois inclui desconto em comparação com o pagamento mensal.
Você pode conferir as opções em Thunderbit Pricing.
❓ FAQ
-
O que é o AI Powered PubMed Scraper?
O AI Powered PubMed Scraper é um fluxo de trabalho na Thunderbit que extrai dados estruturados dos resultados de busca e das páginas de artigos do PubMed. Você pode usar IA para sugerir colunas, extrair listas e enriquecer cada linha visitando subpáginas dos artigos para obter abstracts, afiliações, DOI e muito mais. -
O que é Thunderbit?
Thunderbit é uma extensão de Chrome de web scraper com IA, criada para fluxos de trabalho de negócios e pesquisa em que você precisa de dados estruturados de sites. Ela ajuda você a extrair, rotular e exportar dados rapidamente, sem criar ou manter scripts de scraping. -
É possível extrair páginas de tendências do PubMed e resultados de busca comuns?
Sim. Você pode extrair a página PubMed Trending, buscas padrão por palavra-chave e páginas filtradas de resultados (como consultas focadas em ensaios clínicos). A IA da Thunderbit se adapta a diferentes layouts lendo a página e propondo os campos. -
A Thunderbit consegue extrair abstracts, afiliações e termos MeSH?
Sim, e é aqui que o Subpage Scraping ajuda mais. Você pode extrair primeiro a lista de resultados e, em seguida, fazer com que a Thunderbit abra cada página de registro do PubMed para capturar o texto do abstract, afiliações, termos MeSH, DOI e outros metadados na mesma tabela. -
Como funcionam a paginação e o scroll infinito no PubMed?
A Thunderbit oferece suporte à extração com paginação, incluindo navegação no estilo “próxima página”. Se o PubMed mudar a forma como os resultados carregam, a extração baseada em IA tende a ser mais resiliente do que seletores rígidos, já que ela reinterpreta a estrutura da página a cada execução. -
Em quais formatos posso exportar os dados do PubMed?
Você pode exportar para CSV ou JSON, ou enviar o conjunto de dados para Excel, Google Sheets, Airtable ou Notion. Isso é útil para fluxos de triagem, tabelas de evidências, dashboards e compartilhamento com colaboradores. -
Quantos registros do PubMed posso extrair de graça?
No plano Free, você pode extrair 6 páginas por mês, o que muitas vezes é suficiente para tarefas pequenas de monitoramento. No teste gratuito, você pode extrair 10 páginas grátis para validar a configuração das colunas e a estratégia de enriquecimento via subpáginas. -
Posso personalizar colunas para necessidades específicas de extração de evidências?
Sim. Você pode renomear colunas, definir tipos de dados (texto/data/url) e adicionar Field AI Prompts para extrair ou rotular informações como palavras-chave de desenho de estudo, população, intervenção, comparador, desfechos ou país a partir das afiliações. Isso ajuda você a ir além da extração bruta e preparar evidências estruturadas. -
É permitido extrair dados do PubMed?
O PubMed é um recurso público, e muitas equipes coletam metadados bibliográficos para pesquisa e análise. Ainda assim, você deve seguir as leis aplicáveis, respeitar os termos do site e usar práticas responsáveis de scraping, especialmente em execuções grandes e frequentes.
📚 Saiba mais
- Baixe a extensão: Página de download da Thunderbit Chrome Extension
- Explore guias no Thunderbit Blog
- Aprenda o básico: O que é data scraping e como fazer em 2025
- Crie fluxos de lista: O que é list crawling e como fazer usando IA
- Exporte para planilhas: Como extrair dados de site para o Excel usando IA
- Se você também extrai PDFs em operações de pesquisa: Como extrair dados de PDF usando IA










