
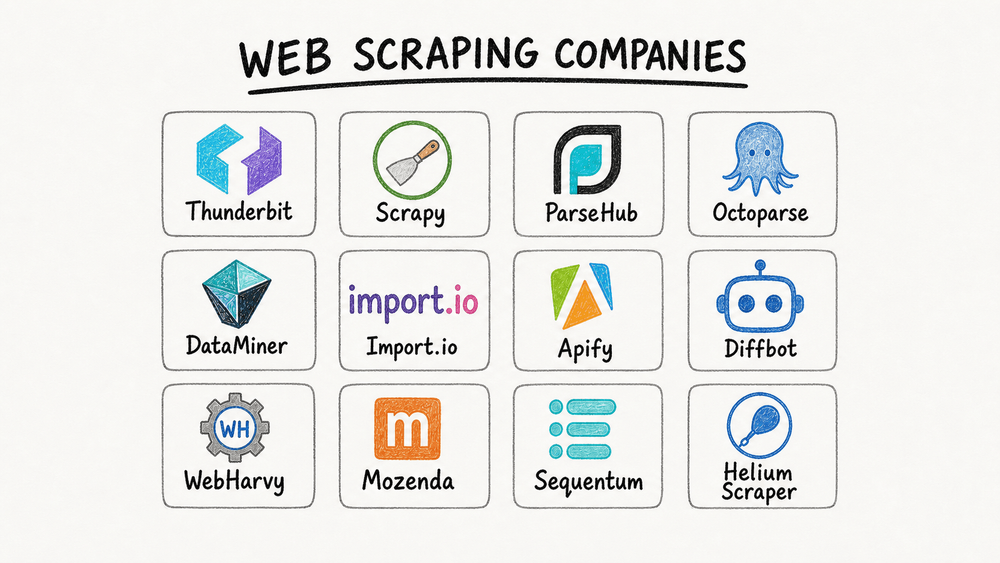
A web está crescendo numa velocidade que, sinceramente, é difícil acompanhar — até 2026, quase metade de todo o tráfego da internet será de bots, e uma fatia enorme disso vem de empresas que fazem coleta de dados para impulsionar vendas, operações e pesquisas competitivas. Já vi de perto como o web scraping deixou de ser um “extra interessante” para quem é de tecnologia e virou uma necessidade real para todo mundo, de equipes comerciais a corretores de imóveis. Mas há um detalhe: nem todas as empresas de web scraping são iguais, e escolher a certa pode ser a diferença entre um fluxo automatizado sem atrito e uma semana inteira de dores de cabeça com copy-paste.
Por isso, arregaçamos as mangas e fomos a fundo nas melhores empresas de web scraping para 2026. Se você é um usuário sem perfil técnico e só quer dados em dois cliques, ou um desenvolvedor em busca de controle total, esta lista reúne o que há de melhor — com uma análise honesta sobre onde cada uma brilha e onde fica devendo. Vamos lá.
Por que as empresas precisam das melhores companhias de web scraping
Extraia dados de qualquer site usando IA Get Started Free
Se você já tentou montar uma lista de leads, acompanhar preços da concorrência ou puxar dados de produtos de dezenas (ou milhares) de páginas, sabe como a coleta manual é desgastante. É lenta, sujeita a erros e, sendo bem honesto, ninguém considera isso uma tarefa agradável. É por isso que o web scraping se consolidou como um setor de verdade, com empresas usando essa tecnologia para tudo, de geração de leads e monitoramento de preços até pesquisa de mercado e análise de sentimento.
A grande vantagem? Automação. As empresas modernas de web scraping permitem que você:
- Automatize pesquisas repetitivas (chega de maratonas de copiar e colar)
- Escalone para milhares de páginas sem esforço extra
- Integre os dados diretamente às suas ferramentas favoritas (Excel, Google Sheets, Notion, CRMs)
- Saia na frente da concorrência com dados mais atuais e mais completos — mais rápido
Mas, com tantas opções, como escolher? É aí que este guia entra.
Como avaliamos as principais empresas de web scraping
Nem todo scraper foi feito para o mesmo perfil de usuário — ou para o mesmo tipo de tarefa. Veja como analisei o mercado:
- Facilidade de uso: uma pessoa sem conhecimentos de programação consegue resultados rapidamente? A interface é intuitiva?
- Automação e recursos: lida com paginação, subpáginas, agendamento e conteúdo dinâmico?
- Escalabilidade: suporta projetos grandes ou funciona melhor em tarefas menores?
- Integração: quão fácil é exportar ou conectar os dados a outras ferramentas?
- Preço: existe versão gratuita? É acessível para PMEs e escalável para empresas maiores?
- Suporte e comunidade: há tutoriais, modelos prontos e ajuda de verdade quando você precisa?
Também considerei o que torna cada empresa única — porque, às vezes, a melhor ferramenta não é a que tem mais recursos, e sim a que se encaixa no seu fluxo de trabalho.
Agora, vamos à lista.
1. Thunderbit
 Thunderbit é o web scraper com IA que mais me empolga para 2026 — e não é só porque ajudei a construir a ferramenta! O Thunderbit foi criado para usuários de negócios que querem dados, não complicação. A extensão do Chrome permite extrair dados de qualquer site usando comandos em linguagem natural e sugestões de campos com IA. Sem código, sem modelos, sem estresse.
Por que o Thunderbit se destaca:
- Extração com um clique: basta clicar em “One-Click Extract” — a IA do Thunderbit faz o resto.
- Suporte a subpáginas e paginação: extraia listagens com facilidade e depois deixe a IA visitar cada subpágina para capturar mais detalhes.
- Modelos instantâneos: para sites populares (Amazon, Zillow, Shopify etc.), use templates prontos para extração em 1 clique.
- Exportação gratuita de dados: exporte para Excel, Google Sheets, Notion ou Airtable — sem paywall sobre os seus próprios dados.
- Enriquecimento de dados com IA: rotule, categorize e traduza dados durante a coleta.
- Coleta agendada e na nuvem: configure tarefas recorrentes ou execute extrações na nuvem para ganhar velocidade.
- Plano grátis de verdade: extraia até 6 páginas gratuitamente, ou 10 com bônus de teste. Os planos pagos começam em US$ 15/mês.
O Thunderbit é confiado por mais de 200.000 usuários no mundo todo, de equipes comerciais a operações de e-commerce. Se você quer a experiência mais fácil e amigável de web scraping em 2026, o Thunderbit é difícil de superar.
Quer ver como funciona? Baixe a extensão do Chrome e teste por conta própria.
Experimente o Thunderbit grátis
2. Scrapy
 Scrapy é o framework Python open source mais usado por desenvolvedores que querem controle total. Ele é poderoso, flexível e testado em batalha para tudo, desde o rastreamento de sites pequenos até a extração de milhões de páginas.
Ideal para: equipes de tecnologia, engenheiros de dados e qualquer pessoa confortável com Python.
Principais recursos:
- Criação de regras personalizadas: monte spiders para lidar com qualquer estrutura de site.
- Escalável e rápido: suporta scraping em grande escala com tratamento robusto de erros.
- Integra com o ecossistema Python: conecte com Pandas, Jupyter e muito mais.
- Gratuito e open source: sem licença paga, com enorme suporte da comunidade.
Atenção: o Scrapy tem uma curva de aprendizado. Se você não programa, talvez seja melhor procurar outra opção. Mas, para desenvolvedores, ele é um verdadeiro motor (ScraperAPI).
3. ParseHub
 ParseHub é um aplicativo de desktop que torna o web scraping visual e acessível. A interface de apontar e clicar permite criar scrapers sem escrever código.
Ideal para: PMEs, pesquisadores e usuários sem perfil técnico que querem flexibilidade.
Principais recursos:
- Fluxo de trabalho visual: clique para selecionar dados e crie lógica para paginação e subpáginas.
- Agendamento na nuvem: execute coletas em horários programados, mesmo com o computador desligado.
- Opções de exportação: baixe em CSV, Excel ou JSON.
- Plano gratuito: 5 projetos, até 200 páginas por execução; planos pagos começam em US$ 189/mês.
O ParseHub é especialmente popular para extrair listagens, avaliações e dados de e-commerce (ScraperAPI).
4. Octoparse
 Octoparse é uma plataforma de web scraping sem código, com arrastar e soltar, focada em automação em escala. É ótima para equipes que querem configurar tarefas complexas sem escrever scripts.
Ideal para: equipes de marketing, pesquisa e operações.
Principais recursos:
- Fluxo de trabalho por arrastar e soltar: crie scrapers visualmente e lide com conteúdo dinâmico e rolagem infinita.
- Scraping e agendamento na nuvem: execute tarefas na nuvem e agende rotinas recorrentes.
- Rotação de IP e anti-bloqueio: recursos integrados para extrair dados de sites mais difíceis.
- Exportação para Excel, Sheets e bancos de dados: integração fácil com seu fluxo de trabalho.
- Plano gratuito: até 10.000 registros/mês; planos pagos começam em US$ 83/mês, ou US$ 69/mês no anual.
O Octoparse é especialmente valorizado pela velocidade e pela capacidade de lidar com projetos em larga escala (ScraperAPI).
5. DataMiner
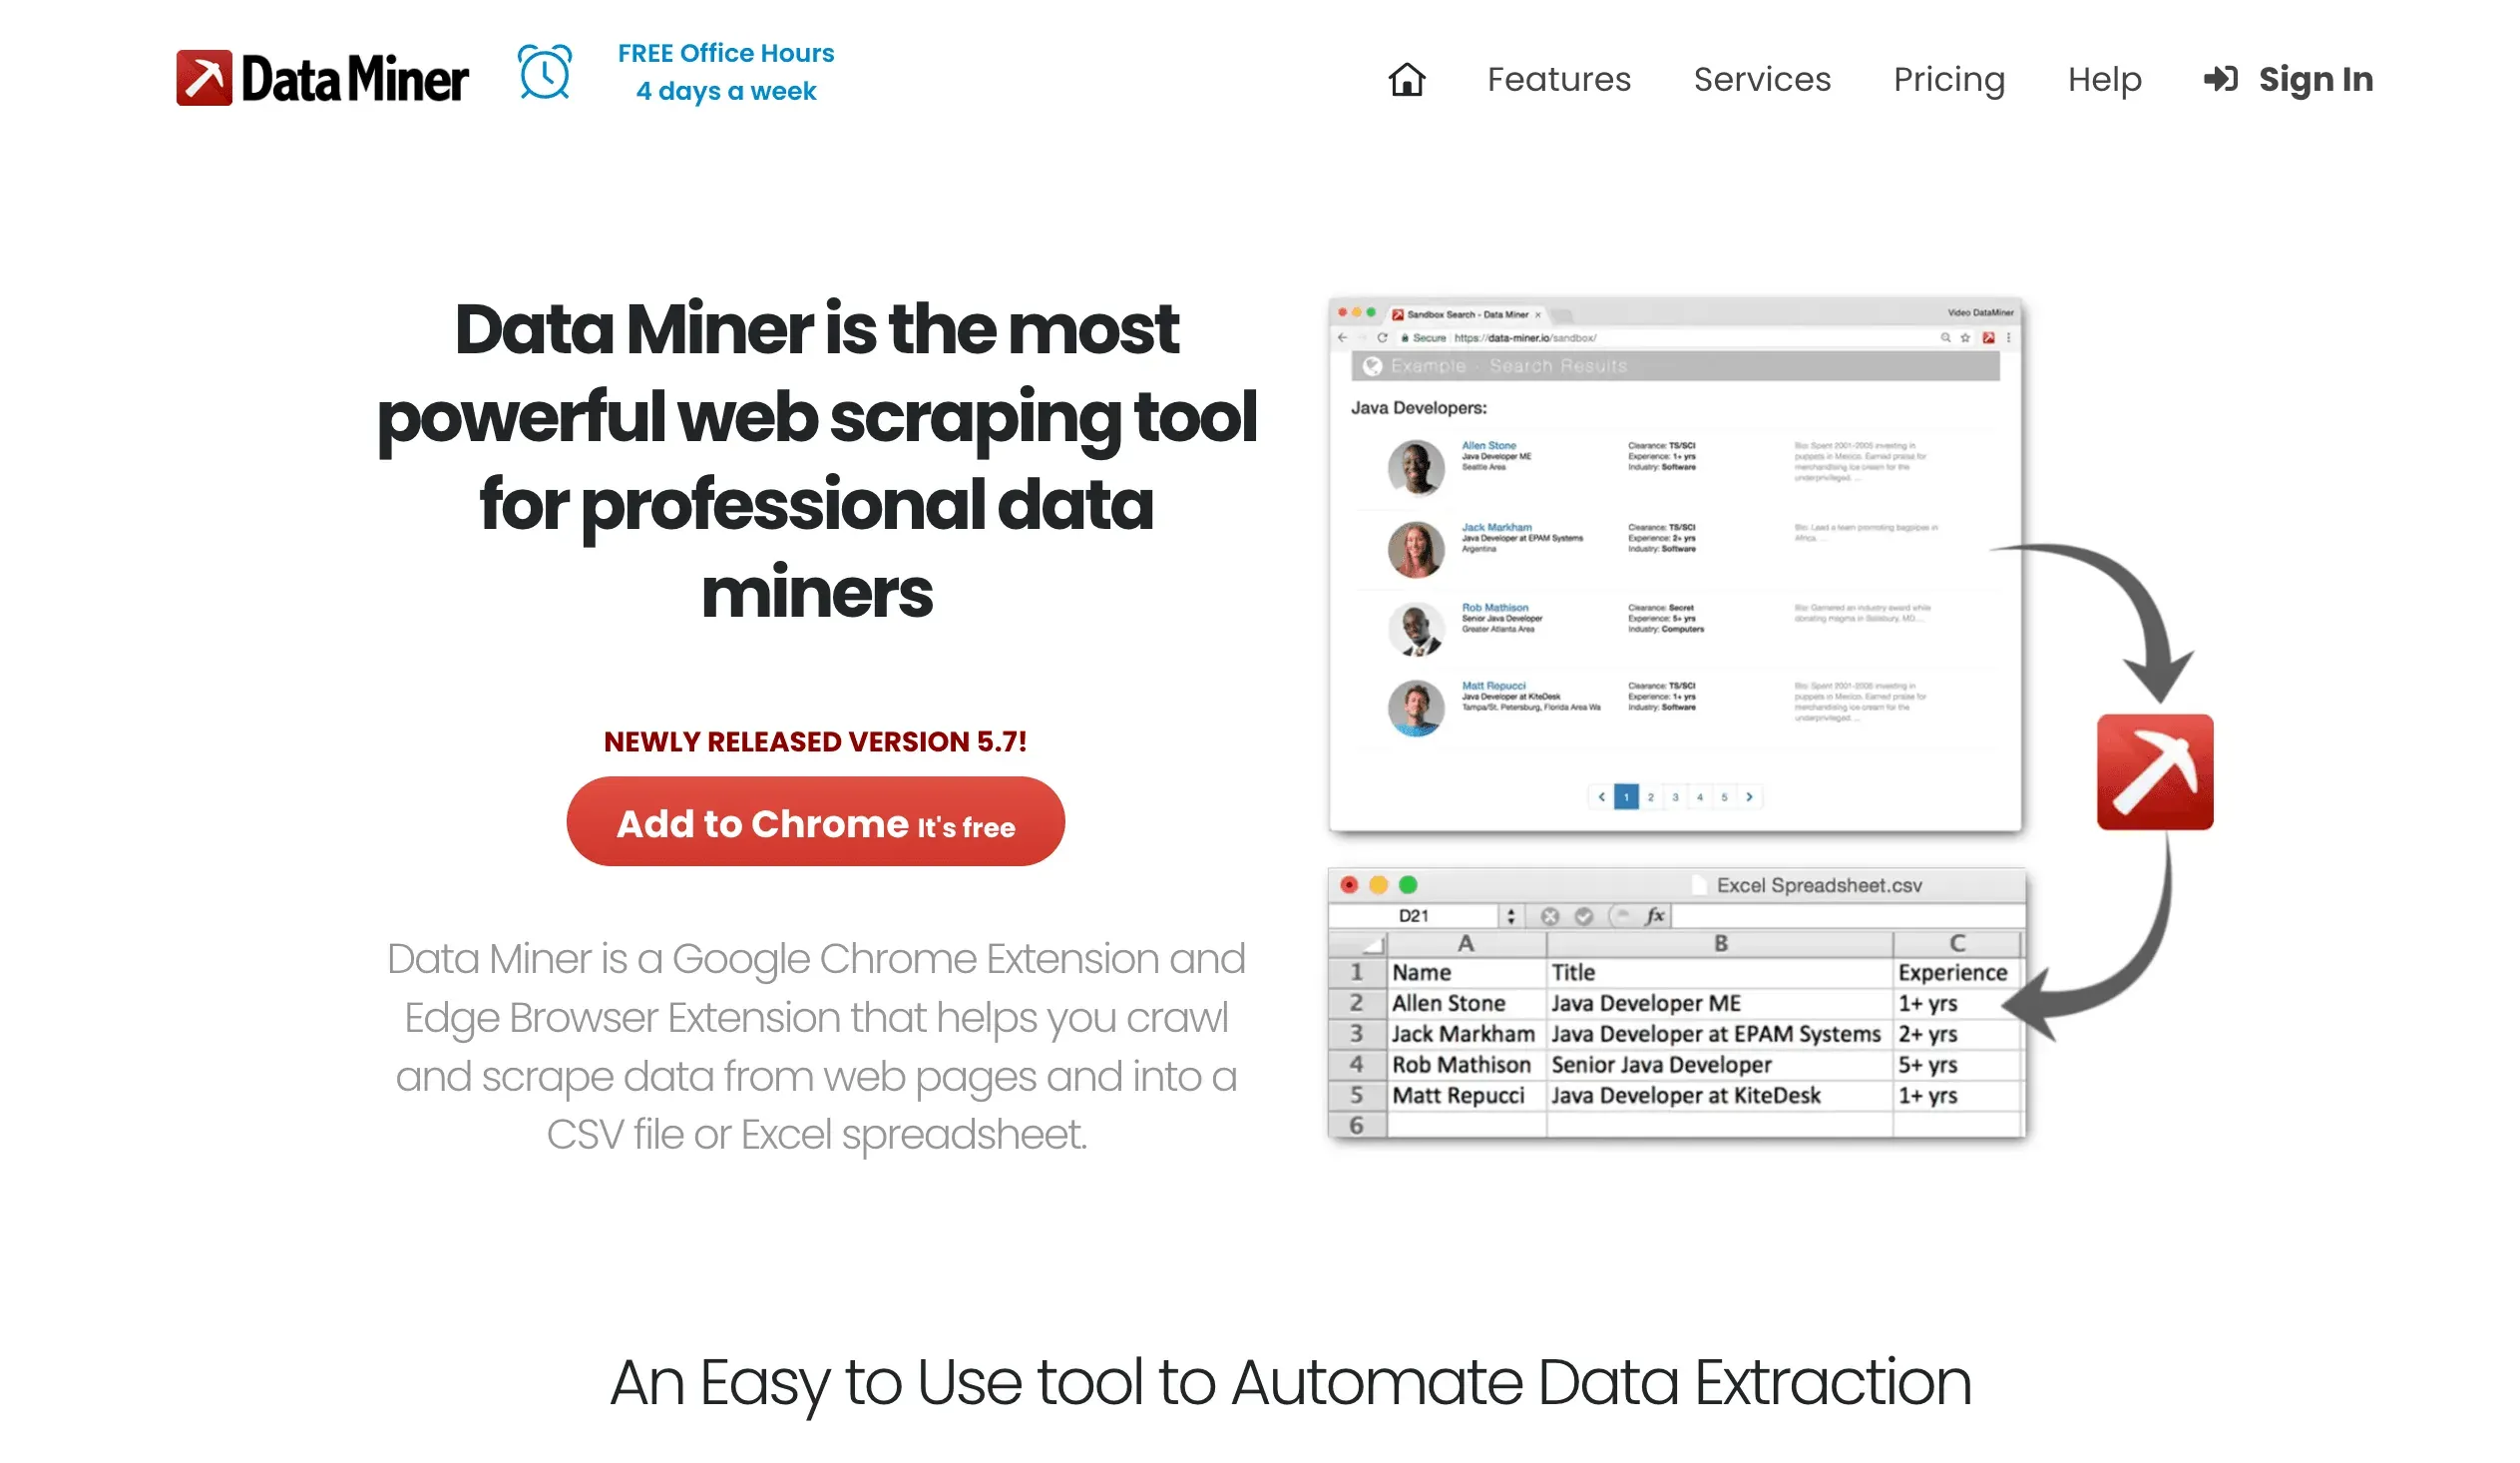 DataMiner é uma extensão do Chrome que leva o web scraping diretamente para o navegador. É perfeita para coletas rápidas, baseadas em templates, em tabelas, listas e sites simples.
Ideal para: usuários do dia a dia, equipes de vendas e qualquer pessoa que vive no Chrome.
Principais recursos:
- Marketplace de templates: mais de 60.000 receitas prontas para sites populares.
- Extração por apontar e clicar: selecione dados visualmente, sem precisar programar.
- Exportação para Excel/Google Sheets: exporte com um clique.
- Plano gratuito: 500 páginas/mês; planos pagos a partir de US$ 19/mês.
O DataMiner é um dos favoritos para tarefas rápidas e usuários não técnicos (DataMiner).
6. Import.io
 Import.io é uma plataforma de nível corporativo focada em transformar conteúdo da web em dados estruturados para análise e business intelligence.
Ideal para: empresas com grandes volumes de dados e necessidade de integração.
Principais recursos:
- Modelo de serviço gerenciado: a equipe da Import.io pode criar e manter scrapers para você.
- Interface visual: monte fluxos de extração sem código.
- Acesso por API: integre os dados extraídos diretamente nos seus apps e painéis.
- Conformidade e segurança: controles de nível enterprise, mascaramento de PII e mais.
Preço: orçamento personalizado, normalmente a partir de US$ 199/mês (PromptCloud).
7. Apify
 Apify é uma plataforma de automação amigável para desenvolvedores, com um enorme marketplace de “Actors” prontos (bots de scraping) e a possibilidade de criar fluxos personalizados.
Ideal para: desenvolvedores, agências e equipes que querem flexibilidade.
Principais recursos:
- Marketplace de Actors: scrapers prontos para sites populares ou a opção de criar os seus.
- Infraestrutura em nuvem: execute coletas em escala, agende tarefas e integre com APIs.
- Integração com GitHub: automatize fluxos e CI/CD.
- Pagamento conforme o uso: créditos gratuitos, depois cobrança por uso; planos pagos começam em US$ 29/mês.
O Apify é ideal tanto para projetos simples quanto para os mais complexos (Black Bear Media).
8. Diffbot
 Diffbot usa IA e grafos de conhecimento para transformar conteúdo web não estruturado em dados estruturados, legíveis por máquina. Pense nele como o “cérebro” do web scraping.
Ideal para: empresas, pesquisadores e qualquer pessoa que precise de extração automatizada em grande escala.
Principais recursos:
- Extração orientada por IA: reconhece automaticamente artigos, produtos, organizações e muito mais.
- Grafo de conhecimento: acesse, via API, o maior grafo de dados da web do mundo.
- Enriquecimento de dados: adiciona entidades relacionadas, notícias e contexto.
- API-first: integra com ferramentas de BI e pipelines de dados.
Preço: a partir de US$ 299/mês (Diffbot Pricing).
9. WebHarvy
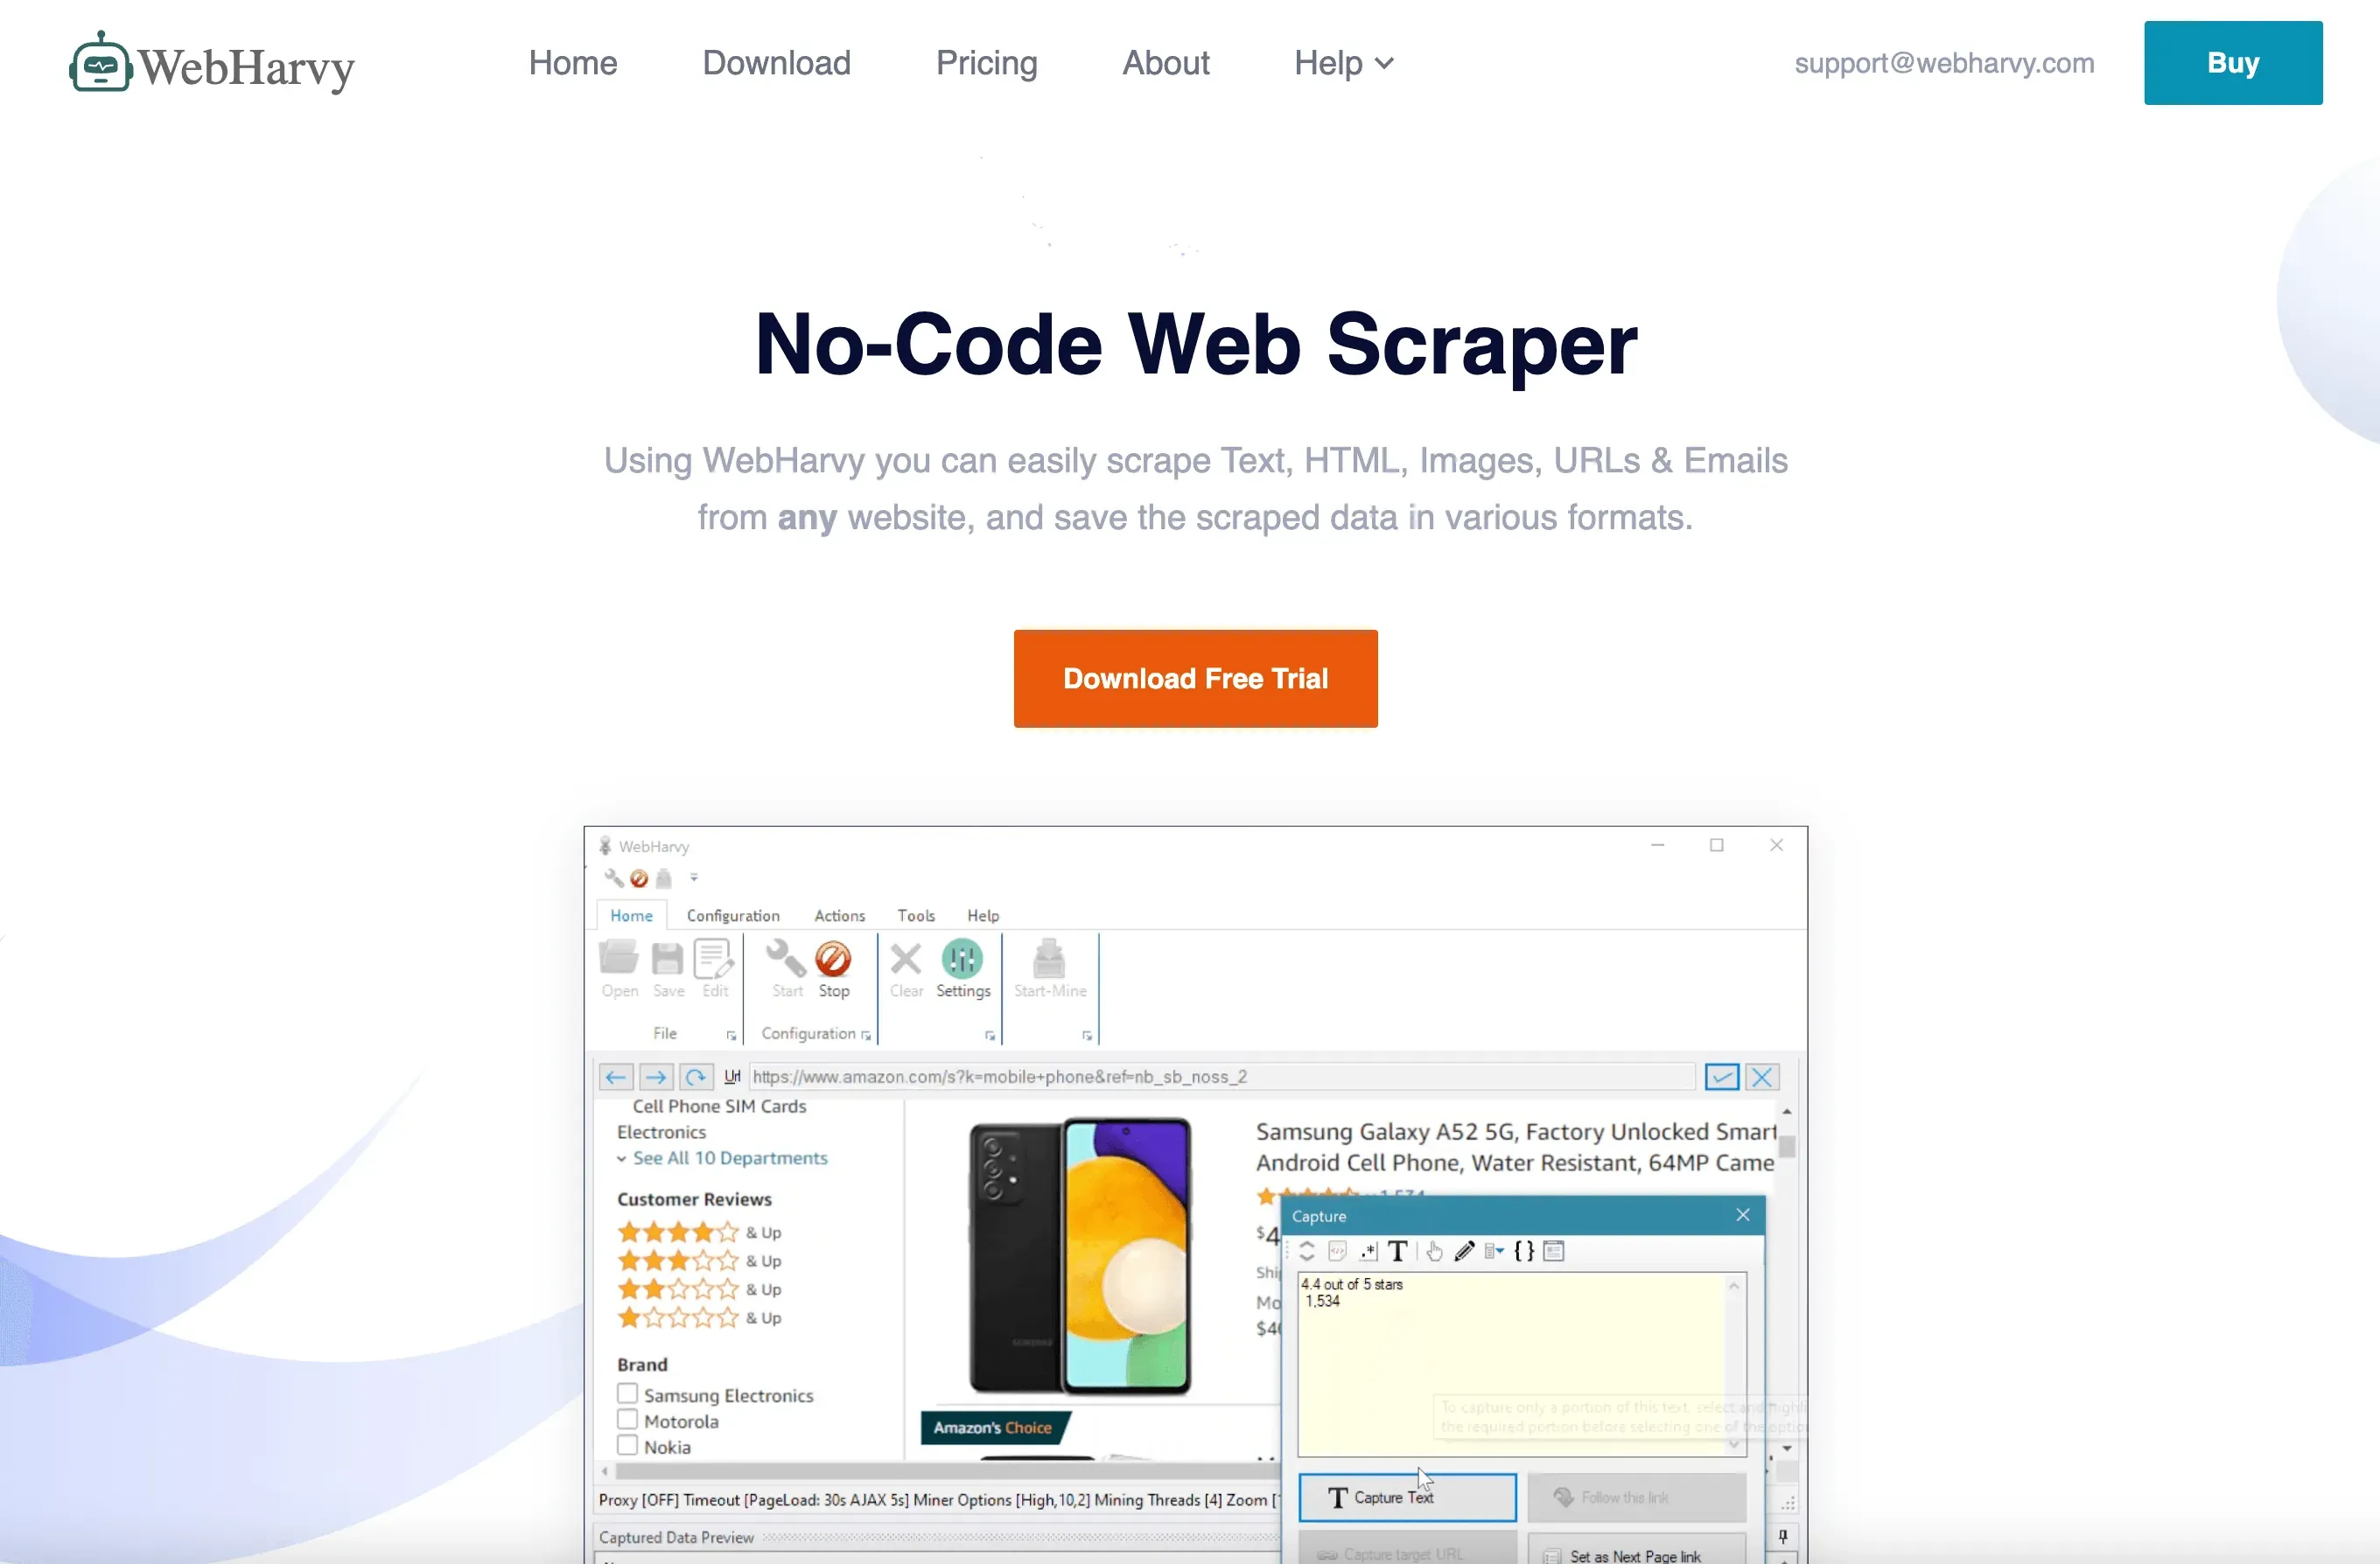 WebHarvy é um scraper de desktop para Windows com interface visual de apontar e clicar. É excelente para quem quer evitar código e prefere um aplicativo local.
Ideal para: usuários do Windows, pesquisadores e PMEs.
Principais recursos:
- Seleção visual: clique nos dados para definir campos — sem precisar programar.
- Lida com imagens e navegação entre páginas: extrai texto, imagens e segue paginação.
- Exportação para Excel, XML e bancos de dados: opções flexíveis de saída.
- Licença única: pague uma vez e use para sempre (WebHarvy).
O WebHarvy é especialmente popular para scraping em sites de e-commerce e classificados (Thunderbit Blog).
10. Mozenda
 Mozenda é uma plataforma baseada na nuvem criada para extração e automação de dados em escala corporativa.
Ideal para: grandes organizações e setores com alta exigência de conformidade.
Principais recursos:
- Automação em nuvem: agende, monitore e gerencie tarefas de scraping de forma centralizada.
- Transformação de dados: limpe, enriqueça e exporte dados em vários formatos.
- Colaboração em equipe: suporte a múltiplos usuários e gestão de fluxos.
- Suporte enterprise: conformidade, confiabilidade e atendimento dedicado (Appvizer).
Preço: cerca de US$ 99/mês; há preços corporativos disponíveis.
11. Sequentum (anteriormente Content Grabber)
 Sequentum é um scraper avançado de desktop/web voltado para profissionais de dados e agências. Se você conhecia essa solução como Content Grabber, esse nome ficou no passado — a Sequentum rebatizou o produto, e o domínio contentgrabber.com não está mais ativo (Sequentum FAQ).
Ideal para: profissionais de dados, agências e quem precisa de automação profunda.
Principais recursos:
- Script avançado: automatize lógicas de extração complexas.
- Relatórios e monitoramento: acompanhe tarefas, receba alertas e gerencie projetos grandes.
- Integração: exporte para bancos de dados, APIs ou armazenamento em nuvem.
- Sem plano gratuito: apenas licenças pagas (DataOX).
O Sequentum foi criado para extração customizável e em alto volume.
12. Helium Scraper
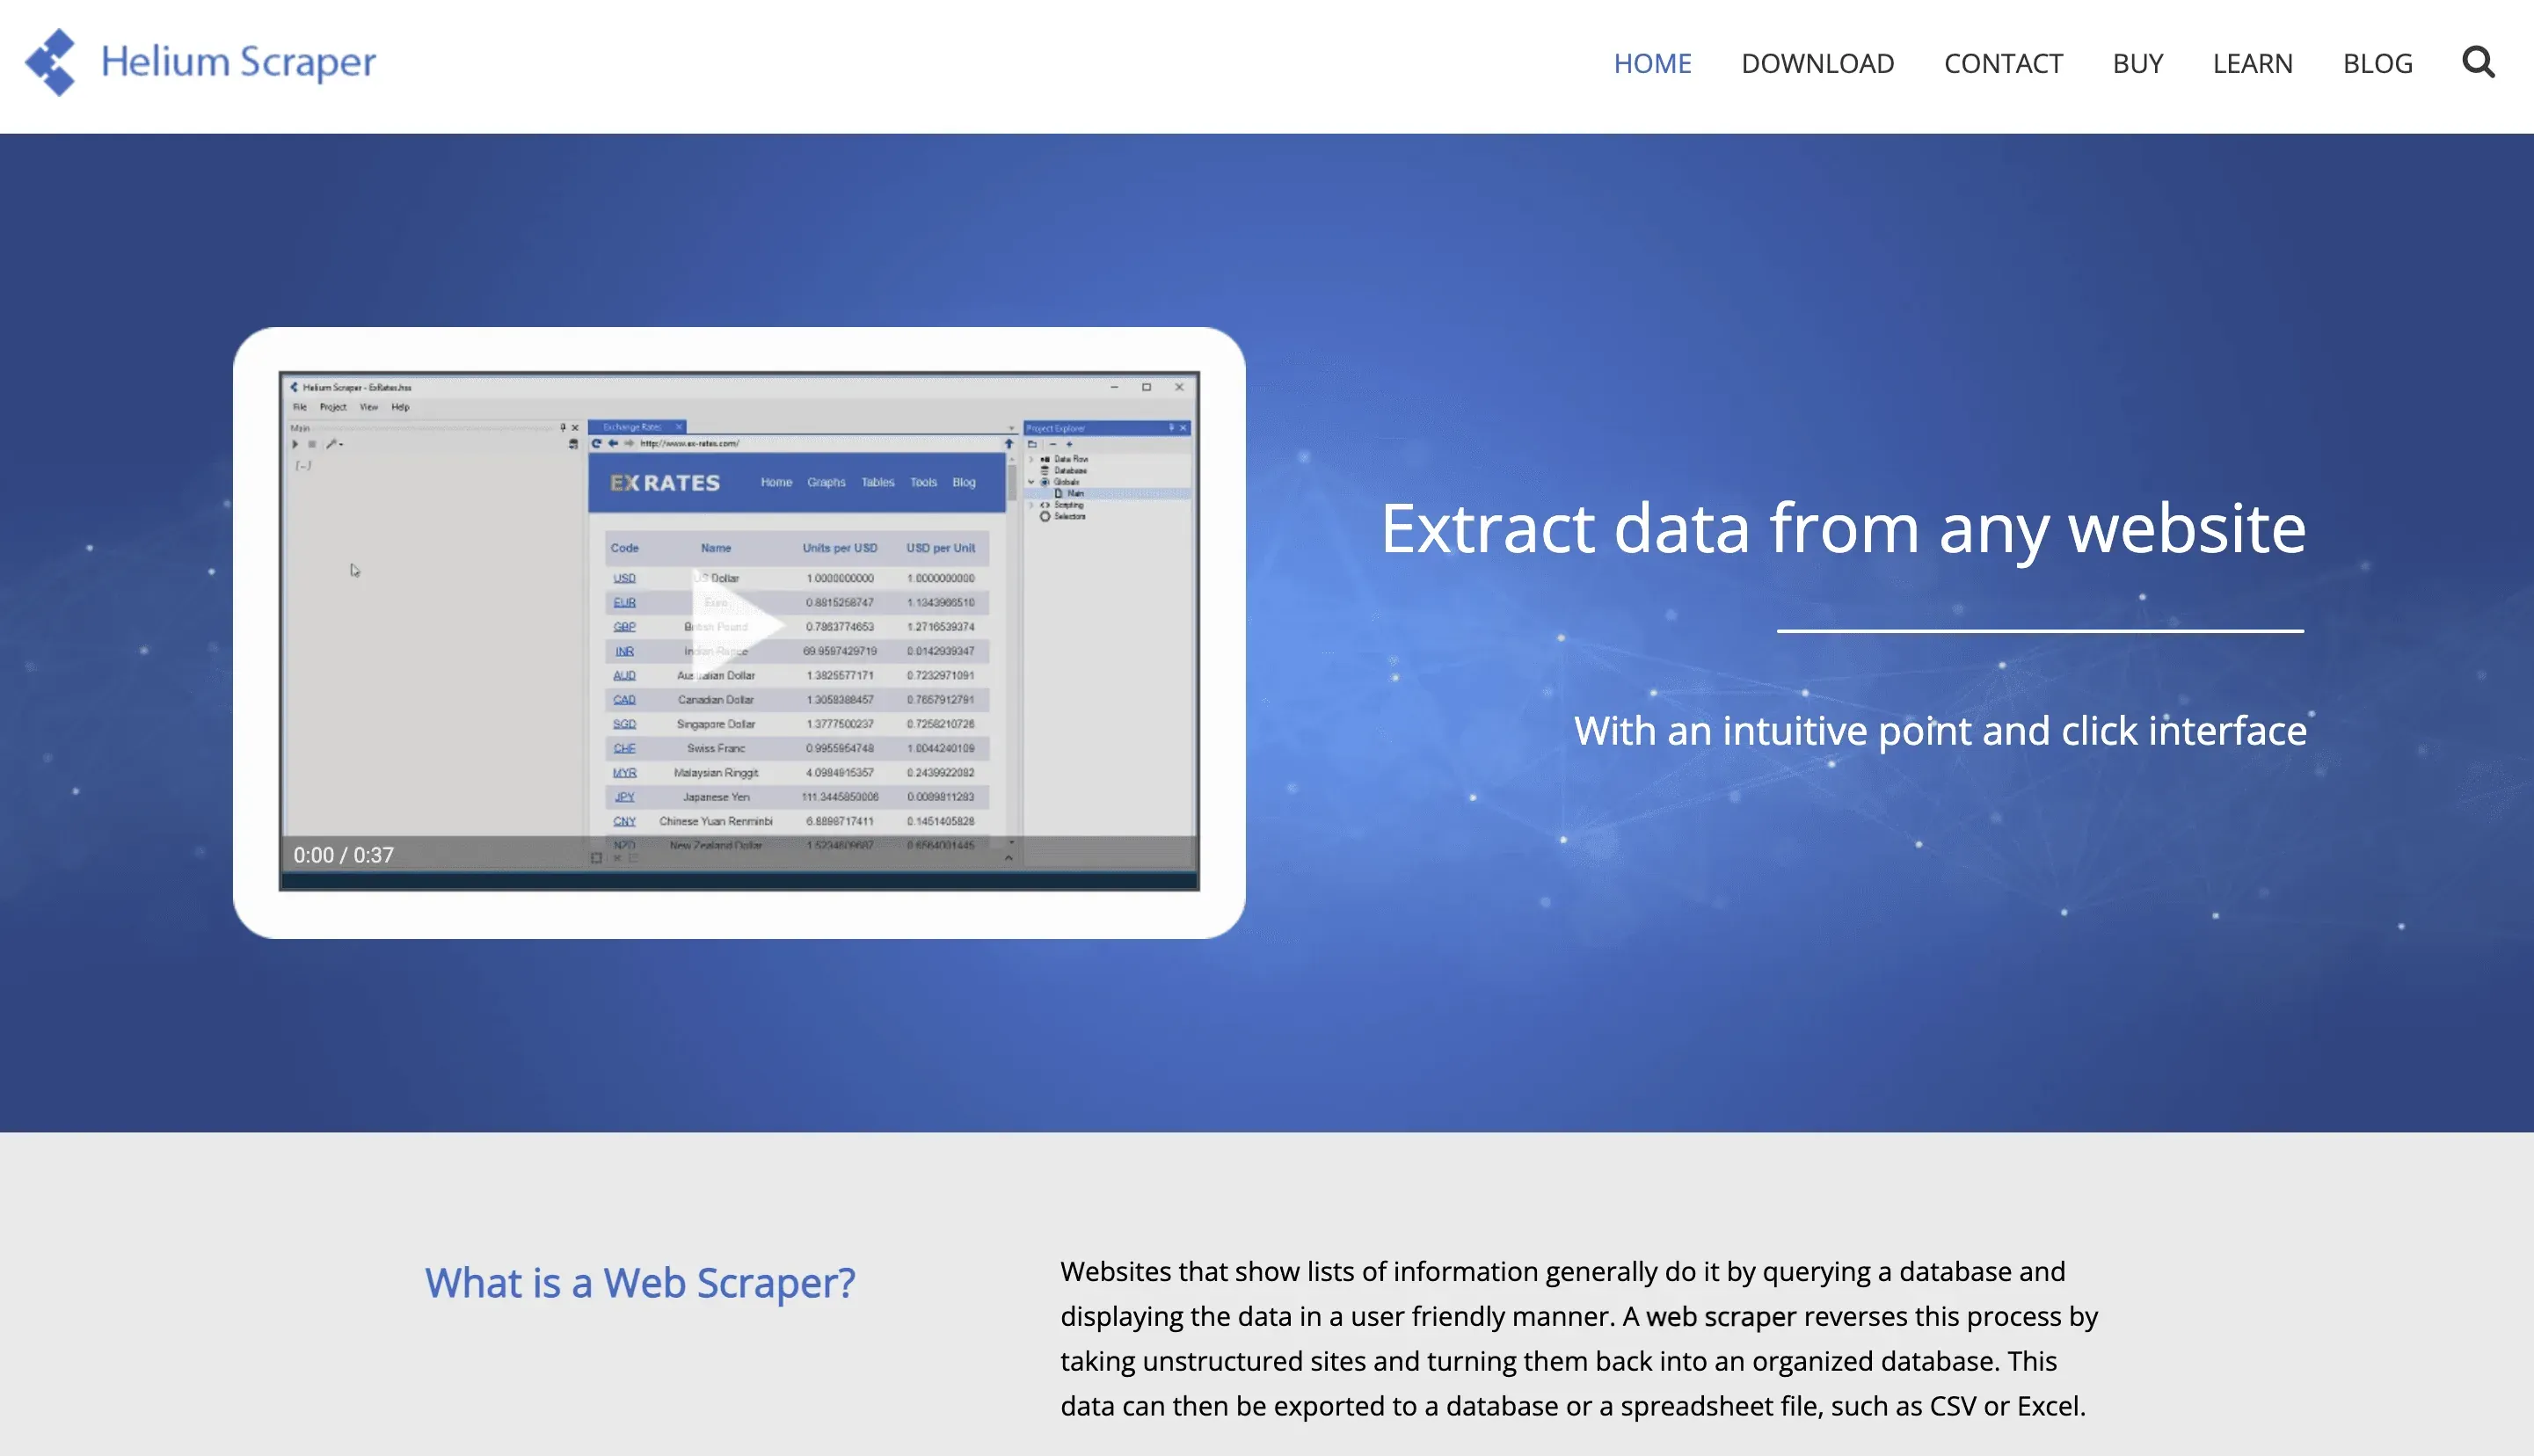 Helium Scraper é uma ferramenta de desktop com construtor visual de fluxos de trabalho, ideal para extrair dados de sites complexos e dinâmicos.
Ideal para: usuários avançados, analistas e quem quer flexibilidade sem programar.
Principais recursos:
- Fluxo de trabalho visual: interface de arrastar e soltar para construir a lógica de extração.
- Lida com conteúdo dinâmico: funciona bem com sites pesados em JavaScript.
- Transformação de dados: limpe e organize os dados antes da exportação.
- Opções de exportação: Excel, CSV, bancos de dados e mais.
- Pagamento único: licenças perpétuas vão de US$ 99 (Basic, 1 usuário) a US$ 699 (Enterprise, 10 usuários) — sem assinatura (Helium Scraper).
O Helium Scraper é especialmente bom para sites fora do padrão e fluxos personalizados.
Comparando as principais empresas de web scraping: recursos lado a lado
Aqui está uma comparação rápida para ajudar você a escolher a melhor opção:
| Empresa | Ideal para | Facilidade de uso | Automação e IA | Escalabilidade | Opções de exportação | Plano gratuito / preço |
|---|---|---|---|---|---|---|
| Thunderbit | Não programadores, PMEs | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | Excel, Sheets, Notion | Grátis (6 páginas), a partir de US$ 15/mês |
| Scrapy | Desenvolvedores | ⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | Python, CSV, DB | Grátis, open source |
| ParseHub | PMEs, pesquisadores | ⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐ | CSV, Excel, JSON | Grátis (5 projetos), US$ 189+ |
| Octoparse | Operações, marketing | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | Excel, DB, API | Grátis (10 mil linhas), US$ 69+ |
| DataMiner | Usuários do Chrome | ⭐⭐⭐⭐⭐ | ⭐⭐ | ⭐⭐ | Excel, Sheets | Grátis (500 páginas), US$ 19+ |
| Import.io | Empresas | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | API, DB, nuvem | Personalizado, US$ 199+/mês |
| Apify | Devs, agências | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | API, DB, Sheets | Créditos grátis, US$ 29+/mês |
| Diffbot | Pesquisa, analytics | ⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | API, Grafo de conhecimento | US$ 299+/mês |
| WebHarvy | Usuários do Windows | ⭐⭐⭐⭐ | ⭐⭐ | ⭐⭐ | Excel, XML, DB | Pagamento único, a partir de US$ 129 |
| Mozenda | Empresas | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | Excel, API, nuvem | US$ 99+/mês, enterprise |
| Sequentum | Profissionais de dados, agências | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | DB, API, nuvem | Apenas licença paga |
| Helium Scraper | Usuários avançados, analistas | ⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐ | Excel, CSV, DB | Pagamento único, a partir de US$ 99 |
Escolhas rápidas:
- Para quem não programa: Thunderbit, DataMiner, ParseHub, WebHarvy
- Para desenvolvedores: Scrapy, Apify, Sequentum
- Para empresas: Import.io, Diffbot, Mozenda
- Para fluxos visuais e flexíveis: Thunderbit, Octoparse, Helium Scraper
Conclusão: escolhendo o parceiro certo de web scraping para o seu negócio
Explore mais guias sobre web scraping Get Started Free
Em 2026, web scraping não é mais coisa só de gente de tecnologia — é uma capacidade central para qualquer empresa que precise de dados para tomar decisões mais inteligentes e mais rápidas. A empresa certa de web scraping pode economizar horas do seu time, aumentar seu ROI e revelar insights que seus concorrentes talvez deixem passar.
Meu conselho é este:
- Escolha a ferramenta de acordo com o seu time: usuários sem perfil técnico vão gostar do Thunderbit ou do DataMiner. Desenvolvedores devem conferir Scrapy ou Apify. Para empresas, vale olhar Import.io ou Diffbot.
- Pense em escala e integração: você vai precisar extrair milhares de páginas? Quer os dados em Sheets, Notion ou no seu CRM?
- Comece com um teste grátis: a maioria das ferramentas oferece um plano gratuito — teste em um projeto real antes de fechar.
- Não tenha medo de combinar soluções: às vezes, o melhor fluxo vem da combinação de duas ou mais ferramentas.
E, se você está pronto para ver como web scraping pode ser simples, experimente o Thunderbit. Suas planilhas — e sua sanidade — vão agradecer.
Para mais análises profundas, dicas e tutoriais, confira o Thunderbit Blog.
Comece a extrair dados com Thunderbit
Perguntas frequentes
1. O que é web scraping e por que ele é importante para empresas em 2026?
Web scraping é o processo automatizado de extrair dados de sites. Ele é crucial para empresas porque permite coletar dados em grande volume e com rapidez para geração de leads, monitoramento de preços, pesquisa de mercado e muito mais — economizando tempo e melhorando a tomada de decisão.
2. Qual empresa de web scraping é melhor para usuários sem conhecimento técnico?
Thunderbit e DataMiner são as melhores escolhas para quem não programa, graças às suas interfaces visuais e com IA. Ambas permitem extrair dados em poucos cliques, sem necessidade de código.
3. Quais recursos devo procurar em uma empresa de web scraping?
Procure facilidade de uso, automação (paginação, subpáginas, agendamento), escalabilidade, opções de exportação (Excel, Sheets, APIs) e um bom suporte ao cliente. Escolha uma ferramenta que combine com suas habilidades técnicas e necessidades de negócio.
4. Existem soluções gratuitas de web scraping?
Sim! Thunderbit, DataMiner, ParseHub e Octoparse oferecem planos gratuitos. O Scrapy é open source e gratuito para desenvolvedores. Os planos grátis são ótimos para projetos pequenos ou para testar antes de escalar.
5. Como me manter em conformidade e agir de forma ética ao coletar dados?
Respeite sempre os termos de uso e as políticas de privacidade dos sites. Extraia apenas dados publicamente disponíveis, evite sobrecarregar os sites e tenha atenção às leis de privacidade, como o GDPR. Muitas das melhores empresas de web scraping oferecem recursos de conformidade e guias de boas práticas.
Pronto para começar a extrair dados de forma mais inteligente? Experimente o Thunderbit grátis ou explore mais guias no Thunderbit Blog.
Experimente o AI Web Scraper Get Started Free
Saiba mais



