
A web nunca teve tanta sede de dados quanto agora, e em 2026 o Node.js está na dianteira para equipes que querem fazer extração de dados com mais inteligência e menos esforço. Seja você da área de vendas, ecommerce ou apenas um apaixonado por dados como eu, provavelmente já percebeu que fazer scraping hoje não é só “coletar as informações” — é fazer isso rápido, em escala e sem ter o IP bloqueado e mandado para a cadeia digital. E a demanda não está desacelerando. Os dados públicos da web viraram, discretamente, a base sobre a qual boa parte das equipes modernas constrói suas operações — de inteligência de preços a pipelines de treino de LLMs — e a concorrência nunca foi tão pesada.
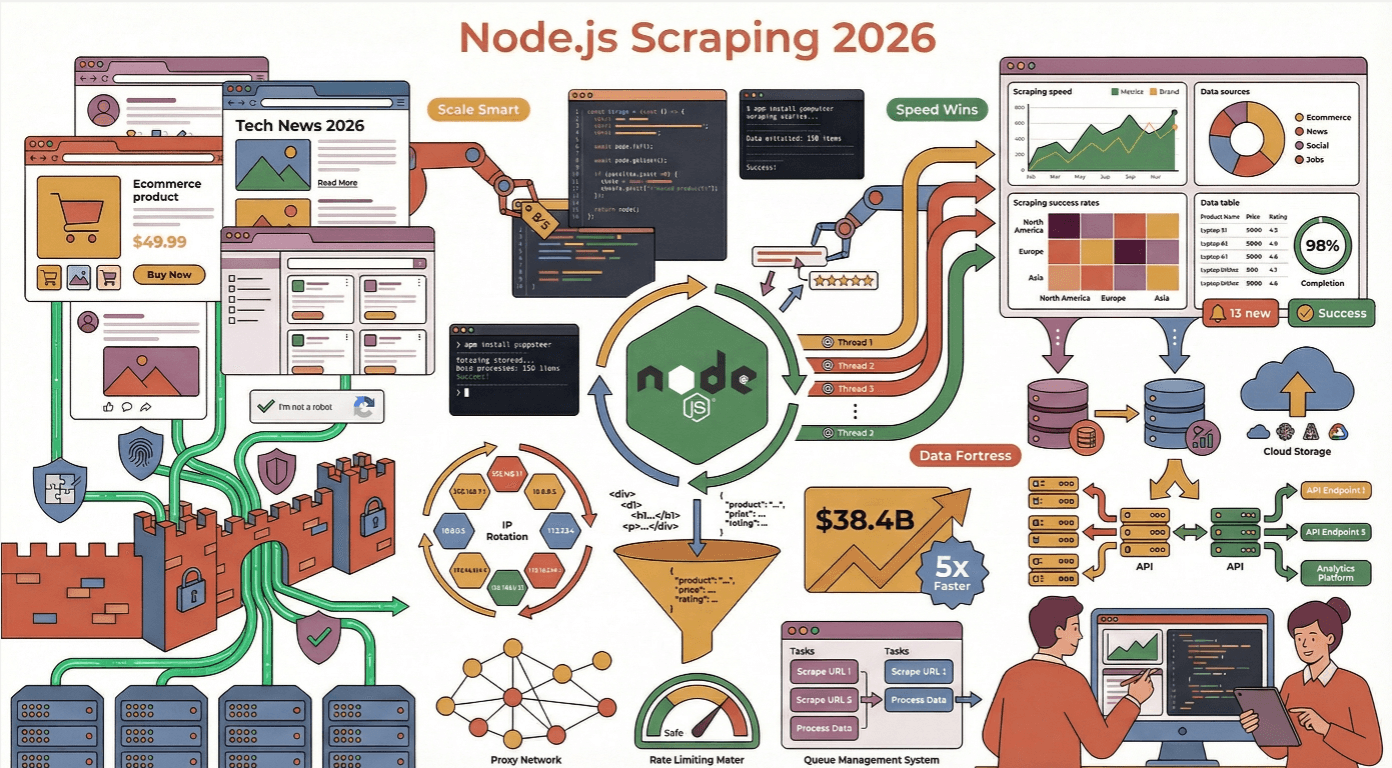
Mas aqui está o problema: a web moderna é uma fortaleza feita de conteúdo dinâmico, armadilhas anti-bot e layouts que mudam o tempo todo. Já vi mais scrapers falharem do que gostaria de admitir — quase sempre porque ignoraram boas práticas ou subestimaram o quanto essas defesas anti-scraping evoluíram. Então, vamos mergulhar nas melhores práticas reais para eficiência em web scraping com Node.js, com algumas histórias, um toque de humor e muito conselho prático.
Por que escolher Node.js para eficiência em Web Scraping?
Se você já tentou raspar centenas (ou milhares) de páginas ao mesmo tempo, sabe que velocidade e concorrência fazem toda a diferença. É aí que o Node.js brilha. Seu modelo de I/O assíncrono e não bloqueante foi feito para lidar com um volume enorme de requisições simultâneas — pense nele como o multitarefa definitivo da web (Node.js Docs). Enquanto outras linguagens ficam presas esperando cada requisição terminar, o Node.js segue girando seu event loop, administrando pedidos como um artista de circo acelerado depois de muito café.
Já vi o Node.js superar Python e Java em cenários que exigem atualizações em tempo real e extração em grande escala, especialmente quando os sites-alvo usam bastante JavaScript. Na prática, ~40% dos desenvolvedores já usam Node.js para backend e automação, tornando-o uma das tecnologias web mais populares do mundo.
Node.js vs. Outros Frameworks de Web Scraping
Vamos ficar um pouco nerd por um instante. Veja como o Node.js se compara com a concorrência:
| Framework | Pontos fortes | Pontos fracos | Melhores casos de uso |
|---|---|---|---|
| Node.js | Assíncrono, ótimo para concorrência, enorme ecossistema npm, JS nativo para sites dinâmicos | Pode consumir muita memória, “callback hell” se não usar async/await | Scraping em tempo real, sites pesados em JS, microsserviços escaláveis |
| Python | Muitas bibliotecas de scraping (BeautifulSoup, Scrapy), sintaxe simples | Mais lento em concorrência massiva, sofre com sites renderizados em JS | HTML estático, pesquisa, prototipação |
| Java | Tipagem forte, robusto para ambientes corporativos | Verboso, menos flexível para scripts rápidos | Scraping em grande escala, nível enterprise |
| Go | Rápido, concorrência eficiente | Ecossistema menor, curva de aprendizado mais íngreme | Scraping de alto desempenho e baixa latência |
Para a maioria dos usuários de negócio, o Node.js encontra o ponto ideal: rápido, flexível e totalmente alinhado com a web moderna baseada em JavaScript (Thunderbit Blog).
Configurando um ambiente robusto de Web Scraping com Node.js
Todo bom scraper começa com uma base sólida. Este é o meu setup preferido:
- Estrutura do projeto: mantenha tudo modular. Use pastas como
/src,/libse/config. Guarde informações sensíveis, como API keys e proxies, em variáveis de ambiente comdotenv(Thunderbit Guide). - Cliente HTTP: use axios, got ou node-fetch para as requisições.
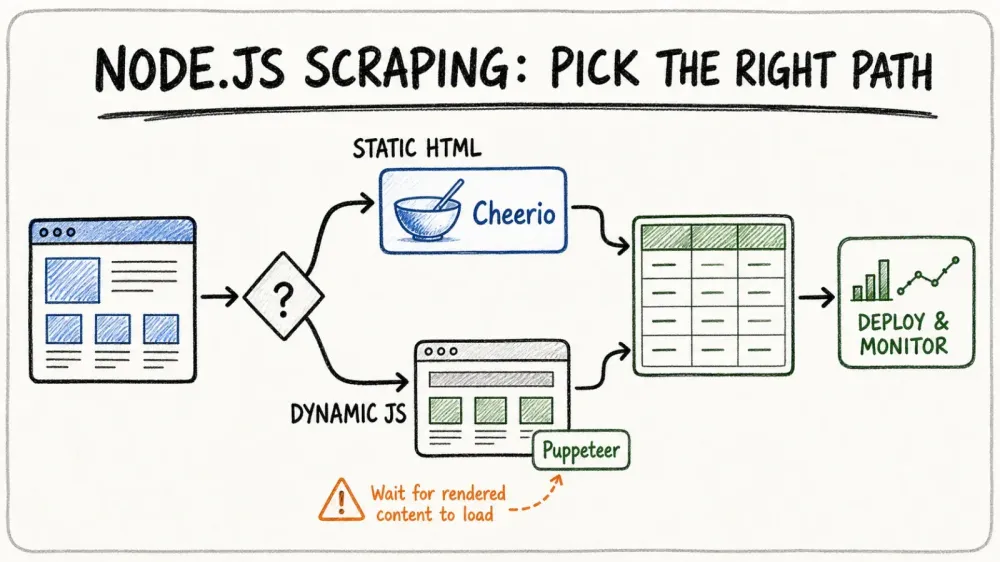
- Parsing de HTML: Cheerio para HTML estático, Puppeteer ou Playwright para conteúdo dinâmico.
- Utilitários: use Lodash para tratar os dados, e validator.js ou Joi para validação.
- Testes e linting: Mocha para testes, ESLint para qualidade de código (LogRocket).
Bibliotecas essenciais de Web Scraping com Node.js
- Clientes HTTP (axios / got /
fetchnativo): para fazer requisições. Vale destacar logo de cara: desde o Node.js v18 você pode usarfetchnativamente, sem instalar nada, e o Node.js v22 o tornou estável. Em um projeto novo numa versão recente do Node, você provavelmente nem precisa do pacotenode-fetch— basta chamarfetchdiretamente. Eu ainda prefiro axios quando quero interceptors, JSON automático e uma API de promises familiar tanto no Node quanto no navegador, e got quando preciso de retries, streams ou HTTP/2 pronto para uso. Escolha o que melhor combina com seu stack; para um script rápido, ofetchnativo resolve. - Cheerio: parser de HTML rápido, com pegada parecida com jQuery. Perfeito para páginas estáticas — analisa em cerca de 0,5 s (Oxylabs).
- Playwright / Puppeteer: automação de navegador headless para sites dinâmicos e pesados em JS. É mais lento (~4 s por página), mas essencial para páginas que carregam conteúdo após o load (Bright Data). Se você está começando do zero em 2026, Playwright é a escolha padrão — funciona em vários navegadores de saída (Chromium / Firefox / WebKit), traz trace viewer integrado, e a equipe que criou o Puppeteer hoje também impulsiona seu desenvolvimento na Microsoft. O Puppeteer ainda é mantido para trabalhos focados em Chrome, mas faz tempo que suas notas de versão têm ficado mais centradas em compatibilidade com Chrome do que em novidades.
- dotenv: para gerenciar variáveis de ambiente.
- csv-writer/jsonfile: para exportação de dados.
Evitando armadilhas comuns no Web Scraping com Node.js
Já perdi a conta de quantas vezes vi scrapers sendo bloqueados, travando ou simplesmente cuspindo uma bagunça de dados. Fique atento a isto:
- Ignorar robots.txt e os Termos de Serviço: sempre verifique antes de fazer scraping. Violar essas regras pode bloquear seu IP — ou pior, colocar você em encrenca jurídica (ScraperAPI).
- Sobrecarregar servidores: não dispare requisições sem controle. Limite a velocidade do scraper com atrasos aleatórios (1–3 segundos), use controle de concorrência e evite agir como um robô histérico (ScrapeGraphAI).
- Não tratar erros: sempre envolva as requisições em try/catch, lide com erros HTTP e registre falhas. Refaça erros transitórios com exponential backoff (ScrapeGraphAI).
- Esquecer headers da requisição: use User-Agent realistas e faça rotação deles. Adicione Accept-Language, Referer e outros headers para simular navegadores de verdade (ScrapeGraphAI).
Como contornar mecanismos anti-scraping
Os sites modernos estão fortemente armados com tecnologias anti-bot. Veja como eu desvio dessas armadilhas digitais:
- Rotação de proxies/IPs: use um pool de proxies e alterne os IPs para evitar bloqueios (Medium).
- Randomização de headers: altere User-Agent, Accept-Language e outros headers a cada requisição.
- Stealth em navegador headless: use plugins como
puppeteer-extra-plugin-stealthpara esconder sinais de automação. - Simulação de comportamento humano: adicione atrasos aleatórios, movimentos de mouse, rolagem e até erros de digitação (ZenRows).
Simulando comportamento humano em scrapers Node.js
Aqui a coisa fica divertida — e um pouco estranha. Em vez de clicar e rolar imediatamente, programe o scraper para:
- Esperar intervalos aleatórios entre ações (
await page.waitForTimeout(randomDelay)) - Mover o mouse em pequenos passos irregulares (
page.mouse.move(x, y)) - Digitar com atrasos aleatórios e pequenos erros de digitação (
page.type(selector, text, {delay: random(100,200)})) - Rolar de forma desigual, sem simplesmente ir direto até o fim
Esses truques podem aumentar bastante sua taxa de sucesso em sites protegidos (ScraperAPI).
Simplificando a extração de dados complexos com Thunderbit
Extraia dados de qualquer site usando IA Elimine o código repetitivo: o web scraper agentic do Thunderbit lê qualquer página e extrai os dados em um clique, sem manter código Node.js. Get Started Free
Agora vamos falar do elefante na sala: fazer scraping é difícil. Mas não precisa ser. É por isso que criamos o Thunderbit.
O Thunderbit é uma extensão Chrome de web scraper agentic que permite extrair dados de qualquer site usando linguagem natural. Basta clicar em “One Click Extract”, deixar a IA entender o que há na página e apertar “Scrape”. É como ter um desenvolvedor júnior que nunca dorme e nunca pede aumento.
E o melhor: o Thunderbit oferece uma API, então você pode integrá-lo diretamente aos seus fluxos de trabalho em Node.js. Em vez de escrever milhares de linhas de código de scraping, você deixa o Thunderbit cuidar da parte pesada — conteúdo dinâmico, subpáginas, paginação e tudo mais. Depois é só puxar os dados estruturados (CSV, JSON ou direto para Google Sheets, Airtable e Notion) e seguir o dia (Thunderbit Blog).
Teste a extensão Chrome do Thunderbit grátis Instale a extensão gratuita do Chrome e extraia dados estruturados em um clique — ou chame a API do Thunderbit a partir do seu app Node.js. Get Started Free
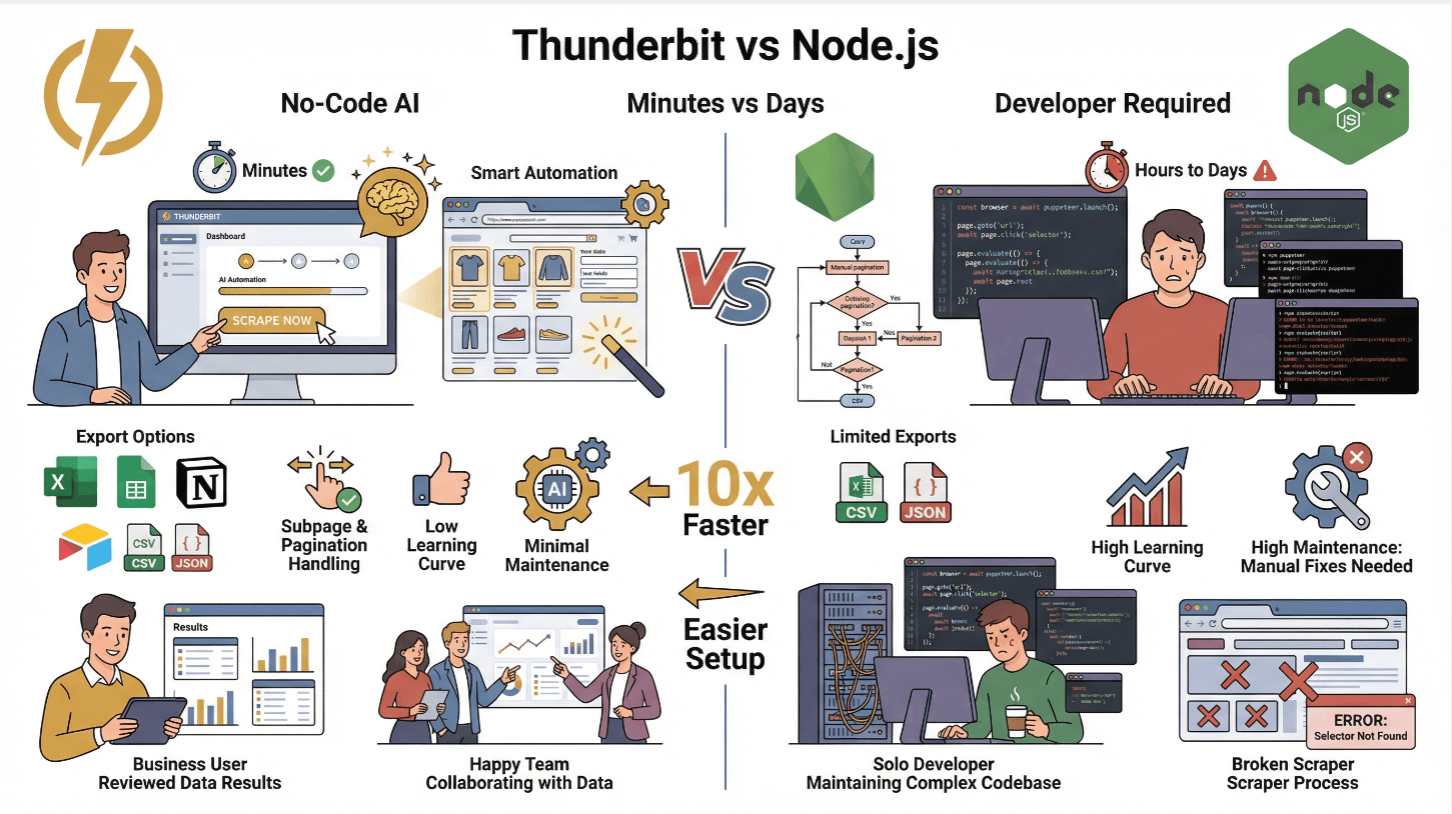
Thunderbit vs. scraping tradicional em Node.js
| Recurso | Thunderbit | Scraper tradicional em Node.js |
|---|---|---|
| Tempo de configuração | Minutos (sem código) | Horas ou dias (codificação, testes) |
| Lida com conteúdo dinâmico | Sim (IA + navegador) | Sim (com Puppeteer/Playwright) |
| Subpáginas e paginação | 1 clique | Exige codificação manual |
| Exportação de dados | Excel, Sheets, Notion, Airtable, CSV, JSON | CSV/JSON (código personalizado) |
| Curva de aprendizado | Baixa (usuários de negócio) | Alta (desenvolvedores) |
| Manutenção | Mínima (a IA se adapta) | Alta (ajustes manuais quando o site muda) |
O Thunderbit é perfeito para equipes não técnicas ou para quem quer pular o trabalho braçal e ir direto para os insights. Para usuários avançados, também dá para usar a API do Thunderbit para automatizar scraping em escala (Thunderbit Docs).
Combinando Cheerio e Puppeteer para conteúdo dinâmico
Esse é o meu combo favorito para scraping em Node.js. Funciona assim:
- Use Puppeteer para carregar a página e executar JavaScript (aguarde
networkidlepara garantir que todo o conteúdo foi carregado). - Capture o HTML com
await page.content(). - Faça o parsing com Cheerio: passe o HTML para o Cheerio para uma extração ultrarrápida com estilo jQuery.
Essa abordagem híbrida entrega o melhor dos dois mundos: a força do Puppeteer para conteúdo dinâmico e a velocidade do Cheerio para o parsing (Browserless).
Dica de performance: selecione apenas os elementos de que você realmente precisa. O Cheerio carrega o DOM inteiro na memória, então evite seletores amplos e faça cache dos resultados se for raspar as mesmas páginas repetidamente (Oxylabs).
Otimizando parsing de HTML e extração de dados
- Use seletores específicos: evite
$('body *')— foque só no que importa. - Faça streaming de páginas grandes: para HTML muito grande, considere streaming ou dividir a tarefa.
- Cache do HTML renderizado: se você revisita URLs, armazene o HTML para evitar requisições redundantes.
- Valide e limpe os dados: use bibliotecas de validação para não encher o banco com lixo (ScrapeGraphAI).
Implantação escalável de um Web Scraper em Node.js na nuvem
Quer raspar em escala? Hora de ir para a nuvem.
- Crie uma imagem Docker do seu scraper: escreva um
Dockerfile, copie o código, instale as dependências e defina o entrypoint. - Faça deploy na nuvem: use AWS EC2, Google Cloud Compute ou Azure VMs para tarefas simples. Para escala séria, use Kubernetes ou serviços gerenciados como AWS ECS/EKS, Google Cloud Run ou Azure Kubernetes Service (DigitalOcean).
- Orquestre com Kubernetes: execute vários pods, faça autoscaling conforme a demanda e use balanceadores de carga para distribuir URLs.
- Agende tarefas: use schedulers da nuvem (CloudWatch Events, Cloud Scheduler) ou jobs cron para disparar as raspagens em intervalos.
Em um exemplo real, escalar de 5 para 10 pods no Kubernetes reduziu uma raspagem de 400 páginas de vários minutos para menos de um minuto (DigitalOcean).
Monitorando e fazendo auto-scaling da infraestrutura de scraping
- Logs: envie os logs para CloudWatch, Stackdriver ou Datadog. Configure alertas para erros ou lentidão.
- Health checks: use Prometheus e Grafana para métricas como páginas raspadas por minuto, taxa de erro e saúde dos pods.
- Auto-scaling: configure o HPA do Kubernetes (Horizontal Pod Autoscaler) para aumentar ou reduzir pods com base em CPU ou número de requisições.
Implemente sempre retries com exponential backoff para se recuperar de falhas de rede ou bloqueios temporários.
Melhores práticas para armazenamento e pós-processamento dos dados
Depois de coletar os dados, é hora de armazenar e limpar:
- Pequenos projetos: exporte para CSV, JSON ou envie para Google Sheets, Airtable ou Notion (o Thunderbit faz isso nativamente).
- Projetos grandes: use SQL (MySQL/PostgreSQL) para dados estruturados, ou NoSQL (MongoDB, DynamoDB) para esquemas semiestruturados ou em evolução (ScrapeHero).
- Armazenamento em nuvem: S3 ou Google Cloud Storage para arquivos brutos e backups.
- Limpeza de dados: sempre valide campos, normalize formatos (datas, números) e remova duplicidades. Use validadores de esquema para garantir a qualidade dos dados (ScrapeGraphAI).
Guarde tanto os dados brutos quanto os limpos — nunca se sabe quando será preciso reprocessar ou depurar.
Conclusão: principais aprendizados sobre eficiência em Web Scraping com Node.js
Pule o código do scraper Veja como o web scraper agentic do Thunderbit se compara a escrever e manter seus próprios scripts de scraping. Get Started Free
Vamos fechar com o essencial:
- Aproveite o poder assíncrono do Node.js para scraping massivo e concorrente — especialmente em sites pesados em JS.
- Combine as ferramentas certas: use axios/got para requisições, Cheerio para HTML estático, Puppeteer para conteúdo dinâmico e misture tudo para ganhar velocidade e flexibilidade.
- Evite armadilhas anti-bot: alterne proxies e headers, simule comportamento humano e respeite o robots.txt.
- Simplifique com Thunderbit: para usuários de negócio ou prototipagem rápida, o Thunderbit permite extrair dados complexos com IA e conectá-los ao seu stack Node.js via API.
- Faça deploy em escala: use Docker, orquestre com Kubernetes e monitore tudo para garantir confiabilidade.
- Armazene e limpe seus dados: escolha o armazenamento certo para sua necessidade e valide sempre antes de usar.
A web não está ficando mais simples, mas com essas boas práticas seus scrapers em Node.js podem continuar rápidos, confiáveis e sempre um passo à frente da corrida anti-bot. E se algum dia você se cansar de depurar seletores às 2 da manhã, lembre-se: a IA do Thunderbit está sempre acordada.
Quer continuar aprendendo? Confira o Thunderbit Blog para mais análises profundas, ou teste a extensão Chrome do Thunderbit para ver como o scraping pode ser fácil.
Faça scraping com o web scraper agentic do Thunderbit A Web Scraper API do Thunderbit permite disparar extrações a partir do seu próprio código Node.js, com um plano gratuito para começar. Get Started Free
Perguntas frequentes
1. Por que o Node.js é especialmente bom para web scraping em 2025?
O modelo assíncrono e orientado a eventos do Node.js permite lidar com milhares de requisições simultâneas, tornando-o ideal para extrair grandes volumes de dados ou atualizações em tempo real. Seu enorme ecossistema npm e o suporte nativo a JavaScript são perfeitos para sites modernos e pesados em JS (Node.js Docs).
2. Como evitar bloqueios ao fazer scraping com Node.js?
Use proxies rotativos, varie os headers da requisição, limite a frequência com atrasos aleatórios e simule comportamento humano (movimento do mouse, rolagem, digitação) com ferramentas como Puppeteer. Sempre respeite o robots.txt e os termos do site (Medium).
3. Quando devo usar Cheerio em vez de Puppeteer no meu scraper em Node.js?
Use Cheerio para analisar rapidamente HTML estático, quando os dados já estão no HTML bruto. Use Puppeteer para sites que carregam conteúdo dinamicamente com JavaScript. Para melhores resultados, use Puppeteer para renderizar a página e depois Cheerio para analisar o HTML (Bright Data).
4. Como o Thunderbit simplifica o web scraping com Node.js?
O Thunderbit permite extrair dados estruturados de qualquer site usando IA e comandos em linguagem natural — sem necessidade de programação. Ele lida com conteúdo dinâmico, subpáginas e paginação, e oferece uma API para integração com Node.js. Os dados podem ser exportados diretamente para Excel, Google Sheets, Airtable ou Notion (Thunderbit Blog).
5. Qual é a melhor forma de escalar e monitorar scrapers em Node.js na nuvem?
Coloque seu scraper em Docker, faça deploy em Kubernetes ou em serviços gerenciados da nuvem e use autoscaling para lidar com picos de demanda. Monitore logs e métricas com ferramentas como CloudWatch ou Prometheus e configure alertas para erros ou lentidão (DigitalOcean).
Pronto para elevar seu web scraping? Experimente o Thunderbit e que seus scrapers sejam rápidos, discretos e sempre um passo à frente.
Experimente o web scraper agentic Get Started Free
Saiba mais
- Como dominar o web scraping com Node para iniciantes: guia passo a passo
- Como extrair dados de sites com eficiência usando as melhores ferramentas
- Como rastrear um site com eficiência: guia passo a passo
- Como dominar o crawling em JavaScript: guia para iniciantes
- Como dominar o web scraping para comparação de preços em 2026




