
De vez em quando, alguém no Reddit posta a mesma reclamação com uma pequena variação: “Extraí dados do Yellow Pages e recebi 500 linhas com números de telefone e endereços… mas nenhum e-mail.” Essa é a frustração mais comum que vejo nas comunidades de geração de leads e, depois de anos criando ferramentas de automação na Thunderbit, posso dizer com segurança que o problema é estrutural, não uma coincidência.
A maioria dos scrapers de Yellow Pages coleta o que aparece na página de resultados — nome da empresa, telefone, endereço e, talvez, um link para o site. Mas e-mails? Quase nunca estão no cartão da listagem. Eles ficam escondidos nas páginas individuais de perfil da empresa, ou simplesmente não existem no Yellow Pages.
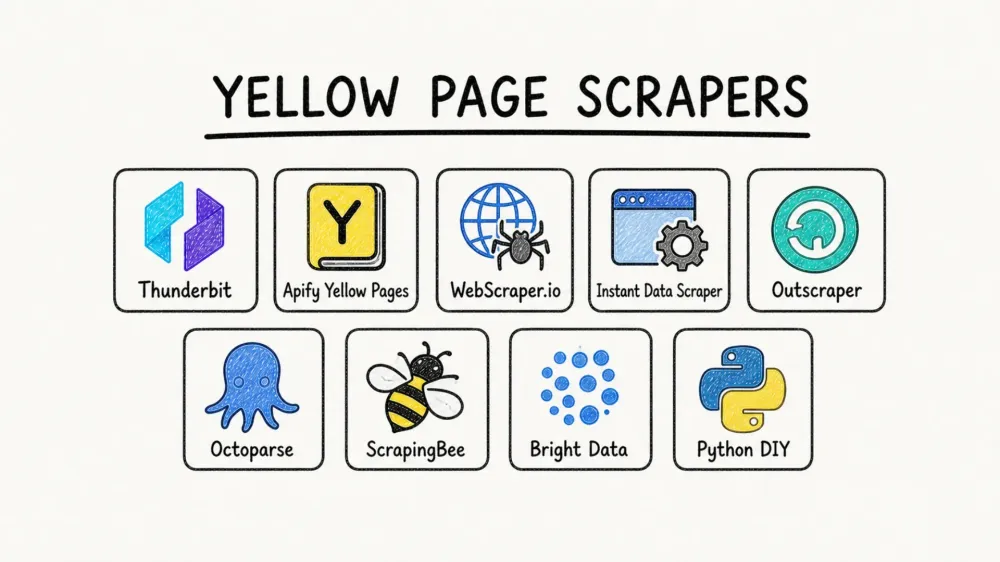
Então, se o seu scraper não visita essas subpáginas, você está deixando passar os dados de contato mais valiosos. Este artigo reúne 9 ferramentas que pesquisei e avaliei com um critério bem específico: realmente entregar e-mails do Yellow Pages — e não só telefones e CEPs. Também vou falar sobre tratamento anti-bot, preços e qual ferramenta faz mais sentido para cada tipo de usuário.
Por que a maioria dos scrapers de Yellow Pages falha ao buscar e-mails
Antes de entrar nas ferramentas, vale entender por que esse problema existe.
As páginas de listagem do Yellow Pages são feitas para mostrar telefone, endereço, horário de funcionamento e links para o site. E-mail não é um campo padrão no cartão de resultados. A documentação e os exemplos de páginas de scraping deixam isso bem claro: o e-mail normalmente não aparece no cartão da listagem e precisa ser encontrado na página de perfil individual da empresa ou no próprio site da empresa.
O ParseBird Yellow Pages Scraper da Apify é incomumente transparente sobre isso. Ele separa “modo de listagem” de “modo detalhado” e informa que a taxa de retorno de e-mails costuma ser de apenas 15–25% das listagens, mesmo quando a extração da página de detalhes está ativada. Isso significa que, mesmo no melhor cenário, recuperar e-mails do Yellow Pages é limitado — e a maioria das ferramentas nem tenta.
Existem três formas comuns de falha:
- O scraper lê só a página de resultados. Sem entrar nas subpáginas, não há e-mail.
- O scraper acessa a página de detalhes, mas não interpreta o campo de e-mail. Ainda assim, nada de e-mail.
- A empresa nunca publicou um e-mail no Yellow Pages. Nenhuma ferramenta consegue extrair o que não existe.
Algumas empresas também direcionam o contato por formulários ou botões do tipo “Email Business” em vez de mostrar um endereço de e-mail em texto puro. Nesse caso, o scraper pode até estar funcionando direito e ainda assim entregar um resultado com 95% de telefones e endereços.
A conclusão é simples: se extrair e-mails é importante para você, o recurso decisivo é scraping de subpáginas — a capacidade de visitar a página de detalhes de cada empresa e coletar dados que não aparecem na listagem principal.
O que procurar nos melhores scrapers de Yellow Pages
Avaliei todas as 9 ferramentas com base em sete critérios, todos ligados a dores reais que aparecem em threads do Reddit, fóruns de scraping e comunidades de geração de leads.
Confiabilidade na extração de e-mails
Esse é o motivo de este artigo existir. A ferramenta realmente devolve endereços de e-mail ou só nomes e telefones? O recurso principal é o scraping de subpáginas — visitar o perfil de cada empresa para encontrar e-mails escondidos no cartão da listagem.
Tratamento anti-bot e de bloqueios
O Yellow Pages usa Cloudflare Bot Management, incluindo exigência de renderização de JavaScript, fingerprint do navegador, limitação de requisições e desafios de CAPTCHA. Um teste em tempo real que fiz em 27 de abril de 2026 retornou uma página de bloqueio do Cloudflare em poucos segundos. Ferramentas que não lidam com isso nativamente vão te deixar encarando páginas de erro.
Preço e disponibilidade de plano gratuito
Vários usuários do Reddit pedem especificamente “scrapers gratuitos ou baratos, de preferência.” Existe uma divisão real entre extensões de navegador totalmente gratuitas, ferramentas em nuvem com créditos iniciais e plataformas empresariais com preços sob consulta.
Suporte à paginação
O Yellow Pages mostra cerca de 30 resultados por página, e buscas amplas podem retornar 500–2.000+ resultados. Um scraper sem paginação automática captura só uma fração dos dados disponíveis.
Opções de exportação
Times de vendas precisam de saída pronta para CRM: CSV, Excel, Google Sheets, Airtable. Algumas ferramentas exportam apenas JSON ou HTML bruto, o que exige processamento extra antes de usar os dados.
Nível de conhecimento técnico exigido
O público é dividido. Representantes de vendas e donos de agência querem ferramentas de dois cliques. Desenvolvedores querem acesso via API e flexibilidade com Python. Classifiquei cada ferramenta de Iniciante a Especialista.
Lead scoring e enriquecimento de dados
Como um usuário do Reddit colocou: “dados brutos sem pontuação são só uma planilha.” Ferramentas que conseguem rotular, categorizar ou enriquecer os dados durante a extração economizam horas de pós-processamento.
Melhores scrapers de Yellow Pages em resumo
A comparação completa das 9 ferramentas está abaixo. Guia rápido dos símbolos: ✅ significa que a ferramenta faz isso muito bem sem configuração extra, ⚠️ significa que é possível, mas exige ajustes ou tem limitações, e ❌ significa que a ferramenta não oferece isso de forma nativa.
| Ferramenta | Tipo | Plano gratuito | E-mails? | Anti-bot | Paginação | Nível técnico | Formatos de exportação | Ideal para |
|---|---|---|---|---|---|---|---|---|
| Thunderbit | Extensão Chrome + nuvem | ✅ (6 páginas/mês) | ✅ (subpágina + extrator de e-mail) | ✅ Alternância nuvem/navegador | ✅ Automática | Iniciante | Excel, CSV, JSON, Sheets, Airtable, Notion | Times de vendas e operações sem perfil técnico |
| Apify YP Scraper | Actor em nuvem | ✅ ($5 em créditos) | ⚠️ 15–25% com páginas de detalhes | ✅ Pool de proxies | ✅ Integrada | Intermediário | JSON, CSV, Excel, XML | Scraping em escala na nuvem |
| WebScraper.io | Extensão Chrome + nuvem | ✅ (extensão grátis) | ⚠️ Configuração manual | ✅ Planos em nuvem | ✅ Baseada em seletores | Intermediário | CSV, XLSX, JSON, Sheets | Usuários de scraper visual |
| Instant Data Scraper | Extensão Chrome | ✅ Totalmente grátis | ❌ Pouco confiável | ❌ Nenhum | ⚠️ Manual | Iniciante | CSV, XLSX | Extrações rápidas e pontuais |
| Outscraper | API/Nuvem | ✅ (500 empresas) | ⚠️ Precisa de enriquecimento | ✅ Gerenciado | ✅ Automática | Iniciante–Intermediário | CSV, JSON, XLSX | Projetos de diretórios com orçamento controlado |
| Octoparse | App desktop + nuvem | ✅ (10 tarefas, 50 mil/mês) | ⚠️ Baseado em template | ✅ Nativo | ✅ Auto-detect | Intermediário | CSV, Excel, JSON, bancos de dados | Scraping visual no desktop |
| ScrapingBee | API | ✅ (1.000 chamadas) | ❌ Apenas HTML bruto | ✅ Gerenciado | ❌ Manual | Avançado | JSON, HTML | Desenvolvedores que precisam de HTML renderizado |
| Bright Data | Plataforma | ✅ (5 mil registros/mês) | ✅ Produtos de dados | ✅ Nível enterprise | ✅ Nativo | Avançado | JSON, CSV, NDJSON, S3 e mais | Escala corporativa |
| Python DIY | Código | ✅ Grátis (open source) | ⚠️ Parsing manual | ❌ Gerenciado por você | ❌ Manual | Especialista | Qualquer um | Engenheiros com necessidades customizadas |
1. Thunderbit — Melhor scraper de Yellow Pages para equipes não técnicas

Experimente a Thunderbit para scraping de Yellow Pages
Thunderbit é uma extensão do Chrome com IA que minha equipe e eu criamos para tornar o web scraping acessível para quem não é desenvolvedor. Em vez de configurar seletores CSS ou escrever código, você clica uma vez e a IA lê a página, identifica quais dados estão disponíveis e os extrai automaticamente. Ou, se você já souber exatamente o que quer, basta descrever isso para a IA e ela trabalha a partir da sua instrução. É isso — um clique para transformar página em dados estruturados.
No caso específico do Yellow Pages, o fluxo resolve o problema dos e-mails de frente. Depois de extrair a página de listagem, você pode estender a extração para as subpáginas, e a Thunderbit visita a página de detalhes de cada empresa para encontrar e-mails, URLs do site, horário de funcionamento, avaliações e outros campos que não aparecem no cartão principal. Também criamos um Extrator de Email e um Extrator de Número de Telefone dedicados, como ferramentas independentes, para que você possa usá-los em qualquer página com um único clique.
Como a Thunderbit lida com a extração de e-mails do Yellow Pages
O grande diferencial é o scraping de subpáginas. A maioria dos scrapers para na página de resultados e devolve só o que está visível — o que, no Yellow Pages, significa nenhum e-mail. O recurso de subpáginas da Thunderbit visita o perfil de cada empresa e coleta dados dessa camada mais profunda. Você também pode usar o Field AI Prompt para adicionar instruções como “extraia o e-mail da seção de contato” ou “marque empresas sem site” e, assim, melhorar a precisão e adicionar contexto durante a própria extração.
Com base nas estruturas atuais das páginas e na documentação de scrapers, os e-mails no cartão da listagem do Yellow Pages são praticamente zero. Scrapers de páginas de detalhes como o recurso de subpáginas da Thunderbit recuperam e-mails de cerca de 15–25% das empresas — que é o teto realista para extração de e-mails no Yellow Pages em 2026. Isso não é uma limitação da Thunderbit; é uma limitação dos dados do Yellow Pages.
Tratamento anti-bot e paginação
A Thunderbit oferece dois modos de scraping: scraping na nuvem (que passa por servidores nos EUA/Europa/Ásia com rotação automática de proxy) e scraping no navegador (que usa sua sessão local do navegador). Se o modo cloud for bloqueado pelo Cloudflare, você pode alternar para o modo navegador como plano B — sua sessão autenticada muitas vezes contorna proteções que bloqueiam requisições cloud sem navegador.
A paginação é totalmente automática. A Thunderbit lida com botões “Next” clicáveis e com rolagem infinita sem necessidade de configuração.
Preço e exportação
- Plano gratuito: 6 páginas por mês
- Teste grátis: 10 páginas
- Plano Starter: a partir de cerca de US$ 9/mês no faturamento anual para 500 créditos (1 crédito = 1 linha)
- Exportação: Excel, CSV e JSON estão disponíveis no plano gratuito; integração com Google Sheets, Airtable e Notion nos planos pagos
Você pode conferir os detalhes mais recentes na nossa página de preços.
Ideal para: representantes de vendas, agências e times de operações que precisam de leads rapidamente, sem programar nem gerenciar proxies.
2. Apify Yellow Pages Scraper — Melhor para scraping em nuvem em escala
 Apify é uma plataforma de scraping baseada em nuvem com um marketplace de “actors” prontos — incluindo vários desenvolvidos especificamente para Yellow Pages. Você configura a extração no console da Apify (termo de busca, localidade, quantidade de resultados) e ela roda na nuvem, sem precisar de navegador ou máquina local.
O actor ParseBird Yellow Pages é o mais transparente que encontrei em relação à extração de e-mails. Ele separa explicitamente o modo de listagem do modo detalhado e documenta que o retorno de e-mails costuma ficar em 15–25% das listagens quando as páginas de detalhes estão ativadas. A extração em modo detalhado custa cerca de US$ 6 por 1.000 empresas, contra US$ 1 por 1.000 no modo de listagem — um reflexo direto do processamento adicional necessário para visitar cada subpágina.
- Pool de proxies incluído com suporte a proxies residenciais
- Paginação integrada para conjuntos com várias páginas
- Exportação: JSON, CSV, Excel, XML, HTML, RSS, JSONL
- Preço: plano grátis com US$ 5 em créditos; planos pagos de US$ 29, US$ 199 e US$ 999/mês
Ideal para: usuários intermediários e avançados que executam campanhas maiores de geração de leads em várias cidades ou categorias.
3. WebScraper.io — Melhor para criar sitemaps personalizados de Yellow Pages
 WebScraper.io oferece uma extensão do Chrome com um “Sitemap Wizard” visual que detecta automaticamente a estrutura das listagens no Yellow Pages. É a ferramenta por trás de um dos tutoriais mais bem ranqueados sobre scraping do Yellow Pages, e por um bom motivo — ela dá controle granular sobre o que será extraído e como isso acontece.
A contrapartida é que esse controle exige configuração. A extração de e-mails não é automática; você precisa configurar seletores manualmente para apontar para os campos de e-mail e definir o scraper para seguir links até as páginas de detalhes das empresas. Se você montar bem, funciona. Se não, vai receber o mesmo resultado de telefones e endereços que qualquer outra ferramenta.
As notas do marketplace do WebScraper.io também são incomumente honestas sobre as defesas do Yellow Pages: elas documentam Cloudflare Bot Management, exigência de renderização JavaScript e fingerprint do navegador como obstáculos específicos.
- Paginação: tratada por meio de configuração do botão “Next” baseada em seletores
- Exportação: CSV, XLSX, JSON; a versão em nuvem adiciona Google Sheets, Dropbox, S3, Azure, API e webhooks
- Preço: extensão Chrome gratuita; planos em nuvem a partir de US$ 50/mês
Ideal para: usuários confortáveis com ferramentas de seletores point-and-click que querem flexibilidade para personalizar a estrutura da extração.
4. Instant Data Scraper — Melhor scraper gratuito de Yellow Pages, com ressalvas
 Instant Data Scraper é a resposta para “o que posso testar agora, de graça?” É uma extensão do Chrome totalmente gratuita — sem conta, sem créditos, sem limite — que detecta automaticamente dados em formato de tabela nas páginas. Abra uma página de resultados do Yellow Pages, clique no ícone da extensão e ela identifica os dados da listagem.
O problema está em tudo o que ela não faz. Ela extrai apenas o que está visível na página, ou seja, não visita subpáginas e, na maioria dos fluxos reais, não extrai e-mails. Também não tem tratamento anti-bot, então, se o Yellow Pages exibir um CAPTCHA ou bloquear seu IP, você fica travado. O suporte à paginação é básico — talvez seja necessário clicar manualmente em “Next” ou depender de uma rolagem automática limitada.
- Exportação: CSV, XLSX
- Preço: grátis para sempre
Ideal para: iniciantes que precisam de uma extração rápida e gratuita de uma página de resultados e não precisam de e-mails. Não é adequado para campanhas focadas em e-mail ou geração de leads em grande escala.
5. Outscraper — Melhor API gerenciada para Yellow Pages e Google Maps
 Outscraper é uma plataforma em nuvem/API com infraestrutura gerenciada para extrair diretórios como Yellow Pages e Google Maps. A proposta de valor é simplicidade: você não precisa gerenciar proxies, lógica anti-bot ou paginação por conta própria.
No Yellow Pages, os primeiros 500 negócios são gratuitos; depois disso, o preço fica em torno de US$ 1 por 1.000 negócios. A extração de e-mails do próprio Yellow Pages fica limitada ao que estiver na página; para enriquecimento mais profundo de e-mails, a Outscraper oferece recursos separados de enrichment que podem ser combinados com a extração base.
Onde a Outscraper realmente se destaca é no suporte a vários diretórios. Se você estiver extraindo Yellow Pages e Google Maps para a mesma campanha, pode operar tudo em uma única plataforma.
- Paginação automática incluída
- Exportação: CSV, JSON, XLSX, API
- Preço: plano gratuito (500 empresas); cobrança por resultado depois disso
Ideal para: equipes de operações comerciais que querem scraping confiável e sem manutenção em vários diretórios, sem gerenciar infraestrutura.
6. Octoparse — Melhor app desktop para scraping visual de Yellow Pages
 Octoparse é um aplicativo desktop (Windows/Mac) com um construtor visual de fluxos de trabalho por clique. Ele oferece templates prontos para Yellow Pages e sites de diretórios similares, além de recursos anti-bot integrados, como rotação de IP, proxies residenciais e solução automática de CAPTCHA.
A extração de e-mails depende do template. Quando o template é configurado para visitar páginas de detalhes das empresas ou sites vinculados, ele consegue capturar e-mails. Mas os templates podem quebrar quando o Yellow Pages atualiza o layout, e os usuários relatam resultados mistos dependendo da categoria e da região.
- Plano gratuito: 10 tarefas, 50.000 exportações por mês
- Paginação detectada automaticamente
- Exportação: CSV, Excel, JSON, HTML, XML, bancos de dados, Google Sheets, API
- Preço: plano gratuito; planos pagos para execução na nuvem
Ideal para: usuários intermediários que preferem um app desktop com fluxo visual e não se importam em ajustar templates de vez em quando.
7. ScrapingBee — Melhor API para desenvolvedores que precisam de HTML renderizado
 ScrapingBee é um serviço de web scraping orientado por API. Ele lida com renderização de JavaScript, rotação de proxies e solução de CAPTCHA — e depois devolve HTML bruto, JSON ou Markdown. Ele não extrai e-mails nem campos estruturados por padrão. Isso fica por sua conta.
O próprio tutorial de Yellow Pages da ScrapingBee demonstra paginação manual adicionando &page=n à URL, o que reforça que esta é uma ferramenta para desenvolvedores, não uma solução de clique e uso.
- Plano gratuito: 1.000 créditos de API
- Sem paginação ou extração de campos nativas
- Exportação: JSON, HTML
- Preço: a partir de US$ 49/mês
Ideal para: desenvolvedores que precisam de HTML renderizado de forma confiável, com tratamento anti-bot, e que se sentem confortáveis escrevendo sua própria lógica de parsing.
8. Bright Data — Melhor plataforma enterprise para scraping em grande escala
 Bright Data opera a maior rede de proxies do setor e oferece um conjunto completo de APIs de scraping, ferramentas de navegador e datasets prontos. Ela foi criada para organizações que precisam de coleta massiva de dados com recursos de conformidade.
No caso específico do Yellow Pages, a força da Bright Data está na infraestrutura — proxies residenciais, solução de CAPTCHA, defesa contra fingerprint do navegador — e na entrega posterior para JSON, CSV, NDJSON, S3, Snowflake, GCS, Azure e SFTP. Não encontrei um template específico e documentado para Yellow Pages no momento, então o posicionamento aqui é de plataforma enterprise, não de produto dedicado para e-mails do YP.
- Preço: a Web Scraper API inclui plano gratuito de 5.000 registros/mês, depois US$ 1,50 por 1 mil registros no pay-as-you-go; US$ 499/mês em escala
- Paginação embutida em todas as ferramentas de scraping
Ideal para: grandes empresas ou agências com orçamento robusto de dados que precisam de escala, conformidade e infraestrutura de proxies.
9. Python DIY (BeautifulSoup + Playwright) — Melhor para controle total
 Este é o caminho open source: BeautifulSoup para parsing de HTML e Playwright para automação de navegador. Bibliotecas gratuitas, máxima flexibilidade e a maior exigência técnica desta lista.
A extração de e-mails exige escrever lógica personalizada para navegar até a página de detalhes de cada empresa e localizar os campos de e-mail. Rotação de proxies, tratamento de CAPTCHA, limitação de requisições e paginação precisam ser implementados ou comprados separadamente. Como disse um usuário do Reddit: “Depois que você experimenta Playwright, nunca mais volta para Selenium” — mas você também nunca para de depurar sua configuração de proxy.
- Preço: grátis (bibliotecas open source); infraestrutura custa à parte
- Exportação: qualquer formato que você codificar
- Sem recursos nativos — você constrói tudo sozinho
Ideal para: desenvolvedores especialistas com requisitos de scraping específicos que nenhuma ferramenta pronta atende, e que se sentem confortáveis gerenciando a infraestrutura de ponta a ponta.
O que realmente acontece quando o Yellow Pages bloqueia você? Um teste de realidade anti-bot
Quero dedicar um momento a isso porque é o principal ponto de dor em volume de menções nas comunidades de scraping, e a maioria dos artigos passa por cima com um simples “use proxies”.
Quando testei uma requisição scriptada básica para uma URL de busca do Yellow Pages em 27 de abril de 2026, a resposta foi uma página de bloqueio do Cloudflare: “Sorry, you have been blocked. This website is using a security service to protect itself from online attacks.” Isso aconteceu já na primeira requisição. Sem aviso, sem limitação gradual — apenas uma barreira.
O stack anti-bot do Yellow Pages inclui Cloudflare Bot Management, exigência de renderização JavaScript, fingerprint do navegador, rate limiting e reCAPTCHA. O guia de scraping da IPRoyal acrescenta que os sintomas podem incluir bloqueios duros, bans silenciosos, CAPTCHAs, redirecionamentos para splash pages, rastreamento de sessão e limites de requisição.
O contexto geral torna isso ainda pior. O relatório de 2025 da Imperva mostrou que o tráfego automatizado representou 51% de todo o tráfego da internet em 2024, e o relatório de 2025 da DataDome, cobrindo quase 17.000 sites, constatou que apenas 2,8% estavam totalmente protegidos. Sites como o Yellow Pages, que investem em proteção, estão ficando melhores em detectar scrapers — não piores.
Abaixo, uma visão prática de como cada ferramenta lida com isso:
| Ferramenta | Rotação de proxies | Tratamento de CAPTCHA | Resistência a rate limit | Fallback quando bloqueado |
|---|---|---|---|---|
| Thunderbit | ✅ Modo cloud com servidores EUA/Europa/Ásia | ✅ Gerenciado via nuvem | ✅ Auto-throttle | Alternar para scraping no navegador |
| Apify | ✅ Incluindo proxies residenciais | ✅ Via actor/infra de navegador | ✅ Configurável | Repetir com novo proxy |
| WebScraper.io | ✅ Planos em nuvem + add-on de proxy | ✅ Planos em nuvem | ✅ Forte | Usar execução em nuvem |
| Instant Data Scraper | ❌ Nenhuma | ❌ Nenhum | ❌ Fraca | Repetir manualmente ou parar |
| Outscraper | ✅ Backend gerenciado | ⚠️ Documentação limitada | ✅ Moderada | Serviço gerenciado cuida disso |
| Octoparse | ✅ Incluindo proxies residenciais | ✅ Solução automática de CAPTCHA | ✅ Forte | Templates em nuvem + anti-bloqueio |
| ScrapingBee | ✅ Proxies gerenciados | ✅ Nativo | ✅ Forte | Ajustar código, proxies premium |
| Bright Data | ✅ Nível enterprise | ✅ Nativo | ✅ Muito forte | Ajuste completo da infraestrutura |
| Python DIY | ❌ Apenas autogerenciado | ❌ Apenas autogerenciado | ❌ Variável | O que você construir |
Além dos dados brutos: transformando extrações do Yellow Pages em leads prontos para CRM
Vejo isso o tempo todo: alguém extrai 500 listagens do Yellow Pages, exporta para uma planilha e depois passa três horas procurando manualmente no Google o e-mail de cada empresa, conferindo os sites e descobrindo quais realmente valem a abordagem. A extração levou 10 minutos. O enriquecimento levou a tarde inteira.
É daí que vem a crítica de que “dados brutos sem pontuação são só uma planilha.” Um export bruto do Yellow Pages se parece com isto:
| Nome da empresa | Telefone | Endereço | Site | Categoria |
|---|---|---|---|---|
| Example Plumbing Co. | 555-0199 | 123 Main St | exampleplumbing.com | Encanadores |
| NoSite HVAC | 555-0112 | 456 Oak Ave | Nenhum | HVAC |
Uma tabela de leads enriquecida — do tipo que realmente ajuda na prospecção — se parece com isto:
| Nome da empresa | Telefone | Endereço | Site | Avaliações | Tem site? | Observação de prospecção | |
|---|---|---|---|---|---|---|---|
| Example Plumbing Co. | 555-0199 | 123 Main St | exampleplumbing.com | info@exampleplumbing.com | 42 | Sim | Página de contato disponível |
| NoSite HVAC | 555-0112 | 456 Oak Ave | Nenhum | Nenhum | 8 | Não | Possível prospect para agência |
Usando scraping de subpáginas para enriquecer leads
O scraping de subpáginas da Thunderbit visita a página de detalhes de cada empresa e adiciona campos como e-mail, URL do site, horário, avaliações e categorias. Para uma extração com 500 listagens, isso faz a diferença entre 10 minutos de trabalho automatizado e mais de 3 horas de pesquisa manual.
A extração em modo detalhado da Apify faz algo parecido, mas com custo por registro mais alto (cerca de US$ 6 por 1.000 empresas contra US$ 1 por 1.000 no modo de listagem).
Rotulando e categorizando leads durante a extração
O Field AI Prompt da Thunderbit permite adicionar instruções durante a extração — coisas como “marque empresas sem site” ou “categorize por porte da empresa”. A IA processa esses rótulos enquanto coleta os dados, então você já recebe uma lista de leads pré-qualificada em vez de um dump cru.
Um ponto de atenção que vale destacar pela pesquisa: a ausência de site nem sempre significa que uma empresa seja um bom prospect. É um sinal útil para abordagem de agências, mas não deve ser o único critério de qualificação.
Fluxo de exportação para CRM
O fluxo mais comum que vejo entre nossos usuários:
- Thunderbit → Google Sheets ou Airtable → CRM (exportação direta, sem etapas intermediárias)
- Apify → Webhook → CRM (exige alguma configuração)
- Outscraper → download CSV → importação no CRM (manual, mas simples)
Se o seu CRM integra com Google Sheets ou Airtable, a exportação direta da Thunderbit elimina completamente a etapa de baixar arquivos. Você pode saber mais sobre web scraping sem código no nosso blog.
Melhor scraper de Yellow Pages por caso de uso: guia rápido de recomendação
Nem toda ferramenta serve para todo tipo de usuário. Minhas recomendações por perfil:
Melhor para representantes de vendas e donos de agência sem perfil técnico: Thunderbit (scraping com IA em 1 clique, extrator de e-mail grátis, scraping de subpáginas) e Instant Data Scraper (grátis e simples — mas sem e-mails)
Melhor para operações de geração de leads em escala: Apify (actors em nuvem, campanhas multi-cidade, extração de e-mails em páginas detalhadas) e Outscraper (API gerenciada, suporte a vários diretórios)
Melhor opção 100% gratuita: Instant Data Scraper (totalmente grátis para sempre) e plano gratuito da Thunderbit (6 páginas/mês com recursos de IA)
Melhor para desenvolvedores: Python DIY com Playwright (controle máximo) e API da ScrapingBee (renderização + proxies gerenciados)
Melhor para enterprise / grande escala: Bright Data (maior rede de proxies, recursos de conformidade, preço enterprise)
Também publicamos um обзор dos melhores web scrapers com IA e um guia mais profundo sobre geração de leads com IA caso você queira avançar mais.
Yellow Pages vs. Google Maps vs. outros diretórios: quando usar cada um
A maioria dos profissionais de geração de leads não extrai só do Yellow Pages. Eles usam vários diretórios e cruzam as informações. Uma comparação rápida com base na disponibilidade atual de dados:
| Fator | Yellow Pages | Google Maps | Facebook Business |
|---|---|---|---|
| Disponibilidade de e-mail | Baixa (apenas nas páginas de detalhes) | Muito baixa (não é um campo padrão) | Média (páginas podem incluir e-mail) |
| Telefones | ✅ Sempre listados | ✅ Sempre listados | ⚠️ Às vezes ocultos |
| Avaliações/ratings | ✅ Disponíveis | ✅ Dados mais ricos | ✅ Disponíveis |
| Categorias/nichos | ✅ Forte para nichos locais | ✅ Amplo e rico | ⚠️ Inconsistente |
| Melhor ferramenta de scraping | Thunderbit, actor YP da Apify | Outscraper, actor Maps da Apify | Thunderbit (a IA identifica os campos em qualquer site) |
O Yellow Pages é mais forte para cobertura local de nichos — se você precisa de todos os encanadores de uma determinada região metropolitana, é difícil bater isso. O Google Maps oferece dados de avaliações mais ricos e sinais de atualização mais frequentes. As páginas de Facebook Business às vezes superam ambos em visibilidade direta de e-mail, porque os donos das páginas costumam publicar o endereço.
A IA da Thunderbit identifica os campos em qualquer site, então você pode extrair dados do Yellow Pages, do Google Maps e do Facebook com a mesma extensão. Essa versatilidade importa quando você está montando uma lista de leads multissource. Nosso guia sobre o que é web scraping cobre os fundamentos, caso você esteja começando agora.
Considerações legais e éticas sobre scraping do Yellow Pages
Esta seção é breve, mas importante.
Os dados do Yellow Pages são publicamente acessíveis, mas os Termos de Serviço do YP.com dizem explicitamente que o acesso é para fins “individuais, não comerciais e informativos” e que os usuários não podem usar “bots, scrapers, crawlers, spiders” para extrair dados. O cenário jurídico atual dos EUA em relação ao web scraping é complexo — a visibilidade pública pode reduzir o risco sob a CFAA em comparação com páginas protegidas por login, mas ainda valem regras contratuais, privacidade (CCPA) e compliance de marketing.
A FTC enviou cartas de advertência a 21 profissionais de marketing de planos de saúde e geradores de leads em dezembro de 2024 sobre o uso de informações do consumidor em fluxos de geração de leads. A mensagem principal é: faça scraping com responsabilidade, respeite limites de requisição, não revenda dados brutos sem entender as fronteiras legais e use os dados extraídos para finalidades comerciais legítimas.
Este artigo é informativo e não constitui aconselhamento jurídico.
Conclusão
A maioria dos scrapers de Yellow Pages deixa passar os e-mails porque para na página de listagem. As ferramentas que funcionam melhor são as que conseguem chegar às páginas de detalhes das empresas, seguir links para os sites corporativos ou rodar fluxos de enriquecimento em cima da extração base. Mesmo assim, a disponibilidade de e-mails no Yellow Pages fica em torno de 15–25% das listagens — então alinhar expectativas realistas é tão importante quanto escolher a ferramenta certa.
Se você é uma equipe sem perfil técnico e precisa de leads com dados de contato reais, experimente o plano gratuito da Thunderbit — os recursos de scraping de subpáginas e extração de e-mails foram feitos exatamente para esse problema. Se você está conduzindo campanhas maiores, Apify e Outscraper oferecem uma boa infraestrutura em nuvem. E, se você é desenvolvedor e quer controle total, Python com Playwright e ScrapingBee vai te levar até lá, embora você acabe construindo mais partes da pipeline por conta própria.
Comece pela tabela comparativa acima, escolha com base no seu nível técnico e orçamento e lembre-se: o melhor scraper é aquele que realmente entrega os dados de que você precisa para a prospecção — não o que tem a lista de recursos mais longa.
Você também pode conhecer diretamente a nossa Extensão Chrome da Thunderbit ou conferir tutoriais no nosso canal no YouTube.
FAQs
É realmente possível extrair e-mails do Yellow Pages?
Sim, mas a maioria dos e-mails está nas páginas de detalhes das empresas, e não no cartão principal da listagem. A documentação atual de scrapers sugere que apenas cerca de 15–25% das empresas exibem um e-mail que um scraper de página de detalhes consegue recuperar. Para melhores resultados, você precisa de uma ferramenta com capacidade de scraping de subpáginas — como a Thunderbit ou os actors de modo detalhado da Apify.
Qual é o melhor scraper gratuito de Yellow Pages?
O Instant Data Scraper é totalmente gratuito, sem conta nem limite de créditos, mas não extrai e-mails com confiabilidade e não tem tratamento anti-bot. A Thunderbit oferece um plano gratuito (6 páginas/mês) com scraping por IA, acesso a subpáginas e extração de e-mails — uma opção mais forte se e-mail for importante no seu fluxo.
Como evitar bloqueios ao fazer scraping do Yellow Pages?
O Yellow Pages usa Cloudflare Bot Management, CAPTCHAs, rate limiting e fingerprint do navegador. Use ferramentas com rotação de proxy e tratamento de CAPTCHA embutidos (Thunderbit, Apify, Octoparse, ScrapingBee, Bright Data). O alternador nuvem→navegador da Thunderbit oferece um fallback prático — se o scraping na nuvem for bloqueado, o modo navegador usa sua sessão local para contornar parte das proteções.
Scraper de Yellow Pages vs. scraper de Google Maps — qual é melhor para leads?
Depende do que você precisa. O Yellow Pages tem uma cobertura local de nichos mais forte e lista telefones de forma consistente. O Google Maps oferece dados de avaliações mais ricos e atualizações mais frequentes. Nenhum dos dois é ótimo para e-mail — as páginas de Facebook Business costumam ter maior disponibilidade de e-mails. O ideal é cruzar vários diretórios para obter perfis de lead mais completos.
É legal extrair dados do Yellow Pages?
Os dados do Yellow Pages são publicamente acessíveis, mas os Termos de Serviço do YP.com restringem a coleta automática de dados e o uso comercial dos resultados de busca. O cenário jurídico dos EUA sobre scraping de dados públicos está evoluindo. Os usuários devem revisar os Termos de Serviço do site, cumprir as regras de privacidade aplicáveis (CCPA, GDPR quando relevante) e usar os dados extraídos de forma responsável. Este artigo é informativo e não constitui aconselhamento jurídico.
Experimente a Thunderbit para scraping de Yellow Pages Get Started Free
Saiba mais



