
A web está crescendo num ritmo que faz meu café da manhã parecer devagar — e olha que eu bebo rápido. Em 2026, a extração de dados da web já não é mais só um “extra legal” para quem trabalha com tecnologia; ela virou o ingrediente secreto por trás de prospecção comercial, monitoramento de preços no ecommerce, pesquisa de mercado e até análise imobiliária. Com mais de 49% das empresas usando ferramentas de web scraping semanalmente, escolher a biblioteca ou ferramenta certa pode ser a diferença entre horas de trabalho repetitivo e uma planilha cheia de insights acionáveis — entregue antes mesmo de a concorrência terminar o almoço.
Mas aqui vem a parte mais interessante: as bibliotecas de web scraping em 2026 vêm em todos os formatos e estilos, desde extensões AI para Chrome sem código até frameworks robustos para desenvolvedores. Seja você um vendedor que só quer leads no Excel, um gerente de operações acompanhando 500 SKUs ou um especialista em Python montando um crawler sob medida, existe uma ferramenta ideal para o seu caso. Passei anos trabalhando com SaaS e automação — e mais madrugadas do que gostaria de admitir — explorando essas bibliotecas. Então vamos destrinchar as 10 melhores bibliotecas de web scraping que você precisa conhecer este ano e como escolher a que vai facilitar sua vida.
O que faz uma biblioteca de web scraping ser poderosa em 2026?
Extraia dados de qualquer site usando IA Get Started Free
Antes de entrar na lista, vale falar sobre o que realmente importa na hora de escolher uma biblioteca de web scraping. Pela minha experiência, as melhores ferramentas em 2026 têm alguns pontos em comum:
- Facilidade de uso: Uma pessoa sem perfil técnico consegue resultado em minutos? Ou é preciso quase um doutorado em Python?
- Tratamento de conteúdo dinâmico: Ela consegue extrair dados de sites modernos, cheios de JavaScript? Ou trava diante de qualquer coisa mais complexa que HTML estático?
- Suporte a linguagens e plataformas: Funciona na linguagem que você prefere — Python, JavaScript, Java — ou até direto no navegador?
- Escalabilidade: Aguenta centenas (ou milhares) de páginas sem sofrer?
- Integração e exportação: Conecta bem com Excel, Google Sheets, Notion ou seu fluxo de dados?
- IA e automação: Em 2026, ferramentas guiadas por IA que “simplesmente funcionam” com comandos em linguagem natural são um diferencial enorme — especialmente para usuários de negócio que preferem não mexer com código.
A realidade é que as equipes de negócio querem velocidade, precisão e o mínimo de configuração possível. Quanto menos tempo você perder consertando raspadores quebrados ou brigando com código, mais tempo sobra para agir sobre os dados. E, com o avanço da IA e da automação no navegador, até usuários sem conhecimento técnico agora conseguem extrair dados que antes exigiam a ajuda de um desenvolvedor (PromptCloud).
Certo — vamos ao que interessa.
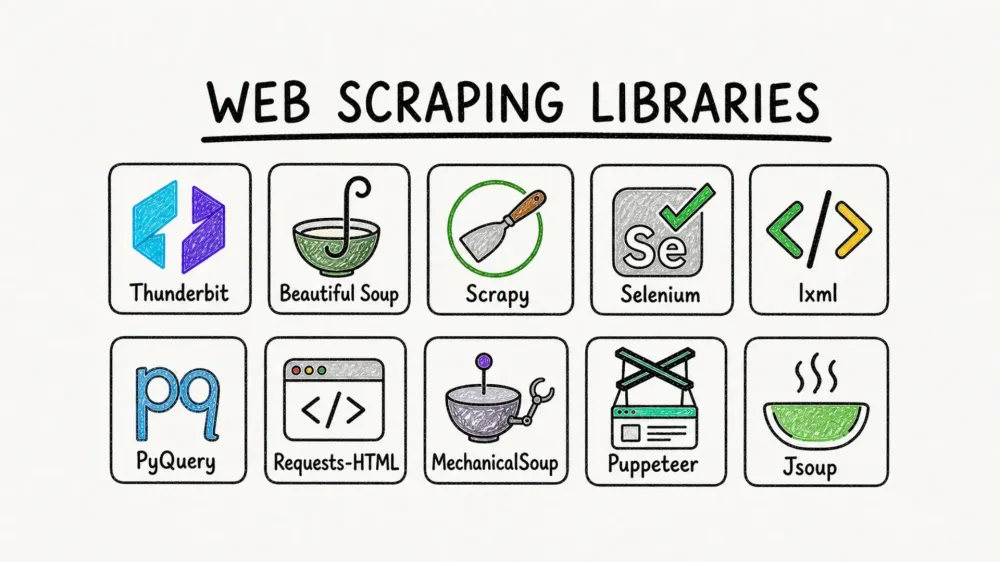
As 10 bibliotecas de web scraping mais poderosas para usar em 2026
- Thunderbit para web scraping sem código e com IA no navegador
- Beautiful Soup para análise de HTML e limpeza de dados em Python
- Scrapy para crawling em grande escala, com alta velocidade e pipelines
- Selenium para automação de navegador e extração em sites dinâmicos, cheios de JavaScript
- lxml para parsing ultrarrápido de XML/HTML em Python
- PyQuery para seleção de HTML no estilo jQuery em Python
- Requests-HTML para HTTP, parsing de HTML e renderização de JavaScript em Python, tudo em um só pacote
- MechanicalSoup para automatizar formulários e tarefas simples de navegação em Python
- Puppeteer para automação do Chrome headless em Node.js
- Jsoup para parsing robusto de HTML em Java
1. Thunderbit

Thunderbit é minha principal recomendação para quem quer extrair dados da web sem escrever uma única linha de código. Esta extensão de Chrome com IA permite que você descreva o que quer (“pegue todos os nomes de produtos, preços e imagens desta página”), e a IA faz o resto. Sem templates, sem configuração — basta clicar uma vez, ajustar as colunas se quiser, e a extração roda mesmo que você não faça mais nada.
Por que o Thunderbit se destaca em 2026:
- Interface sem código e em linguagem natural: Qualquer pessoa pode usar — vendas, operações, marketing, mercado imobiliário. Não precisa de Python.
- Detecção automática de campos: A IA monta o conjunto de colunas diretamente a partir da estrutura da página.
- Extração de subpáginas: Precisa de mais detalhes? O Thunderbit pode visitar cada subpágina (como páginas de produto ou perfil) e enriquecer a sua tabela automaticamente (Thunderbit Blog).
- Templates instantâneos para sites populares: Amazon, Zillow, Shopify e muito mais — extração com um clique.
- Exportação para Excel, Google Sheets, Notion e Airtable: Seus dados chegam exatamente onde a equipe precisa.
- Suporte a 34 idiomas: Perfeito para times globais.
- Extração em nuvem ou no navegador: Escolha o que faz mais sentido para o seu fluxo — a nuvem é extremamente rápida para sites públicos, enquanto o modo navegador lida com logins.
O Thunderbit já é confiado por mais de 200.000 usuários no mundo todo, e o plano gratuito permite extrair até 6 páginas (ou 10 com um bônus de teste). Se você quer ver como é o web scraping moderno, eu começaria por aqui.
Teste grátis o Thunderbit AI Web Scraper
2. Beautiful Soup
Beautiful Soup é uma biblioteca clássica de Python, muito querida por cientistas e analistas de dados pela simplicidade e pela força na hora de interpretar HTML confuso. Se você já tentou extrair dados de uma página com tags quebradas ou formatação estranha, o Beautiful Soup é seu aliado.
O que torna o Beautiful Soup tão bom:
- Lida com HTML irregular: Perfeito para limpar e extrair dados de páginas “bagunçadas” (Beautiful Soup Docs).
- Fácil de aprender: Até quem está começando com Python consegue colocar de pé rapidamente.
- Flexível: Funciona muito bem com clientes HTTP como Requests e pode ser combinado com lxml para ganhar velocidade.
- Casos de uso típicos: Extração rápida de dados, limpeza de dados web, integração com pequenos scripts.
Se você está lidando com páginas estáticas ou precisa organizar marcações desordenadas, o Beautiful Soup é uma escolha sólida.
3. Scrapy
Scrapy é o peso-pesado do web scraping em Python. Trata-se de um framework completo para criar crawlers escaláveis e pipelines de dados. Se você precisa extrair milhares de páginas, seguir links e processar dados em grande escala, o Scrapy foi feito para isso.
Por que o Scrapy é uma das melhores escolhas:
- Altamente modular: Permite criar spiders, pipelines e middlewares complexos (Scrapy Docs).
- Lida bem com projetos grandes: Ideal para pesquisa de mercado, análise competitiva ou qualquer trabalho que precise rastrear e extrair dados de muitos sites.
- Assíncrono e rápido: Projetado para velocidade e eficiência.
- Comunidade ampla: Muitos plugins, tutoriais e suporte.
O Scrapy tem curva de aprendizado, mas, para trabalhos grandes, é uma verdadeira potência.
4. Selenium
Selenium é a ferramenta ideal para automatizar navegadores. Ele é usado para tudo, desde testes de aplicações web até a extração de sites que exigem login, cliques ou manipulação de pop-ups. Se você precisa interagir com sites cheios de JavaScript ou altamente dinâmicos, o Selenium consegue simular um usuário real (ScrapingBee Selenium Guide).
Pontos fortes do Selenium:
- Automatiza navegadores reais: Chrome, Firefox, Safari, Edge — você escolhe.
- Lida com logins, pop-ups e ações do usuário: Ótimo para extrair dados após autenticação ou navegar por fluxos com várias etapas.
- Suporte a múltiplas linguagens: Python, Java, C# e outras.
- Ideal para: Sites que bloqueiam raspadores simples ou situações em que é preciso simular comportamento real de usuário.
Ele é um pouco mais pesado do que bibliotecas baseadas em HTTP, mas às vezes só um navegador de verdade resolve.
5. lxml
lxml é um parser de XML e HTML de alto desempenho para Python. Se velocidade é sua prioridade número um — pense em analisar milhares de documentos grandes —, é difícil bater o lxml (Python HTML Parser Performance).
Por que o lxml é tão querido:
- Muito rápido: Supera a maioria dos outros parsers de Python, especialmente em arquivos grandes.
- Robusto: Lida com XML e HTML e integra bem com outras ferramentas.
- Ótimo para: Processar grandes conjuntos de dados e combinar com Beautiful Soup ou Scrapy para ganhar ainda mais poder.
Se você faz scraping em escala ou precisa processar arquivos enormes, o lxml é item obrigatório no seu kit.
6. PyQuery
PyQuery leva para o Python a sintaxe de seletores do jQuery. Se você gosta da praticidade de selecionar elementos com $('.class') no jQuery, o PyQuery permite fazer o mesmo nos seus scripts de scraping (PyQuery Docs).
Destaques do PyQuery:
- Seletores no estilo jQuery: Intuitivo para quem já conhece desenvolvimento front-end.
- Código curto e legível: Simplifica seleções complexas.
- Integração com lxml: Rápido e eficiente por baixo dos panos.
- Ideal para: Projetos em que você quer manipulação de HTML rápida e parecida com jQuery em Python.
É uma ótima ponte para quem está migrando do desenvolvimento web para a extração de dados.
7. Requests-HTML
Requests-HTML é uma biblioteca de Python que combina a facilidade do Requests (para HTTP) com parsing de HTML embutido e até renderização de JavaScript.
O que diferencia o Requests-HTML:
- Tudo em um só pacote: Baixe páginas, analise HTML e até renderize JavaScript em uma única solução.
- Amigável para iniciantes: Ótimo para projetos pequenos e médios de scraping.
- Perfeito para: Scripts rápidos, sites com algum conteúdo dinâmico e usuários que querem simplicidade.
Se você está começando ou precisa de uma ferramenta flexível para trabalhos menores, o Requests-HTML é uma ótima opção.
8. MechanicalSoup
MechanicalSoup é uma biblioteca de Python que automatiza formulários web e interações simples com o navegador. Ela é construída sobre Beautiful Soup e Requests, o que facilita fazer login, preencher formulários e navegar em fluxos básicos (ScrapingBee MechanicalSoup Guide).
Por que o MechanicalSoup é útil:
- Automatiza formulários e logins: Ótimo para extrair dados atrás de autenticação.
- API simples: Fácil de aprender para iniciantes.
- Ideal para: Tarefas repetitivas no navegador, fluxos simples e sites em que usar automação completa seria exagero.
Ele não é tão poderoso quanto o Selenium em sites complexos, mas é muito mais leve e fácil de usar para necessidades básicas.
9. Puppeteer
Puppeteer é uma biblioteca de Node.js para controlar o Chrome ou Chromium em modo headless. É uma favorita quando o objetivo é extrair dados de sites cheios de JavaScript e altamente interativos (Scrape.do Puppeteer Guide).
Superpoderes do Puppeteer:
- Automação completa de navegador: Clique, role a página, preencha formulários e interaja como um usuário real.
- Lida com conteúdo dinâmico: Perfeito para sites que carregam dados via JavaScript.
- Ótimo para: Ecommerce, redes sociais ou qualquer site em que raspadores tradicionais falham.
Se você é desenvolvedor JavaScript ou precisa fazer scraping da “web moderna”, o Puppeteer é indispensável.
10. Jsoup
Jsoup é o padrão-ouro para parsing de HTML em Java. É como o Beautiful Soup, só que para desenvolvedores Java (Baeldung Jsoup Guide).
Por que times Java adoram o Jsoup:
- API simples e poderosa: Extraia e manipule dados com poucas linhas de código.
- Lida com HTML bagunçado: Limpa e interpreta até páginas mal formatadas.
- Ideal para: Integrar scraping a aplicativos de negócios em Java ou fluxos de backend.
Se a sua stack é Java, o Jsoup é a escolha natural.
Tabela comparativa das bibliotecas de web scraping
Aqui vai uma visão rápida lado a lado das 10 bibliotecas:
| Biblioteca | Linguagem | Facilidade de uso | Conteúdo dinâmico | IA/Sem código | Casos de uso típicos | Ideal para |
|---|---|---|---|---|---|---|
| Thunderbit | Ext. Chrome | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | Sim | Vendas, operações, pesquisa, imóveis | Usuários sem código, negócios |
| Beautiful Soup | Python | ⭐⭐⭐⭐ | ⭐ | Não | Parsing de HTML, limpeza de dados | Iniciantes em Python, analistas |
| Scrapy | Python | ⭐⭐⭐ | ⭐⭐ | Não | Crawling em escala, pipelines | Devs, projetos com muitos dados |
| Selenium | Multi | ⭐⭐ | ⭐⭐⭐⭐⭐ | Não | Automação de navegador, logins | QA, sites dinâmicos |
| lxml | Python | ⭐⭐⭐ | ⭐ | Não | Parsing rápido, arquivos grandes | Usuários avançados, grandes bases |
| PyQuery | Python | ⭐⭐⭐⭐ | ⭐ | Não | Seleção estilo jQuery | Web devs, scripts enxutos |
| Requests-HTML | Python | ⭐⭐⭐⭐ | ⭐⭐ | Não | Scripts rápidos, renderização JS | Iniciantes, projetos pequenos |
| MechanicalSoup | Python | ⭐⭐⭐⭐ | ⭐⭐ | Não | Automação de formulários, logins | Tarefas simples no navegador |
| Puppeteer | Node.js | ⭐⭐⭐ | ⭐⭐⭐⭐⭐ | Não | Sites com JS, automação | Devs JS, scraping dinâmico |
| Jsoup | Java | ⭐⭐⭐⭐ | ⭐ | Não | Parsing de HTML em Java | Times Java, fluxos de backend |
Como escolher a biblioteca de web scraping certa para o seu negócio
O que é data scraping e como fazer em 2025 Get Started Free
Então, qual biblioteca você deve usar? Aqui vai meu conselho, baseado em anos de tentativa, erro e algumas sessões de depuração tarde da noite a mais do que eu gostaria de lembrar:
- Sem perfil técnico ou usuário de negócio: Comece com Thunderbit. A abordagem com IA e sem código faz você chegar a resultados em minutos, não em dias. Se a sua equipe só quer dados no Excel ou no Sheets, não complique.
- Desenvolvedores Python: Beautiful Soup e Requests-HTML são ótimos para trabalhos pequenos. Scrapy é seu aliado em projetos grandes. Combine com lxml ou PyQuery para ganhar poder extra.
- Precisa lidar com login ou conteúdo dinâmico? Selenium (multilinguagem) ou Puppeteer (Node.js) são suas melhores apostas.
- Times Java: Jsoup é o vencedor claro para integrar scraping a aplicativos Java.
- Precisa automatizar formulários ou fluxos simples? MechanicalSoup é leve e fácil de usar.
Fatores-chave a considerar:
- Nível técnico da equipe: Ferramentas sem código como Thunderbit são perfeitas para times não técnicos. Desenvolvedores podem preferir a flexibilidade de bibliotecas baseadas em código.
- Complexidade dos dados: Para páginas simples e estáticas, Beautiful Soup ou Jsoup funcionam muito bem. Para sites dinâmicos e cheios de JavaScript, vá de Selenium ou Puppeteer.
- Escala: Scrapy e lxml brilham em trabalhos grandes e rápidos.
- Integração: A exportação direta do Thunderbit para Sheets, Notion e Airtable economiza muito tempo em fluxos de trabalho de negócio.
Para saber mais sobre como escolher a ferramenta certa, confira o guia da PromptCloud.
Ver preços e o plano gratuito do Thunderbit
Conclusão: destravando dados da web com as ferramentas certas
Em 2026, web scraping já não é assunto só de programador ou cientista de dados. Com a explosão das ferramentas com IA e sem código, qualquer equipe — de vendas à pesquisa — pode aproveitar o tesouro de dados que a web oferece. A biblioteca certa pode economizar centenas de horas por ano (Browsercat), aumentar sua precisão e dar à sua empresa uma vantagem real.
Meu conselho? Comece pelas suas necessidades — velocidade, escala e conforto técnico — e teste algumas opções. O plano gratuito do Thunderbit é uma ótima forma de experimentar, e bibliotecas open source como Beautiful Soup ou Scrapy sempre estarão disponíveis se você quiser colocar a mão na massa.
Quer ir mais fundo? Confira o Thunderbit Blog para mais guias ou assine nosso canal no YouTube para tutoriais práticos.
Boa extração — e que seus dados estejam sempre limpos, organizados e prontos para agir.
Teste grátis o Thunderbit AI Web Scraper Get Started Free
FAQs
1. Qual é a biblioteca de web scraping mais fácil para quem não programa em 2026?
O Thunderbit é a melhor opção para quem não programa. Sua extensão de Chrome com IA permite extrair dados com comandos em linguagem natural — sem necessidade de codificação.
2. Qual biblioteca é melhor para sites dinâmicos ou cheios de JavaScript?
Puppeteer (Node.js) e Selenium (multilinguagem) são as melhores opções para sites dinâmicos renderizados com JavaScript. Eles automatizam navegadores reais e lidam com interações complexas.
3. Qual é a diferença entre Beautiful Soup e Scrapy?
O Beautiful Soup é ótimo para analisar e extrair dados de páginas individuais ou projetos pequenos, especialmente quando o HTML está desorganizado. O Scrapy é um framework completo para criar crawlers escaláveis e processar grandes volumes de dados.
4. Posso exportar os dados extraídos diretamente para Google Sheets ou Notion?
Sim — o Thunderbit oferece exportação direta para Google Sheets, Notion, Airtable e Excel. A maioria das bibliotecas de código exige que você implemente a exportação manualmente.
5. Como escolher a biblioteca de web scraping certa para o meu negócio?
Considere suas habilidades técnicas, a complexidade dos sites que deseja extrair, o volume de dados e as necessidades de integração. Ferramentas sem código como o Thunderbit são ideais para equipes de negócio, enquanto desenvolvedores podem preferir bibliotecas como Scrapy, Beautiful Soup ou Puppeteer para ter mais controle.
Saiba mais
- As 10 melhores bibliotecas de web scraping em Python e uma alternativa com IA
- 7 ferramentas de web scraping mais populares para usar em 2026
- As 5 melhores ferramentas de extração de dados da web em 2026
- As melhores ferramentas e softwares de web scraping em 2025
- Como extrair dados de sites com eficiência usando as melhores ferramentas



