
Na semana passada, um colega me mandou um contrato de fornecedor com 47 páginas e pediu para eu “só jogar as tabelas de preços numa planilha”. Fiquei encarando o PDF por uns três segundos antes de fechar e abrir um PDF scraper. Esse impulso não veio de preguiça — veio de anos vendo gente desperdiçar tardes inteiras tentando arrancar dados de arquivos que nunca foram feitos para entregá-los.
Os números confirmam essa frustração. A pesquisa de 2024 da Airbase com 745 profissionais de finanças mostrou que 38% das equipes gastam mais de um quarto do tempo total em tarefas manuais. O relatório de automação de contas a pagar da SAP Concur acrescenta que 60% dos lançamentos de notas fiscais em sistemas ERP ou contábeis ainda são feitos manualmente.
PDFs estão por toda parte — faturas, contratos, demonstrativos financeiros, recibos escaneados — e, ainda assim, boa parte do trabalho continua no velho copia e cola. Em 2026, os scrapers de PDF vão de bibliotecas Python gratuitas a ferramentas no-code com IA, e escolher a opção errada pode custar dias em vez de economizá-los. Testei 12 dos melhores PDF scrapers em extração de tabelas, OCR, preço e facilidade de uso para você encontrar a melhor opção em poucos minutos.
O que é um PDF Scraper e por que isso importa?
Um PDF scraper é um software que extrai automaticamente texto, tabelas, campos e dados estruturados de arquivos PDF. Se você já tentou copiar uma tabela de um PDF para o Excel e viu as colunas virarem uma única linha toda bagunçada, já entendeu o problema.
PDF scrapers e web scrapers vivem sendo confundidos, então vale fazer uma distinção rápida. Um web scraper lê HTML, que pelo menos traz algumas tags estruturais — títulos, tabelas, divs. Já um PDF scraper parte de um formato de descrição visual de página. A própria documentação da Adobe deixa isso claro: o PDF foi criado para preservar a aparência da página de forma consistente entre dispositivos, e não para expor uma estrutura tabular ou semântica limpa. É por isso que o copiar e colar destrói linhas, colunas e a ordem de leitura.
Onde a extração de PDFs realmente economiza tempo?
- Processamento de faturas: capturar nome do fornecedor, ID da nota, total, impostos e itens
- Relatórios financeiros: extrair tabelas de relatórios anuais, demonstrativos e divulgações
- Registros escaneados: recuperar contatos ou dados de transações em PDFs apenas como imagem
- Migração de arquivos legados: converter arquivos antigos em registros pesquisáveis e estruturados
O impacto no negócio vai além de um único fluxo. A Gartner ainda estima que a má qualidade de dados custa às organizações pelo menos US$ 12,9 milhões por ano, em média. E, em fevereiro de 2025, a Gartner afirmou que 63% das organizações não têm, ou não sabem se têm, as práticas certas de gestão de dados para IA. Até 2026, a Gartner diz que as organizações vão abandonar 60% dos projetos de IA que não forem sustentados por dados prontos para IA. Se os PDFs ainda concentram grande parte dos dados brutos, a qualidade da extração de documentos agora está diretamente ligada à prontidão para IA.
A pesquisa de 2025 da Adobe com profissionais de finanças descobriu que 61% editam regularmente documentos em PDF e 64% os assinam com frequência. A PDF Association também observa que o PDF ficou em 3º lugar entre os formatos de arquivo mais populares da web nos dados do CommonCrawl. Ou seja: PDF não vai desaparecer.
Como avaliamos os melhores PDF scrapers
Antes de entrar nas ferramentas, aqui está a estrutura que usei. Os oito critérios abaixo refletem diretamente os pontos de dor que vejo com mais frequência em fóruns, issues do GitHub e avaliações de produtos:
| Critério | O que mede | Por que importa para o usuário |
|---|---|---|
| Tipos de PDF suportados | Texto nativo, escaneado/apenas imagem, misto | Muitas ferramentas falham antes mesmo de começar a extração |
| Precisão na extração de tabelas | Tabelas simples, sem bordas, multi página, células mescladas | É a reclamação nº 1 na extração de PDFs |
| Capacidade de OCR | Nativo, como complemento ou nenhum | PDFs escaneados ficam inutilizáveis sem OCR |
| Formatos de saída/exportação | Excel, CSV, JSON, Sheets, Notion, APIs | O dado não serve se não puder sair da ferramenta sem bagunça |
| Dificuldade de configuração | No-code, low-code ou code-first | Equipes precisam de níveis muito diferentes de controle |
| Preço / plano grátis | Preço público, teste, ponto de entrada realista | Os modelos de cobrança variam muito |
| Automação / integrações | Zapier, API, agendamento, webhooks | Exportação manual não escala |
| Melhor caso de uso | No que a ferramenta realmente é boa | A maioria não serve para tudo — ela é específica de um fluxo |
Para manter a leitura fluida, as 12 ferramentas se dividem em três categorias: scrapers de IA no-code, parsers SaaS ou baseados em templates e bibliotecas, APIs e ferramentas open source para desenvolvedores.
As 12 melhores ferramentas de PDF scraper em resumo
Aqui está a comparação principal para você identificar seu perfil e ir direto à seção certa:
| Ferramenta | Tipo | Extração de tabelas | OCR nativo | No-code | Plano grátis | Melhor para |
|---|---|---|---|---|---|---|
| Thunderbit | Scraper de IA no-code | ✅ Com IA | ✅ Sim | ✅ Sim | ✅ Créditos grátis | Usuários de negócio, layouts variados |
| Tabula | Desktop open source | ✅ Bom (PDFs com texto) | ❌ Não | ✅ Interface gráfica | ✅ Totalmente grátis | PDFs simples com muitas tabelas |
| Parseur | SaaS híbrido | ⚠️ Template + IA | ✅ Sim | ✅ Sim | ⚠️ Limitado | Processamento recorrente de faturas/e-mails |
| Nanonets | SaaS de IDP com IA | ✅ Forte | ✅ Sim | ✅ Low-code | ⚠️ Teste com créditos | Automação de documentos em alto volume |
| Adobe Acrobat | Suíte de produtividade PDF | ⚠️ Básico | ✅ Sim | ✅ Sim | ❌ Exportação paga | Conversões ocasionais de PDF para Excel |
| PyMuPDF | Biblioteca Python | ⚠️ Parsing manual | ❌ Não (Tesseract opcional) | ❌ Exige código | ✅ Totalmente grátis | Desenvolvedores, PDFs com muito texto |
| Camelot | Biblioteca Python para tabelas | ✅ Forte (lattice + stream) | ❌ Não | ❌ Exige código | ✅ Totalmente grátis | Desenvolvedores, tabelas complexas |
| Docparser | SaaS baseado em templates | ⚠️ Baseado em template | ✅ Sim | ✅ Sim | ⚠️ Teste | Documentos recorrentes + fluxos com Zapier |
| pdfplumber | Biblioteca Python | ✅ Bom (granular) | ❌ Não | ❌ Exige código | ✅ Totalmente grátis | Desenvolvedores, controle detalhado |
| AWS Textract | API em nuvem | ✅ Forte | ✅ Sim | ❌ Exige API | ⚠️ Plano grátis limitado | Pipelines em escala corporativa |
| Docling | Python open source | ✅ Bom | ✅ Via integração | ❌ Exige código | ✅ Totalmente grátis | Pipelines LLM/RAG |
| Parsio | SaaS híbrido | ⚠️ Com apoio de IA | ✅ Sim | ✅ Sim | ⚠️ Limitado | Tipos de documento recorrentes |
Quer zero configuração? Comece nas linhas de no-code ou SaaS. Precisa de máximo controle? Vá direto para as opções para desenvolvedores. Trabalhando com PDFs escaneados? Elimine qualquer ferramenta com OCR = Não.
1. Thunderbit
 Thunderbit é o PDF scraper que eu indicaria para qualquer pessoa que diga “só preciso tirar os dados desse PDF” e não queira ouvir falar de Python, templates ou chaves de API. É um agente de dados com IA — uma extensão do Chrome — que lê PDFs, imagens e sites, e devolve os dados em formato estruturado. Sem templates, sem código.
Criamos o Thunderbit para lidar com o cenário que derruba a maioria das ferramentas: você recebe PDFs de cinco fornecedores diferentes, cada um com um layout um pouco distinto, e precisa dos mesmos campos em todos eles. A IA lê cada documento do zero, sugere nomes de colunas e tipos de dados com o recurso AI Suggest Fields, e extrai tudo para uma tabela estruturada. O OCR integrado trata PDFs escaneados e imagens de forma nativa, com suporte a 34 idiomas.
Principais recursos:
- One Click Extract identifica colunas e tipos de dados em qualquer layout de PDF, sem configuração manual
- OCR integrado para PDFs escaneados e imagens
- Exportação para Excel, Google Sheets, Airtable, Notion, CSV e JSON — tudo grátis
- Rotulagem e reestruturação por IA: a IA pode traduzir, categorizar ou reorganizar os dados durante a extração, não só depois
- Extração de tabelas lê o layout visualmente, como uma pessoa, e se adapta a formatos sem borda, irregulares e de vários fornecedores
Como raspar um PDF com o Thunderbit:
- Instale a Thunderbit Chrome Extension
- Abra ou envie seu PDF no navegador
- Clique em “One Click Extract” — a IA lê o documento e identifica nomes e tipos de coluna
- Clique em “Scrape” — os dados são extraídos para uma tabela estruturada
- Exporte para Google Sheets, Excel, Airtable, Notion, CSV ou JSON
Preço: plano grátis com créditos (cerca de 6 páginas grátis, 10 com teste). Plano inicial a partir de ~US$ 15/mês ou cerca de US$ 9/mês no anual. Os créditos são cobrados por linha (1 crédito = 1 linha de saída). Veja Thunderbit Pricing para detalhes.
Melhor para: usuários não técnicos que lidam com layouts variados de PDF (faturas de vários fornecedores, relatórios em formatos mistos) e querem resultado com um clique.
Prós: configuração mais simples desta lista; OCR integrado; exportação direta para Sheets, Notion, Airtable e Excel; funciona em layouts variados sem templates.
Contras: a cobrança por créditos leva um pouco de tempo para entender em termos de custo por página; menos avaliações de terceiros que os grandes fornecedores SaaS.
Teste o Thunderbit para extração de PDFs Envie faturas de cinco fornecedores diferentes e deixe a IA descobrir as colunas de cada layout — sem configuração por template. Get Started Free
2. Tabula
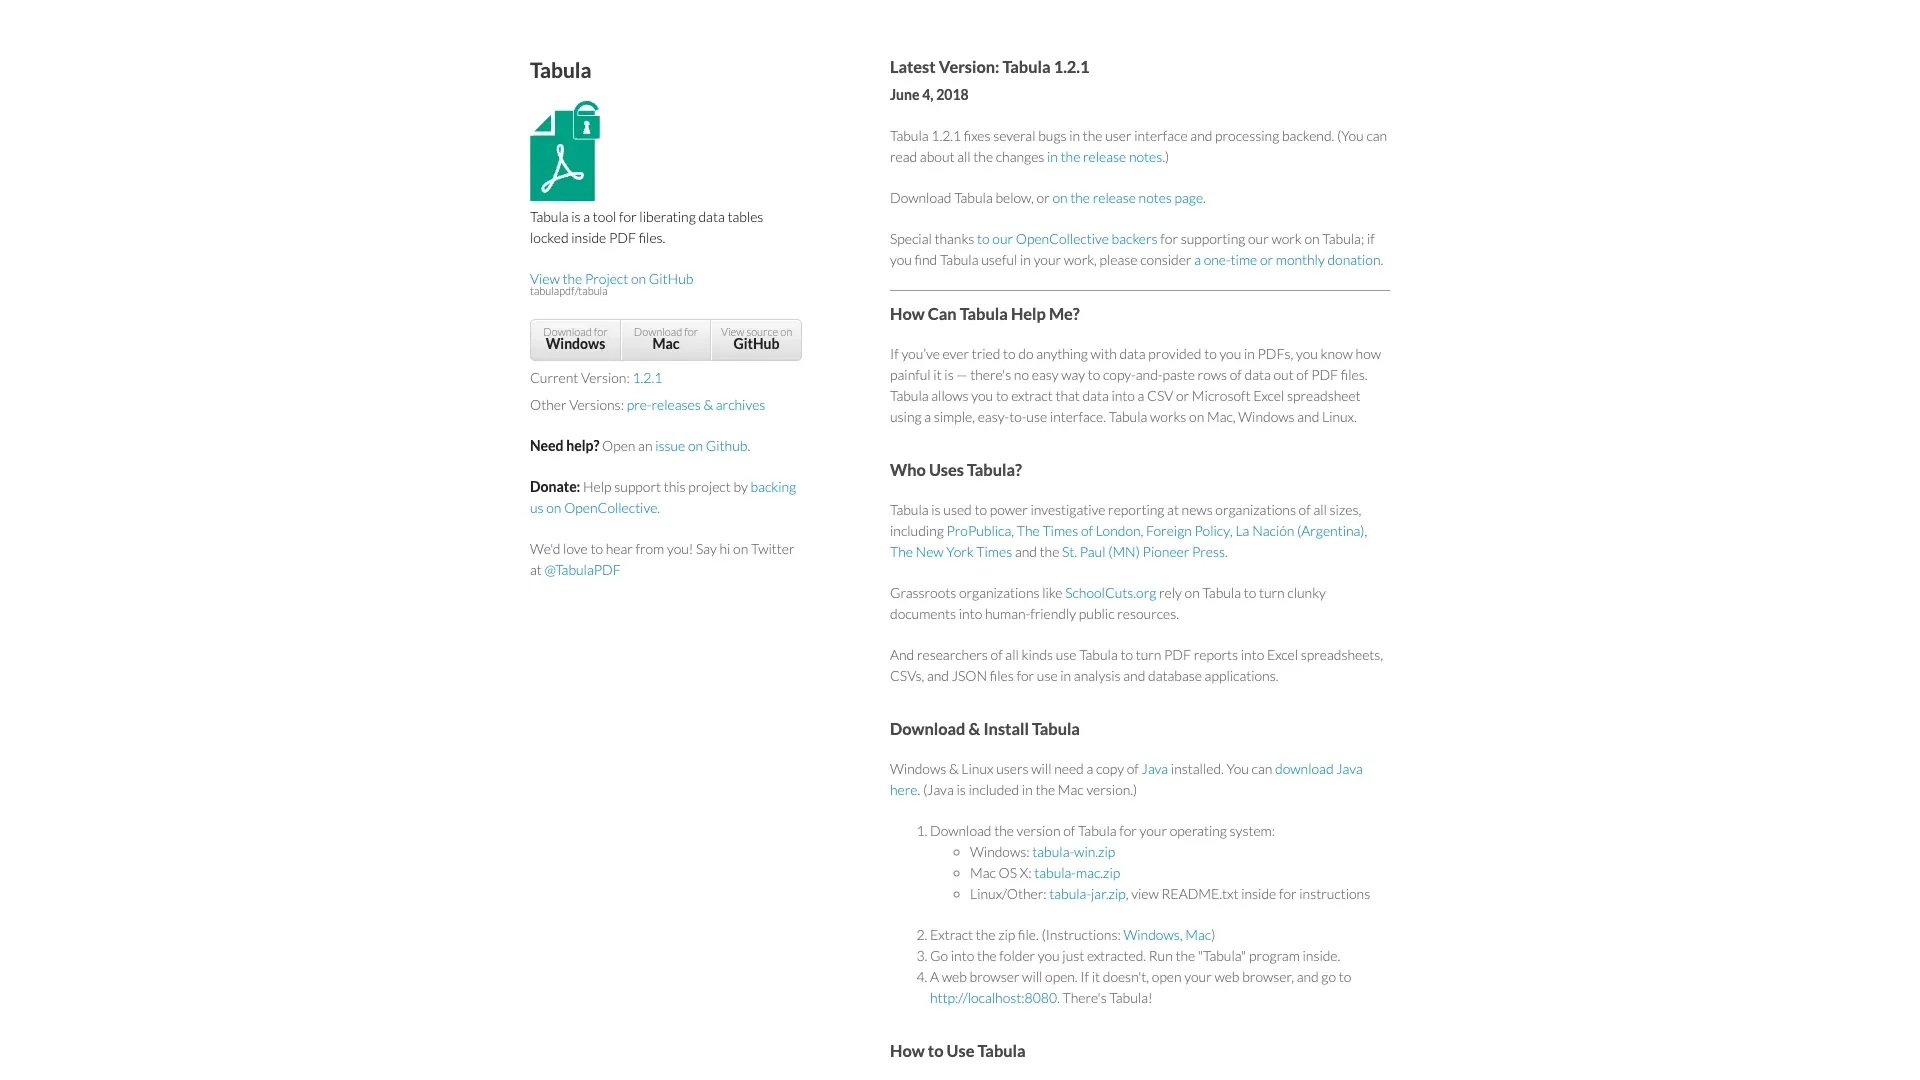 Tabula é a resposta clássica e gratuita para extração de tabelas em PDFs com texto, mas também já mostra sinais claros de projeto legado. O repositório informa que é mantido por voluntários e que é improvável receber atualizações em breve. A versão mais recente do app desktop continua sendo a 1.2.1, de 2018, enquanto o tabula-java lançou a 1.0.5 em 2021.
Principais recursos:
- Interface gráfica de apontar e clicar para selecionar áreas da tabela
- Funciona localmente — os dados nunca saem da sua máquina
- Sem conta, sem assinatura, sem cadastro
Preço: completamente grátis, para sempre. Open source.
Melhor para: quem trabalha com PDFs simples, baseados em texto, com tabelas bem delimitadas e quer uma solução local e gratuita.
Prós: grátis; local; extremamente simples para tabelas básicas.
Contras: sem OCR (PDFs escaneados não servem); fraco para tabelas sem borda; sem automação ou API; sem opção em nuvem; na prática, pouco mantido.
3. Parseur
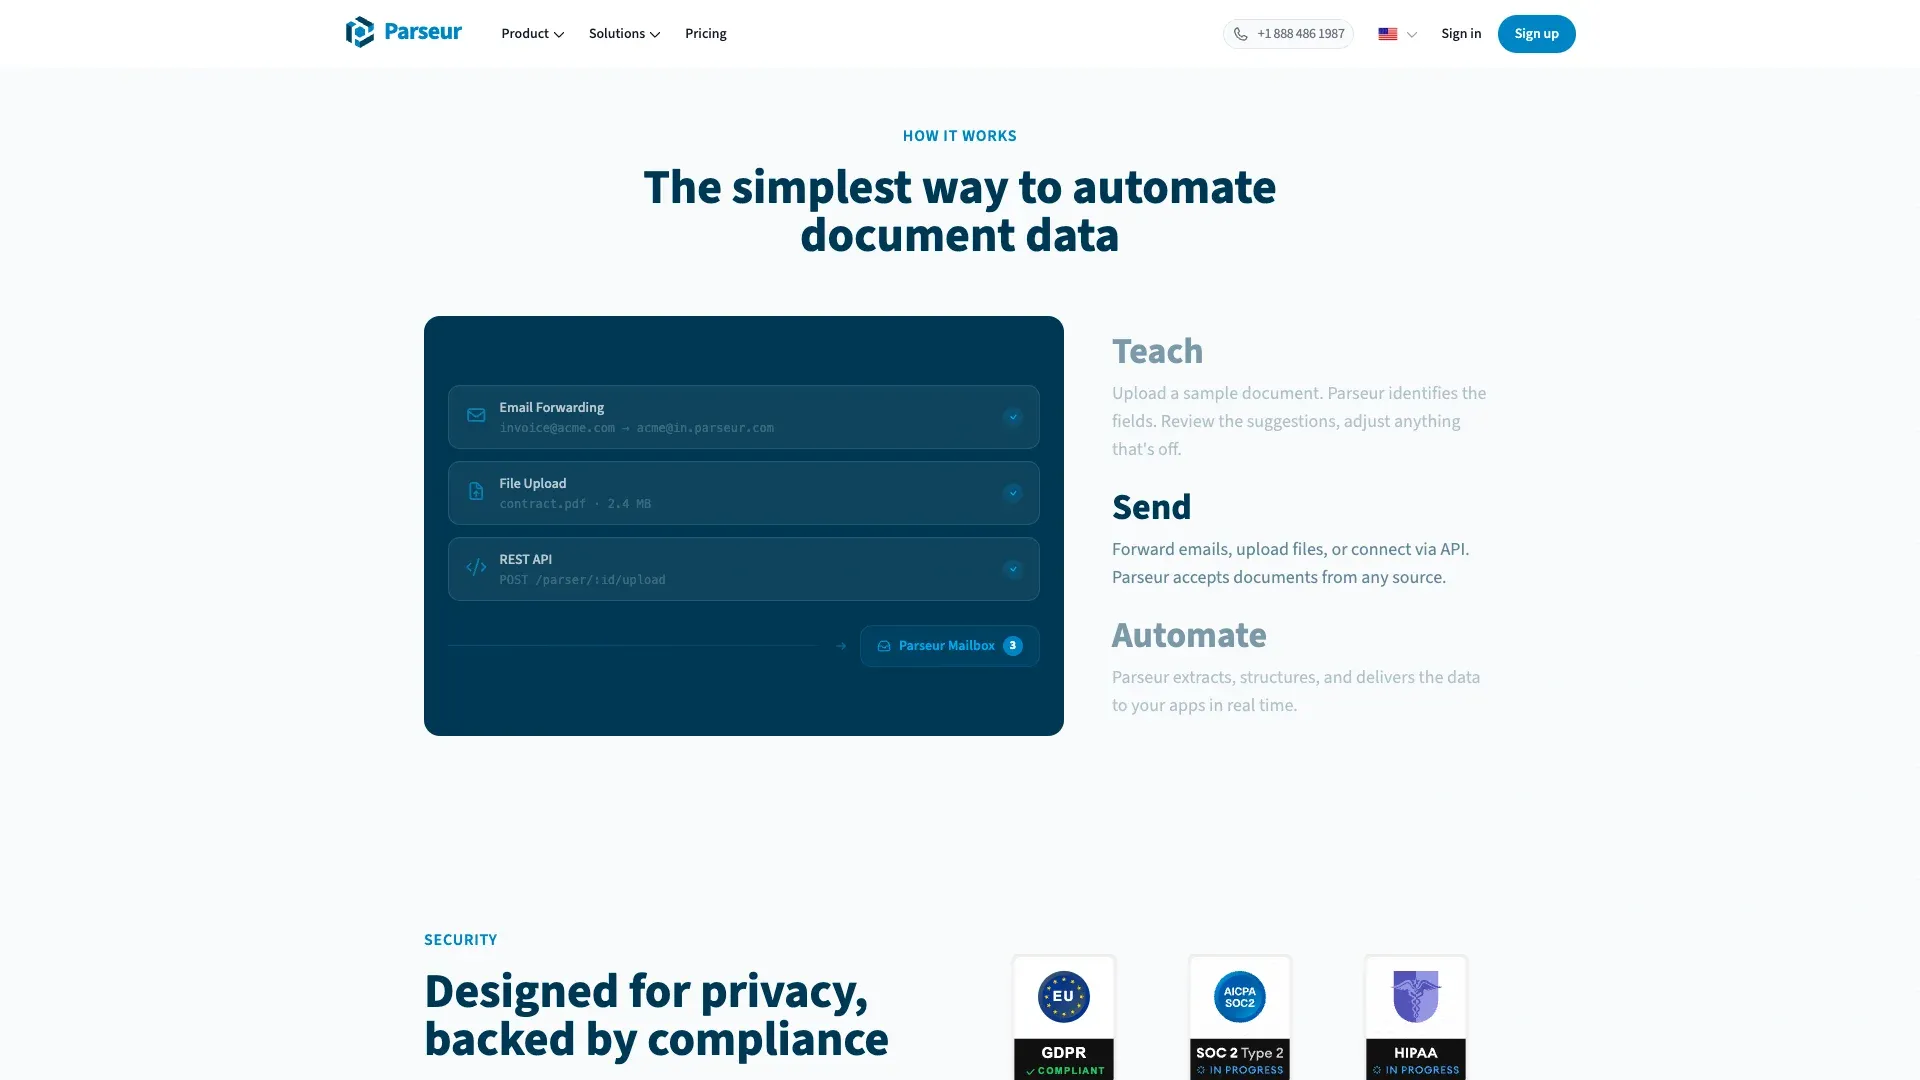 Parseur é a opção híbrida mais forte entre as SaaS porque combina parsing por IA, parsing por template e OCR dinâmico. Isso o torna mais flexível que um parser puramente zonal, mas ainda mais estruturado do que um scraper de IA totalmente genérico.
Principais recursos:
- OCR integrado com suporte a mais de 60 idiomas (160+ em modo experimental)
- Integrações com Zapier, Make, Power Automate, API, webhooks e Google Sheets
- Boa opção para faturas, avisos de envio, confirmações de pedido e tipos de documento recorrentes
Preço: plano grátis de cerca de 20 páginas/mês. O menor plano pago self-service fica em torno de US$ 39/mês. O custo normalizado no menor plano é de aproximadamente US$ 390 por 1.000 páginas, embora o valor efetivo caia em volumes maiores.
Melhor para: equipes que recebem sempre os mesmos tipos de documento e querem automação sem código.
Prós: OCR integrado; stack forte de automação; lida bem com layouts recorrentes.
Contras: cada novo layout ou mudança de layout pode exigir ajuste de template ou fallback da IA; estruturas de tabela complexas ainda são mais difíceis.
4. Nanonets
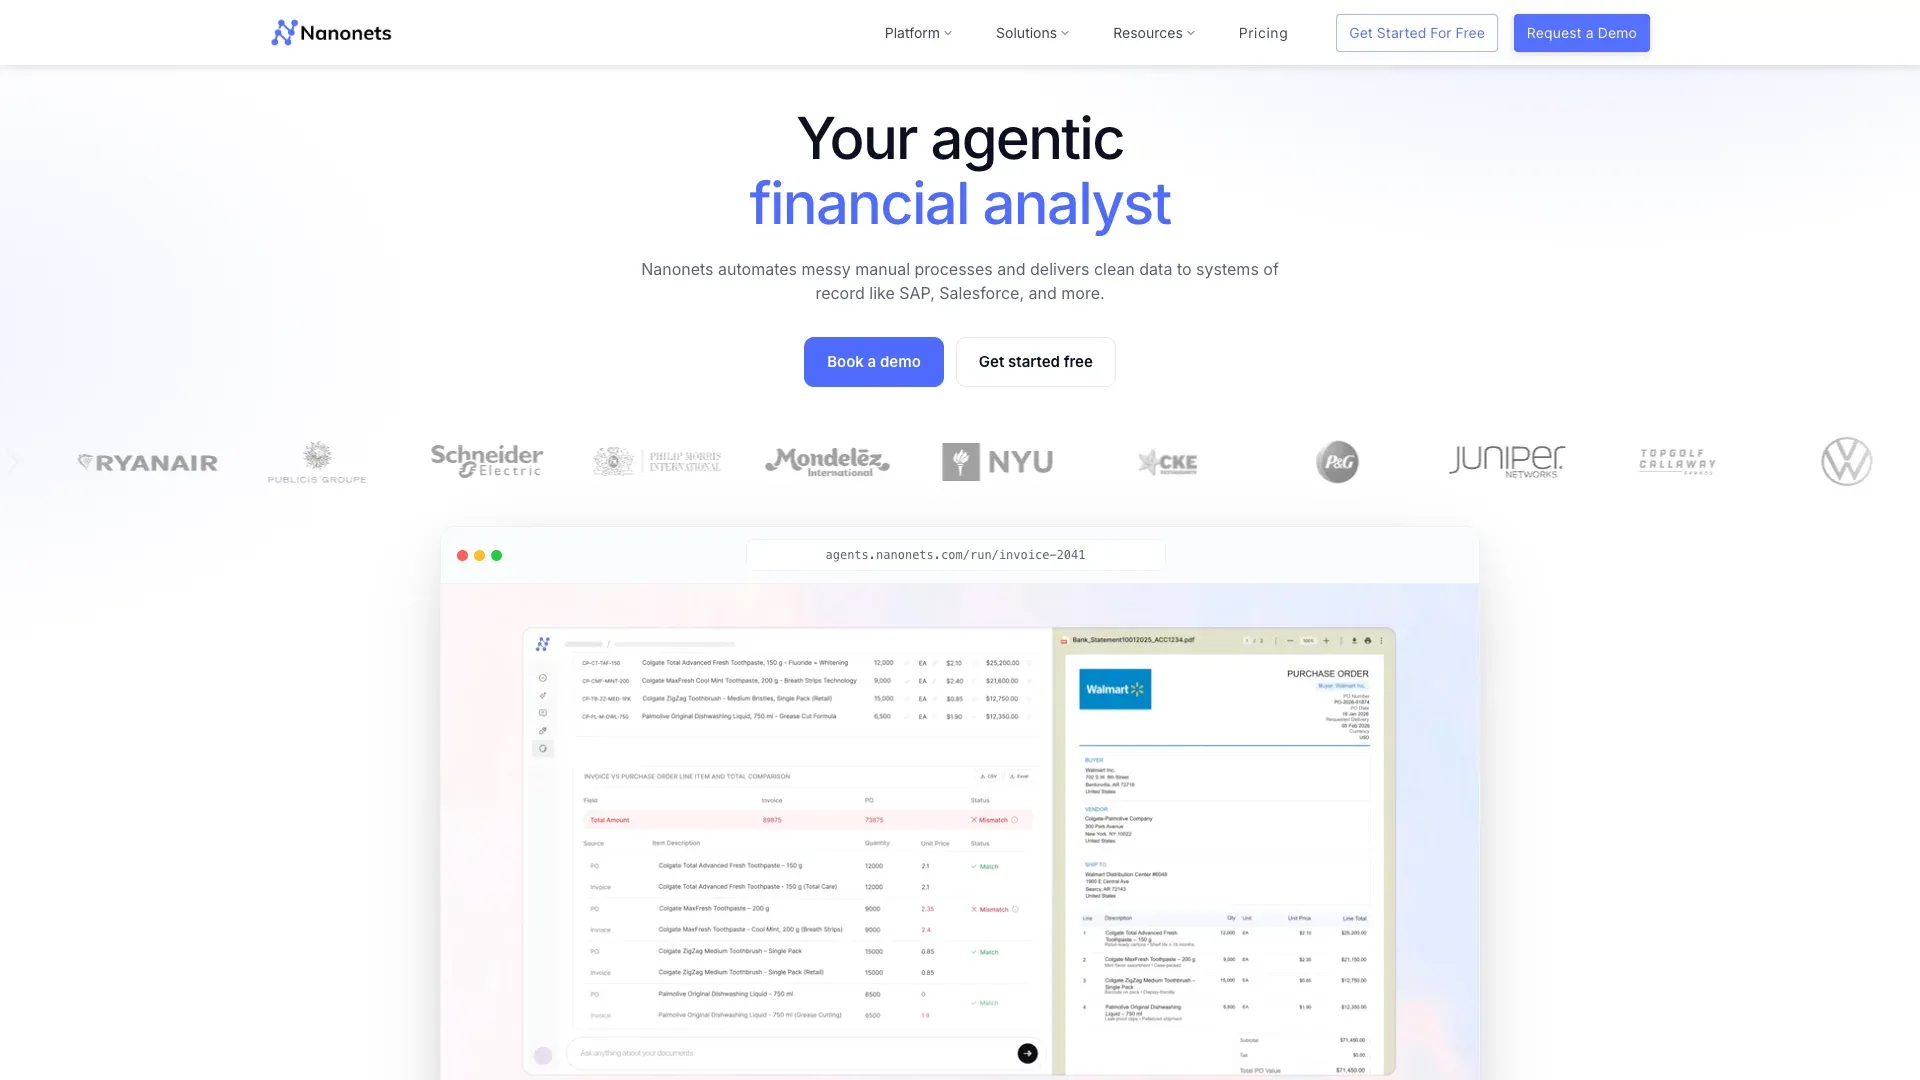 Nanonets está mais para uma plataforma de processamento inteligente de documentos (IDP) do que para um PDF scraper simples — e essa é, ao mesmo tempo, sua força e sua complexidade. A empresa mudou a precificação em 31 de janeiro de 2025, passando a usar créditos pré-pagos em vez de um plano simples por página.
Principais recursos:
- Extração de tabelas e detecção de campos com IA
- OCR integrado com suporte a mais de 40 idiomas
- Automação de fluxos com etapas de aprovação
- Ampla integração para empresas
Preço: créditos no cadastro. Cobrança por uso. Uma estimativa com base na documentação pública de preços por bloco fica em torno de US$ 300–US$ 380 por 1.000 páginas em um fluxo simples de extração.
Melhor para: equipes médias e grandes processando milhares de documentos por mês (automação de AP, logística, sinistros de seguro).
Prós: extração forte por IA; integrações corporativas; automação de workflows.
Contras: o preço é menos previsível; curva de aprendizado para fluxos avançados; plano grátis limitado.
5. Adobe Acrobat
 Adobe Acrobat é a ferramenta padrão de PDF que quase todo mundo reconhece. É forte em OCR e conversão, mas não é exatamente um scraper no mesmo sentido das outras opções desta lista.
Principais recursos:
- OCR integrado no Pro
- Exportação para Word, Excel, PowerPoint, HTML, TXT e formatos de imagem
- Amplo suporte a OCR em vários idiomas
Preço: Acrobat Standard a US$ 14,99/mês; Acrobat Pro a US$ 19,99/mês. O Reader é grátis, mas os recursos de exportação exigem plano pago.
Melhor para: usuários que ocasionalmente precisam converter PDF para Word ou Excel e já assinam o pacote Adobe.
Prós: amplamente confiável; OCR integrado; muita gente já usa.
Contras: extração de tabelas é básica em layouts complexos; sem automação ou API para processamento em lote; não foi feito para ser um “scraper”.
6. PyMuPDF
 PyMuPDF — também conhecido como “fitz” — continua sendo a biblioteca Python de extração de PDFs mais rápida e generalista deste ranking. A versão atual é a 1.27.2.2 de março de 2026, e os benchmarks seguem mostrando desempenho muito superior ao de muitas outras bibliotecas Python para PDF.
Principais recursos:
- Extração de texto bruto extremamente rápida
- Extração de imagens e acesso a metadados
- OCR opcional via Tesseract (embora a documentação observe que o OCR é cerca de 1.000x mais lento que a extração padrão)
- Detecção de tabelas com
find_tables()
Preço: completamente grátis, open source.
Melhor para: desenvolvedores construindo pipelines que lidam principalmente com PDFs nativos cheios de texto.
Prós: muito rápido; leve; comunidade ativa; extração de texto forte.
Contras: sem OCR nativo; extração de tabelas exige lógica manual; requer código.
7. Camelot
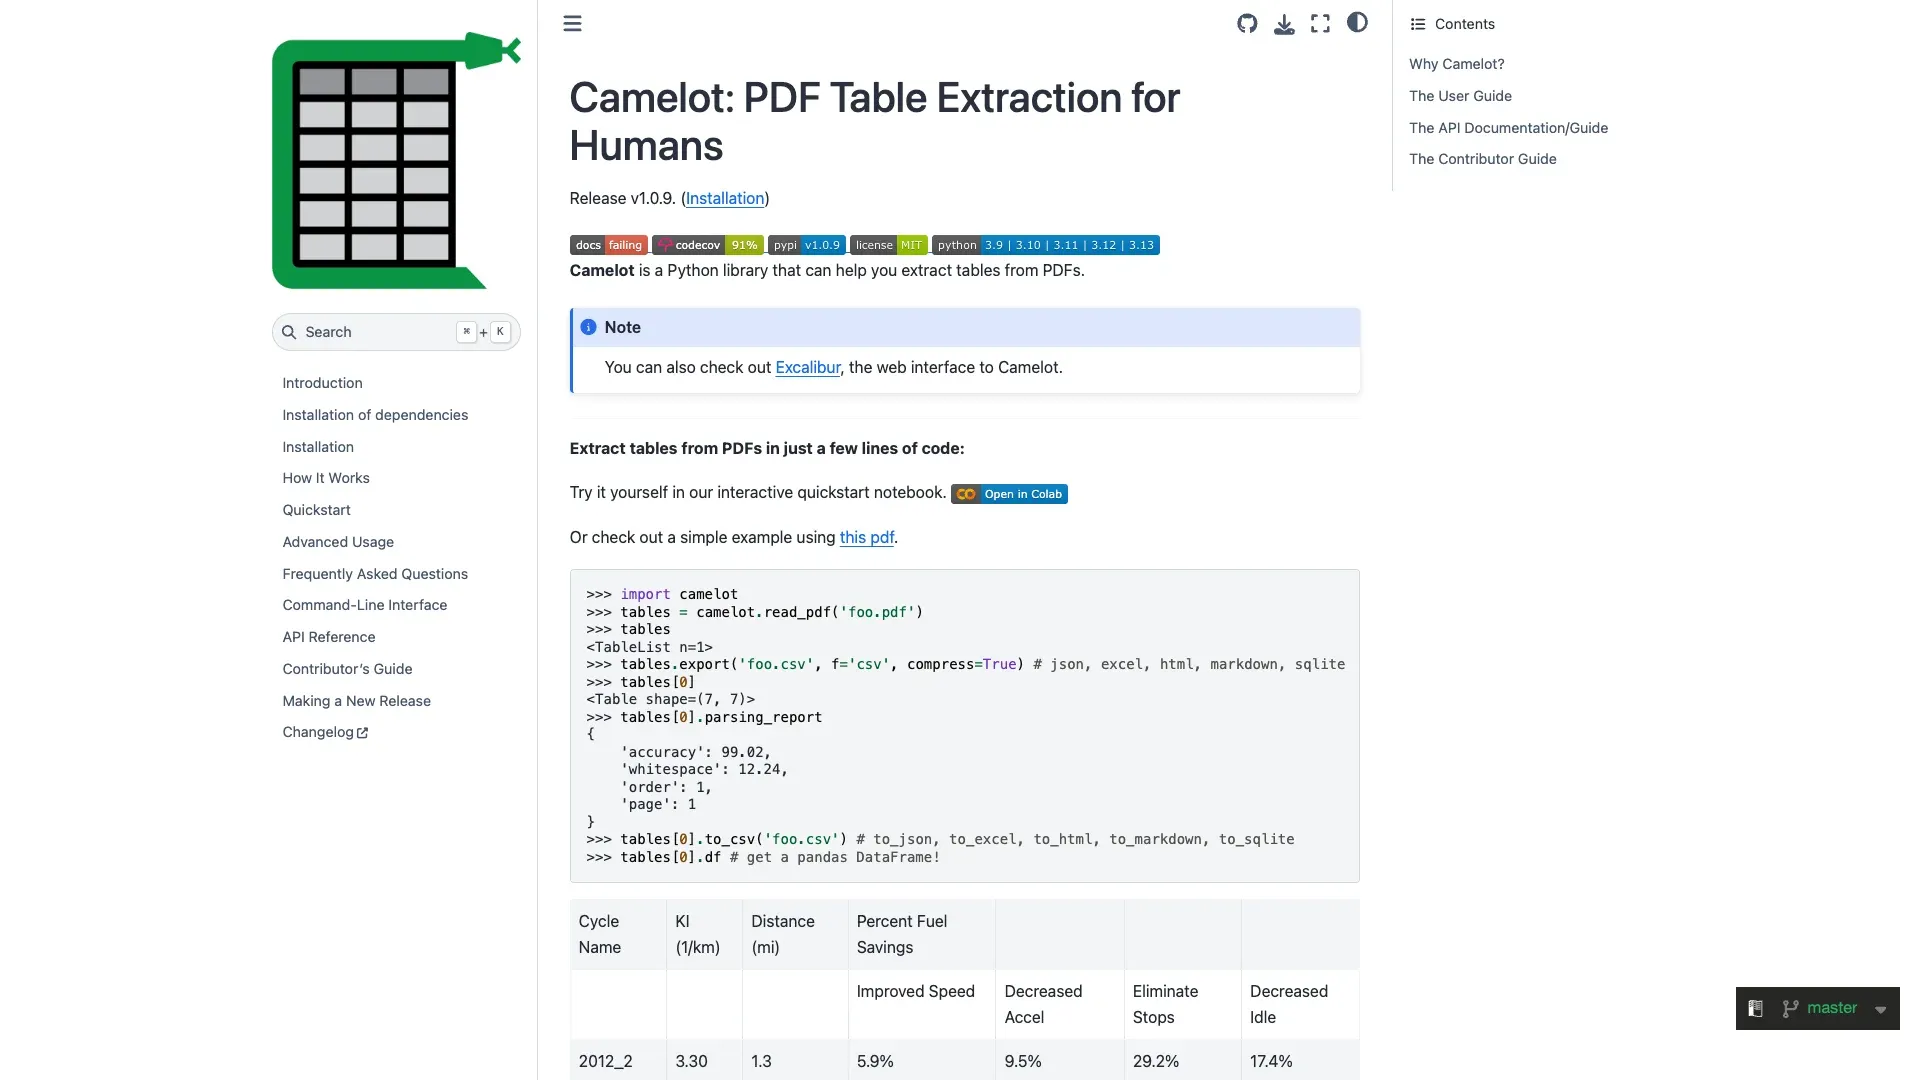 Camelot continua sendo uma das ferramentas Python mais conhecidas para extração de tabelas porque foi feita primeiro para tabelas, e não para documentos em geral. O repositório atual é mantido, com v1.0.9 lançada em agosto de 2025.
Principais recursos:
- Dois modos de extração:
latticepara tabelas com bordas estreampara tabelas sem bordas/baseadas em espaços em branco - Métricas de precisão no relatório de parsing — um dos recursos mais úteis do Camelot para automação
- Exporta para pandas DataFrames, CSV, JSON e Excel
Preço: completamente grátis, open source.
Melhor para: desenvolvedores que precisam de extração precisa de tabelas em PDFs estruturados baseados em texto.
Prós: excelente precisão em tabelas; dois modos de extração; pontuação de acurácia.
Contras: sem OCR; apenas PDFs com texto; exige código; pode ficar lento em documentos grandes.
8. Docparser
 Docparser é a ferramenta SaaS mais claramente guiada por regras nesta lista. Ela usa OCR zonal, palavras-chave âncora e regras de parsing para layouts fixos, em vez de tentar agir como um leitor de IA genérico para qualquer layout.
Principais recursos:
- OCR integrado
- Integrações com Zapier, Workato, Power Automate, Google Sheets, Salesforce e REST API
- Boa opção para encaminhar dados extraídos para fluxos de negócio
Preço: Starter a US$ 39/mês; Professional a US$ 74/mês; Business a US$ 159/mês. Teste grátis de 14 dias. A cobrança é por documento, então o custo normalizado por 1.000 páginas depende do tamanho do documento — aproximadamente US$ 78–US$ 390 no nível Starter.
Melhor para: equipes que precisam automatizar fluxos recorrentes de documentos com integração forte a ferramentas como Zapier ou Salesforce.
Prós: OCR integrado; integrações robustas de workflow; ótimo para layouts estáveis.
Contras: baseado em template — cada layout novo exige configuração; a extração de tabelas depende da definição de zonas; funciona melhor na primeira página.
9. pdfplumber
 pdfplumber continua sendo a biblioteca mais granular para desenvolvedores desta seleção. A versão atual é 0.11.9 de janeiro de 2026, e o repositório informa que o projeto está em desenvolvimento ativo.
Principais recursos:
- Controle detalhado sobre caracteres, linhas, retângulos e estratégias de detecção de tabelas
- Filtragem por recorte e depuração visual
- Saída em listas/dicionários Python para manipulação fácil
Preço: completamente grátis, open source.
Melhor para: desenvolvedores Python que precisam de lógica de extração de tabelas altamente granular e personalizável.
Prós: controle excelente em baixo nível; boa precisão em tabelas complexas; desenvolvimento ativo.
Contras: sem OCR; curva de aprendizado maior que a do Camelot; exige código.
10. AWS Textract
 AWS Textract é a API mais nativa de ambiente corporativo desta lista. Ela foi feita para escala, variedade de documentos e uso programático — não para conveniência de interface gráfica.
Principais recursos:
- Extração de tabelas e formulários com IA
- OCR integrado com suporte a escrita à mão (o mais próximo desta lista, mas ainda imperfeito)
- Escalabilidade de nível corporativo
- Integração limpa com o ecossistema AWS
Preço: cobrança por página. Plano grátis: 1.000 páginas/mês por 3 meses. Depois disso: OCR apenas texto a US$ 1,50/1.000 páginas; tabelas a US$ 15/1.000 páginas; formulários + tabelas a US$ 65/1.000 páginas; documentos de despesas a US$ 10/1.000 páginas.
Melhor para: times corporativos processando mais de 10.000 documentos/mês por meio de uma pipeline via API.
Prós: extração precisa de formulários e tabelas; OCR integrado; escalabilidade corporativa.
Contras: só API; sem interface visual; os custos sobem rápido nos modos avançados; dependência do ecossistema AWS.
11. Docling
 Docling é a ferramenta open source mais voltada ao futuro desta lista porque foi criada diretamente para pipelines de documento para LLM. A versão atual é 2.90.0 de 17 de abril de 2026, e o projeto evolui rapidamente.
Principais recursos:
- Exporta para Markdown, HTML, WebVTT, DocTags e JSON sem perda
- Suporte a OCR por meio de vários motores integrados
- Feito para LangChain, LlamaIndex, CrewAI, Haystack e ecossistemas semelhantes
- Forte crescimento da comunidade
Preço: completamente grátis, open source.
Melhor para: desenvolvedores criando aplicações LLM/RAG que precisam converter PDFs em Markdown estruturado, pronto para IA.
Prós: saída Markdown limpa; OCR via integração; pensado para fluxos modernos de IA; desenvolvimento ativo.
Contras: exige código; voltado principalmente para desenvolvedores; interface gráfica e opções de exportação menos refinadas que as de ferramentas SaaS.
12. Parsio
 Parsio é um parser SaaS híbrido que combina templates, OCR, parsing com IA e parsing com GPT. Ele fica, em espírito, entre Parseur e Docparser: mais flexível que zonas puras, mas ainda otimizado para entrada recorrente de documentos.
Principais recursos:
- OCR integrado
- Detecção de campos com apoio de IA
- Integrações com Google Sheets, webhooks, API, Zapier, Make, n8n e Pabbly
Preço: Sandbox com 30 créditos. Starter a US$ 41/mês para 1.000 créditos; Growth a US$ 124/mês; Business a US$ 249/mês. Um documento processado ou uma página de PDF pode custar 1, 2 ou 5 créditos, dependendo do modo do parser, então a estimativa normalizada no plano Starter fica em torno de US$ 41–US$ 205 por 1.000 páginas.
Melhor para: equipes pequenas e médias que processam tipos recorrentes de documentos (faturas, recibos) e querem uma solução SaaS no-code com leve uso de IA.
Prós: OCR integrado; ampla cobertura de tipos de documento; amplo stack de automação.
Contras: pouca profundidade em avaliações de terceiros; os preços ficam menos transparentes entre os modos de parser; menos claramente diferenciado que Parseur ou Nanonets.
Comparativo de extração de tabelas: como os melhores PDF scrapers lidam com tabelas reais
A extração de tabelas é, de longe, o maior ponto de dor entre usuários de PDF scraper — e por um bom motivo. Benchmarks recentes como o OmniDocBench (1.651 páginas em 10 tipos de documento) e trabalhos acadêmicos sobre extração heterogênea de tabelas confirmam que “extração de tabelas” não é uma única tarefa uniforme. É um espectro.
Tabelas simples (bordas claras, uma página)
A maioria das ferramentas lida bem com isso. Tabula, Camelot, pdfplumber, Thunderbit e AWS Textract têm bom desempenho aqui. Se seus PDFs só têm tabelas simples com bordas, quase qualquer ferramenta desta lista serve.
Tabelas sem bordas e com espaçamento em branco
Aqui a diferença fica evidente. Sem linhas delimitadoras, parsers baseados em regras têm dificuldade para detectar os limites das colunas. O modo stream do Camelot e o ajuste manual de parâmetros do pdfplumber são fortes para desenvolvedores que conseguem calibrar as configurações. Ferramentas com IA como Thunderbit, Nanonets e AWS Textract interpretam o layout visualmente, o que costuma funcionar melhor para não desenvolvedores lidando com formatos inconsistentes.
Tabelas que continuam em mais de uma página
Um caso comum de falha. Ferramentas baseadas em templates e extratores simples muitas vezes tratam cada página como uma tabela separada, a menos que o fluxo reconecte isso explicitamente. Ferramentas orientadas por IA levam vantagem porque interpretam a continuidade de forma semântica, não apenas geométrica — embora nenhuma fornecedora deva ser tratada como perfeita nesse cenário.
Células mescladas e cabeçalhos aninhados
O cenário mais difícil. O artigo de 2024 da EMNLP sobre extração heterogênea de informações de tabelas mostra F1 entre 74,2 e 96,1, dependendo do método e do cenário. Ferramentas com IA (Thunderbit, Nanonets, AWS Textract) tendem a superar parsers baseados em regras aqui porque interpretam o layout de forma semântica em vez de depender só das linhas da tabela.
OCR em comparação: quais PDF scrapers lidam com documentos escaneados?
OCR é a linha que separa ferramentas capazes de lidar com PDFs reais de negócios e ferramentas que só trabalham bem com documentos ideais gerados por máquina. Aqui está a matriz:
| Ferramenta | OCR nativo | Suporte a PDF escaneado | OCR multilíngue | Suporte à escrita à mão |
|---|---|---|---|---|
| Thunderbit | ✅ Integrado | ✅ Sim | ✅ 34 idiomas | ⚠️ Limitado |
| Adobe Acrobat | ✅ Integrado | ✅ Sim | ✅ Forte | ⚠️ Limitado |
| AWS Textract | ✅ Integrado | ✅ Sim | ✅ Vários idiomas principais | ✅ O mais próximo, mas imperfeito |
| Nanonets | ✅ Integrado | ✅ Sim | ✅ 40+ idiomas | ⚠️ Limitado |
| Parseur | ✅ Integrado | ✅ Sim | ✅ 60+ idiomas | ❌ Não |
| Parsio | ✅ Integrado | ✅ Sim | ✅ Multilíngue | ⚠️ Limitado |
| Docparser | ✅ Integrado | ✅ Sim | ✅ Sim | ⚠️ Limitado |
| Docling | ✅ Via integração | ✅ Sim | Depende do motor | ⚠️ Limitado |
| Tabula | ❌ Nenhum | ❌ Não | N/A | N/A |
| PyMuPDF | ❌ (Tesseract opcional) | ❌ Requer complemento | Depende do motor | Depende do motor |
| Camelot | ❌ Nenhum | ❌ Não | N/A | N/A |
| pdfplumber | ❌ Nenhum | ❌ Não | N/A | N/A |
Nenhuma ferramenta lida de forma confiável com escrita à mão em todos os casos em 2026. O AWS Textract é a API corporativa mais próxima disso, mas escrita manual ainda é um recurso para usar com cautela. Se seus PDFs são escaneados, mas digitados, qualquer ferramenta com OCR integrado vai atender bem. Se forem manuscritos, vale ajustar a expectativa.
Com IA, regras ou templates: três gerações de extração de PDFs
A forma mais fácil de entender o mercado de PDF scraper em 2026 é pensar em três gerações:
Geração 1: baseada em regras (Tabula, Camelot, pdfplumber)
Funciona melhor em PDFs estruturados, com texto e layouts consistentes. É poderosa nas mãos de desenvolvedores, mas frágil quando o layout varia. Se seus documentos forem previsíveis, ainda são excelentes — e grátis.
Geração 2: baseada em templates (Parseur, Docparser, Parsio)
O usuário define zonas ou campos para cada tipo de documento. Ótimo para formatos recorrentes, como faturas do mesmo fornecedor. O problema: todo layout novo ou mudança no layout exige configuração ou manutenção.
Geração 3: com IA/LLM (Thunderbit, Nanonets, AWS Textract, Docling para pipelines LLM)
A IA lê o documento de forma semântica, se adapta a novos layouts sem templates e consegue rotular e transformar os dados ao mesmo tempo. É para onde o mercado está indo. Tanto a avaliação de IDP de 2025 da Everest Group quanto a pesquisa multimodal de tabelas da ACL 2025 apontam extração baseada em LLMs e agentes como o próximo padrão.
Para usuários não técnicos, isso importa na prática: se seus PDFs vêm de muitas fontes diferentes (fornecedores, parceiros, clientes), ferramentas baseadas em template viram um fardo de manutenção. Ferramentas com IA lidam com variedade logo de saída. Esse é justamente o espaço para o qual o Thunderbit foi criado — usuários de negócio com PDFs diversos e zero interesse em escrever Python ou manter templates de extração.
Extração de PDF com IA para layouts variados Um único esquema não precisa servir para todos os fornecedores — a IA lê cada documento e entende a estrutura sozinha. Get Started Free
Análise de preço: quanto custam de verdade os melhores PDF scrapers
Essa é a comparação que ninguém mais publica, e é a que os usuários mais perguntam. Aqui vai a visão honesta:
| Ferramenta | Plano grátis | Preço inicial pago | Custo estimado por 1.000 páginas | Open source? |
|---|---|---|---|---|
| Thunderbit | ✅ Créditos grátis | ~US$ 15/mês (US$ 9/mês no anual) | ~US$ 18–US$ 30 | Não |
| Tabula | ✅ Ilimitado | Grátis para sempre | US$ 0 | Sim |
| Camelot | ✅ Ilimitado | Grátis para sempre | US$ 0 | Sim |
| PyMuPDF | ✅ Ilimitado | Grátis para sempre | US$ 0 | Sim |
| pdfplumber | ✅ Ilimitado | Grátis para sempre | US$ 0 | Sim |
| Docling | ✅ Ilimitado | Grátis para sempre | US$ 0 | Sim |
| Parseur | ⚠️ ~20 páginas/mês | ~US$ 39/mês | ~US$ 390 (nível mais baixo) | Não |
| Nanonets | ⚠️ Créditos no cadastro | Cobrança por uso | ~US$ 300–US$ 380 | Não |
| Docparser | ⚠️ Teste de 14 dias | US$ 39/mês | ~US$ 78–US$ 390 | Não |
| Parsio | ⚠️ 30 créditos | US$ 41/mês | ~US$ 41–US$ 205 | Não |
| Adobe Acrobat | ❌ (exportação é paga) | US$ 19,99/mês no Pro | Não cobrado por página | Não |
| AWS Textract | ⚠️ 1.000 páginas/mês (3 meses) | Pagamento por uso | US$ 1,50–US$ 65 | Não |
A troca entre custo e esforço escondido importa mais do que o preço na vitrine. Ferramentas Python open source são gratuitas em dólares, mas exigem tempo de desenvolvedor para configurar, manter e depurar. SaaS baseados em template são simples quando há pouca variação, mas ficam caros quando os layouts mudam. Ferramentas de IA no-code como o Thunderbit cobram créditos por linha, mas reduzem drasticamente o tempo de setup. APIs em nuvem como AWS Textract são as mais baratas em escala — mas só quando você já tem engenharia montada.
Quando penso em “custo real”, incluo o salário de quem faz o trabalho. Uma hora do tempo de um analista de dados configurando templates ou escrevendo Python não é gratuita, mesmo que o software seja.
Qual PDF scraper você deve escolher?
Aqui vai um guia rápido de decisão:
| Sua situação | Ferramenta(s) recomendada(s) |
|---|---|
| Não técnico, layouts variados, quer resultado rápido | Thunderbit, Nanonets |
| Faturas/recibos recorrentes no mesmo formato | Parseur, Docparser, Parsio |
| Desenvolvedor construindo uma pipeline de dados | PyMuPDF, Camelot, pdfplumber |
| Empresa, mais de 10.000 docs/mês, precisa de API | AWS Textract, Nanonets |
| Criando aplicação LLM/RAG | Docling |
| PDF para Excel ocasional, já tem Adobe | Adobe Acrobat |
| Grátis, local, focado em tabelas, sem código | Tabula |
Se você é um usuário de negócio que só quer tirar dados de PDFs sem programar e sem configurar templates, comece com o Thunderbit. Ele lê cada PDF do zero com IA e exporta para as ferramentas que você já usa. Se os seus documentos se repetem em layouts reconhecíveis, Parseur ou Docparser são opções melhores. E, se você quer controle de engenharia, o ecossistema open source ainda é o ponto de partida mais econômico.
Conclusão
A extração de PDFs em 2026 já não é um único problema com uma única resposta. A ferramenta certa depende de você ser desenvolvedor, analista de negócios ou equipe corporativa — e de seus PDFs serem textos organizados ou imagens escaneadas caóticas de uma dúzia de fornecedores.
Se quiser ver na prática como funciona a extração de PDFs com IA, teste o plano grátis do Thunderbit. Acho que você vai se surpreender com a quantidade de informação que dá para tirar de um PDF em poucos cliques. E, se o Thunderbit não for a opção perfeita, experimente algumas das outras ferramentas desta lista. Nunca houve momento melhor para parar de copiar e colar de PDFs e começar a usar de verdade os dados que eles contêm.
Para mais conteúdos sobre extração de dados e automação, confira nossos guias sobre extrair dados de sites para o Excel, melhores ferramentas de extração de dados, extração de dados com IA para negócios e como converter imagens para Excel. Você também pode assistir a tutoriais passo a passo no canal do Thunderbit no YouTube.
Teste o Thunderbit grátis Tabelas, OCR e relatórios em formatos mistos em uma única passada. O plano grátis já serve para testar se ele lida com os seus documentos. Get Started Free
FAQs
1. Qual é o melhor PDF scraper grátis?
Para quem não programa, Tabula é a ferramenta com interface gráfica mais simples e totalmente gratuita para tabelas em PDFs com texto. Para desenvolvedores, Camelot, pdfplumber, PyMuPDF e Docling são ótimas opções grátis. Para uma opção no-code com plano grátis, Thunderbit é o melhor ponto de partida.
2. PDF scrapers conseguem lidar com documentos escaneados?
Só as ferramentas com OCR integrado lidam diretamente com PDFs escaneados. Isso inclui Thunderbit, Adobe Acrobat, AWS Textract, Nanonets, Parseur, Docparser, Parsio e Docling (com motores OCR integrados). Tabula, Camelot e pdfplumber não conseguem lidar com PDFs escaneados sozinhos — precisam ser combinados com OCR externo, como o Tesseract.
3. Quão precisa é a extração de tabelas em PDFs?
Depende muito da complexidade da tabela. A maioria das ferramentas lida bem com tabelas simples com bordas. Tabelas sem bordas, células mescladas e tabelas em várias páginas são bem mais difíceis. Ferramentas com IA como Thunderbit, Nanonets e AWS Textract costumam superar parsers baseados em regras em layouts variados, enquanto ferramentas baseadas em regras ainda podem ser excelentes em PDFs estáveis, baseados em texto.
4. Preciso saber programar para raspar PDFs?
Não. Ferramentas como Thunderbit, Parseur, Docparser, Parsio, Nanonets e Adobe Acrobat podem ser usadas sem código. Tabula também tem interface gráfica. Bibliotecas Python como PyMuPDF, Camelot, pdfplumber e Docling exigem programação.
5. Posso exportar dados de PDF direto para Excel ou Google Sheets?
A maioria das ferramentas permite exportar pelo menos para CSV ou Excel. O Thunderbit também exporta diretamente para Google Sheets, Airtable e Notion gratuitamente. Parseur, Docparser e Parsio suportam exportação para fluxos de negócio por meio de integrações como Zapier, webhooks e APIs.
Teste a extração de PDF com IA no Thunderbit Get Started Free
Saiba mais



