
No mês passado, a integração Stripe de um amigo começou, do nada, a devolver erros 503 às 23h de uma sexta-feira. Só repararam na manhã de sábado — quando a caixa de suporte já tinha mais de 200 e-mails furiosos de clientes com checkouts a falhar.
Esse tipo de história não é nada raro. Um benchmark bastante citado estima o custo médio de downtime em US$ 5.600 por minuto, enquanto falhas de alto impacto podem chegar a milhões por hora. O valor real depende de tráfego, taxa de conversão, ticket médio, impacto de SLA e custo de recuperação — mas a mensagem principal é bem clara: APIs sem monitoramento são risco de negócio, não só dor de cabeça para engenharia. E, com organizações usando em média 131 APIs de terceiros e apenas 16% dizendo ter alta capacidade de mitigar riscos de APIs terceirizadas, monitoramento deixou de ser opcional. O que eu quis fazer com este guia é algo que não vi em outros lugares: organizar as ferramentas por caso de uso, avaliar a qualidade dos alertas (e não só a existência deles), mostrar preços reais de 2026 e medir o quão rápido você consegue colocar tudo para rodar. Nada de mais uma lista genérica de logos.
Mais um ponto: se o teu trabalho com APIs envolve coletar dados da web, alimentar LLMs, construir sistemas RAG, acompanhar páginas de concorrentes ou extrair preços e dados de produtos de sites, a conversa sobre "ferramentas de API" não devia parar no monitoramento de uptime. Você também precisa de uma forma confiável de transformar páginas bagunçadas em dados estruturados. É aí que o Thunderbit Open API entra neste guia: ele não é um monitor de uptime, mas é uma das formas mais rápidas de converter sites em Markdown limpo ou JSON baseado em schema via API.
O Que é Monitoramento de API (e Por Que Sua Equipe Deveria Ligar Para Isso)?
Monitoramento de API significa verificar, sem parar, se os teus endpoints estão disponíveis, rápidos e devolvendo os dados certos. Não é só "o servidor está no ar?" — um bom monitor valida códigos de status HTTP, conteúdo da resposta, latência, certificados SSL, fluxos em várias etapas (como login → busca → checkout) e até a conformidade do schema.
Isso é diferente do monitoramento geral de sites (que vê se uma página carrega) e também do APM (Application Performance Monitoring), que mergulha em traces de código, queries de banco e detalhes internos de execução. O monitoramento de API fica na fronteira: ele testa o que usuários, parceiros e integrações realmente sentem ao chamar os teus endpoints.
Também existe uma categoria relacionada que vale destacar: APIs de dados web. Elas não servem para monitorar se a tua própria API está saudável; elas ajudam teu produto ou fluxo de trabalho a coletar dados externos da web de forma confiável. Por exemplo, o Thunderbit Open API pode transformar uma página em Markdown limpo, extrair campos estruturados em JSON e executar tarefas em lote em várias URLs. Se o teu projeto de "API" depende de dados atualizados de fornecedores, páginas de produto, listagens públicas, páginas de documentação ou fontes de pesquisa, esse tipo de API de extração de dados pode ser tão importante operacionalmente quanto um teste de uptime.
Por que gente fora da engenharia deveria ligar para isso? Porque APIs respondem por 71% do tráfego web dinâmico e 62% dos profissionais de API dizem que APIs geram receita diretamente. Quando um gateway de pagamento, serviço de autenticação ou API de frete cai, isso não é um problema abstrato de infraestrutura — é perda de receita, quebra de contrato com parceiros, aumento de chamados e erosão de confiança. Product, vendas, operações e sucesso do cliente também entram nessa conta.
Métricas-chave para acompanhar:
- Percentual de uptime: parcela do tempo em que o endpoint fica disponível
- Tempo de resposta / latência: quanto tempo o endpoint leva para responder (média, p95, p99)
- Taxa de erro: parcela de requisições que retornam 5xx, timeouts ou falhas de asserção
- Throughput: requisições por segundo/minuto
- Corretude: se a API devolve os dados esperados, e não apenas um 200 OK
Como Avaliamos as Melhores Ferramentas de Monitoramento de API para 2026
A maioria dos artigos sobre "melhores ferramentas de monitoramento de API" só empilha nomes de fornecedores e recursos. Eu quis ser mais rigoroso na seleção — em parte porque passei bastante tempo lendo fóruns de devs, e em parte porque a equipa do Thunderbit me ajudou a extrair em massa dados de preços e recursos dos sites dos fornecedores para montar uma comparação real (mais sobre esse fluxo adiante).
Foi isso que pesou na avaliação:
| Critério | Por que isso importa |
|---|---|
| Facilidade de configuração / tempo até o primeiro alerta | Times pequenos precisam de cobertura hoje, não depois de um projeto de plataforma |
| Inteligência de alertas e redução de ruído | Se o alerta é barulhento, o time ignora e perde incidentes reais |
| Generosidade do plano grátis | Side projects e startups no início geralmente começam sem pagar |
| Transparência de preço | Custos de observabilidade podem explodir com hosts, usuários, logs, execuções sintéticas e ingestão de dados |
| Amplitude de integrações | Os alertas precisam cair onde o time já trabalha (Slack, PagerDuty etc.) |
| Escalabilidade e profundidade de dados | Times maduros precisam de traces, logs, APM, RBAC, SSO e retenção |
| Qualidade da comunidade e do suporte | Times open source precisam de ritmo de releases; times enterprise precisam de SLA |
| Capacidade de extração de dados da web | Apps de IA, fluxos de RAG e ferramentas de pesquisa de mercado muitas vezes precisam de dados externos limpos, não só uptime de endpoint |
Também separamos as recomendações por caso de uso — dev solo, startup, e-commerce/SaaS, enterprise, purista de open source, time de produto de API e time de dados web/IA — para que você possa ir direto ao que interessa, em vez de ler 14 resumos de ferramentas tentando adivinhar qual combina contigo. A pesquisa de observabilidade de 2025 da Grafana mostrou que 46% dos respondentes citaram interoperabilidade e 35% citaram facilidade de troca futura como critérios de escolha, o que confirma que isso não é detalhe.
Melhores Ferramentas de Monitoramento de API por Caso de Uso: Tabela Rápida
Este é o atalho. Encontre a tua linha e depois pule para a seção da ferramenta para ver o detalhamento completo.
| Caso de Uso | Ferramentas Recomendadas | Diferencial Principal |
|---|---|---|
| Times de dados web / apps de IA | Thunderbit Open API, Moesif, Apitally | Transformar sites em Markdown limpo ou JSON estruturado para fluxos de LLM, RAG, precificação e pesquisa |
| Dev solo / side project | UptimeRobot, Uptime Kuma, Gatus | Grátis ou self-hosted, configuração mínima, rápida de ativar |
| Startup (time de 5 a 15 pessoas) | Checkly, Better Stack, Postman | Alertas inteligentes, configuração rápida, preço acessível, páginas de status |
| E-commerce / SaaS | Datadog, New Relic, Moesif, Checkly | Métricas de negócio, APM/tracing, profundidade de SDK, sintéticos em múltiplas etapas |
| Enterprise / multi-cloud | Datadog, New Relic, Splunk, Grafana Cloud | Distributed tracing, compliance, ambiente híbrido, RBAC/SSO |
| Puristas de open source | Prometheus + Grafana, Uptime Kuma, Gatus, Uptrace | Controle total, nativo de OTel, sem lock-in de fornecedor |
| Times de produto de API | Moesif, Apitally, New Relic | Uso por cliente, tendências por endpoint, alertas de anomalia |
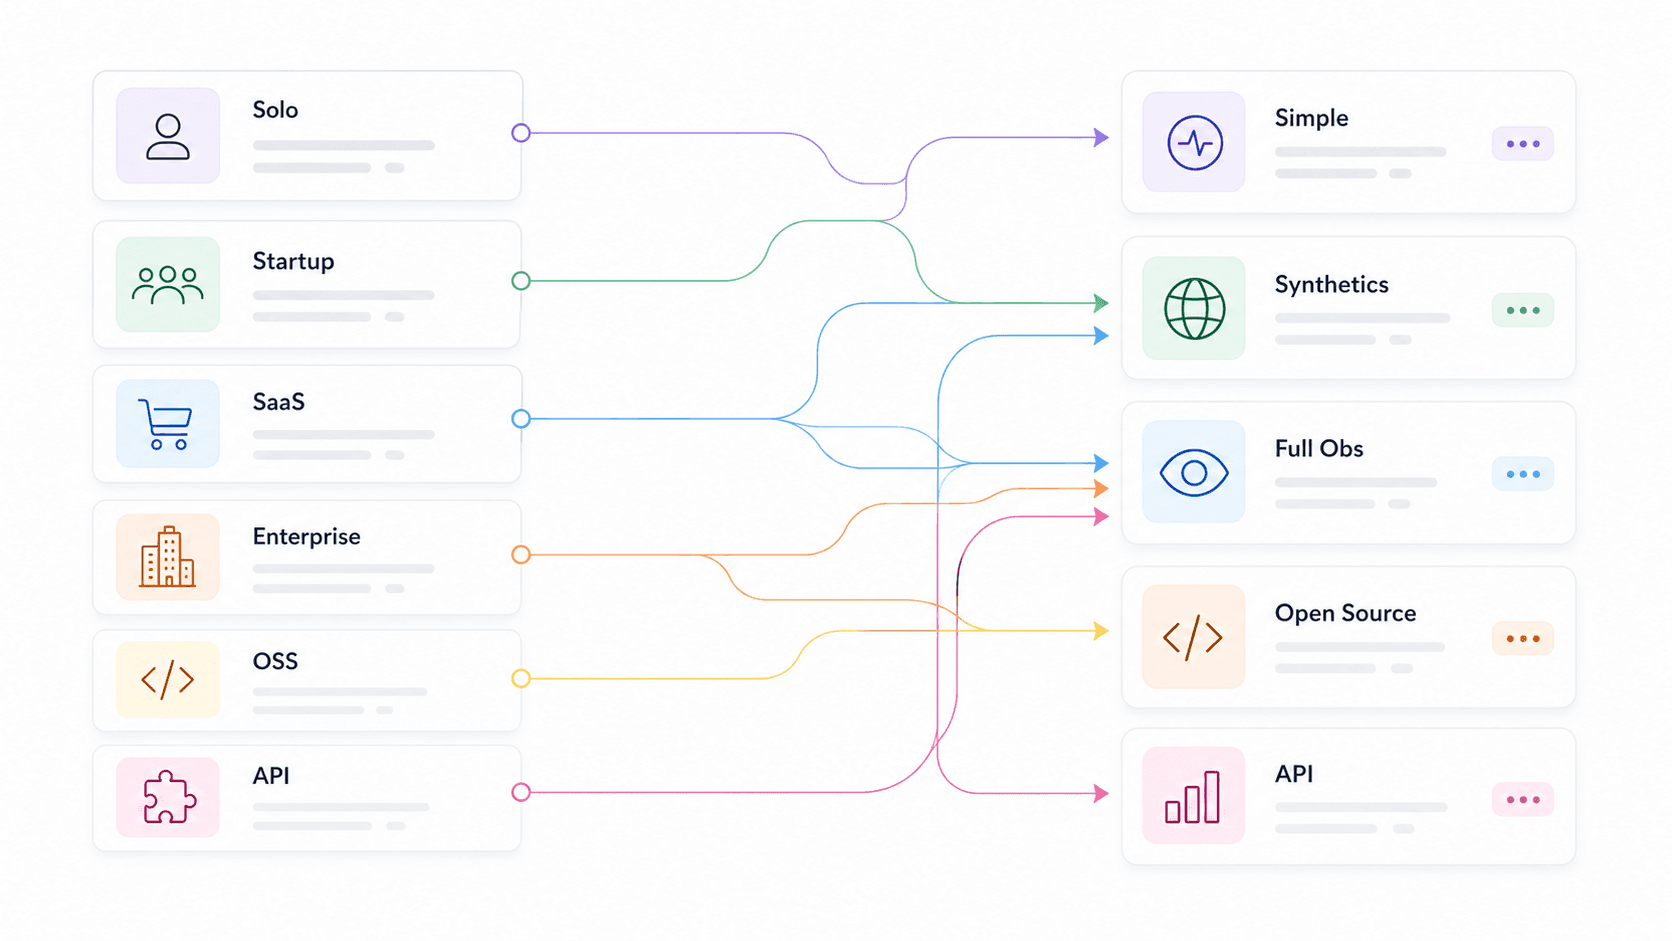
O padrão mais claro: as ferramentas mais rápidas de configurar tendem a ter menos profundidade analítica, enquanto as plataformas mais completas exigem mais configuração e disciplina com custo. Isso não é defeito — é uma troca que você precisa entender. O Thunderbit fica numa faixa um pouco diferente: ele é mais rápido quando a tarefa é transformar páginas da web em dados prontos para API, não quando é para avisar engenheiros sobre downtime.
Thunderbit Open API: Melhor para Transformar Sites em Dados Estruturados via API
Comece a construir com o Thunderbit Open API Converta páginas em Markdown, extraia JSON estruturado e processe URLs em lote sem manter infraestrutura de scraping. Get Started Free
O Thunderbit Open API é a API que eu colocaria em primeiro lugar para times cujo fluxo de "monitoramento" ou pesquisa depende de dados externos da web. Ele não é uma ferramenta tradicional de monitoramento de uptime como Checkly ou UptimeRobot. Em vez disso, o Thunderbit transforma qualquer página em dados limpos e estruturados que os teus apps, agentes, dashboards e pipelines com LLM conseguem realmente usar.
A API tem três fluxos principais. Distill converte uma página em Markdown limpo, pronto para LLM. Extract recebe um schema e devolve campos estruturados em JSON, como nome do produto, preço, disponibilidade, tamanho da empresa, estágio de funding ou nota de avaliação. Batch permite processar até 100 URLs de forma assíncrona com webhooks, o que é útil quando você monitora páginas de preços, catálogos de concorrentes, documentação de fornecedores, fontes de notícias ou grandes listas de pesquisa.
Ele entra num guia de ferramentas de API porque muita equipa subestima quanta infraestrutura é necessária para o simples "extrai essa página". Sites pesados em JavaScript precisam de renderização. Algumas páginas exigem roteamento geográfico. O HTML precisa ser limpo, removendo menus, anúncios, modais e texto repetitivo antes de ficar útil para um LLM. Selectors quebram quando o layout muda. Rotação de proxy, tratamento anti-bot, retries, filas e polling de resultados podem transformar um fluxo pequeno de dados num projeto de manutenção. O Thunderbit absorve boa parte disso atrás de uma única API.
Melhor para: criadores de apps de IA, equipas de RAG, operações de e-commerce, sales ops, growth, pesquisa de mercado e devs que precisam de dados de sites via API sem montar e ficar cuidando de uma stack de scraping.
Preço: Grátis: 600 unidades de API únicas, incluindo até 600 páginas Distill ou 30 páginas Extract, com 2 requisições concorrentes. O Starter aparece por US$ 16/mês no plano anual, com 60.000 unidades de API/ano e 30 requisições concorrentes. O Pro aparece por US$ 40/mês no plano anual, com 600.000 unidades de API/ano e 50 requisições concorrentes.
Velocidade de configuração: cerca de 5–15 minutos para obter uma chave de API e fazer a primeira chamada Distill ou Extract com cURL, SDKs ou o Thunderbit CLI.
Pontos fracos: ele não substitui Datadog, New Relic, Better Stack ou Checkly para checagens de uptime, escalonamento de incidentes, traces, logs ou roteamento de plantão. Pense nele como a API usada para coletar e estruturar dados da web — incluindo preços de fornecedores, documentação, páginas de concorrentes, listagens de produtos ou bases públicas — e não como o sistema que chama o engenheiro de plantão.
Datadog: Melhor para Visibilidade de Stack Completa
O Datadog é a ferramenta que mais vejo em stacks de SaaS enterprise e mid-market, e com razão. Ele não faz só monitoramento de API — é uma plataforma completa de observabilidade que conecta testes sintéticos de API a distributed tracing, logs, métricas de infraestrutura e monitoramento de experiência real do usuário numa única visão.
Falando especificamente de API monitoring, o Datadog suporta HTTP, SSL, DNS, WebSocket, TCP, UDP, ICMP, gRPC e testes de API em múltiplas etapas. Os seus monitores de detecção de anomalias aprendem padrões esperados e alertam sobre desvios, em vez de depender de limites estáticos — o que é um avanço real em relação a "alertar quando a latência > 500ms". Ele também oferece monitores de previsão, que estimam quando uma métrica vai ultrapassar um limite, além de monitores compostos, que combinam várias condições.
Melhor para: times de e-commerce, SaaS e enterprise que precisam de uma visão única de APIs, infraestrutura, logs e traces.
Preço: detalhes do plano grátis variam por produto. Infrastructure Pro começa em US$ 15/host/mês; testes sintéticos de API custam US$ 5 por 10.000 execuções. Mais de 800 integrações.
Velocidade de configuração: cerca de 15–30 minutos para instalar o agent e criar um teste sintético básico.
Pontos fracos: pode ficar caro em escala — "surpresa na conta" é um tema recorrente no Hacker News e no Reddit. A quantidade enorme de SKUs (hosts, logs, métricas customizadas, sintéticos, usuários) faz com que alguém precise acompanhar a fatura, não só os dashboards. A curva de aprendizado da plataforma completa é real.
Checkly: Melhor para Checagens Sintéticas Voltadas a Devs
O Checkly é a ferramenta que eu entregaria a um time de engenharia de startup que quer as checagens de API perto do código. A ideia central é "monitoramento como código": definir checagens de API e browser programaticamente, rodá-las a partir de localidades globais, integrar com pipelines de CI/CD e gerir tudo via Git.
O lado da qualidade do alerta é forte aqui. A lógica de retries do Checkly é apresentada explicitamente como a "primeira linha de defesa" contra falsos positivos — você pode configurar retries fixos, lineares ou exponenciais, retries na mesma localização ou em localização diferente, e duração máxima de retry antes de um alerta disparar. Ele também diferencia estados degradado, falho e recuperado, o que ajuda a reduzir alertas barulhentos.
Melhor para: startups e times de dev que querem checagens de API programáveis, checs de browser baseados em Playwright, integração com CI/CD e configuração rápida.
Preço: dados públicos recentes mostram um plano grátis com 10 monitores de uptime, 1.000 checagens de browser e 10.000 checagens de API. O Starter fica por volta de US$ 24/mês no plano anual — confira a página oficial de preços antes de comprar.
Velocidade de configuração: cerca de 10–20 minutos para uma primeira checagem de API e um canal de alerta.
Pontos fracos: o foco é em checagens sintéticas. Não substitui APM profundo, análise de logs ou distributed tracing. Se você precisa correlacionar uma falha de API com um gargalo de banco de dados, vai precisar de outra ferramenta junto.
UptimeRobot: Melhor para Monitoramento Simples e Acessível de Uptime
O UptimeRobot é o Honda Civic do monitoramento de API. Ele faz uma coisa bem feita: você cria um monitor HTTP, keyword, ping, port, SSL ou heartbeat, escolhe o intervalo e recebe alerta quando falha. Só isso.
Melhor para: devs solo, times pequenos, agências ou qualquer pessoa que precise de monitoramento básico de uptime e latência sem complicação.
Preço: grátis: 50 monitores, intervalos de 5 minutos. O plano Solo pago fica por volta de US$ 7/mês no anual. Não exige cartão para o plano grátis. Velocidade de configuração: cerca de 2–5 minutos — o mais rápido da lista.
Pontos fracos: inteligência de alerta limitada. Alertas básicos por limite, sem detecção de anomalias, sem distributed tracing e sem analytics profundos. Se você precisa entender por que um endpoint está lento (e não apenas que ele está lento), o UptimeRobot não resolve.
Uptime Kuma: Melhor Ferramenta Gratuita e Self-Hosted para Monitoramento de API
O Uptime Kuma é queridinho da comunidade de self-hosting, e os números do GitHub confirmam: 86.637 estrelas, 7.831 forks, 1.060 contribuidores, com versão 2.3.2 em maio de 2026. Ele é licenciado em MIT, suporta HTTP(s), keyword, consulta JSON, WebSocket, TCP, ping, DNS, push, Docker, várias páginas de status e mais de 90 serviços de notificação.
Melhor para: devs solo e times que querem controle total, privacidade e custo recorrente zero de SaaS — desde que tenham um servidor.
Preço: grátis. O custo real é a tua VM/container, backups, atualizações e garantir que o próprio monitor fique de pé. Velocidade de configuração: cerca de 5–15 minutos com Docker para uma checagem básica; 15–30 minutos para caprichar em notificações e página de status.
Pontos fracos: você é responsável pela manutenção. E aqui vai o problema crítico: se você hospedar o Uptime Kuma na mesma infraestrutura que ele monitora, uma queda de cloud ou DNS derruba tanto teu app quanto o monitor. Hospede externamente ou combine com uma checagem SaaS.
Better Stack: Melhor para Resposta Rápida a Incidentes
O Better Stack (ainda chamado de Better Uptime por muitos usuários) combina monitoramento de uptime com gestão de incidentes, escalação de plantão, políticas de escalonamento e páginas de status numa única plataforma. O ponto forte dele não é analytics, mas sim o fluxo de incidente em volta do monitoramento.
As políticas de escalonamento definem quem recebe o alerta, em que ordem e com que atrasos, até que alguém reconheça o problema. O roteamento baseado em metadados envia incidentes por severidade ou responsabilidade. Ele integra com Slack, Teams, webhooks e Zapier.
Melhor para: startups e times médios que querem monitoramento + resposta a incidentes + páginas de status sem juntar três ferramentas separadas.
Preço: plano grátis: 10 monitores/heartbeats, 1 página de status. O Team fica por volta de US$ 29/mês no anual. Velocidade de configuração: cerca de 5–10 minutos com assistente visual.
Pontos fracos: menos profundidade em analytics de payload de API, distributed tracing ou análise de KPIs de negócio quando comparado a Datadog, New Relic ou Moesif.
Prometheus + Grafana: Melhor Stack Open Source para Monitoramento de API
Este é o combo open source padrão da indústria. O Prometheus coleta e armazena métricas de séries temporais. O Grafana (73.705 estrelas no GitHub, 3.010 contribuidores) oferece dashboards e alertas. O Alertmanager cuida de roteamento, agrupamento, deduplicação, silenciamento e inibição. Para checagens de endpoint de API, times adicionam o Blackbox Exporter para probing de HTTP, HTTPS, DNS, TCP, ICMP e gRPC.
Melhor para: puristas de open source, times de Kubernetes/SRE e organizações que já padronizaram métricas em Prometheus.
Preço: grátis e self-hosted. O Grafana Cloud tem um plano grátis (100 mil execuções de testes de API por mês) e planos pagos por uso.
Velocidade de configuração: 1–4 horas para uma base com Blackbox + Prometheus + Grafana + Alertmanager. Dias para HA em produção e ajuste fino de alertas.
Pontos fracos: PromQL, YAML, relabeling, desenho de dashboard, retenção, storage, HA e tuning de alertas são trabalho operacional de verdade. A troca recorrente é "menos interface, mais YAML". É a stack para equipas que já pensam em métricas e querem um único plano de controlo — não para quem quer tudo a correr até ao almoço.
New Relic: Melhor para Performance de Aplicações SaaS
O New Relic combina APM, monitoramento de infraestrutura, logs, distributed tracing, monitoramento sintético, alertas, dashboards e análise de incidentes com apoio de IA. Seu plano grátis — 100 GB/mês de ingestão de dados e 1 usuário full platform — é realmente generoso para times pequenos.
A inteligência de alertas é onde o New Relic brilha na conversa sobre fadiga de alertas. Os seus recursos de incident intelligence incluem correlação de eventos, detecção de anomalias, alertas preditivos, análise de causa raiz e supressão de flapping. O New Relic publicou um exemplo em que 97,2% de efetividade na supressão de flapping significa apenas 28 problemas expostos a cada 1.000 incidentes com flapping — um número concreto de redução de ruído.
Melhor para: times de SaaS e plataformas de e-commerce que querem monitoramento de API integrado com traces, erros, throughput e impacto no usuário.
Preço: grátis: 100 GB/mês, 1 usuário full. A versão paga usa precificação por usuário e por volume de dados.
Velocidade de configuração: cerca de 15–30 minutos para instalar o agent e seguir o setup guiado.
Pontos fracos: o preço pode ficar complexo em escala. A configuração de alertas tem curva de aprendizado — a plataforma é poderosa, mas não é imediata.
Moesif: Melhor para Analytics de API e Métricas de Negócio
O Moesif não é um monitor de uptime tradicional. Ele é analytics de API e inteligência de produto: entender uso de API por cliente, endpoint, coorte, empresa, geografia, SDK, plano e comportamento. Se a tua pergunta é "qual cliente foi impactado?" e não "o endpoint caiu?", o Moesif foi feito para isso.
Ele suporta alertas estáticos por limite e alertas dinâmicos de anomalia para métricas de API como picos/quedas de tráfego, latência e mudanças de comportamento. Os alertas dinâmicos precisam de alguns dias de comportamento da API para criar um modelo, mas, depois disso, capturam mudanças que regras estáticas não percebem.
Melhor para: times de produto de API, empresas SaaS e plataformas de e-commerce que precisam ligar performance de API a receita, engajamento e retenção.
Preço: há plano grátis/teste; os planos pagos escalam com o volume de eventos da API. Os valores self-service não ficaram totalmente acessíveis no meu levantamento — vale conferir a página atual.
Velocidade de configuração: cerca de 20–45 minutos (a integração por SDK/proxy/gateway é mais profunda do que um ping externo).
Pontos fracos: mais voltado a analytics do que a monitoramento tradicional de uptime. Provavelmente você vai querer combinar o Moesif com Checkly, UptimeRobot ou sintéticos do Datadog para checagens externas de disponibilidade.
Splunk: Melhor para Análise de Logs Enterprise e Compliance
O Splunk é a ferramenta que você usa quando agregação de logs, busca, correlação, auditabilidade pronta para compliance e suporte a ambiente híbrido/multi-cloud são inegociáveis. O Splunk Observability Cloud cobre infraestrutura, APM, sintéticos, monitoramento real de usuário, logs e resposta a incidentes. O ITSI/Event Analytics pode agrupar eventos relevantes em episódios e reduzir ruído entre silos de monitoramento.
A própria pesquisa de observabilidade de 2025 da Splunk é preocupante: 73% dos respondentes de ITOps/engenharia relataram outages causados por alertas ignorados ou suprimidos, 59% disseram ter dificuldade com ferramentas demais e desconectadas, e 52% relataram problemas com falsos alertas.
Melhor para: times enterprise e multi-cloud com exigências rígidas de compliance, segurança, auditoria e busca em logs.
Preço: por uso e com forte dependência de proposta comercial. Não há um plano grátis simples para produção.
Velocidade de configuração: a entrada na cloud pode ser mais rápida, mas em enterprise a implantação costuma levar de dias a semanas.
Pontos fracos: caro em escala. Configuração complexa. Exagero para dev solo e startup pequena.
Postman: Melhor para Times que Já Testam APIs
O Postman é principalmente uma plataforma de desenvolvimento e teste de APIs, mas o produto de monitoramento permite agendar collections do Postman e executá-las a partir da cloud. O argumento mais forte é a reutilização: se o teu time de QA ou dev já tem collections com asserções, transformá-las em monitores é o passo natural seguinte.
Melhor para: times de dev e QA que já usam collections do Postman e querem checagens agendadas sem comprar uma ferramenta sintética separada.
Preço: existe plano grátis. Excedentes de monitoramento custam US$ 0,75 por 1.000 chamadas; pacote adicional de 50.000 chamadas por US$ 20/mês. Confira a página de planos atual — o empacotamento do Postman muda com frequência.
Velocidade de configuração: cerca de 10 minutos se as collections já existirem.
Pontos fracos: as capacidades de monitoramento são mais leves que as de ferramentas dedicadas como Checkly, Datadog ou New Relic. As opções de alerta são básicas.
Outras Ferramentas de Monitoramento de API que Valem a Pena
Gatus: dashboard de saúde leve, self-hosted e guiado por configuração. 10.906 estrelas no GitHub, suporta HTTP, ICMP, TCP, DNS, métricas amigáveis ao Prometheus e badges de uptime. Ótimo para devs solo que querem algo mais simples que Prometheus, mas preferem YAML/config-as-code em vez da interface do Uptime Kuma.
Apitally: ferramenta mais nova focada em analytics de tráfego e acompanhamento de qualidade de API para startups. Diz que faz setup em menos de 5 minutos com alertas customizados em 14 métricas. Bom para analytics leve de API sem adotar uma plataforma de observabilidade completa.
Sematext: monitoramento full-stack com logs, sintéticos e visibilidade de infraestrutura. Sintéticos por volta de US$ 2 por monitor HTTP, US$ 7 por monitor de browser, mínimo de US$ 5/mês. Uma alternativa mais barata ao Datadog para times mid-market.
Uptrace: backend nativo de OpenTelemetry para APM, tracing, métricas e logs. 4.198 estrelas no GitHub. Não é um verificador puro de uptime, mas é ideal para equipas padronizadas em OTel que querem um backend de tracing amigável ao open source.
Build vs. Buy: Vale a Pena Criar Seu Próprio Monitoramento de API?
"É melhor eu escrever um script que faz ping nos meus endpoints, ou usar uma ferramenta dedicada?"
Essa pergunta aparece o tempo todo em fóruns de dev. Já li threads suficientes no Reddit para ver o padrão com clareza: times começam com curl + cron, isso funciona bem por um tempo e, depois, migram quando precisam de dashboards, histórico, checagem em múltiplas regiões, roteamento confiável de alertas ou visibilidade entre equipas.
Uma matriz honesta de decisão:
| Fator | Script personalizado | Ferramenta especializada |
|---|---|---|
| Tempo de setup | 1–4 horas (básico); dias (robusto) | 5–30 minutos |
| Manutenção | Você assume para sempre | O fornecedor cuida das atualizações |
| Qualidade do alerta | Básica (subiu/caiu) | Inteligente (tendência de latência, anomalias, retries) |
| Custo | Grátis (seu tempo) | US$ 0–US$ 500+/mês |
| Dashboard | Construção do zero | Pronto e personalizável |
| Melhor quando… | ≤3 endpoints, time muito dev, hobby project | 5+ endpoints, time de ops/produto, receita em jogo |
O insight principal dos fóruns: quem constrói a própria solução muitas vezes se arrepende quando passa a precisar de dashboards, dados históricos ou visibilidade entre equipas. E existe o problema meta — "você precisa de monitoramento para o teu monitoramento". Um monitor self-hosted, banco de dados, backup, caminho de rede e fornecedor de alertas também precisam ser confiáveis.
Construa se você tiver 2 endpoints e gostar de fuçar. Compre se tiver um produto para lançar.
A mesma lógica vale para extração de dados da web. Você pode escrever um scraper, rodar browsers headless, rotacionar proxies, manter selectors, limpar HTML e montar uma fila. Mas, se o objetivo é alimentar de forma confiável um produto de API, um agente de IA ou um fluxo de pesquisa com dados web, usar o Thunderbit Open API costuma ser muito mais rápido do que montar tua própria infraestrutura de scraping.
Fadiga de Alertas: Por Que Qualidade de Alerta Ganha de Quantidade
Esse talvez seja o critério mais subestimado ao escolher uma ferramenta de monitoramento de API. Fadiga de alertas acontece quando o time recebe tantos alertas ruidosos, duplicados ou sem ação prática que começa a ignorar todos — e aí perde incidentes reais.
Os números chamam atenção. O relatório de 2025 da BigPanda mostrou que a organização mediana gerava 2.350 alertas por dia e 803.406 alertas por ano. A acionabilidade mediana dos incidentes foi de apenas 18% — ou seja, menos de um em cada cinco incidentes gerados por alertas era realmente acionável. A pesquisa de 2026 da NeuBird descobriu que 77% dos times de plantão recebem pelo menos 10 alertas por dia e 80% dizem que metade ou menos desses alertas são acionáveis.
A melhor ferramenta de monitoramento é aquela em que você realmente confia nos alertas. Uma comparação de como as ferramentas tratam inteligência de alerta:
| Ferramenta | Tipo de alerta | Método de redução de ruído | Canais de alerta |
|---|---|---|---|
| Datadog | Anomalia de ML, forecast, composto | Faixas históricas de anomalia, baselines dinâmicos, Watchdog AI | Slack, PagerDuty, Opsgenie, Teams, mais de 20 |
| Checkly | Limiar + baseado em degradação | Retry antes de disparar, retries na mesma/diferente localização | Slack, PagerDuty, Opsgenie, Teams, incident.io |
| New Relic | Agrupamento por IA, anomalia, preditivo | Correlação de eventos, supressão de flapping, contexto de causa raiz | Slack, PagerDuty, Teams, webhooks |
| Moesif | Anomalia comportamental | Modelos dinâmicos após alguns dias de comportamento | Slack, PagerDuty, e-mail, SMS |
| Better Stack | Uptime/incidente/plantão | Políticas de escalonamento, roteamento por responsabilidade, atrasos | Slack, Teams, webhooks, Zapier |
| Prometheus + Alertmanager | Alertas por regra PromQL | Agrupamento, deduplicação, silenciamento, inibição | E-mail, PagerDuty, Opsgenie, webhooks |
| Splunk | Eventos, episódios, saúde de serviço | ITSI Event Analytics, agrupamento de episódios, ticketing | Splunk On-Call, ServiceNow, webhooks |
| Thunderbit Open API | Não é plataforma de alertas | Use com teu próprio scheduler, ferramenta de workflow ou stack de monitoramento | Webhooks para jobs em lote; alertas tratados externamente |
Conselho prático: comece com menos alertas, mas com mais confiança. Use retries antes de disparar, confirmação em múltiplas regiões, alertas por burn rate de SLO, deduplicação e roteamento por responsabilidade. Alerta sobre impacto no usuário e fluxos críticos de negócio (falha no checkout, falha de autenticação, 5xx em pagamentos), não sobre cada sintoma interno.
Planos Gratuitos e Preços de 2026: O Que Você Realmente Paga
As páginas de preço mudam. Os planos grátis mudam. Custos escondidos (hosts, usuários, logs, execuções sintéticas, ingestão de dados) podem surpreender. Esta é a seção que eu gostaria que existisse em todo artigo de "melhores ferramentas". O retrato de 2026:
| Ferramenta | Plano Grátis | Preço Inicial Pago | Exige Cartão? | Melhor Uso Gratuito |
|---|---|---|---|---|
| Thunderbit Open API | 600 unidades de API únicas | ~US$ 16/mês no anual | Não | Extração de dados web para LLMs, RAG, precificação e pesquisa |
| Uptime Kuma | Ilimitado (self-host) | — | Não | Monitoramento completo, com teu próprio servidor |
| UptimeRobot | 50 monitores, intervalos de 5 min | ~US$ 7/mês | Não | Checagens básicas de uptime |
| Better Stack | 10 monitores, 1 página de status | ~US$ 29/mês | Não | Uptime + página de status para startup |
| Checkly | 10 uptime, 10k checagens de API | ~US$ 24/mês | Sim | Checagens sintéticas de API |
| Postman | Conta grátis + franquia de monitoramento | ~US$ 14/usuário/mês | Não | Reutilizar collections existentes |
| Prometheus + Grafana | Ilimitado (self-host) | — | Não | Métricas + visualização |
| Grafana Cloud | 100 mil execuções de teste de API/mês | US$ 29/mês plataforma + uso | Verificar | Teste de sintéticos gerenciado |
| New Relic | 100 GB/mês, 1 usuário full | Por usuário + dados | Alguns planos | APM + observabilidade básica |
| Datadog | Trial/varia por produto | US$ 15/host/mês (Infra Pro) | Muitas vezes, sim | Avaliação full-stack |
| Moesif | Plano grátis/teste disponível | Baseado em volume | Verificar | Avaliação de analytics de API |
| Splunk | Trials disponíveis | Sob proposta | Fluxo comercial | Prova de conceito enterprise |
| Gatus | Ilimitado (self-host) | — | Não | Dashboard de status orientado por YAML |
| Apitally | Plano grátis/teste disponível | Verificar | Verificar | Analytics leve de API |
| Sematext | Trial/grátis varia | ~US$ 2/monitor HTTP | Verificar | Synthetics e logs mais baratos |
| Uptrace | Self-host grátis | Planos cloud variam | Verificar | Avaliação de APM com OTel |
Nota sobre custo escondido: ferramentas self-hosted (Uptime Kuma, Prometheus, Gatus) são "grátis" em licença, mas uma VM pequena, backups, tempo de manutenção e failover externo podem facilmente virar o custo real. Para APIs de dados web, o custo escondido costuma ser outro: manter browsers headless, selectors quebrados, pools de proxy, contornos anti-bot e limpeza de HTML.
Estimativa para times pequenos: para 10 endpoints de API e 3 membros no time, o caminho SaaS mais barato costuma ser UptimeRobot grátis ou pago de baixo custo, Better Stack free/Team, ou Checkly se o volume de execuções couber. Datadog e New Relic podem ser acessíveis para avaliação, mas a conta real depende de hosts, usuários, logs, traces e volume de execuções sintéticas. Se o teu projeto precisa de dados de sites via API, as unidades grátis do Thunderbit normalmente já bastam para testar o fluxo antes de assinar um plano pago.
Scorecard de Complexidade de Setup: Quão Rápido Até o Primeiro Alerta?
Nenhum artigo concorrente que encontrei avalia time-to-value — quanto tempo leva do cadastro até receber o primeiro alerta realmente útil. Para times menores, isso importa mais do que profundidade de recurso.
| Ferramenta | Tempo até o Primeiro Alerta | Nível Técnico Necessário | Forma de Configuração |
|---|---|---|---|
| Thunderbit Open API | ~5–15 minutos | Baixo–Médio | Chave de API, cURL/SDK/CLI |
| UptimeRobot | ~2–5 minutos | Baixo | GUI, adicionar com clique |
| Better Stack | ~5–10 minutos | Baixo | Assistente visual |
| Checkly | ~10–20 minutos | Baixo–Médio | Código ou GUI |
| Postman | ~10 minutos (com collections) | Baixo–Médio | Agendador de collection |
| Uptime Kuma | ~5–30 minutos | Médio | Docker + GUI |
| Gatus | ~15–45 minutos | Médio | YAML + Docker |
| Datadog | ~15–30 minutos | Médio | Instalação de agent + GUI |
| New Relic | ~15–30 minutos | Médio | Agent + setup guiado |
| Moesif | ~20–45 minutos | Médio | Integração com SDK/proxy |
| Grafana Cloud Synthetics | ~15–45 minutos | Médio | GUI, Terraform opcional |
| Prometheus + Grafana | 1–4 horas | Médio–Alto | YAML, PromQL |
| Uptrace | 30–90 minutos | Médio–Alto | Integração com SDK OTel |
| Splunk | Horas a semanas | Alto | Onboarding enterprise |
Se o monitoramento precisa estar ativo até ao fim do dia, comece com a metade superior da tabela. Se o objetivo é observabilidade de plataforma durável, planeje um projeto separado para a metade inferior. E, se a tua primeira meta é "colocar dados limpos dessas 100 páginas web dentro de um app", comece com Thunderbit antes de construir infraestrutura própria de scraping.
Melhores Ferramentas de Monitoramento de API em Comparação: Lado a Lado Completo
Uma tabela para bater o olho antes de decidir:
| Ferramenta | Melhor Caso de Uso | Plano Grátis | Inteligência de Alertas | Tempo de Setup | Hospedagem | Recurso de Destaque |
|---|---|---|---|---|---|---|
| Thunderbit Open API | Extração de dados web / pipelines de dados via API | 600 unidades de API | Não é ferramenta de alertas | 5–15 min | Cloud | Converte páginas em Markdown ou extrai JSON baseado em schema |
| Datadog | Enterprise/SaaS com stack completa | Trial/varia | Anomalia, forecast, IA | 15–30 min | Cloud | Correlaciona sintéticos com logs/traces/infra |
| Checkly | Sintéticos para devs | Checks generosos | Retries, degradação | 10–20 min | Cloud | Monitoramento como código + Playwright |
| UptimeRobot | Uptime simples | 50 monitores | Limiar básico | 2–5 min | Cloud | Monitor básico mais rápido e barato |
| Uptime Kuma | Self-host grátis | Ilimitado | Status/limiar básico | 5–30 min | Self-hosted | Interface limpa, sem mensalidade SaaS |
| Better Stack | Resposta a incidentes/páginas de status | 10 monitores | Escalonamento, roteamento | 5–10 min | Cloud | Monitoramento + plantão + página de status |
| Prometheus + Grafana | Stack open source de métricas | Ilimitado (self-host) | Agrupamento do Alertmanager | 1–4 h | Self-hosted/cloud | Profundidade do ecossistema PromQL |
| New Relic | APM SaaS + checagens de API | 100 GB/mês, 1 usuário | Agrupamento por IA, supressão de flapping | 15–30 min | Cloud | Forte APM + sintéticos juntos |
| Moesif | Analytics de API / métricas de negócio | Free/trial | Anomalias comportamentais | 20–45 min | Cloud | Analytics de comportamento por cliente |
| Splunk | Logs enterprise / compliance | Trial | Episódios ITSI, AIOps | Dias+ | Cloud/self-managed | Busca de logs e governança enterprise |
| Postman | Times que já testam APIs | Conta grátis | Alertas básicos | 10 min | Cloud | Reaproveita collections de teste de API |
Como o Thunderbit Pode Acelerar Sua Avaliação de Ferramentas de API
Transparência total: o Thunderbit não é uma ferramenta de monitoramento de API — é um scraper web com recursos agentivos e um Open API para transformar páginas em Markdown limpo ou JSON estruturado. Isso o torna útil em outra etapa da decisão sobre ferramentas de monitoramento: coletar preços de fornecedores, limites de planos, claims de recursos, detalhes de documentação e listas de integrações antes de escolher uma plataforma.
Em vez de abrir manualmente mais de 10 páginas de preço de fornecedores, copiar nomes de planos, limites de monitores, intervalos de checagem, integrações e exigência de cartão para uma planilha, usamos a Thunderbit Chrome Extension para extrair dados estruturados das páginas de preços e recursos de cada ferramenta. A IA do Thunderbit lê cada página e sugere campos — nome do plano, detalhes do plano grátis, preço pago, integrações suportadas — e depois organiza a saída numa planilha exportável.
Para fluxos de trabalho de desenvolvedor, o Thunderbit Open API oferece a mesma ideia de forma programática. Use Distill quando quiser Markdown limpo para LLMs ou RAG. Use Extract quando precisar de campos específicos em JSON. Use Batch quando precisar processar uma lista de páginas de preços, URLs de documentação, páginas de produto ou páginas de concorrentes e receber os resultados de forma assíncrona.
O fluxo de trabalho:
- Abra a página de preços de um fornecedor (Datadog, Checkly, UptimeRobot etc.)
- Clique em "One Click Extract" — a IA do Thunderbit lê a página, entende a estrutura e preenche uma tabela numa passada
- Use subpage scraping para acessar páginas de preços, recursos e documentação de cada fornecedor
- Exporte para Google Sheets, Excel, Airtable, Notion ou CSV
Para times que trabalham com API, o fluxo pela API é tão direto quanto:
- Obtenha uma chave de API grátis no Thunderbit
- Chame o endpoint Distill para obter Markdown limpo de qualquer página pública
- Chame o endpoint Extract com descrições de schema para receber JSON estruturado
- Use endpoints Batch e webhooks para listas maiores de URLs
- Envie a saída para teu app, planilha, warehouse, banco vetorial ou fluxo de monitoramento
Para uma comparação com mais de 10 fornecedores, o copy-paste manual pode levar facilmente de 2 a 3 horas quando você inclui subpáginas de preços, documentação e páginas de integrações. O Thunderbit reduziu nossa primeira extração para algo em torno de 15–30 minutos, com o tempo restante gasto em validação e decisões de julgamento. Se teu time de operações, compras, pesquisa ou produto de IA está avaliando ferramentas sob pressão de tempo, é um atalho prático. Você pode ver mais sobre esse tipo de fluxo no nosso guia de web scraping sem programar, explorar os preços da API do Thunderbit ou conferir nosso canal no YouTube para tutoriais.
Como Escolher a Melhor Ferramenta de Monitoramento de API para Sua Equipe
A melhor ferramenta de monitoramento de API depende do tamanho da equipa, profundidade técnica, orçamento e do que significa uma falha para o teu produto.
Um dev solo não precisa de Splunk. Uma empresa regulada não deveria depender de um cron job. Um time de produto de API pode precisar mais de analytics por cliente no estilo Moesif do que de simples ping de uptime. Um time de e-commerce deve priorizar checagens do caminho crítico para login, busca, adicionar ao carrinho, checkout e autorização de pagamento. Um time de IA ou produto de dados talvez precise de extração de dados web no estilo Thunderbit antes mesmo de pensar em observabilidade completa.
Três princípios que se mantiveram em toda a minha pesquisa:
- Combine a ferramenta com o teu caso de uso. A tabela rápida existe por um motivo — comece por ela.
- Priorize qualidade de alerta, não quantidade. Se o time ignora os alertas, você não tem monitoramento. Tem ruído.
- Não subestime a velocidade de setup. Um monitor que entra no ar hoje e manda alertas confiáveis é melhor do que um plano de plataforma perfeito que deixa o checkout sem monitoramento por mais um mês.
Se você está comparando várias ferramentas ao mesmo tempo e quer acelerar a pesquisa, experimente o Thunderbit para extrair em massa os dados dos fornecedores para uma única planilha. Se estiver construindo um produto de API, pipeline de RAG, agente de IA ou fluxo de inteligência de mercado que precise de dados web limpos, comece com o Thunderbit Open API. Ele não escolhe a ferramenta de monitoramento por você — mas vai acelerar a decisão, e também pode fornecer ao seu próprio produto uma camada confiável de dados web.
FAQs Sobre as Melhores Ferramentas de Monitoramento de API
Qual é a melhor ferramenta gratuita de monitoramento de API em 2026?
Para simplicidade SaaS, o UptimeRobot oferece 50 monitores grátis com intervalos de 5 minutos e sem exigência de cartão. Para controle self-hosted, o Uptime Kuma é open source, ilimitado e tem uma interface limpa com mais de 90 serviços de notificação. Para times que querem profundidade de métricas e já têm maturidade técnica, Prometheus + Grafana + Alertmanager é a melhor stack open source — embora a configuração leve horas, não minutos.
Se teu objetivo não é monitoramento de uptime, mas extração de dados web via API, o Thunderbit Open API tem um plano grátis com 600 unidades de API únicas, o que é suficiente para testar a conversão de páginas para Markdown ou a extração de JSON baseado em schema antes de escalar.
Qual é a diferença entre monitoramento de API e APM?
Monitoramento de API verifica disponibilidade do endpoint, tempo de resposta, erros e corretude de fora para dentro — simulando o que um usuário ou integração experiencia. APM (Application Performance Monitoring) vai mais fundo dentro da aplicação: traces em nível de código, queries de banco, erros de runtime, latência de fila e dependências de serviço. Ferramentas como Datadog e New Relic oferecem os dois; UptimeRobot e Uptime Kuma focam em checagens externas de uptime.
O Thunderbit Open API é diferente dos dois: ele é uma API de extração de dados web. Ele ajuda a transformar websites externos em Markdown ou JSON estruturado, o que é útil para apps de LLM, fluxos de pesquisa, inteligência de preços e pipelines de dados.
Com que frequência devo monitorar minhas APIs?
APIs de produção críticas para receita (checkout, autenticação, pagamentos) normalmente devem ser verificadas a cada 1 minuto. APIs internas ou de baixo tráfego podem ser monitoradas a cada 5 minutos. Mas frequência, sozinha, não resolve tudo — use retries, múltiplas regiões e asserções significativas para que cada checagem seja rápida e confiável. Uma checagem de 1 minuto que gera falso positivo é pior do que uma checagem de 5 minutos em que você confia.
Para fluxos de extração de dados web, a frequência depende de quão rápido a fonte muda. Páginas de preço podem exigir extração diária ou semanal. Dados de estoque, viagens ou marketplaces, que mudam rápido, podem precisar de atualização de hora em hora ou até mais frequente. A API Batch e os webhooks do Thunderbit são úteis quando você precisa processar muitas URLs em agenda.
Posso monitorar APIs sem escrever código?
Sim. UptimeRobot, Better Stack e Uptime Kuma podem ser usados totalmente por interface. Checkly suporta tanto configuração por GUI quanto por código. Postman usa uma interface baseada em collections. Prometheus/Grafana geralmente exige YAML e PromQL. Datadog e New Relic podem começar com setup guiado, mas ficam mais poderosos com instrumentação mais profunda.
Se você quer extrair dados de sites sem escrever código, a Chrome Extension do Thunderbit é o caminho no-code. Se quiser automatizar esse mesmo fluxo a partir de uma aplicação, o Thunderbit Open API oferece endpoints Distill, Extract e Batch para devs.
Como reduzir a fadiga de alertas do monitoramento de API?
Escolha ferramentas com alertas inteligentes: detecção de anomalias (Datadog, New Relic), retries antes de disparar (Checkly), anomalias comportamentais (Moesif) ou agrupamento/silenciamento (Prometheus Alertmanager). Comece com menos alertas e mais confiáveis, focados em impacto para o usuário. Use alertas de burn rate de SLO em vez de limites estáticos, deduplique entre serviços, faça roteamento por responsabilidade e meça acionabilidade — se menos de 20% dos teus alertas levam a uma ação real, reduza o ruído primeiro.
Experimente o Thunderbit Open API para Extração de Dados Web Get Started Free
Saiba Mais



