
Trustpilot raccoglie 361 milioni di recensioni attive su 1,27 milioni di aziende — e la maggior parte degli scraper costruiti per estrarre questi dati si è già rotta da mesi. Se hai provato di recente a recuperare recensioni, probabilmente ti sei scontrato con il famigerato login wall della pagina 10 e hai visto il tuo strumento restituire soltanto errori.
Nelle ultime settimane ho testato, studiato e confrontato gli strumenti che nel 2026 riescono ancora a estrarre in modo affidabile i dati delle recensioni Trustpilot. Il panorama è cambiato parecchio: le protezioni anti-bot di Trustpilot sono diventate più aggressive, il frontend in Next.js genera classi CSS che cambiano a ogni deploy e — soprattutto — l’accesso senza autenticazione si interrompe ora dopo sole 10 pagine di recensioni. Un thread su Reddit di fine 2025 riassumeva perfettamente la frustrazione: "none of the actors on the store work."
Quindi, quali strumenti funzionano davvero? Ne ho valutati cinque in base a come gestiscono il login wall, le misure anti-bot, il carico di manutenzione e le esigenze pratiche sia di marketer sia di sviluppatori.
Perché estrarre recensioni Trustpilot è più difficile di quanto sembri nel 2026
Trustpilot non è un semplice sito statico che puoi interrogare con una richiesta HTTP basilare e analizzare con BeautifulSoup. È una piattaforma moderna, renderizzata dinamicamente e basata su Next.js, e le sue difese sono diventate sensibilmente più rigide nell’ultimo anno.
Contro cosa ti ritrovi davvero a combattere:
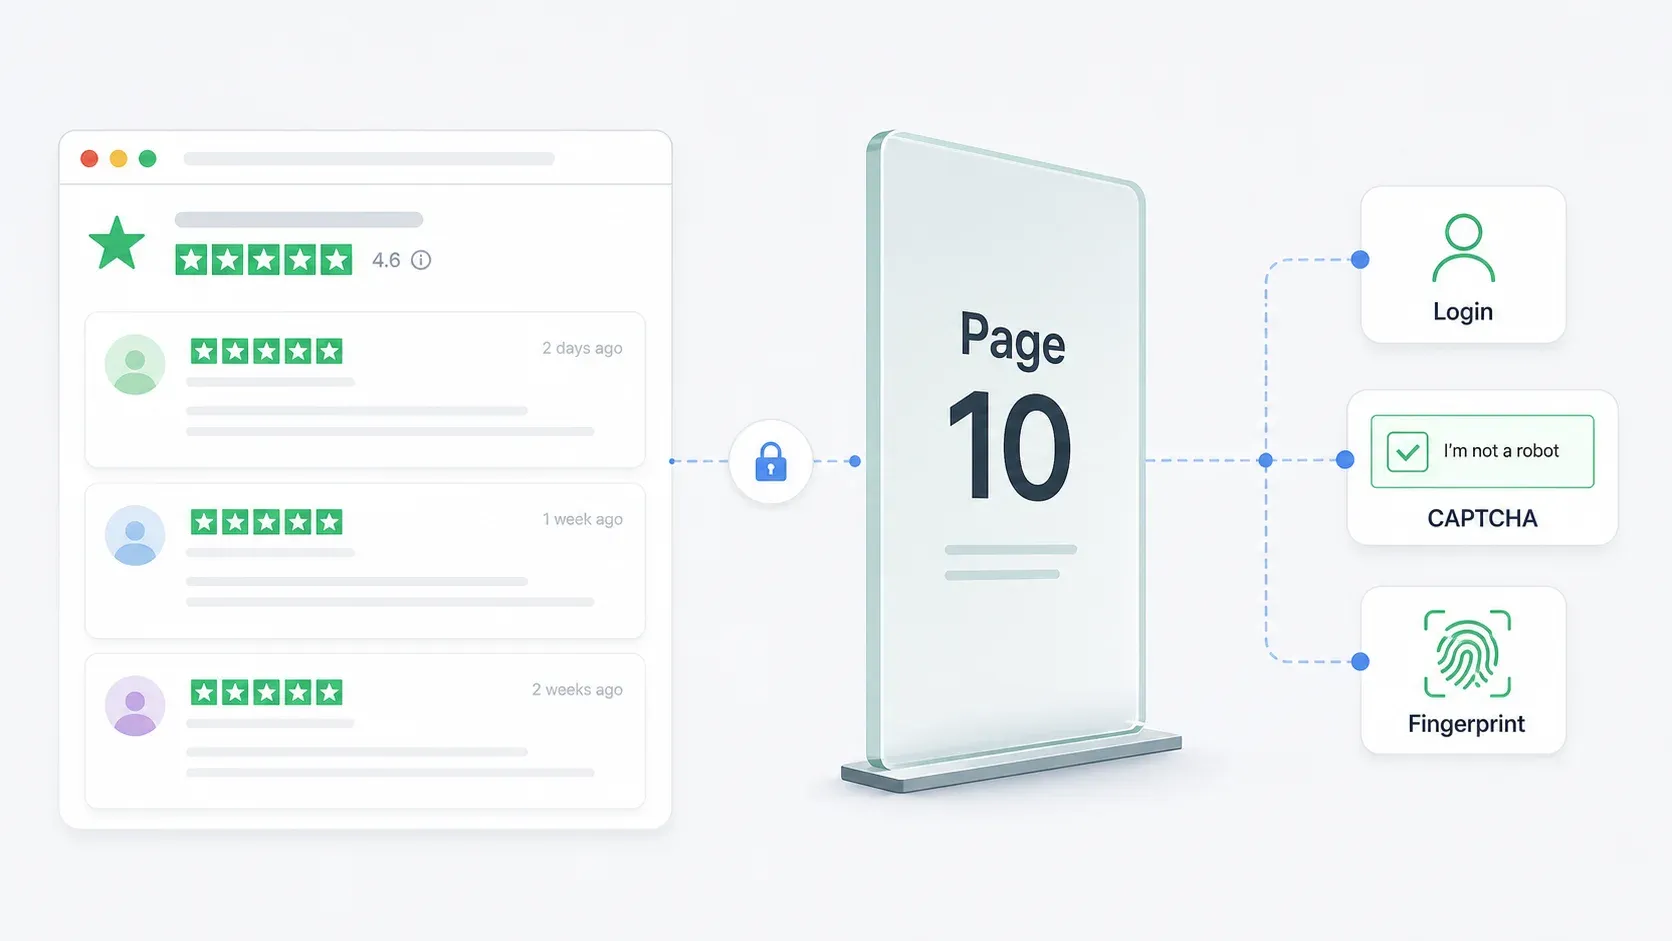
Il login wall della pagina 10. È il problema principale in assoluto. La guida Trustpilot di Web Scraper di marzo 2026 conferma che Trustpilot consente solo le prime 10 pagine di recensioni prima di mostrare un prompt di accesso. Per un’azienda con 2.000 recensioni (circa 100 pagine da 20 recensioni ciascuna), perdi il 90% dei dati, a meno di avere una sessione autenticata.
Protezioni anti-bot. Trustpilot usa reCAPTCHA, blocchi basati sulla sessione, filtraggio delle richieste a livello CDN e fingerprinting del browser. La sua pagina About dichiara esplicitamente che il sito è "protected by reCAPTCHA" e raccoglie segnali del dispositivo e dell’interazione.
Classi CSS dinamiche. Poiché Trustpilot usa Next.js con CSS modules, classi come styles_reviewCardInner__EwDq2 vengono generate in fase di build e cambiano ogni volta che Trustpilot rilascia un aggiornamento. Il tutorial di ScraperAPI si basa proprio su questi selettori — il che significa che qualsiasi codice che segua quella guida si romperà al prossimo cambiamento del frontend.
Modifiche alla struttura DOM. Oltre alle classi CSS, può cambiare anche la gerarchia HTML vera e propria. Gli elementi vengono nidificati in modo diverso, compaiono nuovi wrapper e i componenti di paginazione vengono riorganizzati.
Gli scraper basati su selettori CSS — che siano Actor di Apify, workflow di Octoparse o script Python personalizzati — su Trustpilot sono fragili per natura. Funzionano, finché non smettono di farlo. E spesso quel "finché" si misura in settimane, non in mesi.
Cosa abbiamo cercato nei migliori scraper di recensioni Trustpilot
Non ho valutato questi strumenti con il generico criterio "riesce a fare scraping di una pagina web". Tutti gli strumenti di questa lista possono estrarre dati da una semplice pagina HTML.
La vera domanda è: riesce a gestire Trustpilot nello specifico, con tutte le sue stranezze, nel 2026?
Ecco cosa contava davvero:
| Criterio | Perché è importante per Trustpilot |
|---|---|
| Gestione del login wall (pagina 10+) | La maggior parte delle aziende ha ben più di 200 recensioni. Un limite a 10 pagine significa perdere la maggior parte dello storico. |
| Approccio di bypass anti-bot | reCAPTCHA, blocchi di sessione e filtri CDN fermano sul nascere gli scraper ingenui. |
| Resilienza dei selettori / manutenzione | Le classi CSS generate rompono regolarmente gli strumenti basati sui selettori. Lo strumento si auto-ripara? |
| Supporto alla paginazione | Le recensioni si estendono su centinaia di pagine. Estrarle manualmente una per una non è realistico. |
| Necessità di no-code vs codice | I marketer hanno bisogno di un’interfaccia click-and-point; gli sviluppatori vogliono pieno controllo. |
| Prezzo / piano gratuito | I team con budget limitato devono avere chiarezza prima di impegnarsi. |
| Opzioni di export | Gli utenti business hanno bisogno di Google Sheets, Airtable, Notion — non solo JSON grezzo. |
Il login wall è il fattore decisivo.
Se uno strumento non riesce a superare la pagina 10 — o almeno non offre un percorso chiaro per l’accesso autenticato — nel 2026 non è uno scraper Trustpilot davvero utilizzabile.
I migliori scraper di recensioni Trustpilot in sintesi
Confronto completo:
| Strumento | Livello di competenza | Gestione del login wall | Approccio anti-bot | Paginazione | Piano gratuito | Opzioni di export |
|---|---|---|---|---|---|---|
| Thunderbit | No-code | Modalità browser (usa la tua sessione Chrome già autenticata) | L’estrazione semantica AI si adatta ai cambiamenti di layout | Rilevamento automatico, multi-pagina | 6 pagine gratis/mese | Excel, Sheets, Airtable, Notion, CSV, JSON |
| Apify | Low-code | Dipende dall’Actor; alcuni richiedono la configurazione dei cookie oltre la pagina 10 | Rotazione proxy integrata, specifica dell’Actor | Configurabile per ciascun Actor | $5/mese di crediti gratuiti sulla piattaforma | JSON, CSV, Excel, XML, RSS |
| Octoparse | No-code (visuale) | Configurazione manuale di cookie/sessione | Rotazione IP, proxy residenziali, risoluzione CAPTCHA (a pagamento) | Workflow click/scroll | Piano gratuito + prova premium di 14 giorni | CSV, Excel, JSON, HTML, XML, database |
| Web Scraper | No-code (sitemap) | Limitato — la loro guida documenta un limite di 10 pagine per le recensioni | Cloud + proxy nei piani a pagamento | Configurabile; consigliato click via JS | Estensione Chrome gratuita | CSV, XLSX |
| ScraperAPI | Sviluppatori (Python) | Gestione di sessione/cookie a livello di codice | Oltre 40 milioni di proxy residenziali, rendering JS, gestione CAPTCHA | Basato su codice | Prova di 7 giorni, 5.000 crediti API | Definito dallo sviluppatore (CSV, JSON, ecc.) |
1. Thunderbit

Thunderbit è un’estensione Chrome basata su AI pensata per team business che hanno bisogno di dati strutturati dai siti web senza scrivere codice. Per Trustpilot, offre un template dedicato per l’estrazione delle recensioni che estrae nome del recensore, valutazione, titolo della recensione, testo, data e risposta dell’azienda con un solo clic.
Sono di parte — lavoro qui — ma il motivo per cui abbiamo costruito Thunderbit in questo modo è direttamente legato alla difficoltà dello scraping su Trustpilot. La nostra AI legge le pagine in modo semantico, invece di affidarsi ai selettori CSS. Quando Trustpilot cambia i nomi delle classi o riorganizza il DOM, Thunderbit si adatta perché cerca il significato degli elementi, non il loro indirizzo HTML preciso.
Prova Thunderbit per fare scraping di Trustpilot
Come Thunderbit gestisce il login wall della pagina 10
Qui entra in gioco la modalità browser. Thunderbit opera dentro il tuo browser Chrome — lo stesso in cui sei già autenticato su Trustpilot. Quando passi alla modalità di scraping nel browser, l’estensione legge le pagine visibili nella tua sessione autenticata. Niente acrobazie con i proxy. Niente injection di cookie. Niente pool di sessioni Playwright.
Il flusso pratico: accedi a Trustpilot in Chrome, vai alla pagina delle recensioni che ti interessa e apri l’estensione. Con un clic, l’AI identifica quali campi di recensione sono presenti nella pagina ed esegue l’estrazione da sola. Vuoi un diverso taglio dei dati? Descrivilo e l’AI seguirà quella indicazione. Da lì, la paginazione avviene automaticamente — Thunderbit procede attraverso tutte le pagine accessibili dalla tua sessione browser.
Perché Thunderbit non si rompe quando Trustpilot cambia
La nostra pagina template Trustpilot lo spiega chiaramente: gli scraper tradizionali si rompono quando il layout cambia e i selettori CSS devono essere aggiornati. Thunderbit usa un’AI semantica che capisce i contenuti senza dipendere da CSS specifici, gestisce i contenuti dinamici e automatizza la paginazione.
Confrontalo con il codice del tutorial di ScraperAPI, che analizza in base a classi come styles_reviewCardInner__EwDq2. Quel selettore si romperà alla prossima release di Trustpilot. L’AI di Thunderbit chiede "dov’è il testo della recensione in questa pagina?" invece di "cosa c’è dentro questa specifica classe div?".
Funzionalità chiave per lo scraping di Trustpilot
- Campi rilevati dall’AI: l’estensione riconosce da sola i campi delle recensioni (nome, valutazione, data, titolo, testo, risposta dell’azienda) senza configurazioni manuali — oppure, se hai un set specifico in mente, basta dirglielo e lo usa
- Workflow con un clic: un clic → tabella pronta. Tutto qui.
- Modalità browser per pagine con login obbligatorio: funziona all’interno della tua sessione Chrome autenticata per accedere alla pagina 10+
- Paginazione automatica: gestisce raccolte di recensioni su più pagine senza interventi manuali
- Scraping di sottopagine: può visitare i profili dei singoli recensori per dati aggiuntivi
- Scraping pianificato: imposta monitoraggi settimanali o mensili delle recensioni per il reputation tracking
- Export: Google Sheets, Airtable, Notion, CSV, JSON — tutto incluso gratuitamente
Prezzo
- Piano gratuito: 6 pagine/mese, senza carta di credito
- Sistema a crediti: 1 credito = 1 riga di output
- Piani a pagamento: 15 $/mese, oppure circa 9 $/mese con fatturazione annuale (pagina prezzi)
Ideale per: team marketing, team operations e utenti business che vogliono recensioni Trustpilot senza scrivere codice — e senza dover mantenere uno scraper che si rompe ogni poche settimane.
2. Apify
Apify è una piattaforma di scraping cloud con un marketplace di "Actor" predefiniti — template di scraping creati da altri utenti e dal team Apify. Per Trustpilot, lo store contiene diversi Actor gestiti dalla community con affidabilità variabile.
Il compromesso di Apify è questo: può essere potente, ma è frammentato. Alcuni Actor funzionano. Altri sono obsoleti. Alcuni richiedono cookie per le pagine oltre la 10. E le lamentele su Reddit del tipo "none of the actors on the store work" sono reali — riflettono quanto velocemente le modifiche di Trustpilot possano rompere la logica specifica di un Actor.
Actor Trustpilot e limiti noti
L’Apify Store contiene diversi Actor per Trustpilot. Almeno uno (sviluppato da "burbn") documenta esplicitamente che oltre la pagina 10 è necessario inserire un cookie. Altri hanno valutazioni 0.0, pochissimi utenti o date di modifica molto recenti — segnali che la manutenzione è in corso e l’affidabilità varia.
Vale la pena notare anche gli Actor obsoleti. Un vecchio Actor leggeva direttamente il JSON incorporato __NEXT_DATA__ di Trustpilot — un approccio ingegnoso, più rapido del parsing del DOM, ma comunque rotto quando Trustpilot ha cambiato la struttura dei dati.
Gestione del login wall e delle protezioni anti-bot
- Login wall: dipende interamente dall’Actor scelto. Alcuni supportano l’iniezione dei cookie per la pagina 10+; altri no.
- Anti-bot: la piattaforma di Apify include rotazione proxy e infrastruttura basata su compute unit. I proxy residenziali sono disponibili a $8/GB sui piani Free/Starter.
- Manutenzione: quando un Actor si rompe, devi aspettare che il manutentore lo sistemi, passare a un altro Actor oppure commissionare un Actor privato personalizzato.
Prezzo
- Piano gratuito: $5/mese di utilizzo prepagato, senza carta di credito
- Starter: $9/mese + consumo pay-as-you-go
- Scale: $99/mese + consumo pay-as-you-go
- Export: JSON, CSV, Excel, XML, RSS (dipende dall’Actor)
Ideale per: utenti con una buona base tecnica che sanno valutare più Actor, configurare i cookie e risolvere problemi quando qualcosa si rompe. Non ideale per team che vogliono una soluzione da impostare una volta e dimenticare.
3. Octoparse
Octoparse è uno scraper desktop no-code con un builder visuale click-and-point. Si colloca tra la semplicità immediata di Thunderbit e il controllo completo di ScraperAPI — hai configurazione visiva senza codice, ma stai comunque costruendo e mantenendo un workflow.
Impostare uno scraping Trustpilot in Octoparse
Il workflow è semplice ma manuale:
- Incolla l’URL di una pagina recensioni Trustpilot di un’azienda
- Seleziona visivamente gli elementi delle recensioni (titolo, corpo, valutazione, data, nome del recensore)
- Definisci un ciclo di paginazione usando il pulsante della pagina successiva
- Configura i tempi di attesa (consigliati 2-5 secondi per evitare reCAPTCHA)
- Esegui in locale per piccoli campioni oppure nel cloud per lavori più grandi
La configurazione richiede 10-15 minuti a chi conosce già lo strumento. Il problema è che Octoparse usa selettori visivi legati agli elementi del DOM, quindi dovrai aggiornare il workflow ogni volta che Trustpilot modifica la struttura della pagina.
Gestione del login wall e delle protezioni anti-bot
- Login wall: richiede configurazione manuale di login/cookie/sessione. Non viene gestito automaticamente.
- Anti-bot: i piani a pagamento includono rotazione IP, proxy residenziali ($3/GB) e risoluzione automatica dei CAPTCHA ($1-1,5 ogni mille).
- Manutenzione: moderata. Aspettati di dover ricostruire o adattare il workflow quando Trustpilot aggiorna il frontend.
Prezzo
- Piano gratuito: gratuito per sempre, 10 task, 1 dispositivo, estrazione locale, fino a 50.000 righe/mese
- Standard: $69/mese (fatturazione annuale)
- Professional: $149/mese
- Prova premium di 14 giorni: include estrazione cloud, pianificazione, API e template
- Export: Excel, CSV, JSON, HTML, XML; database e Google Sheets nei piani superiori
Ideale per: utenti che vogliono controllo visivo sul workflow, non hanno problemi con un po’ di configurazione iniziale e sono pronti a mantenere i processi quando le pagine cambiano. Buona scelta per team che vogliono più personalizzazione di uno strumento one-click, ma meno complessità rispetto a scrivere Python.
4. Web Scraper
Web Scraper è un’estensione Chrome e una piattaforma cloud con un approccio basato su sitemap per lo scraping. La sua offerta più forte per Trustpilot è un template già pronto per le pagine aziendali che estrae dati a livello di azienda: nome, categoria, indirizzo, valutazione, numero di recensioni, TrustScore e URL del sito.
Per lo scraping delle recensioni in sé, Web Scraper ha un limite documentato che vale la pena segnalare.
Template predefinito vs configurazione personalizzata
Il template del marketplace funziona bene per la scoperta delle aziende — scraping dei profili business nelle categorie Trustpilot. Per l’estrazione personalizzata delle recensioni, il Sitemap Wizard permette di costruire visivamente uno scraper dentro l’estensione Chrome.
La guida ufficiale di Web Scraper di marzo 2026 raccomanda la paginazione via click JavaScript invece della paginazione basata sull’URL, perché Trustpilot può riordinare dinamicamente i contenuti tra le pagine, causando uno spostamento dei risultati.
Gestione del login wall e delle protezioni anti-bot
Qui serve essere chiari: la guida ufficiale di Web Scraper afferma esplicitamente che Trustpilot consente solo le prime 10 pagine di recensioni prima di mostrare un prompt di accesso. La guida documenta questo come un limite noto, senza offrire un workaround.
- Login wall: gestione limitata. Il limite di 10 pagine è documentato nella loro guida.
- Anti-bot: i piani cloud includono supporto proxy; la guida consiglia ritardi di 2-5 secondi e concorrenza ridotta.
- Paginazione: configurabile, ma di fatto limitata alle prime 10 pagine di recensioni per l’accesso non autenticato.
Prezzo
- Estensione Chrome gratuita: scraping locale, funzionalità limitate
- Project: $50/mese (5.000 URL credit)
- Professional: $100/mese (20.000 URL credit)
- Scale: da $200/mese (URL credit illimitati con condizioni)
- Prova gratuita di 7 giorni sui piani cloud a pagamento
- Export: CSV, XLSX
Ideale per: utenti che vogliono un template già pronto per estrarre i profili aziendali Trustpilot, oppure che hanno bisogno solo delle recensioni delle prime 10 pagine. Non è la scelta giusta se ti serve lo storico completo delle recensioni di aziende con molti feedback.
5. ScraperAPI
ScraperAPI è un’infrastruttura di scraping per sviluppatori — non uno strumento click-and-point, ma un livello di proxy/rendering che gestisce le misure anti-bot mentre tu scrivi la logica di parsing. La sua pagina soluzione per Trustpilot promuove rendering JS, gestione CAPTCHA e oltre 40 milioni di proxy.
Se sei uno sviluppatore Python che vuole il pieno controllo sulla logica di estrazione, ScraperAPI ti fornisce l’infrastruttura.
Ma la manutenzione resta tua.
Costruire uno scraper Trustpilot personalizzato con ScraperAPI
Il tutorial di ScraperAPI di gennaio 2026 mostra un flusso di lavoro Python + BeautifulSoup:
import requests
from bs4 import BeautifulSoup

payload = {
    "api_key": "YOUR_API_KEY",
    "url": "https://www.trustpilot.com/review/example.com",
    "render": "true",
    "keep_headers": "true",
}

html = requests.get("https://api.scraperapi.com", params=payload).text
soup = BeautifulSoup(html, "html.parser")
Il codice completo del tutorial imposta pages_to_scrape = 10 — riconoscendo implicitamente il limite delle pagine pubbliche. Per la pagina 10+, gli sviluppatori devono gestire autonomamente sessioni autenticate, cookie e token.
Gestione del login wall e delle protezioni anti-bot
- Login wall: serve gestione di sessione/cookie a livello di codice. ScraperAPI gestisce proxy e rendering; tu gestisci la logica di autenticazione.
- Anti-bot: pool di proxy residenziali con rotazione automatica degli IP, rendering JS tramite
render=true, gestione CAPTCHA attraverso una rotazione intelligente dei proxy. Disponibile su tutti i piani. - Manutenzione: quando Trustpilot cambia le classi CSS (e succede regolarmente), devi aggiornare il tuo codice di parsing. Il selettore
styles_reviewCardInner__EwDq2del tutorial è già una bomba a orologeria.
Prezzo
- Prova di 7 giorni: 5.000 crediti API gratuiti, senza carta di credito
- Hobby: $49/mese (100.000 crediti API)
- Startup: $149/mese (1.000.000 di crediti)
- Business: $299/mese (3.000.000 di crediti)
- Export: quello che produce il tuo codice (di solito CSV, JSON, scrittura su database)
Ideale per: sviluppatori che vogliono massima personalizzazione, che sanno mantenere i propri script di parsing e che hanno bisogno di controllo programmabile su gestione delle sessioni, logica di paginazione e struttura dei dati. Non adatto agli utenti non tecnici.
Perché gli scraper Trustpilot continuano a rompersi (e come scegliere uno che resista)
Questo è il fattore più sottovalutato nella scelta di uno scraper Trustpilot. La domanda non è "funziona oggi?". È "funzionerà ancora tra tre settimane?"
Gli scraper si rompono su Trustpilot per quattro motivi ricorrenti:
-
Modifiche alle classi CSS generate. I CSS modules di Next.js producono classi come
styles_reviewCardInner__EwDq2. Queste cambiano a ogni deploy del frontend. Qualsiasi scraper che punta a queste classi si rompe. -
Modifiche alla struttura DOM. Trustpilot può riorganizzare la gerarchia HTML — nidificando diversamente le card delle recensioni, cambiando gli elementi wrapper, spostando i metadati in altre posizioni.
-
Cambiamenti nei trigger anti-bot. Le soglie di reCAPTCHA cambiano. La rotazione dei token di sessione diventa più aggressiva. Le regole di filtraggio CDN si aggiornano.
-
Cambiamenti nell’autenticazione/sessione. Il login wall della pagina 10 è stato introdotto (o reso più severo) a fine 2025. In futuro potrebbero comparire altre restrizioni di accesso.
La differenza architetturale fondamentale è tra estrazione basata sui selettori ed estrazione semantica:
-
Strumenti basati su selettori (Actor di Apify, workflow di Octoparse, script ScraperAPI, sitemap di Web Scraper) chiedono: "Trova l’elemento in questo preciso percorso CSS." Quando il percorso cambia, falliscono in silenzio o restituiscono dati vuoti.
-
Strumenti semantici/AI (Thunderbit) chiedono: "Trova il testo della recensione, la valutazione e la data in questa pagina." L’AI interpreta i contenuti in base al significato, non all’indirizzo. I cambi di layout non la mandano in crisi perché il significato non è cambiato.
La mia raccomandazione:
- Zero tolleranza alla manutenzione? → AI-based (Thunderbit)
- Accetti un po’ di manutenzione e vuoi automazione cloud? → Apify (con selezione e monitoraggio degli Actor)
- Controllo visivo, manutenzione moderata? → Octoparse
- Approccio basato su template, ambito limitato? → Web Scraper
- Controllo totale, vuoi gestire tutto tu? → ScraperAPI
Cosa fare con le recensioni Trustpilot estratte
Estrarre le recensioni è solo il primo passo. La domanda che vedo continuamente nei forum è: "Ora che ho i dati, cosa me ne faccio?"
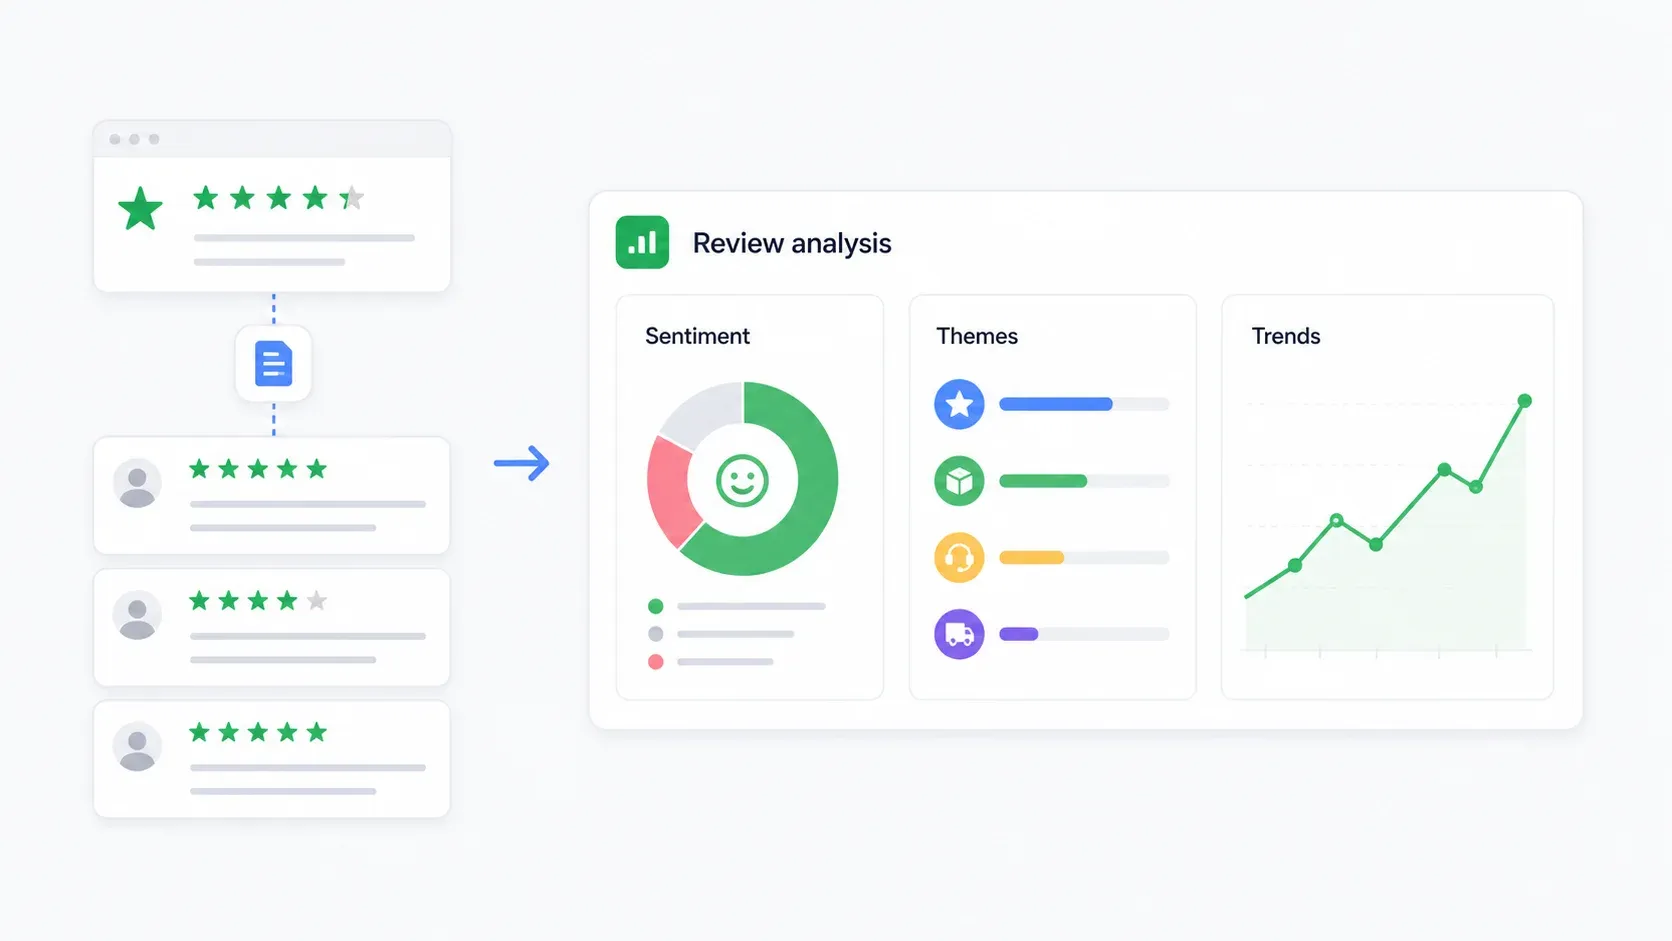
Analisi del sentiment
Il flusso più semplice: esporta le recensioni in Google Sheets, poi usa uno strumento AI (ChatGPT, Claude o una funzione AI di Sheets) per classificare ogni recensione come positiva, neutra o negativa. Aggiungi colonne per categoria del problema, urgenza e priorità di intervento suggerita.
Per dataset più grandi, carica il CSV in ChatGPT e chiedi un riepilogo: "Classifica queste recensioni per sentiment e identifica i 5 temi di reclamo principali con citazioni rappresentative."
Monitoraggio dei competitor
Usa lo scraping pianificato di Thunderbit per raccogliere recensioni dei competitor ogni settimana o ogni mese. Tieni traccia di:
- andamento della valutazione media nel tempo
- quota di recensioni a 1 e 2 stelle
- variazioni nel volume di recensioni (ne stanno ricevendo di più o di meno?)
- temi di reclamo più frequenti
- tasso e velocità delle risposte dell’azienda
Una semplice dashboard in Google Sheets con tabelle pivot per valutazione e data ti offre un feed di competitive intelligence che si aggiorna automaticamente.
Estrazione dei temi
Raggruppa le recensioni per categorie ricorrenti: spedizione/consegna, assistenza clienti, rimborsi, qualità del prodotto, fatturazione, usabilità dell’app, prezzo/valore e problemi di frode. Il risultato dovrebbe essere una tabella con: tema, numero di occorrenze, valutazione media, citazioni rappresentative e azione aziendale suggerita.
È più utile di una word cloud. Ti dice davvero cosa sta guidando soddisfazione o insoddisfazione.
Analisi bulk su più aziende
Per ricerche a livello di categoria, estrai recensioni di più aziende nella stessa categoria Trustpilot. Confronta volumi, valutazioni, distribuzione delle stelle e diffusione dei temi su un intero segmento di mercato. Il template per le liste aziende di Web Scraper è utile per scoprire le imprese; Thunderbit o ScraperAPI possono gestire il campionamento a livello di recensione per ciascuna.
Considerazioni legali ed etiche per lo scraping di Trustpilot
Non sono un avvocato e questo non è un parere legale. Ma qui la realtà della compliance conta.
I Termini di utilizzo di Trustpilot sono chiari. Vietano agli utenti di accedere o raccogliere contenuti "by any means other than as provided or specifically approved by Trustpilot", e citano esplicitamente text mining, data mining e web scraping senza autorizzazione espressa.
Lo spettro di rischio è questo:
- Rischio più basso: esportare le recensioni della propria azienda per analisi interne, soprattutto usando gli strumenti business ufficiali di Trustpilot o la sua API.
- Rischio moderato: fare scraping di pagine pubbliche dei competitor a basso volume per ricerche di mercato. Rimangono validi i Termini di servizio e gli obblighi privacy.
- Rischio più alto: fare scraping di contenuti protetti da login oltre la pagina 10, aggirare controlli tecnici, ridistribuire dati dei recensori o usare le recensioni estratte per addestrare modelli AI.
Considerazioni GDPR: nomi dei recensori, link al profilo, testo della recensione e dati di localizzazione possono costituire dati personali ai sensi della normativa europea. Le misure pratiche includono raccogliere solo i campi necessari, hashare i nomi per le analisi interne, impostare tempi di conservazione dei dati e non ripubblicare su larga scala il testo grezzo delle recensioni.
Dati pubblici vs autenticati: c’è una distinzione legale ed etica rilevante tra lo scraping di pagine visibili a chiunque (le prime 10 pagine di recensioni) e lo scraping di dati dietro una barriera di autenticazione. Gli strumenti che operano solo su dati pubblici comportano un rischio di compliance inferiore rispetto a quelli che richiedono credenziali di accesso.
Questo dovrebbe influire sulla tua scelta dello strumento. La modalità browser di Thunderbit funziona con le pagine visibili nella tua sessione — non aggira l’autenticazione in modo indipendente. ScraperAPI offre agli sviluppatori pieno controllo, ma anche piena responsabilità sulla legalità della gestione delle sessioni.
Come scegliere il giusto scraper di recensioni Trustpilot
Schema decisionale per profilo:
- Marketer non tecnico che ha bisogno di recensioni senza codice? → Thunderbit. Un clic, l’AI fa il resto, export in Sheets/Notion/Airtable.
- Utente low-code a suo agio con configurazione e debug? → Apify. Scegli un Actor, configura i cookie per la pagina 10+, monitora eventuali rotture.
- Builder visuale che vuole controllare il workflow? → Octoparse. Configurazione click-and-point, ma aspettati manutenzione quando Trustpilot cambia.
- Ti servono dati a livello azienda o solo le prime 10 pagine di recensioni? → Web Scraper. Template predefiniti solidi per i profili business.
- Sviluppatore che vuole massima personalizzazione? → ScraperAPI. Gestisci tu parsing, sessioni e pipeline dati.
Se la tua priorità è la tolleranza alla manutenzione, la scala va da Thunderbit (manutenzione quasi nulla) a ScraperAPI (devi mantenere tutto tu). Dal punto di vista del budget, ogni strumento di questa lista offre un punto d’ingresso gratuito — conviene partire da lì prima di impegnarsi.
Conclusione
I dati delle recensioni Trustpilot sono davvero preziosi per la competitive intelligence, il monitoraggio della reputazione e l’analisi dei clienti.
Ma nel 2026, estrarli in modo affidabile richiede uno strumento che sappia gestire il login wall della pagina 10, adattarsi ai cambiamenti del DOM e superare le protezioni anti-bot senza interventi manuali continui.
Per la maggior parte degli utenti business, Thunderbit è la strada con meno attrito — un clic, rilevamento AI dei campi, modalità browser per le pagine autenticate e nessuna manutenzione quando Trustpilot modifica il frontend. Puoi provarlo gratis con 6 pagine/mese e senza carta di credito.
Per gli sviluppatori che vogliono il controllo totale, ScraperAPI offre l’infrastruttura. Per tutti gli altri, Apify, Octoparse e Web Scraper rispondono a esigenze specifiche. La chiave è abbinare lo strumento al tuo livello tecnico, alla tua tolleranza alla manutenzione e ai requisiti di compliance.
Se vuoi vedere come Thunderbit gestisce Trustpilot nello specifico, abbiamo un tutorial sul nostro canale YouTube. E per un contesto più ampio su come fare web scraping senza codice o che cos’è davvero il web scraping, queste guide coprono le basi.
FAQ
1. Si possono estrarre recensioni Trustpilot oltre la pagina 10?
Sì, ma solo tramite un percorso autenticato. Trustpilot blocca l’accesso non autenticato dopo le prime 10 pagine di recensioni. La modalità browser di Thunderbit funziona all’interno della tua sessione Chrome già autenticata, quindi può accedere alle pagine che riesci a vedere. ScraperAPI richiede gestione di sessioni/cookie a livello di codice. Gli Actor di Apify necessitano della configurazione dei cookie. Octoparse richiede configurazione manuale di login/cookie. La documentazione di Web Scraper riconosce il limite delle 10 pagine senza offrire un workaround integrato.
2. È legale fare scraping delle recensioni Trustpilot?
I Termini di utilizzo di Trustpilot vietano la raccolta automatica di dati senza autorizzazione esplicita. Il rischio legale varia in base al metodo e al caso d’uso: estrarre le proprie recensioni pubbliche comporta un rischio inferiore rispetto al bypass di barriere di autenticazione per fare scraping dei competitor. Il GDPR si applica ai dati dei recensori UE. Questo non è un parere legale — per progetti di scraping su larga scala o commerciali, consulta un legale.
3. Quali dati si possono estrarre da Trustpilot?
I campi più comuni includono: nome del recensore, valutazione a stelle, titolo della recensione, testo della recensione, data di pubblicazione, data dell’esperienza, stato di acquisto verificato, località del recensore, testo della risposta dell’azienda, nome dell’azienda, TrustScore, numero totale di recensioni, distribuzione delle stelle e URL della recensione.
4. Con quale frequenza si rompono gli scraper Trustpilot?
Gli strumenti basati su selettori (Actor di Apify, workflow di Octoparse, script Python personalizzati) possono rompersi ogni volta che Trustpilot modifica le classi CSS o la struttura DOM — e questo può accadere più volte al mese. Gli strumenti AI-semantici come Thunderbit si adattano automaticamente perché interpretano il significato della pagina invece di puntare selettori specifici. Tuttavia, nessuno strumento è immune a cambiamenti importanti nei controlli di accesso, come il login wall della pagina 10.
5. Posso estrarre recensioni Trustpilot gratis?
Tutti gli strumenti in questa lista hanno un punto d’ingresso gratuito: Thunderbit offre 6 pagine gratis/mese, ScraperAPI fornisce 5.000 crediti di prova per 7 giorni, Web Scraper ha un’estensione Chrome gratuita per l’uso locale, Octoparse ha un piano gratuito per sempre (10 task, 50.000 righe/mese) e Apify include $5/mese in crediti gratuiti sulla piattaforma. Per campionamenti o test su piccola scala, ognuno di questi funziona senza pagamento.
Prova Thunderbit per lo scraping delle recensioni Trustpilot Get Started Free
Scopri di più



