
Dulu saya sempat mengira "pengumpulan data" itu cuma duduk berjam-jam copy-paste baris dari website ke spreadsheet, lalu baru sadar separuh nomor telepon kelewat dan tanpa sengaja ada meme kucing yang ikut masuk ke kolom harga. Di 2026, alur kerja seperti itu rasanya sudah ketinggalan zaman. Sekarang kategorinya mencakup AI web scraper, infrastruktur proxy dan API, tim scraping terkelola, hingga jaringan riset dan anotasi berbasis manusia dalam skala besar.
Ini penting karena bisnis tetap membutuhkan data yang lebih segar, lebih bersih, dan lebih andal daripada yang bisa dikumpulkan tim internal secara manual. Tim sales ingin daftar prospek yang tidak cepat basi. Tim ecommerce ingin memantau produk, harga, dan stok. Tim riset dan AI butuh cara yang bisa diskalakan untuk mengumpulkan data web publik, masukan manusia, data pelatihan, dan dataset terstruktur tanpa harus membangun semua pipeline dari nol.
Panduan ini dibuat untuk membantu keputusan praktis itu: perusahaan pengumpulan data mana yang paling cocok untuk alur kerja, tingkat keahlian tim, dan skala kebutuhan Anda di 2026?
Kenapa Bisnis Membutuhkan Layanan Pengumpulan Data di 2026
Pengumpulan data manual masih sering gagal di titik yang sama seperti dulu: terlalu banyak pekerjaan berulang, terlalu banyak tab, terlalu banyak pembersihan data, dan terlalu rapuh ketika sumber datanya berubah. Bedanya di 2026, makin banyak tim yang mengharapkan otomasi menangani ekstraksi awal, enrichment, penjadwalan, dan ekspor secara default.
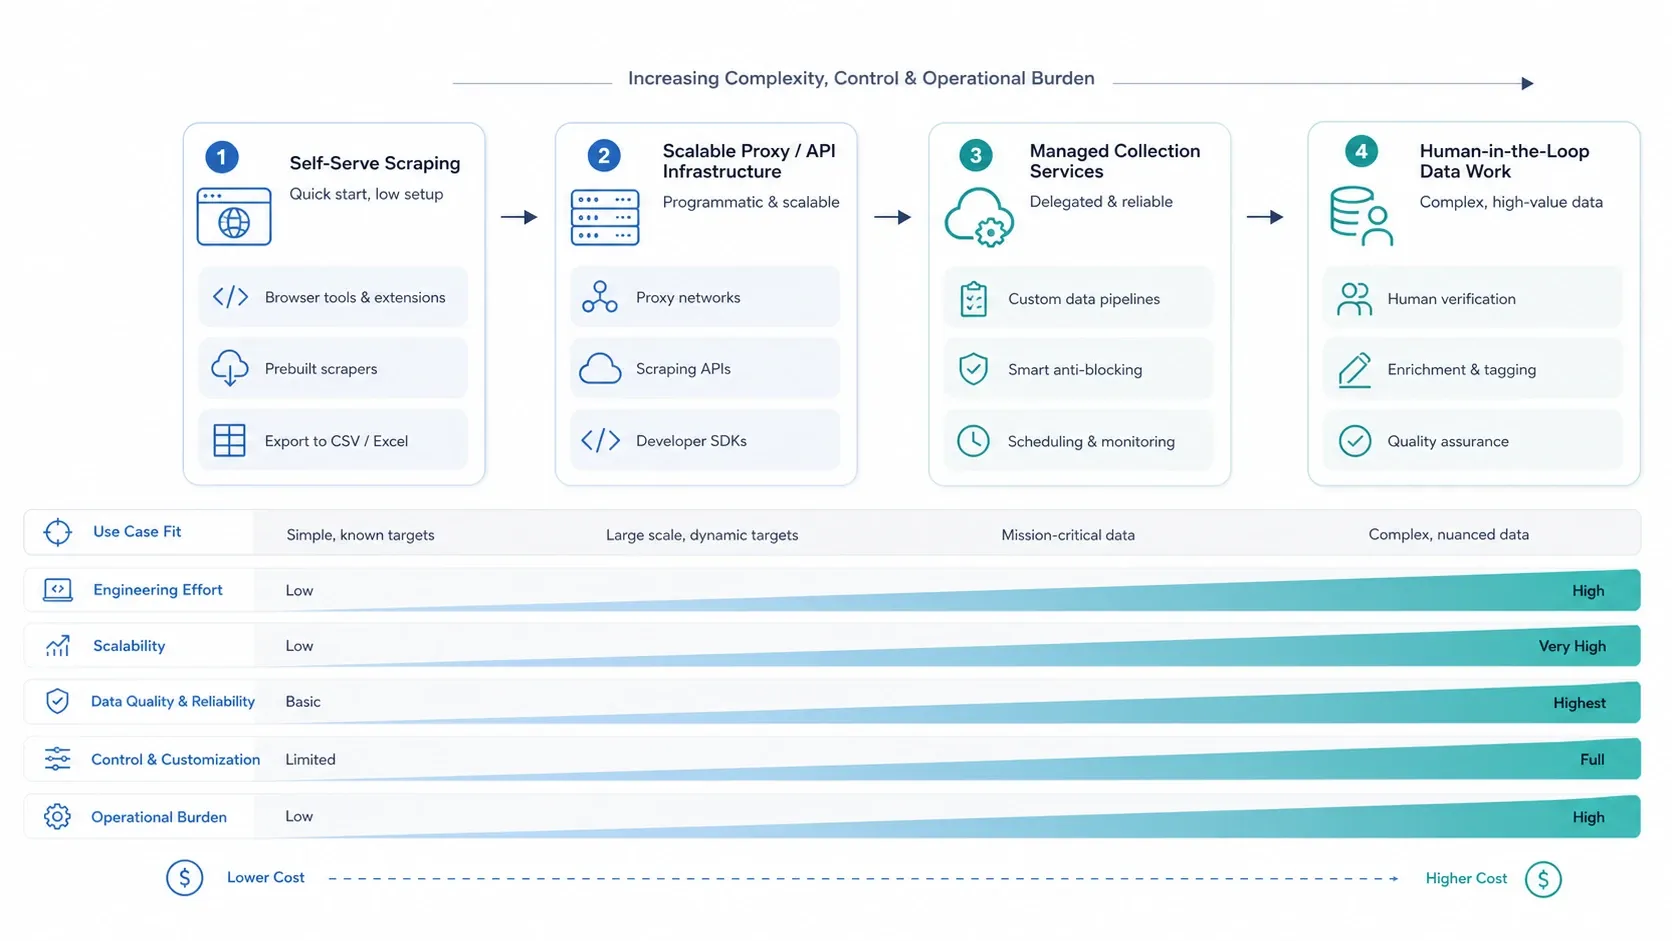
Karena itu layanan pengumpulan data kini terbagi ke beberapa lapisan. Ada alat yang membantu pengguna non-teknis melakukan web scraping dengan hampir tanpa setup. Ada yang fokus pada jaringan proxy, automasi browser, dan infrastruktur unblock untuk tim engineering. Ada juga yang menjual layanan fully managed atau pengumpulan dan anotasi berbasis manusia. Jadi, memilih yang tepat bukan lagi soal mencari vendor yang paling besar, melainkan mencocokkan alat dengan pekerjaannya.
Kalau tim Anda hanya perlu mengekstrak listing, kontak, atau halaman produk dengan cepat, AI scraper bisa langsung menghemat banyak waktu. Kalau Anda butuh pipeline yang tangguh untuk target ber-volume tinggi atau yang dilindungi, vendor infrastruktur lebih masuk akal. Kalau masalah Anda berkaitan dengan survei, labeling, evaluasi, atau penilaian manusia yang bernuansa, platform riset dan anotasi berbasis crowdsourcing biasanya jauh lebih cocok.
Kalau Anda ingin gambaran cepat tentang kenapa operasi data yang lebih kuat itu penting sebelum menyusun shortlist vendor, video konteks pasar singkat ini bisa jadi pengantar yang berguna.
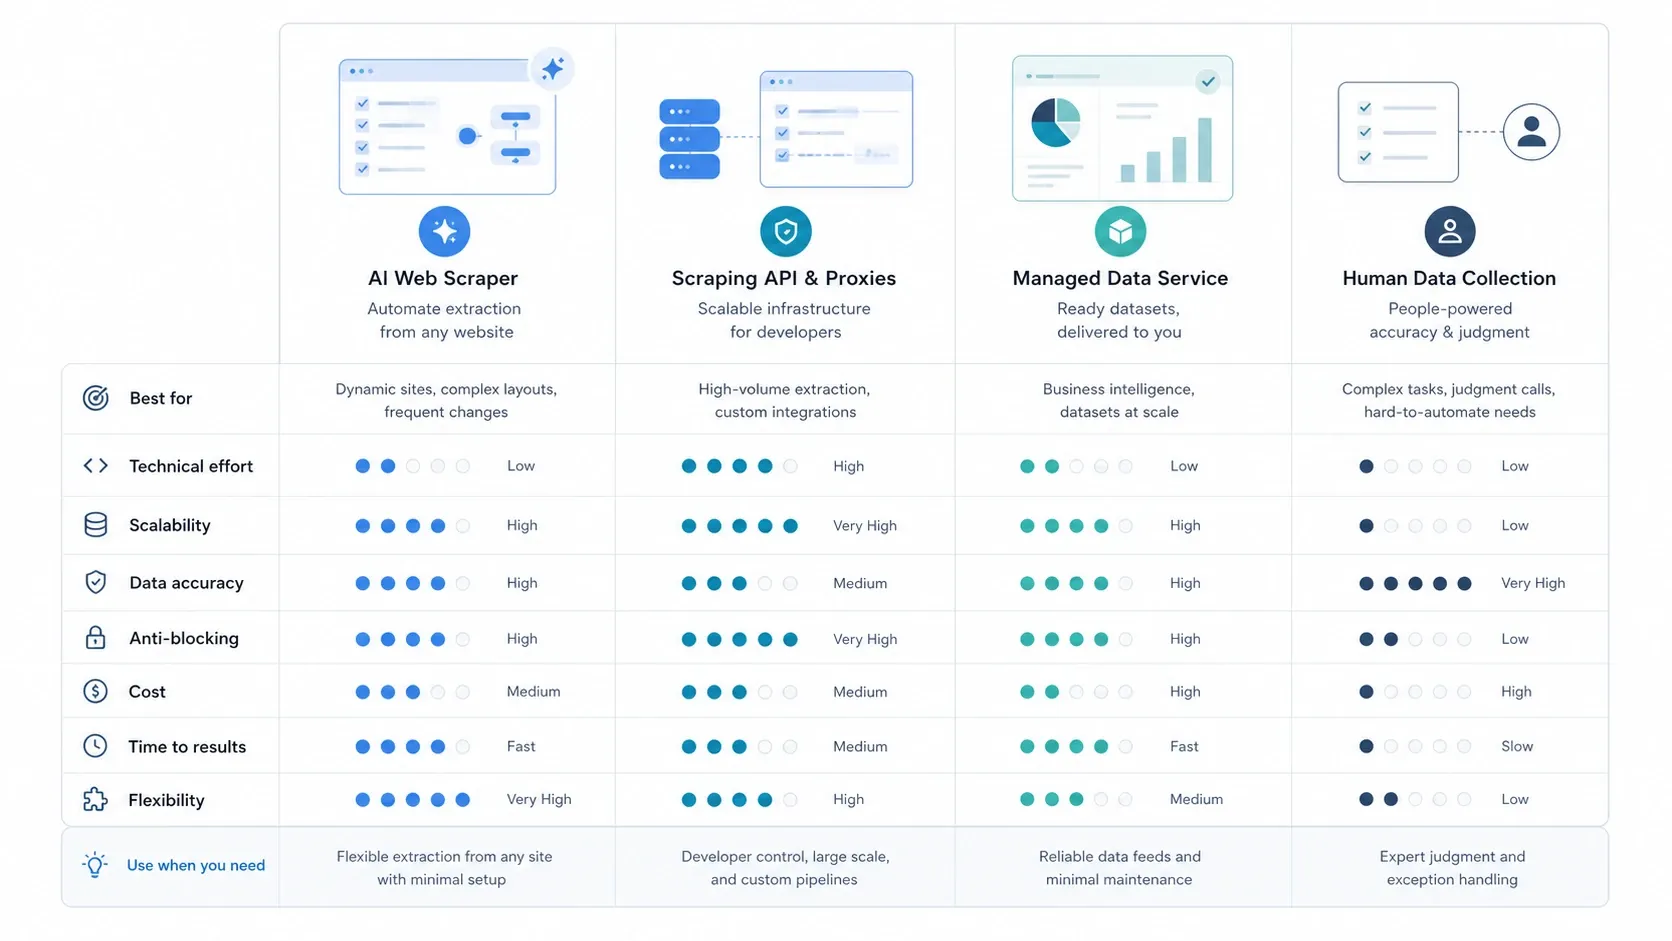
Cara Kami Memilih Layanan Pengumpulan Data Terbaik
Perusahaan pengumpulan data memang banyak, tapi tidak semuanya menyelesaikan masalah yang sama. Untuk pembaruan ini, saya fokus pada beberapa kriteria praktis:
- Fitur dan kemampuan: Apakah layanan ini bisa menangani halaman web publik, ekspor terstruktur, halaman dinamis, penjadwalan, API, atau tugas human-in-the-loop?
- Kemudahan penggunaan: Apakah bisa dipakai oleh user bisnis, atau lebih ditujukan untuk developer dan tim data?
- Skalabilitas: Apakah bisa mendukung semuanya, mulai dari prospecting ringan sampai pipeline enterprise dan pekerjaan pengumpulan berulang?
- Model harga: Gratis, langganan, berbasis pemakaian, bayar per tugas, atau berbasis penawaran?
- Reputasi dan positioning: Apakah positioning produk saat ini masih sesuai dengan kebutuhan pembeli di 2026?
- Kemampuan AI: Apakah AI benar-benar dipakai untuk ekstraksi, parsing, enrichment, atau evaluasi, atau cuma sekadar otomasi workflow biasa?
Saya juga membersihkan klaim angka yang sudah usang dan branding lama. Untuk angka harga atau kapasitas yang tidak didukung rapi oleh halaman resmi saat ini, saya menggeser pembandingannya ke model harga dan skenario penggunaan terbaik, bukan pura-pura angka lama itu masih akurat.
Tabel Perbandingan Cepat: 15 Perusahaan Pengumpulan Data Terbaik
Sebelum masuk ke detailnya, berikut gambaran berdampingan dari 15 layanan pengumpulan data terbaik di 2026.
| Layanan | Fitur Utama | Jenis Data yang Didukung | AI Web Scraper? | Uji Coba / Akses Gratis | Model Harga | Cocok Untuk |
|---|---|---|---|---|---|---|
| Thunderbit | Ekstensi Chrome berbasis AI, deteksi field otomatis, subpage, pagination, scheduling, ekspor ke Sheets dan Excel | Halaman web, tabel, gambar, email, nomor telepon | Ya | Paket gratis | Paket gratis + tier berbayar | Pengguna bisnis non-teknis yang ingin ekstraksi web cepat dan minim ribet |
| Bright Data | Web Scraper API, infrastruktur proxy, dataset, alat unblock, kontrol kepatuhan | Data web publik, ecommerce, sosial, pencarian, API | Sebagian | Uji coba gratis | Uji coba gratis + berbasis pemakaian / paket skala | Tim teknis yang menjalankan pipeline pengumpulan data skala besar |
| Oxylabs | Scraper API, jaringan proxy, dataset siap pakai, dukungan parsing | Data produk, pencarian, travel, perusahaan, dan marketplace | Sebagian | Uji coba pada produk tertentu | Berbasis penawaran / penjualan enterprise | Enterprise yang butuh infrastruktur scraping andal dan bervolume tinggi |
| Octoparse | Visual scraper tanpa kode, template, cloud scheduling, workflow builder | Website, daftar, tabel, data halaman terstruktur | AI terbatas | Paket gratis | Paket gratis + langganan | Analis dan operator yang ingin kontrol tanpa coding |
| Zyte | Zyte API, ekstraksi AI, tool proxy cerdas, fokus kepatuhan | Data web dinamis, ekstraksi terstruktur, target berbasis browser | Ya | Uji coba gratis | Berbasis pemakaian | Tim yang menginginkan ekstraksi data berbasis API dan patuh aturan |
| NetNut | Jaringan proxy, akses data B2B, geo-targeting, scraping API | Data perusahaan dan profesional dari web, pengumpulan berbasis proxy | Tidak | Uji coba / demo | Berbasis penawaran | Enrichment data B2B dan workflow intelijen penjualan |
| Decodo (sebelumnya Smartproxy) | Scraping API, produk proxy, site unblocker, paket self-serve | Data pencarian, belanja, sosial, dan web umum | Tidak | Paket gratis / uji coba gratis | Paket gratis + langganan | Tim hemat biaya yang tetap butuh infrastruktur scraping yang skalabel |
| Infatica | Jaringan proxy, scraper API, rendering JS, dukungan terkelola | Website dinamis, target terbatas, halaman dengan browser rendering | Tidak | Uji coba | Berbasis penawaran | Tim teknis yang butuh dukungan scraping kustom yang fleksibel |
| DataHen | Web scraping terkelola, dukungan ETL, pengiriman dalam format terstruktur | Data web publik, proyek pengumpulan khusus | Tidak | Konsultasi | Harga layanan kustom | Enterprise yang mengalihkan pekerjaan pengumpulan data kustom |
| HabileData | Enrichment data, anotasi, pemrosesan dokumen, operasi outsourcing | Record terstruktur, dokumen, gambar, dataset spesifik industri | Tidak | Konsultasi | Harga layanan kustom | Pemrosesan data tervalidasi manusia dan pekerjaan data back-office |
| Coresignal | Dataset web publik, API, cakupan perusahaan dan tenaga kerja | Data perusahaan, karyawan, dan pasar kerja | Tidak | Akses contoh | Harga kontrak | Tim yang menginginkan dataset intelijen bisnis siap pakai |
| LXT | Pengumpulan data manusia global, anotasi, RLHF, jangkauan multibahasa | Audio, teks, gambar, dan dataset evaluasi | Tidak | Inquiry enterprise | Harga enterprise kustom | Tim AI yang butuh data pelatihan multibahasa berbasis manusia |
| Appen | Pengumpulan data AI terkelola, anotasi, validasi, evaluasi | Speech, teks, gambar, dan data evaluasi model | Tidak | Inquiry enterprise | Harga enterprise kustom | Enterprise yang menjalankan program data AI skala besar dan terkelola |
| Prolific | Partisipan riset berkualitas tinggi, prescreening, layanan terkelola | Survei, studi, evaluasi manusia, data feedback | Tidak | Akses self-serve | Pay-as-you-go | Tim riset, UX, dan evaluasi AI yang memprioritaskan kualitas partisipan |
| Amazon Mechanical Turk | Marketplace tugas besar, alat untuk requester, workflow microtask fleksibel | Survei, labeling, review, validasi, dan input data | Tidak | Tidak ada uji coba gratis | Bayar per tugas + biaya platform | Distribusi tugas manusia berbiaya rendah dan fleksibel dalam skala besar |
Thunderbit: AI Web Scraper Paling Mudah untuk Pengguna Bisnis
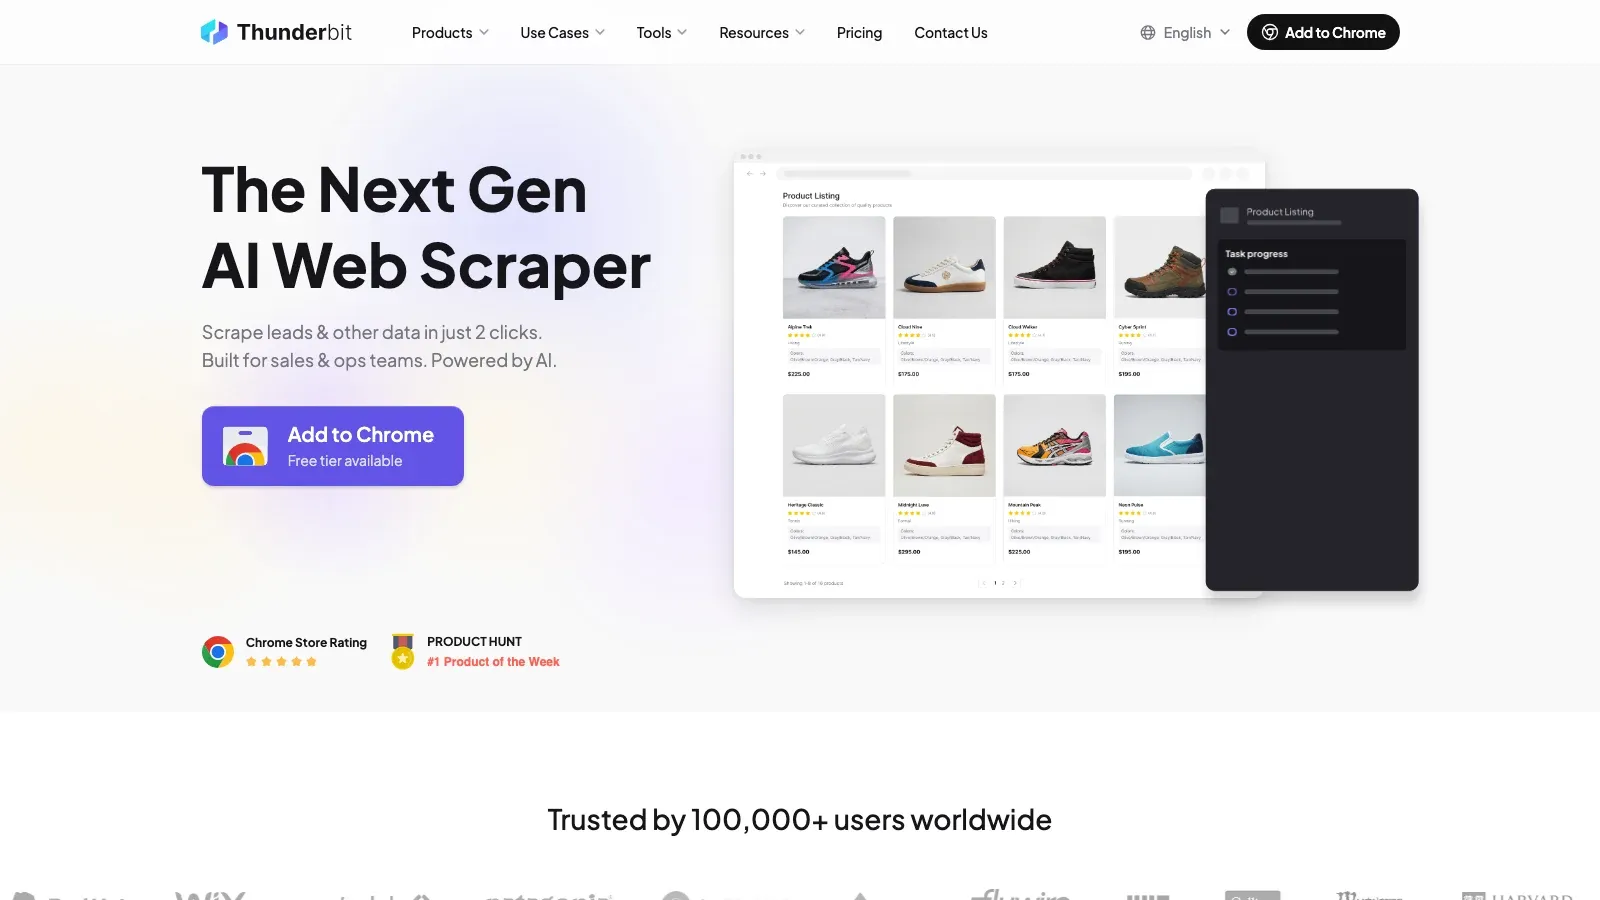
Kita mulai dari favorit saya: Thunderbit. Thunderbit dibuat untuk orang yang butuh data terstruktur dari web, tapi tidak mau menghabiskan minggu mereka untuk debug selector, automasi browser, atau alur scraping yang gampang rusak. Alat ini mengubah halaman menjadi tabel hanya dalam beberapa klik dan sangat kuat untuk lead generation, pemantauan ecommerce, scraping direktori, dan pengumpulan operasional berulang.
Yang membuat Thunderbit menonjol adalah workflow yang mengutamakan AI. Dengan AI Suggest Fields, Anda cukup membuka halaman, meminta Thunderbit mengekstrak data apa, lalu langsung dapat skema yang bisa dipakai. Untuk pengguna bisnis, ini jauh lebih enak dibanding membangun setiap field secara manual. Thunderbit juga mendukung pagination, subpage, ekspor, dan job terjadwal, jadi cocok untuk pengumpulan satu kali maupun pemantauan berkala.
Fitur Utama Thunderbit
- Deteksi field berbasis AI: Thunderbit menyarankan skema ekstraksi untuk halaman tersebut, jadi Anda tidak perlu merancang semuanya dari nol.
- Workflow minim hambatan: Dirancang untuk pengguna bisnis, bukan hanya developer atau spesialis scraping.
- Scraping subpage dan pagination: Berguna untuk katalog produk, direktori, listing properti, dan halaman ulasan.
- Enrichment langsung di alur kerja: Anda bisa membersihkan, mengklasifikasikan, menerjemahkan, atau memformat field saat proses ekstraksi.
- Opsi ekspor fleksibel: Ekspor ke Excel, Google Sheets, Airtable, Notion, CSV, atau JSON.
- Mode cloud dan browser: Gunakan eksekusi cloud untuk skala, atau mode browser untuk situs yang butuh login dan sensitif terhadap sesi.
- Scheduling: Jalankan pekerjaan berulang tanpa harus membangun ulang workflow setiap kali.
- Paket gratis: Cara praktis untuk mencoba alur kerja sebelum masuk ke penggunaan berbayar.
Thunderbit ideal untuk tim sales, ecommerce, operasional, dan riset yang ingin hasil cepat tanpa menjadikan maintenance scraper sebagai pekerjaan sampingan.
Kalau Anda ingin melihat seperti apa workflow dengan hambatan paling rendah di kategori ini, panduan quick-start resmi ini adalah contoh paling jelas di daftar ini.
Ingin melihat Thunderbit secara langsung? Cek blog atau channel YouTube.
Coba Thunderbit AI Web Scraper Gratis
Bright Data: Web Scraper dan Infrastruktur Proxy Level Enterprise
Kalau Thunderbit itu tombol mudahnya, Bright Data adalah stack infrastrukturnya. Bright Data dibangun untuk organisasi yang butuh pengumpulan berskala besar, cakupan target yang sulit, alat unblock, dan berbagai cara mengakses data web publik tanpa merakit semuanya sendiri.
Alur produk dan harga Bright Data saat ini berpusat pada Web Scraper API, dengan uji coba gratis, opsi pay-as-you-go, paket skala, dan tier enterprise kustom yang terlihat di halaman harga resminya. Ini membuatnya cocok untuk tim teknis yang butuh fleksibilitas lintas proxy, API, dataset, dan workflow yang sensitif terhadap kepatuhan.
Oxylabs: Scraper API dan Dataset Andal untuk Pipeline Data
Oxylabs masih menjadi salah satu pilihan enterprise yang paling aman kalau prioritas Anda adalah reliabilitas, API scraping khusus, dan kedalaman infrastruktur. Lini produknya ditujukan untuk use case pengumpulan serius, bukan scraping ringan sekali pakai.
Platform ini sangat kuat untuk organisasi yang butuh ekstraksi andal dari sumber pencarian, ecommerce, travel, dan marketplace, plus dukungan operasional untuk menjalankan pipeline tersebut dalam skala besar. Dibanding alat self-serve yang lebih sederhana, Oxylabs lebih berat di sisi infrastruktur dan lebih berorientasi sales, itulah sebabnya tim besar sering memasukkannya ke shortlist.
Octoparse: Data Scraping Tanpa Kode untuk Analis dan Operator
Octoparse masih menjadi salah satu scraper visual tanpa kode yang paling dikenal. Nilai utamanya sederhana: Anda mendapat workflow builder, template, dan cloud scheduling tanpa harus menulis kode khusus untuk tugas ekstraksi yang umum.
Halaman harga resmi Octoparse saat ini masih membuatnya menarik bagi tim kecil karena tetap menyediakan paket gratis, lalu naik ke langganan berbayar untuk penggunaan yang lebih serius. Ini pilihan yang baik untuk analis, marketer, dan operator yang ingin kontrol lebih manual daripada alat yang sepenuhnya AI, tetapi tetap ingin menghindari membangun semuanya dari kode.
Zyte: Pengumpulan Data Web Berbasis AI dan API-First
Zyte terus memposisikan diri sebagai platform ekstraksi data web yang patuh aturan dan berfokus pada API. Perusahaan ini menggabungkan infrastruktur browser dan proxy dengan ekstraksi AI di dalam Zyte API, yang menarik jika Anda menginginkan antarmuka programatik yang lebih rapi daripada merangkai beberapa tool terpisah.
Zyte sangat kuat untuk tim yang peduli pada ekstraksi terstruktur, target yang kompleks, dan postur legal atau tata kelola. Harganya yang saat ini berbasis pemakaian cocok untuk beban kerja yang berubah-ubah, dibanding harga seat-based yang kaku.
NetNut: Data B2B dan Pengumpulan Berbasis Proxy
NetNut berada di kubu infrastruktur, dengan pesan produk yang berfokus pada proxy berkualitas tinggi, pengumpulan data web, dan use case B2B. Ini cocok untuk intelijen penjualan, enrichment, dan program pengumpulan yang lebih menekankan kualitas pengiriman daripada UI yang ramah konsumen.
Kalau alur kerja Anda bergantung pada akses yang andal ke sumber data perusahaan dan profesional, NetNut lebih masuk akal dibanding alat no-code serbaguna. Ini bukan titik awal termudah untuk pengguna non-teknis, tetapi bisa menjadi bagian yang kuat dari stack pengumpulan yang lebih besar.
Decodo (Dulu Smartproxy): Scraping dan Proxy yang Skalabel
Smartproxy sekarang sudah rebranding menjadi Decodo, dan positioning resmi terbarunya menekankan produk scraping, proxy, dan akses self-serve. Ini penting karena perbandingan lama yang masih memperlakukan Smartproxy sebagai brand terpisah saat ini sudah tertinggal.
Decodo tetap menarik untuk tim kecil yang butuh alat unblock, akses proxy, dan scraping API tanpa langsung masuk ke siklus penjualan enterprise yang berat. Ini opsi tengah yang bagus kalau Anda sudah melewati alat scraping ringan, tapi belum siap ke vendor infrastruktur paling mahal.
Infatica: Scraping API dan Dukungan Proxy yang Fleksibel
Infatica menggabungkan produk proxy dengan scraper API dan dukungan untuk target yang dirender browser. Lebih tepat jika dianggap sebagai infrastruktur fleksibel plus support, bukan aplikasi scraping untuk pemula.
Karena itu Infatica berguna untuk tim teknis dengan situs dinamis, kebutuhan geo-spesifik, atau kebutuhan pengumpulan kustom yang tidak cocok dengan template produk yang kaku.
DataHen: Web Scraping Terkelola untuk Pekerjaan Enterprise Kustom
DataHen mengambil jalur managed service. Alih-alih meminta tim Anda menjalankan seluruh stack, platform ini memposisikan diri pada layanan crawling dan web scraping kustom dengan delivery terstruktur.
Ini pilihan kuat saat masalah sebenarnya bukan "bagaimana cara scraping satu halaman ini?", melainkan "bagaimana saya membuat vendor mengambil alih workflow pengumpulan yang berantakan dan berulang ini dari awal sampai akhir?"
HabileData: Pemrosesan dan Enrichment Data yang Divalidasi Manusia
HabileData bukan soal glamor web scraping, melainkan operasi data outsourcing. Positioning-nya mencakup layanan ala BPO, enrichment, pemrosesan dokumen, anotasi, dan pekerjaan data spesifik industri.
Kalau bottleneck Anda ada di pembersihan, validasi, enrichment, atau pemrosesan yang berat dokumen, bukan di automasi browser itu sendiri, HabileData lebih relevan dibanding vendor yang berfokus pada proxy.
Coresignal: Dataset Web Publik Siap Pakai
Coresignal adalah opsi dataset di roundup ini. Positioning saat ini menekankan data web publik real-time untuk perusahaan, karyawan, dan intelijen pasar kerja, sehingga berguna kalau Anda menginginkan data bisnis yang siap dipakai tanpa harus mengoperasikan workflow pengumpulan sendiri.
Ini keputusan pembelian yang berbeda dari alat scraping biasa. Coresignal paling cocok ketika tim Anda lebih menghargai kecepatan menuju analisis daripada fleksibilitas ekstraksi kustom.
LXT: Data Berbasis Manusia untuk Pelatihan dan Evaluasi AI
LXT dibuat untuk pengumpulan data AI, anotasi, dan workflow human-in-the-loop multibahasa. Kalau use case Anda adalah pelatihan model, RLHF, evaluasi, atau pembuatan data manusia skala besar, LXT tetap layak masuk pembicaraan meskipun bukan web scraper dalam arti biasa.
Platform ini lebih cocok untuk tim AI yang membutuhkan operasi data manusia khusus daripada tim yang masalah utamanya mengekstrak data terstruktur dari website.
Appen: Pengumpulan Data AI Terkelola Skala Enterprise
Appen masih menjadi nama besar dalam pengumpulan data AI terkelola. Positioning saat ini berpusat pada data pelatihan AI, pengumpulan data kustom, dan program terkelola skala enterprise.
Kalau Anda butuh partner untuk inisiatif data AI yang besar dan kompleks, bukan produk self-serve, Appen masih relevan. Trade-off-nya adalah keterlibatan enterprise yang lebih berat, bukan solusi cepat tinggal pakai.
Prolific: Partisipan Manusia Berkualitas Tinggi untuk Riset dan Evaluasi
Prolific adalah salah satu pilihan paling rapi untuk input manusia setara riset. Halaman harganya menekankan akses pay-as-you-go dan tanpa biaya platform bulanan untuk penggunaan self-serve, yang cocok untuk riset UX, studi akademik, dan pekerjaan evaluasi AI yang sangat memprioritaskan kualitas partisipan.
Kalau hasil Anda bergantung pada jawaban manusia yang kredibel, bukan sekadar volume tugas mentah, Prolific biasanya lebih cocok daripada marketplace microtask generik.
Kalau shortlist Anda mencakup pengumpulan data berbasis partisipan, bukan infrastruktur scraping, gambaran Prolific ini menunjukkan seperti apa cabang kategori yang berorientasi riset.
Amazon Mechanical Turk: Distribusi Tugas Manusia yang Fleksibel dan Hemat Biaya
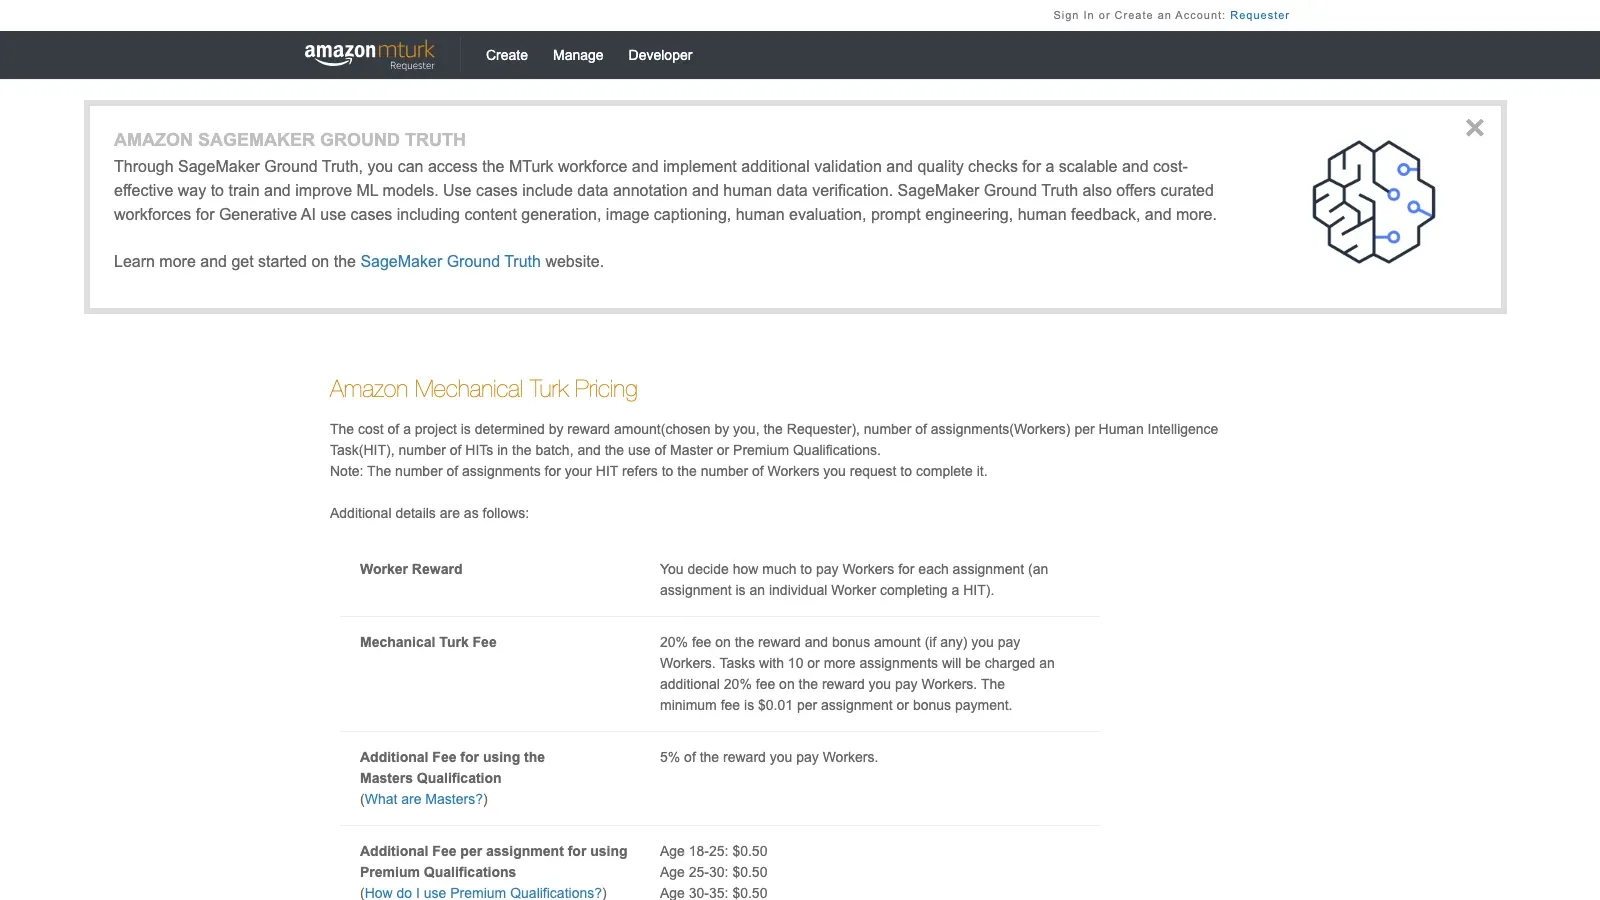
Amazon Mechanical Turk masih menjadi pilihan marketplace yang fleksibel untuk tugas manusia terdistribusi. Platform ini tetap berguna untuk validasi, review, labeling, survei, dan workflow microtask lain ketika Anda ingin jangkauan luas dan kontrol biaya.
Trade-off-nya tidak banyak berubah: MTurk fleksibel dan ekonomis, tetapi tanggung jawab quality control, desain tugas, dan filtering lebih besar ada di requester. Ini sering masih dapat diterima untuk operator berpengalaman, tetapi bukan pilihan terbaik kalau kualitas respons adalah prioritas utama.
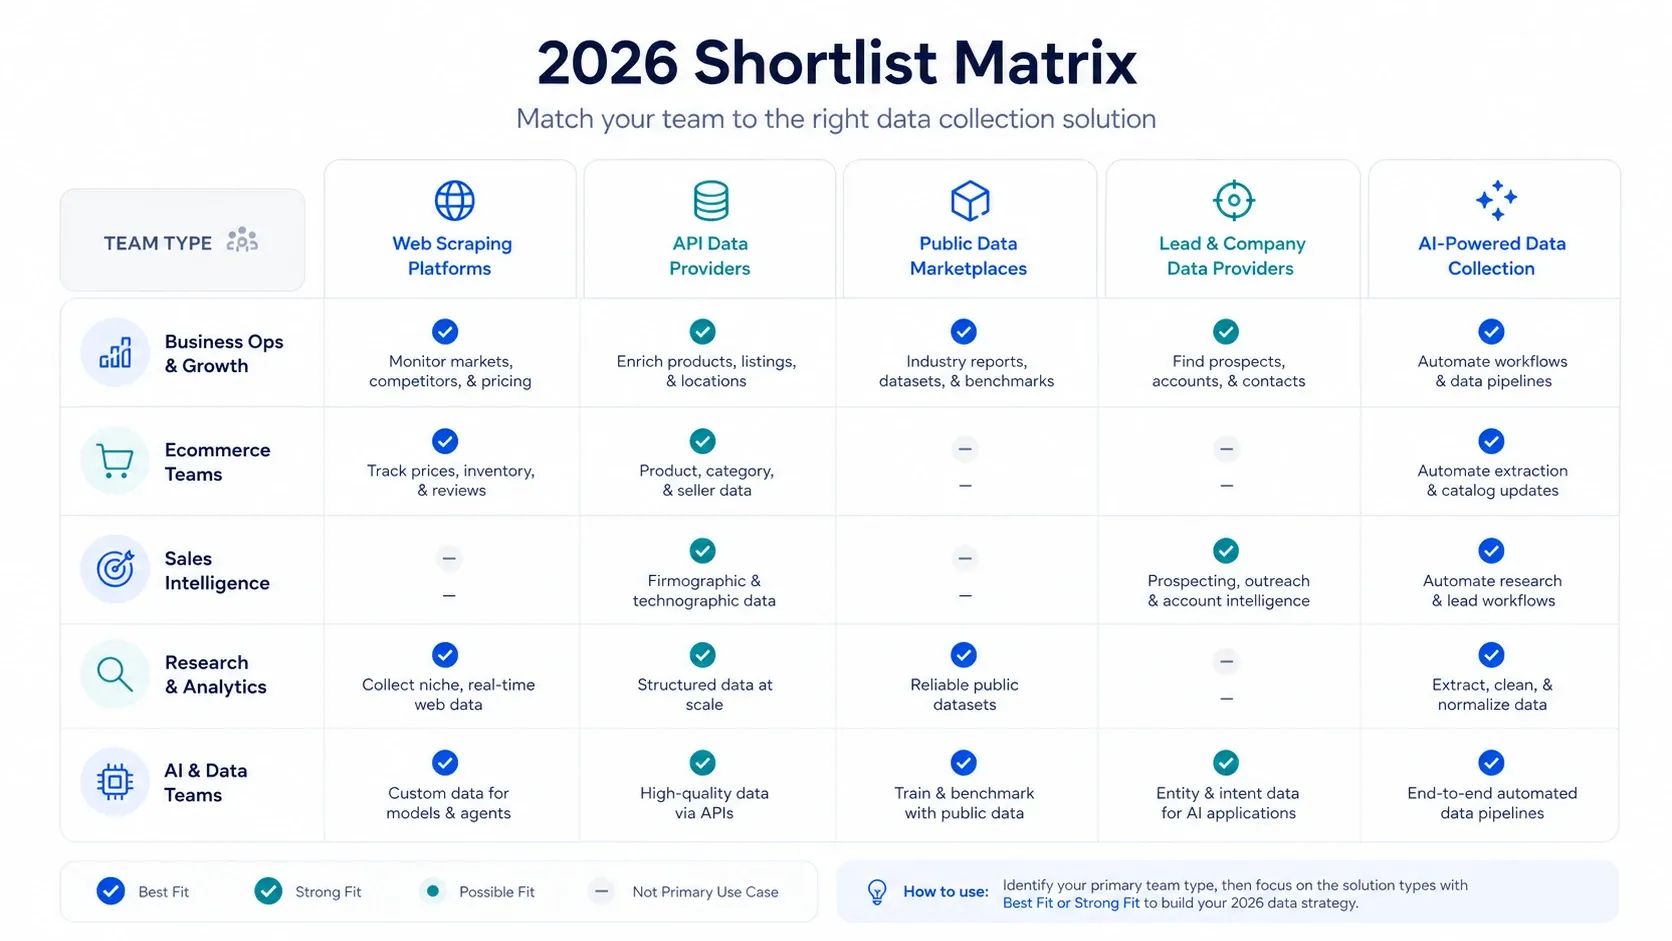
Layanan Pengumpulan Data Mana yang Tepat untuk Bisnis Anda?
Berikut versi singkat shortlist-nya:
- Pengguna non-teknis atau tim bisnis ramping: Mulai dengan Thunderbit kalau Anda ingin jalan tercepat dari halaman web ke spreadsheet.
- Pengumpulan teknis skala enterprise: Bright Data atau Oxylabs cocok untuk pipeline tangguh dan berat di infrastruktur.
- Pembangun workflow no-code: Octoparse masih jadi salah satu opsi paling praktis kalau Anda ingin kontrol visual.
- Scraping kustom terkelola: DataHen atau Infatica masuk akal kalau Anda ingin vendor memikul lebih banyak beban operasional.
- Data perusahaan dan tenaga kerja: Coresignal dan NetNut berguna saat tujuan Anda adalah intelijen bisnis atau enrichment.
- Data pelatihan AI dan anotasi: LXT dan Appen lebih tepat dibanding vendor scraper jika kebutuhan utamanya adalah data yang dibuat manusia.
- Riset dan evaluasi manusia: Prolific lebih bagus untuk kualitas partisipan; MTurk lebih cocok untuk distribusi tugas yang fleksibel dan murah.
- Infrastruktur hemat biaya: Decodo adalah titik tengah yang bagus antara alat scraping sederhana dan stack enterprise yang mahal.
Jawaban yang tepat sering kali berupa kombinasi. Banyak tim memakai satu alat untuk AI scraping ringan, alat lain untuk target yang berat secara teknis, dan platform terpisah untuk evaluasi atau anotasi manusia.
Unduh Ekstensi Chrome Thunderbit
Kesimpulan: Memilih Partner Pengumpulan Data yang Tepat di 2026
Di 2026, pengumpulan data bukan lagi satu kategori dengan satu pola pembelian. Ada pembeli yang butuh ekstraksi berbantuan AI yang bisa dijalankan sendiri. Ada yang butuh infrastruktur proxy dan API yang tangguh. Ada yang butuh pengumpulan data fully managed. Ada juga yang butuh manusia sungguhan untuk riset, anotasi, atau evaluasi.
Itulah sebabnya vendor terbaik tidak ditentukan oleh ranking umum, melainkan oleh kecocokan workflow. Kalau Anda ingin jalur tercepat menuju data web yang berguna tanpa repot setup teknis, Thunderbit adalah titik awal paling mudah di daftar ini. Kalau masalah Anda lebih sulit, lebih besar, atau lebih berat di sisi infrastruktur, vendor enterprise dan provider terkelola jadi jauh lebih relevan.
Bagi kebanyakan tim, langkah cerdasnya adalah mulai dari alat paling kecil yang benar-benar bisa menyelesaikan pekerjaan, lalu naik kelas hanya ketika skala, reliabilitas, atau kompleksitas data memang menuntutnya.
Unduh paket visual yang diperbarui
Coba Pengumpulan Data AI dengan Thunderbit Get Started Free
FAQ
1. Apa itu layanan pengumpulan data dan kenapa bisnis membutuhkannya di 2026?
Layanan pengumpulan data membantu bisnis mengumpulkan informasi terstruktur dari website, platform, dokumen, API, atau partisipan manusia tanpa bergantung pada copy-paste manual. Di 2026, layanan ini penting karena tim butuh data yang lebih segar, workflow yang lebih cepat, dan pipeline yang lebih andal untuk sales, ecommerce, riset, dan AI.
2. Apa perbedaan Thunderbit dengan alat pengumpulan data lain?
Thunderbit dibuat untuk pengguna non-teknis yang ingin berpindah dari halaman web ke data terstruktur dengan cepat. Ekstensi Chrome berbasis AI-nya otomatis menyarankan field, mendukung pagination dan subpage, serta mengekspor data dengan rapi ke spreadsheet dan alat lain tanpa perlu setup yang berorientasi developer.
3. Apa yang perlu saya pertimbangkan saat memilih layanan pengumpulan data?
Lihat hal-hal berikut:
- Kecocokan workflow: Apakah Anda menyelesaikan web scraping, pengumpulan terkelola, enrichment, riset, atau pembuatan data AI?
- Kemudahan penggunaan: Apakah tim Anda saat ini bisa menjalankannya dengan efektif?
- Skala dan reliabilitas: Apakah tetap bekerja saat volume naik atau target makin sulit?
- Model harga: Paket gratis, langganan, berbasis pemakaian, bayar per tugas, atau kontrak kustom?
- Beban operasional: Apakah Anda ingin alat self-serve, lapisan infrastruktur, atau partner fully managed?
4. Alat mana yang paling bagus untuk proyek skala enterprise?
Bright Data dan Oxylabs adalah pilihan kuat untuk pengumpulan data web skala enterprise ketika infrastruktur, ketahanan, dan pengiriman ber-volume besar menjadi prioritas. DataHen, Appen, dan provider terkelola lain menjadi relevan ketika Anda ingin vendor menangani lebih banyak workflow secara langsung.
5. Apakah saya bisa memakai beberapa alat pengumpulan data untuk kebutuhan yang berbeda?
Tentu saja. Banyak tim memadukan beberapa alat: Thunderbit untuk AI scraping ringan, Bright Data atau Oxylabs untuk target teknis yang sulit, Coresignal untuk dataset siap pakai, dan Prolific atau MTurk untuk riset atau labeling berbasis manusia.



