
Setiap minggu saya hampir selalu menerima pesan dengan inti yang sama dari pengguna Thunderbit: “Hei, saya menemukan scraper lain bernama Ultimate Web Scraper — kalau dibandingkan dengan kalian bagaimana?” Pertanyaan yang wajar, dan jujur saja saya senang menjawabnya, karena kebanyakan artikel perbandingan alat di internet itu sampah.
Saya coba mencari perbandingan yang jujur antara Thunderbit dan Ultimate Web Scraper, dan hasilnya... nihil. Tidak ada satu pun artikel teratas untuk pencarian persis ini yang benar-benar menyebut Ultimate Web Scraper secara spesifik — yang ada cuma daftar generik seperti “5 scraper terbaik” atau ulasan satu alat, tapi tidak ada yang benar-benar menaruh dua produk ini berdampingan. Jadi saya telusuri sendiri, mengambil dokumen resmi dan halaman harga terbaru dari keduanya, lalu menyusun head-to-head yang seharusnya sudah ada dari awal. Sedikit pengungkapan sebelum mulai: saya menjalankan Thunderbit, jadi silakan baca dengan secukupnya, tapi saya berusaha mengambil setiap klaim tentang Ultimate Web Scraper dari halaman resminya sendiri, bukan menebak dari namanya.
Putusan Singkat
Kalau Anda ingin jalan paling cepat dari “ini sebuah halaman web” ke “ini spreadsheet yang rapi,” pendekatan agentic dan one-click dari Thunderbit biasanya terasa lebih cepat karena memang jauh lebih sedikit yang perlu dikonfigurasi. Kalau pekerjaan Anda kebanyakan lokal, Anda sensitif terhadap biaya tahunan, dan Anda suka alat yang punya fungsi khusus yang jelas namanya (pencari email, pencari telepon, ekstraktor Google Maps, ekstraktor Shopify), model toolbox milik Ultimate Web Scraper dan ekstraksi lokal tak terbatas pada paket berbayar sulit diabaikan.
Tidak ada yang menang mutlak di semua sisi. Itu jawaban yang jujur, dan terus terang jauh lebih menarik daripada headline palsu semacam “Tool A menghancurkan Tool B”.
Apa Itu Thunderbit dan Ultimate Web Scraper?
Thunderbit Sekilas
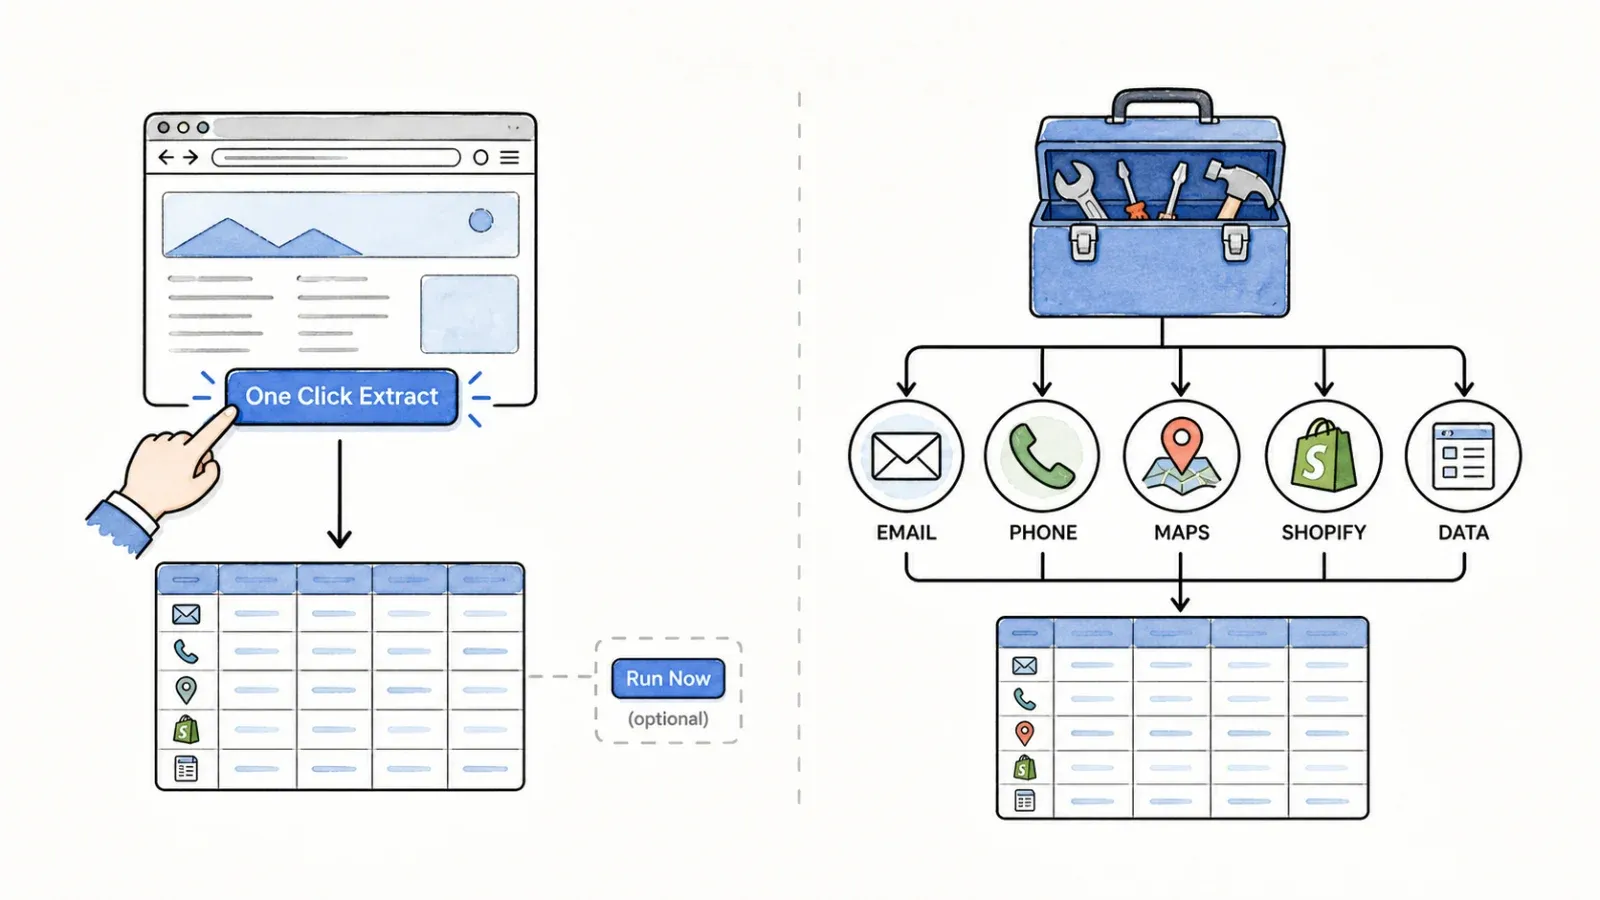
Thunderbit adalah yang saya sebut sebagai web scraper agentic — penekanannya ada pada kata “agentic”. Alur default di Ekstensi Chrome Thunderbit hanya membutuhkan satu klik wajib: One Click Extract. Setelah itu, agen membaca halaman, menebak field mana yang kemungkinan penting (harga, nama, email, atau apa pun yang memang jelas ditampilkan halaman), lalu mengusulkannya. Tombol Run Now memang muncul, tetapi sifatnya opsional karena job akan langsung berjalan otomatis jika Anda tidak mengubah apa pun. Anda tetap bisa mengatur field atau menambahkan instruksi dalam bahasa sehari-hari kalau ingin kontrol lebih, tetapi Anda tidak perlu menyusun skema atau menulis selector apa pun untuk mendapatkan tabel yang bisa dipakai.

Selain ekstensi, Thunderbit juga tersedia sebagai Web App, Open API untuk developer, MCP Server untuk workflow agen AI, dan CLI untuk automasi berbasis terminal. Penjadwalan, enrichment subpage (mengambil daftar lalu membuka tiap link baris untuk menarik detail tambahan), serta ekspor ke Excel, Google Sheets, Airtable, dan Notion melengkapi keseluruhan fiturnya. Tim saya membangunnya khusus agar orang-orang yang berpikir, “Saya cuma butuh data ini ke spreadsheet, saya tidak mau belajar alat baru,” benar-benar bisa mencapainya dalam hitungan menit.
Ultimate Web Scraper Sekilas
Ultimate Web Scraper adalah produk komersial dari Happy Panda Tech FZ-LLC, tersedia di ultimatewebscraper.com. Perlu dicatat dari awal: ini adalah rebrand dari produk yang sebelumnya bernama PandaExtract, dan sama sekali tidak terkait dengan toolkit PHP CubicleSoft yang namanya mirip — saya sebut ini karena saat riset saya sendiri hampir salah masuk ke lubang kelinci yang salah.
Versi saat ini, menurut listing Chrome Web Store, bisa mendeteksi daftar, tabel, dan direktori di halaman secara otomatis lalu menawarkan ekstraksi satu klik dari sana. Namun pembeda utamanya ada pada kumpulan extractor khusus — alat terpisah untuk alamat email, nomor telepon, tautan sosial, gambar, teks halaman, listing Google Maps, dan toko Shopify. Di paket berbayar, ia mendukung ekstraksi lokal tak terbatas (menggunakan sesi browser Anda sendiri yang sudah login dan berizin), plus platform cloud yang lebih baru dengan penjadwalan dan dukungan proxy. Ini produk matang bergaya toolbox, bukan scraper minimalis.
Perbandingan Fitur Head-to-Head
Berikut tabel yang saya harap sudah ada sebelum saya mulai riset ini. Beberapa sel ditandai “menurut dokumen resmi” karena dokumentasi Ultimate Web Scraper sendiri adalah satu-satunya sumber yang kredibel untuk kemampuan mereka — saya tidak menyimpulkan apa pun dari nama produknya.
| Kriteria | Thunderbit | Ultimate Web Scraper |
|---|---|---|
| Pengaturan default | Satu klik (One Click Extract), agen mendeteksi field, Run Now opsional | Satu klik untuk deteksi otomatis daftar/tabel; extractor bernama terpisah untuk tugas spesifik |
| Pagination/infinite scroll | Didukung di halaman yang kompatibel | Otomatis, menurut dokumen resmi |
| Workflow halaman detail/batch | Subpage enrichment (gabung list ke detail) | Page Extractor untuk halaman batch, menurut dokumen resmi |
| Sesi yang sudah login | Didukung pada halaman yang berizin dan kompatibel | Ekstraksi lokal menggunakan sesi login yang berizin |
| Eksekusi cloud | Tersedia lewat Web App/API | Cloud browser, diluncurkan 2026 |
| Penjadwalan | Didukung selama sesuai dengan plan/surface | 11 preset jadwal, menurut dokumen kredits |
| Proxy | Bukan positioning utama | Proxy ISP/residential dengan pilihan negara |
| Ekspor | Excel, Google Sheets, Airtable, Notion, unduhan | CSV, Excel, Google Sheets, JSON berbayar |
| API/MCP | Open API + MCP Server | MCP + integrasi Claude |
| Pengguna ideal | Pengguna bisnis non-teknis, pembangun agen AI | Pengguna yang dominan lokal, kebutuhan ekstraksi khusus |
Saya sengaja tidak memakai deretan centang hijau yang panjang. Gaya seperti itu sering menutupi trade-off yang sebenarnya, padahal justru di situlah letak hal yang penting untuk dibaca.
Perbedaan Inti Workflow: Satu Aksi Agentic vs Toolbox Berisi Extractor
Alur One Click Extract dari Thunderbit
Ini sebenarnya inti perbandingannya, dan menurut saya justru bagian yang paling sering dilewatkan reviewer karena lebih sulit dijelaskan daripada daftar fitur. Di Thunderbit, Anda membuka halaman, klik One Click Extract, lalu agen yang melakukan pembacaan untuk Anda. Ia melihat struktur halaman, pola yang berulang, heading, dan petunjuk konteks untuk menentukan seperti apa seharusnya sebuah “baris” data di halaman itu — apakah itu listing produk, posting properti, atau direktori kontak. Tidak ada dropdown jenis extractor yang harus dipilih terlebih dahulu. Anda tidak perlu memutuskan “ini pekerjaan email” atau “ini pekerjaan Maps” — agen cukup melihat apa yang benar-benar ada di halaman dan bekerja dari sana.
Cara Ultimate Web Scraper Mengorganisasi Pekerjaan
Ultimate mengambil pendekatan yang lebih terstruktur, seperti toolbox. Deteksi otomatis daftar/tabel menangani kasus umum, tetapi jika Anda tahu bahwa yang Anda butuhkan memang email, nomor telepon, profil sosial, gambar, listing Google Maps, atau data produk Shopify, ada extractor khusus yang dibuat untuk pekerjaan itu. Saya tidak ingin menggambarkannya sebagai “friksi karena terlalu banyak selector” — memang tidak sesederhana itu, dan bagi pengguna yang sudah tahu bahwa mereka perlu, misalnya, scrape email massal dari 10.000 situs, alat khusus seperti ini justru bisa lebih efisien daripada menunggu agen serbaguna menebak maksud Anda. Trade-off-nya adalah Anda memilih di antara alat-alat bernama, bukan membiarkan satu sistem memutuskan untuk Anda, sehingga ada sedikit lapisan keputusan: “Saya perlu extractor yang mana?” — sesuatu yang dilewati Thunderbit sepenuhnya.
Daftar, Pagination, dan Enrichment Halaman Detail
Kedua alat bisa menangani kasus umum seperti “scrape daftar, ikuti pagination, ambil lebih banyak baris” — pada titik ini itu sudah menjadi kebutuhan dasar untuk scraper modern. Yang lebih menarik adalah apa yang terjadi setelah daftar itu didapat.
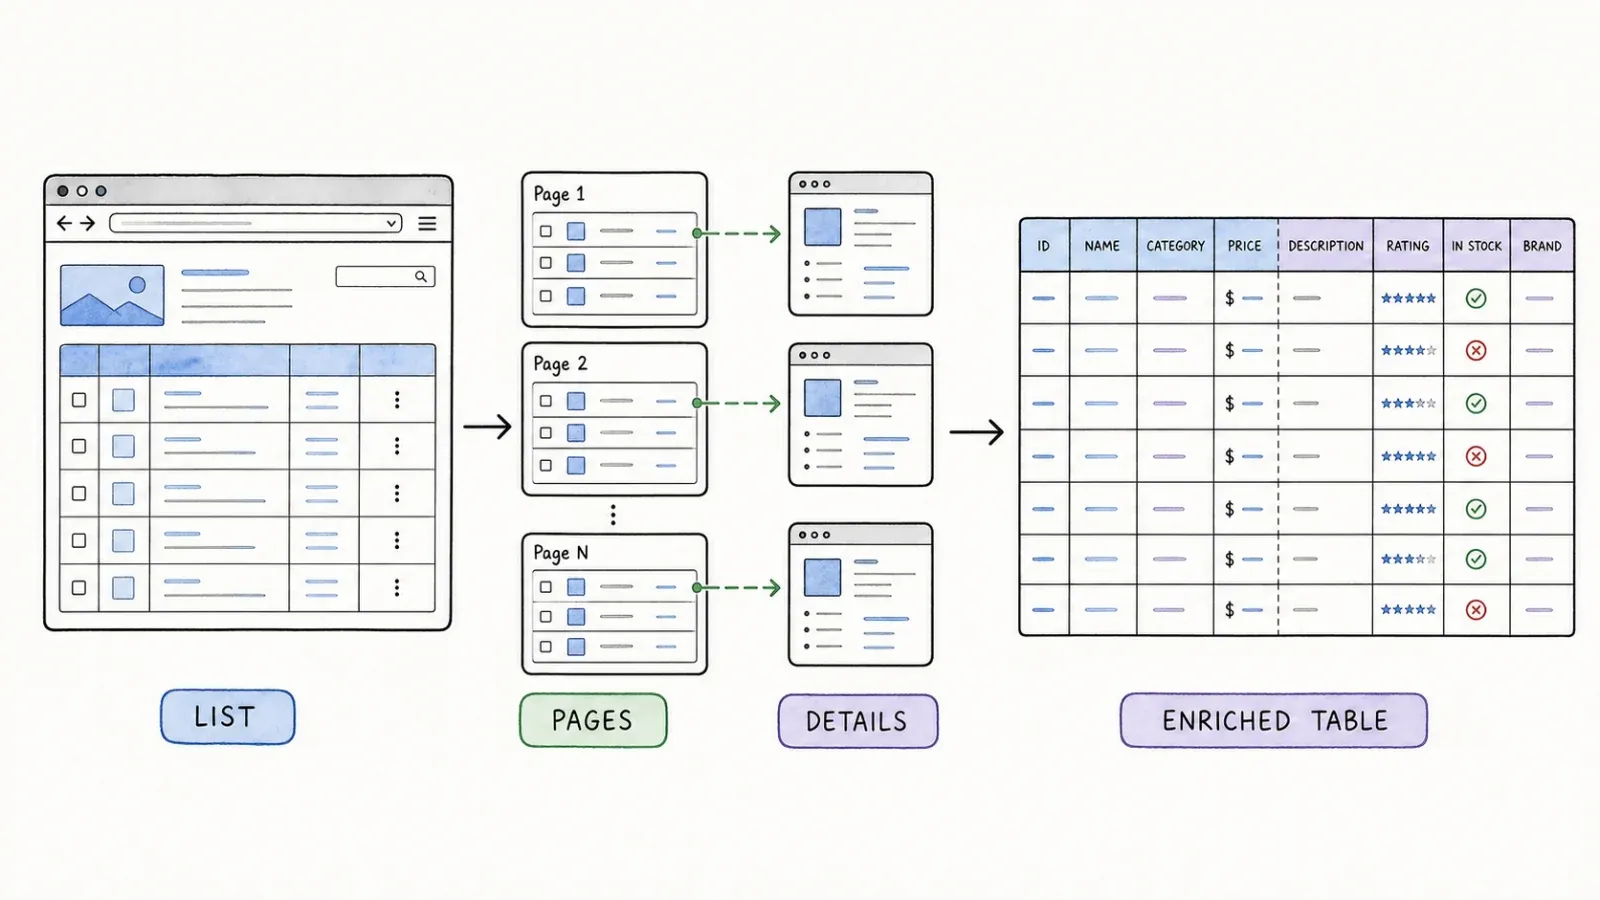
Subpage enrichment milik Thunderbit memungkinkan Anda mengambil daftar item (misalnya nama perusahaan dengan link), lalu otomatis mengunjungi setiap halaman yang ditautkan untuk menarik field tambahan — nomor telepon, alamat, jumlah ulasan — kemudian menggabungkannya kembali ke baris asli. Ini satu alur utuh: daftar plus detail, hasil akhirnya spreadsheet yang rapi.
Page Extractor milik Ultimate Web Scraper juga menangani batch pages, dengan batas yang dipublikasikan dan penting untuk diketahui: menurut dokumentasinya, satu job Page Extractor dibatasi sekitar 2.000 halaman, pemindaian email/sosial dibatasi hingga 10.000 situs per job, dan ekstraksi Google Maps dibatasi sekitar 2.000 listing per run. Itu adalah batas resmi plan, bukan throughput nyata yang diukur di lapangan, dan saya akan memperlakukannya sebagai pagar perencanaan, bukan jaminan. Tidak ada perusahaan yang mengklaim kompatibilitas universal di setiap tata letak situs — halaman dengan rendering sisi klien yang berat atau struktur DOM yang tidak biasa bisa menjatuhkan scraper apa pun, baik agentic maupun berbasis aturan.
Sesi Browser, Run Cloud, Proxy, dan Penjadwalan
Perbedaan lokal versus cloud adalah titik di mana ekonomi dan model berpikirnya mulai cukup jauh.
Mode lokal Ultimate Web Scraper berjalan langsung di sesi browser Anda sendiri yang sudah login dan berizin — artinya kalau Anda sudah masuk ke sebuah situs, ekstensi bisa memakai sesi itu secara langsung, dan pada paket berbayar ekstraksi lokal ini tidak dibatasi. Platform cloud-nya, yang dirilis ke publik pada 2026, menambahkan cloud browser, 11 preset penjadwalan (dari setiap 10 menit sampai sebulan sekali), opsi proxy ISP dan residential dengan target negara, serta beberapa mekanisme pembuka blokir otomatis untuk tantangan tertentu. Itu stack cloud yang benar-benar tangguh untuk produk yang awalnya hanya ekstensi browser.
Thunderbit juga memisahkan eksekusi browser dan cloud — Anda bisa menjalankan ekstraksi langsung di browser pada halaman yang berizin Anda lihat, atau menyerahkannya ke eksekusi cloud untuk job terjadwal dan yang lebih besar selama plan Anda mendukungnya. Saya ingin jujur soal satu hal di sini, karena saya melihat terlalu banyak vendor scraper melebih-lebihkan: tidak ada produk yang menjamin berhasil melawan semua sistem anti-bot atau CAPTCHA. Tantangan Cloudflare, rate limiting agresif, dan login wall ditangani per situs, sebisa mungkin, pada kedua alat ini. Kalau ada yang bilang scraper mereka tidak pernah diblokir, kemungkinan mereka berbohong atau belum cukup banyak scraping situs.
Output dan Surface Otomasi
Mengeluarkan data ke luar sebenarnya membuat kedua alat ini terlihat cukup mirip di atas kertas, meski abstraksi dasarnya berbeda.
Thunderbit mengekspor langsung ke Excel, Google Sheets, Airtable, dan Notion, plus unduhan standar, dan untuk developer ada Open API serta MCP Server untuk menghubungkan ekstraksi ke workflow agen AI di alat seperti Claude atau Cursor. Ultimate Web Scraper menawarkan ekspor CSV, Excel, dan Google Sheets, dengan JSON hanya tersedia di paket berbayar, plus pengiriman lewat webhook dan integrasi MCP sendiri yang memungkinkan agen AI memulai scrape, memeriksa sitemap, dan meng-query tabel yang sudah dibersihkan. Kedua perusahaan jelas melihat arah pasar — agen AI akan menjalankan banyak job scraping ke depan, bukan cuma manusia yang klik tombol — dan keduanya sudah membangun ke sana. Bedanya, surface MCP Ultimate mengekspos keluarga extractor bernama sebagai alat yang bisa dipanggil terpisah, sementara surface MCP Thunderbit mengekspos satu primitive ekstraksi fleksibel yang bisa diarahkan agen ke hampir semua halaman.
Harga: Ekonomi Lokal vs Ekonomi Cloud
Di sini saya akan menyarankan siapa pun yang memilih di antara keduanya untuk memperlambat langkah dan benar-benar menghitung sesuai volume sendiri, karena harga stiker saja bisa menyesatkan.
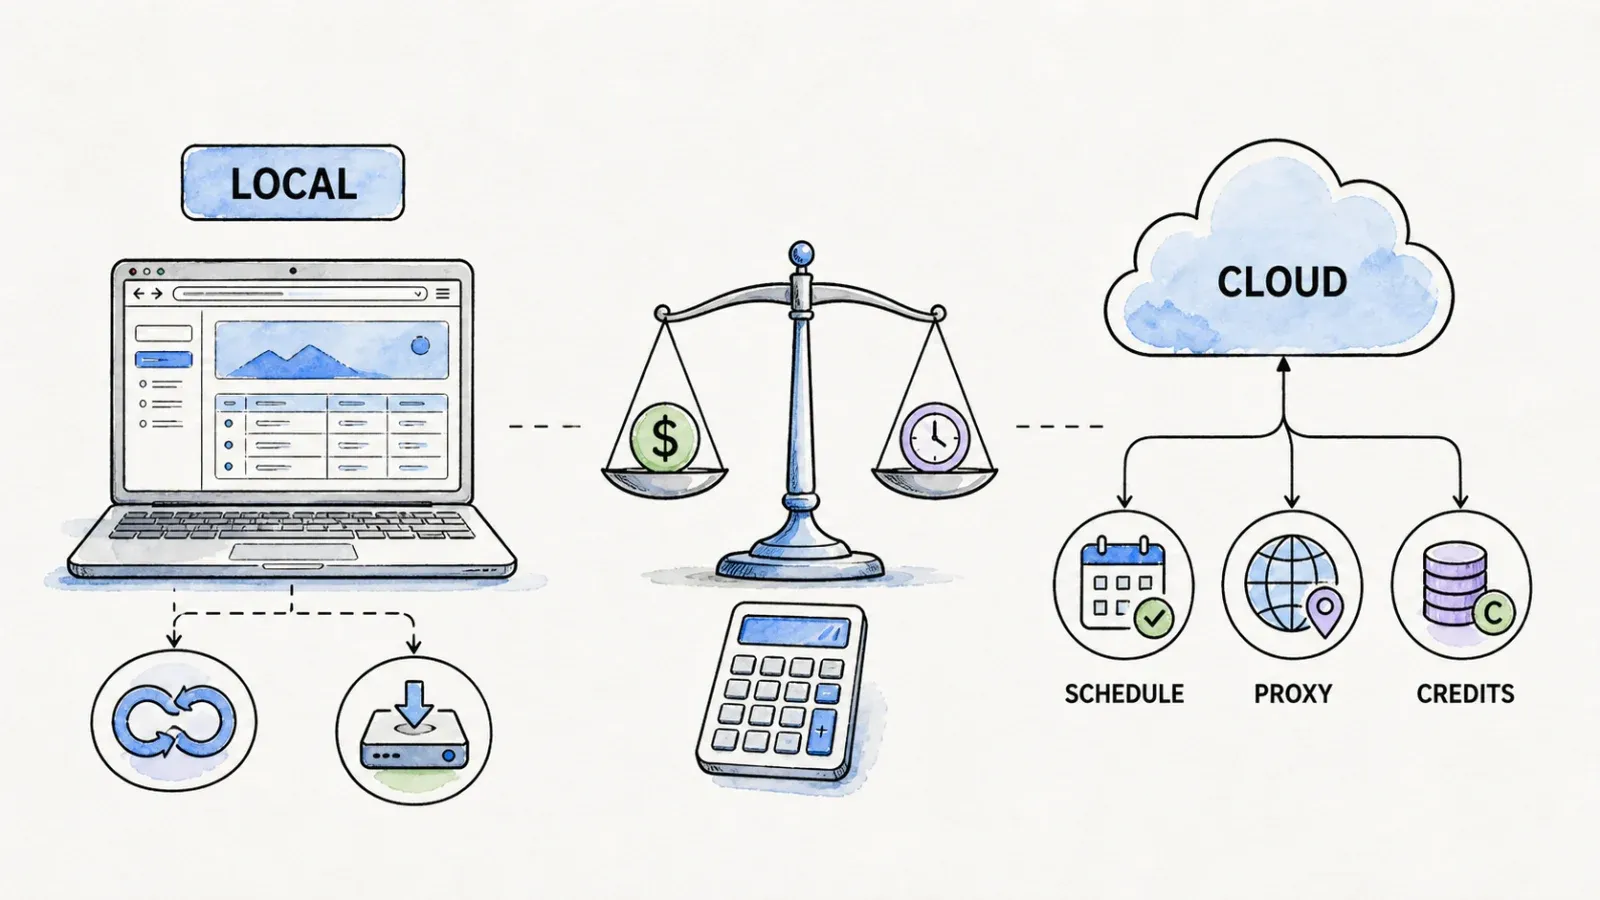
Per riset saya pada 2026-08-13, harga Ultimate Web Scraper hanya memakai penagihan tahunan: Pro $60/tahun dengan 10.000 cloud credits per tahun, Pro+ $99/tahun dengan 100.000 credits, dan Team $249/tahun dengan 200.000 credits untuk enam seat. Credits tidak dibawa ke bulan berikutnya (semuanya pool tahunan), dan — ini bagian penting — semua paket berbayar membuka ekstraksi lokal tak terbatas. Jadi kalau beban kerja Anda kebanyakan “scrape sesuatu di mesin saya sendiri, di sesi browser saya sendiri,” $60/tahun untuk job lokal tak terbatas memang sangat murah. Cloud credits baru benar-benar relevan saat Anda menjadwalkan job berulang atau butuh cloud browser berjalan tanpa laptop Anda menyala.
Thunderbit memakai model berbasis credit dengan paket gratis dan paket berbayar bulanan/tahunan — cek angka terbarunya langsung di halaman harga Thunderbit daripada mempercayai angka yang saya sebut di sini, karena halaman harga bisa berubah dan saya lebih suka mengarahkan Anda ke sumber aslinya ketimbang memberi angka lama.
Nuansa yang penting adalah ini: satu “credit” di platform cloud Ultimate setara dengan satu halaman, sementara unit credit Thunderbit bekerja berbeda tergantung surface dan jenis job. Ini bukan perbandingan apel dengan apel, jadi tahan keinginan untuk sekadar membagi dolar dengan credit lalu selesai. Kalau Anda sedang memodelkan biaya untuk 1.000 atau 10.000 halaman per bulan, cara paling jujur adalah mengecek kedua halaman harga yang masih live, memasukkan estimasi campuran job lokal versus cloud/terjadwal yang Anda benar-benar butuhkan, lalu menghitung dari sana — saya lebih suka menyuruh Anda menghitung dengan angka real-time daripada memberi tabel angka yang sudah usang saat Anda membacanya.
Adopsi, Aktivitas, dan Batas Bukti
Angka memang menggoda untuk dijadikan pegangan, jadi saya ingin jelas soal apa yang sebenarnya bisa mereka buktikan.
Menurut snapshot Chrome Web Store yang saya ambil pada 2026-08-13, Ultimate Web Scraper menunjukkan 100.000 pengguna, rating 4,6 dari 5 dari 234 ulasan, status featured, versi 3.2, dan update bertanggal 2026-08-11. Snapshot Thunderbit menunjukkan 200.000 pengguna, rating 4,2 dari 5 dari 193 ulasan, dan update bertanggal 2026-07-28.
Saya akan blak-blakan: angka-angka ini memberi tahu Anda jumlah instalasi dan seberapa baru update yang mereka rilis. Angka itu tidak memberi tahu alat mana yang mengekstrak data lebih akurat, mana yang lebih cocok untuk situs spesifik Anda, atau mana yang lebih tahan terhadap CAPTCHA. Saya mencari benchmark independen dan terkontrol yang membandingkan keduanya secara head-to-head dari sisi kecepatan, akurasi, atau keberhasilan melewati blokir — sejauh yang saya temukan, belum ada. Siapa pun yang mengklaim sebaliknya kemungkinan sedang mengutip angka marketing mereka sendiri.
Mana yang Sebaiknya Anda Pilih?
Daripada jawaban samar seperti “tergantung,” berikut pembagian skenario yang nyata berdasarkan cara orang biasanya memakai masing-masing alat.
| Situasi Anda | Pilihan yang lebih cocok |
|---|---|
| Marketer atau founder non-teknis yang ingin spreadsheet cepat tanpa setup | Thunderbit |
| Sebagian besar scraping lokal, anggaran tahunan ketat | Ultimate Web Scraper |
| Butuh gabungan list + detail halaman subpage dalam satu tabel rapi | Thunderbit |
| Butuh ekstraksi khusus email/telepon/sosial/Maps/Shopify | Ultimate Web Scraper |
| Membangun agen AI yang butuh primitive scraping fleksibel via MCP | Thunderbit |
| Ingin agen AI yang memanggil extractor bernama (Maps, Shopify, dll.) | Ultimate Web Scraper |
| Butuh job cloud terjadwal dengan proxy/target negara langsung siap pakai | Ultimate Web Scraper |
| Ingin akses terprogram lewat Open API umum untuk workflow backend | Thunderbit |
Rekomendasi jujur saya, dan ini saya katakan meskipun saya bekerja di Thunderbit: instal keduanya di halaman berizin Anda sendiri dan jalankan pada situs nyata yang memang Anda pedulikan. Tes lima menit pada data asli Anda akan memberi tahu lebih banyak daripada artikel perbandingan mana pun, termasuk yang ini.
Penggunaan yang Bertanggung Jawab dan Keterbatasan
Tidak ada satu pun alat yang menjadi kunci ajaib untuk semua situs di internet, dan saya akan merugikan Anda kalau menyiratkan sebaliknya. Keduanya mengharuskan Anda mengekstrak dari halaman yang memang Anda berwenang akses — menghormati login wall, syarat layanan situs, dan hukum privasi data yang berlaku adalah tanggung jawab Anda, bukan software-nya. Scraping pada halaman login hanya bekerja mulus di situs yang sesi dan ekstensi Anda berperilaku konsisten bersama, dan situs yang sangat terlindungi atau strukturnya tidak biasa bisa memperlambat atau memblokir kedua alat. Ini bukan nasihat hukum, hanya pengingat bahwa “secara teknis bisa di-scrape” dan “seharusnya dilakukan” adalah dua pertanyaan berbeda yang layak diajukan setiap kali.
Kesimpulan Akhir
Saat membandingkan keduanya berdampingan, yang paling menarik bagi saya adalah bahwa mereka menyelesaikan masalah yang mirip dari ujung yang berlawanan. Thunderbit bertaruh pada pengurangan keputusan — satu klik, agen yang mencari tahu, subpage enrichment yang menyatukan detailnya. Ultimate Web Scraper bertaruh pada pemberian alat yang lebih eksplisit dan harga tahunan yang sangat rendah untuk pekerjaan lokal. Tergantung siapa yang bertanya, kedua taruhan itu sama-sama berhasil. Kalau Anda terutama ingin tahu mana yang menghemat klik paling banyak per job, alur agentic Thunderbit akan menang di perlombaan itu. Kalau Anda terutama ingin tahu mana yang menghemat uang paling banyak untuk beban kerja lokal yang berat, model harga Ultimate memang benar-benar kompetitif. Saya juga menyarankan Anda melihat pembahasan kami sendiri tentang AI web scraping dan AI web scraper terbaik jika Anda ingin konteks lebih luas tentang ke mana arah kategori ini sebelum memutuskan salah satu alat.
FAQ
Apakah Ultimate Web Scraper sama dengan toolkit PHP CubicleSoft?
Tidak. Ultimate Web Scraper adalah ekstensi Chrome komersial dan platform cloud dari Happy Panda Tech FZ-LLC, yang sebelumnya menggunakan brand PandaExtract. Produk ini tidak memiliki kode atau kepemilikan apa pun dengan proyek open-source CubicleSoft PHP yang namanya mirip, jadi jangan sampai tertukar saat mencari dokumentasi.
Mana yang lebih mudah untuk pengguna non-teknis?
Thunderbit dibangun khusus untuk menghilangkan langkah setup — klik One Click Extract dan agen otomatis mengusulkan field tanpa perlu selector. Ultimate Web Scraper juga no-code untuk deteksi otomatis daftar/tabel, tetapi memilih di antara beberapa extractor khususnya (email, telepon, Maps, Shopify, dll.) menambah sedikit lapisan keputusan yang harus dipelajari pengguna baru.
Apakah Ultimate Web Scraper membutuhkan CSS selector?
Tidak untuk deteksi otomatis daftar/tabel atau extractor bernamanya — semua itu dirancang untuk satu klik, menurut dokumentasi resminya. Filosofinya berbeda dari alat yang sepenuhnya berbasis selector, meski memang lebih bergaya toolbox dibanding aksi agentic tunggal seperti Thunderbit.
Apakah kedua alat bisa bekerja pada halaman yang sudah login?
Keduanya mendukung ekstraksi dari sesi browser yang sudah login dan berizin pada halaman yang kompatibel. Keduanya tidak menjamin berhasil di setiap situs yang dibatasi login, terutama yang punya proteksi anti-bot agresif, jadi ujilah pada target spesifik Anda sebelum bergantung pada salah satunya untuk pekerjaan produksi.
Produk mana yang lebih murah untuk scraping lokal versus cloud?
Untuk beban kerja lokal yang berat dan murni lokal, paket Pro Ultimate Web Scraper seharga $60/tahun dengan ekstraksi lokal tak terbatas sulit dikalahkan dari sisi harga. Untuk workflow cloud, terjadwal, atau terprogram, perbandingan yang lebih adil adalah memeriksa harga live terbaru di halaman harga Thunderbit dan halaman harga Ultimate, karena unit credit di keduanya tidak bisa langsung disamakan.
Apakah rating Chrome Store membuktikan scraper mana yang lebih akurat?
Tidak. Rating toko dan jumlah instalasi, seperti 4,6/5 dari 234 rating milik Ultimate atau 4,2/5 dari 193 rating milik Thunderbit, mencerminkan sentimen pengguna dan adopsi, bukan akurasi ekstraksi yang terukur. Saat ini belum ada benchmark independen dan terkontrol yang membandingkan keduanya secara head-to-head, jadi satu-satunya tes yang benar-benar bisa diandalkan adalah menjalankan keduanya pada halaman nyata Anda sendiri.



