
Saya lebih sering ditanya, "Thunderbit atau ParseHub?" daripada yang saya bayangkan saat kami mulai membangun Thunderbit. Wajar juga sih — ParseHub sudah ada bertahun-tahun dan punya basis pengguna yang loyal, terutama di kalangan analis yang memang suka melihat dengan jelas bagaimana scraper mereka bekerja. Jadi alih-alih bikin listicle abu-abu lagi seperti "7 scraper terbaik", saya benar-benar duduk dan memetakan bagaimana dua alat ini menangani pekerjaan yang sama, berdampingan, dalam satu tempat.
Menariknya, sebelum menulis ini saya sempat cari perbandingan head-to-head yang benar-benar serius antara keduanya, dan ternyata saya tidak menemukannya. Semua artikel yang saya baca entah cuma menaruh keduanya sebagai satu poin kecil di daftar panjang, atau berupa ulasan ParseHub yang di tengah jalan diam-diam berubah jadi promosi alat lain. Jadi inilah versi saya yang lebih jujur: tanpa belok arah, tanpa sales pitch yang menyamar sebagai objektivitas — hanya penjelasan apa adanya tentang di mana masing-masing unggul dan di mana tidak.
Jawaban Singkat: Ekstraksi Agentik Sekali Klik vs Kontrol Workflow Visual
Kalau kamu ingin versi singkat sebelum memutuskan membaca lebih dari 2.000 kata soal web scraper (saya hormat semangatnya), ini intinya: Thunderbit dibuat untuk pengguna bisnis yang ingin jalan tercepat dari "ini sebuah halaman web" ke "ini spreadsheet saya". Kamu buka halaman, klik satu tombol, lalu agen akan mengurus sisanya. ParseHub dibuat untuk orang yang ingin melihat dan mengendalikan setiap langkah — selector, logika navigasi, kondisi, seluruh graph workflow — dan tidak keberatan menghabiskan waktu lebih banyak di awal demi hasil ekstraksi yang persis seperti yang mereka rancang.
Keduanya bukan versi "pemula" dari yang lain. ParseHub tidak primitif hanya karena hadir sebelum gelombang AI, dan Thunderbit bukan sekadar salinan ParseHub yang dipangkas lalu dipasangi chatbot. Keduanya dibangun dengan model operasional yang benar-benar berbeda, dan mana yang cocok untuk kamu lebih bergantung pada seberapa besar kontrol yang kamu inginkan atas prosesnya dibanding seberapa cepat kamu ingin hasilnya.
Sekilas
Berikut tabel perbandingan yang saya harap sudah ada waktu saya mencarinya:
| Dimensi | Thunderbit | ParseHub |
|---|---|---|
| Jenis platform | Ekstensi browser (Chrome/Edge), Web App, Open API | Aplikasi desktop yang bisa diunduh + project cloud |
| Metode setup | Agentic One Click Extract — halaman dianalisis otomatis, field diusulkan otomatis | Teaching selector dengan klik langsung, relative selects, perintah navigasi |
| Kurva belajar | Rendah — cukup satu klik untuk mulai, penyempurnaan opsional | Sedang hingga cukup curam — perlu desain project, testing, dan debugging |
| Halaman dinamis / AJAX | Didukung pada halaman yang kompatibel dan terotorisasi | Kekuatan utama yang didokumentasikan melalui logika interaksi eksplisit |
| Pagination & enrichment subpage | Didukung pada halaman yang kompatibel | Didukung lewat perintah navigasi dan loop |
| Konten di balik login | Berjalan dalam sesi login yang sudah terotorisasi, jika didukung | Didukung lewat penanganan halaman login dalam desain project |
| Otomatisasi | Eksekusi cloud/browser, penjadwalan pada kondisi yang didukung | Eksekusi cloud, scheduling, rotasi IP pada paket yang memenuhi syarat |
| Akses developer | Open API, MCP Server, CLI | REST API, webhook |
| Tujuan ekspor | Excel, Google Sheets, Airtable, Notion, dan unduhan file | CSV/Excel/JSON, Google Sheets, Dropbox, S3 tergantung paket |
| Privasi free tier | Periksa syarat terbaru di halaman harga Thunderbit | Project gratis bersifat publik menurut halaman harga resmi ParseHub |
| Model harga | Periksa paket terbaru di Thunderbit Pricing | Gratis, Standard $189/bulan, Professional $599/bulan, Plus kustom |
Saya sengaja tidak memasukkan kecepatan dan "akurasi" ke tabel itu. Saya belum melihat benchmark independen yang terkontrol untuk membandingkan keduanya, dan angka-angka yang diklaim vendor di kedua sisi juga bukan sesuatu yang akan saya jadikan dasar rekomendasi. Kalau ada yang bilang scraper mereka "3x lebih cepat", tanya dulu dalam kondisi seperti apa, di situs apa, dengan koneksi internet bagaimana. Biasanya jawabannya cuma, "percaya saja."
Apa Itu Thunderbit?
Thunderbit adalah agentic web scraper yang tim saya bangun khusus untuk orang yang tidak mau pusing memikirkan CSS selector, XPath, atau "desain workflow" sama sekali — mereka hanya ingin datanya. Ide utamanya, dan jujur salah satu hal yang paling saya banggakan, adalah Thunderbit Chrome Extension hanya butuh satu klik yang disengaja di halaman yang didukung dan terotorisasi: One Click Extract.

Begitu kamu mengkliknya, agen akan membaca dan menganalisis halaman, mencari data terstruktur yang layak diambil (daftar produk, lowongan kerja, entri direktori, apa pun itu), lalu menyiapkan field secara otomatis. Setelah itu ia menampilkan Run Now — tapi ini opsional, karena proses ekstraksi memang langsung dimulai. Kamu tinggal duduk santai dan membiarkannya berjalan, atau memberi instruksi dengan bahasa alami kalau ingin format field diubah, diterjemahkan, atau dikategorikan. Intinya memang itu: kami mencoba menghilangkan langkah "sekarang buat template dulu" sepenuhnya.
Di luar ekstensi, ada Thunderbit Web App untuk eksekusi berbasis cloud, dan bagi developer atau tim yang ingin mengintegrasikannya ke sistem yang lebih besar, ada Thunderbit Open API, Thunderbit MCP Server untuk workflow AI agent, serta Thunderbit CLI and Skills untuk penggunaan via terminal dan coding agent. Thunderbit juga menangani enrichment subpage (mengambil daftar halaman, lalu mengikuti tiap link untuk mengambil detail tambahan) dan pagination di situs yang kompatibel, lalu mengekspor hasil ke Excel, Google Sheets, Airtable, atau Notion.
Apa Itu ParseHub?
ParseHub mengambil filosofi desain yang berlawanan: beri pengguna antarmuka visual yang nyaris seperti browser, lalu ajarkan scraper apa yang harus dilakukan, klik demi klik. Ini aplikasi desktop yang bisa diunduh, dan setelah masuk ke sebuah project, kamu pada dasarnya sedang membangun program kecil menggunakan perintah point-and-click, bukan kode.

Menurut halaman fitur resmi ParseHub, alat ini mendukung relative selects, navigasi antar halaman, pengiriman form, tab, pop-up, menu dropdown, conditional dan expression, plus XPath, RegEx, dan CSS selector untuk pengguna yang butuh presisi lebih tinggi. Memang dirancang untuk situs AJAX dan JavaScript yang berat, halaman di balik login, infinite scroll, dan crawling multi-URL. Kamu bisa menjalankan project secara lokal atau mengirimnya ke cloud ParseHub, menjadwalkan run berkala, dan menarik data lewat REST API atau webhook.
Saya ingin adil di sini: ParseHub bukan relic usang. Ini alat yang matang dengan kedalaman fitur nyata, dan kalau pekerjaanmu mengharuskan klik lewat form bertahap, menangani lima keadaan dropdown berbeda, atau menavigasi labirin logika kondisional, ParseHub memberi kamu struktur visual untuk membangun semuanya langkah demi langkah dan benar-benar melihatnya bekerja. Kontrol eksplisit seperti itu punya nilai nyata — hanya saja nilainya berbeda dari "klik sekali lalu ditinggal."
Perbedaan Inti: Mendelegasikan Pekerjaan vs Merancang Workflow
Cara terbaik yang bisa saya gambarkan adalah: dengan Thunderbit, kamu mendelegasikan pekerjaan ekstraksi ke agen. Dengan ParseHub, kamu sendiri yang merancang workflow-nya, satu perintah demi satu perintah. Keduanya sama-sama memberi kamu data. Hanya saja, keduanya meminta hal yang sangat berbeda dari waktu dan perhatianmu.
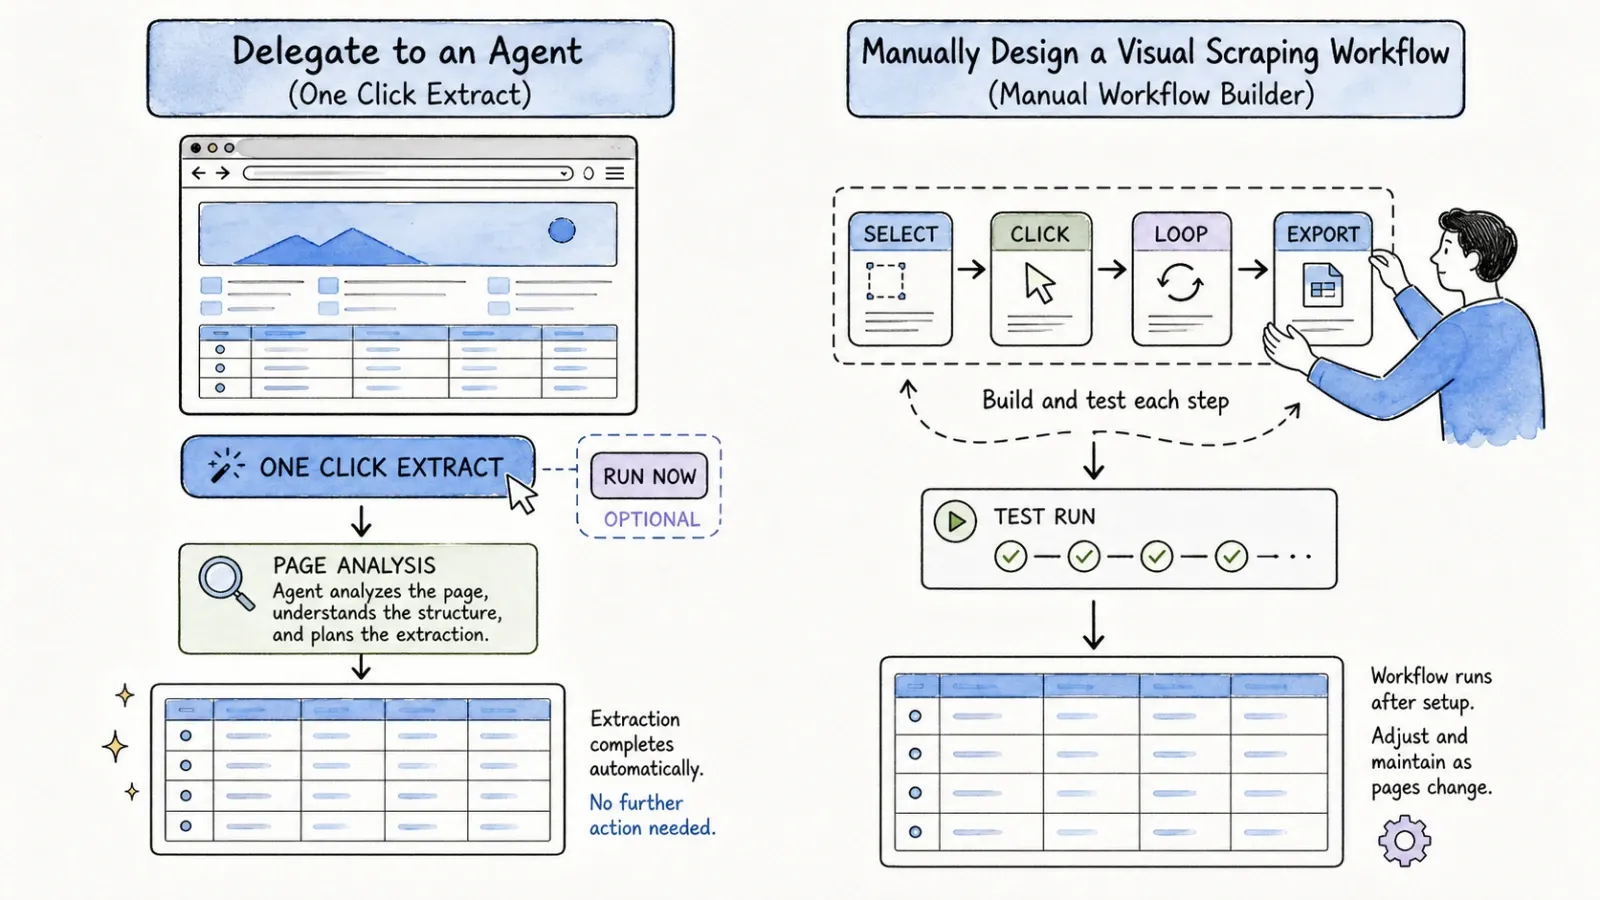
Workflow agentik sekali klik milik Thunderbit
Kamu membuka sebuah halaman — misalnya direktori restoran lokal atau daftar lowongan kerja. Lalu klik One Click Extract. Agen membaca struktur halaman, menentukan apa yang layak diambil, mengusulkan kolom, lalu mulai berjalan. Kalau kamu ingin menambah field, mengubah format, atau memberi instruksi agar hanya mengambil listing yang diposting minggu ini, kamu tinggal menuliskannya dalam bahasa biasa. Tidak perlu membangun selector, tidak perlu tahap "ajari saya dengan klik-klik" untuk memulai.
Workflow project visual milik ParseHub
Direktori restoran yang sama di ParseHub terlihat berbeda. Kamu membuka aplikasi, membuat project baru, mengarahkannya ke URL, lalu mulai mengklik elemen yang ingin diambil — nama, alamat, rating. Kamu menambahkan "relative select" untuk mengambil field yang berhubungan di dekat tiap item, mungkin perintah "click" kalau pagination membutuhkan klik tombol "Next" alih-alih sekadar scroll. Kamu menguji run pada sampel kecil, memeriksa output, memperbaiki elemen yang salah terbaca, lalu memperluasnya atau menjadwalkannya.
Kenapa arsitektur mengubah kurva belajar
Tidak ada yang secara objektif "lebih sulit" secara umum — semuanya tergantung apa yang ingin kamu optimalkan. Thunderbit menukar sebagian kontrolmu demi kecepatan: agen menginfer struktur, dan dalam banyak kasus itulah yang kamu inginkan untuk halaman list/detail standar. ParseHub menukar kecepatan demi presisi: kamu bisa melihat dan menyesuaikan setiap langkah, dan ini sangat penting ketika struktur situs tidak biasa atau logikanya memang kompleks. Saya sudah cukup lama membangun alat otomasi untuk tahu bahwa tidak ada makan siang gratis — kamu selalu menukar waktu setup dengan kontrol di suatu titik dalam pipeline.
Perbandingan Workflow Langsung
Halaman daftar sederhana
Untuk sesuatu seperti katalog produk sederhana atau daftar direktori, alur satu klik Thunderbit hampir yang tercepat — klik, biarkan berjalan, ekspor. ParseHub tentu bisa melakukan ini juga, tetapi kamu harus mengajarkan selector terlebih dulu, dan itu butuh waktu lebih lama untuk halaman sesederhana ini. Inilah skenario ketika argumen "jalur paling singkat" untuk Thunderbit paling kuat.
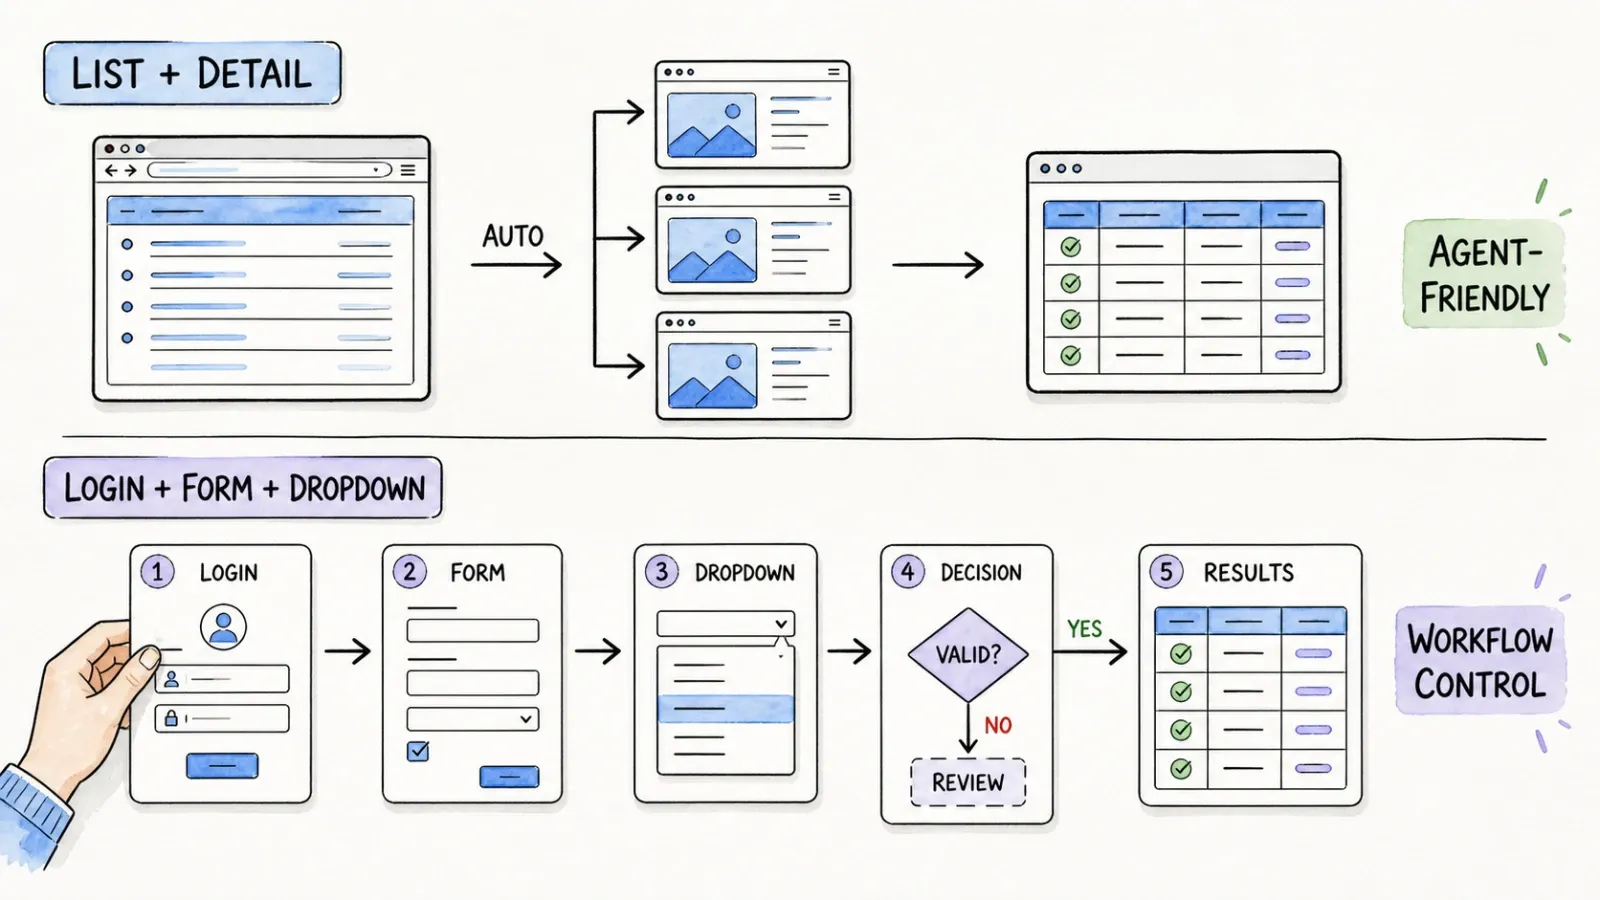
Halaman daftar plus enrichment halaman detail
Di sinilah semuanya jadi lebih menarik. Misalnya kamu punya daftar perusahaan dan ingin mengunjungi halaman tiap perusahaan untuk mengambil field tambahan — jumlah karyawan, kantor pusat, tahun berdiri. Thunderbit menangani ini lewat subpage enrichment pada halaman yang kompatibel: ia mengikuti link secara otomatis dan menggabungkan field tambahan kembali ke baris data kamu. ParseHub juga bisa melakukannya, dengan relative selects dan perintah navigasi, tetapi kamu sendiri yang merangkai logikanya. Keduanya bisa; yang satu meminta kamu menggambar peta, yang satu menggambarkannya untuk kamu.
Workflow yang di balik login atau penuh interaksi
Ini trade-off yang jujur. ParseHub memang punya kekuatan yang terdokumentasi dengan baik untuk menangani login, form, dropdown, dan interaksi bertahap karena desainnya memang dibangun di atas urutan perintah yang eksplisit — kamu memberi tahu persis tombol mana yang diklik dan kapan. Thunderbit bisa bekerja di dalam sesi browser yang sudah login dan terotorisasi jika didukung, tetapi ia tidak dirancang sebagai automaton pengisi form serbaguna seperti sistem perintah ParseHub. Kalau pekerjaanmu berat di logika interaksi multi-step (bayangkan: login, pilih filter, submit form, lalu ekstrak), model eksplisit ParseHub punya keunggulan.
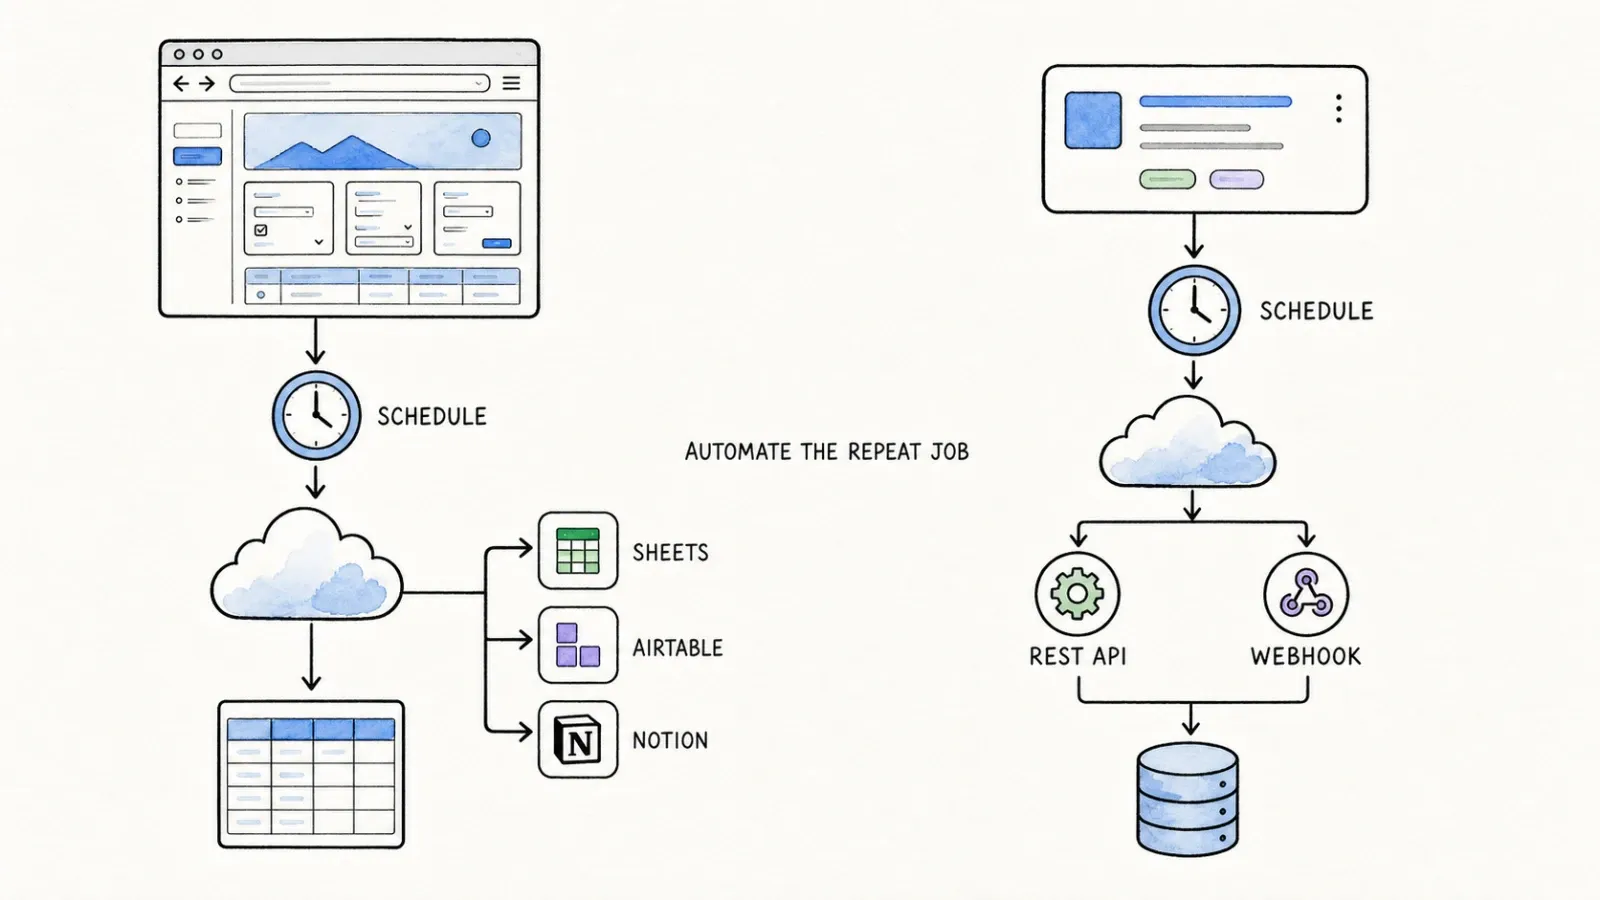
Pengumpulan terjadwal yang berulang
Kedua alat mendukung run terjadwal, meski kelayakannya tergantung paketmu. Scheduling ParseHub terhubung ke sistem cloud project-nya dengan rotasi IP pada tier yang memenuhi syarat. Thunderbit mendukung ekstraksi terjadwal di mana paket dan surface produk saat ini mendukungnya, dan untuk tim yang ingin memasukkannya ke pipeline yang lebih besar, Open API atau MCP Server memungkinkan AI agent atau sistem backend memicu ekstraksi sendiri sesuai jadwal, bukan sekadar bergantung pada scheduler berbasis UI.
Situs Dinamis, Pagination, dan Navigasi Kompleks
Saya ingin hati-hati di bagian ini karena ini memang jenis klaim yang sering dilebih-lebihkan di marketing scraper di mana-mana — "bisa menangani semua website!" Tidak. Tidak ada yang bisa.
Kekuatan terdokumentasi ParseHub ada pada logika interaksi yang granular: conditional, expression, XPath/RegEx/CSS selector, dan perintah navigasi eksplisit membuat pengguna yang mahir sering bisa membangun jalan keluar untuk situs AJAX yang benar-benar aneh, asalkan punya cukup waktu. Itu kekuatan nyata yang memang pantas didapat, hasil perkembangan fitur selama bertahun-tahun, menurut halaman fitur ParseHub.
Kekuatan Thunderbit ada pada struktur yang diinfer oleh agen pada halaman yang kompatibel — ia bagus untuk melihat halaman list-detail yang "normal" dan memahami polanya tanpa kamu menjelaskannya, serta menangani pagination umum dan enrichment subpage pada halaman yang memang dibuat untuk itu. Tetapi sistem anti-bot, alur autentikasi yang tidak biasa, dan situs dinamis yang sangat obfuscated tetap menjadi batas nyata untuk alat scraping apa pun, baik yang agentic maupun manual. Saran jujur saya: kalau sebuah situs cukup penting untuk dijadikan workflow berulang, uji dulu di alat mana pun yang sedang kamu pertimbangkan sebelum kamu menginvestasikan berjam-jam di sana.
Otomatisasi dan Akses Developer
Cerita otomasi ParseHub berjalan lewat eksekusi cloud project, scheduling, dan REST API dengan webhook — infrastruktur yang solid dan terdokumentasi baik untuk orang yang ingin memicu run secara programatis atau menyalurkan hasilnya ke sistem lain.
Cerita Thunderbit dibangun untuk bertemu developer dan workflow AI agent di tempat mereka memang sudah bekerja. Open API memberi aplikasi akses HTTP/JSON ke tugas ekstraksi. MCP Server adalah yang paling saya sukai secara pribadi, karena ia mengekspos alat ekstraksi Thunderbit langsung ke host AI yang kompatibel seperti Claude atau Cursor — artinya AI agent bisa memanggil Thunderbit sebagai tool di tengah percakapan, alih-alih kamu menjalankan scraper terpisah lalu copy-paste hasilnya kembali. Dan paket CLI and Skills mencakup workflow berbasis terminal dan coding agent. MCP bagi kami bukan fitur tempelan — ini adalah taruhan bahwa dalam beberapa tahun ke depan, semakin banyak "scraping" tidak akan dilakukan manusia yang klik UI, melainkan AI agent yang memutuskan butuh data dan mengambil alat untuk melakukannya.
Ekspor dan Kolaborasi
Keduanya mengekspor format dasar: CSV, Excel, JSON. ParseHub menambah Google Sheets, Dropbox, dan S3 tergantung paket. Thunderbit mengekspor ke Excel, Google Sheets, Airtable, dan Notion, plus unduhan file — lebih ditujukan untuk tim bisnis yang hidup di spreadsheet dan database ringan daripada engineer yang mengalirkan data ke cloud storage bucket.
Satu catatan kolaborasi yang perlu disebut jujur: project free tier ParseHub bersifat publik, menurut halaman harga resminya, artinya bisa dilihat atau dibagikan orang lain. Itu oke untuk belajar atau project uji yang tidak sensitif, tetapi kalau kamu mengekstrak sesuatu yang sifatnya rahasia, kamu sebaiknya memakai paket berbayar dengan project privat. Periksa dulu syarat terbaru sebelum membangun sesuatu yang sensitif di free tier salah satu alat.
Harga dan Total Cost of Ownership
Saya sering melihat banyak keluhan "biaya vs nilai" soal harga scraper di tempat seperti r/webscraping dan r/datasets, dan kebanyakan berujung pada hal yang sama: orang membandingkan harga di label tanpa menghitung jam yang akan habis untuk setup atau memperbaiki run yang rusak. Jadi mari kita lihat dulu harga resminya, lalu bicara tentang apa yang tidak terlihat di sana.
Per pengecekan terakhir saya, halaman harga resmi ParseHub mencantumkan tier bulanan berikut:
| Paket | Harga | Halaman per run | Project | Retensi |
|---|---|---|---|---|
| Free | $0 | 200 | 5 project publik | 14 hari |
| Standard | $189/bulan | 10.000 | 20 project privat | 14 hari |
| Professional | $599/bulan | Tanpa batas | 120 project privat | 30 hari |
| Plus | Kustom | Layanan terkelola | Kustom | Kustom |
Pembayaran kuartalan dilaporkan bisa menghemat 15%, dan tier yang lebih tinggi menambah scheduling serta rotasi IP. Klaim kecepatan seperti "200 halaman dalam kurang dari dua menit" pada Professional adalah klaim dari vendor, bukan benchmark independen, jadi anggap saja sebagai petunjuk, bukan kebenaran mutlak.
Untuk Thunderbit, saya lebih suka mengarahkan kamu ke halaman harga live daripada menuliskan angka di sini yang mungkin sudah basi saat kamu membacanya — tier paket dan struktur credit memang bisa berubah, dan saya lebih suka kamu melihat versi terbaru daripada percaya angka yang saya ketik pada Selasa sore di bulan Agustus.
Pelajaran yang lebih besar dari membangun perusahaan SaaS: total cost of ownership bukan cuma biaya langganan. Ada waktu setup, maintenance saat situs mengubah layout, dan seberapa banyak pembersihan manual yang kamu lakukan setelah run selesai. Alat yang lebih murah tetapi menghabiskan empat jam seminggu untuk membangun ulang selector yang rusak sebenarnya tidak lebih murah. Pertimbangkan itu sebelum memilih hanya berdasarkan invoice.
Mana yang Sebaiknya Anda Pilih?
Pilih Thunderbit jika...
Kamu marketer, operator ecommerce, recruiter, atau peneliti yang butuh data terstruktur dengan cepat dan tidak ingin menghabiskan sore untuk membangun template scraping. Kamu nyaman dengan alur kerja ekstensi browser atau Web App, dan target situs kamu termasuk tipe yang "normal" — halaman daftar, direktori, katalog produk — bukan form multi-step yang sangat interaktif. Kamu juga ingin workflow ekstraksi kamu nantinya terhubung ke AI agent atau sistem backend lewat API atau MCP.
Pilih ParseHub jika...
Kamu analis data atau operator teknis yang membutuhkan kontrol presisi dan terlihat jelas atas sejumlah kecil situs yang kompleks dan berat JavaScript, dan kamu tidak keberatan menginvestasikan waktu setup demi mendapatkan logika workflow yang persis kamu mau. Kamu suka bisa melihat dan melakukan debugging pada setiap klik, kondisi, dan selector, dan anggaran kamu mendukung tier Standard atau Professional untuk pekerjaan rutin dengan volume tinggi.
Pakai keduanya jika...
Jujur saja, banyak tim memang melakukan ini — Thunderbit untuk pekerjaan ekstraksi cepat sehari-hari yang tidak butuh banyak mikir, dan ParseHub disimpan untuk beberapa situs yang benar-benar rumit dan butuh logika interaksi eksplisit. Tidak ada aturan yang mewajibkan kamu memilih satu alat untuk semua pekerjaan scraping selamanya.
Kesimpulan Akhir
Tidak ada alat yang "lebih baik" dalam arti universal — keduanya dibangun di atas taruhan yang berbeda tentang apa yang pengguna inginkan. ParseHub bertaruh bahwa orang ingin kontrol yang terlihat dan eksplisit atas setiap langkah ekstraksi, walaupun itu memakan waktu setup. Thunderbit bertaruh bahwa kebanyakan orang sebenarnya hanya ingin datanya dan lebih suka mendelegasikan "caranya" ke agen.
Saran jujur saya: pilih satu situs target yang memang kamu pedulikan dan jalankan di kedua alat. Ukur waktu setup, hitung baris yang benar-benar bisa dipakai, catat berapa banyak maintenance yang dibutuhkan saat kamu menjalankannya lagi seminggu kemudian, lalu bandingkan biaya bulanan dengan nilai waktu kamu. Tes itu akan memberi jawaban lebih banyak daripada artikel perbandingan mana pun, termasuk yang ini.
Kalau kamu ingin mencoba jalur sekali klik, ambil Thunderbit Chrome Extension dan arahkan ke halaman yang memang kamu boleh scrap — lihat seberapa jauh satu klik bisa membawa kamu. Dan kalau kamu ingin konteks yang lebih luas tentang bagaimana scraping berbasis AI dibandingkan di ranah yang lebih besar, saya juga sarankan membaca ulasan kami tentang AI web scraping, AI web scraper terbaik, dan web scraping tanpa coding.
FAQ
Apakah Thunderbit lebih mudah daripada ParseHub? Untuk sebagian besar halaman daftar dan detail yang standar, ya — alur satu klik Thunderbit tidak perlu membangun selector, sedangkan ParseHub meminta kamu mengajarinya pola ekstraksi terlebih dahulu. Tapi "lebih mudah" tetap tergantung pekerjaannya; untuk situs yang sangat interaktif dengan form dan kondisi yang kompleks, kontrol eksplisit ParseHub justru bisa terasa lebih sederhana setelah kamu tahu cara memakainya.
Bisakah ParseHub mengekstrak situs yang berat JavaScript dan di balik login? Ya, menurut halaman fitur resmi ParseHub, alat ini memang dibuat untuk menangani situs AJAX/JavaScript, halaman login, form, dropdown, dan infinite scroll melalui sistem workflow berbasis perintah.
Apakah Thunderbit membutuhkan CSS selector atau coding? Tidak. Workflow default di ekstensi browser hanya mengharuskan kamu mengklik One Click Extract; agen mendeteksi dan menganalisis halaman lalu menyiapkan field secara otomatis. Penyempurnaan opsional dilakukan dengan bahasa biasa, bukan kode atau selector.
Apakah kedua produk menyediakan akses API? Ya. ParseHub menyediakan REST API dan webhook. Thunderbit menyediakan Open API, plus MCP Server untuk workflow AI agent dan CLI untuk penggunaan berbasis terminal.
Apakah ParseHub gratis? ParseHub menawarkan free tier dengan 200 halaman per run dan lima project publik, menurut halaman harga resminya. Perlu dicatat bahwa project free tier bersifat publik, jadi pekerjaan privat dan sensitif memerlukan paket berbayar.



