
Beberapa minggu lalu, ada seseorang di tim kami yang kirim pesan Slack singkat: “perlu khawatir sama Crawl4AI nggak?” Saya ketawa, karena membandingkan Thunderbit dengan Crawl4AI itu kurang lebih seperti membandingkan aplikasi pesan makanan dengan dapur komersial yang lengkap. Dua-duanya memang bisa bikin Anda dapat makan malam. Tapi salah satunya mengasumsikan Anda tahu cara masak.
Sebagian besar perjalanan karier saya memang muter di dunia otomatisasi — pertama di Automation Anywhere, lihat perusahaan besar mencoba menempelkan bot ke sistem legacy, lalu di Jet.com, saat setiap jam engineering yang habis buat plumbing data berarti satu jam yang nggak dipakai untuk membangun produk inti. Jadi ketika orang minta saya membandingkan Thunderbit dengan crawler Python open-source, saya nggak melihatnya dari kacamata “alat kami lebih bagus.” Saya melihatnya dari kacamata “siapa yang benar-benar akan pakai ini, dan mereka punya waktu untuk apa.” Mari kita bedah dengan jujur apa tujuan masing-masing alat, karena jawaban sebenarnya memang: tergantung Anda lebih suka klik tombol atau nulis script.
Jawaban Singkat
Kalau Anda mau versi pendeknya sebelum saya masuk ke detail: Thunderbit adalah web scraper managed dan agentik yang dibuat untuk pengguna bisnis — Anda buka halaman, klik One Click Extract, lalu sistem memberi Anda tabel terstruktur. Buat developer yang ingin menghubungkannya ke pipeline tanpa harus bikin logika scraping dari nol, Thunderbit juga punya Open API, MCP Server, dan CLI.
Crawl4AI adalah framework Python open-source untuk developer yang membangun pipeline data AI dan RAG. Kemampuannya memang kuat — deep crawling, adaptive crawling, pembuatan Markdown, strategi ekstraksi LLM — tapi Anda tetap menulis kode, mengelola infrastruktur browser sendiri, dan membayar komputasi serta token LLM yang dipakai.
Perbedaan utamanya bukan “bagus vs buruk.” Lebih tepatnya, ini soal kecepatan menuju hasil versus kontrol di level kode. Nggak ada yang salah. Keduanya memang dibuat untuk tipe pengguna yang berbeda dan ada di titik stack yang berbeda.
Sekilas Perbandingan
Sebelum masuk satu per satu, ini tabel yang saya harap sudah ada waktu pertama kali saya membandingkan keduanya. Banyak artikel “X vs Crawl4AI” yang beredar sekarang sebenarnya membahas Firecrawl, bukan Thunderbit, jadi saya susun yang ini dari awal.
| Dimensi | Thunderbit | Crawl4AI |
|---|---|---|
| Model setup | Ekstensi browser / Web App, One Click Extract | Library Python (pip install), script buatan sendiri |
| Perlu coding? | Tidak perlu code (deteksi field agentik) | Ya (Python + opsional key LLM untuk ekstraksi terstruktur) |
| Rendering JS/dinamis | Ditangani pada halaman yang didukung dan diizinkan | Chromium via Playwright, dikonfigurasi manual |
| Format output | Tabel terstruktur, ekspor ke Excel/Sheets/Airtable/Notion | Markdown, JSON (melalui schema Anda sendiri atau ekstraksi LLM) |
| PDF/gambar/dokumen | Tipe input didukung (cek daftar terbaru di dokumentasi resmi) | Bukan fokus utama — HTML/Markdown-first |
| Model hosting | Cloud (Web App) / sesi browser | Self-hosted (Docker, infrastruktur milik sendiri) |
| Pengguna ideal | Tim operasional non-teknis, sales, riset | Developer yang membangun pipeline RAG/LLM |
| Lisensi | Komersial, berbasis subscription/credit (harga saat ini) | Apache 2.0 dengan klausul atribusi |
Sedikit catatan di sini, karena kalau tidak saya sampaikan justru merugikan Anda: tier harga, batas kredit, dan tipe input yang didukung cukup sering berubah di kedua sisi. Anggap tabel ini sebagai peta, bukan kontrak — cek dokumentasi terbaru sebelum ambil keputusan pembelian.
Apa Itu Thunderbit?
Thunderbit adalah hasil kerja tim kami setelah capek melihat orang non-teknis — sales rep, manajer operasional, peneliti — terus mentok tiap kali butuh data dari website dan jawabannya selalu “tanya engineer.” Alur sekarang memang sengaja dibuat sesimpel mungkin: Anda buka halaman yang datanya ingin diambil, klik One Click Extract, lalu agent membaca halaman, memahami field yang masuk akal, dan mulai menarik datanya. Anda akan lihat tombol Run Now, tapi itu opsional — kalau tidak disentuh, proses ekstraksi akan jalan otomatis.

Intinya memang di situ. Nggak perlu selector, nggak perlu file schema, nggak ada langkah “tentukan aturan ekstraksi” sebelum Anda bahkan melihat preview. Setelah itu, Anda bisa merapikan output dengan bahasa yang biasa dipakai sehari-hari — ganti nama kolom, minta field diterjemahkan, atau suruh sistem melewati baris yang nggak punya harga — dan pada halaman yang didukung, Thunderbit bisa mengikuti pagination atau membuka subpage untuk memperkaya dataset.
Thunderbit juga bukan cuma ekstensi browser. Ada Web App untuk kerja berbasis cloud, Open API untuk developer yang ingin akses programatik tanpa membangun scraper sendiri, MCP Server untuk disambungkan ke Claude, Cursor, atau environment AI-agent lain, serta CLI untuk workflow terminal dan coding-agent. Hasil ekspor bisa langsung ke Excel, Google Sheets, Airtable, atau Notion. Ini jenis alat yang dulu saya harap sudah ada waktu masih di Jet.com, ketika saya lihat analis copy-paste harga kompetitor ke spreadsheet tiap minggu.
Apa Itu Crawl4AI?
Crawl4AI adalah sesuatu yang sangat berbeda, dan saya memang ingin kasih apresiasi yang layak karena ini software open-source yang solid — bukan sekadar scraper yang buang HTML ke Markdown. Ini adalah async Python crawler, secara default dibangun di atas Chromium, dan sejak rilis v0.9.0 pada 18 Juni 2026, proyek ini membawa perubahan besar demi keamanan default pada Docker API self-hosted, termasuk autentikasi yang aktif secara default dan binding ke loopback kecuali Anda atur sebaliknya.
Dokumentasi quickstart menunjukkan alur dasarnya: jalankan AsyncWebCrawler, arahkan ke URL, lalu dapatkan Markdown yang bersih, atau tentukan schema CSS/XPath, atau serahkan ke LLMExtractionStrategy kalau Anda ingin AI menentukan struktur dengan model yang Anda konfigurasi dan bayar sendiri.
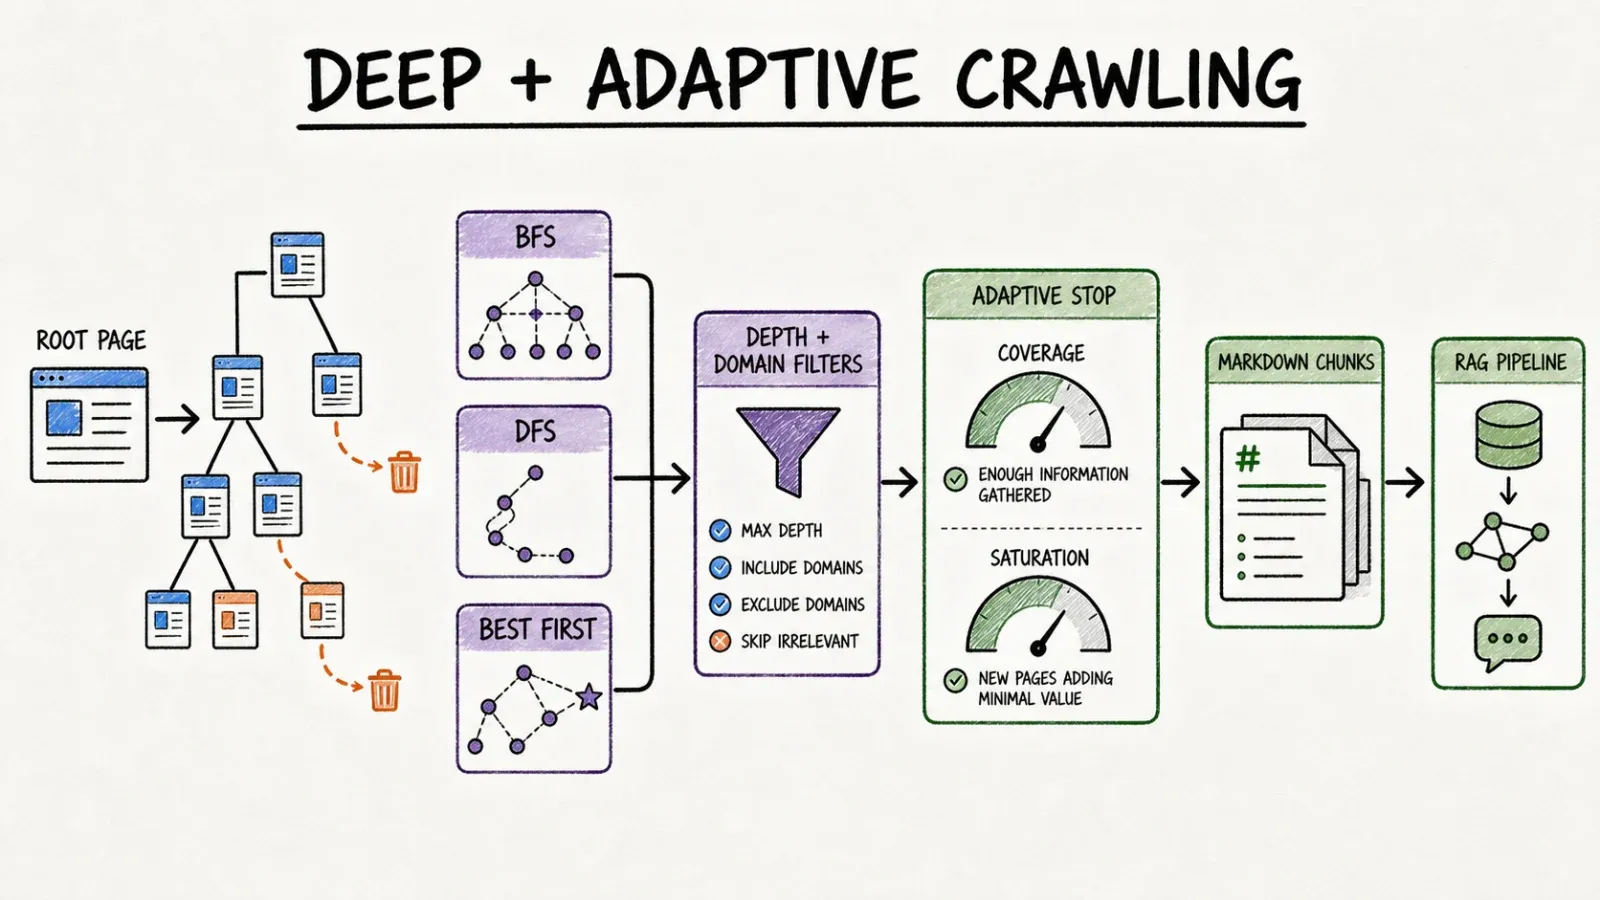
Yang paling menarik buat saya saat mendalami ini adalah logika crawling-nya. Ada deep crawling dengan strategi BFS, DFS, dan BestFirst, lengkap dengan batas kedalaman, filter domain, dan scoring — sangat berguna kalau Anda sedang memetakan situs dokumentasi atau arsip konten besar. Ada juga adaptive crawling, ide yang cukup cerdas: sistem memilih tautan mana yang akan diikuti berikutnya dan berhenti ketika merasa informasi yang terkumpul sudah “cukup”, memakai metrik coverage dan saturation, bukan crawling tanpa henti. Dari sisi kontrol browser, Crawl4AI menangani cookie, header, geolokasi, virtual scrolling, storage state, dan bahkan capture PDF/screenshot.
Lisensinya Apache 2.0, tapi — dan ini penting dibaca kalau Anda pengguna komersial — ada klausul atribusi khusus proyek yang disebutkan di file lisensi. “Gratis dan open source” nggak selalu berarti “tanpa syarat,” dan saya lebih baik tandai sekarang daripada Anda baru tahu belakangan.
Perbedaan Inti: Produk Agentik Siap Pakai vs Framework untuk Developer
Waktu menuju tabel pertama
Saya nggak akan pura-pura melakukan benchmark stopwatch di sini, karena ngarang angka menit tertentu itu nggak jujur dan juga agak sia-sia — kecepatan jaringan, kompleksitas halaman, dan kecepatan Anda mengetik semuanya ikut memengaruhi hasil. Tapi perbedaan jumlah langkahnya nyata dan layak dijelaskan dengan jujur.
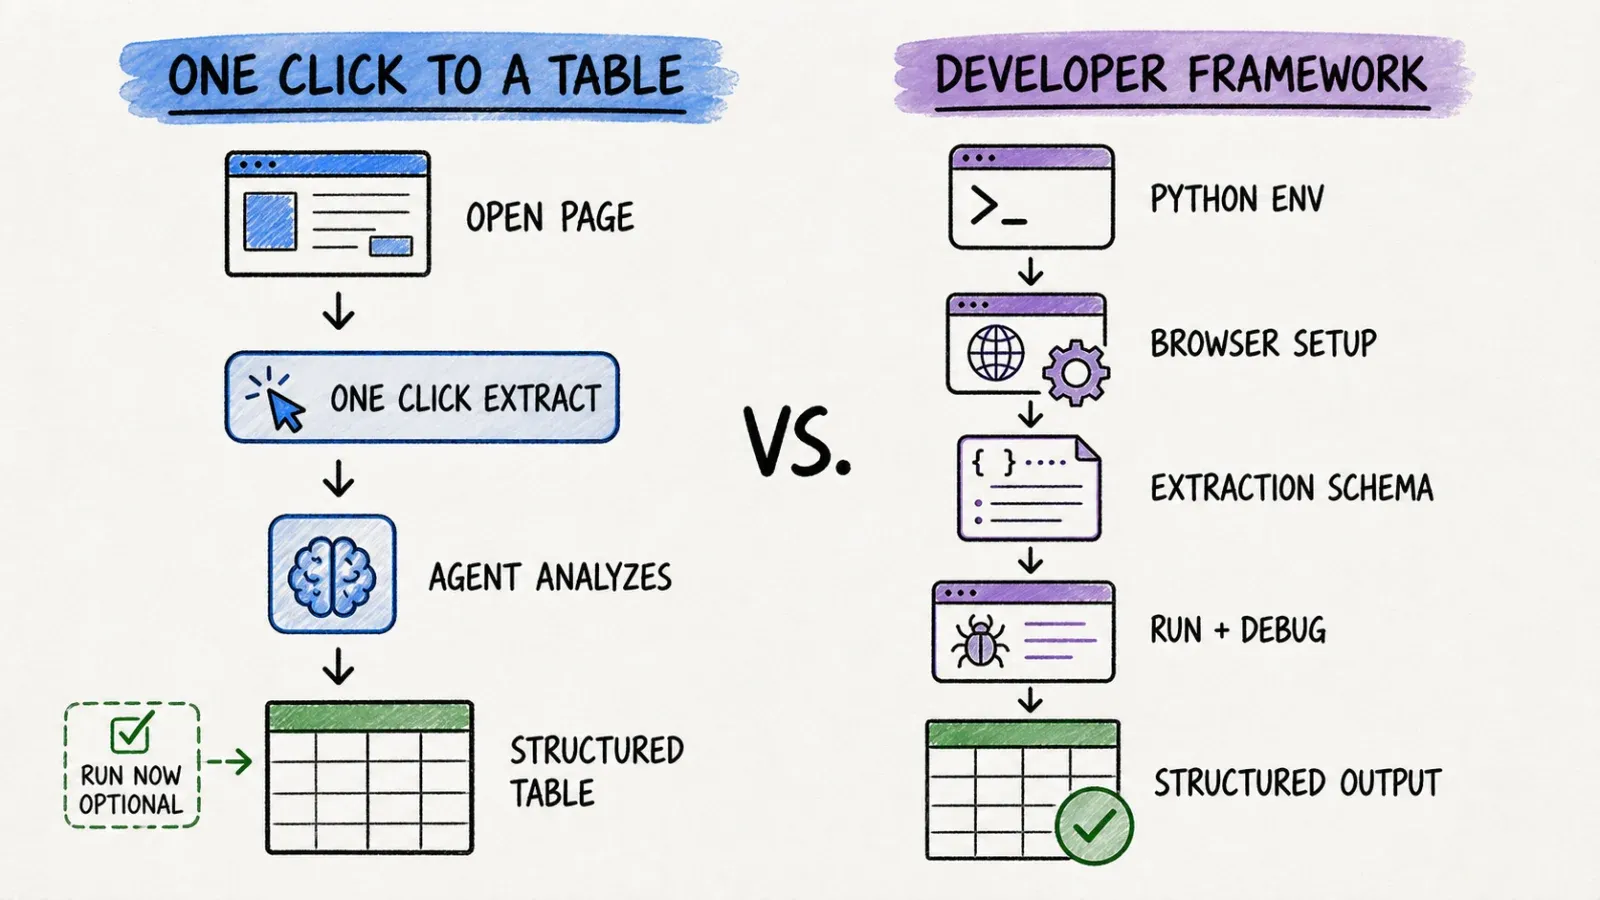
Dengan Crawl4AI, alurnya kira-kira begini: siapkan environment Python, pip install crawl4ai, jalankan setup/doctor check, konfigurasi browser dan dependency Playwright, tulis schema ekstraksi atau sambungkan key LLM, jalankan script, lalu debug output saat ada bagian yang nggak ter-parse dengan benar (biasanya memang ada yang salah di percobaan pertama — itulah software).
Dengan Thunderbit, alurnya: instal ekstensi browser, buka halaman, klik One Click Extract, lalu klik Run Now atau tunggu saja karena prosesnya otomatis mulai. Selesai. Satu klik yang disengaja, tanpa code.
Kalau Anda developer yang sudah hidup di terminal, alur Crawl4AI nggak terasa menakutkan — itu hari Selasa biasa. Kalau Anda sales manager yang cuma butuh daftar prospek sebelum makan siang, itu justru jadi penghalang besar.
Kontrol atas logika crawling dan ekstraksi
Di sini Crawl4AI memang unggul untuk audiens tertentu. Anda punya kontrol penuh atas crawl depth, concurrency, retry logic, caching, dan cara konten dipecah sebelum masuk ke LLM atau vector database. Kalau Anda membangun pipeline RAG dan butuh kontrol presisi atas cara dokumen dipotong untuk embedding, detail seperti ini sangat penting, dan Thunderbit memang nggak mencoba bersaing di area itu.
Kontrol Thunderbit berbeda — fokusnya pada apa yang diekstrak (field mana, format apa, bahasa apa), bukan bagaimana crawler menjelajahi web di level kode. Untuk data bisnis yang terstruktur, tradeoff ini biasanya malah menguntungkan Anda. Untuk arsitektur RAG yang kustom, Anda bakal lebih butuh kontrol di level kode.
Hosting, observability, dan siapa yang memikul maintenance
Dengan Crawl4AI, infrastrukturnya ada di tangan Anda. Artinya Anda yang bertanggung jawab atas deployment Docker, dependency browser, rotasi proxy kalau situs menolak, monitoring saat crawl gagal diam-diam jam 2 pagi, dan update script ketika target situs mengubah markup. Dengan Thunderbit, beban operasional itu ada di pihak kami — eksekusi browser dan cloud, logika membaca halaman, serta pemeliharaan mesin ekstraksi.
Nggak ada pendekatan yang benar-benar tanpa kompromi. Self-hosting memberi Anda kemampuan audit, modifikasi, dan kontrol penuh, tapi juga berarti setiap kegagalan jam 2 pagi jadi masalah Anda.
Skenario di Lapangan
Perbandingan abstrak memang oke, tapi saya lebih gampang menilainya lewat skenario nyata.
Pengguna bisnis yang mengekstrak halaman saat ini. Misalnya Anda market researcher yang perlu data harga dari 40 halaman produk kompetitor sebelum hari habis. Anda nggak bisa Python dan juga nggak pengin belajar hari ini. Ekstensi Thunderbit memberi Anda tabel terstruktur tanpa harus pindah dari tab browser yang lagi Anda pakai.
Developer yang membangun pipeline ingestion RAG. Anda mengindeks situs dokumentasi teknis untuk chatbot internal, dan Anda butuh potongan Markdown rapi dengan format konsisten untuk embedding. Ini jelas wilayah Crawl4AI — pembuatan Markdown dan kontrol chunking-nya memang dibuat untuk kebutuhan seperti ini.
Deep crawling situs dokumentasi. Anda ingin memetakan seluruh knowledgebase, ratusan halaman ke dalam, dengan pembatasan domain dan scoring supaya komputasi nggak habis untuk halaman yang nggak relevan. Strategi deep crawling Crawl4AI memang dibuat khusus untuk ini; ini bukan use case utama Thunderbit.
Memanggil scraping dari AI agent. Anda sudah menyiapkan Claude atau Cursor sebagai agent yang perlu menarik data terstruktur di tengah workflow tanpa manusia klik apa pun. MCP Server Thunderbit langsung cocok untuk environment seperti itu, dan Open API juga bisa dipakai untuk otomasi backend.
Akurasi, Halaman Dinamis, dan Maintenance
Penting buat memisahkan dua hal yang sering dicampur orang: inferensi field (menentukan data apa yang penting di halaman) dan kontrol browser/crawl (benar-benar merender dan menavigasi halaman).
Thunderbit mengotomatiskan keduanya pada halaman yang didukung dan diizinkan — agent membaca halaman, menyimpulkan strukturnya, dan menangani rendering di belakang layar. Crawl4AI mengotomatiskan rendering-nya (via Chromium/Playwright) tapi membiarkan keputusan inferensi struktur ada di tangan Anda, entah itu selector CSS yang ditulis manual atau pemanggilan ekstraksi LLM yang Anda konfigurasi dan bayar sendiri.
Nggak ada alat yang menjamin akses universal. Halaman yang butuh login, sistem anti-bot yang agresif, dan markup yang terus berubah adalah masalah berat untuk scraper apa pun, baik managed maupun self-hosted. Saya akan bohong kalau bilang Thunderbit bekerja di semua website — yang benar, Thunderbit bekerja dengan baik pada halaman yang didukung dan diizinkan, dan itu klaim yang jujur, bukan jargon marketing. Crawl4AI punya batasan yang sama; bedanya, beban menanganinya jatuh ke waktu engineering Anda sendiri, bukan ke vendor.
Harga, Lisensi, dan Total Biaya
Ini bagian yang paling sering dilewatkan artikel perbandingan, dan saya selalu terganggu karenanya, karena “gratis” dan “tanpa biaya” itu bukan hal yang sama.
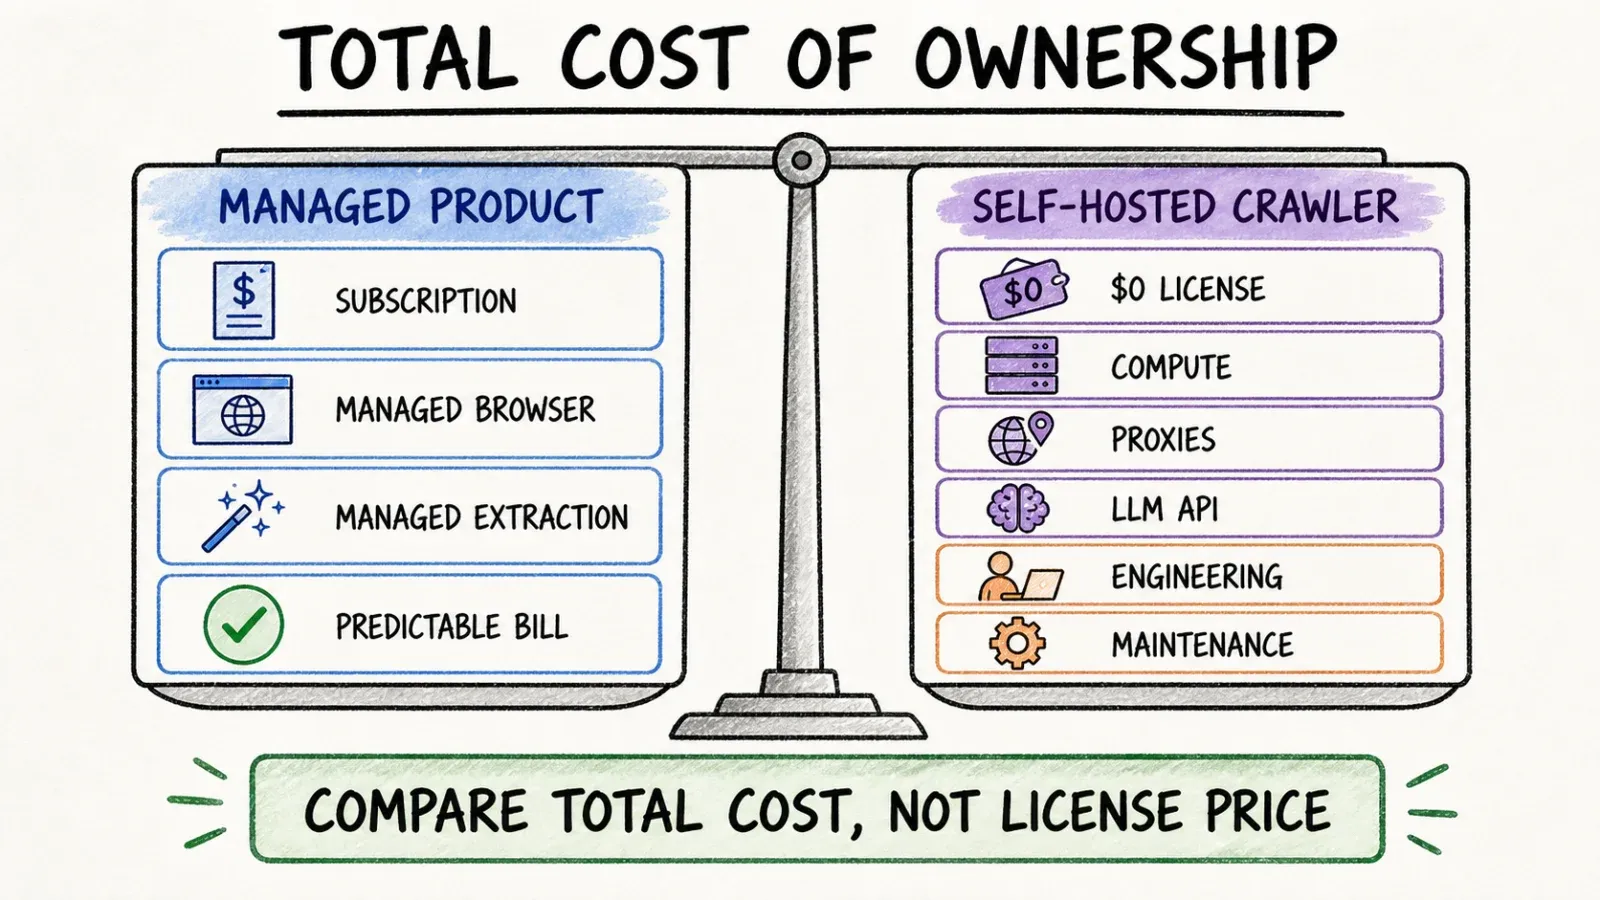
Mari pakai skenario nyata: Anda perlu mengekstrak sekitar 3.000 baris per bulan — lead, listing, apa pun itu — secara berkelanjutan.
Dengan Crawl4AI, lisensinya memang gratis. Tapi Anda tetap harus bayar:
- Compute dan hosting browser (server atau container yang menjalankan Chromium)
- Biaya proxy kalau situs target butuh rotasi IP
- Biaya token API LLM kalau Anda pakai
LLMExtractionStrategydengan model kelas GPT-4o untuk ekstraksi terstruktur - Waktu engineering untuk menulis, menguji, men-deploy, dan memelihara script — plus memperbaikinya saat situs mengubah desain layout
Nggak satu pun dari itu muncul di label harga “$0”, tapi semuanya muncul di pengeluaran bulanan nyata Anda, biasanya tersebar di tagihan cloud, invoice API, dan kalender seseorang.
Dengan Thunderbit, Anda membayar subscription atau tier kredit yang flat dan mudah diprediksi — cek halaman harga saat ini karena tier memang bisa berubah dari waktu ke waktu — dan Anda nggak perlu mengelola key LLM, kontrak proxy, atau deployment Docker secara terpisah.
Framing yang paling jujur bukan “gratis vs berbayar.” Melainkan “biaya engineering tersembunyi vs langganan yang bisa diprediksi.” Saya sudah cukup lama melihat tim engineering diam-diam menelan biaya infrastruktur ke dalam anggaran headcount untuk tahu bahwa “software gratis” dan “operasi gratis” adalah dua kalimat yang sangat berbeda.
Siapa yang Sebaiknya Memilih Thunderbit?
Kalau Anda pengguna non-teknis atau sedang dikejar waktu dan butuh data terstruktur — tabel, lead, listing — dengan cepat, lalu ingin hasilnya langsung diekspor ke Excel, Sheets, Airtable, atau Notion tanpa sentuh infrastruktur, proxy, atau key LLM, Thunderbit adalah jalur yang lebih langsung. Ini juga cocok untuk tim yang ingin menjalankan workflow AI lead generation atau riset ad hoc tanpa harus selalu melibatkan engineering.
Siapa yang Sebaiknya Memilih Crawl4AI?
Kalau Anda developer yang membangun pipeline data RAG atau LLM, butuh kontrol penuh atas logika crawling — parallel crawling, chunking kustom, schema ekstraksi buatan sendiri — dan Anda nyaman self-hosting serta memelihara kode Python, Crawl4AI memberi Anda kontrol seperti itu dengan cara yang memang nggak dirancang untuk ditandingi oleh produk managed.
Apakah Tim Bisa Memakai Keduanya?
Tentu saja bisa, dan ini bukan saya menghindari memilih kubu. Saya sudah lihat pola ini di perusahaan yang lebih besar: tim engineering membangun crawler khusus berbasis Crawl4AI untuk pipeline RAG karena mereka butuh kontrol tingkat tinggi atas chunking dan persiapan embedding, sementara tim sales, marketing, dan riset memakai Thunderbit untuk permintaan harian seperti “saya butuh daftar perusahaan ini sebelum jam 3 sore” yang nggak sebanding dengan waktu menulis script. Nggak ada integrasi resmi antara kedua produk, dan saya nggak akan pura-pura ada — tapi pembagian berdasarkan peran ini memang masuk akal secara praktis.
Kesimpulan
Penilaian jujur saya, setelah bertahun-tahun ada di dua sisi — “membangun otomasi” dan “melihat orang kesulitan tanpa otomasi” — adalah: pilih berdasarkan siapa yang mengerjakan dan seberapa dalam beban kerjanya. Kalau Anda punya engineer yang punya waktu untuk memelihara infrastruktur dan Anda butuh deep, adaptive crawling untuk pipeline AI, Crawl4AI adalah opsi open-source yang sangat kuat dan terawat. Kalau Anda butuh data terstruktur dari website tanpa harus menyalakan environment Python — dan kebanyakan orang yang nanya “harus pakai scraper nggak” memang masuk kategori ini — Thunderbit akan membawa Anda ke hasil lebih cepat, dengan beban maintenance yang lebih kecil ke depannya. Nggak ada pemenang universal di sini, cuma kecocokan yang lebih pas tergantung Anda sedang duduk di sisi keyboard yang mana.
Kalau Anda ingin lihat seperti apa sisi no-code ini bekerja, ada baiknya baca web scraping tanpa coding atau telusuri rangkuman kami tentang AI web scrapers terbaik untuk konteks tambahan tentang posisi alat-alat ini satu sama lain.
FAQ
Apakah Crawl4AI benar-benar gratis dan open source? Library inti memakai lisensi Apache 2.0 dengan klausul atribusi khusus proyek, dan tidak ada biaya subscription dari vendor. Tapi “gratis” cuma mencakup lisensinya — Anda tetap membayar hosting, proxy, dan panggilan API LLM apa pun yang Anda konfigurasi untuk ekstraksi, plus waktu engineering untuk membangun dan memeliharanya.
Apakah Thunderbit butuh coding? Tidak. Workflow inti — instal ekstensi Chrome, klik One Click Extract, tinjau hasil — nggak memerlukan coding. Developer yang ingin akses programatik bisa pakai Open API, MCP Server, atau CLI, tapi itu lapisan opsional, bukan keharusan.
Mana yang lebih baik untuk pipeline RAG/LLM? Crawl4AI memang dibuat untuk ini — pembuatan Markdown, deep dan adaptive crawling, serta kontrol chunking semuanya dirancang untuk persiapan RAG. Thunderbit dibuat untuk data bisnis terstruktur yang bisa diekspor (tabel, lead, listing), bukan pipeline yang berorientasi Markdown, jadi untuk arsitektur RAG khusus, Crawl4AI adalah kecocokan yang lebih natural.
Mana yang lebih cepat untuk ekstraksi sekali jalan? Untuk satu halaman atau beberapa halaman, alur satu klik Thunderbit punya lebih sedikit langkah antara “saya butuh data ini” dan “saya sudah punya datanya” — tanpa setup environment, tanpa nulis script. Overhead setup Crawl4AI lebih terasa manfaatnya pada pekerjaan crawling yang berulang, skala besar, atau sangat kustom, bukan untuk pengambilan cepat sekali jalan.
Apakah Thunderbit punya MCP dan akses API? Ya. Thunderbit menawarkan MCP Server untuk environment AI-agent seperti Claude dan Cursor, plus Open API untuk workflow backend dan programatik, di samping ekstensi browser no-code dan Web App. Kalau Anda membandingkan alternatif di luar dua alat ini, nama seperti Firecrawl, Apify, dan Bright Data juga sering muncul dalam percakapan yang sama, dan ada baiknya lihat ulasan kami yang lebih luas tentang AI web scraping untuk memahami peta pasarnya secara keseluruhan.




