
Google memang sudah mematikan Flights API sejak 2018, tetapi harga tiket pesawat terus berubah — bahkan sampai 17 kali dalam 48 jam untuk satu rute domestik. Kalau kamu ingin mengakses data itu secara programatis, web scraping praktis jadi satu-satunya jalan.
Saya sudah cukup lama menguji berbagai cara untuk menarik data penerbangan dari Google, dan lanskapnya berubah drastis — terutama setelah Google meluncurkan SearchGuard pada Januari 2025. Dalam panduan ini, saya akan menunjukkan cara membangun scraper Python yang benar-benar bekerja untuk Google Flights menggunakan Playwright, cara menghadapi proteksi anti-bot yang bikin banyak orang gagal, lalu mengembangkannya menjadi price tracker otomatis dengan notifikasi. Kalau kamu ingin langsung tanpa kode, saya juga akan membahas jalan pintas no-code dengan Thunderbit yang bisa memberi hasil serupa dalam sekitar dua menit.
Kenapa Scrape Google Flights dengan Python?
Google Flights mendominasi pencarian tiket pesawat. Visibilitas mobile di AS melonjak ke 47,6%, mengalahkan semua OTA besar. Pasar metasearch travel di belakangnya bernilai US$8,33 miliar pada 2024, dengan pertumbuhan 30,2% CAGR. Namun sejak QPX Express API ditutup permanen pada 10 April 2018, tidak ada cara resmi untuk mengakses data ini secara programatis.
Di sisi lain, harga tiket bisa berfluktuasi hingga 50% untuk itinerari yang sama, dengan selisih rata-rata sekitar US$20 antara harga terendah dan tertinggi. Maskapai seperti Delta memakai 77 fare bucket untuk dynamic pricing. Rata-rata tarif pulang-pergi di AS pada awal 2026 berada di US$408, dengan harga tiket 14,9% lebih tinggi dibanding tahun sebelumnya.
Platform dominan, tanpa API, harga yang sangat fluktuatif. Itu sebabnya scraping Google Flights dengan Python jadi salah satu proyek paling populer di GitHub dan forum travel.
Berikut siapa yang paling diuntungkan dan bagaimana caranya:
| Tipe Pengguna | Use Case | Manfaat Utama |
|---|---|---|
| Pelancong individual | Memantau harga rute tertentu dari waktu ke waktu | Hemat rata-rata US$50 per penerbangan |
| Agen travel | Intel pricing kompetitif | Pemantauan parity tarif secara real-time |
| Tim perjalanan korporat | Optimasi biaya lintas rute | Penghematan 10–30% untuk perjalanan bisnis |
| Developer | Membangun aplikasi perbandingan tarif | Akses data harga secara programatis |
| Peneliti | Analisis volatilitas harga maskapai | Riset akademik dan pasar |
Pengguna forum biasanya blak-blakan soal alasan mereka beralih ke scraping: "Google Flights API was discontinued and I should use web scraping instead" adalah sentimen yang sering muncul. Dan ROI-nya nyata — Hopper mengklaim akurasi prediksi 95% dengan menganalisis lebih dari 5 miliar kutipan harga setiap hari, sementara data Expedia 2026 menunjukkan bahwa memesan 8–15 hari sebelumnya bisa menghemat sekitar US$25 untuk penerbangan domestik.
Data Apa Saja yang Bisa Diambil dari Google Flights?
Halaman hasil Google Flights ternyata menyimpan cukup banyak field data. Biasanya kamu bisa mendapatkan:
- Nama maskapai (dan logo)
- Waktu keberangkatan dan kode bandara
- Waktu kedatangan dan kode bandara
- Total durasi penerbangan
- Jumlah transit dan detail layover (bandara, durasi, apakah menginap)
- Harga tiket (sesuai mata uang)
- Emisi CO2 (kg CO2e, beserta persentase perbandingan vs penerbangan biasa)
- Kelas perjalanan, nomor penerbangan, model pesawat
- Spesifikasi legroom
- Fasilitas tambahan (Wi-Fi, colokan listrik, streaming media)
- Indikator level harga (rendah/normal/tinggi)
- Peringatan keterlambatan ("Sering terlambat lebih dari 30 menit")
Ketersediaan data berbeda-beda tergantung rute, tanggal, dan jenis tiket (one-way vs round-trip). Berikut contoh satu record hasil scraping dalam format JSON:
{
  "search_date": "2026-04-16",
  "route": "SFO-JFK",
  "departure_date": "2026-05-15",
  "flights": [
    {
      "airline": "United Airlines",
      "flight_number": "UA123",
      "departure_time": "08:00",
      "departure_airport": "SFO",
      "arrival_time": "16:35",
      "arrival_airport": "JFK",
      "duration_minutes": 335,
      "stops": 0,
      "price_usd": 287,
      "price_level": "low",
      "co2_kg": 156,
      "co2_vs_typical": "-12%",
      "travel_class": "Economy"
    }
  ]
}
Menyiapkan Environment Python Anda
Sebelum kita menulis kode scraping, ada beberapa hal yang perlu disiapkan.
Prasyarat:
- Tingkat kesulitan: Menengah
- Waktu yang dibutuhkan: Sekitar 1–2 jam untuk tutorial lengkap
- Yang kamu perlukan: Python 3.7+, pengetahuan dasar Python, browser berbasis Chrome
Install Library yang Dibutuhkan
Kita akan memakai Playwright untuk otomatisasi browser (Google Flights 100% dirender oleh JavaScript — request HTTP biasa tidak akan mengembalikan data yang berguna), plus beberapa helper:
pip install playwright playwright-stealth pandas
playwright install chromium
- Playwright — otomatisasi browser headless, menangani rendering JavaScript, dan punya mekanisme wait bawaan
- playwright-stealth — membantu menyamarkan sinyal bot yang umum
- pandas — untuk analisis data dan ekspor CSV nantinya
Kenapa Playwright, Bukan Selenium atau Requests
Google Flights tidak akan berjalan hanya dengan requests + BeautifulSoup — kontennya sepenuhnya dirender oleh JavaScript. Jadi kamu butuh browser sungguhan.
| Fitur | Playwright | Selenium | requests + BS4 |
|---|---|---|---|
| Rendering JS | Dukungan penuh | Dukungan penuh | Tidak ada |
| Kecepatan | 42% lebih cepat secara keseluruhan | Baseline | Tidak berlaku untuk use case ini |
| Dukungan async | Native | Hanya sequential | Tidak berlaku |
| Penggunaan memori | 30% lebih hemat | Lebih tinggi | Minimal |
| Menghindari deteksi bot | Baik (dengan stealth) | Lebih mudah terdeteksi | Tidak berlaku |
Playwright lebih cepat, lebih modern, dan dukungan async-nya lebih baik. Khusus untuk Google Flights, ini jelas pilihan terbaik.
Langkah demi Langkah: Cara Scrape Google Flights dengan Python
Ini inti dari tutorialnya. Kita akan membangun scraper sedikit demi sedikit.
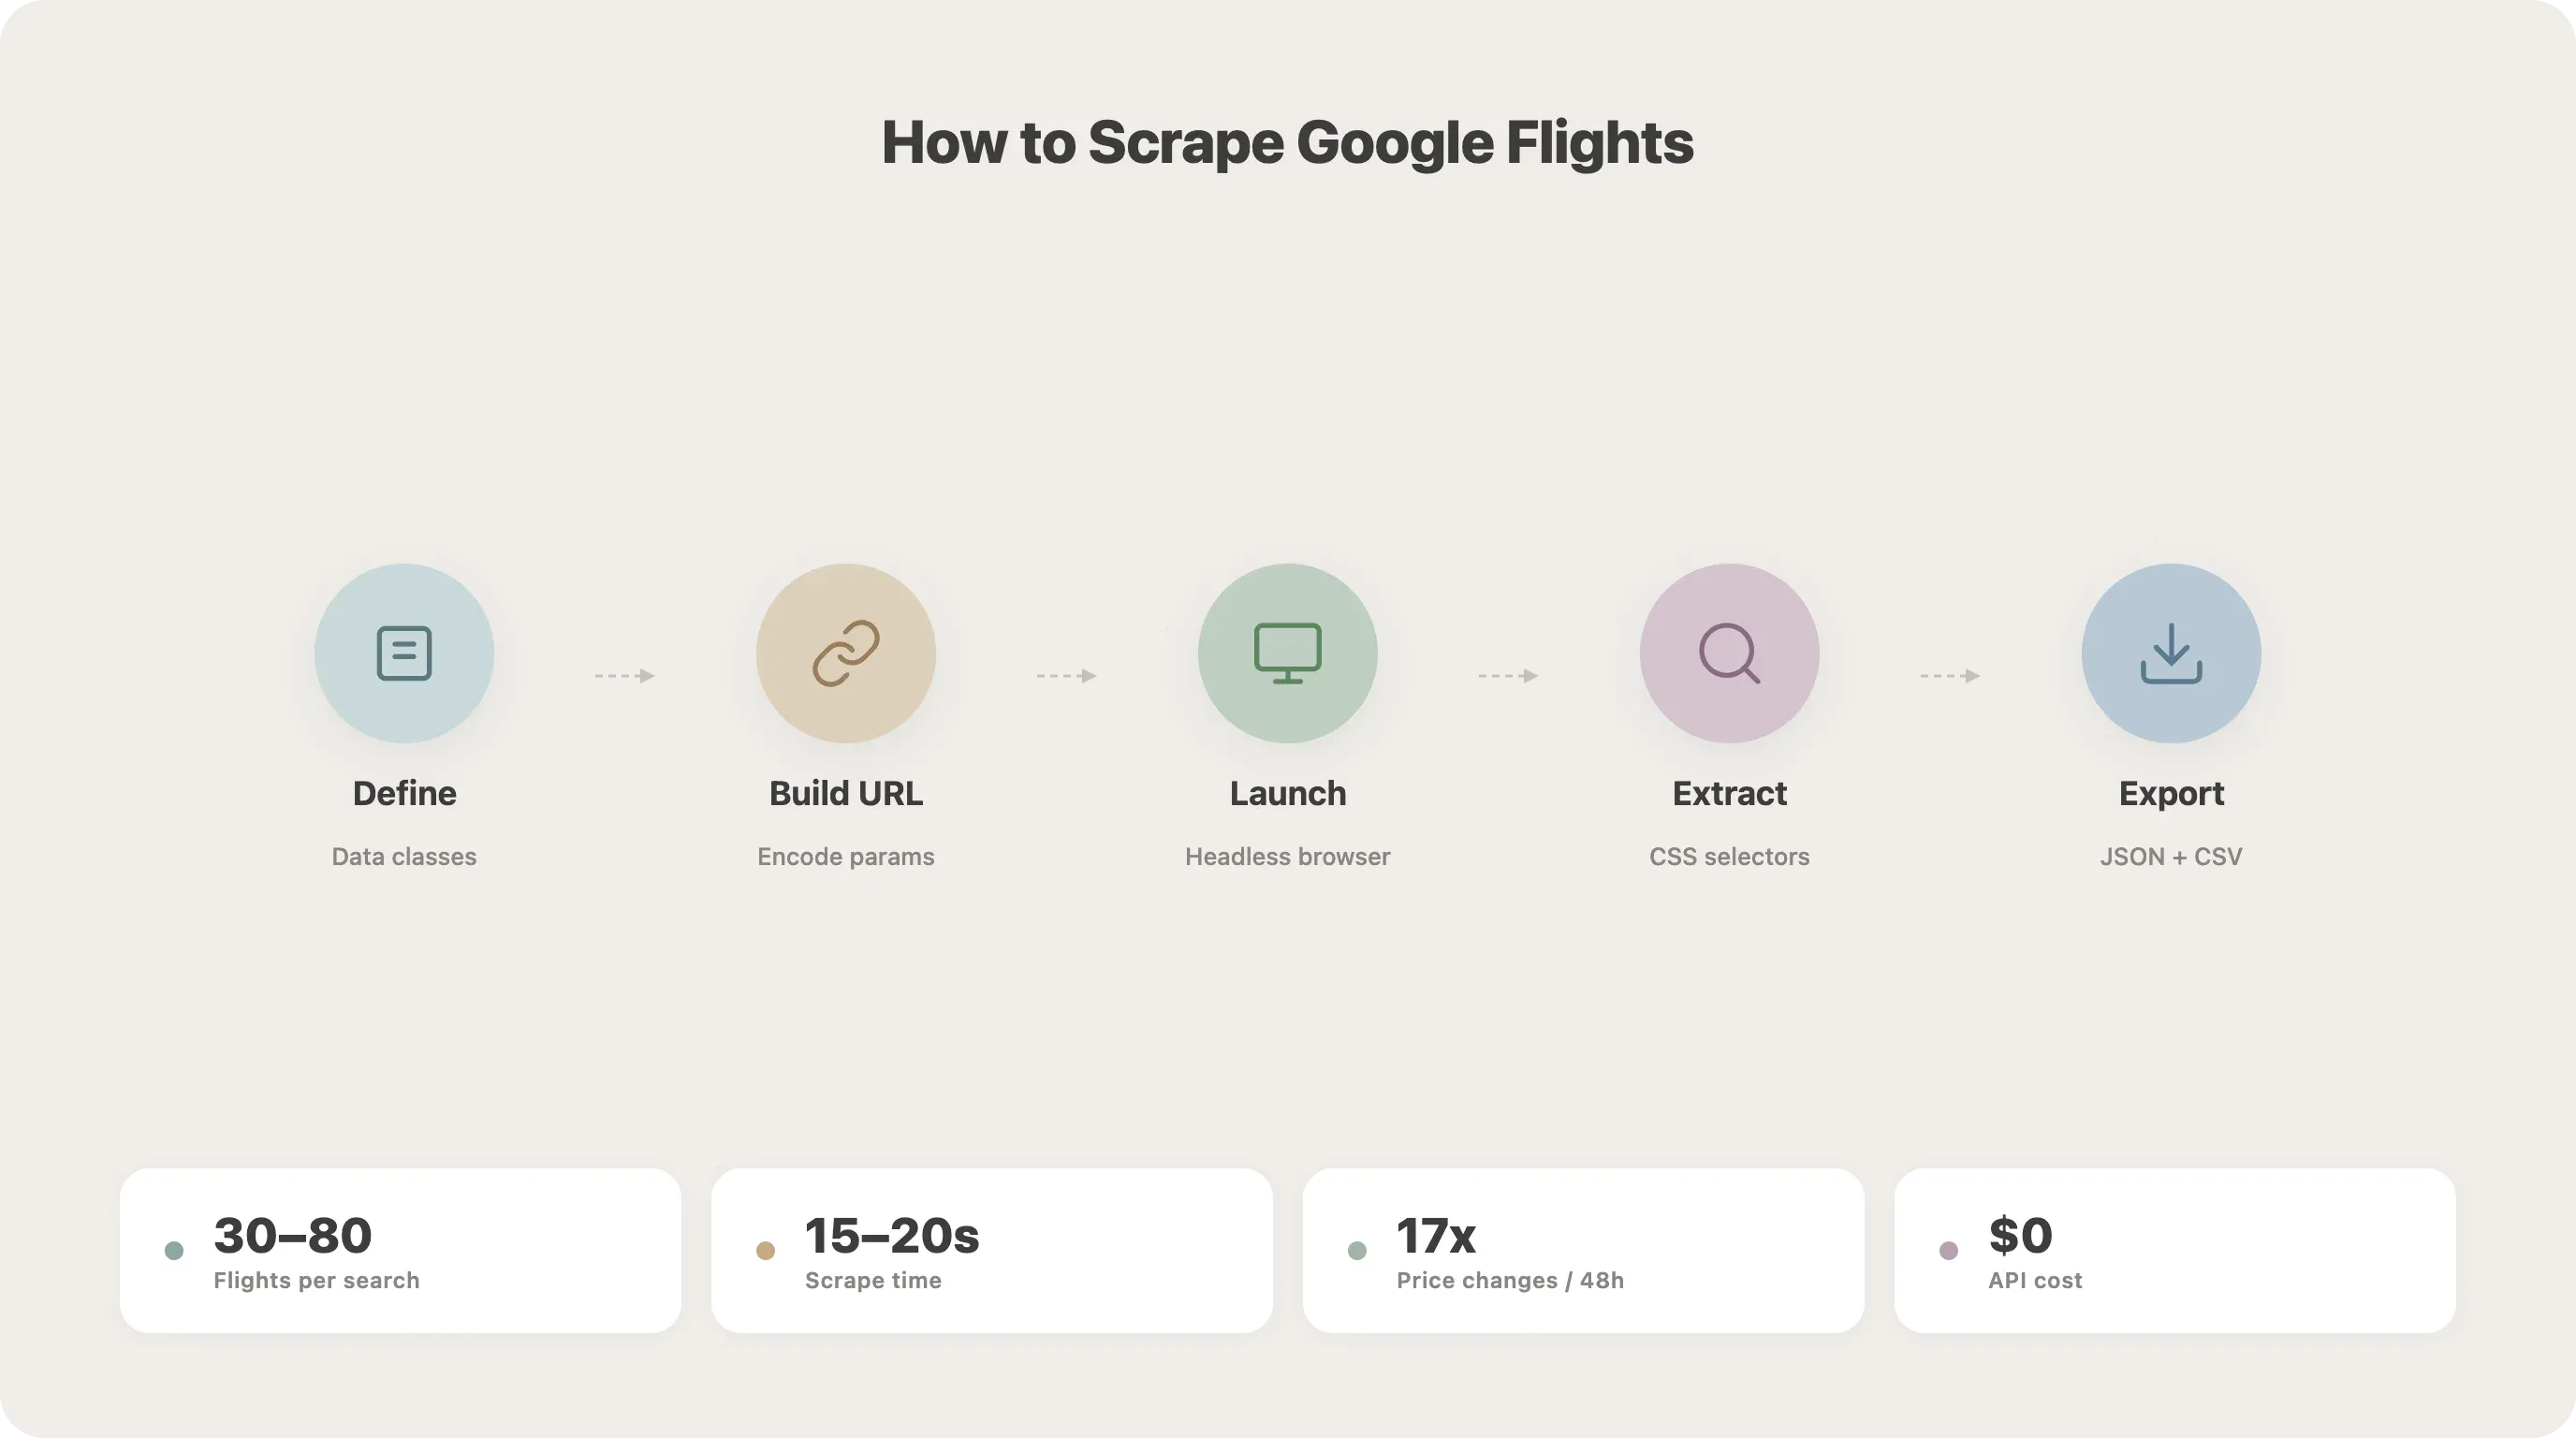
Langkah 1: Definisikan Data Class Anda
Mulailah dengan menyusun parameter pencarian dan data penerbangan menggunakan dataclass Python. Ini membuat kode lebih rapi dan lebih mudah dikembangkan nanti.
from dataclasses import dataclass, field
from typing import Optional, List

@dataclass
class SearchParams:
    origin: str          # e.g., "SFO"
    destination: str     # e.g., "JFK"
    departure_date: str  # e.g., "2026-05-15"
    return_date: Optional[str] = None
    trip_type: str = "one-way"  # "one-way" or "round-trip"
    travel_class: str = "economy"

@dataclass
class FlightData:
    airline: str = ""
    departure_time: str = ""
    arrival_time: str = ""
    duration: str = ""
    stops: str = ""
    price: str = ""
    co2_emissions: str = ""
Setiap field dipetakan langsung ke data yang akan kita ambil dari halaman. Dengan struktur ini sejak awal, kamu tidak perlu melempar-lempar dictionary yang berantakan di tahap berikutnya.
Langkah 2: Pahami Struktur URL Google Flights
Google Flights meng-encode parameter pencarian menggunakan Protobuf yang di-encode Base64 di parameter URL tfs. Kamu bisa membongkar encoding ini, atau memakai cara yang lebih sederhana: membangun URL query dalam bahasa alami.
Cara paling sederhana adalah memakai format query pencarian berikut:
https://www.google.com/travel/flights?q=flights+from+SFO+to+JFK+on+2026-05-15&curr=USD
Kalau ingin lebih fleksibel, kamu bisa membangun URL secara programatis:
def build_flights_url(origin: str, destination: str, date: str) -> str:
    base = "https://www.google.com/travel/flights"
    query = f"flights from {origin} to {destination} on {date}"
    return f"{base}?q={query.replace(' ', '+')}&curr=USD"
Alternatifnya — membongkar encoding Protobuf — memberi kontrol yang lebih presisi, tetapi bisa rusak saat Google mengubah format internalnya. Library seperti fast-flights di GitHub memakai decoding Protobuf untuk melewati HTML parsing sepenuhnya, tetapi itu pendekatan yang lebih advanced.
Langkah 3: Jalankan Browser dan Buka Google Flights
Berikut setup Playwright-nya. Kita memakai playwright-stealth untuk mengurangi risiko deteksi sejak awal.
import asyncio
from playwright.async_api import async_playwright
from playwright_stealth import Stealth

async def scrape_flights(params: SearchParams) -> List[FlightData]:
    async with Stealth().use_async(async_playwright()) as pw:
        browser = await pw.chromium.launch(
            headless=True,
            args=[
                "--disable-blink-features=AutomationControlled",
                "--disable-dev-shm-usage",
                "--no-first-run",
            ]
        )
        context = await browser.new_context(
            viewport={"width": 1920, "height": 1080},
            user_agent=(
                "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                "AppleWebKit/537.36 (KHTML, like Gecko) "
                "Chrome/125.0.0.0 Safari/537.36"
            ),
            locale="en-US",
            timezone_id="America/New_York",
        )
        # Pre-set cookie consent to skip the popup
        await context.add_cookies([{
            "name": "SOCS",
            "value": "CAESHwgBEhJnd3NfMjAyNTAyMjctMF9SQzIaBXpoLUNOIAEaBgiAy6O-Bg",
            "domain": ".google.com",
            "path": "/"
        }])
        page = await context.new_page()
Kita menjalankan headless untuk produksi (ubah ke headless=False untuk debugging), menetapkan viewport dan user agent yang realistis, dan memasang cookie SOCS terlebih dulu untuk melewati popup persetujuan — nanti dibahas lebih lanjut di bagian anti-bot.
Langkah 4: Buka Halaman Hasil Pencarian
Muat URL yang sudah dibangun dan tunggu hingga hasil penerbangan muncul:
        url = build_flights_url(
            params.origin, params.destination, params.departure_date
        )
        await page.goto(url, wait_until="networkidle")

        # Wait for flight results to load
        await page.wait_for_selector(
            "li.pIav2d", timeout=15000
        )
Kalau di sini terjadi timeout, biasanya penyebabnya popup consent memblokir halaman (lihat perbaikan cookie di Langkah 3) atau Google sedang menampilkan CAPTCHA. Kita akan bahas keduanya di bagian anti-bot.
Langkah 5: Muat Semua Hasil Penerbangan
Google Flights menyembunyikan hasil tambahan di balik tombol "Show more flights". Kamu perlu mengkliknya berulang kali sampai semua penerbangan terlihat:
        # Click "Show more flights" until all results are loaded
        while True:
            try:
                more_button = page.locator(
                    'button:has-text("Show more flights")'
                )
                if await more_button.is_visible(timeout=3000):
                    await more_button.click()
                    await page.wait_for_timeout(2000)
                else:
                    break
            except Exception:
                break
Loop ini mengklik tombol, menunggu 2 detik agar hasil baru dirender, lalu berhenti saat tombol sudah tidak terlihat. Dari pengujian saya, kebanyakan rute punya 1–3 halaman hasil.
Langkah 6: Ekstrak Data Penerbangan dengan CSS Selector
Sekarang kita parsing data penerbangan yang sebenarnya dari halaman yang sudah dimuat. Berikut selector-nya (terverifikasi per April 2026 — lihat bagian maintenance di bawah untuk alasan mengapa tanggal ini penting):
        flights = []
        cards = await page.query_selector_all("li.pIav2d")

        for card in cards:
            flight = FlightData()

            # Airline name
            airline_el = await card.query_selector(
                "div.sSHqwe span:not([class])"
            )
            if airline_el:
                flight.airline = (await airline_el.inner_text()).strip()

            # Departure time
            dep_el = await card.query_selector(
                'span[aria-label*="Departure time"]'
            )
            if dep_el:
                flight.departure_time = (await dep_el.inner_text()).strip()

            # Arrival time
            arr_el = await card.query_selector(
                'span[aria-label*="Arrival time"]'
            )
            if arr_el:
                flight.arrival_time = (await arr_el.inner_text()).strip()

            # Duration
            dur_el = await card.query_selector("div.gvkrdb")
            if dur_el:
                flight.duration = (await dur_el.inner_text()).strip()

            # Stops
            stops_el = await card.query_selector("div.EfT7Ae span")
            if stops_el:
                flight.stops = (await stops_el.inner_text()).strip()

            # Price
            price_el = await card.query_selector(
                "div.FpEdX span"
            )
            if price_el:
                flight.price = (await price_el.inner_text()).strip()

            # CO2 emissions
            co2_el = await card.query_selector("div.O7CXue")
            if co2_el:
                flight.co2_emissions = (
                    await co2_el.get_attribute("aria-label") or ""
                ).strip()

            flights.append(flight)

        await browser.close()
        return flights
Perlu diingat: class seperti pIav2d, sSHqwe, dan FpEdX dibuat oleh Google Closure Compiler dan bisa berubah kapan saja pada build berikutnya. Selector aria-label biasanya lebih stabil. Saya akan bahas strategi maintenance lengkap di bawah.
Langkah 7: Simpan Hasil ke JSON atau CSV
Terakhir, simpan data hasil scraping dengan timestamp (ini penting untuk price tracking nanti):
import json
from datetime import datetime
from dataclasses import asdict

async def main():
    params = SearchParams(
        origin="SFO",
        destination="JFK",
        departure_date="2026-05-15"
    )
    flights = await scrape_flights(params)

    output = {
        "search_date": datetime.now().isoformat(),
        "params": asdict(params),
        "flights": [asdict(f) for f in flights],
    }

    with open("flights.json", "w") as f:
        json.dump(output, f, indent=2)

    # Also save as CSV
    import pandas as pd
    df = pd.DataFrame([asdict(f) for f in flights])
    df["search_date"] = datetime.now().isoformat()
    df["route"] = f"{params.origin}-{params.destination}"
    df.to_csv("flights.csv", index=False)

    print(f"Scraped {len(flights)} flights")

asyncio.run(main())
Jalankan ini dan kamu akan mendapatkan flights.json serta flights.csv berisi hasilnya. Dari pengujian saya, pencarian SFO-JFK biasanya menghasilkan 30–80 opsi penerbangan dan memakan waktu sekitar 15–20 detik.
Panduan Bertahan dari Anti-Bot Saat Scrape Google Flights
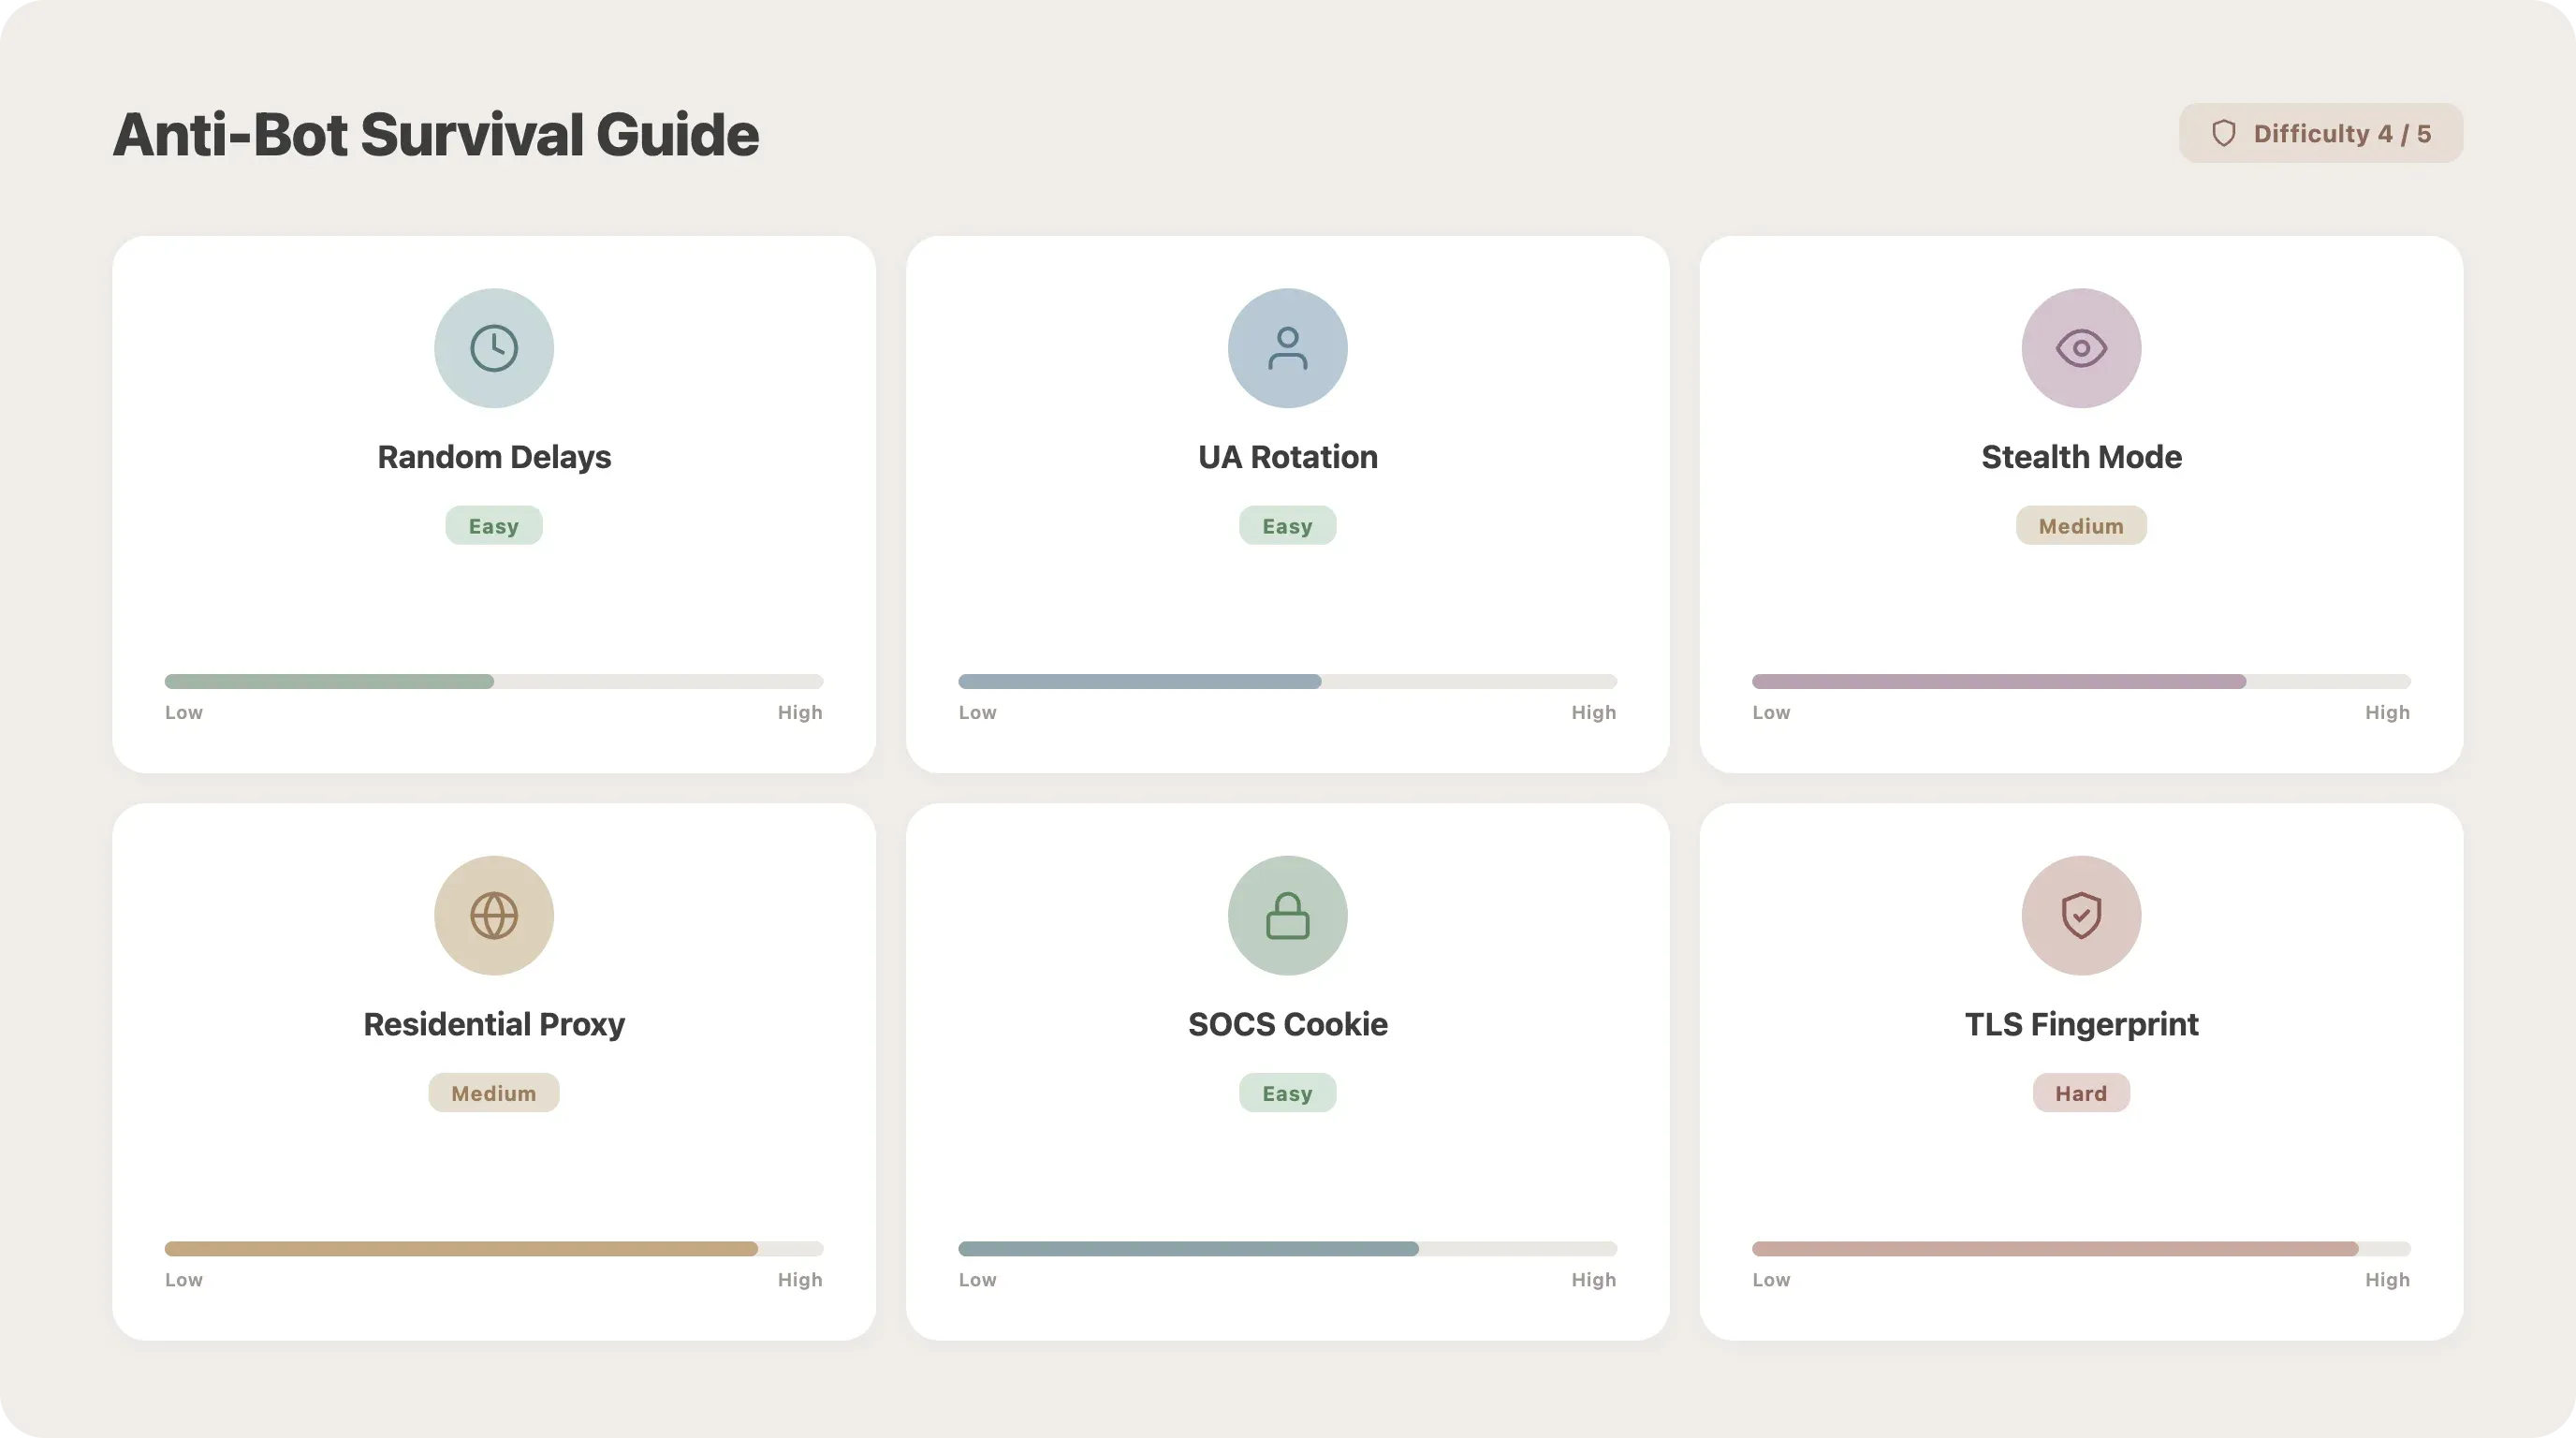
Kebanyakan tutorial berhenti di sini. Kebanyakan scraper gagal di sini. Google meluncurkan SearchGuard pada Januari 2025, dan itu merusak hampir semua scraper SERP dalam semalam. Google menyebutnya sebagai "hasil dari puluhan ribu jam kerja dan investasi bernilai jutaan dolar." Google Flights dinilai 4/5 tingkat kesulitannya untuk scraping.
Tidak ada artikel kompetitor yang membahas ini secara mendalam, padahal ini adalah alasan utama scraper orang-orang berhenti bekerja. Inilah tantangannya dan cara mengatasinya.
Delay Acak Antar Request
Pertahanan paling sederhana terhadap rate limiting. Dua baris kode, efektivitas sedang:
import time
import random

time.sleep(random.uniform(3, 7))
Tambahkan ini di antara perpindahan halaman. Interval tetap (misalnya tepat 5 detik setiap kali) justru jadi sinyal mencurigakan — jadi buat acak.
Rotasi User-Agent
Mengirim string user-agent yang sama pada setiap request sangat mudah terdeteksi. Rotasikan dari daftar berikut:
import random

USER_AGENTS = [
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 Chrome/125.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 14_5) AppleWebKit/605.1.15 Safari/605.1.15",
    "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 Chrome/124.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:126.0) Gecko/20100101 Firefox/126.0",
]

user_agent = random.choice(USER_AGENTS)
Bypass Deteksi Headless
Google memeriksa flag navigator.webdriver dan sinyal otomatisasi lainnya. Library playwright-stealth menangani sebagian besar hal ini, tetapi kamu juga sebaiknya memakai launch arguments yang ditunjukkan di Langkah 3. Flag pentingnya:
args=[
    "--disable-blink-features=AutomationControlled",
    "--disable-dev-shm-usage",
    "--no-first-run",
]
Ini membantu melewati deteksi dasar. SearchGuard melangkah lebih jauh — memantau kecepatan mouse, timing keyboard, dan pola scroll — tetapi untuk scraping volume sedang, stealth mode plus delay realistis biasanya sudah cukup.
Rotasi Proxy: Datacenter vs Residential
Untuk kebutuhan di luar beberapa pencarian saja, kamu akan butuh proxy. Perbedaannya penting:
| Fitur | Proxy Datacenter | Proxy Residential |
|---|---|---|
| Kecepatan | 100–1.000 Mbps | 10–100 Mbps |
| Tingkat keberhasilan (Google) | 20–40% | 85–95% |
| Biaya | US$0,10–US$0,50/IP/bulan | US$5–US$15/GB |
| Risiko terdeteksi | Tinggi | Sangat rendah |
Proxy residential kira-kira 180x lebih murah per request yang berhasil saat scraping situs yang dilindungi. Harga provider di 2026: Smartproxy mulai US$7/GB, Bright Data US$8,40/GB, Oxylabs US$8/GB.
Tambahkan proxy ke Playwright seperti ini:
browser = await pw.chromium.launch(
    proxy={"server": "http://proxy-host:port",
           "username": "user", "password": "pass"}
)
Menangani Popup Persetujuan Cookie
Pengguna konsisten menyebut popup "I agree to terms" sebagai penghambat: "first google will show you the 'I agree to terms and conditions' popup." Cara paling bersih adalah memasang cookie SOCS terlebih dulu (seperti di Langkah 3). Kalau itu tidak berhasil, klik popup-nya:
try:
    accept_btn = page.locator('button:has-text("Accept all")')
    if await accept_btn.is_visible(timeout=3000):
        await accept_btn.click()
        await page.wait_for_timeout(1000)
except Exception:
    pass  # No popup present
Catatan: teks tombol bisa berbeda tergantung locale — "Alle akzeptieren" dalam bahasa Jerman, "Tout accepter" dalam bahasa Prancis.
Referensi Cepat Anti-Bot
| Teknik | Tingkat Kesulitan | Efektivitas | Perlu Kode? |
|---|---|---|---|
| Delay acak (2–7 detik) | Rendah | Sedang | 2 baris |
| Rotasi user-agent | Rendah | Sedang | 5 baris |
| Bypass deteksi headless | Sedang | Tinggi | Playwright launch args |
| Plugin playwright-stealth | Sedang | 60–80% pada situs dasar | pip install |
| Rotasi proxy (datacenter) | Sedang | Sedang | Konfigurasi |
| Rotasi proxy (residential) | Sedang | 85–95% berhasil | Konfigurasi |
| Pre-set cookie consent (SOCS) | Rendah | Wajib | 1 baris |
Untuk laju yang aman dan direkomendasikan: beri jeda 10–20 detik antar request dengan rotasi IP. Ambang Google kira-kira 100 request/menit per IP sebelum terkena 429, dan volume berkelanjutan di atas 1.000 request/hari per IP bisa memicu blokir sementara.
Kenapa Selector Google Flights Sering Rusak (dan Cara Memperbaikinya)
Ini adalah titik sakit nomor satu, jauh di atas yang lain. Thread forum penuh dengan variasi kalimat seperti "all I get back is 14 empty lists." Setiap tutorial memberi kamu selector. Hampir tidak ada yang menjelaskan kenapa selector itu rusak.
Kenapa Selector Google Flights Berubah
Ada tiga penyebab utama:
-
Obfuscation dari Closure Compiler. Google memakai Closure Stylesheets untuk menghasilkan nama class seperti
BVAVmfdanYMlIzlewatgoog.setCssNameMapping(). Ini bisa berubah di setiap build — kadang setiap minggu. -
A/B testing. Pengguna yang berbeda bisa melihat struktur HTML yang berbeda pada waktu yang sama. Scraper kamu mungkin jalan di komputer kamu, tapi gagal untuk orang lain di wilayah lain.
-
Perbedaan locale. Pengguna UE melihat istilah, layout, dan bahkan field data yang berbeda dibanding pengguna AS.
Tulis Selector yang Lebih Tahan Lama
Prioritaskan selector yang mengacu pada makna, bukan tampilan:
# Fragile — breaks on every build
price_el = await card.query_selector("div.BVAVmf > div.YMlIz")

# More resilient — tied to accessibility labels
dep_el = await card.query_selector('span[aria-label*="Departure time"]')

# Also resilient — text-based matching
more_btn = page.locator('button:has-text("Show more flights")')
Urutan stabilitas selector (dari paling stabil ke paling rapuh):
- Atribut
aria-label— terikat pada aksesibilitas, jarang berubah - Atribut
data-*— sengaja ditambahkan untuk fungsi tertentu - Atribut
role— role ARIA bersifat semantik - Selector berbasis teks — cocok dengan konten yang terlihat
- Pencocokan sebagian nama class — misalnya
[class*="price"] - Nama class obfuscated lengkap — hindari jika memungkinkan
Tambahkan Fungsi Validasi
Jangan biarkan selector yang rusak diam-diam menghasilkan data kosong. Deteksi sejak awal:
import logging

logger = logging.getLogger(__name__)

def validate_flight(data: FlightData) -> bool:
    required = ["airline", "price", "departure_time",
                "arrival_time", "duration"]
    valid = True
    for field_name in required:
        if not getattr(data, field_name, ""):
            logger.warning(
                f"Missing '{field_name}' — selectors may need updating"
            )
            valid = False
    return valid
Jalankan ini untuk setiap penerbangan yang di-scrape. Kalau mulai muncul warning, saatnya inspeksi halaman dan memperbarui selector.
Strategi Maintenance Selector
- Cek selector setiap bulan, atau segera saat kualitas output menurun
- Simpan selector di dictionary konfigurasi terpisah agar mudah diperbarui
- Selector dalam artikel ini terakhir diverifikasi: April 2026
- Pertimbangkan library fast-flights sebagai alternatif — ia memakai decoding Protobuf alih-alih CSS selector, sehingga melewati masalah ini sepenuhnya (meski tetap punya titik rapuh sendiri ketika Google mengubah format data internal)
Dari Sekali Scrape Menjadi Google Flights Price Tracker Otomatis
Kebanyakan tutorial berhenti di "save to JSON." Judul artikel ini bilang "Price Alerts." Saatnya menepati janji.
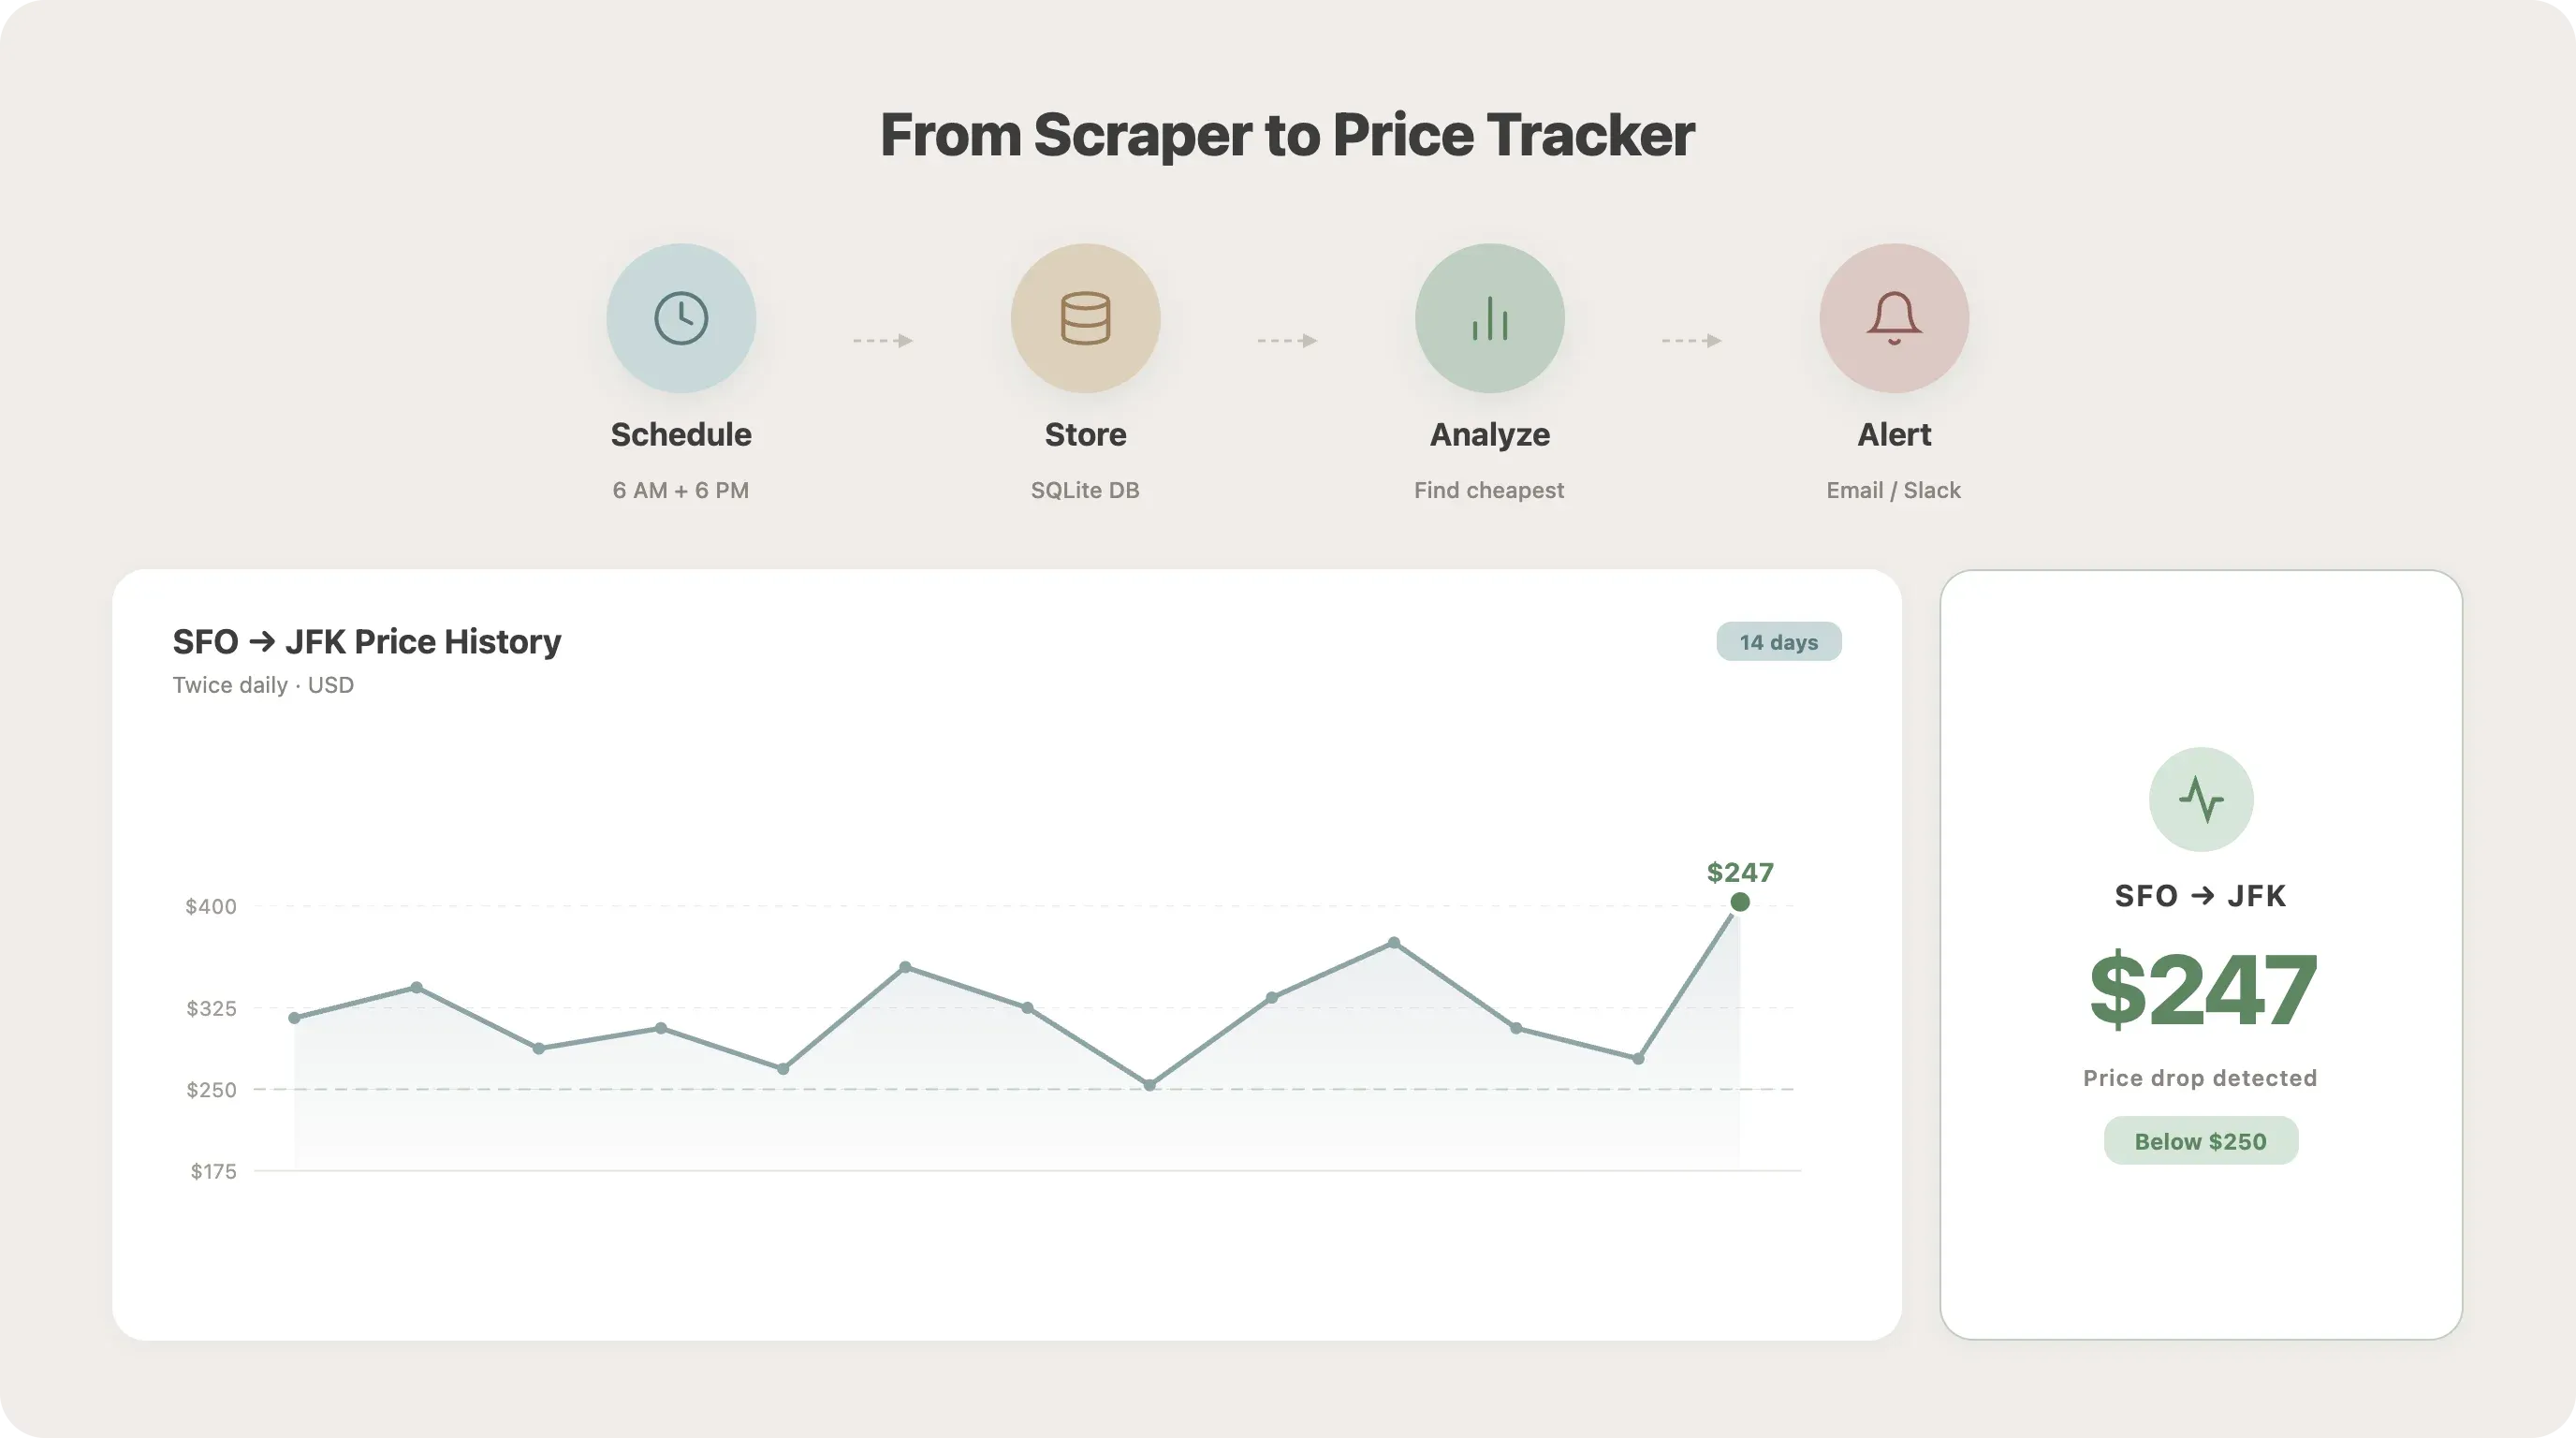
Jadwalkan Scraper untuk Jalan Otomatis
Opsi 1: Library Python schedule (paling sederhana, lintas platform):
import schedule
import time

def run_scraper():
    asyncio.run(main())

schedule.every().day.at("06:00").do(run_scraper)
schedule.every().day.at("18:00").do(run_scraper)

while True:
    schedule.run_pending()
    time.sleep(60)
Opsi 2: cron job (Linux/Mac):
# Run at 6 AM and 6 PM daily
0 6,18 * * * cd /path/to/scraper && python scraper.py
Opsi 3: Windows Task Scheduler — buat task dasar yang menjalankan python scraper.py sesuai jadwal yang kamu pilih.
Komprominya: semua opsi ini butuh mesin yang selalu menyala. Kalau kamu menjalankannya di laptop yang sering sleep, scraping akan terlewat.
Simpan Data Harga Historis
Ubah pendekatan dari menimpa file JSON menjadi menambahkan data ke database SQLite:
import sqlite3
from datetime import datetime

def init_db():
    conn = sqlite3.connect("flights.db")
    conn.execute("""
        CREATE TABLE IF NOT EXISTS flights (
            id INTEGER PRIMARY KEY AUTOINCREMENT,
            scrape_date TEXT NOT NULL,
            route TEXT NOT NULL,
            airline TEXT,
            departure_time TEXT,
            arrival_time TEXT,
            duration TEXT,
            stops TEXT,
            price_usd REAL,
            co2_emissions TEXT
        )
    """)
    conn.execute(
        "CREATE INDEX IF NOT EXISTS idx_route_date "
        "ON flights(route, scrape_date)"
    )
    conn.commit()
    return conn

def save_flight(conn, route: str, flight: FlightData):
    price_num = float(
        flight.price.replace("$", "").replace(",", "")
    ) if flight.price else None
    conn.execute(
        "INSERT INTO flights "
        "(scrape_date, route, airline, departure_time, "
        "arrival_time, duration, stops, price_usd, co2_emissions) "
        "VALUES (?, ?, ?, ?, ?, ?, ?, ?, ?)",
        (datetime.now().isoformat(), route, flight.airline,
         flight.departure_time, flight.arrival_time,
         flight.duration, flight.stops, price_num,
         flight.co2_emissions)
    )
    conn.commit()
Setelah seminggu scraping dua kali sehari, kamu akan punya cukup data untuk mulai melihat pola.
Analisis Tren Harga dan Setel Alert
Cari opsi termurah dari data historismu:
import pandas as pd
import sqlite3

conn = sqlite3.connect("flights.db")
df = pd.read_sql_query(
    "SELECT * FROM flights WHERE route = 'SFO-JFK'", conn
)
summary = df.groupby("scrape_date")["price_usd"].agg(
    ["min", "max", "mean"]
)
cheapest = df.loc[df["price_usd"].idxmin()]
print(
    f"Cheapest: ${cheapest['price_usd']:.0f} on "
    f"{cheapest['scrape_date']} ({cheapest['airline']})"
)
Picu email alert saat harga turun di bawah threshold yang kamu tentukan:
import smtplib
from email.mime.text import MIMEText

def send_price_alert(route, price, threshold, recipient):
    msg = MIMEText(
        f"Price drop alert! {route}: ${price:.0f} "
        f"(below your ${threshold:.0f} threshold)"
    )
    msg["Subject"] = f"Flight Deal: {route} at ${price:.0f}"
    msg["From"] = "alerts@example.com"
    msg["To"] = recipient

    with smtplib.SMTP_SSL("smtp.gmail.com", 465) as server:
        server.login("alerts@example.com", "your_app_password")
        server.send_message(msg)

# After each scrape, check for deals
min_price = df["price_usd"].min()
threshold = 250
if min_price < threshold:
    send_price_alert("SFO-JFK", min_price, threshold,
                     "you@email.com")
Untuk frekuensi scraping yang direkomendasikan: dua kali sehari sudah cukup untuk memantau harga pribadi (waktu acak mengurangi risiko deteksi). Setiap 4–6 jam jika kamu memantau untuk bisnis. Setiap jam hanya saat periode promo besar, dan itu pun sementara.
Jalur Mudah: Scheduled Scraper Thunderbit
Kalau mengelola cron job, server yang selalu hidup, dan konfigurasi proxy terdengar terlalu banyak infrastruktur untuk kamu rawat, Scheduled Scraper Thunderbit menangani use case yang sama tanpa semua kerumitan itu. Kamu cukup menjelaskan interval scraping dalam bahasa biasa, memasukkan URL Google Flights kamu, lalu scraper berjalan otomatis di infrastruktur cloud Thunderbit — dengan penanganan anti-bot bawaan dan hasil yang langsung diekspor ke Google Sheets, Excel, atau Airtable. Ini bukan pengganti penuh untuk pendekatan Python (kamu kehilangan fleksibilitas), tetapi untuk use case spesifik "saya ingin spreadsheet untuk memantau harga", ini adalah jalur tercepat. Kamu bisa mencobanya di paket gratis.
Kalau Python Terlalu Berlebihan: Cara No-Code untuk Scrape Google Flights
Setelah membangun semua di atas, jujur saja: ini cukup banyak komponen yang harus dikelola. Tidak semua orang butuh tingkat kontrol seperti ini. Selector bisa rusak, proxy perlu dirotasi, cron job perlu dipantau. Kalau tujuanmu adalah "memasukkan harga tiket ke spreadsheet secara rutin," ada opsi yang lebih cepat.
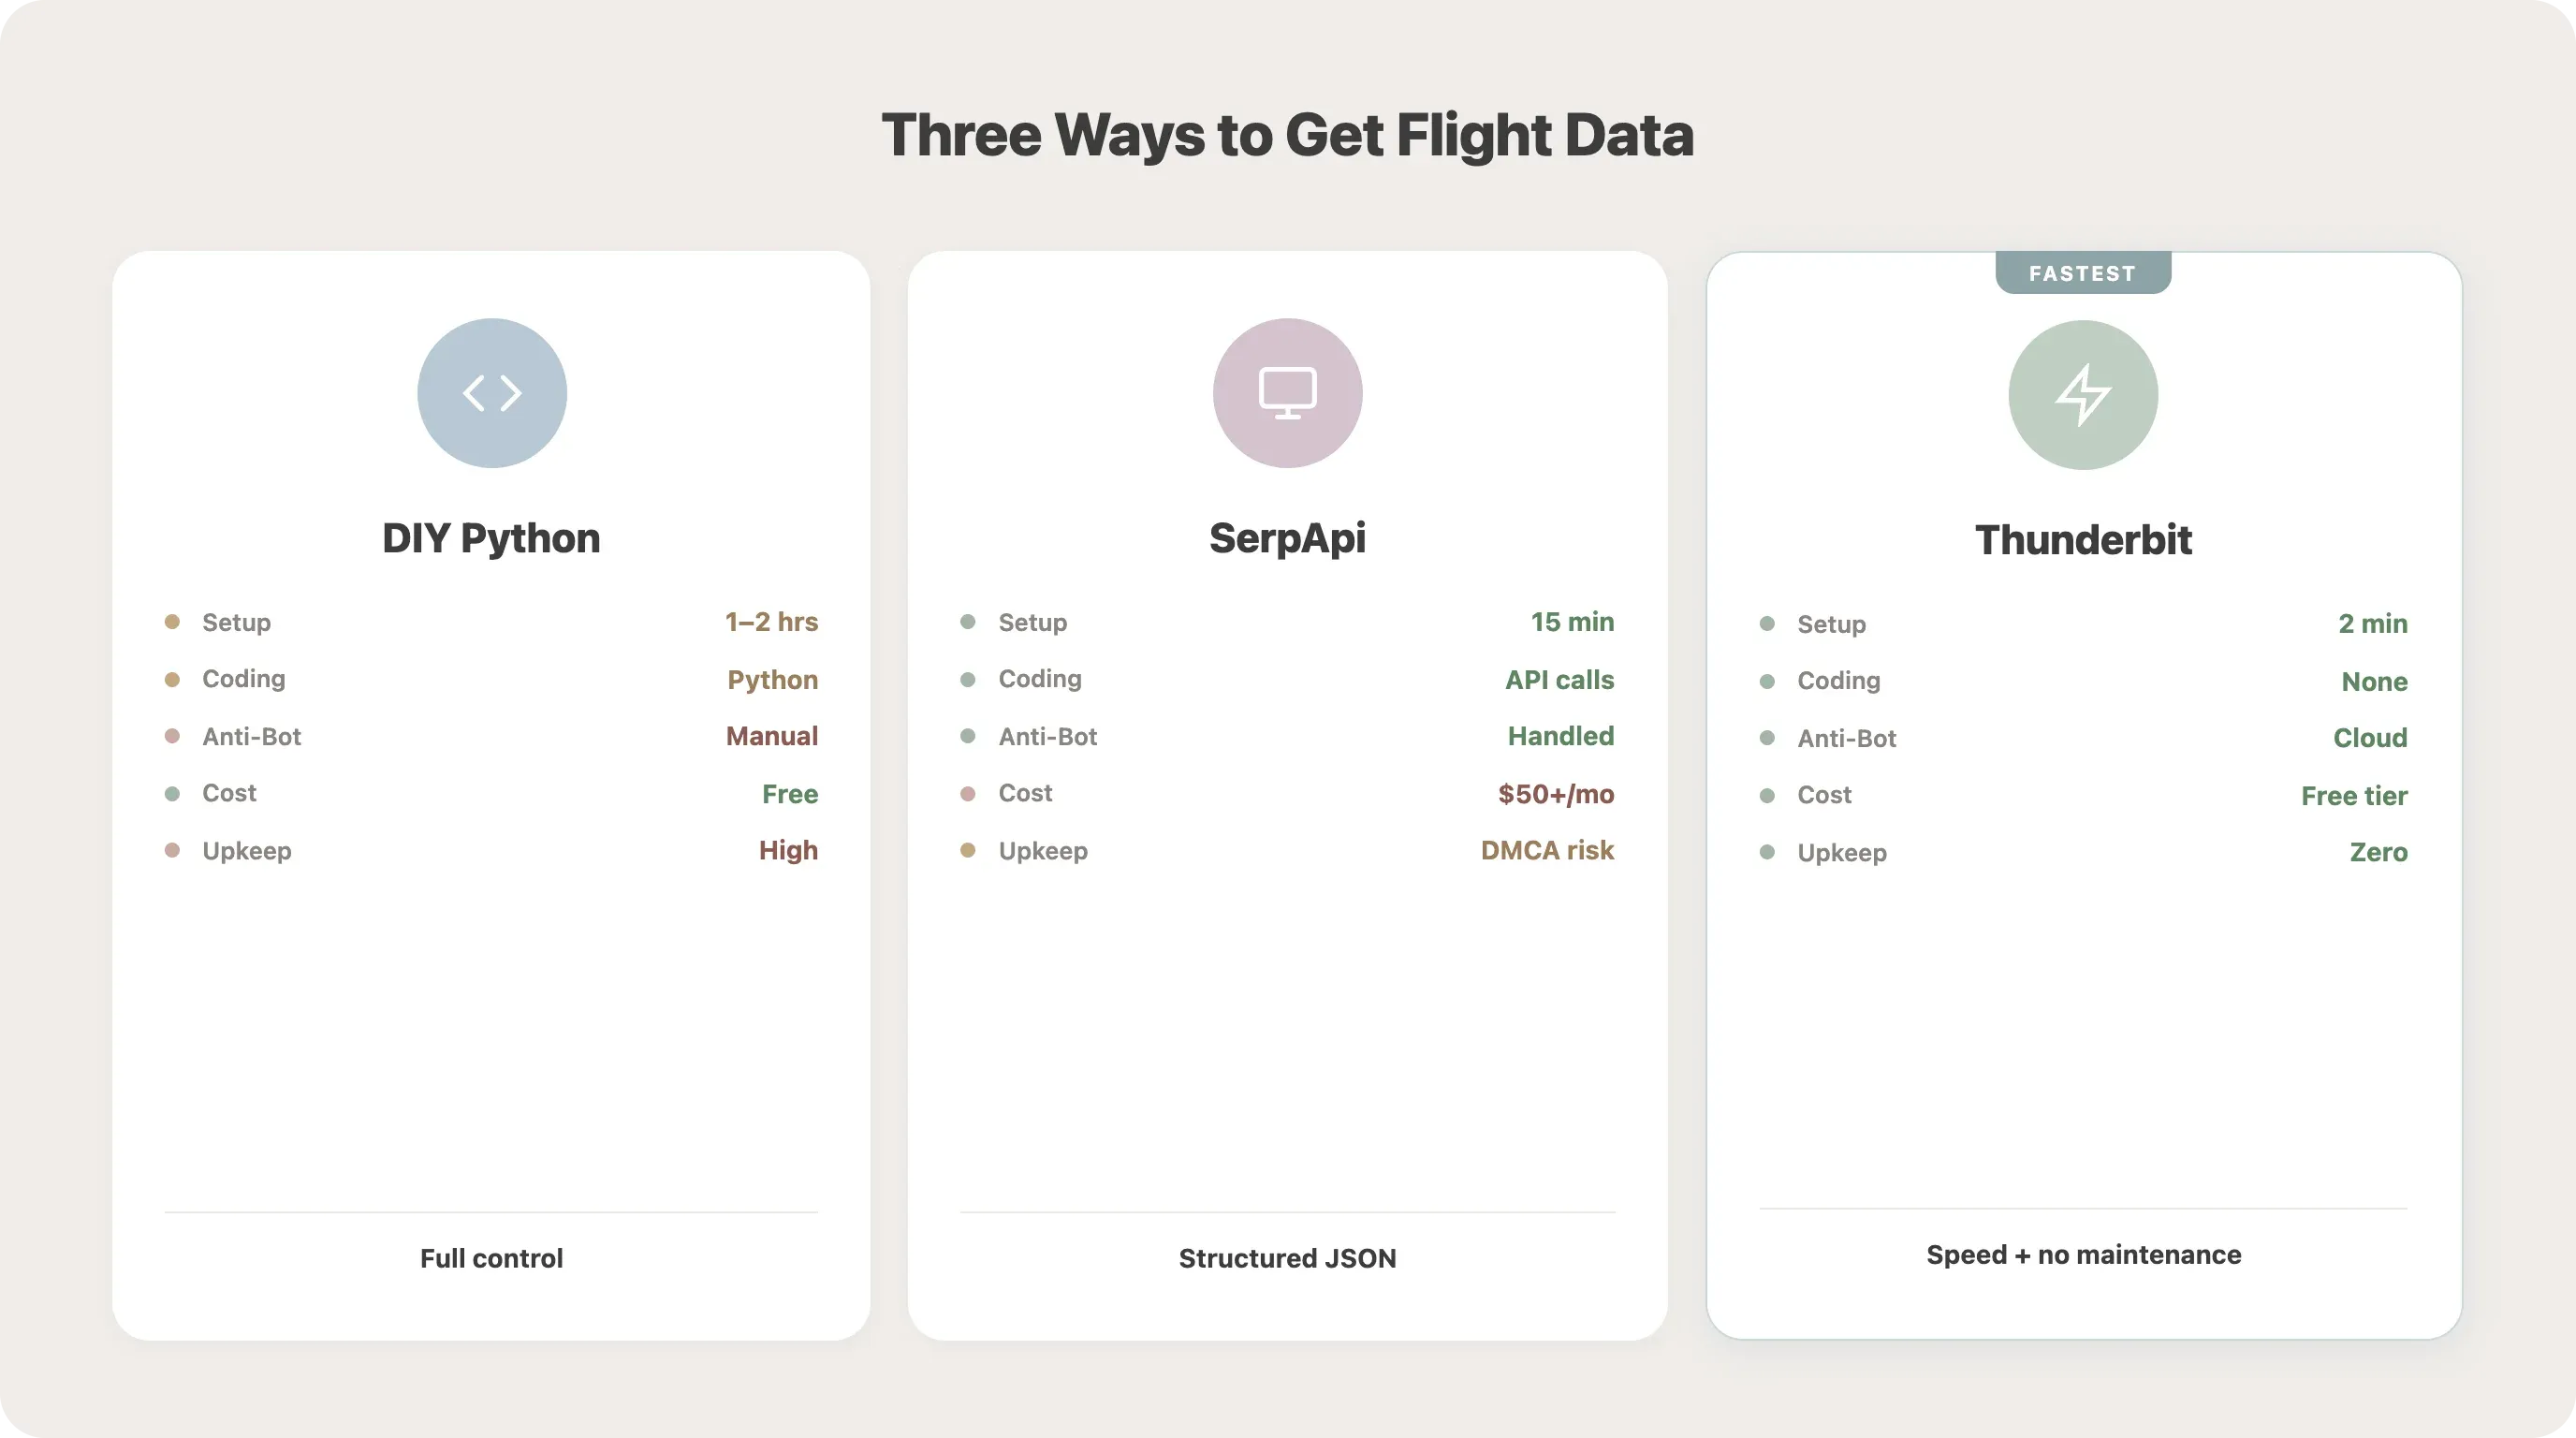
Perbandingan: Python DIY vs Layanan API vs Thunderbit
| Pendekatan | Waktu Setup | Perlu Coding | Menangani Anti-Bot | Penjadwalan | Biaya |
|---|---|---|---|---|---|
| DIY Playwright (tutorial ini) | 1–2 jam | Python (menengah) | Konfigurasi manual | Manual (cron) | Gratis + biaya proxy |
| Endpoint Google Flights SerpApi | 15 menit | Hanya API call | Ditangani | Via API | Sekitar US$50+/bulan |
| Thunderbit Chrome Extension | 2 menit | Tidak ada | Cloud scraping | Scheduler bawaan | Tersedia paket gratis |
Sedikit catatan soal SerpApi: Google mengajukan gugatan DMCA terhadap SerpApi pada Desember 2025, dengan tuduhan bahwa request mereka meningkat 25.000% dalam dua tahun. Ketidakpastian hukum ini layak dipertimbangkan kalau kamu sedang mengevaluasi penyedia API.
Cara Thunderbit Scrape Google Flights
Buka hasil pencarian Google Flights kamu di Chrome, klik tombol Thunderbit "AI Suggest Fields" — AI akan membaca halaman dan menyarankan kolom seperti airline, price, departure time, stops — tinjau field yang disarankan, lalu klik "Scrape." Hasilnya muncul dalam tabel yang bisa kamu ekspor ke Excel, Google Sheets, Airtable, atau Notion — semuanya tersedia di paket gratis.
Untuk use case price tracking secara khusus, Scheduled Scraper Thunderbit dan Cloud Scraping (yang bisa menangani 50 halaman secara bersamaan) menggantikan seluruh infrastruktur cron + proxy + server.
Python memberi kamu kontrol penuh dan kustomisasi tanpa batas. Thunderbit memberi kamu kecepatan dan tanpa maintenance. Pilih sesuai tujuan nyata kamu. Kalau kamu ingin mempelajari pendekatan no-code scraping lebih lanjut, lihat panduan kami tentang top no-code web scrapers.
Apakah Scraping Google Flights Legal? Yang Perlu Kamu Tahu
Pengguna forum sering menyinggung ini: "scraping Google Flights directly violates the TOS that Google has." Kekhawatiran yang wajar — apalagi karena API-nya sudah dihentikan dan tidak ada alternatif resmi.
Pelanggaran ToS vs Risiko Hukum
Syarat dan Ketentuan Google (diperbarui 22 Mei 2024) menyatakan bahwa pengguna tidak boleh "access or use the Services or any content through the use of any automated means (such as robots, spiders or scrapers)." Melanggar ToS berarti melanggar kontrak (ranah perdata) — itu tidak sama dengan melanggar hukum pidana.
Preseden hukum utama: hiQ v. LinkedIn (Ninth Circuit, 2022) menetapkan bahwa scraping data yang tersedia untuk publik tidak melanggar Computer Fraud and Abuse Act (CFAA). Namun, kasus itu berakhir dengan settlement, dan gugatan Google terhadap SerpApi pada Desember 2025 memakai teori hukum yang berbeda — DMCA Section 1201 (circumvention of technological protection measures) — yang berpotensi lebih serius.
Praktik Terbaik untuk Scraping yang Bertanggung Jawab
- Batasi laju request — beri jeda 10–20 detik dengan rotasi IP
- Jangan scrape data pribadi — harga tiket adalah data agregat yang ditampilkan publik
- Jangan melakukan bypass CAPTCHA secara programatis (ini area risiko DMCA)
- Gunakan data untuk riset pribadi, bukan untuk membangun produk komersial pesaing tanpa lisensi yang sesuai
- Pertimbangkan API resmi jika tersedia
Sumber Data Alternatif
Kalau scraping terasa terlalu berisiko untuk use case kamu, ada opsi API yang sah:
| Provider | Biaya | Free Tier | Catatan |
|---|---|---|---|
| SerpApi | US$75–US$3.750+/bulan | 250 pencarian/bulan | JSON Google Flights langsung (sedang dalam sorotan hukum) |
| Kiwi Tequila | Gratis (model afiliasi) | Tidak terbatas | Terbaik untuk startup dan testing |
| Amadeus | Bayar sesuai pemakaian | 2.000 request/bulan | 400+ maskapai, ada kemampuan booking |
| Skyscanner | Kustom | Perlu persetujuan | 52 pasar, 30 bahasa |
Kami juga menulis pembahasan lebih dalam tentang implikasi hukum web scraping kalau kamu ingin melihat gambaran lengkapnya.
Kesimpulan dan Poin Penting
Lumayan panjang juga. Berikut yang paling penting:
- Python + Playwright adalah pendekatan paling fleksibel untuk scraping Google Flights, tetapi perlu maintenance berkelanjutan
- Proteksi anti-bot (delay, rotasi user-agent, proxy residential) bukan opsional — itu krusial untuk reliability, terutama setelah SearchGuard
- Selector sering rusak — gunakan
aria-labeldan selector berbasis teks jika memungkinkan, validasi output kamu, dan lakukan maintenance rutin - Automasi dengan
scheduleatau cron untuk mengubah satu kali scrape menjadi price tracker sungguhan dengan data historis dan email alert - Thunderbit menawarkan alternatif no-code dengan scheduling bawaan, cloud scraping, dan penanganan anti-bot — ideal kalau tujuanmu adalah spreadsheet pelacak harga, bukan proyek coding
- Patuhi batas hukum — batasi laju request, scrape hanya data publik, dan pertimbangkan alternatif API untuk penggunaan komersial
Ambil kode dari tutorial ini, atau install ekstensi Chrome Thunderbit untuk jalur cepat. Apa pun pilihannya, kamu akan memantau harga tiket secara otomatis, bukan refresh Google Flights manual terus-menerus.
Untuk teknik scraping Python lainnya, lihat panduan kami tentang cara web scrape dengan Python dan tool web scraping Python terbaik.
FAQ
1. Apakah saya bisa scrape Google Flights tanpa Python?
Bisa. Layanan API seperti SerpApi dan Kiwi Tequila menyediakan data penerbangan terstruktur lewat API call (tanpa perlu otomatisasi browser). Untuk pendekatan full no-code, ekstensi Chrome Thunderbit bisa scrape hasil Google Flights langsung dari browser kamu dengan AI-suggested fields dan export satu klik.
2. Apakah Google memblokir scraping penerbangan?
Google memakai deteksi bot (SearchGuard), CAPTCHA, dan rate limiting. Dengan langkah anti-bot yang tepat — delay acak, rotasi user-agent, proxy residential, dan pengaturan browser stealth — kamu bisa menjaga scraping tetap andal pada volume menengah. Lihat bagian anti-bot di atas untuk teknik dan ambang batas spesifik.
3. Seberapa sering saya harus scrape Google Flights untuk price tracking?
Dua kali sehari (di waktu acak) sudah cukup untuk memantau harga pribadi dan menjaga risiko deteksi tetap rendah. Untuk monitoring bisnis, setiap 4–6 jam dengan rotasi proxy. Hindari scraping setiap jam kecuali saat promo tarif jangka pendek — itu sangat meningkatkan peluang diblokir.
4. Apakah ada Google Flights API gratis?
Official Google QPX Express API dihentikan pada April 2018. Tidak ada pengganti resmi yang gratis. Opsi gratis yang paling mendekati adalah Kiwi Tequila API (model afiliasi, pencarian tidak terbatas). SerpApi menawarkan 250 pencarian gratis per bulan. Bagi kebanyakan pengguna, scraping atau alat no-code seperti Thunderbit adalah jalur yang paling praktis.
5. Kenapa CSS selector Google Flights saya terus menghasilkan data kosong?
Google memakai Closure Compiler untuk membuat nama class obfuscated yang berubah di setiap build. A/B testing dan perbedaan locale juga membuat struktur HTML bervariasi antar pengguna. Solusinya: gunakan atribut aria-label dan selector berbasis teks alih-alih class name, tambahkan fungsi validasi untuk menangkap kerusakan lebih awal, dan cek selector kamu setiap bulan. Lihat bagian strategi maintenance selector untuk panduan lebih detail.
Pelajari Lebih Lanjut




