
Setiap daftar “best proxy API” berisiko mengulang kesalahan yang sama: Bright Data, Thunderbit, dan Apify diperlakukan seolah-olah mereka sedang bersaing untuk pekerjaan yang persis sama. Padahal tidak. Satu produk bisa menyediakan konektivitas IP terarah, yang lain mengembalikan JSON terstruktur, dan yang satu lagi menjalankan alur kerja scraping terjadwal. Membandingkan produk-produk itu hanya dari harga awal ibarat membandingkan selang taman dengan pabrik pengolahan air.
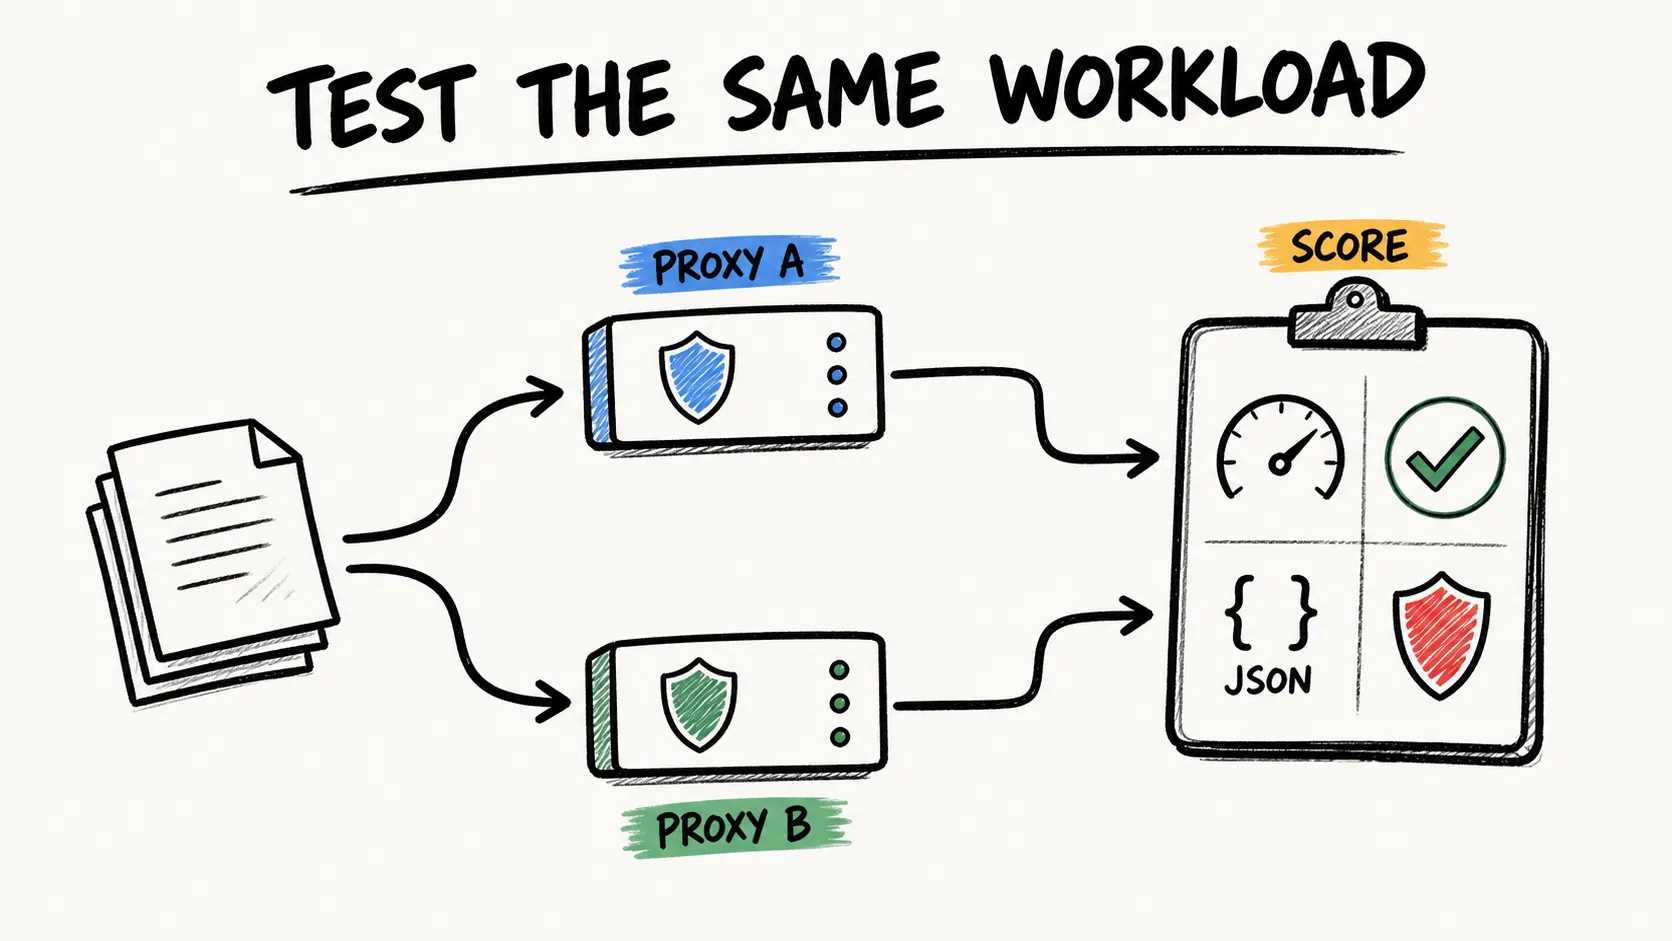
Panduan ini memetakan sepuluh produk proxy, managed scraping, extraction, dan platform berdasarkan dokumentasi resmi yang diambil pada 10 Agustus 2026. Panduan ini tidak menetapkan pemenang universal atau mengulang klaim tingkat keberhasilan yang tidak bisa dipindahkan. Sebaliknya, panduan ini memberi cara untuk mendefinisikan hasil yang valid, menyusun daftar pendek produk berdasarkan kategori, dan menjalankan pilot yang sah pada targetmu sendiri.
Mengapa “Proxy API” Tidak Hanya Berarti Satu Hal
Inilah sumber kebingungan di balik hampir setiap thread “proxy API mana yang harus saya pakai”: istilah ini mencakup setidaknya empat jenis produk yang benar-benar berbeda.
Raw proxy network memberi kamu IP dan kontrol routing — kamu masih harus menulis logika request, menangani retry, merender JavaScript jika diperlukan, dan mem-parsing apa pun yang kembali. Ini adalah definisi proxy yang paling dekat dengan buku teks: RFC 9110 mendeskripsikannya sebagai perantara penerusan pesan yang dipilih klien untuk digunakan, tidak lebih.
Managed unblocking atau browser API mengambil alih lebih banyak bagian dari siklus request. Kamu kirim URL, API memilih IP, merender halaman jika perlu, mencoba lagi saat gagal, lalu mengembalikan HTML, screenshot, atau kadang Markdown.
Extraction API naik satu level lagi — kamu memperoleh JSON terstruktur atau teks yang bersih, bukan HTML mentah yang harus diproses sendiri.
Scraping platform membungkus semua hal di atas, ditambah penjadwalan, penyimpanan, dan sering kali marketplace scraper siap pakai.
Alasan ini penting untuk artikel “memilih proxy API” sangat sederhana: harga dan “success rate” tidak bisa dibandingkan lintas kategori. Jaringan residential yang ditagih berdasarkan traffic dan managed API yang ditagih per request memecahkan masalah yang berbeda. Penyebut, pekerjaan yang sudah termasuk, dan semantik output-nya berbeda, jadi ranking berdasarkan harga utama akan menyesatkan. Karena itu, tiap profil di bawah selalu diawali dengan kategori produknya.
Satu hal lagi yang layak ditekankan sejak awal: punya akses proxy tidak otomatis memberi izin untuk scraping apa pun yang kamu mau. Otorisasi, ToS target, dan kewajiban privasi data adalah pembahasan yang terpisah dari “vendor mana yang punya kumpulan IP terbesar,” dan tidak ada proxy API — sebaik apa pun — yang bisa menghapus pembahasan itu.
Cara Mengevaluasi Sepuluh Opsi Ini
Tidak ada bobot tetap yang benar-benar adil dan cocok untuk semua tim. Arsip HTML mentah, pemantau harga yang sensitif lokasi, dan alur kerja enrichment data terstruktur punya kebutuhan yang berbeda. Mulailah dengan kriteria berikut, beri bobot yang totalnya 100, dan beri skor hanya berdasarkan bukti pilotmu sendiri atau requirement yang terdokumentasi:
| Kriteria | Apa yang diukur |
|---|---|
| Tingkat hasil valid | Persentase percobaan yang lolos validator semantik kamu, bukan sekadar HTTP 200 |
| Biaya per hasil valid | Seluruh biaya request, traffic, rendering, retry, parsing, penyimpanan, dan operator dibagi output valid |
| Kecocokan output | Respons mentah, HTML hasil render, screenshot, Markdown, atau data berbentuk skema |
| Kontrol koneksi dan geo | Wilayah, kota, ASN, sesi, rotasi, header, cookie, dan kontrol protokol yang benar-benar kamu perlukan |
| Observabilitas dan batas | Request ID, header unit penagihan, log, replay, kontrol concurrency, dan penghenti anggaran |
| Bukti kepatuhan | Pernyataan sumber, kontrak, kelayakan target, auditabilitas, dan proses dukungan |
| Upaya engineering | Integrasi, pemeliharaan parser, monitoring, dan waktu perbaikan manual |
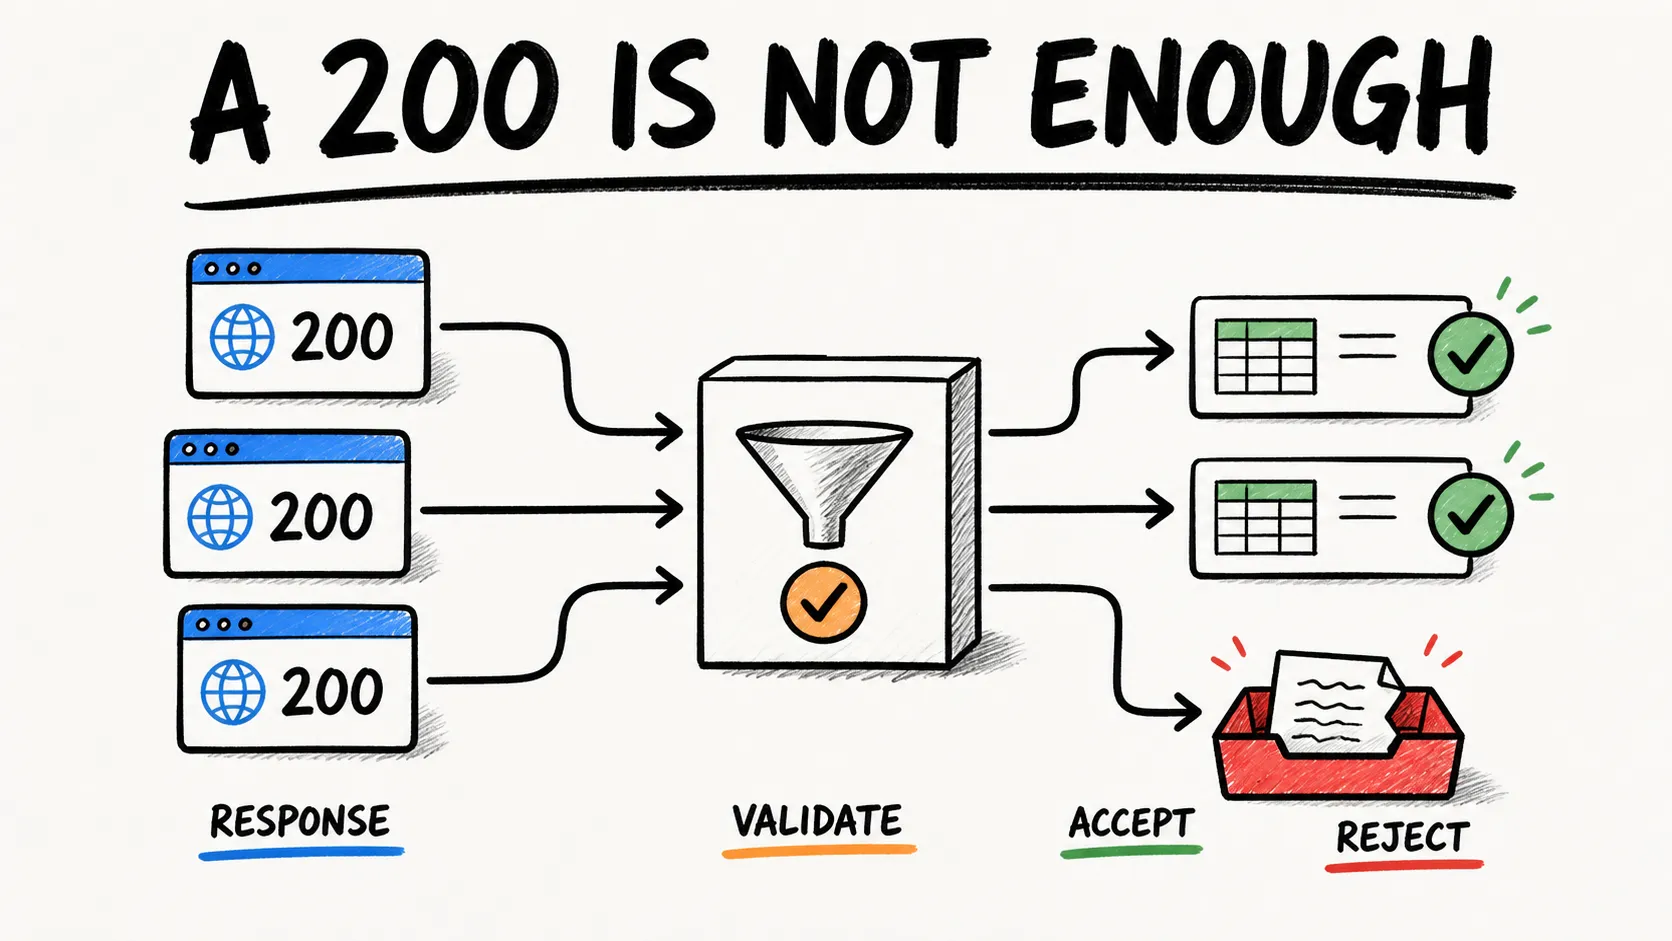
Biarkan sel yang tidak didukung tetap kosong atau beri tanda “tidak berlaku”. Tujuannya adalah keputusan yang spesifik untuk beban kerja kamu, bukan skor yang memberi kesan presisi palsu.
1. Thunderbit
Thunderbit adalah pengecualian di daftar ini karena ini adalah extraction API yang berdekatan, bukan raw proxy network yang kamu colokkan ke HTTP client. Dokumentasi API publiknya menjelaskan Distill untuk Markdown, Extract untuk JSON berbentuk skema, dan Batch untuk kumpulan URL asinkron. Batasan itu bisa menghapus beberapa langkah lanjutan ketika output yang kamu inginkan adalah konten atau record, bukan koneksi proxy.
Perbedaan praktisnya langsung terasa saat kamu mengirim request. Dengan proxy API tradisional, panggilan yang sukses hanya memberi HTML mentah — pekerjaan baru setengah selesai. Dengan endpoint POST /extract milik Thunderbit, kamu mengirim URL target dan JSON Schema yang menjelaskan field yang kamu inginkan, lalu hasilnya sudah berupa JSON terstruktur yang cocok dengan skema itu. Tidak perlu menulis CSS selector, tidak perlu memelihara parser saat situs mengubah desain halaman produknya di Q3.
Batas produk ini memang jadi selling point yang nyata: caller bisa mendeskripsikan skema output alih-alih mempertahankan stack proxy, renderer, dan parser terpisah. Tetap perlu pilot sungguhan. Validasi kelengkapan field, dukungan target, latensi, konsumsi unit saat ini, concurrency, dan perilaku kegagalan pada URL yang diizinkan sebelum mengadopsinya.
Fitur utama:
- Output terstruktur secara default — JSON yang cocok dengan skema yang kamu definisikan, bukan HTML mentah
- Kontrol rendering dan routing terdokumentasi — dievaluasi sebagai bagian dari endpoint extraction, bukan sebagai produk proxy mentah
- Batasan API HTTP — Distill, Extract, dan Batch mencakup Markdown, JSON terstruktur, dan kumpulan URL asinkron
- Mode batch untuk job multi-URL asinkron, berguna untuk lebih dari beberapa halaman
- Extraction berbasis skema yang mengurangi, tetapi tidak menghilangkan, kebutuhan validasi dan pemeliharaan di level field
Unit penagihan: Distill dan Extract menggunakan unit per halaman yang terdokumentasi, bukan bandwidth proxy. Periksa harga Thunderbit dan dokumentasi API terbaru sebelum menyusun anggaran karena unit dan paket bisa berubah.
Cocok untuk: developer yang menginginkan data terstruktur yang tervalidasi sejak awal dan tidak ingin membangun serta memelihara pipeline rotasi proxy-plus-parser sendiri.
Di mana proxy API tradisional masih unggul: jika kamu butuh HTML mentah untuk pipeline kustom, pengarsipan massal, atau protokol non-HTTP, model output terstruktur Thunderbit bukan alat yang tepat — kamu justru ingin salah satu dari sembilan entri berikutnya.
Lewati Proxy untuk Extraction Berbasis AI Agentic web scraper Thunderbit menangani rendering dan penghalang anti-bot sendiri, jadi banyak pekerjaan tidak memerlukan proxy API terpisah sama sekali. Get Started Free
2. Bright Data
Bright Data adalah yang paling mendekati incumbent di industri ini, dengan residential, datacenter, ISP, dan mobile proxy network plus produk managed terpisah bernama Web Unlocker. Kata “terpisah” itu penting — Bright Data bukan satu produk, melainkan keluarga produk, dan harga/perilakunya sangat bervariasi tergantung bagian mana yang kamu beli.
Dokumentasi Residential network mencantumkan targeting berdasarkan negara, region, kota, ZIP, dan ASN. Web Unlocker adalah lapisan managed terpisah dengan billing pay-per-success dan batas pengeluaran bulanan. Kontrol-kontrol ini berguna, tetapi akurasi dan kecocokannya tetap perlu diverifikasi dalam pilot pembeli; panduan ini tidak menjalankan benchmark geo lintas vendor.
Fitur utama:
- Jenis proxy residential, datacenter, ISP, dan mobile dengan geo-targeting granular
- Web Unlocker managed API dengan billing pay-per-success dan batas pengeluaran
- Pernyataan sourcing opt-in yang terdokumentasi untuk IP residential
- Field debug (request ID, status tagihan, negara peer) untuk troubleshooting
Unit penagihan: produk proxy mentah dan Web Unlocker memakai unit yang berbeda. Pastikan produk yang tepat, komitmen, kelayakan target, dan tarif saat ini di halaman harga resmi sebelum menyusun anggaran.
Cocok untuk: tim enterprise yang membutuhkan semua jenis proxy yang tersedia dan bersedia mengelola lineup produk yang sedikit lebih kompleks demi skala.
3. Oxylabs
Oxylabs berada di kelas yang sama dengan Bright Data — residential, datacenter, ISP, dan mobile proxy network plus produk Web Unblocker terpisah untuk akses managed. Penanganan sesi menggunakan header khusus X-Oxylabs-Session-Id, memberi kontinuitas IP dalam jendela waktu terbatas, yang sangat berguna untuk alur multi-langkah seperti hasil pencarian bertingkat.
Fitur utama:
- Berbagai jenis proxy dengan kontrol geo terdokumentasi dari vendor
- Web Unblocker untuk rendering JS dan managed unblocking, ditagih per GB pada harga saat ini
- Persistensi sesi melalui session ID berbasis header
- Header job/session disertakan dalam contoh respons untuk debugging
Unit penagihan: halaman Web Unblocker yang diambil untuk riset ini menggunakan paket berbasis GB dengan batas rate spesifik paket; produk Oxylabs lain memakai unit berbeda. Periksa kembali halaman produk yang dipilih saat ini.
Cocok untuk: operasi bervolume besar yang membutuhkan keberagaman geo dan tidak keberatan mengelola penagihan berbasis GB lintas produk.
4. ScrapingBee
ScrapingBee adalah managed HTML API: kamu kirim URL, lalu halaman dikembalikan, dan kamu umumnya tetap bertanggung jawab atas validasi dan parsing lanjutan. Dokumentasinya menampilkan sistem kredit yang bergantung pada fitur, Auto-Mode, header biaya, dan parameter max_cost yang bisa membatasi biaya request Auto-Mode individual.
Fitur utama:
- Auto-Mode yang menaikkan konfigurasi secara otomatis (tier proxy, rendering) sampai berhasil
- Parameter
max_costuntuk membatasi pengeluaran per request - Percobaan Auto-Mode yang gagal di semua konfigurasi tidak memakai kredit sama sekali
- Header penggunaan/biaya pada setiap respons untuk pelacakan real-time
Unit penagihan: kredit bervariasi tergantung rendering, tier proxy, dan fitur lain yang diaktifkan. Periksa ladder kredit dan batas concurrency saat ini, jangan menganggap paket dasar sebagai harga per request.
Cocok untuk: proyek kecil hingga menengah yang lebih mengutamakan setup cepat daripada kustomisasi mendalam — ladder kredit membuat biaya benar-benar bisa diprediksi setelah kamu memahaminya.
5. ZenRows
ZenRows menggabungkan Universal Scraper API, Scraping Browser, dan residential proxy dalam satu ekosistem, dengan pengali request untuk rendering JavaScript dan penggunaan premium proxy. Satu keunikan yang perlu dicatat jelas: ZenRows menghitung respons HTTP 404 dan 410 sebagai “berhasil” untuk tujuan penagihan, yang jadi pengingat bagus bahwa “berhasil” di invoice vendor dan “berhasil” di validatormu belum tentu sama.
Fitur utama:
- Toolkit gabungan: scraper API, browser automation, dan residential proxy
- Beberapa format output yang diklaim (JSON, Markdown, screenshot, plaintext)
- Komponen rendering dan akses yang dikelola dan perilaku saat ini harus diverifikasi pada target yang diizinkan
- Batas penggunaan berbasis URL yang menunda request sampai kapasitas tambahan dibeli
Unit penagihan: kredit request dengan pengali terdokumentasi untuk fitur seperti rendering JavaScript dan premium proxy. Konfirmasi paket dan aturan pengali terbaru.
Cocok untuk: tim yang ingin mengevaluasi scraper API, browser, dan produk proxy dari satu vendor, sambil menguji produk terpilih pada target yang diizinkan.
Pola Apa yang Mulai Terlihat?
Lima tool sudah lewat, polanya sudah jelas: hampir tidak ada batas produk yang benar-benar persis sama dengan copy marketing mereka. Bright Data dan Oxylabs sama-sama memisahkan “raw proxy” dari “managed unblocking” menjadi produk yang berbeda dengan model harga berbeda, yang berarti homepage vendor sendiri tidak langsung menjawab “berapa biaya yang akan saya keluarkan” — kamu harus memilih produk spesifik dulu. ScrapingBee dan ZenRows sama-sama memakai billing berbasis kredit dengan pengali bertahap, yang lebih transparan daripada harga per GB tetapi tetap mengharuskan kamu membaca detail kecil tentang pemicu pengali.
Tema yang berulang lainnya: “request berhasil” didefinisikan oleh vendor, bukan oleh kamu. ZenRows menghitung 404 sebagai sukses yang ditagihkan bukan hal yang jahat — hanya saja itu definisi yang tidak sama dan bisa merugikanmu jika kamu mengira “ditagih sebagai sukses” berarti “data yang saya butuhkan memang ada.”
6. Scrape.do
Scrape.do menjalankan Managed Web Scraping API dengan model billing “Successful API Credits” — kamu hanya ditagih untuk endpoint inti saat ini, karena navigasi harga perusahaan sendiri mencantumkan produk proxy dan scraping-browser terpisah sebagai “coming soon” (layak dicek sebelum menganggap Scrape.do menjual raw proxy hari ini). Surface API-nya mencakup geo-targeting, sesi, header, cookie, dan pengalih mode browser/proxy.
Fitur utama:
- Billing berbasis kredit yang menghentikan request begitu batas bulanan tercapai (tanpa overage tak terduga secara default)
- Sakelar premium-network tersedia untuk target yang memenuhi syarat
- Kontrol sesi dan geo yang sebaiknya diuji pada workload yang persis sama
- Mode rendering browser untuk halaman yang berat JavaScript
Unit penagihan: paket successful API credits dengan batas bulanan; verifikasi batas paket saat ini, concurrency, dan aturan kapasitas tambahan.
Cocok untuk: tim yang hemat anggaran dan ingin managed API tanpa komitmen ke harga berbasis GB.
7. Smartproxy / Decodo
Smartproxy telah berganti nama menjadi Decodo, dan halaman harga residential proxy terkininya mendokumentasikan paket per-GB dan pay-as-you-go dengan targeting level ASN serta session rotating dan sticky melalui HTTP(S)/SOCKS5. Halaman yang diambil merujuk riset Proxyway untuk klaim performa yang ditampilkan. Asal-usul data itu berguna sebagai konteks, tetapi bukan bukti bahwa hasil yang sama akan berlaku untuk target, wilayah, jendela waktu, atau konfigurasi akun lain.
Fitur utama:
- Residential, datacenter, ISP, dan mobile proxy
- Targeting level ASN dan lokasi
- Dukungan session rotating dan sticky melalui HTTP(S) dan SOCKS5
- Klaim performa bersumber dari riset pihak ketiga, bukan dilaporkan sendiri
Unit penagihan: halaman residential yang diambil untuk riset ini mendokumentasikan opsi per-GB dan pay-as-you-go. Pastikan tarif saat ini dan kontrol yang termasuk di halaman produk yang dipilih.
Cocok untuk: pemantauan e-commerce dan operasi skala menengah yang menginginkan variasi proxy tanpa harga enterprise.
8. Scrapfly
Scrapfly adalah managed scraping API dengan fitur opsional Anti Scraping Protection (ASP). Dokumentasinya sendiri secara eksplisit menyebut bahwa pertahanan target terus berkembang, pemulihan setelah diblokir bisa memakan waktu yang tidak pasti, dan biaya terkait resource bisa berubah. Catatan ini penting: managed access bukan jaminan akses yang tahan lama.
Fitur utama:
- ASP dengan eskalasi biaya dinamis berdasarkan tingkat kesulitan target
- Parameter
cost_budgetdan perlindungan fairness untuk failed scrape (status code yang dikecualikan tidak dihitung melawanmu) - Header biaya di level respons dan dashboard replay/debug request
- Rendering browser opsional dan pool residential proxy
Unit penagihan: kredit dengan biaya yang bisa berubah tergantung pool proxy, rendering, dan konfigurasi ASP. Header respons, cost_budget, dan limit proyek membantu mengukur dan membatasi biaya itu.
Cocok untuk: tim yang secara khusus memprioritaskan anti-detection tooling dan ingin visibilitas atas berapa biaya nyata setiap request dalam bentuk kredit.
9. Zyte
Zyte (sebelumnya Scrapinghub, bagi yang sudah lama berkecimpung di ruang ini) menawarkan API yang dapat mengembalikan respons HTTP mentah, HTML hasil render browser, screenshot, atau objek terstruktur yang diekstrak otomatis, tergantung request. Harga ditetapkan per target/tier request, bukan tarif flat, dan — seperti beberapa tool lain di sini — respons gagal serta request yang dibatasi rate tidak ditagih.
Fitur utama:
- Berbagai mode output: HTTP, browser, screenshot, atau auto-extraction
- Integrasi native Scrapy untuk developer Python yang sudah memakai ekosistem itu
- Batas pengeluaran dan threshold pemblokiran yang bisa kamu atur dari awal
- Harga per target/request tier yang menyesuaikan kesulitan situs
Harga: tersedia pay-as-you-go; tarif pasti tergantung tier target.
Cocok untuk: tim yang membutuhkan managed HTTP/browser/extraction API, terutama yang sudah menggunakan Scrapy. Kesesuaian target dan stabilitas tier harus dibuktikan lewat pilot.
10. Apify
Apify bukan sekadar proxy API, melainkan platform scraping penuh — compute, “Actors” siap pakai (istilah mereka untuk scraper terkemas), penjadwalan, penyimpanan dataset, dan layanan proxy semuanya dibundel bersama dengan billing terpisah untuk tiap item. Itu bisa sangat berguna kalau kamu menginginkan marketplace scraper siap pakai untuk situs-situs umum; tapi jadi rumit kalau yang kamu butuhkan hanya proxy dan malah diberi platform.
Fitur utama:
- Marketplace Actors siap pakai untuk target scraping umum
- Layanan proxy residential, datacenter, dan SERP tersedia sebagai salah satu komponen
- Penjadwalan, penyimpanan dataset, dan dukungan webhook untuk otomasi workflow
- Kode status proxy diagnostik yang detail untuk debugging request gagal
Unit penagihan: penggunaan platform prabayar dapat mencakup biaya compute, Actor, proxy, dataset, dan storage yang terpisah. Modelkan seluruh workload, jangan hanya mengutip baris proxy saja.
Cocok untuk: tim yang lebih membutuhkan scraper siap pakai dan otomasi workflow daripada kontrol proxy mentah.
Masalah Biaya Tersembunyi: Gunakan Biaya per Hasil Valid
Harga daftar hanyalah satu pembilang. Penyebut yang berguna bukan request yang dikirim, bytes yang ditransfer, atau respons HTTP 200. Penyebut yang benar adalah jumlah output yang memenuhi validator semantikmu sendiri.
Tentukan pengukuran sebelum pilot:
cost_per_1,000_valid = total_pilot_cost / valid_results * 1,000
total_pilot_cost harus mencakup biaya yang memang berbeda antar kandidat: unit request atau network, pengali rendering dan premium-routing, retry, parsing, compute, penyimpanan, monitoring, dan waktu operator. valid_results hanya boleh menghitung respons dengan field yang dibutuhkan, locale yang benar, kesegaran yang dapat diterima, dan tanpa halaman challenge atau consent yang menyamar sebagai konten.
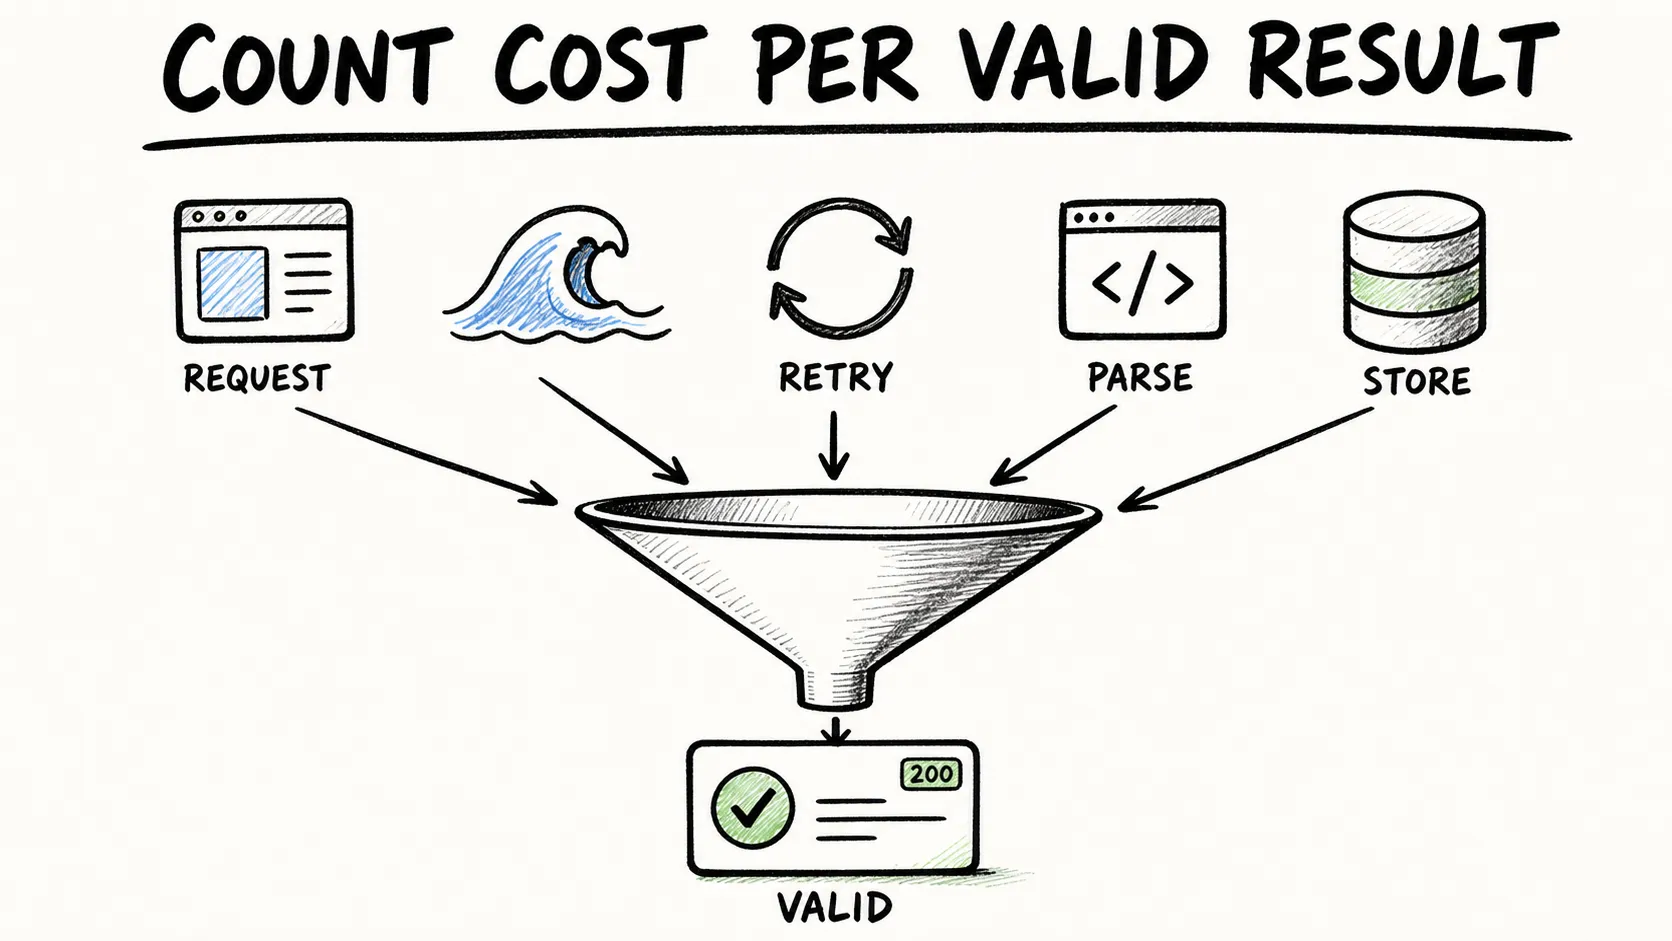
Pertimbangkan contoh yang sengaja hipotetis. Provider A biayanya $3,00 untuk satu batch uji dan menghasilkan 600 record valid; Provider B biayanya $3,50 dan menghasilkan 950. Biaya normalisasi mereka menjadi $5,00 dan sekitar $3,68 per 1.000 record valid. Angka-angka itu hanya menunjukkan aritmetika. Itu bukan klaim tentang provider, kelas target, atau sistem proteksi mana pun.
Untuk extraction API seperti Thunderbit, masukkan nilai dan biaya menerima data berbentuk skema alih-alih HTML mentah. Untuk raw proxy, masukkan pekerjaan parser dan pemeliharaan downstream. Tidak ada batas yang selalu lebih murah; jawabannya bergantung pada output yang benar-benar dibutuhkan workload.
Kalau kamu ingin memahami mekanisme yang lebih dalam tentang bagaimana extraction berbasis AI menangani ini secara berbeda dari scraping berbasis selector, pembahasan AI web scraping kami menjelaskan pendekatan dasarnya.
Proxy API vs. AI Scraping API: Apakah Anda Benar-Benar Butuh Proxy?
Setiap artikel peringkat teratas tentang topik ini mengasumsikan pembaca membutuhkan proxy. Tidak satu pun yang mempertanyakan premis itu — padahal aneh, mengingat sekarang banyak orang justru menanyakan hal yang lebih mendasar: apakah saya benar-benar butuh HTML mentah, atau saya cuma butuh datanya?
| Dimensi | Traditional Proxy API | AI Scraping API (mis. Thunderbit) |
|---|---|---|
| Yang kamu terima | HTML mentah yang kamu parse sendiri | JSON terstruktur yang cocok dengan skema kamu |
| Perilaku managed access | Dikendalikan oleh stack proxy/client kamu atau produk managed terpisah | Menjadi bagian dari layanan extraction dan tunduk pada batas terdokumentasi |
| Parsing/extraction | Kamu membangun dan memelihara parser | AI mengekstrak field sesuai skema |
| Pemeliharaan saat layout berubah | Tim kamu menangani perubahan selector dan parser | Layanan menangani lebih banyak logika extraction, tetapi tim kamu tetap memvalidasi output |
| Paling cocok untuk | Pengarsipan HTML massal, pipeline kustom, protokol niche | Data terstruktur, ingestion RAG, daftar leads |
| Batas integrasi | Endpoint proxy atau API provider | Endpoint extraction HTTP seperti Distill, Extract, dan Batch |
Inti yang jujur: jika pipeline kamu benar-benar membutuhkan HTML mentah, kontrol sesi level proxy, atau stack request kustom, traditional proxy API mungkin adalah batas produk yang tepat. Jika output yang dibutuhkan adalah data produk terstruktur, record lead, atau hasil pencarian yang siap masuk spreadsheet atau pipeline retrieval, extraction API bisa memindahkan routing, rendering, dan extraction ke satu batas layanan. Itu mengubah sudut pandang keputusan tanpa membuktikan bahwa salah satu model selalu lebih baik.
Untuk tim yang secara spesifik mencari lead atau record terstruktur, bukan halaman mentah, panduan AI lead generation dan AI for sales menunjukkan jenis workflow yang secara alami menghasilkan baris terstruktur.
Lihat Apakah Anda Benar-Benar Perlu Proxy Paket gratis mencakup 6 halaman per bulan — uji apakah rendering bawaan Thunderbit menangani situs targetmu sebelum membeli kapasitas proxy. Get Started Free
Pertanyaan Kepatuhan dan Sourcing Harus Masuk dalam Evaluasi
Akses teknis dan otorisasi adalah hal yang terpisah. Sebelum pilot, dokumentasikan URL mana saja yang diizinkan organisasi untuk diambil, field data yang dibutuhkan, aturan retensi, kewajiban privasi, ketentuan target yang berlaku, dan penanggung jawab eskalasi. Langganan proxy tidak memperluas izin-izin itu.
Untuk jaringan residential, minta provider dokumentasi sourcing dan consent terkini, aturan kelayakan target, syarat identitas atau KYC, bukti audit, dan proses respons ketika rentang IP atau target menjadi tidak tersedia. Pernyataan vendor resmi berguna sebagai bukti, tetapi bukan audit rantai pasok independen.
Selama pilot, catat observasi region dan ASN bila relevan, tetapi jangan menyimpulkan bahwa satu lookup membuktikan sumber seluruh network. Perlakukan perbedaan sebagai pertanyaan untuk provider dan tim procurement. Jika otorisasi berubah, pemeriksaan kebijakan gagal, batas retry tercapai, atau cap anggaran terpicu, hentikan run.
Untuk layanan extraction dan platform, tanggung jawab sourcing dan akses tidak hilang; hanya berpindah ke batas layanan yang berbeda. Pembeli tetap harus meninjau kontrak, kebijakan penggunaan yang didukung, perilaku kegagalan, dan penanganan data. Panduan ini adalah panduan evaluasi teknis, bukan nasihat hukum.
Perbandingan Sekilas
| Tool | Batas produk | Output umum | Unit penagihan yang perlu diverifikasi | Pertanyaan pilot yang berguna |
|---|---|---|---|---|
| Thunderbit | Extraction API | Markdown atau JSON berbentuk skema | Unit per halaman | Apakah field yang dibutuhkan tetap valid di semua template target? |
| Bright Data | Keluarga raw proxy plus Unlocker managed | Koneksi, konten mentah, atau output managed | Traffic atau successful request, tergantung produk | Produk dan kontrol geo apa yang sebenarnya dibutuhkan workload? |
| Oxylabs | Keluarga proxy plus Web Unblocker dan scraper API | Koneksi atau konten managed | Spesifik produk; halaman Unlocker yang diambil berbasis GB | Bagaimana ukuran respons dan kontinuitas sesi memengaruhi biaya? |
| ScrapingBee | Managed HTML API | HTML | Kredit yang bergantung pada fitur | Konfigurasi mana yang berhasil, dan berapa biayanya per halaman valid? |
| ZenRows | Scraper API, browser, dan residential proxy | Berbagai format terdokumentasi dari vendor | Request dengan pengali fitur | Bagaimana semantik billing 404/410 berinteraksi dengan validator kamu? |
| Scrape.do | Managed Web Scraping API | Konten halaman | Successful API credits | Apakah kontrol premium, geo, sesi, dan browser cocok dengan workload? |
| Decodo | Keluarga produk proxy dan scraping | Koneksi atau output spesifik produk | GB atau PAYG pada halaman residential yang diambil | Apakah kontrol lokasi, ASN, protokol, dan sticky session cukup akurat? |
| Scrapfly | Managed scraping API | Konten halaman, output browser, extraction opsional | Kredit yang bergantung pada fitur | Apakah cost budget, log, dan perlindungan kegagalan berperilaku seperti yang diharapkan? |
| Zyte | Antarmuka managed HTTP, browser, extraction, dan Scrapy | HTTP, HTML hasil render, screenshot, atau objek | Tier target/request plus opsi | Apakah tier stabil, dan apakah batas mode request cocok dengan implementasi? |
| Apify | Platform scraping dan marketplace plus proxy | Dataset Actor atau crawler | Biaya compute, Actor, proxy, storage, dan dataset | Apakah manfaat workflow sepadan dengan biaya penuh platform? |
Kategori dan unit penagihan di atas mencerminkan halaman resmi yang diambil pada 10 Agustus 2026. Paket, batas, nama, dan pengali fitur dapat berubah, jadi periksa kembali produk yang tepat sebelum menyusun anggaran.
Bagan Keputusan: Sebenarnya Anda Sedang Scraping Apa?
Pertanyaan paling umum dalam thread forum soal proxy biasanya berbunyi semacam “saya tidak tahu mana yang terbaik, ada rekomendasi?” — lalu diikuti daftar umum yang sebenarnya tidak menjawab. Ini upaya untuk mendekati jalur keputusan yang nyata.
Output apa yang kamu butuhkan?
- Butuh kontrol protokol proxy, respons mentah, header kustom, atau parser sendiri? Buat daftar pendek produk raw proxy.
- Butuh HTML yang sudah dirender tanpa mengoperasikan browser dan layer retry sendiri? Buat daftar pendek managed scraping atau browser API.
- Butuh field tervalidasi, record, atau Markdown? Buat daftar pendek extraction API, termasuk endpoint Distill dan Extract yang didokumentasikan Thunderbit.
- Butuh penjadwalan, penyimpanan, marketplace jobs, dan operasi tim? Buat daftar pendek scraping platform.
Kontrol apa yang tidak bisa ditawar? Tuliskan region yang diperlukan, durasi sesi, perilaku rotasi, method request, cookie, header, rendering, screenshot, bentuk data, concurrency, log, dan batas pengeluaran. Singkirkan kandidat yang tidak bisa memenuhi requirement keras sebelum menguji preferensi lunak.
Volume yang dibicarakan berapa? Jangan gunakan ambang jumlah halaman generik untuk memilih provider. Volume berinteraksi dengan ukuran respons, concurrency, pengali fitur, tingkat hasil valid, komitmen yang dinegosiasikan, dan upaya engineering. Modelkan campuran template target yang diharapkan dan jalankan pilot pada concurrency yang representatif.
HTML mentah atau data terstruktur? Inilah percabangan utamanya. Jika kamu butuh HTML mentah untuk pipeline kustom, uji produk proxy atau managed-HTML. Jika deliverable-nya adalah baris tervalidasi, JSON, atau Markdown, uji batas extraction sebagai kategori terpisah alih-alih memaksa perbandingan proxy yang bukan perbandingan sepadan.
Bangun Scorecard Berbobot Anda Sendiri
Daftar fitur tidak membuat keputusan karena performa dan biaya bergantung pada set target dan konfigurasi. Bangun scorecard dari requirement dan hasil pilotmu sendiri. Bobot di bawah ini sengaja dikosongkan.
| Kriteria | Bobot Anda | Skor Provider A (1–5) | Bukti | Skor Provider B (1–5) | Bukti |
|---|---|---|---|---|---|
| Tingkat hasil valid | |||||
| Biaya per hasil valid | |||||
| Kecocokan output | |||||
| Kontrol geo/sesi/request | |||||
| Observabilitas dan kontrol anggaran | |||||
| Bukti kepatuhan dan sourcing | |||||
| Dukungan dan kecocokan operasional | |||||
| Upaya engineering dan pemeliharaan | |||||
| Total | 100 |
Gunakan skor 1–5 hanya jika buktinya ada. Pisahkan “tidak berlaku” dari nol. Publikasikan bobot di samping hasil agar rekan kerja bisa melihat asumsi mana yang mendorong hasil akhirnya.
Contoh Python ringkas berikut gagal dengan aman jika input hilang atau tidak valid. Minimum 30 percobaan adalah pagar pengaman untuk tutorial, bukan klaim ukuran sampel statistik universal:
from dataclasses import dataclass

@dataclass(frozen=True)
class PilotResult:
    attempts: int
    valid_results: int
    request_cost: float
    engineering_cost: float = 0.0

    def cost_per_1000_valid(self) -> float:
        if self.attempts < 30:
            raise ValueError("pilot needs at least 30 attempts for this tutorial")
        if not 0 < self.valid_results <= self.attempts:
            raise ValueError("valid_results must be between 1 and attempts")
        if self.request_cost < 0 or self.engineering_cost < 0:
            raise ValueError("costs cannot be negative")
        total = self.request_cost + self.engineering_cost
        return total / self.valid_results * 1000

def weighted_score(weights: dict[str, float], scores: dict[str, float]) -> float:
    if set(weights) != set(scores):
        raise ValueError("every weighted criterion needs a score")
    if abs(sum(weights.values()) - 100.0) > 1e-9:
        raise ValueError("weights must sum to 100")
    if any(not 1 <= score <= 5 for score in scores.values()):
        raise ValueError("scores must be in the 1–5 range")
    return sum(weights[name] * scores[name] for name in weights) / 100
Jalankan setidaknya dua ronde pada waktu berbeda dengan kondisi tetap. Untuk setiap percobaan, catat kelompok target, region, konfigurasi, status, hasil semantic validator, latensi, retry, unit yang ditagihkan, bytes, request atau job ID, dan alasan ketidakvalidan. Pembelian yang lebih besar butuh sampel yang disesuaikan dengan risiko tim dan keragaman target; batas minimal tutorial tidak bisa menggantikan desain itu.
Kalau kamu masih baru dalam scraping secara umum dan ingin memahami dasarnya sebelum masuk ke perbandingan vendor, panduan kami tentang apa itu web scraping dan panduan web scraping tanpa coding adalah titik awal yang bagus.
Memilih proxy API sebenarnya bukan pertanyaan “vendor mana yang terbaik” — melainkan “batas produk mana yang cocok dengan kebutuhan output saya”, lalu dilanjutkan dengan pilot untuk memastikan klaim marketing vendor benar-benar cocok dengan targetmu. Sepuluh provider, empat kategori produk, dan satu rumus (biaya per hasil valid) sudah membawa kamu cukup jauh. Sisanya tinggal menjalankan tes sendiri, bukan mempercayai benchmark orang lain.
Jika tujuan nyata kamu adalah data terstruktur, bukan tumpukan HTML untuk diparse, kamu bisa memasukkan ekstensi Chrome Thunderbit atau API ke shortlist dan mengecek batas trial atau plan saat ini sebelum menjalankan pilot. Kanal YouTube Thunderbit juga menyediakan panduan produk; anggap itu demonstrasi, bukan bukti benchmark independen.
Coba Agentic Web Scraper Thunderbit Get Started Free
Pelajari Lebih Lanjut
- Apa Itu Web Scraping
- AI Web Scraping
- Web Scraping Tanpa Coding
- Alternatif Instant Data Scraper
- Scraping LinkedIn
FAQ
1. Apa perbedaan nyata antara proxy network dan scraping API?
Raw proxy network memberi kamu IP dan kontrol routing — kamu tetap menangani rendering, retry, dan parsing sendiri. Scraping API (managed atau berbasis AI) mengambil alih lebih banyak siklus itu dan mengembalikan HTML, JSON, atau Markdown tergantung produknya. Keduanya tidak bisa dipertukarkan, dan membandingkan harganya secara langsung biasanya menghasilkan kesimpulan yang menyesatkan.
2. Bagaimana cara mengukur “success rate” yang benar-benar bermakna?
Jangan anggap HTTP 200 sebagai sukses. Definisikan sukses sebagai “konten atau field yang saya butuhkan memang ada dan benar,” lalu uji pada sampel yang representatif dari target nyata kamu — bukan situs demo vendor.
3. Bagaimana cara menghitung biaya per request yang berhasil?
Bagi harga yang tercantum (per request atau per GB) dengan success rate yang kamu ukur pada target spesifikmu. Provider yang lebih murah tetapi success rate-nya lebih rendah bisa saja berakhir lebih mahal setelah retry diperhitungkan — hitung dulu sebelum berkomitmen ke paket.
4. Apakah saya butuh proxy API kalau saya hanya ingin data terstruktur, bukan HTML mentah?
Belum tentu. Extraction API seperti Thunderbit dapat mengembalikan JSON terstruktur dan menempatkan rendering serta routing di balik batas layanan, sehingga kamu mungkin tidak perlu membeli raw proxy terpisah untuk workflow itu. Tetap uji dukungan target dan validitas field. Produk proxy tradisional tetap relevan ketika kamu butuh respons mentah atau kontrol level proxy.
5. Apa yang harus saya tanyakan ke provider soal sourcing IP sebelum mendaftar?
Minta dokumentasi consent dan sourcing IP residential terkini, kebijakan penggunaan yang didukung, bukti kepatuhan, auditabilitas, dan proses respons ketika subnet atau target menjadi tidak tersedia. Pernyataan pihak pertama harus ditinjau procurement atau counsel jika risikonya layak; itu bukan audit rantai pasok independen.




