
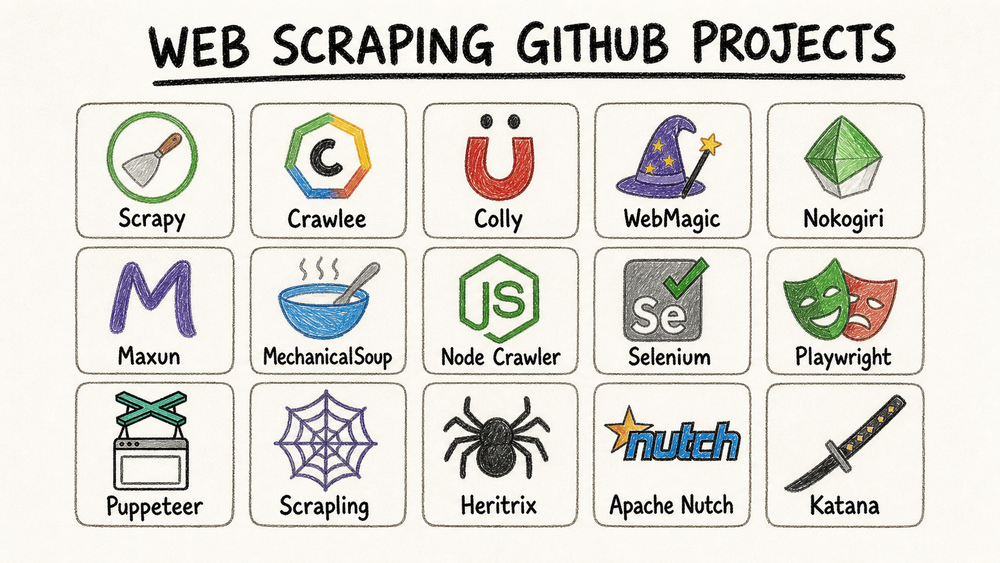
Web masih menyimpan banyak data berharga di 2026, tetapi kebanyakan tim sebenarnya tidak butuh “sebuah scraper” dalam arti umum. Mereka butuh jawaban praktis untuk salah satu dari tiga pertanyaan: proyek open-source mana yang masih layak dijadikan fondasi, stack mana yang sanggup menangani situs modern yang berat di JavaScript, dan apakah non-developer sebaiknya langsung lewat GitHub saja lalu memakai workflow no-code.
Pembaruan ini saya susun mengikuti alur keputusan itu. Saya cek ulang halaman repo GitHub publik, jumlah bintang, dan aktivitas commit feed pada 6 Agustus 2026, lalu membandingkan proyek-proyek di bawah ini berdasarkan kompleksitas setup, dukungan JavaScript, sinyal pemeliharaan, kemudahan ekspor, dan kecocokan untuk audiens tertentu.
Jawaban Singkat
- Pilih Scrapy jika Anda ingin framework crawling Python yang paling matang untuk scraping terstruktur skala besar.
- Pilih Crawlee jika tim Anda bekerja dengan JavaScript atau TypeScript dan menginginkan satu stack untuk scraping via HTTP maupun browser.
- Pilih Playwright atau Puppeteer jika situsnya sangat berat di JavaScript dan otomasi browser sungguhan memang dibutuhkan.
- Pilih Maxun jika Anda ingin lapisan no-code open-source yang visual dan bisa di-host sendiri, alih-alih menulis kode scraping dari nol.
- Pilih Heritrix, Apache Nutch, atau Katana hanya jika pekerjaan Anda sangat spesifik: crawling arsip, crawling terdistribusi, atau reconnaissance keamanan.
- Pilih Thunderbit jika Anda tidak ingin membangun apa pun di GitHub dan hanya ingin data cepat ke Sheets, Airtable, Notion, CSV, atau JSON.
Coba Scraper No-Code Sebelum Anda Terlanjur Memilih Stack Kode
Perbandingan Sekilas
Bintang GitHub dan sinyal commit terakhir di bawah ini dicek berdasarkan halaman repo publik dan commit feed pada 6 Agustus 2026.
| Proyek | Bahasa / Model | Setup | Dukungan JS | Cocok untuk | Bintang GitHub | Sinyal Commit Terakhir |
|---|---|---|---|---|---|---|
| Scrapy | Framework Python | Menengah | Tidak ada rendering JS native | Spider skala besar, ecommerce, berita | 63.7k | 6 Agustus 2026 |
| Crawlee | Framework Node.js / TypeScript | Menengah | Ya | Scraping statis + dinamis dalam satu stack | 25.2k | 6 Agustus 2026 |
| Maxun | Platform no-code open-source | Menengah untuk deployment, mudah bagi pengguna | Ya | Pengguna bisnis yang tetap ingin kontrol open-source | 17.1k | 5 Agustus 2026 |
| MechanicalSoup | Library Python | Mudah | Tidak | Form, sesi, dan situs statis sederhana | 4.9k | 4 Agustus 2026 |
| Node Crawler | Crawler Node.js | Menengah | Tidak | Crawling statis cepat dan agregasi feed | 6.8k | 18 Juni 2026 |
| Heritrix | Crawler arsip Java | Lanjutan | Tidak | Web archiving dan pengambilan skala domain | 3.3k | 5 Agustus 2026 |
| Apache Nutch | Crawler terdistribusi Java | Lanjutan | Tidak | Crawling gaya search dan big data | 3.3k | 5 Agustus 2026 |
| Selenium | Otomasi browser multi-bahasa | Menengah | Ya | Alur yang banyak interaksi dan fidelitas browser | 34.3k | 6 Agustus 2026 |
| Playwright | Otomasi browser multi-bahasa | Menengah | Ya | Situs dinamis modern dan scripting yang tangguh | 94.1k | 6 Agustus 2026 |
| Puppeteer | Otomasi browser Node.js | Menengah | Ya | Otomasi dan scraping yang berfokus pada Chrome | 95.4k | 6 Agustus 2026 |
| Scrapling | Toolkit scraping stealth Python | Menengah | Ya | Scraping browser yang sensitif terhadap anti-bot | 72.8k | 30 Juli 2026 |
| Katana | Crawler / CLI Go | Menengah | Headless opsional | Security crawling dan discovery URL | 17.3k | 5 Agustus 2026 |
| Colly | Framework Go | Menengah | Tidak | Scraping statis berperforma tinggi | 25.4k | 18 Juni 2026 |
| WebMagic | Framework Java | Menengah | Tidak ada JS native | Pipeline scraping Java umum | 11.7k | 20 Desember 2025 |
| Nokogiri | Parser Ruby | Mudah | Tidak | Aplikasi Ruby dan workflow parsing kustom | 6.3k | 3 Agustus 2026 |
| Thunderbit | Ekstensi Chrome no-code berbasis AI | Tinggal pakai | Ya | Tim non-teknis yang butuh data siap pakai dengan cepat | N/A | Produk terkelola, terus diperbarui |
Sebelum Memilih Proyek GitHub, Tanyakan Dulu: Apakah Anda Benar-Benar Butuh Workflow Kode?
Thunderbit bukan proyek GitHub, dan justru karena itu ia layak masuk ke panduan ini. Banyak orang yang mencari “best web scraping GitHub projects” sebenarnya tidak ingin repot memelihara stack crawler. Mereka cuma ingin data terstruktur dari sebuah website yang masih aktif, hari ini juga.
Thunderbit adalah jalan paling mulus dari riset scraping berbasis kode ke eksekusi yang siap dipakai bisnis:
- Paling cocok untuk: prospecting sales, pemantauan ecommerce, pengumpulan data properti, riset rekrutmen, dan pekerjaan operasional berbasis browser.
- Kenapa menonjol: saran field berbasis AI, enrichment subpage, penanganan halaman dinamis, serta ekspor ke Sheets, Airtable, Notion, CSV, dan JSON tanpa perlu menulis logika scraping.
- Perlu diperhatikan: kalau pekerjaan Anda adalah platform crawling internal jangka panjang dengan infrastruktur kustom, framework open-source tetap memberi kontrol yang lebih besar.
Kalau Anda ingin melihat jalur no-code dulu sebelum memutuskan hidup di dalam GitHub, walkthrough Thunderbit berikut adalah cek realitas tercepat:
Coba Thunderbit AI Web Scraper Gratis
Cara Saya Mengevaluasi Proyek Scraping GitHub Ini
Tidak semua proyek scraping GitHub bisa dibandingkan secara langsung. Ada yang berupa framework penuh. Ada yang library otomasi browser. Ada yang parser. Ada juga crawler niche yang dibuat untuk arsip atau tim keamanan.
Agar daftar ini tetap berguna, saya memprioritaskan proyek yang masih lolos empat filter praktis berikut:
- Masih relevan dengan realitas pasar.
Bintang tinggi saja tidak cukup, tetapi adopsi rendah ditambah pemeliharaan yang sepi biasanya pertanda buruk. - Masih terlihat aktif.
Untuk pembaruan ini, saya mengecek ulang aktivitas commit feed publik pada 6 Agustus 2026, bukan hanya mengandalkan angka roundup lama. - Memecahkan pekerjaan scraping yang nyata.
Saya mengesampingkan repo yang menarik tapi terlalu obscure dan tidak cocok dengan workflow bisnis atau riset yang sesungguhnya. - Cukup berbeda untuk dipertimbangkan.
Tujuannya bukan menumpuk 50 repo, melainkan membantu Anda memilih antara framework, stack browser, tool no-code open-source, dan crawler spesialis.
Dimensi perbandingannya sama seperti yang biasanya menentukan sukses atau gagalnya proyek di lapangan:
- Kompleksitas setup: seberapa cepat pengguna baru bisa mencapai scrape yang berhasil.
- Dukungan JavaScript: apakah proyek mampu menangani situs modern yang dirender di sisi klien.
- Kesehatan proyek: apakah repo masih cukup aktif untuk dipercaya.
- Pengelolaan data: apakah proyek menghasilkan output terstruktur atau malah menambah pekerjaan Anda.
- Kecocokan audiens: apakah proyek ini memang untuk pemula, data engineer, tim keamanan, atau operator non-teknis.
Kompleksitas Setup: Seberapa Cepat Anda Bisa Mulai?
Taksonomi setup ini masih relevan, tetapi pada 2026 framing yang paling berguna justru lebih sederhana:
- Tinggal pakai: Thunderbit untuk pengguna bisnis; MechanicalSoup atau Nokogiri untuk script kode ringan.
- Menengah: Scrapy, Crawlee, Maxun, Selenium, Playwright, Puppeteer, Colly, Katana, Scrapling, WebMagic, dan Node Crawler semuanya masih memerlukan sedikit coding, CLI, atau deployment.
- Lanjutan: Heritrix dan Apache Nutch hanya masuk akal jika Anda memang membutuhkan crawling arsip atau crawling terdistribusi berbasis Java.
Maxun layak disebut khusus di sini karena posisinya ada di tengah. Platform-nya sendiri perlu deployment, tetapi workflow untuk pengguna akhirnya jauh lebih ringan dibanding bekerja langsung dengan Scrapy atau Playwright.
Dukungan Konten Dinamis: Proyek Mana yang Bisa Menangani Web Modern?
Website modern penuh dengan React, Vue, infinite scroll, panggilan API di background, dan alur login yang rumit. Inilah batas yang memisahkan “saya dapat HTML” dari “saya dapat data yang benar-benar saya butuhkan.”
Proyek-proyek dalam daftar ini terbagi ke dalam tiga kelompok:
- Otomasi browser penuh: Selenium, Playwright, dan Puppeteer menjalankan JavaScript sepenuhnya dan masih menjadi pilihan paling andal untuk situs yang interaksinya banyak.
- Hybrid atau dukungan wrapper: Crawlee bisa berganti antara crawling HTTP ringan dan scraping berbasis browser. Scrapling menambahkan tooling berorientasi stealth untuk target yang lebih sulit. Maxun memakai pendekatan berbasis browser di balik interface visual.
- Default-nya hanya HTML statis: Scrapy, MechanicalSoup, Node Crawler, Colly, WebMagic, Nokogiri, Heritrix, dan Apache Nutch tidak menyelesaikan masalah rendering modern secara native sendirian.
Kalau keraguan terbesar Anda adalah “apakah stack ini bisa menangani halaman berat JavaScript tanpa saya harus menulis semua langkah browser secara manual?”, tutorial Playwright berikut adalah cek realitas terbaik di tengah jalan:
Kesehatan Proyek: Repo Mana yang Masih Terlihat Andal di 2026?
Versi artikel tahun 2025 banyak bertumpu pada jumlah bintang dan beberapa catatan pembaruan yang sudah tua. Itu sekarang tidak cukup lagi. Saya mengecek jumlah bintang terkini sekaligus sinyal commit terbaru pada 6 Agustus 2026.
Gambaran kesehatannya terlihat seperti ini:
- Jelas aktif saat ini: Scrapy, Crawlee, Maxun, MechanicalSoup, Heritrix, Apache Nutch, Selenium, Playwright, Puppeteer, Scrapling, Katana, dan Nokogiri semuanya mendorong commit publik dalam dua minggu sebelum pengecekan ini.
- Masih hidup tapi lebih lambat: Colly dan Node Crawler sama-sama terakhir commit pada 18 Juni 2026. Keduanya masih terlihat bisa dipakai, tetapi update-nya datang dalam ledakan sesekali, bukan setara ritme mingguan seperti Playwright atau Crawlee.
- Perlu lebih hati-hati: WebMagic adalah satu-satunya celah nyata di daftar ini. Sinyal commit publik terbaru yang saya temukan adalah 20 Desember 2025, jadi saya akan memperlakukannya sebagai stabil, bukan proyek yang sedang aktif berevolusi.
Itu penting karena gaya pemeliharaan harus memengaruhi shortlist Anda:
- Jika Anda ingin default yang aman untuk build engineering baru, utamakan repo yang terlihat aktif.
- Jika tool-nya sederhana dan use case Anda sempit, proyek yang bergerak lebih lambat masih bisa diterima.
- Jika proyeknya spesialis, nilai dulu kecocokannya, bukan seberapa sering rilis keluar tiap minggu.
15 Proyek GitHub Web Scraping Terbaik di 2026
Framework untuk Scraping Skala Besar atau Serbaguna
1. Scrapy
Scrapy masih menjadi jawaban default Python ketika pekerjaannya lebih besar daripada sekadar script cepat. Jika Anda butuh spider, pipeline, middleware, throttling, retry, dan ekosistem yang matang, ini tetap taruhan open-source paling aman di daftar ini.
- Setup: Menengah
- Cocok untuk: katalog ecommerce, scraping direktori, crawling berita, dan sistem scraping internal jangka panjang
- Dukungan JS: Tidak ada rendering native; pasangkan dengan Playwright atau Selenium bila perlu
- Kenapa dipilih: arsitektur matang, dokumentasi kuat, dan salah satu rasio power-to-community terbaik di open-source scraping
- Perlu diperhatikan: kurva belajarnya nyata jika Anda belum pernah bekerja di dalam framework crawler
Jika Anda ingin menilai apakah jalur Scrapy memang cocok sebelum benar-benar komit, walkthrough pemula berikut masih sangat berguna:
2. Crawlee
Crawlee menjadi pilihan framework JavaScript atau TypeScript yang paling menarik ketika Anda ingin satu proyek yang bisa mencakup crawling ringan sekaligus scraping berbasis browser. Kemampuan berpindah antara workflow HTTP-first dan workflow yang digerakkan Playwright atau Puppeteer adalah keunggulan utamanya.
- Setup: Menengah
- Cocok untuk: tim JS dan TS, target hybrid statis dan dinamis, serta tooling internal yang berat di otomasi
- Dukungan JS: Ya
- Kenapa dipilih: model runtime fleksibel, helper anti-blocking, dan ergonomi cerita browser yang lebih kuat daripada stack crawler lama
- Perlu diperhatikan: paling masuk akal jika tim Anda sudah nyaman bekerja di Node.js
3. Colly
Colly masih menjadi salah satu pilihan berperforma tinggi yang paling bersih untuk tim Go yang tidak membutuhkan rendering browser secara default. Cepat, elegan, dan praktis ketika hambatannya adalah volume, bukan kompleksitas antarmuka.
- Setup: Menengah
- Cocok untuk: developer Go yang membangun crawler statis cepat
- Dukungan JS: Tidak ada rendering native
- Kenapa dipilih: concurrency, rate limiting, dan API yang enak untuk pekerjaan throughput tinggi
- Perlu diperhatikan: bukan pilihan tepat ketika otomasi browser adalah kebutuhan utama
4. WebMagic
WebMagic tetap relevan sebagai analog Java untuk tim yang menyukai model Scrapy tetapi ingin tetap berada di ekosistem JVM. Masih masuk akal untuk tim Java, walaupun perhatian komunitas di sekitarnya lebih kecil dibanding opsi berbasis Python atau Node.
- Setup: Menengah
- Cocok untuk: pipeline scraping berbasis Java
- Dukungan JS: Tidak ada rendering native
- Kenapa dipilih: scheduler, pipeline, dan struktur framework yang jelas
- Perlu diperhatikan: ekosistemnya lebih senyap dibanding opsi Python dan Node yang lebih besar, dan sinyal commit publik terbaru yang saya temukan adalah 20 Desember 2025, jadi perlakukan sebagai stabil, bukan aktif berevolusi
5. Nokogiri
Nokogiri bukan framework crawler. Ini adalah parser yang masih sering dipakai developer Ruby saat ingin menangani HTML atau XML secara rapi di dalam script atau alur aplikasi kustom.
- Setup: Mudah
- Cocok untuk: aplikasi Ruby dan Rails yang butuh parsing, bukan framework crawler penuh
- Dukungan JS: Tidak
- Kenapa dipilih: parsing cepat, stabil, dan aman secara default
- Perlu diperhatikan: Anda tetap harus menyediakan layer HTTP, session, atau browser sendiri
Proyek Ringan Statis dan Ramah Pemula
6. Maxun
Maxun adalah jawaban open-source untuk orang yang suka ide scraping no-code tetapi tetap ingin self-hosting dan kontrol sekelas GitHub. Jauh lebih mudah diakses oleh non-developer dibanding framework murni, namun tetap proyek open-source sungguhan, bukan SaaS tertutup.
- Setup: Menengah untuk deployment, lebih mudah bagi pengguna akhir setelah setup selesai
- Cocok untuk: tim yang ingin UI visual dengan kontrol open-source
- Dukungan JS: Ya
- Kenapa dipilih: ekstraksi point-and-click, flow multi-langkah, dan aksesibilitas yang lebih baik daripada menulis kode dari nol
- Perlu diperhatikan: langkah deployment tetap lebih berat daripada ekstensi browser yang sepenuhnya dikelola
7. MechanicalSoup
MechanicalSoup tetap pantas masuk daftar karena tidak semua scrape membutuhkan browser headless. Kalau masalah utamanya adalah penanganan sesi, pengiriman form, atau menelusuri alur statis di balik login, tool ini tetap kecil dan mudah dipahami.
- Setup: Mudah
- Cocok untuk: form sederhana, halaman statis yang diproteksi login, dan script otomasi Python cepat
- Dukungan JS: Tidak
- Kenapa dipilih: minim friksi, kode mudah dibaca, dan jalur masuk yang lembut untuk pengguna Python
- Perlu diperhatikan: cepat kehilangan manfaat pada situs yang berat di JS
8. Node Crawler
Node Crawler masih punya tempat jika target Anda HTML statis dan Anda terutama peduli pada concurrency, queueing, dan parsing ala Cheerio. Saya tidak akan memilihnya untuk proyek browser-heavy yang baru, tetapi tool ini masih cukup cocok untuk pengumpulan feed dan situs statis.
- Setup: Menengah
- Cocok untuk: crawling statis berkecepatan tinggi dan agregasi
- Dukungan JS: Tidak
- Kenapa dipilih: kontrol concurrency dan workflow parsing yang terasa familiar seperti jQuery
- Perlu diperhatikan: sinyal commit publik terbaru yang saya temukan adalah 18 Juni 2026, dan jarak antar update-nya panjang, jadi ini bukan tempat saya memulai stack situs dinamis jangka panjang yang baru
Proyek Dinamis dan Otomasi Browser
9. Selenium
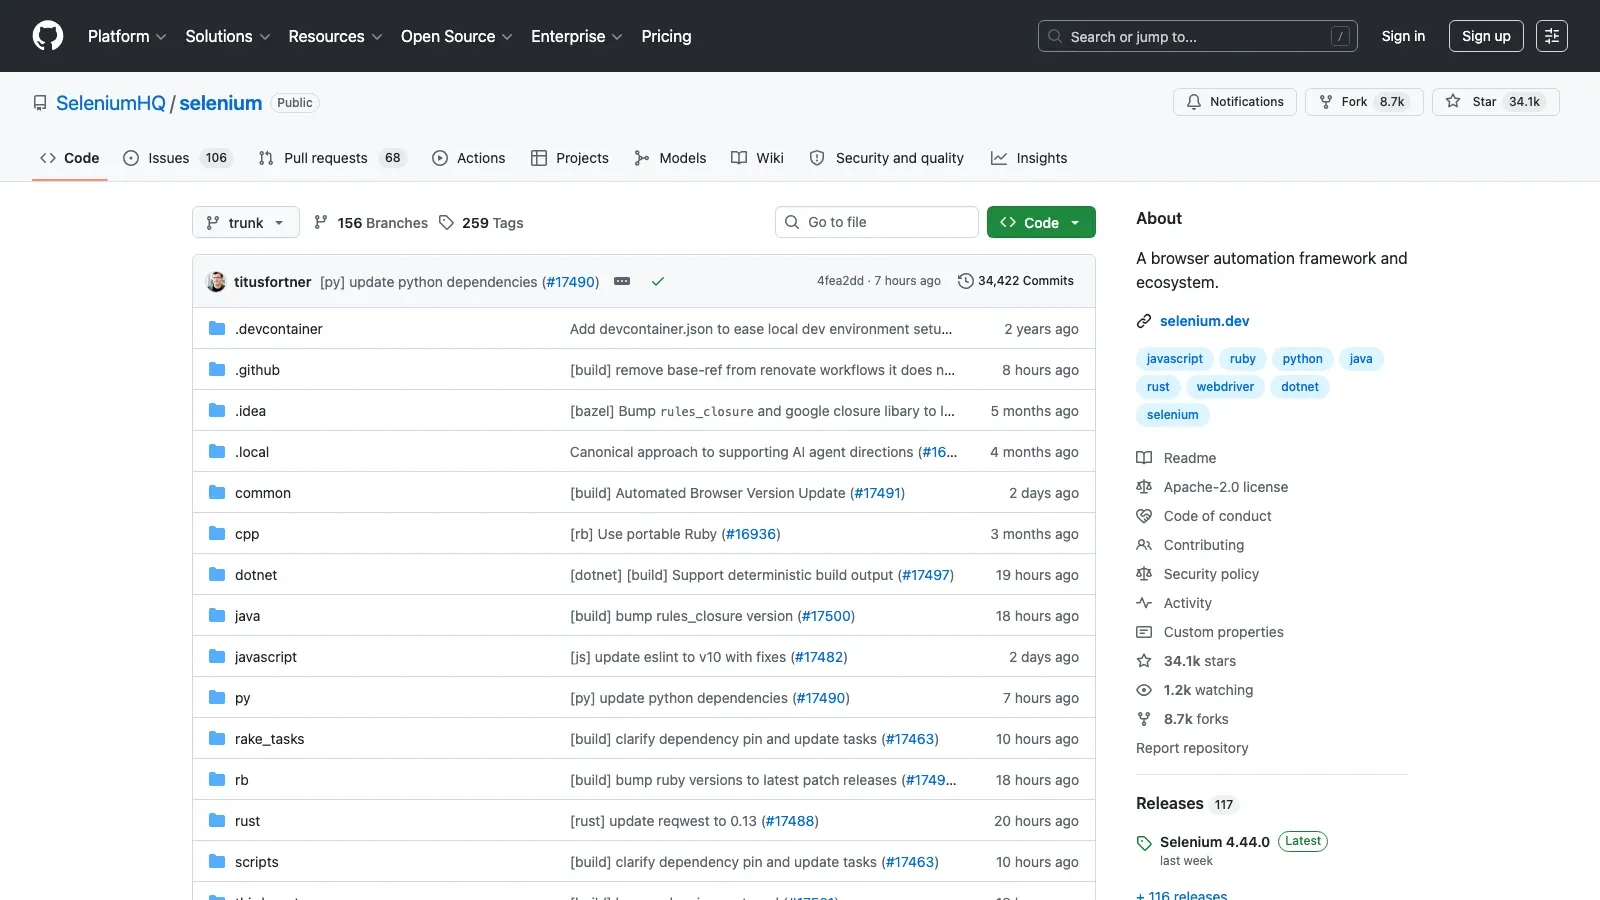
Selenium lebih tua daripada Playwright, tetapi tetap penting ketika perilaku browser yang presisi dan fidelitas interaksi lebih utama daripada keindahan API. Ini masih sangat relevan ketika scraping beririsan dengan QA, otomasi regresi, atau situs yang menuntut perilaku browser yang sangat literal.
- Setup: Menengah
- Cocok untuk: alur yang banyak interaksi, otomasi browser legacy, dan tim yang sudah memakai Selenium untuk testing
- Dukungan JS: Ya
- Kenapa dipilih: cakupan browser luas, ekosistem besar, dan kematangan yang sudah lama teruji
- Perlu diperhatikan: stack otomasi yang lebih baru sering terasa lebih bersih dan lebih cepat untuk pekerjaan scraping greenfield
10. Playwright
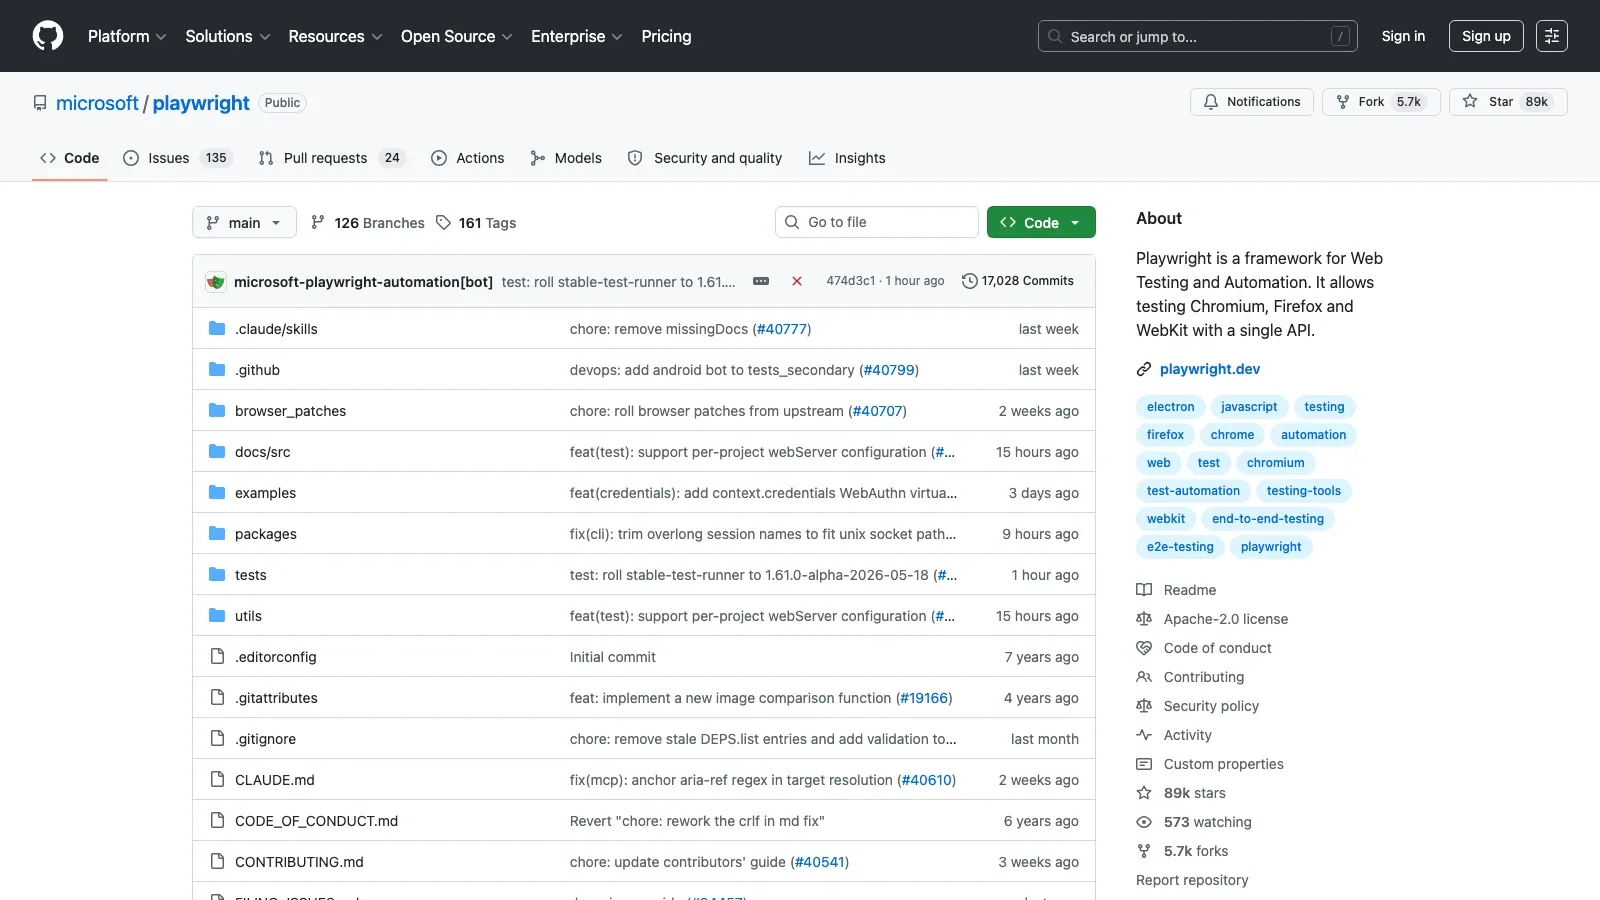
Playwright adalah rekomendasi modern default saya untuk tim developer yang membutuhkan scraping halaman dinamis. Kombinasi dukungan multi-browser, perilaku waiting yang kuat, dan API yang bersih membuatnya jadi proyek otomasi browser di daftar ini yang paling mudah direkomendasikan secara luas.
- Setup: Menengah
- Cocok untuk: aplikasi web modern, alur login, dan target yang berat di JavaScript
- Dukungan JS: Ya
- Kenapa dipilih: kontrol lintas browser, primitive otomasi yang tangguh, dan pemeliharaan yang aktif
- Perlu diperhatikan: Anda tetap harus menangani selector, infrastruktur browser, retry, dan kualitas output
11. Puppeteer
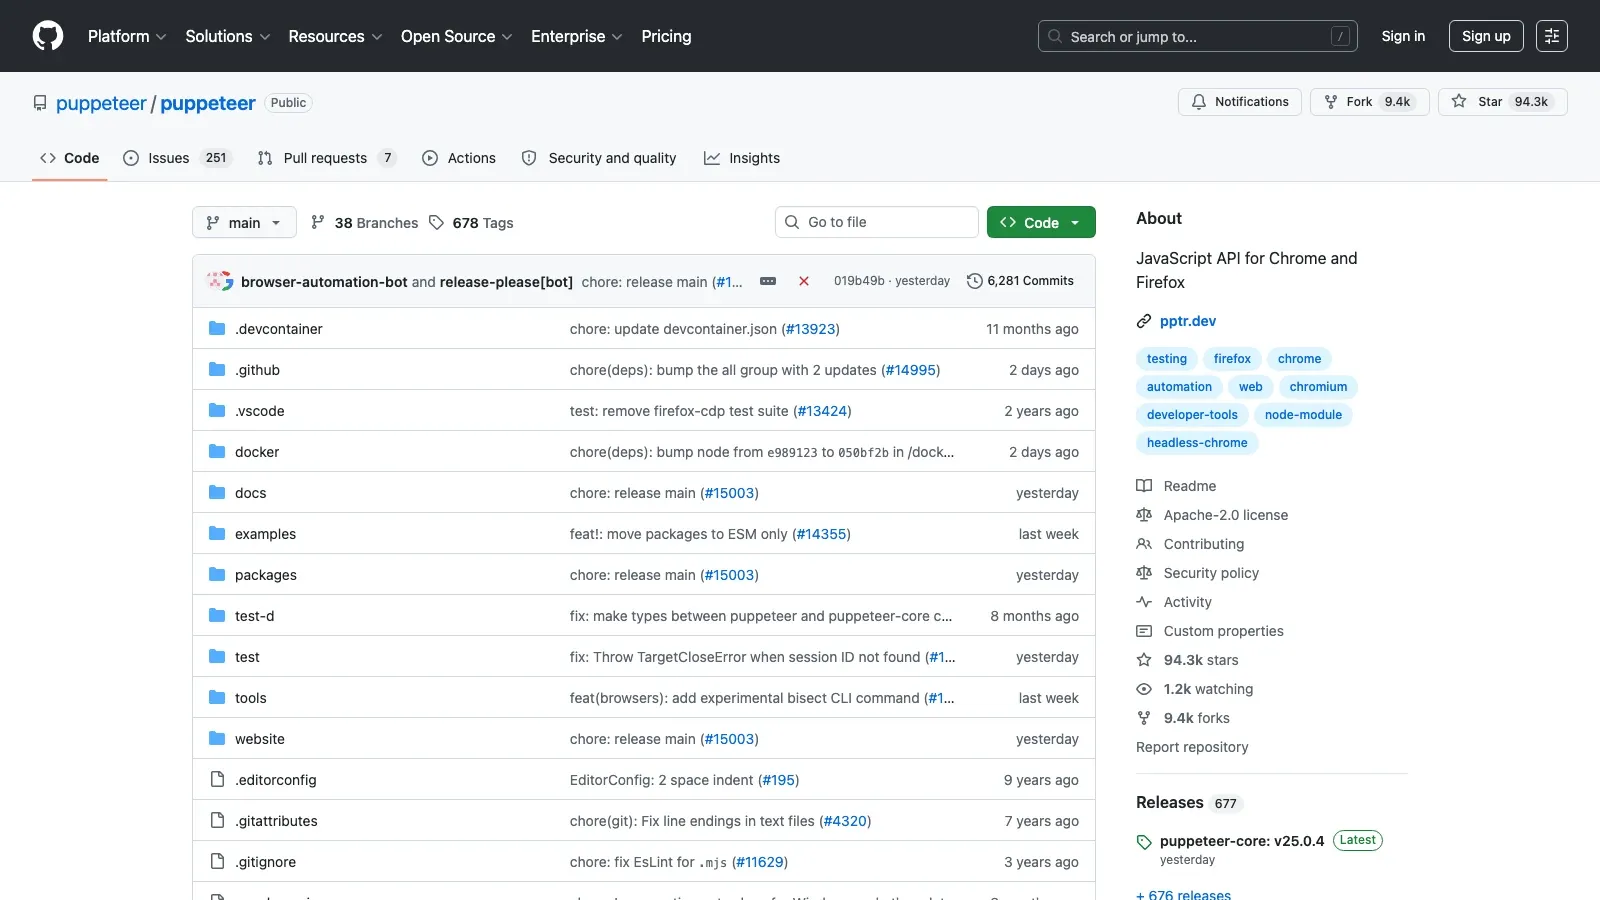
Puppeteer masih menjadi klasik yang berfokus pada Chrome. Jika tim Anda sudah memakai Node.js dan sebagian besar menargetkan workflow yang kompatibel dengan Chromium, ini tetap pilihan yang praktis dan sudah sangat dipahami.
- Setup: Menengah
- Cocok untuk: otomasi berorientasi Chrome, screenshot, PDF, dan ekstraksi konten dinamis
- Dukungan JS: Ya
- Kenapa dipilih: kontrol browser yang kaya dan banyak sekali contoh dari komunitas
- Perlu diperhatikan: Playwright kini menjadi default yang lebih kuat jika Anda ingin cakupan browser yang lebih luas atau cerita cross-browser yang lebih modern
12. Scrapling
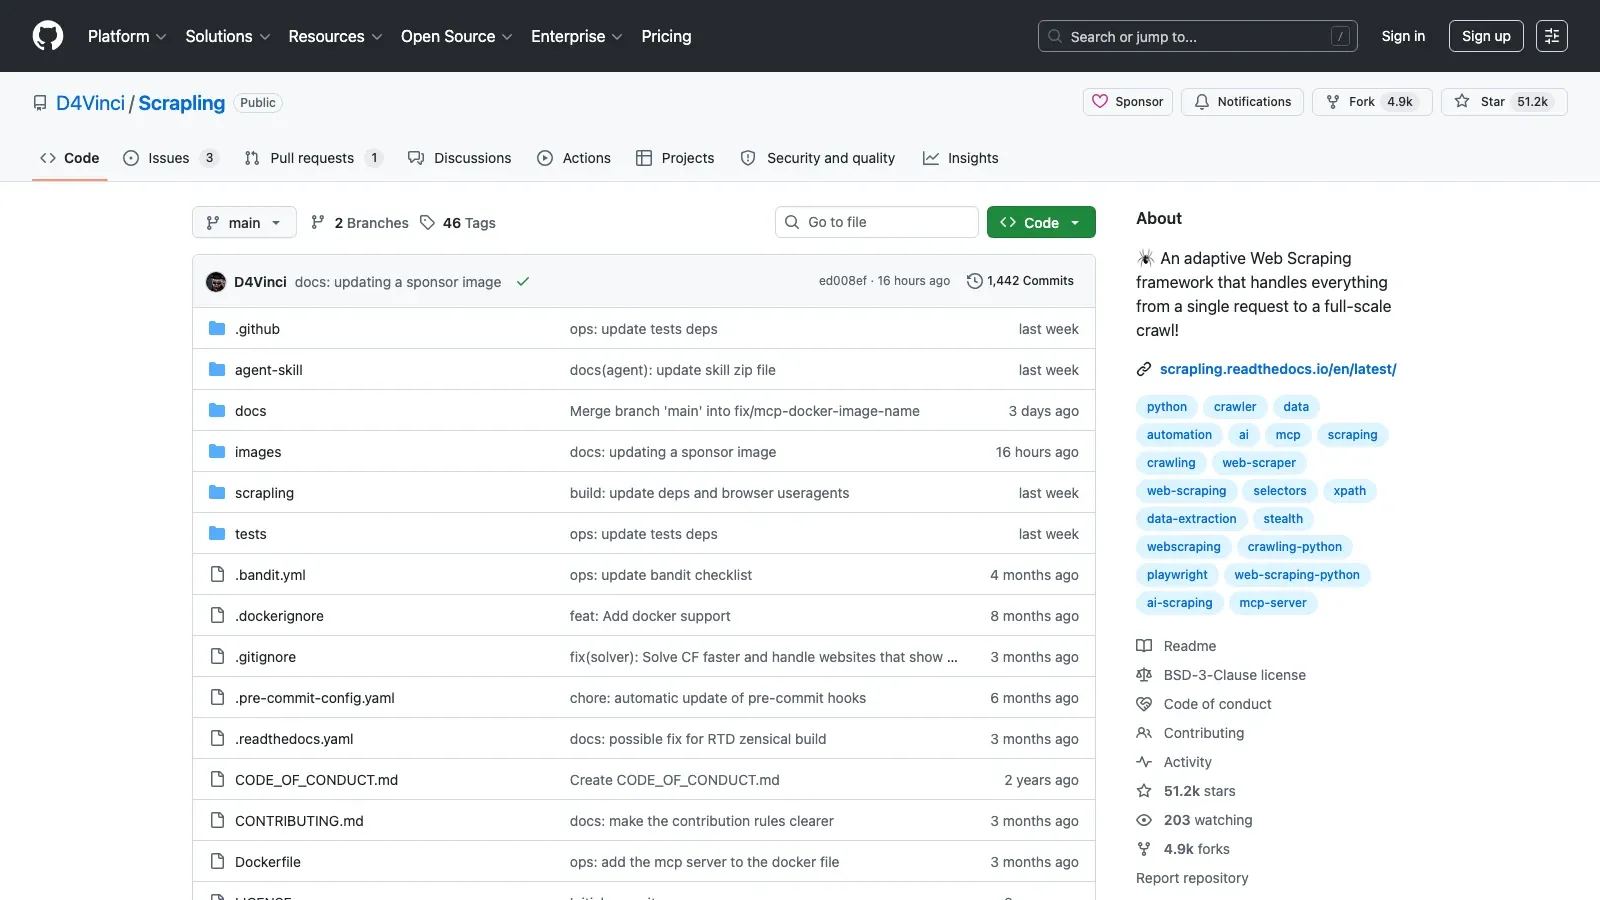
Scrapling adalah pendatang modern yang paling terspesialisasi di kelompok ini. Tool ini ditujukan untuk orang yang sudah tahu bahwa rendering browser bukan satu-satunya masalah. Mereka juga butuh stealth, kesadaran proxy, dan posture anti-bot yang lebih kuat.
- Setup: Menengah
- Cocok untuk: stealth scraping, target yang sensitif terhadap anti-bot, dan kerja situs dinamis berbasis Python
- Dukungan JS: Ya
- Kenapa dipilih: pengembangan aktif dan fokus yang lebih tajam pada friksi scraping yang sering diabaikan framework yang lebih sederhana
- Perlu diperhatikan: terlalu berlebihan untuk situs statis biasa dan kurang ramah pemula dibanding MechanicalSoup atau Scrapy
Crawler Spesialis untuk Riset, Keamanan, dan Infrastruktur
13. Heritrix
Heritrix bukan scraper untuk perbandingan produk. Ini adalah crawler arsip yang dibuat untuk institusi yang peduli pada preservasi seluruh situs dan pengambilan yang sesuai standar.
- Setup: Lanjutan
- Cocok untuk: arsip, perpustakaan, dan workflow preservasi skala besar
- Dukungan JS: Tidak
- Kenapa dipilih: warisan Internet Archive dan workflow arsip berorientasi WARC
- Perlu diperhatikan: alat yang salah untuk scraping daftar atau harga yang ditargetkan
14. Apache Nutch
Apache Nutch masih masuk akal untuk tim yang berpikir dalam istilah crawling terdistribusi, indexing, atau pengumpulan data bergaya search, bukan scraping bisnis sekali jalan.
- Setup: Lanjutan
- Cocok untuk: crawling terdistribusi, dataset riset, dan pengumpulan ala mesin pencari
- Dukungan JS: Tidak
- Kenapa dipilih: model plugin dan familiaritas gaya enterprise khas Apache
- Perlu diperhatikan: terlalu berat untuk sebagian besar pekerjaan yang berangkat dari spreadsheet atau browser
15. Katana
Katana masuk di sini karena crawling keamanan adalah use case tersendiri. Jika pekerjaannya adalah reconnaissance, discovery endpoint, atau memetakan struktur target dengan cepat, Katana jauh lebih cocok daripada framework scraping serbaguna.
- Setup: Menengah
- Cocok untuk: reconnaissance keamanan, discovery link, dan pembuatan inventaris URL
- Dukungan JS: Mode headless opsional
- Kenapa dipilih: kecepatan, concurrency, dan model crawling yang berfokus pada keamanan
- Perlu diperhatikan: tool ini tidak dirancang sebagai stack ekstraksi data bisnis yang rapi
Rekomendasi Singkat Berdasarkan Tipe Tim
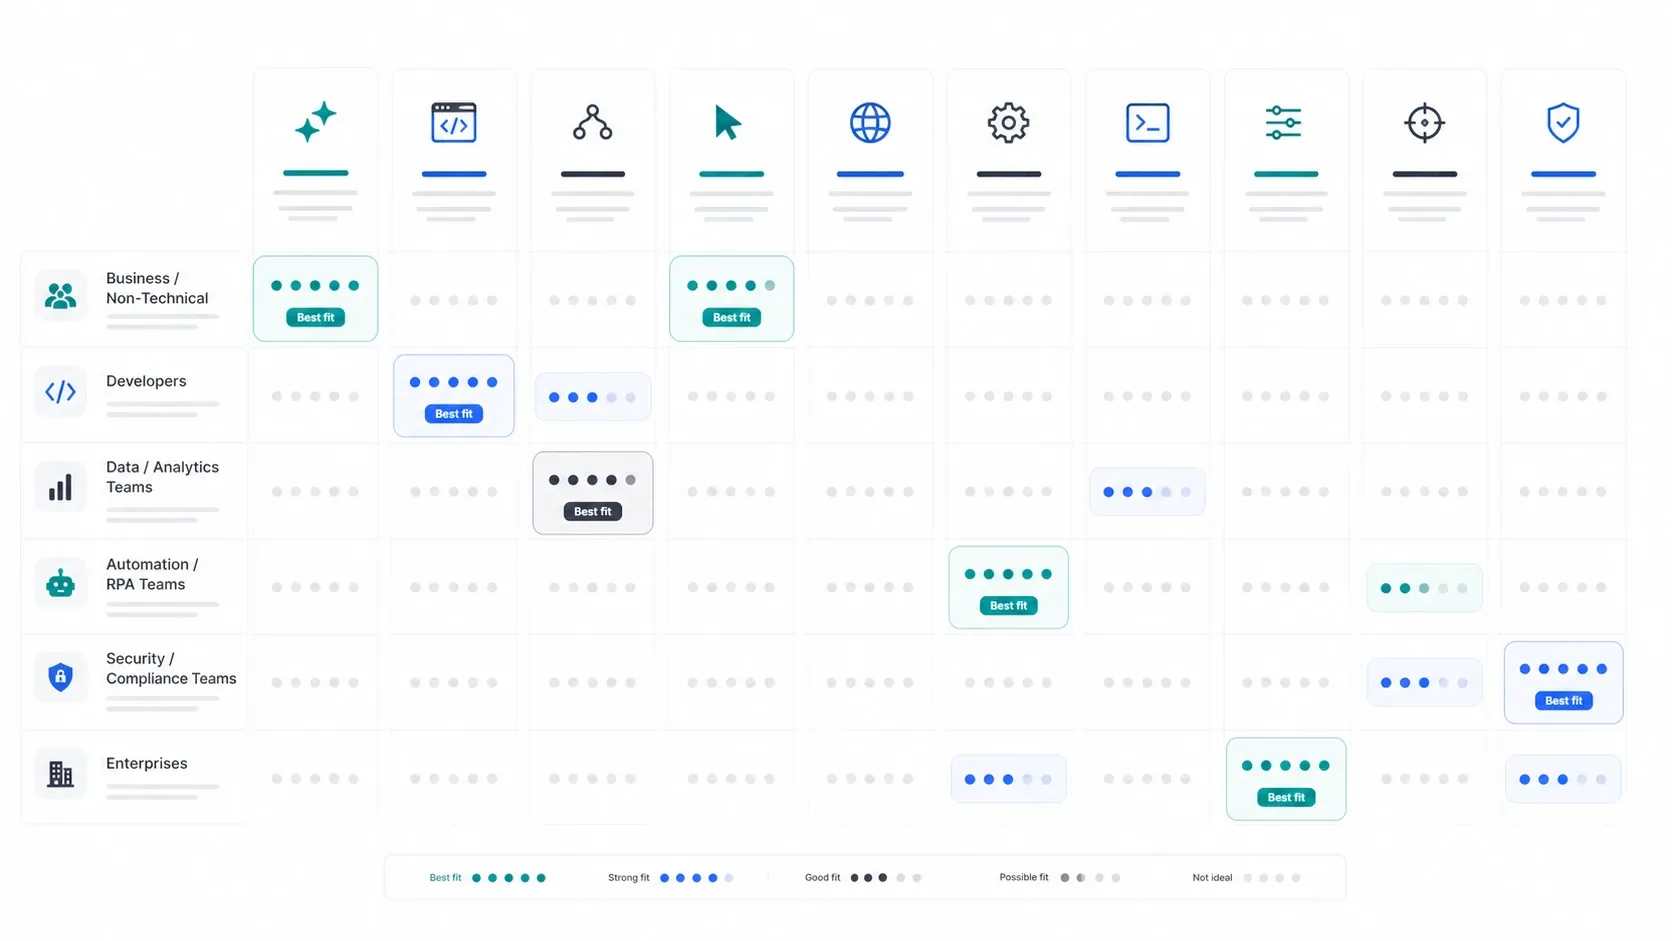
- Developer Python: mulai dari Scrapy untuk framework, MechanicalSoup untuk alur statis yang lebih kecil, dan Scrapling jika stealth atau friksi anti-bot sudah menjadi bagian dari masalah.
- Tim JavaScript atau TypeScript: mulai dari Crawlee untuk framework, Playwright untuk otomasi browser, dan Puppeteer jika workflow yang berfokus pada Chrome sudah cukup.
- Tim Go: Colly untuk scraping, Katana untuk crawling keamanan yang banyak discovery.
- Tim Java: WebMagic untuk crawling umum, Heritrix untuk pengambilan arsip, Apache Nutch untuk crawling terdistribusi bergaya search.
- Operator non-teknis: Maxun jika Anda ingin self-hosting open-source, atau Thunderbit jika Anda ingin workflow no-code terkelola yang lebih cepat menghasilkan output yang bisa dipakai.
Proyek Mana yang Sebaiknya Dijadikan Titik Mulai Kebanyakan Orang?
Jawaban pragmatisnya:
- Jika Anda ingin membangun dan memiliki scraper, mulai dari Scrapy atau Crawlee.
- Jika Anda perlu mengontrol browser sungguhan, mulai dari Playwright.
- Jika Anda butuh lapisan visual open-source, mulai dari Maxun.
- Jika Anda memerlukan crawling arsip atau keamanan yang spesifik, pilih Heritrix, Nutch, atau Katana hanya karena use case Anda memang menuntutnya.
- Jika Anda ingin melewati coding dan langsung dapat datanya, jangan memaksa diri masuk ke GitHub dulu. Pakai Thunderbit.
Kesimpulan
Proyek GitHub web scraping terbaik di 2026 lebih ditentukan oleh beban apa yang siap Anda tanggung daripada sekadar jumlah bintang. Scrapy masih menjadi default framework Python yang paling aman. Crawlee adalah pilihan framework JavaScript modern terbaik. Playwright adalah default otomasi browser yang paling kuat. Maxun adalah jalur no-code open-source yang paling menarik. Heritrix, Apache Nutch, dan Katana adalah tool spesialis yang sangat bagus hanya ketika kebutuhannya memang spesifik.
Yang paling penting adalah tidak mencampuradukkan “paling kuat” dengan “paling cocok”. Kalau tim Anda hanya butuh data bersih di spreadsheet, GitHub mungkin bukan titik awal yang tepat sama sekali.
Hindari Beban Pemeliharaan dan Mulai Scraping Lebih Cepat Get Started Free



