
Trustpilot punya 361 juta ulasan aktif dari 1,27 juta bisnis — dan sebagian besar scraper yang dibuat untuk mengambil data itu sudah jebol beberapa bulan lalu. Kalau kamu baru-baru ini coba menarik ulasan, besar kemungkinan kamu juga mentok di tembok login halaman 10 yang terkenal itu dan melihat tool kamu cuma balikin error.
Selama beberapa minggu terakhir, saya menguji, meneliti, dan membandingkan tool yang masih bisa mengekstrak data ulasan Trustpilot secara andal di 2026. Situasinya sudah jauh berubah: perlindungan anti-bot Trustpilot sekarang jauh lebih agresif, frontend Next.js-nya menghasilkan nama class yang berubah setiap kali deployment, dan — yang paling penting — akses tanpa autentikasi sekarang berhenti setelah cuma 10 halaman ulasan. Sebuah thread Reddit dari akhir 2025 menangkap frustrasi ini dengan sangat pas: "none of the actors on the store work."
Jadi, tool mana yang benar-benar jalan? Saya mengevaluasi lima tool berdasarkan cara mereka menghadapi tembok login, lapisan anti-bot, beban maintenance, dan kebutuhan praktis baik untuk marketer maupun developer.
Mengapa Scraping Ulasan Trustpilot Lebih Sulit dari yang Terlihat di 2026
Trustpilot bukan situs statis sederhana yang bisa kamu panggil dengan request HTTP biasa lalu di-parse pakai BeautifulSoup. Ini adalah platform modern yang dirender secara dinamis berbasis Next.js, dan pertahanannya jauh lebih ketat selama setahun terakhir.
Yang sebenarnya kamu hadapi:
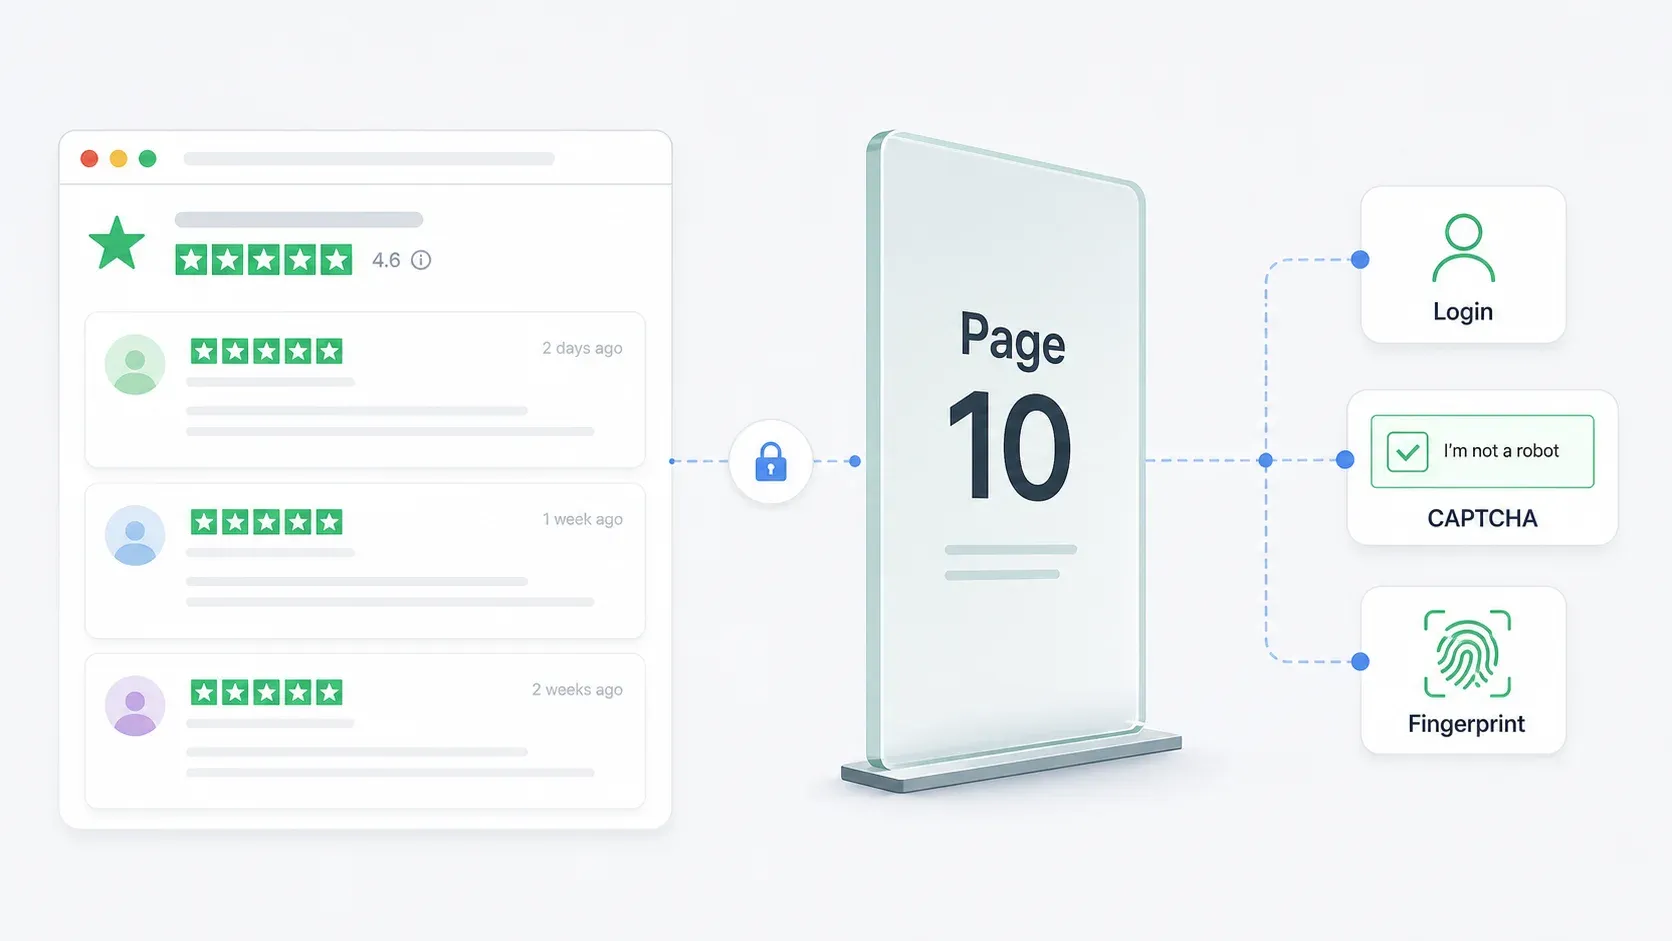
Tembok login di halaman 10. Ini titik paling nyebelin. Panduan Trustpilot dari Web Scraper sendiri pada Maret 2026 mengonfirmasi bahwa Trustpilot hanya mengizinkan 10 halaman ulasan pertama sebelum menampilkan prompt login. Untuk bisnis dengan 2.000 ulasan (sekitar 100 halaman kalau 20 ulasan per halaman), kamu kehilangan akses ke 90% data kecuali punya sesi terautentikasi.
Perlindungan anti-bot. Trustpilot memakai reCAPTCHA, pemblokiran berbasis sesi, filtering request di level CDN, dan browser fingerprinting. Halaman About mereka secara eksplisit menyebut situs ini "protected by reCAPTCHA" dan mengumpulkan sinyal perangkat serta interaksi.
Nama class CSS dinamis. Karena Trustpilot memakai Next.js dengan CSS modules, nama class seperti styles_reviewCardInner__EwDq2 dibuat saat build dan berubah setiap kali Trustpilot melakukan deployment update. Tutorial milik ScraperAPI bergantung pada selector persis seperti ini — artinya kode apa pun yang mengikuti tutorial itu bakal rusak saat Trustpilot mendorong perubahan frontend berikutnya.
Perubahan struktur DOM. Selain nama class, hierarki HTML yang sebenarnya juga bisa bergeser. Elemen bisa tersarang dengan cara berbeda, wrapper baru muncul, dan komponen pagination direstrukturisasi.
Scraper berbasis CSS selector — entah itu Apify Actor, workflow Octoparse, atau skrip Python kustom — secara struktural rapuh di Trustpilot. Mereka bekerja sampai tidak bekerja lagi. Dan "sampai tidak bekerja lagi" itu seringnya dihitung dalam hitungan minggu, bukan bulan.
Apa yang Kami Cari dari Scraper Review Trustpilot Terbaik
Saya tidak menilai tool-tool ini berdasarkan kriteria umum seperti "bisa scraping halaman web atau tidak". Semua tool di daftar ini bisa mengekstrak data dari halaman HTML sederhana.
Pertanyaan yang benar: apakah tool itu benar-benar sanggup menangani Trustpilot, lengkap dengan semua keunikannya, di 2026?
Inilah yang paling penting:
| Kriteria | Mengapa Penting untuk Trustpilot |
|---|---|
| Penanganan tembok login (halaman 10+) | Sebagian besar bisnis punya jauh lebih dari 200 ulasan. Batas 10 halaman berarti kamu kehilangan sebagian besar data historis. |
| Pendekatan bypass anti-bot | reCAPTCHA, pemblokiran sesi, dan filtering CDN akan langsung menghentikan scraper yang naif. |
| Ketahanan selector / maintenance | Class CSS yang di-generate sering merusak tool berbasis selector. Apakah tool-nya bisa self-heal? |
| Dukungan pagination | Ulasan bisa tersebar di ratusan halaman. Ekstraksi manual satu per satu jelas tidak realistis. |
| Tanpa kode vs butuh kode | Marketer butuh klik-klik; developer ingin kontrol penuh. |
| Harga / free tier | Tim dengan anggaran terbatas butuh kepastian sebelum komit. |
| Opsi ekspor | Pengguna bisnis butuh Google Sheets, Airtable, Notion — bukan sekadar JSON mentah. |
Tembok login adalah penentu utama.
Kalau sebuah tool tidak bisa melewati halaman 10 — atau setidaknya tidak punya jalur yang jelas untuk akses terautentikasi — maka itu bukan scraper Trustpilot yang layak di 2026.
Gambaran Singkat Scraper Review Trustpilot Terbaik
Perbandingan lengkap:
| Tool | Tingkat Keahlian | Penanganan Tembok Login | Pendekatan Anti-Bot | Pagination | Free Tier | Opsi Ekspor |
|---|---|---|---|---|---|---|
| Thunderbit | Tanpa kode | Mode browser (menggunakan sesi Chrome kamu yang sudah login) | Ekstraksi AI semantik menyesuaikan perubahan layout | Auto-detect, multi-halaman | 6 halaman gratis/bulan | Excel, Sheets, Airtable, Notion, CSV, JSON |
| Apify | Low-code | Tergantung Actor; beberapa butuh konfigurasi cookie untuk halaman >10 | Rotasi proxy bawaan, spesifik per Actor | Bisa dikonfigurasi per Actor | Kredit platform gratis $5/bulan | JSON, CSV, Excel, XML, RSS |
| Octoparse | Tanpa kode (visual) | Konfigurasi cookie/sesi manual | Rotasi IP, residential proxy, solving CAPTCHA (berbayar) | Workflow klik/scroll | Paket gratis + trial premium 14 hari | CSV, Excel, JSON, HTML, XML, database |
| Web Scraper | Tanpa kode (sitemap) | Terbatas — panduan resminya mendokumentasikan batas 10 halaman ulasan | Cloud + proxy pada paket berbayar | Bisa dikonfigurasi; disarankan klik via JS | Ekstensi Chrome gratis | CSV, XLSX |
| ScraperAPI | Developer (Python) | Manajemen sesi/cookie di level kode | 40M+ residential proxy, rendering JS, penanganan CAPTCHA | Berbasis kode | Trial 7 hari, 5.000 kredit API | Ditentukan developer (CSV, JSON, dll.) |
1. Thunderbit

Thunderbit adalah ekstensi Chrome berbasis AI yang dibuat untuk tim bisnis yang butuh data terstruktur dari website tanpa nulis kode. Untuk Trustpilot secara khusus, Thunderbit menyediakan template scraping ulasan khusus yang mengekstrak nama reviewer, rating, judul ulasan, teks ulasan, tanggal, dan respons bisnis hanya dengan satu klik.
Saya memang punya bias — saya bekerja di sini — tetapi alasan kami membangun Thunderbit seperti ini sangat terkait dengan kenapa scraping Trustpilot itu susah. AI kami membaca halaman secara semantik, bukan bergantung pada CSS selector. Saat Trustpilot mengubah nama class atau menyusun ulang DOM, Thunderbit tetap menyesuaikan karena ia melihat makna dari elemen halaman, bukan alamat HTML spesifiknya.
Coba Thunderbit untuk scraping Trustpilot
Cara Thunderbit Menangani Tembok Login di Halaman 10
Di sinilah mode browser jadi penting. Thunderbit berjalan di dalam browser Chrome kamu — browser yang sama tempat kamu sudah login ke Trustpilot. Saat kamu pindah ke mode browser scraping, ekstensi membaca halaman yang memang terlihat di sesi terautentikasi kamu. Tanpa trik proxy. Tanpa injection cookie. Tanpa pool sesi Playwright.
Alur praktisnya: login ke Trustpilot di Chrome, buka halaman ulasan yang kamu mau, lalu buka ekstensinya. Sekali klik, AI akan mengidentifikasi field ulasan yang ada di halaman lalu mengekstraknya sendiri. Mau output data yang berbeda? Jelaskan kebutuhannya dan AI akan mengikuti. Pagination berjalan otomatis setelah itu — Thunderbit akan memproses setiap halaman yang bisa diakses oleh sesi browser kamu.
Mengapa Thunderbit Tidak Mudah Rusak Saat Trustpilot Berubah
Halaman template Trustpilot kami membandingkan ini secara langsung: scraper tradisional rusak ketika layout berubah dan selector CSS perlu diperbarui. Thunderbit menggunakan AI semantik yang memahami konten tanpa bergantung pada CSS tertentu, menangani konten dinamis, dan mengelola auto-pagination.
Bandingkan dengan kode tutorial ScraperAPI, yang mem-parse berdasarkan class seperti styles_reviewCardInner__EwDq2. Selector itu akan rusak saat Trustpilot melakukan deploy berikutnya. AI Thunderbit bertanya "di mana teks ulasan di halaman ini?" alih-alih "apa isi div class spesifik ini?"
Fitur Utama untuk Scraping Trustpilot
- Field yang terdeteksi AI: ekstensi mengenali field ulasan sendiri (nama, rating, tanggal, judul, teks, respons bisnis) tanpa konfigurasi manual — atau, kalau kamu punya kebutuhan spesifik, cukup jelaskan dan AI akan mengikutinya
- Workflow satu klik: satu klik → tabel jadi. Beres.
- Mode browser untuk halaman yang butuh login: bekerja di sesi Chrome terautentikasi kamu untuk akses halaman 10+
- Auto-pagination: menangani set ulasan multi-halaman tanpa intervensi manual
- Scraping sub-halaman: bisa membuka profil reviewer individual untuk data tambahan
- Scraping terjadwal: atur pemantauan ulasan mingguan atau bulanan untuk tracking reputasi
- Ekspor: Google Sheets, Airtable, Notion, CSV, JSON — semuanya gratis
Harga
- Paket gratis: 6 halaman/bulan, tanpa kartu kredit
- Sistem berbasis kredit: 1 kredit = 1 baris output
- Paket berbayar: $15/bulan, atau sekitar $9/bulan jika ditagih tahunan (halaman harga)
Cocok untuk: Tim marketing, tim operasional, dan pengguna bisnis yang butuh ulasan Trustpilot tanpa menyentuh kode — dan yang tidak mau repot memelihara scraper yang rusak setiap beberapa minggu.
2. Apify
Apify adalah platform scraping berbasis cloud dengan marketplace "Actors" siap pakai — template scraping yang dibuat oleh pengguna lain dan tim Apify. Untuk Trustpilot, store mereka berisi beberapa Actor yang dikelola komunitas dengan tingkat reliabilitas yang berbeda-beda.
Trade-off di Apify: kuat, tapi terfragmentasi. Ada Actor yang jalan. Ada yang sudah usang. Ada yang butuh cookie untuk halaman 10+. Dan keluhan di Reddit bahwa "none of the actors on the store work" itu nyata — itu mencerminkan betapa cepatnya perubahan Trustpilot bisa merusak logika spesifik Actor.
Actor Trustpilot dan Keterbatasan yang Sudah Dikenal
Apify Store berisi beberapa Actor Trustpilot. Setidaknya satu (dari developer "burbn") secara eksplisit mendokumentasikan bahwa input cookie diperlukan untuk halaman di atas 10. Yang lain punya rating 0,0, jumlah pengguna sangat kecil, atau tanggal modifikasi yang sangat baru — sinyal bahwa maintenance masih berjalan dan reliabilitasnya bervariasi.
Actor yang sudah deprecated juga patut dicatat. Salah satu Actor lama membaca JSON __NEXT_DATA__ bawaan Trustpilot secara langsung — pendekatan cerdas yang lebih cepat daripada parsing DOM, tetapi tetap rusak ketika Trustpilot mengubah struktur datanya.
Penanganan Tembok Login dan Anti-Bot
- Tembok login: sepenuhnya tergantung Actor yang kamu pilih. Ada yang mendukung injection cookie untuk halaman 10+; ada juga yang tidak.
- Anti-bot: platform Apify menyertakan rotasi proxy dan infrastruktur berbasis compute unit. Residential proxy tersedia dengan harga $8/GB pada paket Free/Starter.
- Maintenance: saat Actor rusak, kamu harus menunggu maintainer memperbaikinya, pindah ke Actor lain, atau memesan private Actor kustom.
Harga
- Paket gratis: kredit pemakaian pra-bayar $5/bulan, tanpa kartu kredit
- Starter: $9/bulan + bayar sesuai penggunaan
- Scale: $99/bulan + bayar sesuai penggunaan
- Ekspor: JSON, CSV, Excel, XML, RSS (tergantung Actor)
Cocok untuk: Pengguna yang cukup teknis untuk mengevaluasi beberapa Actor, mengonfigurasi cookie, dan troubleshooting saat ada masalah. Kurang ideal untuk tim yang ingin solusi tinggal pakai.
3. Octoparse
Octoparse adalah scraper tanpa kode berbasis desktop dengan builder workflow visual point-and-click. Posisi tool ini ada di antara kesederhanaan satu klik milik Thunderbit dan kontrol penuh milik ScraperAPI — kamu dapat konfigurasi visual tanpa kode, tetapi kamu tetap membangun dan memelihara workflow.
Menyiapkan Scrape Trustpilot di Octoparse
Workflow-nya cukup sederhana, tetapi manual:
- Tempel URL ulasan bisnis Trustpilot
- Pilih elemen ulasan secara visual (judul, isi, rating, tanggal, nama reviewer)
- Tentukan loop pagination memakai tombol halaman berikutnya
- Konfigurasikan waktu tunggu (disarankan 2–5 detik agar tidak memicu reCAPTCHA)
- Jalankan secara lokal untuk sampel kecil atau di cloud untuk job yang lebih besar
Setup ini memakan 10–15 menit bagi orang yang sudah familiar dengan tool-nya. Tantangannya: karena Octoparse memakai visual selector yang terkait dengan elemen DOM, kamu perlu memperbarui workflow setiap kali Trustpilot mengubah struktur halamannya.
Penanganan Tembok Login dan Anti-Bot
- Tembok login: perlu konfigurasi login/cookie/sesi manual. Tidak ditangani otomatis.
- Anti-bot: paket berbayar mencakup rotasi IP, residential proxy ($3/GB), dan solving CAPTCHA otomatis ($1–1,5 per seribu).
- Maintenance: sedang. Kamu perlu membangun ulang atau menyesuaikan workflow saat Trustpilot memperbarui frontend.
Harga
- Paket gratis: gratis selamanya, 10 tugas, 1 perangkat, ekstraksi lokal, hingga 50.000 baris/bulan
- Standard: $69/bulan (ditagih tahunan)
- Professional: $149/bulan
- Trial premium 14 hari: termasuk cloud extraction, scheduling, API, dan template
- Ekspor: Excel, CSV, JSON, HTML, XML; database dan Google Sheets di tier yang lebih tinggi
Cocok untuk: Pengguna yang ingin kontrol workflow visual, tidak keberatan dengan waktu setup awal, dan nyaman memelihara workflow saat halaman berubah. Bagus untuk tim yang butuh lebih banyak kustomisasi daripada tool satu klik, tapi tidak serumit menulis Python.
4. Web Scraper
Web Scraper adalah ekstensi Chrome dan platform cloud dengan pendekatan scraping berbasis sitemap. Penawaran Trustpilot terkuatnya adalah template halaman bisnis siap pakai yang mengekstrak data level perusahaan: nama bisnis, kategori, alamat, rating, jumlah ulasan, TrustScore, dan URL website.
Untuk scraping ulasan secara spesifik, Web Scraper punya keterbatasan yang perlu dicatat.
Template Siap Pakai vs Setup Kustom
Template marketplace-nya bekerja dengan baik untuk discovery perusahaan — scraping profil bisnis di berbagai kategori Trustpilot. Untuk ekstraksi ulasan kustom, Sitemap Wizard memungkinkan kamu membangun scraper secara visual di dalam ekstensi Chrome.
Panduan resmi Web Scraper pada Maret 2026 merekomendasikan pagination berbasis klik JavaScript alih-alih pagination berbasis URL, karena Trustpilot bisa mengubah urutan konten secara dinamis antar halaman dan membuat hasil bergeser.
Penanganan Tembok Login dan Anti-Bot
Di sinilah kejujuran penting: panduan resmi Web Scraper secara eksplisit menyatakan bahwa Trustpilot hanya mengizinkan 10 halaman ulasan pertama sebelum menampilkan prompt login. Panduan itu mendokumentasikan ini sebagai keterbatasan yang diketahui, bukan menawarkan workaround.
- Tembok login: penanganan terbatas. Batas 10 halaman ulasan didokumentasikan di panduan mereka sendiri.
- Anti-bot: paket cloud mendukung proxy; panduan menyarankan delay 2–5 detik dan concurrency yang dikurangi.
- Pagination: bisa dikonfigurasi, tetapi secara praktik terbatas pada 10 halaman ulasan pertama untuk akses tanpa autentikasi.
Harga
- Ekstensi Chrome gratis: scraping lokal, fungsi terbatas
- Project: $50/bulan (5.000 kredit URL)
- Professional: $100/bulan (20.000 kredit URL)
- Scale: mulai $200/bulan (kredit URL tak terbatas dengan syarat tertentu)
- Trial gratis 7 hari pada paket cloud berbayar
- Ekspor: CSV, XLSX
Cocok untuk: Pengguna yang ingin template siap pakai untuk scraping profil perusahaan Trustpilot, atau yang cuma butuh ulasan dari 10 halaman pertama. Bukan pilihan tepat kalau kamu butuh riwayat ulasan lengkap untuk bisnis dengan jumlah ulasan besar.
5. ScraperAPI
ScraperAPI adalah infrastruktur scraping untuk developer — bukan tool point-and-click, melainkan layer proxy/rendering yang menangani anti-bot sementara kamu menulis logika parsing. Halaman solusi Trustpilot mereka mengiklankan rendering JS, penanganan CAPTCHA, dan 40M+ proxy.
Kalau kamu developer Python yang ingin kontrol penuh atas logika ekstraksi, ScraperAPI menyediakan infrastrukturnya.
Tapi kamu juga yang pegang maintenance-nya.
Membangun Scraper Trustpilot Kustom dengan ScraperAPI
Tutorial ScraperAPI dari Januari 2026 menunjukkan workflow Python + BeautifulSoup:
import requests
from bs4 import BeautifulSoup

payload = {
    "api_key": "YOUR_API_KEY",
    "url": "https://www.trustpilot.com/review/example.com",
    "render": "true",
    "keep_headers": "true",
}

html = requests.get("https://api.scraperapi.com", params=payload).text
soup = BeautifulSoup(html, "html.parser")
Kode selesai pada tutorial tersebut mengatur pages_to_scrape = 10 — secara implisit mengakui batas halaman publik. Untuk halaman 10+, developer harus mengelola sesi terautentikasi, cookie, dan token sendiri.
Penanganan Tembok Login dan Anti-Bot
- Tembok login: butuh manajemen sesi/cookie di level kode. ScraperAPI menangani proxy dan rendering; kamu menangani logika autentikasi.
- Anti-bot: pool residential proxy dengan rotasi IP otomatis, rendering JS lewat
render=true, penanganan CAPTCHA melalui rotasi proxy cerdas. Tersedia di semua paket. - Maintenance: saat Trustpilot mengubah nama class (dan itu memang sering terjadi), kamu harus memperbarui kode parsing. Selector
styles_reviewCardInner__EwDq2di tutorial itu sudah seperti bom waktu.
Harga
- Trial 7 hari: 5.000 kredit API gratis, tanpa kartu kredit
- Hobby: $49/bulan (100.000 kredit API)
- Startup: $149/bulan (1.000.000 kredit)
- Business: $299/bulan (3.000.000 kredit)
- Ekspor: apa pun yang dihasilkan kode kamu (biasanya CSV, JSON, penulisan ke database)
Cocok untuk: Developer yang ingin kustomisasi penuh, bisa memelihara skrip parsing sendiri, dan butuh kontrol terprogram atas manajemen sesi, logika pagination, dan struktur data. Bukan untuk pengguna non-teknis.
Mengapa Scraper Trustpilot Sering Rusak (dan Cara Memilih yang Tidak Mudah Rusak)
Ini faktor yang paling sering diremehkan saat memilih scraper Trustpilot. Pertanyaannya bukan "apakah tool ini bekerja hari ini?" Melainkan "apakah tool ini masih akan bekerja tiga minggu lagi?"
Scraper rusak di Trustpilot karena empat alasan yang berulang:
-
Perubahan class CSS yang di-generate. CSS modules Next.js menghasilkan nama class seperti
styles_reviewCardInner__EwDq2. Ini berubah setiap kali frontend di-deploy ulang. Scraper yang menargetkan class ini akan rusak. -
Perubahan struktur DOM. Trustpilot bisa menyusun ulang hierarki HTML-nya — kartu ulasan disusun berbeda, elemen wrapper berubah, metadata dipindah ke posisi lain.
-
Perubahan trigger anti-bot. Ambang reCAPTCHA bergeser. Rotasi token sesi jadi lebih agresif. Aturan filtering CDN diperbarui.
-
Perubahan autentikasi/sesi. Tembok login halaman 10 diperkenalkan (atau ditegakkan lebih ketat) pada akhir 2025. Pembatasan akses baru bisa muncul kapan saja.
Perbedaan arsitektur mendasarnya adalah antara ekstraksi berbasis selector dan semantik:
-
Tool berbasis selector (Apify Actor, workflow Octoparse, skrip ScraperAPI, sitemap Web Scraper) bertanya: "Cari elemen di jalur CSS persis ini." Saat jalurnya berubah, tool akan gagal diam-diam atau mengembalikan data kosong.
-
Tool semantik/AI (Thunderbit) bertanya: "Cari teks ulasan, rating, dan tanggal di halaman ini." AI menafsirkan konten halaman berdasarkan makna, bukan alamat. Perubahan layout tidak mematahkannya karena maknanya tidak berubah.
Rekomendasi saya:
- Tidak tahan maintenance sama sekali? → Berbasis AI (Thunderbit)
- Masih oke ada maintenance, ingin otomasi cloud? → Apify (dengan pemilihan Actor dan monitoring)
- Ingin kontrol visual, maintenance sedang? → Octoparse
- Berbasis template, cakupan terbatas? → Web Scraper
- Kontrol penuh, semua di tangan sendiri? → ScraperAPI
Apa yang Bisa Dilakukan dengan Ulasan Trustpilot yang Sudah Di-scrape
Mengekstrak ulasan hanyalah langkah pertama. Pertanyaan yang sering saya lihat di forum: "Datanya sudah ada — lalu apa?"
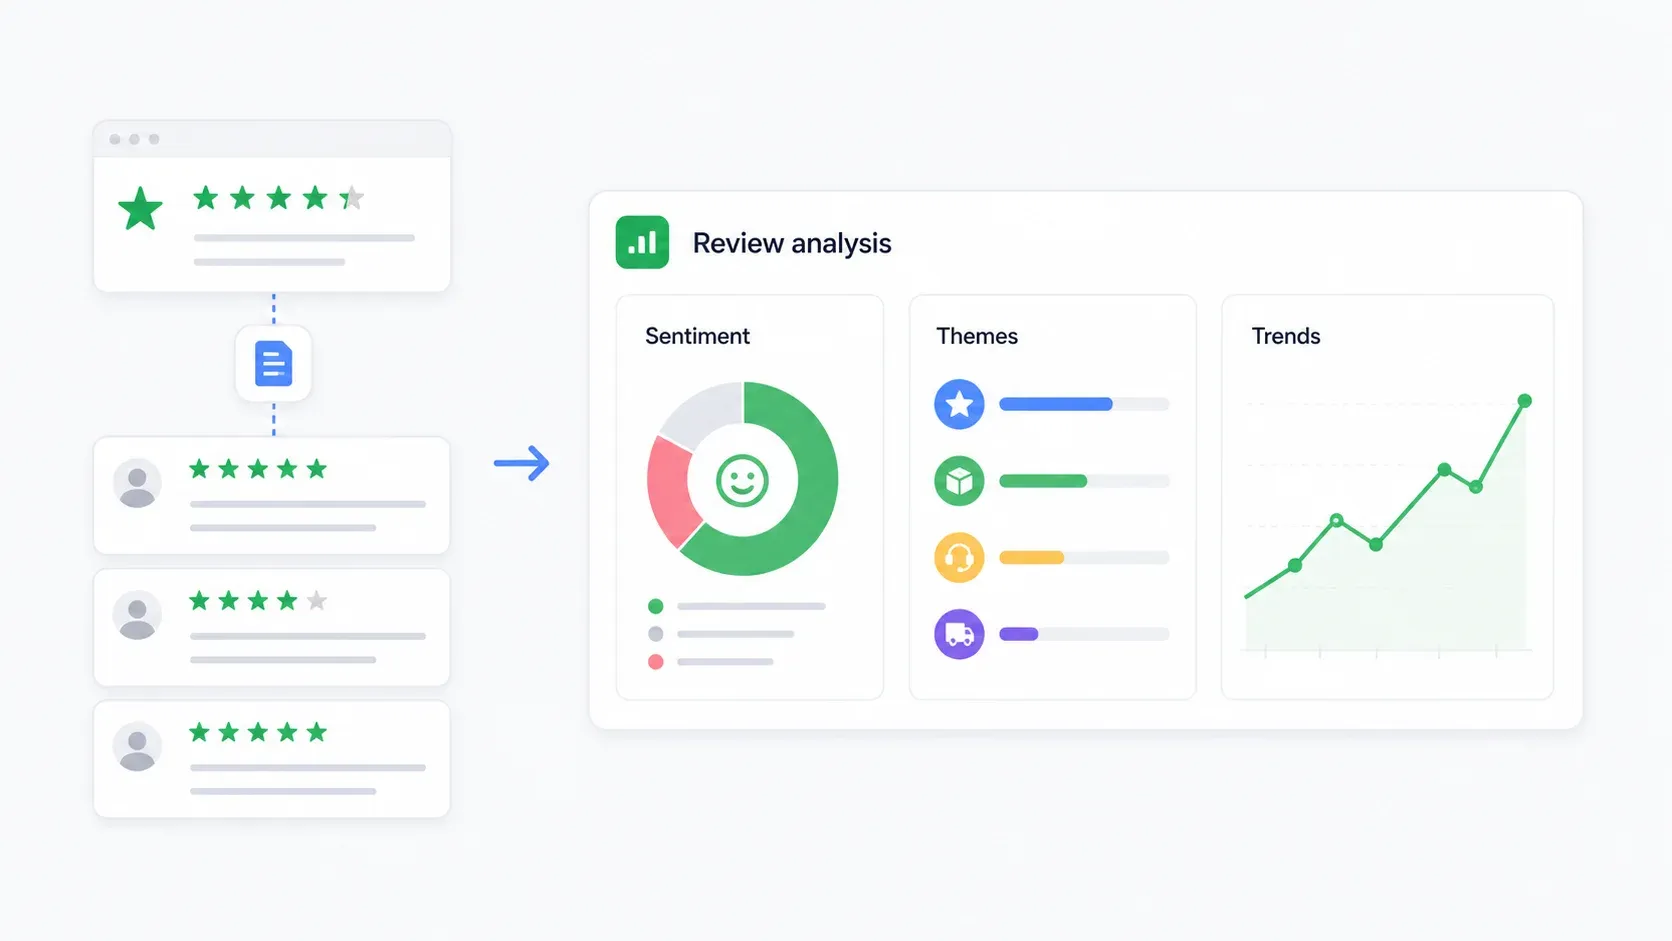
Analisis Sentimen
Workflow paling sederhana: ekspor ulasan ke Google Sheets, lalu gunakan tool AI (ChatGPT, Claude, atau fungsi AI di Sheets) untuk mengklasifikasikan tiap ulasan sebagai positif, netral, atau negatif. Tambahkan kolom untuk kategori keluhan, urgensi, dan prioritas tindakan yang disarankan.
Untuk dataset yang lebih besar, upload CSV ke ChatGPT dan minta ringkasan: "Klasifikasikan ulasan ini berdasarkan sentimen dan identifikasi 5 tema keluhan teratas beserta kutipan representatif."
Pemantauan Kompetitor
Gunakan scraping terjadwal Thunderbit untuk menarik ulasan kompetitor mingguan atau bulanan. Lacak:
- Tren rating rata-rata dari waktu ke waktu
- Proporsi ulasan bintang 1 dan 2
- Perubahan volume ulasan (apakah mereka mendapat lebih banyak atau lebih sedikit ulasan?)
- Tema keluhan yang paling umum
- Tingkat dan kecepatan respons bisnis
Dashboard Google Sheets sederhana dengan pivot table berdasarkan rating dan tanggal memberi kamu feed intelijen kompetitif yang selalu diperbarui.
Ekstraksi Tema
Kelompokkan ulasan berdasarkan kategori umum: pengiriman/delivery, customer support, refund, kualitas produk, billing, usability aplikasi, harga/nilai, dan kekhawatiran penipuan. Output-nya sebaiknya berupa tabel yang menampilkan: tema, jumlah, rating rata-rata, kutipan representatif, dan tindakan bisnis yang disarankan.
Ini jauh lebih berguna daripada word cloud. Ini menunjukkan apa yang benar-benar mendorong kepuasan atau ketidakpuasan.
Analisis Massal Multi-Bisnis
Untuk riset tingkat kategori, scrape ulasan di beberapa bisnis dalam kategori Trustpilot yang sama. Bandingkan volume ulasan, rating, distribusi bintang, dan prevalensi tema di seluruh segmen pasar. Template listing bisnis milik Web Scraper berguna untuk menemukan perusahaan; Thunderbit atau ScraperAPI bisa menangani sampling level ulasan untuk masing-masing.
Pertimbangan Legal dan Etis dalam Scraping Trustpilot
Saya bukan pengacara, dan ini bukan nasihat hukum. Tapi realitas kepatuhan tetap penting di sini.
Syarat Penggunaan Trustpilot cukup jelas. Mereka melarang pengguna mengakses atau mengumpulkan konten "dengan cara apa pun selain yang disediakan atau secara khusus disetujui oleh Trustpilot," dan secara spesifik menyebut text mining, data mining, serta web scraping tanpa izin eksplisit.
Spektrum risikonya seperti ini:
- Risiko lebih rendah: Mengekspor ulasan milik perusahaan kamu sendiri untuk analisis internal, terutama menggunakan tool bisnis resmi atau API Trustpilot.
- Risiko sedang: Scraping halaman kompetitor yang publik dalam volume rendah untuk riset pasar. Tetap tunduk pada ToS dan kewajiban privasi.
- Risiko lebih tinggi: Scraping konten halaman 10+ yang dipagari autentikasi, melewati kontrol teknis, mendistribusikan ulang data reviewer, atau memakai ulasan yang di-scrape untuk training model AI.
Pertimbangan GDPR: Nama reviewer, link profil, teks ulasan, dan data lokasi dapat tergolong data pribadi menurut hukum privasi Uni Eropa. Pengamanan praktis mencakup hanya mengambil field yang memang diperlukan, melakukan hashing pada nama reviewer untuk analitik internal, menetapkan periode retensi data, dan tidak memublikasikan ulang teks ulasan mentah dalam skala besar.
Data publik vs data terautentikasi: Ada perbedaan legal dan etis yang signifikan antara scraping halaman yang bisa dilihat siapa pun (10 halaman ulasan pertama) dan scraping data di balik tembok autentikasi. Tool yang bekerja hanya lewat data publik membawa risiko kepatuhan yang lebih rendah dibanding tool yang memerlukan kredensial login.
Ini harus jadi faktor dalam pemilihan tool kamu. Mode browser Thunderbit bekerja dengan halaman yang terlihat di sesi kamu sendiri — bukan membypass autentikasi secara independen. ScraperAPI memberi developer kontrol penuh, tetapi juga tanggung jawab penuh atas legalitas manajemen sesi.
Cara Memilih Scraper Review Trustpilot yang Tepat
Kerangka keputusan berdasarkan persona:
- Marketer non-teknis yang butuh ulasan tanpa kode? → Thunderbit. Satu klik, AI menangani sisanya, ekspor ke Sheets/Notion/Airtable.
- Pengguna low-code yang nyaman dengan konfigurasi dan debugging? → Apify. Pilih Actor, konfigurasi cookie untuk halaman 10+, pantau kalau ada yang rusak.
- Builder visual yang ingin kontrol workflow? → Octoparse. Setup klik-klik, tapi siap-siap maintenance saat Trustpilot berubah.
- Butuh data level perusahaan atau cuma ulasan 10 halaman pertama? → Web Scraper. Template siap pakai yang kuat untuk profil bisnis.
- Developer yang ingin kustomisasi penuh? → ScraperAPI. Kamu yang pegang logika parsing, manajemen sesi, dan pipeline data.
Kalau toleransi maintenance jadi perhatian utama, spektrumnya bergerak dari Thunderbit (hampir nol maintenance) sampai ScraperAPI (kamu memelihara semuanya). Dari sisi anggaran, semua tool di daftar ini punya entry point gratis — mulai dari situ sebelum komit.
Kesimpulan
Data ulasan Trustpilot benar-benar bernilai untuk competitive intelligence, pemantauan reputasi, dan insight pelanggan.
Namun di 2026, mengekstraknya secara andal butuh tool yang bisa menangani tembok login halaman 10, menyesuaikan diri dengan perubahan DOM, dan mengelola perlindungan anti-bot tanpa intervensi manual terus-menerus.
Bagi sebagian besar pengguna bisnis, Thunderbit adalah jalur paling gampang — satu klik, deteksi field berbasis AI, mode browser untuk halaman terautentikasi, dan tanpa maintenance saat Trustpilot mengubah frontend-nya. Kamu bisa mencobanya gratis dengan 6 halaman/bulan dan tanpa kartu kredit.
Bagi developer yang ingin kontrol penuh, ScraperAPI menyediakan infrastrukturnya. Untuk semua yang berada di tengah, Apify, Octoparse, dan Web Scraper masing-masing melayani ceruk yang spesifik. Kuncinya adalah mencocokkan tool dengan kenyamanan teknis, toleransi maintenance, dan kebutuhan kepatuhan kamu.
Kalau kamu ingin lihat bagaimana Thunderbit menangani Trustpilot secara spesifik, kami punya walkthrough di channel YouTube kami. Dan untuk konteks yang lebih luas tentang web scraping tanpa coding atau apa sebenarnya web scraping itu, panduan tersebut membahas dasarnya.
FAQ
1. Bisakah kamu scraping ulasan Trustpilot melewati halaman 10?
Ya, tapi hanya lewat jalur terautentikasi. Trustpilot memblokir akses tanpa login setelah 10 halaman ulasan pertama. Mode browser Thunderbit berjalan di dalam sesi Chrome kamu yang sudah login, jadi bisa mengakses halaman yang memang bisa kamu lihat. ScraperAPI memerlukan manajemen sesi/cookie di level kode. Actor Apify perlu konfigurasi cookie. Octoparse memerlukan setup login/cookie manual. Dokumentasi resmi Web Scraper sendiri mengakui batas 10 halaman tanpa menawarkan workaround bawaan.
2. Apakah legal untuk scraping ulasan Trustpilot?
Syarat Penggunaan Trustpilot melarang pengumpulan data otomatis tanpa izin eksplisit. Risiko hukumnya bervariasi tergantung metode dan kasus penggunaan: scraping ulasan publik milik sendiri risikonya lebih rendah dibanding membypass tembok autentikasi untuk scraping kompetitor. GDPR berlaku untuk data reviewer di Uni Eropa. Ini bukan nasihat hukum — konsultasikan dengan penasihat hukum untuk proyek scraping skala besar atau komersial.
3. Data apa saja yang bisa diekstrak dari Trustpilot?
Field yang umum mencakup: nama reviewer, rating bintang, judul ulasan, teks ulasan, tanggal posting, tanggal pengalaman, status verified purchase, lokasi reviewer, teks respons bisnis, nama perusahaan, TrustScore, total jumlah ulasan, distribusi bintang, dan URL ulasan.
4. Seberapa sering scraper Trustpilot rusak?
Tool berbasis selector (Apify Actor, workflow Octoparse, skrip Python kustom) bisa rusak setiap kali Trustpilot mengubah class CSS atau struktur DOM-nya — dan ini bisa terjadi beberapa kali dalam sebulan. Tool AI semantik seperti Thunderbit beradaptasi otomatis karena menafsirkan makna halaman, bukan menarget selector tertentu. Namun, tidak ada tool yang kebal terhadap perubahan besar pada kontrol akses seperti tembok login halaman 10.
5. Bisakah saya scraping ulasan Trustpilot secara gratis?
Setiap tool di daftar ini punya entry point gratis: Thunderbit menawarkan 6 halaman gratis/bulan, ScraperAPI menyediakan 5.000 kredit trial selama 7 hari, Web Scraper punya ekstensi Chrome gratis untuk penggunaan lokal, Octoparse punya paket gratis selamanya (10 tugas, 50.000 baris/bulan), dan Apify menyertakan kredit platform gratis $5/bulan. Untuk sampling kecil atau pengujian, semuanya bisa dipakai tanpa pembayaran.
Coba Thunderbit untuk scraping ulasan Trustpilot Get Started Free
Pelajari Lebih Lanjut



