
Facebook scraping עדיין יכול להיות משתלם גם ב-2026 — אבל רק אם בוחרים את מודל האיסוף הנכון. Pew Research Center דיווח ב-20 בנובמבר 2025 כי 71% מהמבוגרים בארה״ב משתמשים ב-Facebook, ו-Meta מסרה ב-29 באפריל 2026 כי משפחת האפליקציות שלה הגיעה ל-3.56 מיליארד אנשים פעילים מדי יום במרץ 2026. בקנה מידה כזה, Facebook נשאר רלוונטי לניטור Marketplace, מחקר של דפים ציבוריים, יצירת לידים ומעקב אחר מתחרים. הבעיה היא לא למצוא שימושים. הבעיה היא להשיג נתונים נקיים בלי להיתקע מול מסכי התחברות, טעינות דינמיות, חסימות זמניות או מערכי scraping שבירים.
הרשימה הקצרה השנתית הזו נבנתה כדי לעזור לך להחליט מהר. בדקתי מחדש באוגוסט 2026 את דפי המוצר הרשמיים, התיעוד וסימני התמחור, ושמרתי את הרשימה ממוקדת בכלים שעדיין הגיוניים למשתמשים עסקיים אמיתיים. אם אתם צריכים תשתית ברמת API, Bright Data, Apify ו-Nimble by Nimbleway נמצאים בראש הרשימה. אם העבודה שלכם כוללת אוטומציות בענן או פעולות המשך אחרי האיסוף, PhantomBuster שווה בדיקה מעמיקה יותר.
בחירות מהירות לפי צורך
- צריכים מסלול רשמי לנכס שאתם מנהלים? התחילו עם כלי הניהול של Meta ועם APIs מאושרים.
- צריכים API ייעודי לנתונים ציבוריים? בדקו את Bright Data או את Apify מול היעד המדויק והשימוש המותר.
- צריכים שכבת תשתית כללית לנתוני רשת? בדקו את Nimble או את ScrapingBot באמצעות הוכחת היתכנות מוגבלת.
- צריכים תהליך ויזואלי עבור מקור שאינו של Meta ואשר השימוש בו מותר? Octoparse עשוי להתאים לתהליך שנמצא בבעלות אנליסט.
למה איסוף נתונים מ-Facebook עדיין מורכב ב-2026
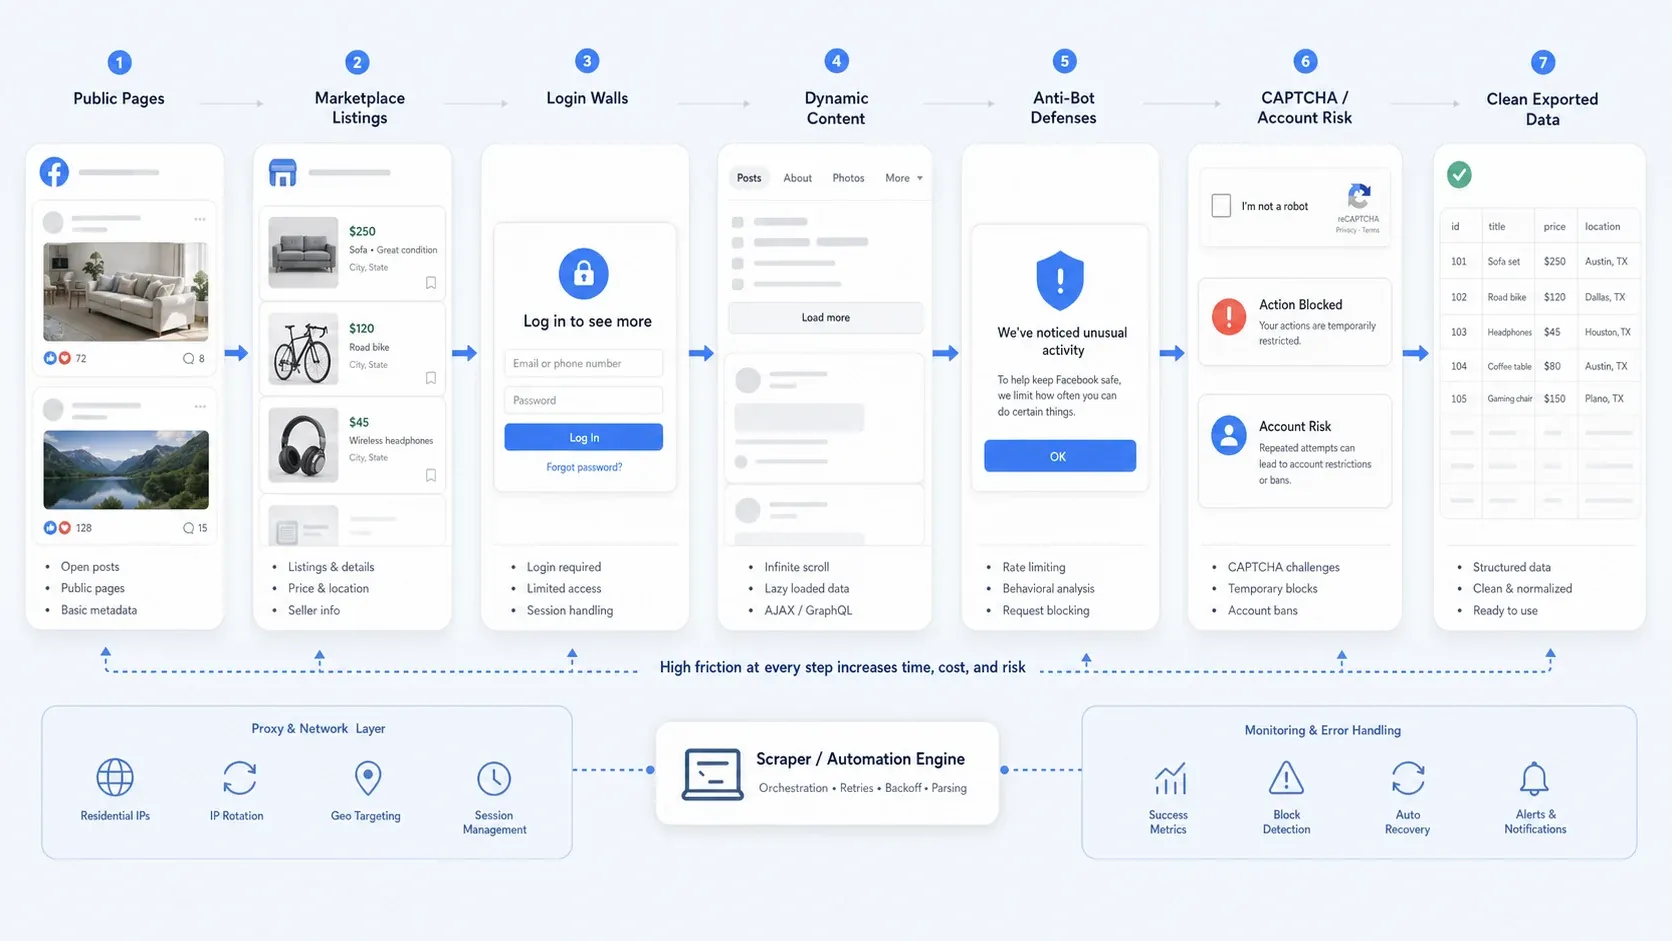
web scraping facebook כבר מזמן לא מסתכם רק ב-selector נכון. בפועל, רוב הצוותים נתקלים באחת או יותר מהבעיות הבאות:
- גישה ציבורית חלקית: חלק מהדפים נשארים פתוחים, אבל זרימות אחרות דוחפות אתכם להתחבר כדי לראות עוד פרטים.
- תוכן דינמי: תצוגות של Marketplace, שרשורי תגובות ארוכים ותוכן דפים נטענים לעיתים בהדרגה.
- הגנות נגד bots: הגבלת קצב, בדיקות התנהגות, CAPTCHA וחסימות זמניות משבשות אוטומציות פשוטות.
- סיכון תפעולי: איסוף שדורש התחברות לחשבון מסוכן הרבה יותר מ-scraping של דפים ציבוריים, במיוחד אם חשובה לכם בטיחות החשבון ויכולת שחזור.
איך הערכתי את הכלים האלה
בניתי את העמוד הזה כדי לעזור לבחור, לא כדי להעמיס עליו פיצ'רים מיותרים. הכלים כאן נבחנו לפי:
- התאמה לזרימת העבודה: האם המוצר באמת מתאים למשימות איסוף מ-Facebook ומ-Marketplace שצוותים עובדים עליהן בפועל?
- קלות שימוש: האם גם מי שאינם מפתחים או צוותים קטנים יכולים להפיק תוצאה שימושית במהירות?
- סקייל ואמינות: האם הכלי עדיין הגיוני כשעוברים מ-scrape חד-פעמי לעבודה חוזרת?
- התמודדות עם חסימות וניהול סשנים: כמה כאב תשתיתי המוצר חוסך?
- איכות הפלט: האם אפשר לקבל נתונים מובְנים ל-CSV, Sheets או למערכות המשך בלי הרבה ניקוי?
- איתות תמחור: האם המוצר פרקטי לבדיקה, או שהוא דורש תהליך ארגוני כבד?
- עמדה כלפי ציות ועמידה בכללים: האם הכלי מכוון בבירור לאיסוף נתונים ציבוריים ולשימוש אחראי?
איזה סוג של Facebook Scraper אתם צריכים?
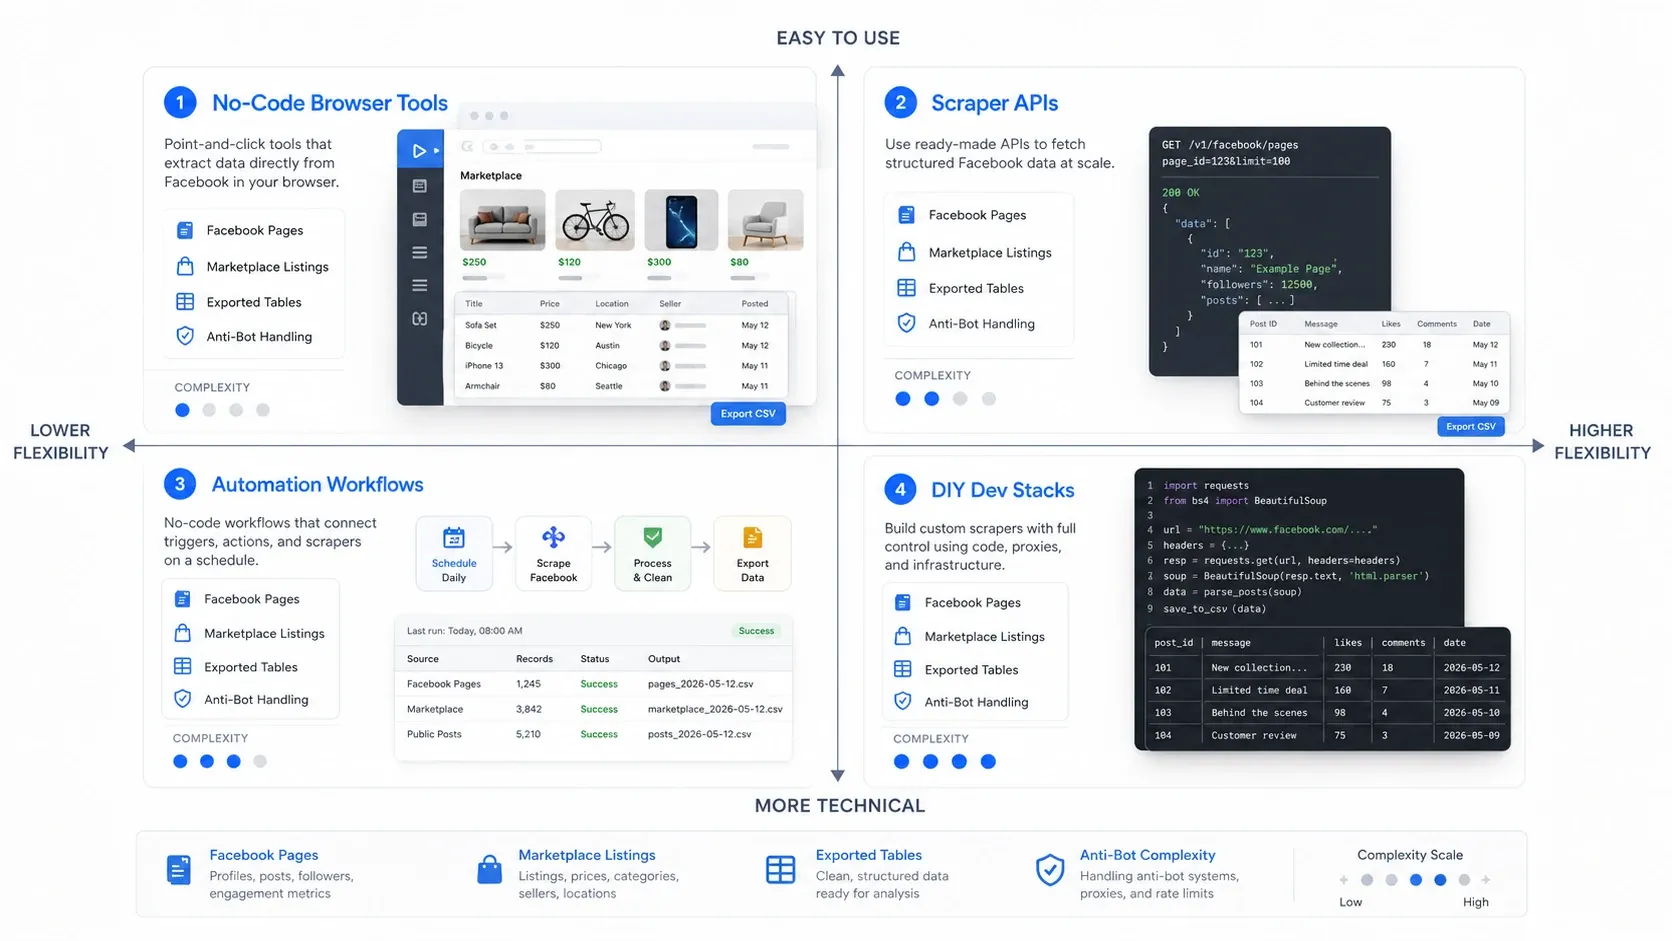
הדרך המהירה ביותר לבחור נכון היא קודם לבחור את הקטגוריה הנכונה. כלי scraping ל-Facebook מתחלקים בדרך כלל לארבעה מודלים:
- כלי browser ללא קוד: מתאימים כשצריך חילוץ מהיר מהעמוד שכבר פתוח מולכם.
- Scraper APIs: מתאימים כשצריך איסוף אמין וחוזר בנפח גבוה יותר.
- זרימות אוטומציה: מתאימות כש-scraping הוא רק שלב אחד בתהליך go-to-market רחב יותר.
- ערימות DIY למפתחים: מתאימות כשיש צורך בשליטה מרבית והצוות מוכן לשאת בעול התחזוקה.
טבלת השוואה
| כלי | התאמה הטובה ביותר | מודל פעולה |
|---|---|---|
| Bright Data | זרימת עבודה מנוהלת של API לנתונים ציבוריים | API ייעודי ושכבת מסירה |
| Apify | משימה חוזרת לדף או פרופיל | Actor בענן ופלט Dataset |
| Nimble | בדיקה הנדסית | API כללי לרשת ציבורית |
| ScrapingBot | בדיקה עם יכולת rendering | API כללי ל-scraping |
| PhantomBuster | זרימת GTM על חשבון בבעלותכם | אוטומציית Prospects |
| Octoparse | משימה ויזואלית בבעלות אנליסט | זרימה ויזואלית ללא קוד |
1. Bright Data
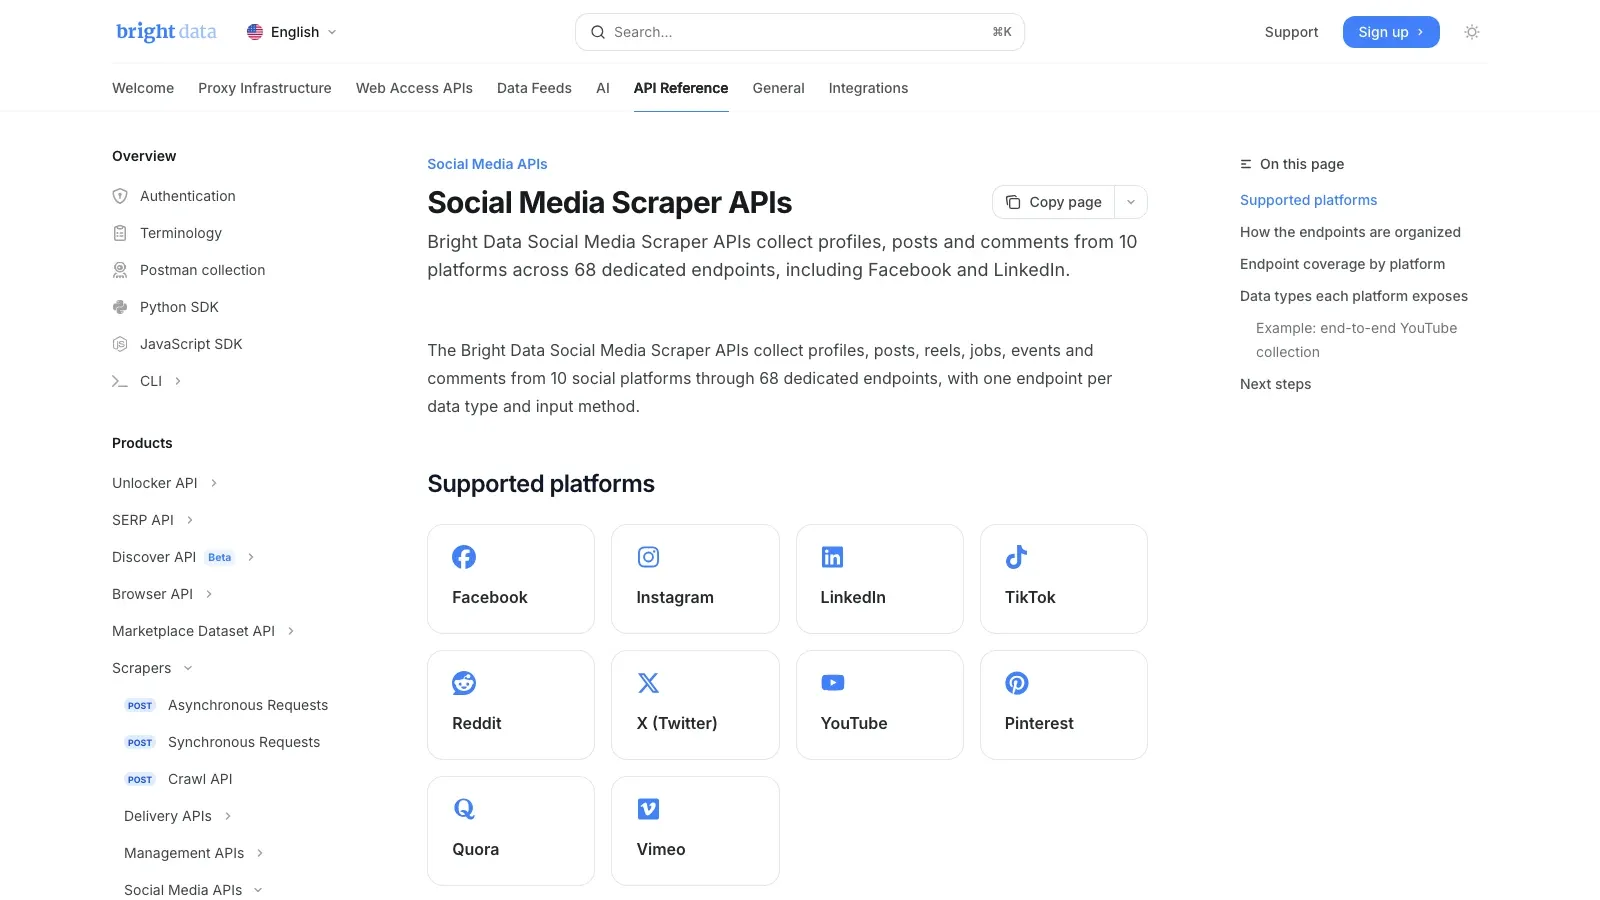
Bright Data הוא הבחירה של “תשתית קודם כול”. לפי התיעוד של Bright Data, Social Media Scraper APIs שלו מכסים 10 פלטפורמות ו-68 endpoints ייעודיים, כולל Facebook. אם המשימה שלכם היא איסוף בקנה מידה גדול של נתונים ציבוריים, stack מנוהל כזה הוא בדרך כלל מציאותי הרבה יותר מאשר ניסיון להגדיל תוסף browser או scraper שנבנה ידנית.
למה הוא נכנס לרשימה הקצרה:
- Endpoints ייעודיים ל-scraping של רשתות חברתיות
- ניהול מובנה של unblocking ושל חילוץ נתונים
- מסירה של פלט מובנה לצינורות נתונים
- התאמה טובה יותר לניטור ולניתוח שדורשים אמינות גבוהה
מתאים במיוחד ל: אנליסטים, צוותי דאטה, פרויקטי ניטור גדולים ו-datasets ציבוריים בקנה מידה.
איתות תמחור: המחיר משתנה לפי מוצר ונפח. בדקו מול התמחור הנוכחי של Bright Data.
2. Apify
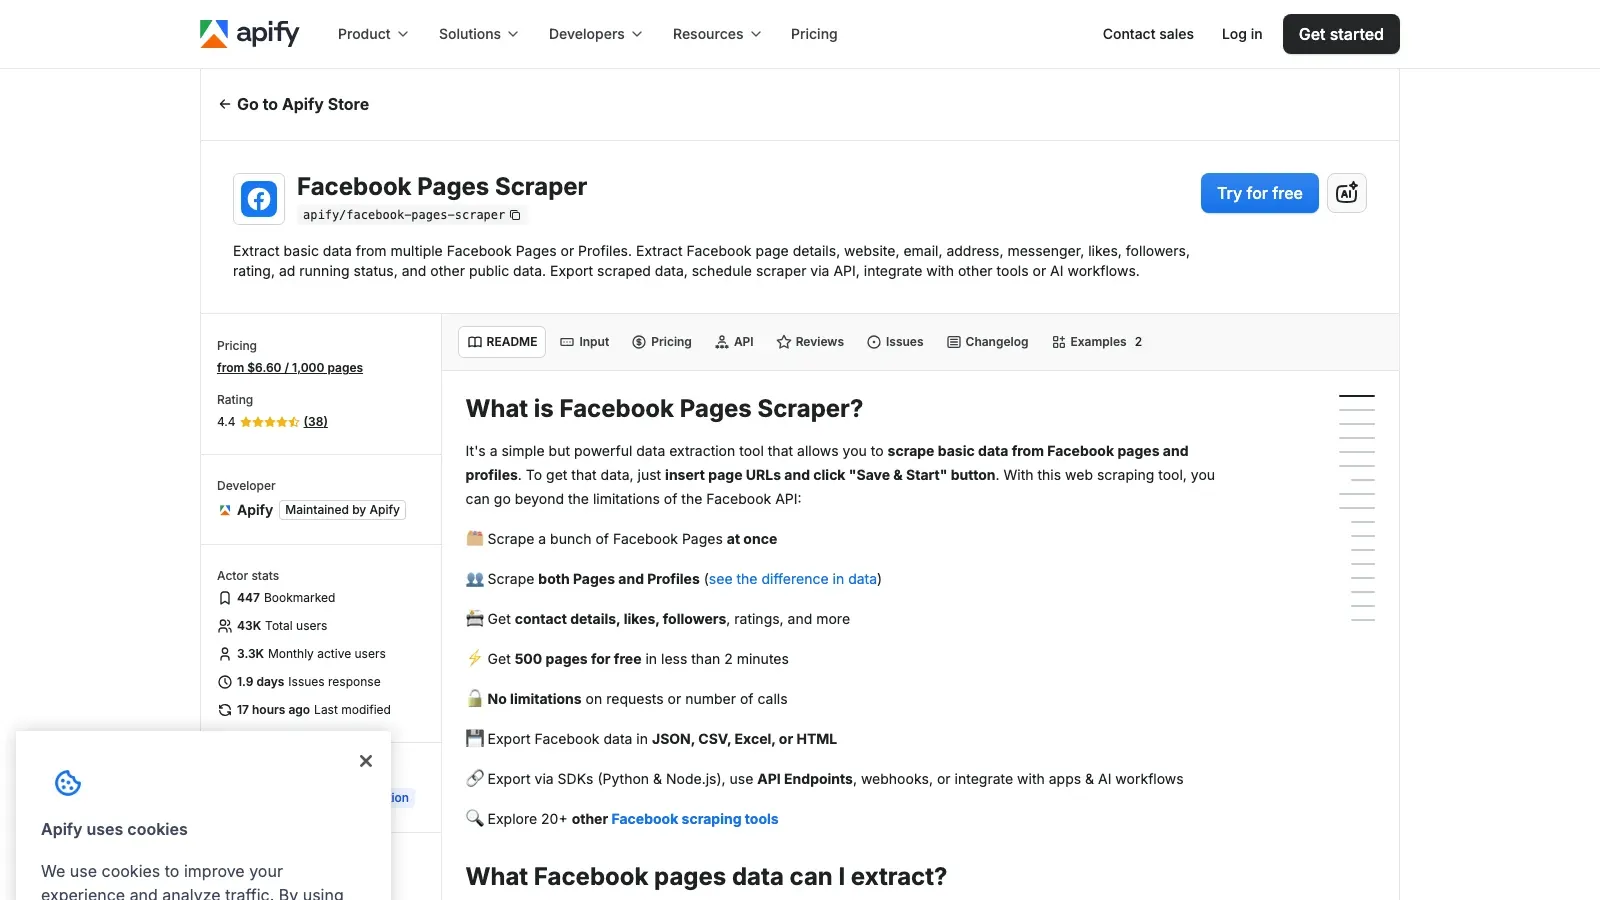
Apify נשאר רלוונטי כי הוא נותן איזון טוב בין תבניות לבין התאמה מלאה. ה-Facebook Pages Scraper actor שלו הוא נקודת פתיחה שימושית, בעוד שהפלטפורמה הרחבה של Apify מספקת הרצה בענן, תזמון, APIs ומרחב להרחיב את הזרימה אם הצרכים נהיים מורכבים יותר.
למה הוא נכנס לרשימה:
- Actors מוכנים ל-Facebook
- הרצה בענן ותזמונים חוזרים
- ייצוא גמיש וגישה ל-API
- קל יותר להרחבה מאשר workflow ויזואלי פשוט ללא קוד
מתאים במיוחד ל: marketers טכניים, סוכנויות, צוותי ops ומשימות איסוף חוזרות בכמה אתרים.
איתות תמחור: תוכניות הפלטפורמה בתשלום, ושימוש ב-actor מחויב בנפרד לפי צריכה. בדקו את התמחור של Apify.
3. Nimble by Nimbleway
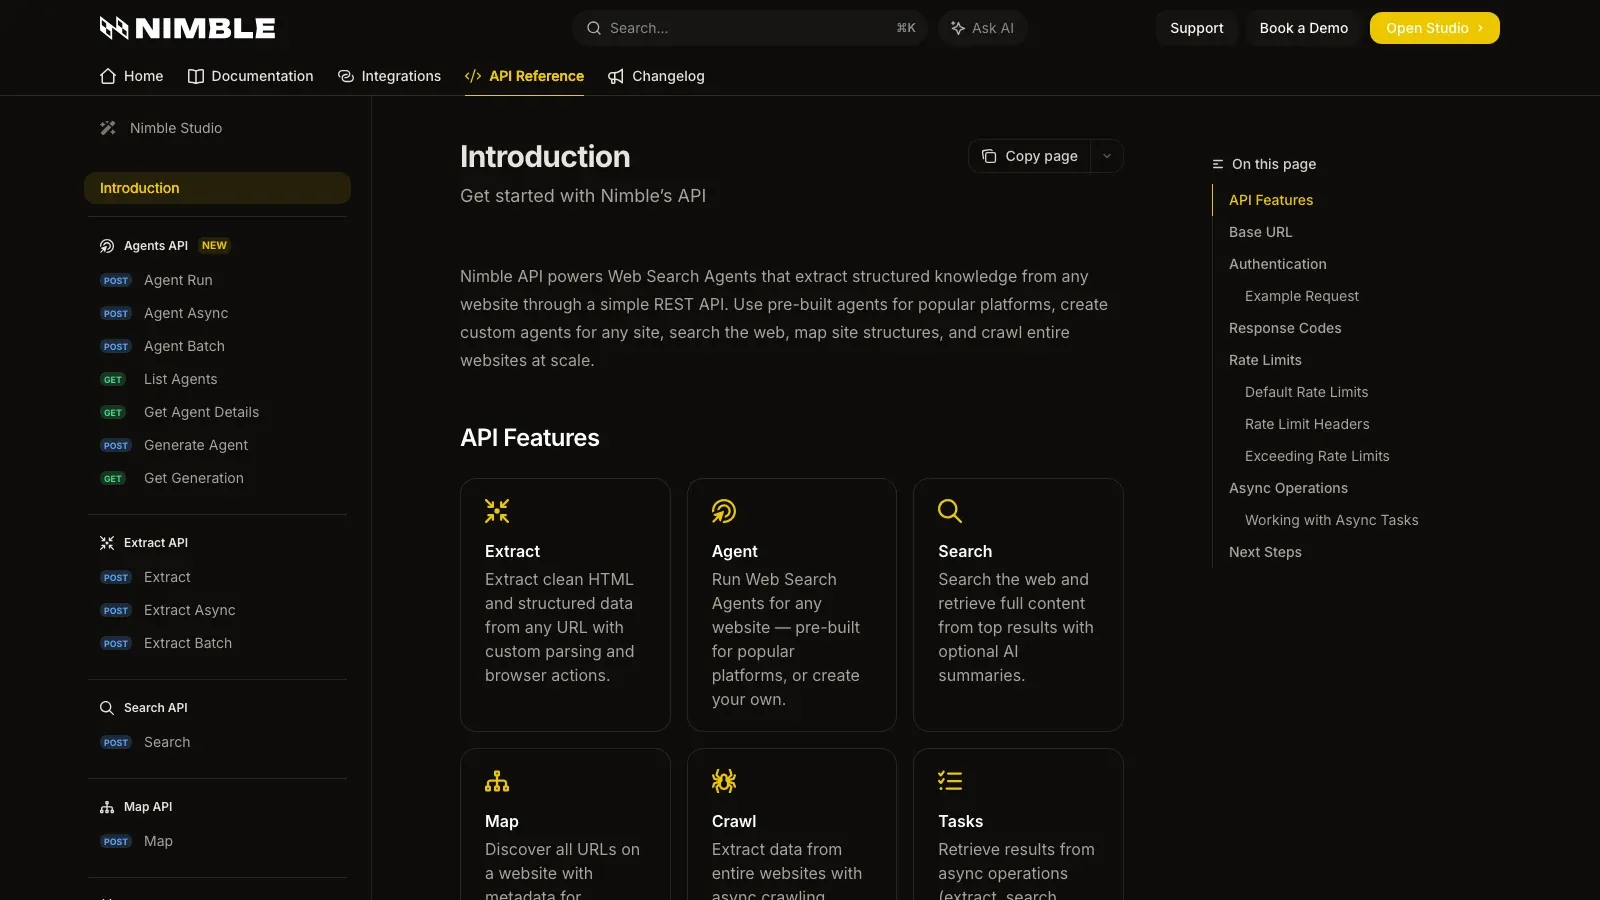
Nimble by Nimbleway הוא ה-option שמכוון ל-API-First עבור צוותים שרוצים לשלוח URL ולתת לפלטפורמה לטפל בגישה, rendering ומסירה. Nimble מציב את Web Scraper API שלו ככלי לאיסוף נתוני רשת ציבורית מקצה לקצה, ולכן הוא שימושי במיוחד כש-Facebook scraping הוא רק חלק אחד מתשתית דאטה רחבה יותר.
למה כדאי לבדוק אותו:
- זרימת API שמתחילה מ-URL
- פחות עומס תחזוקה על צוותי הנדסה
- התאמה טובה לחילוץ עמיד של נתונים מרשת ציבורית
- שימושי כשהנתונים נכנסים למוצרים פנימיים או לדשבורדים
מתאים במיוחד ל: צוותים בהובלת הנדסה, צינורות נתונים מוצריים וארגונים שרוצים שכבת תשתית ולא כלי נקודתי.
איתות תמחור: Nimble לא מדגיש תמחור self-serve פומבי בדפי ה-API המרכזיים שלו, ולכן כדאי לצפות למודל מכירה דרך צוות מכירות ולאמת ישירות מול Nimble by Nimbleway.
4. ScrapingBot
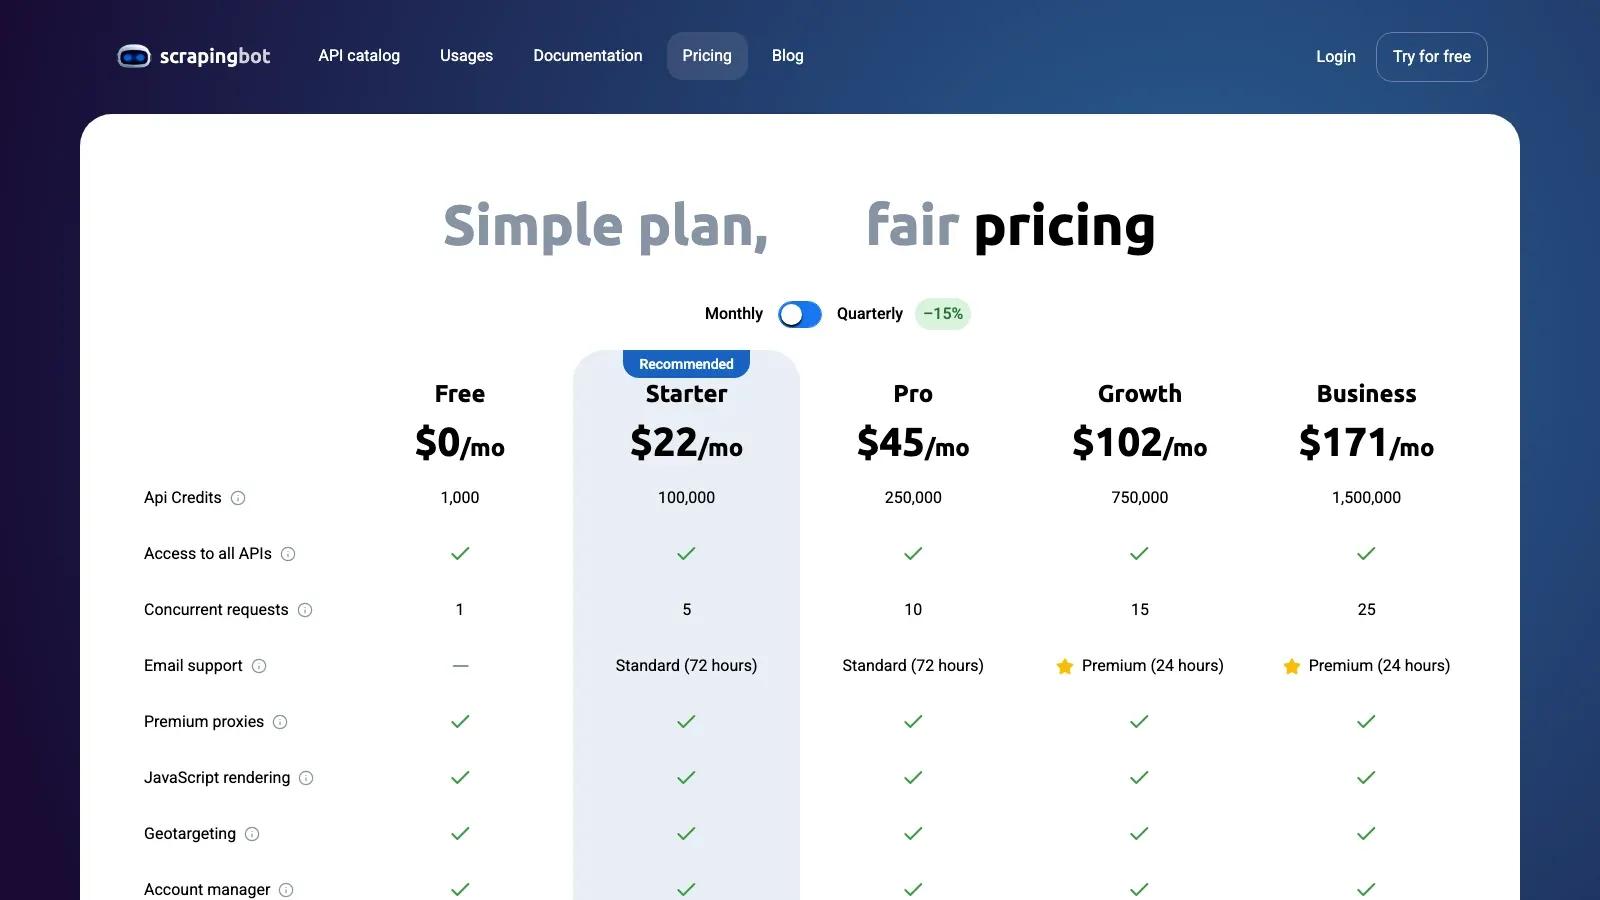
ScrapingBot הוא ה-API החסכוני יותר ברשימה הזו. זה לא ה-platform הכי מעמיק ל-Facebook, אבל הוא עדיין הגיוני למשימות נתונים ציבוריים קטנות יותר, כשצריך API, תמיכה ב-rendering ועלות כניסה נמוכה יותר מתשתית scraping ארגונית.
איפה הוא מתאים:
- איסוף ציבורי פשוט באמצעות API
- מחיר כניסה נמוך יותר
- כולל rendering וניהול proxy
- מתאים יותר ל-prototypes ולמשיכות חוזרות קלות מאשר לתוכניות intelligence גדולות
מתאים במיוחד ל: סטארטאפים, עסקים קטנים ומפתחים שבודקים שימושים קלים יותר לאיסוף דפים ציבוריים.
איתות תמחור: יש תוכנית חינמית; דף התמחור הציבורי הנוכחי מתחיל מכ-$22 לחודש.
5. PhantomBuster
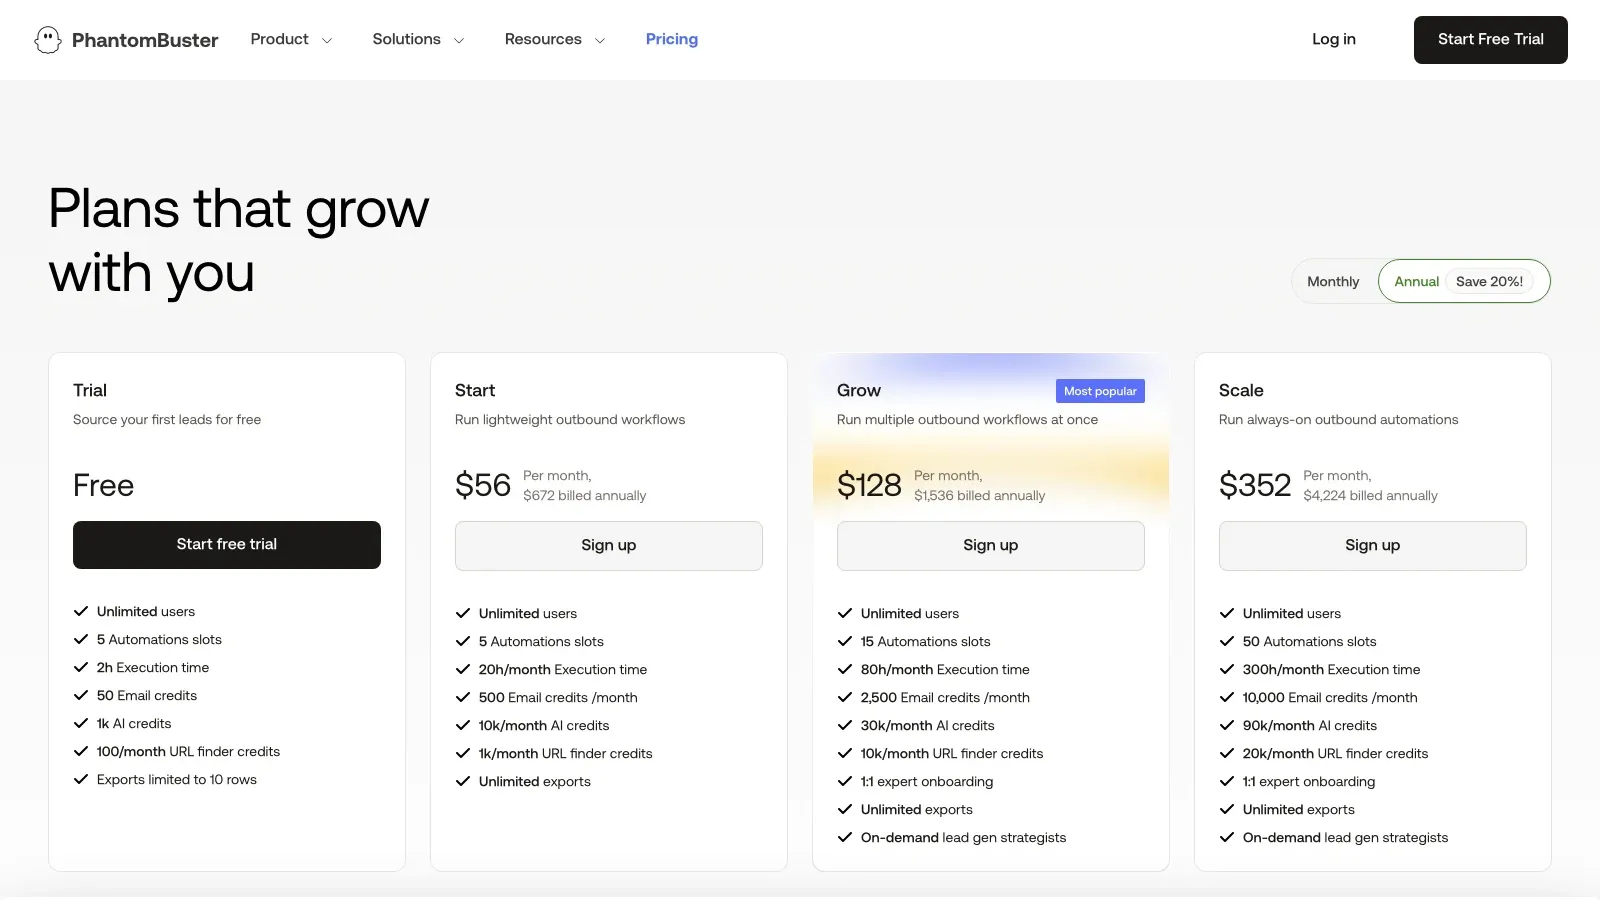
PhantomBuster עוסק פחות בתשתית scraping גולמית ויותר במה שקורה אחרי האיסוף. אם המקרה שלכם הוא “לאסוף את הנתונים ואז להפעיל outreach, enrichment או פעולות המשך”, PhantomBuster לרוב שימושי יותר ממחלץ פשוט, כי הוא בנוי סביב אוטומציות בענן וזרימות פעולה מבוססות browser.
למה צוותים עדיין בוחרים בו:
- זרימות אוטומציה בענן
- שימושי ליצירת לידים ולפעולות GTM
- התאמה טובה יותר כש-scraping הוא רק שלב אחד בתהליך רחב
- פרקטי למפעילים שאכפת להם מפעולות ולא רק מייצוא
מתאים במיוחד ל: צוותי GTM, צוותי growth, מגייסים ומפעילים שמחברים איסוף לפעולה בהמשך.
איתות תמחור: יש trial חינמי; התוכניות בתשלום בדף התמחור הנוכחי מתחילות מכ-$56 לחודש.
6. Octoparse
Octoparse נשאר אחד מכלי ה-scraping הוויזואליים ללא קוד הטובים יותר למשתמשים שרוצים workflows חוזרים והרצות ענן מתוזמנות. הוא נותן לא-מפתחים שליטה ברורה יותר על אופן בניית הלוגיקה של האיסוף ועל חזרה עליה, במחיר של יותר הגדרה ראשונית מאשר workflow חד-פעמי קליל.
למה הוא עדיין רלוונטי:
- בונה workflow ויזואלי של point-and-click
- איסוף בענן ותזמון
- מתאים היטב למשימות מובְנות שחוזרות על עצמן
- מתאים יותר לאנליסטים שרוצים עקביות בלי קוד
מתאים במיוחד ל: אנליסטים לא טכניים, צוותי ops ב-SMB ומשימות איסוף חוזרות עם לוגיקה ויזואלית ברורה.
איתות תמחור: דף התמחור הציבורי של Octoparse מציג תוכניות בתשלום שמתחילות מכ-$69 לחודש לתוכנית Standard, בחיוב שנתי.
רשימה קצרה לפי צוות
- Workflow שמבוסס API: Bright Data או Apify
- הערכה של נתוני רשת ציבורית בבעלות הנדסה: Nimble או ScrapingBot
- Workflow ל-prospecting דרך חשבון בבעלותכם: PhantomBuster
- Workflow ויזואלי וניתן לעריכה: Octoparse
לפני שבוחרים אפשרות כלשהי, בדקו את סוג הדף ואת השדות המדויקים שהצוות שלכם מורשה להשתמש בהם. הנראות ב-Facebook משתנה בין Pages, Profiles, Marketplace, Groups, מיקומים ומצב החשבון.
השורה התחתונה
המסלול הנכון תלוי בנתונים, במודל הגישה ובאחריות של הצוות לאימות. עבור נכסים שאתם מנהלים, התחילו עם כלי Meta הרשמיים ועם APIs מאושרים. למחקר מחוץ לתחום הזה, בחרו ספק או מקור רק אחרי שתאמתו את סוג הדף, השימוש המותר, חובות הפרטיות וההתנהגות הנוכחית של המוצר.
שאלות נפוצות
איזה מסלול כדאי למשתמש לא טכני לשקול קודם?
עבור נכס שהארגון שלכם מנהל, התחילו עם כלי הניהול והאנליטיקה של Meta. לצורך מחקר רחב יותר, זהו מקור מותר שה-workflow וזכויות הנתונים שלו ניתנים לבדיקה.
איזו אפשרות הכי טובה לשילוב עם תוכנה או צינור נתונים?
בדקו API ייעודי ל-Facebook כמו Bright Data, פלטפורמה מבוססת actor כמו Apify, או API כללי לרשת ציבורית — אבל רק דרך בדיקה מוגבלת מול היעד המדויק.
האם הכלים האלה יכולים לעקוף מגבלות גישה של Facebook?
לא. אין להשתמש בכלי כדי לעקוף בקרות פלטפורמה, מסכי התחברות או הגנות פרטיות.




