
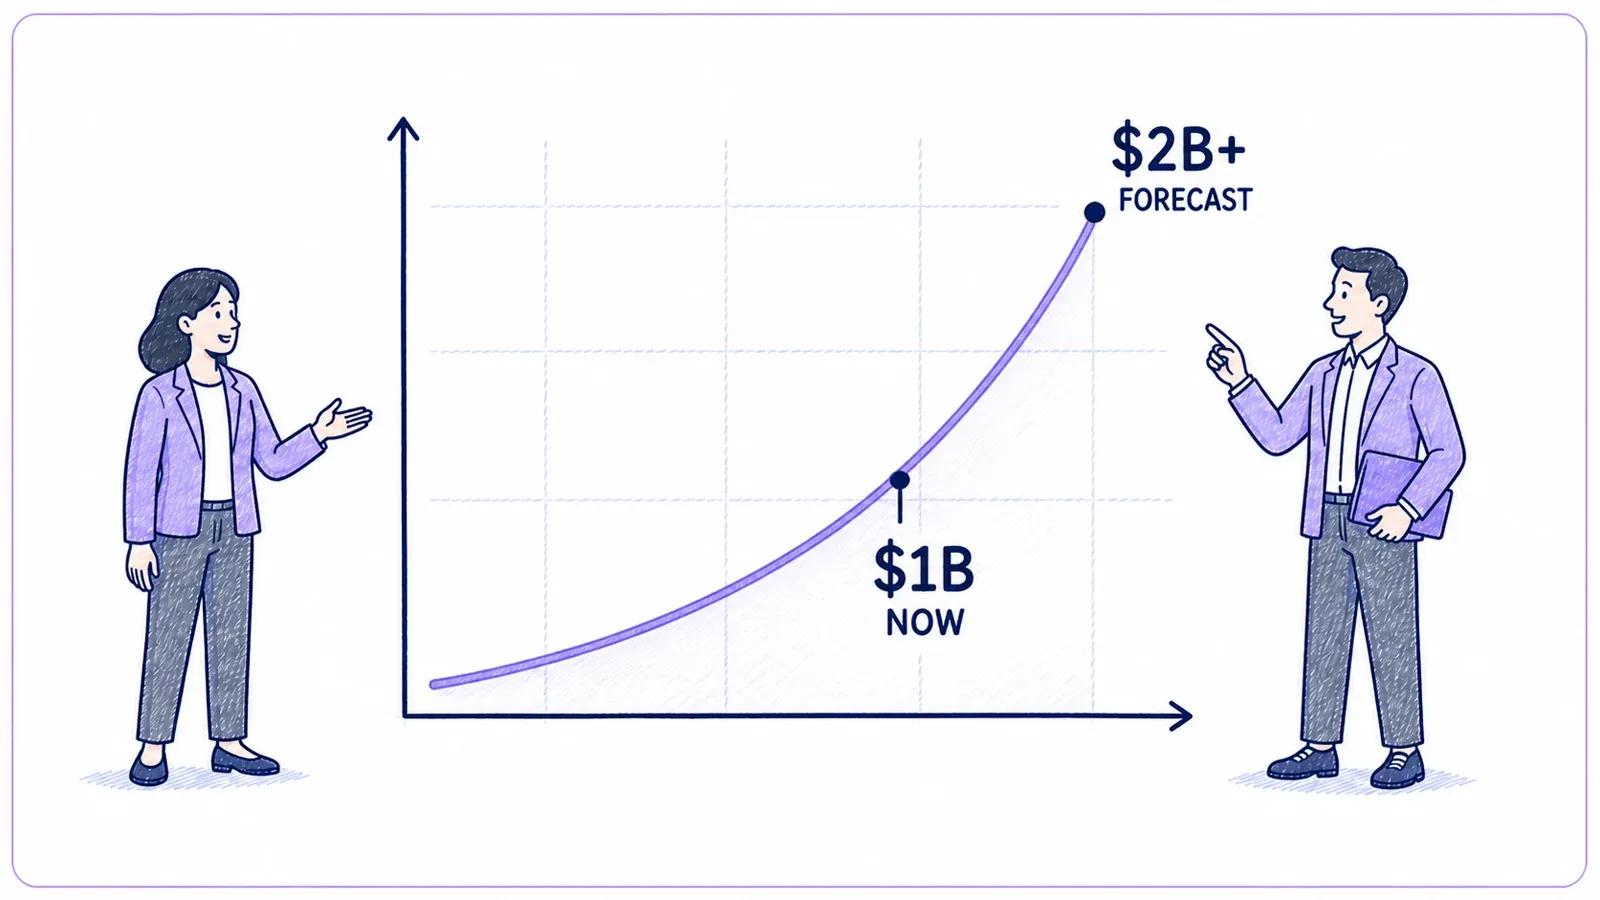
בואו נדבר רגע בכנות: בשנת 2026, אם אתם עדיין מעתיקים ומדביקים נתונים מאתרים ידנית, זה בערך כמו לרוץ מרתון בכפכפים. שוק תוכנות ה-web scraping הגיע ל־1.01 מיליארד דולר ב־2024 וצפוי להגיע ל־2.49 מיליארד דולר עד 2032, לפי דוח מצב ה-web scraping של Apify. יותר ממחצית מהעסקים בארה״ב כבר אוספים נתוני אינטרנט חיצוניים—עוקבים אחרי מתחרים, מנטרים מחירים ובונים רשימות לידים—כי הם יודעים שמי שמקבל את המידע הכי עדכני, מנצח.
חלצו נתוני אתר עם AI בלחיצה אחת ה־agentic web scraper של Thunderbit קורא את הנתונים מכל אתר בעצמו ומחלץ אותם בלחיצה אחת, בלי צורך בהגדרות. Get Started Free
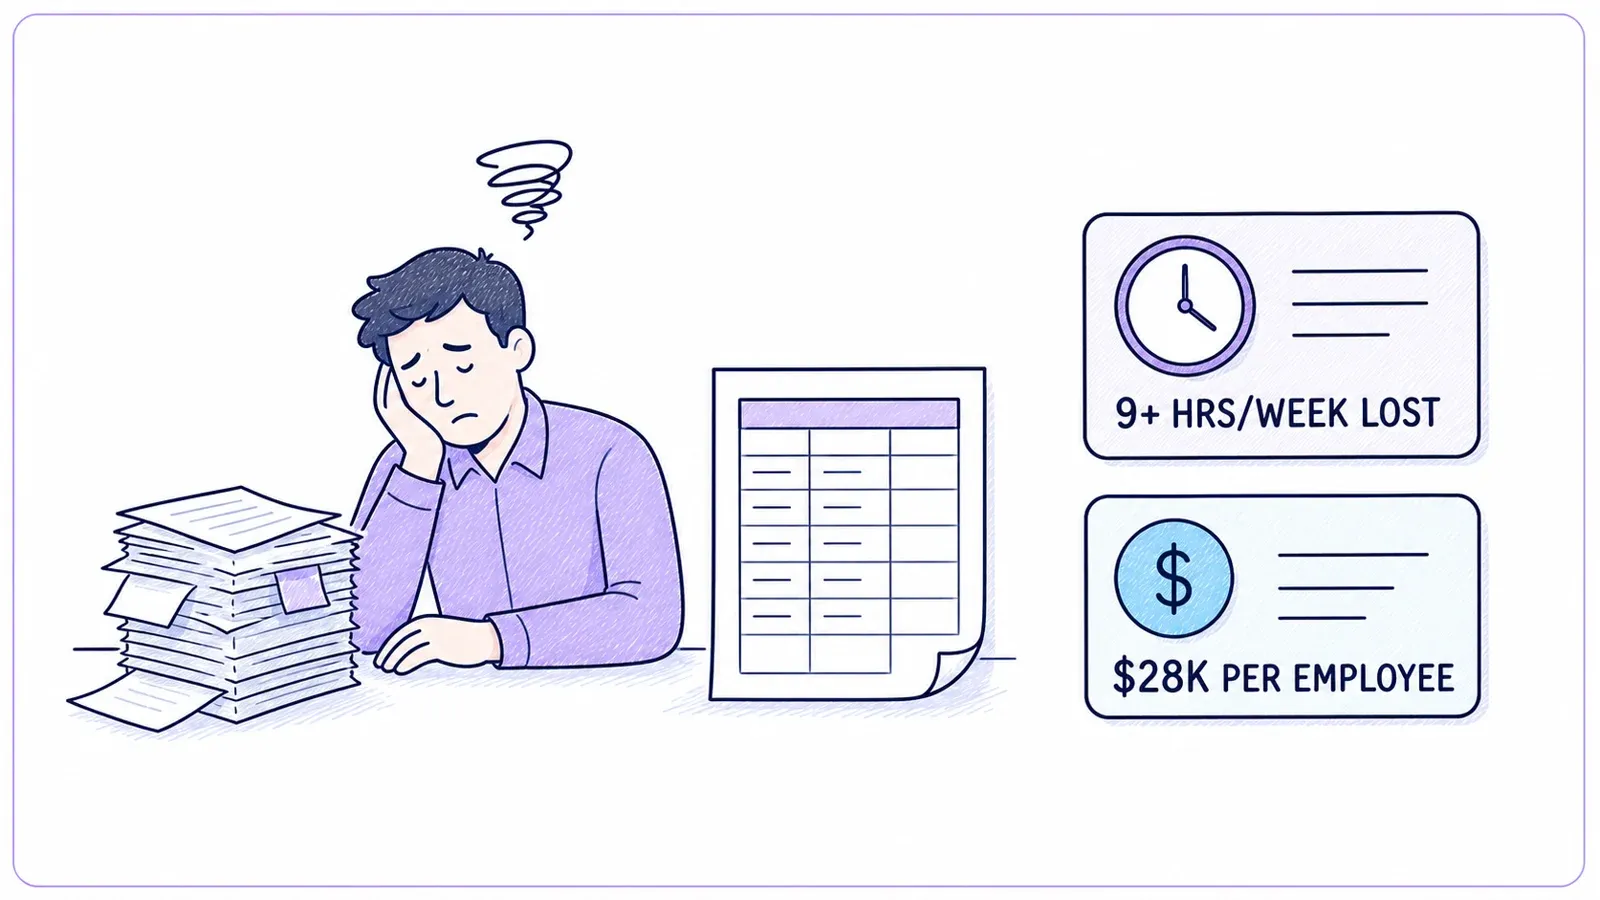
אבל יש כאן קטע: רוב המשתמשים העסקיים אינם מתכנתים. ראיתי צוותי מכירות, שיווק ותפעול מבזבזים 9+ שעות בשבוע על הזנת נתונים חוזרת, מה שעולה לחברות כ־28,500 דולר לעובד בשנה, לפי סקר 2025 של Parseur/QuestionPro בקרב 500 אנשי מקצוע בארה״ב. וכמעט 60% מהעובדים אומרים שהמשימות האלה שוחקות אותם. החדשות הטובות? חילוץ יעיל של נתוני אתר כבר בהישג יד של כולם—גם אם מעולם לא כתבתם שורת קוד. בואו נפרק בדיוק איך עושים את זה, אילו כלים כדאי להשתמש בהם, ואיך לעבור מ״אני צריך את הנתונים האלה״ לגיליון עבודה שמיש — באתרים מסודרים זה קורה בכמה קליקים; באתרים מבולגנים, בכמה קליקים ועוד כמה התאמות של פרומפט.
מה זה בעצם לחלץ נתוני אתר?
בבסיס, חילוץ נתוני אתר פירושו שימוש בתוכנה כדי להוציא מידע מדפי אינטרנט באופן אוטומטי ולארגן אותו בפורמט מובנה—כמו טבלאות, גיליונות או מסדי נתונים. דמיינו עוזר דיגיטלי שמבקר במאות דפי אינטרנט, אוסף את מה שאתם צריכים (למשל שמות, מחירים, אימיילים) ומכניס הכול ישר ל־Excel בזמן שאתם שותים קפה.
איסוף נתונים ידני—העתקה והדבקה מאתרים—עובד טוב כשיש רק כמה שורות. אבל כשצריך לאסוף מידע מעשרות או אלפי דפים, זה מתכון לכאבי פרקים והרבה טעויות הקלדה. כלי web scraping אוטומטיים עושים בשבילכם את העבודה הקשה, שולפים בדיוק את שדות המידע הרצויים, בקנה מידה גדול, ועם הרבה פחות טעויות (ParseHub).
השלבים הבסיסיים ב-web scraping:
- מגדירים את הנתונים שרוצים (למשל מחירי מוצרים, פרטי קשר, ביקורות).
- מחלצים את הנתונים בעזרת כלי או סקריפט.
- מייצאים את התוצאות לפורמט שאפשר לנתח (CSV, Excel, Google Sheets וכו׳).
מגרדי אינטרנט מודרניים יכולים אפילו להתמודד עם רשימות מרובות עמודים, ללחוץ על כפתורי “הבא”, ולבקר בתתי־עמודים—כך מקבלים את כל הנתונים, לא רק את מה שרואים במסך אחד.
למה חילוץ נתוני אתר חשוב לצוותים עסקיים
בואו נדבר על למה המיומנות הזו חיונית לצוותי מכירות, שיווק ותפעול:
- יצירת לידים: בניית רשימות ממוקדות של לקוחות פוטנציאליים על ידי חילוץ נתונים מספריות עסקים, LinkedIn או דפי משתתפים באירועים. לא צריך יותר לקנות רשימות מיושנות או לבזבז שעות בגוגל.
- ניטור מחירים: מעקב אחר מחירי מתחרים ורמות מלאי בפלטפורמות מסחר. קמעונאיות כמו John Lewis הגדילו מכירות ב־4% באמצעות נתוני תמחור מחולצים.
- מחקר שוק: איסוף ביקורות, דירוגים ואזכורים ברשתות חברתיות כדי לזהות מגמות ותחושות לקוח בזמן אמת.
- יעילות תפעולית: שמירה על קטלוגי מוצרים, מידע על ספקים או רישומי נדל״ן מעודכנים—באופן אוטומטי.
הנה טבלה קצרה שמסכמת את היתרונות:
| יתרון מרכזי | מה זה אומר בפועל | תוצאה בעולם האמיתי |
|---|---|---|
| חיסכון בזמן | אוטומציה של שעות עבודה ידנית על נתונים | +9 שעות/שבוע נחסכות לכל עובד (PRNewswire) |
| דיוק | פחות שגיאות, נתונים עקביים יותר | עד 99.5% דיוק (Scrapingdog) |
| יתרון תחרותי | תובנות מהירות ועדכניות יותר מהמתחרים | תמחור דינמי, מיקוד טוב יותר |
| אוטומציה של תהליכים | הנתונים מתעדכנים לבד—בלי בדיקות ידניות | דוחות יומיים/שבועיים מתוזמנים |
לא פלא ש־63% מהחברות שמשתמשות בנתונים חיצוניים אומרות שזה שיפר את קבלת ההחלטות, ויותר ממחציתן ראו צמיחה בהכנסות.
מדריך שלב־אחר־שלב: איך לחלץ נתוני אתר בלי קוד
אני שומע את השאלה הזו הרבה: “איך בכלל מתחילים לחלץ נתונים אם אני לא טכני?” הנה מסלול ידידותי למתחילים:
1. הגדירו את המטרה ושדות הנתונים
החליטו מה אתם רוצים. האם זו רשימה של כל המסעדות בעיר שלכם מ־Yelp, כולל שם, כתובת וטלפון? או אולי מחירי מוצרים של מתחרים מ־Amazon? כתבו את השדות שאתם צריכים.
2. בחרו את הכלי הנכון
אם אתם לא מתכנתים, אפשר לוותר על סקריפטים ב־Python. לכו על כלי no-code כמו Thunderbit, תוסף Chrome מבוסס AI, או על מגרדים ויזואליים אחרים כמו Octoparse או ParseHub.
נסו את Thunderbit Agentic Web Scraper בחינם התוכנית החינמית כוללת 6 דפים בחודש, בלי צורך בכרטיס אשראי — דרך מהירה לבדוק חילוץ באתר היעד. Get Started Free
3. הגדירו את סביבת העבודה
התקינו את הכלי שבחרתם (ב־Thunderbit, הורידו את תוסף Chrome). הירשמו, התחברו, ואתם מוכנים לצאת לדרך.
4. זהו את הנתונים באתר
נווטו לדף היעד. עם Thunderbit, פשוט לחצו על “One Click Extract”—ה־AI סורק את הדף, מזהה את העמודות הנכונות (כמו Name, Price, Email), ומחלץ אותן.
5. הריצו ניסיון קצר
תמיד התחילו בקטן. חלצו דף אחד או כמה רשומות כדי לבדוק אם הנתונים נראים נכונים. התאימו עמודות או פרומפטים לפי הצורך.
6. חלצו את כל מערך הנתונים
ברגע שאתם מרוצים, הריצו את החילוץ המלא. לעבודות גדולות, השתמשו במצב ענן (עוד על זה בהמשך). הכלי יטפל בדפדוף בין עמודים ובתתי־עמודים אם הגדרתם זאת.
7. ייצאו והשתמשו בנתונים
ייצאו ל־Excel, Google Sheets, Airtable או Notion. בדקו מדגמית כמה שורות כדי לוודא שהכול תקין.
טיפ מקצועי: הימנעו מטעויות נפוצות כמו שכחת דפדוף בין עמודים, חילוץ של יותר מדי נתונים בבת אחת, או התעלמות מתנאי השימוש של האתר. התחילו ממוקד, בצעו שיפורים לאורך הדרך, ותוך זמן קצר תהיו מקצוענים.
איך לבחור את הכלי הנכון: Thunderbit לעומת פתרונות scraping מסורתיים
בואו נשווה בין האפשרויות:
| פתרון | קלות שימוש | זמן הגדרה | תחזוקה | יכולת הרחבה | עלות | מתאים במיוחד ל |
|---|---|---|---|---|---|---|
| Thunderbit (AI No-Code) | גבוהה מאוד | דקות | נמוכה | גבוהה (ענן) | חינם, $15+ לחודש | מכירות, תפעול, מי שלא כותב קוד |
| תוספים מסורתיים | בינונית | 30+ דק׳ | בינונית | מוגבלת | חינם/נמוכה | משתמשים פשוטים וסבלניים |
| קוד מותאם אישית (Python) | נמוכה | שעות+ | גבוהה | גבוהה מאוד | זמן פיתוח | מפתחים, צוותי דאטה |
| שירותי מיקור חוץ | גבוהה | ימים | נמוכה | גבוהה | $$$ | פרויקטים גדולים וחד־פעמיים |
Thunderbit בולט במיוחד עבור משתמשים לא טכניים: בלי קוד, One Click Extract, ותהליך פשוט כמו להזמין אוכל. כלים מסורתיים דורשים יותר התעסקות, וקוד מותאם עדיף להשאיר למהנדסים.
חלצו כל דף בלחיצה אחת ה־agentic web scraper של Thunderbit קורא את הדף, מבין את המבנה שלו ומחזיר לכם טבלה נקייה — בלי selectors. Get Started Free
Thunderbit בפעולה: איך לחלץ נתוני אתר בכמה קליקים בלבד
כך הייתי משתמש ב־Thunderbit כדי לחלץ, למשל, ספרייה של סוכני נדל״ן:
- מתקינים את תוסף Chrome ומתחברים.
- נכנסים לאתר היעד (למשל ספריית נדל״ן).
- לוחצים על אייקון Thunderbit כדי לפתוח את סרגל הצד.
- לוחצים על “One Click Extract.” ה־AI של Thunderbit סורק את הדף ומציע עמודות כמו Name, Agency, Phone, Email.
- בודקים ומכווננים שדות — משנים שמות עמודות, מוסיפים פרומפט מותאם אם רוצים לסווג או לעצב נתונים.
- לוחצים על “Scrape.” Thunderbit מחלץ את הנתונים לטבלה, כולל טיפול בדפדוף בין עמודים ואפילו בגלילה אינסופית.
- מייצאים ל־Excel, Google Sheets או Notion — בלי תשלום נוסף, בלי עמלות נסתרות.
אם לכל סוכן יש קישור לדף פרופיל, השתמשו ב־Subpage Scraping: Thunderbit יבקר בכל פרופיל, יאסוף מידע נוסף (כמו כתובת או שנות ניסיון), ויצרף אותו לטבלה שלכם. לא צריך לפתוח טאבים אחד־אחד.
Scraping בדפדפן מול Scraping בענן: איזה מצב מתאים לכם?
Thunderbit מציע שני מצבים:
- Browser Scraping: רץ בדפדפן Chrome המקומי שלכם. מושלם לחילוץ נתונים מאחורי התחברות או מדפים מותאמים אישית (כמו חשבון LinkedIn שלכם או דשבורדים פנימיים). הוא משתמש בסשן ובעוגיות שלכם, כך שאם אתם יכולים לראות את זה, Thunderbit יכול לחלץ את זה.
- Cloud Scraping: רץ על השרתים של Thunderbit. מהיר מאוד לנתונים ציבוריים—מחלץ עד 50 דפים בבת אחת, לא תופס את המחשב שלכם, וממשיך לעבוד גם אם סגרתם את המחשב הנייד. מצוין לעבודות גדולות כמו חילוץ כל המוצרים מאתר ecommerce.
מתי להשתמש בכל מצב:
- Browser Mode: אתרים שדורשים התחברות, פידים מותאמים אישית, עבודות קטנות.
- Cloud Mode: נתונים ציבוריים בקנה מידה גדול, חילוצים מתוזמנים, או כשאתם רוצים להגדיר ולשכוח.
Thunderbit מטפל גם ב־pagination וב־subpages בשני המצבים, כך שתקבלו מערכי נתונים מלאים בכל פעם.
יעילות כפולה: שימוש ב־AI כדי לשפר שדות ופורמטים של נתונים
אחת התכונות האהובות עליי ב־Thunderbit היא “AI Improve Fields”. הנה למה היא נהדרת:
- עיצוב אוטומטי: סטנדרטיזציה של מספרי טלפון, מחירים או תאריכים בזמן החילוץ—בלי גיליונות מבולגנים.
- סיווג: הוסיפו עמודה כמו “Category” ותנו ל־AI לתייג כל שורה (למשל Electronics, Clothing, Furniture) לפי התיאור.
- תרגום: חלצו מאתרים בשפות אחרות ותנו ל־Thunderbit לתרגם שדות לאנגלית (או ל־34+ שפות אחרות).
- פרומפטים מותאמים: רוצים לחלץ תחושת ביקורת או לתייג חברות לפי גודל? פשוט הוסיפו פרומפט AI לשדה.
זה אומר שאתם מקבלים נתונים מוכנים לניתוח ישר מהכלי, בלי שעות של ניקוי ידני.
אוטומציה של התהליך שלכם: תזמון חילוץ נתונים מאתרים באופן קבוע
למה לעצור בחילוץ חד־פעמי? תכונת Schedule של Thunderbit מאפשרת לכם להגדיר חילוצים חוזרים—יומיים, שבועיים, או מתי שתרצו.
- מתארים את לוח הזמנים בשפה פשוטה (“כל יום שני ב־9:00”).
- בוחרים את הפרויקט ואת יעד הייצוא (Excel, Google Sheets, Airtable, Notion).
- Thunderbit מריץ את החילוץ אוטומטית ומעדכן את הנתונים—בלי עבודה ידנית.
דוגמאות שימוש:
- מכירות: עדכון יומי של רשימות לידים.
- Ecommerce: ניטור מחירים אוטומטי.
- תפעול: התראות מלאי או סטוק.
- מחקר שוק: איסוף חדשות או ביקורות.
עם חילוץ מתוזמן, הנתונים שלכם נשארים עדכניים, והצוות תמיד מחזיק את המידע האחרון בהישג יד.
השוואה מהירה בין כלים פופולריים לחילוץ נתוני אתר
הנה מבט זה לצד זה על האפשרויות הנפוצות:
| סוג הכלי | קלות שימוש | זמן הגדרה | יכולת הרחבה | תחזוקה | עלות | מתאים במיוחד ל |
|---|---|---|---|---|---|---|
| Thunderbit (AI No-Code) | ⭐⭐⭐⭐⭐ | דקות | גבוהה | נמוכה | חינם/$15+ לחודש | מכירות, תפעול, מי שלא כותב קוד |
| תוספים מסורתיים | ⭐⭐⭐ | 30+ דק׳ | בינונית | בינונית | חינם/נמוכה | משתמשים פשוטים וסבלניים |
| קוד מותאם אישית (Python) | ⭐ | שעות+ | גבוהה מאוד | גבוהה | זמן פיתוח | מפתחים, צוותי דאטה |
| שירותי מיקור חוץ | ⭐⭐⭐⭐ | ימים | גבוהה | נמוכה | $$$ | פרויקטים גדולים וחד־פעמיים |
עבור רוב המשתמשים העסקיים, Thunderbit הוא המנצח הברור במהירות, בפשטות ובעלות.
עיקרי הדברים: איך לחלץ נתוני אתר ביעילות
- web scraping כבר נגיש לכולם. לא צריך קוד—רק לבחור את הכלי הנכון ולעקוב אחרי כמה שלבים פשוטים.
- הגדירו מטרות ושדות לפני שמתחילים. דעו איזה מידע אתם צריכים ואיפה למצוא אותו.
- השתמשו בכלים מבוססי AI כמו Thunderbit כדי לקבל את התוצאות הקלות והמהירות ביותר—במיוחד למשתמשים לא טכניים.
- אוטומטו משימות חוזרות עם תזמון כדי שהנתונים יתעדכנו לבד.
- שפרו ופרמטו את הנתונים תוך כדי החילוץ בעזרת פרומפטים של AI—קבלו תוצאות מוכנות לניתוח מיד.
מוכנים לנסות? הורידו את תוסף Chrome של Thunderbit והתחילו את החילוץ הראשון שלכם בחינם. או בדקו את בלוג Thunderbit לעוד מדריכים ודוגמאות מהשטח.
ראו איך Thunderbit משתווה ראו איך החילוץ בלחיצה אחת של Thunderbit, המבוסס AI, משתווה לכלים האחרים שמופיעים במדריך הזה. Get Started Free
שאלות נפוצות
1. האם web scraping הוא חוקי ובטוח לשימוש עסקי?
כן, כל עוד מחלצים נתונים ציבוריים ומכבדים את תנאי השימוש של האתר. הימנעו מחילוץ מידע אישי או רגיש ללא הרשאה, ותמיד בדקו את מדיניות האתר.
2. איזה סוג נתונים אפשר לחלץ עם Thunderbit?
אפשר לחלץ טקסט, מספרים, תאריכים, URLs, אימיילים, מספרי טלפון, תמונות ועוד. ה־AI של Thunderbit יכול אפילו לסווג, לתייג ולתרגם שדות בזמן החילוץ.
3. אפשר לחלץ נתונים מאתרים שדורשים התחברות?
בהחלט—השתמשו ב־Browser Mode של Thunderbit כדי לחלץ נתונים מכל דף שאליו יש לכם גישה בדפדפן, כולל מאחורי התחברות.
4. איך Thunderbit מתמודד עם אתרים עם הרבה דפים או תתי־עמודים?
Thunderbit תומך בדפדוף אוטומטי ובחילוץ תתי־עמודים. הוא יכול לעקוב אחרי כפתורי “הבא” ולבקר בדפי פירוט מקושרים, ולמזג את כל הנתונים לטבלה אחת.
5. אפשר לתזמן חילוצים שירוצו אוטומטית?
כן! תכונת Schedule של Thunderbit מאפשרת להגדיר חילוצים חוזרים (יומיים, שבועיים וכו׳) ולייצא תוצאות ישירות ל־Excel, Google Sheets, Airtable או Notion.
נסו את Thunderbit Agentic Web Scraper בחינם Get Started Free
חילוץ נתוני אתר לא חייב להיות כאב ראש. עם הכלים הנכונים ותוכנית ברורה, אפשר להפוך את הרשת למסד הנתונים האישי שלכם—בלי קוד, בלי לחץ, רק תוצאות. חילוץ נעים!



