
MarkItDown לא פעם נכנס לאותה קטגוריה עם web scrapers, אבל זו הגדרה לא מדויקת. אין בו crawler, אין מנוע JavaScript, ואין שום דרך להזין כתובת URL ולנקות ממנה את כל הרכיבים המיותרים של הדף. מה שהוא כן עושה זה לקחת קבצים שכבר יש לכם — PDF, מסמך Word, גיליון אלקטרוני, מצגת — ולהמיר את כולם ל-Markdown שקל למודלי שפה לקרוא.
במשך כמה שבועות הרצתי את Microsoft MarkItDown על סט של מסמכים אמיתיים על Mac יחיד, בדקתי כל טבלה מול manifest שכתבתי מראש, ותזמנתי כל המרה. השורה התחתונה: כשקלט נקי, הוא מהיר ונאמן למקור; אבל באריזה שלו מתחבא runtime של למידת מכונה בנפח 73 MB שלא ביקשתם; ובטבלאות הוא נשבר בדרכים שיכולות לעבור בדיקת "האם הטקסט שרד?" אבל להיכשל בבדיקת "האם הנתונים נשארו בעמודה הנכונה?". הנה התמונה המלאה, עם המספרים.
מה MarkItDown באמת עושה
MarkItDown הוא כלי Python של Microsoft שממיר קבצים ומסמכי Office ל-Markdown שמותאם ל-LLMs. אפשר להפנות אליו PDF, קובץ .docx, .xlsx, .pptx, תמונה, קובץ HTML, ועוד כמה פורמטים נוספים — והוא מחזיר Markdown. יש לו שלוש דרכי שימוש: CLI (markitdown file.pdf -o out.md, או דרך stdin), API ב-Python (MarkItDown().convert(...)), ושרת MCP אופציונלי לזרימות עבודה של agents.
ההבחנה הכי חשובה היא מה הוא לא עושה — כי זה גם מה שה-README לא טוען, וגם מה שאימתתי בבדיקה: אין crawling, אין רינדור JS, אין מעקב אחרי קישורים, אין דפדוף בין עמודים, ואין חילוץ של התוכן המרכזי בסגנון Readability. זהו ממיר שלם-למסמך. אתם מביאים את הבייטים; הוא מנרמל אותם. ההבדל הזה הוא בדיוק מה שקובע אם הכלי הזה מתאים ל-stack שלכם או לא, אז אחזור אליו שוב ושוב.
ה-repo עצמו נראה כבד לפי מדדי היוהרה של GitHub — 165,282 כוכבים ו-11,790 forks נכון לאמצע יולי 2026, ברישיון MIT, כשהגרסה האחרונה (v0.1.6) יצאה ב-2026-05-26. אבל ספירת הכוכבים הזו משקפת Repo של Microsoft שרוכב על ההתלהבות הכללית מכלי LLM, לא בהכרח על בשלות של מנגנון ההמרה עצמו. יש גם 833 issues פתוחים, וחלק מהם רלוונטיים אליכם עוד לפני ההתקנה (עוד נגיע לזה).
HTML ל-Markdown: מהיר ומקיף, כולל boilerplate
מכיוון ששאר סדרת הביקורות שלי על scrapers משתמשת באותן ארבע דוגמאות אינטרנט, הזנתי ל-MarkItDown את אותם קבצי HTML מקומיים — לא כדי למדוד אותו כ-scraper, אלא כדי לבדוק כמה טובה ההמרה שלו מ-HTML ל-Markdown. בדפים שמסומנים היטב הוא באמת טוב.
כל ארבעת הדפים הומרו בהתקנה הבסיסית בלי תוספות, וכל בדיקות ה-body שרדו. מאמר Wikipedia על "Web scraping" (226 KB) יצא עם עץ כותרות משוכפל כמו שצריך — h1 אחד, שבעה h2-ים, שנים-עשר h3-ים, בהתאם למבנה האמיתי של המאמר — ו-418 קישורים נשמרו כראוי בפורמט [text](url). טבלת הסטטיסטיקות של ההוקי בגודל 25×9 בדף Scrape This Site forms page הפכה לטבלת GFM נקייה עם 27 שורות (כותרת + מפריד + 26 שורות נתונים), כולל תאים ריקים. גם המהירות לא היוותה בעיה: חציון של 48 ms עבור דף הציטוטים הקטן ועד 352 ms עבור דף ה-Wikipedia בן 226 KB.
אבל יש כאן קטע, וזהו בחירה עיצובית ולא באג. MarkItDown לא מסיר boilerplate. הוא ממיר את כל ה-<body>, ולכן כל ה-site chrome עובר איתו — וככל שיש יותר chrome בדף, כך נשאר יותר זבל בפלט.
| דף | תווי פלט | כותרות (h1/h2/h3) | קישורים | שורות site chrome |
|---|---|---|---|---|
| Books to Scrape | 10,478 | 1 / 0 / 0 | 94 | 0.6% (1/159) |
| Quotes to Scrape | 2,973 | 1 / 1 / 0 | 55 | 1.2% (1/86) |
| ScrapeThisSite forms | 3,385 | 1 / 0 / 0 | 31 | 6.7% (5/75) |
| Wikipedia Web scraping | 60,159 | 1 / 7 / 12 | 418 | 12.4% (42/338) |
בעמוד הבית של Books, שכמעט נטול chrome, רק 0.6% משורות הפלט הן chrome. ב-Wikipedia זה כבר 12.4% — כלומר 42 מתוך 338 שורות לא ריקות הן "jump to content", "toggle the table of contents", "22 languages", "retrieved from", כותרות תחתונות של עוגיות ורישיון. אפילו הבאנרים התחזוקתיים של Wikipedia (למשל "This article needs additional citations") עוברים נאמנה לטבלאות pipe דו-עמודתיות, ומשם מגיעות תשע שורות טבלה בדף שאין בו בכלל טבלת נתונים אמיתית.
אבל זו לא טעות של MarkItDown. זה ממיר של מסמך שלם, לא מחלץ של מאמר נקי: faithful HTML-to-Markdown הוא משימה אחרת לגמרי מחילוץ מאמרים בסגנון readability. כלים כמו Trafilatura או Firecrawl שואפים להחזיר רק את התוכן המרכזי; MarkItDown מחזיר את הדף. מתחת למכסה המנוע, _html_converter.py שלו מסיר <script> ו-<style>, ואז מעביר את כל ה-body ל-library בשם markdownify — בלי שום heuristic של main-content לאורך כל המסלול. אם אתם רוצים רק את המאמר, זה השכבה הלא נכונה.
המקום הטבעי שלו: PDF, DOCX, XLSX, PPTX
מסמכים הם מה ש-MarkItDown נבנה עבורו. בדקתי אותו מול קבצים ציבוריים אמיתיים — מאמר arXiv עם שכבת טקסט, ה-whitepaper של Bitcoin, PDF סרוק מבוסס-תמונה שעיבדתי כך שלא יכיל טקסט בכלל, וקבצי DOCX/XLSX/PPTX מתוך חבילת הבדיקות שלו עצמו (עם UUID-ים כדי לזהות אובדן תוכן שקט).
| מסמך | קלט | תווי פלט | בדיקות | זמן חציוני | הערות |
|---|---|---|---|---|---|
| arXiv 1706.03762 (PDF עם שכבת טקסט) | 2.2 MB | 40,174 | 7/7 | 3.7 שנ׳ (warm) | title, "Transformer", "BLEU", "References" כולם מופיעים |
| Bitcoin whitepaper (9 עמודים) | 184 KB | 22,485 | 6/6 | 1.4 שנ׳ | "Satoshi Nakamoto", "proof-of-work", "Conclusion" מופיעים |
| PDF סרוק (ללא שכבת טקסט) | 89 KB | 0 | 0/4 | 15 ms | פלט ריק, ללא שגיאה, ללא OCR |
| DOCX (test.docx) | 136 KB | 4,651 | — | 70 ms | כותרות + טבלת GFM; UUID-ים מוטמעים נשמרו |
| DOCX עם משוואות | 15 KB | 240 | — | 101 ms | Office Math נשמר כ-LaTeX |
| XLSX (test.xlsx) | 12 KB | 808 | — | 57 ms | כל גיליון → ## SheetName + טבלת GFM |
| PPTX (test.pptx) | 278 KB | 2,047 | — | 52 ms | סימוני מספר שקף, טבלאות, תרשים → טבלה |
החזרת הטקסט ב-PDF-ים עם שכבת טקסט הייתה מצוינת — 7 מתוך 7 probes שנקבעו מראש במאמר arXiv "Attention Is All You Need" ו-6 מתוך 6 ב-Bitcoin whitepaper — ואף אחד מקבצי ה-Office לא איבד אף סמן UUID, כך שלא הייתה אובדן תוכן שקט ב-fixtures של המתחזקים עצמם. ניצחון נקודתי יפה: מסלול ה-DOCX (דרך mammoth) שומר על משוואות Office Math כ-LaTeX, וממיר את equations.docx ל-$$...$$ אמיתי. אם אתם מזינים מסמכי Word עתירי מתמטיקה ל-LLM, זו נקודת חוזק אמיתית, אם כי מאוד ממוקדת, שלא מצאתי לה תיעוד במקום אחר.
אבל יש כאן שני ממצאים שמגיע להם יחס מיוחד, כי הם כנראה אלה שיפגעו בכם קודם.
ה-PDF הסרוק שנעלם
אם מזינים ל-MarkItDown PDF מבוסס-תמונה בלי שכבת טקסט, מתקבלת מחרוזת ריקה. אפס תווים, בלי חריגה, בלי אזהרה — וזה גם לוקח בערך 15 ms כי פשוט אין מה לחלץ. מסלול ה-PDF של MarkItDown מבצע רק extraction של טקסט (באמצעות pdfminer ו-pdfplumber מתחת למכסה המנוע), ואין בו OCR בהתקנה הבסיסית או באף pip extra.
זה חשוב מאוד בעיבוד באצווה. מפתח שמזין תיקייה של PDFs כשחלקם סריקות יקבל פלט ריק בשקט עבור אותם קבצים, בלי שום סימן שמשהו דולג. בדקתי גם שה-fixture לא שבור על ידי הרצה ישירה של extract_text של pdfminer — התקבל אפס תווים נקיים, בלי שכבת טקסט, ואימות מלא — כך שהפלט הריק הוא ההתנהגות האמיתית של MarkItDown על סריקה אמיתית. זה משחזר פער OCR fallback ידוע ופתוח (#1268) שמנוהל כבר זמן מה upstream. הנתיב המתועד הוא backend אופציונלי של Azure Document Intelligence או plugin; אף אחד מהם לא כלול בהתקנה כברירת מחדל.
PDFs יוצאים כטקסט שטוח, לא כמבנה
בשני ה-PDF-ים עם שכבת הטקסט, MarkItDown לא הפיק אפילו סימן כותרת אחד ב-Markdown. ל-PDF אין תגיות סמנטיות של כותרות, ו-MarkItDown לא מסיק אותן מגודל גופן, ולכן כל שורה נופלת לרמת body. החזרת הטקסט מצוינת; המבנה שטוח.
זו לא רק התוצאה שלי. בנצ'מרקים ציבוריים של צד שלישי מדרגים את היררכיית הכותרות של PDF ב-MarkItDown סביב 0.0, ואת נאמנות הטבלאות סביב 0.27 — הרבה מתחת ל-0.88 של Docling, שמבוסס על TableFormer (ראו את השוואת MarkItDown מול Docling מול Marker ואת READoc benchmark). ה-fixtures שלי משחזרים את אותן תוצאות, וזה דווקא מחזק את הראיות: המספרים שלי תואמים מקור חיצוני. אותו בנצ'מרק מציין גם ש-MarkItDown מהיר בערך פי 100 מ-Docling, וזה מסתדר עם זמני השניות ולא הדקות שקיבלתי על מסמכים שכלי מבוסס layout-model מעבד במשך דקות. המסקנה: MarkItDown נותן לכם טקסט נקי ומהיר מתוך PDF; הוא לא נותן לכם את המבנה של ה-PDF. אם כותרות וטבלאות חייבות לשרוד, כלי מבוסס layout-model כמו Docling או Marker הוא השכבה הנכונה.
טבלאות: התוכן תמיד שורד, המבנה לא תמיד
טבלאות הן המקום שבו "האם הטקסט שרד?" ו"האם הנתונים עדיין שמישים?" נפרדים זה מזה, אז בניתי מטריצת 13 מקרים — טבלת <table> לכל מקרה, כל אחת נבדקה מול manifest שנכתב לפני הריצה — כדי למפות בדיוק אילו צורות נשמרות ואילו נשברות.
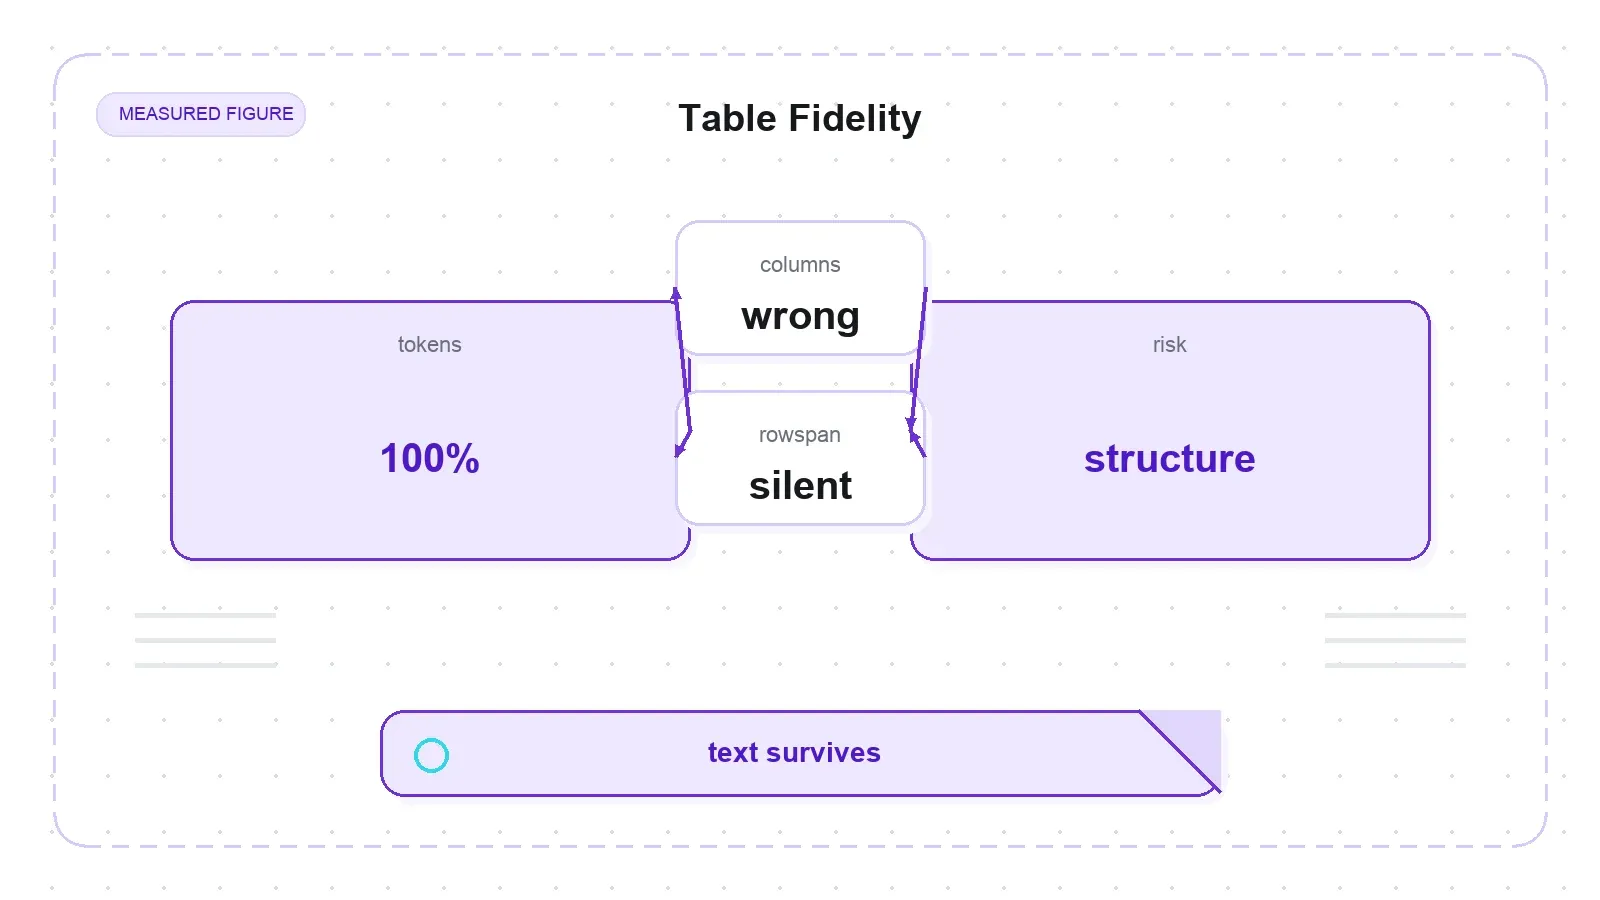
הכותרת הראשית: MarkItDown אף פעם לא איבד תוכן טבלאי. כל 13 המקרים שמרו על 100% מהטוקנים שהוגדרו מראש. אבל נאמנות מבנית התפצלה לשלושה סוגים. שבעה מתוך שלושה-עשר יצרו grid תקין של GFM (טבלאות רגילות, header-colspan, טבלאות רחבות עם 24 עמודות, ללא כותרת, עם תאים ריקים, block-in-cell, וערבית מימין לשמאל). ארבעה יצאו עקומים, כי ל-Markdown אין מושג של תא ממוזג, ולכן rowspan, colspan ומקורות פגומים יוצרים שורות קצרות. ושניים פשוט נשברו לגמרי.
שני השברים האלה שווים קריאה בשם. טבלה מקוננת (כלומר <table> בתוך <td>) משתטחת inline, משליכה את ה-pipes ואת שורת המפריד שלה לתוך התא האב ומייצרת שורת זבל עם 14 "עמודות". ו-| מילולי בתוך תא לא עובר escaping — טקסט התא a | b הופך לשתי עמודות, ו-x || y הופך לשלוש — כך שטבלה דו-עמודתית מייצרת שורות של שתי, שלוש וארבע עמודות, וכל parser של Markdown שממשיך הלאה קורא גבולות שגויים. מעניין לציין שכוכביות ו-backticks בתוך תא כן עוברים escaping; רק pipe-ים לא. הסיבה היא שבמסלול ה-HTML MarkItDown משתמש בטיפול ברירת המחדל של markdownify בטבלאות, וה-subclass המותאם שלו מחליף רק קישורים, תמונות וכותרות — לא תאי טבלה. אותה משפחת באגים של escaping ל-pipe קיימת גם כ-issue פתוח עבור ממיר CSV (#2019), אבל התיקון שם לא נוגע למסלול ה-HTML שבדקתי.
העדין יותר — הממצא שהייתי הכי רוצה שמהנדס נתונים יראה — הוא rowspan. מקרה t03 לא רק יוצא עקום; הוא מזיז נתונים בשקט. תווית עם rowspan=2 ("Fruit") מופיעה פעם אחת, והשורה שמתחתיה הופכת לשורה קצרה של שתי עמודות (| Banana | 8 |), כך ש-"Banana" נוחת מתחת לעמודת Group במקום Item. כל הטוקנים קיימים. צרכן נאיבי שקורא את "העמודה השנייה" יקבל את הערך הלא נכון. זה מסוג הבאגים שעוברים בדיקת שרידות טקסט ומקלקלים שְׁתָק dataset שלם.
המגבלה של spans עצמה היא constraint עיצובי ידוע ומנוהל (#1211, #1248) — grid שטוח של GFM באמת לא יכול לייצג spans או nesting, ולכן הממיר מקריב מבנה לטובת שלמות התוכן. יש גם התנהגויות טובות בתוך הערבוב הזה: טבלאות בלי header מקבלות שורת כותרת ריקה שנוצרת אוטומטית (כך שאף נתון לא מקודם בטעות לכותרת), תאים ריקים נשמרים, ו-<caption> נשאר כשורת טקסט מעל הטבלה.
התקנה ו-startup: המס שעליו "כלי קל משקל" לא מזהיר אתכם
שום דבר כאן לא הפתיע אותי יותר, ודווקא כאן ההגדרה "כלי Python קל משקל" מבטיחה יותר מדי בשקט.
ראשית, אל תריצו pip install 'markitdown[all]'. ב-Python 3.14 זה חוזר בשקט לגרסה markitdown 0.0.2 — גרסה מלפני שנתיים — ושחזרתי את זה בזמן אמת ב-venv נקי. כשהצמדתי גרסה הופיע למה: pip install 'markitdown[all]==0.1.6' נכשל, משום שה-extra של [all] נועל את youtube-transcript-api~=1.0.0, וב-PyPI הנוכחי כל build בטווח הזה מוגבל ל-Python <3.14, בעוד שה-build-ים היחידים שתואמים ל-3.14 נמצאים מחוץ לטווח הנעול. לכן ה-resolver חוזר עד לגרסה האחרונה שהתלויות שלה עדיין ניתנות לפתרון. זה תואם ל-issue פתוח upstream (#2179). הפתרון פשוט — נועלים גרסה ומתקינים את ה-extras בנפרד: pip install 'markitdown==0.1.6', ואז pip install 'markitdown[pdf,docx,pptx,xlsx,xls]==0.1.6'. כל אלה נפתרים בלי בעיה; רק חבילת [all] המורכבת כוללת את ה-pin הבעייתי. (המלכודת הזו תלויה בגרסת Python — ב-Python 3.13 או מוקדם יותר החסם אולי לא יפעל, ולכן [all] עשוי להיפתר אחרת.)
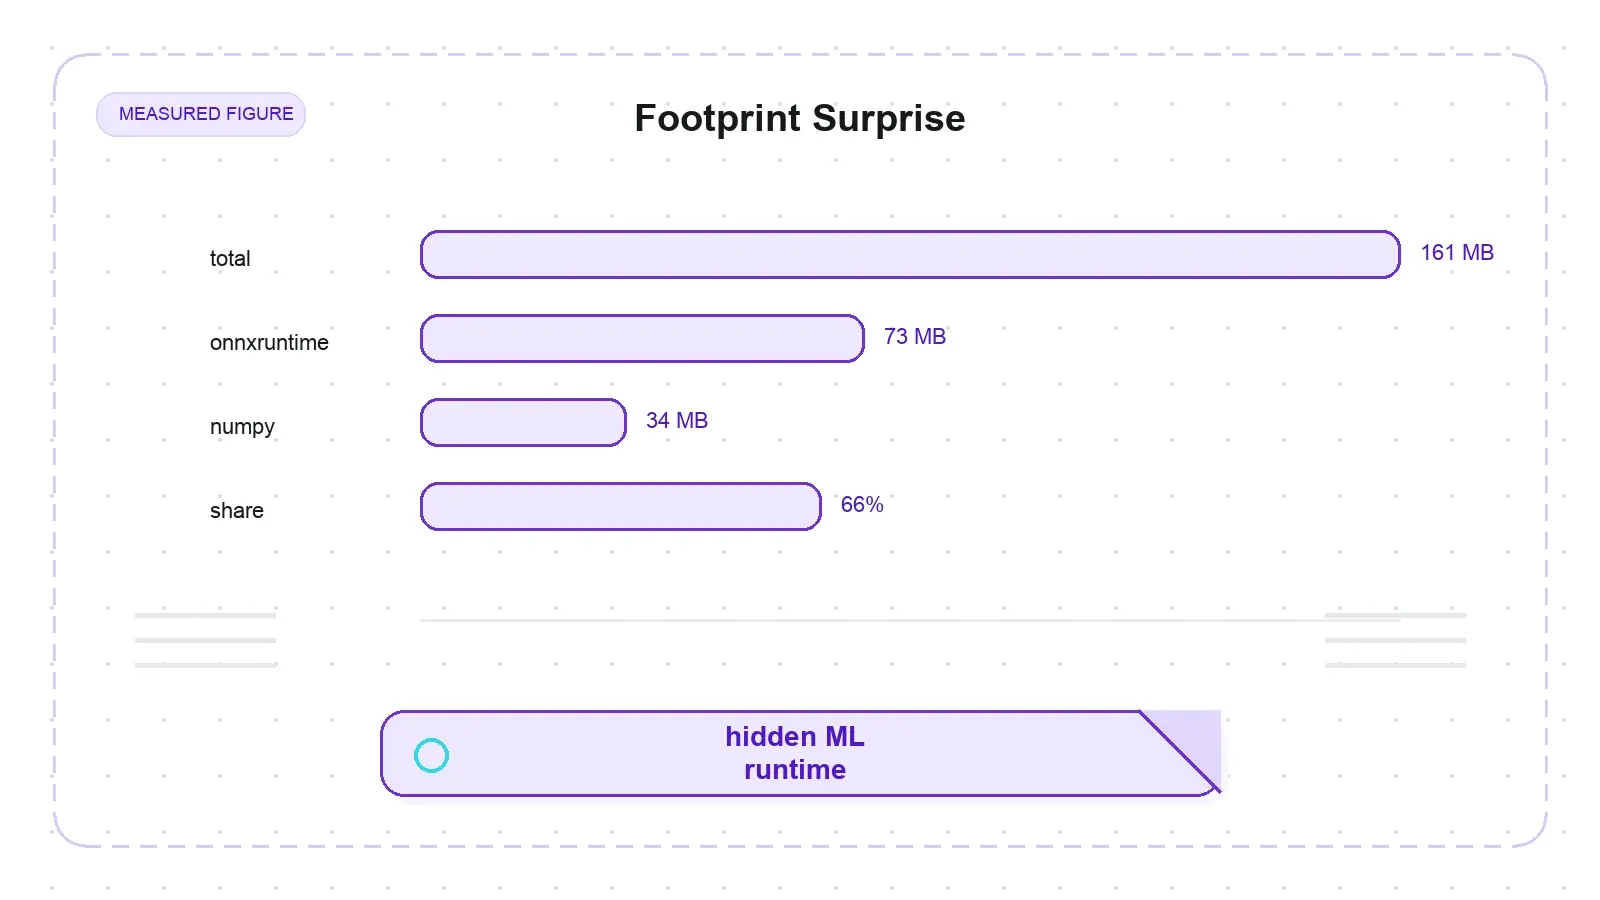
שנית, טביעת הרגל. ההתקנה הבסיסית תופסת 161 MB (venv ריק של 13 MB ועוד 148 MB). מתוכם, onnxruntime (73 MB) ו-numpy (34 MB) יחד הם 107 MB — כלומר 66% מכל טביעת הרגל הבסיסית — ושניהם נגררים פנימה על ידי תלות קשיחה אחת: magika, זיהוי סוג קובץ מבוסס-ML של Google. כלומר, ממיר טקסט מגיע עם runtime של ONNX inference בנפח 73 MB כבר בהתקנה הבסיסית, עוד לפני שהוספתם אפילו תוסף מסמכים אחד. אחרי שמוסיפים את תוספי המסמכים, ה-venv מגיע ל-310 MB. זה עדיין הרבה יותר קל מ-stack של headless browser, אבל אם ציפיתם ל-pip install וסיימנו — כדאי שתדעו ש-runtime של ONNX מגיע איתו.
שלישית — וזה הממצא היחיד בכל החבילה שלי שעובר כל בדיקת novelty שהרצתי — גם אחרי התקנה נקייה, import markitdown עולה בערך 3.35 שניות במכונה הזו. כמעט כל העלות היא בזמן import: markitdown._markitdown מייבא מיד את כל registry של הממירים (סה״כ 2.56 שנ׳, 76% מהזמן), מה שמושך פנימה את pandas (1.21 שנ׳, דרך ממיר XLSX), את python-pptx (427 ms), את magika (354 ms) ואת requests (270 ms) — גם אם לא תמירו אף אחד מהפורמטים האלה. עבור שירות שרץ לאורך זמן, עלות ה-import נבלעת ואינה חשובה. עבור הרצת CLI או cold start ב-serverless, זה מס אמיתי לכל תהליך, כזה שהתווית "כלי קל משקל" לא מכינה אתכם אליו. (סייג הוגן: זהו פרופיל יחיד, כלומר תצפית אחת, לא התפלגות של ריצות מרובות.)
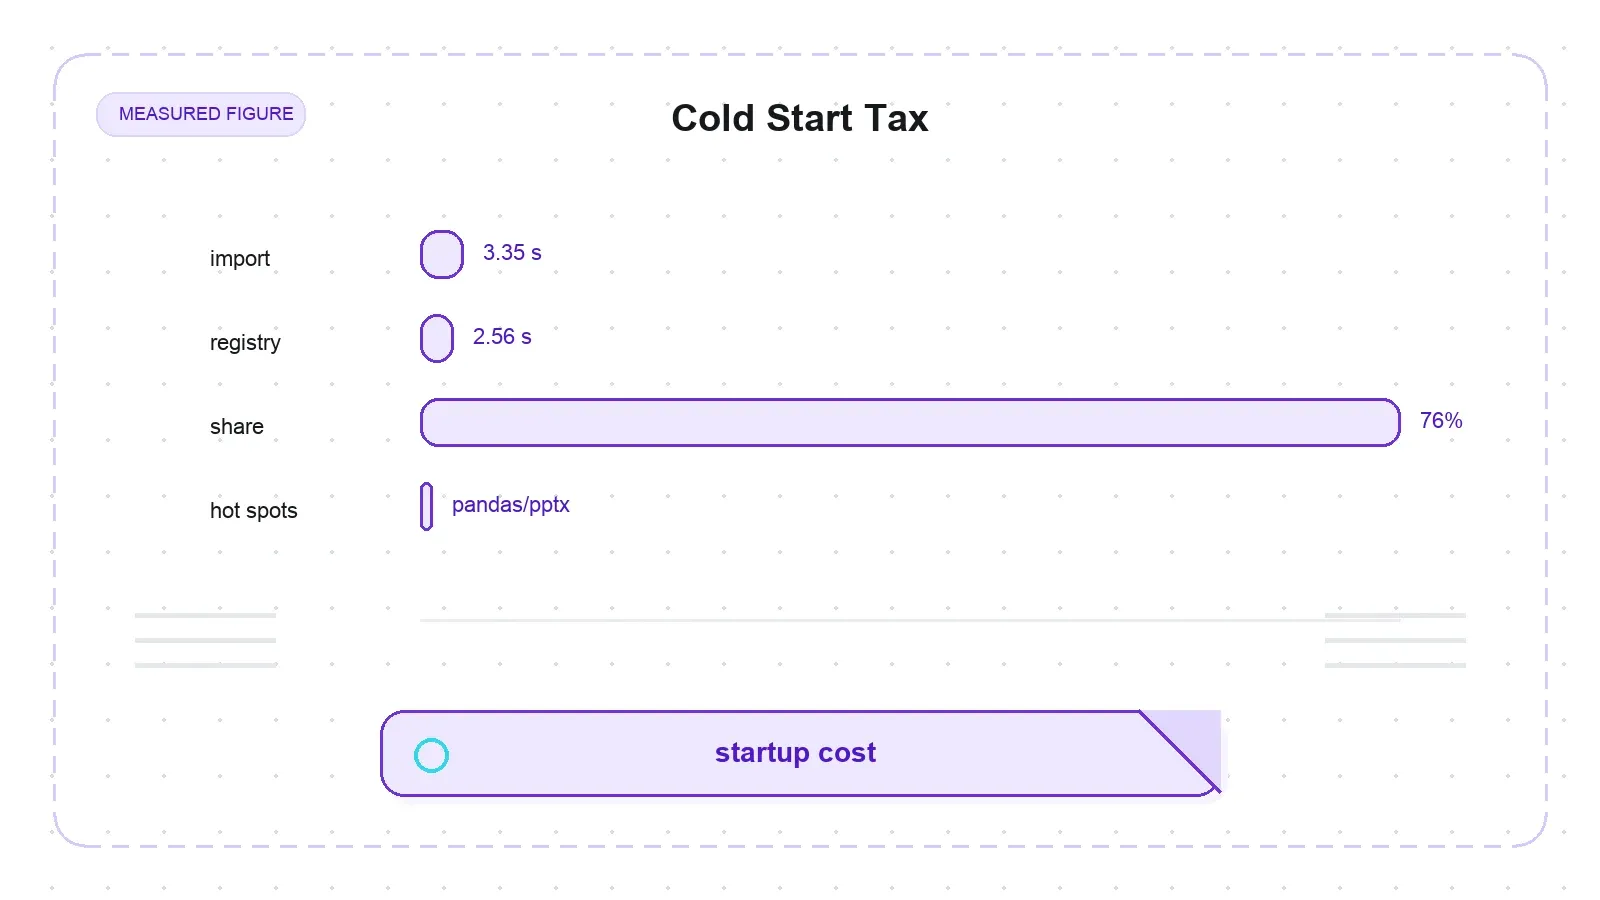
סקייל: הוא לא קורס, אבל תקצו CPU ל-PDF-ים ו-RAM לגיליונות אלקטרוניים
הרצתי ארבעה נושאים גדולים, כל אחד בתהליך נפרד כדי שזיכרון השיא לא יזוהם מריצה קודמת. שום דבר לא קרס. אבל פרופיל העלות לא מאוזן.
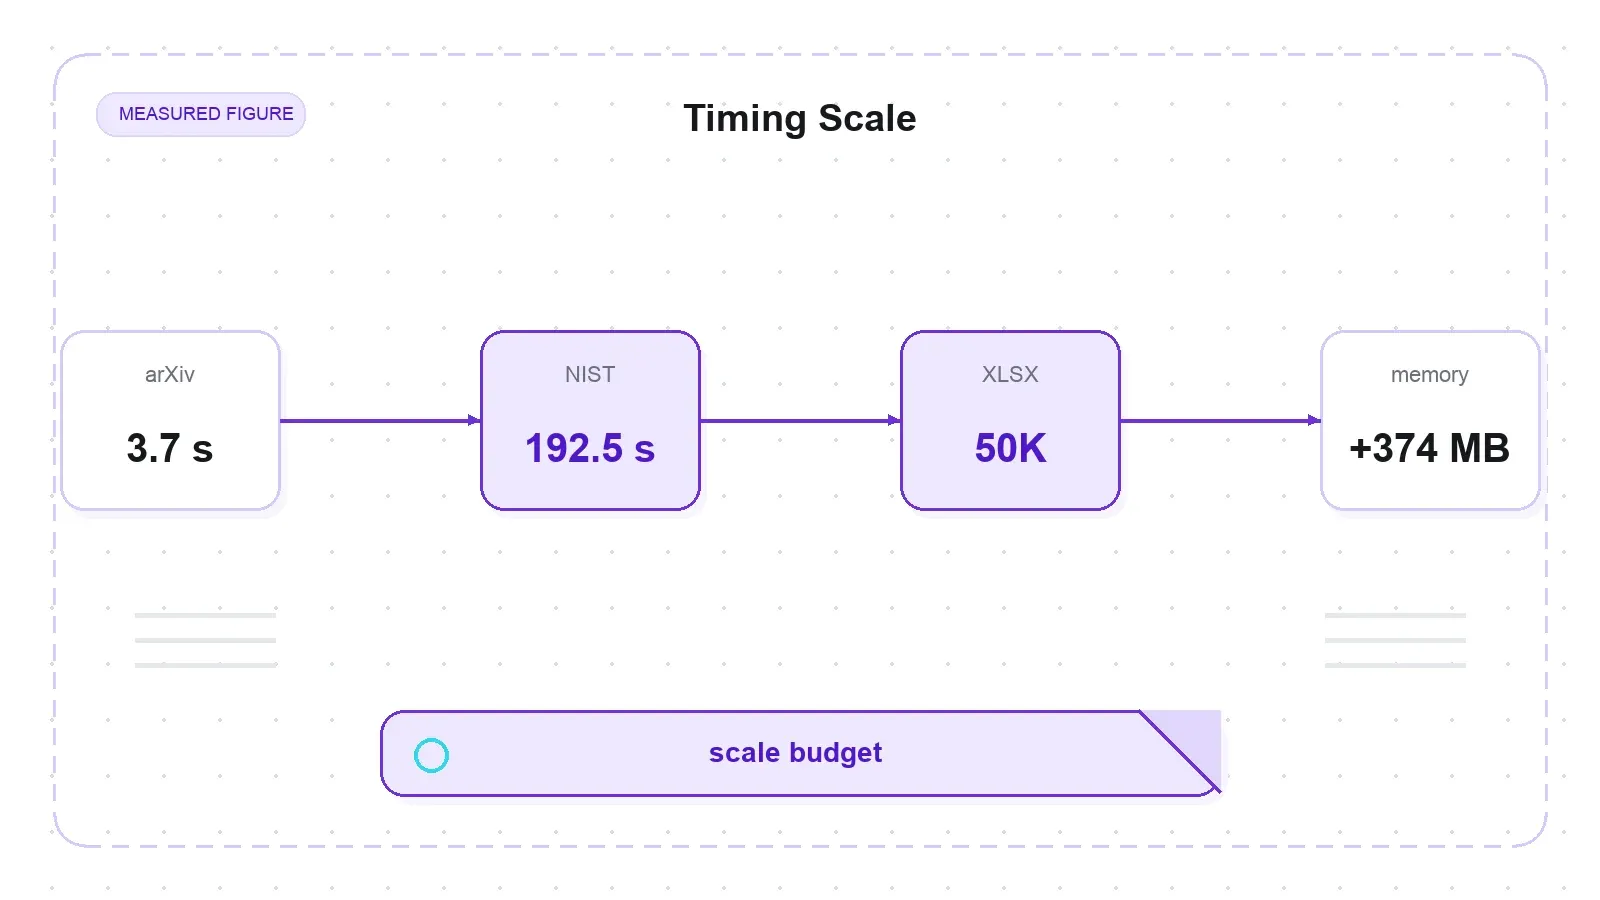
| נושא | קלט | תווי פלט | זמן חציוני | Peak RSS Δ |
|---|---|---|---|---|
| NIST SP 800-53r5 (PDF של 492 עמודים) | 6.07 MB | 1,625,365 | 192.5 שנ׳ | +40 MB |
| XLSX של 50,000 שורות × 8 עמודות | 2.1 MB | 3,722,955 | 62.1 שנ׳ | +374 MB |
| arXiv 1706.03762 (כ-15 עמודים) | 2.2 MB | 40,174 | 12.6 שנ׳ | +25 MB |
| XLSX של 200 שורות × 64 עמודות | 46 KB | 120,129 | 2.9 שנ׳ | +22 MB |
ה-PDF של 492 עמודים של NIST לקח חציון של 192.5 שניות — בערך 3.2 דקות, או 0.39 שנ׳ לעמוד — משום ש-pdfplumber מריץ זיהוי טפסים לפי מיקום מילים על כל עמוד. ה-peak RSS נשאר על +40 MB, כך שזה צוואר בקבוק של CPU ולא של זיכרון. אפילו ה-PDF של arXiv בן 15 העמודים לקח 12.6 שניות בתהליך מבודד משלו, בערך פי 3.4 מה-3.7 שניות שאותו קובץ הראה כשהיה warm בתוך חבילת המסמכים שלי. הפער הזה הוא העלות של תהליך קר, ומוכיח שעבודת per-page היא המנוע, לא גודל הבייטים הגולמי. אם אתם רוצים מספר יחיד שאפשר לקחת הלאה עבור ה-PDF הזה, השתמשו ב-12.6 שניות המבודדות.
מסלול הגיליונות האלקטרוניים הופך את הבקבוק. קובץ XLSX של 2.1 MB עם 50,000 שורות התנפח ל-+374 MB peak RSS (ול-3.7 מיליון תווי פלט) משום שהממיר טוען את כל הגיליון ובונה מחרוזת Markdown אחת גדולה. לכן ההנחיה המעשית היא פשוטה: עבור PDF-ים גדולים, תקצו דקות של CPU; עבור גיליונות גדולים, תקצו מאות MB של RAM. אלה מספרים ממחשב יחיד על macOS arm64 ו-Python 3.14, והקבועים של per-page ו-per-row תלויי פלטפורמה — אבל הצורה הכללית (PDF איטי ותלוי CPU, XLSX כבד בזיכרון, שום דבר לא קורס) היא החלק שעובר ממערכת למערכת.
איפה Thunderbit נכנס — ואיפה לא
נסו את Thunderbit לחילוץ נתוני רשת
זה ההשוואה הכי קלה להגזים בה, אז אקבע את הגבול בזהירות. MarkItDown ו-Thunderbit פותרים בעיות קרובות, לא זהות.
MarkItDown ממיר קבצים שכבר יש לכם. Thunderbit מביא קודם את הדף. נקודת הקצה /distill של Thunderbit הופכת דף אינטרנט חי ל-Markdown נקי ומוכן ל-LLM — כולל טיפול ברינדור JS, נגד-בוט, ותוכן דינמי שאין ל-MarkItDown שום מנגנון להתמודד איתו — ונקודת הקצה /extract מחזירה JSON מובנה שתואם לסכימה, לא רק Markdown גולמי. למפתחים זה זמין כ-API (POST /distill / POST /extract), כשרת MCP, וכ-CLI (npx @thunderbit/thunderbit-cli) מעל אותו מנוע AI, אותו אחד שמאחורי ההרחבה עם יותר מ-100,000 משתמשים.
אז הם חופפים רק בדבר אחד — שניהם יכולים להפיק "LLM-ready Markdown" — אבל תחום הקלט שונה: ה-distill של Thunderbit לוקח URL ברשת הפתוחה, ו-MarkItDown לוקח קובץ מקומי. הם לא תחליפים זהים, ולא אעמיד פנים שכן. ה-stack הריאלי משתמש בשניהם: Thunderbit (או שירות בסגנון Firecrawl) מביא וסורק את האינטרנט, ואז MarkItDown מנרמל את המסמכים המקומיים המעורבים שגם יש לכם — PDF-ים, מצגות וגיליונות אלקטרוניים. אחד מטפל ברשת; השני מטפל בארון הקבצים.
יתרונות וחסרונות
חוזקות
- שחזור מלא של body ב-HTML נקי (4/4 דפים), עם שמירה נאמנה על עץ כותרות וקישורים
- שחזור טקסט מצוין ב-PDF/DOCX (arXiv 7/7 בדיקות, Bitcoin 6/6) וללא אובדן תוכן שקט ב-fixtures של ה-Office של המתחזקים
- משוואות Office Math נשמרות כ-LaTeX — יתרון נישתי אמיתי
- לא קרס באף נושא שנבדק, כולל PDF של 492 עמודים ו-XLSX של 50 אלף שורות
- קל מאוד לשימוש: CLI,
convert(), piping דרך stdin, ושרת MCP אופציונלי - ברישיון MIT, מתוחזק באופן פעיל על ידי Microsoft, ועם tracker מגיב
חולשות
- שומר boilerplate — עד 12.4% שורות chrome ב-Wikipedia; אינו מחלץ מאמרים
- טבלאות נשברות ב-spans, nesting, ו-pipes בתוך תא (2/13 שבורות, 4/13 עקומות), ו-rowspan מזיז נתונים בשקט
- PDF-ים סרוקים/מבוססי-תמונה מחזירים פלט ריק בלי OCR ובלי שגיאה
- פלט PDF חסר לגמרי מבנה של כותרות (תואם לבנצ'מרקים ציבוריים)
- התקנה בסיסית של 161 MB עם runtime של ONNX בנפח 73 MB; ~3.35 שנ׳ import קר
- ה-extra של
[all]חוזר בשקט לגרסה 0.0.2 מלפני שנתיים ב-Python 3.14
למי זה מתאים ולמי לא
בחרו ב-MarkItDown אם אתם מייצרים תקן אחיד לערימה של מסמכים מקומיים מעורבים — Word, Excel, PowerPoint, PDF-ים עם שכבת טקסט — לתוך Markdown עבור pipeline של LLM, ואתם מעדיפים שלמות טקסט על פני שמירה על מבנה. כ-converter של ה-last mile בעבודת batch, שמזין טקסט נקי למודל, הוא מהיר, נאמן, וחינמי.
דלגו עליו, או חברו אותו לכלי נוסף, אם העבודה שלכם היא אחת מאלה: אתם צריכים רק את המאמר המרכזי מדף אינטרנט (השתמשו בכלי readability או Firecrawl-style); אתם צריכים שכותרות וטבלאות של PDF ישרדו כמו שצריך (זה התחום של Docling או Marker); או שהקלט כולל מסמכים סרוקים שדורשים OCR (תצטרכו את backend של Azure או כלי אחר לגמרי). ואם חשבתם שאתם מחפשים scraper — משהו שמביא וסורק — זה בכלל לא זה.
הציון הזמני שחישבתי, על rubric שנראה כמו scraper, יוצא 60/100, והציון הנמוך הזה הוא תוצאה של כך שדרגתי ממיר לפי מבחן של crawler. בשטח שלו עצמו, ציוני נאמנות הטקסט שלו גבוהים; נקודות החולשה הן מבניות (טבלאות, כותרות PDF) ואריזתיות (טביעת רגל, import, מלכודת [all]), לא איכות הטקסט. תשפטו אותו כפי שהוא — ממיר מקובץ ל-Markdown — ותקבלו כלי יציב ומתוחזק היטב, עם כמה קצוות חדים שכדאי להכיר לפני שמכניסים אותו לייצור.
שאלות נפוצות
האם MarkItDown הוא web scraper?
לא. אין בו crawler, אין רינדור JavaScript, אין מעקב אחרי קישורים, ואין דפדוף בין עמודים. הוא ממיר קבצים ומסמכים שכבר יש לכם — PDF, DOCX, XLSX, PPTX, תמונות, HTML — ל-Markdown. אם אתם צריכים להביא ולסרוק דפי אינטרנט חיים, אתם צריכים כלי scraping כמו Thunderbit או Firecrawl; MarkItDown הוא השלב שאחר כך, שממיר קבצים מקומיים או שנמשכו מהאינטרנט ל-Markdown נקי.
למה pip install markitdown[all] מתקין גרסה ישנה?
ב-Python 3.14, ה-extra של [all] נועל את youtube-transcript-api~=1.0.0, וכל build בטווח הזה מוגבל לגרסאות Python נמוכות מ-3.14. ה-resolver לא מצליח לעמוד ב-pin, ולכן הוא חוזר בשקט ל-markitdown 0.0.2, גרסה מלפני שנתיים. הפתרון הוא לנעול גרסה ולהתקין את ה-extras בנפרד: pip install 'markitdown==0.1.6', ואז להוסיף 'markitdown[pdf,docx,pptx,xlsx,xls]==0.1.6'. זה מתועד ב-issue #2179.
האם MarkItDown עושה OCR ל-PDF-ים סרוקים?
לא בהתקנה הבסיסית. מסלול ה-PDF שלו מבצע רק חילוץ טקסט, כך ש-PDF מבוסס-תמונה בלי שכבת טקסט מחזיר מחרוזת ריקה — בלי שגיאה ובלי אזהרה. OCR דורש את backend האופציונלי של Azure Document Intelligence או plugin, ואף אחד מהם לא נכלל כברירת מחדל. זהו פער ידוע ומנוהל לאורך זמן (issue #1268).
כמה טוב MarkItDown מטפל בטבלאות?
מבחינת תוכן — מצוין. במבחן שלי של 13 מקרים, הוא שמר על 100% מתוכן הטבלאות בכל מצב. מבחינת מבנה — זה תלוי בצורה: טבלאות פשוטות, רחבות, בלי header, ועם תאים ריקים יוצאות כ-grid נקי של GFM, אבל rowspan ו-colspan יוצרים שורות עקומות (ו-rowspan יכול להזיז נתונים בשקט לעמודה הלא נכונה), טבלאות מקוננות משתטחות לשורות זבל, ותווי pipe מילוליים בתוך תאים לא עוברים escaping. פורמט הטבלה השטוח של Markdown פשוט לא מסוגל לייצג spans או nesting.
האם MarkItDown מהיר מספיק למסמכים גדולים?
הוא לא קורס על קבצים גדולים, אבל צריך לתכנן משאבים לפי סוג הקובץ. PDF של 492 עמודים לקח בערך 3.2 דקות (כ-0.39 שנ׳ לעמוד) כי הוא מבצע זיהוי טפסים לכל עמוד, והוא CPU-bound. גיליון אלקטרוני של 50,000 שורות סיים בערך בדקה, אבל השתמש בעוד 374 MB של RAM כי הוא בונה מחרוזת Markdown אחת גדולה בזיכרון. עבור PDF-ים גדולים תכננו דקות של CPU; עבור גיליונות גדולים תכננו מאות MB של RAM.
נסו את Thunderbit לחילוץ נתוני רשת Get Started Free




